AI Agent Memory: Schema-Guided State und Provenance

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Artikel richtet sich an Engineers, die langlaufende oder mandantenfähige Agents bauen. Einfacher Semantic Memory hat keine Regel dafür, welcher Wert eines Fakts aktuell ist, und deshalb liefern Agents veraltete Fakten. Ändert ein Nutzer die Passfrist vom 15. Juli auf den 30. Juni, kann Vector Search beide Aussagen finden. Eine zustandsbehaftete Memory-Schicht muss festhalten, dass der Wert vom 30. Juni den früheren ersetzt.
Du lernst, wie du Memory als typisierte Records mit Gültigkeitszeiträumen, Mandantenbezug und Quellenverweisen speicherst, eine Korrektur schreibst, ohne die Historie zu verlieren, und aktuelle sowie zeitpunktbezogene Lesezugriffe testest.
Warum Context und Vector Recall veraltete Fakten liefern
Das Context Window ist die Eingabe, die für einen Model-Aufruf zur Verfügung steht. Eine Anwendung kann Nachrichten in spätere Aufrufe mitnehmen, aber die Anwendungsregeln müssen entscheiden, welche alten Fakten weiterhin gelten und wer sie sehen darf.
Langlaufende Agents müssen sich Präferenzen, Task-Status, Kundenfakten, Tool-Entscheidungen, Compliance-Notizen und frühere Fehler merken. Die einfache Variante hängt Zusammenfassungen an oder kippt alte Notizen in einen Vector Store. Das funktioniert, bis sich einer der gemerkten Fakten ändert.
Dann hat der Agent zwei Passfristen, zwei bevorzugte Formate oder zwei Projektentscheidungen. Semantic Search findet womöglich beide. Eine Zusammenfassung überschreibt vielleicht eine davon. Ein langer Context enthält möglicherweise den veralteten Wert neben dem aktiven. Diese Designs liefern Text, können aber nicht sagen, welcher Wert aktuell ist.
Der Memory-Vertrag muss konkrete Fragen beantworten:
- Was gilt jetzt?
- Was galt am 2. Juni?
- Wer hat es gesagt?
- Zu welchem Mandanten gehört es?
- Welchen älteren Fakt hat dieser Fakt ersetzt?
- Kann ich es löschen oder ablaufen lassen?
Schema-Guided Agent Memory (SGAM) speichert diese Antworten als Felder und Relationen, statt sie im Fließtext implizit zu lassen.
Was SGAM bedeutet
Zwei ähnlich benannte Forschungsideen grenzen SGAM ab.
Schema-Guided Memory (SGM) ist der Forschungsbegriff von Mei et al. in According to Me: Long-Term Personalized Referential Memory QA. Das Paper vergleicht freitextliches Descriptive Memory (DM) mit Key-Value-Memory-Items nach festem Schema. Beide Darstellungen enthalten dieselben Quellinformationen in unterschiedlicher Struktur. Eine frühere Verwendung des Namens, das Schema-Guided Dialogue Dataset, verfolgt den Dialogzustand für Service-APIs und hat mit Long-Term Memory nichts zu tun.
In diesem Artikel meine ich mit Schema-Guided Agent Memory (SGAM) ein Engineering-Muster, in dem Schemas Schreiben, Aktualisieren, Retrieval und Löschen steuern. Das Schema definiert den Anwendungszustand und seinen Lebenszyklus.
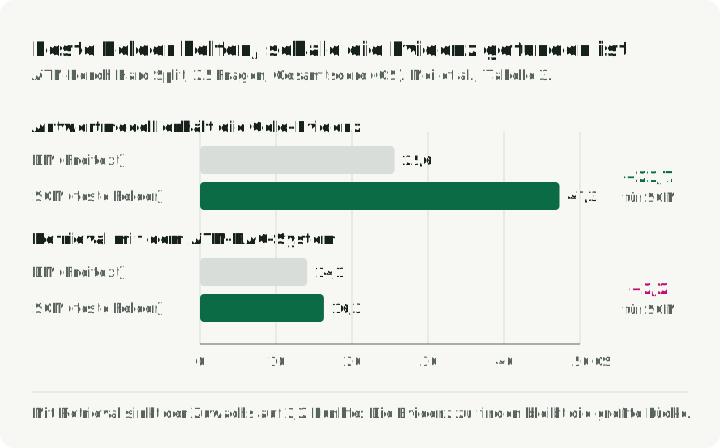
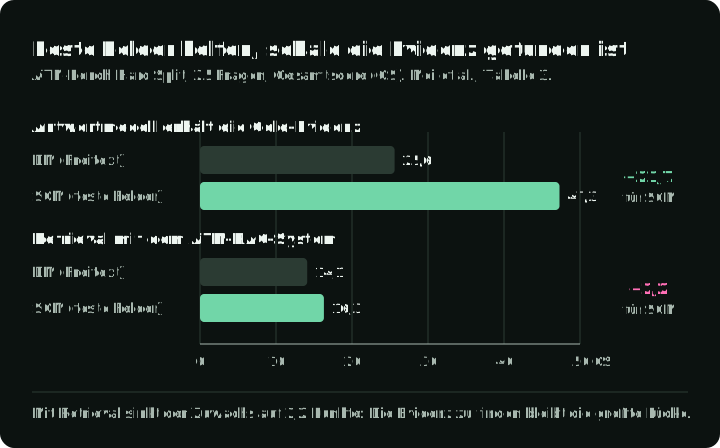
ATM-Bench zeigt, warum die Darstellung zählt. Der Benchmark nutzt rund vier Jahre persönlicher Daten aus E-Mails, Bildern und Videos. Die Fragen erfordern persönliche Bezüge, Ortsangaben, mehrere Belege und Änderungen im Zeitverlauf. SGM legt Felder wie Zeit, Quelle, Ort, Entitäten und Tags in einer festen Darstellung offen. Auf dem Hard Split mit 25 Fragen steigt laut Tabelle 3 des Papers der Gesamtscore (QS) von 25,6 mit DM auf 47,3 mit SGM, wenn das Antwortmodell die Gold-Evidenz erhält. Mit Retrieval im ATM-RAG-System der Autoren steigt der Score auf dem Hard Split nur von 14,1 auf 16,3. Das Finden der Evidenz bleibt also die größte Lücke.
Das Diagramm stellt die vier Hard-Split-Scores nebeneinander. Vergleiche den Zuwachs durch feste Felder mit Gold-Evidenz und mit Retrieval.
SGM gegen DM beantwortet eine Speicherfrage: Soll Memory Freitext bleiben oder benannte Felder nutzen? Ein produktiver Agent hat vorher ein anderes Problem. Er muss aus einer unstrukturierten Konversation ein vorgeschlagenes Memory-Update machen. Der nächste Abschnitt zeigt, wie Schema-Guided Reasoning (SGR) diesen Model-Aufruf formt und wo SGAM übernimmt.
Model-Extraktion und Memory-Ownership trennen
Der Memory-Schreibvorgang durchläuft drei Schichten. Structured Output (SO) erzwingt die Form des Kandidatenobjekts. Schema-Guided Reasoning (SGR) macht die vorgesehenen Felder und die Entscheidungsabsicht des Models in einer strukturierten Antwort nachvollziehbar. Schema-Guided Agent Memory (SGAM) verwaltet den Kandidaten nach dem Model-Aufruf als dauerhaften Zustand. Getrennte Aufrufe, Validatoren und Anwendungsregeln erzwingen Abhängigkeiten, Reihenfolge und Lifecycle-Regeln.
Frühere Artikel wenden SGR auf strukturierte Judges, Planner und Router und RAG-Rubrics an. In jedem dieser Fälle läuft ein Urteil, eine Route oder ein Plan meist mit der aktuellen Anfrage ab. Ein anderer Run liest einen Memory-Kandidaten vielleicht erst Tage später oder nutzt ihn, um einen Tool Call zu wählen. Diese längere Lebensdauer verlangt Speicherregeln, die SGR nicht liefert.
SGR legt die Felder einer einzelnen Model-Antwort in der Reihenfolge fest, in der das Model sie füllen soll. Bei einem Memory-Write kann die Antwort Quellenbelege, ein normalisiertes Subject und Attribute, einen Vergleich mit dem aktuellen Zustand und ein vorgeschlagenes Update enthalten. Pydantic oder JSON Schema beschreibt diese Felder. Provider-natives Structured Output oder eine Guided-Decoding-Runtime wie XGrammar hält die Antwort in dieser Form. Die Form kann weder eine richtige Schlussfolgerung garantieren noch beweisen, dass das Model die Felder in dieser Reihenfolge genutzt hat.
SGAM entscheidet, was passiert, nachdem dieses Objekt existiert. Soll es gespeichert werden? Ersetzt es einen älteren Fakt? Welcher Mandant darf es sehen? Ist es aktuell oder historisch? Welche Quell-Episode belegt es?
Die Tabelle zeigt Zuständigkeit und Fehlerbild jeder Schicht:
| Dimension | SO | SGR | SGAM |
|---|---|---|---|
| Zweck | Ein Objekt zurückgeben, das einem Schema entspricht | Vorgesehene Felder und Entscheidungsabsicht nachvollziehbar machen | Dauerhaften Memory nach dem Model-Aufruf verwalten |
| Reichweite | Eine generierte Antwort | Eine Model-Antwort; schrittübergreifende Regeln können mehrere Aufrufe umfassen | Records, die über Aufrufe, Sessions und Runs hinweg genutzt werden |
| Rolle des Schemas | Definiert Ausgabefelder, Typen und erlaubte Werte | Beschreibt Evidenz, Zwischenfelder und Entscheidungskandidaten | Definiert gespeicherte Records, Relationen und Lifecycle |
| Durchsetzung | Constrained Decoding blockiert schemaungültige Ausgabe | Nur die Form; getrennte Aufrufe, Validatoren und Regeln erzwingen Abhängigkeiten und Reihenfolge | Anwendungsvalidierung, Datenbank-Constraints und Konfliktregeln erzwingen den Lifecycle |
| Lebensdauer | Der aktuelle Aufruf, sofern die Anwendung das Objekt nicht speichert | Der Reasoning Trace wird nach der Entscheidung meist verworfen | Bleibt bestehen, bis er aktualisiert wird, abläuft oder gelöscht wird |
| Fehlerbild | Gültige Form mit falscher Bedeutung | Die Felder sind vorhanden, aber Reasoning oder Umgang mit Abhängigkeiten kann trotzdem falsch sein | Veralteter, verunreinigter, nicht eingegrenzter oder nicht nachprüfbarer Zustand |
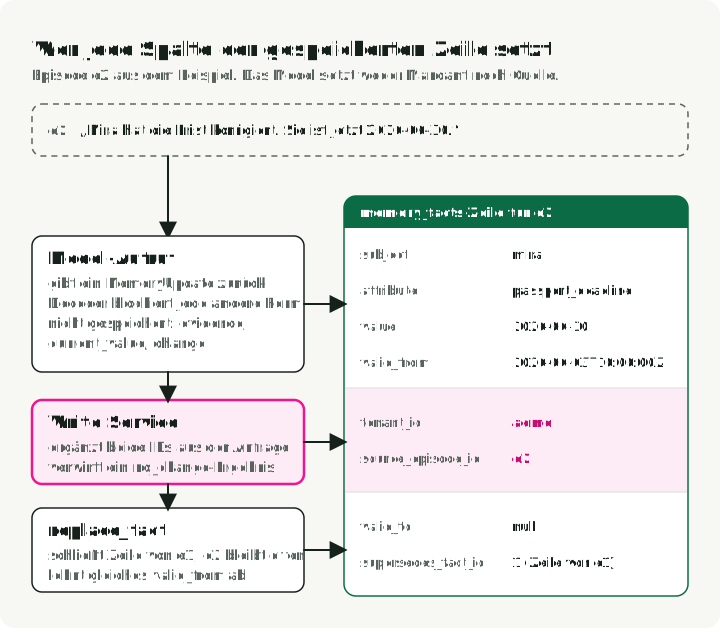
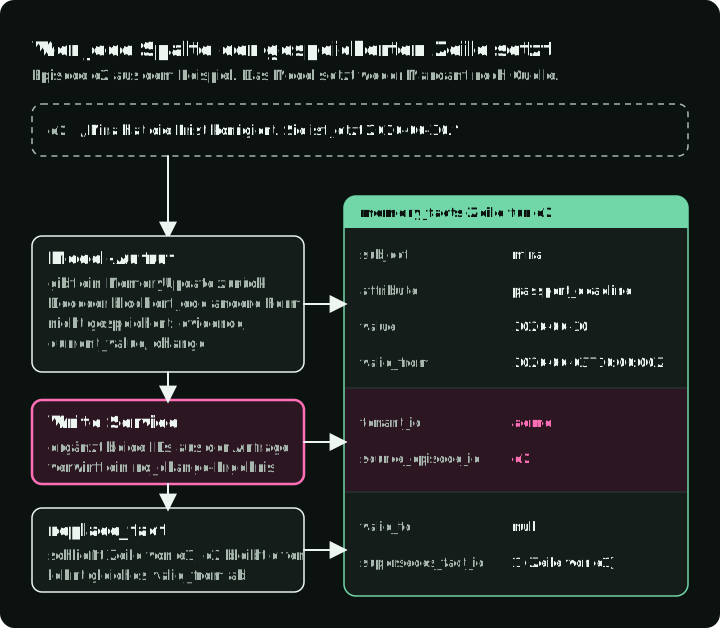
Das Diagramm verfolgt die Korrektur aus dem Beispiel unten bis in eine gespeicherte Zeile und zeigt, wer jede Spalte setzt: das Model, der Write Service aus der Anfrage oder replace_fact.
Das folgende Schema definiert das Objekt, das von der Extraktion an den SGAM-Write-Service übergeben wird. Es setzt Pydantic voraus. Die Anwendung legt den aktuell gespeicherten Wert in den Prompt, damit das Model ihn mit der neuen Evidenz vergleichen kann:
from datetime import datetime
from typing import Literal

from pydantic import BaseModel, Field

class MemoryUpdate(BaseModel):
    evidence: str = Field(description="Exact quote from the episode")
    subject: str = Field(description="Normalized entity ID, e.g. mira")
    attribute: str = Field(description="Property being updated")
    current_value: str | None = Field(description="Stored value shown in the prompt")
    change: Literal["new", "update", "no_change"]
    value: str | None = Field(description="New value; None when change is no_change")
    valid_from: datetime = Field(description="When the new value starts to apply")
Der Write-Service verwirft no_change-Ergebnisse, ergänzt tenant_id und source_episode_id aus der Anfrage und gibt den Rest an replace_fact im folgenden Beispiel weiter. Das Model wählt weder den Mandanten noch die Quell-Episode.
Write und Read Path haben unterschiedliche Aufgaben
Nur der Write Path verändert den gespeicherten Zustand. Der Read Path wählt Records für die aktuelle Anfrage aus.
Der Ingestion Flow ist der Write Path:
- Erfasse eine Roh-Episode aus Nachrichten, Tool Results oder Geschäftsereignissen. Halte ihren Mandanten und ihre Aufbewahrungsklasse fest.
- Extrahiere typisierte Kandidaten mit Structured Output.
- Validiere die Nutzdaten mit Pydantic oder der Schema-Schicht, die dein Stack bereits nutzt, und weise fehlerhafte Writes ab.
- Löse Konflikte vor dem Insert: Entscheide, ob der neue Record einen alten ersetzt, und schließe den veralteten Fakt.
- Behalte einen Quellverweis auf die Roh-Episode, das Tool Result, die Datei, das Ticket oder die Nutzerbestätigung, die den Record erzeugt hat.
- Schreibe den Record mit seiner
schema_versionin den SGAM-Store, statt die Version nur im Anwendungscode zu belassen.
Der Request Flow ist der Read Path:
- Beginne mit der Nutzerfrage.
- Entscheide, ob die Frage den aktuellen oder einen zeitpunktbezogenen Zustand braucht.
- Filtere nach Mandant, Memory-Typ, Subject, Attribute und Gültigkeitszeitraum.
- Ergänze Vector- oder Graph-Expansion nur, wenn der exakte Zustandsabruf nicht reicht. Nutze sie für zusätzliche Belege, verwandte Entitäten und Beispiele, nicht als Autorität für aktuelle Fakten.
- Stelle den kleinsten zitierten Context für das Model zusammen.
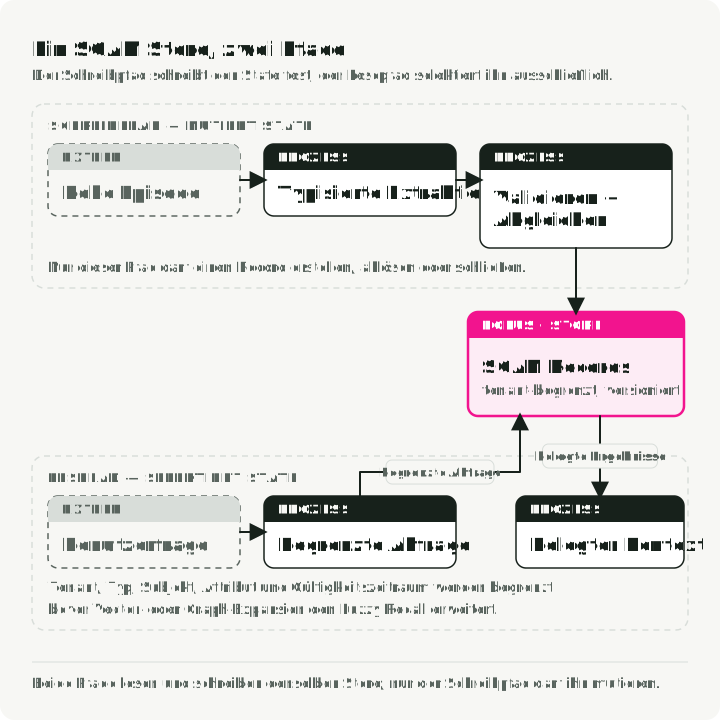
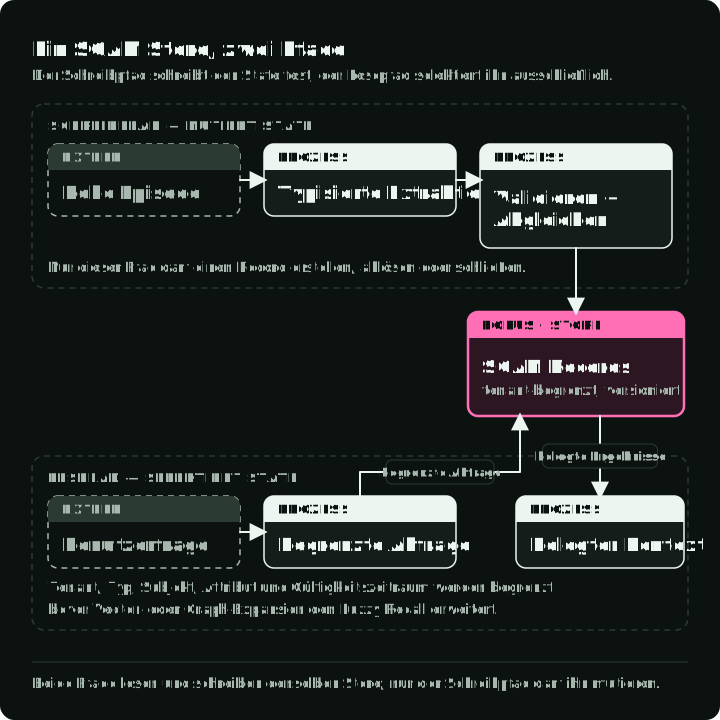
Lies das Diagramm von oben nach unten. Der Write Path schließt e1 und fügt e2 in einen Store ein. Der Read Path wählt einen Filter für aktuellen oder zeitpunktbezogenen Zustand und selektiert dann Zeilen aus demselben Store.
Was in ein Memory-Schema gehört
Ein minimaler SGAM-Record braucht mehr als text. Jedes Feld beantwortet eine der Fragen aus dem ersten Abschnitt oder erfüllt eine Aufgabe im Lifecycle:
| Feld | Frage, die es beantwortet, oder Aufgabe, die es erfüllt |
|---|---|
tenant_id | Zu welchem Mandanten gehört es? Jeder Read und Write filtert danach. |
memory_id | Eine stabile ID, auf die andere Records und Löschjobs verweisen. |
subject, attribute | Der Schlüssel: welche Entität und welche Eigenschaft, etwa mira und passport_deadline. |
value | Der gespeicherte Wert. |
memory_type | Die Art des Memory: semantisch (stabile Fakten und Profile), episodisch (vergangene Ereignisse und Traces) oder prozedural (Anweisungen und Prompt-Regeln), wie LangGraph sie beschreibt. |
schema_version | Welches Schema den Record geschrieben hat, damit eine Migration alte Records finden und konvertieren kann. |
valid_from, valid_to | Was gilt jetzt? valid_from <= now und (valid_to ist null oder now < valid_to). Was galt am 2. Juni? Das Intervall enthält diesen Zeitpunkt. |
supersedes_memory_id | Welchen älteren Fakt hat dieser Fakt ersetzt? |
source_episode_id | Wer hat es gesagt? Das Feld verweist auf die Roh-Episode. |
confidence | Ein Score, den der Write-Service mit einem Schwellenwert vergleicht: den Kandidaten zum aktuellen Zustand befördern oder den Nutzer um Bestätigung bitten. |
retention_policy | Kann ich es löschen oder ablaufen lassen? Das Feld sagt Löschjobs, was sie sonst noch entfernen müssen. |
Mit diesen Feldern kann eine neue Passfrist die vorherige schließen, ohne die Historie zu löschen. Dieselbe Tabelle kann aktuelle und zeitpunktbezogene Abfragen beantworten und das Ergebnis bis zur Quell-Episode zurückverfolgen.
Nutze RAG, um Dokumente abzurufen, und SGAM, um veränderlichen Zustand zu pflegen. Vector Search gehört weiterhin ins System, für unscharfen Recall, Clustering und Expansion. Der aktuelle Wert von mira.passport_deadline sollte aus einem Memory-Record mit passendem Scope stammen und nicht aus dem Chunk, der zufällig zuerst gerankt wurde.
Ein Beispiel für einen veralteten Fakt
Betrachte einen synthetischen Trace aus zwei Episoden, dargestellt als DM-Baseline und als SGAM-Ledger:
e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.
e2: Mira corrected the deadline. It is now 2026-06-30.
Eine DM-Baseline behält beide Episoden als Freitext, sodass die Textsuche e1 zurückgeben kann, weil es die passenden Wörter enthält. SGAM extrahiert aus jeder Episode einen typisierten Fakt, geschlüsselt nach Mandant, Subject und Attribute. Es sollte e2 als aktuellen Zustand zurückgeben und e1 für eine historische Abfrage behalten.
Das folgende Skript beantwortet zwei der früheren Fragen: was jetzt gilt und was am 2. Juni galt. Sieh dir replace_fact an: Die Funktion schließt die alte Zeile, statt sie zu löschen, und hält fest, welche Zeile die neue ersetzt. Der Aufrufer muss jeden gespeicherten und für Abfragen verwendeten Zeitstempel auf ein einheitliches UTC-Zeichenkettenformat mit fester Sekundengenauigkeit normalisieren: YYYY-MM-DDTHH:MM:SSZ. SQLite vergleicht diese TEXT-Werte lexikografisch; unterschiedliche Zeitzonen-Offsets oder Genauigkeiten können Fakten deshalb falsch ordnen. Jede Zeile gilt ab valid_from bis ausschließlich valid_to. Die Tabelle weist ungültige Intervalle ab und hat einen partiellen Unique Index für einen offenen Fakt pro Mandant, Subject und Attribute. replace_fact verwaltet eine Transaktion und startet sie mit BEGIN IMMEDIATE, bevor die Funktion Zeilen liest. Rufe sie auf einer Verbindung ohne aktive Transaktion auf. SQLite serialisiert gleichzeitige Writer, daher sollten Aufrufer nach einem Lock- oder Eindeutigkeitsfehler die gesamte Transaktion wiederholen. Am Ende steht ein Keyword-Treffer stellvertretend für Vector Search. Jedes Ranking, das die Korrektur nicht kennt, kann e1 zurückgeben.
import sqlite3
from dataclasses import dataclass

@dataclass(frozen=True)
class MemoryFact:
    tenant_id: str
    subject: str
    attribute: str
    value: str
    valid_from: str
    source_episode_id: str

def open_db() -> sqlite3.Connection:
    db = sqlite3.connect(":memory:")
    db.row_factory = sqlite3.Row
    db.executescript(
        """
        create table memory_facts (
            fact_id integer primary key,
            tenant_id text not null,
            subject text not null,
            attribute text not null,
            value text not null,
            valid_from text not null,
            valid_to text,
            supersedes_fact_id integer references memory_facts (fact_id),
            source_episode_id text not null,
            check (valid_to is null or valid_from < valid_to)
        );
        create unique index one_open_fact
        on memory_facts (tenant_id, subject, attribute)
        where valid_to is null;
        """
    )
    return db

def replace_fact(db: sqlite3.Connection, fact: MemoryFact) -> None:
    with db:
        db.execute("BEGIN IMMEDIATE")
        exact = db.execute(
            """
            select fact_id
            from memory_facts
            where tenant_id = ? and subject = ? and attribute = ? and valid_from = ?
            """,
            (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
        ).fetchone()
        if exact:
            raise ValueError("equal valid_from requires an application conflict policy")

        containing = db.execute(
            """
            select fact_id, valid_to
            from memory_facts
            where tenant_id = ?
              and subject = ?
              and attribute = ?
              and valid_from < ?
              and (valid_to is null or valid_to > ?)
            limit 1
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.valid_from,
                fact.valid_from,
            ),
        ).fetchone()
        if containing:
            db.execute(
                "update memory_facts set valid_to = ? where fact_id = ?",
                (fact.valid_from, containing["fact_id"]),
            )
            successor_boundary = containing["valid_to"]
        else:
            successor = db.execute(
                """
                select valid_from
                from memory_facts
                where tenant_id = ? and subject = ? and attribute = ? and valid_from > ?
                order by valid_from
                limit 1
                """,
                (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
            ).fetchone()
            successor_boundary = successor["valid_from"] if successor else None

        db.execute(
            """
            insert into memory_facts
                (tenant_id, subject, attribute, value, valid_from, valid_to,
                 supersedes_fact_id, source_episode_id)
            values (?, ?, ?, ?, ?, ?, ?, ?)
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.value,
                fact.valid_from,
                successor_boundary,
                containing["fact_id"] if containing else None,
                fact.source_episode_id,
            ),
        )

def fact_at(
    db: sqlite3.Connection, tenant_id: str, subject: str, attribute: str, timestamp: str
) -> sqlite3.Row | None:
    return db.execute(
        """
        select fact_id, value, valid_from, supersedes_fact_id, source_episode_id
        from memory_facts
        where tenant_id = ?
          and subject = ?
          and attribute = ?
          and valid_from <= ?
          and (valid_to is null or valid_to > ?)
        limit 1
        """,
        (tenant_id, subject, attribute, timestamp, timestamp),
    ).fetchone()

KEY = ("acme", "mira", "passport_deadline")

db = open_db()
replace_fact(db, MemoryFact(*KEY, "2026-07-15", "2026-06-01T09:00:00Z", "e1"))
replace_fact(db, MemoryFact(*KEY, "2026-06-30", "2026-06-03T10:00:00Z", "e2"))
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")

historical = fact_at(db, *KEY, "2026-06-02T00:00:00Z")
assert (historical["value"], historical["source_episode_id"]) == ("2026-07-15", "e1")
assert current["supersedes_fact_id"] == historical["fact_id"]

# A delayed extraction predates e1. It ends at e1's existing boundary,
# rather than closing e2, which remains current.
replace_fact(db, MemoryFact(*KEY, "2026-08-01", "2026-05-30T08:00:00Z", "e0"))
delayed = fact_at(db, *KEY, "2026-05-31T00:00:00Z")
assert (delayed["value"], delayed["source_episode_id"]) == ("2026-08-01", "e0")
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")
intervals = db.execute("select valid_from, valid_to from memory_facts").fetchall()
assert all(row["valid_to"] is None or row["valid_from"] < row["valid_to"] for row in intervals)

episodes = (
    "e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.",
    "e2: Mira corrected the deadline. It is now 2026-06-30.",
)
naive_match = next(episode for episode in episodes if "passport deadline" in episode)
assert naive_match.startswith("e1:")

print("Naive text memory:")
print(f"  returned episode: {naive_match}")
print()
print("SGAM current state:")
print(f"  mira.passport_deadline = {current['value']}")
print(f"  valid_from={current['valid_from']}, source={current['source_episode_id']}")
print()
print("SGAM point-in-time state:")
print(f"  on 2026-06-02, mira.passport_deadline = {historical['value']}")
Das Skript gibt Folgendes aus:
Naive text memory:
  returned episode: e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.

SGAM current state:
  mira.passport_deadline = 2026-06-30
  valid_from=2026-06-03T10:00:00Z, source=e2

SGAM point-in-time state:
  on 2026-06-02, mira.passport_deadline = 2026-07-15
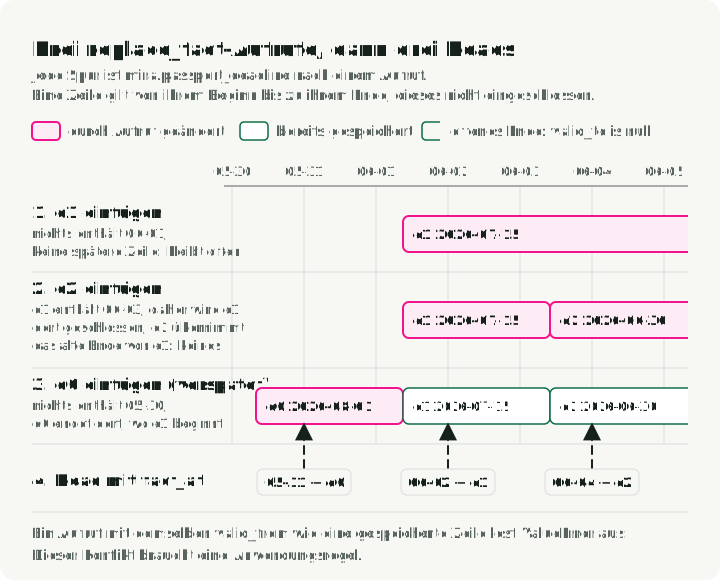
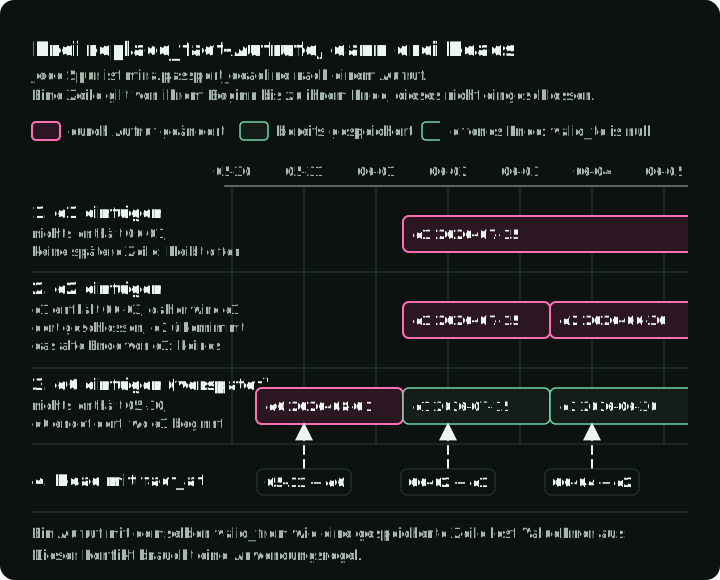
replace_fact weist zuerst ein gleiches valid_from ab: Dieser Konflikt braucht eine Anwendungsregel, etwa Quellenpriorität oder eine vom Nutzer bestätigte Revision, statt eines stillen Überschreibens. Andernfalls sucht die Funktion das Intervall, das den eingehenden Zeitstempel enthält. Findet sie eines, schließt sie diesen Vorgänger an der eingehenden Grenze, gibt der eingefügten Zeile das frühere Ende des Vorgängers und trägt den Vorgänger in supersedes_fact_id ein. Liegt der Zeitstempel vor allen gespeicherten Intervallen, nimmt sie das valid_from des nächsten Intervalls als Ende der neuen Zeile. So wird ein verspäteter Fakt vor e1 zu [2026-05-30, 2026-06-01) und lässt e1 und das aktuelle e2 unberührt. Der partielle Unique Index ist die Absicherung in der Datenbank für eine offene Zeile. DM hat keinen vergleichbaren Update-Schritt, daher kann der alte Text weiterhin höher als die Korrektur eingestuft werden.
Die Timeline zeigt die Zeilen nach jedem replace_fact-Aufruf im Skript und danach die drei Reads. Achte auf Schritt 2, in dem e2 e1 schließt, und auf Schritt 3, in dem das verspätete e0 dort endet, wo e1 beginnt.
Kombiniere in Produktion diese Transaktion mit strukturierter Extraktion auf dem Write Path. Die Datenbanktransaktion aktualisiert die zeitliche Gültigkeit. Das Model extrahiert einen Kandidatenfakt, entscheidet aber nicht, welche gespeicherte Zeile aktuell bleibt.
Die Speicherwahl folgt dem Retrieval-Muster
Projekte verwenden mehrere Namen für Teile dieses Musters: Memory Stores, Context Graphs, Profile, Long-Term Stores, Graph RAG und zustandsbehaftete Agents.
| Tool oder Framework | Hauptspeicherschicht | Mechanismus für zeitlichen Zustand | Schema-Mechanismus | Einsetzen, wenn |
|---|---|---|---|---|
| Graphiti | Neo4j, FalkorDB und Amazon Neptune; Kuzu ist veraltet | Gültigkeitsintervalle von Fakten plus Quell-Episode als Provenance | Pydantic-Entitäts- und Edge-Typen, zeitliche Edges, Provenance | du Gültigkeitsintervalle und Graph-Traversierung brauchst und die Graphdatenbank selbst betreibst |
| Zep | Proprietäre Context Graph Engine | Verwaltete zeitliche Context Graphs, die sich ändernde Fakten behalten | Standard- und eigene Entitäts- und Edge-Typen | du dasselbe zeitliche Graphmodell als Managed Service willst |
| LangGraph / LangMem | LangGraph-Stores, Postgres-basierte Stores | Von der Anwendung verwaltete Zeitstempel und Felder in Store-Records | JSON-Stores plus Pydantic-Extraktion von Profilen oder Collections | du bereits LangGraph nutzt und Zeitstempel und Konfliktregeln selbst verantwortest |
| Mem0 | Managed Stack, Valkey / Redis / Vector-Backends in OSS-Setups | Memory-Updates; die zeitliche Regel bleibt bei der Anwendung | Memory-Typen, eigene Kategorien, Extraktions-Prompts | du verwaltetes Hinzufügen, Suchen, Aktualisieren und Löschen willst, nach Nutzer, Agent, App oder Run eingegrenzt, und die zeitliche Regel selbst verantwortest |
| Letta / MemGPT | Datenbankgestützter Agent-Zustand und Memory Blocks | Editierbare Blöcke ohne Gültigkeitsintervalle auf Feldebene | Editierbare, benannte Memory Blocks | der Agent seine eigenen Memory Blocks bearbeitet oder mehrere Agents einen gemeinsamen Block brauchen, den alle sehen |
| Cognee | Graph plus Vector- und relationale Backends | Die Historie hängt von Ontologie und gewähltem Backend ab | Ontologiebasierte Extraktion und Validierung | du die Extraktion gegen eine Domänen-Ontologie validierst |
| LlamaIndex property graph | Property-Graph-Stores plus Vector Stores | Zeitfelder hängen von Graphschema und Store ab | SchemaLLMPathExtractor mit erlaubten Entitäten und Relationen | du einen Property Graph aus Dokumenten oder Traces extrahierst |
LangGraph trennt Thread-Checkpoints, die eine Konversation fortsetzen, von Cross-Thread-Stores, die Daten halten, welche spätere Threads lesen. Das Zep-Paper berichtet Verbesserungen bei Deep Memory Retrieval und LongMemEval, und das Mem0-Paper berichtet Verbesserungen bei LoCoMo. Jeder Anbieter hat sein eigenes Paper geschrieben, lies die Zahlen also als Herstellerergebnisse und nicht als Garantie für deine Workload.
Beginne mit dem Datenmodell. Wenn der exakte Faktenabruf die Hauptoperation ist, reicht meist eine relationale Tabelle mit JSON-Nutzdaten, Gültigkeitsspalten, Mandanten-Indizes und einem Vector-Sidecar. Ergänze einen Graph, wenn die Abfragen des Produkts Beziehungen folgen.
Den Write Path vor dem Graph bauen
Entscheide zuerst, was das Produkt sich merken darf. Die Wahl zwischen Graph und Vector kommt später.
Ein Support-Agent könnte sich Account-Tarif, offene Fälle und dauerhafte Kontaktpräferenzen merken. Er sollte nicht jede genervte Nebenbemerkung in den Profilzustand übernehmen. Ein Coding Agent könnte sich Repo-Konventionen und offene Aufgaben merken. Er sollte eine private Notiz nicht für immer behalten, nur weil sie einmal abgerufen wurde.
Der erste SGAM-Store kann eine relationale Tabelle mit einer JSON-Spalte und ein paar Indizes sein, beschrieben vom oben genannten Write Path mit sechs Schritten. Ein Graph wird nützlich, wenn das Produkt Beziehungen wie Kunde-zu-Account, Account-zu-Policy, Task-zu-Artefakt oder Projekt-zu-Entscheidung traversieren muss.
Hot Path und Hintergrund-Writes
Sofortige Extraktion lohnt sich, wenn der nächste Turn vom neuen Memory abhängt. Sagt der Nutzer „Merk dir, dass ich kurze Antworten bevorzuge“, sollte das System keinen nächtlichen Job brauchen, bevor es sich anders verhält.
Die meisten Turns brauchen keinen sofortigen Write. Speichere die Roh-Episode mit Mandant, Session und Tool-Metadaten und lass einen Hintergrund-Worker die Kandidaten später extrahieren. Bei wiederholungsbasierter Konsolidierung puffert der Worker schwache Signale und befördert einen Fakt erst, wenn ähnliche Evidenz wiederkehrt oder der Nutzer ihn bestätigt. Das erzeugt eine Verzögerung der Aktualität. Bei „Nutzer fragt oft nach CSV-Exporten“ ist das akzeptabel, bei „Kunde hat die Lieferadresse geändert“ riskant.
Behandle eine Schemamigration als Produktänderung, weil sie verändert, was der Agent abrufen, zitieren oder löschen kann. Sie kann auch ändern, welche historischen Fakten als aktuell gelten. Plane Migrationsskripte, Backfills, Dual-Read-Fenster und das Löschverhalten im selben Release.
Wann SGAM die Komplexität wert ist
Nutze SGAM, wenn sich Fakten mit der Zeit ändern können:
- Nutzerpräferenzen, die aktualisiert oder widerrufen werden können
- Kunden- oder Account-Fakten mit Audit-Anforderungen
- Task-Zustand für langlaufende Assistenten
- Projekt-Memory von Coding Agents
- gemeinsamer Zustand mehrerer Agents
- Compliance-Notizen, bei denen Provenance zählt
- zeitliche Fragen wie „was haben wir vor der Migration angenommen?“
SGAM ist überdimensioniert, wenn Memory kurzlebig, explorativ oder billig neu zu berechnen ist. Braucht der Agent nur ein paar Turns Kontinuität, genügen ein Checkpoint und ein gekürzter Nachrichtenverlauf. Statische Dokument-QA braucht womöglich nur RAG. Und ist die Domäne so unfertig, dass sich das Schema täglich ändert, bremst typisierter Memory das Team aus.
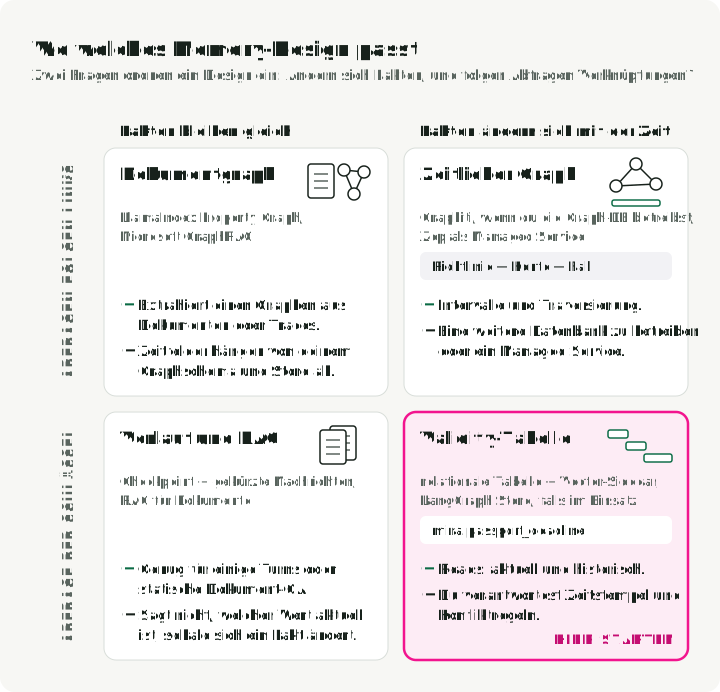
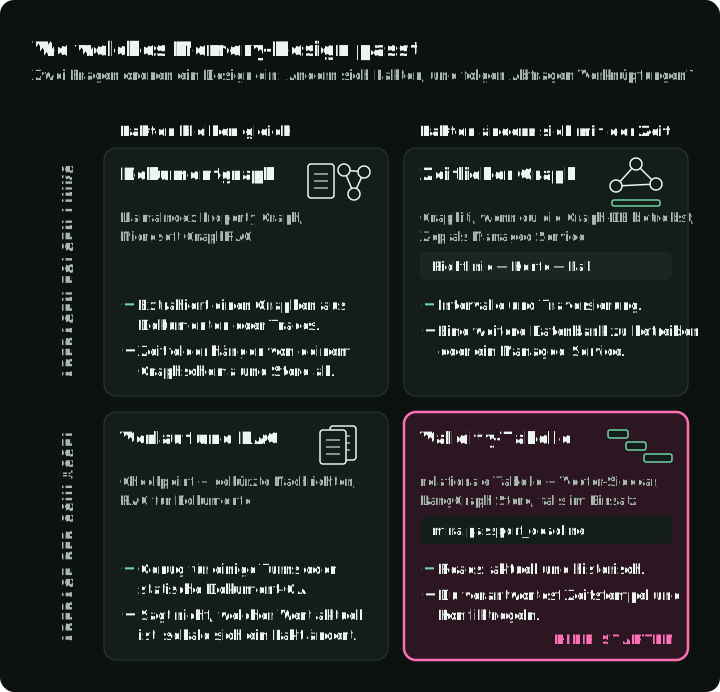
Das Raster ordnet jedes Design nach zwei Fragen: Ändern sich deine Fakten, und folgen deine Abfragen Verknüpfungen zwischen Records?
Evaluations-Checkliste
Evaluiere den Memory-Lifecycle und nicht nur die endgültige Antwort. Ein System kann eine plausible Antwort liefern, nachdem es den falschen Fakt geschrieben, einen veralteten abgerufen oder eine Mandantengrenze überschritten hat.
Ich nutze dieselbe stufenweise Aufteilung wie in meinem Artikel zur RAG-Evaluation. Miss die Stufe, in der ein Fehler auftreten kann, statt die Evaluation auf den generierten Text zu beschränken. Auch die Trace-Disziplin aus dem Artikel zur Agent-Evaluation gilt, denn ein Memory-Fehler zeigt sich oft schon in der Run-Historie, bevor er die Antwort erreicht.
Ich würde SGAM mit Replay testen. Spiele eine feste Folge von Episoden in den Memory-Writer ein und prüfe das Ledger nach jedem relevanten Turn. Stelle dann Fragen zum aktuellen und zum zeitpunktbezogenen Zustand an den entstandenen Store.
| Schicht | Fehler, nach dem du suchst | Messgrößen |
|---|---|---|
| Write-Extraktion | Der Agent hat einen Fakt übersehen, erfunden oder eine ungültige Form erzeugt | Rate schemagültiger Writes, Precision/Recall der Extraktion, Abdeckung durch Quell-Episoden |
| Konfliktbehandlung | Ein veralteter Fakt blieb aktuell oder ein gültiger alter Fakt wurde überschrieben | Korrektheit der Supersession, Duplikatrate, Korrektheit der Invalidierung veralteter Fakten |
| Isolation und Policy | Memory ist zwischen Nutzern durchgesickert oder hat sein Policy-Fenster überlebt | Fehler bei der Mandantenisolation, Korrektheit des Löschens, Einhaltung der Aufbewahrung |
| Read Retrieval | Der richtige Record existiert, aber der Reader hat ihn nicht geladen | Genauigkeit beim aktuellen Zustand, Genauigkeit beim Zeitpunktzustand, Recall@k über Memory-Records |
| Answer Grounding | Die Antwort nutzte Memory ohne Beleg oder zitierte die falsche Quelle | Belegung von Aussagen durch Quell-Episoden, Zitiergenauigkeit, Korrektheit der Konfliktauflösung |
| Betrieb | Der Memory-Pfad ist zu langsam, zu veraltet oder zu teuer | p95-Write-Latency, Verzögerung der Aktualität, Read-Latency, Kosten pro Anfrage |
Benchmarks wie LoCoMo, LongMemEval und ATM-Bench liefern öffentliche Testfälle. Sie ersetzen keine domänenspezifische Test-Suite. Ein Coding-Assistent, ein Kundensupport-Bot und ein Compliance-Copilot brauchen unterschiedliche Schemas, Filter, Aufbewahrungsregeln und Fehlertests.
From traces to better memory führt eine Verbesserungsschleife an einem Memory-Tool aus, das Fakten mit Owner, Quellereignis und Gültigkeitsintervall speichert, nach diesen Regeln.
Einschränkungen
SGAM ist meine Bezeichnung für ein Muster, kein Standard. Die Tools in der Tabelle oben nutzen für Teile davon andere Namen: Memory Stores, zeitliche Context Graphs, Memory Blocks und Knowledge Graphs. Microsoft GraphRAG beschreibt einen verwandten Teil des Problems als graphbasiertes Retrieval über Dokumente.
Ein Nutzerprofil, ein Episoden-Log, ein Dokumentgraph und ein vom Agent editierbarer Memory Block lösen unterschiedliche Retrieval- und Update-Probleme. Ich reserviere SGAM für dauerhaften Memory, der den aktuellen Anwendungszustand abbildet und deshalb Schema, Gültigkeit, Provenance, Konfliktbehandlung, Aufbewahrung und Migration braucht.
Typisierter Memory kann trotzdem falsch sein. Ein Schema macht schlechte Writes leichter prüfbar; vertrauenswürdig macht es sie nicht. Du brauchst weiterhin Quellenvertrauen, Nutzerbestätigung für sensible Fakten, eine Konfliktregel, Löschung und Monitoring.
Referenzen
- According to Me: Long-Term Personalized Referential Memory QA - Paper von Mei et al., das ATM-Bench und Schema-Guided Memory einführt.
- Towards Scalable Multi-Domain Conversational Agents: The Schema-Guided Dialogue Dataset - Paper von Rastogi et al. zum SGD-Dataset.
- Evaluating Very Long-Term Conversational Memory of LLM Agents - Paper von Maharana et al., das LoCoMo einführt.
- LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory - Benchmark von Wu et al. für Long-Term-Memory-Fähigkeiten.
- Graphiti: Build Temporal Context Graphs for AI Agents
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory
- Mem0 Platform Overview
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
- LangGraph Memory Overview
- LangGraph Persistence
- LangMem documentation
- Letta: Introduction to Stateful Agents
- Letta: Shared memory
- Microsoft GraphRAG documentation
- LlamaIndex: Using a Property Graph Index
- Cognee Documentation
- Pydantic model validation docs
- Python sqlite3 documentation