Память ИИ-агента: состояние под управлением схемы и происхождение

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Эта статья для инженеров, которые строят долгоживущих или мультитенантных агентов. У обычной семантической памяти нет правила, какое значение факта текущее, поэтому агенты возвращают устаревшие факты. Если пользователь меняет срок по паспорту с 15 июля на 30 июня, vector search может найти оба утверждения. Слой памяти с состоянием должен записать, что значение «30 июня» заменяет более раннее.
Вы узнаете, как хранить память в виде типизированных записей с окнами валидности, областью tenant и ссылками на источники, как записывать исправление без потери истории и как тестировать чтение текущего состояния и состояния на заданный момент.
Почему контекст и векторный recall возвращают устаревшие факты
Контекстное окно — это входные данные, доступные одному вызову модели. Приложение может переносить сообщения в следующие вызовы, но политика приложения должна решать, какие старые факты остаются верными и кто вправе их видеть.
Долгоживущим агентам нужно помнить предпочтения, статус задач, факты о клиентах, решения по инструментам, заметки о compliance и прошлые ошибки. Простой вариант: дописывать саммари или складывать старые заметки в векторное хранилище. Это работает, пока один из запомненных фактов не изменится.
Теперь у агента два срока по паспорту, два предпочтительных формата или два решения по проекту. semantic search может найти оба. Саммари может перезаписать один. Длинный контекст может содержать устаревший факт рядом с актуальным. Такие схемы возвращают текст, но не могут сказать, какое значение текущее.
Контракт памяти должен отвечать на конкретные вопросы:
- Что верно сейчас?
- Что было верно 2 июня?
- Кто это сказал?
- К какому tenant это относится?
- Какой более старый факт заменил этот?
- Можно ли это удалить или задать срок действия?
Schema-Guided Agent Memory (SGAM) хранит эти ответы в виде полей и связей, а не оставляет их неявными в прозе.
Что означает SGAM
Область применения SGAM определяют две исследовательские идеи с похожими названиями.
Schema-Guided Memory (SGM) — исследовательский термин, который используют Mei et al. в According to Me: Long-Term Personalized Referential Memory QA. Статья сравнивает свободный текст, Descriptive Memory (DM), с элементами памяти «ключ-значение» с фиксированной схемой. Оба представления содержат одну и ту же исходную информацию в разных структурах. Более раннее использование этого названия, датасет Schema-Guided Dialogue, отслеживает состояние диалога для сервисных API и не связано с долгосрочной памятью.
В этой статье я использую Schema-Guided Agent Memory (SGAM) для инженерного паттерна, в котором схемы управляют записью, обновлением, извлечением и удалением. Схема определяет состояние приложения и его жизненный цикл.
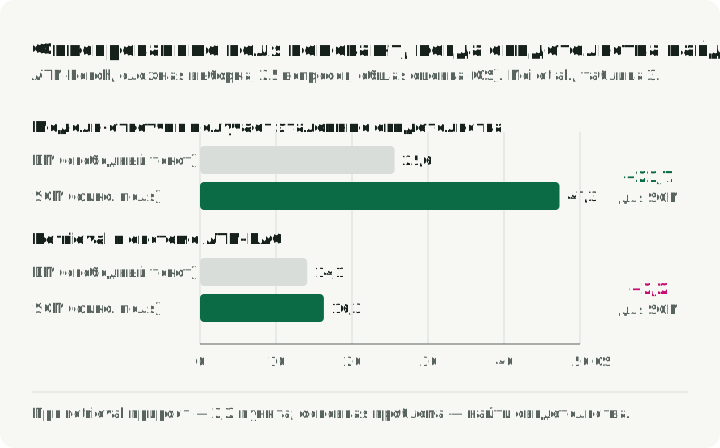
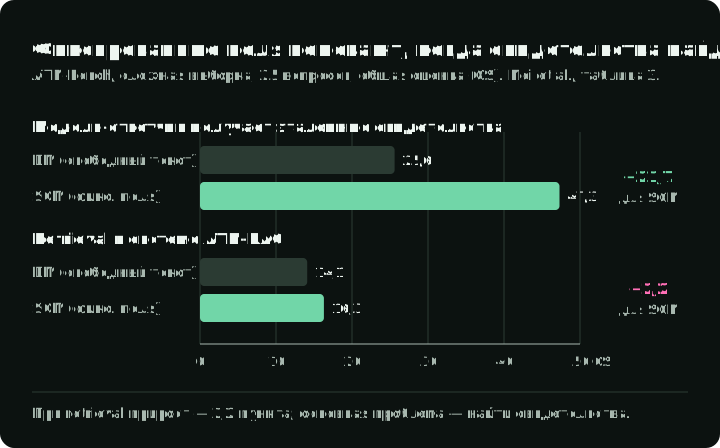
ATM-Bench показывает, почему важно представление. Бенчмарк использует примерно четыре года личных данных: письма, изображения и видео. Вопросы требуют личных отсылок, местоположения, нескольких источников свидетельств и учёта изменений во времени. SGM выносит такие поля, как время, источник, местоположение, сущности и теги, в фиксированное представление. На сложной выборке из 25 вопросов таблица 3 статьи показывает рост общей оценки (QS) с 25,6 для DM до 47,3 для SGM, когда модель-ответчик получает эталонные свидетельства. При retrieval в системе ATM-RAG авторов оценка на сложной выборке растёт лишь с 14,1 до 16,3, так что главный пробел по-прежнему в поиске свидетельств.
Диаграмма сравнивает четыре оценки на сложной выборке рядом. Сопоставьте рост от фиксированных полей при эталонных свидетельствах и при retrieval.
Сравнение SGM и DM отвечает на вопрос о хранении: оставлять ли память свободным текстом или использовать именованные поля? У агента в рабочей системе есть другая задача до хранения. Он должен превратить неструктурированный разговор в предложенное обновление памяти. Следующий раздел показывает, как Schema-Guided Reasoning (SGR) формирует этот вызов модели и где управление берёт SGAM.
Разделяйте извлечение моделью и владение памятью
Запись в память проходит через три слоя. Structured Output (SO) задаёт форму объекта-кандидата. Schema-Guided Reasoning (SGR) делает намеченные моделью поля и намерение решения видимыми в структурированном ответе. Schema-Guided Agent Memory (SGAM) управляет кандидатом как долговременным состоянием после вызова модели. Зависимости, порядок и правила жизненного цикла обеспечивают отдельные вызовы, валидаторы и политика приложения.
Прошлые статьи применяют SGR к структурированным джаджам, планировщикам и роутерам и рубрикам для RAG. В каждом из них вердикт, маршрут или план обычно живёт не дольше текущего запроса. Другой запуск может прочитать кандидата в память через несколько дней или использовать его для выбора tool call. Такой долгий срок требует правил хранения, которых SGR не даёт.
SGR раскладывает поля одного ответа модели в том порядке, в котором модель должна их заполнять. Для записи в память ответ может включать цитату-свидетельство, нормализованные субъект и атрибут, сравнение с текущим состоянием и предложенное обновление. Эти поля описывают Pydantic или JSON Schema. Нативный structured output провайдера или рантайм управляемого декодирования, например XGrammar, удерживает ответ в этой форме. Форма не гарантирует верный вывод и не доказывает, что модель использовала поля по порядку.
SGAM решает, что происходит после появления этого объекта. Нужно ли его сохранять? Заменяет ли он более старый факт? Какой tenant может его видеть? Он текущий или исторический? Какой исходный эпизод его подтверждает?
Таблица показывает, за что отвечает каждый слой и как он ломается:
| Параметр | SO | SGR | SGAM |
|---|---|---|---|
| Цель | Вернуть объект, соответствующий схеме | Сделать намеченные поля и намерение решения видимыми | Управлять долговременной памятью после вызова модели |
| Область | Один сгенерированный ответ | Один ответ модели; межшаговая политика может охватывать несколько вызовов | Записи, используемые между вызовами, сессиями и запусками |
| Роль схемы | Определяет поля вывода, типы и допустимые значения | Описывает свидетельства, промежуточные поля и решение-кандидат | Определяет хранимые записи, связи и жизненный цикл |
| Контроль | Constrained decoding блокирует вывод, не соответствующий схеме | Только форма; зависимости и порядок обеспечивают отдельные вызовы, валидаторы и политика | Валидация в приложении, ограничения базы данных и правила конфликтов обеспечивают жизненный цикл |
| Время жизни | Текущий вызов, если приложение не сохраняет объект | Трейс ризонинга обычно отбрасывается после решения | Хранится, пока его не обновят, не истечёт срок или не удалят |
| Тип сбоя | Корректная форма с неверным смыслом | Поля есть, но ризонинг или обработка зависимостей всё равно могут быть неверными | Устаревшее, загрязнённое, не ограниченное по области или неаудируемое состояние |
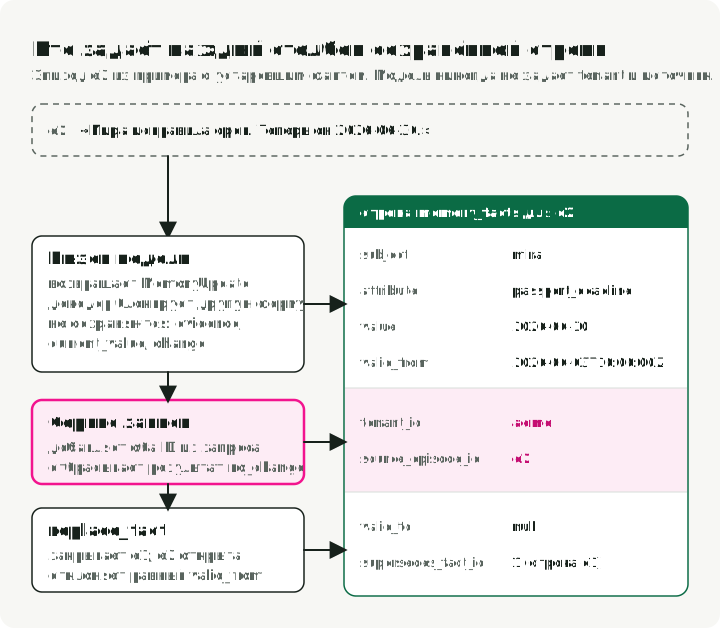
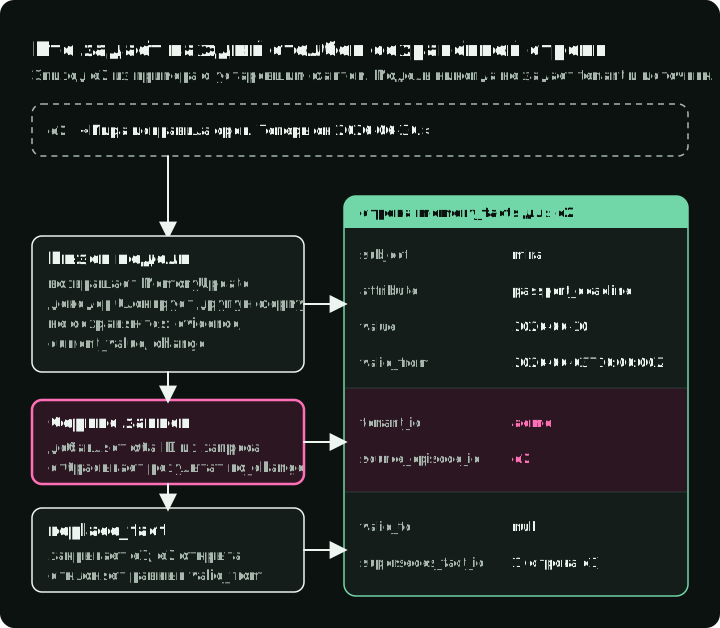
Диаграмма прослеживает исправление из примера ниже до одной сохранённой строки и показывает, кто задаёт каждый столбец: модель, сервис записи на основе запроса или replace_fact.
Следующая схема определяет объект, который передаётся от извлечения в сервис записи SGAM. Нужен Pydantic. Приложение подставляет в промпт текущее сохранённое значение, чтобы модель могла сравнить его с новым свидетельством:
from datetime import datetime
from typing import Literal

from pydantic import BaseModel, Field

class MemoryUpdate(BaseModel):
    evidence: str = Field(description="Exact quote from the episode")
    subject: str = Field(description="Normalized entity ID, e.g. mira")
    attribute: str = Field(description="Property being updated")
    current_value: str | None = Field(description="Stored value shown in the prompt")
    change: Literal["new", "update", "no_change"]
    value: str | None = Field(description="New value; None when change is no_change")
    valid_from: datetime = Field(description="When the new value starts to apply")
Сервис записи отбрасывает результаты no_change, добавляет tenant_id и source_episode_id из запроса и передаёт остальное в replace_fact из примера ниже. Модель никогда не выбирает tenant или исходный эпизод.
У путей записи и чтения разные задачи
Только путь записи меняет сохранённое состояние. Путь чтения выбирает записи для текущего запроса.
Поток приёма данных — это путь записи:
- Зафиксируйте сырой эпизод из сообщений, результатов инструментов или бизнес-событий. Запишите его tenant и класс хранения.
- Извлеките типизированных кандидатов через structured output.
- Проверьте payload через Pydantic или слой схем, который уже есть в вашем стеке, и отклоняйте некорректные записи.
- Разрешите конфликты до вставки: решите, заменяет ли новая запись старую, и закройте устаревший факт.
- Сохраните указатель на сырой эпизод, результат инструмента, файл, тикет или подтверждение пользователя, из которого появилась запись.
- Зафиксируйте запись в хранилище SGAM вместе с её
schema_version, а не оставляйте версию только в коде приложения.
Поток запроса — это путь чтения:
- Начните с вопроса пользователя.
- Решите, нужно ли для вопроса текущее состояние или состояние на заданный момент.
- Отфильтруйте по tenant, типу памяти, субъекту, атрибуту и окну валидности.
- Добавляйте векторное или графовое расширение, только если точного поиска состояния недостаточно. Используйте его для подтверждающих свидетельств, связанных сущностей и примеров, а не как авторитетный источник текущих фактов.
- Соберите для модели минимальный контекст со ссылками на источники.
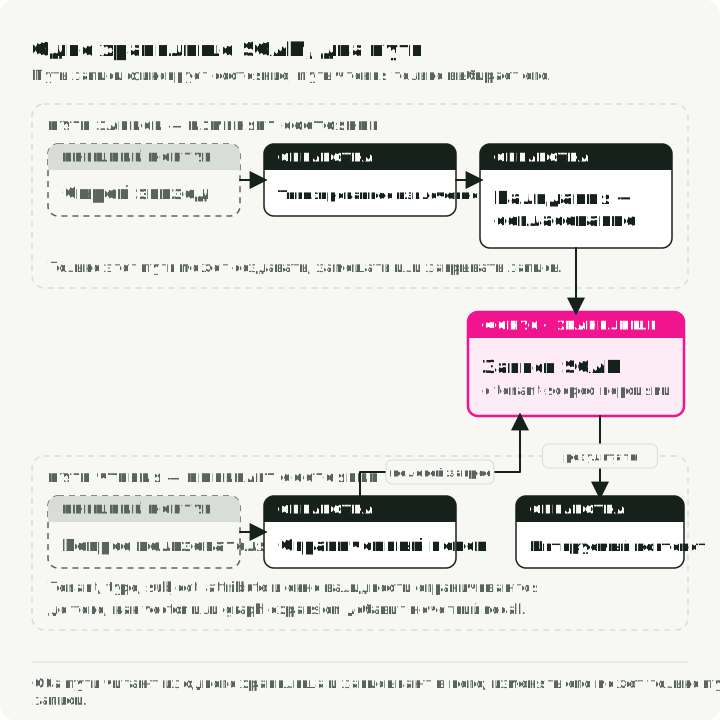
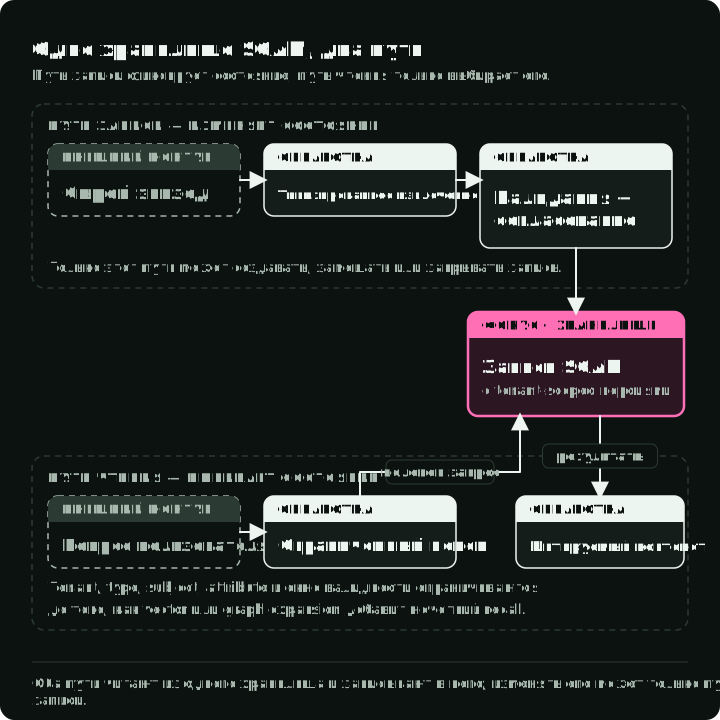
Читайте диаграмму сверху вниз. Путь записи закрывает e1 и вставляет e2 в одно хранилище. Путь чтения выбирает фильтр текущего состояния или состояния на момент времени, затем выбирает строки из того же хранилища.
Что входит в схему памяти
Минимальной записи SGAM нужно больше, чем text. Каждое поле отвечает на один из вопросов из первого раздела или выполняет одну задачу жизненного цикла:
| Поле | На какой вопрос отвечает или какую задачу решает |
|---|---|
tenant_id | К какому tenant относится запись? По нему фильтруется каждое чтение и каждая запись. |
memory_id | Стабильный ID, на который ссылаются другие записи и задачи удаления. |
subject, attribute | Ключ: какая сущность и какое свойство, например mira и passport_deadline. |
value | Хранимое значение. |
memory_type | Вид памяти: семантическая (стабильные факты и профили), эпизодическая (прошлые события и трейсы) или процедурная (инструкции и правила промптов), как их описывает LangGraph. |
schema_version | Какая схема записала запись, чтобы миграция могла найти и преобразовать старые записи. |
valid_from, valid_to | Что верно сейчас? valid_from <= now и (valid_to равно null или now < valid_to). Что было верно 2 июня? Интервал содержит этот момент. |
supersedes_memory_id | Какой более старый факт заменил этот? |
source_episode_id | Кто это сказал? Указывает на сырой эпизод. |
confidence | Оценка, которую сервис записи сравнивает с порогом: либо перевести кандидата в текущее состояние, либо попросить пользователя подтвердить его. |
retention_policy | Можно ли это удалить или задать срок действия? Подсказывает задачам удаления, что ещё нужно убрать. |
С этими полями новый срок по паспорту может закрыть предыдущий, не стирая историю. Та же таблица отвечает на запросы о текущем состоянии и о состоянии на момент времени, а затем прослеживает результат до исходного эпизода.
Используйте RAG для извлечения документов, а SGAM для поддержки изменяемого состояния. Vector search по-прежнему нужен в системе для нечёткого recall, кластеризации и расширения. Текущее значение mira.passport_deadline должно приходить из записи памяти в нужной области видимости, а не из того чанка, который случайно оказался первым в выдаче.
Пример с устаревшим фактом
Возьмём синтетический трейс из двух эпизодов, представленный как базовый DM и реестр SGAM:
e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.
e2: Mira corrected the deadline. It is now 2026-06-30.
Базовый DM хранит оба эпизода как свободный текст, поэтому текстовый поиск может вернуть e1, потому что там есть нужные слова. SGAM извлекает типизированный факт из каждого эпизода с ключом из tenant, субъекта и атрибута. Он должен вернуть e2 как текущее состояние и сохранить e1 для исторического запроса.
Скрипт ниже отвечает на два из прежних вопросов: что верно сейчас и что было верно 2 июня. Обратите внимание на replace_fact: он закрывает старую строку, а не удаляет её, и записывает, какую строку заменяет новая. Вызывающий код должен нормализовать каждый сохранённый или используемый в запросе момент времени к одному строковому формату UTC с фиксированной точностью до секунд: YYYY-MM-DDTHH:MM:SSZ. SQLite сравнивает эти значения TEXT лексикографически, поэтому разные смещения часовых поясов или точность могут нарушить порядок фактов. Каждая строка действует от valid_from до valid_to, не включая его. Таблица отклоняет некорректные интервалы и содержит частичный уникальный индекс: один открытый факт на tenant, субъект и атрибут. replace_fact управляет одной транзакцией и начинает её с BEGIN IMMEDIATE до чтения строк. Вызывайте функцию на соединении без активной транзакции. SQLite сериализует конкурирующие записи, поэтому после ошибки блокировки или уникальности вызывающий код должен повторить всю транзакцию. В конце совпадение по ключевому слову заменяет vector search. Любое ранжирование, которое не знает об исправлении, может вернуть e1.
import sqlite3
from dataclasses import dataclass

@dataclass(frozen=True)
class MemoryFact:
    tenant_id: str
    subject: str
    attribute: str
    value: str
    valid_from: str
    source_episode_id: str

def open_db() -> sqlite3.Connection:
    db = sqlite3.connect(":memory:")
    db.row_factory = sqlite3.Row
    db.executescript(
        """
        create table memory_facts (
            fact_id integer primary key,
            tenant_id text not null,
            subject text not null,
            attribute text not null,
            value text not null,
            valid_from text not null,
            valid_to text,
            supersedes_fact_id integer references memory_facts (fact_id),
            source_episode_id text not null,
            check (valid_to is null or valid_from < valid_to)
        );
        create unique index one_open_fact
        on memory_facts (tenant_id, subject, attribute)
        where valid_to is null;
        """
    )
    return db

def replace_fact(db: sqlite3.Connection, fact: MemoryFact) -> None:
    with db:
        db.execute("BEGIN IMMEDIATE")
        exact = db.execute(
            """
            select fact_id
            from memory_facts
            where tenant_id = ? and subject = ? and attribute = ? and valid_from = ?
            """,
            (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
        ).fetchone()
        if exact:
            raise ValueError("equal valid_from requires an application conflict policy")

        containing = db.execute(
            """
            select fact_id, valid_to
            from memory_facts
            where tenant_id = ?
              and subject = ?
              and attribute = ?
              and valid_from < ?
              and (valid_to is null or valid_to > ?)
            limit 1
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.valid_from,
                fact.valid_from,
            ),
        ).fetchone()
        if containing:
            db.execute(
                "update memory_facts set valid_to = ? where fact_id = ?",
                (fact.valid_from, containing["fact_id"]),
            )
            successor_boundary = containing["valid_to"]
        else:
            successor = db.execute(
                """
                select valid_from
                from memory_facts
                where tenant_id = ? and subject = ? and attribute = ? and valid_from > ?
                order by valid_from
                limit 1
                """,
                (fact.tenant_id, fact.subject, fact.attribute, fact.valid_from),
            ).fetchone()
            successor_boundary = successor["valid_from"] if successor else None

        db.execute(
            """
            insert into memory_facts
                (tenant_id, subject, attribute, value, valid_from, valid_to,
                 supersedes_fact_id, source_episode_id)
            values (?, ?, ?, ?, ?, ?, ?, ?)
            """,
            (
                fact.tenant_id,
                fact.subject,
                fact.attribute,
                fact.value,
                fact.valid_from,
                successor_boundary,
                containing["fact_id"] if containing else None,
                fact.source_episode_id,
            ),
        )

def fact_at(
    db: sqlite3.Connection, tenant_id: str, subject: str, attribute: str, timestamp: str
) -> sqlite3.Row | None:
    return db.execute(
        """
        select fact_id, value, valid_from, supersedes_fact_id, source_episode_id
        from memory_facts
        where tenant_id = ?
          and subject = ?
          and attribute = ?
          and valid_from <= ?
          and (valid_to is null or valid_to > ?)
        limit 1
        """,
        (tenant_id, subject, attribute, timestamp, timestamp),
    ).fetchone()

KEY = ("acme", "mira", "passport_deadline")

db = open_db()
replace_fact(db, MemoryFact(*KEY, "2026-07-15", "2026-06-01T09:00:00Z", "e1"))
replace_fact(db, MemoryFact(*KEY, "2026-06-30", "2026-06-03T10:00:00Z", "e2"))
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")

historical = fact_at(db, *KEY, "2026-06-02T00:00:00Z")
assert (historical["value"], historical["source_episode_id"]) == ("2026-07-15", "e1")
assert current["supersedes_fact_id"] == historical["fact_id"]

# A delayed extraction predates e1. It ends at e1's existing boundary,
# rather than closing e2, which remains current.
replace_fact(db, MemoryFact(*KEY, "2026-08-01", "2026-05-30T08:00:00Z", "e0"))
delayed = fact_at(db, *KEY, "2026-05-31T00:00:00Z")
assert (delayed["value"], delayed["source_episode_id"]) == ("2026-08-01", "e0")
current = fact_at(db, *KEY, "2026-06-04T00:00:00Z")
assert (current["value"], current["source_episode_id"]) == ("2026-06-30", "e2")
intervals = db.execute("select valid_from, valid_to from memory_facts").fetchall()
assert all(row["valid_to"] is None or row["valid_from"] < row["valid_to"] for row in intervals)

episodes = (
    "e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.",
    "e2: Mira corrected the deadline. It is now 2026-06-30.",
)
naive_match = next(episode for episode in episodes if "passport deadline" in episode)
assert naive_match.startswith("e1:")

print("Naive text memory:")
print(f"  returned episode: {naive_match}")
print()
print("SGAM current state:")
print(f"  mira.passport_deadline = {current['value']}")
print(f"  valid_from={current['valid_from']}, source={current['source_episode_id']}")
print()
print("SGAM point-in-time state:")
print(f"  on 2026-06-02, mira.passport_deadline = {historical['value']}")
Запуск скрипта выводит:
Naive text memory:
  returned episode: e1: Mira prefers concise answers. Her passport deadline is 2026-07-15.

SGAM current state:
  mira.passport_deadline = 2026-06-30
  valid_from=2026-06-03T10:00:00Z, source=e2

SGAM point-in-time state:
  on 2026-06-02, mira.passport_deadline = 2026-07-15
replace_fact сначала отклоняет равное значение valid_from: такой конфликт требует политики приложения, например приоритета источников или подтверждённой пользователем ревизии, а не молчаливой перезаписи. Иначе функция находит интервал, содержащий входящую метку времени. Если он найден, она закрывает этого предшественника на входящей границе, даёт вставляемой строке прежний конец предшественника и записывает предшественника в supersedes_fact_id. Если метка раньше всех сохранённых интервалов, концом новой строки становится valid_from следующего интервала. Так запоздавший факт до e1 получает интервал [2026-05-30, 2026-06-01) и оставляет e1 и текущий e2 нетронутыми. Частичный уникальный индекс — это защита на уровне базы данных от второй открытой строки. У DM нет подобного шага обновления, поэтому старый текст всё ещё может обойти исправление в ранжировании.
Временная шкала показывает строки после каждого вызова replace_fact в скрипте, а затем три чтения. Обратите внимание на шаг 2, где e2 закрывает e1, и на шаг 3, где запоздавший e0 заканчивается там, где начинается e1.
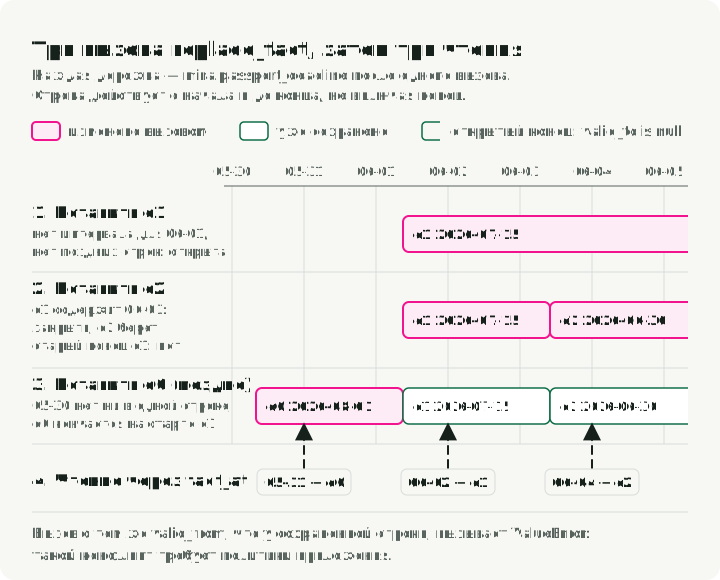
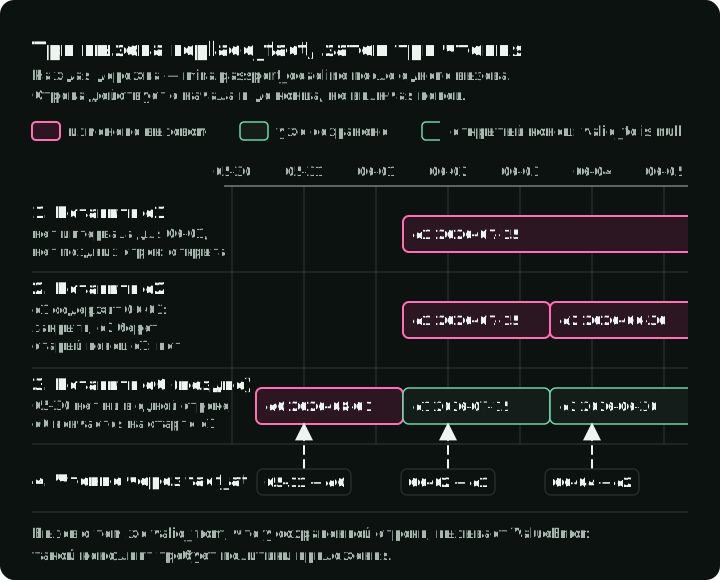
В рабочей системе сочетайте эту транзакцию со структурированным извлечением на пути записи. Транзакция в базе данных обновляет временную валидность. Модель извлекает факт-кандидат, но не решает, какая сохранённая строка остаётся текущей.
Выбор хранилища определяется паттерном retrieval
Проекты используют несколько названий для частей этого паттерна: хранилища памяти, графы контекста, профили, долгосрочные хранилища, graph RAG и агенты с состоянием.
| Инструмент или фреймворк | Основной слой хранения | Механизм временного состояния | Механизм схемы | Когда использовать |
|---|---|---|---|---|
| Graphiti | Neo4j, FalkorDB и Amazon Neptune; Kuzu объявлен устаревшим | Интервалы валидности фактов плюс происхождение по исходным эпизодам | Типы сущностей и рёбер на Pydantic, временные рёбра, происхождение | Нужны интервалы валидности и обход графа, и вы будете сами эксплуатировать графовую базу данных |
| Zep | Проприетарный Context Graph Engine | Управляемые временные Context Graphs, сохраняющие меняющиеся факты | Стандартные и пользовательские типы сущностей и рёбер | Нужна та же модель временного графа как управляемый сервис |
| LangGraph / LangMem | Хранилища LangGraph, хранилища на базе Postgres | Метки времени и поля в записях хранилища ведёт приложение | JSON-хранилища плюс извлечение профиля или коллекции через Pydantic | Вы уже используете LangGraph и готовы сами вести метки времени и правила конфликтов |
| Mem0 | Управляемый стек, Valkey / Redis / векторные бэкенды в OSS-конфигурациях | Обновления памяти; временная политика остаётся на стороне приложения | Типы памяти, пользовательские категории, промпты извлечения | Нужны управляемые add, search, update и delete в области пользователя, агента, приложения или запуска, а временную политику вы будете вести сами |
| Letta / MemGPT | Состояние агента и блоки памяти в базе данных | Редактируемые блоки без интервалов валидности на уровне полей | Редактируемые именованные блоки памяти | Агент сам редактирует свои блоки памяти или нескольким агентам нужен один общий блок, который видят все |
| Cognee | Граф плюс векторные и реляционные бэкенды | История зависит от онтологии и выбранного бэкенда | Извлечение и валидация на основе онтологии | Вы проверяете извлечение по доменной онтологии |
| LlamaIndex property graph | Хранилища property graph плюс векторные хранилища | Поля времени зависят от схемы графа и хранилища | SchemaLLMPathExtractor с допустимыми сущностями и связями | Вы извлекаете property graph из документов или трейсов |
LangGraph разделяет чекпоинты потоков, которые возобновляют один разговор, и межпотоковые хранилища, где лежат данные, читаемые следующими потоками. Статья про Zep сообщает о приросте на Deep Memory Retrieval и LongMemEval, а статья про Mem0 — на LoCoMo. Каждый вендор написал свою статью, поэтому читайте эти цифры как результаты вендоров, а не как гарантии для вашей нагрузки.
Начните с модели данных. Если основная операция — точный поиск факта, обычно хватает реляционной таблицы с JSON-payload, колонками валидности, индексами по tenant и вспомогательным векторным индексом. Добавляйте граф, когда запросы продукта идут по связям.
Сначала создайте путь записи, а потом граф
Сначала решите, что продукту разрешено помнить. Выбор между графом и векторным хранилищем идёт потом.
Агент поддержки может помнить тариф аккаунта, открытые кейсы и постоянные предпочтения по контактам. Он не должен превращать каждую раздражённую реплику в состояние профиля. Агент для кода может помнить соглашения репозитория и нерешённые задачи. Он не должен хранить личную заметку вечно только потому, что она один раз попала в выдачу.
Первое хранилище SGAM может быть реляционной таблицей с JSON-колонкой и несколькими индексами, в которую пишет описанный выше путь записи из шести шагов. Граф становится полезным, когда продукту нужно обходить связи вроде клиент-аккаунт, аккаунт-политика, задача-артефакт или проект-решение.
Немедленные записи и фоновые записи
Немедленное извлечение оправдано, когда следующий ход зависит от новой памяти. Если пользователь говорит «запомни, что я предпочитаю короткие ответы», системе не нужно ждать ночной задачи, чтобы вести себя иначе.
Большинству ходов немедленная запись не нужна. Сохраните сырой эпизод с метаданными tenant, сессии и инструментов, а фоновый воркер позже извлечёт кандидатов. При консолидации по повторению воркер накапливает слабые сигналы и повышает факт до записи, только когда похожие свидетельства повторяются или пользователь подтверждает его. Это добавляет задержку актуальности. Для «пользователь часто просит экспорт в CSV» она приемлема, а для «клиент сменил адрес доставки» рискованна.
Относитесь к миграции схемы как к изменению продукта, потому что она меняет то, что агент может вспомнить, процитировать или удалить. Она также может изменить, какие исторические факты считаются текущими. Планируйте скрипты миграции, бэкфилы, окна двойного чтения и поведение при удалении в одном релизе.
Когда SGAM оправдывает сложность
Используйте SGAM, когда факты могут меняться со временем:
- предпочтения пользователя, которые можно обновить или отозвать
- факты о клиентах или аккаунтах с требованиями аудита
- состояние задач для долгоживущих ассистентов
- память о проекте у агента для кода
- общее состояние multi-agent-системы
- заметки о compliance, где важно происхождение
- временные вопросы вроде «что мы считали верным до миграции?»
SGAM избыточен, когда память живёт недолго, носит исследовательский характер или её дёшево пересчитать. Если агенту нужна непрерывность всего на несколько ходов, достаточно чекпоинта и урезанной истории сообщений. Для QA по статичным документам может хватить одного RAG. А если предметная область настолько нестабильна, что схема меняется каждый день, типизированная память замедлит команду.
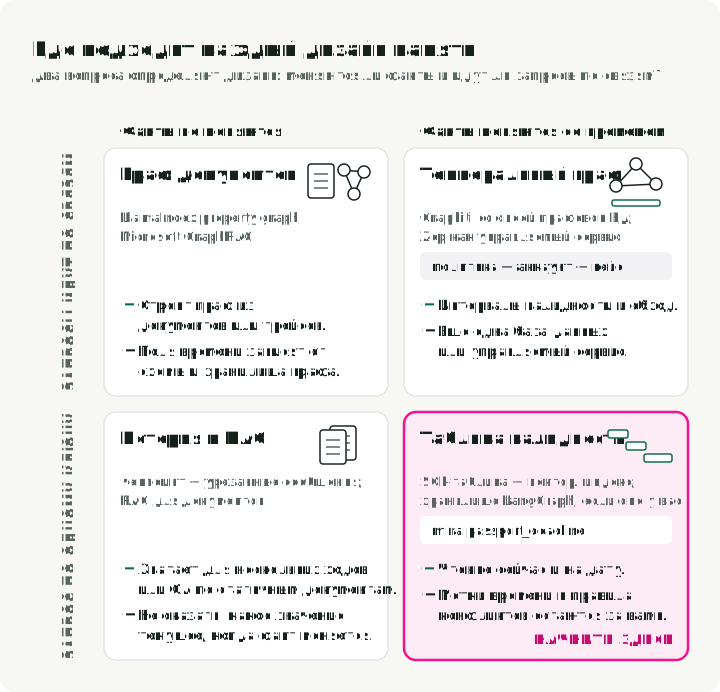
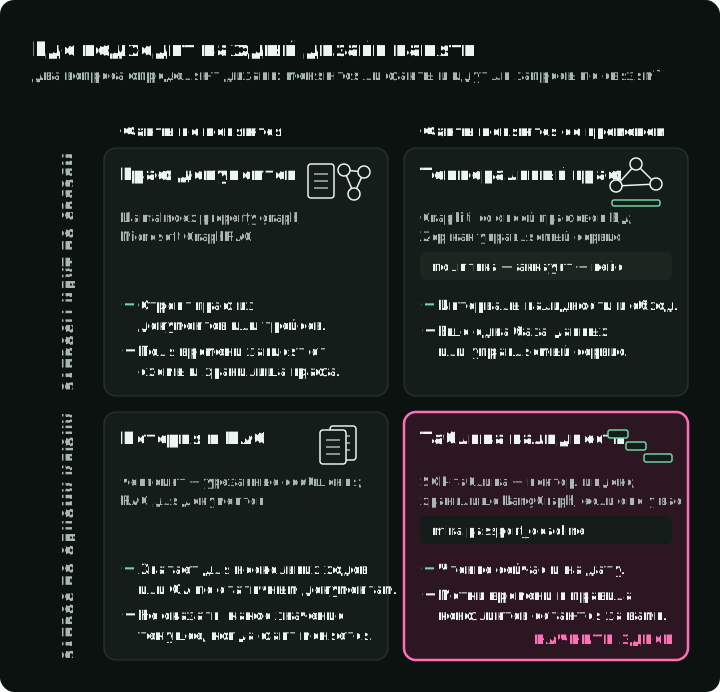
Сетка размещает каждый дизайн по двум вопросам: меняются ли ваши факты и идут ли ваши запросы по связям между записями?
Чеклист оценки
Оценивайте жизненный цикл памяти, а не только итоговый ответ. Система может дать правдоподобный ответ после того, как записала неверный факт, извлекла устаревший или пересекла границу tenant.
Я использую то же деление по стадиям, что и в статье об оценке RAG. Измеряйте ту стадию, на которой может произойти сбой, а не ограничивайтесь оценкой сгенерированного текста. Дисциплина работы с трейсами из статьи об оценке агентов тоже применима, потому что ошибка памяти часто видна в истории запуска раньше, чем в ответе.
Я бы тестировал SGAM через replay. Подайте в сервис записи памяти фиксированную последовательность эпизодов и проверяйте реестр после каждого значимого хода. Затем задайте вопросы о текущем состоянии и о состоянии на момент времени к полученному хранилищу.
| Слой | Какой сбой вы ищете | Метрики |
|---|---|---|
| Извлечение записи | Агент пропустил факт, выдумал его или выдал неверную форму | Доля валидных по схеме записей, precision/recall извлечения, покрытие исходными эпизодами |
| Обработка конфликтов | Устаревший факт остался текущим или верный старый факт был перезаписан | Корректность замены, доля дубликатов, корректность инвалидации устаревших фактов |
| Изоляция и политика | Память утекла между пользователями или пережила срок, заданный политикой | Нарушения изоляции tenant, корректность удаления, соблюдение сроков хранения |
| Извлечение при чтении | Нужная запись есть, но сервис чтения её не получил | Точность текущего состояния, точность на момент времени, recall@k по записям памяти |
| Граундинг ответа | Ответ использовал память без подтверждения или сослался не на тот источник | Подтверждение утверждений исходными эпизодами, точность цитирования, корректность разрешения конфликтов |
| Эксплуатация | Путь памяти слишком медленный, слишком устаревший или слишком дорогой | Латентность записи p95, задержка актуальности, латентность чтения, стоимость запроса |
Бенчмарки вроде LoCoMo, LongMemEval и ATM-Bench дают публичные тестовые случаи. Они не заменяют набор тестов для вашей предметной области. Ассистенту для кода, боту поддержки и compliance-копилоту нужны разные схемы, фильтры, правила хранения и тесты на сбои.
От трейсов к лучшей памяти запускает цикл улучшения на инструменте памяти, который хранит факты с владельцем, исходным событием и интервалом валидности, следуя этим правилам.
Ограничения
SGAM — это моё название паттерна, а не стандарт. Инструменты из таблицы выше используют другие названия для его частей: хранилища памяти, временные графы контекста, блоки памяти и графы знаний. Microsoft GraphRAG описывает близкую часть проблемы как графовый retrieval по документам.
Профиль пользователя, журнал эпизодов, граф документов и редактируемый агентом блок памяти решают разные задачи извлечения и обновления. Я использую SGAM для долговременной памяти, которая представляет текущее состояние приложения и потому требует схемы, валидности, происхождения, обработки конфликтов, хранения и миграции.
Типизированная память тоже может быть неверной. Схема упрощает проверку плохих записей, но не делает их достоверными. Всё равно нужны доверие к источникам, подтверждение пользователем для чувствительных фактов, политика конфликтов, удаление и мониторинг.
Источники
- According to Me: Long-Term Personalized Referential Memory QA - статья Mei et al., вводящая ATM-Bench и Schema-Guided Memory.
- Towards Scalable Multi-Domain Conversational Agents: The Schema-Guided Dialogue Dataset - статья Rastogi et al. о датасете SGD.
- Evaluating Very Long-Term Conversational Memory of LLM Agents - статья Maharana et al., вводящая LoCoMo.
- LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory - бенчмарк Wu et al. для способностей долгосрочной памяти.
- Graphiti: Build Temporal Context Graphs for AI Agents
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory
- Mem0 Platform Overview
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory
- LangGraph Memory Overview
- LangGraph Persistence
- LangMem documentation
- Letta: Introduction to Stateful Agents
- Letta: Shared memory
- Microsoft GraphRAG documentation
- LlamaIndex: Using a Property Graph Index
- Cognee Documentation
- Pydantic model validation docs
- Python sqlite3 documentation