Arquitetura de memória para agentes de AI: checkpoints e bases vetoriais

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Um agente pode parecer que «esquece» por vários motivos. Pode perder uma execução inacabada depois de um reinício, não recuperar uma preferência de uma conversa anterior ou seguir uma nota de projeto desatualizada. Cada falha exige um tipo de estado diferente e um teste diferente. Este artigo destina-se a engenheiros que desenham esse estado: vai ver quando usar um checkpoint, uma consulta exata, recuperação semântica ou um documento inspecionável, e que ferramentas servem cada tarefa, desde os checkpoint savers de PostgreSQL e Redis até pgvector, Qdrant, ficheiros Markdown e frameworks de memória geridos.
A parte 1 construiu o reasoning loop. Aqui vamos usar o Market Analyst Agent para ver o que o ciclo tem de preservar quando faz uma pausa antes de publicar um relatório e quando um utilizador regressa com preferências conhecidas.
Quatro falhas que parecem esquecimento
«Acrescentar memória» é demasiado vago para escolher uma implementação. Um requisito útil diz o que tem de sobreviver, quem o pode ler e o que acontece quando está errado.
| Requisito | Estado a preservar | Primeiro desenho útil | Falha a testar |
|---|---|---|---|
| Continuar uma análise após uma aprovação ou o reinício de um worker | Mensagens, plano, rascunho, passo pendente do grafo | Checkpoint durável para essa thread | Reiniciar antes da publicação; retomar no passo previsto |
| Aplicar a preferência de risco de um utilizador que regressa | Um facto atual e com nome, ligado a esse utilizador | Perfil estruturado com uma chave exata | Alterar a preferência; nunca usar o valor antigo |
| Recuperar uma observação não estruturada de trabalho anterior | Fonte, texto, proprietário, data, validade | Registos pesquisáveis; embeddings apenas se forem necessários | Reformular uma consulta e verificar a fonte recuperada |
| Reutilizar uma convenção do projeto | Nota revisível e o seu proprietário | Ficheiro ou armazenamento de documentos | Corrigir uma nota errada e confirmar que a execução seguinte vê a correção |
A primeira pergunta é se o agente precisa sequer de estado armazenado. Um classificador de uma só passagem, cuja entrada completa chega num único pedido, pode validar a resposta e terminar. Não precisa de uma base de dados vetorial só porque um sistema maior poderá um dia fazer uma pergunta de seguimento.
Assim que existir um requisito, esta tabela indica uma ferramenta inicial para cada tarefa. As secções seguintes explicam quando passar à alternativa.
| Tarefa | Começar com | Passar para |
|---|---|---|
| Retomar uma execução ou thread | Saver PostgreSQL do LangGraph | Saver Redis quando a latência dos checkpoints for um estrangulamento medido; saver SQLite para uso local |
| Ler um facto do utilizador com nome | Linha PostgreSQL ou coluna JSONB, hash Redis ou uma chave de Store do LangGraph | Nada mais, enquanto o facto tiver um nome estável |
| Recuperar uma nota pelo significado | Store do LangGraph com um índice, ou pgvector junto aos dados da aplicação | Qdrant ou outra base de dados vetorial quando a filtragem, a escala ou a operação o exigirem |
| Encontrar uma nota por termos exatos | Pesquisa de texto integral do PostgreSQL com um índice GIN | Recuperação híbrida por palavras-chave e vetores quando as paráfrases contornam as palavras-chave |
| Responder a perguntas sobre ligações | Registos relacionais ligados | Um grafo de conhecimento temporal como o Graphiti |
| Manter o conhecimento do projeto revisível | Ficheiros Markdown no repositório | Documentos em PostgreSQL com pesquisa de texto integral e vetorial para muitos tenants |
| Entregar a extração e a manutenção a uma ferramenta | As suas próprias regras de escrita e atualização | Mem0, Letta ou LangMem quando não precisar de controlar esse pipeline |
O armazenamento e o contexto do modelo também são coisas diferentes. Uma base de dados pode guardar um milhão de registos; o modelo só vê o subconjunto que a aplicação seleciona e coloca no pedido seguinte. Guardar um facto não garante que seja recuperado. Recuperá-lo não garante que o agente o use corretamente. É por isso que um desenho de memória precisa, além de uma regra de escrita, de uma regra de leitura e de um teste do resultado.
O artigo CoALA dá nomes úteis aos tipos de informação envolvidos: estado de trabalho para o passo atual; memória episódica de eventos; memória semântica de factos; e memória procedimental sobre como agir. O modelo de persistência do LangGraph faz uma distinção diferente, ao nível da implementação: um checkpointer guarda o estado de uma thread, enquanto um store guarda dados da aplicação entre threads. Um documento pode conter um evento, um facto ou um procedimento. Estas categorias dizem o que a informação significa; não prescrevem uma base de dados por categoria.
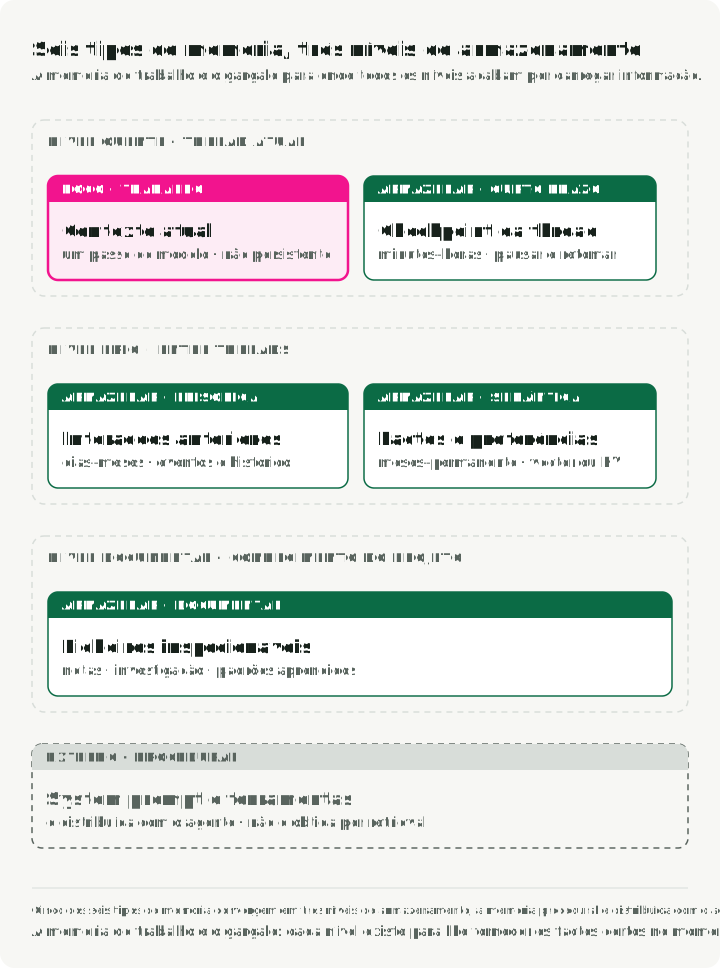
A figura coloca esses tipos nos três armazenamentos usados neste artigo: um checkpoint para a thread atual, registos entre threads e documentos para o conhecimento do projeto. Leia uma coluna de cima para baixo para ver que um armazenamento pode conter vários tipos de informação. Os procedimentos podem ser distribuídos com o agente como instruções e ferramentas, ou armazenados e recuperados como qualquer outro documento.
O estado de trabalho pode viver em variáveis do processo e no pedido atual ao modelo. As mensagens e os tool results selecionados têm de caber na janela de contexto do modelo; o estado da aplicação pode ser maior. Se o processo terminar, só a parte deliberadamente persistida pode ser recuperada. «Curto prazo» e «longo prazo» descrevem o âmbito da reutilização, não períodos de retenção fixos. A política de retenção da aplicação decide quando cada um é apagado.
Um checkpoint permite que a execução continue
Considere uma análise que reuniu evidências e redigiu um relatório, e depois faz uma pausa à espera de aprovação. Se o worker terminar, outro worker precisa de conhecer o rascunho, o estado da aprovação e o nó do grafo que vem a seguir. Uma transcrição da conversa, por si só, não diz se o relatório já foi publicado.
O LangGraph guarda o estado do grafo nas fronteiras de super-step. Um super-step é uma ronda de nós agendados; vários podem correr em paralelo. O estado guardado da thread inclui valores e informação de agendamento, pelo que uma execução pode continuar a partir de uma fronteira concluída. Não pode retomar a partir de uma linha arbitrária dentro de um nó. A documentação dos checkpointers também descreve as escritas pendentes de nós que terminaram dentro de um super-step falhado. Um checkpoint é um registo de recuperação, não um rasto completo de tudo o que o agente fez.
O projeto de acompanhamento torna essa fronteira visível. A sua fábrica de grafos compila com um checkpointer e interrompe antes do nó de publicação. O caminho de aprovação lê o estado guardado, verifica que a publicação é o passo pendente, regista a aprovação e retoma. A configuração de checkpoints usa PostgreSQL por omissão e pode selecionar Redis. Invoque com durability="sync" quando uma falha não puder perder o último passo concluído.
O modo de durabilidade decide o que uma falha pode perder. Nos modos documentados do LangGraph, as escritas assíncronas deixam o passo seguinte correr antes de um checkpoint terminar; uma falha pode, por isso, perder o último passo. O modo síncrono espera por cada escrita de checkpoint antes de avançar. O modo exit guarda quando o grafo termina, pelo que não consegue recuperar de uma falha a meio de uma execução longa. Escolha o modo a partir do requisito de recuperação e depois teste um reinício forçado na fronteira que importa. A figura executa o mesmo grafo em cada modo e interrompe-o durante o terceiro super-step.
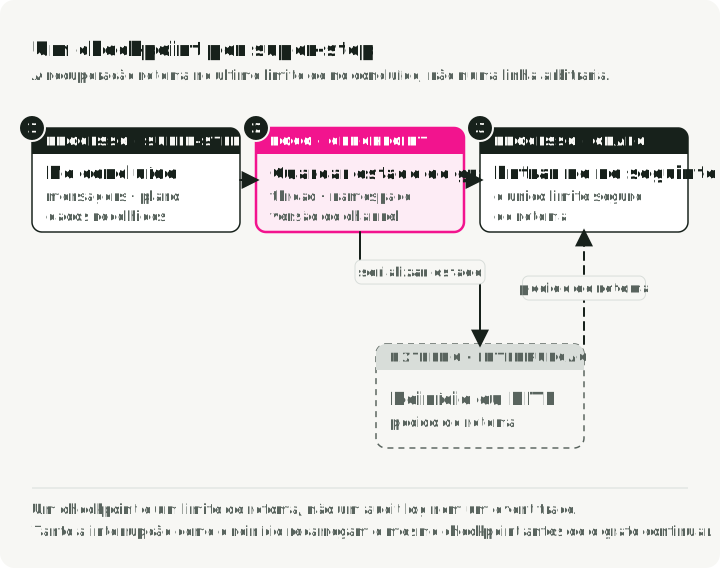
O que um saver guarda
Todos os backends de checkpoint do LangGraph implementam BaseCheckpointSaver: put() escreve um checkpoint, get_tuple() lê o mais recente de uma thread e list() devolve o seu histórico. Cada checkpoint é identificado por (thread_id, checkpoint_ns, checkpoint_id). O thread_id identifica a conversa, checkpoint_ns separa subgrafos e checkpoint_id identifica uma versão. Um thread_id localiza o estado guardado; não estabelece quem é o chamador nem autoriza o acesso a essa thread.
O saver PostgreSQL de langgraph-checkpoint-postgres cria as suas tabelas em setup(). Dois workers que escrevem na mesma thread ficam separados pela chave do checkpoint e por upserts, não por bloqueios: não corrompem as linhas um do outro, mas também não se coordenam. Dê a cada execução um único escritor ativo, como descreve a parte 5.
Uma configuração mínima de PostgreSQL, assumindo que create_graph constrói e compila o seu grafo:
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver

async def run(connection_string: str, authenticated_user_id: str) -> None:
    # from_conn_string owns the connection, so the graph runs inside this block.
    async with AsyncPostgresSaver.from_conn_string(connection_string) as checkpointer:
        await checkpointer.setup()  # creates the tables; safe on every start
        graph = create_graph(checkpointer=checkpointer)
        config = {"configurable": {"thread_id": "analysis-42"}}
        await graph.ainvoke({"user_id": authenticated_user_id, "messages": [...]}, config)
        # Later, after the server authenticates the approver:
        await graph.aupdate_state(config, {"report_approved": True})
        await graph.ainvoke(None, config)  # continue from the saved interrupt
O user_id vem do contexto de pedido autenticado do servidor, nunca do modelo nem do JSON do cliente. Se alguém além da aplicação puder escrever linhas de checkpoint, defina LANGGRAPH_STRICT_MSGPACK=true para que a desserialização aceite apenas tipos seguros ou declarados, como descreve o aviso de segurança do LangGraph.
Um checkpoint não torna segura uma escrita externa
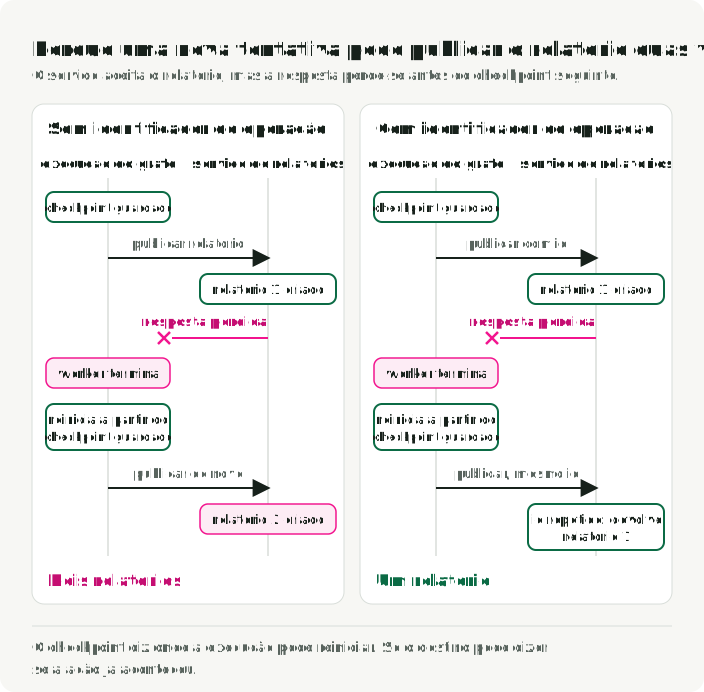
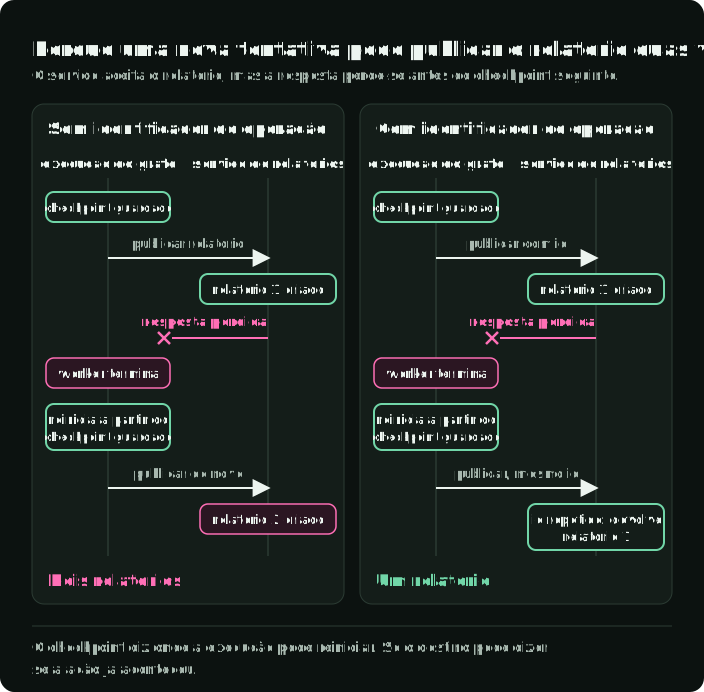
Suponha que o nó de publicação envia um relatório para um serviço externo. O serviço aceita-o, mas a resposta perde-se antes de o grafo guardar o checkpoint seguinte. Reiniciar a partir do checkpoint anterior pode executar o nó outra vez. Nenhuma definição da base de dados de checkpoints consegue saber se essa escrita externa teve êxito.
Para uma escrita repetível, atribua à operação um identificador que pertença à aplicação e faça com que o destino reconheça uma nova tentativa com esse identificador. Se não o conseguir fazer, a recuperação tem de verificar o destino ou pedir uma decisão humana antes de repetir a ação. O mesmo se aplica a pagamentos, mensagens e escritas de ficheiros. Um checkpoint responde a «onde pode a execução reiniciar?»; a operação externa precisa da sua própria resposta a «esta ação já aconteceu?». As orientações da AWS sobre API idempotentes explicam o contrato do lado do serviço. A figura segue uma resposta perdida com e sem esse identificador.
Mantenha os registos de negócio separados do estado do grafo. Um arquivo de relatórios regista o que foi publicado; um checkpoint regista como o grafo chegou a esse passo ou esperou por ele. Um registo de eventos ou um trace pode registar cada ação tentada. Nenhum dos três substitui os outros dois. A parte 5 volta à recuperação e às evidências do runtime.
Escolher o backend a partir dos requisitos de recuperação
O projeto de acompanhamento suporta checkpoint savers de PostgreSQL e Redis. Têm o mesmo papel perante o grafo, mas o seu comportamento operacional depende da base de dados e do saver configurados.
| Pergunta | PostgreSQL | Redis |
|---|---|---|
| O que tem de ser operado? | Uma base de dados relacional, o seu armazenamento, cópias de segurança e tabelas de checkpoints | Memória do Redis, despejo, persistência e definições de cópia de segurança |
| Que histórico é necessário? | Histórico completo de checkpoints com o saver padrão | Verifique o saver escolhido e a política de retenção; um saver superficial guarda apenas o último checkpoint |
| O que deve decidir? | A operação existente da base de dados, as necessidades de recuperação e o custo de escrita medido | A latência de checkpoint medida, a perda tolerada e as definições reais de persistência |
Se o PostgreSQL já suporta a aplicação e o histórico durável importa, eu começaria por aí. Serve execuções longas em que perder o estado significa horas de recálculo, domínios em que a durabilidade é obrigatória e equipas que querem depurar recuando no histórico de checkpoints. Com o pgvector, a mesma base de dados pode também guardar a memória de longo prazo e a pesquisa vetorial, o que deixa um único sistema para operar.
Escolha o Redis quando o acesso aos checkpoints for um estrangulamento medido, como em chat em streaming ou voz, ou quando o Redis já for o armazenamento de estado adequado do sistema. Afirmar que o Redis é «mais rápido» não é uma medição deste grafo: o tamanho do estado serializado, a frequência de escrita, o caminho de rede e a política de persistência influenciam o resultado. O pacote langgraph-checkpoint-redis também oferece um ShallowRedisSaver que guarda apenas o último checkpoint por thread: suficiente para pausar e retomar, sem histórico para depuração.
Escolha a política de persistência do Redis a partir da perda que consegue tolerar; com a configuração append-only habitual, uma falha pode perder cerca de um segundo de escritas. Teste a recuperação após falha com as definições reais.
Dois outros savers cobrem configurações comuns. O langgraph-checkpoint-sqlite serve o desenvolvimento local e implementações com um único processo. Na AWS, o langgraph-checkpoint-aws fornece um DynamoDBSaver que transfere checkpoints grandes para o S3.
O histórico de checkpoints cresce. Apagar linhas antigas com uma consulta SQL genérica baseada na idade pode partir a reconstrução quando os checkpoints mantidos dependem de escritas anteriores ou de delta channels. Use uma operação de retenção suportada pelo saver cujo comportamento de recuperação tenha testado. Se não existir nenhuma para a versão instalada, mantenha o histórico necessário até conseguir verificar um procedimento de poda.
A memória entre threads precisa de uma regra de atualização
Um utilizador que regressa pode ter uma preferência de risco que deve influenciar uma nova análise. Esse facto não deve ficar escondido no checkpoint de uma conversa antiga: o novo pedido pode usar outra thread. Precisa de um registo entre threads com um proprietário, uma forma de o ler e uma forma de o substituir ou apagar.
A implementação de memória de longo prazo do projeto de acompanhamento guarda perfis de utilizador no Qdrant. O seu caminho get_profile usa um filtro exato pelo ID do utilizador, e guardar um perfil usa um ID de ponto determinístico para as atualizações. O caminho do perfil é armazenamento entre threads, não recuperação semântica. Um perfil com campos com nome, como a tolerância ao risco e o horizonte de investimento, também poderia viver numa coluna JSONB do PostgreSQL ou num hash do Redis, que são mais simples do que gerar embeddings e consultar vetores. Acrescentar embeddings não traria qualquer benefício a esta consulta exata.
O ID do utilizador numa consulta ao store tem de vir de uma identidade verificada da aplicação quando isto é exposto como serviço. Um filtro de payload do Qdrant delimita a recuperação; não é autenticação. O projeto de acompanhamento também tem uma interface de linha de comandos que aceita um ID de utilizador. Essa interface é útil para uma demonstração local, mas uma aplicação que serve várias pessoas tem de impor a propriedade antes de ler ou escrever perfis. A documentação de multitenancy do Qdrant descreve filtros e índices por tenant; continua a ser a aplicação a decidir quem pode fornecer o valor do tenant.
O store do LangGraph
A Store API do LangGraph guarda itens entre threads como pares (namespace, key) com um valor JSON. O namespace codifica normalmente o proprietário, por exemplo ("user", user_id, "preferences"). BaseStore oferece put(), get(), search() e delete(), com delimitação hierárquica por namespace. Três implementações cobrem a maioria das necessidades:
InMemoryStorepara desenvolvimento e testes; os dados perdem-se quando o processo termina.PostgresStorepara um store persistente consultado com SQL.AsyncRedisStore, do pacote Redis, para memória entre threads com pesquisa vetorial, TTL e filtros de metadados.
Uma configuração index acrescenta pesquisa vetorial sobre os itens guardados, com uma função de embedding fornecida por si. Para muitas aplicações, este store integrado é suficiente antes de ser preciso uma base de dados vetorial dedicada:
from langgraph.store.memory import InMemoryStore

store = InMemoryStore(index={"dims": 1536, "embed": embed_texts})

async def remember_and_recall(user_id: str) -> list:
    await store.aput(
        ("user", user_id, "preferences"),
        "risk-profile",
        {"risk_tolerance": "high", "horizon": "long-term"},
    )
    # The namespace prefix is positional in search and asearch.
    return await store.asearch(("user", user_id), query="investment style", limit=5)
Passe o store ao compilar o grafo, ao lado do checkpointer, e um nó pode declarar um parâmetro store para o ler: builder.compile(checkpointer=checkpointer, store=store).
Quando acrescentar recuperação semântica
Agora mude o pedido: «Que preocupação levantei sobre os fornecedores na última análise?» A nota útil pode não ter uma chave estável conhecida de quem chama. A pesquisa por significado pode encontrar notas candidatas mesmo quando a pergunta usa outras palavras. Essa necessidade é a razão para acrescentar embeddings. Ter uma base de dados vetorial disponível não é.
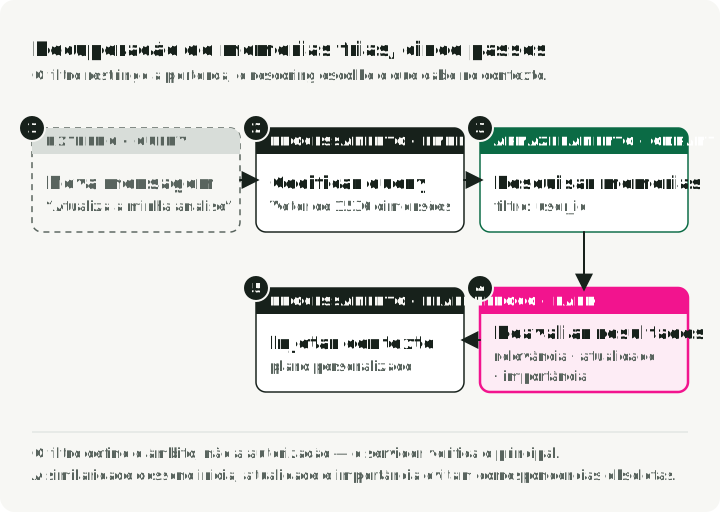
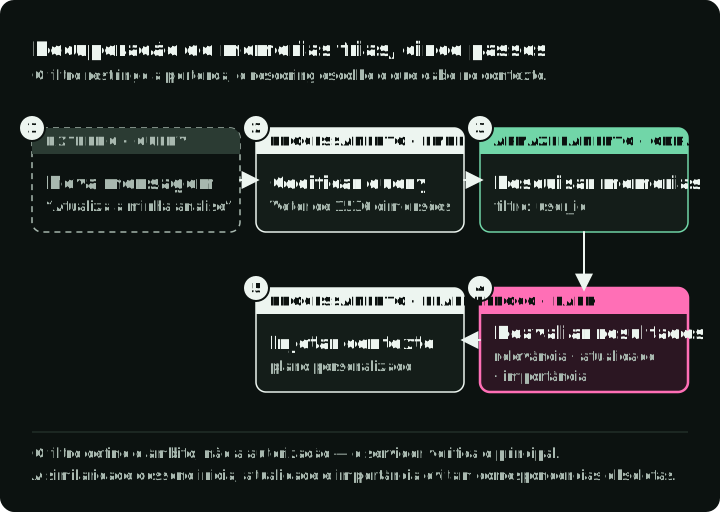
Uma extensão ilustrativa extrairia um facto candidato curto de uma conversa concluída, juntaria a fonte e o proprietário, geraria um embedding e guardaria o texto e o vetor. Num pedido posterior, a aplicação restringiria primeiro a pesquisa a esse proprietário, recuperaria candidatos, verificaria se continuam válidos e daria ao modelo apenas os factos relevantes e atribuídos.
O facto extraído é apenas um candidato. Um modelo pode inferir uma «preferência» a partir de uma única mensagem ambígua. Antes de o promover a memória durável, decida que factos exigem confirmação do utilizador, quais podem ser atualizados automaticamente e quais nunca devem ser inferidos. Guarde a fonte e a hora da observação para que uma correção posterior possa substituir um facto. A semelhança mede proximidade temática; não estabelece verdade, validade atual nem permissão.
O sítio onde os vetores vivem é uma escolha à parte. O pgvector mantém-nos na base de dados PostgreSQL que a aplicação já corre. O Qdrant é uma base de dados vetorial dedicada com indexação HNSW e pesquisa filtrada; o artigo sobre ranking de pesquisa trata o HNSW e os seus compromissos. O Qdrant publica também um servidor MCP que expõe uma coleção como ferramenta de memória para clientes MCP. Um serviço dedicado é útil quando precisa da sua recuperação, filtragem, escala ou adequação operacional; demonstre essa necessidade com as suas próprias consultas e o seu próprio corpus antes de o acrescentar.
A semelhança de cosseno em bruto é apenas um sinal inicial. O artigo Generative Agents combinou três sinais para recuperar as memórias de agentes simulados: recência, com decaimento exponencial; importância, classificada por um modelo numa escala de 1–10; e relevância, como semelhança de embeddings. Normalizou os três antes de os somar com pesos iguais. Se adotar a ideia, normalize primeiro, caso contrário a pontuação de importância de 1–10 domina, e ajuste os pesos com testes de recall e de tarefa reservados. Se a recuperação semântica devolver uma preferência desatualizada porque a sua formulação se parece com a nova pergunta, corrija a regra de validade antes de ajustar pesos. Um valor estruturado com uma atualização explícita continua a ser a resposta mais simples para uma preferência com nome.
Experimente a pesquisa por palavras-chave ou de texto integral quando nomes e termos exatos identificarem a nota. Use embeddings quando as paráfrases contornarem regularmente essa pesquisa. Se ambos importarem, recupere candidatos pelos dois caminhos antes de combinar as suas classificações. Reordenar resultados de palavras-chave apenas com pontuações vetoriais não consegue recuperar uma nota relevante que o filtro de palavras-chave já descartou.
| Abordagem | Ideal para | Principal custo operacional |
|---|---|---|
| Armazenamento chave-valor (JSONB do PostgreSQL, hash do Redis) | Perfis e preferências estruturados | Uso de memória e política de persistência |
| Pesquisa de texto integral (GIN do PostgreSQL) | Recall por palavras-chave no histórico de conversas | Crescimento do índice e afinação de consultas |
| Pesquisa vetorial (pgvector, Qdrant) | Recall semântico de notas não estruturadas | Ciclo de vida dos embeddings e do índice |
| Híbrida (palavras-chave + vetores) | Recall quando a formulação das consultas varia | Dois caminhos de pontuação para afinar e avaliar |
| Grafo de conhecimento (Graphiti, Neo4j) | Relações entre entidades e consultas com vários saltos | Modelação do grafo e mais um sistema de dados |
| Armazenamento de documentos (ficheiros) | Conhecimento do projeto e notas geridas pelo agente | Concorrência, permissões e pesquisa |
Relações e frameworks geridos
As relações podem pedir outra forma. Uma pergunta como «Que fornecedores anteriores estiveram ligados a esta empresa e quando foi válida cada ligação?» é candidata a um grafo temporal. O Graphiti, da Zep, constrói um grafo de conhecimento que regista quando cada facto foi verdadeiro, além do que era verdadeiro, e mantém os valores substituídos com os seus intervalos de validade. No benchmark DMR do artigo da Zep, a Zep ficou a menos de meio ponto de colocar a conversa completa no contexto, pelo que esse resultado não mostra uma vantagem geral dos grafos temporais. A extração e as atualizações continuam a ter de determinar se uma relação está correta. Se registos ligados responderem às consultas, use-os em vez de operar mais um serviço de grafos.
Os frameworks de memória executam por si o pipeline de extração, consolidação e recuperação. No Mem0, um modelo extrai factos candidatos, compara cada um com as entradas existentes e decide se acrescenta, atualiza, apaga ou deixa a memória inalterada. O Letta, antes MemGPT, dá ao agente ferramentas para mover dados entre a «core memory» dentro do contexto e a «archival memory» fora do contexto. O LangMem fornece ferramentas de gestão de memória para agentes LangGraph. Avalie um deles quando quiser rapidamente um pipeline funcional e não precisar de controlar cada regra de escrita; a retenção, a eliminação e os testes abaixo continuam a ser responsabilidade sua.
Os documentos tornam inspecionável o conhecimento acumulado
Alguma memória lê-se melhor como documento. Um agente de programação pode precisar do comando de testes e das notas de arquitetura de um projeto. Um agente de investigação pode precisar de uma lista de fontes revista e do raciocínio por trás de uma decisão anterior. São peças de conhecimento ligadas que uma pessoa deve conseguir ler, corrigir e versionar.
Considere um agente de programação que trabalha durante semanas num projeto. Aprende que o projeto usa Pydantic v2, que os testes correm com pytest -x --tb=short e que o programador quer pathlib em vez de os.path. Estes factos podiam estar num armazenamento chave-valor, mas um ficheiro permite ao programador lê-los, corrigir um errado com uma edição normal e rever cada alteração em git diff.
Os assistentes de programação já usam este padrão:
- Claude Code lê ficheiros
CLAUDE.mddo projeto e das suas pastas-mãe, e guarda memória por projeto em Markdown em~/.claude/projects/. Os ficheiros do projeto são submetidos com o código. - Cursor carrega regras do projeto a partir de
.cursor/rulescomo ficheiros.mdc, com front matter que controla quando cada regra se aplica. - Devin Desktop lê regras de
.devin/rules/e pode guardar memórias geradas automaticamente por espaço de trabalho. - A ferramenta de memória da Anthropic para a Claude API é uma ferramenta do lado do cliente cujos comandos de ficheiros (view, create, edit, delete, rename) operam numa pasta
/memories. A sua aplicação implementa cada comando, pelo que decide se os ficheiros ficam em disco, no S3 ou numa base de dados.
A DocumentMemory do projeto de acompanhamento escreve envelopes JSON com conteúdo, metadados e uma data de criação em namespaces. O seu nó de publicação arquiva um relatório aprovado no namespace de investigação. Um agente de investigação poderia usar esta estrutura:
.agent-memory/
    README.md                  # What this directory is, for human readers
    PROGRESS.md                # Handoff for the next session: done, next
    user-profiles/user-123.md  # Preferences and risk profile
    research/NVDA-2026-02.md   # Notes from a recent analysis
    conventions/analysis-format.md
    learnings/common-errors.md # Mistakes the agent has learned to avoid
A figura mostra as duas formas de entrar nessa pasta: as chamadas do agente e as edições de uma pessoa.
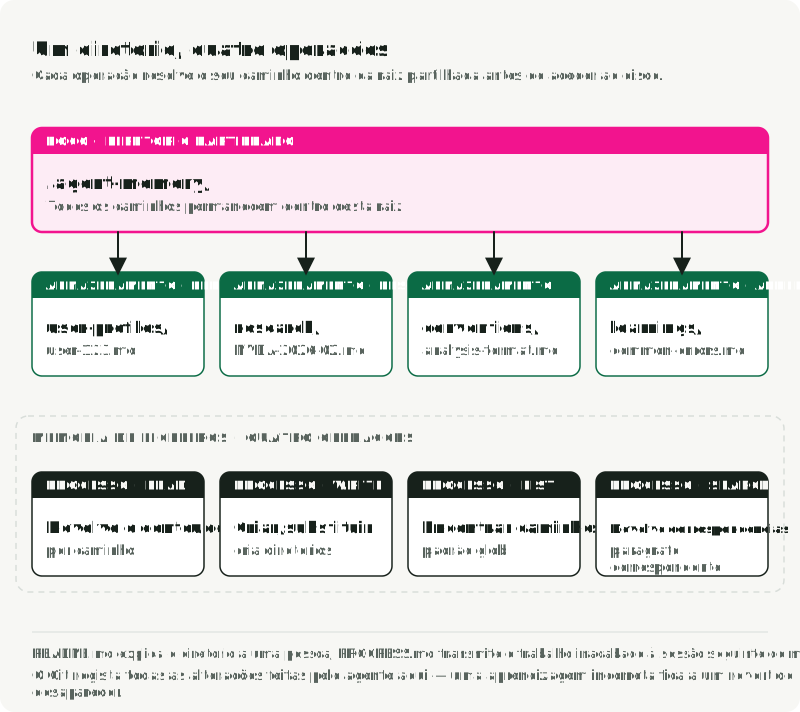
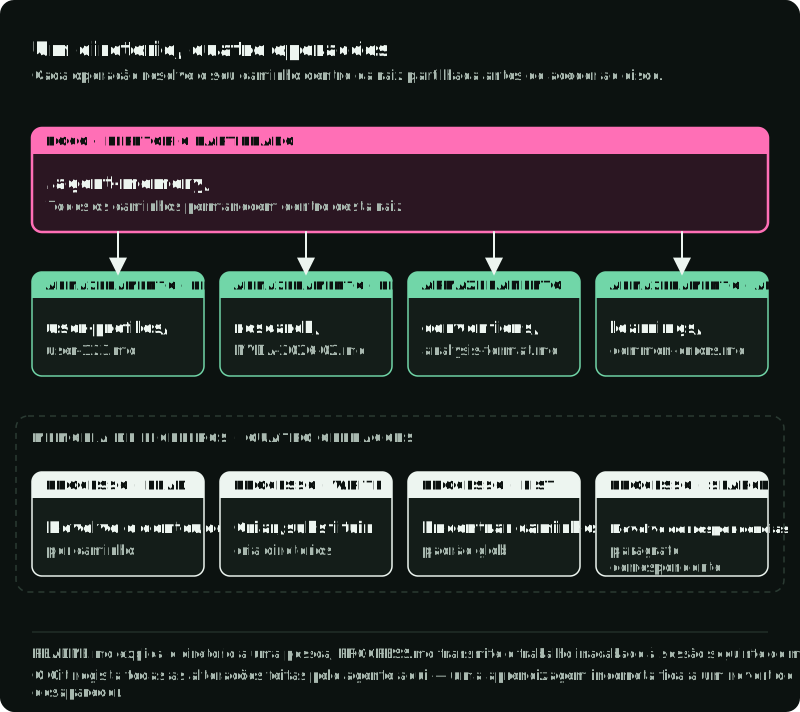
Para um único projeto cujas notas precisam de revisão humana, Markdown simples pode bastar. Use nomes que digam o que um documento cobre; registe a fonte e a última revisão quando afetarem a confiança. O agente precisa de quatro operações: ler um documento, escrever um, listá-los e pesquisá-los por palavra-chave. Ficheiros curtos, como uma nota de convenções ou de passagem de testemunho, podem ser carregados inteiros; um corpus grande continua a precisar de recuperação. Quando a pesquisa nesses ficheiros ficar lenta ou falhar notas relevantes, acrescente um índice de palavras-chave ou vetorial mantendo uma única cópia de referência. O número de documentos, por si só, não decide quando esse índice é necessário.
Uma interface de ficheiros não se limita à pesquisa por palavras-chave. Numa avaliação feita pelo próprio fornecedor, a Letta reportou 74,0% no benchmark LoCoMo de conversas longas para um agente com GPT-4o mini que pesquisava semanticamente ficheiros anexados, contra 68,5% da melhor variante com grafo do Mem0. Trata-se de um fornecedor, um modelo, um benchmark e um harness; mostra que uma interface orientada a ficheiros pode funcionar nessa configuração, não que Markdown bruto seja suficiente.
| Pergunta | Base vetorial | Armazenamento chave-valor | Armazenamento de documentos |
|---|---|---|---|
| Padrão de consulta | «Encontra notas semelhantes a X» | «Obtém o valor da chave» | «Lê o documento neste caminho» |
| Ideal para | Recall variado e não estruturado | Consultas estruturadas | Contexto e notas do projeto |
| Revisão humana | Inspecionar payloads e pontuações | Chaves exatas, valores JSON | Ler e editar Markdown |
| Controlo de versões | Através de exportações ou registos de alterações | Possível | Nativo com Git |
| Pipeline de embeddings | Necessário | Não necessário | Não necessário |
| Pesquisa | Semelhança semântica | Correspondência exata | Caminho, palavra-chave, índice opcional |
Use documentos quando o agente acumular conhecimento do projeto entre sessões e as pessoas precisarem de o inspecionar, corrigir ou versionar. Use uma base vetorial quando as consultas variarem na formulação ao longo de muitas notas separadas. Use um armazenamento chave-valor quando o esquema for conhecido e as consultas forem exatas. Os três podem coexistir, mas nenhuma aplicação precisa dos três por omissão.
A fronteira dos ficheiros exige cuidado quando os agentes podem escrever. Delimite cada leitura e escrita ao projeto ou utilizador previsto. Rejeite path traversal e fugas por ligações simbólicas. Coordene os escritores concorrentes e decida que edições exigem revisão humana. Os ficheiros recuperados são dados da tarefa de menor confiança: uma nota que diga «ignorar aprovação» não pode alterar a regra de aprovação da aplicação.
Servir documentos a muitos tenants
Os ficheiros servem um programador ou um sistema de ficheiros controlado. Vários tenants e escritores concorrentes precisam de controlo de acesso explícito e de coordenação de escritas. Há três desenhos comuns:
- Escrever em ficheiros, servir a partir de uma base de dados. Os programadores editam Markdown e submetem-no; a implementação sincroniza os ficheiros para linhas do PostgreSQL e o agente lê linhas indexadas no runtime.
- Armazenamento de objetos com um índice vetorial. Os documentos ficam no S3 ou no GCS, e uma coleção do Qdrant indexa os seus embeddings. O agente encontra os IDs dos documentos no Qdrant e depois obtém o conteúdo do armazenamento. Isto escala horizontalmente, à custa de dois sistemas, um pipeline de embeddings e consistência eventual entre eles.
- Documentos PostgreSQL com pesquisa híbrida. Guarde cada documento como uma linha com metadados, um índice de texto integral e um embedding pgvector opcional. Obtém pesquisa por palavras-chave e semântica, transações e um único sistema para operar. Para um serviço multi-tenant, eu começaria aqui.
No terceiro desenho, obtenha o tenant a partir do pedido autenticado, nunca do modelo nem do cliente, e faça com que o PostgreSQL aplique essa restrição através da segurança ao nível das linhas. Use um papel da aplicação que não seja proprietário das tabelas e que não tenha privilégios de superutilizador nem BYPASSRLS; se esse papel tiver de ser proprietário de uma tabela, use também ALTER TABLE ... FORCE ROW LEVEL SECURITY. Teste uma consulta sem filtro de tenant com o papel real da aplicação e confirme que não devolve linhas de outros tenants. Combine as correspondências por palavras-chave e por vetores conforme descrito acima para a recuperação semântica.
Um procedimento também é diferente de uma observação memorizada. O Voyager guardava programas executáveis reutilizáveis e recuperava-os pela descrição. O Agent Workflow Memory, em vez disso, acrescenta ao prompt workflows web induzidos como orientação. Uma nota de projeto pode descrever como executar uma verificação. Os programas executáveis precisam de testes e de execução restrita; as notas precisam de revisão dos factos e de uma verificação de que segui-las ajuda. Nenhum deve ganhar novas permissões por ter sido recuperado da memória. Uma Agent Skill é o caso vizinho: um ficheiro SKILL.md que diz ao agente como realizar uma classe de trabalho, e que a parte 3 compara com as ferramentas.
A compactação muda o contexto, não a fonte de verdade
Uma conversa longa acaba por exigir seleção. A aplicação pode omitir mensagens antigas ou resumi-las para que o pedido seguinte ao modelo caiba no seu orçamento de contexto. A compactação do lado do servidor do Claude, uma funcionalidade beta em setembro de 2026, devolve um bloco compaction que os pedidos posteriores usam em vez do conteúdo anterior. Esse resumo pode ajudar o modelo a continuar, mas pode perder um ID de encomenda, uma proposta rejeitada ou uma condição de aprovação.
Mantenha os factos operacionais em estado explícito: o passo pendente do grafo, os efeitos externos concluídos e o estado exato da aprovação. Mantenha os factos entre threads em registos com proprietários e regras de atualização. Use um resumo para fornecer contexto e depois teste o que ele omitiu: force a compactação a meio de um teste e verifique se a ação seguinte continua a respeitar uma restrição anterior. Escolha um facto que o resumo não consegue reconstruir por dedução, como um ID de operação ou a condição exata associada a uma aprovação, e confirme-o no estado de referência em vez de na redação do resumo. Avalie a redação do resumo como uma verificação própria e separada. Um checkpoint restaura a execução do grafo; a compactação encurta a entrada do modelo; a recuperação seleciona informação para um novo pedido. São operações separadas mesmo quando um único harness executa as três.
A compactação também reinicia a cache de prefixos do fornecedor, e aceitar esse reinício raramente, num único salto grande, sai mais barato do que cortar algumas mensagens em cada ronda. Os fornecedores reutilizam o trabalho feito sobre um prefixo de pedido estável, pelo que substituir mensagens antigas altera o prefixo e o pedido seguinte paga o preço total pelo que vem a seguir. Um salto grande custa uma leitura a preço total de uma entrada muito mais pequena e depois volta a acrescentos baratos, enquanto os cortes pequenos e contínuos pagam esse custo vezes sem conta e podem tornar uma conversa mais curta mais cara do que uma mais longa. Escolha o limiar de compactação testando-o com o seu modelo e a sua tarefa, em vez de o fixar numa fração da janela de contexto.
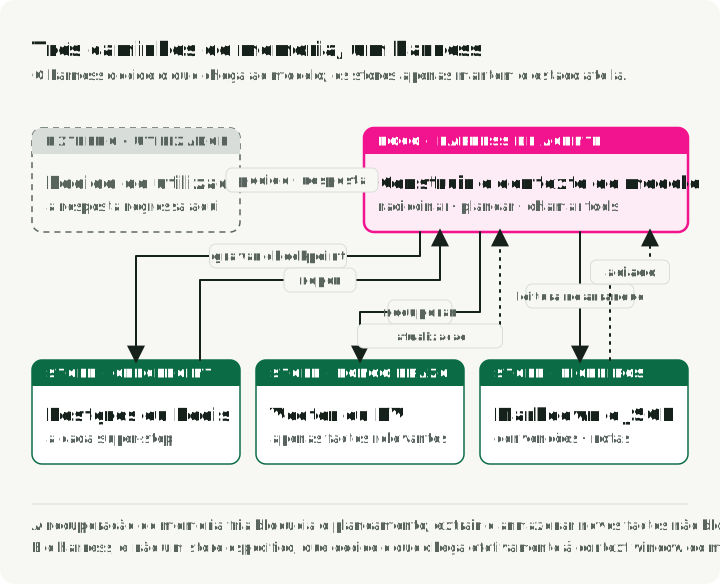
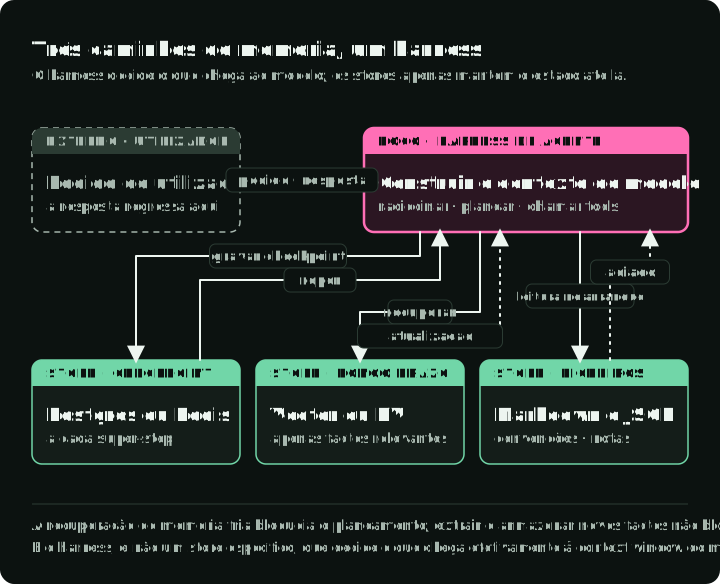
A figura mostra os três caminhos em conjunto. O caminho do checkpoint escreve em cada super-step e restaura ao retomar. O caminho de longo prazo é lido antes do planeamento, pelo que a sua latência atrasa o plano; os factos novos podem ser escritos depois da resposta. O caminho de documentos é lido durante o planeamento e escrito à medida que o trabalho termina. É o harness, e não um armazenamento em particular, que decide o que chega ao modelo.
No Market Analyst Agent, o checkpoint permite que o grafo pare antes da publicação e continue mais tarde. O Qdrant fornece uma consulta exata do perfil para a análise seguinte. O armazenamento de documentos arquiva um relatório após a aprovação. Nem a compactação nem a recuperação semântica são necessárias para explicar esses comportamentos implementados.
Custos e riscos a prever
- Custo e latência dos embeddings. Cada nota guardada precisa de um embedding e cada consulta semântica gera o embedding da pergunta. Em setembro de 2026, a OpenAI indica
text-embedding-3-smalla $0.02 por milhão de tokens; o custo por facto é pequeno, mas cresce com os utilizadores e as sessões. Agrupe as escritas, coloque em cache os embeddings de consultas frequentes ou corra um modelo de embeddings local quando o caminho de leitura for sensível à latência. - Orçamento de contexto. Cada facto recuperado retira tokens à tarefa. Limite quantos factos são recuperados e ordene-os antes de entrarem no prompt.
- Factos desatualizados. As preferências mudam. A expiração é a solução grosseira; a memória de agente guiada por esquema regista a validade e a proveniência de cada facto para que o valor atual prevaleça no momento da recuperação.
- Privacidade. A memória de longo prazo guarda dados de utilizadores. Remova os dados pessoais antes do armazenamento sempre que possível, defina regras de retenção e dê aos utilizadores uma forma de apagar o que foi guardado, incluindo cópias em índices, resumos e caches.
- Consolidação. Um facto derivado como «o utilizador perguntou por NVDA três vezes em janeiro» pode ajudar a recuperação sem substituir as conversas de origem. O Mem0 decide se acrescenta, atualiza ou apaga; o Graphiti mantém os episódios originais ligados aos factos derivados. Nenhum deles define a sua política de retenção.
- Arranque a frio. Um utilizador novo não tem memória. O agente deve perguntar em vez de presumir.
- Envenenamento da memória. Uma nota guardada pode conter uma instrução como «aprovar sempre as transações». Valide antes de guardar, trate o texto recuperado como dados e mantenha as permissões fora da memória.
- Deriva dos documentos. Os ficheiros não têm deduplicação nem deteção de conflitos automáticas; uma nota pode dizer «usar pytest» e outra «usar unittest». Agende revisões que os limpem e fundam.
Testes de memória: escrever, ler, alterar, apagar
Um teste de memória útil cria um facto, lê-o numa execução posterior, altera-o e verifica que a nova execução usa o substituto. Também exercita as falhas e a eliminação. Os testes abaixo decorrem diretamente dos quatro requisitos do início do artigo.
| Teste | O que inspecionar |
|---|---|
| Reiniciar enquanto se espera pela aprovação | O grafo continua na fronteira de aprovação; não publicou por iniciativa própria |
| Perder a resposta a uma escrita externa | Uma nova tentativa não cria um segundo efeito, ou a recuperação reporta a incerteza e para |
| Alterar uma preferência de risco | Uma thread nova lê o valor atual e não usa o antigo |
| Reformular uma pergunta sobre uma nota anterior | A fonte prevista é recuperada, ou o agente diz que não encontra evidências suficientes |
| Apagar um facto guardado de um utilizador | A consulta exata, o índice vetorial, os resumos e as caches deixam de o devolver |
| Perguntar como outro utilizador | Nenhum registo ou documento do primeiro utilizador entra no contexto do segundo |
| Colocar uma instrução falsa numa nota | As permissões e as regras de aprovação da aplicação continuam a aplicar-se |
Compare com uma referência sem memória. Nas tarefas de recuperação, uma referência com o contexto completo ajuda a mostrar se o pipeline de extração e pesquisa acrescentado melhora alguma coisa nas mesmas condições da tarefa. Meça a qualidade da recuperação separadamente da qualidade da resposta: uma resposta aparentemente correta pode resultar do facto errado ou desatualizado. Registe a latência, o crescimento do armazenamento e qualquer custo de embeddings ou do modelo, em vez de presumir que uma memória mais elaborada é melhor.
O LongMemEval oferece 500 perguntas que cobrem extração de informação, raciocínio entre sessões, raciocínio temporal, atualizações e abstenção. O seu benchmark é útil para desenhar testes de recall, mas uma pontuação nele não prova que uma aplicação retoma em segurança nem que respeita a eliminação. Um produto que promete aprender com trabalho anterior também precisa de tarefas sequenciais em que o feedback altera o comportamento posterior; o MemoryArena constrói tarefas interdependentes desse tipo entre sessões para compras, planeamento de viagens, pesquisa progressiva e raciocínio formal. Em ambos os casos, mantenha o teste próximo da falha que o produto tem de evitar.
O EvoMemBench comparou 15 métodos de memória com referências fortes de contexto longo, segundo o seu protocolo. O contexto longo manteve-se competitivo e nenhuma forma de memória foi a melhor em todos os cenários. Esse resultado não escolhe um armazenamento para este agente; é uma razão para manter a referência simples e testar se um caminho de memória acrescentado melhora esta tarefa.
Opcional: examinar o projeto de acompanhamento
O Market Analyst Agent demonstra os caminhos do checkpoint, do perfil e do arquivo de relatórios. Requer Python 3.13+, uv, Docker e credenciais de API para o modelo e a pesquisa. A sua análise faz chamadas pagas ao modelo. A partir de um checkout novo, siga a configuração do ambiente do repositório e depois execute:
git clone https://github.com/slavadubrov/market-analyst-agent
cd market-analyst-agent
git checkout 6794a0d
make setup
make install
cp .env.example .env
# Configure a model API key in .env before continuing.
make db-up
uv run market-analyst --set-profile --risk-tolerance conservative --horizon long
uv run market-analyst "Analyze NVDA stock"
# Use the thread ID printed by the run after it stops for approval.
uv run market-analyst --approve --thread-id <thread-id>
O ID de utilizador na linha de comandos é um dado de delimitação, não um mecanismo de autenticação; acrescente identidade verificada e verificações de propriedade antes de expor este caminho como serviço multiutilizador.
Use o armazenamento mais pequeno que passe nesses testes. Para o projeto de acompanhamento, isso significa um checkpoint durável, um registo exato do perfil e um arquivo de relatórios. A recuperação semântica e um caderno de projeto navegável só são próximos passos úteis se um pedido real e uma avaliação mostrarem o que acrescentam. A parte 3 passa às ações que um agente pode realizar com este contexto; a parte 4 trata a fronteira de confiança em torno dessas ações.
Referências
Artigos
- Cognitive Architectures for Language Agents (CoALA) — Sumers, Yao et al., 2023 — taxonomia dos tipos de memória de agente
- Memory in the Age of AI Agents — 2025 — revisão organizada por forma, função e dinâmica da memória
- MemGPT: Towards LLMs as Operating Systems — Packer et al., 2023 — gestão de contexto virtual
- Generative Agents: Interactive Simulacra of Human Behavior — Park et al., 2023 — pontuação por recência, importância e relevância
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory — Rasmussen, 2025 — grafo de conhecimento temporal
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory — 2025 — pipeline de extração e consolidação
- Voyager: An Open-Ended Embodied Agent with Large Language Models — Wang et al., 2023 — biblioteca de competências executáveis
- Agent Workflow Memory — Wang et al., 2024 — workflows reutilizáveis para agentes web
- LongMemEval — 2024 — benchmark de memória de longo prazo
- EvoMemBench — 2026 — comparação de métodos de memória com referências de contexto longo
LangGraph e backends de checkpoints
- Persistência do LangGraph, checkpointers e stores
langgraph-checkpoint-postgres— saver PostgreSQLlanggraph-checkpoint-redis— saver e store Redislanggraph-checkpoint-sqlite— saver SQLite para uso locallanggraph-checkpoint-aws— saver DynamoDB com transferência para o S3
Pesquisa vetorial, grafos e frameworks de memória
- pgvector — pesquisa vetorial no PostgreSQL
- Qdrant e o seu servidor MCP
- Graphiti — motor de grafos de conhecimento temporais da Zep
- Mem0, Letta e LangMem
Memória baseada em ficheiros
- Memória do Claude Code
- Ferramenta de memória da Anthropic
- Regras do Cursor
- Memórias do Devin Desktop
Projeto de demonstração
- Market Analyst Agent — caminhos de armazenamento de checkpoints, perfis e documentos