Harness Engineering para agentes de AI: verificar a conclusão

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Um agente pode terminar o seu turno com o trabalho ainda incompleto. Este artigo destina-se a engenheiros que constroem ou reveem coding agents e que precisam de decidir quando aceitar um resultado, repetir uma operação incerta ou retomar o trabalho noutra sessão. Mostra também como medir se um componente adicional do harness melhora esses resultados o suficiente para justificar o seu custo.
O harness é o código da aplicação à volta do reasoning loop do modelo. Fornece contexto, verifica as ações propostas, regista o que aconteceu e decide se a evidência é suficiente para terminar. O runtime executa as ações aceites e mantém disponíveis a sessão, a sandbox e o checkpoint. Os artigos anteriores explicam o reasoning loop, a memória, as ferramentas e as permissões. Aqui, a questão é o que o harness faz depois de o modelo propor uma ação ou dizer “concluído”.
Os exemplos da loja e dos pagamentos abaixo são casos de ensino fictícios. O laboratório complementar é uma simulação determinística; não mede um coding agent real.
O que conta como concluído
Suponha que se pede a um coding agent que baixe de $100 para $75 o limiar de um desconto automático de 10% num repositório fictício de uma loja. O agente altera src/checkout.py. Um carrinho de $80 deve agora receber um desconto de $8. A tarefa tem duas verificações obrigatórias:
pytest tests/test_checkout.pyverifica o cálculo.pnpm playwright test tests/checkout_discount.spec.tsverifica o resultado visível do checkout numa loja local com dados pré-carregados.
Uma resposta final plausível não é uma dessas verificações. O harness só deve aceitar um candidato cujo snapshot testado completo esteja identificado e cujas duas verificações obrigatórias tenham passado nesse mesmo snapshot. Um commit limpo pode identificá-lo; caso contrário, use um digest ou um manifesto que inclua os ficheiros não rastreados relevantes. Mantenha os testes fora do âmbito de escrita do agente ou aprove de forma independente as alterações a esses testes antes da avaliação.
É aqui que o modelo, o harness e o runtime têm funções diferentes. As implementações podem juntar várias delas num só processo, mas os seus limites de falha continuam a ser diferentes:
| Componente | Função | Exemplo num coding agent |
|---|---|---|
| Modelo | Propõe texto, uma tool call ou uma resposta final | Sugere uma edição a src/checkout.py |
| Reasoning loop | Escolhe o passo seguinte a partir do contexto disponível | Inspecionar, editar, testar, voltar a inspecionar |
| Harness | Fornece contexto, valida e autoriza propostas, despacha as calls aceites, regista resultados, verifica a conclusão | Permite edições em src/ e exige os dois testes indicados |
| Runtime | Executa as calls aceites e mantém o estado ativo fora do processo worker | Registo da sessão, sandbox, checkpoint store, backend de traces |
A descrição do loop do Codex da OpenAI descreve o ciclo: o harness monta um prompt, pede ao modelo a ação seguinte, envia uma tool call aceite ao runtime, acrescenta o resultado e volta a perguntar até aceitar o resultado ou devolver o controlo ao utilizador. Para a alteração do desconto, uma passagem tem este aspeto:
- O context builder fornece a tarefa, as instruções do repositório, os ficheiros relevantes, os tool results anteriores e o plano atual.
- O modelo propõe uma call
edit_filecom um caminho e o texto de substituição. - A fronteira da ferramenta valida os argumentos, compara o caminho com o âmbito permitido e pede aprovação se a operação o exigir.
- O runtime aplica a edição na sandbox e devolve um resultado estruturado.
- O harness executa
pytest tests/test_checkout.py, depoispnpm playwright test tests/checkout_discount.spec.ts, e lê os dois exit codes. - Uma verificação falhada torna-se novo contexto para o turno seguinte do modelo; duas verificações aprovadas fazem da alteração um candidato à conclusão.
- O harness regista de forma durável os comandos, os exit codes, o snapshot testado, o avaliador e as versões do ambiente; um trace pode ligar-se a esse registo.
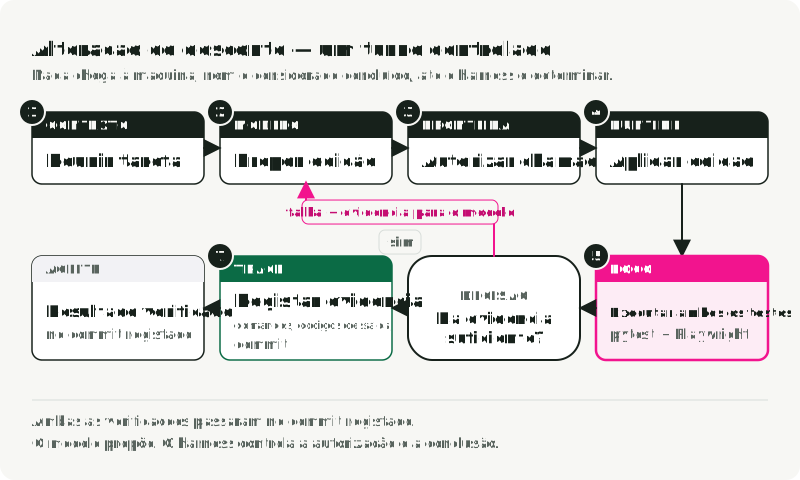
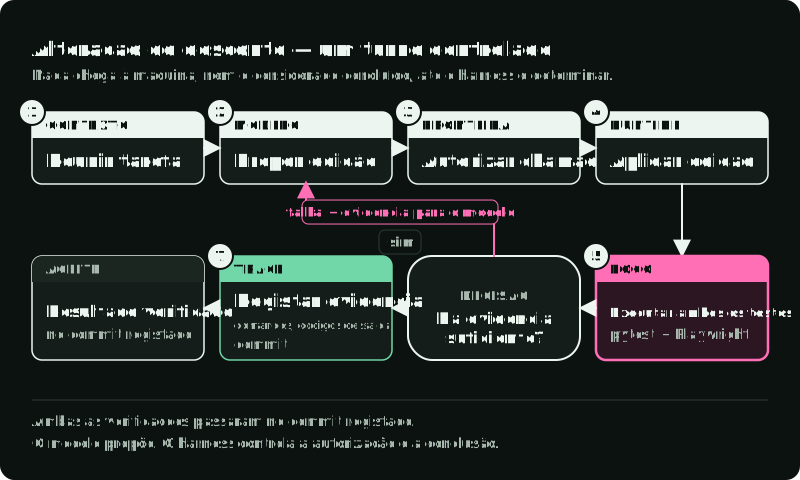
Depois do passo 2, nenhum ficheiro foi alterado. O harness ainda pode rejeitar ../../secrets.env, exigir aprovação para um comando destrutivo ou parar uma execução que esgotou o seu orçamento. Depois do passo 5, é o próprio harness que lê os exit codes, pelo que o modelo não pode marcar a sua própria edição como aprovada.
Um registo de conclusão para esta tarefa precisa do snapshot candidato, dos dois comandos e respetivos exit codes, e das versões do ambiente de teste e do avaliador. Deve ser durável e estar fora do controlo do candidato. Um trace pode ligar a proposta, a call aprovada, o resultado do runtime e o registo de aceitação para diagnóstico. Um trace, por si só, não é a decisão de aceitação.
Um trace também não contém necessariamente o pedido. Pode registar o documento de origem ou um evento de middleware sem mostrar o que o pedido montado continha no fim. Se precisar de estabelecer o que o modelo recebeu, capture-o no último ponto antes de a call sair, depois de todas as transformações.
O estudo de caso de harness engineering da OpenAI descreve uma aplicação arrancável por worktree, com acesso ao browser, logs, métricas e traces. Essa configuração tornou um objetivo de latência de um percurso do utilizador inspecionável pelo agente. Ilustra o pré-requisito por trás de uma regra de aceitação: a aplicação e os sinais relevantes têm de estar disponíveis no ambiente de teste. Lopopolo, o autor desse estudo de caso, mantém um guia de campo de harness engineering com as mesmas duas alavancas: manter o modelo fixo e trabalhar o contexto e as ferramentas à sua volta. O nível de qualidade, os procedimentos e as regras de aprovação de uma organização ficam fora do que um modelo genérico sabe; o harness fornece-os como instruções do repositório, regras de permissão e verificações de aceitação.
Considere três resultados aparentemente semelhantes:
| Evidência no fim da execução | Decisão do harness | Porquê |
|---|---|---|
| O teste unitário passa; falta o resultado no browser | Continuar ou parar como incompleta | Uma verificação obrigatória não tem resultado |
| Os dois testes passam e depois o agente edita um ficheiro | Executar de novo as duas verificações | As aprovações registadas pertencem a um snapshot anterior |
| Os dois testes passam no mesmo snapshot identificado | Elegível para aceitação | A evidência exigida corresponde ao candidato |
“Elegível” deixa espaço para uma aprovação humana ou outra regra obrigatória; não permite que o modelo certifique o seu próprio trabalho. Um avaliador com contexto novo pode rever um resultado visual segundo uma rubrica quando um exit code não consegue exprimir o critério. Compare esse avaliador com revisões humanas antes de o deixar decidir a conclusão. Não pode substituir uma verificação determinística obrigatória.
Para o agente de pesquisa desta série, uma regra de conclusão determinística proposta verificaria o schema do relatório e confirmaria que os tickers pedidos aparecem. Essas verificações não conseguem estabelecer que a análise está factualmente correta; isso continua a exigir a revisão das fontes. As orientações de avaliação da Anthropic recomendam ambientes estáveis e testes exaustivos para tarefas de programação, com calibração humana para avaliadores baseados em modelos.
Onde cada regra é aplicada
O requisito de que tests/checkout_discount.spec.ts passe pertence a código determinístico, não ao prompt. Um prompt pode lembrar o modelo de executar o teste. Não consegue impedir o modelo de declarar sucesso sem evidência. Outras regras cabem noutros sítios:
| Colocar a regra em | Adequado para | Exemplo |
|---|---|---|
| Prompt ou skill | Ordem de pesquisa, convenções de código e formato do plano | Ler AGENTS.md antes de editar o código do checkout |
| Fronteira da ferramenta | Validação de argumentos, caminhos permitidos, aprovações e acesso às ferramentas | Permitir escritas apenas em src/ |
| Código determinístico | Orçamentos, timeouts, retries, exit codes dos testes e requisitos de release | Manter a execução aberta enquanto o teste Playwright falha |
| Avaliador com contexto novo | Revisão visual ou critérios que exigem juízo | Comparar um diagrama gerado com uma rubrica escrita |
Cada uma das partes anteriores desta série decide uma coisa dentro desse percurso:
| Parte anterior | O que decide para este turno | Onde atua no percurso |
|---|---|---|
| Parte 2 — memória | Que estado anterior entra no prompt | Passo 1, o context builder |
| Parte 3 — tool use | Que ações existem e qual é o aspeto de um resultado validado | A validação do passo 3 e o resultado do passo 4 |
| Parte 4 — segurança | Se esta call específica pode ser executada agora | Passo 3, a verificação do caminho e a aprovação |
| Parte 6 — este artigo | Se a evidência resultante termina a execução | Passos 5 a 7, as verificações de aceitação |
A tabela mapeia responsabilidades, não a ordem de execução. As Partes 3 e 4 partilham o passo 3: o mesmo código do harness que rejeita um argumento malformado também rejeita uma call permitida mas ainda não aprovada. Se a validação e a autorização correrem em serviços separados, passe os argumentos validados através dessa fronteira, para que a decisão de autorização se aplique à call que vai ser executada.
Tratar um timeout como um resultado desconhecido
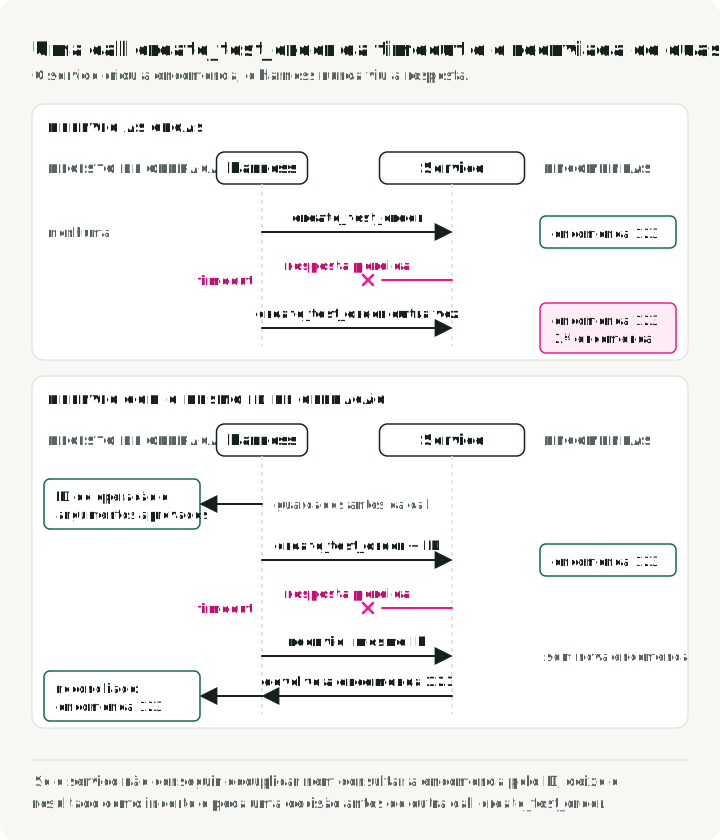
A edição do desconto é local e os seus testes podem ser executados de novo. Uma migração de pagamentos na mesma loja fictícia traz um problema diferente. Suponha que o agente chama create_test_order num serviço de staging e que a call dá timeout. O serviço pode ter criado a encomenda, mesmo que o harness nunca tenha recebido a resposta. Repetir às cegas pode criar uma segunda encomenda.
O nome da ação ou um ID de tool call gerado pelo modelo não basta para a recuperar. Antes do despacho, persista um ID de operação controlado pela aplicação, juntamente com os argumentos aprovados. O serviço tem de deduplicar os retries para esse ID ou disponibilizar uma consulta de estado que permita reconciliar o resultado. Reutilize o mesmo ID para a mesma encomenda pretendida depois de um reinício; um pedido de encomenda alterado precisa de uma nova decisão. As orientações da AWS sobre APIs idempotentes descrevem o identificador do cliente e a atomicidade do lado do servidor necessários para tornar isto seguro. Verifique durante quanto tempo o fornecedor guarda as chaves: o contrato da Stripe, por exemplo, permite eliminá-las após pelo menos 24 horas, pelo que um retry posterior exige reconciliação em vez de um novo envio.
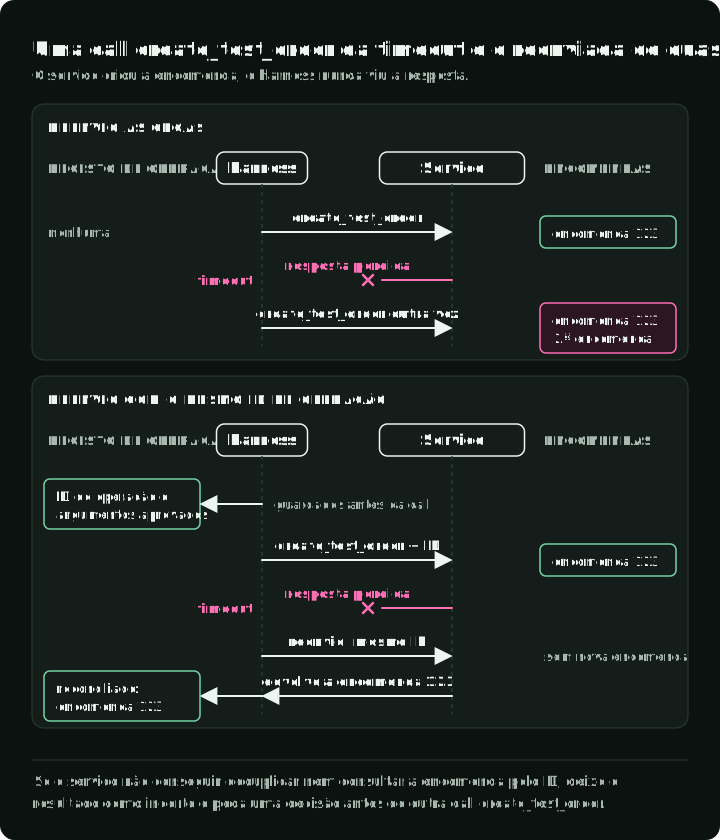
A figura segue uma única call create_test_order que deu timeout, duas vezes: uma reenviada às cegas e outra reenviada com o ID de operação guardado.
O harness só consegue tomar estas decisões sem consultar o modelo se cada ferramenta tiver um contrato explícito. Para create_test_order, esse contrato inclui:
- argumentos validados, para que entradas malformadas sejam rejeitadas antes da execução;
- um resultado estruturado como
{ "order_id": "123", "created": true }, para que as verificações posteriores não tenham de analisar texto livre; - uma categoria de efeito: se a call apenas lê ou se altera um ficheiro, um registo ou um serviço externo, e se é seguro repeti-la;
- uma política de timeout e de retry, para que uma resposta perdida não inicie uma sequência ilimitada de calls;
- uma regra de permissão: consultar o estado da encomenda pode correr automaticamente, enquanto criar uma encomenda pode exigir confirmação.
| Resultado observado pelo harness | Ação seguinte |
|---|---|
Uma call só de leitura get_order_status devolve 503 | Repetir dentro de um limite, se for seguro repetir essa consulta |
create_test_order dá timeout; a consulta encontra a encomenda pelo seu ID de operação | Usar a encomenda existente e registar o resultado reconciliado |
create_test_order dá timeout; o serviço não consegue deduplicar nem verificar o estado | Deixar o resultado como incerto e pedir uma decisão antes de outra criação |
Esse último estado tem de sobreviver a uma falha do worker. Chamar-lhe “falhado” seria falso: a encomenda pode existir. O registo durável da operação precisa do payload aprovado, do ID de operação, do estado do despacho, do resultado do servidor ou da consulta de estado, e de qualquer aprovação. O trace ajuda a encontrar esse registo; a transcrição só mostra o que o modelo viu.
A descrição de uma ferramenta ajuda o modelo a escolher uma ação. Não concede permissão nem prova que um retry é seguro. Se o serviço de encomendas estiver exposto através de MCP, o cliente continua a ter de aplicar a sua própria validação e política de confiança, e o servidor tem de impor controlos de acesso. A especificação de ferramentas do MCP diz que os clientes devem tratar as anotações de comportamento das ferramentas como não fiáveis, a menos que venham de um servidor de confiança. Um servidor que descreva create_test_order como só de leitura não o torna só de leitura. A especificação não prescreve uma única configuração de confiança, por isso escreva uma política explícita para a sua implementação que diga que metadados do servidor podem influenciar as decisões de permissão ou de retry.
O MCP também tem uma forma padrão de manter o controlo de uma call de longa duração. Com a extensão Tasks oficial, um servidor pode responder a tools/call com um handle de tarefa em vez de um resultado final. O cliente consulta então com tasks/get ou interrompe o trabalho com tasks/cancel. A especificação de Tasks diz que os clientes devem persistir os IDs de tarefa para que a consulta possa ser retomada após uma falha, por isso guarde o ID da tarefa no mesmo registo da operação. Uma tarefa completed não significa que a ferramenta teve êxito: um tool result com isError: true também conclui a tarefa, e só um erro de protocolo a passa para failed. Cliente e servidor negociam o suporte em cada pedido, por isso confirme que ambos o implementam antes de depender dele.
Passar o progresso à sessão seguinte
Agora o agente fictício tem de migrar o checkout do payment adapter v1 para o v2. Alterou o handler e o cliente, iniciou uma sandbox de pagamentos local e deixou tests/payment_migration.spec.ts a falhar. A tarefa dura mais do que uma sessão do modelo. Um resumo da conversa antiga pode dizer que a sandbox está a correr mesmo depois de o processo ter terminado.
A sessão seguinte precisa de três tipos diferentes de estado:
| Estado | O que a sessão seguinte tem de verificar |
|---|---|
| Conversa | O pedido, as decisões e os tool results relevantes |
| Workspace e runtime | Ficheiros atuais, branch, processos e ambiente de teste |
| Progresso da tarefa | Verificações concluídas, aprovação pendente ou escrita incerta, e ação seguinte |
A compactação substitui mensagens mais antigas por um resumo mais curto, para que a sessão atual possa continuar. Um handoff de progresso é memória documental para a sessão seguinte. Se a conversa antiga trouxer pressupostos desatualizados, o harness pode iniciar uma sessão nova com o handoff e o workspace atual; substituir um worker que falhou e restaurar os seus processos é uma tarefa separada do runtime.
Um checkpoint pode preservar o estado de execução, mas não prova que uma operação de pagamento externa foi confirmada nem que um processo continua ativo. Um handoff de progresso ajuda quando o contexto seguinte do modelo não tem um estado da tarefa utilizável. Registe a branch, os ficheiros alterados, o último comando e o seu resultado, os IDs de operação pendentes e o próximo passo por resolver. Ao retomar, verifique essas afirmações contra o workspace e o serviço reais antes de agir. As experiências da Anthropic com coding agents de longa duração usaram o histórico do git e um ficheiro de progresso para ajudar as sessões seguintes a recuperar o trabalho. O relatório posterior da Anthropic sobre design de harness nota que os handoffs acrescentam orquestração, tokens e tempo de execução.
O handoff deve ser condicional. Uma edição pequena que termina numa sessão não precisa de nenhum. Mesmo uma tarefa longa pode não precisar de outro ficheiro se o seu checkpoint já contiver o progresso necessário e a sessão seguinte o puder usar. Verifique se uma sessão retomada repete trabalho concluído, ignora uma escrita pendente ou age sobre um ambiente desatualizado. Corrija o estado em falta em vez de acrescentar um resumo por defeito.
Diagnosticar a falha antes de acrescentar um componente
Os três casos acima produzem traces diferentes: um teste de aceitação em falta, uma escrita externa incerta e trabalho repetido depois de retomar. As suas correções pertencem a sítios diferentes. Um resultado de browser em falta no registo de aceitação exige uma verificação de conclusão obrigatória. Uma encomenda incerta exige deduplicação ou reconciliação do lado do servidor. Uma edição repetida depois de uma sessão nova exige um estado de progresso utilizável.
Para a execução seguinte, registe a tarefa e a versão do harness, a ação proposta, a aprovação, o tool result, o snapshot testado, o resultado da aceitação, a latência e o custo. Anote as contagens de tokens de entrada separadamente do custo de entrada faturado, incluindo as leituras em cache: dois harnesses que se comportam de forma idêntica podem faturar de forma diferente, consoante a forma como cada um monta o seu pedido e se a cache do fornecedor estava quente. Mantenha segredos e dados pessoais desnecessários fora dos traces. Ligue os registos de operações externas por ID, já que um timeout do lado do cliente não pode revelar o que o servidor fez. Quando uma falha se repetir, escreva um caso de regressão que a reproduza. Avaliação de agentes de AI em produção desenvolve esse processo de trace para teste.
Cada sintoma repetido sugere uma pequena alteração e uma medida que mostraria se ajudou:
| Sintoma repetido | Pequena alteração a experimentar | O que medir |
|---|---|---|
| Consultas só de leitura falham de forma transitória | Retry limitado com backoff | Taxa de recuperação, calls extra, tempo de execução |
| Sessões retomadas repetem trabalho concluído | Handoff de progresso estruturado | Ações de ferramentas duplicadas depois de retomar |
| Faltam testes obrigatórios no momento da conclusão | Rejeitar a conclusão até todas as verificações obrigatórias passarem | Tarefas aceites sem todas as verificações obrigatórias |
| Defeitos visuais sobrevivem às verificações determinísticas | Avaliador com contexto novo e uma rubrica | Defeitos encontrados, rejeições falsas, tempo de revisão |
| O agente edita fora do seu âmbito | Permissão de ferramenta mais restrita | Calls bloqueadas e overrides manuais |
| A memória recuperada ocupa o lugar da tarefa atual | Limitar os factos recuperados; ordená-los antes de os injetar | Tokens gastos em recuperação, tarefas concluídas, custo |
| Uma regra ou estado declarado nunca chega ao modelo | Capturar o pedido montado antes de a call sair | Pedidos sem a regra; rondas até ela voltar a aparecer |
Antes de acrescentar uma política de retry, um handoff ou um avaliador, indique a falha que deve alterar e a métrica que mostraria a melhoria. Conte também o custo: mais tarefas aceites não são úteis se as calls extra duplicarem o tempo de revisão ou criarem encomendas duplicadas. Autorização, isolamento, regras de privacidade e verificações de aceitação obrigatórias são requisitos; um pequeno benchmark de sucesso não é razão para os remover. Teste essas restrições com casos proibidos explícitos.
Medir uma alteração opcional de cada vez
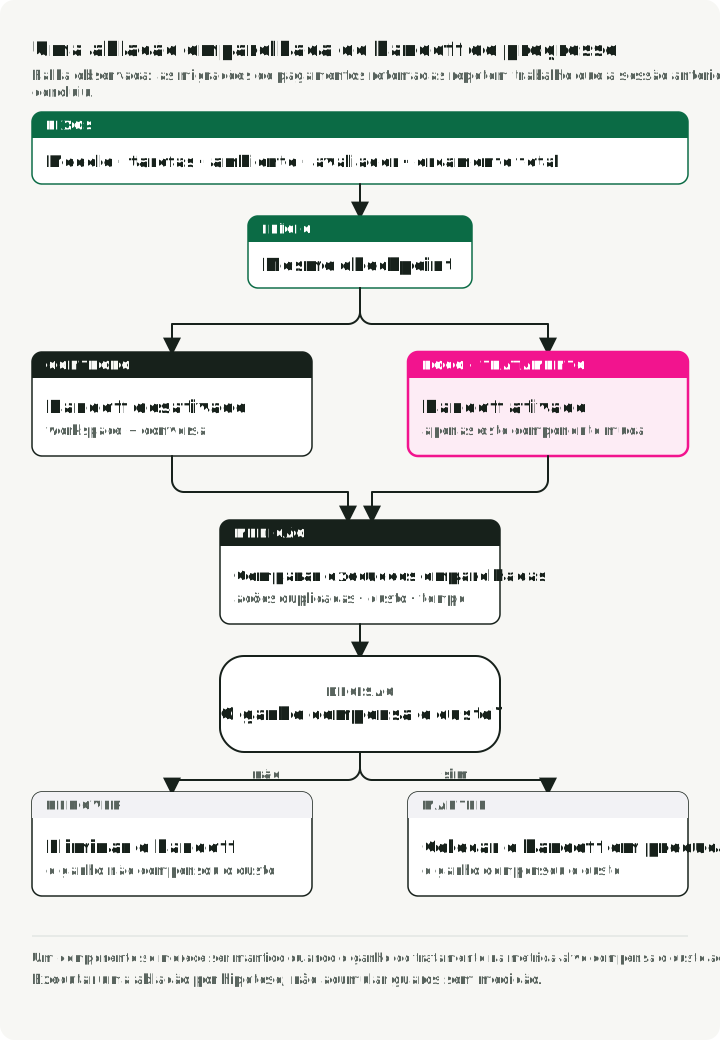
Uma ablação compara um harness com e sem um componente, mantendo fixo o resto da experiência. Use este protocolo:
- Congele a versão do modelo e o endpoint do fornecedor, as instâncias das tarefas, o ambiente e os seus limites de computação, o avaliador e os prompts fora do componente em teste. Só os limites de recursos podem alterar a pontuação de um benchmark de agentes; o artigo sobre evals trata da medição da Anthropic.
- Dê às duas variantes o mesmo orçamento total de tokens, tempo e dinheiro.
- Escolha o número de ensaios ou a regra de paragem antes de fazer a comparação.
- Execute as mesmas instâncias das tarefas nas duas variantes e repita cada tarefa, porque o output do modelo varia.
- Reporte a média com a sua dispersão ou intervalo de confiança.
- Conte todos os ensaios iniciados, incluindo timeouts, paragens por política, falhas do harness e falhas do avaliador.
Para a migração de pagamentos, o handoff de progresso opcional é um candidato. Comece cada par controlo–tratamento a partir do mesmo commit do repositório e do mesmo checkpoint pré-carregado, sendo o handoff a única diferença.
A medida principal poderia ser as ações de ferramentas duplicadas depois de retomar: uma operação sobre um artefacto que a sessão anterior já tinha concluído. Reporte também as tarefas aceites, os defeitos que escaparam, o tempo de execução, o custo do modelo e do avaliador e os minutos de revisão. Escolha antecipadamente o número de ensaios e a regra de paragem e depois reporte a variação, e não apenas a média. Se o handoff reduzir os duplicados mas custar mais do que poupa, isso é um resultado negativo útil.
O artigo do SWE-agent dá um exemplo limitado de ablação da interface. Com o GPT-4 Turbo, no subconjunto SWE-bench Lite de 300 tarefas e com um limite de $4 por tarefa, alterou uma funcionalidade da interface de cada vez:
| Alteração da interface | Resolvidas |
|---|---|
| Interface completa do SWE-agent (referência) | 18.0% |
| Editor sem linting | 15.0% |
| Ficheiro completo em vez de um visualizador de 100 linhas | 12.7% |
| Histórico completo de observações em vez das últimas cinco | 15.0% |
Estes são resultados para esse modelo e esse benchmark, não ganhos esperados para esta loja fictícia. O que se transfere é o método: testar uma escolha de interface identificada numa configuração fixa e depois reportar as condições juntamente com o número.
As comparações agrupadas são comuns e não conseguem identificar a alteração que ajudou. A LangChain reporta um ganho no Terminal-Bench 2.0 para deepagents-cli, de 52.8% para 66.5%, com o modelo fixo, depois de alterar em conjunto o system prompt, as ferramentas e o middleware. O relatório ARC-AGI-3 da OpenAI mostra o risco inverso: uma pontuação quase triplicou quando o harness manteve o reasoning e usou compactação, duas definições da API alteradas em conjunto. Registe a API, a retenção do reasoning, a política de compactação e os orçamentos juntamente com o ID do modelo; caso contrário, uma aparente regressão do modelo pode ser uma capacidade em falta no adaptador.
Testar uma alteração de cada vez também apanha alterações que parecem pequenas demais para importar. O postmortem do Claude Code de abril de 2026 da Anthropic relata que a API não foi afetada, mas três alterações na camada do produto reduziram a qualidade: um esforço de reasoning por defeito mais baixo, um bug que apagava o reasoning anterior em cada turno depois de uma sessão inativa e uma linha do system prompt que limitava o texto entre tool calls. Quando a Anthropic fez uma ablação dessa linha num conjunto mais amplo de evals, uma delas mostrou uma queda de 3% tanto no Opus 4.6 como no Opus 4.7. Uma linha de prompt ou uma definição por defeito é uma alteração do harness; teste-a como tal.
Volte a validar os componentes quando o modelo muda. O relatório da Anthropic sobre aplicações de longa duração é um estudo de caso qualitativo: quando o Opus 4.6 foi lançado, a equipa removeu componentes do harness um de cada vez e verificou que as calls ao avaliador se tornaram overhead nas tarefas que o modelo passou a concluir sozinho, embora continuassem a ajudar perto do seu limite.
Inclua uma paragem de segurança do fornecedor no conjunto de falhas: deve parar o despacho e passar para revisão, não repetir. A Parte 4 trata dos detalhes.
Experimentar a comparação no laboratório complementar
O projeto harness-demo no commit 517353f3 torna executável a regra da ablação. As suas doze tarefas sintéticas genéricas, como fix-parser-edge-case, split-large-module e wire-browser-test, declaram cada uma uma dificuldade e quatro condições: uma ferramenta instável, progresso perdido, uma lacuna de implementação não detetada e uma conclusão ambígua. O simulador deriva uma quinta condição para tarefas difíceis que também precisam de um ficheiro de progresso: sem context_reset, a compactação mantém pressupostos desatualizados. Uma função pura marca uma tarefa como aprovada quando a configuração selecionada trata todas as condições aplicáveis. Não há modelo, ferramenta externa nem tarefa de programação real. Os seus resultados e contagens de tokens são dados de ensino simulados, não evidência de que um harness com cinco componentes melhora um agente real.
Clone a revisão fixada e execute as verificações e a simulação com o uv instalado:
git clone https://github.com/slavadubrov/harness-demo.git
cd harness-demo
git checkout 517353f3a47541d66099983170fe90812b6ef23b
make check
make run
make failures
make check executa o Ruff e sete testes unitários, incluindo um teste que rejeita uma comparação que altera dois componentes. make run imprime uma matriz de ensino cumulativa e cinco pares leave-one-component-out. make failures identifica cada falha simulada; a configuração completa termina com all synthetic tasks pass.
| Componente reposto na configuração completa | Sem ele | Com ele |
|---|---|---|
| Política de retry | 8/12 | 12/12 |
| Handoff de progresso | 7/12 | 12/12 |
| Avaliador novo | 8/12 | 12/12 |
| Aceitação fail-closed | 7/12 | 12/12 |
| Reinício do contexto | 10/12 | 12/12 |
As linhas são consequências determinísticas das flags das tarefas e do código do avaliador. Não são estimativas da dimensão de um efeito num sistema real. A matriz cumulativa anterior acrescenta vários componentes numa só transição e não consegue identificar qual deles causou a sua alteração.
O model.py do lab impede que uma alteração agrupada seja chamada ablação: compara todos os campos de componentes de um par, e o seu teste de regressão fornece um par inválido com o retry e o avaliador ambos alterados. Esta versão autónoma da proteção corre sobre um par válido de handoff de progresso:
from dataclasses import dataclass, fields

@dataclass(frozen=True)
class Config:
    progress_handoff: bool = False
    evaluator: bool = False
    retry_policy: bool = False
    fail_closed_acceptance: bool = False
    context_reset: bool = False

def changed_components(control: Config, treatment: Config) -> tuple[str, ...]:
    return tuple(
        field.name
        for field in fields(control)
        if getattr(control, field.name) != getattr(treatment, field.name)
    )

control = Config(progress_handoff=False, evaluator=True, retry_policy=True)
treatment = Config(progress_handoff=True, evaluator=True, retry_policy=True)
assert changed_components(control, treatment) == ("progress_handoff",)
Para levar o método para um projeto real, substitua as flags sintéticas das tarefas por um conjunto de tarefas versionado e as contagens de tokens simuladas por medições de traces. Mantenha as regras de aceitação fora do controlo do candidato. Um modelo fixo, por si só, não é uma comparação controlada se os prompts, os dados de teste, as permissões ou as definições de reasoning e compactação da API também mudaram.
Encontrar o código por trás de um comportamento
Um harness que passa nas suas ablações pode ainda assim sobreviver ao modelo para o qual foi afinado, e alterá-lo mais tarde exige o código que implementa um comportamento. Um pedido como “mascarar segredos em todos os caminhos de captura” nomeia um comportamento, não um ficheiro. Num harness de produção, esse comportamento pode abranger várias fases de execução e estado partilhado.
Um preprint de 2026 de Wang et al. propõe um Harness Handbook para esta pesquisa, a que o artigo chama behavior localization. A análise estática extrai um grafo do programa, um LLM agrupa as suas unidades em fases de execução, e um maintainer ou um coding agent desce de uma visão geral do sistema até entradas baseadas no código-fonte para uma função ou um ficheiro. Cada entrada tem de ser resolvida contra o repositório real e é ressincronizada depois de cada alteração.
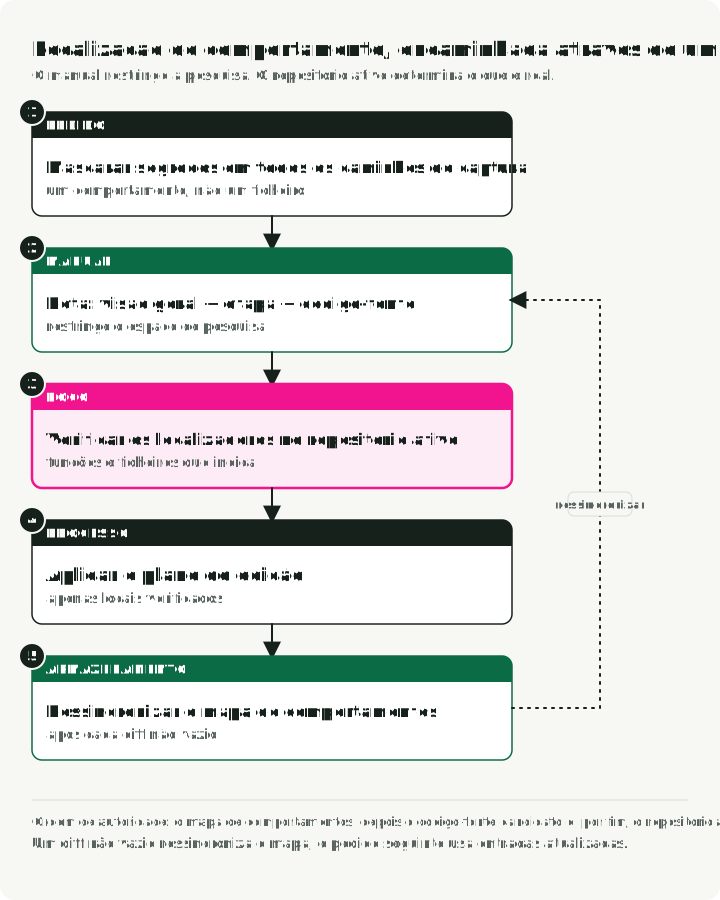
Em dois sistemas harness de código aberto, um planner que passava pelo handbook produziu planos de edição que os avaliadores preferiram com mais frequência, com menos tokens. O estudo avaliou planos e não alterações executadas, e não reportou incerteza, por isso trate-o como uma abordagem em fase de investigação.
Usar a falha para encontrar o responsável
Esta série foi construída a partir do reasoning loop para fora. Quando uma execução falha, encontre a primeira responsabilidade que a pode prevenir ou detetar:
| O que aconteceu | Investigar |
|---|---|
| Passo seguinte fraco com a informação certa disponível | Modelo e reasoning loop |
| Perdeu uma decisão anterior ou repetiu trabalho concluído | Montagem do contexto e memória |
| Não conseguiu exprimir uma ação ou ler o seu resultado | Contrato da ferramenta |
| Executou uma ação proibida | Verificação de permissões e o serviço que a impõe |
| O worker falhou e o seu ambiente desapareceu | Runtime e checkpoint |
| Declarou sucesso sem a evidência exigida | Regra de aceitação do harness e snapshot testado |
Eu começaria com um modelo capaz, ferramentas restritas, uma sandbox e uma verificação de aceitação explícita. Registe a primeira falha, acrescente o controlo mais pequeno que a resolve e compare com esse controlo desativado. Mantenha a regra e o trace juntos, para que a próxima atualização do modelo lhe dê uma razão para manter ou remover o componente. Para cada componente, registe quem o mantém, quantos tokens ou segundos acrescenta e que teste de regressão justificaria removê-lo. Seis meses depois, alguém que veja progress_handoff=True deve conseguir encontrar os traces falhados que o justificaram e os casos de regressão que ainda o mantêm.
Referências
- OpenAI, Unrolling the Codex agent loop.
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Demystifying evals for AI agents.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Lopopolo, Harness engineering: anthology, field guide, and agent context bundle.
- LangChain, Improving Deep Agents with harness engineering.
- OpenAI, How two settings tripled our ARC-AGI-3 scores.
- Wang et al., Harness Handbook: Making Evolving Agent Harnesses Readable, Navigable, and Editable, arXiv:2607.13285, 2026.
- Stripe, Idempotent requests.
- Yang et al., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering.
- AWS, Making retries safe with idempotent APIs.
- Model Context Protocol, Tools specification.
- Model Context Protocol, Tasks extension e Tasks specification.
- Anthropic Engineering, An update on recent Claude Code quality reports.
O código do Market Analyst Agent da série está no GitHub.