Tool use em agentes de AI: MCP, CLI, Skills e execução de código

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este artigo destina-se a engenheiros que dão a um agente acesso a dados, comandos ou serviços externos. Vai aprender a definir uma ação que o agente consiga usar de forma fiável, a escolher uma interface de execução para ela e a verificar se essa interface ajuda nas suas tarefas. O exemplo usado ao longo do texto é o Market Analyst Agent, um agente de investigação que obtém dados de mercado e prepara relatórios.
Na Parte 1, o modelo escolhia o passo seguinte num reasoning loop. A Parte 2 tratou do que ele consegue reter entre passos. Uma ferramenta dá a essa escolha um efeito fora do modelo: pode obter uma cotação, ler um relatório guardado, executar código ou alterar um registo. O programa que envolve o modelo, o harness, continua a decidir quais dessas ações existem e se uma chamada proposta pode ser executada.
A primeira decisão de design é a própria ação. Se o agente precisa de dados de preço e de avaliação para um relatório, deve pedir dois endpoints de API, um snapshot da ação ou um programa gerado? A resposta depende da tarefa e do feedback de que o agente precisa, não do protocolo de integração.
Para a decisão rápida sobre a interface, consulte AI Agent Tool Interfaces.
O que um resumo de uma empresa exige
Suponha que o utilizador pede ao Market Analyst Agent um resumo atual de uma empresa. O agente pode precisar de uma cotação recente, do volume de negociação, de métricas de avaliação, do histórico de preços e de notícias. São perguntas diferentes. A última cotação e as métricas básicas costumam pertencer à mesma resposta, enquanto o histórico de preços e as notícias podem ser desnecessários numa resposta curta. Uma capacidade sem relação com isto, como executar uma operação de compra ou venda, não deve entrar neste percurso de investigação.
Antes de expor uma API, escreva quatro coisas:
- Ação: O que pode o agente pedir num passo? Prefira uma operação que corresponda a uma pergunta a que ele precisa realmente de responder.
- Argumentos: Que entradas tem de fornecer quem chama, e quais pode a aplicação validar antes de contactar o serviço?
- Resultado: Que factos permitem ao agente decidir o passo seguinte, e que dados de proveniência ou identificadores têm de se manter para verificações posteriores?
- Falha e efeito: O que pode mudar, como pode quem chama saber se a ação aconteceu e quando é seguro repetir a tentativa?
Estas perguntas separam três responsabilidades. O modelo propõe uma ação. O harness valida-a e encaminha-a. A implementação da ferramenta executa-a e devolve um resultado. Um JSON Schema pode rejeitar um ticker mal formado; não pode estabelecer que uma operação de compra ou venda está autorizada. Um protocolo pode entregar um tool call; não pode tornar segura a repetição de uma escrita que falhou.
O artigo do SWE-agent chama ao design desta interação Agent-Computer Interface (ACI), por analogia com a interação pessoa-computador: os agentes baseados em modelos de linguagem são um novo tipo de utilizador e beneficiam de interfaces construídas para eles. A sua ablação com 300 tarefas do SWE-bench Lite atingiu 18,0% com a interface completa, face a 7,3% numa condição apenas com shell sem demonstração resolvida e 11,0% com uma. As condições diferem em mais do que uma única descrição de ferramenta, por isso estes números não preveem o ganho de redesenhar as suas próprias ferramentas. Mostram, no entanto, que a interface deve ser testada juntamente com o modelo. O Building Effective Agents, da Anthropic, diz o mesmo: planeie dedicar tanto esforço à interface agente-computador como a uma interface para pessoas.
A figura segue uma chamada get_stock_snapshot pelo modelo, pelo harness e pela ferramenta, e numera cada passo com o princípio da lista abaixo que o rege. A verificação de um preço em falta é uma recomendação: a implementação do snapshot na revisão indicada atribui atualmente zero por omissão a um preço ausente.
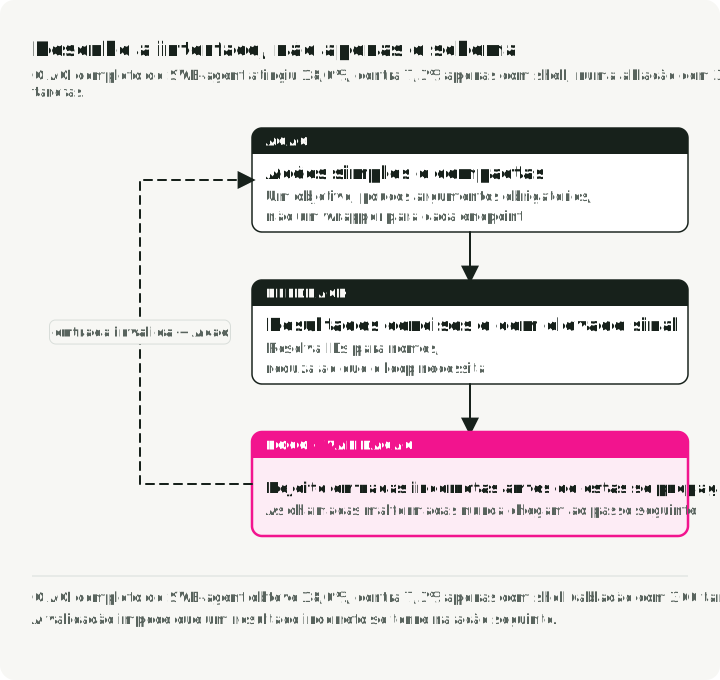
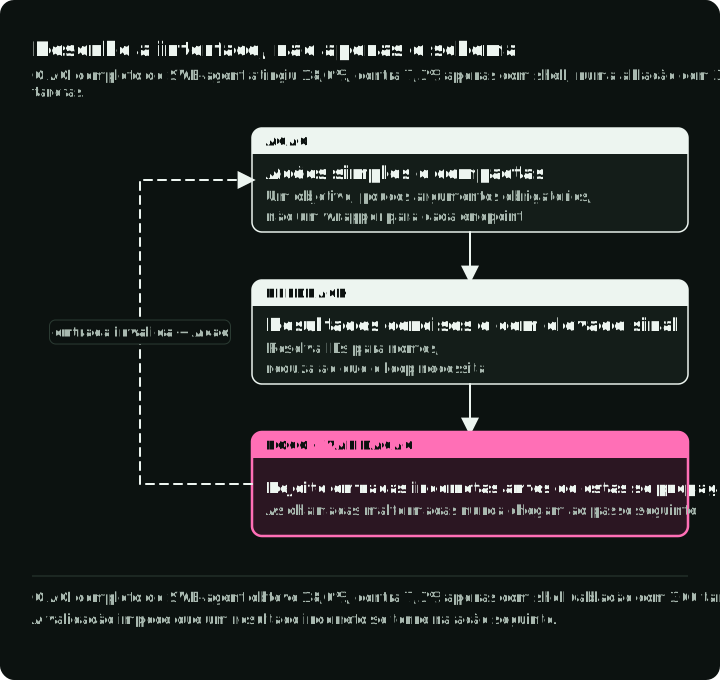
Os quatro princípios ACI aplicam-se a todas as interfaces deste artigo:
- Ações simples. Não envolva os endpoints de API um a um. Em vez de
list_users,list_eventsecreate_event, ofereçaschedule_event, que encontra disponibilidade e faz a marcação numa só chamada. Em vez deread_logs, ofereçasearch_logs, que devolve as linhas relevantes com contexto. - Ações compactas. Combine operações que servem uma mesma tarefa, como faz o snapshot da ação mais abaixo.
- Feedback conciso e informativo. Devolva nomes semânticos em vez de HTML em bruto, payloads completos de API ou IDs crípticos, mas mantenha qualquer ID de que uma chamada posterior precise.
- Validação que impede a propagação de erros. Verifique os argumentos antes da chamada e os resultados antes da ação seguinte. No SWE-agent, um editor com linting integrado rejeitava erros de sintaxe; ativá-lo elevou a condição de edição de 15,0% para 18,0%.
Uma ferramenta fácil de escolher e de usar
O Market Analyst Agent dá um exemplo concreto. Uma versão anterior expunha get_stock_price e get_company_metrics em separado. O executor expõe agora get_stock_snapshot, get_price_history, get_financials, search_news e search_competitors. O snapshot combina preço, volume, capitalização bolsista e rácio P/E, porque um resumo básico precisa normalmente deles em conjunto. O histórico, as demonstrações financeiras e as notícias ficam separados, porque o agente pode não precisar de cada um deles.
| Antes (ferramentas originais) | Depois (ferramentas de dados de mercado) | Porquê |
|---|---|---|
get_stock_price + get_company_metrics | get_stock_snapshot | Uma chamada devolve o snapshot básico de preço e avaliação |
get_price_history | get_price_history | Mantida, com períodos validados e resumo do volume médio |
search_news | search_news | Devolve itens estruturados com os pontos-chave extraídos |
search_competitors | search_competitors | Mantém a ação de pesquisa centrada nos concorrentes |
| Sem ferramenta de demonstrações financeiras | get_financials | Seleciona por parâmetro a demonstração de resultados, o balanço ou os fluxos de caixa |
A lista de ferramentas do agente inclui ainda um carregador de skills, dois wrappers de CLI e um avaliador de Python restrito que corre no próprio processo, cobrindo assim três das interfaces descritas abaixo; o MCP aparece como um sidecar à parte.
Trata-se de uma escolha sobre o tamanho da ação. Um wrapper um a um de cada endpoint upstream obriga o modelo a planear em torno da organização da API do fornecedor. Uma única ferramenta com muitos modos sem relação entre si limita-se a transferir o problema de seleção para os argumentos. Agrupe os campos que servem a mesma tarefa e depois teste se os agentes escolhem a ação certa.
Escreva a descrição para o modelo
A descrição do snapshot diz quando o chamar primeiro, o que devolve e quando escolher antes o histórico ou as demonstrações financeiras. Essa orientação sobre as ferramentas vizinhas é tão importante como o nome. “Search for items” não consegue dizer ao modelo se é search_news ou search_competitors que responde a um pedido. O guia de design de ferramentas da Anthropic também recomenda descrições, exemplos e resultados que ajudem um modelo a escolher a ação certa, e a documentação sobre definição de ferramentas sugere pelo menos três ou quatro frases que cubram quando usar a ferramenta, os seus parâmetros, a sua saída e os casos-limite:
# Vague: the model cannot tell when to use it.
vague = [{"name": "search", "description": "Search for items"}]

# Specific: when to use it, what it returns, and which tool to use instead.
specific = [{
    "name": "search_news",
    "description": (
        "Search for recent news articles about a specific stock or company. "
        "Use this tool when the user asks about recent events, earnings, "
        "announcements, or market-moving news for a specific ticker. "
        "Returns up to 10 articles sorted by relevance. "
        "For company competitors rather than news, use search_competitors instead."
    ),
    "input_schema": {
        "type": "object",
        "properties": {
            "query": {
                "type": "string",
                "description": "Search query. Examples: 'NVDA earnings Q3 2025', 'Tesla delivery numbers'",
            },
            "max_results": {
                "type": "integer",
                "description": "Max articles to return (1-10, default 5)",
                "default": 5,
            },
        },
        "required": ["query"],
    },
}]
Acrescente exemplos onde os parâmetros sejam ambíguos; não gaste contexto a repetir o que um schema simples já diz. Nos testes internos da Anthropic, acrescentar um campo input_examples elevou a precisão no tratamento de parâmetros complexos de 72% para 90%. A Anthropic refere também que usar o espaço de nomes como prefixo ou sufixo (asana_search ou search_asana) teve efeitos apreciáveis nas suas avaliações, sem dizer qual ganhou, por isso teste ambos no seu conjunto de ferramentas. Depois entregou transcrições de avaliação ao Claude Code para reescrever as ferramentas e, em testes reservados, esse ciclo superou as ferramentas escritas por especialistas.
Valide os argumentos e dê forma aos resultados
A implementação valida o ticker antes do pedido de dados de mercado. Este excerto foi adaptado do código indicado; o normalizador partilhado remove espaços, passa o valor para maiúsculas e aceita sufixos com ponto ou hífen, como BRK.B e BF-B. A consulta de histórico acrescenta um conjunto de períodos permitidos:
from pydantic import BaseModel, Field, field_validator

from market_analyst.utils import normalize_ticker

class StockQuery(BaseModel):
    ticker: str = Field(description="Stock ticker symbol (e.g., NVDA)")

    @field_validator("ticker")
    @classmethod
    def validate_ticker(cls, value: str) -> str:
        return normalize_ticker(value)

class StockHistoryQuery(StockQuery):
    period: str = Field(default="1mo", description="Time period: 1d, 5d, 1mo, 3mo, 6mo, 1y")

    @field_validator("period")
    @classmethod
    def validate_period(cls, value: str) -> str:
        valid = {"1d", "5d", "1mo", "3mo", "6mo", "1y"}
        if value not in valid:
            raise ValueError(f"Invalid period: {value}. Must be one of {valid}")
        return value
As ferramentas de ações e de notícias devolvem resultados validados com Pydantic em vez de payloads em bruto do fornecedor. O campo summary dá ao agente uma string pronta para um relatório, e os key_points poupam-lhe a análise do corpo dos artigos:
from pydantic import BaseModel

class StockSnapshot(BaseModel):
    ticker: str
    price: float
    change_pct: float
    volume: int
    market_cap_b: float
    pe_ratio: float | None
    summary: str  # One line for direct use in a report

class NewsItem(BaseModel):
    headline: str
    source: str
    date: str
    relevance_score: float  # Pre-ranked by the tool
    key_points: list[str]  # Extracted by the tool, not the agent

class NewsSearchResult(BaseModel):
    query: str
    results: list[NewsItem]
    summary: str
O resultado do snapshot tem estes campos tipados para preço, variação percentual, volume, capitalização bolsista, rácio P/E e um breve resumo. Acrescente ao resultado a fonte dos dados e a hora de referência do mercado, e faça o relatório indicá-las. Obter os dados agora não prova que a cotação seja atual.
Mantenha os resultados curtos o suficiente para a decisão seguinte, mas não descarte um identificador ou uma fonte de que uma ação posterior precise. Num resultado de pesquisa, um título e um resumo podem bastar para ordenar candidatos; o URL ou o ID tem de continuar disponível se o agente tiver de obter ou citar um item concreto. Um resultado conciso e um detalhado podem servir passos diferentes: os testes da Anthropic acrescentaram um parâmetro response_format que devolvia cerca de 72 tokens no modo conciso e 206 no modo detalhado. Os payloads upstream em bruto raramente são uma predefinição útil.
Devolva erros sobre os quais o ciclo possa agir
Os erros fazem parte do mesmo contrato. Não atribua zero por omissão a um preço em falta, porque uma cotação indisponível passa então a parecer um preço de zero dólares. Também não envolva todas as falhas finais num único tipo de exceção, porque quem chama deixa de conseguir escolher uma categoria de nova tentativa. Rejeite dados de mercado em falta e distinga entre entrada inválida, falha temporária do fornecedor e dados indisponíveis. Numa ferramenta que escreve estado externo, tem também de distinguir uma falha conhecida de um resultado que pode ter sido concluído apesar de a resposta se ter perdido. Devolva detalhe suficiente para escolher entre nova tentativa, pedido de esclarecimento ou escalamento; impeça que o texto do fornecedor se torne uma instrução para o modelo.
Quatro mecanismos tratam classes de falha diferentes: nova tentativa com backoff para erros transitórios, fallback de modelo para falhas do fornecedor, uma classificação que devolve ao agente os erros recuperáveis e escala os restantes, e recuperação a partir de checkpoint em caso de crash (Parte 2). Repita apenas falhas transitórias, como timeouts, erros de rede e respostas 429 e 5xx, com backoff exponencial e um limite pequeno de tentativas; uma biblioteca como a Tenacity faz isto num decorador. Quem chama continua a ter de transformar uma exceção final, ou um 4xx que não deve ser repetido, num resultado estável que diga que operação falhou e o que fazer a seguir. Repetir um pedido não classifica o seu erro, e só é seguro para uma leitura ou uma escrita idempotente. Meça a taxa de recuperação, as novas tentativas e os escalamentos no seu próprio conjunto de tarefas.
Experimente o contrato
A partir do repositório de apoio, instale as dependências bloqueadas e execute os testes das ferramentas:
uv sync --locked
uv run pytest tests/test_tools.py -q
O teste do snapshot injeta dados de mercado sintéticos e verifica o ticker, o preço, o volume, os campos de avaliação e o resumo. Testa o contrato da ferramenta sem cotação em tempo real nem modelo; não mede se um agente escolhe a ferramenta certa. Com as credenciais do fornecedor configuradas como descreve o README do repositório, também pode executar uv run market-analyst "NVDA price update" --mode flash --no-persist para analisar um rascunho produzido pelo agente. Essa execução usa serviços em tempo real e é um exemplo, não um benchmark.
Escolha a interface de execução
Quando o contrato da ação estiver claro, escolha como o agente lhe chega. Estas interfaces respondem a perguntas diferentes; uma mais recente não substitui uma mais antiga.
A figura traça cada rota do Market Analyst Agent, do modelo até à operação que alcança.
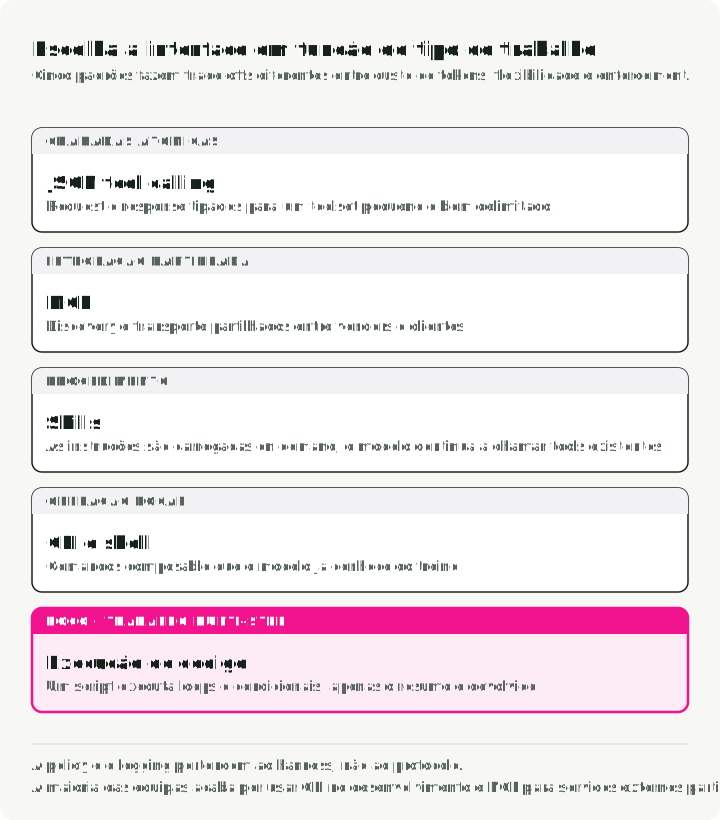
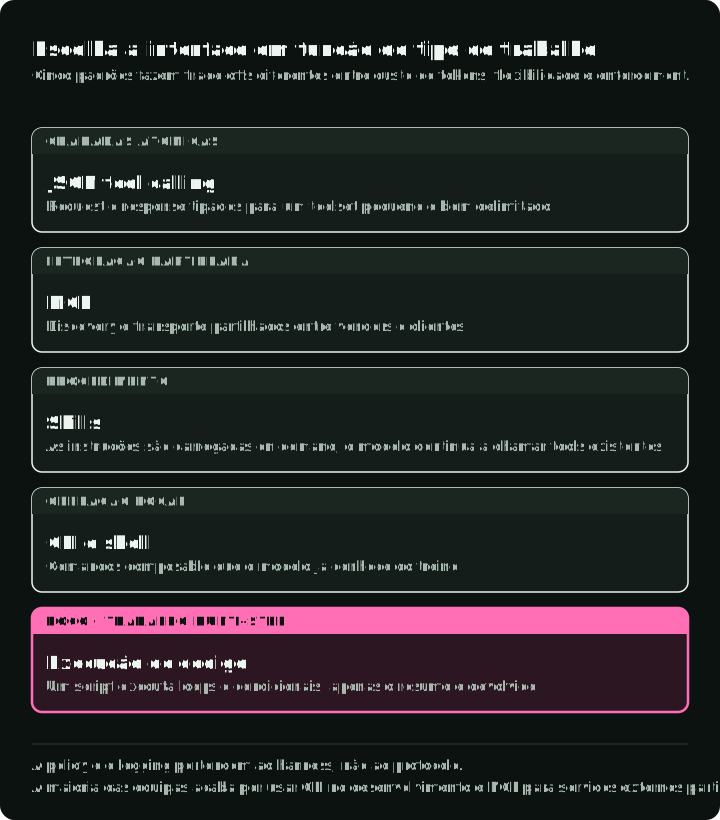
| Necessidade | Interface inicial | O que acrescenta |
|---|---|---|
| Um pequeno conjunto de operações tipadas numa aplicação | Tool calls JSON | Nomes, argumentos e resultados explícitos |
| As mesmas ferramentas servidas a vários clientes | MCP | Descoberta e transporte partilhados |
| Um comando existente com saída estável | Wrapper de CLI | Reutilização do comando e da sua ajuda |
| Muitas operações dependentes ou processamento local de dados | Execução de código | Ciclos, condições e filtragem dentro de uma execução |
| Instruções reutilizáveis para qualquer das anteriores | Skill | Orientação carregada quando é relevante |
A tabela dá uma primeira escolha; não ordena as interfaces por desempenho. As ferramentas MCP continuam a ter schemas e chamadas estruturadas. Uma CLI pode ficar por trás de um wrapper de ferramenta JSON. Um executor de código pode chamar ferramentas permitidas. As Skills são instruções para usar uma capacidade, não mais um canal de execução.
Chamadas tipadas para ações delimitadas
Para get_stock_snapshot(ticker), basta uma chamada tipada. O modelo fornece um ticker; o harness verifica o argumento, invoca a implementação e devolve um resultado estruturado. A chamada seguinte pode depender desse resultado. Consultas independentes podem muitas vezes correr em paralelo, mas uma chamada cujos argumentos dependem do primeiro resultado precisa de outro passo do modelo, a menos que o código da aplicação combine as operações.
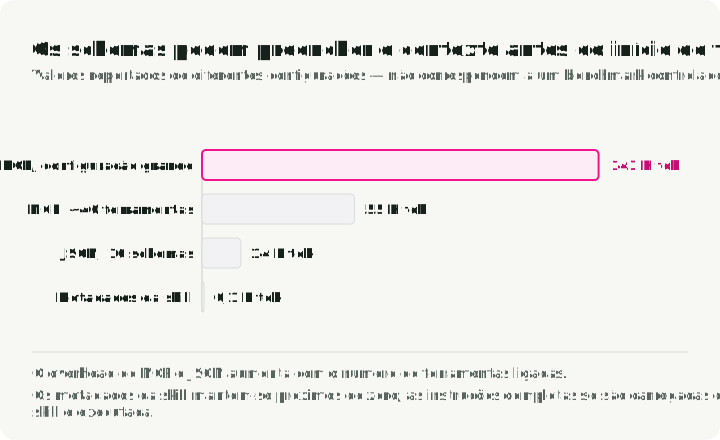
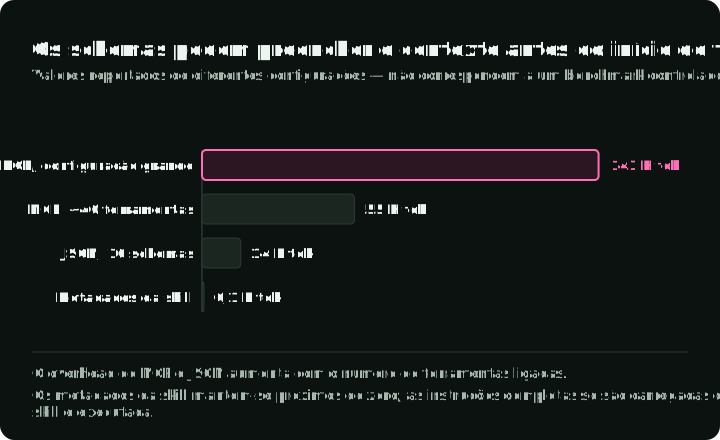
O baixo custo de configuração é útil quando uma aplicação detém um pequeno conjunto de ferramentas. Os tokens dos schemas continuam a contar quando as definições de ferramentas são carregadas no contexto, por isso meça o tamanho das suas definições reais. Se o catálogo crescer, a descoberta diferida pode carregar apenas as candidatas prováveis. No exemplo de Tool Search da Anthropic, o contexto aproximado antes do trabalho desceu de 77 000 para 8700 tokens numa configuração com mais de 50 ferramentas, ao carregar apenas as três a cinco ferramentas de que um pedido precisa. É um resultado do seu conjunto de ferramentas e do seu método de pesquisa, e acrescenta um passo de descoberta antes de cada chamada. Ajuda menos num pequeno conjunto de ferramentas usado em todas as sessões. A descoberta também tem de ser testada contra ferramentas omitidas ou incorretas.
Carregar um schema tende a ser unidirecional: uma definição que o modelo pode chamar vinte passos depois tem de continuar disponível, e removê-la altera a parte estável do pedido de que depende o prefix caching, pelo que um passo de descoberta normalmente acrescenta definições e nunca troca uma por outra. Um schema que o modelo ainda consegue ver também não é uma permissão que o modelo ainda detém. Registe a versão do schema e a permissão efetiva no momento da descoberta e volte a verificar a permissão quando a chamada é enviada para execução.
Quando um resultado é encurtado para caber no orçamento, diga-o no próprio resultado e dê ao modelo uma forma de pedir um intervalo de linhas ou de bytes da saída completa, para que distinga uma resposta curta de uma truncada e peça o resto quando isso importar.
O gráfico coloca este exemplo na mesma escala de tokens que as configurações MCP descritas mais adiante nesta secção.
MCP para um serviço partilhado
O Model Context Protocol permite que um servidor anuncie ferramentas e outras capacidades aos clientes através de stdio ou HTTP. O cliente MCP do agente liga-se, pergunta ao servidor o que ele oferece e reencaminha as chamadas do modelo, de modo que um servidor funciona com qualquer cliente que fale o protocolo. Desde dezembro de 2025, o MCP é gerido pela Agentic AI Foundation no âmbito da Linux Foundation, e não por um único fornecedor.
Use MCP quando um serviço deve estar acessível a partir de vários hosts de agentes, para integrações SaaS como Figma, Notion ou Salesforce, para serviços sem CLI, ou quando a descoberta normalizada, o tratamento de OAuth e a integração remota justificam o custo de operar um servidor. O Market Analyst Agent também expõe as suas ferramentas de investigação através de um sidecar MCP. A ação sobre ações cotadas não passou a ser outra operação de negócio só porque o cliente a descobre através de MCP.
O protocolo não autoriza um efeito de negócio pedido. O servidor e a aplicação continuam a precisar de autenticação, permissões delimitadas, verificações de entrada e um registo de auditoria para as operações que importam. As descrições de ferramentas e os documentos devolvidos também são entradas não fiáveis; a demonstração de tool poisoning da Invariant Labs mostra que instruções maliciosas nos metadados de uma ferramenta podem influenciar um agente antes de a ferramenta ser chamada. O benchmark MCPTox, que testou 20 agentes LLM contra 45 servidores MCP ativos e 353 ferramentas reais, reportou a maior taxa de sucesso de ataque, 72,8%, para o o1-mini na sua configuração de tool poisoning; é o resultado de benchmark de um modelo, não uma taxa de incidentes. O Vulnerable MCP Project reúne relatos úteis como casos de teste. O host tem de tratar o texto das ferramentas como dados, não como concessão de autoridade.
Verifique que revisão do MCP cada lado suporta. A revisão 2026-07-28 torna os pedidos sem estado, substituindo o handshake de inicialização, e remove a retoma de streams, por isso tutoriais mais antigos podem não corresponder ao SDK que instalar. Um stream de resposta interrompido precisa então de um novo pedido, mais uma razão para evitar efeitos de negócio duplicados na própria ferramenta. Inspecione o SDK instalado e o contrato do servidor antes de depender de uma funcionalidade. Para uma chamada que demora mais do que uma resposta, a extensão Tasks oficial acrescenta um identificador duradouro: o servidor devolve um ID de tarefa, e o cliente consulta ou cancela o trabalho com tasks/get e tasks/cancel. A Parte 6 usa esse identificador quando uma chamada excede o tempo limite.
Catálogos grandes podem sair caros se todas as descrições forem carregadas em todos os pedidos. A Apideck descreve uma configuração comum, GitHub, Slack e Sentry com cerca de 40 ferramentas, que carrega aproximadamente 55 000 tokens de definições antes de o utilizador perguntar alguma coisa, e cita uma equipa cujos três servidores MCP ocupavam 143 000 de 200 000 tokens de contexto. Ambos são números reportados, não medições do seu catálogo. É uma decisão sobre o carregamento de schemas, não um preço inerente ao protocolo de transmissão do MCP. Sempre que possível, carregue um conjunto relevante mais pequeno e meça se a descoberta continua a encontrar a ferramenta certa.
Wrappers de CLI para comandos estabelecidos
Uma CLI é atrativa quando a operação já existe como comando com um --help útil, códigos de saída estáveis e saída legível por máquina. As ferramentas CLI do Market Analyst Agent envolvem dois comandos específicos para listar e mostrar relatórios guardados. Passam uma lista de argumentos a subprocess.run e pedem JSON; o agente não recebe uma shell arbitrária. Essa distinção torna visível a ação permitida e evita tratar como fiável cada string de comando gerada.
Um comando amplamente documentado como git, gh, docker, kubectl, curl ou jq pode exigir pouca documentação nova para um agente de programação, mas uma CLI interna continua a precisar de exemplos e de contratos de saída. O guia de Ugo Enyioha Writing CLI Tools That AI Agents Actually Want to Use enumera oito regras para um comando assim:
- Suportar saída estruturada com
--json. - Usar códigos de saída distintos para tipos de erro diferentes.
- Tornar os comandos idempotentes.
- Fornecer
--helpcom exemplos realistas. - Suportar composição:
--quietpara valores simples e entrada a partir de stdin. - Fornecer
--dry-rune--yes. - Indicar a versão da ferramenta.
- Obter as credenciais a partir de variáveis de ambiente.
Uma shell acrescenta pipes e composição, juntamente com acesso a ficheiros, processos, credenciais e caminhos de rede. Dê-lhe apenas o acesso que a tarefa exige. Uma CLI não tem um modelo de descoberta nem de autorização ao nível do protocolo; o harness tem de aplicar a política e registar as chamadas que precisa de auditar. Uma predefinição prática é CLI para desenvolvimento e operações locais, e MCP para serviços externos partilhados quando a descoberta entre clientes ou o tratamento de OAuth justificam operar um servidor.
Na comparação de 75 execuções da Scalekit, a CLI usou menos tokens em cinco tarefas de GitHub só de leitura do que uma configuração que carregava 43 tool schemas MCP. As suas sete falhas de MCP foram timeouts de ligação ao servidor remoto. Estes resultados comparam essas interfaces tal como foram implementadas, não uma propriedade geral de que a CLI seja mais fiável ou de que o MCP exija mais contexto. Repita a comparação com os comandos, o servidor e a política de descoberta que implementaria de facto.
Execução de código para composição
Um programa gerado é útil quando o agente tem de combinar muitas chamadas, filtrar dados intermédios ou fazer cálculos sobre um resultado grande. Em vez de passar cada linha pelo modelo e lhe pedir que planeie a operação seguinte, um runtime pode executar um ciclo e devolver o resumo relevante. O artigo do CodeAct testou 17 modelos e encontrou até 20 pontos percentuais a mais de sucesso nas suas 82 tarefas com várias ferramentas, com até 30% menos ações do que as alternativas JSON. É um motivo para experimentar a interface em trabalho semelhante, não para substituir uma consulta tipada única por um executor de código.
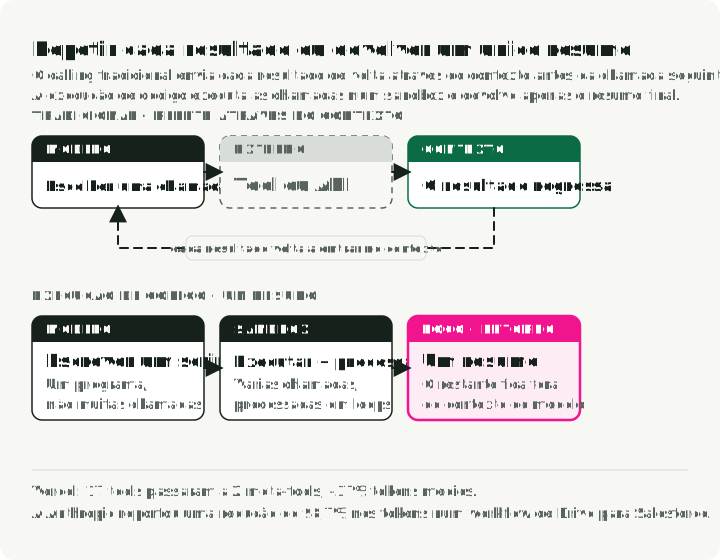
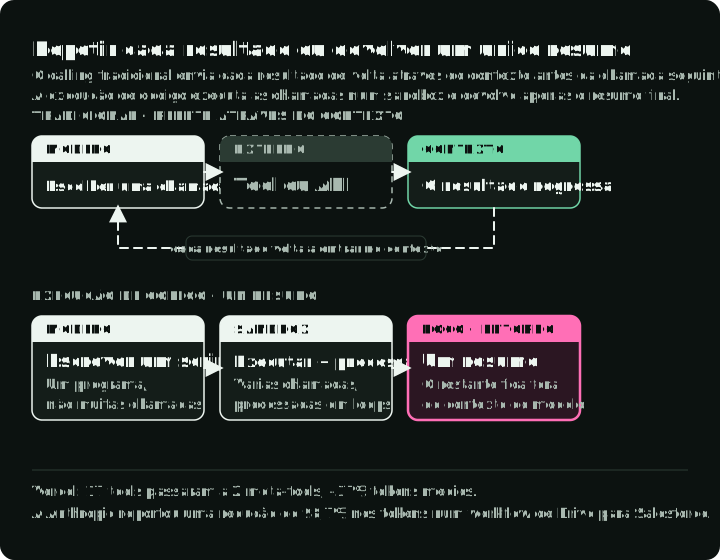
A figura executa a verificação de despesas da Anthropic, descrita abaixo, das duas maneiras e compara o que chega ao contexto do modelo.
Há aqui dois padrões diferentes. A ferramenta de código do Market Analyst Agent aceita Python para cálculos sobre dados que já lhe foram fornecidos. Não deixa esse código chamar as ferramentas de dados de mercado. Verifica os nós da árvore sintática e depois executa o código dentro do processo da aplicação. Essa lista de permissões é uma restrição didática, não uma sandbox de segurança para código não fiável. Antes de expor código gerado arbitrário ou recursos sensíveis do processo, a execução precisa de um runtime isolado com limites de recursos e de acesso.
O Programmatic Tool Calling da Anthropic (PTC) é uma organização diferente: o código gerado pode invocar ferramentas ativadas especificamente dentro de um ambiente de execução gerido e devolver um resultado selecionado ao contexto do modelo. No exemplo de análise de despesas da Anthropic, chamar ferramenta a ferramenta exige mais de 20 passagens do modelo, com cada linha a passar pelo contexto; o código gerado reduziu o que chegava ao contexto de cerca de 200 KB de linhas de despesas para 1 KB de resultados. O script abaixo mostra esse fluxo de controlo com adaptadores assíncronos de Python comuns, não com os wrappers nativos de PTC:
# Custom async adapters that return decoded Python objects, not native PTC wrappers.
import asyncio
import json

async def main() -> None:
    team = await get_team_members("engineering")
    levels = list({member["level"] for member in team})
    budgets = dict(zip(levels, await asyncio.gather(*(get_budget_by_level(l) for l in levels))))
    expenses = await asyncio.gather(*(get_expenses(member["id"], "Q3") for member in team))
    over_budget = []
    for member, rows in zip(team, expenses):
        total = sum(row["amount"] for row in rows)
        limit = budgets[member["level"]]["travel_limit"]
        if total > limit:
            over_budget.append({"name": member["name"], "spent": total, "limit": limit})
    print(json.dumps(over_budget))  # Only this summary returns to the model

asyncio.run(main())
Os wrappers nativos de PTC diferem destes adaptadores nos formatos de argumentos e de retorno, e nem todos os tipos de ferramenta podem ser chamados a partir de código; consulte o guia atual antes de portar um script. A definição allowed_callers da API orienta a invocação, mas não substitui a autorização pelo host de cada efeito subjacente, incluindo uma chamada direta inesperada. Manter as linhas intermédias fora do contexto do modelo poupa tokens, mas não as torna confidenciais em relação ao ambiente de execução nem as isenta de registo e controlos de acesso.
O benefício depende da forma da tarefa. Nas avaliações internas da Anthropic, um benchmark de gestão de projetos com 75 ferramentas usou cerca de 38% menos tokens de entrada faturados, com a mesma precisão. Em tarefas do tau2-bench com uma ou duas chamadas sequenciais por turno, as pontuações não mudaram e o custo foi cerca de 8% superior. Um exemplo separado de Drive para Salesforce desceu de cerca de 150 000 para 2000 tokens, uma redução de 98,7% para esse workflow. Nenhum destes valores é uma taxa universal de código face a JSON. A geração de código, o arranque do runtime, as falhas e o tratamento da saída podem superar a poupança de contexto em tarefas simples.
Dois estudos de caso de fornecedores mostram o mesmo design em produtos. A Vercel reconstruiu o seu agente text-to-SQL d0 em torno de duas ferramentas gerais, ExecuteCommand e ExecuteSQL, em vez das 17 indicadas no seu exemplo antigo. Em cinco consultas representativas, reporta que o sucesso subiu de 4/5 para 5/5, o tempo médio desceu de 274,8 s para 77,4 s e os tokens diminuíram 37%. No Code Mode da Cloudflare, os agentes escrevem código TypeScript que usa uma API em vez de chamarem tool schemas, com o argumento de que os modelos viram muito mais TypeScript real do que exemplos de tool calls. Trate ambos como evidência de fornecedores e repita a comparação nas suas tarefas.
O tool calling JSON continua a ser a melhor opção para operações atómicas únicas, ambientes sem sandboxing, modelos mais pequenos com fraca geração de código e regras de auditoria que exigem um registo de cada chamada individual.
Skills para procedimentos
Uma Agent Skill empacota um ficheiro SKILL.md com um nome, uma descrição e instruções; pode também conter scripts e referências. A norma aberta exige apenas name e description. Uma skill mínima para este agente poderia ser assim:
---
name: stock-overview
description: Prepare a short overview of one stock. Use when the user asks for a current snapshot of a company.
---
1. Call get_stock_snapshot for the ticker.
2. If the result has no market timestamp, say that freshness is unknown.
3. Call search_news only if the user asked about recent events.
4. Cite every news item you use.
A skill diz ao agente como usar as suas ferramentas; não acrescenta nenhuma capacidade nova. Use skills para conhecimento do domínio, procedimentos com vários passos e trabalho recorrente, como migrações de bases de dados ou integrações de pagamentos. O host continua a determinar que ferramentas o agente pode executar. O texto de uma skill é orientação, não aplicação de políticas.
O formato permite carregar o nome curto e a descrição, cerca de 100 tokens, antes das instruções completas; os scripts e ficheiros referenciados só são carregados quando necessário. Isso ajuda quando existem muitos procedimentos, mas a skill ativa e os ficheiros que ela carrega continuam a consumir contexto. Reveja as suas instruções e ficheiros executáveis como qualquer outra entrada do harness. Se um workflow for crítico para a segurança, codifique a validação necessária na ferramenta ou na aplicação em vez de confiar em que uma instrução seja seguida.
Uma skill carregada também pode piorar os resultados. Um estudo de 2026 sobre o SkillsBench e o SWE-Skills-Bench atribuiu 307 falhas a skills carregadas específicas: 125 falhas funcionais, em que o resultado da tarefa estava errado, e 182 regressões de eficiência, em que a execução custou mais. São falhas que os autores conseguiram atribuir em dois benchmarks, não uma taxa de falhas das skills em geral. Execute uma skill nova em tarefas representativas, com e sem ela, antes de depender dela. As diretrizes do Agent Framework da Microsoft também limitam as skills a operações idempotentes ou de baixo risco e preferem um workflow explícito quando um passo tem um efeito colateral, como um pagamento, que não deve repetir-se numa nova tentativa. As suas ferramentas de skills exigem aprovação por defeito.
Compare as interfaces
| Pergunta | Tool calls JSON | MCP | Skills | CLI | Execução de código |
|---|---|---|---|---|---|
| Mais indicado para | Ações simples e únicas | Serviços partilhados entre clientes | Procedimentos reutilizáveis para outra interface | Desenvolvimento e operações locais | Trabalho com vários passos sobre resultados grandes |
| Custo de contexto | Schemas carregados | Schemas carregados ou diferidos | Cerca de 100 tokens até ser ativada | Texto de ajuda, comando e saída | Schemas de entrada, código e saída |
| Chamadas dependentes | Normalmente um turno do modelo por chamada | Um turno do modelo mais o transporte | Segue a interface subjacente | Normalmente um turno do modelo por chamada | Um turno para o script; o runtime executa o fluxo |
| Superfície de segurança | Autoridade sobre argumentos e efeitos | Identidade do servidor e autoridade das ferramentas | O host e os recursos que concede | Shell, caminhos, credenciais | Código, acesso a dados e tráfego de rede de saída |
| Configuração | Baixa | Implementação do servidor | Baixa; depende da interface subjacente | Muito baixa para comandos existentes | Um runtime em sandbox |
| Depuração | Entrada e saída estruturadas | Acrescenta uma camada de transporte | Markdown legível | Os comandos são visíveis | Código legível |
As Skills orientam uma das outras quatro interfaces, por isso a sua latência e configuração seguem a interface que selecionam. As linhas resumem os exemplos citados, não um benchmark controlado das cinco.
Alguns compromissos atravessam a tabela. A execução de código pode poupar contexto, mas acrescenta tempo de geração e de contentor. O MCP poupa trabalho de integração, mas acrescenta um servidor para operar. A CLI não custa nada para começar e é mais difícil de governar em escala. Ajuste a interface à sua equipa: a execução de código pressupõe um modelo que escreve código fiável, a CLI pressupõe convenções Unix e o MCP pressupõe familiaridade com transportes e OAuth. A consolidação de ferramentas também pode ir longe demais, quando uma ferramenta junta modos sem relação entre si. As chamadas estruturadas são fáceis de registar, mas nenhum protocolo cria por si só um registo de auditoria completo; o host, o servidor ou o harness registam chamadas e resultados e aplicam a política.
Um primeiro conjunto de testes para a interface
Uma lista de ferramentas mais pequena ou um prompt mais barato só é útil se o agente continuar a concluir o trabalho. Compare interfaces com o mesmo conjunto de tarefas, modelo, dados, operações permitidas e regras de conclusão. Inclua casos em que o passo seguinte correto seja pedir esclarecimento ou parar.
Para o Market Analyst Agent, um primeiro conjunto de testes poderia incluir estes casos:
| Pedido ou condição | O que inspecionar |
|---|---|
| Resumo básico de uma ação | Ticker correto, campos do snapshot, fonte e hora do mercado na resposta |
| É preciso o histórico de preços, mas não notícias | O agente seleciona o histórico sem chamadas desnecessárias |
| O fornecedor não devolve um preço válido | Nenhuma cotação inventada; a execução reporta dados indisponíveis |
| Grande conjunto de consultas independentes | Qualidade da resposta final, turnos do modelo, tokens de entrada/saída, latência e falhas do runtime |
| Operação de compra ou venda proposta durante uma investigação | Nenhum efeito de compra ou venda; a lista de ferramentas de investigação não concede essa ação |
Registe os tool calls e os seus resultados, além da resposta final. Um relatório plausível pode esconder uma consulta falhada; um preço final correto pode esconder chamadas desnecessárias. Se uma interface mudar, conte tanto as tarefas bem-sucedidas como os novos modos de falha: seleção errada de ferramentas, argumentos inválidos, descoberta falhada, efeitos secundários repetidos, erros de sintaxe e timeouts. Registe também os tokens de descoberta, a entrada com e sem cache e as novas tentativas.
Pode então mudar a interface quando uma medição o justificar. Mantenha uma chamada tipada enquanto ela resolver a tarefa de forma limpa. Acrescente MCP quando for necessária descoberta partilhada, um wrapper de CLI quando um comando existente for a operação mais clara, ou execução de código quando ganhos medidos de composição justificarem o seu runtime. O contrato da ação, ou seja, o que pode acontecer, que resultado o prova e o que significa uma falha, continua a ter de ser explícito.
Três direções para o tool use em escala
Recuperação de ferramentas. Antes de o modelo escolher, recupere as poucas descrições de ferramentas que correspondem ao pedido. No benchmark e no teste de stress de MCP do RAG-MCP, a recuperação elevou a precisão na seleção de ferramentas de 13,62% para 43,13% e reduziu os tokens do prompt de cerca de 2134 para 1084. As descrições da configuração diferem entre secções do artigo, o que limita até onde os números se podem generalizar.
Agentes que criam ferramentas. No LATM, um modelo forte escreve funções Python reutilizáveis que um modelo mais pequeno depois chama. O ToolMaker implementou corretamente 12 de 15 tarefas construídas a partir de artigos com código público. Esse benchmark pequeno não estabelece fiabilidade em produção, mas aponta para a gestão de uma biblioteca de ferramentas geradas.
A2A ao lado do MCP. A Google transferiu o A2A para a Linux Foundation em junho de 2025. A documentação do A2A divide os papéis: o MCP liga um agente a ferramentas e recursos, enquanto o A2A permite que agentes separados se descubram uns aos outros, partilhem tarefas e deleguem trabalho.
A Parte 4, AI Agent Security, acompanha a ação proposta até à sua verificação de permissões. A Parte 5, Agent Runtime, coloca a execução dentro de um runtime recuperável. A Parte 6, Harness Engineering for AI Agents, junta o ciclo, as ferramentas, a política e a verificação de conclusão.
Referências
Artigos científicos
- Executable Code Actions Elicit Better LLM Agents (CodeAct) — Wang et al., ICML 2024
- SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering — Yang, Jimenez et al., NeurIPS 2024
- RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection
- LLMs As Tool Makers (LATM) — Cai et al., 2023
- ToolMaker: LLM Agents Making Agent Tools — Wölflein et al., ACL 2025
- MCPTox: A Benchmark for Tool Poisoning Attack on Real-World MCP Servers
- Agent Skills Can Be Harmful: An Empirical Study of Skill-Induced Failures in LLM Agents — Dong et al., 2026
Engenharia e documentação da Anthropic
- Advanced tool use — Tool Search, Programmatic Tool Calling e exemplos de entrada
- Programmatic tool calling — guia atual da API e restrições
- Code execution with MCP — o exemplo de Drive para Salesforce
- Writing effective tools for agents
- Building effective agents
Protocolos
- Especificação do Model Context Protocol, 2026-07-28 e registo de alterações
- MCP Tasks extension
- Especificação das Agent Skills
- Microsoft Agent Framework: Agent Skills
- A2A and MCP
Estudos de caso e segurança
- Vercel: We removed 80% of our agent’s tools
- Cloudflare: Code Mode
- Apideck: MCP server eating your context window
- Scalekit: MCP vs CLI
- Invariant Labs: MCP tool poisoning attacks
- Vulnerable MCP Project
- Writing CLI Tools That AI Agents Actually Want to Use — Ugo Enyioha
Projeto de demonstração
- Market Analyst Agent — consolidação de ferramentas e padrões ACI