AI Agent Tool Use : MCP, CLI, Skills et exécution de code

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Cet article s’adresse aux ingénieurs qui donnent à un agent l’accès à des données, à des commandes ou à des services externes. Vous verrez comment définir une action que l’agent peut utiliser de manière fiable, choisir une interface d’exécution pour cette action et vérifier si cette interface aide sur vos tâches. L’exemple suivi tout au long de l’article est le Market Analyst Agent, un agent de recherche qui récupère des données de marché et prépare des rapports.
Dans la partie 1, le modèle choisissait l’étape suivante dans un reasoning loop. La partie 2 traitait de ce qu’il peut conserver d’une étape à l’autre. Un outil donne à ce choix un effet en dehors du modèle : il peut récupérer une cotation, lire un rapport enregistré, exécuter du code ou modifier un enregistrement. Le programme qui entoure le modèle, le harness, décide toujours quelles actions existent et si un appel proposé peut s’exécuter.
La première décision de conception porte sur l’action elle-même. Si l’agent a besoin de données de cours et de valorisation pour un rapport, doit-il appeler deux endpoints d’API, demander un snapshot de l’action ou générer un programme ? La réponse dépend de la tâche et du retour dont l’agent a besoin, pas du protocole d’intégration.
Pour la décision rapide sur l’interface, consultez AI Agent Tool Interfaces.
Ce dont a besoin une présentation d’entreprise
Supposons que l’utilisateur demande au Market Analyst Agent une présentation à jour d’une entreprise. L’agent peut avoir besoin d’une cotation récente, du volume d’échanges, d’indicateurs de valorisation, de l’historique des cours et d’actualités. Ce sont des questions différentes. La dernière cotation et les indicateurs de base relèvent souvent de la même réponse, alors que l’historique des cours et les actualités peuvent être superflus pour une réponse courte. Une capacité sans rapport, comme exécuter un ordre de bourse, ne doit pas entrer dans ce parcours de recherche.
Avant d’exposer une API, notez quatre choses :
- Action : Que peut demander l’agent en une étape ? Préférez une opération qui correspond à une question à laquelle il doit réellement répondre.
- Arguments : Quelles entrées l’appelant doit-il fournir, et lesquelles l’application peut-elle valider avant de contacter le service ?
- Résultat : Quels faits permettent à l’agent de décider de l’étape suivante, et quelles informations de provenance ou quels identifiants doivent être conservés pour des vérifications ultérieures ?
- Échec et effet : Qu’est-ce qui peut changer, comment un appelant peut-il savoir si l’action a eu lieu, et quand une nouvelle tentative est-elle sûre ?
Ces questions séparent trois responsabilités. Le modèle propose une action. Le harness la valide et la route. L’implémentation de l’outil l’exécute et renvoie un résultat. Un JSON Schema peut rejeter un ticker mal formé ; il ne peut pas établir qu’un ordre de bourse est autorisé. Un protocole peut transmettre un tool call ; il ne peut pas rendre sûre la répétition d’une écriture qui a échoué.
L’article SWE-agent appelle la conception de cette interaction une Agent-Computer Interface (ACI), par analogie avec l’interaction homme-machine : les agents fondés sur des modèles de langage sont un nouveau type d’utilisateur et bénéficient d’interfaces conçues pour eux. Son ablation sur 300 tâches de SWE-bench Lite atteignait 18,0 % avec l’interface complète, contre 7,3 % pour une condition limitée au shell sans démonstration détaillée et 11,0 % avec une démonstration. Les conditions diffèrent par plus qu’une simple description d’outil, donc ces chiffres ne prédisent pas le gain d’une refonte de vos propres outils. Ils montrent en revanche que l’interface doit être testée avec le modèle. Building Effective Agents, d’Anthropic, dit la même chose : prévoyez autant d’effort pour l’interface agent-ordinateur que pour une interface destinée à des humains.
La figure suit un appel get_stock_snapshot à travers le modèle, le harness et l’outil, et numérote chaque étape avec le principe de la liste ci-dessous qui s’y applique. Le contrôle d’un prix manquant est une recommandation : l’implémentation du snapshot à la révision indiquée remplace actuellement un prix absent par zéro.
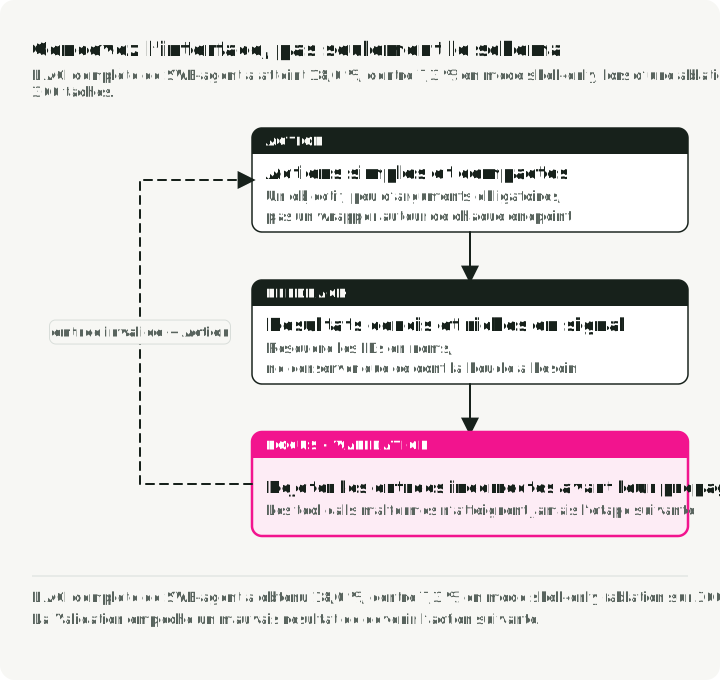
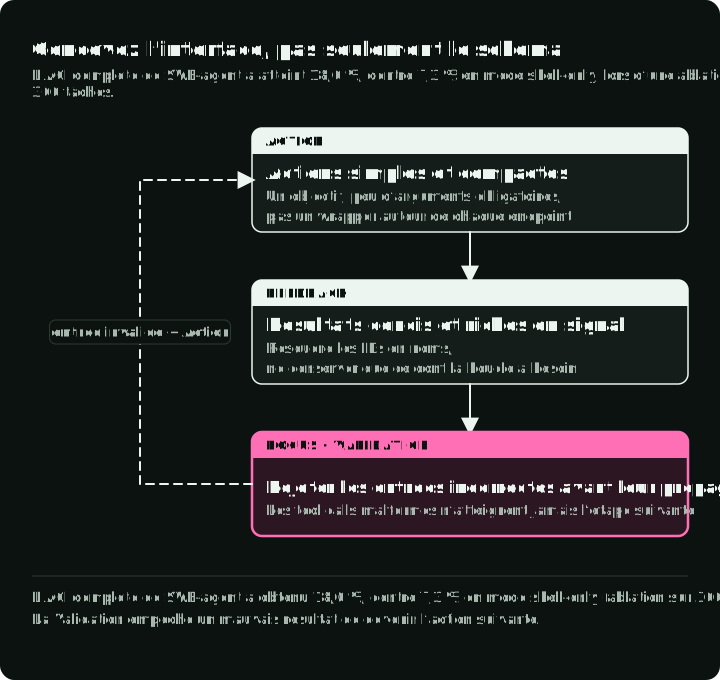
Les quatre principes ACI s’appliquent à toutes les interfaces de cet article :
- Actions simples. N’enveloppez pas les endpoints d’API un à un. Au lieu de
list_users,list_eventsetcreate_event, proposezschedule_event, qui trouve les disponibilités et réserve en un seul appel. Au lieu deread_logs, proposezsearch_logs, qui renvoie les lignes pertinentes avec leur contexte. - Actions compactes. Regroupez les opérations qui servent une même tâche, comme le fait le snapshot de l’action ci-dessous.
- Retour concis et informatif. Renvoyez des noms sémantiques plutôt que du HTML brut, des payloads d’API complets ou des identifiants obscurs, tout en conservant tout identifiant dont un appel ultérieur a besoin.
- Une validation qui empêche les erreurs de se propager. Vérifiez les arguments avant l’appel et les résultats avant l’action suivante. Dans SWE-agent, un éditeur doté d’un linting intégré rejetait les erreurs de syntaxe ; l’activer a fait passer la condition d’édition de 15,0 % à 18,0 %.
Un outil facile à choisir et à utiliser
Le Market Analyst Agent en donne un exemple concret. Une version antérieure exposait get_stock_price et get_company_metrics séparément. L’exécuteur expose désormais get_stock_snapshot, get_price_history, get_financials, search_news et search_competitors. Le snapshot regroupe le cours, le volume, la capitalisation boursière et le PER, car une présentation de base en a généralement besoin ensemble. L’historique, les états financiers et les actualités restent séparés, car l’agent n’a pas forcément besoin de chacun d’eux.
| Avant (outils d’origine) | Après (outils de données de marché) | Pourquoi |
|---|---|---|
get_stock_price + get_company_metrics | get_stock_snapshot | Un appel renvoie le snapshot de base du cours et de la valorisation |
get_price_history | get_price_history | Conservé, avec des périodes validées et un résumé du volume moyen |
search_news | search_news | Renvoie des éléments structurés avec les points clés extraits |
search_competitors | search_competitors | Conserve l’action de recherche centrée sur les concurrents |
| Aucun outil d’états financiers | get_financials | Sélectionne par paramètre le compte de résultat, le bilan ou les flux de trésorerie |
La liste d’outils de l’agent comprend aussi un chargeur de skills, deux wrappers CLI et un évaluateur Python restreint exécuté dans le processus ; elle couvre donc trois des interfaces décrites plus bas. MCP apparaît sous la forme d’un sidecar séparé.
C’est un choix de taille d’action. Un wrapper un à un autour de chaque endpoint amont oblige le modèle à planifier en fonction de l’organisation de l’API du fournisseur. Un outil unique doté de nombreux modes sans rapport déplace simplement le problème de sélection dans ses arguments. Regroupez les champs qui servent la même tâche, puis vérifiez que les agents choisissent la bonne action.
Rédiger la description pour le modèle
La description du snapshot indique quand l’appeler en premier, ce qu’il renvoie et quand choisir plutôt l’historique ou les états financiers. Cette indication sur les outils voisins compte autant que le nom. « Search for items » ne permet pas au modèle de savoir si search_news ou search_competitors répond à une demande. Le guide de conception d’outils d’Anthropic recommande lui aussi des descriptions, des exemples et des résultats qui aident un modèle à choisir la bonne action, et sa documentation sur la définition d’outils suggère au moins trois ou quatre phrases couvrant quand utiliser l’outil, ses paramètres, sa sortie et les cas limites :
# Vague: the model cannot tell when to use it.
vague = [{"name": "search", "description": "Search for items"}]

# Specific: when to use it, what it returns, and which tool to use instead.
specific = [{
    "name": "search_news",
    "description": (
        "Search for recent news articles about a specific stock or company. "
        "Use this tool when the user asks about recent events, earnings, "
        "announcements, or market-moving news for a specific ticker. "
        "Returns up to 10 articles sorted by relevance. "
        "For company competitors rather than news, use search_competitors instead."
    ),
    "input_schema": {
        "type": "object",
        "properties": {
            "query": {
                "type": "string",
                "description": "Search query. Examples: 'NVDA earnings Q3 2025', 'Tesla delivery numbers'",
            },
            "max_results": {
                "type": "integer",
                "description": "Max articles to return (1-10, default 5)",
                "default": 5,
            },
        },
        "required": ["query"],
    },
}]
Ajoutez des exemples lorsque les paramètres sont ambigus ; ne dépensez pas de contexte à répéter ce qu’un schéma simple dit déjà. Dans les tests internes d’Anthropic, l’ajout d’un champ input_examples a fait passer la précision sur la gestion de paramètres complexes de 72 % à 90 %. Anthropic indique aussi que l’espace de noms en préfixe ou en suffixe (asana_search ou search_asana) avait des effets notables sur ses évaluations, sans dire lequel l’emportait ; testez donc les deux sur votre ensemble d’outils. Anthropic a ensuite confié des transcriptions d’évaluation à Claude Code pour réécrire les outils et, sur des tests mis de côté, cette boucle a fait mieux que ses outils écrits par des experts.
Valider les arguments et mettre en forme les résultats
L’implémentation valide le ticker avant la requête de données de marché. Cet extrait est adapté du code source lié ; le normaliseur partagé supprime les espaces aux extrémités, met la valeur en majuscules et accepte les suffixes avec point ou trait d’union comme BRK.B et BF-B. La requête d’historique ajoute un ensemble de périodes autorisées :
from pydantic import BaseModel, Field, field_validator

from market_analyst.utils import normalize_ticker

class StockQuery(BaseModel):
    ticker: str = Field(description="Stock ticker symbol (e.g., NVDA)")

    @field_validator("ticker")
    @classmethod
    def validate_ticker(cls, value: str) -> str:
        return normalize_ticker(value)

class StockHistoryQuery(StockQuery):
    period: str = Field(default="1mo", description="Time period: 1d, 5d, 1mo, 3mo, 6mo, 1y")

    @field_validator("period")
    @classmethod
    def validate_period(cls, value: str) -> str:
        valid = {"1d", "5d", "1mo", "3mo", "6mo", "1y"}
        if value not in valid:
            raise ValueError(f"Invalid period: {value}. Must be one of {valid}")
        return value
Les outils d’actions et d’actualités renvoient des résultats validés par Pydantic plutôt que des payloads bruts du fournisseur. Le champ summary fournit à l’agent une chaîne prête pour un rapport, et key_points lui évitent d’analyser le corps des articles :
from pydantic import BaseModel

class StockSnapshot(BaseModel):
    ticker: str
    price: float
    change_pct: float
    volume: int
    market_cap_b: float
    pe_ratio: float | None
    summary: str  # One line for direct use in a report

class NewsItem(BaseModel):
    headline: str
    source: str
    date: str
    relevance_score: float  # Pre-ranked by the tool
    key_points: list[str]  # Extracted by the tool, not the agent

class NewsSearchResult(BaseModel):
    query: str
    results: list[NewsItem]
    summary: str
Le résultat du snapshot comporte ces champs typés pour le cours, la variation en pourcentage, le volume, la capitalisation boursière, le PER et un bref résumé. Ajoutez au résultat la source des données et l’heure de référence du marché, et faites en sorte que le rapport les indique. Récupérer les données maintenant ne prouve pas que la cotation est actuelle.
Gardez les résultats assez courts pour la décision suivante, mais ne supprimez pas un identifiant ou une source dont une action ultérieure a besoin. Pour un résultat de recherche, un titre et un résumé peuvent suffire à classer des candidats ; l’URL ou l’identifiant doit rester disponible si l’agent doit récupérer ou citer un élément précis. Un résultat concis et un résultat détaillé peuvent servir des étapes différentes : les tests d’Anthropic ont ajouté un paramètre response_format qui renvoyait environ 72 tokens en mode concis et 206 en mode détaillé. Les payloads amont bruts constituent rarement un bon comportement par défaut.
Renvoyer des erreurs exploitables par la boucle
Les erreurs font partie du même contrat. Ne remplacez pas un cours manquant par zéro : une cotation indisponible ressemble alors à un cours de zéro dollar. N’enveloppez pas non plus chaque échec définitif dans un seul type d’exception : l’appelant ne peut alors pas choisir une catégorie de relance. Rejetez les données de marché manquantes et distinguez entrée invalide, panne temporaire du fournisseur et données indisponibles. Un outil qui écrit un état externe doit aussi distinguer un échec connu d’un résultat qui a pu aboutir malgré une réponse perdue. Renvoyez assez de détails pour choisir entre relance, demande de précision et escalade ; empêchez le texte du fournisseur de devenir une instruction pour le modèle.
Quatre mécanismes traitent différentes classes d’échec : la relance avec backoff pour les erreurs transitoires, le repli sur un autre modèle en cas de panne du fournisseur, une classification qui renvoie les erreurs récupérables à l’agent et fait remonter les autres, et la reprise depuis un checkpoint en cas de plantage (partie 2). Ne relancez que les échecs transitoires, comme les timeouts, les erreurs réseau et les réponses 429 et 5xx, avec un backoff exponentiel et un petit nombre maximal de tentatives ; une bibliothèque comme Tenacity le fait dans un décorateur. L’appelant doit tout de même transformer une exception finale, ou une erreur 4xx non relançable, en un résultat stable qui indique quelle opération a échoué et quoi faire ensuite. Relancer une requête ne classe pas son erreur, et ce n’est sûr que pour une lecture ou une écriture idempotente. Mesurez le taux de reprise, les relances et les escalades sur votre propre suite de tâches.
Essayer le contrat
Depuis le dépôt compagnon, installez ses dépendances verrouillées et lancez les tests des outils :
uv sync --locked
uv run pytest tests/test_tools.py -q
Le test du snapshot injecte des données de marché synthétiques et vérifie le ticker, le cours, le volume, les champs de valorisation et le résumé. Il teste le contrat de l’outil sans cotation en direct ni modèle ; il ne mesure pas si un agent choisit le bon outil. Avec des identifiants de fournisseur configurés comme le décrit le README du dépôt, vous pouvez aussi lancer uv run market-analyst "NVDA price update" --mode flash --no-persist pour examiner un brouillon produit par l’agent. Cette exécution utilise des services en direct ; c’est un exemple, pas un benchmark.
Choisir l’interface d’exécution
Une fois le contrat d’action clair, choisissez comment l’agent y accède. Ces interfaces répondent à des questions différentes ; une interface plus récente ne remplace pas une plus ancienne.
La figure suit chaque route du Market Analyst Agent, du modèle jusqu’à l’opération qu’elle atteint.
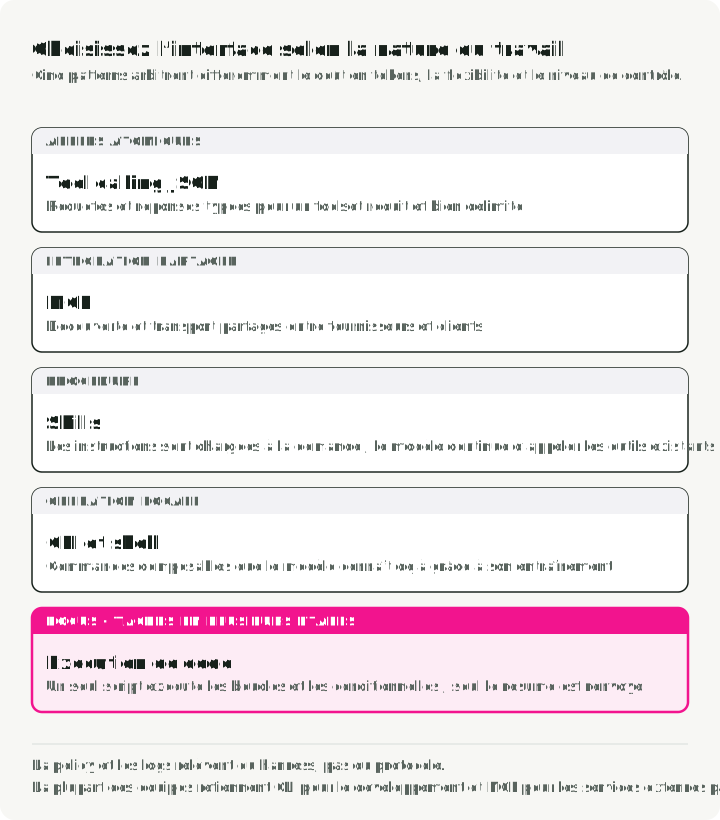
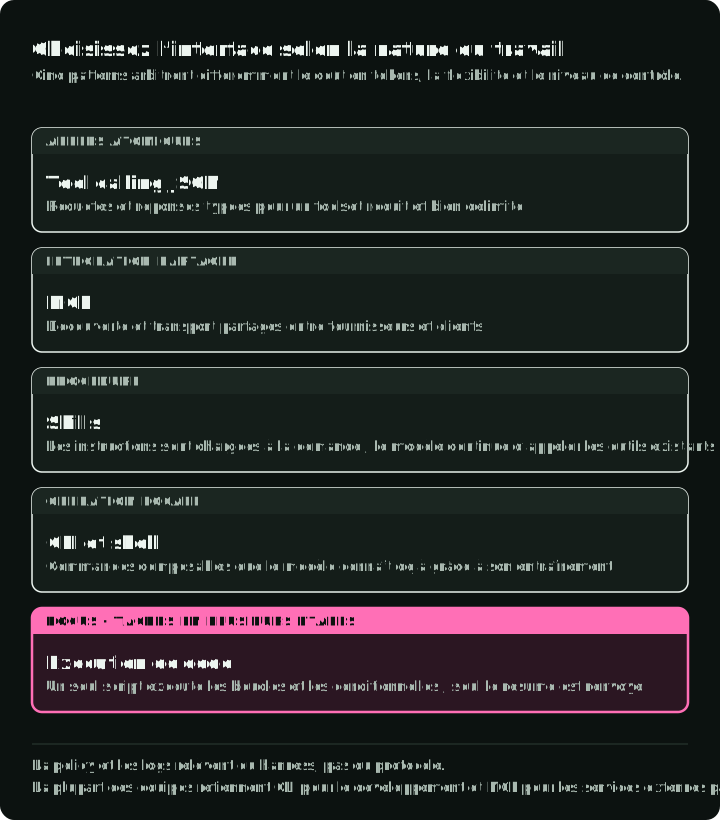
| Besoin | Interface de départ | Ce qu’elle apporte |
|---|---|---|
| Un petit ensemble d’opérations typées dans une application | Tool calls JSON | Des noms, des arguments et des résultats explicites |
| Les mêmes outils servis à plusieurs clients | MCP | Découverte et transport partagés |
| Une commande existante avec une sortie stable | Wrapper CLI | Réutilisation de la commande et de son aide |
| De nombreuses opérations dépendantes ou un traitement local des données | Exécution de code | Boucles, conditions et filtrage au sein d’une exécution |
| Des instructions réutilisables pour tout ce qui précède | Skill | Des indications chargées quand elles sont pertinentes |
Le tableau propose un premier choix ; il ne classe pas les interfaces selon leurs performances. Les outils MCP ont toujours des schémas et des appels structurés. Une CLI peut se trouver derrière un wrapper d’outil JSON. Un exécuteur de code peut appeler des outils autorisés. Les Skills sont des instructions pour utiliser une capacité, pas un autre canal d’exécution.
Appels typés pour les actions ciblées
Pour get_stock_snapshot(ticker), un appel typé suffit. Le modèle fournit un ticker ; le harness vérifie l’argument, appelle l’implémentation et renvoie un résultat structuré. L’appel suivant peut dépendre de ce résultat. Des recherches indépendantes peuvent souvent s’exécuter en parallèle, mais un appel dont les arguments dépendent du premier résultat nécessite une nouvelle étape du modèle, sauf si le code de l’application combine les opérations.
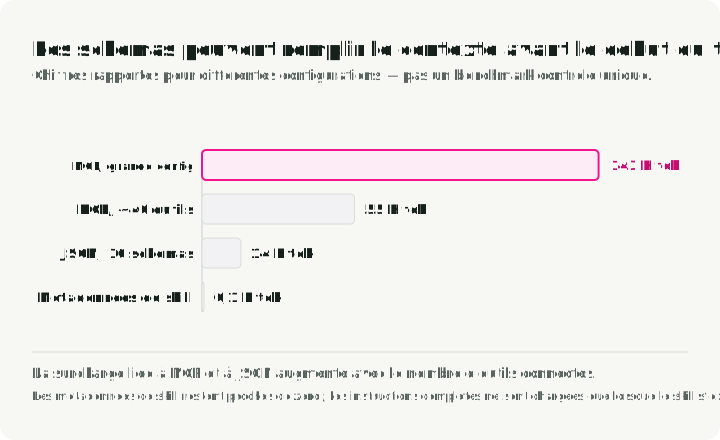
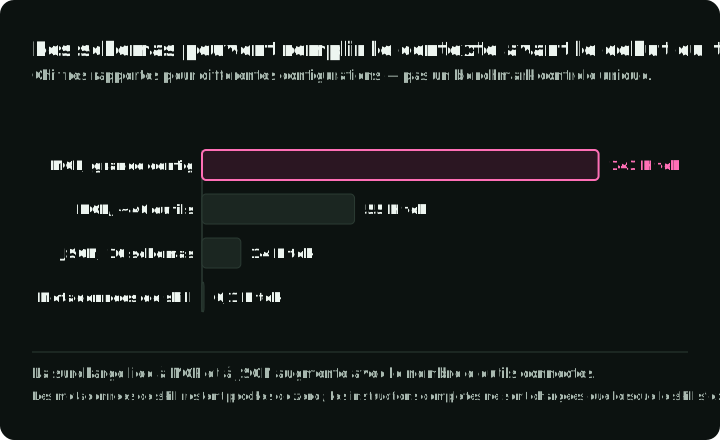
Le faible coût de mise en place est utile lorsqu’une application possède un petit ensemble d’outils. Les tokens des schémas comptent quand même lorsque les définitions d’outils sont chargées dans le contexte ; mesurez donc la taille de vos définitions réelles. Si le catalogue grandit, une découverte différée peut ne charger que les candidats probables. Dans l’exemple Tool Search d’Anthropic, le contexte approximatif avant le début du travail est passé de 77 000 à 8 700 tokens dans une configuration de plus de 50 outils, en ne chargeant que les trois à cinq outils dont une requête a besoin. C’est un résultat propre à son ensemble d’outils et à sa méthode de recherche, et il ajoute une étape de découverte avant chaque appel. Il aide moins pour un petit ensemble d’outils utilisé à chaque session. La découverte doit aussi être testée contre les outils manqués ou incorrects.
Le chargement d’un schéma tend à être à sens unique : une définition que le modèle peut appeler vingt étapes plus tard doit rester disponible, et la retirer modifie la partie stable de la requête dont dépend le prefix caching ; une étape de découverte ajoute donc généralement des définitions et n’en remplace jamais une. Un schéma que le modèle peut encore voir n’est pas non plus une autorisation que le modèle détient encore. Enregistrez la version du schéma et l’autorisation effective au moment de la découverte, puis revérifiez l’autorisation lorsque l’appel est envoyé à l’exécution.
Lorsqu’un résultat est raccourci pour tenir dans le budget, dites-le dans le résultat et donnez au modèle un moyen de demander une plage de lignes ou d’octets de la sortie complète, afin qu’il puisse distinguer une réponse courte d’une réponse tronquée et demander le reste quand cela compte.
Le graphique place cet exemple sur la même échelle de tokens que les configurations MCP décrites plus loin dans cette section.
MCP pour un service partagé
Le Model Context Protocol permet à un serveur de proposer des outils et d’autres capacités à des clients via stdio ou HTTP. Le client MCP de l’agent se connecte, demande au serveur ce qu’il propose et transmet les appels du modèle, si bien qu’un serveur fonctionne avec tout client qui parle le protocole. Depuis décembre 2025, MCP est gouverné par l’Agentic AI Foundation au sein de la Linux Foundation, et non par un seul fournisseur.
Utilisez MCP lorsqu’un service doit être accessible depuis plusieurs hôtes d’agents, pour des intégrations SaaS comme Figma, Notion ou Salesforce, pour des services sans CLI, ou lorsque la découverte standardisée, la gestion d’OAuth et l’intégration à distance justifient le coût d’exploitation d’un serveur. Le Market Analyst Agent expose aussi ses outils de recherche via un sidecar MCP. L’action boursière n’est pas devenue une autre opération métier simplement parce que le client la découvre via MCP.
Le protocole n’autorise pas un effet métier demandé. Le serveur et l’application ont toujours besoin d’authentification, de permissions limitées, de contrôles des entrées et d’une trace d’audit pour les opérations qui comptent. Les descriptions d’outils et les documents renvoyés sont eux aussi des entrées non fiables ; la démonstration de tool poisoning d’Invariant Labs montre que des instructions malveillantes dans les métadonnées d’un outil peuvent influencer un agent avant même l’appel de l’outil. Le benchmark MCPTox, qui a testé 20 agents LLM face à 45 serveurs MCP actifs et 353 outils réels, a rapporté le taux de réussite d’attaque le plus élevé, 72,8 %, pour o1-mini dans sa configuration de tool poisoning ; il s’agit du résultat de benchmark d’un seul modèle, pas d’un taux d’incidents. Le Vulnerable MCP Project rassemble des rapports utiles comme cas de test. L’hôte doit traiter le texte des outils comme des données, pas comme une délégation d’autorité.
Vérifiez quelle révision de MCP chaque côté prend en charge. La révision 2026-07-28 rend les requêtes sans état, en remplaçant la poignée de main d’initialisation, et supprime la reprise des flux ; d’anciens tutoriels peuvent donc ne pas correspondre au SDK que vous installez. Un flux de réponse interrompu nécessite alors une nouvelle requête, raison de plus pour empêcher les effets métier en double dans l’outil lui-même. Inspectez le SDK installé et le contrat du serveur avant de compter sur une fonctionnalité. Pour un appel qui dure plus longtemps qu’une réponse, l’extension Tasks officielle ajoute un identifiant durable : le serveur renvoie un ID de tâche, et le client interroge ou annule le travail avec tasks/get et tasks/cancel. La partie 6 utilise cet identifiant lorsqu’un appel expire.
Les grands catalogues peuvent coûter cher si chaque description est chargée pour chaque requête. Apideck décrit une configuration courante, GitHub, Slack et Sentry avec environ 40 outils, qui charge près de 55 000 tokens de définitions avant que l’utilisateur ne pose la moindre question, et cite une équipe dont les trois serveurs MCP occupaient 143 000 des 200 000 tokens de contexte. Ce sont des chiffres rapportés, pas des mesures de votre catalogue. Il s’agit d’une décision sur le chargement des schémas, pas d’un coût inhérent au protocole de transport de MCP. Chargez de préférence un ensemble pertinent plus restreint lorsque c’est possible, et mesurez si la découverte trouve toujours le bon outil.
Wrappers CLI pour les commandes établies
Une CLI est intéressante lorsque l’opération existe déjà sous forme de commande avec un --help utile, des codes de sortie stables et une sortie lisible par une machine. Les outils CLI du Market Analyst Agent enveloppent deux commandes précises pour lister et afficher des rapports enregistrés. Ils passent une liste d’arguments à subprocess.run et demandent du JSON ; l’agent ne reçoit pas un shell arbitraire. Cette distinction rend visible l’action autorisée et évite de considérer comme fiable chaque chaîne de commande générée.
Une commande largement documentée comme git, gh, docker, kubectl, curl ou jq peut nécessiter peu de nouvelle documentation pour un agent de développement, mais une CLI interne a toujours besoin d’exemples et de contrats de sortie. Le guide d’Ugo Enyioha Writing CLI Tools That AI Agents Actually Want to Use énumère huit règles pour une telle commande :
- Prendre en charge une sortie structurée avec
--json. - Utiliser des codes de sortie distincts pour les différents types d’erreur.
- Rendre les commandes idempotentes.
- Fournir un
--helpavec des exemples réalistes. - Permettre la composition :
--quietpour des valeurs brutes et une entrée depuis stdin. - Fournir
--dry-runet--yes. - Indiquer la version de l’outil.
- Lire les identifiants dans des variables d’environnement.
Un shell ajoute les pipes et la composition, ainsi que l’accès aux fichiers, aux processus, aux identifiants et aux chemins réseau. Ne lui donnez que l’accès dont la tâche a besoin. Une CLI n’a pas de modèle de découverte ni d’autorisation au niveau du protocole ; le harness doit appliquer la politique et journaliser les appels qu’il doit auditer. Un choix par défaut pratique consiste à utiliser la CLI pour le développement et les opérations locales, et MCP pour les services externes partagés lorsque la découverte entre clients ou la gestion d’OAuth justifie l’exploitation d’un serveur.
Dans la comparaison de Scalekit sur 75 exécutions, la CLI a consommé moins de tokens sur cinq tâches GitHub en lecture seule qu’une configuration qui chargeait 43 tool schemas MCP. Ses sept échecs MCP étaient des timeouts de connexion au serveur distant. Ces résultats comparent ces interfaces telles que déployées ; ils n’établissent pas que la CLI serait en général plus fiable ou que MCP exigerait plus de contexte. Refaites la comparaison avec les commandes, le serveur et la politique de découverte que vous déploieriez réellement.
Exécution de code pour la composition
Un programme généré est utile lorsque l’agent doit combiner de nombreux appels, filtrer des données intermédiaires ou calculer sur un résultat volumineux. Au lieu de faire passer chaque ligne par le modèle et de lui demander de planifier l’opération suivante, un runtime peut exécuter une boucle et renvoyer le résumé pertinent. L’article CodeAct a testé 17 modèles et constaté jusqu’à 20 points de pourcentage de réussite en plus sur ses 82 tâches multi-outils, avec jusqu’à 30 % d’actions en moins que les alternatives JSON. C’est une raison d’essayer l’interface sur un travail similaire, pas de remplacer une simple recherche typée par un exécuteur de code.
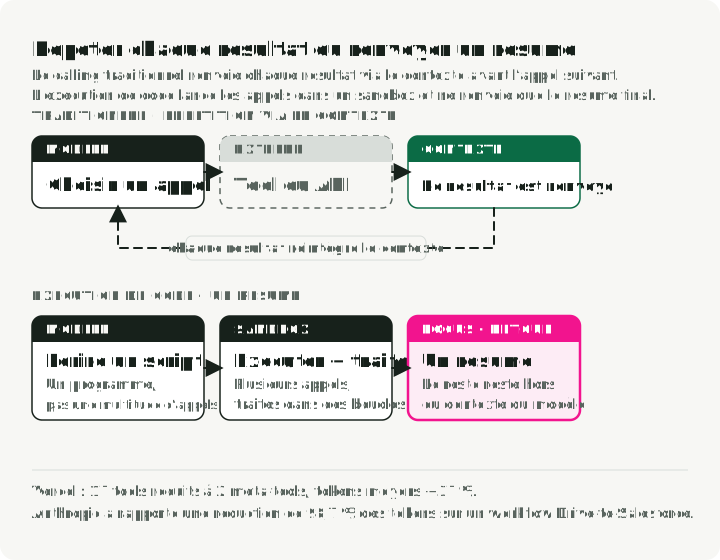
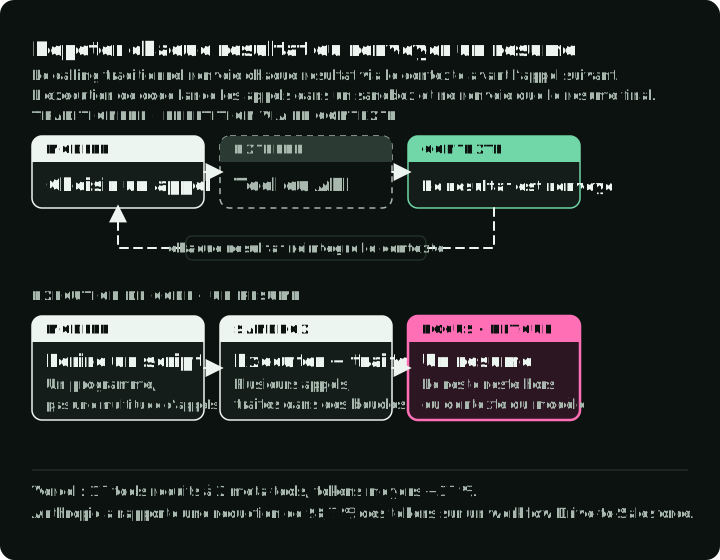
La figure exécute dans les deux modes le contrôle de notes de frais d’Anthropic, décrit plus bas, et compare ce qui parvient au contexte du modèle.
Il y a ici deux modèles différents. L’outil de code du Market Analyst Agent accepte du Python pour des calculs sur des données qui lui ont déjà été fournies. Il ne permet pas à ce code d’appeler les outils de données de marché. Il vérifie les nœuds de l’arbre syntaxique, puis exécute le code dans le processus de l’application. Cette liste d’autorisation est une contrainte pédagogique, pas une sandbox de sécurité pour du code non fiable. Avant d’exposer du code généré arbitraire ou des ressources sensibles du processus, l’exécution a besoin d’un runtime isolé avec des limites de ressources et d’accès.
Le Programmatic Tool Calling d’Anthropic (PTC) est un dispositif différent : du code généré peut appeler des outils explicitement activés dans un environnement d’exécution géré et renvoyer un résultat choisi dans le contexte du modèle. Dans l’exemple d’analyse de notes de frais d’Anthropic, appeler les outils un par un demande plus de 20 passages du modèle, chaque ligne transitant par le contexte ; le code généré a réduit ce qui atteignait le contexte d’environ 200 Ko de lignes de dépenses à 1 Ko de résultats. Le script ci-dessous montre ce flux de contrôle avec des adaptateurs Python asynchrones ordinaires, et non avec les wrappers PTC natifs :
# Custom async adapters that return decoded Python objects, not native PTC wrappers.
import asyncio
import json

async def main() -> None:
    team = await get_team_members("engineering")
    levels = list({member["level"] for member in team})
    budgets = dict(zip(levels, await asyncio.gather(*(get_budget_by_level(l) for l in levels))))
    expenses = await asyncio.gather(*(get_expenses(member["id"], "Q3") for member in team))
    over_budget = []
    for member, rows in zip(team, expenses):
        total = sum(row["amount"] for row in rows)
        limit = budgets[member["level"]]["travel_limit"]
        if total > limit:
            over_budget.append({"name": member["name"], "spent": total, "limit": limit})
    print(json.dumps(over_budget))  # Only this summary returns to the model

asyncio.run(main())
Les wrappers PTC natifs diffèrent de ces adaptateurs par les formats d’arguments et de retour, et tous les types d’outils ne peuvent pas être appelés depuis du code ; consultez le guide actuel avant de porter un script. Le paramètre allowed_callers de l’API oriente l’appel mais ne remplace pas l’autorisation par l’hôte de chaque effet sous-jacent, y compris un appel direct inattendu. Garder les lignes intermédiaires hors du contexte du modèle économise des tokens, mais ne les rend pas confidentielles vis-à-vis de l’environnement d’exécution et ne les soustrait pas à la journalisation ni aux contrôles d’accès.
Le bénéfice dépend de la forme de la tâche. Dans les évaluations internes d’Anthropic, un benchmark de gestion de projet à 75 outils a utilisé environ 38 % de tokens d’entrée facturés en moins, avec une précision inchangée. Sur des tâches tau2-bench comportant un ou deux appels séquentiels par tour, les scores sont restés identiques et le coût a été environ 8 % plus élevé. Un exemple distinct de Drive vers Salesforce est passé d’environ 150 000 à 2 000 tokens, soit une réduction de 98,7 % pour ce workflow. Aucun de ces chiffres n’est un taux universel du code face au JSON. La génération de code, le démarrage du runtime, les échecs et le traitement de la sortie peuvent dépasser les économies de contexte sur des tâches simples.
Deux études de cas de fournisseurs montrent la même conception dans des produits. Vercel a reconstruit son agent text-to-SQL d0 autour de deux outils généraux, ExecuteCommand et ExecuteSQL, au lieu des 17 cités dans son ancien exemple. Sur cinq requêtes représentatives, il rapporte un taux de réussite passé de 4/5 à 5/5, un temps moyen ramené de 274,8 s à 77,4 s et 37 % de tokens en moins. Avec le Code Mode de Cloudflare, les agents écrivent du TypeScript contre une API au lieu d’appeler des tool schemas, au motif que les modèles ont vu bien plus de vrai TypeScript que d’exemples de tool calls. Considérez ces deux cas comme des résultats de fournisseurs et refaites la comparaison sur vos tâches.
Le tool calling JSON reste le meilleur choix pour les opérations atomiques uniques, les environnements sans sandboxing, les petits modèles qui génèrent mal du code et les règles d’audit qui exigent une trace de chaque appel individuel.
Les Skills pour les procédures
Une Agent Skill regroupe un fichier SKILL.md avec un nom, une description et des instructions ; elle peut aussi contenir des scripts et des références. Le standard ouvert n’exige que name et description. Une skill minimale pour cet agent pourrait ressembler à ceci :
---
name: stock-overview
description: Prepare a short overview of one stock. Use when the user asks for a current snapshot of a company.
---
1. Call get_stock_snapshot for the ticker.
2. If the result has no market timestamp, say that freshness is unknown.
3. Call search_news only if the user asked about recent events.
4. Cite every news item you use.
La skill indique à l’agent comment utiliser ses outils ; elle n’ajoute aucune nouvelle capacité. Utilisez les skills pour les connaissances métier, les procédures en plusieurs étapes et les travaux récurrents comme les migrations de base de données ou les intégrations de paiement. L’hôte continue de déterminer quels outils l’agent peut exécuter. Le texte d’une skill est une indication, pas l’application d’une politique.
Le format permet de charger le nom court et la description, soit environ 100 tokens, avant les instructions complètes ; les scripts et fichiers référencés ne sont chargés qu’en cas de besoin. Cela aide lorsqu’il existe de nombreuses procédures, mais la skill active et les fichiers qu’elle charge consomment toujours du contexte. Examinez ses instructions et ses fichiers exécutables comme toute autre entrée du harness. Si un workflow est critique pour la sécurité, codez la validation requise dans l’outil ou dans l’application plutôt que de compter sur le respect d’une instruction.
Une skill chargée peut aussi dégrader les résultats. Une étude de 2026 sur SkillsBench et SWE-Skills-Bench a attribué 307 échecs à des skills chargées précises : 125 échecs fonctionnels, où le résultat de la tâche était faux, et 182 régressions d’efficacité, où l’exécution coûtait plus cher. Ce sont des échecs que les auteurs ont pu attribuer dans deux benchmarks, pas un taux d’échec des skills en général. Exécutez une nouvelle skill sur des tâches représentatives, avec et sans elle, avant de compter dessus. Les recommandations d’Agent Framework de Microsoft limitent aussi les skills aux opérations idempotentes ou à faible risque et préfèrent un workflow explicite lorsqu’une étape a un effet de bord, comme un paiement, qui ne doit pas se répéter lors d’un retry. Ses outils de skills exigent une approbation par défaut.
Comparer les interfaces
| Question | Tool calls JSON | MCP | Skills | CLI | Exécution de code |
|---|---|---|---|---|---|
| Idéal pour | Actions simples et uniques | Services partagés entre clients | Procédures réutilisables pour une autre interface | Développement et opérations locales | Travail en plusieurs étapes sur de gros résultats |
| Coût en contexte | Schémas chargés | Schémas chargés ou différés | Environ 100 tokens avant activation | Texte d’aide, commande et sortie | Schémas d’entrée, code et sortie |
| Appels dépendants | Généralement un tour du modèle par appel | Un tour du modèle plus le transport | Suit l’interface sous-jacente | Généralement un tour du modèle par appel | Un tour pour le script ; le runtime exécute le flux |
| Surface de sécurité | Autorité sur les arguments et les effets | Identité du serveur et autorité des outils | L’hôte et les ressources qu’il accorde | Shell, chemins, identifiants | Code, accès aux données et sortie réseau |
| Mise en place | Faible | Déploiement d’un serveur | Faible ; dépend de l’interface sous-jacente | Très faible pour les commandes existantes | Un runtime en sandbox |
| Débogage | Entrées et sorties structurées | Ajoute une couche de transport | Markdown lisible | Les commandes sont visibles | Code lisible |
Les Skills guident l’une des quatre autres interfaces ; leur latence et leur mise en place dépendent donc de l’interface qu’elles sélectionnent. Les lignes résument les exemples cités, pas un benchmark contrôlé portant sur les cinq.
Quelques compromis traversent le tableau. L’exécution de code peut économiser du contexte, mais ajoute du temps de génération et de conteneur. MCP économise du travail d’intégration, mais ajoute un serveur à exploiter. La CLI ne coûte rien au départ et devient plus difficile à gouverner à grande échelle. Adaptez l’interface à votre équipe : l’exécution de code suppose un modèle qui écrit du code fiable, la CLI suppose les conventions Unix, et MCP suppose une bonne connaissance des transports et d’OAuth. La consolidation d’outils peut aussi aller trop loin, lorsqu’un outil réunit des modes sans rapport. Les appels structurés sont faciles à journaliser, mais aucun protocole ne crée à lui seul une trace d’audit complète ; l’hôte, le serveur ou le harness enregistre les appels et les résultats et applique la politique.
Un premier jeu de tests pour l’interface
Une liste d’outils plus courte ou un prompt moins coûteux n’est utile que si l’agent accomplit toujours le travail. Comparez les interfaces avec le même ensemble de tâches, le même modèle, les mêmes données, les mêmes opérations autorisées et les mêmes règles d’achèvement. Incluez des cas où la bonne étape suivante consiste à demander une précision ou à s’arrêter.
Pour le Market Analyst Agent, un premier jeu de tests pourrait inclure ces cas :
| Demande ou condition | Ce qu’il faut examiner |
|---|---|
| Présentation de base d’une action | Bon ticker, champs du snapshot, source et heure du marché dans la réponse |
| Historique des cours nécessaire, mais pas d’actualités | L’agent sélectionne l’historique sans appels superflus |
| Le fournisseur ne renvoie aucun cours valide | Aucune cotation inventée ; l’exécution signale des données indisponibles |
| Grand ensemble de recherches indépendantes | Qualité de la réponse finale, tours du modèle, tokens en entrée/sortie, latence et échecs du runtime |
| Ordre de bourse proposé pendant une demande de recherche | Aucun effet d’ordre ; la liste d’outils de recherche n’accorde pas cette action |
Enregistrez les tool calls et leurs résultats en plus de la réponse finale. Un rapport plausible peut masquer une recherche échouée ; un cours final correct peut masquer des appels inutiles. Si une interface change, comptez à la fois les tâches réussies et les nouveaux modes d’échec : mauvais choix d’outil, arguments invalides, découverte manquée, effets de bord répétés, erreurs de syntaxe et timeouts. Enregistrez aussi les tokens de découverte, les entrées en cache et hors cache, ainsi que les relances.
Vous pouvez ensuite changer d’interface lorsqu’une mesure le justifie. Gardez un appel typé tant qu’il répond proprement à la tâche. Ajoutez MCP lorsqu’une découverte partagée est nécessaire, un wrapper CLI lorsqu’une commande existante est l’opération la plus claire, ou l’exécution de code lorsque des gains de composition mesurés justifient son runtime. Le contrat d’action, c’est-à-dire ce qui peut se produire, quel résultat le prouve et ce que signifie un échec, doit toujours être explicite.
Trois directions pour le tool use à grande échelle
Recherche d’outils. Avant que le modèle ne choisisse, récupérez les quelques descriptions d’outils qui correspondent à la demande. Dans le benchmark et le test de charge MCP de RAG-MCP, la recherche a fait passer la précision de sélection d’outils de 13,62 % à 43,13 % et réduit les tokens du prompt d’environ 2 134 à 1 084. Les descriptions de la configuration diffèrent d’une section à l’autre de l’article, ce qui limite la portée des chiffres.
Des agents qui créent des outils. Avec LATM, un modèle puissant écrit des fonctions Python réutilisables qu’un modèle plus petit appelle ensuite. ToolMaker a correctement implémenté 12 des 15 tâches construites à partir d’articles accompagnés de code public. Ce petit benchmark n’établit pas une fiabilité en production, mais il ouvre la voie à la gestion d’une bibliothèque d’outils générés.
A2A à côté de MCP. Google a transféré A2A à la Linux Foundation en juin 2025. La documentation A2A répartit les rôles : MCP relie un agent à des outils et à des ressources, tandis qu’A2A permet à des agents distincts de se découvrir, de partager des tâches et de déléguer du travail.
La partie 4, AI Agent Security, suit l’action proposée jusqu’à son contrôle d’autorisation. La partie 5, Agent Runtime, place l’exécution dans un runtime récupérable. La partie 6, Harness Engineering for AI Agents, réunit la boucle, les outils, la politique et la vérification d’achèvement.
Références
Articles de recherche
- Executable Code Actions Elicit Better LLM Agents (CodeAct) — Wang et al., ICML 2024
- SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering — Yang, Jimenez et al., NeurIPS 2024
- RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection
- LLMs As Tool Makers (LATM) — Cai et al., 2023
- ToolMaker: LLM Agents Making Agent Tools — Wölflein et al., ACL 2025
- MCPTox: A Benchmark for Tool Poisoning Attack on Real-World MCP Servers
- Agent Skills Can Be Harmful: An Empirical Study of Skill-Induced Failures in LLM Agents — Dong et al., 2026
Ingénierie et documentation d’Anthropic
- Advanced tool use — Tool Search, Programmatic Tool Calling et exemples d’entrée
- Programmatic tool calling — guide actuel de l’API et contraintes
- Code execution with MCP — l’exemple Drive vers Salesforce
- Writing effective tools for agents
- Building effective agents
Protocoles
- Spécification du Model Context Protocol, 2026-07-28 et journal des modifications
- MCP Tasks extension
- Spécification Agent Skills
- Microsoft Agent Framework: Agent Skills
- A2A and MCP
Études de cas et sécurité
- Vercel: We removed 80% of our agent’s tools
- Cloudflare: Code Mode
- Apideck: MCP server eating your context window
- Scalekit: MCP vs CLI
- Invariant Labs: MCP tool poisoning attacks
- Vulnerable MCP Project
- Writing CLI Tools That AI Agents Actually Want to Use — Ugo Enyioha
Projet de démonstration
- Market Analyst Agent — consolidation des outils et modèles ACI