Reasoning loops des agents AI : ReAct, ReWOO, Plan-and-Execute

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Un reasoning loop d’agent est le flux de contrôle qui décide quand un modèle choisit une action, reçoit un tool result et choisit à nouveau, ou s’arrête. Cet article s’adresse aux ingénieurs qui doivent décider comment un agent traite un travail dont l’étape suivante peut dépendre de ce que trouvent ses outils. Vous verrez quand utiliser ReAct, ReWOO ou Plan-and-Execute, et comment ces choix se traduisent dans une implémentation LangGraph.
Une demande de cours actuel d’une action suit des étapes de consultation connues. Une enquête sur les raisons pour lesquelles ses perspectives ont changé peut exiger que la recherche suivante dépende du premier résultat. Le modèle a besoin d’une liberté différente pour ces deux tâches, et la seconde demande généralement plus d’appels au modèle.
Voici la Partie 1 de Engineering the Agentic Stack. La boucle en est la couche la plus interne ; les parties suivantes traitent de la mémoire, des outils, de la sécurité, du runtime et des vérifications effectuées avant de déclarer une tâche terminée. L’exemple suivi tout au long de l’article est un Market Analyst Agent construit avec LangGraph.
Pour une comparaison rapide des frameworks qui implémentent ces boucles, consultez Best AI Agent Frameworks in 2026.
Les décisions qu’un modèle doit prendre
Listez les décisions qui restent une fois la demande et ses outils définis. Pour une consultation de cours, l’application peut appeler l’outil de cotation et transmettre son résultat à un modèle pour qu’il l’explique. Si l’utilisateur demande un briefing à partir du cours, des données financières et des actualités récentes, un planificateur peut nommer ces appels indépendants à l’avance. Si une actualité sur un retraitement des résultats exige une nouvelle requête, une liste fixe ne suffit plus : le modèle doit voir le résultat avant de choisir cette requête.
Trois questions déterminent la boucle :
- Le code peut-il nommer les appels dès maintenant ? Si oui, utilisez un workflow fixe. Un modèle peut toujours résumer les résultats, mais il n’a pas à décider de l’ordre des consultations.
- Si un modèle doit choisir les appels, peut-il tous les nommer avant de voir les résultats ? ReWOO peut exécuter ce plan sans revenir au modèle entre les appels. Son worker peut exécuter ensemble les appels indépendants.
- Un résultat peut-il modifier l’appel suivant ou un objectif ultérieur ? ReAct donne au modèle une nouvelle décision après chaque observation. Plan-and-Execute ajoute une liste d’objectifs établie à l’avance autour de ces boucles locales ; modifier des objectifs ultérieurs nécessite une étape de replanification distincte.
Ce choix détermine aussi l’endroit où un échec apparaît. Un plan ReWOO erroné peut traverser plusieurs appels avant que le solver ne voie un problème. Une boucle ReAct peut se remettre d’un résultat inattendu, mais elle peut aussi s’égarer ou répéter du travail. Un plan établi à l’avance rend une longue tâche plus facile à suivre, mais un executor local ne peut pas corriger en silence un plan global erroné. Chaque pattern a toujours besoin d’une règle d’arrêt, de permissions d’outils et d’un moyen de signaler les appels en échec ; la boucle elle-même n’apporte aucune de ces garanties.
Ce que chaque pattern fait d’un résultat
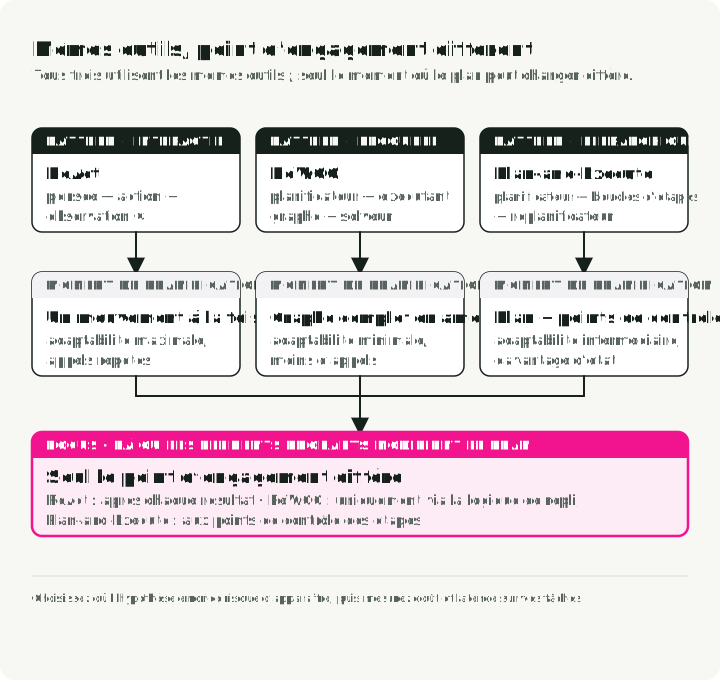
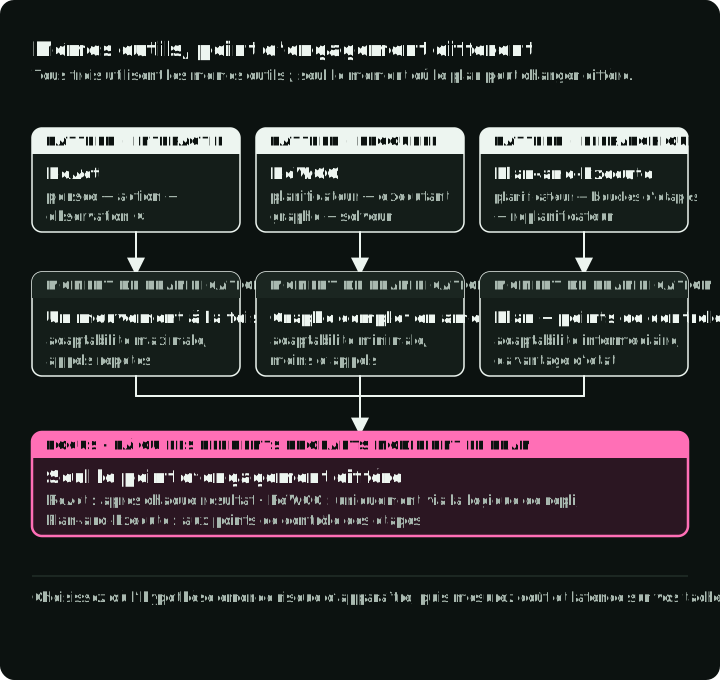
Les trois patterns appellent les mêmes outils. Ils diffèrent par le moment où un tool result peut modifier le plan : après chaque appel, seulement après l’exécution, ou à l’intérieur de chaque étape planifiée.
ReAct : décider après chaque observation
ReAct (Yao et al., 2022), abréviation de Reason + Act, répète une seule décision : le modèle choisit un tool call, l’application l’exécute et le résultat revient au modèle. Pour une demande d’analyse de la baisse de marge d’une entreprise, un état financier pourrait indiquer une hausse des coûts ; l’appel suivant pourrait alors chercher des éléments sur ces coûts. Le modèle n’a pas à choisir ce second appel avant d’avoir vu l’état financier.
L’article original l’écrit sous la forme Thought → Action → Observation. Les APIs d’outils natives exposent l’appel proposé et le tool result, mais n’ont pas à exposer le raisonnement interne du modèle. Réfléchir entre les tool calls est une capacité distincte du modèle et de l’API.
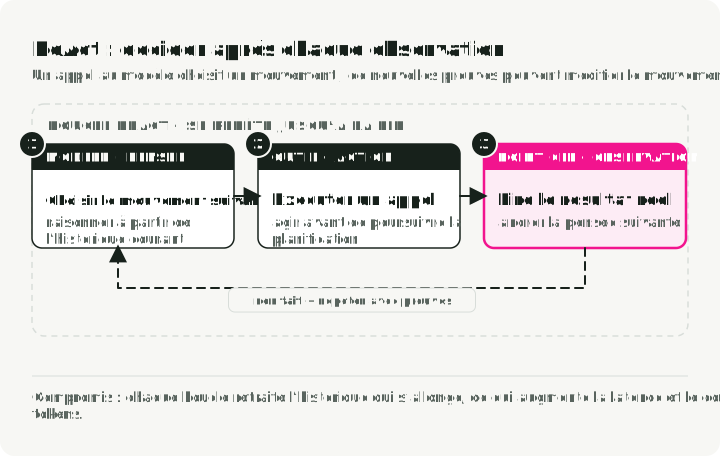
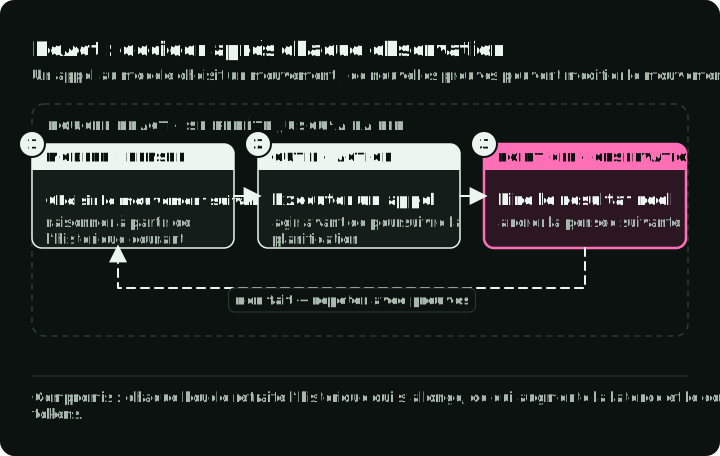
Ce feedback est l’avantage de ReAct : une observation surprenante peut modifier l’action suivante. L’historique des tool calls montre aussi quelles preuves le système a récupérées. Dans l’échantillon manuel HotpotQA de l’article avec PaLM-540B, les observations Wikipedia ont produit moins de faits hallucinés que le prompting chain-of-thought. Ce résultat concerne sa tâche et son modèle, pas la précision de toute boucle utilisant des outils.
Le coût, ce sont les décisions répétées. Une implémentation avec historique complet envoie à chaque tour une conversation de plus en plus longue. Le prompt caching peut réduire le traitement répété de l’entrée et sa facturation, mais il ne retire pas les anciennes observations de la fenêtre de contexte. Résumer ou tronquer retire bien de l’information. Limitez le nombre d’étapes et la durée, et vérifiez si l’agent se remet d’un mauvais résultat ou s’il continue simplement à chercher.
Utilisez ReAct pour la recherche exploratoire, le débogage et les tâches dont vous ne pouvez pas prévoir l’action suivante.
ReWOO : compiler d’abord le graphe d’outils
ReWOO (Reasoning WithOut Observation) sépare l’appel de planification d’un modèle de sa réponse finale. Le planificateur nomme tous les tool calls avant qu’un résultat n’arrive. Il peut désigner un résultat futur par #E1, puis placer #E1 dans les arguments d’un appel ultérieur. Un worker sans LLM résout ces placeholders et exécute les appels ; un modèle solver reçoit les résultats rassemblés et rédige la réponse.
Pour un snapshot de marché, le planificateur peut demander ensemble le cours, les données financières et les actualités récentes. Le worker de cet article exécute en parallèle les appels dont les dépendances sont prêtes. Ce batching est un choix d’implémentation ; la caractéristique déterminante du système décrit dans l’article, c’est que le worker suit un plan sans demander au modèle quoi faire ensuite.
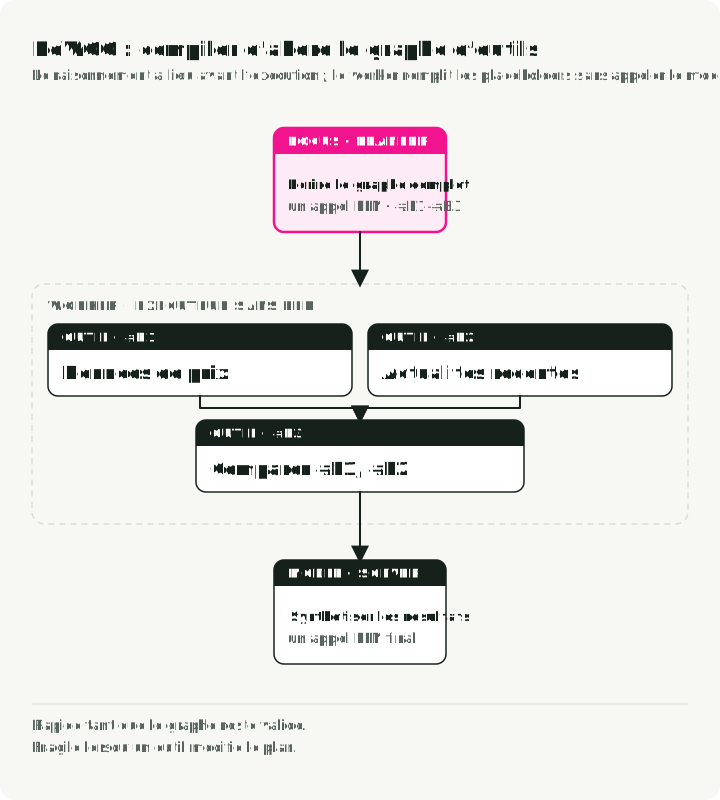
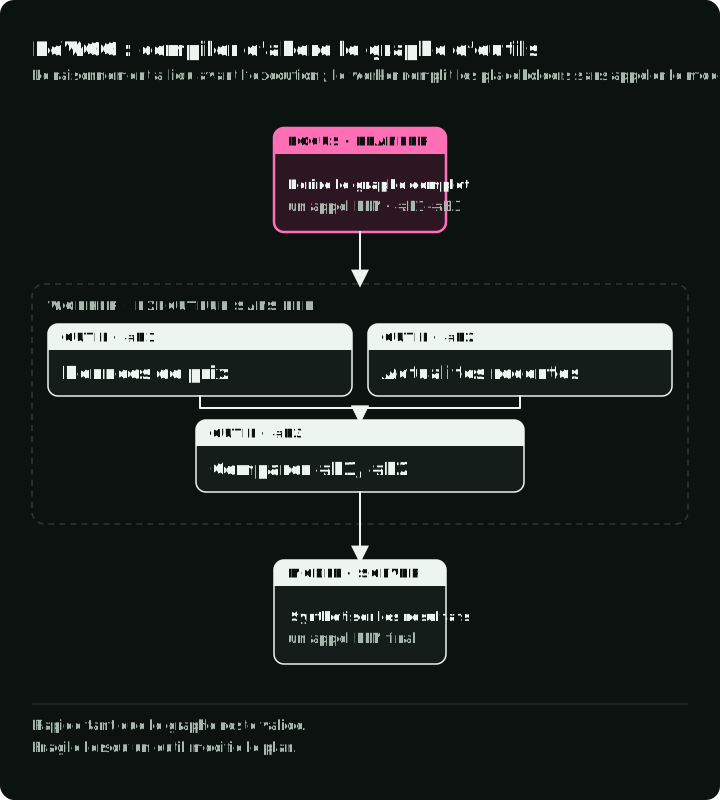
Il y a moins d’appels au modèle pendant l’exécution, à condition que le plan initial reste utile. Le stress test HotpotQA de l’article a remplacé chaque tool result par No evidence found ; ReWOO a perdu moins de précision que ReAct dans ce test. Il n’a pas pour autant récupéré les preuves manquantes. Un worker doit décider si une erreur est transmise au solver, fait l’objet d’un nouvel essai ou arrête l’exécution. Le solver ne peut pas corriger une dépendance erronée ou un outil manquant une fois que les appels ont déjà été exécutés.
Comme le planificateur ne lit jamais de tool result, il peut faire l’objet d’un fine-tuning ou être testé seul, sans environnement d’outils réel. Utilisez ReWOO pour les snapshots rapides, les vérifications d’état et les dashboards dont les outils ont un comportement prévisible.
Plan-and-Execute : décomposer, puis réagir localement
Le Plan-and-Solve prompting crée d’abord un plan, puis résout ses sous-tâches. Le pattern d’orchestration d’outils associé, Plan-and-Execute, laisse un planificateur lister des objectifs de haut niveau et un executor les traiter un par un. Le Market Analyst Agent demande des étapes de recherche comme vérifier la santé financière et examiner les risques. À l’intérieur de chaque étape, une boucle ReAct peut choisir des outils après avoir vu des résultats. La sortie du planificateur est une liste d’objectifs, contrairement aux tool calls proposés par ReWOO.
L’article Plan-and-Solve étudiait le prompting zero-shot, pas ce graphe utilisant des outils. Choisir des modèles différents pour la planification et l’exécution est possible dans une implémentation ; ce n’est pas un résultat établi par cet article.
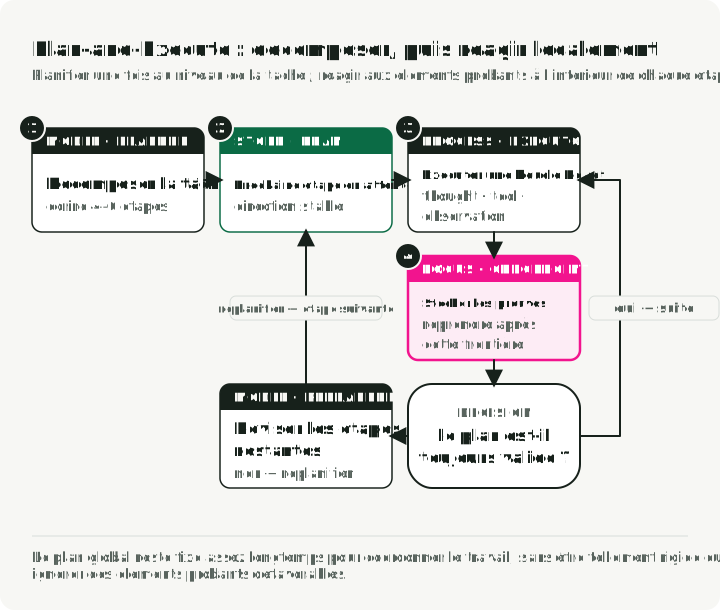
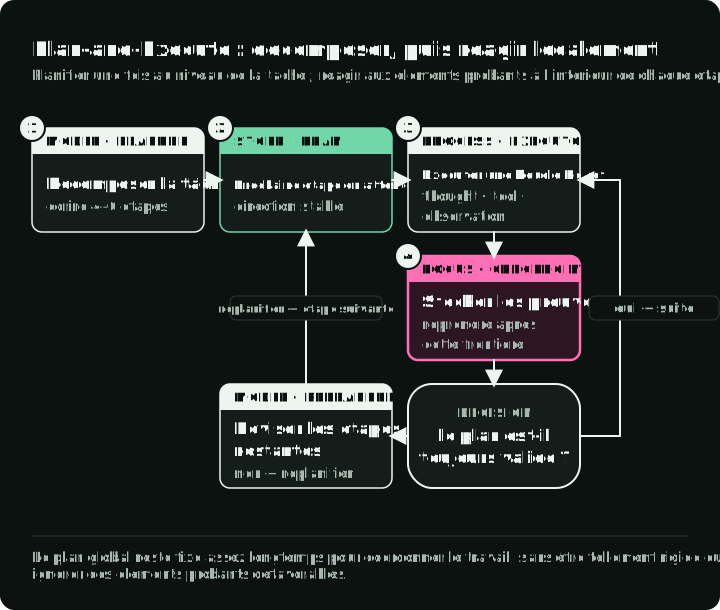
La figure inclut un replanificateur optionnel. Le graphe pédagogique ci-dessous n’a pas de branche de replanification : les résultats peuvent modifier le travail à l’intérieur d’une étape, mais la liste des étapes suivantes reste fixe. N’ajoutez une replanification que lorsque le résultat d’une étape doit modifier cette liste.
Dans une implémentation, le planificateur peut tourner sur un modèle plus puissant et l’executor sur un modèle moins cher, et avec un checkpointer chaque étape terminée devient un point de reprise. Le pattern demande aussi plus d’appels au modèle et plus d’état qu’une simple consultation ; utilisez-le donc seulement lorsque le plan explicite aide le système à accomplir une tâche plus large, comme un rapport de recherche qui se termine par une synthèse.
Choisir une boucle pour la tâche, puis tester son échec
| Signal de la tâche | Flux de contrôle de départ | Exemple | Ce qu’il faut tester |
|---|---|---|---|
| Les étapes de consultation sont déjà connues | Workflow fixe | Cours actuel d’un ticker | Le résultat doit-il être interprété, ou le code peut-il le renvoyer directement ? |
| Un modèle peut nommer chaque appel et chaque dépendance avant l’exécution | ReWOO | Cours, données financières et actualités d’un ticker ; météo dans cinq villes | Que se passe-t-il quand un appel planifié échoue ou que le plan nomme une dépendance invalide ? |
| L’appel suivant dépend du dernier résultat | ReAct | Comprendre pourquoi la marge d’une entreprise a baissé | Peut-il se remettre d’un résultat trompeur et s’arrêter dans un budget limité ? |
| Une longue tâche a des objectifs nommés, chacun nécessitant des décisions locales | Plan-and-Execute | Une thèse d’investissement avec risques et concurrents | L’executor peut-il terminer une étape, et que se passe-t-il quand un résultat invalide des objectifs ultérieurs ? |
Il s’agit d’une règle de départ, pas d’un classement de performances. En particulier, le graphe pédagogique Plan-and-Execute ne peut pas réviser les objectifs ultérieurs. Le worker ReWOO exécute en parallèle les appels dont les dépendances sont prêtes, mais il ne peut pas créer un nouvel appel après avoir vu un résultat. Comparez les routes sur les mêmes tâches, avec le même comportement des outils et le même budget, avant de choisir selon le nombre d’appels au modèle.
Les patterns décrivent des décisions extérieures au modèle. Un modèle qui raisonne entre les tool calls a toujours besoin d’un programme pour exécuter ces appels, arrêter la boucle et autoriser les effets. Quand vous comparez des boucles, comptez les reasoning tokens facturés en plus des appels ; un modèle peut raisonner sans afficher ce texte.
Pour une nouvelle implémentation LangChain, create_agent fournit une boucle d’outils pilotée par les observations. Le graphe compagnon ci-dessous utilise l’ancienne API create_react_agent de LangGraph ; ses extraits expliquent donc le flux de contrôle plutôt que de servir de guide de mise en place pour un nouveau projet.
Si la tâche nécessite des contextes de sous-agents isolés, un système de fichiers et une gestion automatique du contexte, Deep Agents les regroupe autour de la même boucle d’outils. C’est un choix de harness, pas un quatrième pattern de raisonnement. Comparez un agent unique à la délégation sur des tâches qui se découpent en travaux indépendants, et comptez dans le résultat le coût de coordination et le contexte perdu.
Un exemple complet : le Market Analyst Agent
Le Market Analyst Agent fait passer une demande de flash briefing par ReWOO : planifier les appels de données de marché, les exécuter, puis synthétiser les résultats. Une demande de recherche approfondie passe par Plan-and-Execute, avec une boucle ReAct dans chaque étape planifiée. Dans cette route, ReAct est une primitive d’exécution, pas une troisième route pour l’utilisateur. Les routes diffèrent par ce que le planificateur transmet à l’executor : des tool calls proposés exacts pour ReWOO, ou des objectifs qui exigent encore de choisir des outils pour Plan-and-Execute.
Les extraits sont des variantes pédagogiques abrégées du commit b4e769a, et non des scripts autonomes.
Il utilise LangGraph pour l’orchestration. Un nœud est une fonction Python qui renvoie les champs à mettre à jour dans l’état partagé ; une arête choisit le nœud suivant. Les deux routes partagent un même schéma d’état, tandis que leur progression se trouve dans des champs différents :
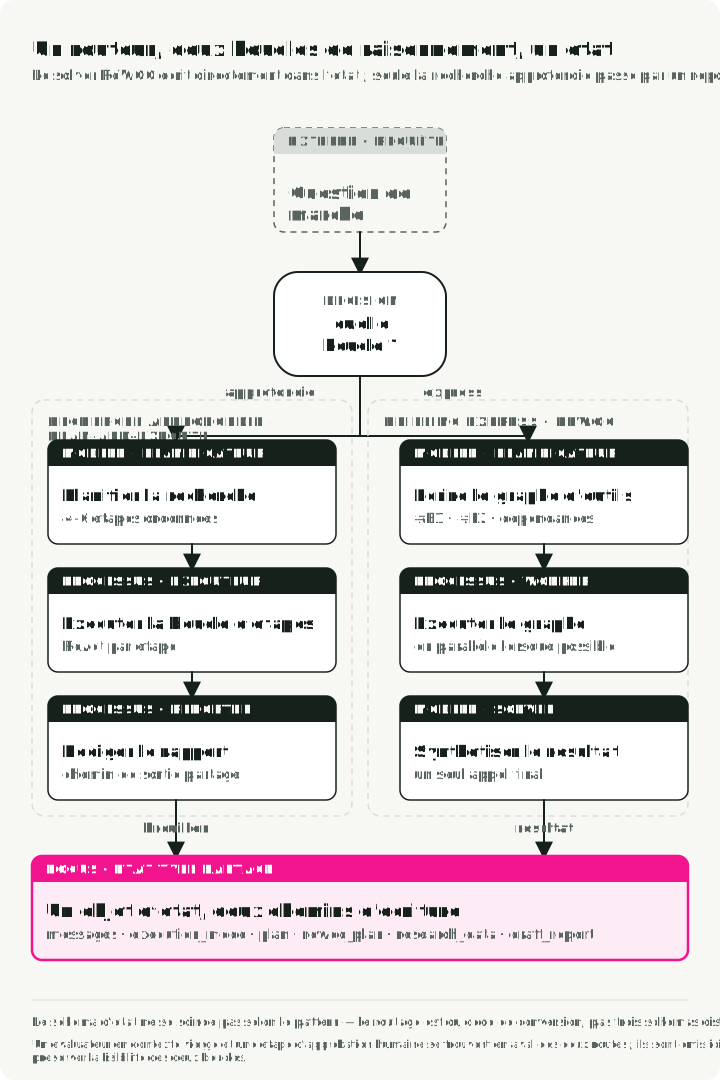
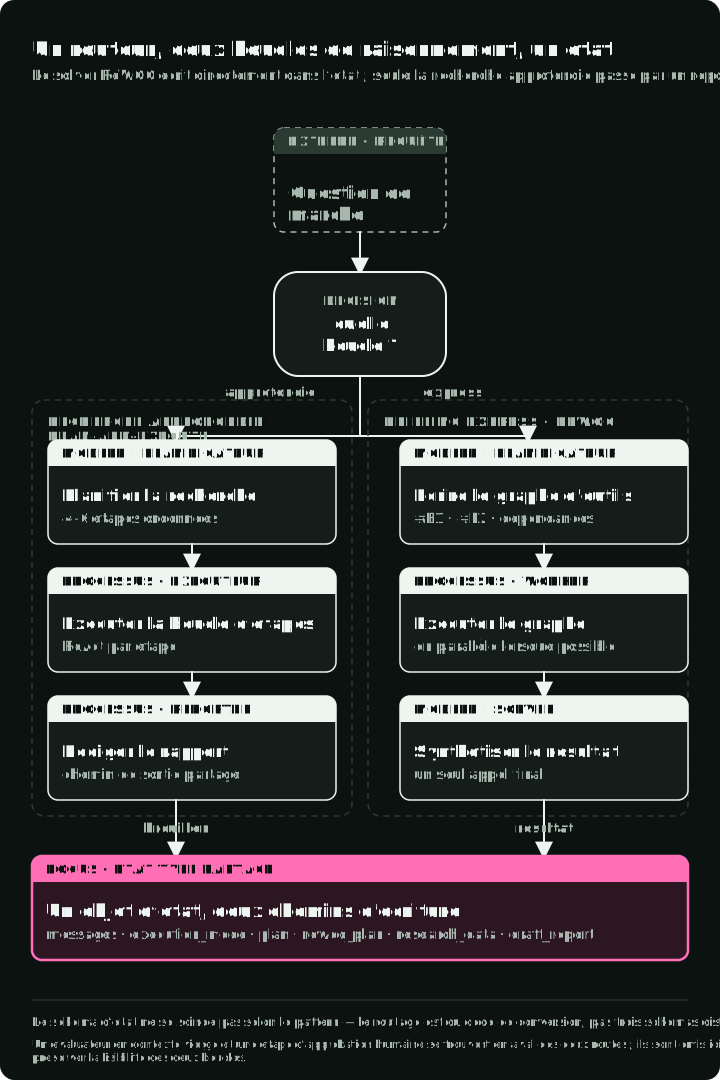
Le diagramme isole le routage et la création du brouillon. Il omet l’évaluateur partagé et l’approbation humaine avant publication, que le câblage du graphe ci-dessous inclut.
Définition de l’état
Le schéma d’état conserve la progression propre à chaque route dans plan ou rewoo_plan et place le brouillon final de l’une ou l’autre route dans draft_report. Les champs de mémoire et d’approbation apparaissent parce que les deux routes partagent le même état applicatif ; ils ne décident pas quelle boucle s’exécute.
from typing import Literal

class PlanStep(BaseModel):
    """A single step in the research plan."""
    step_number: int
    description: str
    tool_hint: str | None = None
    completed: bool = False
    result: str | None = None

class UserProfile(BaseModel):
    """Structured user context loaded from long-term memory."""
    risk_tolerance: str | None = None
    investment_horizon: str | None = None

class AgentState(BaseModel):
    """Main state for the Market Analyst Agent graph."""

    # Identity and profile context for memory-backed personalization
    user_id: str
    user_profile: UserProfile = Field(default_factory=UserProfile)

    # Message history with LangGraph's add_messages reducer
    messages: Annotated[list, add_messages] = Field(default_factory=list)

    # Execution mode (set by router)
    execution_mode: ExecutionMode | None = None

    # Plan-and-Execute state
    plan: list[PlanStep] = Field(default_factory=list)
    current_step_index: int = 0

    # ReWOO state
    rewoo_plan: list[ReWOOPlanStep] = Field(default_factory=list)

    # Research results
    research_data: ResearchData | None = None

    # Final report. Both paths write this field, then the graph pauses before
    # publishing (see interrupt_before below), so a human signs off on a draft
    # a fresh-context evaluator has already voted on.
    draft_report: DraftReport | None = None
    report_approved: bool = False
    evaluator_verdict: Literal["pass", "fail", "needs_human"] | None = None
    evaluator_reasons: list[str] = Field(default_factory=list)
Pattern 1 : implémentation de Plan-and-Execute
Plan-and-Execute convient aux synthèses en plusieurs étapes. Un planificateur rédige les étapes de haut niveau, puis une boucle ReAct exécute chaque étape et réagit aux tool results.
Les extraits compagnons conservent claude-sonnet-4-5-20250929 et l’ancienne API create_react_agent pour rester comparables au commit lié. Pour du nouveau code, utilisez l’interface create_agent actuelle. Migrer ce graphe exige aussi de tester ses schémas de planification, ses messages internes, son routage et son comportement à la reprise ; changer seulement le nom du modèle ne constitue pas cette migration.
Le planificateur fait un appel au modèle et renvoie des descriptions d’étapes. Il n’appelle aucun outil de données de marché. Le structured output vérifie la forme de la réponse ; une vérification distincte reste nécessaire pour obtenir un plan non vide et exploitable.
# System prompt guides the LLM to think like a research analyst
# creating a strategic plan, not immediate tool calls
PLANNER_SYSTEM_PROMPT = """You are a senior investment research analyst.
Break down stock analysis requests into 4-6 research steps covering:
1. Current price and basic metrics
2. Recent news and announcements
3. Competitor analysis (if relevant)
4. Financial health assessment
5. Risk factors
6. Investment thesis synthesis

Output as JSON with step_number, description, and tool_hint."""

# Schema-Guided Reasoning: Enforce structure with Pydantic
class PlanOutput(BaseModel):
    """Structured output for the planner."""

    steps: list[PlanStep] = Field(description="Research steps to execute")
    ticker: str = Field(description="The stock ticker being analyzed")

def planner_node(state: AgentState) -> dict:
    """Generate a research plan from the user's request.

    This is Phase 1 of Plan-and-Execute: creating the high-level strategy.
    """

    # Use a powerful model for strategic planning
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Ask for a typed plan and validate it before execution.
    # The API can still fail, so production code also handles that exception.
    structured_llm = llm.with_structured_output(PlanOutput)

    # Pull the request out of the message history
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    last_user_message = human[-1].content if human else "Analyze the market"

    # Context from long-term memory personalizes the plan
    profile_context = f"""
User Profile:
- Risk Tolerance: {state.user_profile.risk_tolerance}
- Investment Horizon: {state.user_profile.investment_horizon}
"""

    # Single LLM call creates the complete plan
    result: PlanOutput = structured_llm.invoke([
        SystemMessage(content=PLANNER_SYSTEM_PROMPT + profile_context),
        HumanMessage(content=f"Create a research plan for: {last_user_message}"),
    ])

    # State update: Store the plan and initialize tracking
    return {
        "plan": result.steps,           # The sequential steps to execute
        "current_step_index": 0,        # Start at step 0
        "research_data": ResearchData(ticker=result.ticker),  # Initialize data container
    }
Cette ligne llm.with_structured_output(PlanOutput) relève du Schema-Guided Reasoning (SGR), présenté dans un article précédent. Le schéma vérifie les types des champs, mais pas si les étapes sont exploitables. Avant l’exécution, exigez une liste non vide et bornée, avec des numéros d’étape uniques et des descriptions claires.
Pattern 2 : exécution ReAct
Une fois le plan créé, executor_node transmet un objectif et un résumé des résultats précédents à une boucle ReAct interne. La boucle interne peut choisir un autre outil après avoir vu une observation. Quand elle se termine, le graphe externe enregistre le résultat final de l’étape et avance ; il ne conserve pas la transcription interne dans plan.
# Market-data tools available to the inner loop in this excerpt. The repo's
# TOOLS list also has a skill loader, two CLI wrappers, and a restricted Python
# evaluator; Part 3 compares those interfaces, and MCP runs as a sidecar.
TOOLS = [
    get_stock_snapshot,
    get_price_history,
    search_news,
    search_competitors,
    get_financials,
]

def executor_node(state: AgentState) -> dict:
    """Execute the current step using a ReAct agent.

    This is Phase 2 of Plan-and-Execute: adaptive execution of each planned step.
    Each step runs as a mini ReAct loop until completion.
    """

    # Guard against an empty or exhausted plan before indexing it
    if state.current_step_index >= len(state.plan):
        raise ValueError("No plan step to execute; check the planner output")

    # Get the current step from the plan
    current_step = state.plan[state.current_step_index]

    # Build context from what we've learned so far
    # Each step sees a digest of earlier results
    previous_context = ""
    for step in state.plan[:state.current_step_index]:
        if step.result:
            previous_context += f"\nStep {step.step_number}: {step.result}\n"

    # Create a ReAct agent for this step. The companion pins the older
    # create_react_agent API; new code uses create_agent.
    react_agent = create_react_agent(
        model=ChatAnthropic(model="claude-sonnet-4-5-20250929"),
        tools=TOOLS,
    )

    # Invoke the ReAct loop for this single step
    # The agent will loop internally until it completes the step
    result = react_agent.invoke({
        "messages": [
            SystemMessage(content=EXECUTOR_SYSTEM_PROMPT),
            HumanMessage(content=f"""Execute Step {current_step.step_number}:
{current_step.description}

Ticker: {state.research_data.ticker}
Previous findings: {previous_context}"""),
        ]
    })

    # Extract the final answer from the ReAct agent's message history
    # The last message contains the synthesis after all tool calls
    updated_plan = list(state.plan)
    updated_plan[state.current_step_index] = PlanStep(
        step_number=current_step.step_number,
        description=current_step.description,
        completed=True,
        result=str(result["messages"][-1].text),  # Final synthesized answer
    )

    # State update: Mark step complete and advance to next
    return {
        "plan": updated_plan,
        "current_step_index": state.current_step_index + 1,
    }
Pattern 3 : ReWOO pour les snapshots rapides
Pour un briefing rapide, le planificateur renvoie des tool calls proposés au lieu d’objectifs de recherche. Le worker exécute sans modèle les appels dont les dépendances sont prêtes ; le solver fait un seul appel au modèle sur leurs résultats. Ces extraits montrent chaque passage de relais.
Phase 1 : planificateur ReWOO (rédige à l’avance un plan typé d’appels proposés)
class ReWOOPlanStep(BaseModel):
    """A step in the ReWOO plan with variable placeholders.

    Key difference from Plan-and-Execute's PlanStep:
    - Contains actual tool_name and tool_args (not just description)
    - Uses variable references (#E1) for dependencies
    """
    step_id: str  # e.g., "#E1" - becomes a variable
    description: str
    tool_name: str     # Requested tool name; validate it against a registry in production
    tool_args: dict    # Proposed arguments; may contain refs like {"price": "#E1"}
    depends_on: list[str] = []  # Declared ordering; cross-check it against #E placeholders
    result: str | None = None

class ReWOOPlanOutput(BaseModel):
    """Structured output for ReWOO planner."""
    steps: list[ReWOOPlanStep] = Field(description="Planned tool calls with variables")

def rewoo_planner_node(state: AgentState) -> dict:
    """Generate a complete plan of tool calls upfront.

    This is the key difference from Plan-and-Execute: instead of creating
    human-readable step descriptions, it creates typed proposed tool calls.
    Production code validates them before execution; this teaching worker does not.
    """

    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Schema-Guided Reasoning validates the planner response shape.
    # It does not validate a tool name, its arguments, or its dependencies.
    structured_llm = llm.with_structured_output(ReWOOPlanOutput)

    ticker = state.research_data.ticker if state.research_data else "UNKNOWN"
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    query = human[-1].content if human else f"Analyze {ticker}"

    # Single LLM call to plan ALL tool executions
    result: ReWOOPlanOutput = structured_llm.invoke([
        SystemMessage(content=REWOO_PLANNER_PROMPT),
        HumanMessage(content=f"""Create a ReWOO plan for: {query}

Ticker: {ticker}

Output tool calls with:
- step_id: Variable name (#E1, #E2, etc.)
- description: What this accomplishes
- tool_name: Exact tool from the list
- tool_args: Dictionary of arguments
- depends_on: List of step_ids this depends on"""),
    ])

    # Store the typed proposed-call plan.
    # This teaching worker sends ready steps directly to execute_tool.
    return {"rewoo_plan": result.steps}
Phase 2 : worker ReWOO (exécute les outils sans raisonnement du LLM)
def rewoo_worker_node(state: AgentState) -> dict:
    """Execute dependency-ready tools in parallel batches (no LLM calls).

    Independent tools share a batch. Dependent tools wait until their
    prerequisites complete. The worker follows the dependency graph and
    does not add LLM calls.
    """

    results = {}        # Results keyed by step_id (e.g., "#E1": "$150.23")
    updated_steps = []  # Plan steps with their result field filled in
    pending = {step.step_id: step for step in state.rewoo_plan}

    # Keep scheduling dependency-ready batches until the graph is complete.
    # This handles chains even when the planner does not list them topologically.
    with ThreadPoolExecutor(max_workers=5) as executor:
        while pending:
            ready = [
                step for step in pending.values()
                if all(dep in results for dep in step.depends_on)
            ]
            if not ready:
                unresolved = ", ".join(pending)
                raise ValueError(f"Unresolvable ReWOO dependencies: {unresolved}")

            futures = {
                executor.submit(execute_tool, step, results): step
                for step in ready
            }
            for future in as_completed(futures):
                step = futures[future]
                results[step.step_id] = future.result()
                updated_steps.append(step.model_copy(update={"result": results[step.step_id]}))
                del pending[step.step_id]

    # State update: restore the planner's order (sorting on step_id would put
    # "#E10" before "#E2") and hand the filled-in plan to the Solver
    plan_order = {s.step_id: i for i, s in enumerate(state.rewoo_plan)}
    return {"rewoo_plan": sorted(updated_steps, key=lambda s: plan_order[s.step_id])}
Phase 3 : solver ReWOO (synthétise tous les résultats en un seul appel au LLM)
def rewoo_solver_node(state: AgentState) -> dict:
    """Synthesize all tool results into a flash briefing.

    This is the second efficiency gain: Instead of interleaving
    LLM calls with tool execution (like ReAct), we make ONE
    final synthesis call with all gathered data.
    """

    # Build context from ALL tool results at once
    tool_results = []
    for step in state.rewoo_plan:
        if step.result:
            tool_results.append(f"### {step.description}\n{step.result}")

    context = "\n\n".join(tool_results)

    # Single LLM call to synthesize everything
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
    structured_llm = llm.with_structured_output(FlashBriefingOutput)
    result = structured_llm.invoke([
        SystemMessage(content=REWOO_SOLVER_PROMPT),
        HumanMessage(content=f"Create a flash briefing from this data:\n\n{context}"),
    ])

    # FlashBriefingOutput and DraftReport carry the same fields; the state
    # schema expects DraftReport, so convert before returning.
    return {"draft_report": DraftReport(**result.model_dump())}
Le planificateur rédige les appels proposés, le worker remplit leurs placeholders et le solver reçoit les résultats. Le schéma vérifie leur forme, pas la capacité du plan à s’exécuter. Le dictionnaire pending ci-dessus supprime silencieusement les ID en double. Si #E2 utilise #E1 dans ses arguments mais omet #E1 dans depends_on, les deux appels peuvent entrer dans le même lot avant que le premier résultat n’existe.
Avant l’envoi, rejetez les plans vides ou trop grands, les ID en double, les dépendances manquantes et les cycles. Validez les noms d’outils et les arguments par rapport à un registre. Inspectez les placeholders à l’intérieur des valeurs imbriquées et exigez qu’ils correspondent à depends_on. Ce worker pédagogique saute ces vérifications. Il envoie les appels prêts à execute_tool du code compagnon, dont les exceptions interceptées deviennent des chaînes d’erreur. Le solver doit traiter une telle chaîne comme une preuve manquante, pas comme une consultation réussie. Un graphe impossible à résoudre s’arrête avant le solver. La reprise nécessite un résultat d’échec, une arête de replanification conditionnelle et une limite de tentatives.
Ce sur quoi le planificateur s’engage
| Route dans ce graphe | Avant le premier appel de données de marché | Après un tool result | Appels au modèle dans cette implémentation | Nœuds |
|---|---|---|---|---|
| Deep research : Plan-and-Execute avec étapes ReAct | Le planificateur rédige des descriptions d’objectifs | La boucle ReAct interne peut choisir un autre appel dans son objectif actuel ; les objectifs ultérieurs restent fixes | Un plan, une boucle modèle/outil par étape, un rapport | planner_node → executor_node par étape → reporter_node |
| Flash briefing : ReWOO | Le planificateur rédige les noms d’outils, les arguments et les dépendances | Le worker suit le plan ; le solver voit les résultats après l’exécution | Un plan, aucun appel au modèle dans le worker, une synthèse | rewoo_planner_node → rewoo_worker_node → rewoo_solver_node |
Un PlanStep qui dit « Investigate recent earnings » laisse le choix de l’outil à l’agent interne. Un ReWOOPlanStep qui nomme search_news et fournit sa requête s’engage sur cet appel avant qu’un résultat n’arrive. C’est cette différence, et non le nom du pattern, qui décide quelles observations inattendues peuvent modifier l’exécution. Côte à côte, les deux sorties du planificateur ressemblent à ceci :
# Plan-and-Execute: goals; the inner ReAct loop picks the tools.
plan = [
    PlanStep(step_number=1, description="Get current price and key metrics",
             tool_hint="get_stock_snapshot"),
    PlanStep(step_number=2, description="Search for recent news and earnings",
             tool_hint="search_news"),
]

# ReWOO: exact calls, fixed before any result arrives.
rewoo_plan = [
    ReWOOPlanStep(step_id="#E1", description="Read the price and valuation snapshot",
                  tool_name="get_stock_snapshot", tool_args={"ticker": "NVDA"}),
    ReWOOPlanStep(step_id="#E2", description="Find recent NVDA earnings news",
                  tool_name="search_news",
                  tool_args={"query": "NVDA earnings", "max_results": 5}),
]
Un tool_hint est un conseil que l’executor peut ignorer. Un tool_name avec tool_args est l’appel que le worker effectuera.
Une boucle ReAct autonome peut transporter chaque message précédent dans chaque nouvel appel au modèle. Ce graphe démarre chaque boucle interne avec son étape actuelle et un résumé des étapes terminées. L’état externe conserve les résultats des étapes, pas la transcription interne des tool calls. ReWOO, lui, remplit les étapes planifiées avec les résultats et transmet la liste complète à son solver. Ce sont des choix de gestion du contexte propres à ce code compagnon, pas des exigences des articles originaux.
Relier les deux routes dans un graphe
Le graphe comporte deux routes pour l’utilisateur sur un seul AgentState : deep research utilise Plan-and-Execute avec une boucle ReAct dans chaque étape, tandis que flash briefing utilise ReWOO.
Cette implémentation n’a pas de replanificateur : elle exécute le plan initial jusqu’au bout. Ajouter une replanification nécessiterait une arête de executor vers planner et une règle précisant quand un résultat surprenant justifie un nouvel appel au modèle.
LangGraph garde le câblage déclaratif :
def create_graph(checkpointer=None):
    builder = StateGraph(AgentState)

    # Add nodes
    builder.add_node("router", router_node)
    builder.add_node("planner", planner_node)
    builder.add_node("executor", executor_node)
    builder.add_node("reporter", reporter_node)
    builder.add_node("rewoo_planner", rewoo_planner_node)
    builder.add_node("rewoo_worker", rewoo_worker_node)
    builder.add_node("rewoo_solver", rewoo_solver_node)
    builder.add_node("evaluator", evaluator_node)
    builder.add_node("publish", publish_node)

    # Define edges
    builder.add_edge(START, "router")
    builder.add_conditional_edges("router", route_after_router, {
        "planner": "planner",
        "rewoo_planner": "rewoo_planner",
    })

    # Deep Research path
    builder.add_edge("planner", "executor")
    builder.add_conditional_edges("executor", route_after_executor, {
        "executor": "executor",  # Loop back for more steps
        "reporter": "reporter",  # Done with plan
    })
    builder.add_edge("reporter", "evaluator")

    # Flash Briefing path (ReWOO)
    builder.add_edge("rewoo_planner", "rewoo_worker")
    builder.add_edge("rewoo_worker", "rewoo_solver")
    builder.add_edge("rewoo_solver", "evaluator")

    # Both paths run the same evaluator before the human approval step.
    builder.add_edge("evaluator", "publish")
    builder.add_edge("publish", END)

    return builder.compile(
        checkpointer=checkpointer,
        # Human-in-the-loop pause: the reporter (or ReWOO solver) writes a
        # draft. A separate model session reads that draft and records its
        # assessment. The graph then stops before publishing, whichever
        # assessment it produced, so a human can review both the draft and
        # assessment. Part 6 explains how the program decides a run is complete.
        interrupt_before=["publish"],
    )
Tester si l’appel au modèle du routeur est utile
Le routeur classe les snapshots rapides, y compris « current price », comme ReWOO, et les demandes complexes comme une thèse d’investissement comme Plan-and-Execute. Par défaut, il choisit deep research quand la classification n’est pas claire. Le Schema-Guided Reasoning restreint la sortie du classifieur à l’un des deux modes :
class ExecutionMode(str, Enum):
    DEEP_RESEARCH = "deep_research"  # Plan-and-Execute with ReAct steps
    FLASH_BRIEFING = "flash_briefing"  # ReWOO

class RouterOutput(BaseModel):
    mode: ExecutionMode
    ticker: str
    reasoning: str

ROUTER_SYSTEM_PROMPT = """Classify the user's request:

1. deep_research: complex analysis requiring synthesis
   - Examples: "Analyze strategic risks", "investment thesis"
2. flash_briefing: quick snapshots, simple data retrieval
   - Examples: "quick snapshot", "current price"

Default to deep_research if unclear."""

llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
structured_llm = llm.with_structured_output(RouterOutput)
C’est ainsi que cette application route les demandes ; ce n’est pas la preuve que toute consultation de cours a besoin d’un planificateur. Pour une demande qui ne porte que sur le cours, un appel direct à l’outil éviterait les appels du routeur, du planificateur ReWOO et du solver. Ces appels ne se justifient que pour les demandes qui nécessitent qu’un modèle sélectionne ou explique des données.
Un routeur peut aussi envoyer une demande vers la mauvaise boucle. Comparez les deux routes et un workflow fixe sur les mêmes tâches, outils et budget. Enregistrez l’accomplissement de la tâche, les acceptations indues, les tokens mis en cache et non mis en cache, le temps réel et la reprise après des erreurs d’outils ou des observations trompeuses. Répétez les exécutions lorsque le choix du modèle est stochastique et comptez chaque tentative lancée. Un nombre d’appels plus faible n’aide que si la route accomplit toujours la tâche dans ses contraintes. Le retour d’expérience d’ingénierie d’Anthropic recommande lui aussi de commencer par des workflows simples et composables.
L’implémentation compagnon complète, y compris le routeur et l’état partagé, se trouve dans le commit b4e769a du Market Analyst Agent.
Essayer l’API actuelle à boucle unique
Le graphe ci-dessus utilise une ancienne factory d’agents de LangGraph. Si vous voulez d’abord examiner l’API create_agent actuelle, cette petite fixture évite les services de données de marché. Elle montre un appel modèle/outil et son résultat, pas une raison d’utiliser un agent pour une consultation connue. Dans une application qui ne répond qu’à cette question, appelez directement la fonction de consultation.
Définissez ANTHROPIC_API_KEY et installez langchain et langchain-anthropic avant d’exécuter l’extrait. L’invocation effectue une requête payante au modèle.
from langchain.agents import create_agent
from langchain_anthropic import ChatAnthropic

def lookup_fixture_company(ticker: str) -> str:
    """Look up a company name in a local fixture, not live market data."""
    return {"NVDA": "NVIDIA", "AMD": "AMD"}.get(
        ticker.strip().upper(), "No company in the fixture"
    )

agent = create_agent(
    model=ChatAnthropic(model="claude-sonnet-5", max_tokens=4096),
    tools=[lookup_fixture_company],
    system_prompt="Use the fixture for company names. Do not invent market data.",
)
result = agent.invoke({
    "messages": [{"role": "user", "content": "Which company is NVDA in the fixture?"}]
})
print(result["messages"][-1].text)
Si le modèle propose lookup_fixture_company, la bibliothèque appelle cette fonction Python et lui renvoie son résultat. L’extrait ne garantit pas que le modèle utilisera l’outil, et il ne teste ni une comparaison de routes, ni une politique d’échec, ni la précision sur des données réelles.
La couche suivante est la mémoire
La boucle décide quel appel vient ensuite ; le reste du harness doit fournir le contexte, exécuter et autoriser les appels, préserver l’état et vérifier l’achèvement. La Partie 2, architecture de mémoire des agents AI distingue les checkpoints permettant la reprise des connaissances entre sessions et des documents de projet. Sans checkpoints durables, un redémarrage du worker perd l’état en cours de ce graphe. La Partie 3 examine les interfaces d’outils, la Partie 4 traite de l’autorisation, la Partie 5 de l’exécution et de la reprise, et la Partie 6 examine les preuves d’achèvement.
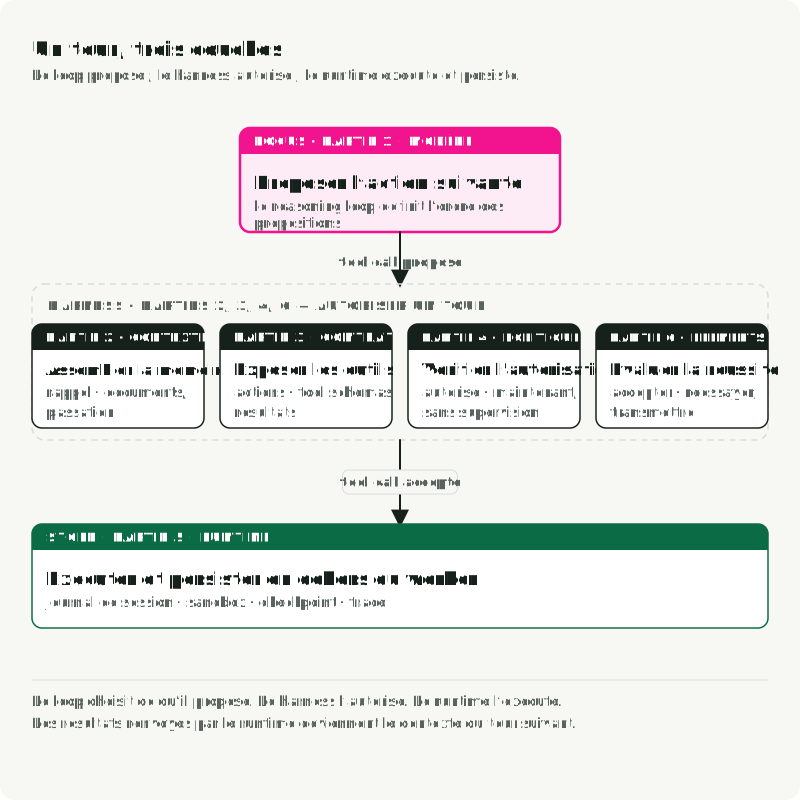
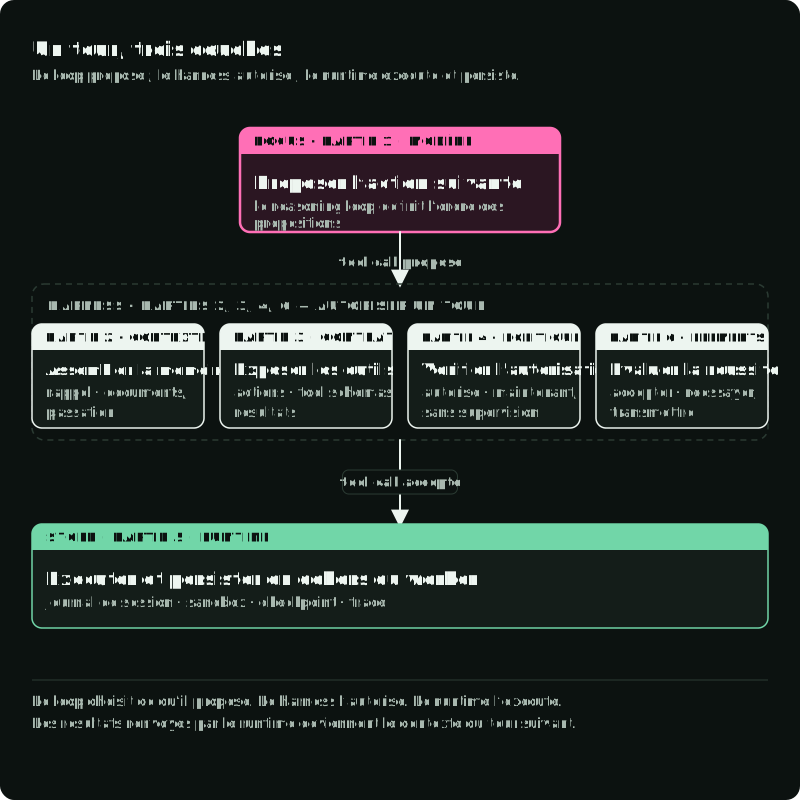
La figure place chaque partie au point d’un tour où elle agit.
Références
- ReAct: Synergizing Reasoning and Acting in Language Models (Yao et al., 2022)
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models (Xu et al., 2023)
- Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models (Wang et al., 2023)
- Market Analyst Agent Repository