Reasoning loops voor AI agents: ReAct, ReWOO, Plan-and-Execute

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Een agent reasoning loop is de control flow die bepaalt wanneer een model een actie kiest, een tool result ontvangt en opnieuw kiest, of stopt. Dit artikel is bedoeld voor engineers die bepalen hoe een agent werk moet afhandelen waarvan de volgende stap kan afhangen van wat de tools vinden. Je leert wanneer je ReAct, ReWOO of Plan-and-Execute gebruikt, en hoe die keuzes eruitzien in een LangGraph-implementatie.
Een vraag naar de actuele koers van een aandeel heeft bekende opzoekstappen. Een onderzoek naar waarom de vooruitzichten zijn veranderd, kan vereisen dat de volgende zoekopdracht afhangt van het eerste resultaat. Het model heeft bij die twee taken verschillende vrijheid nodig, en de tweede vraagt meestal meer model calls.
Dit is Deel 1 van Engineering the Agentic Stack. De loop is de binnenste laag; latere delen behandelen memory, tools, security, runtime en de checks voordat een taak als klaar geldt. Het uitgewerkte voorbeeld is een Market Analyst Agent gebouwd met LangGraph.
Een korte vergelijking van de frameworks die deze loops implementeren vind je in Best AI Agent Frameworks in 2026.
De beslissingen die een model moet nemen
Zet de beslissingen op een rij die overblijven zodra het verzoek en de tools vastliggen. Voor een koersopvraag kan de applicatie de koerstool aanroepen en het resultaat aan een model geven voor uitleg. Als de gebruiker om een briefing vraagt met koers, financiële cijfers en recent nieuws, kan een planner die onafhankelijke calls vooraf benoemen. Als nieuws over een herziening van de winstcijfers een nieuwe query vereist, volstaat een vaste lijst niet meer: het model moet het resultaat zien voordat het die query kiest.
Drie vragen bepalen de loop:
- Kan code de calls nu benoemen? Gebruik dan een vaste workflow. Een model kan de resultaten nog steeds samenvatten, maar hoeft de volgorde van de opzoekingen niet te bepalen.
- Als een model de calls moet kiezen, kan het ze dan allemaal benoemen voordat het resultaten ziet? ReWOO kan dat plan uitvoeren zonder tussen de calls naar het model terug te gaan. De worker kan onafhankelijke calls samen uitvoeren.
- Kan een resultaat de volgende call of een later doel veranderen? ReAct geeft het model na elke observatie een nieuwe beslissing. Plan-and-Execute zet een vooraf opgestelde lijst met doelen om zulke lokale loops heen; latere doelen veranderen vereist een aparte replanning-stap.
De keuze bepaalt ook waar een fout zichtbaar wordt. Een verkeerd ReWOO-plan kan meerdere calls doorlopen voordat de solver een probleem ziet. Een ReAct loop kan herstellen van een onverwacht resultaat, maar kan ook afdwalen of werk herhalen. Een vooraf opgesteld plan maakt een lange taak makkelijker te volgen, maar een lokale executor kan een verkeerd totaalplan niet ongemerkt repareren. Elk patroon heeft nog steeds een stopregel, toolrechten en een manier om mislukte calls te melden nodig; de loop zelf levert geen van die garanties.
Wat elk patroon met een resultaat doet
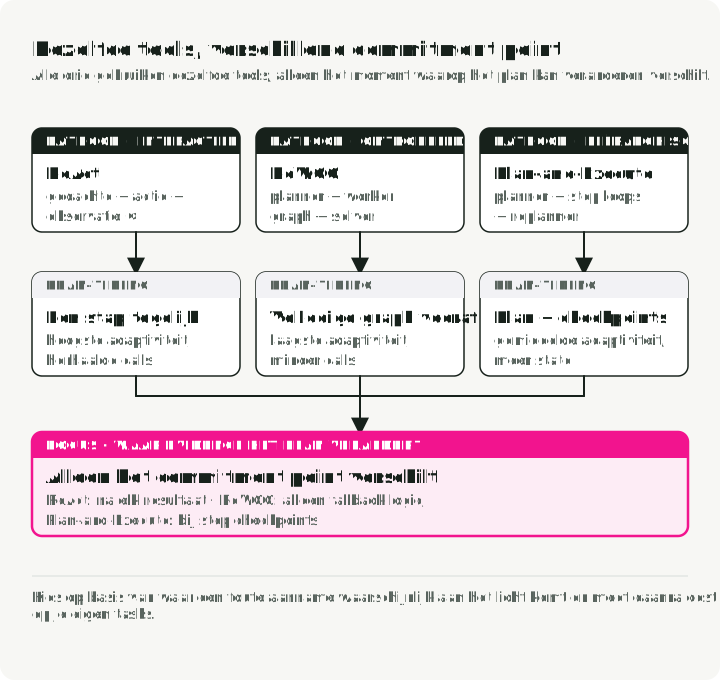
Alle drie de patronen roepen dezelfde tools aan. Ze verschillen in wanneer een tool result het plan kan veranderen: na elke call, pas na de uitvoering, of binnen elke geplande stap.
ReAct: na elke observatie beslissen
ReAct (Yao et al., 2022), kort voor Reason + Act, herhaalt één beslissing: het model kiest een tool call, de applicatie voert die uit en het resultaat gaat terug naar het model. Bij een verzoek om de dalende marge van een bedrijf te onderzoeken, kan een financieel overzicht wijzen op stijgende kosten; de volgende call kan dan zoeken naar bewijs over die kosten. Het model hoeft die tweede call niet te kiezen voordat het het overzicht heeft gezien.
De oorspronkelijke paper schrijft dit als Thought → Action → Observation. Native APIs voor tools geven de voorgestelde call en het tool result terug, maar hoeven de interne reasoning van het model niet te tonen. Thinking tussen tool calls is een aparte mogelijkheid van model en API.
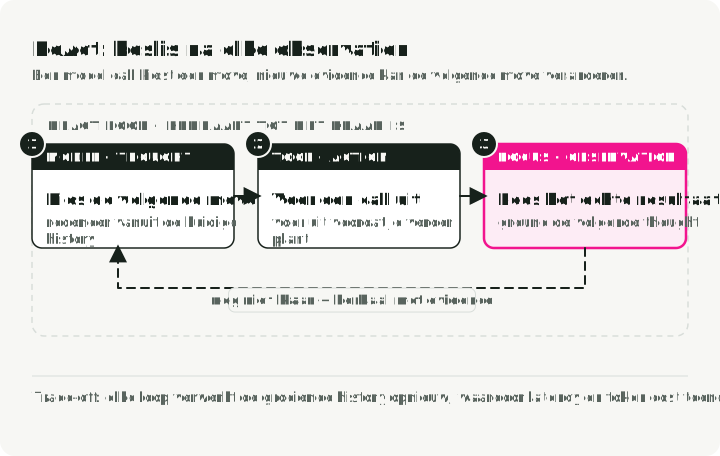
Die feedback is het voordeel van ReAct: een verrassende observatie kan de volgende actie veranderen. De geschiedenis van tool calls laat ook zien welk bewijs het systeem heeft opgehaald. In de handmatige PaLM-540B-HotpotQA-steekproef van de paper leverden Wikipedia-observaties minder gehallucineerde feiten op dan chain-of-thought prompting. Die bevinding gaat over die taak en dat model, niet over de nauwkeurigheid van elke loop die tools gebruikt.
De prijs is herhaalde beslissingen. Een implementatie met volledige geschiedenis stuurt bij elke turn een steeds langer gesprek. Prompt caching kan de herhaalde verwerking van input en de kosten daarvan verlagen, maar haalt oude observaties niet uit het context window. Samenvatten of afkappen haalt wel informatie weg. Beperk het aantal stappen en de doorlooptijd, en test of de agent herstelt van een slecht resultaat of alleen blijft zoeken.
Gebruik ReAct voor verkennend onderzoek, debugging en taken waarbij je de volgende actie niet kunt voorspellen.
ReWOO: eerst de toolgraaf compileren
ReWOO (Reasoning WithOut Observation) scheidt de planning call van een model van zijn uiteindelijke antwoord. De planner benoemt alle tool calls voordat er een resultaat binnenkomt. Hij kan naar een toekomstig resultaat verwijzen als #E1 en #E1 daarna in de argumenten van een latere call zetten. Een worker zonder LLM lost die placeholders op en voert de calls uit; een solver-model ontvangt de verzamelde resultaten en schrijft het antwoord.
Voor een snapshot van de markt kan de planner koers, financiële cijfers en recent nieuws tegelijk aanvragen. De worker in dit artikel voert calls waarvan de afhankelijkheden klaar zijn parallel uit. Die batching is een implementatiekeuze; het bepalende kenmerk in de paper is dat de worker een plan volgt zonder het model te vragen wat hij hierna moet doen.
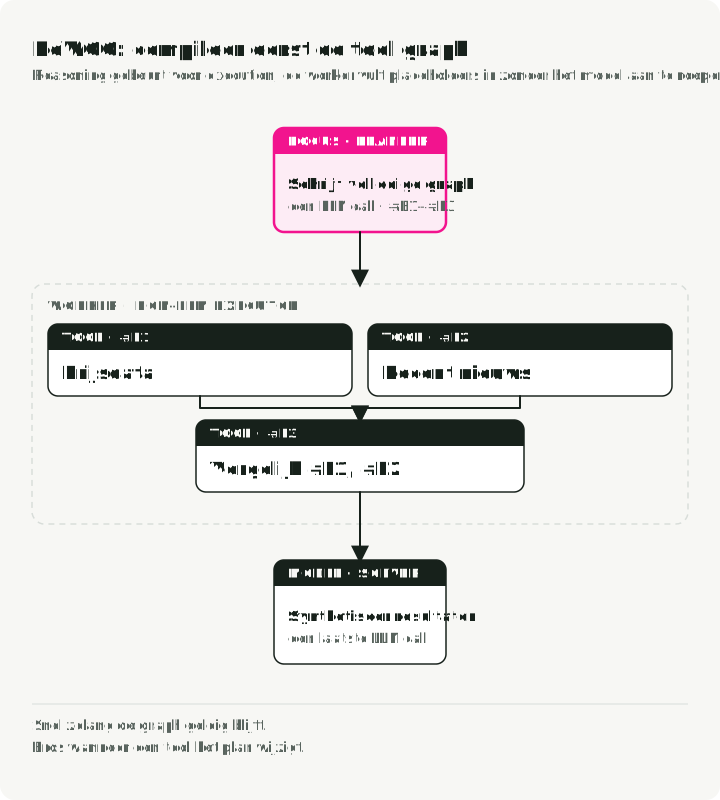
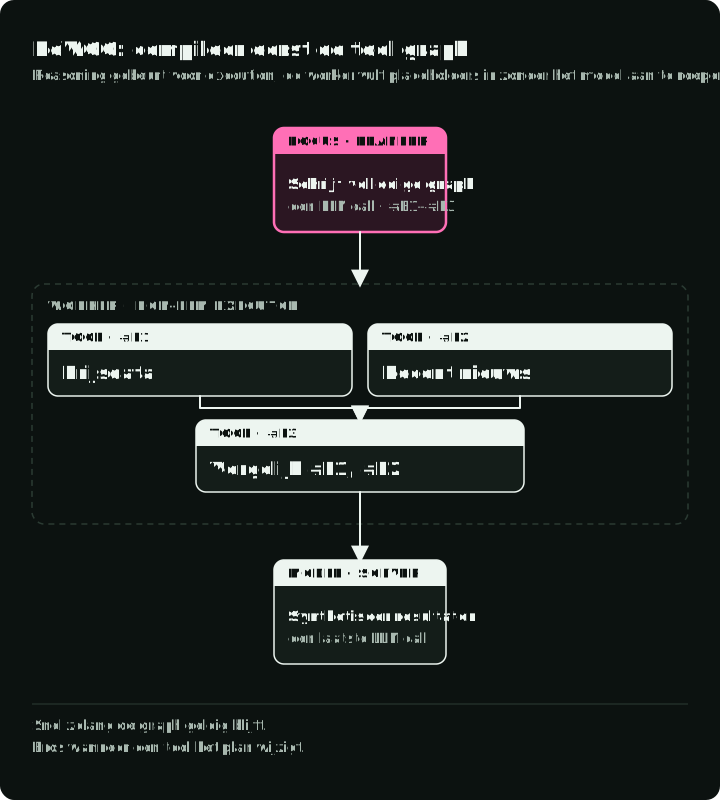
Tijdens de uitvoering zijn er minder model calls, zolang het oorspronkelijke plan bruikbaar blijft. De HotpotQA-stresstest van de paper verving elk tool result door No evidence found; ReWOO verloor in die test minder nauwkeurigheid dan ReAct. Het ontbrekende bewijs kreeg het daarmee nog niet terug. Een worker moet bepalen of een fout naar de solver gaat, opnieuw wordt geprobeerd of de uitvoering stopt. Een verkeerde afhankelijkheid of een ontbrekende tool kan de solver niet meer herstellen als de calls al zijn uitgevoerd.
Omdat de planner nooit een tool result leest, kan hij afzonderlijk met fine-tuning worden aangepast of getest, zonder live toolomgeving. Gebruik ReWOO voor snelle snapshots, statuschecks en dashboards met voorspelbaar toolgedrag.
Plan-and-Execute: opsplitsen en dan lokaal reageren
Plan-and-Solve prompting maakt eerst een plan en lost daarna de deeltaken op. Het verwante patroon voor tool-orchestration, Plan-and-Execute, laat een planner doelen op hoog niveau opsommen en een executor ze één voor één afhandelen. De Market Analyst Agent vraagt om onderzoeksstappen zoals de financiële gezondheid controleren en risico’s onderzoeken. Binnen elke stap kan een ReAct loop tools kiezen nadat hij resultaten heeft gezien. De output van de planner is een lijst met doelen, anders dan de voorgestelde tool calls van ReWOO.
De Plan-and-Solve-paper onderzocht zero-shot prompting, niet deze graaf met tools. Verschillende models kiezen voor planning en uitvoering is mogelijk in een implementatie; het is geen resultaat dat die paper aantoont.
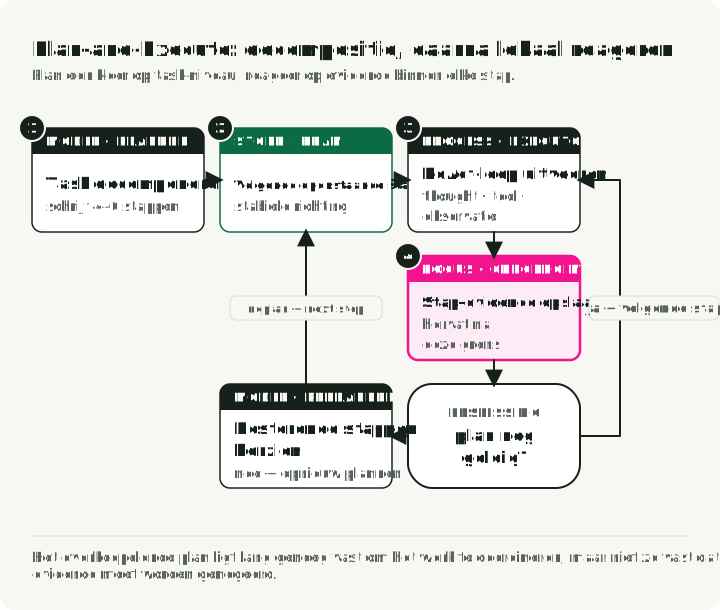
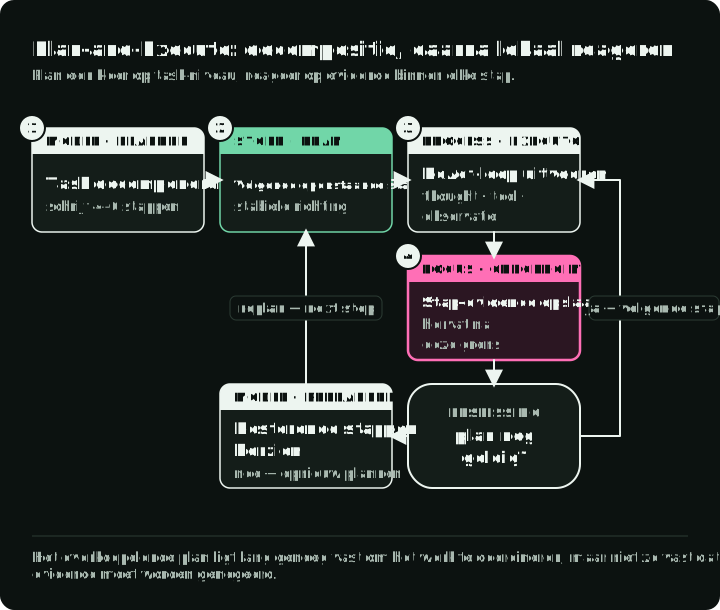
De figuur bevat een optionele replanner. De lesgraaf hieronder heeft geen replanning-tak: resultaten kunnen het werk binnen een stap veranderen, maar de lijst met latere stappen blijft vast. Voeg replanning alleen toe wanneer het resultaat van een stap die lijst moet veranderen.
In een implementatie kan de planner op een sterker model draaien en de executor op een goedkoper model, en met een checkpointer wordt elke afgeronde stap een punt waarop je kunt hervatten. Het patroon vraagt ook meer model calls en meer state dan één opzoeking. Gebruik het dus alleen wanneer het expliciete plan het systeem helpt een grotere taak af te ronden, zoals een onderzoeksrapport dat eindigt met een synthese.
Kies een loop voor de taak en test daarna het falen
| Signaal van de taak | Control flow om mee te beginnen | Voorbeeld | Wat je test |
|---|---|---|---|
| De opzoekstappen zijn al bekend | Vaste workflow | Actuele koers voor één ticker | Moet het resultaat worden geïnterpreteerd, of kan code het direct teruggeven? |
| Een model kan elke call en afhankelijkheid vóór de uitvoering benoemen | ReWOO | Koers, financiële cijfers en nieuws voor één ticker; het weer in vijf steden | Wat gebeurt er als een geplande call faalt of het plan een ongeldige afhankelijkheid noemt? |
| De volgende call hangt af van het laatste resultaat | ReAct | Uitzoeken waarom de marge van een bedrijf daalde | Kan hij herstellen van een misleidend resultaat en stoppen binnen een begrensd budget? |
| Een lange taak heeft benoemde doelen die elk lokale beslissingen vragen | Plan-and-Execute | Een investeringsthese met risico’s en concurrenten | Kan de executor een stap afronden, en wat gebeurt er als een resultaat latere doelen ongeldig maakt? |
Dit is een startregel, geen prestatieranking. Met name kan de Plan-and-Execute-lesgraaf latere doelen niet herzien. De ReWOO-worker voert calls met klaarstaande afhankelijkheden parallel uit, maar kan na een resultaat geen nieuwe call aanmaken. Vergelijk de routes op dezelfde taken, met hetzelfde toolgedrag en budget, voordat je kiest op basis van het aantal model calls.
De patronen beschrijven beslissingen buiten het model. Een model dat reasoning doet tussen tool calls heeft nog steeds een programma nodig dat die calls uitvoert, de loop stopt en effecten autoriseert. Tel bij het vergelijken van loops naast de calls ook de gefactureerde reasoning tokens; een model kan reasoning doen zonder die tekst te tonen.
Voor een nieuwe LangChain-implementatie levert create_agent een toolloop die door observaties wordt gestuurd. De begeleidende graaf hieronder gebruikt de oudere create_react_agent-API van LangGraph, dus de fragmenten leggen de control flow uit en zijn geen setup-gids voor een nieuw project.
Als de taak geïsoleerde subagent-contexten, een bestandssysteem en automatisch contextbeheer nodig heeft, bundelt Deep Agents die rond dezelfde toolloop. Dat is een keuze voor de harness, geen vierde reasoning-patroon. Vergelijk één agent met delegatie op taken die in onafhankelijk werk uiteenvallen, en reken coördinatiekosten en verloren context mee in het resultaat.
Een uitgewerkt voorbeeld: de Market Analyst Agent
De Market Analyst Agent stuurt een verzoek om een flash briefing door ReWOO: marktdata-calls plannen, uitvoeren en de resultaten daarna samenvoegen. Een verzoek om dieper onderzoek gaat door Plan-and-Execute, met een ReAct loop in elke geplande stap. ReAct is in die route een bouwsteen voor uitvoering, geen derde route voor de gebruiker. De routes verschillen in wat de planner aan de executor doorgeeft: exacte voorgestelde tool calls bij ReWOO, of doelen waarvoor nog tools gekozen moeten worden bij Plan-and-Execute.
De fragmenten zijn ingekorte lesvarianten van commit b4e769a, geen zelfstandige scripts.
Het gebruikt LangGraph voor orchestration. Een node is een Python-functie die velden teruggeeft die in de gedeelde state moeten worden bijgewerkt; een edge kiest de volgende node. Beide routes delen één state-schema, terwijl hun voortgang in verschillende velden staat:
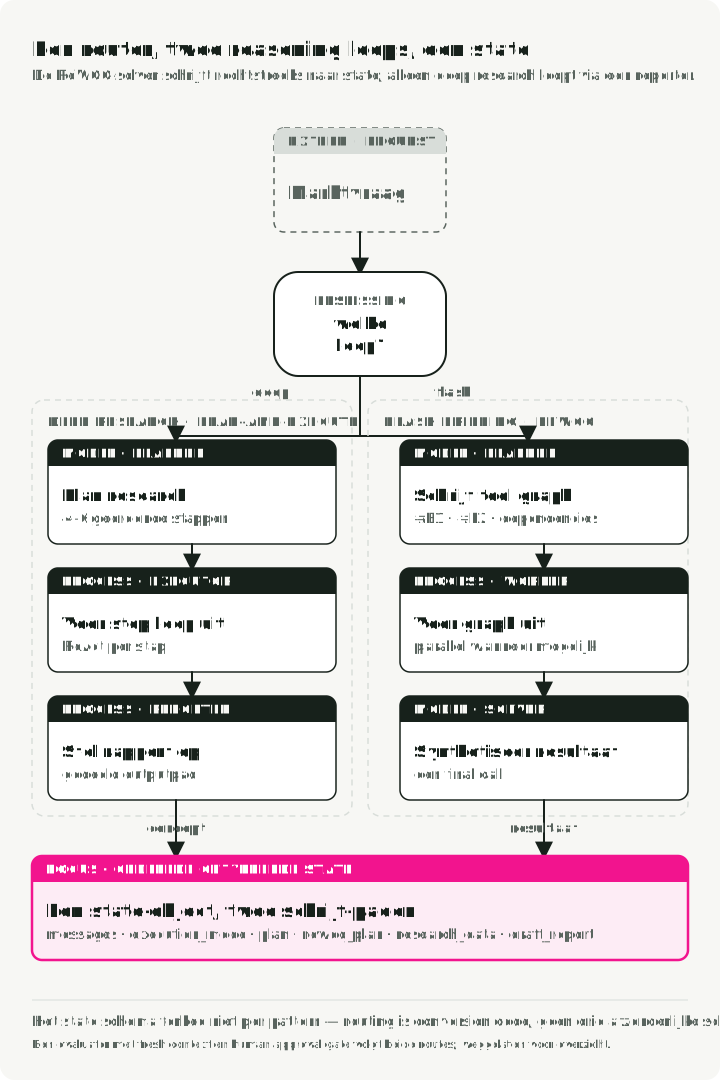
Het diagram toont alleen routing en het maken van het concept. Het laat de gedeelde evaluator en de menselijke goedkeuring vóór publicatie weg, die wel in de graafbedrading hieronder staan.
State-definitie
Het state-schema houdt de routespecifieke voortgang bij in plan of rewoo_plan en zet het definitieve concept van beide routes in draft_report. Velden voor memory en goedkeuring staan erin omdat beide routes dezelfde applicatiestate delen; ze bepalen niet welke loop draait.
from typing import Literal

class PlanStep(BaseModel):
    """A single step in the research plan."""
    step_number: int
    description: str
    tool_hint: str | None = None
    completed: bool = False
    result: str | None = None

class UserProfile(BaseModel):
    """Structured user context loaded from long-term memory."""
    risk_tolerance: str | None = None
    investment_horizon: str | None = None

class AgentState(BaseModel):
    """Main state for the Market Analyst Agent graph."""

    # Identity and profile context for memory-backed personalization
    user_id: str
    user_profile: UserProfile = Field(default_factory=UserProfile)

    # Message history with LangGraph's add_messages reducer
    messages: Annotated[list, add_messages] = Field(default_factory=list)

    # Execution mode (set by router)
    execution_mode: ExecutionMode | None = None

    # Plan-and-Execute state
    plan: list[PlanStep] = Field(default_factory=list)
    current_step_index: int = 0

    # ReWOO state
    rewoo_plan: list[ReWOOPlanStep] = Field(default_factory=list)

    # Research results
    research_data: ResearchData | None = None

    # Final report. Both paths write this field, then the graph pauses before
    # publishing (see interrupt_before below), so a human signs off on a draft
    # a fresh-context evaluator has already voted on.
    draft_report: DraftReport | None = None
    report_approved: bool = False
    evaluator_verdict: Literal["pass", "fail", "needs_human"] | None = None
    evaluator_reasons: list[str] = Field(default_factory=list)
Patroon 1: implementatie van Plan-and-Execute
Plan-and-Execute past bij synthese in meerdere stappen. Een planner schrijft de stappen op hoog niveau, daarna voert een ReAct loop elke stap uit en reageert op tool results.
De begeleidende fragmenten houden claude-sonnet-4-5-20250929 en de oudere create_react_agent-API aan, zodat ze vergelijkbaar blijven met de gelinkte commit. Gebruik voor nieuwe code de actuele create_agent-interface. Deze graaf migreren vraagt ook om tests van de planner-schema’s, de interne messages, de routing en het hervattingsgedrag; alleen de model string wijzigen is die migratie niet.
De planner doet één model call en geeft stapbeschrijvingen terug. Hij roept geen marktdata-tool aan. structured output controleert de vorm van het antwoord; een aparte check op een niet-leeg, bruikbaar plan blijft nodig.
# System prompt guides the LLM to think like a research analyst
# creating a strategic plan, not immediate tool calls
PLANNER_SYSTEM_PROMPT = """You are a senior investment research analyst.
Break down stock analysis requests into 4-6 research steps covering:
1. Current price and basic metrics
2. Recent news and announcements
3. Competitor analysis (if relevant)
4. Financial health assessment
5. Risk factors
6. Investment thesis synthesis

Output as JSON with step_number, description, and tool_hint."""

# Schema-Guided Reasoning: Enforce structure with Pydantic
class PlanOutput(BaseModel):
    """Structured output for the planner."""

    steps: list[PlanStep] = Field(description="Research steps to execute")
    ticker: str = Field(description="The stock ticker being analyzed")

def planner_node(state: AgentState) -> dict:
    """Generate a research plan from the user's request.

    This is Phase 1 of Plan-and-Execute: creating the high-level strategy.
    """

    # Use a powerful model for strategic planning
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Ask for a typed plan and validate it before execution.
    # The API can still fail, so production code also handles that exception.
    structured_llm = llm.with_structured_output(PlanOutput)

    # Pull the request out of the message history
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    last_user_message = human[-1].content if human else "Analyze the market"

    # Context from long-term memory personalizes the plan
    profile_context = f"""
User Profile:
- Risk Tolerance: {state.user_profile.risk_tolerance}
- Investment Horizon: {state.user_profile.investment_horizon}
"""

    # Single LLM call creates the complete plan
    result: PlanOutput = structured_llm.invoke([
        SystemMessage(content=PLANNER_SYSTEM_PROMPT + profile_context),
        HumanMessage(content=f"Create a research plan for: {last_user_message}"),
    ])

    # State update: Store the plan and initialize tracking
    return {
        "plan": result.steps,           # The sequential steps to execute
        "current_step_index": 0,        # Start at step 0
        "research_data": ResearchData(ticker=result.ticker),  # Initialize data container
    }
Die regel llm.with_structured_output(PlanOutput) is Schema-Guided Reasoning (SGR), behandeld in een eerdere post. Het schema controleert veldtypen, maar niet of de stappen bruikbaar zijn. Eis vóór de uitvoering een niet-lege, begrensde lijst met unieke stapnummers en duidelijke beschrijvingen.
Patroon 2: ReAct-uitvoering
Zodra het plan bestaat, geeft executor_node één doel en een samenvatting van eerdere resultaten aan een interne ReAct loop. De interne loop kan na een observatie een andere tool kiezen. Als hij klaar is, legt de buitenste graaf het eindresultaat van de stap vast en gaat verder; het interne transcript bewaart hij niet in plan.
# Market-data tools available to the inner loop in this excerpt. The repo's
# TOOLS list also has a skill loader, two CLI wrappers, and a restricted Python
# evaluator; Part 3 compares those interfaces, and MCP runs as a sidecar.
TOOLS = [
    get_stock_snapshot,
    get_price_history,
    search_news,
    search_competitors,
    get_financials,
]

def executor_node(state: AgentState) -> dict:
    """Execute the current step using a ReAct agent.

    This is Phase 2 of Plan-and-Execute: adaptive execution of each planned step.
    Each step runs as a mini ReAct loop until completion.
    """

    # Guard against an empty or exhausted plan before indexing it
    if state.current_step_index >= len(state.plan):
        raise ValueError("No plan step to execute; check the planner output")

    # Get the current step from the plan
    current_step = state.plan[state.current_step_index]

    # Build context from what we've learned so far
    # Each step sees a digest of earlier results
    previous_context = ""
    for step in state.plan[:state.current_step_index]:
        if step.result:
            previous_context += f"\nStep {step.step_number}: {step.result}\n"

    # Create a ReAct agent for this step. The companion pins the older
    # create_react_agent API; new code uses create_agent.
    react_agent = create_react_agent(
        model=ChatAnthropic(model="claude-sonnet-4-5-20250929"),
        tools=TOOLS,
    )

    # Invoke the ReAct loop for this single step
    # The agent will loop internally until it completes the step
    result = react_agent.invoke({
        "messages": [
            SystemMessage(content=EXECUTOR_SYSTEM_PROMPT),
            HumanMessage(content=f"""Execute Step {current_step.step_number}:
{current_step.description}

Ticker: {state.research_data.ticker}
Previous findings: {previous_context}"""),
        ]
    })

    # Extract the final answer from the ReAct agent's message history
    # The last message contains the synthesis after all tool calls
    updated_plan = list(state.plan)
    updated_plan[state.current_step_index] = PlanStep(
        step_number=current_step.step_number,
        description=current_step.description,
        completed=True,
        result=str(result["messages"][-1].text),  # Final synthesized answer
    )

    # State update: Mark step complete and advance to next
    return {
        "plan": updated_plan,
        "current_step_index": state.current_step_index + 1,
    }
Patroon 3: ReWOO voor snelle snapshots
Voor een korte briefing geeft de planner voorgestelde tool calls terug in plaats van onderzoeksdoelen. De worker voert calls met klaarstaande afhankelijkheden uit zonder model; de solver doet één model call over hun resultaten. Deze fragmenten tonen elke overdracht.
Fase 1: ReWOO-planner (schrijft vooraf een getypeerd plan met voorgestelde calls)
class ReWOOPlanStep(BaseModel):
    """A step in the ReWOO plan with variable placeholders.

    Key difference from Plan-and-Execute's PlanStep:
    - Contains actual tool_name and tool_args (not just description)
    - Uses variable references (#E1) for dependencies
    """
    step_id: str  # e.g., "#E1" - becomes a variable
    description: str
    tool_name: str     # Requested tool name; validate it against a registry in production
    tool_args: dict    # Proposed arguments; may contain refs like {"price": "#E1"}
    depends_on: list[str] = []  # Declared ordering; cross-check it against #E placeholders
    result: str | None = None

class ReWOOPlanOutput(BaseModel):
    """Structured output for ReWOO planner."""
    steps: list[ReWOOPlanStep] = Field(description="Planned tool calls with variables")

def rewoo_planner_node(state: AgentState) -> dict:
    """Generate a complete plan of tool calls upfront.

    This is the key difference from Plan-and-Execute: instead of creating
    human-readable step descriptions, it creates typed proposed tool calls.
    Production code validates them before execution; this teaching worker does not.
    """

    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Schema-Guided Reasoning validates the planner response shape.
    # It does not validate a tool name, its arguments, or its dependencies.
    structured_llm = llm.with_structured_output(ReWOOPlanOutput)

    ticker = state.research_data.ticker if state.research_data else "UNKNOWN"
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    query = human[-1].content if human else f"Analyze {ticker}"

    # Single LLM call to plan ALL tool executions
    result: ReWOOPlanOutput = structured_llm.invoke([
        SystemMessage(content=REWOO_PLANNER_PROMPT),
        HumanMessage(content=f"""Create a ReWOO plan for: {query}

Ticker: {ticker}

Output tool calls with:
- step_id: Variable name (#E1, #E2, etc.)
- description: What this accomplishes
- tool_name: Exact tool from the list
- tool_args: Dictionary of arguments
- depends_on: List of step_ids this depends on"""),
    ])

    # Store the typed proposed-call plan.
    # This teaching worker sends ready steps directly to execute_tool.
    return {"rewoo_plan": result.steps}
Fase 2: ReWOO-worker (voert tools uit zonder LLM-reasoning)
def rewoo_worker_node(state: AgentState) -> dict:
    """Execute dependency-ready tools in parallel batches (no LLM calls).

    Independent tools share a batch. Dependent tools wait until their
    prerequisites complete. The worker follows the dependency graph and
    does not add LLM calls.
    """

    results = {}        # Results keyed by step_id (e.g., "#E1": "$150.23")
    updated_steps = []  # Plan steps with their result field filled in
    pending = {step.step_id: step for step in state.rewoo_plan}

    # Keep scheduling dependency-ready batches until the graph is complete.
    # This handles chains even when the planner does not list them topologically.
    with ThreadPoolExecutor(max_workers=5) as executor:
        while pending:
            ready = [
                step for step in pending.values()
                if all(dep in results for dep in step.depends_on)
            ]
            if not ready:
                unresolved = ", ".join(pending)
                raise ValueError(f"Unresolvable ReWOO dependencies: {unresolved}")

            futures = {
                executor.submit(execute_tool, step, results): step
                for step in ready
            }
            for future in as_completed(futures):
                step = futures[future]
                results[step.step_id] = future.result()
                updated_steps.append(step.model_copy(update={"result": results[step.step_id]}))
                del pending[step.step_id]

    # State update: restore the planner's order (sorting on step_id would put
    # "#E10" before "#E2") and hand the filled-in plan to the Solver
    plan_order = {s.step_id: i for i, s in enumerate(state.rewoo_plan)}
    return {"rewoo_plan": sorted(updated_steps, key=lambda s: plan_order[s.step_id])}
Fase 3: ReWOO-solver (voegt alle resultaten samen in één LLM call)
def rewoo_solver_node(state: AgentState) -> dict:
    """Synthesize all tool results into a flash briefing.

    This is the second efficiency gain: Instead of interleaving
    LLM calls with tool execution (like ReAct), we make ONE
    final synthesis call with all gathered data.
    """

    # Build context from ALL tool results at once
    tool_results = []
    for step in state.rewoo_plan:
        if step.result:
            tool_results.append(f"### {step.description}\n{step.result}")

    context = "\n\n".join(tool_results)

    # Single LLM call to synthesize everything
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
    structured_llm = llm.with_structured_output(FlashBriefingOutput)
    result = structured_llm.invoke([
        SystemMessage(content=REWOO_SOLVER_PROMPT),
        HumanMessage(content=f"Create a flash briefing from this data:\n\n{context}"),
    ])

    # FlashBriefingOutput and DraftReport carry the same fields; the state
    # schema expects DraftReport, so convert before returning.
    return {"draft_report": DraftReport(**result.model_dump())}
De planner schrijft voorgestelde calls, de worker vult hun placeholders in en de solver ontvangt de resultaten. Het schema controleert hun vorm, niet of het plan uitvoerbaar is. De dictionary pending hierboven laat dubbele ID’s ongemerkt vallen. Als #E2 #E1 in zijn argumenten gebruikt maar #E1 weglaat uit depends_on, kunnen beide calls in dezelfde batch terechtkomen voordat het eerste resultaat bestaat.
Wijs vóór de dispatch lege of te grote plannen, dubbele ID’s, ontbrekende afhankelijkheden en cycli af. Valideer toolnamen en argumenten tegen een registry. Controleer placeholders ook in geneste waarden en eis dat ze overeenkomen met depends_on. Deze lesworker slaat die checks over. Hij stuurt klaarstaande calls naar execute_tool uit de begeleidende code, waarvan opgevangen exceptions foutstrings worden. De solver moet zo’n string behandelen als ontbrekend bewijs, niet als een geslaagde opzoeking. Een graaf die niet op te lossen is, stopt vóór de solver. Herstel vraagt om een foutresultaat, een voorwaardelijke replanning-edge en een limiet op het aantal pogingen.
Waar de planner zich op vastlegt
| Route in deze graaf | Vóór de eerste marktdata-call | Na een tool result | Model calls in deze implementatie | Nodes |
|---|---|---|---|---|
| Deep research: Plan-and-Execute met ReAct-stappen | Planner schrijft doelbeschrijvingen | Interne ReAct loop kan binnen het huidige doel een andere call kiezen; latere doelen blijven vast | Eén plan, een model/tool-loop per stap, één rapport | planner_node → executor_node per stap → reporter_node |
| Flash briefing: ReWOO | Planner schrijft toolnamen, argumenten en afhankelijkheden | Worker volgt het plan; solver ziet resultaten na de uitvoering | Eén plan, geen model calls in de worker, één synthese | rewoo_planner_node → rewoo_worker_node → rewoo_solver_node |
Een PlanStep met “Investigate recent earnings” laat de toolkeuze aan de interne agent over. Een ReWOOPlanStep die search_news noemt en de query meegeeft, legt zich op die call vast voordat er een resultaat binnenkomt. Dat verschil, niet de naam van het patroon, bepaalt welke onverwachte observaties de uitvoering kunnen veranderen. Naast elkaar zien de twee planner-outputs er zo uit:
# Plan-and-Execute: goals; the inner ReAct loop picks the tools.
plan = [
    PlanStep(step_number=1, description="Get current price and key metrics",
             tool_hint="get_stock_snapshot"),
    PlanStep(step_number=2, description="Search for recent news and earnings",
             tool_hint="search_news"),
]

# ReWOO: exact calls, fixed before any result arrives.
rewoo_plan = [
    ReWOOPlanStep(step_id="#E1", description="Read the price and valuation snapshot",
                  tool_name="get_stock_snapshot", tool_args={"ticker": "NVDA"}),
    ReWOOPlanStep(step_id="#E2", description="Find recent NVDA earnings news",
                  tool_name="search_news",
                  tool_args={"query": "NVDA earnings", "max_results": 5}),
]
Een tool_hint is advies dat de executor mag negeren. Een tool_name met tool_args is de call die de worker zal doen.
Een zelfstandige ReAct loop kan elk eerder bericht meenemen in elke nieuwe model call. Deze graaf start elke interne loop met de huidige stap en een samenvatting van de afgeronde stappen. De buitenste state bewaart de stapresultaten, niet het interne transcript van tool calls. ReWOO vult in plaats daarvan de geplande stappen met resultaten en geeft de complete lijst aan zijn solver. Dit zijn keuzes voor contextbeheer in deze begeleidende code, geen eisen uit de oorspronkelijke papers.
Beide routes in één graaf bedraden
De graaf heeft twee routes voor de gebruiker over één AgentState: deep research gebruikt Plan-and-Execute met een ReAct loop in elke stap, flash briefing gebruikt ReWOO.
Deze implementatie heeft geen replanner: ze voert het oorspronkelijke plan tot het einde uit. Replanning toevoegen vereist een edge van executor terug naar planner en een regel voor wanneer een verrassend resultaat een extra model call rechtvaardigt.
LangGraph houdt de bedrading declaratief:
def create_graph(checkpointer=None):
    builder = StateGraph(AgentState)

    # Add nodes
    builder.add_node("router", router_node)
    builder.add_node("planner", planner_node)
    builder.add_node("executor", executor_node)
    builder.add_node("reporter", reporter_node)
    builder.add_node("rewoo_planner", rewoo_planner_node)
    builder.add_node("rewoo_worker", rewoo_worker_node)
    builder.add_node("rewoo_solver", rewoo_solver_node)
    builder.add_node("evaluator", evaluator_node)
    builder.add_node("publish", publish_node)

    # Define edges
    builder.add_edge(START, "router")
    builder.add_conditional_edges("router", route_after_router, {
        "planner": "planner",
        "rewoo_planner": "rewoo_planner",
    })

    # Deep Research path
    builder.add_edge("planner", "executor")
    builder.add_conditional_edges("executor", route_after_executor, {
        "executor": "executor",  # Loop back for more steps
        "reporter": "reporter",  # Done with plan
    })
    builder.add_edge("reporter", "evaluator")

    # Flash Briefing path (ReWOO)
    builder.add_edge("rewoo_planner", "rewoo_worker")
    builder.add_edge("rewoo_worker", "rewoo_solver")
    builder.add_edge("rewoo_solver", "evaluator")

    # Both paths run the same evaluator before the human approval step.
    builder.add_edge("evaluator", "publish")
    builder.add_edge("publish", END)

    return builder.compile(
        checkpointer=checkpointer,
        # Human-in-the-loop pause: the reporter (or ReWOO solver) writes a
        # draft. A separate model session reads that draft and records its
        # assessment. The graph then stops before publishing, whichever
        # assessment it produced, so a human can review both the draft and
        # assessment. Part 6 explains how the program decides a run is complete.
        interrupt_before=["publish"],
    )
Test of de model call van de router helpt
De router classificeert snelle snapshots, waaronder “current price”, als ReWOO en complexe verzoeken zoals een investeringsthese als Plan-and-Execute. Bij een onduidelijke classificatie kiest hij standaard deep research. Schema-Guided Reasoning beperkt de output van de classifier tot een van de twee modi:
class ExecutionMode(str, Enum):
    DEEP_RESEARCH = "deep_research"  # Plan-and-Execute with ReAct steps
    FLASH_BRIEFING = "flash_briefing"  # ReWOO

class RouterOutput(BaseModel):
    mode: ExecutionMode
    ticker: str
    reasoning: str

ROUTER_SYSTEM_PROMPT = """Classify the user's request:

1. deep_research: complex analysis requiring synthesis
   - Examples: "Analyze strategic risks", "investment thesis"
2. flash_briefing: quick snapshots, simple data retrieval
   - Examples: "quick snapshot", "current price"

Default to deep_research if unclear."""

llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
structured_llm = llm.with_structured_output(RouterOutput)
Zo routeert deze applicatie verzoeken; het bewijst niet dat elke koersopvraag een planner nodig heeft. Voor een verzoek dat alleen om de koers vraagt, vermijdt een directe tool call de calls van de router, de ReWOO-planner en de solver. Die calls zijn alleen gerechtvaardigd voor verzoeken waarbij een model data moet selecteren of uitleggen.
Een router kan een verzoek ook naar de verkeerde loop sturen. Vergelijk beide routes en een vaste workflow op dezelfde taken, tools en budget. Leg vast of de taak is afgerond, hoe vaak iets ten onrechte werd geaccepteerd, gecachete en niet-gecachete tokens, wandkloktijd en herstel na toolfouten of misleidende observaties. Herhaal runs wanneer de keuze van het model stochastisch is en tel elke gestarte poging. Minder calls helpen alleen als de route de taak binnen de randvoorwaarden nog steeds afrondt. Het engineeringverslag van Anthropic raadt ook aan te beginnen met eenvoudige, combineerbare workflows.
De volledige begeleidende implementatie, inclusief de router en gedeelde state, staat in commit b4e769a van de Market Analyst Agent.
Probeer de huidige single-loop-API
De graaf hierboven gebruikt een oudere agent factory van LangGraph. Wil je eerst de huidige create_agent-API bekijken, dan omzeilt deze kleine fixture de marktdataservices. Hij toont een call van model/tool en het resultaat ervan, geen reden om een agent te gebruiken voor een bekende opzoeking. In een applicatie die alleen deze vraag beantwoordt, roep je de opzoekfunctie direct aan.
Stel ANTHROPIC_API_KEY in en installeer langchain en langchain-anthropic voordat je het snippet uitvoert. De aanroep doet een betaald modelverzoek.
from langchain.agents import create_agent
from langchain_anthropic import ChatAnthropic

def lookup_fixture_company(ticker: str) -> str:
    """Look up a company name in a local fixture, not live market data."""
    return {"NVDA": "NVIDIA", "AMD": "AMD"}.get(
        ticker.strip().upper(), "No company in the fixture"
    )

agent = create_agent(
    model=ChatAnthropic(model="claude-sonnet-5", max_tokens=4096),
    tools=[lookup_fixture_company],
    system_prompt="Use the fixture for company names. Do not invent market data.",
)
result = agent.invoke({
    "messages": [{"role": "user", "content": "Which company is NVDA in the fixture?"}]
})
print(result["messages"][-1].text)
Als het model lookup_fixture_company voorstelt, roept de library die Python-functie aan en geeft het resultaat terug. Het snippet garandeert niet dat het model de tool gebruikt, en test geen routevergelijking, faalbeleid of nauwkeurigheid op live data.
De volgende laag is memory
De loop bepaalt welke call als volgende komt; de rest van de harness moet context leveren, calls uitvoeren en autoriseren, state bewaren en controleren of de taak af is. Deel 2, memory-architectuur voor AI agents scheidt hervatbare checkpoints van kennis over sessions heen en projectdocumenten. Zonder duurzame checkpoints verliest een herstart van de worker de lopende state van deze graaf. Deel 3 onderzoekt toolinterfaces, Deel 4 behandelt autorisatie, Deel 5 behandelt uitvoering en herstel, en Deel 6 onderzoekt het bewijs dat een taak af is.
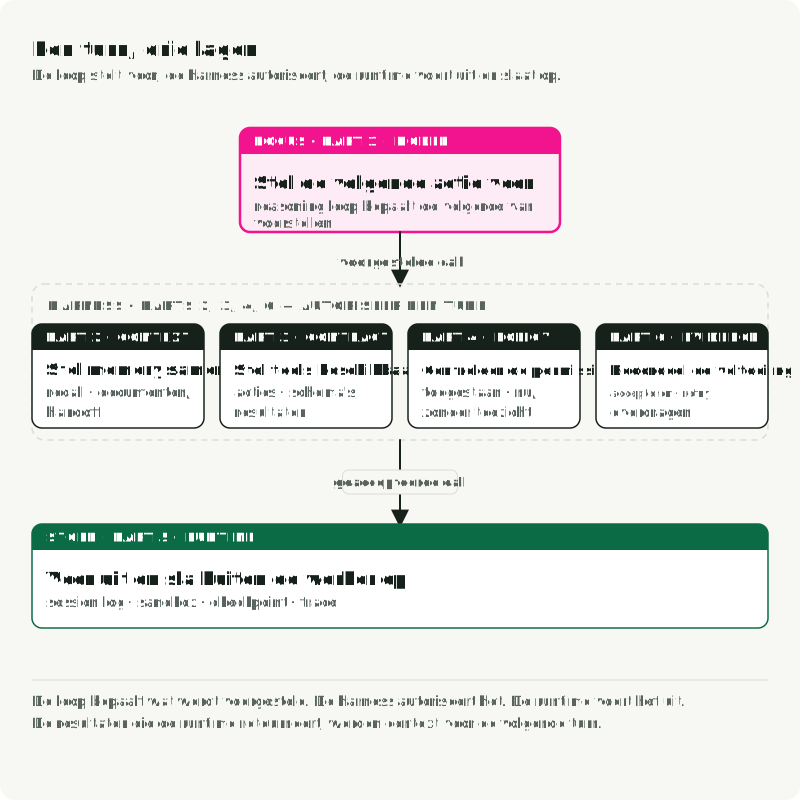
De figuur plaatst elk deel op het punt in één beurt waar het werkt.
Referenties
- ReAct: Synergizing Reasoning and Acting in Language Models (Yao et al., 2022)
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models (Xu et al., 2023)
- Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models (Wang et al., 2023)
- Market Analyst Agent Repository