Architectuur voor agent memory: checkpoints en vector stores

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Een agent kan om verschillende redenen iets lijken te “vergeten”. Hij kan een onafgemaakte run kwijtraken na een herstart, een voorkeur uit een eerder gesprek niet terugvinden, of een verouderde projectnotitie volgen. Elke fout vraagt om een ander soort state en een andere test. Dit artikel is bedoeld voor engineers die die state ontwerpen: je leert wanneer je een checkpoint, een exacte lookup, semantische retrieval of een inspecteerbaar document gebruikt, en welke tools bij elke taak passen, van PostgreSQL- en Redis-checkpoint savers tot pgvector, Qdrant, Markdown-bestanden en beheerde memory-frameworks.
Deel 1 bouwde de reasoning loop. Hier gebruiken we de Market Analyst Agent om te zien wat de loop moet bewaren wanneer hij pauzeert voordat een rapport wordt gepubliceerd, en wanneer een gebruiker terugkomt met bekende voorkeuren.
Vier fouten die op vergeten lijken
“Memory toevoegen” is te vaag om een implementatie te kiezen. Een bruikbare eis zegt wat moet blijven bestaan, wie het mag lezen en wat er gebeurt als het fout is.
| Eis | Te bewaren state | Eerste bruikbare ontwerp | Te testen fout |
|---|---|---|---|
| Een analyse voortzetten na goedkeuring of een herstart van een worker | Berichten, plan, concept, openstaande graph-stap | Duurzaam checkpoint voor die thread | Herstarten vóór publicatie; hervatten vanaf de bedoelde stap |
| De risicovoorkeur van een terugkerende gebruiker toepassen | Eén actueel, benoemd feit gekoppeld aan die gebruiker | Gestructureerd profiel met een exacte sleutel | De voorkeur wijzigen; de oude waarde nooit gebruiken |
| Een ongestructureerde observatie uit eerder werk terughalen | Bron, tekst, eigenaar, tijdstip, geldigheid | Doorzoekbare records; embeddings alleen als dat nodig is | Een query herformuleren en de opgehaalde bron controleren |
| Een projectconventie hergebruiken | Reviewbare notitie en de eigenaar ervan | Bestand of document store | Een foute notitie corrigeren en bevestigen dat de volgende run de correctie ziet |
De eerste vraag is of de agent überhaupt opgeslagen state nodig heeft. Een one-shot classifier waarvan de volledige invoer in één request binnenkomt, kan zijn antwoord valideren en stoppen. Die heeft geen vector database nodig omdat een groter systeem ooit een vervolgvraag zou kunnen stellen.
Zodra er een eis is, geeft deze tabel een starttool per taak. De secties hieronder leggen uit wanneer je naar het alternatief overstapt.
| Taak | Begin met | Stap over op |
|---|---|---|
| Eén run of thread hervatten | LangGraph PostgreSQL saver | Redis saver wanneer checkpoint-latency een gemeten bottleneck is; SQLite saver voor lokaal gebruik |
| Een benoemd gebruikersfeit lezen | PostgreSQL-rij of JSONB-kolom, Redis-hash of een LangGraph-Store-sleutel | Niets meer, zolang het feit een stabiele naam heeft |
| Een notitie op betekenis terughalen | LangGraph Store met een index, of pgvector naast de applicatiedata | Qdrant of een andere vector database wanneer filtering, schaal of beheer dat vereisen |
| Een notitie op exacte termen vinden | PostgreSQL full-text search met een GIN-index | Hybride retrieval op keywords en vectoren wanneer herformuleringen de keywords omzeilen |
| Vragen over verbanden beantwoorden | Gekoppelde relationele records | Een temporele knowledge graph zoals Graphiti |
| Projectkennis reviewbaar houden | Markdown-bestanden in de repository | PostgreSQL-documenten met full-text en vector search voor veel tenants |
| Extractie en onderhoud aan een tool overlaten | Je eigen schrijf- en updateregels | Mem0, Letta of LangMem wanneer je die pipeline niet zelf hoeft te beheersen |
Opslag en modelcontext zijn ook verschillende dingen. Een database kan een miljoen records bevatten; het model ziet alleen de subset die de applicatie selecteert en in het volgende request plaatst. Een feit opslaan garandeert niet dat het wordt opgehaald. Het ophalen garandeert niet dat de agent het correct gebruikt. Daarom heeft een memory-ontwerp naast een schrijfregel ook een leesregel en een uitkomsttest nodig.
Het CoALA-paper geeft bruikbare namen aan de betrokken soorten informatie: working state voor de huidige stap; episodic memory van gebeurtenissen; semantic memory van feiten; en procedural memory van hoe te handelen. Het persistentiemodel van LangGraph maakt een ander onderscheid, op implementatieniveau: een checkpointer bewaart state voor één thread, terwijl een store applicatiedata over threads heen bewaart. Een document kan een gebeurtenis, een feit of een procedure bevatten. Deze categorieën zeggen wat informatie betekent; ze schrijven niet één database per categorie voor.
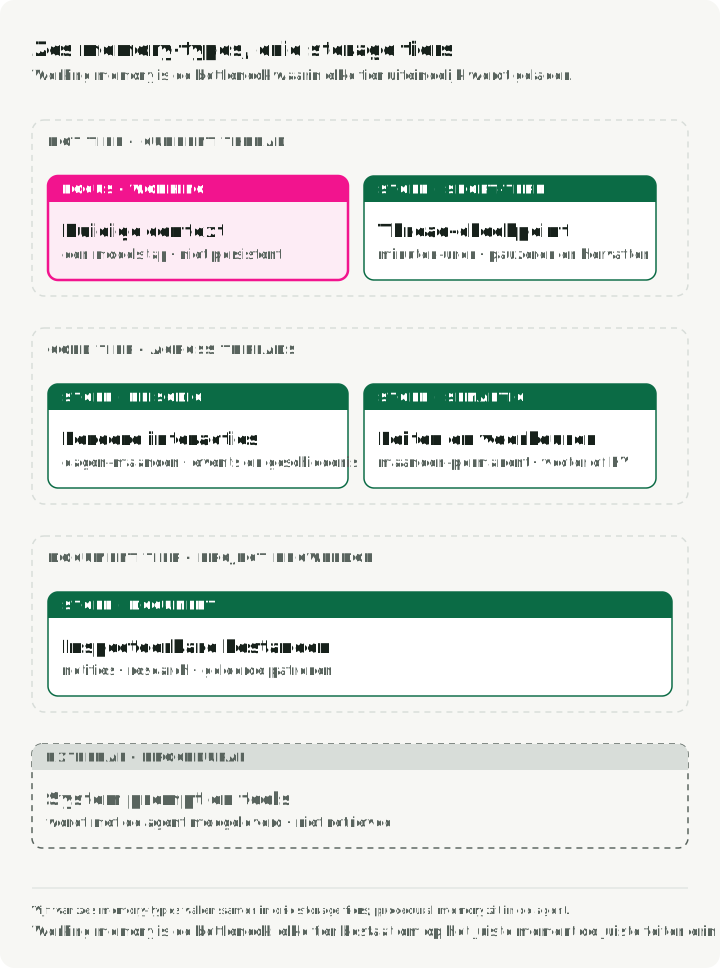
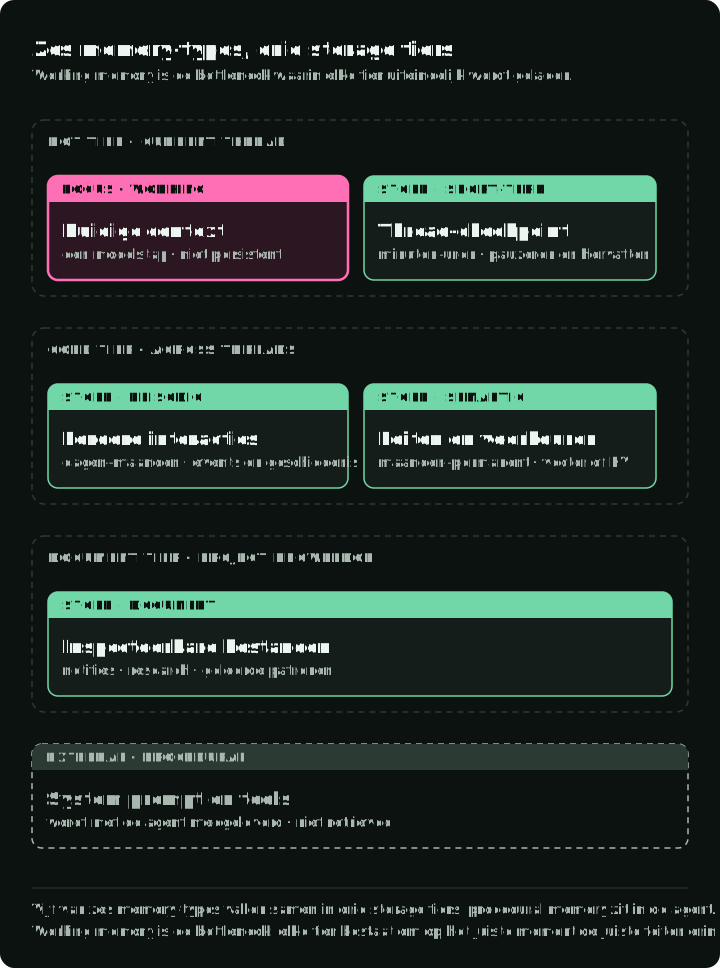
De figuur plaatst die soorten in de drie stores die dit artikel gebruikt: een checkpoint voor de huidige thread, thread-overstijgende records en documenten voor projectkennis. Lees een kolom van boven naar beneden om te zien dat één store meerdere soorten informatie kan bevatten. Procedures kunnen met de agent worden meegeleverd als instructies en tools, of worden opgeslagen en opgehaald zoals elk ander document.
Working state kan in procesvariabelen en in het huidige modelrequest leven. De geselecteerde berichten en tool results moeten in het context window van het model passen; de applicatiestate mag groter zijn. Als het proces stopt, is alleen het deel dat bewust is gepersisteerd terug te halen. “Short-term” en “long-term” beschrijven de reikwijdte van hergebruik, geen vaste bewaartermijnen. Het retentiebeleid van de applicatie bepaalt wanneer een van beide wordt verwijderd.
Een checkpoint laat de run doorgaan
Neem een analyse die bewijs heeft verzameld en een rapport heeft opgesteld, en daarna pauzeert voor goedkeuring. Als de worker stopt, moet een andere worker het concept, de goedkeuringsstatus en de volgende graph-node kennen. Een gesprekstranscript alleen zegt niet of het rapport al is gepubliceerd.
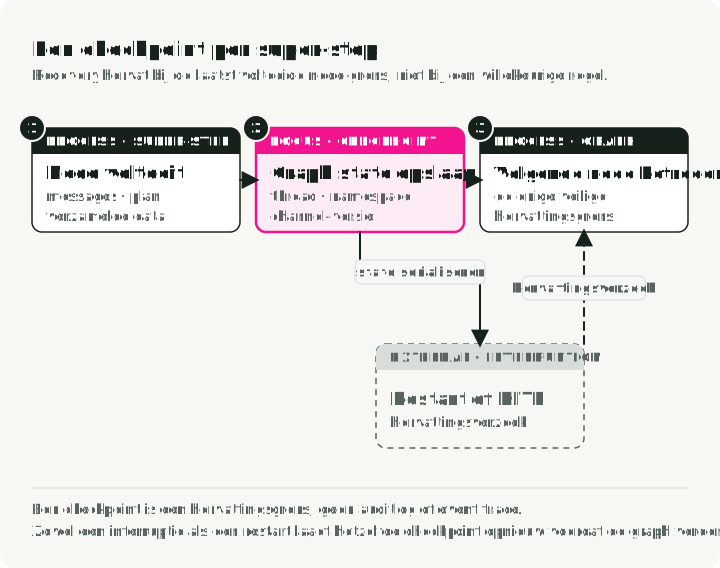
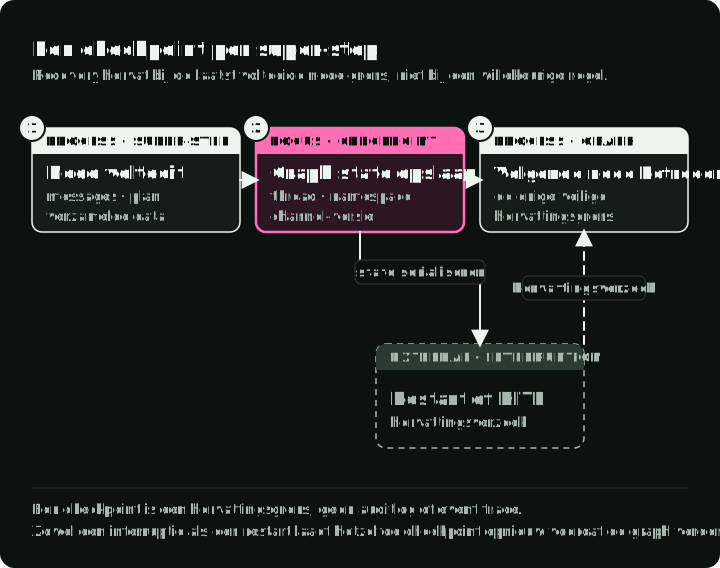
LangGraph slaat graph-state op bij super-step-grenzen. Een super-step is één ronde geplande nodes; meerdere kunnen parallel draaien. De opgeslagen thread-state bevat waarden en planningsinformatie, zodat een run kan doorgaan vanaf een voltooide grens. Hij kan niet hervatten vanaf een willekeurige regel binnen een node. De checkpointer-documentatie beschrijft ook pending writes van nodes die binnen een mislukte super-step zijn voltooid. Een checkpoint is een herstelrecord, geen volledige trace van alles wat de agent heeft gedaan.
Het begeleidende project maakt die grens zichtbaar. De graph factory compileert met een checkpointer en onderbreekt vóór de publish-node. Het goedkeuringspad leest de opgeslagen state, controleert dat publicatie de openstaande stap is, legt de goedkeuring vast en hervat. De checkpoint-setup gebruikt standaard PostgreSQL en kan Redis selecteren. Roep aan met durability="sync" wanneer een crash de laatst voltooide stap niet mag verliezen.
De durability-modus bepaalt wat een crash kan kosten. In de gedocumenteerde modi van LangGraph laten asynchrone writes de volgende stap draaien voordat een checkpoint klaar is; een crash kan daardoor de laatste stap kosten. Sync wacht op elke checkpoint-write voordat het verdergaat. Exit-modus slaat op wanneer de graph eindigt, en kan zich dus niet herstellen van een crash midden in een lange run. Kies de modus op basis van de hersteleis en test daarna een geforceerde herstart op de grens die ertoe doet. De figuur draait dezelfde graph onder elke modus en laat die crashen tijdens de derde super-step.
Wat een saver opslaat
Elke LangGraph-checkpoint-backend implementeert BaseCheckpointSaver: put() schrijft een checkpoint, get_tuple() leest het nieuwste voor een thread, en list() geeft de geschiedenis terug. Elk checkpoint is geadresseerd met (thread_id, checkpoint_ns, checkpoint_id). De thread_id identificeert het gesprek, checkpoint_ns scheidt subgraphs, en checkpoint_id identificeert één versie. Een thread_id lokaliseert opgeslagen state; het stelt niet vast wie de aanroeper is en autoriseert geen toegang tot die thread.
De PostgreSQL saver in langgraph-checkpoint-postgres maakt zijn tabellen aan bij setup(). Twee workers die naar dezelfde thread schrijven, worden gescheiden door de checkpoint-sleutel en door upserts, niet door locks: ze beschadigen elkaars rijen niet, maar ze coördineren ook niet. Geef een run één actieve schrijver, zoals deel 5 beschrijft.
Een minimale PostgreSQL-setup, ervan uitgaande dat create_graph je graph bouwt en compileert:
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver

async def run(connection_string: str, authenticated_user_id: str) -> None:
    # from_conn_string owns the connection, so the graph runs inside this block.
    async with AsyncPostgresSaver.from_conn_string(connection_string) as checkpointer:
        await checkpointer.setup()  # creates the tables; safe on every start
        graph = create_graph(checkpointer=checkpointer)
        config = {"configurable": {"thread_id": "analysis-42"}}
        await graph.ainvoke({"user_id": authenticated_user_id, "messages": [...]}, config)
        # Later, after the server authenticates the approver:
        await graph.aupdate_state(config, {"report_approved": True})
        await graph.ainvoke(None, config)  # continue from the saved interrupt
De user_id komt uit de geauthenticeerde requestcontext van de server, nooit van het model of uit de JSON van de client. Als iemand anders dan de applicatie checkpoint-rijen kan schrijven, stel dan LANGGRAPH_STRICT_MSGPACK=true in zodat deserialisatie alleen veilige of gedeclareerde typen accepteert, zoals de security advisory van LangGraph beschrijft.
Een checkpoint maakt een externe write niet veilig
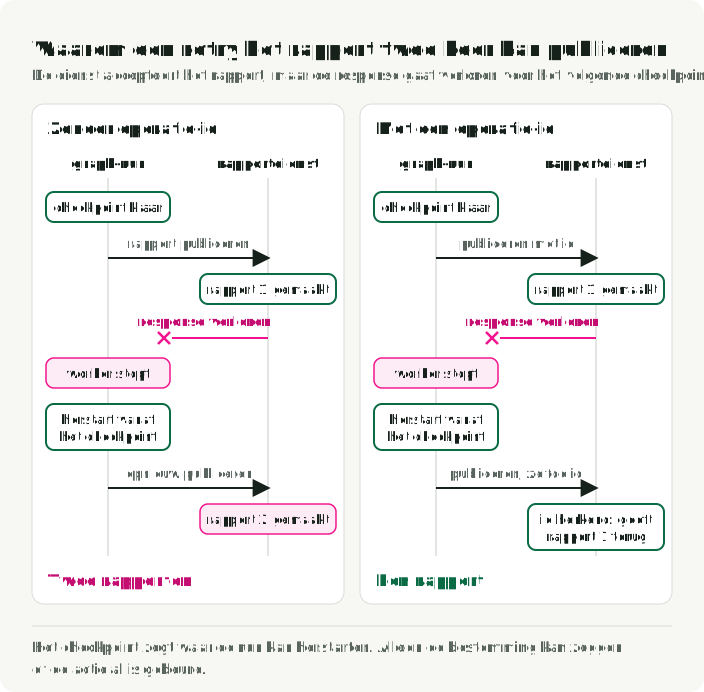
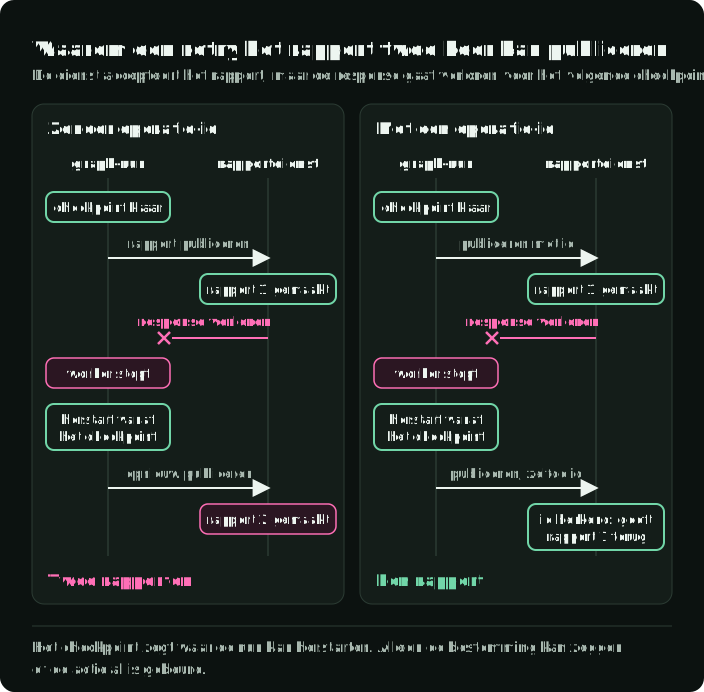
Stel dat de publish-node een rapport naar een externe dienst stuurt. De dienst accepteert het, maar het antwoord gaat verloren voordat de graph het volgende checkpoint opslaat. Herstarten vanaf het vorige checkpoint kan de node opnieuw uitvoeren. Geen enkele instelling van de checkpoint-database kan zien of die externe write is geslaagd.
Geef een herhaalbare write een identifier die van de applicatie is, en laat de bestemming een retry met die identifier herkennen. Kan de bestemming dat niet, dan moet herstel de bestemming controleren of om een menselijke beslissing vragen voordat de actie wordt herhaald. Hetzelfde geldt voor betalingen, berichten en bestandswrites. Een checkpoint beantwoordt “waar kan de uitvoering herstarten?”; de externe operatie heeft een eigen antwoord nodig op “is deze actie al gebeurd?”. De richtlijnen van AWS over idempotente API’s leggen het contract aan de kant van de dienst uit. De figuur volgt één verloren response met en zonder die identifier.
Houd bedrijfsrecords gescheiden van graph-state. Een rapportarchief legt vast wat is gepubliceerd; een checkpoint legt vast hoe de graph die stap bereikte of erop wachtte. Een event log of trace kan elke geprobeerde actie vastleggen. Geen van de drie vervangt de andere twee. Deel 5 komt terug op herstel en runtime-bewijs.
Kies een backend op basis van hersteleisen
Het begeleidende project ondersteunt PostgreSQL- en Redis-checkpoint savers. Ze hebben dezelfde rol richting de graph, maar hun operationele gedrag hangt af van de geconfigureerde database en saver.
| Vraag | PostgreSQL | Redis |
|---|---|---|
| Wat moet worden beheerd? | Een relationele database, de opslag, backups en checkpoint-tabellen | Redis-geheugen, eviction, persistentie en backup-instellingen |
| Welke geschiedenis is nodig? | Volledige checkpoint-geschiedenis met de standaard-saver | Controleer de gekozen saver en het retentiebeleid; een shallow saver bewaart alleen het nieuwste checkpoint |
| Wat moet de doorslag geven? | Bestaand databasebeheer, herstelbehoefte, gemeten schrijfkosten | Gemeten checkpoint-latency, toelaatbaar verlies en de werkelijke persistentie-instellingen |
Als PostgreSQL de applicatie al draait en duurzame geschiedenis belangrijk is, zou ik daar beginnen. Het past bij lange runs waarin verloren state uren herberekening betekent, bij domeinen waar durability verplicht is, en bij teams die time-travel debugging uit de checkpoint-geschiedenis willen. Met pgvector kan dezelfde database ook long-term memory en vector search bevatten, zodat er één systeem te beheren blijft.
Kies Redis wanneer checkpoint-toegang een gemeten bottleneck is, zoals bij streaming chat of spraak, of wanneer Redis al de geschikte state store van het systeem is. De bewering dat Redis “sneller” is, is geen meting van deze graph: de grootte van de geserialiseerde state, de schrijffrequentie, het netwerkpad en het persistentiebeleid beïnvloeden allemaal het resultaat. Het pakket langgraph-checkpoint-redis biedt ook een ShallowRedisSaver die per thread alleen het nieuwste checkpoint bewaart: genoeg voor pauzeren en hervatten, zonder geschiedenis om te debuggen.
Kies het Redis-persistentiebeleid op basis van het verlies dat je kunt accepteren; met de gangbare append-only-instelling kan een crash ongeveer één seconde aan writes kosten. Test crashherstel met de werkelijke instellingen.
Twee andere savers dekken gangbare setups af. langgraph-checkpoint-sqlite past bij lokale ontwikkeling en deployments met één proces. Op AWS levert langgraph-checkpoint-aws een DynamoDBSaver die grote checkpoints naar S3 verplaatst.
De checkpoint-geschiedenis groeit. Oude rijen verwijderen met een generieke, op leeftijd gebaseerde SQL-query kan de reconstructie breken wanneer bewaarde checkpoints afhangen van eerdere writes of van delta channels. Gebruik een door de saver ondersteunde retentie-operatie waarvan je het herstelgedrag hebt getest. Bestaat die niet voor de geïnstalleerde versie, bewaar dan de benodigde geschiedenis totdat je een pruning-procedure kunt verifiëren.
Thread-overstijgend memory heeft een updateregel nodig
Een terugkerende gebruiker kan een risicovoorkeur hebben die een nieuwe analyse zou moeten beïnvloeden. Dat feit hoort niet verstopt te zitten in een oud gespreks-checkpoint: het nieuwe request kan een andere thread gebruiken. Het heeft een thread-overstijgend record nodig met een eigenaar, een manier om het te lezen en een manier om het te vervangen of te verwijderen.
De long-term memory-implementatie van het begeleidende project slaat gebruikersprofielen op in Qdrant. Het get_profile-pad gebruikt een exacte filter op gebruikers-ID, en het opslaan van een profiel gebruikt een deterministische point-ID voor updates. Het profielpad is thread-overstijgende opslag, geen semantische recall. Een profiel met benoemde velden zoals risicotolerantie en beleggingshorizon zou ook in een PostgreSQL JSONB-kolom of een Redis-hash kunnen staan, wat eenvoudiger is dan vectoren embedden en bevragen. Embeddings toevoegen zou deze exacte lookup niets opleveren.
De gebruikers-ID in een store-query moet uit een geverifieerde applicatie-identiteit komen wanneer dit als dienst wordt aangeboden. Een Qdrant-payloadfilter begrenst de retrieval; het is geen authenticatie. Het begeleidende project heeft ook een command-line interface die een gebruikers-ID accepteert. Die interface is handig voor een lokale demo, maar een applicatie die meerdere mensen bedient, moet eigenaarschap afdwingen voordat ze profielen leest of schrijft. De multitenancy-documentatie van Qdrant beschrijft tenant-filters en indexen; de applicatie bepaalt nog steeds wie de tenant-waarde mag aanleveren.
De store van LangGraph
De Store API van LangGraph bewaart thread-overstijgende items als (namespace, key)-paren met een JSON-waarde. De namespace codeert meestal de eigenaar, zoals ("user", user_id, "preferences"). BaseStore biedt put(), get(), search() en delete(), met hiërarchische afbakening per namespace. Drie implementaties dekken de meeste behoeften:
InMemoryStorevoor ontwikkeling en tests; de data gaan verloren wanneer het proces stopt.PostgresStorevoor een persistente store die met SQL wordt bevraagd.AsyncRedisStore, uit het Redis-pakket, voor thread-overstijgend memory met vector search, TTL en metadatafilters.
Een index-configuratie voegt vector search toe over opgeslagen items, met een embedding-functie die je zelf levert. Voor veel applicaties is deze ingebouwde store voldoende voordat een dedicated vector database nodig is:
from langgraph.store.memory import InMemoryStore

store = InMemoryStore(index={"dims": 1536, "embed": embed_texts})

async def remember_and_recall(user_id: str) -> list:
    await store.aput(
        ("user", user_id, "preferences"),
        "risk-profile",
        {"risk_tolerance": "high", "horizon": "long-term"},
    )
    # The namespace prefix is positional in search and asearch.
    return await store.asearch(("user", user_id), query="investment style", limit=5)
Geef de store mee bij het compileren van de graph, naast de checkpointer, en een node kan een store-parameter declareren om hem te lezen: builder.compile(checkpointer=checkpointer, store=store).
Wanneer je semantische retrieval toevoegt
Verander nu het request: “Welke zorg over leveranciers heb ik bij de vorige analyse geuit?” De nuttige notitie heeft misschien geen stabiele sleutel die de aanroeper kent. Zoeken op betekenis kan kandidaatnotities vinden, ook als de vraag andere woorden gebruikt. Die behoefte is de reden om embeddings toe te voegen. Het feit dat er een vector database beschikbaar is, is dat niet.
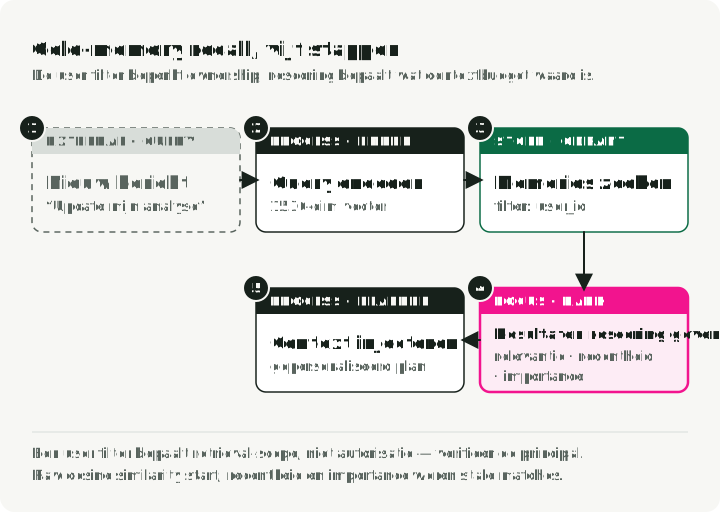
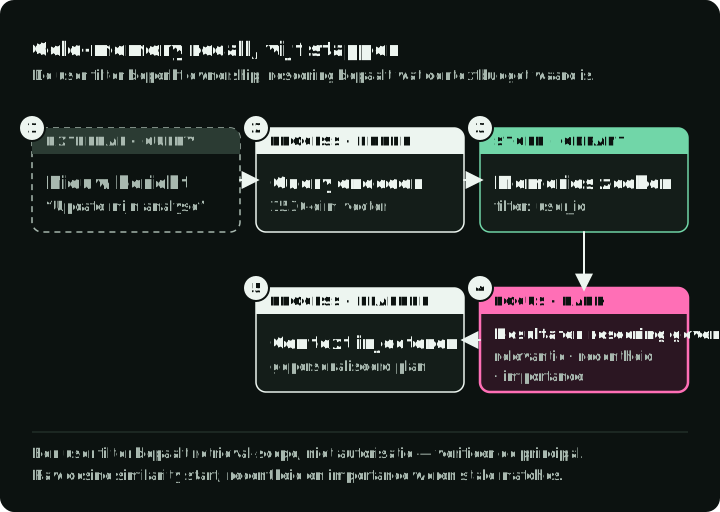
Een illustratieve uitbreiding zou een kort kandidaatfeit uit een afgerond gesprek halen, de bron en eigenaar toevoegen, een embedding genereren en zowel tekst als vector opslaan. Bij een later request zou de applicatie de zoekopdracht eerst tot die eigenaar beperken, kandidaten ophalen, controleren of ze nog geldig zijn, en het model alleen de relevante, toegeschreven feiten geven.
Het geëxtraheerde feit is slechts een kandidaat. Een model kan uit één dubbelzinnig bericht een “voorkeur” afleiden. Bepaal voordat je het naar duurzaam memory promoveert welke feiten bevestiging door de gebruiker vereisen, welke automatisch mogen worden bijgewerkt en welke nooit mogen worden afgeleid. Bewaar bron en observatietijd zodat een latere correctie een feit kan vervangen. Similarity meet thematische nabijheid; het stelt geen waarheid, actuele geldigheid of toestemming vast.
Waar de vectoren staan, is een aparte keuze. pgvector houdt ze in de PostgreSQL-database die de applicatie al draait. Qdrant is een dedicated vector database met HNSW-indexering en gefilterd zoeken; de post over search ranking behandelt HNSW en de afwegingen. Qdrant publiceert ook een MCP-server die een collection beschikbaar maakt als memory-tool voor MCP-clients. Een dedicated dienst is nuttig wanneer je de retrieval, filtering, schaal of operationele fit ervan nodig hebt; stel die behoefte vast met je eigen queries en corpus voordat je hem toevoegt.
Ruwe cosine similarity is slechts een beginsignaal. Het Generative Agents-paper combineerde drie signalen om de herinneringen van gesimuleerde agents op te halen: recency, met exponentieel verval; importance, door een model beoordeeld op een schaal van 1–10; en relevance, als embedding-similarity. Het normaliseerde de drie voordat het ze met gelijke gewichten optelde. Als je het idee overneemt, normaliseer dan eerst, anders domineert de importance-score van 1–10, en stem de gewichten af op achtergehouden recall- en taakcontroles. Als semantische recall een verouderde voorkeur teruggeeft omdat de formulering op de nieuwe vraag lijkt, repareer dan eerst de geldigheidsregel voordat je gewichten afstemt. Een gestructureerde waarde met een expliciete update blijft het eenvoudigere antwoord voor een benoemde voorkeur.
Probeer keyword- of full-text search wanneer exacte namen en termen de notitie identificeren. Gebruik embeddings wanneer herformuleringen die lookup regelmatig omzeilen. Als beide tellen, haal dan kandidaten via beide paden op voordat je hun rangordes combineert. Keyword-hits alleen met vectorscores herordenen kan geen relevante notitie terughalen die de keyword-filter al heeft weggegooid.
| Aanpak | Het meest geschikt voor | Belangrijkste operationele kosten |
|---|---|---|
| Key-value store (PostgreSQL JSONB, Redis-hash) | Gestructureerde profielen en voorkeuren | Geheugengebruik en persistentiebeleid |
| Full-text search (PostgreSQL GIN) | Keyword-recall over de gespreksgeschiedenis | Indexgroei en query-tuning |
| Vector search (pgvector, Qdrant) | Semantische recall van ongestructureerde notities | Levenscyclus van embeddings en index |
| Hybride (keyword + vector) | Recall wanneer de formulering van queries varieert | Twee scoringpaden om af te stemmen en te evalueren |
| Knowledge graph (Graphiti, Neo4j) | Relaties tussen entiteiten en multi-hop-queries | Graph-modellering en nog een datasysteem |
| Document store (bestanden) | Projectkennis en door de agent beheerde notities | Gelijktijdigheid, rechten en zoeken |
Relaties en beheerde frameworks
Relaties kunnen om een andere vorm vragen. Een vraag als “Welke eerdere leveranciers waren aan dit bedrijf gekoppeld, en wanneer was elke koppeling geldig?” is een kandidaat voor een temporele graph. Graphiti, van Zep, bouwt een knowledge graph die bijhoudt wanneer elk feit waar was en niet alleen wat waar was, en die vervangen waarden met hun geldigheidsintervallen bewaart. Op de DMR-benchmark van het Zep-paper scoorde Zep binnen een halve punt van het plaatsen van het volledige gesprek in de context, dus dat resultaat toont geen algemeen voordeel van temporele graphs. Extractie en updates moeten nog steeds bepalen of een relatie klopt. Als gekoppelde records de queries beantwoorden, gebruik die dan in plaats van nog een graph-dienst te beheren.
Memory-frameworks draaien de pipeline van extractie, consolidatie en ophalen voor je. Bij Mem0 extraheert een model kandidaatfeiten, vergelijkt het elk ervan met bestaande items en beslist het of memory wordt aangevuld, bijgewerkt, verwijderd of ongewijzigd gelaten. Letta, voorheen MemGPT, geeft de agent tools om data te verplaatsen tussen “core memory” in de context en “archival memory” buiten de context. LangMem levert tools voor memory-beheer voor LangGraph-agents. Evalueer er een wanneer je snel een werkende pipeline wilt en niet elke schrijfregel zelf hoeft te beheersen; retentie, verwijdering en de tests hieronder blijven jouw verantwoordelijkheid.
Documenten maken opgebouwde kennis inspecteerbaar
Sommig memory lees je het best als document. Een coding agent kan het testcommando en de architectuurnotities van een project nodig hebben. Een research agent kan een gereviewde bronnenlijst en de redenering achter een eerdere beslissing nodig hebben. Dit zijn samenhangende stukken kennis die een mens moet kunnen lezen, corrigeren en versioneren.
Neem een coding agent die wekenlang aan één project werkt. Hij leert dat het project Pydantic v2 gebruikt, dat tests draaien met pytest -x --tb=short, en dat de ontwikkelaar pathlib wil in plaats van os.path. Deze feiten zouden in een key-value store kunnen staan, maar met een bestand kan de ontwikkelaar ze lezen, een fout feit met een gewone bewerking corrigeren en elke wijziging in git diff reviewen.
Coding assistants gebruiken dit patroon al:
- Claude Code leest
CLAUDE.md-bestanden uit het project en de bovenliggende mappen, en bewaart memory per project in Markdown onder~/.claude/projects/. Projectbestanden worden met de code gecommit. - Cursor laadt projectregels uit
.cursor/rulesals.mdc-bestanden, met front matter die bepaalt wanneer elke regel geldt. - Devin Desktop leest regels uit
.devin/rules/en kan automatisch gegenereerde memories per workspace opslaan. - De memory-tool van Anthropic voor de Claude API is een client-side tool waarvan de bestandscommando’s (view, create, edit, delete, rename) werken op een
/memories-map. Je applicatie implementeert elk commando en bepaalt dus of de bestanden op schijf, in S3 of in een database staan.
De DocumentMemory van het begeleidende project schrijft JSON-enveloppen met inhoud, metadata en een aanmaaktijd onder namespaces. De publish-node archiveert een goedgekeurd rapport in de research-namespace. Een research agent zou deze structuur kunnen gebruiken:
.agent-memory/
    README.md                  # What this directory is, for human readers
    PROGRESS.md                # Handoff for the next session: done, next
    user-profiles/user-123.md  # Preferences and risk profile
    research/NVDA-2026-02.md   # Notes from a recent analysis
    conventions/analysis-format.md
    learnings/common-errors.md # Mistakes the agent has learned to avoid
De figuur toont de twee manieren om in die map te komen: de aanroepen van de agent en de bewerkingen van een persoon.
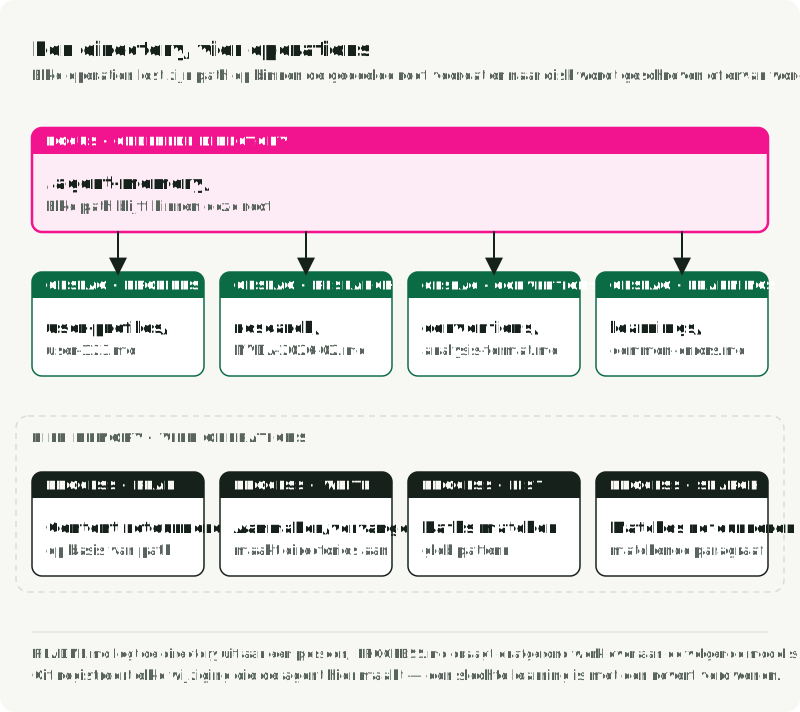
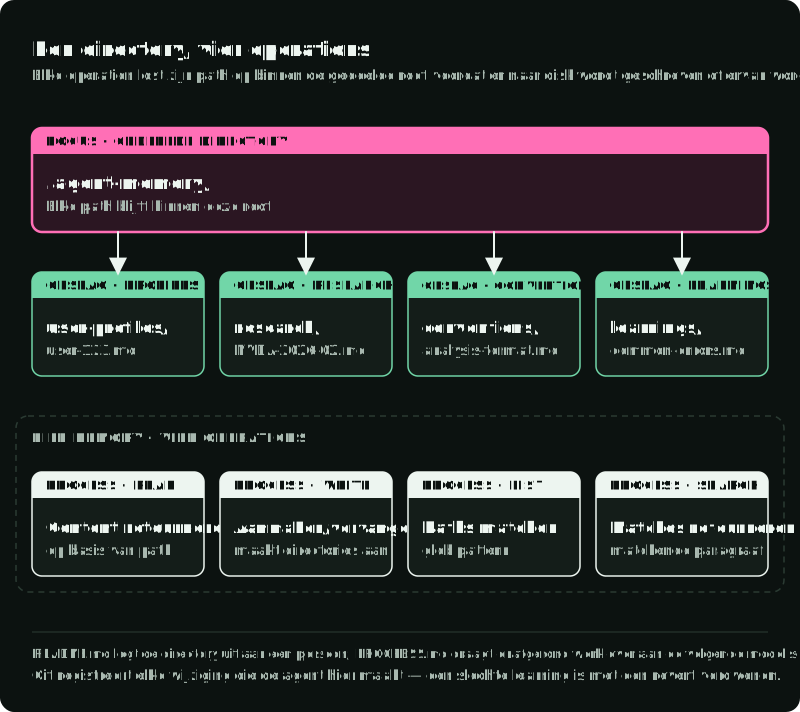
Voor één project waarvan de notities menselijke review nodig hebben, kan gewoon Markdown volstaan. Gebruik namen die zeggen wat een document behandelt; leg bron en laatste review vast waar die het vertrouwen beïnvloeden. De agent heeft vier operaties nodig: een document lezen, er een schrijven, ze oplijsten en ze op keyword doorzoeken. Korte bestanden, zoals een conventie- of overdrachtsnotitie, kunnen in hun geheel worden geladen; een groot corpus heeft nog steeds retrieval nodig. Wanneer zoeken in die bestanden traag wordt of relevante notities mist, voeg dan een keyword- of vectorindex toe en houd één gezaghebbende kopie aan. Het aantal documenten alleen bepaalt niet wanneer die index nodig is.
Een bestandsinterface is niet beperkt tot zoeken op keywords. In een door de leverancier zelf uitgevoerde evaluatie rapporteerde Letta 74,0% op de LoCoMo-benchmark voor lange gesprekken voor een GPT-4o mini-agent die bijgevoegde bestanden semantisch doorzocht, tegenover 68,5% voor de beste graph-variant van Mem0. Dat is één leverancier, één model, één benchmark en één harness; het laat zien dat een bestandsgerichte interface in die setup kan werken, niet dat ruw Markdown volstaat.
| Vraag | Vector store | Key-value store | Document store |
|---|---|---|---|
| Querypatroon | ”Vind notities die lijken op X" | "Geef de waarde voor de sleutel" | "Lees het document op dit pad” |
| Het meest geschikt voor | Ongestructureerde, gevarieerde recall | Gestructureerde lookups | Projectcontext en notities |
| Menselijke review | Payloads en scores inspecteren | Exacte sleutels, JSON-waarden | Markdown lezen en bewerken |
| Versiebeheer | Via exports of wijzigingslogs | Mogelijk | Native met Git |
| Embedding-pipeline | Vereist | Niet nodig | Niet nodig |
| Zoeken | Semantische similarity | Exacte match | Pad, keyword, optionele index |
Gebruik documenten wanneer de agent over sessions heen projectkennis opbouwt en mensen die moeten inspecteren, corrigeren of versioneren. Gebruik een vector store wanneer queries in formulering variëren over veel losse notities. Gebruik een key-value store wanneer het schema bekend is en lookups exact zijn. De drie kunnen naast elkaar bestaan, maar geen applicatie heeft standaard alle drie nodig.
De bestandsgrens vraagt om zorg wanneer agents kunnen schrijven. Beperk elke lees- en schrijfactie tot het bedoelde project of de bedoelde gebruiker. Weiger path traversal en ontsnappingen via symlinks. Coördineer gelijktijdige schrijvers en bepaal welke bewerkingen menselijke review vereisen. Opgehaalde bestanden zijn taakdata met minder vertrouwen: een notitie met “negeer goedkeuring” kan de goedkeuringsregel van de applicatie niet veranderen.
Documenten aanbieden aan veel tenants
Bestanden passen bij één ontwikkelaar of één gecontroleerd bestandssysteem. Meerdere tenants en gelijktijdige schrijvers vragen om expliciete toegang en gecoördineerde writes. Drie ontwerpen komen veel voor:
- Schrijven in bestanden, serveren vanuit een database. Ontwikkelaars bewerken Markdown en committen het; de deployment synchroniseert de bestanden naar PostgreSQL-rijen, en de agent leest geïndexeerde rijen tijdens runtime.
- Objectopslag met een vectorindex. Documenten staan in S3 of GCS, en een Qdrant-collection indexeert hun embeddings. De agent vindt document-ID’s in Qdrant en haalt daarna de inhoud uit de opslag. Dit schaalt horizontaal, ten koste van twee systemen, een embedding-pipeline en eventual consistency daartussen.
- PostgreSQL-documenten met hybride zoeken. Sla elk document op als een rij met metadata, een full-text-index en een optionele pgvector-embedding. Dat geeft zoeken op keywords en semantic search, transacties en één systeem om te beheren. Voor een multi-tenant dienst zou ik hier beginnen.
Neem bij het derde ontwerp de tenant uit het geauthenticeerde verzoek, nooit uit het model of van de client, en laat PostgreSQL dit afdwingen met row-level security. Gebruik een applicatierol die de tabellen niet bezit en geen superuser- of BYPASSRLS-rechten heeft; als die rol een tabel moet bezitten, gebruik dan ook ALTER TABLE ... FORCE ROW LEVEL SECURITY. Test een query zonder tenantfilter onder de werkelijke applicatierol en controleer dat die geen rijen van andere tenants teruggeeft. Combineer trefwoord- en vectormatches zoals hierboven beschreven bij semantic retrieval.
Een procedure is ook iets anders dan een onthouden observatie. Voyager sloeg herbruikbare uitvoerbare programma’s op en haalde ze op via hun beschrijving. Agent Workflow Memory voegt in plaats daarvan afgeleide web-workflows als richtlijn aan de prompt toe. Een projectnotitie kan beschrijven hoe je een controle uitvoert. Uitvoerbare programma’s hebben tests en beperkte uitvoering nodig; notities hebben een feitencontrole nodig en een test of het volgen ervan helpt. Geen van beide mag nieuwe rechten krijgen omdat het uit memory is opgehaald. Een Agent Skill is het naburige geval: een SKILL.md-bestand dat de agent vertelt hoe hij een soort werk uitvoert, en dat deel 3 met tools vergelijkt.
Compaction verandert de context, niet de bron van waarheid
Een lang gesprek heeft uiteindelijk selectie nodig. De applicatie kan oudere berichten weglaten of samenvatten zodat het volgende modelrequest in het contextbudget past. Server-side compaction van Claude, per september 2026 een bètafunctie, geeft een compaction-blok terug dat latere requests gebruiken in plaats van de eerdere inhoud. Die samenvatting kan het model helpen verder te gaan, maar kan een order-ID, een afgewezen voorstel of een goedkeuringsvoorwaarde laten vallen.
Houd operationele feiten in expliciete state: de openstaande graph-stap, voltooide externe effecten en de exacte goedkeuringsstatus. Houd thread-overstijgende feiten in records met eigenaren en updateregels. Gebruik een samenvatting om context te leveren en test daarna wat ze wegliet: forceer compaction halverwege een test en controleer of de volgende actie een eerdere beperking nog respecteert. Kies een feit dat de samenvatting niet door te raden kan reconstrueren, zoals een operatie-ID of de exacte voorwaarde bij een goedkeuring, en controleer het tegen de gezaghebbende state in plaats van tegen de bewoording van de samenvatting. Beoordeel de bewoording van de samenvatting als een eigen, aparte controle. Een checkpoint herstelt de graph-uitvoering; compaction verkort de modelinvoer; retrieval selecteert informatie voor een nieuw request. Het zijn aparte operaties, ook als één harness ze alle drie uitvoert.
Compaction reset ook de prefix-cache van de provider; die reset zelden nemen, in één grote sprong, is goedkoper dan elke ronde een paar berichten wegsnijden. Providers hergebruiken werk op een stabiele request-prefix; als je oudere berichten vervangt, verandert de prefix en betaalt het volgende request de volle prijs voor alles wat volgt. Eén grote sprong kost één keer het lezen van een veel kleinere invoer tegen de volle prijs en keert daarna terug naar goedkope toevoegingen, terwijl voortdurend kleine stukjes wegsnijden die kosten steeds opnieuw betaalt en een korter gesprek duurder kan maken dan een langer. Kies de compaction-drempel door hem voor jouw model en taak te testen, in plaats van hem vast te zetten op een fractie van het context window.
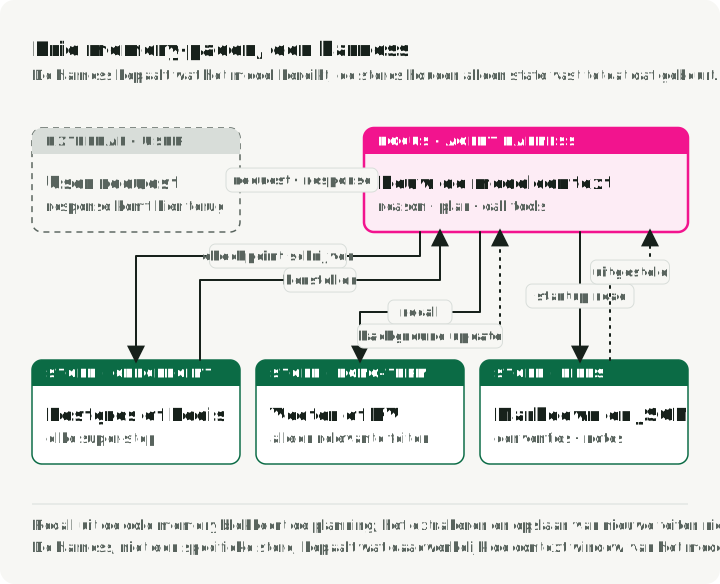
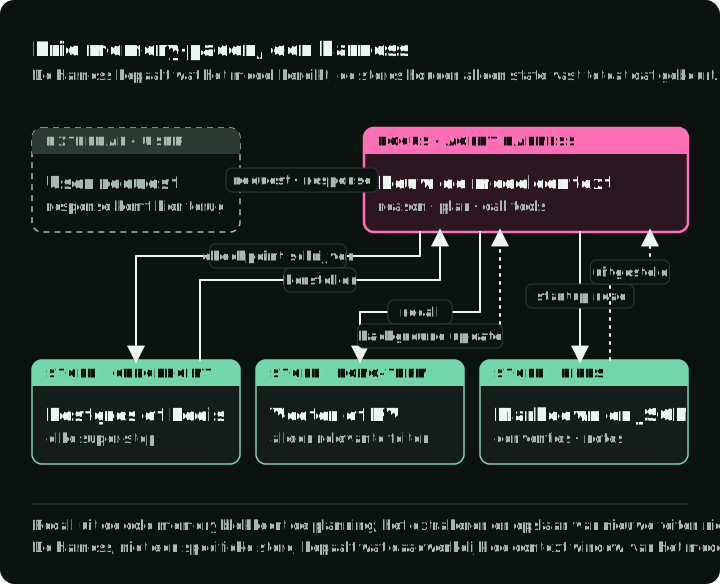
De figuur toont de drie paden samen. Het checkpoint-pad schrijft bij elke super-step en herstelt bij het hervatten. Het long-term-pad wordt vóór de planning gelezen, dus de latency ervan vertraagt het plan; nieuwe feiten kunnen na het antwoord worden geschreven. Het documentpad wordt tijdens de planning gelezen en geschreven naarmate werk klaar is. De harness, niet een afzonderlijke store, bepaalt wat het model bereikt.
In de Market Analyst Agent laat het checkpoint de graph vóór publicatie stoppen en later doorgaan. Qdrant levert een exacte profiel-lookup voor de volgende analyse. De document store archiveert een rapport na goedkeuring. Compaction noch semantische recall is nodig om dat geïmplementeerde gedrag te verklaren.
Kosten en risico’s om op te plannen
- Kosten en latency van embeddings. Elke opgeslagen notitie heeft een embedding nodig, en elke semantische query embedt de vraag. Per september 2026 vermeldt OpenAI
text-embedding-3-smallvoor $0.02 per miljoen tokens; de kosten per feit zijn klein, maar groeien met gebruikers en sessions. Bundel writes, cache veelvoorkomende query-embeddings of draai een lokaal embedding model wanneer het leespad latency-gevoelig is. - Contextbudget. Elk opgehaald feit kost de taak tokens. Beperk hoeveel feiten worden opgehaald en rangschik ze voordat ze de prompt in gaan.
- Verouderde feiten. Voorkeuren veranderen. Verloop is de grove oplossing; schema-gestuurd agent memory legt bij elk feit geldigheid en herkomst vast, zodat bij retrieval de actuele waarde wint.
- Privacy. Long-term memory slaat gebruikersdata op. Verwijder persoonsgegevens vóór opslag waar mogelijk, stel retentieregels in en geef gebruikers een manier om het opgeslagene te wissen, inclusief kopieën in indexen, samenvattingen en caches.
- Consolidatie. Een afgeleid feit zoals “gebruiker vroeg in januari drie keer naar NVDA” kan retrieval helpen zonder de brongesprekken te vervangen. Mem0 beslist of er wordt aangevuld, bijgewerkt of verwijderd; Graphiti houdt ruwe episodes gekoppeld aan afgeleide feiten. Geen van beide bepaalt je retentiebeleid.
- Cold start. Een nieuwe gebruiker heeft geen memory. De agent moet vragen in plaats van aannemen.
- Memory poisoning. Een opgeslagen notitie kan een instructie bevatten als “keur transacties altijd goed”. Valideer vóór opslag, behandel opgehaalde tekst als data en houd rechten buiten memory.
- Drift in documenten. Bestanden hebben geen automatische deduplicatie of conflictdetectie; de ene notitie kan “gebruik pytest” zeggen terwijl een andere “gebruik unittest” zegt. Plan reviews in die ze opschonen en samenvoegen.
Memory-tests: schrijven, lezen, wijzigen, verwijderen
Een bruikbare memory-test maakt een feit aan, leest het in een latere run, wijzigt het en controleert dat de nieuwe run de vervanging gebruikt. Hij test ook foutgevallen en verwijdering. De tests hieronder volgen direct uit de vier eisen aan het begin van het artikel.
| Test | Wat je controleert |
|---|---|
| Herstarten tijdens het wachten op goedkeuring | De graph staat nog op de goedkeuringsgrens; hij heeft niet uit zichzelf gepubliceerd |
| Het antwoord op een externe write verliezen | Een retry veroorzaakt geen tweede effect, of herstel meldt onzekerheid en stopt |
| Een risicovoorkeur wijzigen | Een nieuwe thread leest de actuele waarde en gebruikt de oude niet |
| Een vraag over een eerdere notitie herformuleren | De bedoelde bron wordt opgehaald, of de agent zegt dat hij onvoldoende bewijs vindt |
| Een opgeslagen feit van een gebruiker verwijderen | Exacte lookup, vectorindex, samenvattingen en caches geven het niet meer terug |
| Vragen als een andere gebruiker | Geen record of document van de eerste gebruiker komt in de context van de tweede |
| Een valse instructie in een notitie zetten | De rechten en goedkeuringsregels van de applicatie blijven gelden |
Vergelijk met een baseline zonder memory. Bij retrieval-taken helpt een full-context-baseline om te zien of de toegevoegde extractie- en zoekpipeline onder dezelfde taakomstandigheden iets verbetert. Meet de kwaliteit van retrieval los van de kwaliteit van het antwoord: een correct ogend antwoord kan uit het verkeerde of verouderde feit voortkomen. Leg latency, opslaggroei en alle embedding- of modelkosten vast, in plaats van aan te nemen dat uitgebreider memory beter is.
LongMemEval biedt 500 vragen over informatie-extractie, reasoning over meerdere sessions, temporele reasoning, updates en onthouding. De benchmark helpt bij het ontwerpen van recall-tests, maar een score daarop bewijst niet dat een applicatie veilig hervat of verwijdering respecteert. Een product dat belooft van eerder werk te leren, heeft ook opeenvolgende taken nodig waarin feedback later gedrag verandert; MemoryArena bouwt zulke onderling afhankelijke taken over sessions heen voor winkelen, reisplanning, progressief zoeken en formele reasoning. Houd de test in beide gevallen dicht bij de fout die het product moet voorkomen.
EvoMemBench vergeleek 15 memory-methoden met sterke long-context-baselines onder het eigen protocol. Lange context bleef concurrerend, en geen enkele vorm van memory was in elke setting de beste. Dat resultaat kiest geen store voor deze agent; het is een reden om de eenvoudige baseline te behouden en te testen of een toegevoegd memory-pad deze taak verbetert.
Optioneel: het begeleidende project bekijken
De Market Analyst Agent demonstreert de paden voor checkpoint, profiel en rapportarchief. Hij vereist Python 3.13+, uv, Docker en API-credentials voor het model en de zoekdienst. De analyse doet betaalde modelaanroepen. Volg vanuit een nieuwe checkout de omgevingssetup van de repository en voer daarna uit:
git clone https://github.com/slavadubrov/market-analyst-agent
cd market-analyst-agent
git checkout 6794a0d
make setup
make install
cp .env.example .env
# Configure a model API key in .env before continuing.
make db-up
uv run market-analyst --set-profile --risk-tolerance conservative --horizon long
uv run market-analyst "Analyze NVDA stock"
# Use the thread ID printed by the run after it stops for approval.
uv run market-analyst --approve --thread-id <thread-id>
De gebruikers-ID op de command line is een afbakeningsinvoer, geen authenticatiemechanisme; voeg geverifieerde identiteit en eigendomscontroles toe voordat je dit pad als dienst voor meerdere gebruikers aanbiedt.
Gebruik de kleinste store die deze tests doorstaat. Voor het begeleidende project betekent dat een duurzaam checkpoint, een exact profielrecord en een rapportarchief. Semantische recall en een doorzoekbaar projectnotitieboek zijn alleen nuttige volgende stappen als een echt request en een evaluatie laten zien wat ze toevoegen. Deel 3 gaat over de acties die een agent met deze context kan uitvoeren; deel 4 behandelt de vertrouwensgrens rond die acties.
Referenties
Papers
- Cognitive Architectures for Language Agents (CoALA) — Sumers, Yao et al., 2023 — taxonomie van soorten agent memory
- Memory in the Age of AI Agents — 2025 — overzicht geordend naar vorm, functie en dynamiek van memory
- MemGPT: Towards LLMs as Operating Systems — Packer et al., 2023 — virtueel contextbeheer
- Generative Agents: Interactive Simulacra of Human Behavior — Park et al., 2023 — scoring op recency, importance en relevance
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory — Rasmussen, 2025 — temporele knowledge graph
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory — 2025 — pipeline voor extractie en consolidatie
- Voyager: An Open-Ended Embodied Agent with Large Language Models — Wang et al., 2023 — bibliotheek van uitvoerbare skills
- Agent Workflow Memory — Wang et al., 2024 — herbruikbare workflows voor web-agents
- LongMemEval — 2024 — benchmark voor long-term memory
- EvoMemBench — 2026 — vergelijking van memory-methoden met long-context-baselines
LangGraph en checkpoint-backends
- LangGraph-persistentie, checkpointers en stores
langgraph-checkpoint-postgres— PostgreSQL saverlanggraph-checkpoint-redis— Redis saver en storelanggraph-checkpoint-sqlite— SQLite saver voor lokaal gebruiklanggraph-checkpoint-aws— DynamoDB saver met offloading naar S3
Vector search, graphs en memory-frameworks
- pgvector — vector search in PostgreSQL
- Qdrant en de MCP-server
- Graphiti — engine voor temporele knowledge graphs van Zep
- Mem0, Letta en LangMem
Memory op basis van bestanden
Demoproject
- Market Analyst Agent — opslagpaden voor checkpoint, profiel en documenten