Архитектура памяти ИИ-агента: чекпоинты и векторные хранилища

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Агент может «забывать» по разным причинам. Он может потерять незавершённый запуск после перезапуска, не найти предпочтение из прошлого разговора или следовать устаревшей заметке о проекте. Каждый такой сбой требует своего вида состояния и своего теста. Статья написана для инженеров, которые проектируют это состояние: вы узнаете, когда нужен чекпоинт, точный поиск по ключу, семантический retrieval или документ, который можно просмотреть, и какие инструменты подходят для каждой задачи — от checkpoint saver для PostgreSQL и Redis до pgvector, Qdrant, Markdown-файлов и управляемых фреймворков памяти.
В части 1 мы построили цикл ризонинга. Здесь на примере Market Analyst Agent посмотрим, что цикл должен сохранить, когда он останавливается перед публикацией отчёта, и когда пользователь возвращается с уже известными предпочтениями.
Четыре сбоя, похожие на забывание
«Добавить память» — слишком расплывчатая формулировка, чтобы выбрать реализацию. Полезное требование говорит, что должно сохраниться, кто может это читать и что произойдёт, если данные неверны.
| Требование | Какое состояние сохранить | Первый рабочий дизайн | Какой сбой тестировать |
|---|---|---|---|
| Продолжить анализ после одобрения или перезапуска воркера | Сообщения, план, черновик, ожидающий шаг графа | Надёжный чекпоинт для этого треда | Перезапуск до публикации; продолжение с нужного шага |
| Применить предпочтение по риску вернувшегося пользователя | Один актуальный именованный факт, привязанный к пользователю | Структурированный профиль с точным ключом | Изменить предпочтение; старое значение не должно использоваться |
| Вспомнить неструктурированное наблюдение из прошлой работы | Источник, текст, владелец, время, срок действия | Записи с поиском; эмбеддинги только при необходимости | Перефразировать запрос и проверить найденный источник |
| Переиспользовать соглашение проекта | Заметка для ревью и её владелец | Файл или хранилище документов | Исправить ошибочную заметку и убедиться, что следующий запуск видит исправление |
Первый вопрос — нужно ли агенту сохранённое состояние вообще. Одноразовый классификатор, который получает весь вход в одном запросе, может проверить ответ и завершиться. Ему не нужна векторная база данных только потому, что когда-нибудь более крупная система может задать уточняющий вопрос.
Когда требование есть, эта таблица подсказывает стартовый инструмент для каждой задачи. В разделах ниже объясняется, когда переходить на альтернативу.
| Задача | С чего начать | На что перейти |
|---|---|---|
| Продолжить один запуск или тред | PostgreSQL saver из LangGraph | Redis saver, если латентность чекпоинтов — измеренный боттлнек; SQLite saver для локальной работы |
| Прочитать именованный факт о пользователе | Строка PostgreSQL или колонка JSONB, Redis hash или ключ в Store из LangGraph | Больше ничего, пока у факта стабильное имя |
| Найти заметку по смыслу | Store из LangGraph с индексом или pgvector рядом с данными приложения | Qdrant или другая векторная база данных, когда этого требуют фильтрация, масштаб или эксплуатация |
| Найти заметку по точным терминам | Полнотекстовый поиск PostgreSQL с индексом GIN | Гибридный retrieval по ключевым словам и векторам, когда перефразировки обходят ключевые слова |
| Отвечать на вопросы о связях | Связанные реляционные записи | Темпоральный граф знаний, например Graphiti |
| Держать знания о проекте доступными для ревью | Markdown-файлы в репозитории | Документы в PostgreSQL с полнотекстовым и vector search для многих тенантов |
| Отдать извлечение и поддержку инструменту | Собственные правила записи и обновления | Mem0, Letta или LangMem, если контроль над этим пайплайном не нужен |
Хранилище и контекст модели — тоже разные вещи. В базе данных может лежать миллион записей; модель видит только то подмножество, которое приложение выбрало и поместило в следующий запрос. Сохранение факта не гарантирует, что его найдут. То, что его нашли, не гарантирует, что агент использует его правильно. Поэтому дизайну памяти нужны не только правило записи, но и правило чтения и тест результата.
Статья CoALA даёт удобные названия видам информации: рабочее состояние текущего шага; эпизодическая память о событиях; семантическая память о фактах; процедурная память о том, как действовать. Модель персистентности LangGraph проводит другое различие, на уровне реализации: checkpointer хранит состояние одного треда, а store хранит данные приложения между тредами. Документ может содержать событие, факт или процедуру. Эти категории говорят о том, что означает информация; они не требуют отдельной базы данных для каждой категории.
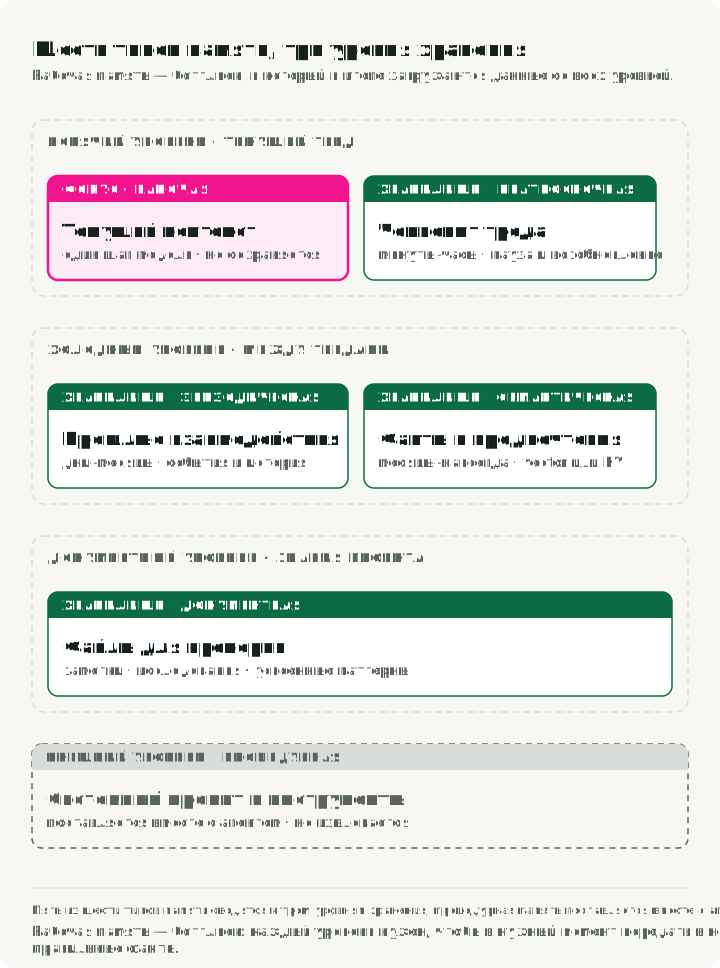
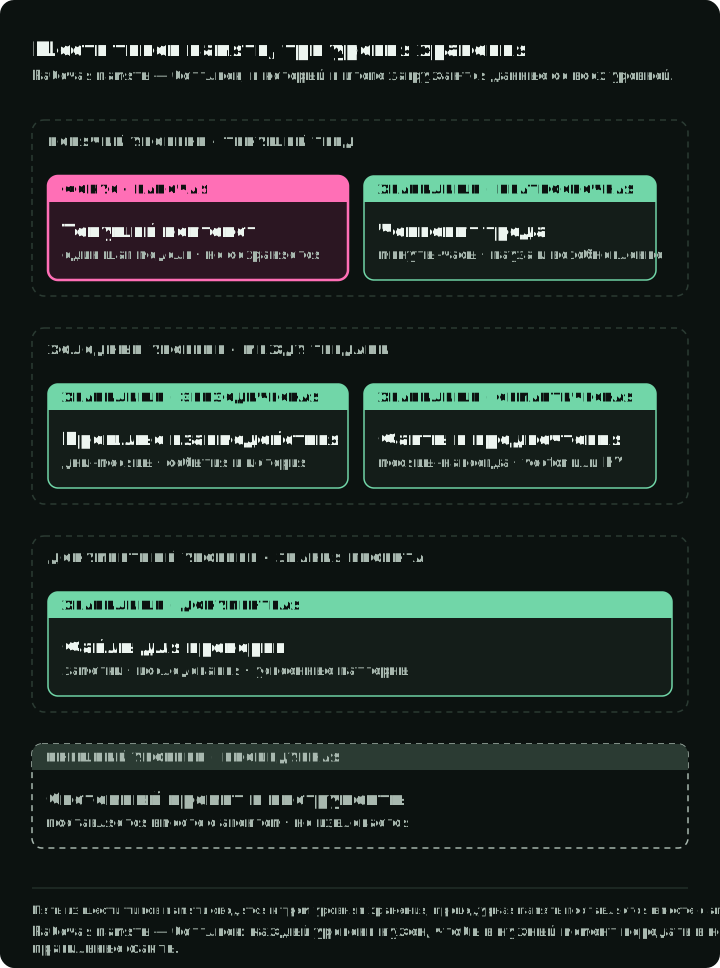
На рисунке эти виды разложены по трём хранилищам, которые используются в статье: чекпоинт для текущего треда, межтредовые записи и документы для знаний о проекте. Читайте столбец сверху вниз, и видно, что одно хранилище может содержать несколько видов информации. Процедуры могут поставляться вместе с агентом в виде инструкций и инструментов или храниться и извлекаться как любой другой документ.
Рабочее состояние может жить в переменных процесса и в текущем запросе к модели. Выбранные сообщения и результаты инструментов должны помещаться в контекстное окно модели; состояние приложения может быть больше. Если процесс завершится, восстановить можно только ту часть, которую сознательно сохранили. «Краткосрочная» и «долгосрочная» описывают область переиспользования, а не фиксированные сроки хранения. Когда удалять ту или другую, решает политика хранения приложения.
Чекпоинт позволяет продолжить запуск
Возьмём анализ, который собрал данные, подготовил черновик отчёта и остановился в ожидании одобрения. Если его воркер завершится, другому воркеру нужно знать черновик, статус одобрения и следующий узел графа. Одна только расшифровка разговора не говорит, опубликован ли отчёт.
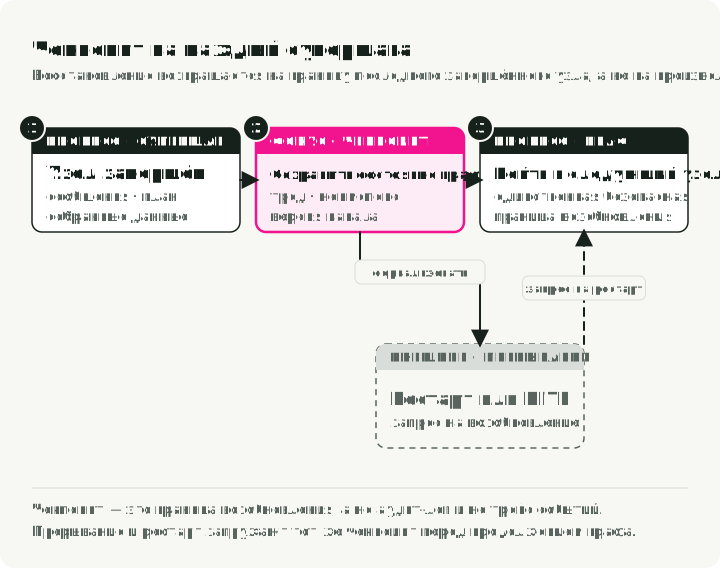
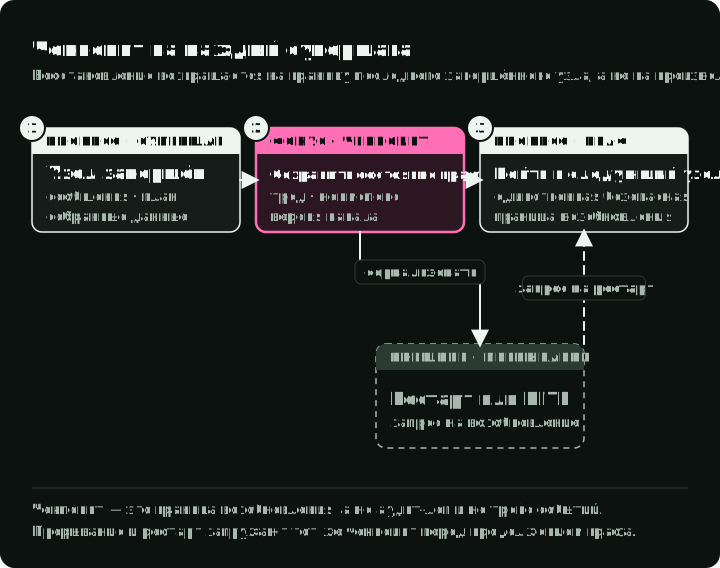
LangGraph сохраняет состояние графа на границах super-step. Super-step — это один раунд запланированных узлов; несколько из них могут выполняться параллельно. Сохранённое состояние треда включает значения и информацию о планировании, поэтому запуск может продолжиться с завершённой границы. Продолжить с произвольной строки внутри узла нельзя. Документация по checkpointer также описывает отложенные записи узлов, которые завершились внутри неудачного super-step. Чекпоинт — это запись для восстановления, а не полный трейс всего, что сделал агент.
Проект-компаньон делает эту границу видимой. Его фабрика графа компилирует граф с checkpointer и прерывает выполнение перед узлом публикации. Путь одобрения читает сохранённое состояние, проверяет, что ожидающий шаг — это публикация, записывает одобрение и продолжает выполнение. Настройка чекпоинтов по умолчанию использует PostgreSQL и может выбрать Redis. Вызывайте граф с durability="sync", если при сбое нельзя потерять последний завершённый шаг.
Режим надёжности определяет, какое состояние может быть потеряно при сбое. В документированных режимах LangGraph асинхронная запись позволяет следующему шагу начаться до того, как чекпоинт записан; поэтому при сбое можно потерять последний шаг. Режим sync ждёт каждую запись чекпоинта, прежде чем идти дальше. Режим exit сохраняет состояние при завершении графа, поэтому не может восстановиться после сбоя в середине долгого запуска. Выбирайте режим по требованию к восстановлению, а затем тестируйте принудительный перезапуск на той границе, которая важна. На рисунке один и тот же граф запускается в каждом режиме и падает во время третьего super-step.
Что хранит saver
Каждый бэкенд чекпоинтов в LangGraph реализует BaseCheckpointSaver: put() записывает чекпоинт, get_tuple() читает последний чекпоинт треда, а list() возвращает его историю. Каждый чекпоинт адресуется ключом (thread_id, checkpoint_ns, checkpoint_id). thread_id определяет разговор, checkpoint_ns разделяет подграфы, а checkpoint_id определяет одну версию. thread_id указывает на сохранённое состояние; он не устанавливает, кто вызывающий, и не даёт права доступа к треду.
PostgreSQL saver из langgraph-checkpoint-postgres создаёт свои таблицы при setup(). Два воркера, пишущие в один тред, разделены ключом чекпоинта и upsert-ами, а не блокировками: они не испортят строки друг друга, но и не будут координироваться. Давайте запуску одного активного писателя, как описано в части 5.
Минимальная настройка PostgreSQL, если create_graph собирает и компилирует ваш граф:
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver

async def run(connection_string: str, authenticated_user_id: str) -> None:
    # from_conn_string owns the connection, so the graph runs inside this block.
    async with AsyncPostgresSaver.from_conn_string(connection_string) as checkpointer:
        await checkpointer.setup()  # creates the tables; safe on every start
        graph = create_graph(checkpointer=checkpointer)
        config = {"configurable": {"thread_id": "analysis-42"}}
        await graph.ainvoke({"user_id": authenticated_user_id, "messages": [...]}, config)
        # Later, after the server authenticates the approver:
        await graph.aupdate_state(config, {"report_approved": True})
        await graph.ainvoke(None, config)  # continue from the saved interrupt
user_id берётся из аутентифицированного контекста запроса на сервере, а не из модели и не из JSON клиента. Если строки чекпоинтов может записывать кто-то кроме приложения, установите LANGGRAPH_STRICT_MSGPACK=true, чтобы десериализация принимала только безопасные или объявленные типы, как описано в бюллетене безопасности LangGraph.
Чекпоинт не делает внешнюю запись безопасной
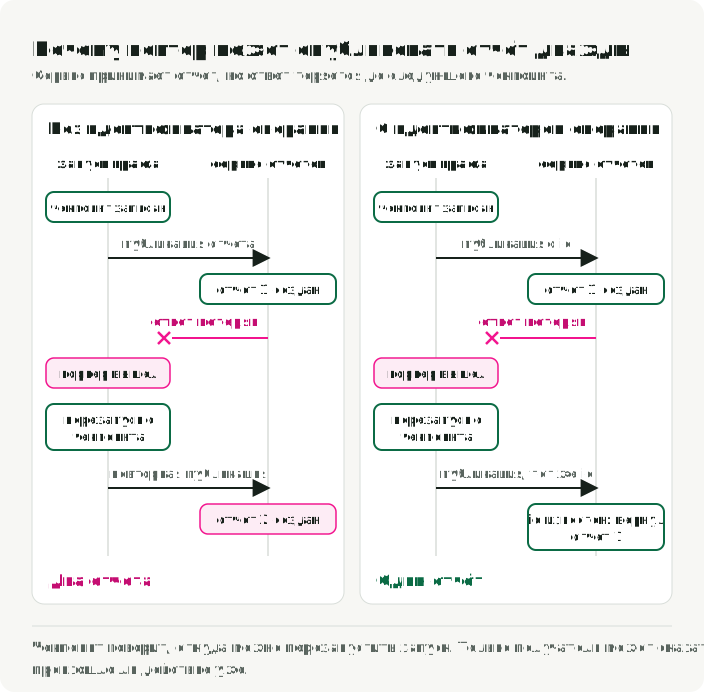
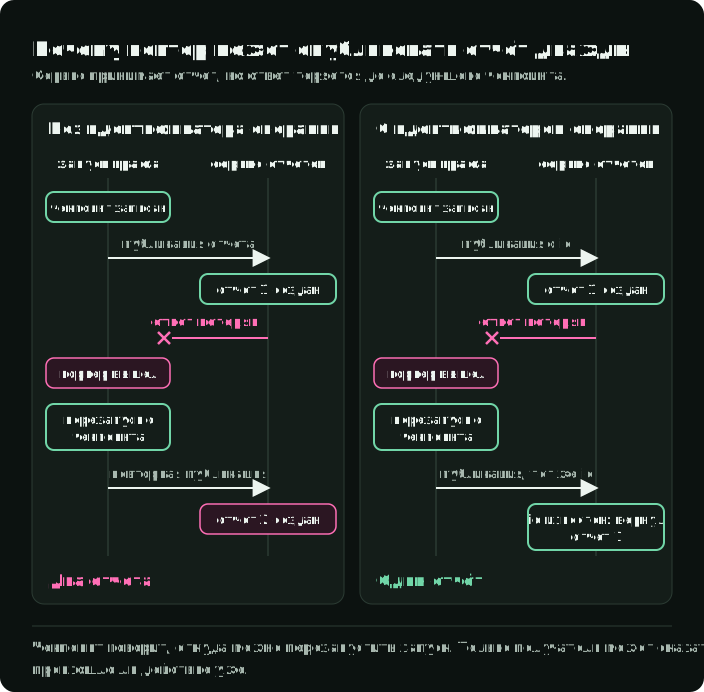
Допустим, узел публикации отправляет отчёт во внешний сервис. Сервис его принимает, но ответ теряется до того, как граф сохранит следующий чекпоинт. Перезапуск с предыдущего чекпоинта может выполнить узел ещё раз. Никакая настройка базы чекпоинтов не скажет, удалась ли эта внешняя запись.
Для записи, которую можно повторить, дайте операции идентификатор, принадлежащий приложению, и пусть получатель распознаёт повтор с этим идентификатором. Если получатель этого не умеет, восстановление должно проверить получателя или запросить решение человека, прежде чем повторять действие. То же касается платежей, сообщений и записи файлов. Чекпоинт отвечает на вопрос «где можно перезапустить выполнение?»; внешней операции нужен свой ответ на вопрос «это действие уже произошло?». Руководство AWS по идемпотентным API объясняет контракт на стороне сервиса. На рисунке показан один потерянный ответ с этим идентификатором и без него.
Держите бизнес-записи отдельно от состояния графа. Архив отчётов фиксирует, что опубликовано; чекпоинт фиксирует, как граф дошёл до этого шага или ждал его. Журнал событий или трейс может фиксировать каждое предпринятое действие. Ни одна из этих трёх записей не заменяет две другие. Часть 5 возвращается к восстановлению и свидетельствам рантайма.
Выбор бэкенда по требованиям к восстановлению
Проект-компаньон поддерживает checkpoint saver для PostgreSQL и Redis. Для графа у них одна роль, но поведение в эксплуатации зависит от настроенной базы данных и saver.
| Вопрос | PostgreSQL | Redis |
|---|---|---|
| Что нужно эксплуатировать? | Реляционную базу данных, её хранилище, бэкапы и таблицы чекпоинтов | Память Redis, вытеснение, персистентность и настройки бэкапов |
| Какая история нужна? | Полная история чекпоинтов со стандартным saver | Проверьте выбранный saver и политику хранения; shallow saver хранит только последний чекпоинт |
| Что должно решать? | Уже налаженная эксплуатация базы, требования к восстановлению, измеренная стоимость записи | Измеренная латентность чекпоинтов, допустимые потери и реальные настройки персистентности |
Если приложение уже работает на PostgreSQL и важна надёжная история, я бы начал с него. Он подходит для долгих запусков, где потеря состояния означает часы повторных вычислений, для областей, где надёжность обязательна, и для команд, которым нужна отладка с перемещением по истории чекпоинтов. С pgvector та же база может хранить и долгосрочную память, и vector search, так что эксплуатировать остаётся одну систему.
Выбирайте Redis, когда доступ к чекпоинтам — измеренный боттлнек, как в стриминговом чате или голосовом интерфейсе, или когда Redis уже подходит системе как хранилище состояния. Утверждение, что Redis «быстрее», — не замер этого графа: на результат влияют размер сериализованного состояния, частота записи, сетевой путь и политика персистентности. Пакет langgraph-checkpoint-redis также предлагает ShallowRedisSaver, который хранит только последний чекпоинт каждого треда: этого хватает для паузы и продолжения, но истории для отладки нет.
Выбирайте политику персистентности Redis по допустимым потерям; при обычной настройке append-only при сбое можно потерять примерно секунду записей. Тестируйте восстановление после сбоя на реальных настройках.
Ещё два saver покрывают типичные конфигурации. langgraph-checkpoint-sqlite подходит для локальной разработки и деплоев с одним процессом. В AWS langgraph-checkpoint-aws предоставляет DynamoDBSaver, который выносит большие чекпоинты в S3.
История чекпоинтов растёт. Удаление старых строк универсальным SQL-запросом по возрасту может сломать восстановление, если сохранённые чекпоинты зависят от более ранних записей или от delta channels. Используйте операцию очистки, которую поддерживает saver и поведение которой при восстановлении вы проверили. Если для установленной версии такой операции нет, храните нужную историю, пока не сможете проверить процедуру очистки.
Межтредовой памяти нужно правило обновления
У вернувшегося пользователя может быть предпочтение по риску, которое должно повлиять на новый анализ. Этот факт не стоит прятать в чекпоинте старого разговора: новый запрос может использовать другой тред. Нужна межтредовая запись с владельцем, способом чтения и способом замены или удаления.
Реализация долгосрочной памяти в проекте-компаньоне хранит профили пользователей в Qdrant. Путь get_profile использует точный фильтр по ID пользователя, а при сохранении профиля для обновлений используется детерминированный ID точки. Путь профиля — это межтредовое хранение, а не семантическое извлечение. Профиль с именованными полями вроде толерантности к риску и инвестиционного горизонта мог бы лежать и в колонке JSONB в PostgreSQL или в Redis hash — это проще, чем строить эмбеддинги и запрашивать векторы. Эмбеддинги не дали бы этому точному поиску ничего.
Когда это открыто как сервис, ID пользователя в запросе к store должен браться из проверенной идентичности в приложении. Фильтр по payload в Qdrant ограничивает retrieval; это не аутентификация. У проекта-компаньона есть и интерфейс командной строки, который принимает ID пользователя. Он удобен для локальной демонстрации, но приложение, которое обслуживает нескольких людей, должно проверять владение, прежде чем читать или записывать профили. Документация Qdrant по мультитенантности описывает фильтры и индексы по тенантам; кто может передать значение тенанта, по-прежнему решает приложение.
Store в LangGraph
Store API в LangGraph хранит межтредовые элементы как пары (namespace, key) со значением JSON. Namespace обычно кодирует владельца, например ("user", user_id, "preferences"). BaseStore предоставляет put(), get(), search() и delete() с иерархическим ограничением по namespace. Большинство потребностей покрывают три реализации:
InMemoryStoreдля разработки и тестов; данные теряются при завершении процесса.PostgresStoreдля персистентного store, к которому обращаются через SQL.AsyncRedisStoreиз пакета Redis для межтредовой памяти с vector search, TTL и фильтрами по метаданным.
Конфигурация index добавляет vector search по сохранённым элементам с функцией эмбеддинга, которую вы передаёте. Для многих приложений этого встроенного store хватает, прежде чем понадобится отдельная векторная база данных:
from langgraph.store.memory import InMemoryStore

store = InMemoryStore(index={"dims": 1536, "embed": embed_texts})

async def remember_and_recall(user_id: str) -> list:
    await store.aput(
        ("user", user_id, "preferences"),
        "risk-profile",
        {"risk_tolerance": "high", "horizon": "long-term"},
    )
    # The namespace prefix is positional in search and asearch.
    return await store.asearch(("user", user_id), query="investment style", limit=5)
Передайте store при компиляции графа рядом с checkpointer, и узел сможет объявить параметр store, чтобы его читать: builder.compile(checkpointer=checkpointer, store=store).
Когда добавлять семантический retrieval
Теперь изменим запрос: «Какое опасение насчёт поставщиков я высказал в прошлом анализе?» У нужной заметки может не быть стабильного ключа, известного вызывающему. Поиск по смыслу может найти заметки-кандидаты, даже если в вопросе другие слова. Именно эта потребность — причина добавить эмбеддинги. Наличие векторной базы данных такой причиной не является.
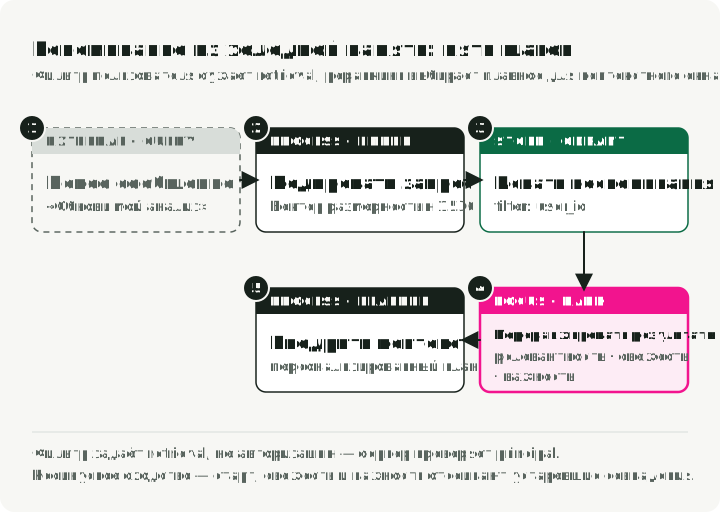
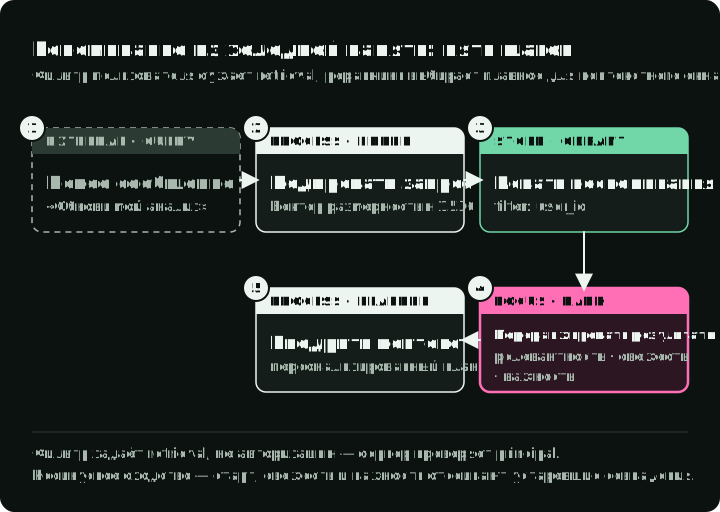
Условное расширение извлекало бы из завершённого разговора короткий факт-кандидат, добавляло бы источник и владельца, строило эмбеддинг и сохраняло и текст, и вектор. При следующем запросе приложение сначала ограничило бы поиск этим владельцем, получило кандидатов, проверило, действуют ли они ещё, и передало модели только релевантные факты с указанием источника.
Извлечённый факт — это лишь кандидат. Модель может вывести «предпочтение» из одного двусмысленного сообщения. Прежде чем переносить его в долговременную память, решите, какие факты требуют подтверждения пользователя, какие можно обновлять автоматически, а какие нельзя выводить никогда. Храните источник и время наблюдения, чтобы более позднее исправление могло заменить факт. Сходство измеряет тематическую близость; оно не устанавливает ни истинность, ни актуальность, ни права доступа.
Где хранить векторы — отдельный выбор. pgvector держит их в базе PostgreSQL, которую приложение уже использует. Qdrant — отдельная векторная база данных с индексацией HNSW и поиском с фильтрами; HNSW и его компромиссы разобраны в статье о ранжировании поиска. Qdrant также публикует MCP-сервер, который открывает коллекцию как инструмент памяти для MCP-клиентов. Отдельный сервис полезен, когда нужны его retrieval, фильтрация, масштаб или удобство эксплуатации; подтвердите эту потребность на своих запросах и своём корпусе, прежде чем его добавлять.
Сырое косинусное сходство — лишь отправной сигнал. Статья Generative Agents сочетала три сигнала для извлечения воспоминаний симулированных агентов: свежесть с экспоненциальным затуханием; важность, которую модель оценивала по шкале 1–10; и релевантность как сходство эмбеддингов. Все три нормализовались, а затем складывались с равными весами. Если берёте эту идею, сначала нормализуйте, иначе будет доминировать оценка важности по шкале 1–10, и подбирайте веса на отложенных проверках recall и задач. Если семантическое извлечение возвращает устаревшее предпочтение, потому что его формулировка похожа на новый вопрос, исправьте правило актуальности, прежде чем подбирать веса. Для именованного предпочтения более простым ответом остаётся структурированное значение с явным обновлением.
Попробуйте поиск по ключевым словам или полнотекстовый поиск, когда заметку определяют точные имена и термины. Используйте эмбеддинги, когда перефразировки регулярно обходят такой поиск. Если важно и то и другое, получайте кандидатов обоими путями, прежде чем объединять их ранги. Переранжирование результатов поиска по ключевым словам одними векторными оценками не вернёт релевантную заметку, которую фильтр по ключевым словам уже отбросил.
| Подход | Для чего лучше всего | Главная стоимость эксплуатации |
|---|---|---|
| Key-value-хранилище (PostgreSQL JSONB, Redis hash) | Структурированные профили и предпочтения | Расход памяти и политика персистентности |
| Полнотекстовый поиск (PostgreSQL GIN) | Recall по ключевым словам в истории разговоров | Рост индекса и настройка запросов |
| Vector search (pgvector, Qdrant) | Семантический recall неструктурированных заметок | Жизненный цикл эмбеддингов и индекса |
| Гибридный (ключевые слова + векторы) | Recall, когда формулировки запросов различаются | Два пути оценки, которые нужно настраивать и проверять |
| Граф знаний (Graphiti, Neo4j) | Связи между сущностями и многошаговые запросы | Моделирование графа и ещё одна система данных |
| Хранилище документов (файлы) | Знания о проекте и заметки, которыми управляет агент | Конкурентный доступ, права и поиск |
Связи и управляемые фреймворки
Для связей может понадобиться другая форма. Вопрос вроде «Какие прежние поставщики были связаны с этой компанией и когда действовала каждая связь?» — кандидат на темпоральный граф. Graphiti от Zep строит граф знаний, который хранит не только то, что было верно, но и когда это было верно, и сохраняет заменённые значения вместе с интервалами их действия. В бенчмарке DMR из статьи о Zep результат Zep отличался менее чем на полпункта от варианта, где в контекст помещается весь разговор, так что этот результат не показывает общего преимущества темпоральных графов. Извлечение и обновления по-прежнему должны определять, верна ли связь. Если на запросы отвечают связанные записи, используйте их вместо того, чтобы эксплуатировать ещё один графовый сервис.
Фреймворки памяти запускают за вас пайплайн извлечения, консолидации и поиска. В Mem0 модель извлекает факты-кандидаты, сравнивает каждый с существующими записями и решает, добавить, обновить, удалить что-то или оставить память без изменений. Letta, ранее MemGPT, даёт агенту инструменты для перемещения данных между «core memory» в контексте и «archival memory» вне контекста. LangMem предоставляет инструменты управления памятью для агентов на LangGraph. Попробуйте один из них, если нужен рабочий пайплайн быстро, а контроль над каждым правилом записи не нужен; хранение, удаление и тесты ниже всё равно остаются на вас.
Документы делают накопленные знания проверяемыми
Часть памяти удобнее читать как документ. Агенту для программирования может понадобиться команда запуска тестов и заметки об архитектуре проекта. Исследовательскому агенту — проверенный список источников и обоснование прошлого решения. Это связанные фрагменты знаний, которые человек должен иметь возможность прочитать, исправить и версионировать.
Возьмём агента для программирования, который неделями работает над одним проектом. Он узнаёт, что проект использует Pydantic v2, что тесты запускаются командой pytest -x --tb=short и что разработчик предпочитает pathlib вместо os.path. Эти факты можно хранить в key-value-хранилище, но файл позволяет разработчику их прочитать, исправить ошибочный обычной правкой и просмотреть каждое изменение в git diff.
Ассистенты для программирования уже используют этот паттерн:
- Claude Code читает файлы
CLAUDE.mdиз проекта и его родительских каталогов и хранит память по каждому проекту в Markdown в~/.claude/projects/. Файлы проекта коммитятся вместе с кодом. - Cursor загружает правила проекта из
.cursor/rulesв виде файлов.mdc; их front matter определяет, когда применяется каждое правило. - Devin Desktop читает правила из
.devin/rules/и может хранить автоматически созданные воспоминания для каждого воркспейса. - Инструмент памяти Anthropic для Claude API — клиентский инструмент, файловые команды которого (view, create, edit, delete, rename) работают с каталогом
/memories. Каждую команду реализует ваше приложение, поэтому оно и решает, где лежат файлы: на диске, в S3 или в базе данных.
DocumentMemory в проекте-компаньоне записывает JSON-обёртки с содержимым, метаданными и временем создания в namespace-ы. Её узел публикации архивирует одобренный отчёт в namespace research. Исследовательский агент мог бы использовать такую структуру:
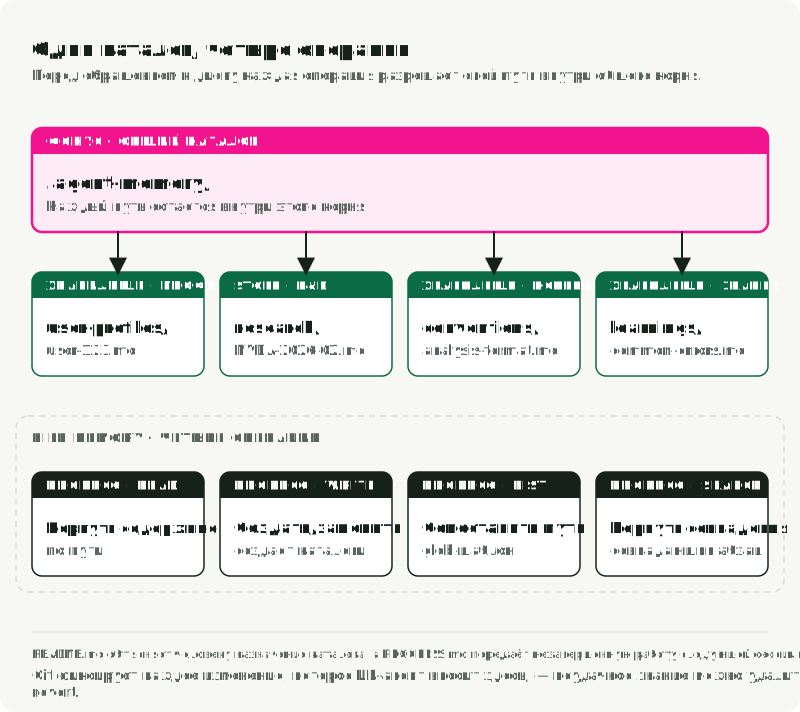
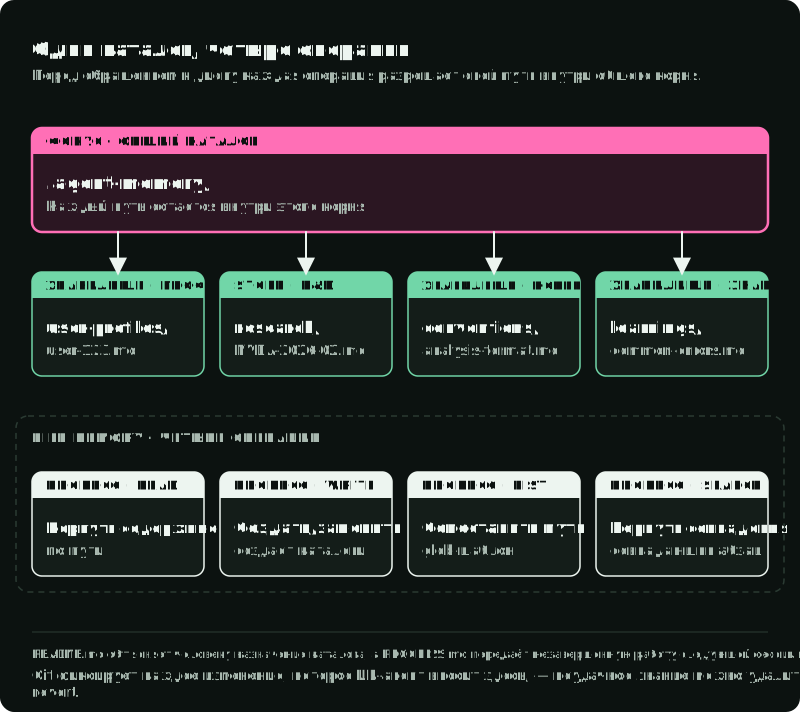
.agent-memory/
    README.md                  # What this directory is, for human readers
    PROGRESS.md                # Handoff for the next session: done, next
    user-profiles/user-123.md  # Preferences and risk profile
    research/NVDA-2026-02.md   # Notes from a recent analysis
    conventions/analysis-format.md
    learnings/common-errors.md # Mistakes the agent has learned to avoid
На рисунке показаны два пути в этот каталог: вызовы агента и правки человека.
Для одного проекта, заметки которого требуют ревью человеком, может хватить обычного Markdown. Используйте имена, которые говорят, о чём документ; записывайте источник и дату последнего ревью, если они влияют на доверие. Агенту нужны четыре операции: прочитать документ, записать его, получить список документов и искать по ключевому слову. Короткие файлы, например заметку о соглашениях или о передаче работы, можно загружать целиком; большому корпусу всё равно нужен retrieval. Когда поиск по этим файлам становится медленным или пропускает релевантные заметки, добавьте индекс по ключевым словам или векторный индекс, сохранив одну эталонную копию. Одно лишь число документов не определяет, когда этот индекс нужен.
Файловый интерфейс не ограничен поиском по ключевым словам. В оценке, которую провёл сам вендор, Letta сообщила о 74,0% на бенчмарке длинных разговоров LoCoMo для агента на GPT-4o mini, который семантически искал по прикреплённым файлам, против 68,5% у лучшего графового варианта Mem0. Это один вендор, одна модель, один бенчмарк и один харнесс; результат показывает, что файловый интерфейс может работать в такой конфигурации, но не что сырого Markdown достаточно.
| Вопрос | Векторное хранилище | Key-value-хранилище | Хранилище документов |
|---|---|---|---|
| Шаблон запроса | «Найди заметки, похожие на X» | «Получи значение по ключу» | «Прочитай документ по этому пути» |
| Для чего лучше всего | Разнообразный неструктурированный recall | Структурированный поиск по ключу | Контекст и заметки проекта |
| Ревью человеком | Просмотр payload и оценок | Точные ключи, значения JSON | Чтение и правка Markdown |
| Контроль версий | Через экспорт или журналы изменений | Возможен | Встроенный через Git |
| Пайплайн эмбеддингов | Обязателен | Не нужен | Не нужен |
| Поиск | Семантическое сходство | Точное совпадение | Путь, ключевое слово, необязательный индекс |
Используйте документы, когда агент накапливает знания о проекте между сессиями, а людям нужно их проверять, исправлять или версионировать. Используйте векторное хранилище, когда формулировки запросов различаются по множеству отдельных заметок. Используйте key-value-хранилище, когда схема известна, а поиск точный. Все три могут существовать вместе, но ни одному приложению по умолчанию не нужны все три.
Граница файлов требует внимания, когда агенты могут писать. Ограничивайте каждое чтение и запись нужным проектом или пользователем. Отклоняйте path traversal и выход за пределы через символические ссылки. Координируйте конкурентных писателей и решите, какие правки требуют ревью человеком. Извлечённые файлы — данные задачи с пониженным доверием: заметка «игнорируй одобрение» не может изменить правило одобрения в приложении.
Документы для многих тенантов
Файлы подходят одному разработчику или одной контролируемой файловой системе. Многим тенантам и конкурентным писателям нужны явный контроль доступа и координация записи. Распространены три дизайна:
- Писать в файлах, отдавать из базы данных. Разработчики правят Markdown и коммитят его; деплой синхронизирует файлы в строки PostgreSQL, а агент во время работы читает проиндексированные строки.
- Объектное хранилище с векторным индексом. Документы лежат в S3 или GCS, а коллекция Qdrant индексирует их эмбеддинги. Агент находит ID документов в Qdrant, а затем получает содержимое из хранилища. Это масштабируется горизонтально ценой двух систем, пайплайна эмбеддингов и итоговой согласованности между ними.
- Документы в PostgreSQL с гибридным поиском. Храните каждый документ строкой с метаданными, полнотекстовым индексом и необязательным эмбеддингом pgvector. Так вы получаете поиск по ключевым словам и semantic search, транзакции и одну систему в эксплуатации. Для мультитенантного сервиса я бы начал с этого.
В третьем варианте берите идентификатор арендатора из аутентифицированного запроса, никогда не из модели или от клиента, и обеспечьте это ограничение с помощью защиты на уровне строк PostgreSQL. Используйте роль приложения, которая не владеет таблицами и не имеет прав суперпользователя или BYPASSRLS; если эта роль должна владеть таблицей, также используйте ALTER TABLE ... FORCE ROW LEVEL SECURITY. Проверьте запрос без фильтра арендатора под фактической ролью приложения и убедитесь, что он не возвращает строки других арендаторов. Объединяйте результаты поиска по ключевым словам и векторам, как описано выше в разделе о семантическом retrieval.
Процедура тоже отличается от запомненного наблюдения. Voyager хранил переиспользуемые исполняемые программы и находил их по описанию. Agent Workflow Memory вместо этого добавляет в промпт выведенные веб-воркфлоу как подсказки. Заметка о проекте может описывать, как запустить проверку. Исполняемым программам нужны тесты и ограниченное выполнение; заметкам — проверка фактов и тест того, что следование им помогает. Ни то ни другое не должно получать новых прав только потому, что было извлечено из памяти. Agent Skill — соседний случай: файл SKILL.md, который говорит агенту, как выполнять определённый класс работы, и который часть 3 сравнивает с инструментами.
Компакция меняет контекст, а не источник истины
Длинному разговору в какой-то момент нужен отбор. Приложение может опустить старые сообщения или пересказать их, чтобы следующий запрос к модели уложился в бюджет контекста. Серверная компакция Claude, на сентябрь 2026 года бета-функция, возвращает блок compaction, который последующие запросы используют вместо прежнего содержимого. Такой пересказ помогает модели продолжить, но может потерять номер заказа, отклонённое предложение или условие одобрения.
Держите операционные факты в явном состоянии: ожидающий шаг графа, завершённые внешние эффекты и точный статус одобрения. Держите межтредовые факты в записях с владельцами и правилами обновления. Используйте пересказ, чтобы дать контекст, а затем проверьте, что он опустил: принудительно запустите компакцию посреди теста и проверьте, соблюдает ли следующее действие ранее заданное ограничение. Выберите факт, который пересказ не может восстановить догадкой, например идентификатор операции или точное условие, привязанное к одобрению, и сверьте его с эталонным состоянием, а не с формулировкой пересказа. Формулировки пересказа оценивайте как отдельную, самостоятельную проверку. Чекпоинт восстанавливает выполнение графа; компакция сокращает вход модели; retrieval отбирает информацию для нового запроса. Это разные операции, даже если все три выполняет один харнесс.
Компакция ещё и сбрасывает префиксный кэш провайдера, и пойти на этот сброс редко, одним большим скачком, дешевле, чем подрезать по нескольку сообщений в каждом раунде. Провайдеры переиспользуют работу над стабильным префиксом запроса, поэтому замена старых сообщений меняет префикс, и следующий запрос платит полную цену за всё, что идёт дальше. Один большой скачок стоит одного чтения по полной цене гораздо меньшего входа, после чего снова идут дешёвые дописывания, а постоянные мелкие подрезки платят эту цену снова и снова, и более короткий разговор может обойтись дороже длинного. Порог компакции выбирайте, проверяя его для вашей модели и задачи, а не задавая фиксированной долей контекстного окна.
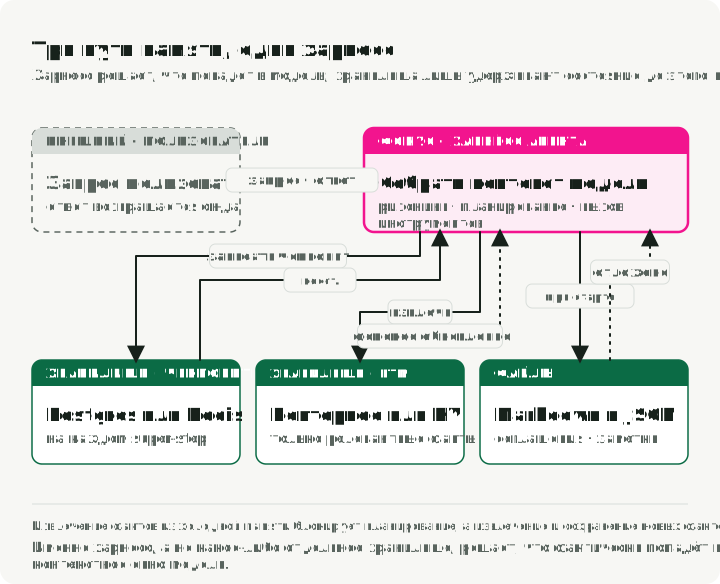
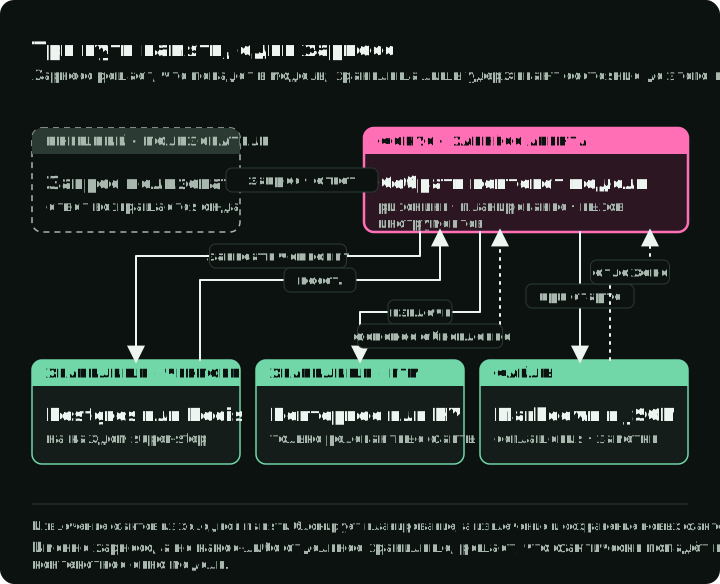
Рисунок показывает три пути вместе. Путь чекпоинта пишет на каждом super-step и восстанавливает состояние при продолжении. Долгосрочный путь читается до планирования, поэтому его латентность задерживает план; новые факты можно записать после ответа. Путь документов читается во время планирования и пишется по мере завершения работы. Что попадает в модель, решает харнесс, а не какое-то одно хранилище.
В Market Analyst Agent чекпоинт позволяет графу остановиться перед публикацией и продолжить позже. Qdrant даёт точный поиск профиля для следующего анализа. Хранилище документов архивирует отчёт после одобрения. Чтобы объяснить это реализованное поведение, не нужны ни компакция, ни семантическое извлечение.
Затраты и риски, которые нужно учесть
- Стоимость и латентность эмбеддингов. Каждой сохранённой заметке нужен эмбеддинг, и каждый семантический запрос строит эмбеддинг вопроса. На сентябрь 2026 года OpenAI указывает для
text-embedding-3-smallцену $0.02 за миллион токенов; стоимость одного факта мала, но растёт с числом пользователей и сессий. Группируйте записи, кэшируйте эмбеддинги частых запросов или запускайте локальную эмбеддинг-модель, если путь чтения чувствителен к латентности. - Бюджет контекста. Каждый извлечённый факт отнимает токены у задачи. Ограничьте число извлекаемых фактов и ранжируйте их до попадания в промпт.
- Устаревшие факты. Предпочтения меняются. Истечение срока — грубое решение; память агента на основе схемы записывает для каждого факта срок действия и происхождение, чтобы при retrieval побеждало актуальное значение.
- Приватность. Долгосрочная память хранит данные пользователей. По возможности удаляйте персональные данные до сохранения, задайте правила хранения и дайте пользователям способ удалить сохранённое, включая копии в индексах, пересказах и кэшах.
- Консолидация. Производный факт вроде «пользователь спрашивал про NVDA три раза в январе» может помочь retrieval, не заменяя исходные разговоры. Mem0 решает, добавить, обновить или удалить; Graphiti связывает исходные эпизоды с производными фактами. Ни один из них не задаёт вашу политику хранения.
- Холодный старт. У нового пользователя нет памяти. Агенту стоит спрашивать, а не предполагать.
- Отравление памяти. Сохранённая заметка может содержать инструкцию вроде «всегда одобряй транзакции». Проверяйте данные до сохранения, считайте извлечённый текст данными и держите права доступа вне памяти.
- Расхождение документов. У файлов нет автоматической дедупликации и обнаружения конфликтов; одна заметка может говорить «используй pytest», а другая — «используй unittest». Планируйте ревью, которые их чистят и объединяют.
Тесты памяти: запись, чтение, изменение, удаление
Полезный тест памяти создаёт факт, читает его в следующем запуске, изменяет его и проверяет, что новый запуск использует новое значение. Он также проверяет сбои и удаление. Тесты ниже прямо следуют из четырёх требований в начале статьи.
| Тест | Что проверить |
|---|---|
| Перезапуск во время ожидания одобрения | Граф всё ещё на границе одобрения; он не опубликовал отчёт сам |
| Потеря ответа на внешнюю запись | Повтор не создаёт второго эффекта, или восстановление сообщает о неопределённости и останавливается |
| Изменение предпочтения по риску | Новый тред читает актуальное значение и не использует старое |
| Перефразированный вопрос о прошлой заметке | Найден нужный источник, или агент говорит, что не нашёл достаточных данных |
| Удаление сохранённого факта пользователя | Точный поиск, векторный индекс, пересказы и кэши больше его не возвращают |
| Запрос от имени другого пользователя | Ни одна запись и ни один документ первого пользователя не попадают в контекст второго |
| Ложная инструкция в заметке | Права доступа и правила одобрения приложения по-прежнему действуют |
Сравнивайте с базовым вариантом без памяти. В задачах retrieval базовый вариант с полным контекстом помогает показать, улучшает ли что-нибудь добавленный пайплайн извлечения и поиска в тех же условиях задачи. Измеряйте качество retrieval отдельно от качества ответа: правдоподобный ответ может получиться из неверного или устаревшего факта. Записывайте латентность, рост хранилища и любые затраты на эмбеддинги или модель, а не предполагайте, что более сложная память лучше.
LongMemEval предлагает 500 вопросов на извлечение информации, ризонинг по нескольким сессиям, временной ризонинг, обновления и отказ от ответа. Этот бенчмарк полезен при проектировании тестов recall, но результат на нём не доказывает, что приложение безопасно продолжает работу или соблюдает удаление. Продукту, который обещает учиться на прошлой работе, нужны и последовательные задачи, в которых обратная связь меняет последующее поведение; MemoryArena строит такие взаимозависимые задачи между сессиями для покупок, планирования поездок, поэтапного поиска и формального ризонинга. В обоих случаях держите тест близко к сбою, который продукт должен предотвратить.
EvoMemBench сравнил 15 методов памяти с сильными базовыми вариантами с длинным контекстом по своему протоколу. Длинный контекст остался конкурентоспособным, и ни одна форма памяти не оказалась лучшей во всех условиях. Этот результат не выбирает хранилище для данного агента; это повод сохранить простой базовый вариант и проверять, улучшает ли добавленный путь памяти эту задачу.
Дополнительно: изучите проект-компаньон
Market Analyst Agent показывает пути чекпоинта, профиля и архива отчётов. Для него нужны Python 3.13+, uv, Docker и учётные данные для API модели и поиска. Анализ делает платные вызовы модели. В новом checkout выполните настройку окружения из репозитория, а затем запустите:
git clone https://github.com/slavadubrov/market-analyst-agent
cd market-analyst-agent
git checkout 6794a0d
make setup
make install
cp .env.example .env
# Configure a model API key in .env before continuing.
make db-up
uv run market-analyst --set-profile --risk-tolerance conservative --horizon long
uv run market-analyst "Analyze NVDA stock"
# Use the thread ID printed by the run after it stops for approval.
uv run market-analyst --approve --thread-id <thread-id>
ID пользователя в командной строке ограничивает область данных, но не является механизмом аутентификации; добавьте проверенную идентичность и проверки владения, прежде чем открывать этот путь как многопользовательский сервис.
Используйте самое маленькое хранилище, которое проходит эти тесты. Для проекта-компаньона это надёжный чекпоинт, точная запись профиля и архив отчётов. Семантическое извлечение и просматриваемый блокнот проекта — полезные следующие шаги только тогда, когда реальный запрос и эвал показывают, что они дают. Часть 3 переходит к действиям, которые агент может выполнять с этим контекстом; часть 4 рассматривает границу доверия вокруг этих действий.
Источники
Статьи
- Cognitive Architectures for Language Agents (CoALA) — Sumers, Yao et al., 2023 — таксономия видов памяти агента
- Memory in the Age of AI Agents — 2025 — обзор, упорядоченный по форме, функции и динамике памяти
- MemGPT: Towards LLMs as Operating Systems — Packer et al., 2023 — управление виртуальным контекстом
- Generative Agents: Interactive Simulacra of Human Behavior — Park et al., 2023 — оценка по свежести, важности и релевантности
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory — Rasmussen, 2025 — темпоральный граф знаний
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory — 2025 — пайплайн извлечения и консолидации
- Voyager: An Open-Ended Embodied Agent with Large Language Models — Wang et al., 2023 — библиотека исполняемых навыков
- Agent Workflow Memory — Wang et al., 2024 — переиспользуемые воркфлоу для веб-агентов
- LongMemEval — 2024 — бенчмарк долгосрочной памяти
- EvoMemBench — 2026 — сравнение методов памяти с базовыми вариантами на длинном контексте
LangGraph и бэкенды чекпоинтов
- Персистентность LangGraph, checkpointer и store
langgraph-checkpoint-postgres— PostgreSQL saverlanggraph-checkpoint-redis— Redis saver и storelanggraph-checkpoint-sqlite— SQLite saver для локальной работыlanggraph-checkpoint-aws— DynamoDB saver с выносом данных в S3
Vector search, графы и фреймворки памяти
- pgvector — vector search в PostgreSQL
- Qdrant и его MCP-сервер
- Graphiti — движок темпоральных графов знаний от Zep
- Mem0, Letta и LangMem
Файловая память
Демо-проект
- Market Analyst Agent — пути хранения чекпоинтов, профилей и документов