Циклы ризонинга ИИ-агентов: ReAct, ReWOO, Plan-and-Execute

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Цикл ризонинга агента — это поток управления, который определяет, когда модель выбирает действие, получает результат инструмента и выбирает снова — или останавливается. Статья написана для инженеров, которые решают, как агенту обрабатывать задачу, если следующий шаг может зависеть от того, что найдут его инструменты. Вы узнаете, когда использовать ReAct, ReWOO или Plan-and-Execute и как эти решения выглядят в реализации на LangGraph.
У запроса текущей цены акции известные шаги поиска. Выяснение, почему изменился прогноз по ней, может потребовать, чтобы следующий поиск зависел от первого результата. В этих двух задачах модели нужна разная свобода, и вторая обычно требует больше вызовов модели.
Это Часть 1 серии Engineering the Agentic Stack. Цикл — её самый внутренний слой; следующие части посвящены памяти, инструментам, безопасности, рантайму и проверкам перед тем, как задача считается выполненной. Сквозной пример — Market Analyst Agent, построенный на LangGraph.
Краткое сравнение фреймворков, реализующих эти циклы, есть в статье Best AI Agent Frameworks in 2026.
Какие решения должна принимать модель
Перечислите решения, которые остаются после того, как запрос и его инструменты определены. Для запроса цены приложение может вызвать инструмент котировок и передать результат модели для пояснения. Если пользователь просит сводку по цене, финансовым показателям и свежим новостям, планировщик может заранее назвать эти независимые вызовы. Если новость о пересмотре отчётности требует нового запроса, фиксированного списка уже недостаточно: модель должна увидеть результат, прежде чем выбрать этот запрос.
Цикл определяют три вопроса:
- Может ли код назвать вызовы прямо сейчас? Если может, используйте фиксированный workflow. Модель по-прежнему может суммировать результаты, но ей не нужно решать, в каком порядке выполнять поиск.
- Если вызовы должна выбирать модель, может ли она назвать их все до того, как увидит результаты? ReWOO может выполнить такой план, не возвращаясь к модели между вызовами. Его воркер может запускать независимые вызовы одновременно.
- Может ли результат изменить следующий вызов или более позднюю цель? ReAct даёт модели новое решение после каждого наблюдения. Plan-and-Execute добавляет вокруг таких локальных циклов заранее составленный список целей; чтобы изменить последующие цели, нужен отдельный шаг перепланирования.
Выбор определяет и то, где проявится сбой. Неверный план ReWOO может пройти через несколько вызовов, прежде чем солвер заметит проблему. Цикл ReAct может восстановиться после неожиданного результата, но может и выполнять ненужные действия или повторять работу. Заранее составленный план упрощает отслеживание длинной задачи, но локальный экзекьютор не может незаметно исправить неверный общий план. Каждому паттерну по-прежнему нужны правило остановки, права на инструменты и способ сообщать о неудачных вызовах; сам цикл ни одной из этих гарантий не даёт.
Что каждый паттерн делает с результатом
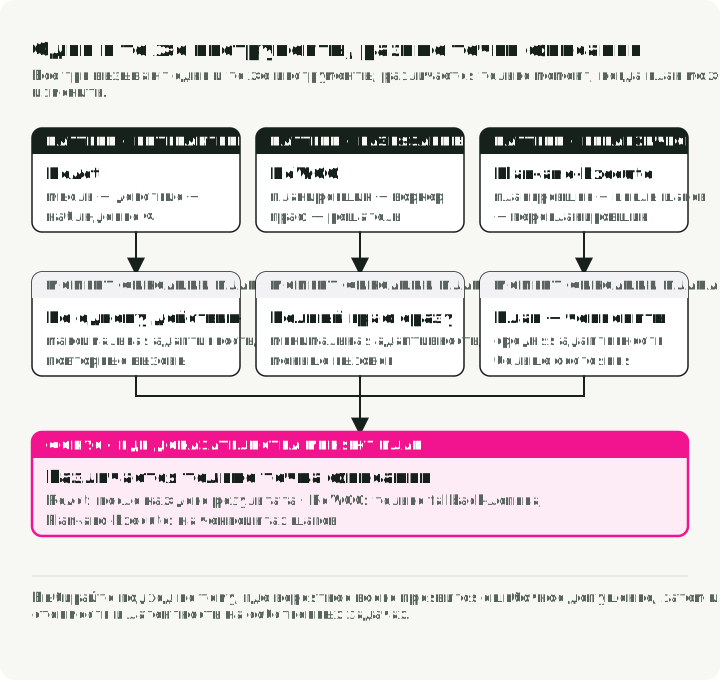
Все три паттерна вызывают одни и те же инструменты. Они различаются тем, когда результат инструмента может изменить план: после каждого вызова, только после выполнения или внутри каждого запланированного шага.
ReAct: решение после каждого наблюдения
ReAct (Yao et al., 2022), сокращение от Reason + Act, повторяет одно решение: модель выбирает tool call, приложение его выполняет, а результат возвращается модели. Если нужно выяснить, почему падает маржа компании, финансовый отчёт может указать на рост затрат; тогда следующий вызов может искать данные об этих затратах. Модели не нужно выбирать этот второй вызов до того, как она увидит отчёт.
В оригинальной статье это записано как Thought → Action → Observation. Нативные APIs инструментов возвращают предложенный вызов и результат инструмента, но не обязаны раскрывать внутренний ризонинг модели. Размышление между tool calls — отдельная возможность модели и API.
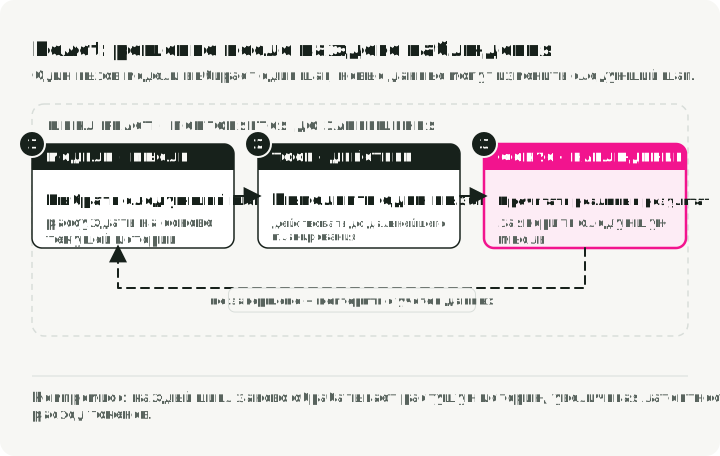
Эта обратная связь и есть преимущество ReAct: неожиданное наблюдение может изменить следующее действие. История tool calls также показывает, какие данные получила система. В ручной выборке HotpotQA с PaLM-540B из статьи наблюдения из Википедии дали меньше галлюцинированных фактов, чем промптинг chain-of-thought. Этот вывод относится к той задаче и той модели, а не к точности любого цикла с инструментами.
Цена — повторяющиеся решения. Реализация с полной историей на каждом шаге отправляет всё более длинный диалог. Кэширование промптов может сократить повторную обработку входа и плату за неё, но не убирает старые наблюдения из контекстного окна. Суммаризация или обрезка информацию как раз убирают. Ограничьте число шагов и время выполнения и проверьте, восстанавливается ли агент после плохого результата или просто продолжает искать.
Используйте ReAct для исследовательского поиска, отладки и задач, в которых нельзя предсказать следующее действие.
ReWOO: сначала скомпилировать граф инструментов
ReWOO (Reasoning WithOut Observation) отделяет вызов модели для планирования от её итогового ответа. Планировщик называет все tool calls до того, как придёт хоть один результат. Он может сослаться на будущий результат как на #E1, а затем подставить #E1 в аргументы более позднего вызова. Воркер без LLM подставляет значения вместо этих плейсхолдеров и выполняет вызовы; модель-солвер получает собранные результаты и пишет ответ.
Для рыночного снапшота планировщик может запросить цену, финансовые показатели и свежие новости одновременно. Воркер в этой статье параллельно запускает вызовы, зависимости которых уже готовы. Такой батчинг — решение реализации; определяющая черта в статье — воркер следует плану, не спрашивая модель, что делать дальше.
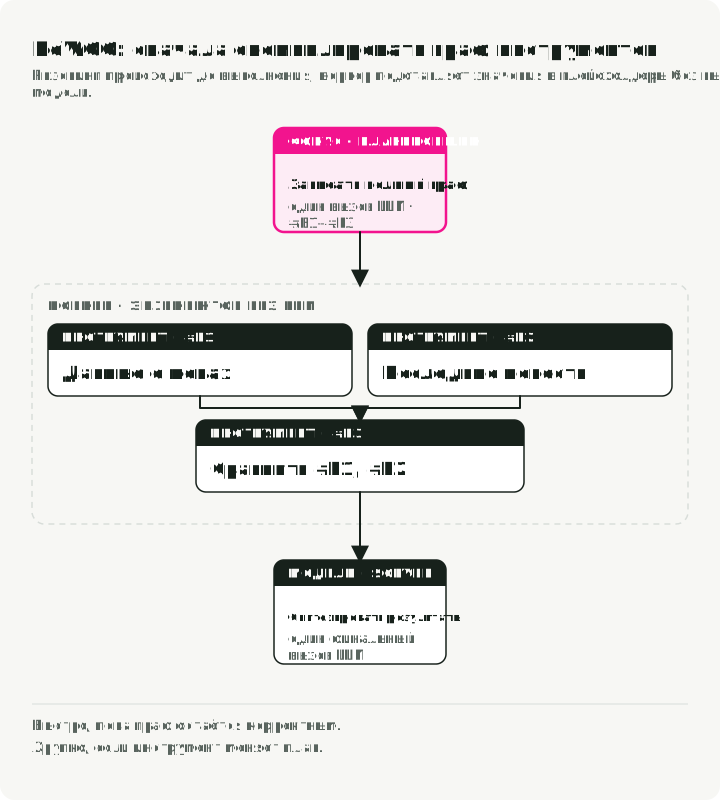
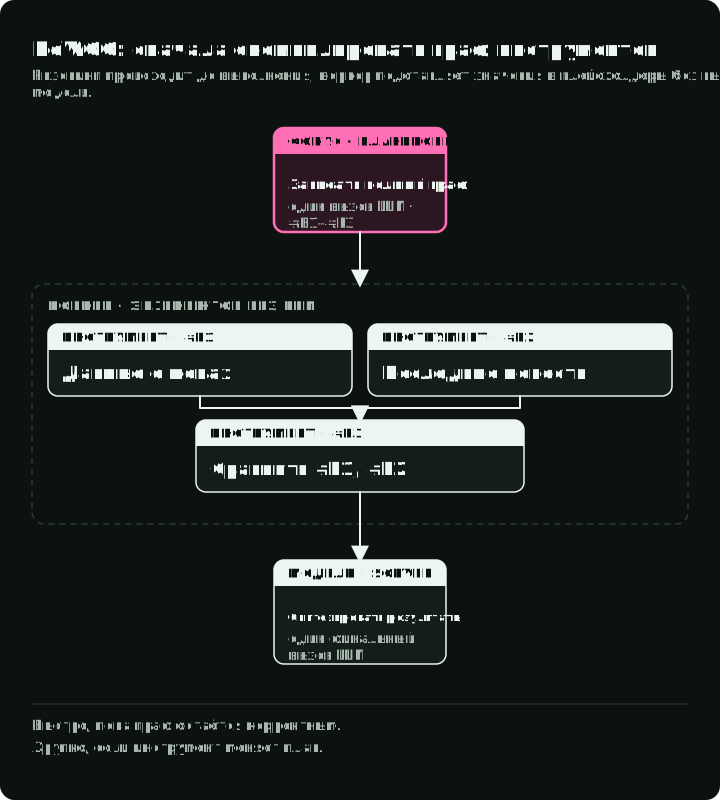
Во время выполнения вызовов модели меньше, если исходный план остаётся пригодным. В стресс-тесте статьи на HotpotQA каждый результат инструмента заменялся на No evidence found; ReWOO потерял в этом тесте меньше точности, чем ReAct. Недостающие данные он при этом не восстановил. Воркер должен решить, передаётся ли ошибка солверу, повторяется ли вызов или выполнение останавливается. Неверную зависимость или отсутствующий инструмент солвер уже не исправит, если вызовы выполнены.
Поскольку планировщик никогда не читает результаты инструментов, для него можно отдельно проводить файн-тюнинг или тестирование без живого окружения инструментов. Используйте ReWOO для быстрых снапшотов, проверок статуса и дашбордов с предсказуемым поведением инструментов.
Plan-and-Execute: разбить задачу, затем реагировать локально
Plan-and-Solve prompting сначала составляет план, а затем решает его подзадачи. Родственный паттерн оркестрации инструментов, Plan-and-Execute, позволяет планировщику перечислить высокоуровневые цели, а экзекьютору — обрабатывать их по одной. Market Analyst Agent запрашивает шаги исследования, например проверку финансового состояния и анализ рисков. Внутри каждого шага цикл ReAct может выбирать инструменты, увидев результаты. Выход планировщика — список целей, в отличие от предложенных tool calls в ReWOO.
Статья Plan-and-Solve исследовала zero-shot промптинг, а не такой граф с инструментами. Выбрать разные модели для планирования и выполнения в реализации можно; это не результат, доказанный той статьёй.
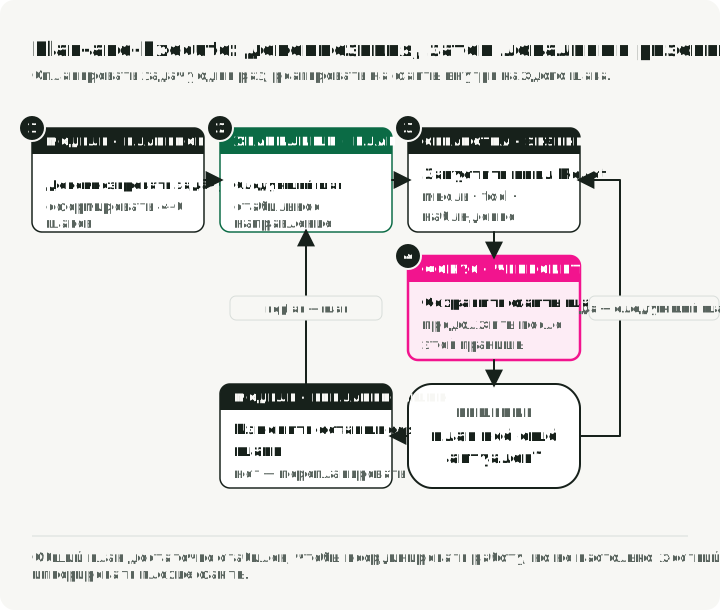
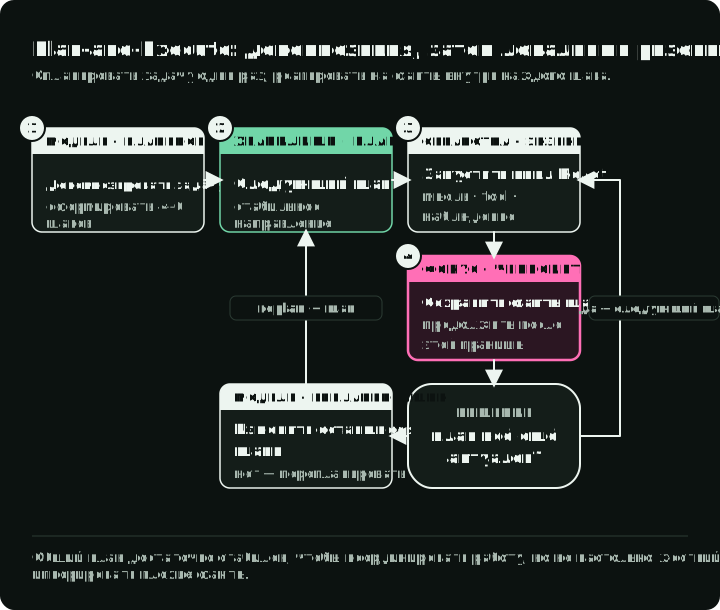
На рисунке есть опциональный репланировщик. В учебном графе ниже ветки перепланирования нет: результаты могут менять работу внутри шага, но список последующих шагов остаётся фиксированным. Добавляйте перепланирование, только когда результат шага должен изменить этот список.
В реализации планировщик может работать на более сильной модели, а экзекьютор — на более дешёвой, и с чекпоинтером каждый завершённый шаг становится точкой, с которой можно продолжить выполнение. Паттерну также нужно больше вызовов модели и больше состояния, чем одиночному запросу, поэтому используйте его, только когда явный план помогает системе выполнить большую задачу, например исследовательский отчёт, который заканчивается синтезом.
Выберите цикл под задачу, затем протестируйте его сбой
| Признак задачи | Начальный поток управления | Пример | Что тестировать |
|---|---|---|---|
| Шаги поиска уже известны | Фиксированный workflow | Текущая цена одного тикера | Нужно ли интерпретировать результат, или код может вернуть его напрямую? |
| Модель может назвать каждый вызов и каждую зависимость до выполнения | ReWOO | Цена, финансовые показатели и новости по одному тикеру; погода в пяти городах | Что происходит, если запланированный вызов падает или план называет недопустимую зависимость? |
| Следующий вызов зависит от последнего результата | ReAct | Выяснить, почему упала маржа компании | Может ли он восстановиться после вводящего в заблуждение результата и остановиться в пределах бюджета? |
| У длинной задачи есть названные цели, и каждой нужны локальные решения | Plan-and-Execute | Инвестиционный тезис с рисками и конкурентами | Может ли экзекьютор завершить шаг, и что происходит, когда результат делает последующие цели неактуальными? |
Это стартовое правило, а не рейтинг производительности. В частности, учебный граф Plan-and-Execute не умеет пересматривать последующие цели. Воркер ReWOO параллельно запускает вызовы с готовыми зависимостями, но не может создать новый вызов, увидев результат. Сравните маршруты на одних и тех же задачах, при одинаковом поведении инструментов и бюджете, прежде чем выбирать по числу вызовов модели.
Паттерны описывают решения за пределами модели. Модели, которая рассуждает между tool calls, всё равно нужна программа, которая выполняет эти вызовы, останавливает цикл и авторизует действия. Сравнивая циклы, считайте не только вызовы, но и оплачиваемые токены ризонинга; модель может рассуждать, не показывая этот текст.
Для новой реализации на LangChain create_agent предоставляет цикл инструментов, управляемый наблюдениями. Сопровождающий граф ниже использует более старый API create_react_agent из LangGraph, поэтому его фрагменты объясняют поток управления, а не служат руководством по настройке нового проекта.
Если задаче нужны изолированные контексты субагентов, файловая система и автоматическое управление контекстом, Deep Agents собирает их вокруг того же цикла инструментов. Это выбор харнесса, а не четвёртый паттерн ризонинга. Сравните одного агента с делегированием на задачах, которые делятся на независимые части, и учтите в результате затраты на координацию и потерянный контекст.
Сквозной пример: Market Analyst Agent
Market Analyst Agent направляет запрос на flash briefing через ReWOO: спланировать вызовы рыночных данных, выполнить их, затем синтезировать результаты. Запрос на более глубокое исследование идёт через Plan-and-Execute, с циклом ReAct внутри каждого запланированного шага. ReAct в этом маршруте — примитив выполнения, а не третий маршрут для пользователя. Маршруты различаются тем, что планировщик передаёт экзекьютору: точные предложенные tool calls в ReWOO или цели, для которых ещё нужно выбрать инструменты, в Plan-and-Execute.
Фрагменты — сокращённые учебные варианты коммита b4e769a, а не самостоятельные скрипты.
Для оркестрации используется LangGraph. Узел — это функция Python, которая возвращает поля для обновления в общем состоянии; ребро выбирает следующий узел. Оба маршрута используют одну схему состояния, а их прогресс хранится в разных полях:
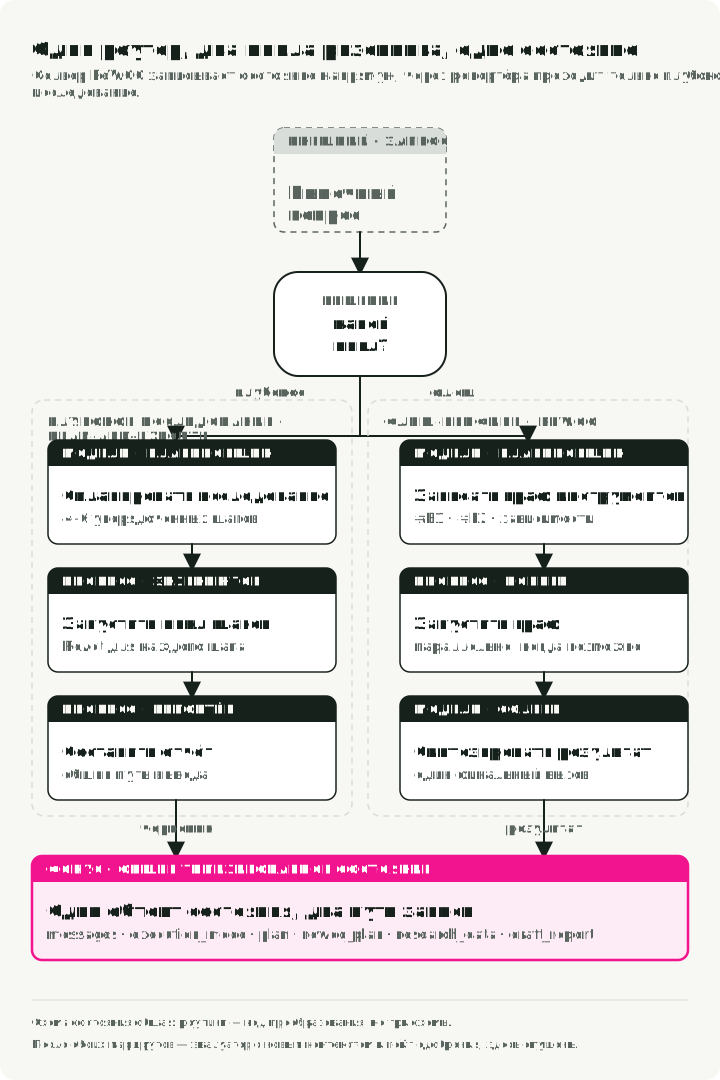
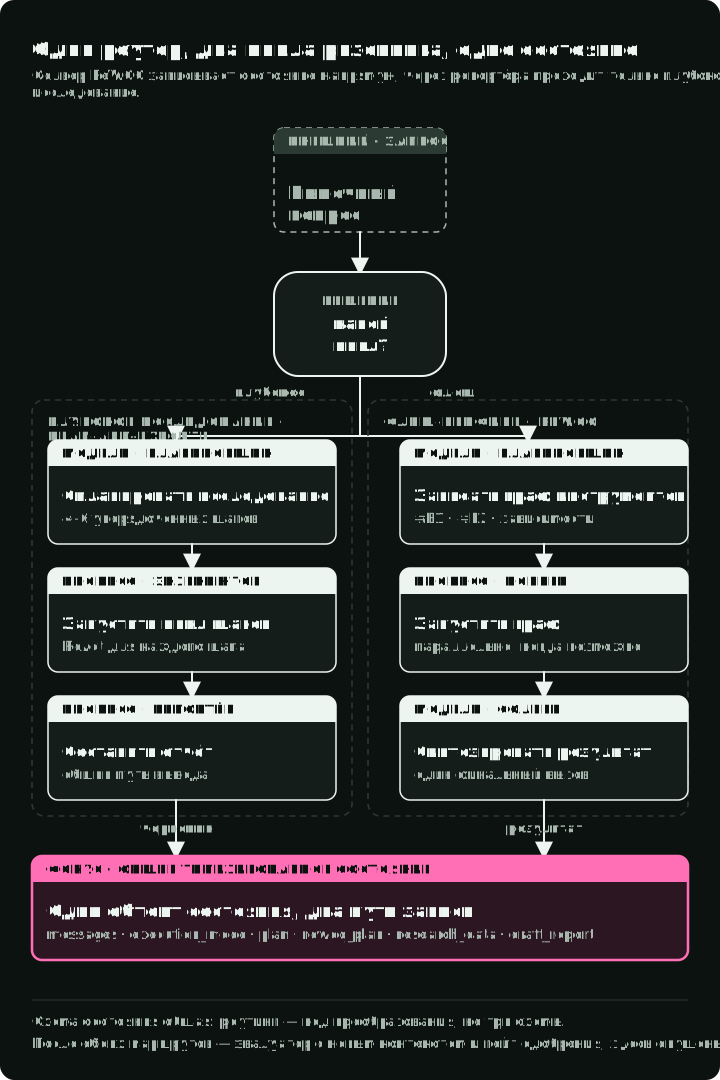
Диаграмма показывает только роутинг и создание черновика. На ней нет общего эвалуатора и одобрения человеком перед публикацией, которые есть в описании графа ниже.
Определение состояния
Схема состояния хранит прогресс конкретного маршрута в plan или rewoo_plan и помещает итоговый черновик любого маршрута в draft_report. Поля памяти и одобрения присутствуют потому, что оба маршрута используют одно состояние приложения; они не определяют, какой цикл запускается.
from typing import Literal

class PlanStep(BaseModel):
    """A single step in the research plan."""
    step_number: int
    description: str
    tool_hint: str | None = None
    completed: bool = False
    result: str | None = None

class UserProfile(BaseModel):
    """Structured user context loaded from long-term memory."""
    risk_tolerance: str | None = None
    investment_horizon: str | None = None

class AgentState(BaseModel):
    """Main state for the Market Analyst Agent graph."""

    # Identity and profile context for memory-backed personalization
    user_id: str
    user_profile: UserProfile = Field(default_factory=UserProfile)

    # Message history with LangGraph's add_messages reducer
    messages: Annotated[list, add_messages] = Field(default_factory=list)

    # Execution mode (set by router)
    execution_mode: ExecutionMode | None = None

    # Plan-and-Execute state
    plan: list[PlanStep] = Field(default_factory=list)
    current_step_index: int = 0

    # ReWOO state
    rewoo_plan: list[ReWOOPlanStep] = Field(default_factory=list)

    # Research results
    research_data: ResearchData | None = None

    # Final report. Both paths write this field, then the graph pauses before
    # publishing (see interrupt_before below), so a human signs off on a draft
    # a fresh-context evaluator has already voted on.
    draft_report: DraftReport | None = None
    report_approved: bool = False
    evaluator_verdict: Literal["pass", "fail", "needs_human"] | None = None
    evaluator_reasons: list[str] = Field(default_factory=list)
Паттерн 1: реализация Plan-and-Execute
Plan-and-Execute подходит для многошагового синтеза. Планировщик записывает высокоуровневые шаги, затем цикл ReAct выполняет каждый шаг и реагирует на результаты инструментов.
Сопровождающие фрагменты сохраняют claude-sonnet-4-5-20250929 и старый API create_react_agent, чтобы оставаться сопоставимыми со связанным коммитом. Для нового кода используйте актуальный интерфейс create_agent. Миграция этого графа также требует тестирования схем планировщика, внутренних сообщений, роутинга и поведения при возобновлении; одна замена имени модели такой миграцией не является.
Планировщик делает один вызов модели и возвращает описания шагов. Он не вызывает ни одного инструмента рыночных данных. structured output проверяет форму ответа; отдельная проверка на непустой и пригодный план всё равно нужна.
# System prompt guides the LLM to think like a research analyst
# creating a strategic plan, not immediate tool calls
PLANNER_SYSTEM_PROMPT = """You are a senior investment research analyst.
Break down stock analysis requests into 4-6 research steps covering:
1. Current price and basic metrics
2. Recent news and announcements
3. Competitor analysis (if relevant)
4. Financial health assessment
5. Risk factors
6. Investment thesis synthesis

Output as JSON with step_number, description, and tool_hint."""

# Schema-Guided Reasoning: Enforce structure with Pydantic
class PlanOutput(BaseModel):
    """Structured output for the planner."""

    steps: list[PlanStep] = Field(description="Research steps to execute")
    ticker: str = Field(description="The stock ticker being analyzed")

def planner_node(state: AgentState) -> dict:
    """Generate a research plan from the user's request.

    This is Phase 1 of Plan-and-Execute: creating the high-level strategy.
    """

    # Use a powerful model for strategic planning
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Ask for a typed plan and validate it before execution.
    # The API can still fail, so production code also handles that exception.
    structured_llm = llm.with_structured_output(PlanOutput)

    # Pull the request out of the message history
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    last_user_message = human[-1].content if human else "Analyze the market"

    # Context from long-term memory personalizes the plan
    profile_context = f"""
User Profile:
- Risk Tolerance: {state.user_profile.risk_tolerance}
- Investment Horizon: {state.user_profile.investment_horizon}
"""

    # Single LLM call creates the complete plan
    result: PlanOutput = structured_llm.invoke([
        SystemMessage(content=PLANNER_SYSTEM_PROMPT + profile_context),
        HumanMessage(content=f"Create a research plan for: {last_user_message}"),
    ])

    # State update: Store the plan and initialize tracking
    return {
        "plan": result.steps,           # The sequential steps to execute
        "current_step_index": 0,        # Start at step 0
        "research_data": ResearchData(ticker=result.ticker),  # Initialize data container
    }
Строка llm.with_structured_output(PlanOutput) — это Schema-Guided Reasoning (SGR), о котором шла речь в одном из прошлых постов. Схема проверяет типы полей, но не то, пригодны ли шаги. Перед выполнением требуйте непустой ограниченный список с уникальными номерами шагов и понятными описаниями.
Паттерн 2: выполнение через ReAct
Когда план готов, executor_node передаёт внутреннему циклу ReAct одну цель и сводку предыдущих результатов. Внутренний цикл может выбрать другой инструмент, увидев наблюдение. Когда он заканчивает, внешний граф записывает итоговый результат шага и переходит дальше; внутренний транскрипт он в plan не сохраняет.
# Market-data tools available to the inner loop in this excerpt. The repo's
# TOOLS list also has a skill loader, two CLI wrappers, and a restricted Python
# evaluator; Part 3 compares those interfaces, and MCP runs as a sidecar.
TOOLS = [
    get_stock_snapshot,
    get_price_history,
    search_news,
    search_competitors,
    get_financials,
]

def executor_node(state: AgentState) -> dict:
    """Execute the current step using a ReAct agent.

    This is Phase 2 of Plan-and-Execute: adaptive execution of each planned step.
    Each step runs as a mini ReAct loop until completion.
    """

    # Guard against an empty or exhausted plan before indexing it
    if state.current_step_index >= len(state.plan):
        raise ValueError("No plan step to execute; check the planner output")

    # Get the current step from the plan
    current_step = state.plan[state.current_step_index]

    # Build context from what we've learned so far
    # Each step sees a digest of earlier results
    previous_context = ""
    for step in state.plan[:state.current_step_index]:
        if step.result:
            previous_context += f"\nStep {step.step_number}: {step.result}\n"

    # Create a ReAct agent for this step. The companion pins the older
    # create_react_agent API; new code uses create_agent.
    react_agent = create_react_agent(
        model=ChatAnthropic(model="claude-sonnet-4-5-20250929"),
        tools=TOOLS,
    )

    # Invoke the ReAct loop for this single step
    # The agent will loop internally until it completes the step
    result = react_agent.invoke({
        "messages": [
            SystemMessage(content=EXECUTOR_SYSTEM_PROMPT),
            HumanMessage(content=f"""Execute Step {current_step.step_number}:
{current_step.description}

Ticker: {state.research_data.ticker}
Previous findings: {previous_context}"""),
        ]
    })

    # Extract the final answer from the ReAct agent's message history
    # The last message contains the synthesis after all tool calls
    updated_plan = list(state.plan)
    updated_plan[state.current_step_index] = PlanStep(
        step_number=current_step.step_number,
        description=current_step.description,
        completed=True,
        result=str(result["messages"][-1].text),  # Final synthesized answer
    )

    # State update: Mark step complete and advance to next
    return {
        "plan": updated_plan,
        "current_step_index": state.current_step_index + 1,
    }
Паттерн 3: ReWOO для быстрых снапшотов
Для короткой сводки планировщик возвращает предложенные tool calls вместо целей исследования. Воркер выполняет вызовы с готовыми зависимостями без модели; солвер делает один вызов модели по их результатам. Эти фрагменты показывают каждую передачу.
Фаза 1: планировщик ReWOO (заранее записывает типизированный план предложенных вызовов)
class ReWOOPlanStep(BaseModel):
    """A step in the ReWOO plan with variable placeholders.

    Key difference from Plan-and-Execute's PlanStep:
    - Contains actual tool_name and tool_args (not just description)
    - Uses variable references (#E1) for dependencies
    """
    step_id: str  # e.g., "#E1" - becomes a variable
    description: str
    tool_name: str     # Requested tool name; validate it against a registry in production
    tool_args: dict    # Proposed arguments; may contain refs like {"price": "#E1"}
    depends_on: list[str] = []  # Declared ordering; cross-check it against #E placeholders
    result: str | None = None

class ReWOOPlanOutput(BaseModel):
    """Structured output for ReWOO planner."""
    steps: list[ReWOOPlanStep] = Field(description="Planned tool calls with variables")

def rewoo_planner_node(state: AgentState) -> dict:
    """Generate a complete plan of tool calls upfront.

    This is the key difference from Plan-and-Execute: instead of creating
    human-readable step descriptions, it creates typed proposed tool calls.
    Production code validates them before execution; this teaching worker does not.
    """

    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Schema-Guided Reasoning validates the planner response shape.
    # It does not validate a tool name, its arguments, or its dependencies.
    structured_llm = llm.with_structured_output(ReWOOPlanOutput)

    ticker = state.research_data.ticker if state.research_data else "UNKNOWN"
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    query = human[-1].content if human else f"Analyze {ticker}"

    # Single LLM call to plan ALL tool executions
    result: ReWOOPlanOutput = structured_llm.invoke([
        SystemMessage(content=REWOO_PLANNER_PROMPT),
        HumanMessage(content=f"""Create a ReWOO plan for: {query}

Ticker: {ticker}

Output tool calls with:
- step_id: Variable name (#E1, #E2, etc.)
- description: What this accomplishes
- tool_name: Exact tool from the list
- tool_args: Dictionary of arguments
- depends_on: List of step_ids this depends on"""),
    ])

    # Store the typed proposed-call plan.
    # This teaching worker sends ready steps directly to execute_tool.
    return {"rewoo_plan": result.steps}
Фаза 2: воркер ReWOO (выполняет инструменты без ризонинга LLM)
def rewoo_worker_node(state: AgentState) -> dict:
    """Execute dependency-ready tools in parallel batches (no LLM calls).

    Independent tools share a batch. Dependent tools wait until their
    prerequisites complete. The worker follows the dependency graph and
    does not add LLM calls.
    """

    results = {}        # Results keyed by step_id (e.g., "#E1": "$150.23")
    updated_steps = []  # Plan steps with their result field filled in
    pending = {step.step_id: step for step in state.rewoo_plan}

    # Keep scheduling dependency-ready batches until the graph is complete.
    # This handles chains even when the planner does not list them topologically.
    with ThreadPoolExecutor(max_workers=5) as executor:
        while pending:
            ready = [
                step for step in pending.values()
                if all(dep in results for dep in step.depends_on)
            ]
            if not ready:
                unresolved = ", ".join(pending)
                raise ValueError(f"Unresolvable ReWOO dependencies: {unresolved}")

            futures = {
                executor.submit(execute_tool, step, results): step
                for step in ready
            }
            for future in as_completed(futures):
                step = futures[future]
                results[step.step_id] = future.result()
                updated_steps.append(step.model_copy(update={"result": results[step.step_id]}))
                del pending[step.step_id]

    # State update: restore the planner's order (sorting on step_id would put
    # "#E10" before "#E2") and hand the filled-in plan to the Solver
    plan_order = {s.step_id: i for i, s in enumerate(state.rewoo_plan)}
    return {"rewoo_plan": sorted(updated_steps, key=lambda s: plan_order[s.step_id])}
Фаза 3: солвер ReWOO (синтезирует все результаты одним вызовом LLM)
def rewoo_solver_node(state: AgentState) -> dict:
    """Synthesize all tool results into a flash briefing.

    This is the second efficiency gain: Instead of interleaving
    LLM calls with tool execution (like ReAct), we make ONE
    final synthesis call with all gathered data.
    """

    # Build context from ALL tool results at once
    tool_results = []
    for step in state.rewoo_plan:
        if step.result:
            tool_results.append(f"### {step.description}\n{step.result}")

    context = "\n\n".join(tool_results)

    # Single LLM call to synthesize everything
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
    structured_llm = llm.with_structured_output(FlashBriefingOutput)
    result = structured_llm.invoke([
        SystemMessage(content=REWOO_SOLVER_PROMPT),
        HumanMessage(content=f"Create a flash briefing from this data:\n\n{context}"),
    ])

    # FlashBriefingOutput and DraftReport carry the same fields; the state
    # schema expects DraftReport, so convert before returning.
    return {"draft_report": DraftReport(**result.model_dump())}
Планировщик записывает предложенные вызовы, воркер заполняет их плейсхолдеры, а солвер получает результаты. Схема проверяет их форму, а не то, выполним ли план. Словарь pending выше молча отбрасывает дублирующиеся ID. Если #E2 использует #E1 в аргументах, но не указывает #E1 в depends_on, оба вызова могут попасть в один батч раньше, чем появится первый результат.
Перед отправкой отклоняйте пустые или слишком большие планы, дублирующиеся ID, отсутствующие зависимости и циклы. Проверяйте имена инструментов и аргументы по реестру. Проверяйте плейсхолдеры и во вложенных значениях и требуйте, чтобы они совпадали с depends_on. Этот учебный воркер пропускает такие проверки. Он отправляет готовые вызовы в execute_tool из сопровождающего кода, где перехваченные исключения превращаются в строки с ошибкой. Солвер должен считать такую строку отсутствием данных, а не успешным результатом поиска. Граф, который невозможно разрешить, останавливается до солвера. Для восстановления нужны результат с ошибкой, условное ребро перепланирования и лимит попыток.
На что обязуется планировщик
| Маршрут в этом графе | До первого вызова рыночных данных | После результата инструмента | Вызовы модели в этой реализации | Узлы |
|---|---|---|---|---|
| Deep research: Plan-and-Execute с шагами ReAct | Планировщик пишет описания целей | Внутренний цикл ReAct может выбрать другой вызов в рамках текущей цели; последующие цели остаются фиксированными | Один план, цикл модель/инструмент на каждый шаг, один отчёт | planner_node → executor_node на каждый шаг → reporter_node |
| Flash briefing: ReWOO | Планировщик пишет имена инструментов, аргументы и зависимости | Воркер следует плану; солвер видит результаты после выполнения | Один план, ни одного вызова модели в воркере, один синтез | rewoo_planner_node → rewoo_worker_node → rewoo_solver_node |
PlanStep с текстом «Investigate recent earnings» оставляет выбор инструмента внутреннему агенту. ReWOOPlanStep, который называет search_news и передаёт запрос, обязуется выполнить этот вызов ещё до получения какого-либо результата. Именно эта разница, а не название паттерна, определяет, какие неожиданные наблюдения могут изменить выполнение. Рядом друг с другом два выхода планировщика выглядят так:
# Plan-and-Execute: goals; the inner ReAct loop picks the tools.
plan = [
    PlanStep(step_number=1, description="Get current price and key metrics",
             tool_hint="get_stock_snapshot"),
    PlanStep(step_number=2, description="Search for recent news and earnings",
             tool_hint="search_news"),
]

# ReWOO: exact calls, fixed before any result arrives.
rewoo_plan = [
    ReWOOPlanStep(step_id="#E1", description="Read the price and valuation snapshot",
                  tool_name="get_stock_snapshot", tool_args={"ticker": "NVDA"}),
    ReWOOPlanStep(step_id="#E2", description="Find recent NVDA earnings news",
                  tool_name="search_news",
                  tool_args={"query": "NVDA earnings", "max_results": 5}),
]
tool_hint — подсказка, которую экзекьютор может проигнорировать. tool_name с tool_args — это вызов, который выполнит воркер.
Самостоятельный цикл ReAct может переносить каждое предыдущее сообщение в каждый новый вызов модели. Этот граф запускает каждый внутренний цикл с текущим шагом и сводкой завершённых шагов. Внешнее состояние хранит результаты шагов, а не внутренний транскрипт tool calls. ReWOO, наоборот, заполняет запланированные шаги результатами и передаёт готовый список своему солверу. Это решения по управлению контекстом в сопровождающем коде, а не требования оригинальных статей.
Как связать оба маршрута в один граф
У графа два маршрута для пользователя поверх одного AgentState: deep research использует Plan-and-Execute с циклом ReAct внутри каждого шага, а flash briefing — ReWOO.
В этой реализации нет репланировщика: она выполняет исходный план до конца. Чтобы добавить перепланирование, нужно ребро от executor обратно к planner и правило, определяющее, когда неожиданный результат оправдывает ещё один вызов модели.
LangGraph описывает связи декларативно:
def create_graph(checkpointer=None):
    builder = StateGraph(AgentState)

    # Add nodes
    builder.add_node("router", router_node)
    builder.add_node("planner", planner_node)
    builder.add_node("executor", executor_node)
    builder.add_node("reporter", reporter_node)
    builder.add_node("rewoo_planner", rewoo_planner_node)
    builder.add_node("rewoo_worker", rewoo_worker_node)
    builder.add_node("rewoo_solver", rewoo_solver_node)
    builder.add_node("evaluator", evaluator_node)
    builder.add_node("publish", publish_node)

    # Define edges
    builder.add_edge(START, "router")
    builder.add_conditional_edges("router", route_after_router, {
        "planner": "planner",
        "rewoo_planner": "rewoo_planner",
    })

    # Deep Research path
    builder.add_edge("planner", "executor")
    builder.add_conditional_edges("executor", route_after_executor, {
        "executor": "executor",  # Loop back for more steps
        "reporter": "reporter",  # Done with plan
    })
    builder.add_edge("reporter", "evaluator")

    # Flash Briefing path (ReWOO)
    builder.add_edge("rewoo_planner", "rewoo_worker")
    builder.add_edge("rewoo_worker", "rewoo_solver")
    builder.add_edge("rewoo_solver", "evaluator")

    # Both paths run the same evaluator before the human approval step.
    builder.add_edge("evaluator", "publish")
    builder.add_edge("publish", END)

    return builder.compile(
        checkpointer=checkpointer,
        # Human-in-the-loop pause: the reporter (or ReWOO solver) writes a
        # draft. A separate model session reads that draft and records its
        # assessment. The graph then stops before publishing, whichever
        # assessment it produced, so a human can review both the draft and
        # assessment. Part 6 explains how the program decides a run is complete.
        interrupt_before=["publish"],
    )
Проверьте, помогает ли вызов модели в роутере
Роутер относит быстрые снапшоты, включая «current price», к ReWOO, а сложные запросы вроде инвестиционного тезиса — к Plan-and-Execute. Если классификация неясна, по умолчанию выбирается deep research. Schema-Guided Reasoning ограничивает выход классификатора одним из двух режимов:
class ExecutionMode(str, Enum):
    DEEP_RESEARCH = "deep_research"  # Plan-and-Execute with ReAct steps
    FLASH_BRIEFING = "flash_briefing"  # ReWOO

class RouterOutput(BaseModel):
    mode: ExecutionMode
    ticker: str
    reasoning: str

ROUTER_SYSTEM_PROMPT = """Classify the user's request:

1. deep_research: complex analysis requiring synthesis
   - Examples: "Analyze strategic risks", "investment thesis"
2. flash_briefing: quick snapshots, simple data retrieval
   - Examples: "quick snapshot", "current price"

Default to deep_research if unclear."""

llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
structured_llm = llm.with_structured_output(RouterOutput)
Так это приложение маршрутизирует запросы; это не доказательство, что любой запрос цены требует планировщика. Для запроса только цены прямой вызов инструмента позволил бы обойтись без вызовов роутера, планировщика ReWOO и солвера. Эти вызовы оправданы только для запросов, где модель должна выбрать или объяснить данные.
Роутер может и отправить запрос не в тот цикл. Сравните оба маршрута и фиксированный workflow на одних и тех же задачах, инструментах и бюджете. Фиксируйте выполнение задачи, ошибочные принятия результата, кэшированные и некэшированные токены, реальное время и восстановление после ошибок инструментов или вводящих в заблуждение наблюдений. Повторяйте запуски, если выбор модели стохастичен, и считайте каждую начатую попытку. Меньшее число вызовов полезно, только если маршрут по-прежнему выполняет задачу в рамках своих ограничений. Инженерный обзор Anthropic также рекомендует начинать с простых компонуемых workflow.
Полная сопровождающая реализация, включая роутер и общее состояние, находится в коммите Market Analyst Agent b4e769a.
Попробуйте актуальный API с одним циклом
Граф выше использует более старую фабрику агентов LangGraph. Если сначала хотите посмотреть на актуальный API create_agent, этот небольшой набор тестовых данных обходится без сервисов рыночных данных. Он показывает вызов модели и инструмента и его результат, а не причину использовать агента для известного запроса. В приложении, которое отвечает только на этот вопрос, вызывайте функцию поиска напрямую.
Перед запуском фрагмента задайте ANTHROPIC_API_KEY и установите langchain и langchain-anthropic. Вызов отправляет платный запрос к модели.
from langchain.agents import create_agent
from langchain_anthropic import ChatAnthropic

def lookup_fixture_company(ticker: str) -> str:
    """Look up a company name in a local fixture, not live market data."""
    return {"NVDA": "NVIDIA", "AMD": "AMD"}.get(
        ticker.strip().upper(), "No company in the fixture"
    )

agent = create_agent(
    model=ChatAnthropic(model="claude-sonnet-5", max_tokens=4096),
    tools=[lookup_fixture_company],
    system_prompt="Use the fixture for company names. Do not invent market data.",
)
result = agent.invoke({
    "messages": [{"role": "user", "content": "Which company is NVDA in the fixture?"}]
})
print(result["messages"][-1].text)
Если модель предложит lookup_fixture_company, библиотека вызовет эту функцию Python и вернёт ей результат. Фрагмент не гарантирует, что модель воспользуется инструментом, и не проверяет ни сравнение маршрутов, ни политику обработки сбоев, ни точность на живых данных.
Следующий слой — память
Цикл решает, какой вызов будет следующим; остальной харнесс должен предоставлять контекст, выполнять и авторизовать вызовы, сохранять состояние и проверять завершение. Часть 2, архитектура памяти ИИ-агентов разделяет чекпоинты для возобновления, знания между сессиями и документы проекта. Без долговременных чекпоинтов перезапуск воркера приводит к потере текущего состояния этого графа. Часть 3 разбирает интерфейсы инструментов, Часть 4 — авторизацию, Часть 5 — выполнение и восстановление, а Часть 6 — доказательства завершения задачи.
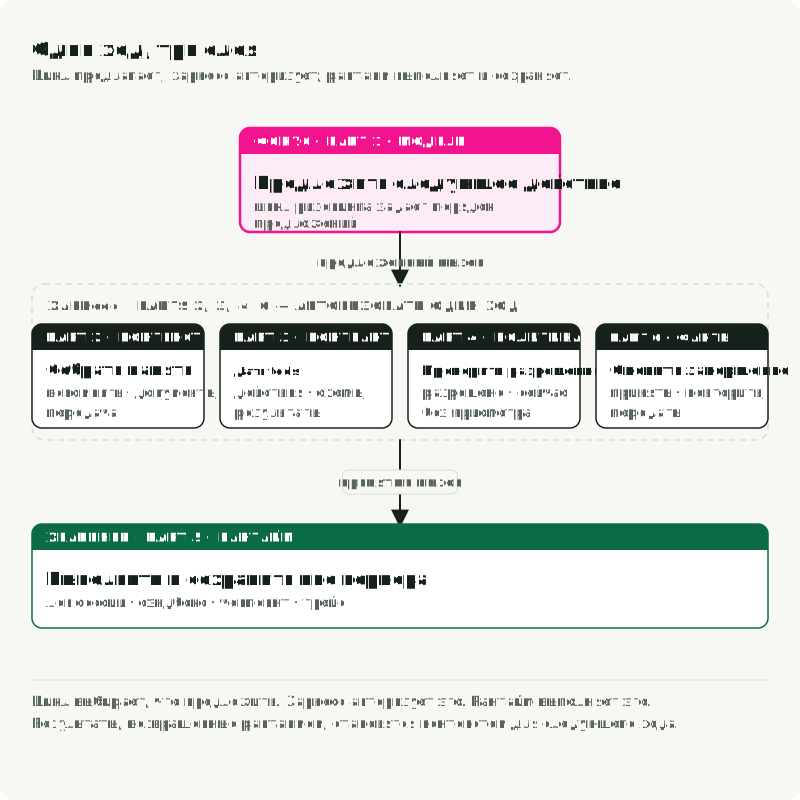
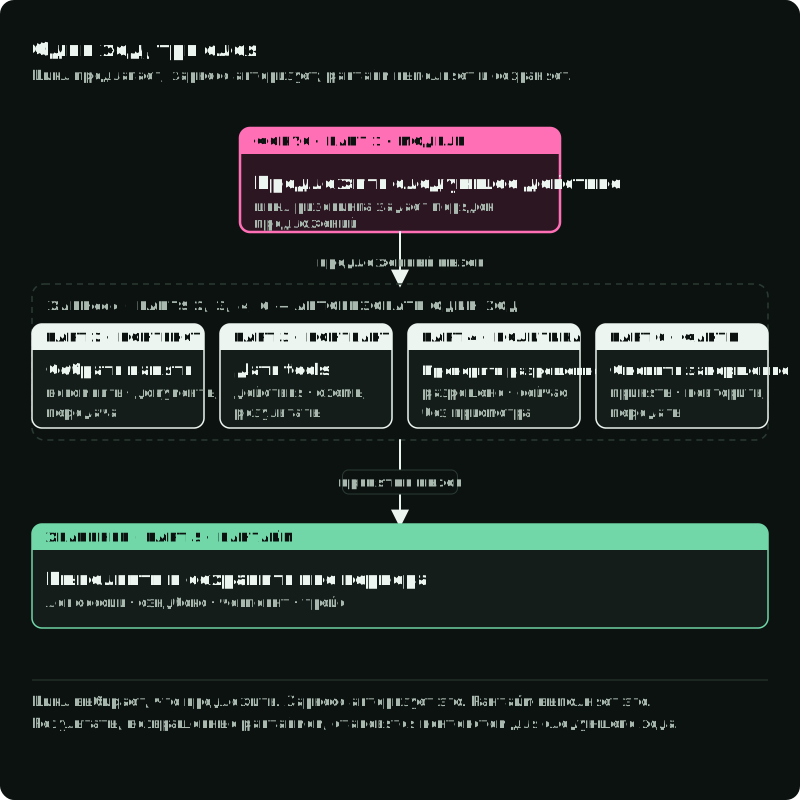
Рисунок помещает каждую часть в ту точку одного хода, где она действует.
Источники
- ReAct: Synergizing Reasoning and Acting in Language Models (Yao et al., 2022)
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models (Xu et al., 2023)
- Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models (Wang et al., 2023)
- Market Analyst Agent Repository