reasoning loops für AI Agents: ReAct, ReWOO, Plan-and-Execute

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Ein Agent reasoning loop ist der Kontrollfluss, der entscheidet, wann ein Model eine Aktion wählt, ein tool result erhält und erneut wählt – oder stoppt. Dieser Artikel richtet sich an Ingenieure, die entscheiden, wie ein Agent Arbeit behandeln soll, deren nächster Schritt davon abhängen kann, was seine Tools finden. Sie erfahren, wann Sie ReAct, ReWOO oder Plan-and-Execute einsetzen und wie diese Entscheidungen in einer LangGraph-Implementierung aussehen.
Eine Anfrage nach dem aktuellen Kurs einer Aktie hat bekannte Abfrageschritte. Eine Untersuchung, warum sich ihr Ausblick verändert hat, kann erfordern, dass die nächste Suche vom ersten Ergebnis abhängt. Das Model braucht bei diesen beiden Aufgaben unterschiedlich viel Freiheit, und die zweite braucht meist mehr Model-Aufrufe.
Dies ist Teil 1 von Engineering the Agentic Stack. Der Loop ist die innerste Schicht der Serie; spätere Teile behandeln Memory, Tools, Security, runtime und die Prüfungen, bevor eine Aufgabe als erledigt gilt. Das durchgehende Beispiel ist ein mit LangGraph gebauter Market Analyst Agent.
Einen kurzen Vergleich der Frameworks, die diese Loops implementieren, finden Sie unter Best AI Agent Frameworks in 2026.
Die Entscheidungen, die ein Model treffen muss
Listen Sie die Entscheidungen auf, die übrig bleiben, wenn die Anfrage und ihre Tools definiert sind. Für eine Kursabfrage kann die Anwendung das Kurs-Tool aufrufen und dessen Ergebnis einem Model zur Erklärung übergeben. Wenn der Nutzer ein Briefing aus Kurs, Finanzkennzahlen und aktuellen Nachrichten verlangt, kann ein Planner diese unabhängigen Calls im Voraus benennen. Wenn eine Nachricht über eine korrigierte Gewinnmeldung eine neue Abfrage erfordert, reicht eine feste Liste nicht mehr aus: Das Model muss das Ergebnis sehen, bevor es diese Abfrage wählt.
Drei Fragen bestimmen den Loop:
- Kann der Code die Calls jetzt benennen? Verwenden Sie dann einen festen Workflow. Ein Model kann die Ergebnisse trotzdem zusammenfassen, muss aber nicht über die Reihenfolge der Abfragen entscheiden.
- Wenn ein Model die Calls wählen muss: Kann es alle benennen, bevor es Ergebnisse sieht? ReWOO kann diesen Plan ausführen, ohne zwischen den Calls zum Model zurückzukehren. Sein Worker kann unabhängige Calls gemeinsam ausführen.
- Kann ein Ergebnis den nächsten Call oder ein späteres Ziel ändern? ReAct gibt dem Model nach jeder Observation eine weitere Entscheidung. Plan-and-Execute legt eine vorab erstellte Liste von Zielen um solche lokalen Loops; spätere Ziele zu ändern erfordert einen separaten Replanning-Schritt.
Die Wahl entscheidet auch, wo ein Fehler sichtbar wird. Ein falscher ReWOO-Plan kann mehrere Calls durchlaufen, bevor der Solver ein Problem sieht. Ein ReAct Loop kann sich von einem unerwarteten Ergebnis erholen, kann aber auch abschweifen oder Arbeit wiederholen. Ein vorab erstellter Plan macht eine lange Aufgabe leichter nachvollziehbar, aber ein lokaler Executor kann einen falschen Gesamtplan nicht stillschweigend reparieren. Jedes Pattern braucht weiterhin eine Stoppregel, Tool-Berechtigungen und einen Weg, fehlgeschlagene Calls zu melden; der Loop selbst liefert keine dieser Garantien.
Was jedes Pattern mit einem Ergebnis macht
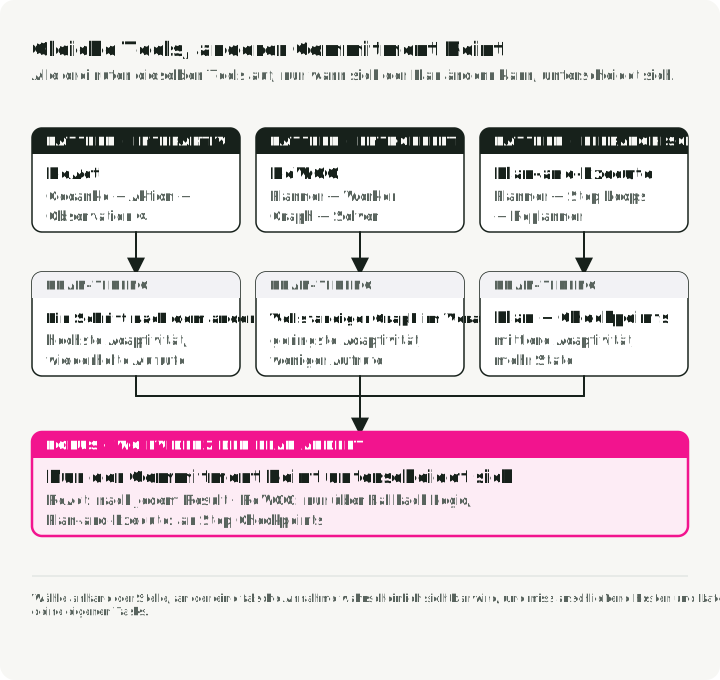
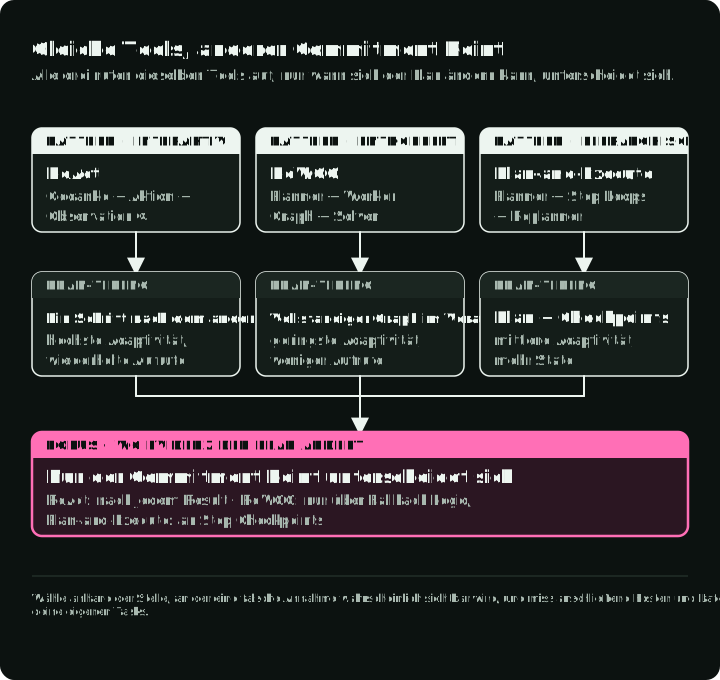
Alle drei Patterns rufen dieselben Tools auf. Sie unterscheiden sich darin, wann ein tool result den Plan ändern kann: nach jedem Call, erst nach der Ausführung oder innerhalb jedes geplanten Schritts.
ReAct: Nach jeder Observation entscheiden
ReAct (Yao et al., 2022), kurz für Reason + Act, wiederholt eine Entscheidung: Das Model wählt einen tool call, die Anwendung führt ihn aus, und das Ergebnis geht an das Model zurück. Bei einer Anfrage, die sinkende Marge eines Unternehmens zu untersuchen, könnte ein Finanzbericht auf steigende Kosten hindeuten; der nächste Call könnte dann nach Belegen zu diesen Kosten suchen. Das Model muss diesen zweiten Call nicht wählen, bevor es den Bericht sieht.
Das Original-Paper schreibt dies als Thought → Action → Observation. Native Tool APIs stellen den vorgeschlagenen Call und das tool result bereit, müssen aber das interne Reasoning des Models nicht offenlegen. Thinking zwischen tool calls ist eine separate Fähigkeit von Model und API.
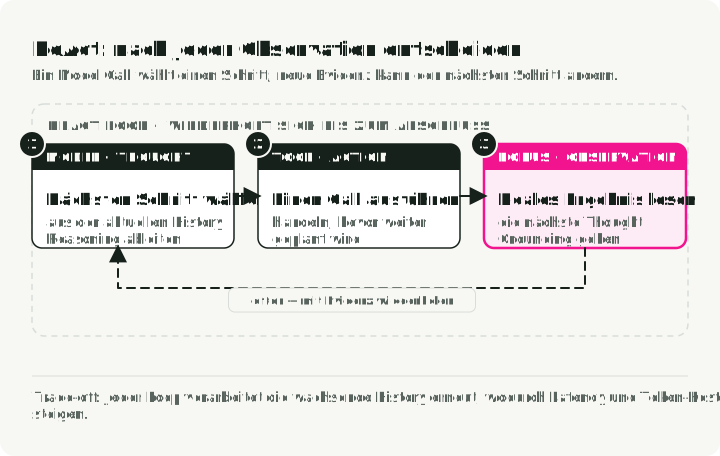
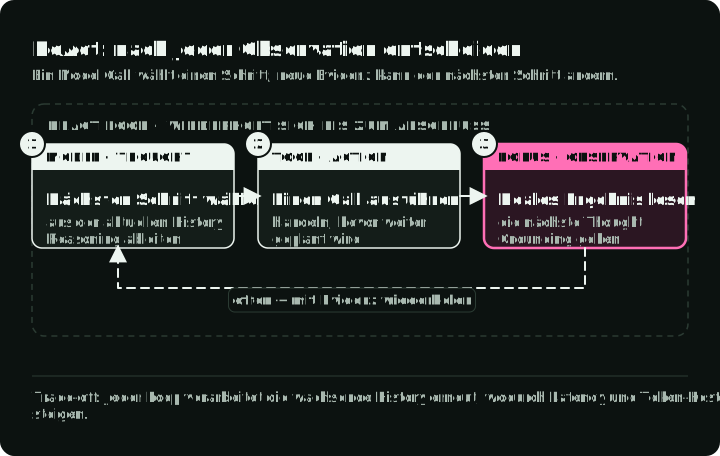
Dieses Feedback ist der Vorteil von ReAct: Eine überraschende Observation kann die nächste Aktion ändern. Die Historie der tool calls zeigt außerdem, welche Evidenz das System abgerufen hat. Im manuellen PaLM-540B-HotpotQA-Sample des Papers erzeugten Wikipedia-Observations weniger halluzinierte Fakten als chain-of-thought Prompting. Dieser Befund betrifft die dortige Aufgabe und das dortige Model, nicht die Genauigkeit jedes Tool-nutzenden Loops.
Der Preis sind wiederholte Entscheidungen. Eine Implementierung mit vollständiger Historie sendet in jedem Turn eine immer längere Konversation. prompt caching kann die wiederholte Verarbeitung des Inputs und die Kosten dafür senken, entfernt aber keine alten Observations aus dem context window. Zusammenfassen oder Abschneiden entfernt dagegen Information. Begrenzen Sie Schritte und Laufzeit, und testen Sie, ob sich der Agent von einem schlechten Ergebnis erholt oder nur weitersucht.
Verwenden Sie ReAct für explorative Recherche, Debugging und Aufgaben, bei denen Sie die nächste Aktion nicht vorhersagen können.
ReWOO: Zuerst den Tool Graph kompilieren
ReWOO (Reasoning WithOut Observation) trennt den Planning Call eines Models von seiner finalen Antwort. Der Planner benennt alle tool calls, bevor ein Ergebnis eintrifft. Er kann auf ein zukünftiges Ergebnis als #E1 verweisen und #E1 dann in die Argumente eines späteren Calls einsetzen. Ein Worker ohne LLM löst diese Platzhalter auf und führt die Calls aus; ein Solver-Model erhält die gesammelten Ergebnisse und schreibt die Antwort.
Für einen Markt-Snapshot kann der Planner Kurs, Finanzkennzahlen und aktuelle Nachrichten gemeinsam anfordern. Der Worker in diesem Artikel führt Calls, deren Abhängigkeiten erfüllt sind, parallel aus. Dieses Batching ist eine Implementierungsentscheidung; das bestimmende Merkmal im Paper ist, dass der Worker einem Plan folgt, ohne das Model zu fragen, was als Nächstes zu tun ist.
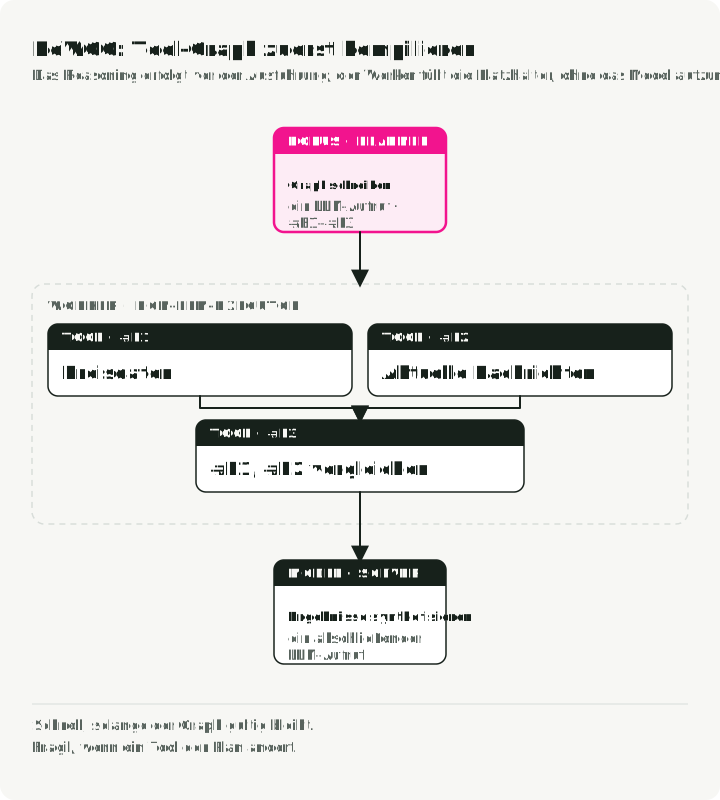
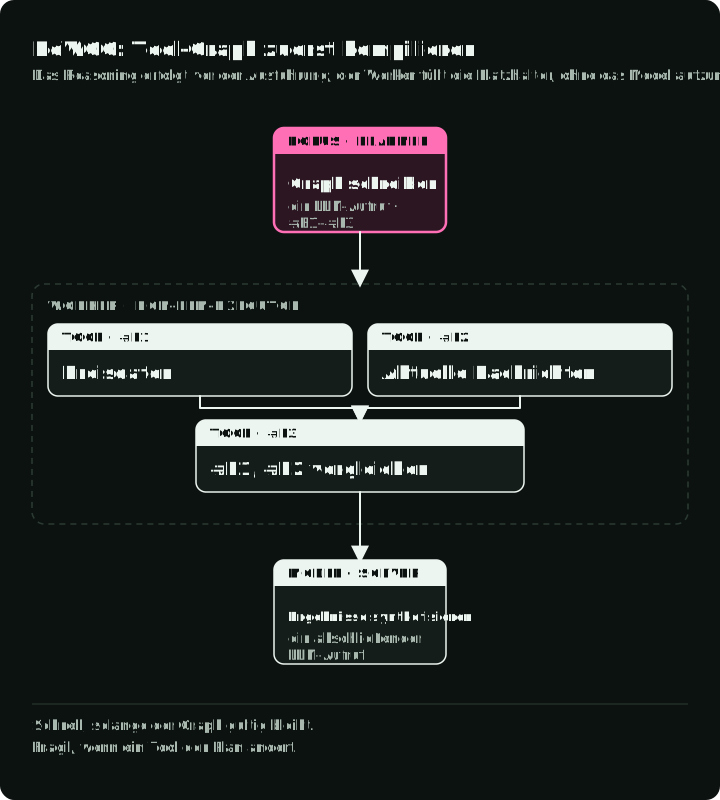
Während der Ausführung gibt es weniger Model-Aufrufe, sofern der initiale Plan brauchbar bleibt. Der HotpotQA-Stresstest des Papers ersetzte jedes tool result durch No evidence found; ReWOO verlor in diesem Test weniger Genauigkeit als ReAct. Die fehlende Evidenz gewann es trotzdem nicht zurück. Ein Worker muss entscheiden, ob ein Fehler an den Solver geht, wiederholt wird oder die Ausführung stoppt. Eine falsche Abhängigkeit oder ein fehlendes Tool kann der Solver nicht mehr beheben, wenn die Calls bereits gelaufen sind.
Da der Planner nie ein tool result liest, kann er für sich allein mit fine-tuning angepasst oder getestet werden, ohne Live-Tool-Umgebung. Verwenden Sie ReWOO für schnelle Snapshots, Status-Checks und Dashboards mit vorhersehbarem Tool-Verhalten.
Plan-and-Execute: Zerlegen, dann lokal reagieren
Plan-and-Solve Prompting erstellt zuerst einen Plan und löst dann dessen Teilaufgaben. Das verwandte Tool-Orchestration-Pattern, Plan-and-Execute, lässt einen Planner übergeordnete Ziele auflisten und einen Executor diese nacheinander bearbeiten. Der Market Analyst Agent fragt nach Rechercheschritten wie der Prüfung der finanziellen Lage und der Untersuchung von Risiken. Innerhalb jedes Schritts kann ein ReAct Loop Tools wählen, nachdem er Ergebnisse gesehen hat. Die Ausgabe des Planners ist eine Liste von Zielen, anders als die vorgeschlagenen tool calls bei ReWOO.
Das Plan-and-Solve-Paper untersuchte Zero-Shot Prompting, nicht diesen Tool-nutzenden Graph. Unterschiedliche Models für Planning und Execution zu wählen, ist in einer Implementierung möglich; es ist kein von diesem Paper belegtes Ergebnis.
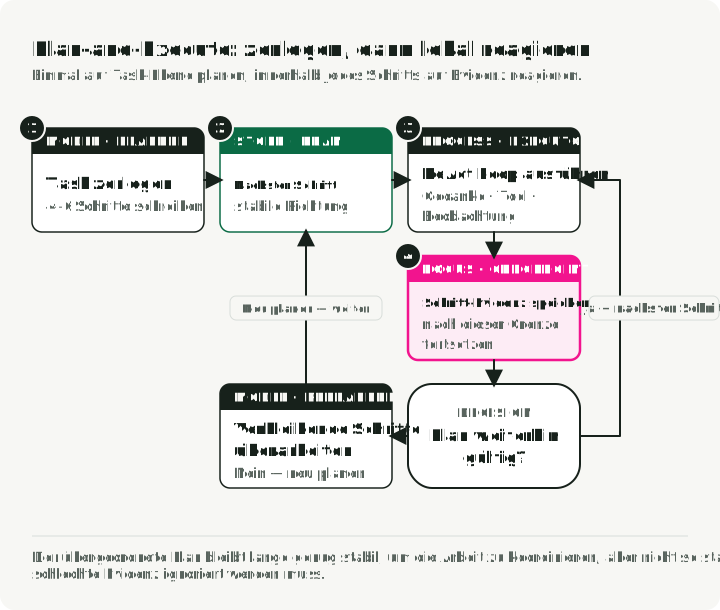
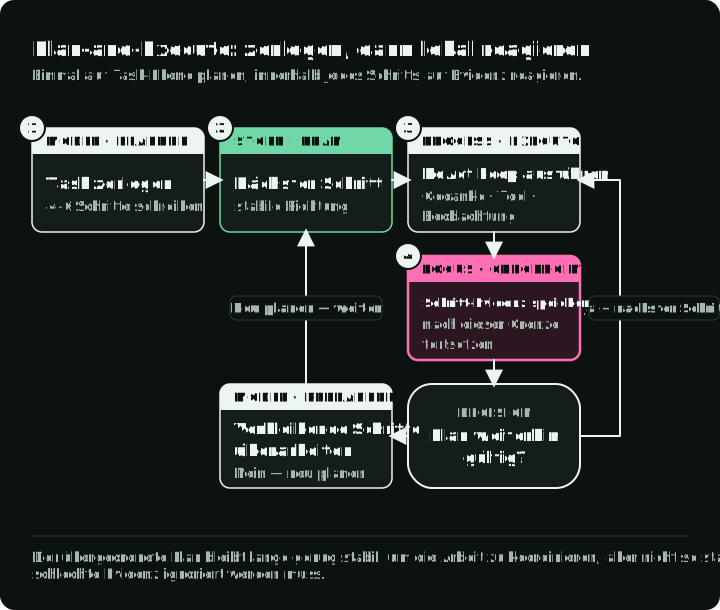
Die Abbildung enthält einen optionalen Replanner. Der Lehr-Graph unten hat keinen Replanning-Branch: Ergebnisse können die Arbeit innerhalb eines Schritts ändern, aber die Liste der späteren Schritte bleibt fest. Fügen Sie Replanning nur hinzu, wenn ein Schrittergebnis diese Liste ändern muss.
In einer Implementierung kann der Planner auf einem stärkeren Model laufen und der Executor auf einem günstigeren, und mit einem Checkpointer wird jeder abgeschlossene Schritt zu einem Punkt, an dem ein Run fortgesetzt werden kann. Das Pattern braucht außerdem mehr Model-Aufrufe und mehr State als eine einzelne Abfrage. Setzen Sie es daher nur ein, wenn der explizite Plan dem System hilft, eine größere Aufgabe abzuschließen, etwa einen Research-Bericht, der mit einer Synthese endet.
Einen Loop für die Aufgabe wählen und dann seinen Fehlerfall testen
| Signal der Aufgabe | Kontrollfluss für den Start | Beispiel | Was zu testen ist |
|---|---|---|---|
| Die Abfrageschritte sind bereits bekannt | Fester Workflow | Aktueller Kurs für einen Ticker | Muss das Ergebnis interpretiert werden, oder kann der Code es direkt zurückgeben? |
| Ein Model kann jeden Call und jede Abhängigkeit vor der Ausführung nennen | ReWOO | Kurs, Finanzkennzahlen und Nachrichten für einen Ticker; Wetter in fünf Städten | Was passiert, wenn ein geplanter Call fehlschlägt oder der Plan eine ungültige Abhängigkeit nennt? |
| Der nächste Call hängt vom letzten Ergebnis ab | ReAct | Herausfinden, warum die Marge eines Unternehmens gesunken ist | Kann er sich von einem irreführenden Ergebnis erholen und innerhalb eines begrenzten Budgets stoppen? |
| Eine lange Aufgabe hat benannte Ziele, die jeweils lokale Entscheidungen brauchen | Plan-and-Execute | Eine Investment-These mit Risiken und Wettbewerbern | Kann der Executor einen Schritt abschließen, und was passiert, wenn ein Ergebnis spätere Ziele ungültig macht? |
Das ist eine Startregel, kein Performance-Ranking. Insbesondere kann der Plan-and-Execute-Lehr-Graph spätere Ziele nicht überarbeiten. Der ReWOO-Worker führt Calls mit erfüllten Abhängigkeiten parallel aus, kann aber nach einem Ergebnis keinen neuen Call erzeugen. Vergleichen Sie die Routen auf denselben Aufgaben, mit demselben Tool-Verhalten und Budget, bevor Sie nach der Anzahl der Model-Aufrufe wählen.
Die Patterns beschreiben Entscheidungen außerhalb des Models. Ein Model, das zwischen tool calls Reasoning betreibt, braucht weiterhin ein Programm, das diese Calls ausführt, den Loop stoppt und Effekte autorisiert. Zählen Sie beim Vergleich von Loops neben den Calls auch abgerechnete Reasoning Tokens; ein Model kann Reasoning betreiben, ohne diesen Text zu zeigen.
Für eine neue LangChain-Implementierung liefert create_agent einen Tool Loop, der von Observations gesteuert wird. Der Begleit-Graph unten nutzt LangGraphs ältere create_react_agent-API; seine Auszüge erklären daher den Kontrollfluss und sind keine Setup-Anleitung für neue Projekte.
Wenn die Aufgabe isolierte Subagent-Kontexte, ein Dateisystem und automatisches Kontextmanagement braucht, bündelt Deep Agents diese Funktionen um denselben Tool Loop. Das ist eine Entscheidung über den Harness, kein viertes reasoning Pattern. Vergleichen Sie einen einzelnen Agent mit Delegation auf Aufgaben, die sich in unabhängige Arbeit aufteilen lassen, und rechnen Sie Koordinationsaufwand und verlorenen Kontext in das Ergebnis ein.
Ein durchgehendes Beispiel: der Market Analyst Agent
Der Market Analyst Agent leitet eine Anfrage nach einem Flash Briefing durch ReWOO: Marktdaten-Calls planen, ausführen und die Ergebnisse dann zusammenführen. Eine Anfrage nach tieferer Recherche läuft durch Plan-and-Execute, mit einem ReAct Loop in jedem geplanten Schritt. ReAct ist in dieser Route ein Ausführungsbaustein, keine dritte Route für den Nutzer. Die Routen unterscheiden sich darin, was der Planner an den Executor übergibt: exakte vorgeschlagene tool calls bei ReWOO oder Ziele, die weiterhin eine Tool-Wahl erfordern, bei Plan-and-Execute.
Die Auszüge sind gekürzte Lehrvarianten von Commit b4e769a, keine eigenständigen Skripte.
Er nutzt LangGraph für die Orchestration. Ein Node ist eine Python-Funktion, die zu aktualisierende Felder im gemeinsamen State zurückgibt; eine Edge wählt den nächsten Node. Beide Routen teilen ein State-Schema, während ihr Fortschritt in verschiedenen Feldern liegt:
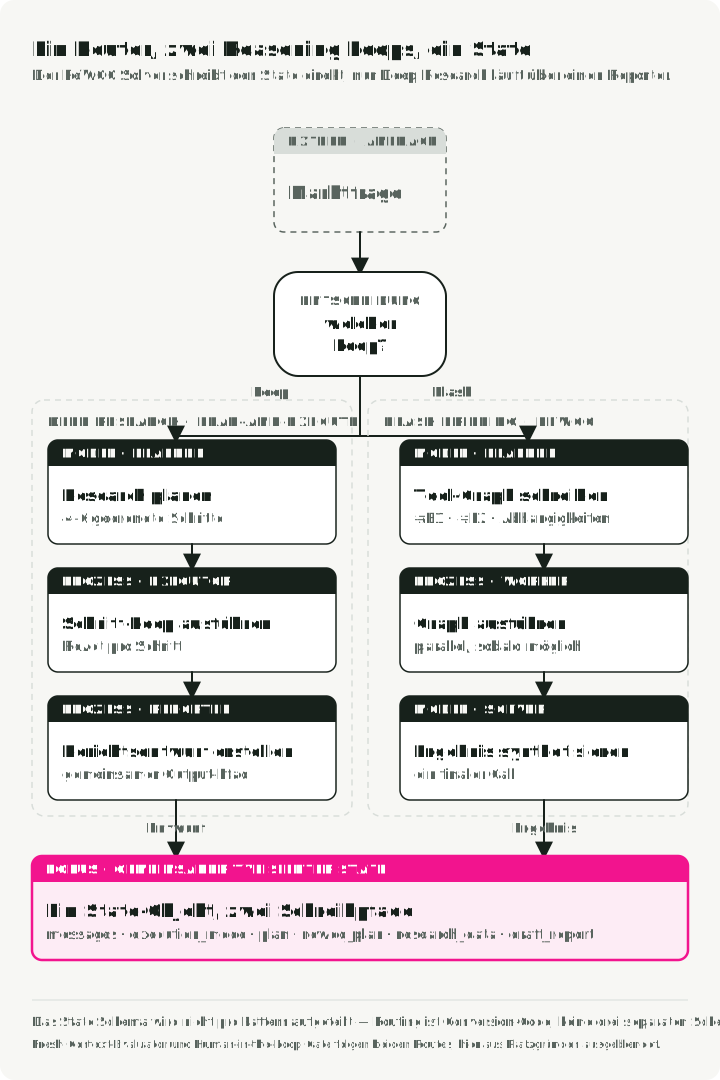
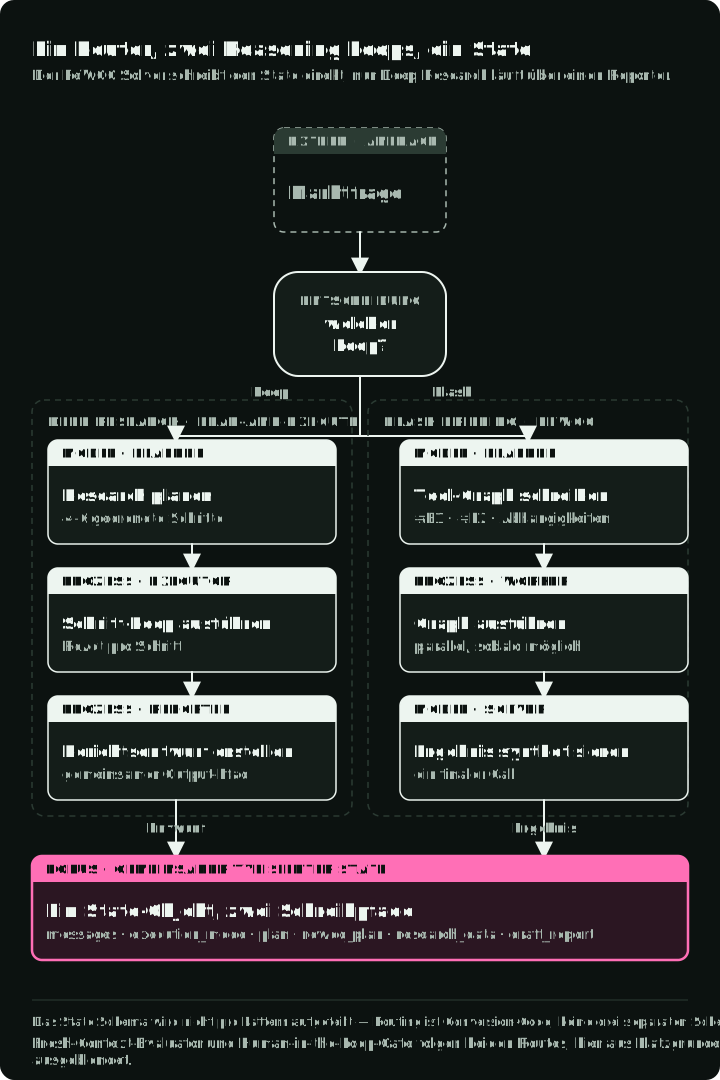
Das Diagramm zeigt nur Routing und Entwurfserstellung. Es lässt den gemeinsamen Evaluator und die menschliche Freigabe vor der Veröffentlichung weg, die in der Graph-Verdrahtung unten enthalten sind.
State-Definition
Das State-Schema hält den routenspezifischen Fortschritt in plan oder rewoo_plan und legt den finalen Entwurf beider Routen in draft_report ab. Memory- und Freigabefelder erscheinen, weil beide Routen denselben Anwendungs-State teilen; sie entscheiden nicht, welcher Loop läuft.
from typing import Literal

class PlanStep(BaseModel):
    """A single step in the research plan."""
    step_number: int
    description: str
    tool_hint: str | None = None
    completed: bool = False
    result: str | None = None

class UserProfile(BaseModel):
    """Structured user context loaded from long-term memory."""
    risk_tolerance: str | None = None
    investment_horizon: str | None = None

class AgentState(BaseModel):
    """Main state for the Market Analyst Agent graph."""

    # Identity and profile context for memory-backed personalization
    user_id: str
    user_profile: UserProfile = Field(default_factory=UserProfile)

    # Message history with LangGraph's add_messages reducer
    messages: Annotated[list, add_messages] = Field(default_factory=list)

    # Execution mode (set by router)
    execution_mode: ExecutionMode | None = None

    # Plan-and-Execute state
    plan: list[PlanStep] = Field(default_factory=list)
    current_step_index: int = 0

    # ReWOO state
    rewoo_plan: list[ReWOOPlanStep] = Field(default_factory=list)

    # Research results
    research_data: ResearchData | None = None

    # Final report. Both paths write this field, then the graph pauses before
    # publishing (see interrupt_before below), so a human signs off on a draft
    # a fresh-context evaluator has already voted on.
    draft_report: DraftReport | None = None
    report_approved: bool = False
    evaluator_verdict: Literal["pass", "fail", "needs_human"] | None = None
    evaluator_reasons: list[str] = Field(default_factory=list)
Pattern 1: Plan-and-Execute-Implementierung
Plan-and-Execute passt zu mehrstufiger Synthese. Ein Planner schreibt die übergeordneten Schritte, dann führt ein ReAct Loop jeden Schritt aus und reagiert auf tool results.
Die Begleitauszüge behalten claude-sonnet-4-5-20250929 und die ältere create_react_agent-API bei, damit sie mit dem verlinkten Commit vergleichbar bleiben. Für neuen Code verwenden Sie das aktuelle create_agent-Interface. Eine Migration dieses Graphs erfordert außerdem Tests der Planner-Schemas, der inneren Messages, des Routings und des Fortsetzungsverhaltens; nur den Model-String zu ändern ist keine Migration.
Der Planner macht einen Model-Aufruf und gibt Schrittbeschreibungen zurück. Er ruft kein Marktdaten-Tool auf. structured output prüft die Form der Antwort; eine separate Prüfung auf einen nicht leeren, brauchbaren Plan ist trotzdem nötig.
# System prompt guides the LLM to think like a research analyst
# creating a strategic plan, not immediate tool calls
PLANNER_SYSTEM_PROMPT = """You are a senior investment research analyst.
Break down stock analysis requests into 4-6 research steps covering:
1. Current price and basic metrics
2. Recent news and announcements
3. Competitor analysis (if relevant)
4. Financial health assessment
5. Risk factors
6. Investment thesis synthesis

Output as JSON with step_number, description, and tool_hint."""

# Schema-Guided Reasoning: Enforce structure with Pydantic
class PlanOutput(BaseModel):
    """Structured output for the planner."""

    steps: list[PlanStep] = Field(description="Research steps to execute")
    ticker: str = Field(description="The stock ticker being analyzed")

def planner_node(state: AgentState) -> dict:
    """Generate a research plan from the user's request.

    This is Phase 1 of Plan-and-Execute: creating the high-level strategy.
    """

    # Use a powerful model for strategic planning
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Ask for a typed plan and validate it before execution.
    # The API can still fail, so production code also handles that exception.
    structured_llm = llm.with_structured_output(PlanOutput)

    # Pull the request out of the message history
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    last_user_message = human[-1].content if human else "Analyze the market"

    # Context from long-term memory personalizes the plan
    profile_context = f"""
User Profile:
- Risk Tolerance: {state.user_profile.risk_tolerance}
- Investment Horizon: {state.user_profile.investment_horizon}
"""

    # Single LLM call creates the complete plan
    result: PlanOutput = structured_llm.invoke([
        SystemMessage(content=PLANNER_SYSTEM_PROMPT + profile_context),
        HumanMessage(content=f"Create a research plan for: {last_user_message}"),
    ])

    # State update: Store the plan and initialize tracking
    return {
        "plan": result.steps,           # The sequential steps to execute
        "current_step_index": 0,        # Start at step 0
        "research_data": ResearchData(ticker=result.ticker),  # Initialize data container
    }
Die Zeile llm.with_structured_output(PlanOutput) ist Schema-Guided Reasoning (SGR), behandelt in einem früheren Beitrag. Das Schema prüft Feldtypen, aber nicht, ob die Schritte brauchbar sind. Verlangen Sie vor der Ausführung eine nicht leere, begrenzte Liste mit eindeutigen Schrittnummern und klaren Beschreibungen.
Pattern 2: ReAct-Ausführung
Sobald der Plan existiert, gibt executor_node ein Ziel und eine Zusammenfassung früherer Ergebnisse an einen inneren ReAct Loop. Der innere Loop kann nach einer Observation ein weiteres Tool wählen. Wenn er fertig ist, speichert der äußere Graph das finale Ergebnis des Schritts und geht weiter; das innere Transkript behält er nicht in plan.
# Market-data tools available to the inner loop in this excerpt. The repo's
# TOOLS list also has a skill loader, two CLI wrappers, and a restricted Python
# evaluator; Part 3 compares those interfaces, and MCP runs as a sidecar.
TOOLS = [
    get_stock_snapshot,
    get_price_history,
    search_news,
    search_competitors,
    get_financials,
]

def executor_node(state: AgentState) -> dict:
    """Execute the current step using a ReAct agent.

    This is Phase 2 of Plan-and-Execute: adaptive execution of each planned step.
    Each step runs as a mini ReAct loop until completion.
    """

    # Guard against an empty or exhausted plan before indexing it
    if state.current_step_index >= len(state.plan):
        raise ValueError("No plan step to execute; check the planner output")

    # Get the current step from the plan
    current_step = state.plan[state.current_step_index]

    # Build context from what we've learned so far
    # Each step sees a digest of earlier results
    previous_context = ""
    for step in state.plan[:state.current_step_index]:
        if step.result:
            previous_context += f"\nStep {step.step_number}: {step.result}\n"

    # Create a ReAct agent for this step. The companion pins the older
    # create_react_agent API; new code uses create_agent.
    react_agent = create_react_agent(
        model=ChatAnthropic(model="claude-sonnet-4-5-20250929"),
        tools=TOOLS,
    )

    # Invoke the ReAct loop for this single step
    # The agent will loop internally until it completes the step
    result = react_agent.invoke({
        "messages": [
            SystemMessage(content=EXECUTOR_SYSTEM_PROMPT),
            HumanMessage(content=f"""Execute Step {current_step.step_number}:
{current_step.description}

Ticker: {state.research_data.ticker}
Previous findings: {previous_context}"""),
        ]
    })

    # Extract the final answer from the ReAct agent's message history
    # The last message contains the synthesis after all tool calls
    updated_plan = list(state.plan)
    updated_plan[state.current_step_index] = PlanStep(
        step_number=current_step.step_number,
        description=current_step.description,
        completed=True,
        result=str(result["messages"][-1].text),  # Final synthesized answer
    )

    # State update: Mark step complete and advance to next
    return {
        "plan": updated_plan,
        "current_step_index": state.current_step_index + 1,
    }
Pattern 3: ReWOO für schnelle Snapshots
Für ein kurzes Briefing gibt der Planner vorgeschlagene tool calls statt Rechercheziele zurück. Der Worker führt Calls mit erfüllten Abhängigkeiten ohne Model aus; der Solver macht einen Model-Aufruf über deren Ergebnisse. Diese Auszüge zeigen jede Übergabe.
Phase 1: ReWOO-Planner (schreibt vorab einen typisierten Plan vorgeschlagener Calls)
class ReWOOPlanStep(BaseModel):
    """A step in the ReWOO plan with variable placeholders.

    Key difference from Plan-and-Execute's PlanStep:
    - Contains actual tool_name and tool_args (not just description)
    - Uses variable references (#E1) for dependencies
    """
    step_id: str  # e.g., "#E1" - becomes a variable
    description: str
    tool_name: str     # Requested tool name; validate it against a registry in production
    tool_args: dict    # Proposed arguments; may contain refs like {"price": "#E1"}
    depends_on: list[str] = []  # Declared ordering; cross-check it against #E placeholders
    result: str | None = None

class ReWOOPlanOutput(BaseModel):
    """Structured output for ReWOO planner."""
    steps: list[ReWOOPlanStep] = Field(description="Planned tool calls with variables")

def rewoo_planner_node(state: AgentState) -> dict:
    """Generate a complete plan of tool calls upfront.

    This is the key difference from Plan-and-Execute: instead of creating
    human-readable step descriptions, it creates typed proposed tool calls.
    Production code validates them before execution; this teaching worker does not.
    """

    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Schema-Guided Reasoning validates the planner response shape.
    # It does not validate a tool name, its arguments, or its dependencies.
    structured_llm = llm.with_structured_output(ReWOOPlanOutput)

    ticker = state.research_data.ticker if state.research_data else "UNKNOWN"
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    query = human[-1].content if human else f"Analyze {ticker}"

    # Single LLM call to plan ALL tool executions
    result: ReWOOPlanOutput = structured_llm.invoke([
        SystemMessage(content=REWOO_PLANNER_PROMPT),
        HumanMessage(content=f"""Create a ReWOO plan for: {query}

Ticker: {ticker}

Output tool calls with:
- step_id: Variable name (#E1, #E2, etc.)
- description: What this accomplishes
- tool_name: Exact tool from the list
- tool_args: Dictionary of arguments
- depends_on: List of step_ids this depends on"""),
    ])

    # Store the typed proposed-call plan.
    # This teaching worker sends ready steps directly to execute_tool.
    return {"rewoo_plan": result.steps}
Phase 2: ReWOO-Worker (führt Tools ohne LLM-Reasoning aus)
def rewoo_worker_node(state: AgentState) -> dict:
    """Execute dependency-ready tools in parallel batches (no LLM calls).

    Independent tools share a batch. Dependent tools wait until their
    prerequisites complete. The worker follows the dependency graph and
    does not add LLM calls.
    """

    results = {}        # Results keyed by step_id (e.g., "#E1": "$150.23")
    updated_steps = []  # Plan steps with their result field filled in
    pending = {step.step_id: step for step in state.rewoo_plan}

    # Keep scheduling dependency-ready batches until the graph is complete.
    # This handles chains even when the planner does not list them topologically.
    with ThreadPoolExecutor(max_workers=5) as executor:
        while pending:
            ready = [
                step for step in pending.values()
                if all(dep in results for dep in step.depends_on)
            ]
            if not ready:
                unresolved = ", ".join(pending)
                raise ValueError(f"Unresolvable ReWOO dependencies: {unresolved}")

            futures = {
                executor.submit(execute_tool, step, results): step
                for step in ready
            }
            for future in as_completed(futures):
                step = futures[future]
                results[step.step_id] = future.result()
                updated_steps.append(step.model_copy(update={"result": results[step.step_id]}))
                del pending[step.step_id]

    # State update: restore the planner's order (sorting on step_id would put
    # "#E10" before "#E2") and hand the filled-in plan to the Solver
    plan_order = {s.step_id: i for i, s in enumerate(state.rewoo_plan)}
    return {"rewoo_plan": sorted(updated_steps, key=lambda s: plan_order[s.step_id])}
Phase 3: ReWOO-Solver (führt alle Ergebnisse in einem LLM Call zusammen)
def rewoo_solver_node(state: AgentState) -> dict:
    """Synthesize all tool results into a flash briefing.

    This is the second efficiency gain: Instead of interleaving
    LLM calls with tool execution (like ReAct), we make ONE
    final synthesis call with all gathered data.
    """

    # Build context from ALL tool results at once
    tool_results = []
    for step in state.rewoo_plan:
        if step.result:
            tool_results.append(f"### {step.description}\n{step.result}")

    context = "\n\n".join(tool_results)

    # Single LLM call to synthesize everything
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
    structured_llm = llm.with_structured_output(FlashBriefingOutput)
    result = structured_llm.invoke([
        SystemMessage(content=REWOO_SOLVER_PROMPT),
        HumanMessage(content=f"Create a flash briefing from this data:\n\n{context}"),
    ])

    # FlashBriefingOutput and DraftReport carry the same fields; the state
    # schema expects DraftReport, so convert before returning.
    return {"draft_report": DraftReport(**result.model_dump())}
Der Planner schreibt vorgeschlagene Calls, der Worker füllt deren Platzhalter, und der Solver erhält die Ergebnisse. Das Schema prüft ihre Form, nicht, ob der Plan ausführbar ist. Das Dictionary pending oben verwirft doppelte IDs stillschweigend. Wenn #E2 in seinen Argumenten #E1 verwendet, #E1 aber nicht in depends_on aufführt, können beide Calls in denselben Batch gelangen, bevor das erste Ergebnis existiert.
Lehnen Sie vor dem Dispatch leere oder zu große Pläne, doppelte IDs, fehlende Abhängigkeiten und Zyklen ab. Validieren Sie Tool-Namen und Argumente gegen eine Registry. Prüfen Sie Platzhalter auch in verschachtelten Werten und verlangen Sie, dass sie zu depends_on passen. Dieser Lehr-Worker überspringt diese Prüfungen. Er sendet bereite Calls an execute_tool aus dem Begleitcode, dessen abgefangene Exceptions zu Fehler-Strings werden. Der Solver muss einen solchen String als fehlende Evidenz behandeln, nicht als erfolgreiche Abfrage. Ein nicht auflösbarer Graph stoppt vor dem Solver. Recovery braucht ein Fehlerergebnis, eine bedingte Replanning-Edge und ein Limit für Versuche.
Worauf sich der Planner festlegt
| Route in diesem Graph | Vor dem ersten Marktdaten-Call | Nach einem tool result | Model-Aufrufe in dieser Implementierung | Nodes |
|---|---|---|---|---|
| Deep Research: Plan-and-Execute mit ReAct-Schritten | Planner schreibt Zielbeschreibungen | Innerer ReAct Loop kann innerhalb seines aktuellen Ziels einen weiteren Call wählen; spätere Ziele bleiben fest | Ein Plan, ein Model-/Tool-Loop pro Schritt, ein Bericht | planner_node → executor_node pro Schritt → reporter_node |
| Flash Briefing: ReWOO | Planner schreibt Tool-Namen, Argumente und Abhängigkeiten | Worker folgt dem Plan; Solver sieht Ergebnisse nach der Ausführung | Ein Plan, keine Model-Aufrufe im Worker, eine Synthese | rewoo_planner_node → rewoo_worker_node → rewoo_solver_node |
Ein PlanStep mit „Investigate recent earnings“ überlässt die Tool-Wahl dem inneren Agent. Ein ReWOOPlanStep, der search_news nennt und dessen Query liefert, legt sich auf diesen Call fest, bevor ein Ergebnis eintrifft. Dieser Unterschied, nicht der Name des Patterns, entscheidet, welche unerwarteten Observations die Ausführung ändern können. Nebeneinander sehen die beiden Planner-Ausgaben so aus:
# Plan-and-Execute: goals; the inner ReAct loop picks the tools.
plan = [
    PlanStep(step_number=1, description="Get current price and key metrics",
             tool_hint="get_stock_snapshot"),
    PlanStep(step_number=2, description="Search for recent news and earnings",
             tool_hint="search_news"),
]

# ReWOO: exact calls, fixed before any result arrives.
rewoo_plan = [
    ReWOOPlanStep(step_id="#E1", description="Read the price and valuation snapshot",
                  tool_name="get_stock_snapshot", tool_args={"ticker": "NVDA"}),
    ReWOOPlanStep(step_id="#E2", description="Find recent NVDA earnings news",
                  tool_name="search_news",
                  tool_args={"query": "NVDA earnings", "max_results": 5}),
]
Ein tool_hint ist ein Hinweis, den der Executor ignorieren darf. Ein tool_name mit tool_args ist der Call, den der Worker ausführen wird.
Ein eigenständiger ReAct Loop kann jede frühere Message in jeden neuen Model-Aufruf mitnehmen. Dieser Graph startet jeden inneren Loop mit dem aktuellen Schritt und einer Zusammenfassung der abgeschlossenen Schritte. Der äußere State behält die Schrittergebnisse, nicht das innere Transkript der tool calls. ReWOO füllt stattdessen die geplanten Schritte mit Ergebnissen und gibt die fertige Liste an seinen Solver. Das sind Entscheidungen zum Kontextmanagement in diesem Begleitcode, keine Anforderungen der Original-Paper.
Beide Routen in einem Graph verdrahten
Der Graph hat zwei Routen für den Nutzer über einem AgentState: Deep Research nutzt Plan-and-Execute mit einem ReAct Loop in jedem Schritt, Flash Briefing nutzt ReWOO.
Diese Implementierung hat keinen Replanner: Sie führt den initialen Plan bis zum Ende aus. Replanning hinzuzufügen würde eine Edge von executor zurück zu planner erfordern und eine Regel, wann ein überraschendes Ergebnis einen weiteren Model-Aufruf rechtfertigt.
LangGraph hält die Verdrahtung deklarativ:
def create_graph(checkpointer=None):
    builder = StateGraph(AgentState)

    # Add nodes
    builder.add_node("router", router_node)
    builder.add_node("planner", planner_node)
    builder.add_node("executor", executor_node)
    builder.add_node("reporter", reporter_node)
    builder.add_node("rewoo_planner", rewoo_planner_node)
    builder.add_node("rewoo_worker", rewoo_worker_node)
    builder.add_node("rewoo_solver", rewoo_solver_node)
    builder.add_node("evaluator", evaluator_node)
    builder.add_node("publish", publish_node)

    # Define edges
    builder.add_edge(START, "router")
    builder.add_conditional_edges("router", route_after_router, {
        "planner": "planner",
        "rewoo_planner": "rewoo_planner",
    })

    # Deep Research path
    builder.add_edge("planner", "executor")
    builder.add_conditional_edges("executor", route_after_executor, {
        "executor": "executor",  # Loop back for more steps
        "reporter": "reporter",  # Done with plan
    })
    builder.add_edge("reporter", "evaluator")

    # Flash Briefing path (ReWOO)
    builder.add_edge("rewoo_planner", "rewoo_worker")
    builder.add_edge("rewoo_worker", "rewoo_solver")
    builder.add_edge("rewoo_solver", "evaluator")

    # Both paths run the same evaluator before the human approval step.
    builder.add_edge("evaluator", "publish")
    builder.add_edge("publish", END)

    return builder.compile(
        checkpointer=checkpointer,
        # Human-in-the-loop pause: the reporter (or ReWOO solver) writes a
        # draft. A separate model session reads that draft and records its
        # assessment. The graph then stops before publishing, whichever
        # assessment it produced, so a human can review both the draft and
        # assessment. Part 6 explains how the program decides a run is complete.
        interrupt_before=["publish"],
    )
Testen, ob der Model-Aufruf des Routers hilft
Der Router klassifiziert kurze Snapshots, darunter „current price“, als ReWOO und komplexe Anfragen wie eine Investment-These als Plan-and-Execute. Bei unklarer Klassifizierung wählt er standardmäßig Deep Research. Schema-Guided Reasoning beschränkt die Ausgabe des Klassifikators auf einen der beiden Modi:
class ExecutionMode(str, Enum):
    DEEP_RESEARCH = "deep_research"  # Plan-and-Execute with ReAct steps
    FLASH_BRIEFING = "flash_briefing"  # ReWOO

class RouterOutput(BaseModel):
    mode: ExecutionMode
    ticker: str
    reasoning: str

ROUTER_SYSTEM_PROMPT = """Classify the user's request:

1. deep_research: complex analysis requiring synthesis
   - Examples: "Analyze strategic risks", "investment thesis"
2. flash_briefing: quick snapshots, simple data retrieval
   - Examples: "quick snapshot", "current price"

Default to deep_research if unclear."""

llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
structured_llm = llm.with_structured_output(RouterOutput)
So routet diese Anwendung Anfragen; es ist kein Beleg dafür, dass jede Kursabfrage einen Planner braucht. Für eine reine Kursanfrage würde ein direkter tool call die Calls von Router, ReWOO-Planner und Solver vermeiden. Diese Calls sind nur für Anfragen gerechtfertigt, bei denen ein Model Daten auswählen oder erklären muss.
Ein Router kann eine Anfrage auch an den falschen Loop schicken. Vergleichen Sie beide Routen und einen festen Workflow auf denselben Aufgaben, mit denselben Tools und demselben Budget. Erfassen Sie Aufgabenerfüllung, unangemessene Akzeptanz, gecachte und nicht gecachte Tokens, Laufzeit und Recovery nach Tool-Fehlern oder irreführenden Observations. Wiederholen Sie Runs, wenn die Wahl des Models stochastisch ist, und zählen Sie jeden gestarteten Versuch. Eine geringere Anzahl von Calls hilft nur, wenn die Route die Aufgabe weiterhin innerhalb ihrer Vorgaben erfüllt. Anthropics Engineering-Bericht empfiehlt ebenfalls, mit einfachen, kombinierbaren Workflows zu beginnen.
Die vollständige Begleitimplementierung, einschließlich Router und gemeinsamem State, finden Sie im Commit b4e769a des Market Analyst Agent.
Die aktuelle Single-Loop-API ausprobieren
Der Graph oben nutzt eine ältere Agent Factory von LangGraph. Wenn Sie zuerst die aktuelle create_agent-API ansehen möchten, kommt diese kleine Testdatensammlung ohne Marktdaten-Services aus. Sie zeigt einen Model-/Tool-Aufruf und dessen Ergebnis, keinen Grund, für eine bekannte Abfrage einen Agent zu verwenden. In einer Anwendung, die nur diese Frage beantwortet, rufen Sie die Abfragefunktion direkt auf.
Setzen Sie ANTHROPIC_API_KEY und installieren Sie langchain und langchain-anthropic, bevor Sie das Snippet ausführen. Der Aufruf sendet eine kostenpflichtige Model-Anfrage.
from langchain.agents import create_agent
from langchain_anthropic import ChatAnthropic

def lookup_fixture_company(ticker: str) -> str:
    """Look up a company name in a local fixture, not live market data."""
    return {"NVDA": "NVIDIA", "AMD": "AMD"}.get(
        ticker.strip().upper(), "No company in the fixture"
    )

agent = create_agent(
    model=ChatAnthropic(model="claude-sonnet-5", max_tokens=4096),
    tools=[lookup_fixture_company],
    system_prompt="Use the fixture for company names. Do not invent market data.",
)
result = agent.invoke({
    "messages": [{"role": "user", "content": "Which company is NVDA in the fixture?"}]
})
print(result["messages"][-1].text)
Wenn das Model lookup_fixture_company vorschlägt, ruft die Bibliothek diese Python-Funktion auf und gibt ihr Ergebnis zurück. Das Snippet garantiert nicht, dass das Model das Tool nutzt, und testet weder einen Routenvergleich noch eine Fehler-Policy oder die Genauigkeit auf Live-Daten.
Die nächste Schicht ist Memory
Der Loop entscheidet, welcher Call als Nächstes kommt; der Rest des Harness muss Kontext liefern, Calls ausführen und autorisieren, State bewahren und den Abschluss prüfen. Teil 2, Memory-Architektur für AI Agents trennt fortsetzbare Checkpoints von sitzungsübergreifendem Wissen und Projektdokumenten. Ohne dauerhafte Checkpoints verliert ein Worker-Neustart den laufenden State dieses Graphs. Teil 3 untersucht Tool-Interfaces, Teil 4 behandelt Autorisierung, Teil 5 behandelt Ausführung und Recovery, und Teil 6 untersucht Belege für den Abschluss einer Aufgabe.
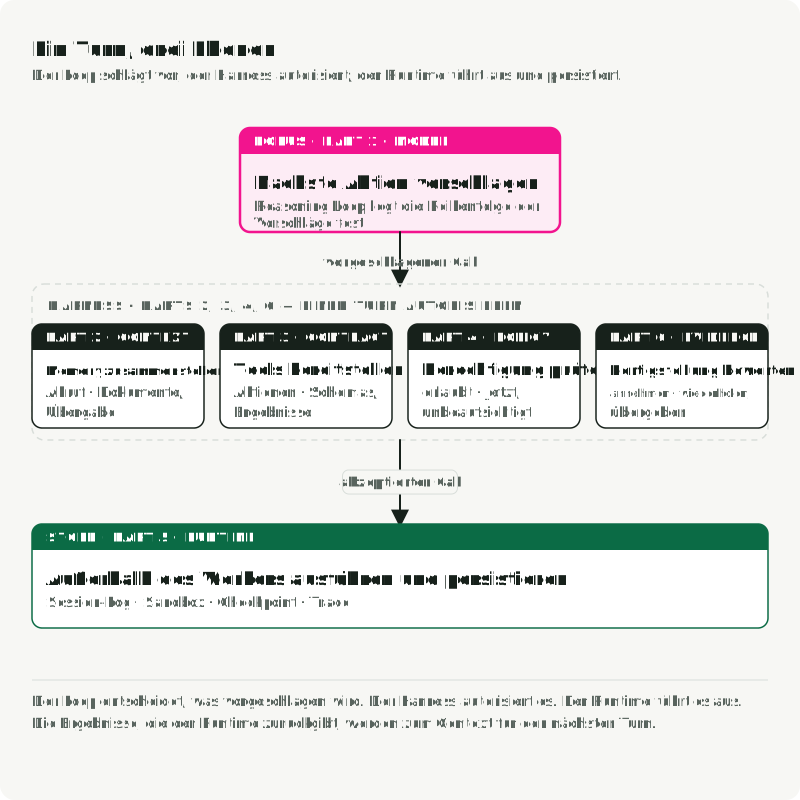
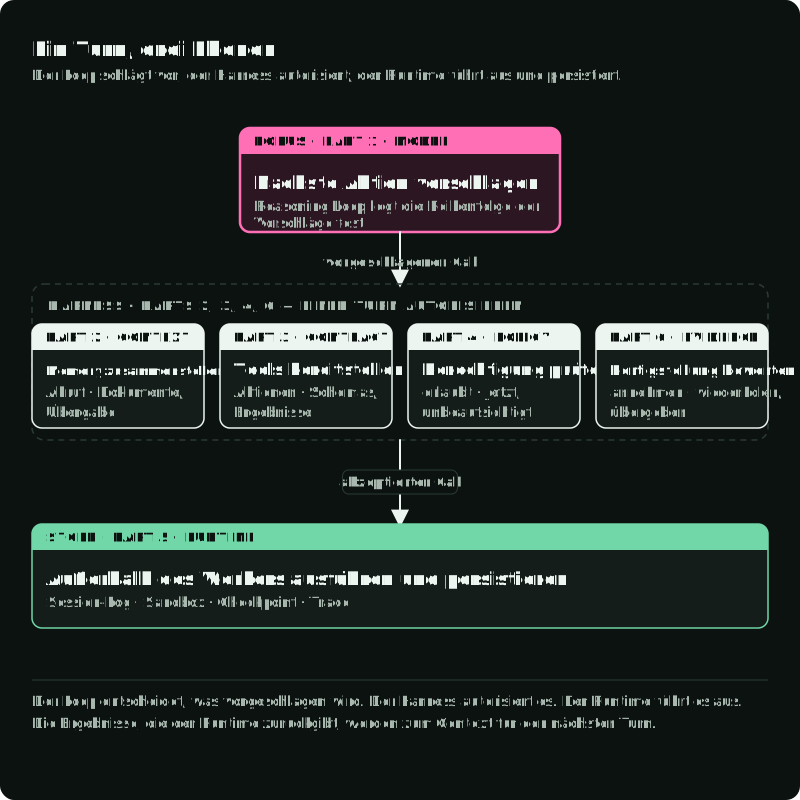
Die Abbildung ordnet jeden Teil dem Punkt in einem Turn zu, an dem er wirkt.
Referenzen
- ReAct: Synergizing Reasoning and Acting in Language Models (Yao et al., 2022)
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models (Xu et al., 2023)
- Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models (Wang et al., 2023)
- Market Analyst Agent Repository