Pętle rozumowania agentów AI: ReAct, ReWOO, Plan-and-Execute

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Pętla rozumowania agenta to przepływ sterowania, który decyduje, kiedy model wybiera akcję, otrzymuje wynik narzędzia i wybiera ponownie albo kończy pracę. Ten artykuł jest dla inżynierów, którzy decydują, jak agent ma obsługiwać zadanie, w którym następny krok może zależeć od tego, co znajdą jego narzędzia. Dowiesz się, kiedy używać ReAct, ReWOO lub Plan-and-Execute i jak te wybory wyglądają w implementacji w LangGraph.
Zapytanie o bieżący kurs akcji ma znane kroki wyszukiwania. Zbadanie, dlaczego zmieniły się perspektywy spółki, może wymagać, aby następne wyszukiwanie zależało od pierwszego wyniku. Model potrzebuje w tych dwóch zadaniach różnej swobody, a drugie zwykle wymaga więcej wywołań modelu.
To Część 1 serii Engineering the Agentic Stack. Pętla jest jej najbardziej wewnętrzną warstwą; kolejne części omawiają pamięć, narzędzia, bezpieczeństwo, runtime i kontrole wykonywane przed uznaniem zadania za zakończone. Przykładem w całym artykule jest Market Analyst Agent zbudowany w LangGraph.
Krótkie porównanie frameworków implementujących te pętle znajdziesz w artykule Best AI Agent Frameworks in 2026.
Decyzje, które musi podjąć model
Wypisz decyzje, które zostają po zdefiniowaniu zapytania i jego narzędzi. Przy sprawdzaniu kursu aplikacja może wywołać narzędzie do kursów i przekazać wynik modelowi do wyjaśnienia. Jeśli użytkownik prosi o briefing na podstawie kursu, danych finansowych i najnowszych wiadomości, planista może z góry nazwać te niezależne wywołania. Jeśli wiadomość o korekcie wyników finansowych wymaga nowego zapytania, stała lista już nie wystarcza: model musi zobaczyć wynik, zanim wybierze to zapytanie.
Pętlę wyznaczają trzy pytania:
- Czy kod może nazwać wywołania już teraz? Jeśli tak, użyj stałego workflowu. Model nadal może podsumować wyniki, ale nie musi decydować o kolejności wyszukiwań.
- Jeśli wywołania musi wybrać model, czy może nazwać je wszystkie przed zobaczeniem wyników? ReWOO może wykonać taki plan bez wracania do modelu między wywołaniami. Jego worker może uruchamiać niezależne wywołania razem.
- Czy wynik może zmienić następne wywołanie albo późniejszy cel? ReAct daje modelowi kolejną decyzję po każdej obserwacji. Plan-and-Execute dodaje wokół takich lokalnych pętli listę celów ustaloną z góry; zmiana późniejszych celów wymaga osobnego kroku ponownego planowania.
Wybór decyduje też o tym, gdzie ujawni się błąd. Błędny plan ReWOO może przejść przez kilka wywołań, zanim solver zauważy problem. Pętla ReAct może poradzić sobie z nieoczekiwanym wynikiem, ale może też wykonywać niepotrzebne działania albo powtarzać pracę. Plan ustalony z góry ułatwia śledzenie długiego zadania, ale lokalny executor nie naprawi po cichu błędnego planu ogólnego. Każdy wzorzec nadal potrzebuje reguły zatrzymania, uprawnień do narzędzi i sposobu zgłaszania nieudanych wywołań; sama pętla nie daje żadnej z tych gwarancji.
Co każdy wzorzec robi z wynikiem
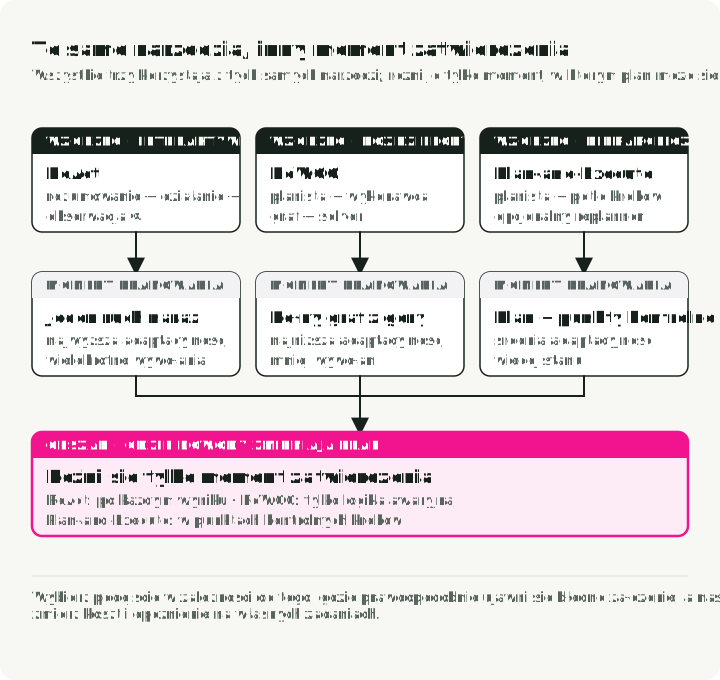
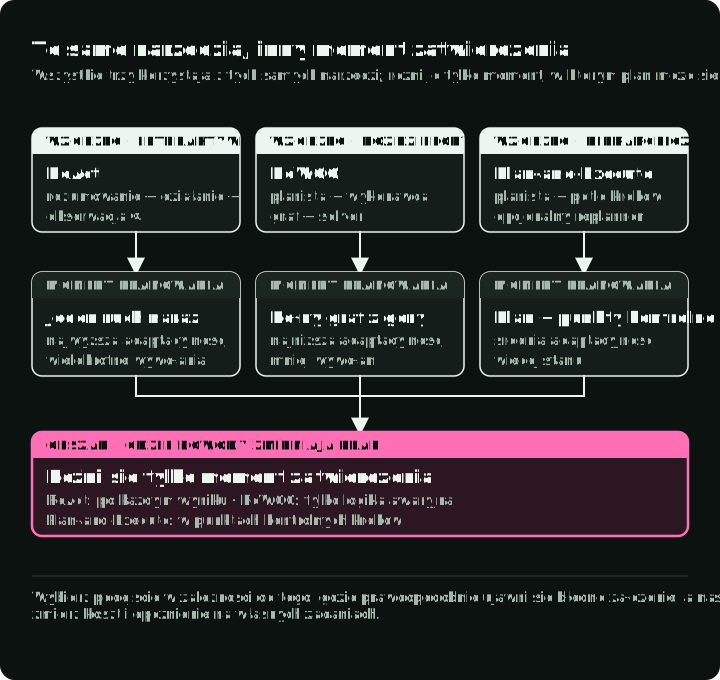
Wszystkie trzy wzorce wywołują te same narzędzia. Różnią się tym, kiedy wynik narzędzia może zmienić plan: po każdym wywołaniu, dopiero po wykonaniu albo wewnątrz każdego zaplanowanego kroku.
ReAct: decyzja po każdej obserwacji
ReAct (Yao et al., 2022), skrót od Reason + Act, powtarza jedną decyzję: model wybiera wywołanie narzędzia, aplikacja je wykonuje, a wynik wraca do modelu. Przy prośbie o zbadanie spadku marży spółki sprawozdanie finansowe może wskazać na rosnące koszty; następne wywołanie może wtedy szukać dowodów dotyczących tych kosztów. Model nie musi wybierać tego drugiego wywołania, zanim zobaczy sprawozdanie.
Oryginalny artykuł zapisuje to jako Thought → Action → Observation. Natywne APIs narzędzi udostępniają proponowane wywołanie i wynik narzędzia, ale nie muszą ujawniać wewnętrznego rozumowania modelu. Myślenie między wywołaniami narzędzi to osobna funkcja modelu i API.
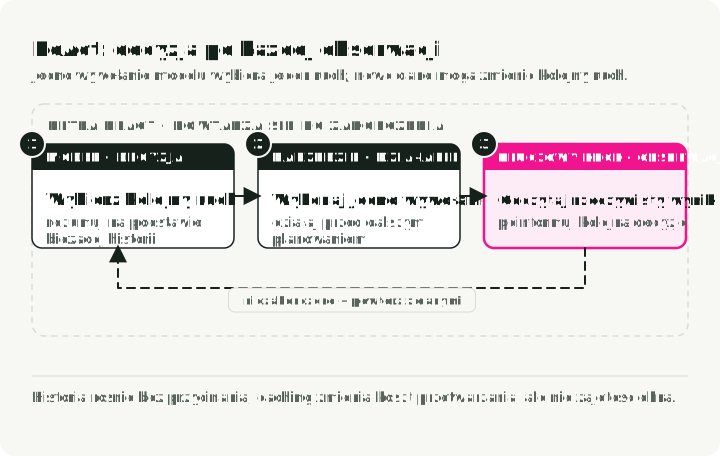
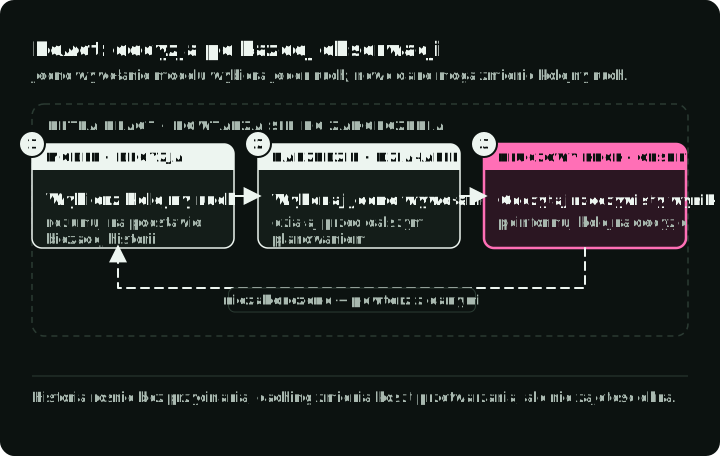
To sprzężenie zwrotne jest zaletą ReAct: zaskakująca obserwacja może zmienić następną akcję. Historia wywołań narzędzi pokazuje też, jakie dowody system pobrał. W ręcznie ocenionej próbce HotpotQA z PaLM-540B z artykułu obserwacje z Wikipedii dały mniej zmyślonych faktów niż prompting chain-of-thought. Ten wynik dotyczy tamtego zadania i modelu, a nie dokładności każdej pętli korzystającej z narzędzi.
Kosztem są powtarzane decyzje. Implementacja z pełną historią wysyła w każdej turze coraz dłuższą rozmowę. Prompt caching może zmniejszyć powtarzane przetwarzanie wejścia i związane z nim opłaty, ale nie usuwa starych obserwacji z okna kontekstu. Streszczanie albo obcinanie usuwa już informacje. Ogranicz liczbę kroków i czas działania oraz sprawdź, czy agent radzi sobie ze złym wynikiem, czy tylko szuka dalej.
Używaj ReAct do badań eksploracyjnych, debugowania i zadań, w których nie da się przewidzieć następnej akcji.
ReWOO: najpierw skompiluj graf narzędzi
ReWOO (Reasoning WithOut Observation) oddziela wywołanie planujące modelu od jego odpowiedzi końcowej. Planista nazywa wszystkie wywołania narzędzi, zanim pojawi się jakikolwiek wynik. Może odwołać się do przyszłego wyniku jako #E1, a potem wstawić #E1 do argumentów późniejszego wywołania. Worker bez LLM rozwiązuje te placeholdery i wykonuje wywołania; model solver dostaje zebrane wyniki i pisze odpowiedź.
Dla snapshotu rynku planista może zażądać jednocześnie kursu, danych finansowych i najnowszych wiadomości. Worker w tym artykule uruchamia równolegle wywołania, których zależności są gotowe. Takie grupowanie to decyzja implementacyjna; cechą definiującą w artykule jest to, że worker wykonuje plan, nie pytając modelu, co robić dalej.
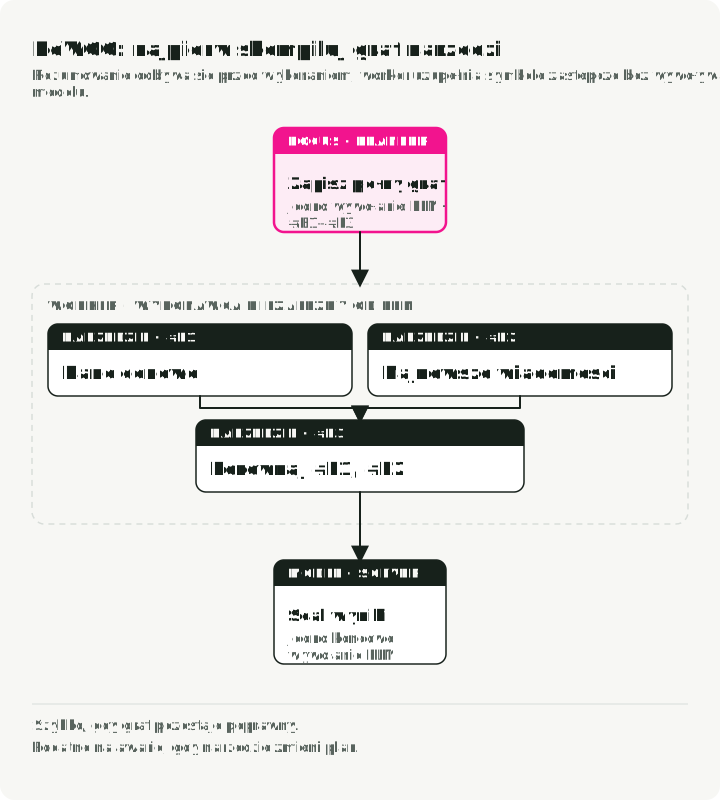
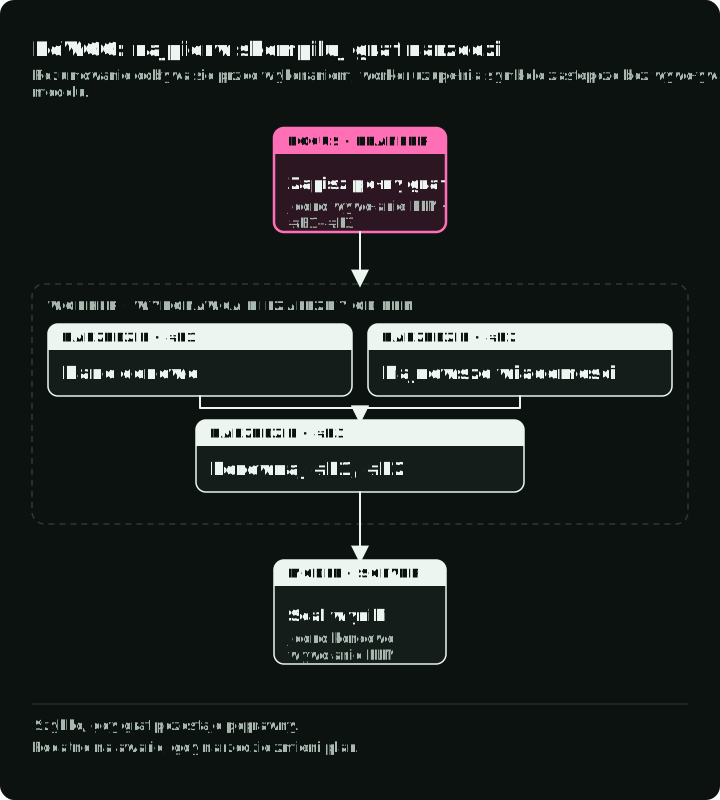
W trakcie wykonania jest mniej wywołań modelu, o ile początkowy plan pozostaje użyteczny. Test obciążeniowy HotpotQA w artykule zastąpił każdy wynik narzędzia tekstem No evidence found; ReWOO straciło w tym teście mniej dokładności niż ReAct. Mimo to nie odzyskało brakujących dowodów. Worker musi zdecydować, czy błąd trafia do solvera, jest ponawiany, czy zatrzymuje wykonanie. Solver nie naprawi błędnej zależności ani brakującego narzędzia, gdy wywołania już się wykonały.
Ponieważ planista nigdy nie czyta wyniku narzędzia, można dla niego osobno przeprowadzić fine-tuning albo go przetestować bez działającego środowiska narzędzi. Używaj ReWOO do szybkich snapshotów, sprawdzania stanu i dashboardów, w których narzędzia zachowują się przewidywalnie.
Plan-and-Execute: rozłóż zadanie, potem reaguj lokalnie
Plan-and-Solve prompting najpierw tworzy plan, a potem rozwiązuje jego podzadania. Powiązany wzorzec orkiestracji narzędzi, Plan-and-Execute, pozwala planiście wypisać cele wysokiego poziomu, a executorowi obsługiwać je po kolei. Market Analyst Agent prosi o kroki badawcze, takie jak sprawdzenie kondycji finansowej i analiza ryzyk. Wewnątrz każdego kroku pętla ReAct może wybierać narzędzia po zobaczeniu wyników. Wynikiem planisty jest lista celów, w przeciwieństwie do proponowanych wywołań narzędzi w ReWOO.
Artykuł o Plan-and-Solve badał prompting zero-shot, a nie ten graf z narzędziami. Wybór różnych modeli do planowania i wykonania jest możliwy w implementacji; nie jest to wynik wykazany w tamtym artykule.
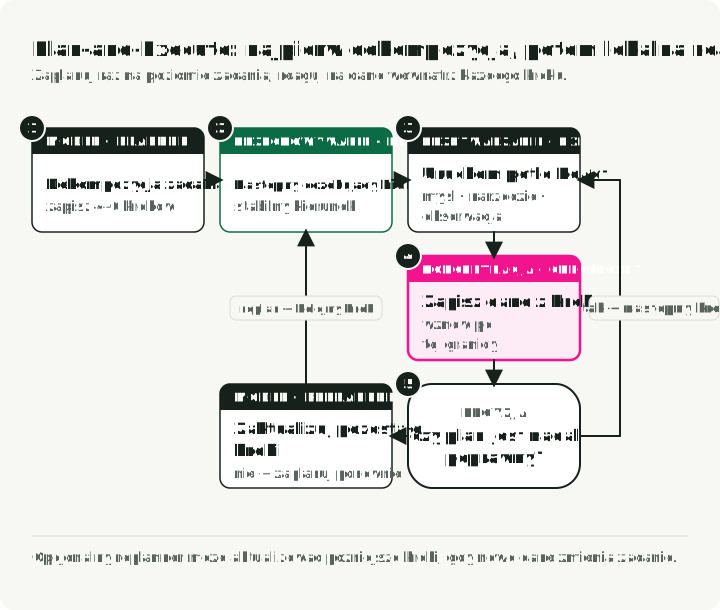
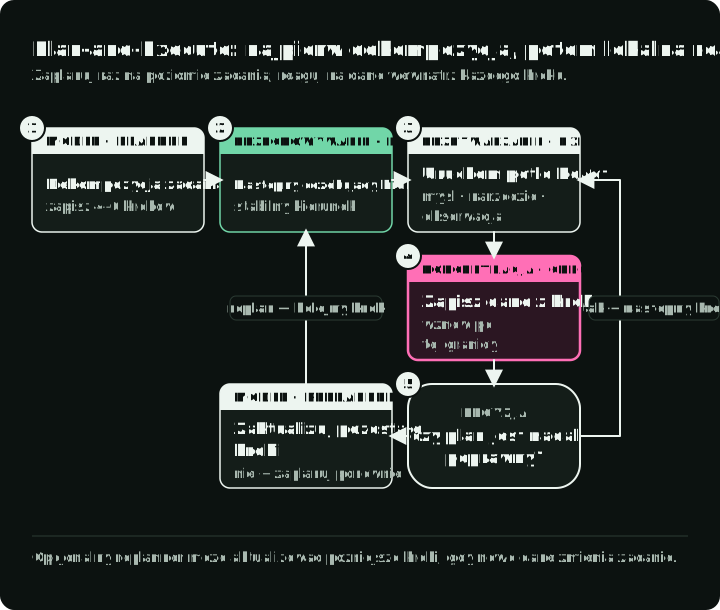
Rysunek zawiera opcjonalny replanner. Poniższy graf dydaktyczny nie ma gałęzi ponownego planowania: wyniki mogą zmienić pracę wewnątrz kroku, ale lista późniejszych kroków pozostaje stała. Dodaj ponowne planowanie tylko wtedy, gdy wynik kroku musi zmienić tę listę.
W implementacji planista może działać na mocniejszym modelu, a executor na tańszym, a z checkpointerem każdy ukończony krok staje się punktem, od którego można wznowić pracę. Wzorzec wymaga też więcej wywołań modelu i więcej stanu niż pojedyncze wyszukiwanie, więc używaj go tylko wtedy, gdy jawny plan pomaga systemowi ukończyć większe zadanie, na przykład raport badawczy zakończony syntezą.
Wybierz pętlę do zadania, a potem przetestuj jej awarię
| Sygnał z zadania | Początkowy przepływ sterowania | Przykład | Co przetestować |
|---|---|---|---|
| Kroki wyszukiwania są już znane | Stały workflow | Bieżący kurs jednego tickera | Czy wynik wymaga interpretacji, czy kod może zwrócić go bezpośrednio? |
| Model może nazwać każde wywołanie i każdą zależność przed wykonaniem | ReWOO | Kurs, dane finansowe i wiadomości dla jednego tickera; pogoda w pięciu miastach | Co się dzieje, gdy zaplanowane wywołanie się nie powiedzie albo plan wskaże nieprawidłową zależność? |
| Następne wywołanie zależy od ostatniego wyniku | ReAct | Ustalenie, dlaczego spadła marża spółki | Czy poradzi sobie z mylącym wynikiem i zatrzyma się w ramach ograniczonego budżetu? |
| Długie zadanie ma nazwane cele, a każdy wymaga lokalnych decyzji | Plan-and-Execute | Teza inwestycyjna z ryzykami i konkurentami | Czy executor może ukończyć krok i co się dzieje, gdy wynik unieważnia późniejsze cele? |
To reguła na początek, a nie ranking wydajności. W szczególności dydaktyczny graf Plan-and-Execute nie może zmieniać późniejszych celów. Worker ReWOO uruchamia równolegle wywołania z gotowymi zależnościami, ale nie może utworzyć nowego wywołania po zobaczeniu wyniku. Porównaj ścieżki na tych samych zadaniach, przy tym samym zachowaniu narzędzi i budżecie, zanim wybierzesz według liczby wywołań modelu.
Wzorce opisują decyzje poza modelem. Model, który rozumuje między wywołaniami narzędzi, nadal potrzebuje programu, który te wywołania wykona, zatrzyma pętlę i autoryzuje skutki. Porównując pętle, licz oprócz wywołań także rozliczane tokens rozumowania; model może rozumować, nie pokazując tego tekstu.
W nowej implementacji w LangChain create_agent dostarcza pętlę narzędziową sterowaną obserwacjami. Graf towarzyszący poniżej używa starszego API create_react_agent z LangGraph, więc jego fragmenty wyjaśniają przepływ sterowania, a nie służą za instrukcję konfiguracji nowego projektu.
Jeśli zadanie wymaga odizolowanych kontekstów subagentów, systemu plików i automatycznego zarządzania kontekstem, Deep Agents udostępnia je wraz z tą samą pętlą narzędziową. To wybór dotyczący harnessu, a nie czwarty wzorzec rozumowania. Porównaj jednego agenta z delegowaniem na zadaniach, które dzielą się na niezależne części, i uwzględnij w wyniku koszt koordynacji oraz utracony kontekst.
Przykład w praktyce: Market Analyst Agent
Market Analyst Agent kieruje prośbę o flash briefing przez ReWOO: zaplanuj wywołania danych rynkowych, wykonaj je, a potem zsyntetyzuj wyniki. Prośba o głębszą analizę przechodzi przez Plan-and-Execute, z pętlą ReAct w każdym zaplanowanym kroku. ReAct jest w tej ścieżce elementem wykonawczym, a nie trzecią ścieżką dla użytkownika. Ścieżki różnią się tym, co planista przekazuje executorowi: dokładne proponowane wywołania narzędzi w ReWOO albo cele, które nadal wymagają wyboru narzędzi, w Plan-and-Execute.
Fragmenty są skróconymi wersjami dydaktycznymi commita b4e769a, a nie samodzielnymi skryptami.
Do orkiestracji używa LangGraph. Węzeł to funkcja Pythona, która zwraca pola do zaktualizowania we wspólnym stanie; krawędź wybiera następny węzeł. Obie ścieżki współdzielą jeden schemat stanu, a ich postęp jest zapisywany w różnych polach:
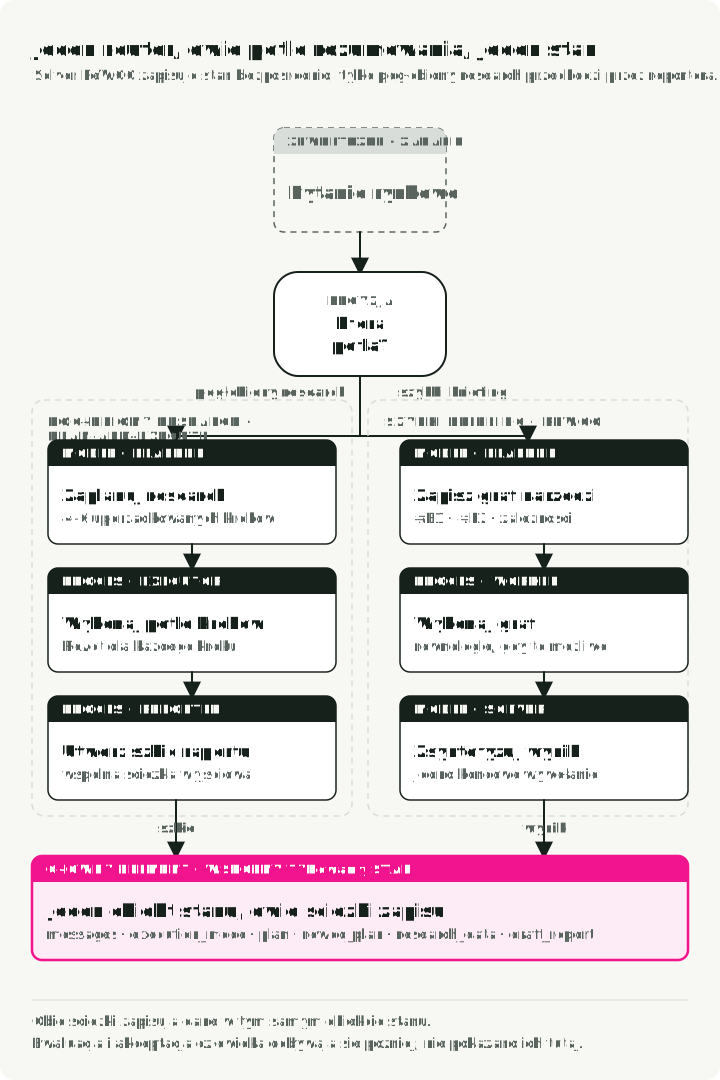
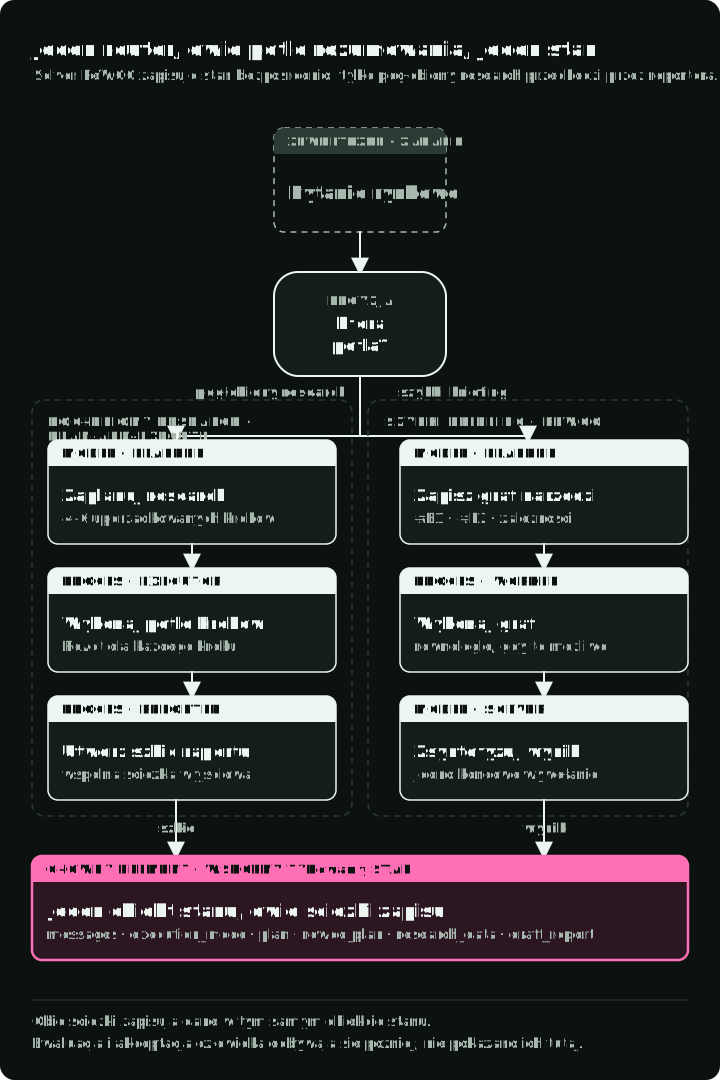
Diagram pokazuje tylko routing i tworzenie szkicu. Pomija wspólny evaluator i akceptację przez człowieka przed publikacją, które uwzględniają poniższe połączenia grafu.
Definicja stanu
Schemat stanu przechowuje postęp specyficzny dla ścieżki w plan albo rewoo_plan, a końcowy szkic każdej ze ścieżek umieszcza w draft_report. Pola pamięci i akceptacji występują, bo obie ścieżki współdzielą ten sam stan aplikacji; nie decydują one, która pętla się uruchamia.
from typing import Literal

class PlanStep(BaseModel):
    """A single step in the research plan."""
    step_number: int
    description: str
    tool_hint: str | None = None
    completed: bool = False
    result: str | None = None

class UserProfile(BaseModel):
    """Structured user context loaded from long-term memory."""
    risk_tolerance: str | None = None
    investment_horizon: str | None = None

class AgentState(BaseModel):
    """Main state for the Market Analyst Agent graph."""

    # Identity and profile context for memory-backed personalization
    user_id: str
    user_profile: UserProfile = Field(default_factory=UserProfile)

    # Message history with LangGraph's add_messages reducer
    messages: Annotated[list, add_messages] = Field(default_factory=list)

    # Execution mode (set by router)
    execution_mode: ExecutionMode | None = None

    # Plan-and-Execute state
    plan: list[PlanStep] = Field(default_factory=list)
    current_step_index: int = 0

    # ReWOO state
    rewoo_plan: list[ReWOOPlanStep] = Field(default_factory=list)

    # Research results
    research_data: ResearchData | None = None

    # Final report. Both paths write this field, then the graph pauses before
    # publishing (see interrupt_before below), so a human signs off on a draft
    # a fresh-context evaluator has already voted on.
    draft_report: DraftReport | None = None
    report_approved: bool = False
    evaluator_verdict: Literal["pass", "fail", "needs_human"] | None = None
    evaluator_reasons: list[str] = Field(default_factory=list)
Wzorzec 1: implementacja Plan-and-Execute
Plan-and-Execute pasuje do wieloetapowej syntezy. Planista zapisuje kroki wysokiego poziomu, a następnie pętla ReAct wykonuje każdy krok i reaguje na wyniki narzędzi.
Fragmenty towarzyszące zachowują claude-sonnet-4-5-20250929 i starsze API create_react_agent, aby pozostały porównywalne z podlinkowanym commitem. W nowym kodzie używaj aktualnego interfejsu create_agent. Migracja tego grafu wymaga też przetestowania schematów planisty, wewnętrznych wiadomości, routingu i zachowania przy wznawianiu; sama zmiana nazwy modelu nie jest taką migracją.
Planista wykonuje jedno wywołanie modelu i zwraca opisy kroków. Nie wywołuje żadnego narzędzia danych rynkowych. Ustrukturyzowane dane wyjściowe sprawdzają kształt odpowiedzi; nadal potrzebna jest osobna kontrola, czy plan jest niepusty i użyteczny.
# System prompt guides the LLM to think like a research analyst
# creating a strategic plan, not immediate tool calls
PLANNER_SYSTEM_PROMPT = """You are a senior investment research analyst.
Break down stock analysis requests into 4-6 research steps covering:
1. Current price and basic metrics
2. Recent news and announcements
3. Competitor analysis (if relevant)
4. Financial health assessment
5. Risk factors
6. Investment thesis synthesis

Output as JSON with step_number, description, and tool_hint."""

# Schema-Guided Reasoning: Enforce structure with Pydantic
class PlanOutput(BaseModel):
    """Structured output for the planner."""

    steps: list[PlanStep] = Field(description="Research steps to execute")
    ticker: str = Field(description="The stock ticker being analyzed")

def planner_node(state: AgentState) -> dict:
    """Generate a research plan from the user's request.

    This is Phase 1 of Plan-and-Execute: creating the high-level strategy.
    """

    # Use a powerful model for strategic planning
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Ask for a typed plan and validate it before execution.
    # The API can still fail, so production code also handles that exception.
    structured_llm = llm.with_structured_output(PlanOutput)

    # Pull the request out of the message history
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    last_user_message = human[-1].content if human else "Analyze the market"

    # Context from long-term memory personalizes the plan
    profile_context = f"""
User Profile:
- Risk Tolerance: {state.user_profile.risk_tolerance}
- Investment Horizon: {state.user_profile.investment_horizon}
"""

    # Single LLM call creates the complete plan
    result: PlanOutput = structured_llm.invoke([
        SystemMessage(content=PLANNER_SYSTEM_PROMPT + profile_context),
        HumanMessage(content=f"Create a research plan for: {last_user_message}"),
    ])

    # State update: Store the plan and initialize tracking
    return {
        "plan": result.steps,           # The sequential steps to execute
        "current_step_index": 0,        # Start at step 0
        "research_data": ResearchData(ticker=result.ticker),  # Initialize data container
    }
Ta linia llm.with_structured_output(PlanOutput) to Schema-Guided Reasoning (SGR), omówione w jednym z wcześniejszych wpisów. Schemat sprawdza typy pól, ale nie to, czy kroki są użyteczne. Przed wykonaniem wymagaj niepustej, ograniczonej listy z unikalnymi numerami kroków i jasnymi opisami.
Wzorzec 2: wykonanie ReAct
Gdy plan już istnieje, executor_node przekazuje jeden cel i streszczenie wcześniejszych wyników do wewnętrznej pętli ReAct. Wewnętrzna pętla może wybrać kolejne narzędzie po zobaczeniu obserwacji. Gdy skończy, zewnętrzny graf zapisuje końcowy wynik kroku i przechodzi dalej; nie przechowuje wewnętrznego zapisu przebiegu w plan.
# Market-data tools available to the inner loop in this excerpt. The repo's
# TOOLS list also has a skill loader, two CLI wrappers, and a restricted Python
# evaluator; Part 3 compares those interfaces, and MCP runs as a sidecar.
TOOLS = [
    get_stock_snapshot,
    get_price_history,
    search_news,
    search_competitors,
    get_financials,
]

def executor_node(state: AgentState) -> dict:
    """Execute the current step using a ReAct agent.

    This is Phase 2 of Plan-and-Execute: adaptive execution of each planned step.
    Each step runs as a mini ReAct loop until completion.
    """

    # Guard against an empty or exhausted plan before indexing it
    if state.current_step_index >= len(state.plan):
        raise ValueError("No plan step to execute; check the planner output")

    # Get the current step from the plan
    current_step = state.plan[state.current_step_index]

    # Build context from what we've learned so far
    # Each step sees a digest of earlier results
    previous_context = ""
    for step in state.plan[:state.current_step_index]:
        if step.result:
            previous_context += f"\nStep {step.step_number}: {step.result}\n"

    # Create a ReAct agent for this step. The companion pins the older
    # create_react_agent API; new code uses create_agent.
    react_agent = create_react_agent(
        model=ChatAnthropic(model="claude-sonnet-4-5-20250929"),
        tools=TOOLS,
    )

    # Invoke the ReAct loop for this single step
    # The agent will loop internally until it completes the step
    result = react_agent.invoke({
        "messages": [
            SystemMessage(content=EXECUTOR_SYSTEM_PROMPT),
            HumanMessage(content=f"""Execute Step {current_step.step_number}:
{current_step.description}

Ticker: {state.research_data.ticker}
Previous findings: {previous_context}"""),
        ]
    })

    # Extract the final answer from the ReAct agent's message history
    # The last message contains the synthesis after all tool calls
    updated_plan = list(state.plan)
    updated_plan[state.current_step_index] = PlanStep(
        step_number=current_step.step_number,
        description=current_step.description,
        completed=True,
        result=str(result["messages"][-1].text),  # Final synthesized answer
    )

    # State update: Mark step complete and advance to next
    return {
        "plan": updated_plan,
        "current_step_index": state.current_step_index + 1,
    }
Wzorzec 3: ReWOO do szybkich snapshotów
Przy krótkim briefingu planista zwraca proponowane wywołania narzędzi zamiast celów badawczych. Worker wykonuje bez modelu wywołania z gotowymi zależnościami; solver wykonuje jedno wywołanie modelu na ich wynikach. Te fragmenty pokazują każde przekazanie.
Faza 1: planista ReWOO (z góry zapisuje typowany plan proponowanych wywołań)
class ReWOOPlanStep(BaseModel):
    """A step in the ReWOO plan with variable placeholders.

    Key difference from Plan-and-Execute's PlanStep:
    - Contains actual tool_name and tool_args (not just description)
    - Uses variable references (#E1) for dependencies
    """
    step_id: str  # e.g., "#E1" - becomes a variable
    description: str
    tool_name: str     # Requested tool name; validate it against a registry in production
    tool_args: dict    # Proposed arguments; may contain refs like {"price": "#E1"}
    depends_on: list[str] = []  # Declared ordering; cross-check it against #E placeholders
    result: str | None = None

class ReWOOPlanOutput(BaseModel):
    """Structured output for ReWOO planner."""
    steps: list[ReWOOPlanStep] = Field(description="Planned tool calls with variables")

def rewoo_planner_node(state: AgentState) -> dict:
    """Generate a complete plan of tool calls upfront.

    This is the key difference from Plan-and-Execute: instead of creating
    human-readable step descriptions, it creates typed proposed tool calls.
    Production code validates them before execution; this teaching worker does not.
    """

    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)

    # Schema-Guided Reasoning validates the planner response shape.
    # It does not validate a tool name, its arguments, or its dependencies.
    structured_llm = llm.with_structured_output(ReWOOPlanOutput)

    ticker = state.research_data.ticker if state.research_data else "UNKNOWN"
    human = [m for m in state.messages if isinstance(m, HumanMessage)]
    query = human[-1].content if human else f"Analyze {ticker}"

    # Single LLM call to plan ALL tool executions
    result: ReWOOPlanOutput = structured_llm.invoke([
        SystemMessage(content=REWOO_PLANNER_PROMPT),
        HumanMessage(content=f"""Create a ReWOO plan for: {query}

Ticker: {ticker}

Output tool calls with:
- step_id: Variable name (#E1, #E2, etc.)
- description: What this accomplishes
- tool_name: Exact tool from the list
- tool_args: Dictionary of arguments
- depends_on: List of step_ids this depends on"""),
    ])

    # Store the typed proposed-call plan.
    # This teaching worker sends ready steps directly to execute_tool.
    return {"rewoo_plan": result.steps}
Faza 2: worker ReWOO (wykonuje narzędzia bez rozumowania LLM)
def rewoo_worker_node(state: AgentState) -> dict:
    """Execute dependency-ready tools in parallel batches (no LLM calls).

    Independent tools share a batch. Dependent tools wait until their
    prerequisites complete. The worker follows the dependency graph and
    does not add LLM calls.
    """

    results = {}        # Results keyed by step_id (e.g., "#E1": "$150.23")
    updated_steps = []  # Plan steps with their result field filled in
    pending = {step.step_id: step for step in state.rewoo_plan}

    # Keep scheduling dependency-ready batches until the graph is complete.
    # This handles chains even when the planner does not list them topologically.
    with ThreadPoolExecutor(max_workers=5) as executor:
        while pending:
            ready = [
                step for step in pending.values()
                if all(dep in results for dep in step.depends_on)
            ]
            if not ready:
                unresolved = ", ".join(pending)
                raise ValueError(f"Unresolvable ReWOO dependencies: {unresolved}")

            futures = {
                executor.submit(execute_tool, step, results): step
                for step in ready
            }
            for future in as_completed(futures):
                step = futures[future]
                results[step.step_id] = future.result()
                updated_steps.append(step.model_copy(update={"result": results[step.step_id]}))
                del pending[step.step_id]

    # State update: restore the planner's order (sorting on step_id would put
    # "#E10" before "#E2") and hand the filled-in plan to the Solver
    plan_order = {s.step_id: i for i, s in enumerate(state.rewoo_plan)}
    return {"rewoo_plan": sorted(updated_steps, key=lambda s: plan_order[s.step_id])}
Faza 3: solver ReWOO (syntetyzuje wszystkie wyniki w jednym wywołaniu LLM)
def rewoo_solver_node(state: AgentState) -> dict:
    """Synthesize all tool results into a flash briefing.

    This is the second efficiency gain: Instead of interleaving
    LLM calls with tool execution (like ReAct), we make ONE
    final synthesis call with all gathered data.
    """

    # Build context from ALL tool results at once
    tool_results = []
    for step in state.rewoo_plan:
        if step.result:
            tool_results.append(f"### {step.description}\n{step.result}")

    context = "\n\n".join(tool_results)

    # Single LLM call to synthesize everything
    llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
    structured_llm = llm.with_structured_output(FlashBriefingOutput)
    result = structured_llm.invoke([
        SystemMessage(content=REWOO_SOLVER_PROMPT),
        HumanMessage(content=f"Create a flash briefing from this data:\n\n{context}"),
    ])

    # FlashBriefingOutput and DraftReport carry the same fields; the state
    # schema expects DraftReport, so convert before returning.
    return {"draft_report": DraftReport(**result.model_dump())}
Planista zapisuje proponowane wywołania, worker wypełnia ich placeholdery, a solver otrzymuje wyniki. Schemat sprawdza ich kształt, a nie to, czy plan da się wykonać. Powyższy słownik pending po cichu pomija zduplikowane identyfikatory. Jeśli #E2 używa #E1 w argumentach, ale nie wymienia #E1 w depends_on, oba wywołania mogą trafić do tej samej partii, zanim pierwszy wynik będzie istniał.
Przed wysłaniem odrzucaj puste lub zbyt duże plany, zduplikowane identyfikatory, brakujące zależności i cykle. Waliduj nazwy narzędzi i argumenty względem rejestru. Sprawdzaj placeholdery także w wartościach zagnieżdżonych i wymagaj, aby zgadzały się z depends_on. Ten dydaktyczny worker pomija te kontrole. Wysyła gotowe wywołania do execute_tool z kodu towarzyszącego, którego przechwycone wyjątki stają się komunikatami o błędach. Solver musi traktować taki komunikat jako brak dowodu, a nie udane wyszukiwanie. Graf, którego nie da się rozwiązać, zatrzymuje się przed solverem. Odzyskiwanie wymaga wyniku błędu, warunkowej krawędzi ponownego planowania i limitu prób.
Do czego zobowiązuje się planista
| Ścieżka w tym grafie | Przed pierwszym wywołaniem danych rynkowych | Po wyniku narzędzia | Wywołania modelu w tej implementacji | Węzły |
|---|---|---|---|---|
| Deep research: Plan-and-Execute z krokami ReAct | Planista zapisuje opisy celów | Wewnętrzna pętla ReAct może wybrać kolejne wywołanie w ramach bieżącego celu; późniejsze cele pozostają stałe | Jeden plan, pętla model/narzędzie na krok, jeden raport | planner_node → executor_node na krok → reporter_node |
| Flash briefing: ReWOO | Planista zapisuje nazwy narzędzi, argumenty i zależności | Worker wykonuje plan; solver widzi wyniki po wykonaniu | Jeden plan, brak wywołań modelu w workerze, jedna synteza | rewoo_planner_node → rewoo_worker_node → rewoo_solver_node |
PlanStep z opisem „Investigate recent earnings” zostawia wybór narzędzia wewnętrznemu agentowi. ReWOOPlanStep, który nazywa search_news i podaje jego zapytanie, zobowiązuje się do tego wywołania, zanim pojawi się jakikolwiek wynik. To ta różnica, a nie nazwa wzorca, decyduje, które nieoczekiwane obserwacje mogą zmienić wykonanie. Obok siebie oba wyniki planisty wyglądają tak:
# Plan-and-Execute: goals; the inner ReAct loop picks the tools.
plan = [
    PlanStep(step_number=1, description="Get current price and key metrics",
             tool_hint="get_stock_snapshot"),
    PlanStep(step_number=2, description="Search for recent news and earnings",
             tool_hint="search_news"),
]

# ReWOO: exact calls, fixed before any result arrives.
rewoo_plan = [
    ReWOOPlanStep(step_id="#E1", description="Read the price and valuation snapshot",
                  tool_name="get_stock_snapshot", tool_args={"ticker": "NVDA"}),
    ReWOOPlanStep(step_id="#E2", description="Find recent NVDA earnings news",
                  tool_name="search_news",
                  tool_args={"query": "NVDA earnings", "max_results": 5}),
]
tool_hint to wskazówka, którą executor może zignorować. tool_name z tool_args to wywołanie, które wykona worker.
Samodzielna pętla ReAct może przenosić każdą wcześniejszą wiadomość do każdego nowego wywołania modelu. Ten graf uruchamia każdą wewnętrzną pętlę z bieżącym krokiem i streszczeniem ukończonych kroków. Zewnętrzny stan przechowuje wyniki kroków, a nie wewnętrzny zapis wywołań narzędzi. ReWOO natomiast wypełnia zaplanowane kroki wynikami i przekazuje gotową listę swojemu solverowi. To decyzje dotyczące zarządzania kontekstem w tym kodzie towarzyszącym, a nie wymagania oryginalnych artykułów.
Połącz obie ścieżki w jeden graf
Graf ma dwie ścieżki dla użytkownika na jednym AgentState: deep research używa Plan-and-Execute z pętlą ReAct w każdym kroku, a flash briefing używa ReWOO.
Ta implementacja nie ma replannera: wykonuje początkowy plan do końca. Dodanie ponownego planowania wymagałoby krawędzi z executor z powrotem do planner i reguły określającej, kiedy zaskakujący wynik uzasadnia kolejne wywołanie modelu.
LangGraph utrzymuje połączenia w formie deklaratywnej:
def create_graph(checkpointer=None):
    builder = StateGraph(AgentState)

    # Add nodes
    builder.add_node("router", router_node)
    builder.add_node("planner", planner_node)
    builder.add_node("executor", executor_node)
    builder.add_node("reporter", reporter_node)
    builder.add_node("rewoo_planner", rewoo_planner_node)
    builder.add_node("rewoo_worker", rewoo_worker_node)
    builder.add_node("rewoo_solver", rewoo_solver_node)
    builder.add_node("evaluator", evaluator_node)
    builder.add_node("publish", publish_node)

    # Define edges
    builder.add_edge(START, "router")
    builder.add_conditional_edges("router", route_after_router, {
        "planner": "planner",
        "rewoo_planner": "rewoo_planner",
    })

    # Deep Research path
    builder.add_edge("planner", "executor")
    builder.add_conditional_edges("executor", route_after_executor, {
        "executor": "executor",  # Loop back for more steps
        "reporter": "reporter",  # Done with plan
    })
    builder.add_edge("reporter", "evaluator")

    # Flash Briefing path (ReWOO)
    builder.add_edge("rewoo_planner", "rewoo_worker")
    builder.add_edge("rewoo_worker", "rewoo_solver")
    builder.add_edge("rewoo_solver", "evaluator")

    # Both paths run the same evaluator before the human approval step.
    builder.add_edge("evaluator", "publish")
    builder.add_edge("publish", END)

    return builder.compile(
        checkpointer=checkpointer,
        # Human-in-the-loop pause: the reporter (or ReWOO solver) writes a
        # draft. A separate model session reads that draft and records its
        # assessment. The graph then stops before publishing, whichever
        # assessment it produced, so a human can review both the draft and
        # assessment. Part 6 explains how the program decides a run is complete.
        interrupt_before=["publish"],
    )
Sprawdź, czy wywołanie modelu przez router pomaga
Router klasyfikuje szybkie snapshoty, w tym „current price”, jako ReWOO, a złożone prośby, takie jak teza inwestycyjna, jako Plan-and-Execute. Gdy klasyfikacja jest niejasna, domyślnie wybiera deep research. Schema-Guided Reasoning ogranicza wynik klasyfikatora do jednego z dwóch trybów:
class ExecutionMode(str, Enum):
    DEEP_RESEARCH = "deep_research"  # Plan-and-Execute with ReAct steps
    FLASH_BRIEFING = "flash_briefing"  # ReWOO

class RouterOutput(BaseModel):
    mode: ExecutionMode
    ticker: str
    reasoning: str

ROUTER_SYSTEM_PROMPT = """Classify the user's request:

1. deep_research: complex analysis requiring synthesis
   - Examples: "Analyze strategic risks", "investment thesis"
2. flash_briefing: quick snapshots, simple data retrieval
   - Examples: "quick snapshot", "current price"

Default to deep_research if unclear."""

llm = ChatAnthropic(model="claude-sonnet-4-5-20250929", temperature=0)
structured_llm = llm.with_structured_output(RouterOutput)
Tak ta aplikacja kieruje zapytania; nie dowodzi to, że każde sprawdzenie kursu wymaga planisty. Przy zapytaniu wyłącznie o kurs bezpośrednie wywołanie narzędzia pozwoliłoby uniknąć wywołań routera, planisty ReWOO i solvera. Te wywołania są uzasadnione tylko przy zapytaniach, w których model musi wybrać lub wyjaśnić dane.
Router może też skierować zapytanie do niewłaściwej pętli. Porównaj obie ścieżki i stały workflow na tych samych zadaniach, narzędziach i budżecie. Zapisuj ukończenie zadania, niewłaściwe akceptacje, tokens z cache i bez cache, czas rzeczywisty oraz odzyskiwanie po błędach narzędzi lub mylących obserwacjach. Powtarzaj uruchomienia tam, gdzie wybór modelu jest stochastyczny, i licz każdą rozpoczętą próbę. Mniejsza liczba wywołań pomaga tylko wtedy, gdy ścieżka nadal kończy zadanie w ramach swoich ograniczeń. Tekst inżynierski Anthropic również zaleca zaczynanie od prostych, składalnych workflowów.
Pełna implementacja towarzysząca, łącznie z routerem i wspólnym stanem, jest dostępna w commicie b4e769a Market Analyst Agent.
Wypróbuj obecne API pojedynczej pętli
Powyższy graf używa starszej fabryki agentów z LangGraph. Jeśli najpierw chcesz przyjrzeć się aktualnemu API create_agent, ten mały zestaw przykładowych danych omija usługi danych rynkowych. Pokazuje wywołanie model/narzędzie i jego wynik, a nie powód, by używać agenta do znanego wyszukiwania. W aplikacji, która odpowiada tylko na to pytanie, wywołaj funkcję wyszukiwania bezpośrednio.
Przed uruchomieniem fragmentu ustaw ANTHROPIC_API_KEY i zainstaluj langchain oraz langchain-anthropic. Wywołanie wysyła płatne zapytanie do modelu.
from langchain.agents import create_agent
from langchain_anthropic import ChatAnthropic

def lookup_fixture_company(ticker: str) -> str:
    """Look up a company name in a local fixture, not live market data."""
    return {"NVDA": "NVIDIA", "AMD": "AMD"}.get(
        ticker.strip().upper(), "No company in the fixture"
    )

agent = create_agent(
    model=ChatAnthropic(model="claude-sonnet-5", max_tokens=4096),
    tools=[lookup_fixture_company],
    system_prompt="Use the fixture for company names. Do not invent market data.",
)
result = agent.invoke({
    "messages": [{"role": "user", "content": "Which company is NVDA in the fixture?"}]
})
print(result["messages"][-1].text)
Jeśli model zaproponuje lookup_fixture_company, biblioteka wywoła tę funkcję Pythona i przekaże jej wynik z powrotem. Fragment nie gwarantuje, że model użyje narzędzia, i nie testuje porównania ścieżek, polityki obsługi błędów ani dokładności na danych na żywo.
Następną warstwą jest pamięć
Pętla decyduje, które wywołanie będzie następne; reszta harnessu musi dostarczyć kontekst, wykonywać i autoryzować wywołania, zachowywać stan i sprawdzać ukończenie. Część 2, architektura pamięci agentów AI oddziela checkpoints pozwalające wznowić pracę od wiedzy między sesjami i dokumentów projektu. Bez trwałych checkpoints ponowne uruchomienie workera powoduje utratę bieżącego stanu tego grafu. Część 3 omawia interfejsy narzędzi, Część 4 autoryzację, Część 5 wykonanie i odzyskiwanie, a Część 6 dowody ukończenia zadania.
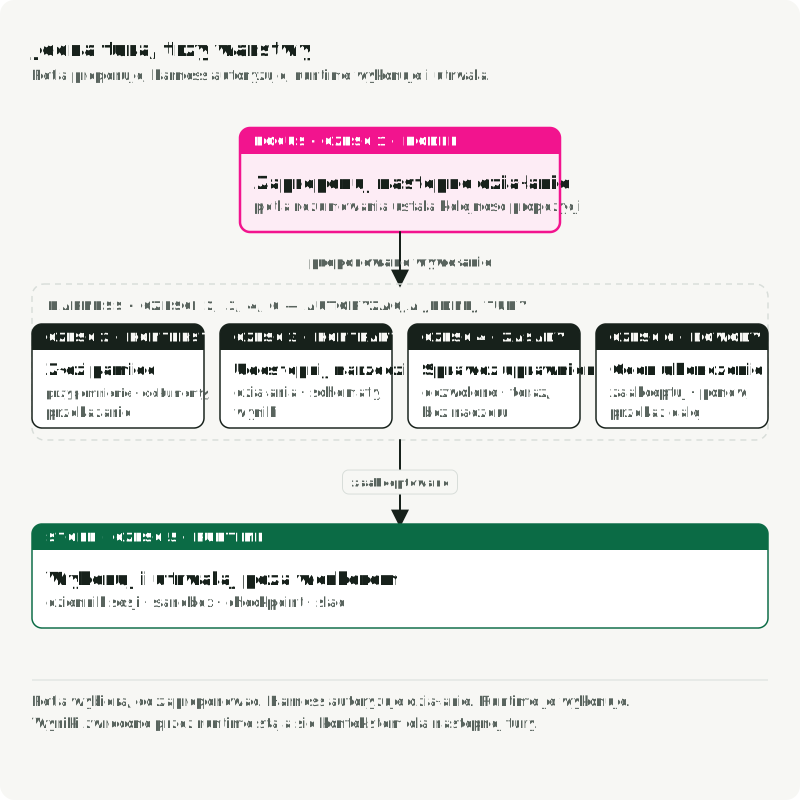
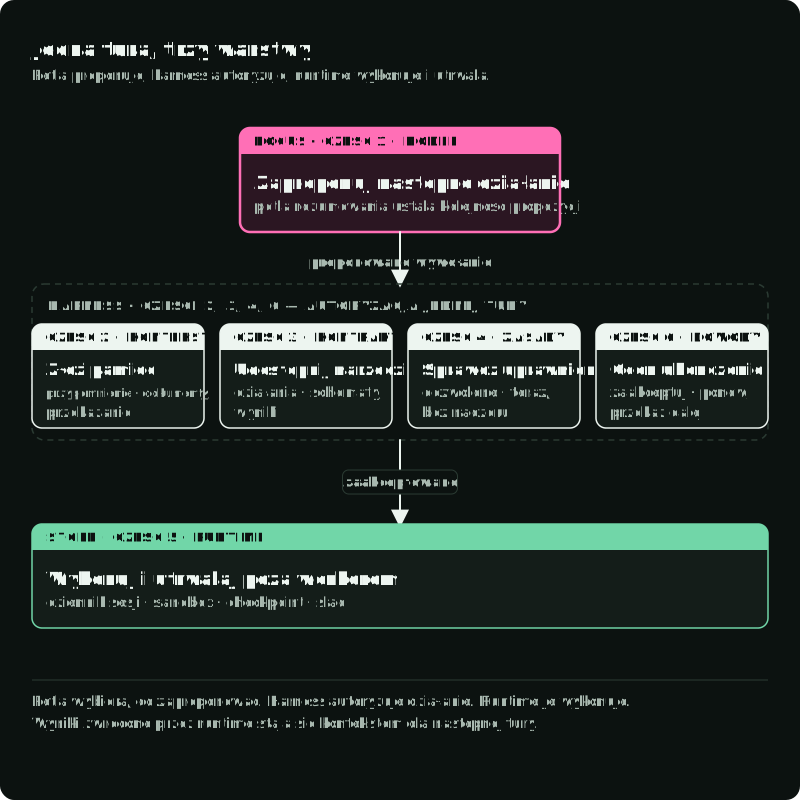
Rysunek umieszcza każdą część w tym punkcie jednej tury, w którym działa.
Źródła
- ReAct: Synergizing Reasoning and Acting in Language Models (Yao et al., 2022)
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models (Xu et al., 2023)
- Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models (Wang et al., 2023)
- Market Analyst Agent Repository