Środowisko uruchomieniowe długotrwałych agentów AI: sesje i checkpointy

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Długotrwałe środowisko uruchomieniowe agenta pozwala, by uruchomienie korzystające z narzędzi przetrwało workera, który je rozpoczął. Ten artykuł jest dla inżynierów, którzy przenoszą agenta z handlera żądań do pracy w tle. Dowiesz się, który stan musi przetrwać restart, dlaczego checkpoint nie sprawia, że ponowienie zewnętrznej akcji jest bezpieczne, i jak te wymagania wyznaczają kształt wdrożenia. Następnie artykuł porównuje konkretne opcje: kolejkę i workera, Temporal, dostawców sandboxów, Cloud Run, Lambda, Fargate, Kubernetes i hostowane platformy agentów, wraz z observability potrzebnym do debugowania uruchomienia po awarii.
Model nadal proponuje kolejną akcję. Harness z Części 6 dostarcza kontekst, autoryzuje narzędzia i sprawdza zakończenie. Środowisko uruchomieniowe daje tej pętli trwały stan i miejsce wykonania. Część 4 omawia decyzję o uprawnieniach; tutaj śledzimy zatwierdzoną akcję przez awarię i odzyskiwanie.
Stan, którego restart nie może wymazać
Załóżmy, że agent badawczy zbiera źródła, pisze szkic raportu, czeka na zatwierdzenie i publikuje zatwierdzony plik. Uruchomienie może trwać minuty albo dni, bo zatwierdzenie nie ma ustalonego czasu nadejścia. Wdrożenie może zastąpić workera, gdy agent pisze szkic, gdy czeka albo tuż po tym, jak usługa publikacji przyjmie plik.
Pamięć workera można utracić. Zatwierdzonego raportu i faktu, że publikacja mogła już nastąpić, utracić nie można. Zanim wybierzesz framework, zapisz, na co inny worker musi umieć odpowiedzieć:
| Pytanie po restarcie | Trwały zapis do zachowania |
|---|---|
| Które to uruchomienie i czy może być kontynuowane? | ID uruchomienia, status, termin, budżet, właściciel lub lease |
| Co agent powinien zrobić dalej? | Checkpoint stanu pętli lub grafu |
| Który raport zatwierdzono? | Niezmienna wersja artefaktu lub hash treści oraz decyzja o zatwierdzeniu |
| Czy publikacja już nastąpiła? | ID oczekującej operacji, argumenty, wynik i wynik zewnętrznego sprawdzenia |
| Dlaczego to uruchomienie zawiodło lub zużyło budżet? | Skorelowane zdarzenia i trace’y |
Te zapisy nie muszą być pięcioma osobnymi produktami. Baza danych może przechowywać wiersze uruchomień, checkpointy i zdarzenia operacji w osobnych tabelach. Magazyn obiektów może przechowywać pliki raportów. Backend trace’ów może przechowywać czasy. Trzymaj te zapisy osobno, bo każdy dowodzi czegoś innego. Opis długotrwałych agentów od Anthropic przedstawia ten sam podstawowy problem od strony modelu: nowy kontekst nie pamięta wcześniejszej pracy, chyba że aplikacja da mu trwały postęp do odczytania. Zespół OpenAI Codex raportuje pojedyncze uruchomienia, które pracują nad jednym zadaniem ponad sześć godzin, więc to nie jest rzadki przypadek.
Jedno przyjęte zadanie nazwijmy uruchomieniem. Może ono korzystać z kilku sesji modelu, gdy konteksty są zastępowane, a jedna konwersacja może zawierać kilka uruchomień. Frameworki używają słów „session” i „thread” różnie. W LangGraph thread_id jest kluczem historii checkpointów; wybierz jawnie, czy jeden taki thread odpowiada jednemu uruchomieniu, czy obejmuje kilka. Tak czy inaczej, trzymaj ID uruchomienia należące do aplikacji na potrzeby logu operacji. Backendy sesji w OpenAI Agents SDK przechowują zmienną historię konwersacji, którą można edytować, czyścić i kompaktować, więc nie traktuj ich jako append-only logu odzyskiwania.
Workspace to kolejny element stanu. W przypadku agenta kodującego commit może wskazywać pliki do przywrócenia; w przykładzie z raportem niezmienny klucz obiektu i hash mogą wskazywać zatwierdzony plik. Wstrzymany sandbox może zachować wygodny system plików, ale jego dalsze istnienie nie powinno być jedynym sposobem odzyskania wyniku. Git worktree rozdzielają checkouty; nie są sandboxami wykonawczymi.
Pięć komponentów do rozmieszczenia
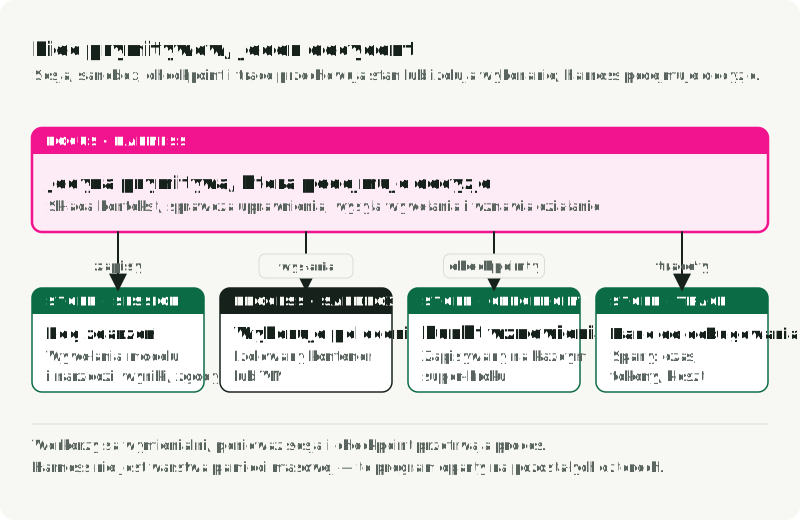
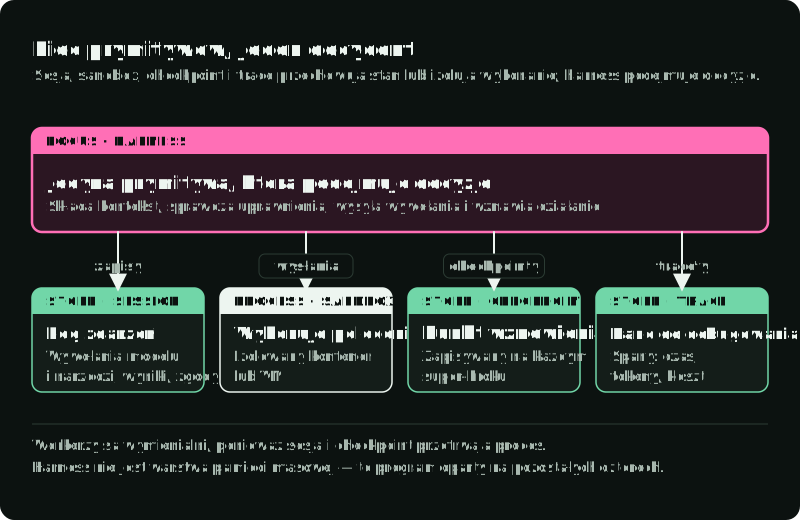
Tekst Anthropic Scaling Managed Agents rozdziela sesję, harness i sandbox. Ten artykuł rozdziela również checkpointy i ślady wykonania, wskazując pięć odpowiedzialności środowiska uruchomieniowego do rozmieszczenia. Implementacja może je łączyć, ale każda potrzebuje właściciela i znanej granicy awarii. Rysunek umieszcza je w układzie kolejki i workera i opisuje, co przechodzi między nimi.
| Komponent | Zadanie | Typowa implementacja |
|---|---|---|
| Sesja | Append-only log wywołań, wyników i zatwierdzeń | Tabela zdarzeń w PostgreSQL z kluczem ID uruchomienia |
| Harness | Prowadzenie tur modelu i narzędzi do końca zadania | Graf LangGraph, runner OpenAI Agents SDK, własna pętla |
| Sandbox | Uruchamianie poleceń z limitami plików, sieci i procesów | Utwardzony kontener, microVM, sandbox przeglądarki |
| Checkpoint | Wznawianie bez odtwarzania całego uruchomienia | Saver PostgreSQL lub Redis w LangGraph, stan silnika workflow |
| Trace | Debugowanie uruchomienia po jego zakończeniu | Spany OpenTelemetry do Tempo, Jaeger, Honeycomb, LangSmith |
Harness jako jedyny podejmuje decyzje; pozostałe cztery przechowują stan lub ograniczają wykonanie. Skompilowany graf LangGraph, Deep Agents od LangChain i Claude Code są harnessami w tym sensie. Przewodnik po sandboxach w OpenAI Agents SDK wyznacza tę samą granicę: zatwierdzenia, tracing, handoffy i stan wznowienia należą do zewnętrznego środowiska uruchomieniowego, a polecenia, zmiany plików i izolacja środowiska należą do sesji sandboxa.
Sandboxy różnią się czasem życia. Świeży efemeryczny sandbox istnieje dla jednego zadania i za każdym razem ponosi koszt startu. Trwały wstrzymywany sandbox zachowuje system plików i snapshot pamięci między uruchomieniami, więc kolejne wznowienie może uniknąć pełnego rozruchu. Sandbox typu snapshot lub fork tworzy odgałęzienie obrazu copy-on-write od przygotowanego rodzica, dzięki czemu wiele zadań współdzieli zainstalowane zależności bez współdzielenia zapisywalnego stanu.
Dwie kwestie przecinają wszystkie pięć komponentów. Egzekwowanie uprawnień działa przed każdym wywołaniem narzędzia. Uprawnienia systemu plików w Deep Agents obejmują tylko jego wbudowane narzędzia plikowe, więc polecenia powłoki, własne narzędzia i wywołania MCP wymagają egzekwowania w polityce sandboxa lub za proxy narzędzi. Sekrety nie powinny trafiać ani do modelu, ani zwykle do sandboxa. Managed Agents od Anthropic klonuje repozytoria z użyciem tokenu podczas przygotowania sandboxa i kieruje wywołania MCP przez proxy przechowujące tokeny OAuth, więc harness nigdy nie widzi poświadczeń.
Sprawdź rozmieszczenie, zapisując każdy komponent i to, co go implementuje. PostgreSQL może przechowywać sesję i checkpointy, kontener workera uruchamia harness, dostawca taki jak Daytona, Modal lub E2B dostarcza sandbox, a Tempo lub LangSmith przechowuje trace’y. Następnie szukaj sprzężonych awarii: dwa komponenty w jednym procesie zawodzą razem, a współdzielone poświadczenie po wycieku przekracza obie granice.
Checkpoint, log zdarzeń i zewnętrzny zapis odpowiadają na różne pytania
Checkpoint mówi, gdzie wykonanie może zostać wznowione: jakie wiadomości lub wartości grafu już powstały, który krok się zakończył i który czeka na uruchomienie. LangGraph zapisuje stan grafu na granicach super-stepów. Jego checkpointer może też zachować udane zapisy węzłów, gdy inny węzeł w tym samym kroku zawiedzie. To użyteczna odporność na błędy, ale checkpoint wartości grafu nie dowodzi, czy usługa spoza grafu zatwierdziła żądanie.
graph.get_state() zwraca StateSnapshot, którego .values zawiera ostatni znany stan grafu, co przydaje się w pakiecie debugowym. Ani on, ani checkpoint nie odtworzą zdarzeń, których harness nigdy nie zalogował.
Log zdarzeń operacji mówi, czego aplikacja próbowała i czego się dowiedziała: publish_requested, publish_pending, publish_succeeded lub needs_human, wszystkie powiązane z jednym ID uruchomienia i ID operacji. Może znajdować się w tej samej bazie co checkpointy, pod warunkiem że aplikacja faktycznie zapisuje zdarzenia. Historia checkpointów grafu nie jest automatycznie tym logiem. Transkrypt czatu to jeszcze coś innego: pomaga modelowi kontynuować, ale nie musi zawierać każdego zatwierdzenia, argumentu narzędzia ani efektu ubocznego.
Usługa zewnętrzna jest właścicielem rozstrzygającego wyniku publikacji. Może oferować klucz idempotencji, sprawdzenie statusu po ID operacji albo zapytanie o obiekt o oczekiwanym hashu. Jeśli nie oferuje żadnej z tych opcji, środowisko uruchomieniowe nie może wywnioskować sukcesu z braku odpowiedzi. Trace może pokazać, że żądanie zostało wysłane i ile trwało, ale span zakończony timeoutem nie rozstrzyga, czy zdalna usługa je zatwierdziła.
Różnica ujawnia się przy odtwarzaniu starego stanu. Odtwarzanie checkpointu w LangGraph ponownie wykonuje kroki po wybranym checkpoincie, łącznie z żądaniami API w tych krokach. To funkcja do debugowania i sterowania przepływem, a nie gwarancja exactly-once dla efektów zewnętrznych. Ta sama zasada dotyczy świeżego workera wznawiającego pracę po awarii.
Prześledź jedną niepewną publikację
Raport jest zatwierdzony i zapisany pod stabilnym ID artefaktu. Teraz harness prosi środowisko uruchomieniowe o jego publikację. Załóżmy, że usługa publikacji może zrealizować żądanie, nawet jeśli worker straci odpowiedź.
- Zapisz intencję. Zanim żądanie opuści workera, zapisz trwale ID operacji należące do aplikacji, hash zatwierdzonego artefaktu, miejsce docelowe i status
pending. Powiąż to ID z tymi argumentami. ID wywołania narzędzia wygenerowane przez model może się zmienić po ponownym planowaniu; nie jest tożsamością akcji biznesowej. - Wyślij akcję. Przekaż to samo ID operacji usłudze publikacji, jeśli jej API obsługuje idempotencję. Jeśli nie obsługuje, użyj stabilnego klucza obiektu lub innego obsługiwanego przez dostawcę sposobu sprawdzenia wyniku. Worker nie może zakładać, że timeout oznacza, że usługa nic nie zrobiła.
- Zapisz wynik. Po potwierdzonej odpowiedzi zapisz ID zewnętrznego wyniku i oznacz operację jako zakończoną, zanim uruchomienie będzie kontynuowane. Kolejny checkpoint może wtedy odwoływać się do tego wyniku.
- Odzyskaj wynik. Załóżmy, że usługa przyjęła raport, ale worker uległ awarii przed krokiem 3. Nowy worker widzi
pending. Pyta usługę, czy ta sama operacja lub artefakt istnieje. Jeśli tak, zapisuje odzyskany wynik i kontynuuje bez publikowania drugiej kopii. Jeśli ponowienie jest obsługiwane, używa tego samego ID operacji i niezmienionych argumentów. - Zatrzymaj się przy niepewności. Jeśli usługa nie potrafi odpowiedzieć i nie obiecuje idempotentnych ponowień, pozostaw operację nierozstrzygniętą do przeglądu. Wygenerowanie nowego klucza i ponowne wysłanie żądania byłoby nową akcją, z ryzykiem podwójnej publikacji.
Poniższa sekwencja pokazuje awarię z kroku 4, między zewnętrznym sukcesem a lokalnym zapisem wyniku.
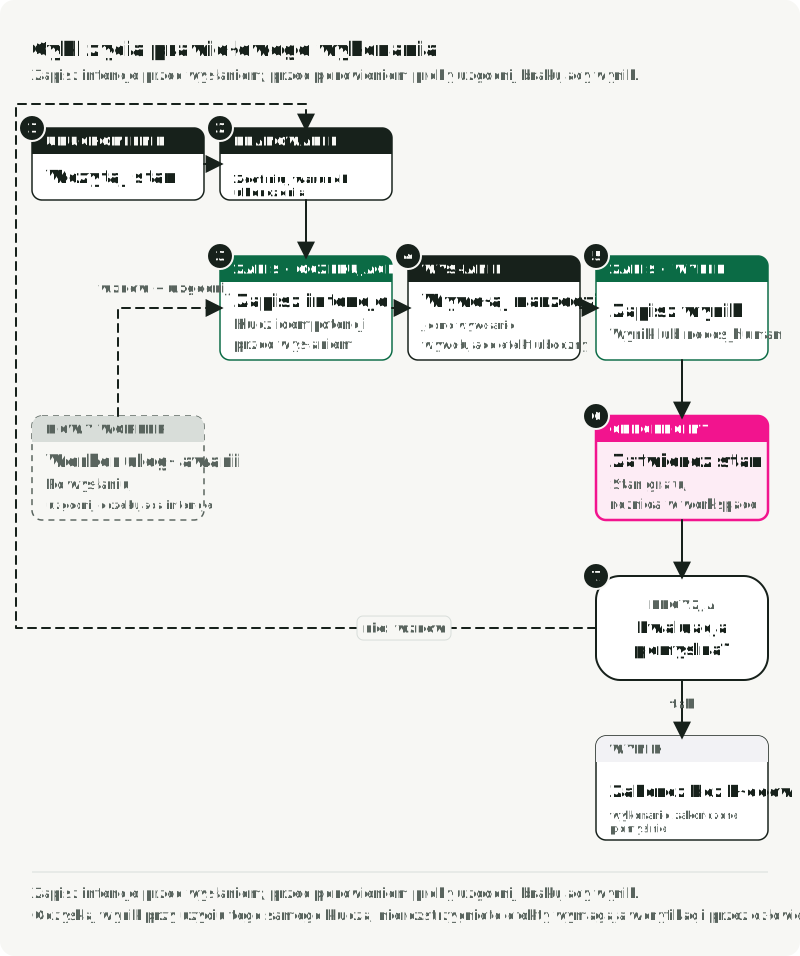
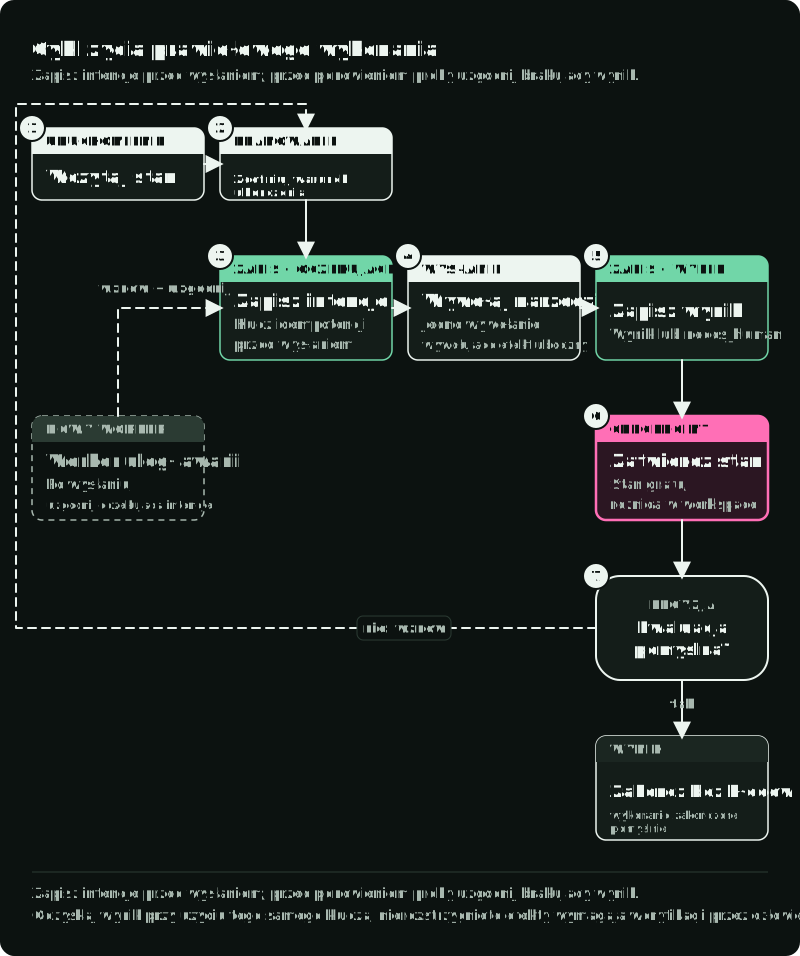
Diff workspace na diagramie to możliwa do odzyskania wersja pliku lub odwołanie do niej; checkpoint grafu nie musi zawierać samych plików.
Przypadek, pod który trzeba projektować, to awaria między zewnętrznym sukcesem a lokalnym zapisem wyniku. Żadna transakcja bazy danych nie zatwierdzi atomowo zapisu w niepowiązanej usłudze bez współpracy tej usługi. Opis idempotentnych API od AWS wyjaśnia, dlaczego ID żądania dostarczone przez wywołującego reprezentuje intencję: dwa identyczne żądania mogą być dwiema zamierzonymi akcjami, a dwa ponowienia z jednym ID powinny reprezentować jedną. Usługa odbierająca musi przestrzegać tego kontraktu i wykrywać zmieniony payload pod tym samym ID. Sprawdź jej okres deduplikacji; wygasły klucz nie jest trwałą obietnicą. Stripe na przykład zwraca pierwszy wynik dla powtórzonego klucza idempotencji i może usuwać klucze po co najmniej 24 godzinach.
Ten sam protokół dotyczy wysłania e-maila, obciążenia konta, otwarcia pull requesta lub zmiany bazy danych należącej do innej usługi. Metoda uzgadniania jest różna. Dostawca może na przykład obsługiwać klucze idempotencji, unikalne ograniczenie zasobu, sprawdzenie read-after-write albo nie oferować żadnego wiarygodnego zapytania. Projektuj politykę ponowień na podstawie tego kontraktu, a nie na podstawie tego, że framework agenta potrafi powtórzyć węzeł.
Spraw, by reszta uruchomienia dała się odzyskać
Niepewne wywołanie zewnętrzne to najtrudniejszy przypadek. Otaczające je uruchomienie nadal potrzebuje kilku jawnych zasad:
- Jeden aktywny proces zapisujący. Kolejka może ponownie dostarczyć pracę po wygaśnięciu lease. Użyj lease uruchomienia z fencingiem lub warunkowymi aktualizacjami statusu, aby nieaktualny worker nie mógł posunąć uruchomienia naprzód. Zachowaj ochronę idempotencji dla wywołań, które już są w toku. Potwierdzaj zadanie dopiero wtedy, gdy stan, który ono reprezentuje, jest trwały. Odzyskiwanie zaczyna się od sprawdzenia oczekujących operacji, a nie od ślepego restartu modelu. Zdecyduj, co oznacza nowe wejście użytkownika w trakcie uruchomienia: odrzucenie, dodanie do kolejki, przerwanie lub wycofanie; opis środowiska uruchomieniowego Deep Agents od LangChain przedstawia te warianty.
- Trwałe oczekiwanie. Jeśli publikacja wymaga zatwierdzenia, zapisz trwale proponowaną akcję i jej dokładne argumenty. Wznów z decyzją o zatwierdzeniu i sprawdź ją ponownie, jeśli proponowana akcja się zmieni. Nie trzymaj otwartego procesu workera tylko po to, by czekać na człowieka.
- Ograniczone uruchomienie. Zapisz trwale termin, limity wywołań lub narzędzi i dopuszczalne wydatki. Rezerwuj budżet przed współbieżnym wysłaniem, aby dwa wywołania nie mogły wydać tej samej reszty; faktyczne zużycie uzgadniaj później. Anulowanie zatrzymuje nowe wywołania i zapisuje żądanie, ale nie cofnie efektu zewnętrznego, który jest w toku. Alert z metryk lub budżet po stronie dostawcy, taki jak beta task budgets od Anthropic, to drugi sygnał; model może przekroczyć budżet doradczy, więc w każdym przypadku prowadź rejestr wysłań.
- Praca możliwa do przywrócenia. Przechowuj odwołanie do zatwierdzonego artefaktu, jego hash i wersję workspace, która go wytworzyła. Przywrócony proces powinien móc zweryfikować plik przed publikacją. Duże pliki należą do magazynu artefaktów, a nie do każdego checkpointu grafu.
- Granica wykonania. Jeśli narzędzie uruchamia wygenerowany kod, instaluje pakiety lub przegląda niezaufane strony, uruchamiaj je w środowisku z wymaganymi ograniczeniami plików, sieci i procesów. Trzymaj długotrwałe poświadczenia poza kontekstem widocznym dla modelu; egzekwuj uprawnienia tam, gdzie akcja jest wykonywana. Sam kontener lub checkout per worktree nie zapewnia izolacji, której może wymagać twój model zagrożeń.
W LangGraph wybierz trwałość checkpointów świadomie. Jego tryb "sync" zapisuje trwale każdy checkpoint przed rozpoczęciem kolejnego kroku; "async" może utracić ostatni checkpoint przy awarii procesu, a "exit" nie zapisuje pośredniego postępu na wypadek awarii w trakcie uruchomienia. Nawet "sync" nie zamyka opisanej wyżej luki efektów zewnętrznych. Log zdarzeń i logika uzgadniania pozostają pracą aplikacji.
Awarie, które dodają długie uruchomienia
Gdy uruchomienia przechodzą między workerami i oknami kontekstu, awarie przesuwają się w stronę stanu, zduplikowanych efektów ubocznych, rozjazdu workspace i kosztów. Każda z nich wymaga kontroli poza pamięcią modelu, aby działała także po restarcie. Rysunek umieszcza każdą kontrolę w kroku pętli uruchomienia, w którym działa; tabela dodaje, gdzie jest zaimplementowana.
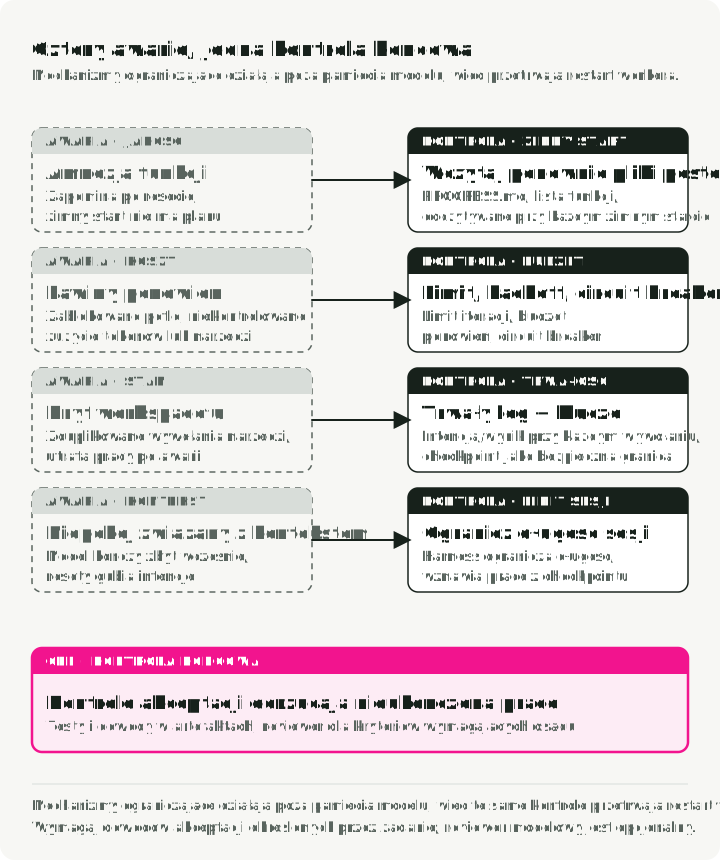
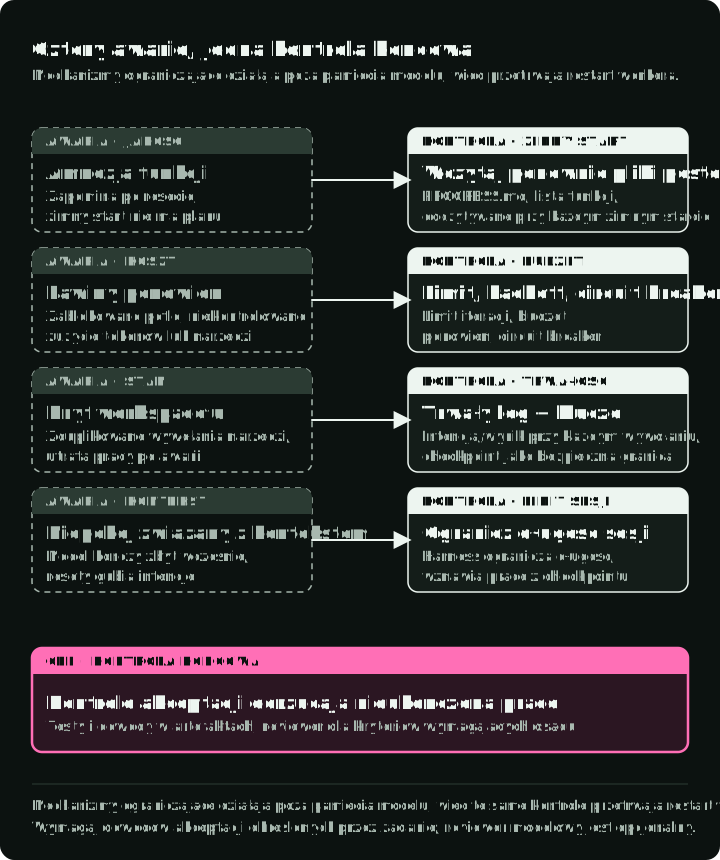
| Awaria | Kontrola | Gdzie działa |
|---|---|---|
| Agent zbyt wcześnie ogłasza zakończenie zadania | Kontrole akceptacyjne artefaktów; opcjonalny ewaluator ze świeżym kontekstem, bez narzędzi zapisu | Krok zakończenia w harnessie; ewaluator we własnej sesji sandboxa |
| Agent zapomina ukończoną pracę po resecie kontekstu | Pliki postępu, takie jak PROGRESS.md i feature-list.json, odczytywane przed pierwszym wywołaniem modelu | Hook startowy każdej sesji modelu |
| Model podsumowuje i przerywa zbyt wcześnie w pobliżu limitu | Ograniczenie długości sesji i rozpoczęcie nowej od handoffu i checkpointu | Limit długości sesji w harnessie |
| Zapętlenia i ponowienia bez limitu | Limit iteracji, wykładniczy backoff, circuit breaker na odsetku błędów narzędzi, twardy budżet wywołań narzędzi | Węzeł wykonywania narzędzi; RetryPolicy w Activities Temporal |
| Agent edytuje pliki należące do innego uruchomienia | Workspace per uruchomienie, commity Git jako punkty odzyskiwania, polityka plików w sandboxie lub proxy narzędzi | Polityka sandboxa; uprawnienia Deep Agents dla wbudowanych narzędzi |
| Wydatki na tokeny lub narzędzia wymykają się spod kontroli | Rezerwacja budżetu przed wysłaniem, ograniczenie wyjścia, uzgadnianie zużycia | Rejestr budżetu na ścieżce wysyłania; alerty Prometheus jako drugi sygnał |
| Wywołanie narzędzia wykonuje się dwa razy po awarii | Trwały zapis pending i klucza idempotencji przed wysłaniem; zapytanie lub ponowienie z tym samym kluczem po wznowieniu | Magazyn zdarzeń plus API idempotencji lub sprawdzania u dostawcy |
| Praca ginie, gdy worker lub sandbox przestaje działać | Trwały log zdarzeń, checkpoint po każdym super-stepie, uzgodnienie oczekujących efektów przed kontynuacją | PostgresSaver plus tabela zdarzeń albo Temporal Workflow |
Quick-start cwc-long-running-agents od Anthropic zawiera wzorce ewaluatora i plików postępu. Przedwczesne zatrzymywanie się w pobliżu limitu kontekstu zależy od modelu, więc testuj każde obejście ponownie, gdy model się zmieni. Jak ujmuje to Anthropic, każdy komponent harnessa koduje założenie o tym, czego model nie potrafi, a to założenie może się zdezaktualizować, gdy model się zmieni.
Awarie transportu, które pętla musi wchłonąć
Strumień może zamknąć się w połowie odpowiedzi. Połączenie może się zerwać, gdy dotarła dopiero połowa odpowiedzi albo połowa wywołania narzędzia. Argumenty narzędzia przychodzą jako fragmenty danych JSON, które da się sparsować dopiero po zakończeniu bloku, więc częściowo złożone wywołanie nigdy nie może trafić do wysyłki (dispatch). Wykonanie ściętego polecenia to dokładnie to, czemu ma zapobiegać warstwa uprawnień. Traktuj zerwany strumień jak nieudane żądanie: odrzuć fragment, nigdy nie dołączaj go jako czegoś, co powiedział model, i ponów całe wywołanie. Stać na to, ponieważ prefiks wysłany wcześniej jest przy ponowieniu odczytem z cache. Trzymaj ponawianie poniżej pętli agenta, w opakowaniu wywołania, aby ponowione żądanie nigdy nie uruchomiło ponownie narzędzia, które już się wykonało.
Streaming przestaje też być opcjonalny, gdy żądania rosną. Dostawcy egzekwują timeouty dla żądań bez streamingu i wymagają streamingu powyżej określonych rozmiarów wyjścia, a SDK mogą przy długich wywołaniach streamować pod spodem. Dlatego produkcyjne środowisko uruchomieniowe zwykle streamuje wszystko i akumuluje wynik, nawet gdy żaden interfejs nie potrzebuje fragmentów. Napływające tokeny pełnią wtedy także rolę sygnału życia: dopóki napływają, wywołanie żyje, więc strumień, który milczy od minuty, świadczy o zawieszeniu. Żądanie bez streamingu nie mówi nic, dopóki nie wróci.
Limity szybkości są mierzone w tokenach, a nie w żądaniach. Dostawcy mierzą tokeny wejściowe i wyjściowe na minutę, więc agent niosący duże żądanie wyczerpuje limit przy częstotliwości żądań, która wygląda na śmiesznie niską. Wzrost kontekstu objawia się zatem jako odpowiedzi 429, a nie jako problem z latencją, a równoległy fan-out mnoży nacisk przez rozmiar każdego żądania, a nie przez liczbę workerów. Ogranicz współbieżność i współdziel jeden budżet tokenów w komponencie, który uruchamia pracę równoległą; backoff wewnątrz każdego workera tylko rozkłada to samo zapotrzebowanie w czasie. Zliczaj odpowiedzi 429 i użyty endpoint w każdym uruchomieniu, aby limit dostawcy nie został wzięty za cechę testowanej konfiguracji.
Środowisko uruchomieniowe potrzebuje też dowodów do diagnozy uruchomienia. Emituj ID uruchomienia i ID operacji wraz ze spanami modelu i narzędzi, statusem, czasem trwania i zużyciem tokenów. Konwencje GenAI w OpenTelemetry nadają tym polom wspólne nazwy, choć konwencje wciąż się rozwijają. Tekst promptu, argumenty narzędzi i wyniki mogą zawierać wrażliwe dane; zanim je przechwycisz, zdecyduj, czy należą do telemetrii. Trace pomaga wyjaśnić awarię. Log zdarzeń i zewnętrzne sprawdzenie rozstrzygają, czy kontynuacja jest bezpieczna. Sekcja o observability poniżej zamienia to w konkretny stos.
Wybierz kształt wdrożenia na podstawie zasad oczekiwania i awarii
Nazwa platformy to późny wybór. Najpierw zapytaj, czy wywołujący potrzebuje końcowego wyniku w tym samym żądaniu, czy uruchomienie może czekać i kto będzie obsługiwał jego trwały stan.
| Potrzeba | Kształt początkowy | Czego nadal potrzebuje |
|---|---|---|
| Krótkie zadanie kończone w ramach jednego żądania | Pętla agenta w handlerze żądań | Osobnej granicy wykonania dla niezaufanych narzędzi; trwałego stanu, jeśli liczy się ponowienie lub kontynuacja |
| Praca w tle, która może przetrwać jednego workera | Kolejka, wymienny worker, trwały stan | Lease uruchomień, checkpointów, logu operacji, w razie potrzeby magazynu artefaktów |
| Wiele zatwierdzeń, timerów, callbacków lub ponowień przez wdrożenia | Trwały silnik workflow z workerami dla wywołań modelu i narzędzi | Zmian workflow bezpiecznych dla odtwarzania i idempotentnych zewnętrznych activities |
Długość uruchomienia to użyteczny pierwszy filtr, choć nie rozstrzyga całego projektu. Rysunek umieszcza każdy kształt początkowy na skali logarytmicznej długości uruchomienia, nad limitami czasu popularnych platform:
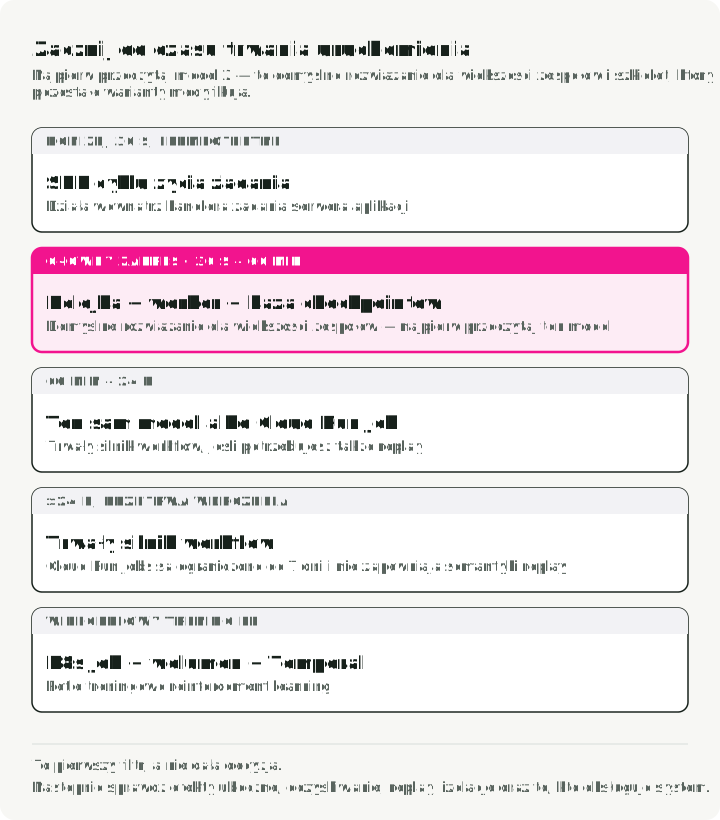
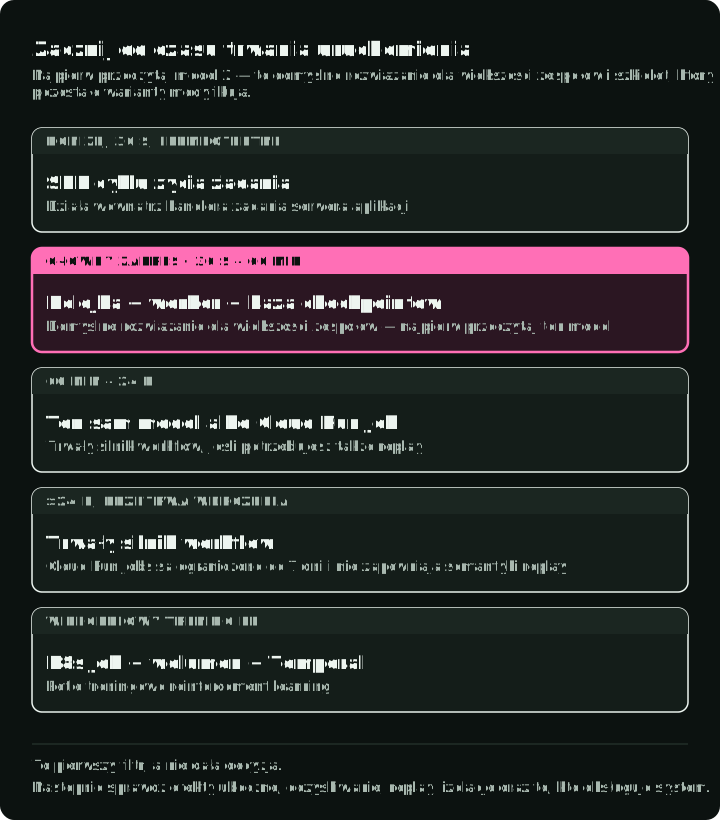
- Poniżej 30 sekund, idempotentnie: SDK agenta w handlerze żądań serwera aplikacji.
- Od 30 sekund do 60 minut: kolejka, worker i baza checkpointów.
- Od 60 minut do 24 godzin: ta sama kolejka i worker albo Cloud Run Job dla jednorazowej pracy; silnik workflow, jeśli potrzebujesz też wersjonowania i odtwarzania.
- Ponad 24 godziny, z przetrwaniem wdrożeń: trwały silnik workflow, taki jak Temporal.
- Wielodniowe pętle treningowe uczenia ze wzmocnieniem: Kubernetes Job z wolumenem plus Temporal.
Po tym filtrze sprawdź efekty uboczne, odzyskiwanie, odtwarzanie, izolację, lokalizację danych i zespół, który będzie obsługiwał system.
Przykład z raportem zacząłbym od kolejki i workera. API zwraca ID uruchomienia; worker prowadzi harness naprzód; trwały magazyn zapisuje checkpointy i oczekujące operacje; magazyn artefaktów przechowuje raport. Taki projekt spełnia konkretne wymagania dotyczące restartu i zatwierdzenia bez zakładania konkretnej chmury. Jeśli zasady oczekiwania i ponowień same staną się workflow, Temporal może trwale zapisywać historię wykonania i odtwarzać decyzje workflow. Jego Activities nadal wykonują wywołania zewnętrzne i mogą być ponawiane, więc wymagają tego samego projektu idempotencji lub uzgadniania.
Usługi chmurowe implementują te kształty; ich timeouty nie definiują architektury. Żądanie do usługi Cloud Run ma termin i może być dalej przetwarzane po zamknięciu połączenia, więc timeout HTTP jest szczególnie słabym dowodem, że akcja się zatrzymała. Cloud Run Job, zadanie ECS lub Kubernetes Job mogą hostować workera w tle, ale sam długi limit zadania nie daje mu trwałego postępu. Zwykłe wywołanie AWS Lambda ma limit 15 minut; workflow może obejmować ograniczone wywołania. Przed wdrożeniem sprawdź aktualne limity i zachowanie ponowień wybranej usługi.
Hostowana platforma agentów może obsługiwać pętlę i część jej stanu za ciebie. Oceń ją tym samym ćwiczeniem awarii: jak eksportujesz stan uruchomienia, znajdujesz oczekujący efekt uboczny, wiążesz zatwierdzenie z akcją, sprawdzasz dane wysyłane do control plane i wznawiasz po wdrożeniu? Oddziel kontrakt sandboxa platformy od kontraktu jej harnessa. Hostowanie harnessa nie czyni automatycznie jego narzędzi bezpiecznymi, a hostowanie sandboxa nie czyni automatycznie uruchomienia trwałym.
Co daje każdy kształt
Macierz podaje komponent, który zapewnia każdą odpowiedzialność w każdym kształcie, oznacza komórki obsługiwane przez hostowanego dostawcę i wyróżnia komórki, które same nie wystarczają. Uwagi pod nią podają limity, które rozstrzygają między nimi, sprawdzone we wrześniu 2026.
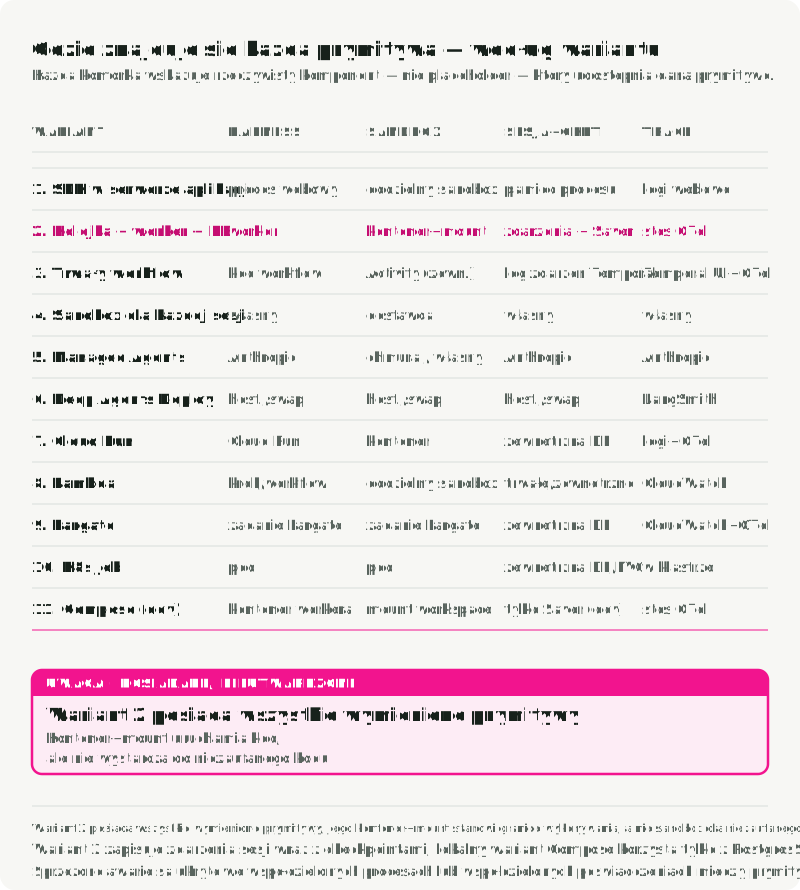
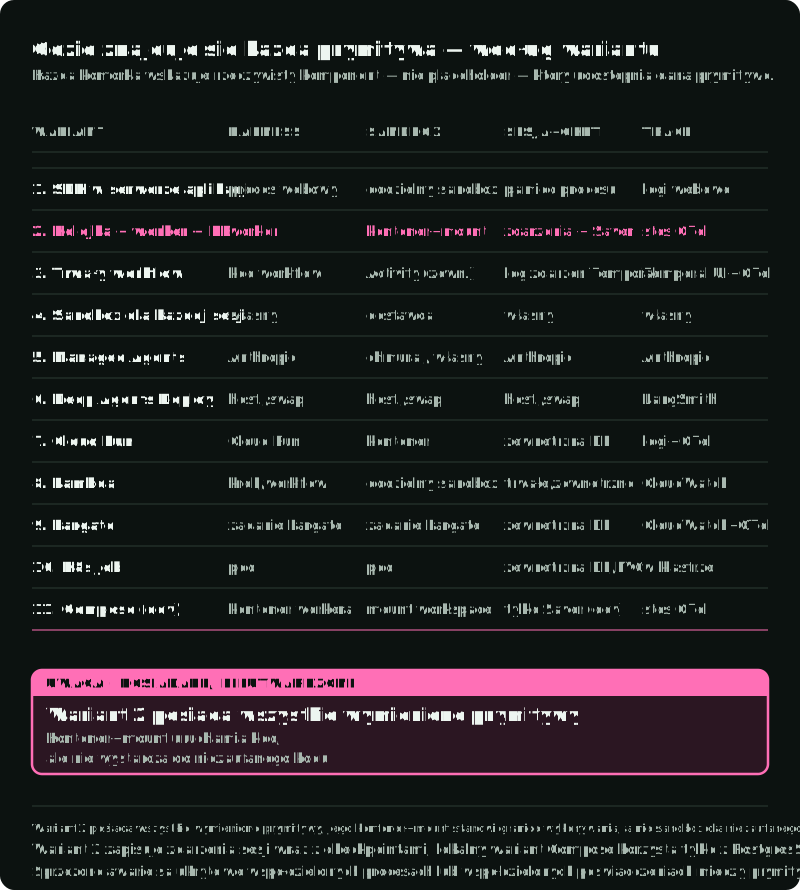
1. SDK w serwerze aplikacji. Agent działa w handlerze żądań. Pasuje do zadań krótszych niż około 30 sekund, demonstracji i narzędzi wewnętrznych. Awaria warstwy webowej powoduje utratę pracy z pamięci procesu. Rozłączenie klienta może anulować pracę albo pozostawić ją w toku, zależnie od serwera i aplikacji; nie rozstrzyga wyniku zewnętrznej akcji. Zapisuj stan trwale, jeśli kontynuacja ma znaczenie, i nie używaj handlera żądań do pracy trwającej wiele godzin.
2. Kolejka, worker i baza checkpointów. Domyślny wybór, który polecam większości zespołów: worker w Pythonie z checkpointerem PostgreSQL oraz Redis Streams lub RabbitMQ dla przychodzących zadań. Market Analyst Agent demonstruje ten układ z osobno uruchamianym workerem kolejki. W projekcie produkcyjnym aplikacja tworzy wiersz uruchomienia, wysyła zadanie do kolejki i zwraca ID uruchomienia; worker uruchamia harness, zapisuje zdarzenia i checkpointy oraz przechowuje artefakty. Głębokość kolejki daje backpressure, a zasoby obliczeniowe typu spot lub preemptible działają, jeśli trwałe zapisy kończą się, zanim worker potwierdzi zadanie. Worker jest harnessem; niezaufany kod nadal potrzebuje utwardzonego sandboxa.
3. Trwały silnik workflow. Orkiestracja agenta działa w Temporal Workflow, a wywołania modelu i narzędzi działają jako Activities. Stan workflow znajduje się w historii zdarzeń przechowywanej w Cassandrze, MySQL lub PostgreSQL, więc jest odtwarzany po awariach, a bezczynny workflow nie zużywa mocy obliczeniowej. Zatwierdzenie przez człowieka staje się trwałym oczekiwaniem zamiast pętli odpytywania. Zmiany kodu, które nakładają się na trwające wykonanie, wymagają bezpiecznego dla odtwarzania Worker Versioning lub patchy. Integracja Temporal z OpenAI Agents SDK uruchamia narzędzia agenta jako Activities; zanim na niej zaczniesz polegać, sprawdź listę nieobsługiwanych funkcji agenta.
4. Dostawca sandboxa na każde uruchomienie. Każde uruchomienie dostaje własną microVM lub własny kontener od dostawcy, a harness, sesja, checkpoint i trace pozostają po twojej stronie, zwykle w kształcie 2. Używaj go, gdy agent uruchamia niezaufany kod, automatyzację przeglądarki, testy lub instalacje pakietów; kosztem są wyższe wydatki i uzależnienie od dostawcy.
| Dostawca | Izolacja | Limity sesji i trwałości |
|---|---|---|
| E2B | Firecracker microVM | Ciągłe sesje 1 h w Hobby, 24 h w Pro; wstrzymanie i wznowienie osobno |
| Vercel Sandbox | Firecracker microVM | 45 min w Hobby, 24 h w Pro i Enterprise; snapshoty domyślnie wygasają 30 dni po ostatnim użyciu |
| Daytona | Sandbox konfigurowany przez dostawcę | Konfigurowalny cykl życia zatrzymania i archiwizacji; forki zapisują swojego rodzica |
| Modal | gVisor | Domyślnie 5 min, maksymalnie 24 h; wolumeny i snapshoty mają osobne zasady trwałości |
| Runloop | microVM, według opisu w Marketplace | Wstrzymanie i wznowienie; snapshoty dysku i gałęzie |
Czasy startu podawane przez dostawców mierzą różne przedziały, więc nie są rankingiem szybkości. Rozruch kontenera Modal w około jedną sekundę na przykład nie obejmuje startu aplikacji. Mierz czas od żądania API do pierwszego udanego polecenia oraz do stanu gotowości aplikacji, na potrzebnych ci percentylach p95 i p99, i sprawdź limity współbieżności konta przed testami obciążeniowymi.
5. Anthropic Managed Agents. Hostowana sesja, harness, sandbox i proxy MCP oparte na vaulcie, w publicznej becie od 8 kwietnia 2026. Rozliczenie to standardowe stawki za tokeny plus $0.08 za godzinę sesji, gdy sesja działa; czas bezczynności jest darmowy, a sesje nie mają trybu wsadowego. Sesja działająca bez przerwy kosztuje około $58 miesięcznie bez tokenów. Nie jest dostępna przez Bedrock ani Vertex AI. Z samodzielnie hostowanymi sandboxami obsługujesz wykonanie i ruch wychodzący, ale wejścia i wyniki narzędzi nadal trafiają do control plane Anthropic. Późniejsze odejście oznacza przeniesienie na inną platformę.
6. LangChain Deep Agents Deploy. deepagents deploy pakuje deepagents.toml do LangSmith Deployment z trwałym wykonaniem, pamięcią, human-in-the-loop, kodem w sandboxie i uruchomieniami według harmonogramu, w trybie chmurowym, hybrydowym lub self-hosted. Dostawca sandboxa (LangSmith Sandboxes, Daytona, Modal, Runloop lub własny) to jedna wartość w konfiguracji. Harness ma licencję MIT i używa otwartego formatu AGENTS.md, więc uzależnienie od dostawcy jest mniejsze niż w kształcie 5.
7. Google Cloud Run. Usługa obsługuje HTTP i skaluje się do zera; timeout żądania wynosi domyślnie 300 sekund, maksymalnie 60 minut. Job działa do zakończenia bez HTTP; zadania mają domyślnie 10 minut i maksymalnie 168 godzin (7 dni) albo 1 godzinę z GPU. Używaj usługi dla synchronicznych uruchomień do 60 minut, a joba dla dłuższej jednorazowej pracy. Żadne z nich nie zachowuje stanu między uruchomieniami ani nie odtwarza go po wdrożeniach, więc sesje i checkpointy trafiają do PostgreSQL, Spanner lub podobnego magazynu.
8. AWS Lambda. Funkcja kończy się timeoutem po 15 minutach. Za API Gateway synchroniczne żądanie dostaje około 30 sekund, chyba że regionalne lub prywatne REST API podniesie ten limit. Lambda durable functions, uruchomione w grudniu 2025, dodają checkpointy, kroki i oczekiwania w wykonaniach trwających do jednego roku, przy czym każde wywołanie pozostaje ograniczone.
9. AWS ECS lub Fargate, jedno zadanie na uruchomienie. Fargate nie ma udokumentowanego limitu czasu działania i daje każdemu zadaniu własny interfejs sieciowy w trybie awsvpc, co pasuje do dostępu do danych wewnątrz VPC. Nie obsługuje GPU; do tego używaj ECS opartego na EC2. Fargate Spot dodaje ryzyko przerwania, a trwałość jest twoim zadaniem. Porównaj też Amazon Bedrock AgentCore Runtime, który hostuje kod agenta z zarządzanymi sesjami do 8 godzin na bezserwerowych microVM lub do 14 dni na typie obliczeniowym Instances, który obsługuje GPU.
10. Kubernetes Job na każde uruchomienie. Jeden Job na uruchomienie z activeDeadlineSeconds, PersistentVolumeClaim na workspace i sidecarem MCP. Pasuje do zespołów, które już obsługują Kubernetes; cold starty wykluczają go przy wymaganym starcie poniżej sekundy, a odzyskiwanie po awarii musisz zbudować sam. Silna izolacja nadal zależy od runtime class, network policy i pod security. Wykonanie na GPU wymaga węzłów GPU, sterowników i device plugina.
11. Lokalny Docker Compose, tylko do rozwoju aplikacji. Projekt towarzyszący uruchamia aplikację Gradio i magazyny z układu 2, z wolumenem workspace i bez utwardzonego sandboxa. Worker kolejki uruchamia się osobno. Poniższy stos referencyjny rozróżnia te procesy.
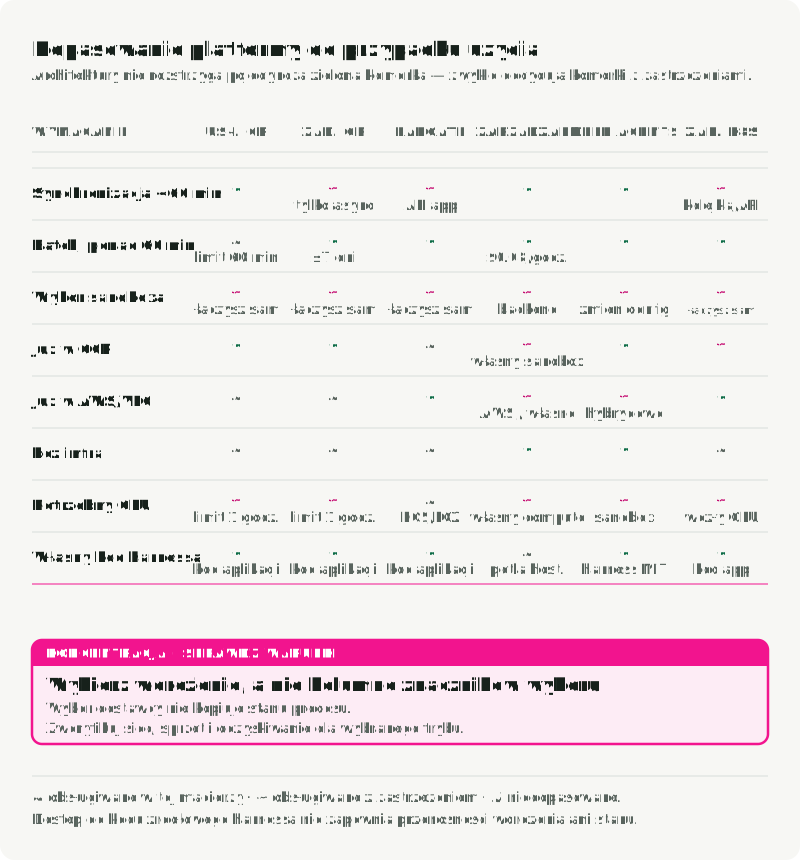
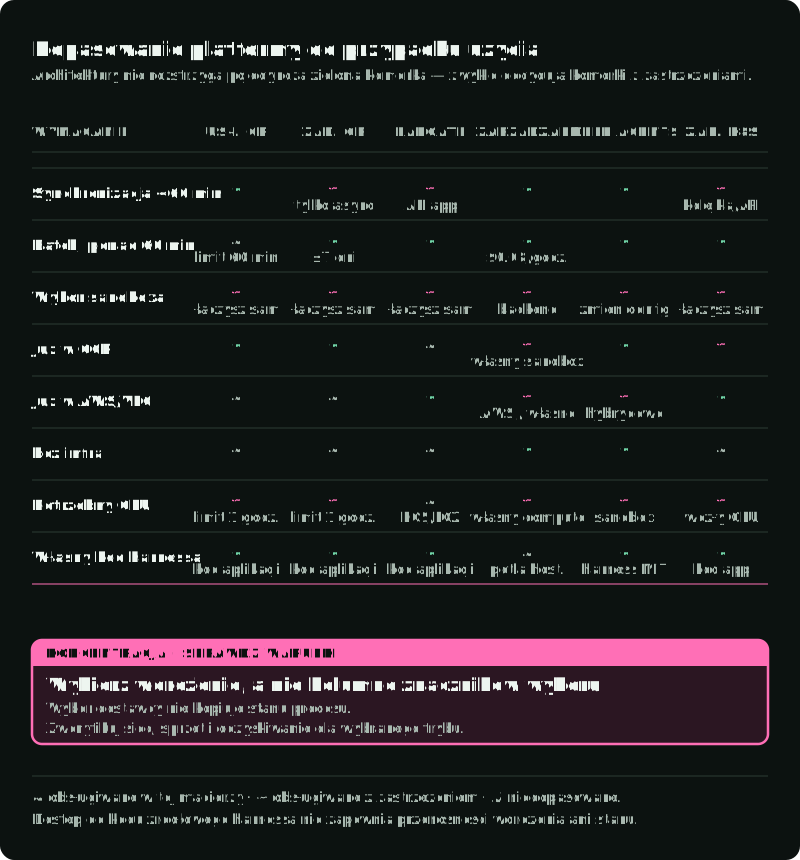
W macierzy o wyborze zwykle decydują komórki oznaczone zastrzeżeniem, a nie znaczniki wyboru. Szerokie pokrycie nie pokazuje rezydencji danych, semantyki odtwarzania, zależności od dostawcy ani kosztu późniejszego przenoszenia stanu.
Harness hostowany czy własny. Hostowany oznacza, że dostawca uruchamia pętlę, a ty wywołujesz API; własny oznacza, że to ty uruchamiasz pętlę, nawet jeśli kod pochodzi od dostawcy. LangChain jest po obu stronach: LangGraph to biblioteka, którą uruchamiasz sam, a Deep Agents Deploy w trybie chmurowym uruchamia harness za ciebie. Wybierz hostowany, gdy jego obsługa modeli, granica danych, zachowanie przy odzyskiwaniu i punkty rozszerzeń już pasują. Wybierz własny, gdy spodziewasz się zmiany tych wymagań, i przetestuj ścieżkę wyjścia, zanim dane produkcyjne zaczną od niej zależeć.
Hostowany sandbox czy własne środowisko wykonawcze. Wybierz hostowany sandbox, gdy jego izolacja, wstrzymywanie i wznawianie lub forkowanie pasują do modelu zagrożeń i budżetu czasu startu. Docker lub Fargate mogą pasować do zaufanej pracy wewnętrznej, która wymaga dostępu do VPC lub ścisłej rezydencji danych, ale standardowy kontener nie wystarczy dla wrogiego kodu; Część 4 omawia opcje izolacji.
Umieść granicę stanu w aplikacji LangGraph
Poniższy fragment pokazuje tylko część kształtu kolejki i workera związaną ze stanem grafu. Zakłada, że builder to istniejący StateGraph, run_id to trwały identyfikator uruchomienia, a task to nowe żądanie. Worker ma połączenie PostgreSQL w DATABASE_URL i uprawnienie do tworzenia tabel checkpointera. To ilustracyjne połączenie elementów, a nie kompletny worker publikujący.
import os

from langgraph.checkpoint.postgres import PostgresSaver

with PostgresSaver.from_conn_string(os.environ["DATABASE_URL"]) as checkpointer:
    checkpointer.setup()  # once during setup or migration
    graph = builder.compile(checkpointer=checkpointer)
    graph.invoke(
        {"messages": [{"role": "user", "content": task}]},
        {"configurable": {"thread_id": run_id}},
        durability="sync",
    )
thread_id to klucz wyszukiwania checkpointów w LangGraph, a nie ID operacji ani dowód, że publikacja nastąpiła. Aplikacja nadal musi trwale zapisać wiersz uruchomienia, zatwierdzony artefakt, oczekującą operację i jej wynik. Musi też odzyskiwać przerwane zadania i decydować, co oznacza nowe wejście, gdy uruchomienie jest aktywne. Nie wznawiaj niepewnego węzła publikacji przez zwykłe ponowne wywołanie. Najpierw uzgodnij stan, a potem przekaż odzyskany wynik do grafu.
Git, baza checkpointów i magazyn obiektów
Długie uruchomienia zwykle używają jednocześnie trzech magazynów, bo każdy przechowuje inny artefakt.
- Git przechowuje workspace: kod, dokumenty i pliki postępu. Używaj go, gdy praca ma postać kodu lub liczy się historia plików. Utwórz gałąź uruchomienia, zrób commit inicjalizujący i commituj po przygotowaniu, po każdej funkcji i po przejściu testów. Przechowuj SHA ostatniego commita obok checkpointu. Przy wznowieniu kolejny worker przełącza się na gałąź, odczytuje
git log --oneline -8, sprawdzagit statusi ostatni diff, a potem odczytuje plik handoffu. Git nie powie, który węzeł grafu działa następny, które wywołanie czeka na zatwierdzenie ani które ponowienie użyło swojego klucza idempotencji. Pomiń go, gdy produktem jest pojedyncza odpowiedź. - Baza checkpointów przechowuje stan grafu: co zdecydowano, które węzły się wykonały i co działa następne. Używaj checkpointów w stylu
PostgresSaver, gdy liczy się stan pośredni między węzłami, takimi jak planner, researcher, writer i verifier. - Magazyn obiektów, taki jak S3 lub GCS, przechowuje duże wyniki: pliki PDF, pliki Parquet, zrzuty ekranu. Używaj go, gdy wynik jest za duży dla bazy checkpointów, gdy odbiorcy potrzebują URL bez przechodzenia przez agenta albo gdy produkt końcowy i uruchomienie mają różny okres przechowywania. Możesz usuwać logi uruchomień po 30 dniach, a końcowy raport trzymać latami. Nadawaj obiektom klucze
(thread_id, checkpoint_id, artifact_name), aby uruchomienie, które je wytworzyło, dało się prześledzić.
Stos referencyjny w Docker Compose
Market Analyst Agent to projekt edukacyjny towarzyszący tej serii. Z katalogu głównego repozytorium, przy dostępnym Docker Compose i .env przygotowanym na podstawie .env.example, make docker-up używa docker/docker-compose.yml do uruchomienia PostgreSQL, Qdrant, Redis i aplikacji. Domyślne polecenie aplikacji uruchamia interfejs Gradio, który wywołuje harness synchronicznie. make worker osobno uruchamia konsumenta kolejki Redis; wymaga uv i Python 3.13+, instaluje zależności projektu i uruchamia bazy danych. Przed analizą na żywo skonfiguruj klucze dostawców w .env. make mcp-up i make observability-up włączają opcjonalne profile MCP i observability.
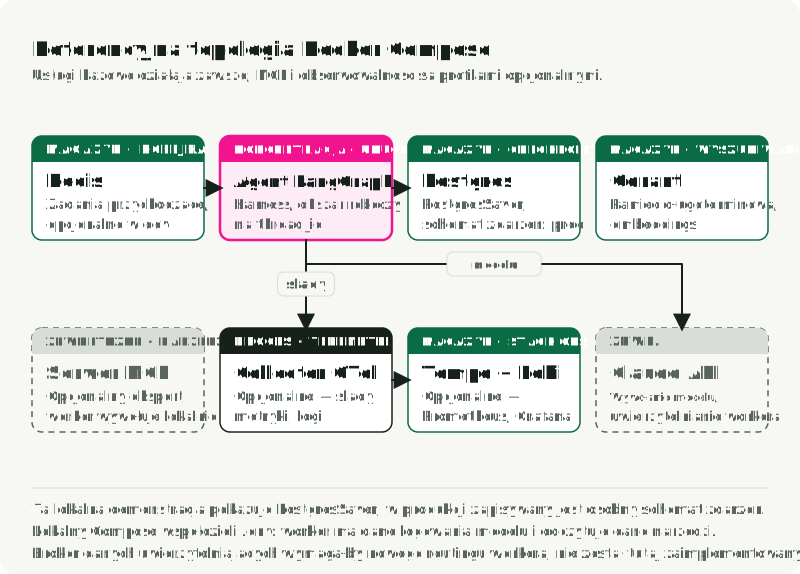
Skonfigurowane trasy observability są niekompletne. Collector ma tylko pipeline śladów do Tempo. Jego filtr uwzględniający strict porównuje gen_ai.operation.name z literałem .+, więc zwykłe wartości, takie jak chat i execute_tool, nie pasują i są wykluczane; matcher Collectora 0.117.0 potwierdza porównanie równości. Prometheus bezpośrednio pobiera metryki z app:9464 oraz własne metryki Collectora; metryki aplikacji wymagają METRICS_ENABLED=true. Eksport śladów aplikacji wymaga też endpointu OTLP. Loki ma backend i źródło danych Grafana, ale nie ma skonfigurowanego wejścia logów. Popraw filtr śladów i dodaj odbiór logów, zanim zaczniesz oczekiwać śladów i logów z danymi; uruchomienie kontenera nie dowodzi działania dashboardów.
Dla kontenera workera dodaj jawny serwis workera i udostępnij współbieżnym procesom zapisującym ten sam wolumen workspace; domyślna aplikacja Compose nie jest konsumentem kolejki. W produkcji dodaj obok checkpointów tabelę zdarzeń dla intencji i wyników narzędzi oraz przetestuj uzgadnianie własnych akcji zewnętrznych.
Odczytaj uruchomienie po jego zakończeniu
Gdy sześciogodzinne uruchomienie zawodzi, zdarzenie, które to spowodowało, mogło nastąpić wiele godzin wcześniej, a worker, który je wytworzył, został już zastąpiony. Debugujesz na podstawie zapisów utworzonych, gdy uruchomienie trwało. Dwa odczytuje się po uruchomieniu: przeszukiwalny log zdarzeń każdego kroku i trace’y pokazujące, na co poszły czas i tokeny. Dwa odczytuje się w trakcie uruchomienia: bieżący widok zmian w workspace i stos observability per worktree, o który może pytać sam agent.
Żaden z zapisów czytanych po uruchomieniu nie musi zawierać żądania w takiej postaci, w jakiej ostatecznie opuściło proces, czyli po złożeniu instrukcji, wyszukiwaniu, kompakcji i przejściu przez middleware. Wpis w logu zdarzeń i span opisują, że wywołanie modelu się odbyło i ile kosztowało. Gdy pytanie brzmi, co model otrzymał, potrzebne jest osobne przechwycenie, wykonane w ostatnim punkcie przed wysłaniem wywołania i przechowywane tam, gdzie później sięgniesz po odpowiedź na to pytanie.
Log zdarzeń. Każde wywołanie modelu, wywołanie narzędzia, wynik, błąd i zatwierdzenie, z kluczem ID uruchomienia i znacznikiem czasu, z możliwością zapytań jak w każdej tabeli. Addy Osmani formułuje test: jeśli nie potrafisz odtworzyć z trwałego magazynu, co agent robił przez ostatnie 24 godziny, masz skrypt powłoki wywołujący model, a nie długotrwałego agenta.
Trace’y OpenTelemetry GenAI. Spany zawierają standardowe atrybuty gen_ai.*: model, dostawcę, liczby tokenów, ID konwersacji i nazwę workflow. Konwencje przeniesiono w 2026 do osobnego repozytorium i nadal mają stabilność Development, więc przypnij zweryfikowaną wersję. Na backendach, które je obsługują, możesz zmieniać miejsca docelowe bez ponownego instrumentowania kodu.
Zmiany w workspace w trakcie uruchomienia. Quick-start Anthropic obserwuje workspace. watch -n 5 'git log --oneline -8' pokazuje najnowsze commity co pięć sekund, a folder zrzutów ekranu posortowany według czasu pokazuje, co agent ostatnio widział. Traktuj oba jako oznaki aktywności i porównuj je z wynikami testów, zanim uznasz, że uruchomienie robi postęp.
Stos per worktree dla agenta. W tekście OpenAI o harnessie każdy worktree Codex dostaje własne krótkotrwałe logi, metryki i trace’y, o które agent pyta podczas pracy. Dzięki temu wymaganie takie jak „żaden span w tych czterech ścieżkach użytkownika nie przekracza dwóch sekund” staje się czymś, co agent może sprawdzić.
Minimalny samodzielnie hostowany stos dla agenta takiego jak Market Analyst Agent:
- OpenTelemetry Collector, który odbiera spany i może filtrować pola
gen_ai.*przed eksportem. - Tempo lub Jaeger dla trace’ów, z kluczem
gen_ai.conversation.idlubthread_id. - Loki dla wpisów logu zdarzeń.
- Prometheus dla metryk tokenów i opóźnień GenAI.
- Grafana z dashboardami opartymi na
gen_ai.agent.nameigen_ai.request.model.
Jeśli wolisz usługę hostowaną, wybierz jedną: LangSmith dla LangGraph i Deep Agents Deploy, Braintrust, gdy na pierwszym miejscu są zestawy ewaluacyjne, Arize Phoenix dla open source OTLP z OpenInference, dashboard tracingu OpenAI dla Agents SDK albo tracing Anthropic dla Managed Agents.
Ustaw standardowe atrybuty na każdym spanie modelu, co najmniej operację, dostawcę, model, ID konwersacji, nazwę agenta i liczby tokenów. Trzy panele dashboardu pokrywają większość debugowania: tokeny wyjściowe na agenta na godzinę, opóźnienie modelu p95 na model i wywołania narzędzi trwające dłużej niż 30 sekund.
Gdy uruchomienie zawiedzie, niech worker zapisze pakiet debugowy do /workspaces/${THREAD_ID}/_debug/:
events.jsonl: wyeksportowany log zdarzeń z intencjami, wynikami, zatwierdzeniami i błędami.checkpoints.jsonl: historia stanu grafu zcheckpointer.list({"configurable": {"thread_id": ...}}), oznaczona jako checkpointy.last_state.json:StateSnapshot.valuesz ostatniego udanego super-stepu.trace.json: wyeksportowane spany uruchomienia, zgodnie z polityką przechwytywania treści.tool_calls.csv:(ts, tool, input_hash, latency_ms, status, error).workspace.tar.zst: workspace plusgit diffwzględem commita inicjalizującego.screenshots/*.png,PROGRESS.md,feature-list.jsoni inne pliki postępu.env.txt: tagi obrazów, wersja modelu i SHA commita harnessa.
Dzięki temu raport może stwierdzić: „uruchomienie s_123 zużyło 71 procent tokenów na powtarzanie trzech poleceń po nieudanym npm install” zamiast „agent się zaciął”.
Testy punktów awarii
Udane uruchomienie bez przerw mówi niewiele o odzyskiwaniu. W przykładzie z raportem wstrzyknij zatrzymanie w trzech punktach: przed zatwierdzeniem oczekującej operacji, po przyjęciu żądania przez usługę publikacji, ale przed zapisaniem wyniku, oraz w czasie, gdy uruchomienie czeka na zatwierdzenie. Zrestartuj ze świeżym workerem i sprawdź liczbę opublikowanych artefaktów, zapisane zatwierdzenie i końcowy status operacji. Środkowy przypadek ujawnia zduplikowane efekty uboczne.
Przetestuj też dwóch workerów przejmujących to samo uruchomienie, anulowanie podczas trwającego wywołania oraz dostawcę, który nie potrafi potwierdzić akcji zakończonej timeoutem. Poprawnym wynikiem ostatniego przypadku może być needs_human, a nie kolejne żądanie. Sprawdź log zdarzeń i trace, aby wyjaśnić każdy wynik. Test odzyskiwania jest kompletny dopiero wtedy, gdy stan zewnętrzny zgadza się z zapisanym stanem uruchomienia.
Zanim długotrwały agent trafi do produkcji, odpowiedz na te pytania w kategoriach infrastruktury:
- Który magazyn jest właścicielem zdarzeń uruchomienia i checkpointów?
- Co się stanie, jeśli worker przestanie działać w połowie wywołania narzędzia?
- Czy jedno uruchomienie może uszkodzić workspace innego uruchomienia?
- Które akcje wymagają zatwierdzenia?
- Czy model lub sandbox mogą odczytać surowe poświadczenia?
- Które wywołania narzędzi można bezpiecznie ponowić?
- Gdzie egzekwowany jest limit kosztu na uruchomienie?
- Które deterministyczne dowody rozstrzygają o zakończeniu, a które kryteria wymagają recenzenta?
- Gdzie znajdują się końcowe wyniki po zniknięciu sandboxa?
- Czy jutro wyjaśnimy nieudane uruchomienie bez ponownego uruchamiania?
Jeśli odpowiedź brzmi „prompt mówi agentowi, żeby był ostrożny”, system nadal jest demonstracją.
To Część 5 serii Engineering the Agentic Stack. Część 6, Harness Engineering dla agentów AI, śledzi pętlę wewnątrz tego środowiska uruchomieniowego: jak autoryzować proponowaną akcję, przekazać pracę do świeżego kontekstu i na podstawie niezależnych dowodów zdecydować, że zadanie jest ukończone.
Źródła
Teksty inżynierskie
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Anthropic Engineering, Scaling Managed Agents: Decoupling the brain from the hands, 8 kwietnia 2026.
- Addy Osmani, Long-running Agents.
Frameworki i SDK
- LangGraph, Checkpointers i
langgraph-checkpoint-postgres. - LangChain, Deep Agents overview, permissions i The runtime behind production Deep Agents.
- OpenAI Agents SDK, Sessions i Sandbox guide.
- Temporal, OpenAI Agents SDK integration i agentic sandboxes.
anthropics/cwc-long-running-agents: wzorce ewaluatora i plików postępu.
Platformy i limity
- Anthropic, Claude platform pricing dla godzin sesji Managed Agents.
- Dostawcy sandboxów: E2B, Vercel Sandbox, Daytona, Modal, Runloop.
- Google Cloud Run, service request timeout i job task timeout.
- AWS, Lambda timeout, Lambda durable functions i Bedrock AgentCore Runtime.
Observability
- OpenTelemetry, Semantic conventions for generative AI, attribute registry i metrics.