Runtime d’AI agent longue durée : sessions et checkpoints

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Un runtime d’agent longue durée permet à une exécution qui utilise des outils de survivre au worker qui l’a lancée. Cet article s’adresse aux ingénieurs qui font passer un agent d’un gestionnaire de requêtes à un traitement en arrière-plan. Vous verrez quel état doit survivre à un redémarrage, pourquoi un checkpoint ne rend pas une action externe sûre à réessayer, et comment ces exigences déterminent la forme du déploiement. L’article compare ensuite des options concrètes : une file d’attente et un worker, Temporal, des fournisseurs de sandboxes, Cloud Run, Lambda, Fargate, Kubernetes et des plateformes d’agents hébergées, avec l’observabilité nécessaire pour déboguer une exécution après son échec.
Le modèle propose toujours l’action suivante. Le harness de la partie 6 fournit le contexte, autorise les outils et vérifie que la tâche est terminée. Le runtime donne à cette boucle un état durable et un endroit où s’exécuter. La partie 4 traite de la décision d’autorisation ; ici, nous suivons une action approuvée à travers un crash et une récupération.
L’état qu’un redémarrage ne doit pas effacer
Imaginons un agent de recherche qui rassemble des sources, rédige un rapport, attend une approbation, puis publie le fichier approuvé. L’exécution peut durer quelques minutes ou plusieurs jours, car l’approbation n’arrive pas à une heure fixe. Un déploiement peut remplacer son worker pendant que l’agent rédige, pendant qu’il attend, ou juste après que le service de publication a accepté le fichier.
La mémoire du worker est jetable. Le rapport approuvé et le fait que la publication a peut-être déjà eu lieu ne le sont pas. Avant de choisir un framework, notez ce à quoi un autre worker doit pouvoir répondre :
| Question après un redémarrage | Enregistrement durable à conserver |
|---|---|
| De quelle exécution s’agit-il, et peut-elle continuer ? | ID d’exécution, statut, échéance, budget, propriétaire ou lease |
| Que doit faire l’agent ensuite ? | Checkpoint de l’état de la boucle ou du graphe |
| Quel rapport a été approuvé ? | Version immuable de l’artefact ou hash du contenu, et décision d’approbation |
| La publication a-t-elle déjà eu lieu ? | ID de l’opération en attente, arguments, résultat et résultat de la recherche externe |
| Pourquoi cette exécution a-t-elle échoué ou épuisé son budget ? | Événements et traces corrélés |
Ces enregistrements n’ont pas besoin d’être cinq produits distincts. Une base de données peut contenir les lignes d’exécution, les checkpoints et les événements d’opération dans des tables séparées. Un object store peut contenir les fichiers de rapport. Un backend de traces peut contenir les durées. Gardez ces enregistrements séparés, car chacun prouve quelque chose de différent. Le compte rendu d’Anthropic sur les agents longue durée décrit le même problème de base du point de vue du modèle : un nouveau contexte ne se souvient pas du travail précédent, sauf si l’application lui fournit une progression durable à lire. L’équipe Codex d’OpenAI rapporte des exécutions uniques qui travaillent sur une même tâche pendant plus de six heures ; ce n’est donc pas un cas rare.
Appelons exécution une tâche acceptée. Elle peut utiliser plusieurs sessions de modèle à mesure que les contextes sont remplacés, et une conversation peut contenir plusieurs exécutions. Les frameworks n’emploient pas « session » et « thread » de la même manière. Dans LangGraph, thread_id sert de clé à l’historique des checkpoints ; décidez explicitement si l’un de ces threads correspond à une exécution ou en couvre plusieurs. Dans tous les cas, conservez un ID d’exécution géré par l’application pour le journal des opérations. Les backends de session de l’OpenAI Agents SDK contiennent un historique de conversation mutable, qui peut être modifié, vidé et compacté ; ne le traitez donc pas comme le journal de récupération en ajout seul.
Le workspace est un autre élément d’état. Pour un agent de code, un commit peut identifier les fichiers à restaurer ; dans l’exemple du rapport, une clé d’objet immuable et un hash peuvent identifier le fichier approuvé. Un sandbox en pause peut préserver un système de fichiers pratique, mais son existence prolongée ne doit pas être le seul moyen de récupérer le résultat. Les Git worktrees séparent des checkouts ; ce ne sont pas des sandboxes d’exécution.
Cinq composants à placer
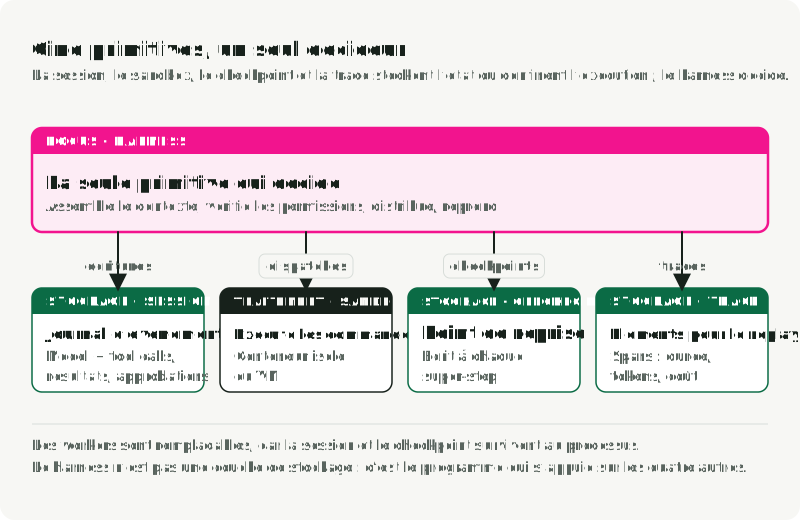
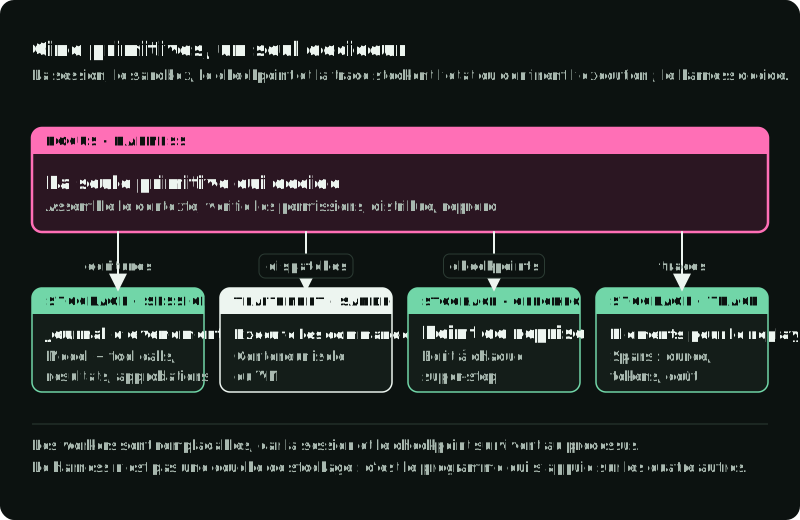
L’article Scaling Managed Agents d’Anthropic sépare la session, le harness et le sandbox. Cet article distingue aussi les checkpoints et les traces, soit cinq responsabilités du runtime à répartir. Une implémentation peut les fusionner, mais chacune doit avoir un responsable et une limite de défaillance connue. La figure les place dans une configuration file d’attente et worker et indique ce qui circule entre eux.
| Composant | Rôle | Implémentation courante |
|---|---|---|
| Session | Journal en ajout seul des appels, résultats et approbations | Table d’événements dans PostgreSQL, indexée par ID d’exécution |
| Harness | Piloter les tours du modèle et des outils jusqu’à la fin de la tâche | Graphe LangGraph, runner de l’OpenAI Agents SDK, boucle maison |
| Sandbox | Exécuter des commandes avec des limites de fichiers, de réseau et de processus | Conteneur renforcé, microVM, sandbox de navigateur |
| Checkpoint | Reprendre sans rejouer toute l’exécution | Saver PostgreSQL ou Redis de LangGraph, état du moteur de workflows |
| Trace | Déboguer une exécution après sa fin | Spans OpenTelemetry vers Tempo, Jaeger, Honeycomb, LangSmith |
Le harness est le seul qui prend des décisions ; les quatre autres stockent l’état ou restreignent l’exécution. Le graphe compilé de LangGraph, les Deep Agents de LangChain et Claude Code sont des harnesses en ce sens. Le guide des sandboxes de l’OpenAI Agents SDK trace la même ligne : les approbations, le tracing, les handoffs et l’état de reprise appartiennent au runtime externe, tandis que les commandes, les modifications de fichiers et l’isolation de l’environnement appartiennent à la session du sandbox.
Les sandboxes diffèrent par leur durée de vie. Un sandbox éphémère neuf existe pour une seule tâche et paie le coût de démarrage à chaque fois. Un sandbox persistant mis en pause conserve son système de fichiers et un snapshot de sa mémoire entre les exécutions, de sorte que la reprise suivante peut éviter un démarrage complet. Un sandbox snapshot ou fork crée une branche d’une image copy-on-write à partir d’un parent préparé, de sorte que de nombreuses tâches partagent les dépendances installées sans partager leur état modifiable.
Deux préoccupations traversent les cinq composants. L’application des permissions intervient avant chaque tool call. Les permissions de système de fichiers de Deep Agents ne couvrent que ses outils de fichiers intégrés ; les commandes shell, les outils personnalisés et les appels MCP doivent donc être contrôlés dans la politique du sandbox ou derrière un proxy d’outils. Les secrets ne doivent atteindre ni le modèle ni, en général, le sandbox. Managed Agents d’Anthropic clone les dépôts avec un token pendant la mise en place du sandbox et fait passer les appels MCP par un proxy qui détient les tokens OAuth ; le harness ne voit donc jamais les identifiants.
Vérifiez le placement en notant chaque composant et ce qui l’implémente. PostgreSQL peut contenir la session et les checkpoints, le conteneur du worker exécute le harness, un fournisseur comme Daytona, Modal ou E2B fournit le sandbox, et Tempo ou LangSmith stocke les traces. Cherchez ensuite les défaillances couplées : deux composants dans un même processus tombent ensemble, et un identifiant partagé franchit les deux frontières s’il fuit.
Un checkpoint, un journal d’événements et un enregistrement externe répondent à des questions différentes
Un checkpoint indique où l’exécution peut reprendre : les messages ou les valeurs du graphe déjà produits, l’étape terminée et l’étape en attente. LangGraph enregistre l’état du graphe aux frontières des super-steps. Son checkpointer peut aussi conserver les écritures réussies d’un nœud lorsqu’un autre nœud de la même étape échoue. C’est une tolérance aux pannes utile, mais un checkpoint des valeurs du graphe ne prouve pas qu’un service extérieur au graphe a validé une requête.
graph.get_state() renvoie un StateSnapshot dont les .values contiennent le dernier état connu du graphe, ce qui est utile dans un bundle de débogage. Ni lui ni le checkpoint ne peuvent reconstituer les événements que le harness n’a jamais journalisés.
Un journal des événements d’opération indique ce que l’application a tenté et ce qu’elle a appris : publish_requested, publish_pending, publish_succeeded ou needs_human, tous rattachés à une exécution et à un ID d’opération. Il peut résider dans la même base de données que les checkpoints, à condition que l’application écrive réellement les événements. L’historique des checkpoints d’un graphe n’est pas automatiquement ce journal. Une transcription de chat est encore autre chose : elle aide le modèle à continuer, mais elle ne contient pas forcément chaque approbation, argument d’outil ou effet de bord.
Le service externe détient le résultat qui fait foi pour la publication. Il peut proposer une clé d’idempotence, une recherche de statut par ID d’opération ou une requête sur un objet avec le hash attendu. S’il ne propose rien de tout cela, le runtime ne peut pas déduire un succès d’une réponse manquante. Une trace peut montrer qu’une requête a été envoyée et combien de temps elle a pris, mais un span qui se termine par un timeout ne permet pas de savoir si le service distant l’a validée.
La différence apparaît quand vous rejouez un ancien état. Le replay de checkpoint de LangGraph réexécute les étapes situées après le checkpoint sélectionné, y compris les requêtes d’API de ces étapes. C’est une fonctionnalité de débogage et de contrôle du flux, pas une garantie exactly-once pour les effets externes. La même règle s’applique à un nouveau worker qui reprend après un crash.
Suivre une publication incertaine
Le rapport est approuvé et stocké sous un ID d’artefact stable. Le harness demande maintenant au runtime de le publier. Supposons que le service de publication puisse terminer la requête même si le worker perd la réponse.
- Enregistrer l’intention. Avant que la requête ne quitte le worker, persistez un ID d’opération géré par l’application, le hash de l’artefact approuvé, la destination et le statut
pending. Liez cet ID à ces arguments. Un ID de tool call généré par le modèle peut changer après une replanification ; ce n’est pas l’identité de l’action métier. - Envoyer l’action. Transmettez le même ID d’opération au service de publication si son API prend en charge l’idempotence. Sinon, utilisez une clé d’objet stable ou un autre moyen, pris en charge par le fournisseur, de rechercher le résultat. Le worker ne doit pas supposer qu’un timeout signifie que le service n’a rien fait.
- Enregistrer le résultat. Sur une réponse confirmée, stockez l’ID du résultat externe et marquez l’opération comme terminée avant de poursuivre l’exécution. Le checkpoint suivant peut alors faire référence à ce résultat.
- Combler l’écart. Supposons que le service ait accepté le rapport mais que le worker ait planté avant l’étape 3. Un nouveau worker voit
pending. Il demande au service si cette même opération ou cet artefact existe. Si c’est le cas, il enregistre le résultat récupéré et continue sans publier une seconde copie. Si un nouvel essai est pris en charge, il utilise le même ID d’opération et des arguments inchangés. - S’arrêter en cas d’incertitude. Si le service ne peut pas répondre et ne garantit pas des nouvelles tentatives idempotentes, laissez l’opération non résolue en vue d’une revue. Générer une nouvelle clé et renvoyer la requête serait une nouvelle action, avec un risque de publication en double.
La séquence ci-dessous suit le crash de l’étape 4, entre le succès externe et l’enregistrement local du résultat.
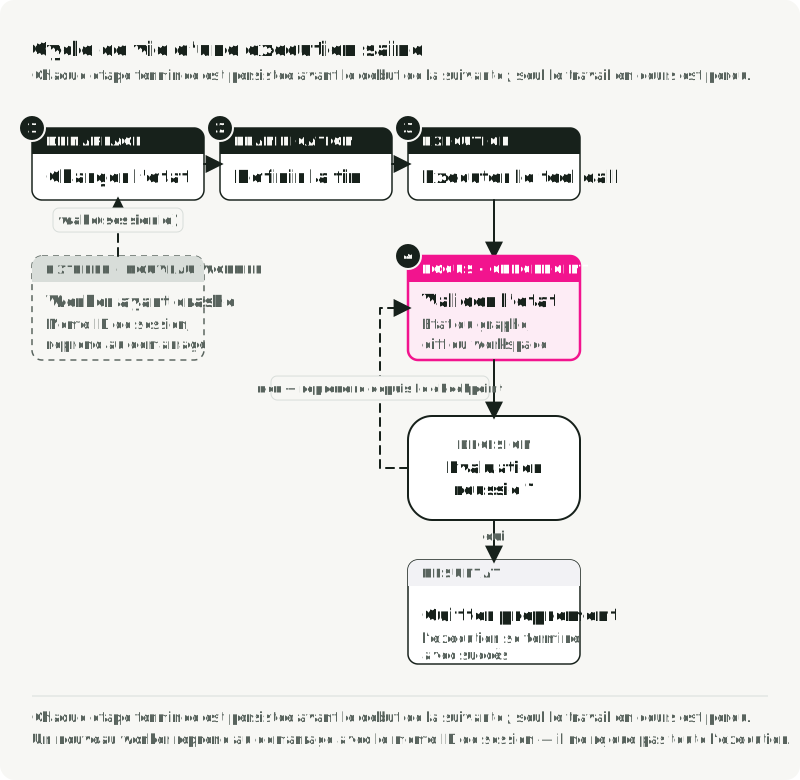
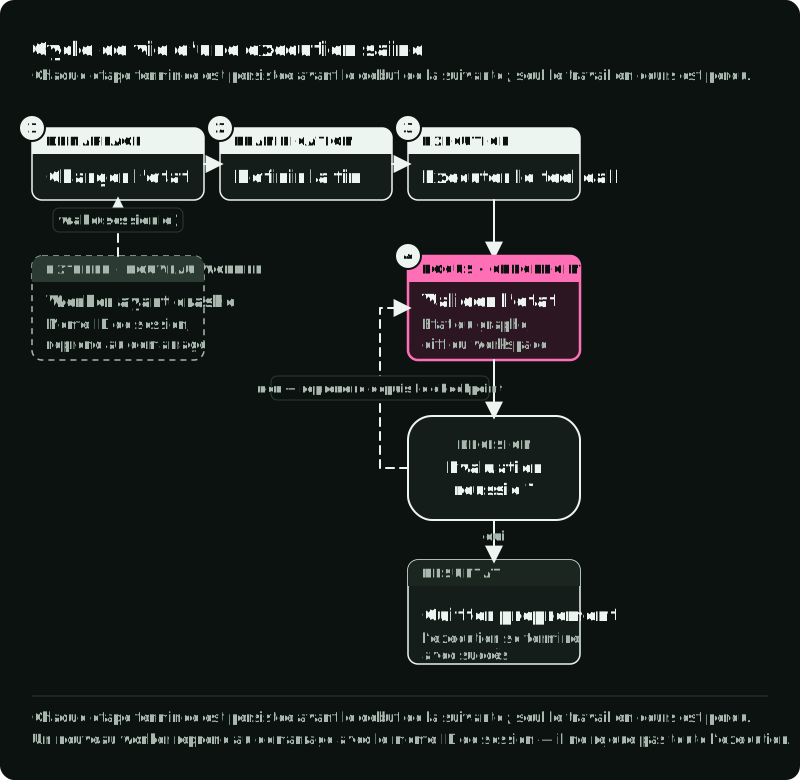
Le diff du workspace dans le diagramme est une version ou une référence de fichier récupérable ; le checkpoint du graphe n’a pas besoin de contenir les fichiers eux-mêmes.
Le cas à prévoir est un crash entre le succès externe et le stockage local du résultat. Aucune transaction de base de données ne peut valider de façon atomique une écriture dans un service indépendant sans la coopération de ce service. L’article d’AWS sur les API idempotentes explique pourquoi un ID de requête fourni par l’appelant représente une intention : deux requêtes identiques peuvent être deux actions voulues, tandis que deux nouvelles tentatives d’un même ID doivent en représenter une seule. Le service destinataire doit respecter ce contrat et détecter un payload modifié sous le même ID. Vérifiez sa période de déduplication ; une clé expirée n’est pas une promesse permanente. Stripe, par exemple, renvoie le premier résultat pour une clé d’idempotence répétée et peut supprimer les clés après au moins 24 heures.
Le même protocole s’applique à l’envoi d’un e-mail, au débit d’un compte, à l’ouverture d’une pull request ou à la modification d’une base de données appartenant à un autre service. La méthode de réconciliation diffère. Par exemple, un fournisseur peut prendre en charge des clés d’idempotence, une contrainte d’unicité sur la ressource, une lecture après écriture, ou aucune requête fiable. Concevez la politique de nouvelles tentatives à partir de ce contrat, et non du fait que le framework d’agent peut répéter un nœud.
Rendre le reste de l’exécution récupérable
L’appel externe incertain est le cas le plus difficile. Le reste de l’exécution a quand même besoin de quelques règles explicites :
- Un seul écrivain actif. Une file d’attente peut redistribuer le travail après l’expiration d’un lease. Utilisez un lease d’exécution avec fencing ou des mises à jour de statut conditionnelles, afin qu’un worker obsolète ne puisse pas faire avancer l’exécution. Conservez la protection par idempotence pour les appels déjà en cours. N’acquittez un job qu’une fois durable l’état qu’il représente. La récupération commence par l’inspection des opérations en attente, et non par un redémarrage aveugle du modèle. Décidez de ce que signifie une nouvelle entrée utilisateur pendant une exécution : la rejeter, la mettre en file d’attente, interrompre ou revenir en arrière ; l’article de LangChain sur le runtime de Deep Agents décrit ces choix.
- Une attente durable. Si la publication nécessite une approbation, persistez l’action proposée et ses arguments exacts. Reprenez avec la décision d’approbation et vérifiez-la à nouveau si l’action proposée change. Ne gardez pas un processus worker ouvert uniquement pour attendre une personne.
- Une exécution bornée. Persistez l’échéance, les limites d’appels ou d’outils et l’enveloppe de dépenses. Réservez le budget avant un dispatch concurrent, afin que deux appels ne puissent pas dépenser le même reliquat ; réconciliez ensuite la consommation réelle. L’annulation arrête les nouveaux appels et enregistre la demande, mais elle ne peut pas défaire un effet externe en cours. Une alerte de métriques ou un budget côté fournisseur, comme les task budgets en bêta d’Anthropic, constitue un second signal ; le modèle peut dépasser un budget indicatif, donc conservez de toute façon le registre de dispatch.
- Un travail restaurable. Stockez une référence à l’artefact approuvé, son hash et la version du workspace qui l’a produit. Un processus restauré doit pouvoir valider le fichier avant de le publier. Les gros fichiers ont leur place dans un artifact store, pas dans chaque checkpoint du graphe.
- Une frontière d’exécution. Si un outil exécute du code généré, installe des paquets ou navigue sur des pages non fiables, exécutez-le dans un environnement doté des restrictions nécessaires sur les fichiers, le réseau et les processus. Gardez les identifiants à longue durée de vie hors du contexte visible par le modèle ; appliquez les permissions là où l’action s’exécute. Un conteneur ou un checkout par worktree ne suffit pas, à lui seul, à établir l’isolation que votre modèle de menace peut exiger.
Avec LangGraph, choisissez délibérément la durabilité des checkpoints. Son mode "sync" persiste chaque checkpoint avant le début de l’étape suivante ; "async" peut perdre un checkpoint récent lors d’un crash du processus, et "exit" n’enregistre pas la progression intermédiaire face à un crash en cours d’exécution. Même "sync" ne comble pas l’écart des effets externes décrit plus haut. Le journal d’événements et la logique de réconciliation restent du travail applicatif.
Les défaillances qu’ajoutent les exécutions longues
Lorsque les exécutions traversent plusieurs workers et context windows, les défaillances se déplacent vers l’état, les effets de bord en double, la dérive du workspace et le coût. Chacune nécessite un contrôle hors de la mémoire du modèle, afin qu’il fonctionne encore après un redémarrage. La figure place chaque contrôle à l’étape de la boucle d’exécution où il s’applique ; le tableau ajoute l’endroit où il est mis en œuvre.
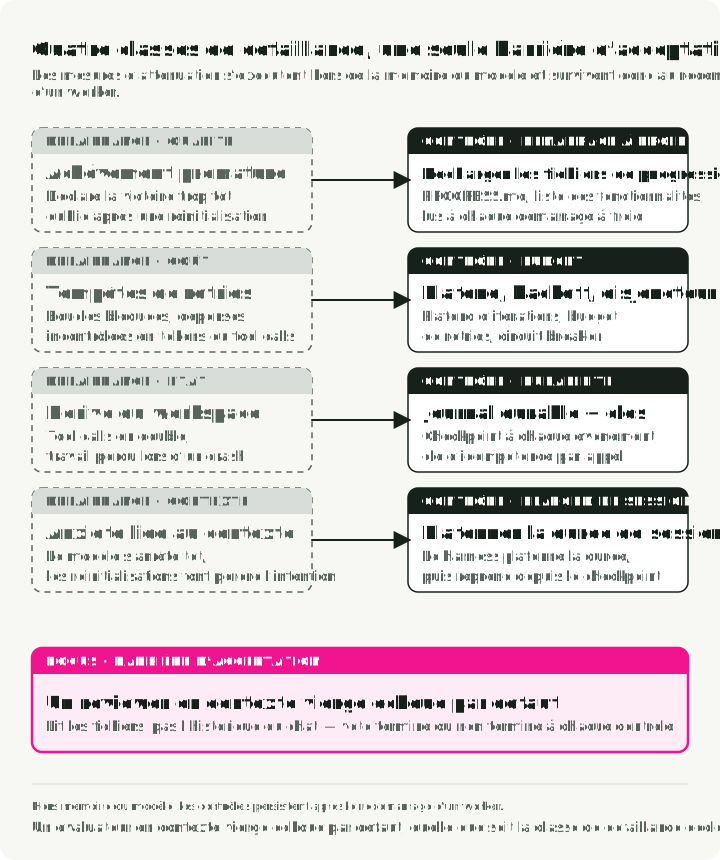
| Défaillance | Contrôle | Où il s’exécute |
|---|---|---|
| L’agent déclare la tâche terminée trop tôt | Contrôles d’acceptation sur les artefacts ; evaluator facultatif en contexte neuf, sans outils d’écriture | Étape de fin du harness ; evaluator dans sa propre session de sandbox |
| L’agent oublie le travail terminé après une réinitialisation du contexte | Fichiers de progression comme PROGRESS.md et feature-list.json, lus avant le premier appel au modèle | Hook de démarrage de chaque session de modèle |
| Le modèle résume et s’arrête trop tôt près de sa limite | Plafonner la session et en démarrer une nouvelle à partir du handoff et du checkpoint | Limite de durée de session du harness |
| Boucles bloquées et retries sans limite | Plafond d’itérations, backoff exponentiel, coupe-circuit sur le taux d’erreur des outils, budget strict de tool calls | Nœud d’exécution des outils ; RetryPolicy sur les Activities Temporal |
| L’agent modifie des fichiers qui appartiennent à une autre exécution | Workspace par exécution, commits Git comme points de récupération, politique de fichiers du sandbox ou du proxy d’outils | Politique du sandbox ; permissions Deep Agents pour ses outils de fichiers intégrés |
| Les dépenses en tokens ou en outils s’emballent | Réserver le budget avant le dispatch, borner la sortie, réconcilier la consommation | Registre de budget sur le chemin de dispatch ; alertes Prometheus comme second signal |
| Un tool call s’exécute deux fois après un crash | Persister pending et une clé d’idempotence avant le dispatch ; à la reprise, interroger ou réessayer avec la même clé | Event store plus l’API d’idempotence ou de recherche du fournisseur |
| Du travail est perdu quand un worker ou un sandbox meurt | Journal d’événements durable, checkpoint après chaque super-step, réconciliation des effets en attente avant de continuer | PostgresSaver plus une table d’événements, ou un Temporal Workflow |
Le quick-start cwc-long-running-agents d’Anthropic inclut les patterns de l’evaluator et des fichiers de progression. L’arrêt prématuré près de la limite de contexte dépend du modèle ; retestez donc tout contournement quand le modèle change. Comme le dit Anthropic, chaque composant du harness encode une hypothèse sur ce que le modèle ne sait pas faire, et cette hypothèse peut devenir obsolète quand le modèle change.
Les défaillances de transport que la boucle doit absorber
Un flux peut se fermer en pleine réponse. La connexion peut tomber alors que seule la moitié d’une réponse, ou la moitié d’un tool call, est arrivée. Les arguments d’un outil arrivent sous forme de fragments de JSON qui ne s’analysent qu’une fois le bloc terminé ; un appel assemblé en partie ne doit donc jamais atteindre le dispatch. Exécuter une commande tronquée est exactement ce que la couche de permissions existe pour empêcher. Traitez un flux interrompu comme une requête échouée : écartez le fragment, ne l’ajoutez jamais comme quelque chose que le modèle aurait dit, et réessayez l’appel entier. C’est abordable parce que le préfixe déjà envoyé est une lecture de cache lors du nouvel essai. Gardez le retry sous la boucle de l’agent, au niveau de l’enveloppe d’appel, afin qu’une requête réessayée ne relance jamais un outil déjà exécuté.
Le streaming cesse aussi d’être facultatif quand les requêtes grossissent. Les fournisseurs imposent des timeouts aux requêtes sans streaming et exigent le streaming au-delà de certaines tailles de sortie, et les SDK peuvent faire du streaming en interne pour les appels longs. Un runtime de production tend donc à tout streamer et à accumuler le résultat, même quand aucune interface ne veut les fragments. L’arrivée des tokens fait alors office de signal de vie : tant qu’ils continuent d’arriver, l’appel est vivant, donc un flux resté silencieux pendant une minute est l’indice d’un blocage. Une requête sans streaming ne vous apprend rien avant son retour.
Les limites de débit se mesurent en tokens, pas en requêtes. Les fournisseurs mesurent les tokens d’entrée et de sortie par minute ; un agent qui porte une grosse requête épuise donc une limite à un rythme de requêtes qui paraît dérisoire. La croissance du contexte se manifeste ainsi par des erreurs 429 plutôt que par un problème de latence, et le fan-out parallèle multiplie la pression par la taille de chaque requête plutôt que par le nombre de workers. Plafonnez la concurrence et partagez un seul budget de tokens dans le composant qui lance le travail parallèle ; un backoff à l’intérieur de chaque worker ne fait qu’étaler la même demande. Comptez les 429 et l’endpoint utilisé par exécution, afin qu’une limite du fournisseur ne soit pas prise pour une propriété de la configuration testée.
Le runtime a aussi besoin d’éléments pour diagnostiquer une exécution. Émettez un ID d’exécution et un ID d’opération avec les spans du modèle et des outils, le statut, la durée et la consommation de tokens. Les conventions GenAI d’OpenTelemetry donnent des noms communs à ces champs, même si ces conventions sont encore en cours d’élaboration. Le texte des prompts, les arguments des outils et les résultats peuvent contenir des données sensibles ; décidez s’ils ont leur place dans la télémétrie avant de les capturer. Une trace aide à expliquer une défaillance. Le journal d’événements et la recherche externe déterminent s’il est sûr de continuer. La section sur l’observabilité ci-dessous en fait une stack.
Choisir la forme de déploiement à partir des règles d’attente et de défaillance
Le nom de la plateforme est un choix tardif. Demandez-vous d’abord si l’appelant a besoin du résultat final dans la même requête, si l’exécution peut attendre et qui exploitera son état durable.
| Besoin | Forme de départ | Ce qu’il faut encore |
|---|---|---|
| Tâche courte terminée dans une seule requête | Agent loop dans le gestionnaire de requêtes | Une frontière d’exécution séparée pour les outils non fiables ; un état durable si la nouvelle tentative ou la poursuite compte |
| Travail en arrière-plan qui peut survivre à un worker | File d’attente, worker remplaçable, état durable | Leases d’exécution, checkpoints, journal des opérations, artifact store selon les besoins |
| Nombreuses approbations, timers, callbacks ou nouvelles tentatives d’un déploiement à l’autre | Moteur de workflows durables avec des workers pour les appels au modèle et les tool calls | Modifications de workflow compatibles avec le replay et activités externes idempotentes |
La durée d’exécution est un premier filtre utile, même si elle ne décide pas de toute la conception. La figure place chaque forme de départ sur une échelle logarithmique de durée d’exécution, au-dessus des limites de temps des plateformes courantes :
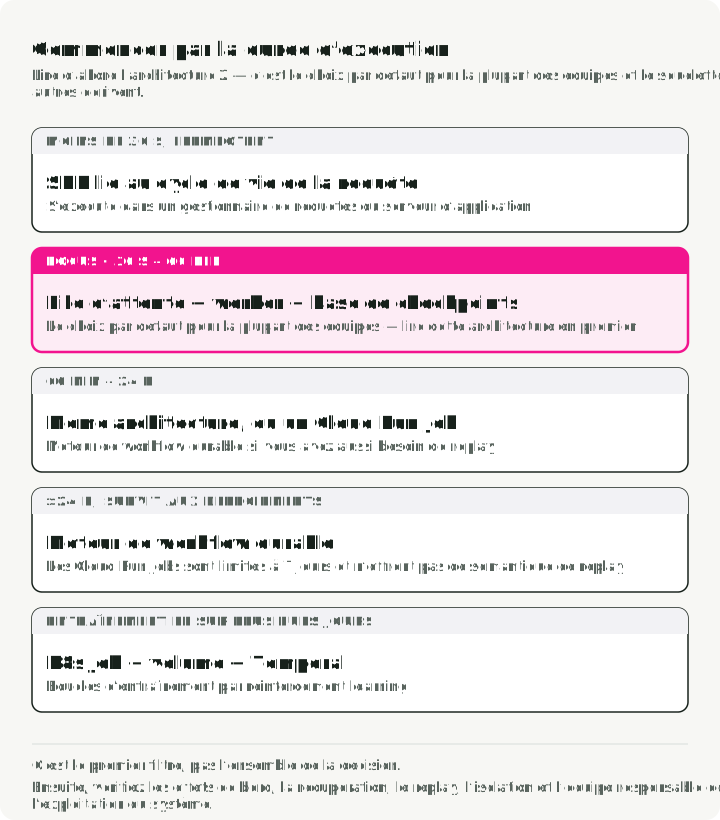
- Moins de 30 secondes, idempotent : le SDK d’agent dans un gestionnaire de requêtes du serveur applicatif.
- De 30 secondes à 60 minutes : file d’attente, worker et base de données de checkpoints.
- De 60 minutes à 24 heures : la même file d’attente et le même worker, ou un Cloud Run Job pour un travail ponctuel ; un moteur de workflows si vous avez aussi besoin de versioning et de replay.
- Plus de 24 heures, en survivant aux déploiements : un moteur de workflows durables comme Temporal.
- Boucles d’entraînement par reinforcement learning sur plusieurs jours : un Kubernetes Job avec un volume, plus Temporal.
Après ce filtre, examinez les effets de bord, la récupération, le replay, l’isolation, la localisation des données et l’équipe qui exploitera le système.
Je commencerais l’exemple du rapport avec une file d’attente et un worker. L’API renvoie un ID d’exécution ; le worker fait avancer le harness ; un store durable enregistre les checkpoints et les opérations en attente ; un artifact store contient le rapport. Cette conception répond aux exigences précises de redémarrage et d’approbation sans supposer un cloud particulier. Si les règles d’attente et de nouvelles tentatives deviennent un workflow à part entière, Temporal peut persister l’historique d’exécution et rejouer les décisions du workflow. Ses Activities exécutent toujours les appels externes et peuvent être réessayées ; elles ont donc besoin de la même conception d’idempotence ou de réconciliation.
Les services cloud implémentent ces formes ; leurs timeouts ne définissent pas l’architecture. Une requête de service Cloud Run a une échéance et peut continuer à être traitée après la fermeture de la connexion ; un timeout HTTP est donc une preuve particulièrement faible qu’une action s’est arrêtée. Un Cloud Run Job, une tâche ECS ou un Kubernetes Job peut héberger un worker en arrière-plan, mais une longue limite de durée de tâche ne lui donne pas à elle seule une progression durable. Une invocation AWS Lambda ordinaire est plafonnée à 15 minutes ; un workflow peut s’étendre sur plusieurs invocations bornées. Vérifiez les limites actuelles et le comportement de nouvelles tentatives du service choisi avant le déploiement.
Une plateforme d’agents hébergée peut exploiter la boucle et une partie de son état à votre place. Évaluez-la avec le même exercice de panne : comment exporter l’état de l’exécution, trouver un effet de bord en attente, lier une approbation à une action, inspecter les données envoyées au control plane et reprendre après un déploiement ? Séparez le contrat du sandbox de la plateforme de son contrat de harness. Héberger le harness ne rend pas automatiquement ses outils sûrs, et héberger le sandbox ne rend pas automatiquement l’exécution durable.
Ce que chaque forme vous apporte
La matrice nomme le composant qui assure chaque responsabilité dans chaque forme, marque les cellules qu’un fournisseur hébergé exploite et met en évidence celles qui ne suffisent pas à elles seules. Les notes qui suivent donnent les limites qui permettent de trancher entre elles, vérifiées en septembre 2026.
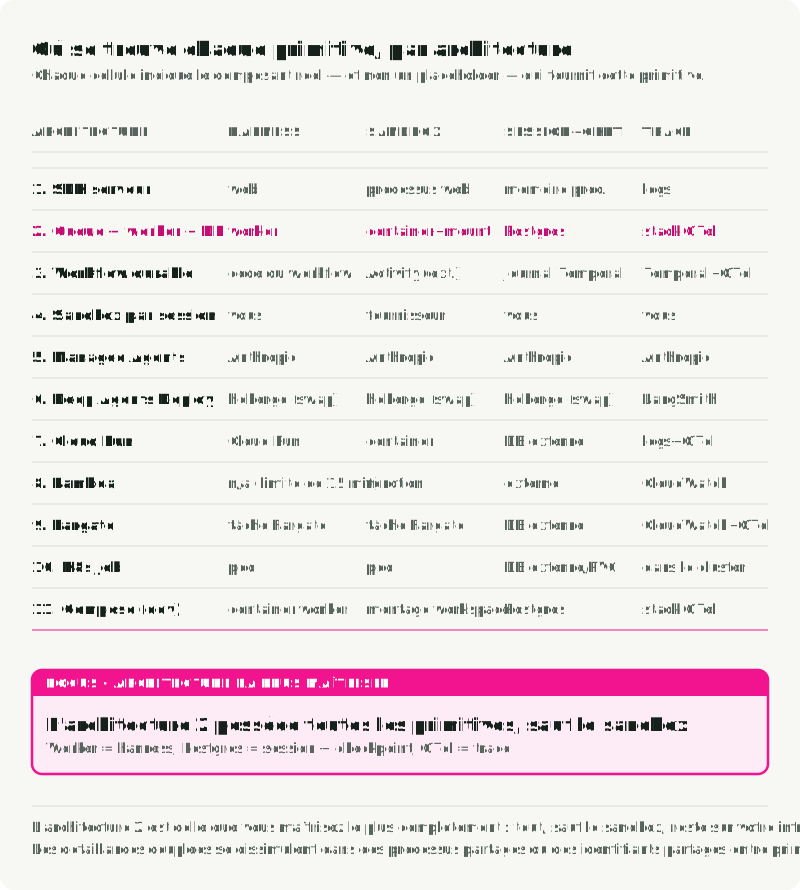
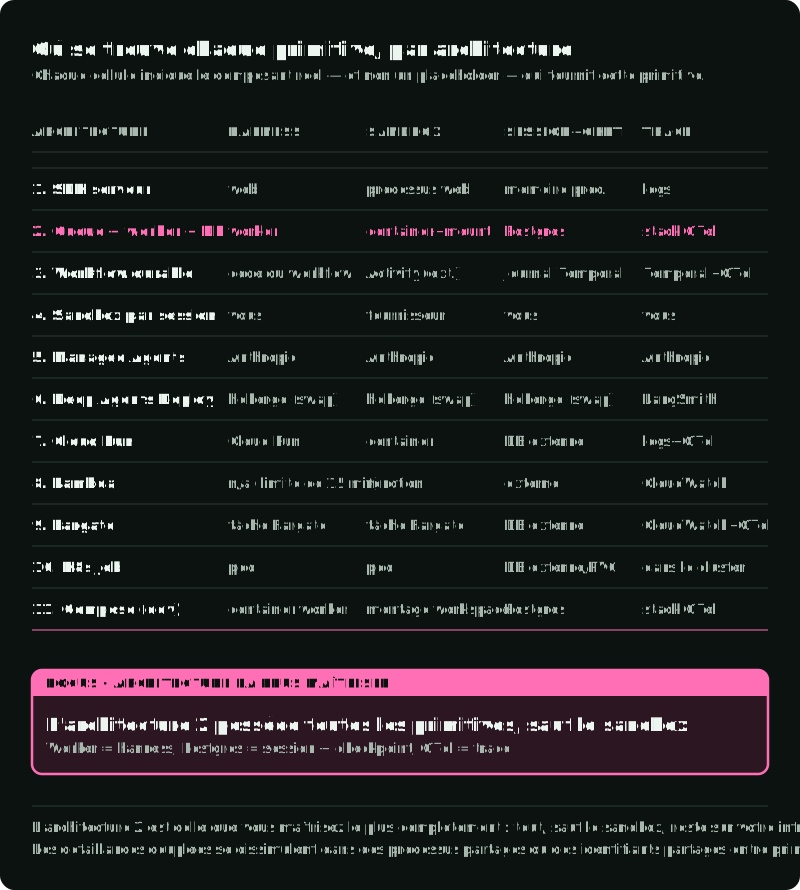
1. SDK dans un serveur applicatif. L’agent s’exécute dans un gestionnaire de requêtes. Cela convient aux tâches de moins de 30 secondes environ, aux démos et aux outils internes. Un crash de la couche web perd le travail en mémoire. Une déconnexion du client peut annuler le travail ou le laisser continuer, selon le serveur et l’application ; elle ne permet pas de connaître le résultat d’une action externe. Persistez l’état si la poursuite compte et n’utilisez pas de gestionnaire de requêtes pour un travail de plusieurs heures.
2. File d’attente, worker et base de données de checkpoints. La forme par défaut que je recommande à la plupart des équipes : un worker Python avec un checkpointer PostgreSQL et Redis Streams ou RabbitMQ pour les jobs entrants. Le Market Analyst Agent illustre cette forme avec un worker de file d’attente démarré séparément. Dans la conception de production, l’application crée une ligne d’exécution, pousse un job et renvoie l’ID d’exécution ; le worker exécute le harness, écrit les événements et les checkpoints, et stocke les artefacts. La profondeur de la file d’attente fournit une backpressure, et le compute spot ou préemptible fonctionne si les écritures durables se terminent avant que le worker acquitte le job. Le worker est le harness ; le code non fiable a toujours besoin d’un sandbox renforcé.
3. Moteur de workflows durables. L’orchestration de l’agent s’exécute dans un Temporal Workflow, et les appels au modèle et les tool calls s’exécutent comme des Activities. L’état du workflow réside dans un historique d’événements stocké dans Cassandra, MySQL ou PostgreSQL ; il est donc rejoué après les pannes, et un workflow inactif n’utilise aucun compute. Une approbation humaine devient une attente durable au lieu d’une boucle de polling. Les modifications de code qui chevauchent une exécution en cours nécessitent un Worker Versioning compatible avec le replay, ou des patches. L’intégration OpenAI Agents SDK de Temporal exécute les outils de l’agent comme des Activities ; consultez sa liste de fonctionnalités d’agent non prises en charge avant de vous y fier.
4. Un fournisseur de sandboxes par exécution. Chaque exécution obtient sa propre microVM ou son propre conteneur auprès d’un fournisseur, tandis que le harness, la session, le checkpoint et la trace restent de votre côté, généralement dans la forme 2. Utilisez-la lorsque l’agent exécute du code non fiable, de l’automatisation de navigateur, des tests ou des installations de paquets ; le prix à payer est une dépense plus élevée et une dépendance au fournisseur.
| Fournisseur | Isolation | Limites de session et de persistance |
|---|---|---|
| E2B | microVM Firecracker | Sessions continues de 1 h en Hobby, 24 h en Pro ; pause et reprise à part |
| Vercel Sandbox | microVM Firecracker | 45 min en Hobby, 24 h en Pro et Enterprise ; par défaut, les snapshots expirent 30 jours après leur dernière utilisation |
| Daytona | Sandbox configuré par le fournisseur | Cycle de vie d’arrêt et d’archivage configurable ; les forks enregistrent leur parent |
| Modal | gVisor | 5 min par défaut, 24 h au maximum ; les volumes et les snapshots ont leurs propres règles de persistance |
| Runloop | microVMs, selon sa fiche Marketplace | Suspension et reprise ; snapshots de disque et branches |
Les chiffres de démarrage des fournisseurs mesurent des intervalles différents ; ils ne constituent donc pas un classement de vitesse. Le démarrage de conteneur d’environ une seconde de Modal, par exemple, exclut le démarrage de l’application. Mesurez le temps entre la requête d’API et la première commande réussie, puis jusqu’à un état où l’application est prête, aux p95 et p99 dont vous avez besoin, et vérifiez les limites de concurrence du compte avant les load tests.
5. Anthropic Managed Agents. Une session, un harness, un sandbox et un proxy MCP adossé à un coffre, hébergés, en bêta publique depuis le 8 avril 2026. La facturation correspond aux tarifs standard des tokens plus $0.08 par heure de session pendant qu’une session tourne ; le temps d’inactivité est gratuit, et les sessions n’ont pas de mode batch. Une session qui tourne en continu coûte environ $58 par mois hors tokens. Le service n’est pas disponible via Bedrock ou Vertex AI. Avec les sandboxes auto-hébergés, vous exploitez l’exécution et le trafic sortant, mais les entrées et résultats des outils atteignent toujours le control plane d’Anthropic. En partir plus tard implique une migration de plateforme.
6. LangChain Deep Agents Deploy. deepagents deploy empaquette un deepagents.toml dans un LangSmith Deployment avec exécution durable, mémoire, human-in-the-loop, code en sandbox et exécutions planifiées, en mode cloud, hybride ou auto-hébergé. Le fournisseur de sandboxes (LangSmith Sandboxes, Daytona, Modal, Runloop ou personnalisé) est une seule valeur de configuration. Le harness est sous licence MIT et utilise le format ouvert AGENTS.md ; la dépendance au fournisseur est donc plus faible que dans la forme 5.
7. Google Cloud Run. Un service traite le HTTP et descend à zéro instance ; son timeout de requête est de 300 secondes par défaut, avec un maximum de 60 minutes. Un job s’exécute jusqu’au bout sans HTTP ; les tâches durent 10 minutes par défaut avec un maximum de 168 heures (7 jours), ou 1 heure avec des GPUs. Utilisez un service pour les exécutions synchrones jusqu’à 60 minutes et un job pour un travail ponctuel plus long. Aucun des deux ne conserve l’état d’une exécution à l’autre ni ne rejoue d’un déploiement à l’autre ; les sessions et les checkpoints vont donc dans PostgreSQL, Spanner ou un store similaire.
8. AWS Lambda. Une fonction expire au bout de 15 minutes. Derrière API Gateway, une requête synchrone dispose d’environ 30 secondes, sauf si une REST API régionale ou privée relève sa limite. Les Lambda durable functions, lancées en décembre 2025, ajoutent des checkpoints, des étapes et des attentes sur des exécutions pouvant durer jusqu’à un an, tandis que chaque invocation reste bornée.
9. AWS ECS ou Fargate, une tâche par exécution. Fargate n’a pas de limite de durée documentée et donne à chaque tâche sa propre interface réseau en mode awsvpc, ce qui convient à l’accès aux données internes au VPC. Il ne prend pas en charge les GPUs ; utilisez ECS sur EC2 pour cela. Fargate Spot ajoute un risque d’interruption, et la durabilité est à votre charge. Comparez aussi Amazon Bedrock AgentCore Runtime, qui héberge le code de l’agent avec des sessions gérées jusqu’à 8 heures sur des microVMs serverless, ou 14 jours avec son type de compute Instances, qui prend en charge les GPUs.
10. Un Kubernetes Job par exécution. Un Job par exécution avec activeDeadlineSeconds, un PersistentVolumeClaim pour le workspace et un sidecar MCP. Cela convient aux équipes qui exploitent déjà Kubernetes ; les cold starts l’excluent pour un démarrage en moins d’une seconde, et la récupération après crash est à construire vous-même. Une isolation forte dépend toujours de la runtime class, de la network policy et de la sécurité des pods. L’exécution sur GPU nécessite des nœuds GPU, des pilotes et un device plugin.
11. Docker Compose en local, pour le développement uniquement. Le projet d’accompagnement démarre une application Gradio et les stores de la forme 2, avec un volume de workspace et sans sandbox renforcé. Son worker de file d’attente démarre séparément. La stack de référence ci-dessous distingue ces processus.
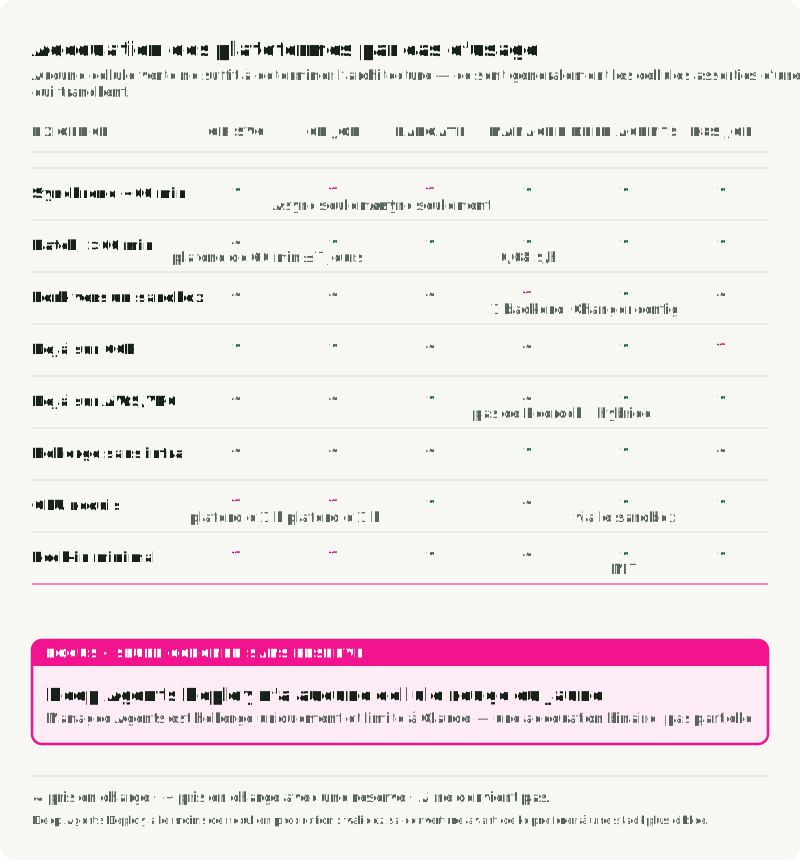
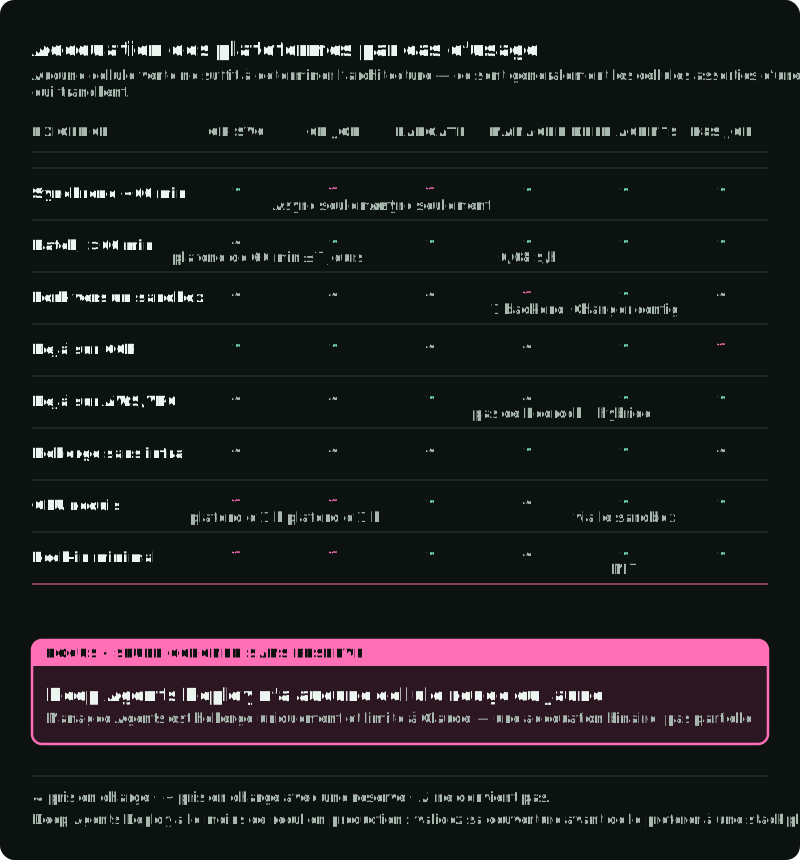
Dans la matrice, ce sont généralement les cellules assorties d’une réserve qui décident du choix, pas les coches. Une large couverture ne montre ni la résidence des données, ni la sémantique de replay, ni la dépendance au fournisseur, ni le coût d’un déplacement ultérieur de l’état.
Harness hébergé ou maîtrisé. Hébergé signifie que le fournisseur exécute la boucle et que vous appelez une API ; maîtrisé signifie que vous exécutez la boucle, même si le code vient d’un fournisseur. LangChain se trouve des deux côtés : LangGraph est une bibliothèque que vous exécutez vous-même, et Deep Agents Deploy exécute un harness pour vous dans son mode cloud. Choisissez l’hébergé quand sa prise en charge des modèles, sa frontière de données, son comportement de récupération et ses points d’extension conviennent déjà. Choisissez le maîtrisé quand vous vous attendez à ce que ces exigences changent, et testez le chemin de sortie avant que des données de production n’en dépendent.
Sandbox hébergé ou environnement d’exécution propre. Choisissez un sandbox hébergé quand son isolation, sa pause et reprise ou son comportement de fork correspondent au modèle de menace et au budget de démarrage. Docker ou Fargate peuvent convenir à un travail interne de confiance qui a besoin d’un accès au VPC ou d’une résidence stricte des données, mais un conteneur standard ne suffit pas pour du code hostile ; la partie 4 couvre les options d’isolation.
Intégrer la frontière d’état dans une application LangGraph
L’extrait suivant ne montre que la partie état du graphe de la forme file d’attente et worker. Il suppose que builder est un StateGraph existant, que run_id est l’identifiant durable de l’exécution et que task est la nouvelle requête. Le worker dispose d’une connexion PostgreSQL dans DATABASE_URL et de l’autorisation de créer les tables du checkpointer. Il s’agit d’un câblage illustratif, pas d’un worker de publication complet.
import os

from langgraph.checkpoint.postgres import PostgresSaver

with PostgresSaver.from_conn_string(os.environ["DATABASE_URL"]) as checkpointer:
    checkpointer.setup()  # once during setup or migration
    graph = builder.compile(checkpointer=checkpointer)
    graph.invoke(
        {"messages": [{"role": "user", "content": task}]},
        {"configurable": {"thread_id": run_id}},
        durability="sync",
    )
Le thread_id est la clé de recherche des checkpoints de LangGraph, pas un ID d’opération ni la preuve que la publication a eu lieu. L’application doit toujours persister la ligne d’exécution, l’artefact approuvé, l’opération en attente et son résultat. Elle doit aussi récupérer les jobs interrompus et décider de ce que signifie une nouvelle entrée pendant qu’une exécution est active. Ne reprenez pas un nœud de publication incertain en l’invoquant simplement à nouveau. Réconciliez d’abord, puis transmettez le résultat récupéré au graphe.
Git, la base de données de checkpoints et l’object storage
Les exécutions longues utilisent généralement trois stores à la fois, car chacun contient un artefact différent.
- Git contient le workspace : code, documents et fichiers de progression. Utilisez-le quand le travail prend la forme de code ou que l’historique des fichiers compte. Créez une branche d’exécution, faites un commit d’initialisation, puis committez après la mise en place, après chaque fonctionnalité et après le passage des tests. Stockez le SHA du dernier commit à côté du checkpoint. À la reprise, le worker suivant récupère la branche, lit
git log --oneline -8, inspectegit statuset le dernier diff, puis lit le fichier de handoff. Git ne peut pas dire quel nœud du graphe s’exécute ensuite, quel appel attend une approbation, ni quelle nouvelle tentative a utilisé sa clé d’idempotence. Passez-vous-en quand le produit est une réponse unique. - La base de données de checkpoints contient l’état du graphe : ce qui a été décidé, quels nœuds se sont exécutés et ce qui s’exécute ensuite. Utilisez un checkpointing de type
PostgresSaverquand l’état intermédiaire entre les nœuds compte, par exemple entre un planner, un chercheur, un rédacteur et un vérificateur. - Un object store comme S3 ou GCS contient les sorties volumineuses : PDF, fichiers Parquet, captures d’écran. Utilisez-le quand la sortie est trop volumineuse pour la base de données de checkpoints, quand les consommateurs ont besoin d’une URL sans passer par l’agent, ou quand le livrable et l’exécution ont des durées de rétention différentes. Vous pouvez supprimer les logs d’exécution après 30 jours et conserver le rapport final pendant des années. Indexez les objets par
(thread_id, checkpoint_id, artifact_name)afin que l’exécution qui les a produits reste traçable.
La stack de référence dans Docker Compose
Le Market Analyst Agent est le projet d’apprentissage qui accompagne cette série. Depuis la racine de son dépôt, avec Docker Compose disponible et .env préparé à partir de .env.example, make docker-up utilise docker/docker-compose.yml pour démarrer PostgreSQL, Qdrant, Redis et l’application. La commande par défaut de l’application lance l’interface Gradio, qui appelle le harness de façon synchrone. make worker démarre séparément le consommateur de la file Redis ; il nécessite uv et Python 3.13+, installe les dépendances du projet et démarre les bases de données. Configurez les clés des fournisseurs dans .env avant une analyse en direct. make mcp-up et make observability-up activent les profils facultatifs MCP et observabilité.
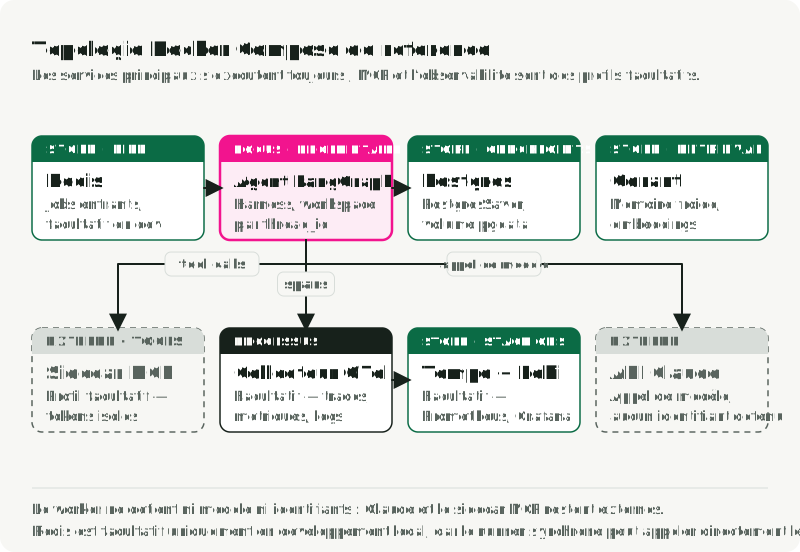
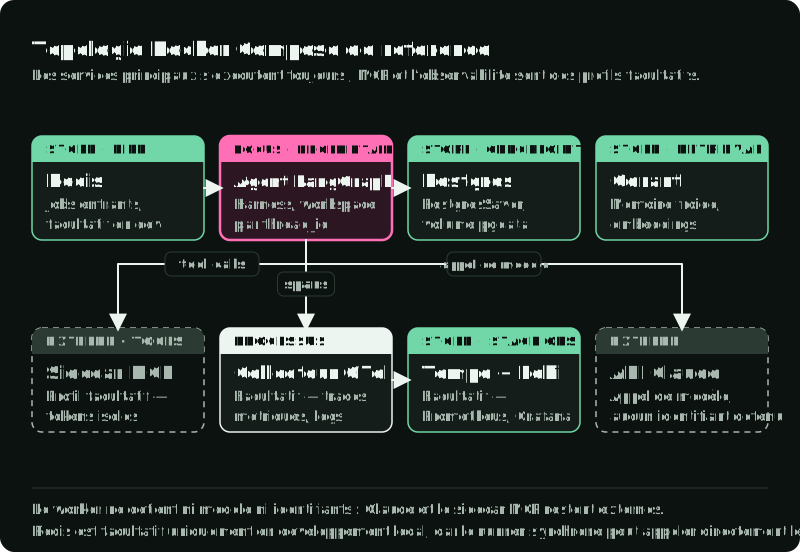
Les routes d’observabilité configurées sont incomplètes. Le Collector n’a qu’un pipeline de traces vers Tempo. Son filtre d’inclusion strict compare gen_ai.operation.name au littéral .+ : des valeurs ordinaires comme chat et execute_tool ne correspondent donc pas et sont exclues ; le matcher de Collector 0.117.0 confirme la comparaison d’égalité. Prometheus collecte directement les métriques de app:9464 et les métriques propres du Collector ; les métriques de l’application nécessitent METRICS_ENABLED=true. L’export des traces de l’application nécessite aussi un endpoint OTLP. Loki possède un backend et une source de données Grafana, mais aucune entrée de logs configurée. Corrigez le filtre de traces et ajoutez l’ingestion de logs avant d’attendre des traces et des logs renseignés ; le démarrage d’un conteneur ne prouve pas que les tableaux de bord fonctionnent.
Pour un conteneur worker, ajoutez un service worker explicite et donnez aux processus qui écrivent simultanément le même volume de workspace ; l’application Compose par défaut ne consomme pas la file. En production, ajoutez une table d’événements pour les intentions et les résultats des outils à côté des checkpoints et testez la réconciliation de vos propres actions externes.
Lire l’exécution après sa fin
Quand une exécution de six heures échoue, l’événement qui en est la cause a pu se produire des heures plus tôt, et le worker qui l’a produit a été remplacé. Vous déboguez à partir d’enregistrements écrits pendant que l’exécution était en cours. Deux d’entre eux se lisent après l’exécution : un journal d’événements interrogeable de chaque étape, et des traces indiquant où sont passés le temps et les tokens. Deux se lisent pendant l’exécution : une vue en direct des modifications du workspace, et une stack d’observabilité par worktree que l’agent lui-même peut interroger.
Aucun des deux enregistrements lus après l’exécution ne contient nécessairement la requête telle qu’elle a finalement quitté le processus, après l’assemblage des instructions, le retrieval, la compaction et tout middleware. Une entrée du journal d’événements et un span décrivent qu’un appel au modèle a eu lieu et ce qu’il a coûté. Quand la question est de savoir ce que le modèle a reçu, il faut une capture dédiée, prise au dernier point avant le départ de l’appel et stockée là où vous irez plus tard pour répondre à cette question.
Journal d’événements. Chaque appel au modèle, tool call, résultat, erreur et approbation, indexé par ID d’exécution et horodatage, interrogeable comme n’importe quelle table. Addy Osmani formule le test : si vous ne pouvez pas reconstituer à partir d’un stockage durable ce que l’agent a fait au cours des dernières 24 heures, vous avez un script shell qui appelle un modèle, pas un agent longue durée.
Traces GenAI OpenTelemetry. Les spans portent les attributs gen_ai.* standard : modèle, fournisseur, nombre de tokens, ID de conversation et nom du workflow. Les conventions ont été déplacées dans leur propre dépôt en 2026 et sont toujours au niveau de stabilité Development ; figez donc la révision que vous avez validée. Sur les backends qui les prennent en charge, vous pouvez changer de destination sans réinstrumenter le code.
Modifications du workspace pendant l’exécution. Le quick-start d’Anthropic surveille le workspace. watch -n 5 'git log --oneline -8' affiche les derniers commits toutes les cinq secondes, et un dossier de captures d’écran trié par date montre ce que l’agent a vu en dernier. Traitez les deux comme des signes d’activité et comparez-les aux résultats des tests avant de conclure que l’exécution progresse.
Une stack par worktree pour l’agent. Dans l’article d’OpenAI sur le harness, chaque worktree Codex reçoit ses propres logs, métriques et traces de courte durée, que l’agent interroge pendant qu’il travaille. Une exigence comme « aucun span dans ces quatre parcours utilisateur ne dépasse deux secondes » devient ainsi quelque chose que l’agent peut vérifier.
Une stack auto-hébergée minimale pour un agent comme le Market Analyst Agent :
- OpenTelemetry Collector, qui reçoit les spans et peut filtrer les champs
gen_ai.*avant l’export. - Tempo ou Jaeger pour les traces, indexées par
gen_ai.conversation.idouthread_id. - Loki pour les entrées du journal d’événements.
- Prometheus pour les métriques de tokens et de latence GenAI.
- Des tableaux de bord Grafana indexés sur
gen_ai.agent.nameetgen_ai.request.model.
Si vous préférez un service hébergé, choisissez-en un : LangSmith pour LangGraph et Deep Agents Deploy, Braintrust quand les suites d’évaluation passent en premier, Arize Phoenix pour de l’OTLP open source avec OpenInference, le tableau de bord de tracing d’OpenAI pour l’Agents SDK, ou le tracing d’Anthropic pour Managed Agents.
Définissez les attributs standard sur chaque span de modèle, au minimum l’opération, le fournisseur, le modèle, l’ID de conversation, le nom de l’agent et le nombre de tokens. Trois panneaux de tableau de bord couvrent l’essentiel du débogage : les tokens de sortie par agent et par heure, la latence p95 du modèle par modèle, et les tool calls qui ont pris plus de 30 secondes.
Quand une exécution échoue, faites écrire par le worker un bundle de débogage dans /workspaces/${THREAD_ID}/_debug/ :
events.jsonl: le journal d’événements exporté, avec les intentions, les résultats, les approbations et les erreurs.checkpoints.jsonl: l’historique de l’état du graphe issu decheckpointer.list({"configurable": {"thread_id": ...}}), étiqueté comme checkpoints.last_state.json:StateSnapshot.valuesdu dernier super-step réussi.trace.json: les spans exportés de l’exécution, selon la politique de capture du contenu.tool_calls.csv:(ts, tool, input_hash, latency_ms, status, error).workspace.tar.zst: le workspace plus legit diffpar rapport au commit d’initialisation.screenshots/*.png,PROGRESS.md,feature-list.jsonet les autres fichiers de progression.env.txt: les tags d’image, la version du modèle et le SHA du commit du harness.
Avec ce bundle, un rapport peut dire « l’exécution s_123 a dépensé 71 % de ses tokens à répéter trois commandes après l’échec de npm install » au lieu de « l’agent s’est bloqué ».
Tests de point de crash
Une exécution réussie sans interruption en dit peu sur la récupération. Pour l’exemple du rapport, injectez un arrêt à trois moments : avant la validation de l’opération en attente, après que le service de publication a accepté la requête mais avant le stockage du résultat, et pendant que l’exécution attend l’approbation. Redémarrez avec un nouveau worker et vérifiez le nombre d’artefacts publiés, l’approbation enregistrée et le statut final de l’opération. Le cas du milieu est celui qui révèle les effets de bord en double.
Testez aussi deux workers qui revendiquent la même exécution, une annulation pendant qu’un appel est en cours, et un fournisseur qui ne peut pas confirmer une action dont l’appel a dépassé le délai. Le résultat correct de ce dernier cas peut être needs_human, et non une nouvelle requête. Inspectez le journal d’événements et la trace pour expliquer chaque résultat. Un test de récupération n’est terminé que lorsque l’état externe concorde avec l’état enregistré de l’exécution.
Avant la mise en production d’un agent longue durée, répondez à ces questions en termes d’infrastructure :
- Quel store détient les événements d’exécution et les checkpoints ?
- Que se passe-t-il si le worker meurt au milieu d’un tool call ?
- Une exécution peut-elle corrompre le workspace d’une autre exécution ?
- Quelles actions nécessitent une approbation ?
- Le modèle ou le sandbox peut-il lire des identifiants en clair ?
- Quels tool calls peuvent être réessayés sans risque ?
- Où le plafond de coût par exécution est-il appliqué ?
- Quels éléments déterministes décident de la fin de la tâche, et quels critères nécessitent un reviewer ?
- Où résident les sorties finales une fois le sandbox disparu ?
- Pouvons-nous expliquer demain une exécution échouée sans la relancer ?
Si une réponse est « le prompt dit à l’agent d’être prudent », le système est encore une démo.
Ceci est la partie 5 de Engineering the Agentic Stack. La partie 6, Harness Engineering for AI Agents, suit la boucle à l’intérieur de ce runtime : comment autoriser une action proposée, confier le travail à un nouveau contexte et décider, à partir d’éléments indépendants, que la tâche est terminée.
Références
Articles d’ingénierie
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Anthropic Engineering, Scaling Managed Agents: Decoupling the brain from the hands, 8 avril 2026.
- Addy Osmani, Long-running Agents.
Frameworks et SDKs
- LangGraph, Checkpointers et
langgraph-checkpoint-postgres. - LangChain, Deep Agents overview, permissions et The runtime behind production Deep Agents.
- OpenAI Agents SDK, Sessions et Sandbox guide.
- Temporal, OpenAI Agents SDK integration et agentic sandboxes.
anthropics/cwc-long-running-agents: patterns de l’evaluator et des fichiers de progression.
Plateformes et limites
- Anthropic, Claude platform pricing pour les heures de session de Managed Agents.
- Fournisseurs de sandboxes : E2B, Vercel Sandbox, Daytona, Modal, Runloop.
- Google Cloud Run, service request timeout et job task timeout.
- AWS, Lambda timeout, Lambda durable functions et Bedrock AgentCore Runtime.
Observabilité
- OpenTelemetry, Semantic conventions for generative AI, attribute registry et metrics.