Long-Running AI Agent Runtime: Sessions und Checkpoints

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Eine Long-Running Agent Runtime lässt einen Run mit Tools länger laufen als den Worker, der ihn gestartet hat. Dieser Artikel richtet sich an Engineers, die einen Agent aus einem Request Handler in Hintergrundarbeit verlagern. Sie erfahren, welcher State einen Restart überstehen muss, warum ein Checkpoint eine externe Action nicht sicher wiederholbar macht und wie diese Anforderungen die Deployment-Form bestimmen. Danach vergleicht der Artikel konkrete Optionen: Queue und Worker, Temporal, Sandbox-Provider, Cloud Run, Lambda, Fargate, Kubernetes und gehostete Agent-Plattformen, dazu die Observability, mit der Sie einen Run nach einem Fehlschlag debuggen.
Das Model schlägt weiterhin die nächste Action vor. Der Harness in Part 6 liefert Context, autorisiert Tools und prüft, ob die Arbeit abgeschlossen ist. Die Runtime gibt dieser Loop dauerhaften State und einen Ort zur Ausführung. Part 4 behandelt die Permission-Entscheidung; hier verfolgen wir eine genehmigte Action durch einen Crash und die Recovery.
State, den ein Restart nicht löschen darf
Angenommen, ein Research Agent sammelt Quellen, schreibt einen Bericht, wartet auf eine Approval und veröffentlicht die genehmigte Datei. Der Run kann Minuten oder Tage dauern, weil die Approval keinen festen Zeitpunkt hat. Ein Deployment kann seinen Worker ersetzen, während der Agent schreibt, während er wartet oder kurz nachdem der Publishing-Service die Datei angenommen hat.
Der Speicher des Workers ist entbehrlich. Der genehmigte Bericht und die Tatsache, dass die Veröffentlichung womöglich schon stattgefunden hat, sind es nicht. Schreiben Sie vor der Wahl eines Frameworks auf, was ein anderer Worker beantworten können muss:
| Frage nach einem Restart | Dauerhaft zu speichernder Datensatz |
|---|---|
| Welcher Run ist das, und darf er weiterlaufen? | Run-ID, Status, Deadline, Budget, Owner oder Lease |
| Was soll der Agent als Nächstes tun? | Checkpoint der Loop oder des Graph State |
| Welcher Bericht wurde genehmigt? | Unveränderliche Artefaktversion oder Content-Hash und die Approval-Entscheidung |
| Ist die Veröffentlichung schon erfolgt? | ID der ausstehenden Operation, Argumente, Ergebnis und Ergebnis der externen Abfrage |
| Warum ist dieser Run fehlgeschlagen oder hat sein Budget verbraucht? | Korrelierte Events und Traces |
Diese Datensätze müssen keine fünf separaten Produkte sein. Eine Datenbank kann Run-Zeilen, Checkpoints und Operation Events in getrennten Tabellen halten. Ein Object Store kann Berichtsdateien halten. Ein Trace-Backend kann Zeitmessungen halten. Halten Sie die Datensätze getrennt, weil jeder etwas anderes belegt. Anthropics Bericht über Long-Running Agents beschreibt dasselbe Grundproblem aus Sicht des Models: Ein neuer Context erinnert sich nicht an die vorherige Arbeit, wenn die Anwendung ihm keinen dauerhaften Fortschritt zum Lesen gibt. Das Codex-Team von OpenAI berichtet von einzelnen Runs, die mehr als sechs Stunden an einer Aufgabe arbeiten, dies ist also kein seltener Fall.
Nennen wir eine angenommene Aufgabe einen Run. Er kann mehrere Model Sessions nutzen, wenn Contexts ersetzt werden, und eine Conversation kann mehrere Runs enthalten. Frameworks verwenden „Session“ und „Thread“ unterschiedlich. In LangGraph ist thread_id der Key der Checkpoint-Historie; legen Sie ausdrücklich fest, ob ein solcher Thread einem Run entspricht oder mehrere umfasst. Führen Sie in jedem Fall eine eigene Run-ID der Anwendung für das Operation Log. Die Session Backends des OpenAI Agents SDK halten eine veränderliche Conversation History, die bearbeitet, geleert und komprimiert werden kann; behandeln Sie ein solches Backend daher nicht als Append-only Recovery Log.
Der Workspace ist ein weiterer Teil des State. Bei einem Coding Agent kann ein Commit die wiederherzustellenden Dateien identifizieren; im Berichtsbeispiel kann ein unveränderlicher Object Key mit Hash die genehmigte Datei identifizieren. Eine pausierte Sandbox kann ein praktisches Filesystem erhalten, aber ihr Weiterbestehen sollte nicht der einzige Weg sein, das Ergebnis wiederherzustellen. Git worktrees trennen Checkouts; sie sind keine Execution Sandboxes.
Fünf Komponenten, die einen Platz brauchen
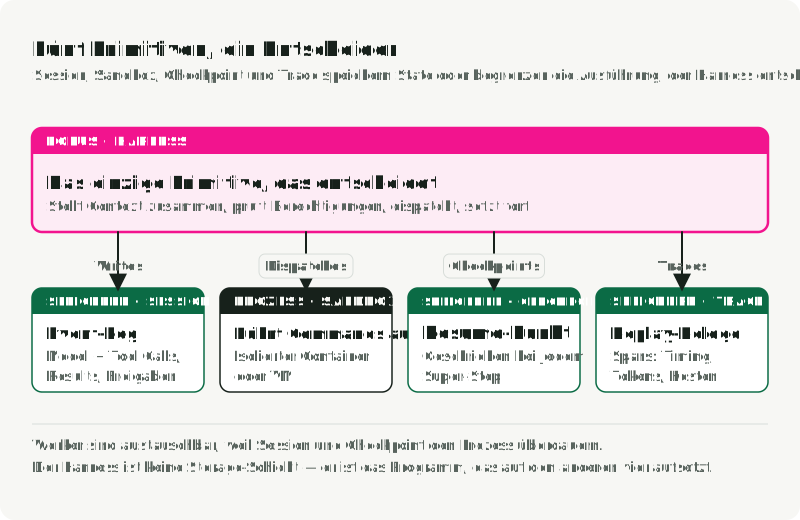
Anthropics Beitrag Scaling Managed Agents trennt Session, Harness und Sandbox. Dieser Artikel unterscheidet zusätzlich Checkpoints und Traces und beschreibt damit fünf Verantwortlichkeiten der Runtime. Eine Implementierung kann sie zusammenlegen, aber jede braucht einen Verantwortlichen und eine bekannte Ausfallgrenze. Die Abbildung zeigt sie in einem Aufbau aus Queue und Worker und beschriftet, was zwischen ihnen übergeben wird.
| Komponente | Aufgabe | Übliche Implementierung |
|---|---|---|
| Session | Append-only Log der Calls, Results und Approvals | Event-Tabelle in PostgreSQL mit Run-ID als Key |
| Harness | Model- und Tool-Turns steuern, bis die Aufgabe endet | LangGraph Graph, OpenAI Agents SDK Runner, eigene Loop |
| Sandbox | Commands mit Datei-, Netzwerk- und Prozessgrenzen ausführen | Gehärteter Container, microVM, Browser Sandbox |
| Checkpoint | Fortsetzen, ohne den ganzen Run erneut abzuspielen | LangGraph PostgreSQL oder Redis Saver, State der Workflow Engine |
| Trace | Einen Run nach seinem Ende debuggen | OpenTelemetry Spans an Tempo, Jaeger, Honeycomb, LangSmith |
Nur der Harness trifft Entscheidungen; die anderen vier speichern State oder beschränken die Ausführung. LangGraphs kompilierter Graph, LangChains Deep Agents und Claude Code sind in diesem Sinn Harnesses. Der Sandbox Guide des OpenAI Agents SDK zieht dieselbe Linie: Approvals, Tracing, Handoffs und Resume State gehören zur äußeren Runtime, Commands, Dateiänderungen und Environment Isolation zur Sandbox Session.
Sandboxes unterscheiden sich darin, wie lange sie leben. Eine fresh ephemeral Sandbox existiert für eine Aufgabe und zahlt jedes Mal die Startkosten. Eine persistent paused Sandbox behält ihr Filesystem und einen Memory Snapshot zwischen Runs, sodass das nächste Resume einen vollständigen Boot vermeiden kann. Eine snapshot or fork Sandbox erzeugt aus einem vorbereiteten Parent eine Copy-on-Write-Kopie, sodass viele Tasks installierte Dependencies teilen, ohne ihren beschreibbaren State zu teilen.
Zwei Anliegen betreffen alle fünf Komponenten. Permission Enforcement läuft vor jedem Tool Call. Die Filesystem Permissions von Deep Agents gelten nur für die integrierten Filesystem Tools; Shell Commands, eigene Tools und MCP Calls brauchen Enforcement in der Sandbox Policy oder hinter einem Tool Proxy. Secrets sollten weder das Model noch in der Regel die Sandbox erreichen. Anthropics Managed Agents klont Repositories während des Sandbox-Setups mit einem Token und leitet MCP Calls über einen Proxy, der die OAuth Tokens hält, sodass der Harness die Credentials nie sieht.
Prüfen Sie die Platzierung, indem Sie jede Komponente und ihre Implementierung aufschreiben. PostgreSQL könnte Session und Checkpoints halten, der Worker-Container führt den Harness aus, ein Provider wie Daytona, Modal oder E2B stellt die Sandbox, und Tempo oder LangSmith speichert Traces. Suchen Sie dann nach gekoppelten Ausfällen: Zwei Komponenten in einem Prozess fallen gemeinsam aus, und ein gemeinsames Credential überschreitet beide Grenzen, wenn es geleakt wird.
Checkpoint, Event Log und externer Datensatz beantworten verschiedene Fragen
Ein Checkpoint sagt, wo die Ausführung fortgesetzt werden kann: die bereits erzeugten Messages oder Graph-Werte, der abgeschlossene Schritt und der wartende Schritt. LangGraph speichert den Graph State an Super-Step-Grenzen. Sein Checkpointer kann auch erfolgreiche Node Writes behalten, wenn ein anderer Node im selben Schritt fehlschlägt. Das ist nützliche Fehlertoleranz, aber ein Checkpoint von Graph-Werten belegt nicht, ob ein Service außerhalb des Graphs einen Request committet hat.
graph.get_state() gibt einen StateSnapshot zurück, dessen .values den letzten bekannten Graph State enthalten; das ist in einem Debug Bundle nützlich. Weder er noch der Checkpoint können Events rekonstruieren, die der Harness nie geloggt hat.
Ein Operation Event Log sagt, was die Anwendung versucht und was sie erfahren hat: publish_requested, publish_pending, publish_succeeded oder needs_human, jeweils an einen Run und eine Operation-ID gebunden. Es kann in derselben Datenbank wie die Checkpoints liegen, sofern die Anwendung die Events tatsächlich schreibt. Die Checkpoint-Historie eines Graphs ist nicht automatisch dieses Log. Ein Chat-Transkript ist wiederum etwas anderes: Es hilft dem Model beim Weitermachen, muss aber nicht jede Approval, jedes Tool-Argument oder jeden Side Effect enthalten.
Der externe Service besitzt das maßgebliche Ergebnis der Veröffentlichung. Er bietet vielleicht einen Idempotency Key, eine Statusabfrage per Operation-ID oder eine Abfrage nach einem Objekt mit dem erwarteten Hash. Bietet er nichts davon, kann die Runtime aus einer fehlenden Response keinen Erfolg ableiten. Ein Trace kann zeigen, dass ein Request gesendet wurde und wie lange er dauerte, aber ein Span, der mit einem Timeout endet, klärt nicht, ob der entfernte Service ihn committet hat.
Der Unterschied zeigt sich, wenn Sie alten State erneut abspielen. LangGraphs Checkpoint Replay führt die Schritte nach dem gewählten Checkpoint erneut aus, einschließlich der API Requests in diesen Schritten. Es ist eine Funktion für Debugging und Control Flow, keine Exactly-once-Garantie für externe Effekte. Dieselbe Regel gilt für einen neuen Worker, der nach einem Crash fortsetzt.
Eine unsichere Veröffentlichung verfolgen
Der Bericht ist genehmigt und unter einer stabilen Artefakt-ID gespeichert. Jetzt bittet der Harness die Runtime, ihn zu veröffentlichen. Nehmen Sie an, dass der Publishing-Service den Request abschließen kann, auch wenn der Worker die Response verliert.
- Die Absicht festhalten. Bevor der Request den Worker verlässt, persistieren Sie eine eigene Operation-ID der Anwendung, den Hash des genehmigten Artefakts, das Ziel und den Status
pending. Binden Sie diese ID an genau diese Argumente. Eine vom Model erzeugte Tool-Call-ID kann sich nach einer Neuplanung ändern; sie ist nicht die Identität der fachlichen Action. - Die Action ausführen. Senden Sie dieselbe Operation-ID an den Publishing-Service, wenn seine API Idempotency unterstützt. Wenn nicht, verwenden Sie einen stabilen Object Key oder einen anderen vom Provider unterstützten Weg, das Ergebnis abzufragen. Der Worker darf nicht annehmen, dass ein Timeout bedeutet, dass der Service nichts getan hat.
- Das Ergebnis festhalten. Bei einer bestätigten Response speichern Sie die externe Ergebnis-ID und markieren die Operation als abgeschlossen, bevor der Run weiterläuft. Der nächste Checkpoint kann dann auf dieses Ergebnis verweisen.
- Die Lücke schließen. Angenommen, der Service hat den Bericht angenommen, aber der Worker ist vor Schritt 3 abgestürzt. Ein neuer Worker sieht
pending. Er fragt den Service, ob genau diese Operation oder dieses Artefakt existiert. Wenn ja, speichert er das wiederhergestellte Ergebnis und macht weiter, ohne eine zweite Kopie zu veröffentlichen. Wenn ein Retry unterstützt wird, verwendet er dieselbe Operation-ID und unveränderte Argumente. - Bei Unsicherheit anhalten. Wenn der Service keine Antwort geben kann und keine idempotenten Retries zusichert, lassen Sie die Operation zur Prüfung ungeklärt. Einen neuen Key zu erzeugen und den Request erneut zu senden, wäre eine neue Action mit dem Risiko einer doppelten Veröffentlichung.
Die folgende Sequenz zeigt den Absturz in Schritt 4, zwischen dem externen Erfolg und dem Speichern des lokalen Ergebnisses.
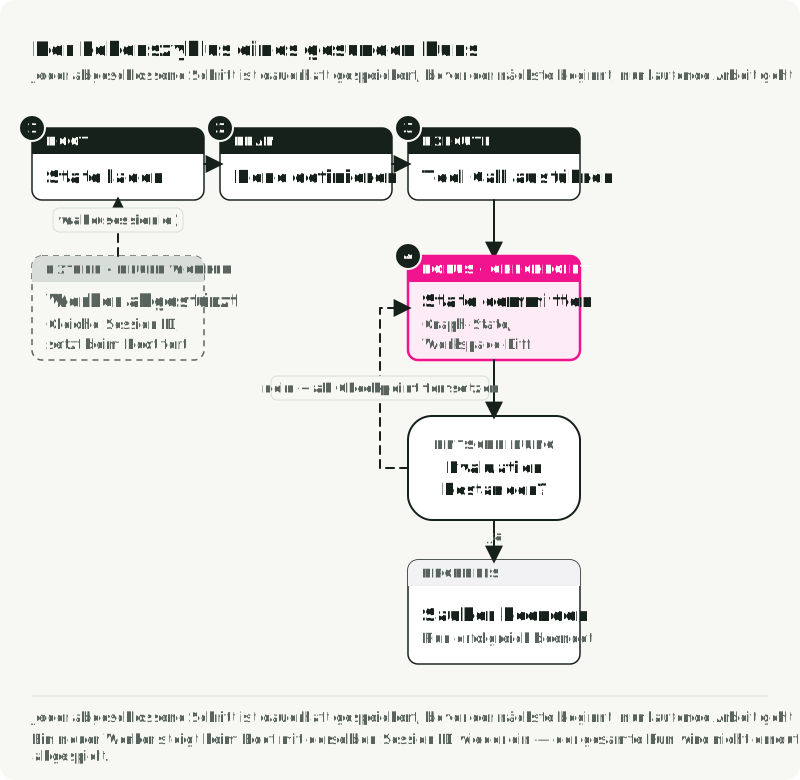
Der Workspace-Diff im Diagramm ist eine wiederherstellbare Dateiversion oder Referenz; der Graph-Checkpoint muss die Dateien selbst nicht enthalten.
Der Fall, für den Sie entwerfen müssen, ist ein Crash zwischen externem Erfolg und lokaler Speicherung des Ergebnisses. Keine Datenbanktransaktion kann einen Write in einem fremden Service atomar committen, ohne dass dieser Service mitwirkt. AWS’ Beitrag über idempotente APIs erklärt, warum eine vom Aufrufer gelieferte Request-ID die Absicht darstellt: Zwei identische Requests können zwei gewollte Actions sein, während zwei Retries mit einer ID eine Action darstellen sollten. Der empfangende Service muss diesen Contract einhalten und einen geänderten Payload unter derselben ID erkennen. Prüfen Sie seinen Deduplizierungszeitraum; ein abgelaufener Key ist kein dauerhaftes Versprechen. Stripe zum Beispiel gibt für einen wiederholten Idempotency Key das erste Ergebnis zurück und kann Keys nach frühestens 24 Stunden entfernen.
Dasselbe Protokoll gilt für das Senden einer E-Mail, das Belasten eines Kontos, das Öffnen eines Pull Requests oder die Änderung einer Datenbank, die einem anderen Service gehört. Die Methode zum Abgleich unterscheidet sich. Ein Provider kann zum Beispiel Idempotency Keys, eine Unique Constraint auf der Ressource, eine Read-after-Write-Abfrage oder überhaupt keine verlässliche Abfrage bieten. Entwerfen Sie die Retry Policy nach diesem Contract, nicht nach der Tatsache, dass das Agent Framework einen Node wiederholen kann.
Den Rest des Runs wiederherstellbar machen
Der unsichere externe Call ist der schwierigste Fall. Der übrige Run braucht trotzdem einige ausdrückliche Regeln:
- Ein aktiver Writer. Eine Queue kann Arbeit erneut ausliefern, wenn eine Lease abläuft. Verwenden Sie eine Run Lease mit Fencing oder bedingten Status-Updates, damit ein veralteter Worker den Run nicht weiterführen kann. Behalten Sie den Idempotency-Schutz für bereits laufende Calls. Bestätigen Sie einen Job erst, wenn der State, den er darstellt, dauerhaft gespeichert ist. Die Recovery beginnt mit der Prüfung ausstehender Operationen, nicht mit einem blinden Neustart des Models. Legen Sie fest, was neuer User-Input während eines Runs bedeutet: ablehnen, einreihen, unterbrechen oder zurückrollen; LangChains Beitrag über die Runtime von Deep Agents beschreibt diese Optionen.
- Ein dauerhaftes Warten. Wenn die Veröffentlichung eine Approval braucht, persistieren Sie die vorgeschlagene Action und ihre exakten Argumente. Setzen Sie mit der Approval-Entscheidung fort und prüfen Sie sie erneut, wenn sich die vorgeschlagene Action ändert. Halten Sie keinen Worker-Prozess offen, nur um auf eine Person zu warten.
- Ein begrenzter Run. Persistieren Sie die Deadline, Call- oder Tool-Limits und das Ausgabebudget. Reservieren Sie Budget vor einem parallelen Dispatch, damit nicht zwei Calls denselben Rest ausgeben können; gleichen Sie den tatsächlichen Verbrauch danach ab. Ein Abbruch stoppt neue Calls und speichert die Anfrage, kann aber einen laufenden externen Effekt nicht rückgängig machen. Ein Metrics-Alert oder ein Budget auf Provider-Seite, etwa Anthropics Task Budgets in der Beta, ist ein zweites Signal; das Model kann ein beratendes Budget überschreiten, führen Sie das Dispatch Ledger also in jedem Fall.
- Wiederherstellbare Arbeit. Speichern Sie eine Referenz auf das genehmigte Artefakt, seinen Hash und die Workspace-Version, die es erzeugt hat. Ein wiederhergestellter Prozess sollte die Datei vor der Veröffentlichung validieren können. Große Dateien gehören in einen Artifact Store, nicht in jeden Graph-Checkpoint.
- Eine Ausführungsgrenze. Wenn ein Tool generierten Code ausführt, Packages installiert oder nicht vertrauenswürdige Seiten aufruft, führen Sie es in einer Umgebung mit den nötigen Datei-, Netzwerk- und Prozessbeschränkungen aus. Halten Sie langlebige Credentials aus dem für das Model sichtbaren Context heraus; setzen Sie Permissions dort durch, wo die Action ausgeführt wird. Ein Container oder ein Checkout pro Worktree allein schafft nicht die Isolation, die Ihr Threat Model womöglich verlangt.
Wählen Sie bei LangGraph die Checkpoint-Durability bewusst. Sein "sync"-Modus persistiert jeden Checkpoint, bevor der nächste Schritt beginnt; "async" kann bei einem Prozess-Crash einen aktuellen Checkpoint verlieren, und "exit" speichert keinen Zwischenstand gegen einen Crash mitten im Run. Auch "sync" schließt die oben beschriebene Lücke bei externen Effekten nicht. Event Log und Abgleichslogik bleiben Aufgabe der Anwendung.
Ausfälle, die lange Runs hinzufügen
Wenn Runs mehrere Worker und Context Windows überspannen, verlagern sich die Ausfälle zu State, doppelten Side Effects, auseinanderlaufenden Workspaces und Kosten. Jeder von ihnen braucht eine Kontrolle außerhalb des Model-Speichers, damit sie auch nach einem Restart noch wirkt. Die Abbildung ordnet jede Kontrolle dem Schritt des Run Loops zu, in dem sie greift; die Tabelle ergänzt, wo sie umgesetzt wird.
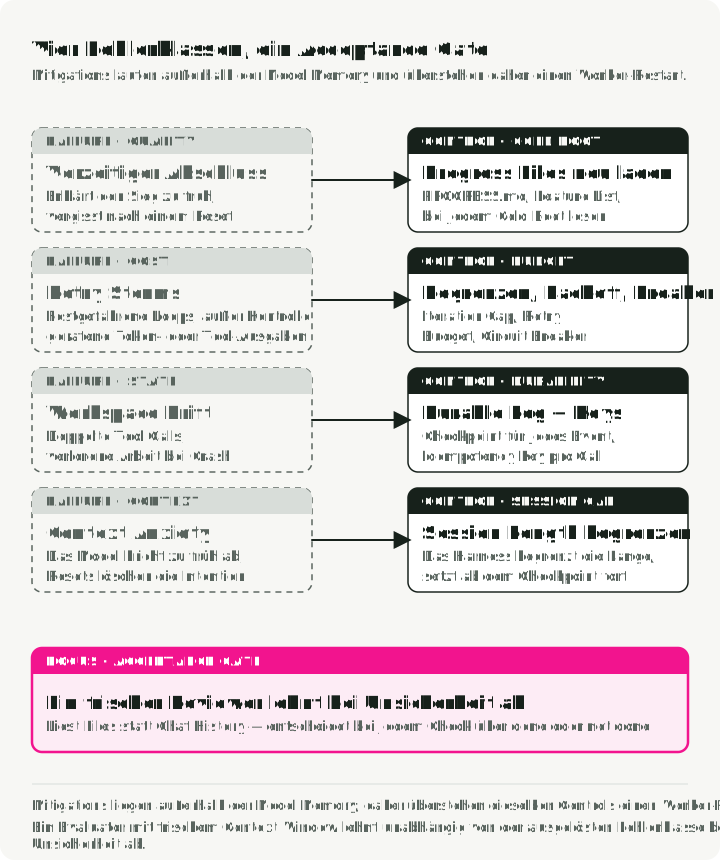
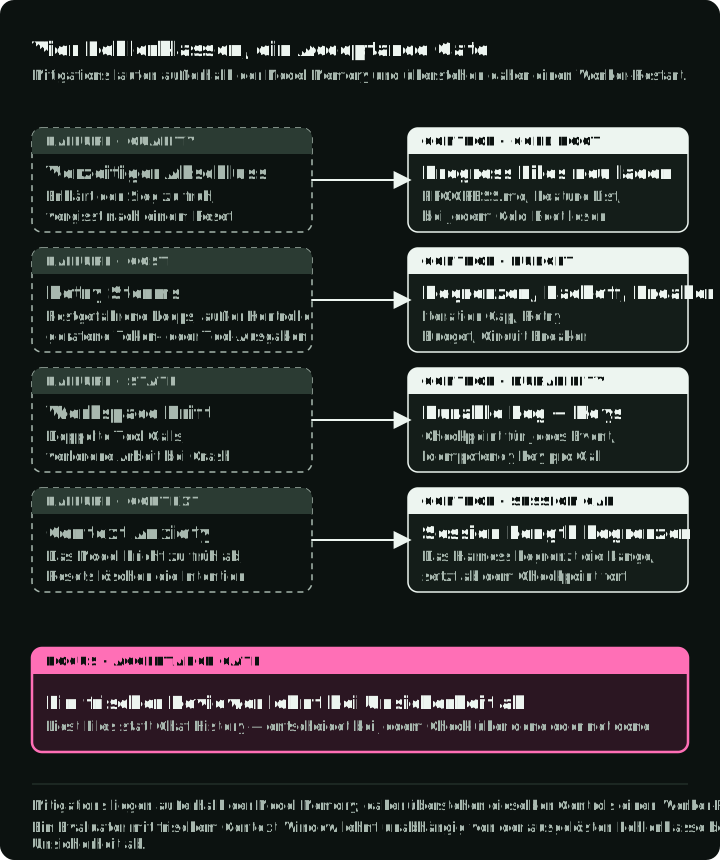
| Ausfall | Kontrolle | Wo sie läuft |
|---|---|---|
| Agent erklärt die Aufgabe zu früh für erledigt | Acceptance Checks auf Artefakten; optional ein Evaluator mit frischem Context ohne Schreib-Tools | Abschlussschritt im Harness; Evaluator in eigener Sandbox Session |
| Agent vergisst erledigte Arbeit nach einem Context Reset | Fortschrittsdateien wie PROGRESS.md und feature-list.json, vor dem ersten Model Call gelesen | Boot Hook jeder Model Session |
| Model fasst zusammen und stoppt nahe seinem Limit zu früh | Session begrenzen und aus Handoff und Checkpoint eine neue starten | Längenlimit der Session im Harness |
| Endlosschleifen und unbegrenzte Retries | Iterationslimit, exponentielles Backoff, Circuit Breaker auf die Tool-Fehlerrate, festes Tool-Call-Budget | Tool-Execution-Node; RetryPolicy auf Temporal Activities |
| Agent bearbeitet Dateien, die einem anderen Run gehören | Workspace pro Run, Git Commits als Wiederherstellungspunkte, Datei-Policy in Sandbox oder Tool Proxy | Sandbox Policy; Deep-Agents-Permissions für die integrierten Datei-Tools |
| Token- oder Tool-Kosten überschreiten das Budget | Budget vor dem Dispatch reservieren, Output begrenzen, Verbrauch abgleichen | Budget Ledger im Dispatch-Pfad; Prometheus-Alerts als zweites Signal |
| Ein Tool Call läuft nach einem Crash zweimal | pending und einen Idempotency Key vor dem Dispatch persistieren; beim Resume mit demselben Key abfragen oder wiederholen | Event Store plus Idempotency- oder Lookup-API des Providers |
| Arbeit geht verloren, wenn ein Worker oder eine Sandbox stirbt | Dauerhaftes Event Log, Checkpoint nach jedem Super-Step, ausstehende Effekte vor dem Weitermachen abgleichen | PostgresSaver plus Event-Tabelle oder ein Temporal Workflow |
Anthropics Quick-Start cwc-long-running-agents enthält die Muster für Evaluator und Fortschrittsdateien. Vorzeitiges Stoppen nahe dem Context Limit hängt vom Model ab, testen Sie jeden Workaround also erneut, wenn sich das Model ändert. Wie Anthropic es formuliert, kodiert jede Komponente eines Harness eine Annahme darüber, was das Model nicht kann, und diese Annahme kann veralten, wenn sich das Model ändert.
Transportausfälle, die der Run Loop abfangen muss
Ein Stream kann mitten in der Antwort abbrechen. Die Verbindung kann abreißen, nachdem erst eine halbe Antwort oder ein halber Tool Call angekommen ist. Tool-Argumente treffen als JSON-Fragmente ein, die sich erst parsen lassen, wenn der Block vollständig ist; ein nur teilweise zusammengesetzter Call darf deshalb nie den Dispatch erreichen. Einen abgeschnittenen Befehl auszuführen ist genau das, was die Permission-Schicht verhindern soll. Behandeln Sie einen abgebrochenen Stream als fehlgeschlagenen Request: Verwerfen Sie das Fragment, hängen Sie es nie als Aussage des Models an und wiederholen Sie den gesamten Call. Das ist bezahlbar, weil der bereits gesendete Prefix beim Retry ein Cache Read ist. Halten Sie den Retry unterhalb des Agent Loops, im Call Wrapper, damit ein wiederholter Request nie ein Tool erneut ausführt, das bereits gelaufen ist.
Streaming ist bei wachsenden Requests außerdem nicht mehr optional. Provider erzwingen Timeouts für Requests ohne Streaming und verlangen Streaming ab bestimmten Output-Größen, und SDKs streamen bei langen Calls mitunter im Hintergrund. Eine Production-Runtime streamt deshalb in der Regel alles und akkumuliert das Ergebnis, selbst wenn keine Oberfläche die Fragmente braucht. Eintreffende Tokens dienen dann zugleich als Liveness-Signal: Solange sie weiter eintreffen, lebt der Call; ein Stream, der eine Minute lang still bleibt, ist daher ein Hinweis auf einen Stillstand. Ein Request ohne Streaming sagt nichts, bis er zurückkehrt.
Rate Limits werden in Tokens gemessen, nicht in Requests. Provider messen Input- und Output-Tokens pro Minute, sodass ein Agent mit einem großen Request ein Limit bei einer Request-Rate ausschöpft, die trivial niedrig wirkt. Context-Wachstum zeigt sich daher als 429-Antworten statt als Latency-Problem, und paralleles Fan-out vervielfacht den Druck mit der Größe jedes Requests statt mit der Anzahl der Worker. Setzen Sie ein Concurrency Cap und teilen Sie ein gemeinsames Token-Budget in der Komponente, die parallele Arbeit startet; Backoff innerhalb jedes Workers verteilt denselben Bedarf nur über die Zeit. Zählen Sie pro Run die 429-Antworten und den genutzten Endpoint, damit ein Provider-Limit nicht für eine Eigenschaft der getesteten Konfiguration gehalten wird.
Die Runtime braucht außerdem Belege, um einen Run zu diagnostizieren. Geben Sie eine Run-ID und eine Operation-ID zusammen mit Model und Tool Spans, Status, Dauer und Token-Verbrauch aus. Die GenAI Conventions von OpenTelemetry geben diesen Feldern gemeinsame Namen, auch wenn sich die Conventions noch entwickeln. Prompt-Text, Tool-Argumente und Results können sensible Daten enthalten; entscheiden Sie, ob sie in die Telemetrie gehören, bevor Sie sie erfassen. Ein Trace hilft, einen Ausfall zu erklären. Event Log und externe Abfrage entscheiden, ob Weitermachen sicher ist. Der Observability-Abschnitt weiter unten macht daraus einen Stack.
Die Deployment-Form aus den Warte- und Ausfallregeln ableiten
Der Plattformname ist eine späte Entscheidung. Fragen Sie zuerst, ob der Aufrufer das Endergebnis im selben Request braucht, ob der Run warten darf und wer seinen dauerhaften State betreiben wird.
| Bedarf | Ausgangsform | Was sie noch braucht |
|---|---|---|
| Kurze Aufgabe, innerhalb eines Requests erledigt | Agent Loop im Request Handler | Eine separate Ausführungsgrenze für nicht vertrauenswürdige Tools; dauerhaften State, wenn Retry oder Fortsetzung zählt |
| Hintergrundarbeit, die einen Worker überdauern kann | Queue, austauschbarer Worker, dauerhafter State | Run Leases, Checkpoints, Operation Log, bei Bedarf Artifact Store |
| Viele Approvals, Timer, Callbacks oder Retries über Deployments hinweg | Durable Workflow Engine mit Workern für Model und Tool Calls | Replay-sichere Workflow-Änderungen und idempotente externe Activities |
Die Run-Dauer ist ein nützlicher erster Filter, auch wenn sie nicht das ganze Design bestimmt. Die Abbildung ordnet jede Startform auf einer logarithmischen Skala der Run-Dauer ein, über den Zeitlimits gängiger Plattformen:
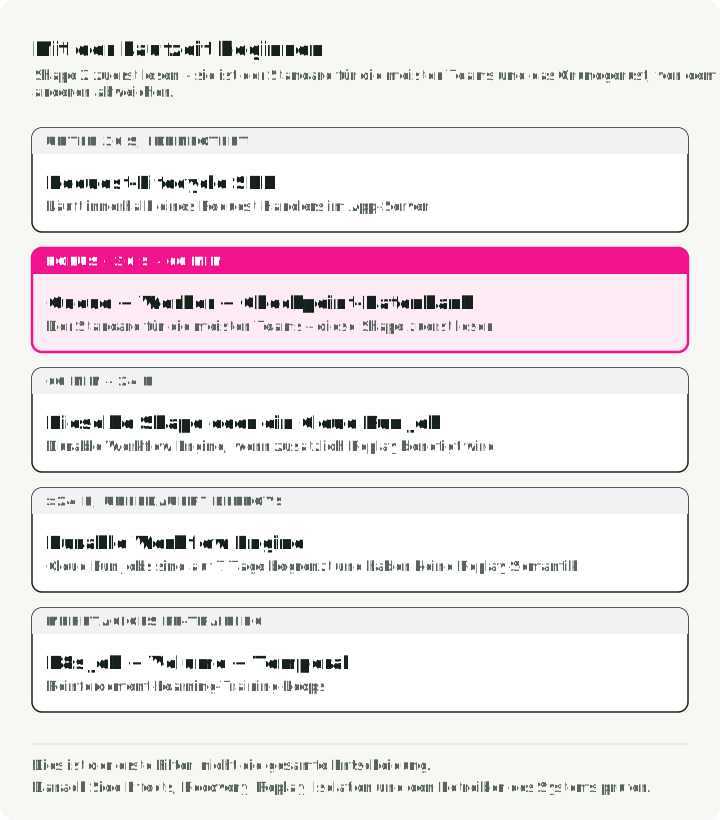
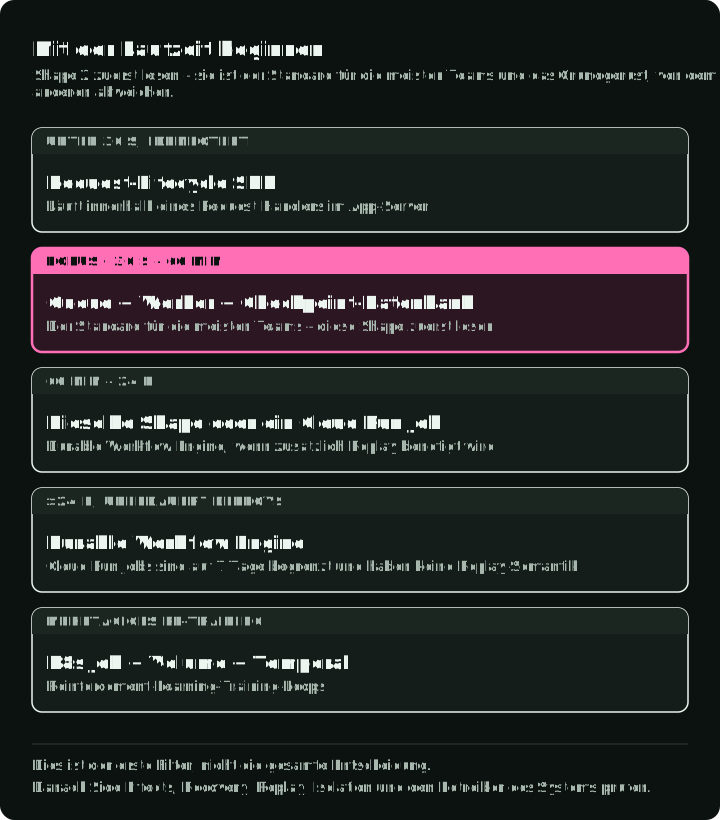
- Unter 30 Sekunden, idempotent: das Agent SDK in einem Request Handler des App-Servers.
- 30 Sekunden bis 60 Minuten: Queue, Worker und Checkpoint-Datenbank.
- 60 Minuten bis 24 Stunden: dieselbe Queue und derselbe Worker oder ein Cloud Run Job für einmalige Arbeit; eine Workflow Engine, wenn Sie zusätzlich Versionierung und Replay brauchen.
- Mehr als 24 Stunden, über Deployments hinweg: eine Durable Workflow Engine wie Temporal.
- Mehrtägige Trainings-Loops für Reinforcement Learning: ein Kubernetes Job mit einem Volume, plus Temporal.
Prüfen Sie nach diesem Filter Side Effects, Recovery, Replay, Isolation, Datenstandort und das Team, das das System betreiben wird.
Ich würde das Berichtsbeispiel mit Queue und Worker beginnen. Die API gibt eine Run-ID zurück; der Worker treibt den Harness voran; ein dauerhafter Store speichert Checkpoints und ausstehende Operationen; ein Artifact Store hält den Bericht. Dieses Design erfüllt die konkreten Anforderungen an Restart und Approval, ohne eine bestimmte Cloud vorauszusetzen. Wenn die Warte- und Retry-Regeln selbst zu einem Workflow werden, kann Temporal die Ausführungshistorie persistieren und Workflow-Entscheidungen erneut abspielen. Seine Activities führen externe Calls weiterhin aus und können wiederholt werden, brauchen also dasselbe Design für Idempotency oder Abgleich.
Cloud-Services implementieren diese Formen; ihre Timeouts definieren nicht die Architektur. Ein Cloud Run Service Request hat eine Deadline und kann nach dem Schließen der Verbindung weiterarbeiten, ein HTTP-Timeout ist also ein besonders schwacher Beleg dafür, dass eine Action gestoppt wurde. Ein Cloud Run Job, ein ECS Task oder ein Kubernetes Job kann einen Hintergrund-Worker hosten, aber ein langes Task-Limit allein gibt ihm keinen dauerhaften Fortschritt. Ein gewöhnlicher AWS-Lambda-Aufruf ist auf 15 Minuten begrenzt; ein Workflow kann sich über mehrere begrenzte Aufrufe erstrecken. Prüfen Sie vor dem Deployment die aktuellen Limits und das Retry-Verhalten des gewählten Services.
Eine gehostete Agent-Plattform kann die Loop und einen Teil ihres State für Sie betreiben. Bewerten Sie sie mit derselben Ausfallübung: Wie exportieren Sie den Run State, finden einen ausstehenden Side Effect, binden eine Approval an eine Action, prüfen die an die Control Plane gesendeten Daten und setzen nach einem Deployment fort? Halten Sie den Sandbox-Contract der Plattform getrennt von ihrem Harness-Contract. Ein gehosteter Harness macht seine Tools nicht automatisch sicher, und eine gehostete Sandbox macht den Run nicht automatisch dauerhaft.
Was jede Form Ihnen gibt
Die Matrix nennt die Komponente, die in jeder Form jede Verantwortlichkeit übernimmt, markiert die Zellen, die ein gehosteter Anbieter betreibt, und hebt die Zellen hervor, die allein nicht ausreichen. Die Anmerkungen danach nennen die Limits, die zwischen ihnen entscheiden, geprüft im September 2026.
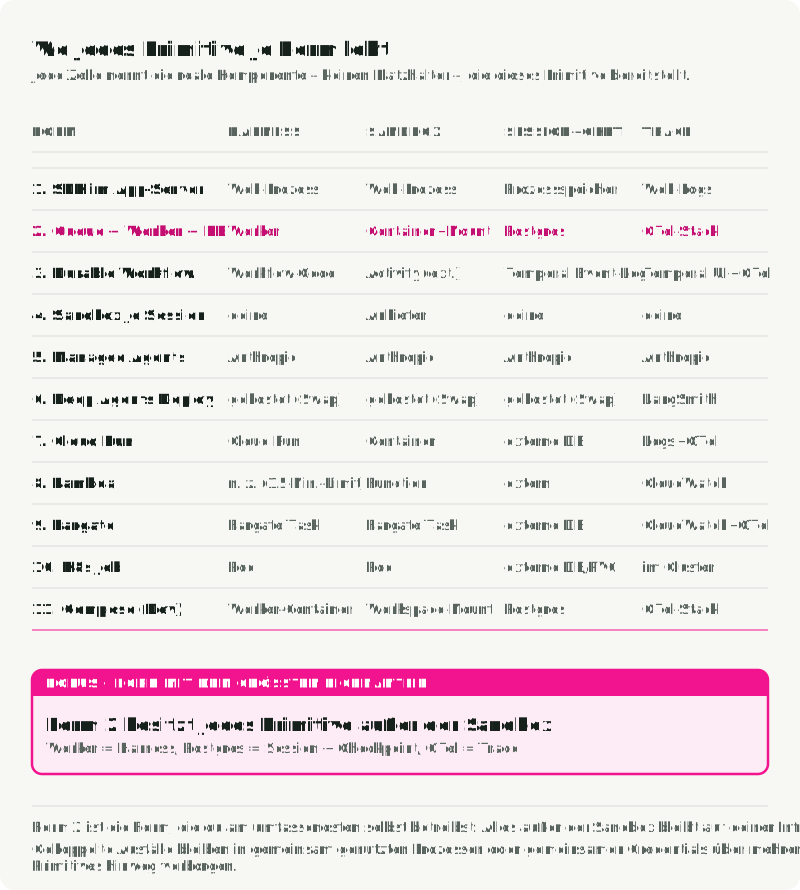
1. SDK in einem App-Server. Der Agent läuft in einem Request Handler. Das passt zu Aufgaben unter etwa 30 Sekunden, Demos und internen Tools. Ein Absturz der Web-Schicht verliert die Arbeit im Prozessspeicher. Ein Verbindungsabbruch des Clients kann die Arbeit abbrechen oder weiterlaufen lassen, je nach Server und Anwendung; er belegt nicht das Ergebnis einer externen Handlung. Speichern Sie den State dauerhaft, wenn die Fortsetzung wichtig ist, und verwenden Sie keinen Request Handler für mehrstündige Arbeit.
2. Queue, Worker und Checkpoint-Datenbank. Meine Standardempfehlung für die meisten Teams: ein Python-Worker mit PostgreSQL Checkpointer und Redis Streams oder RabbitMQ für eingehende Jobs. Der Market Analyst Agent demonstriert diese Form mit einem separat gestarteten Queue-Worker. Im Produktionsentwurf legt die App eine Run-Zeile an, stellt einen Job ein und gibt die Run-ID zurück; der Worker führt den Harness aus, schreibt Events und Checkpoints und speichert Artefakte. Die Queue-Tiefe liefert Backpressure, und Spot- oder Preemptible-Compute funktioniert, wenn die dauerhaften Writes abgeschlossen sind, bevor der Worker den Job bestätigt. Der Worker ist der Harness; nicht vertrauenswürdiger Code braucht weiterhin eine gehärtete Sandbox.
3. Durable Workflow Engine. Die Agent Orchestration läuft in einem Temporal Workflow, und Model und Tool Calls laufen als Activities. Der Workflow State liegt in einer Event-Historie auf Cassandra, MySQL oder PostgreSQL, sodass er sich über Ausfälle hinweg erneut abspielen lässt, und ein untätiger Workflow verbraucht kein Compute. Eine Human Approval wird zu einem dauerhaften Warten statt zu einer Polling-Loop. Codeänderungen, die eine laufende Ausführung überlappen, brauchen replay-sicheres Worker Versioning oder Patches. Temporals Integration des OpenAI Agents SDK führt Agent-Tools als Activities aus; prüfen Sie die Liste der nicht unterstützten Agent-Funktionen, bevor Sie sich darauf verlassen.
4. Ein Sandbox-Provider pro Run. Jeder Run bekommt eine eigene microVM oder einen eigenen Container von einem Provider, während Harness, Session, Checkpoint und Trace auf Ihrer Seite bleiben, meist in Form 2. Verwenden Sie sie, wenn der Agent nicht vertrauenswürdigen Code, Browser-Automatisierung, Tests oder Package-Installationen ausführt; der Preis sind höhere Kosten und Abhängigkeit vom Provider.
| Provider | Isolation | Grenzen für Session und Persistenz |
|---|---|---|
| E2B | Firecracker microVM | 1 h Hobby, 24 h Pro durchgehende Sessions; Pause und Resume separat |
| Vercel Sandbox | Firecracker microVM | 45 min Hobby, 24 h Pro und Enterprise; Snapshots verfallen standardmäßig 30 Tage nach der letzten Nutzung |
| Daytona | Vom Provider konfigurierte Sandbox | Konfigurierbarer Lifecycle für Stop und Archivierung; Forks speichern ihren Parent |
| Modal | gVisor | 5 min Standard, 24 h Maximum; Volumes und Snapshots haben eigene Persistenzregeln |
| Runloop | microVMs, laut Marketplace-Eintrag | Suspend und Resume; Disk Snapshots und Branches |
Die Startzeiten der Provider messen unterschiedliche Intervalle und sind daher kein Geschwindigkeitsranking. Modals Container-Boot von etwa einer Sekunde schließt zum Beispiel den Start der Anwendung nicht ein. Messen Sie die Zeit vom API Request bis zum ersten erfolgreichen Command und bis zu einem einsatzbereiten Zustand der Anwendung, bei dem p95 und p99, die Sie brauchen, und prüfen Sie die Concurrency-Limits des Accounts vor einem Load Test.
5. Anthropic Managed Agents. Gehostete Session, Harness, Sandbox und ein Vault-gestützter MCP Proxy, seit dem 8. April 2026 in der Public Beta. Abgerechnet werden die Standard-Token-Preise plus $0.08 pro Session-Stunde, solange eine Session läuft; Leerlaufzeit ist kostenlos, und Sessions haben keinen Batch-Modus. Eine durchgehend laufende Session kostet vor Tokens etwa $58 im Monat. Über Bedrock oder Vertex AI ist der Dienst nicht verfügbar. Mit Self-hosted Sandboxes betreiben Sie Ausführung und Egress selbst, aber Tool-Inputs und Results erreichen weiterhin die Control Plane von Anthropic. Ein späterer Wechsel bedeutet eine neue Plattform.
6. LangChain Deep Agents Deploy. deepagents deploy verpackt eine deepagents.toml in ein LangSmith Deployment mit Durable Execution, Memory, Human-in-the-Loop, sandboxed Code und geplanten Runs, im Cloud-, Hybrid- oder Self-hosted-Modus. Der Sandbox-Provider (LangSmith Sandboxes, Daytona, Modal, Runloop oder eigener) ist ein einzelner Konfigurationswert. Der Harness steht unter MIT-Lizenz und nutzt das offene Format AGENTS.md, der Lock-in ist also geringer als bei Form 5.
7. Google Cloud Run. Ein Service verarbeitet HTTP und skaliert auf null; sein Request Timeout beträgt standardmäßig 300 Sekunden und maximal 60 Minuten. Ein Job läuft ohne HTTP bis zum Ende; Tasks haben standardmäßig 10 Minuten und maximal 168 Stunden (7 Tage), mit GPUs 1 Stunde. Verwenden Sie einen Service für synchrone Runs bis 60 Minuten und einen Job für längere einmalige Arbeit. Keiner von beiden behält State über Runs hinweg oder spielt über Deployments hinweg erneut ab, Sessions und Checkpoints gehen also nach PostgreSQL, Spanner oder in einen ähnlichen Store.
8. AWS Lambda. Eine Funktion läuft nach 15 Minuten in ein Timeout. Hinter API Gateway bekommt ein synchroner Request etwa 30 Sekunden, sofern keine regionale oder private REST API ihr Limit erhöht. Lambda Durable Functions, im Dezember 2025 eingeführt, ergänzen Checkpoints, Steps und Wartezeiten über Ausführungen von bis zu einem Jahr, während jeder Aufruf begrenzt bleibt.
9. AWS ECS oder Fargate, ein Task pro Run. Fargate hat kein dokumentiertes Laufzeitlimit und gibt jedem Task im awsvpc-Modus ein eigenes Netzwerkinterface, was zu Datenzugriff innerhalb der VPC passt. Es unterstützt keine GPUs; verwenden Sie dafür ECS auf EC2. Fargate Spot fügt ein Unterbrechungsrisiko hinzu, und Durability ist Ihre Aufgabe. Vergleichen Sie auch Amazon Bedrock AgentCore Runtime, das Agent-Code mit verwalteten Sessions bis zu 8 Stunden auf serverlosen microVMs hostet, oder 14 Tage auf seinem Compute-Typ Instances, der GPUs unterstützt.
10. Kubernetes Job pro Run. Ein Job pro Run mit activeDeadlineSeconds, einem PersistentVolumeClaim für den Workspace und einem MCP Sidecar. Das passt zu Teams, die Kubernetes bereits betreiben; Cold Starts schließen es für einen Start unter einer Sekunde aus, und die Crash Recovery müssen Sie selbst bauen. Starke Isolation hängt weiterhin von Runtime Class, Network Policy und Pod Security ab. GPU-Ausführung braucht GPU-Nodes, Treiber und ein Device Plugin.
11. Lokales Docker Compose, nur für die Entwicklung. Der Begleitcode startet eine Gradio-App und die Datenspeicher aus Form 2, mit einem Workspace-Volume und ohne gehärtete Sandbox. Sein Queue-Worker startet separat. Der Referenzaufbau unten unterscheidet diese Prozesse.
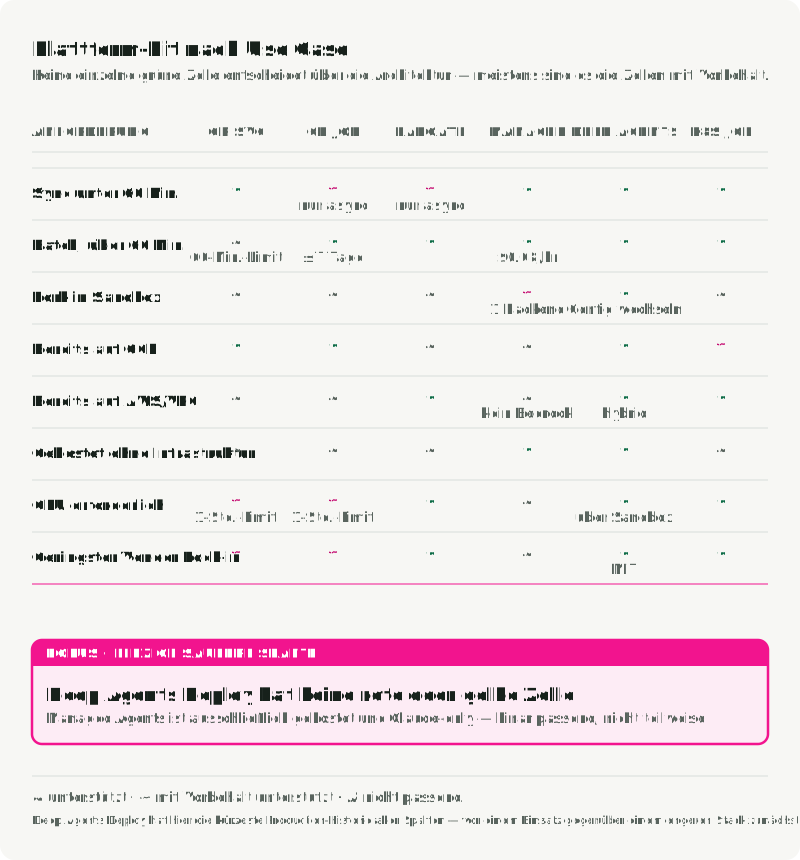
In der Matrix entscheiden meist die Zellen mit Einschränkung über die Wahl, nicht die Häkchen. Breite Abdeckung zeigt weder Datenresidenz noch Replay-Semantik, Abhängigkeit vom Provider oder die Kosten eines späteren Umzugs des State.
Gehosteter oder eigener Harness. Gehostet heißt, dass der Anbieter die Loop betreibt und Sie eine API aufrufen; eigen heißt, dass Sie die Loop betreiben, auch wenn der Code von einem Anbieter stammt. LangChain steht auf beiden Seiten: LangGraph ist eine Library, die Sie selbst ausführen, und Deep Agents Deploy betreibt im Cloud-Modus einen Harness für Sie. Wählen Sie gehostet, wenn Model-Unterstützung, Datengrenze, Recovery-Verhalten und Erweiterungspunkte bereits passen. Wählen Sie eigen, wenn Sie erwarten, dass sich diese Anforderungen ändern, und testen Sie den Ausstiegsweg, bevor Produktionsdaten davon abhängen.
Gehostete Sandbox oder eigene Ausführungsumgebung. Wählen Sie eine gehostete Sandbox, wenn ihre Isolation, Pause und Resume oder ihr Fork-Verhalten zum Threat Model und zum Startzeit-Budget passt. Docker oder Fargate können für vertrauenswürdige interne Arbeit passen, die VPC-Zugriff oder strikte Datenresidenz braucht, aber ein Standard-Container reicht für feindlichen Code nicht aus; Part 4 behandelt die Isolationsoptionen.
Die State-Grenze in eine LangGraph-Anwendung einbauen
Der folgende Ausschnitt zeigt nur den Graph-State-Teil der Queue-und-Worker-Form. Er nimmt an, dass builder ein bestehender StateGraph ist, run_id die dauerhafte Run-Kennung und task der neue Request. Der Worker hat eine PostgreSQL-Verbindung in DATABASE_URL und die Berechtigung, Checkpointer-Tabellen anzulegen. Das ist eine illustrative Verdrahtung, kein vollständiger Publishing-Worker.
import os

from langgraph.checkpoint.postgres import PostgresSaver

with PostgresSaver.from_conn_string(os.environ["DATABASE_URL"]) as checkpointer:
    checkpointer.setup()  # once during setup or migration
    graph = builder.compile(checkpointer=checkpointer)
    graph.invoke(
        {"messages": [{"role": "user", "content": task}]},
        {"configurable": {"thread_id": run_id}},
        durability="sync",
    )
Die thread_id ist LangGraphs Lookup Key für Checkpoints, keine Operation-ID und kein Beleg, dass die Veröffentlichung stattgefunden hat. Die Anwendung muss weiterhin Run-Zeile, genehmigtes Artefakt, ausstehende Operation und Ergebnis persistieren. Sie muss außerdem unterbrochene Jobs zurückholen und festlegen, was neuer Input während eines aktiven Runs bedeutet. Setzen Sie einen unsicheren Publish-Node nicht fort, indem Sie ihn einfach erneut aufrufen. Gleichen Sie zuerst ab und geben Sie dann das wiederhergestellte Ergebnis an den Graph.
Git, die Checkpoint-Datenbank und Object Storage
Lange Runs nutzen meist drei Stores gleichzeitig, weil jeder ein anderes Artefakt hält.
- Git hält den Workspace: Code, Dokumente und Fortschrittsdateien. Verwenden Sie es, wenn die Arbeit Code-artig ist oder die Dateihistorie zählt. Legen Sie einen Run-Branch an, machen Sie einen Initializer Commit und committen Sie nach dem Setup, nach jedem Feature und nach bestandenen Tests. Speichern Sie den neuesten Commit-SHA neben dem Checkpoint. Beim Resume checkt der nächste Worker den Branch aus, liest
git log --oneline -8, prüftgit statusund den letzten Diff und liest dann die Handoff-Datei. Git kann nicht sagen, welcher Graph Node als Nächstes läuft, welcher Call auf eine Approval wartet oder welcher Retry seinen Idempotency Key verwendet hat. Lassen Sie es weg, wenn das Produkt eine einzelne Antwort ist. - Die Checkpoint-Datenbank hält den Graph State: was entschieden wurde, welche Nodes gelaufen sind und was als Nächstes läuft. Verwenden Sie Checkpointing im Stil von
PostgresSaver, wenn Zwischenstände zwischen Nodes zählen, etwa bei Planner, Researcher, Writer und Verifier. - Ein Object Store wie S3 oder GCS hält große Outputs: PDFs, Parquet-Dateien, Screenshots. Verwenden Sie ihn, wenn der Output für die Checkpoint-Datenbank zu groß ist, wenn Konsumenten eine URL brauchen, ohne über den Agent zu gehen, oder wenn Ergebnis und Run unterschiedliche Aufbewahrungsfristen haben. Sie könnten Run-Logs nach 30 Tagen löschen und den finalen Bericht jahrelang behalten. Verwenden Sie
(thread_id, checkpoint_id, artifact_name)als Key der Objekte, damit der erzeugende Run nachvollziehbar bleibt.
Der Referenz-Stack in Docker Compose
Der Market Analyst Agent ist der Lernbegleiter dieser Serie. Im Repository-Stammverzeichnis, mit verfügbarem Docker Compose und einer aus .env.example vorbereiteten .env, startet make docker-up über docker/docker-compose.yml PostgreSQL, Qdrant, Redis und die App. Der Standardbefehl der App startet die Gradio-Oberfläche, die den Harness synchron aufruft. make worker startet den Redis-Queue-Verbraucher separat; es benötigt uv und Python 3.13+, installiert die Projektabhängigkeiten und startet die Datenbanken. Konfigurieren Sie die Provider-Schlüssel in .env, bevor Sie eine Live-Analyse starten. make mcp-up und make observability-up aktivieren die optionalen MCP- und Observability-Profile.
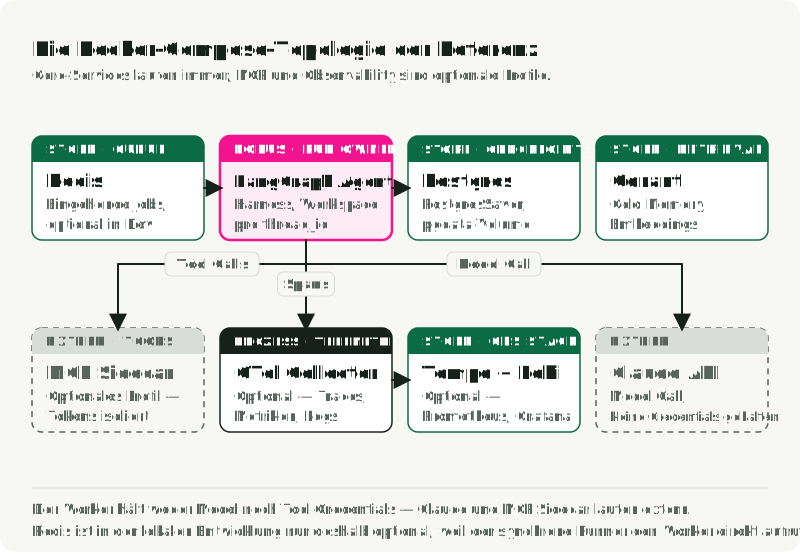
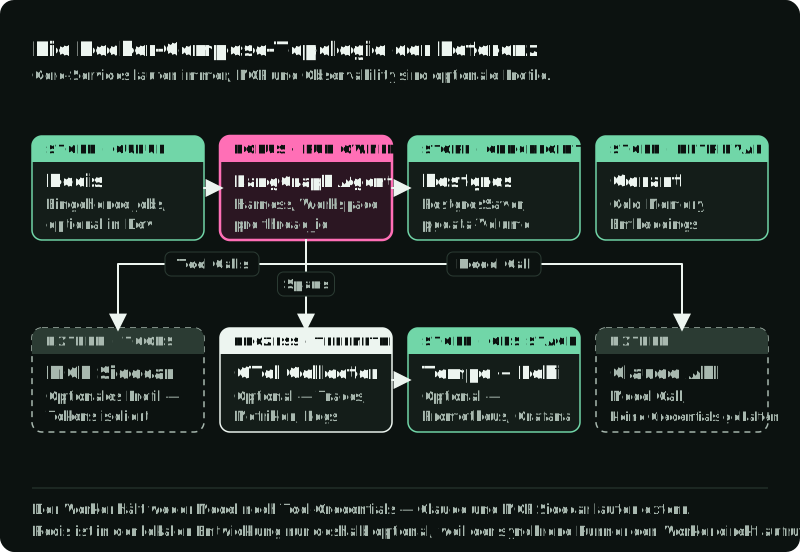
Die konfigurierten Observability-Pfade sind unvollständig. Der Collector hat nur eine Trace-Pipeline zu Tempo. Sein Include-Filter mit strict vergleicht gen_ai.operation.name mit dem Literal .+, sodass übliche Werte wie chat und execute_tool nicht übereinstimmen und ausgeschlossen werden; der Matcher von Collector 0.117.0 bestätigt den Gleichheitsvergleich. Prometheus fragt app:9464 und die eigenen Metrics des Collectors direkt ab; App-Metrics benötigen METRICS_ENABLED=true. Der Trace-Export der App benötigt auch einen OTLP-Endpunkt. Loki hat ein Backend und eine Grafana-Datenquelle, aber keine konfigurierte Log-Eingabe. Korrigieren Sie den Trace-Filter und ergänzen Sie die Log-Aufnahme, bevor Sie gefüllte Traces und Logs erwarten; ein Containerstart belegt nicht, dass die Dashboards funktionieren.
Für einen Worker-Container ergänzen Sie einen ausdrücklichen Worker-Dienst und geben parallelen Schreibern dasselbe Workspace-Volume; die Standard-Compose-App ist kein Queue-Verbraucher. Ergänzen Sie in Produktion neben den Checkpoints eine Event-Tabelle für Tool-Absichten und -Ergebnisse und testen Sie den Abgleich für Ihre externen Handlungen.
Den Run nach seinem Ende lesen
Wenn ein sechsstündiger Run fehlschlägt, kann das auslösende Event Stunden zurückliegen, und der Worker, der es erzeugt hat, wurde ersetzt. Sie debuggen anhand von Datensätzen, die geschrieben wurden, während der Run lief. Zwei werden nach dem Run gelesen: ein abfragbares Event Log jedes Schritts und Traces, die zeigen, wohin Zeit und Tokens gingen. Zwei werden während des Runs gelesen: eine Live-Ansicht der Workspace-Änderungen und ein Observability Stack pro Worktree, den der Agent selbst abfragen kann.
Die beiden Aufzeichnungen, die nach dem Run gelesen werden, enthalten nicht zwingend den Request, wie er den Prozess schließlich verlassen hat, also nach dem Zusammenbau der Instructions, nach Retrieval, Compaction und jeder Middleware. Ein Event-Log-Eintrag und ein Span beschreiben, dass ein Model Call stattgefunden hat und was er gekostet hat. Lautet die Frage, was das Model erhalten hat, braucht es eine eigene Erfassung am letzten Punkt vor dem Verlassen des Calls, gespeichert dort, wo Sie später nachsehen, um diese Frage zu beantworten.
Event Log. Jeder Model Call, Tool Call, jedes Result, jeder Error und jede Approval, mit Run-ID und Zeitstempel als Key und abfragbar wie jede andere Tabelle. Addy Osmani formuliert den Test: Wenn Sie aus dauerhaftem Speicher nicht rekonstruieren können, was der Agent in den letzten 24 Stunden getan hat, haben Sie ein Shell-Skript, das ein Model aufruft, keinen Long-Running Agent.
OpenTelemetry GenAI Traces. Spans tragen die Standard-gen_ai.*-Attribute: Model, Provider, Token Counts, Conversation-ID und Workflow-Name. Die Conventions sind 2026 in ein eigenes Repository umgezogen und haben noch Stabilitätsstufe Development, pinnen Sie also die Revision, die Sie validiert haben. Bei Backends, die sie unterstützen, können Sie das Ziel wechseln, ohne den Code neu zu instrumentieren.
Workspace-Änderungen während des Runs. Anthropics Quick-Start beobachtet den Workspace. watch -n 5 'git log --oneline -8' zeigt alle fünf Sekunden die neuesten Commits, und ein nach Zeit sortierter Screenshot-Ordner zeigt, was der Agent zuletzt gesehen hat. Behandeln Sie beides als Aktivitätszeichen und vergleichen Sie es mit Testergebnissen, bevor Sie schließen, dass der Run vorankommt.
Ein Stack pro Worktree für den Agent. In OpenAIs Harness-Beitrag bekommt jeder Codex Worktree eigene kurzlebige Logs, Metrics und Traces, die der Agent während der Arbeit abfragt. So wird eine Anforderung wie „kein Span in diesen vier User Journeys überschreitet zwei Sekunden“ zu etwas, das der Agent prüfen kann.
Ein minimaler selbst gehosteter Stack für einen Agent wie den Market Analyst Agent:
- OpenTelemetry Collector, der Spans empfängt und
gen_ai.*-Felder vor dem Export filtern kann. - Tempo oder Jaeger für Traces, mit
gen_ai.conversation.idoderthread_idals Key. - Loki für Einträge im Event Log.
- Prometheus für die GenAI-Token- und Latency-Metrics.
- Grafana-Dashboards mit
gen_ai.agent.nameundgen_ai.request.modelals Key.
Wenn Sie einen gehosteten Dienst bevorzugen, wählen Sie einen: LangSmith für LangGraph und Deep Agents Deploy, Braintrust, wenn Eval-Suites Vorrang haben, Arize Phoenix für Open-Source-OTLP mit OpenInference, das Tracing-Dashboard von OpenAI für das Agents SDK oder Anthropics Tracing für Managed Agents.
Setzen Sie die Standardattribute auf jedem Model Span, mindestens Operation, Provider, Model, Conversation-ID, Agent-Name und Token Counts. Drei Dashboard-Panels decken das meiste Debugging ab: Output-Tokens pro Agent und Stunde, p95-Model-Latency pro Model und Tool Calls, die länger als 30 Sekunden gedauert haben.
Wenn ein Run fehlschlägt, lassen Sie den Worker ein Debug Bundle nach /workspaces/${THREAD_ID}/_debug/ schreiben:
events.jsonl: das exportierte Event Log mit Absichten, Ergebnissen, Approvals und Errors.checkpoints.jsonl: die Graph-State-Historie auscheckpointer.list({"configurable": {"thread_id": ...}}), als Checkpoints gekennzeichnet.last_state.json:StateSnapshot.valuesaus dem letzten erfolgreichen Super-Step.trace.json: die exportierten Spans des Runs gemäß der Content-Capture-Policy.tool_calls.csv:(ts, tool, input_hash, latency_ms, status, error).workspace.tar.zst: der Workspace plusgit diffgegen den Initializer Commit.screenshots/*.png,PROGRESS.md,feature-list.jsonund andere Fortschrittsdateien.env.txt: Image Tags, Model-Version und Commit-SHA des Harness.
Damit kann ein Bericht sagen: „Run s_123 hat 71 Prozent seiner Tokens damit verbracht, drei Commands zu wiederholen, nachdem npm install fehlgeschlagen war“, statt „der Agent ist hängen geblieben“.
Tests an Crash-Punkten
Ein erfolgreicher ununterbrochener Run sagt wenig über die Recovery aus. Erzwingen Sie im Berichtsbeispiel einen Stopp an drei Punkten: bevor die ausstehende Operation committet ist, nachdem der Publishing-Service den Request angenommen hat, aber bevor das Ergebnis gespeichert ist, und während der Run auf die Approval wartet. Starten Sie mit einem neuen Worker neu und prüfen Sie die Anzahl veröffentlichter Artefakte, die gespeicherte Approval und den finalen Status der Operation. Der mittlere Fall ist derjenige, der doppelte Side Effects aufdeckt.
Testen Sie außerdem zwei Worker, die denselben Run beanspruchen, einen Abbruch während eines laufenden Calls und einen Provider, der eine Action mit Timeout nicht bestätigen kann. Das korrekte Ergebnis dieses letzten Falls kann needs_human sein, nicht ein weiterer Request. Prüfen Sie Event Log und Trace, um jedes Ergebnis zu erklären. Ein Recovery-Test ist erst vollständig, wenn der externe State mit dem gespeicherten State des Runs übereinstimmt.
Bevor ein Long-Running Agent ausgeliefert wird, beantworten Sie diese Fragen in Infrastrukturbegriffen:
- Welcher Store besitzt Run Events und Checkpoints?
- Was passiert, wenn der Worker mitten in einem Tool Call stirbt?
- Kann ein Run den Workspace eines anderen Runs beschädigen?
- Welche Actions brauchen eine Approval?
- Können Model oder Sandbox rohe Credentials lesen?
- Welche Tool Calls lassen sich sicher wiederholen?
- Wo wird das Kostenlimit pro Run durchgesetzt?
- Welche deterministischen Belege entscheiden über den Abschluss, und welche Kriterien brauchen einen Reviewer?
- Wo liegen die finalen Outputs, nachdem die Sandbox weg ist?
- Können wir einen fehlgeschlagenen Run morgen erklären, ohne ihn erneut auszuführen?
Wenn eine Antwort lautet „der Prompt sagt dem Agent, er soll vorsichtig sein“, ist das System noch eine Demo.
Dies ist Part 5 von Engineering the Agentic Stack. Part 6, Harness Engineering for AI Agents verfolgt die Loop innerhalb dieser Runtime: wie eine vorgeschlagene Action autorisiert wird, wie Arbeit an einen frischen Context übergeben wird und wie aus unabhängigen Belegen entschieden wird, dass die Aufgabe erledigt ist.
Referenzen
Engineering-Beiträge
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Anthropic Engineering, Scaling Managed Agents: Decoupling the brain from the hands, 8. April 2026.
- Addy Osmani, Long-running Agents.
Frameworks und SDKs
- LangGraph, Checkpointers und
langgraph-checkpoint-postgres. - LangChain, Deep Agents overview, permissions und The runtime behind production Deep Agents.
- OpenAI Agents SDK, Sessions und Sandbox guide.
- Temporal, OpenAI Agents SDK integration und agentic sandboxes.
anthropics/cwc-long-running-agents: Muster für Evaluator und Fortschrittsdateien.
Plattformen und Limits
- Anthropic, Claude platform pricing für die Session-Stunden von Managed Agents.
- Sandbox-Provider: E2B, Vercel Sandbox, Daytona, Modal, Runloop.
- Google Cloud Run, service request timeout und job task timeout.
- AWS, Lambda timeout, Lambda durable functions und Bedrock AgentCore Runtime.
Observability
- OpenTelemetry, Semantic conventions for generative AI, attribute registry und metrics.