Inżynieria harnessu dla agentów AI: weryfikacja ukończenia zadania

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Agent może zakończyć swoją turę, mimo że praca nadal jest nieukończona. Ten artykuł jest dla inżynierów, którzy tworzą lub przeglądają agentów programistycznych i muszą zdecydować, kiedy zaakceptować wynik, ponowić niepewną operację albo wznowić pracę w innej sesji. Pokazuje też, jak zmierzyć, czy dodatkowy komponent harnessu poprawia te wyniki na tyle, by uzasadnić swój koszt.
Harness to kod aplikacji wokół pętli rozumowania modelu. Dostarcza kontekst, sprawdza proponowane akcje, rejestruje, co się wydarzyło, i decyduje, czy dowody wystarczają do zakończenia pracy. Runtime wykonuje zaakceptowane akcje i utrzymuje dostępność sesji, sandboxa i stanu checkpoint. Wcześniejsze artykuły wyjaśniają pętlę rozumowania, pamięć, narzędzia i uprawnienia. Tutaj pytanie brzmi: co robi harness po tym, jak model zaproponuje akcję albo powie „gotowe”.
Przykłady sklepu i płatności poniżej są fikcyjnymi przypadkami dydaktycznymi. Dołączone laboratorium jest deterministyczną symulacją; nie mierzy działającego agenta programistycznego.
Co oznacza „gotowe”
Załóżmy, że agent programistyczny ma w repozytorium fikcyjnego sklepu obniżyć próg automatycznego rabatu 10% ze $100 do $75. Zmienia src/checkout.py. Koszyk za $80 powinien teraz otrzymać rabat $8. Zadanie ma dwie wymagane kontrole:
pytest tests/test_checkout.pysprawdza obliczenie.pnpm playwright test tests/checkout_discount.spec.tssprawdza widoczny wynik w kasie w lokalnym sklepie z danymi testowymi.
Wiarygodnie brzmiąca odpowiedź końcowa nie jest żadną z tych kontroli. Harness powinien zaakceptować tylko kandydata, którego kompletny przetestowany snapshot jest zidentyfikowany i którego obie wymagane kontrole przeszły na tym samym snapshocie. Może go identyfikować czysty commit; w przeciwnym razie użyj skrótu (digest) albo manifestu obejmującego istotne nieśledzone pliki. Trzymaj testy poza zakresem zapisu agenta albo niezależnie zatwierdzaj ich zmiany przed oceną.
Tu model, harness i runtime mają różne zadania. Implementacje mogą łączyć kilka z nich w jeden proces, ale granice ich awarii pozostają różne:
| Komponent | Zadanie | Przykład w agencie programistycznym |
|---|---|---|
| Model | Proponuje tekst, wywołanie narzędzia albo odpowiedź końcową | Sugeruje edycję src/checkout.py |
| Pętla rozumowania | Wybiera następny ruch na podstawie dostępnego kontekstu | Sprawdź, edytuj, przetestuj, sprawdź ponownie |
| Harness | Dostarcza kontekst, waliduje i autoryzuje propozycje, przekazuje zaakceptowane wywołania, rejestruje wyniki, sprawdza ukończenie | Pozwala na edycje w src/ i wymaga obu wskazanych testów |
| Runtime | Wykonuje zaakceptowane wywołania i utrzymuje stan poza procesem workera | Log sesji, sandbox, magazyn stanów checkpoint, backend śladów |
Opis pętli Codex od OpenAI przedstawia ten cykl: harness składa prompt, prosi model o następną akcję, wysyła zaakceptowane wywołanie narzędzia do runtime’u, dołącza wynik i pyta ponownie, aż zaakceptuje wynik albo odda kontrolę użytkownikowi. Dla zmiany rabatu jedno przejście wygląda tak:
- Konstruktor kontekstu dostarcza zadanie, instrukcje repozytorium, istotne pliki, wcześniejsze wyniki narzędzi i bieżący plan.
- Model proponuje wywołanie
edit_fileze ścieżką i tekstem zastępczym. - Granica narzędzia waliduje argumenty, sprawdza ścieżkę względem dozwolonego zakresu i prosi o zatwierdzenie, jeśli operacja go wymaga.
- Runtime stosuje edycję w sandboxie i zwraca ustrukturyzowany wynik.
- Harness uruchamia
pytest tests/test_checkout.py, potempnpm playwright test tests/checkout_discount.spec.ts, i odczytuje oba kody wyjścia. - Nieudana kontrola staje się nowym kontekstem dla następnej tury modelu; dwie udane kontrole czynią zmianę kandydatem do ukończenia.
- Harness trwale zapisuje polecenia, kody wyjścia, przetestowany snapshot, oceniającego i wersje środowiska; ślad może odsyłać do tego zapisu.
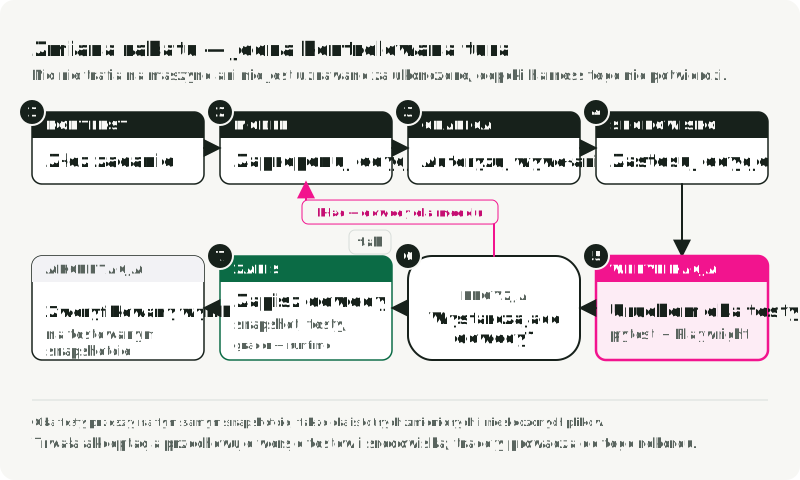
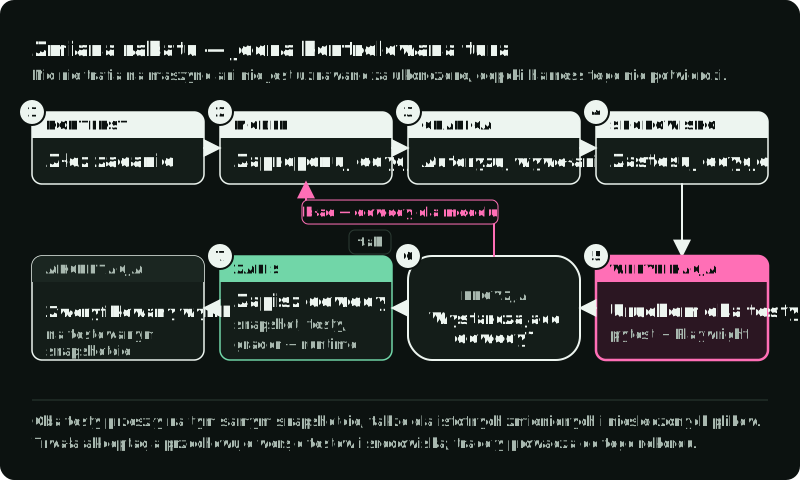
Po kroku 2 żaden plik się nie zmienił. Harness nadal może odrzucić ../../secrets.env, zażądać zatwierdzenia destrukcyjnego polecenia albo zatrzymać przebieg, który wyczerpał budżet. Po kroku 5 harness sam odczytuje kody wyjścia, więc model nie może oznaczyć własnej edycji jako udanej.
Zapis ukończenia dla tego zadania potrzebuje snapshotu kandydata, obu poleceń z kodami wyjścia oraz wersji środowiska testowego i oceniającego. Powinien być trwały i poza kontrolą kandydata. Ślad może łączyć propozycję, zatwierdzone wywołanie, wynik runtime’u i zapis akceptacji na potrzeby diagnozy. Sam ślad nie jest decyzją o akceptacji.
Ślad niekoniecznie zawiera też żądanie. Może zapisać dokument źródłowy lub zdarzenie middleware’u, nie pokazując, co ostatecznie zawierało złożone żądanie. Jeśli musisz ustalić, co otrzymał model, przechwyć to w ostatnim punkcie, zanim wywołanie opuści harness, po każdej transformacji.
Studium przypadku inżynierii harnessu od OpenAI opisuje uruchamialną aplikację dla każdego worktree oraz dostęp do przeglądarki, logów, metryk i śladów. Taka konfiguracja pozwoliła agentowi sprawdzać cel opóźnienia dla ścieżki użytkownika. Ilustruje warunek wstępny reguły akceptacji: odpowiednia aplikacja i sygnały muszą być dostępne w środowisku testowym. Lopopolo, autor tego studium przypadku, prowadzi przewodnik praktyczny po inżynierii harnessu z tymi samymi dwiema dźwigniami: zachowaj stały model i projektuj kontekst oraz narzędzia wokół niego. Poprzeczka jakości organizacji, jej procedury i zasady zatwierdzania leżą poza wiedzą ogólnego modelu; harness dostarcza je jako instrukcje repozytorium, reguły uprawnień i kontrole akceptacyjne.
Rozważ trzy pozornie podobne wyniki:
| Dowody na końcu przebiegu | Decyzja harnessu | Dlaczego |
|---|---|---|
| Test jednostkowy przechodzi; brak wyniku z przeglądarki | Kontynuuj albo zatrzymaj jako nieukończone | Jedna wymagana kontrola nie ma wyniku |
| Oba testy przechodzą, potem agent edytuje plik | Uruchom obie kontrole ponownie | Zapisane zaliczenia dotyczą starszego snapshotu |
| Oba testy przechodzą na tym samym zidentyfikowanym snapshocie | Kwalifikuje się do akceptacji | Wymagane dowody odpowiadają kandydatowi |
„Kwalifikuje się” zostawia miejsce na zatwierdzenie przez człowieka albo inną wymaganą regułę; nie pozwala modelowi poświadczać własnej pracy. Oceniający ze świeżym kontekstem może ocenić wynik wizualny według rubryki, gdy kod wyjścia nie wyraża danego kryterium. Porównaj takiego oceniającego z ocenami ludzi, zanim pozwolisz mu decydować o ukończeniu. Nie może zastąpić wymaganej kontroli deterministycznej.
Dla agenta badawczego z tej serii proponowana deterministyczna reguła ukończenia sprawdzałaby schemat raportu i potwierdzała, że żądane tickery się w nim pojawiają. Te kontrole nie mogą ustalić, czy analiza jest merytorycznie poprawna; to nadal wymaga przeglądu źródeł. Wytyczne Anthropic dotyczące ewaluacji zalecają stabilne środowiska i dokładne testy dla zadań programistycznych, a dla modeli oceniających kalibrację przez ludzi.
Gdzie egzekwowana jest każda reguła
Wymóg, by tests/checkout_discount.spec.ts przechodził, należy do kodu deterministycznego, nie do tekstu prompt. Prompt może przypomnieć modelowi o uruchomieniu testu. Nie może powstrzymać modelu przed ogłoszeniem sukcesu bez dowodów. Inne reguły pasują do innych miejsc:
| Umieść regułę w | Dobre zastosowanie | Przykład |
|---|---|---|
| Tekście prompt lub skillu | Kolejność wyszukiwania, konwencje kodowania i format planu | Przeczytaj AGENTS.md przed edycją kodu kasy |
| Granicy narzędzia | Walidacja argumentów, dozwolone ścieżki, zatwierdzenia i dostęp do narzędzi | Zezwalaj na zapis tylko w src/ |
| Kodzie deterministycznym | Budżety, limity czasu, ponowienia, kody wyjścia testów i wymagania wydania | Utrzymuj przebieg otwarty, dopóki test Playwright nie przechodzi |
| Oceniającym ze świeżym kontekstem | Przegląd wizualny lub kryteria wymagające osądu | Porównaj wygenerowany diagram z pisemną rubryką |
Wcześniejsze części tej serii decydują każda o jednej rzeczy w tym przejściu:
| Wcześniejsza część | O czym decyduje w tej turze | Gdzie działa w przejściu |
|---|---|---|
| Część 2 — pamięć | Który wcześniejszy stan trafia do tekstu prompt | Krok 1, konstruktor kontekstu |
| Część 3 — korzystanie z narzędzi | Jakie akcje istnieją i jak wygląda zwalidowany wynik | Walidacja w kroku 3 i wynik w kroku 4 |
| Część 4 — bezpieczeństwo | Czy to konkretne wywołanie może zostać teraz wykonane | Krok 3, sprawdzenie ścieżki i zatwierdzenie |
| Część 6 — ten artykuł | Czy powstałe dowody kończą przebieg | Kroki od 5 do 7, kontrole akceptacyjne |
Tabela odwzorowuje odpowiedzialności, nie kolejność wykonania. Części 3 i 4 dzielą krok 3: ten sam kod harnessu, który odrzuca niepoprawny argument, odrzuca też wywołanie dozwolone, ale jeszcze niezatwierdzone. Jeśli walidacja i autoryzacja działają w osobnych usługach, przekaż zwalidowane argumenty przez tę granicę, aby decyzja o autoryzacji dotyczyła wywołania, które zostanie wykonane.
Traktuj przekroczenie limitu czasu jako nieznany wynik
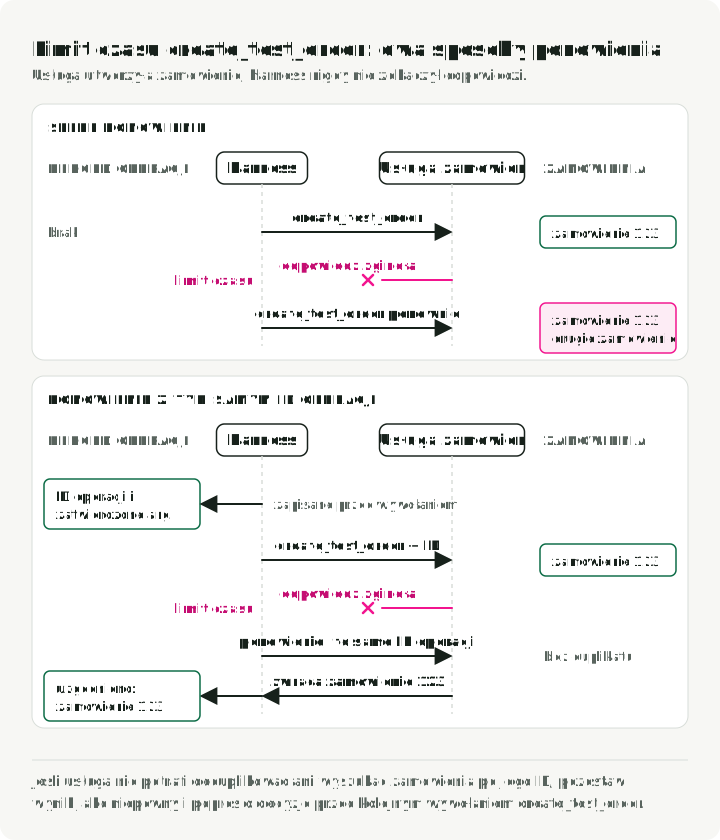
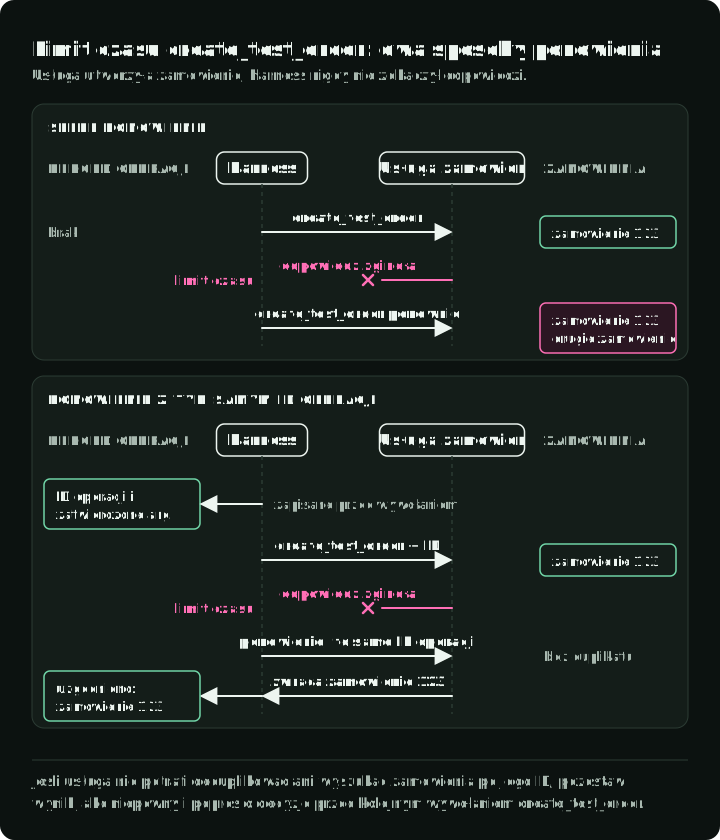
Edycja rabatu jest lokalna, a jej testy można uruchomić ponownie. Migracja płatności w tym samym fikcyjnym sklepie wprowadza inny problem. Załóżmy, że agent wywołuje create_test_order w usłudze stagingowej, a wywołanie przekracza limit czasu. Usługa mogła utworzyć zamówienie, mimo że harness nigdy nie otrzymał odpowiedzi. Ślepe ponowienie może utworzyć drugie zamówienie.
Nazwa akcji ani identyfikator wywołania narzędzia wygenerowany przez model nie wystarczą, by ją odzyskać. Przed wysłaniem zapisz trwale identyfikator operacji należący do aplikacji razem z zatwierdzonymi argumentami. Usługa musi deduplikować ponowienia dla tego identyfikatora albo udostępniać sprawdzanie statusu, które pozwala uzgodnić wynik. Po restarcie używaj tego samego identyfikatora dla tego samego zamierzonego zamówienia; zmienione żądanie zamówienia wymaga nowej decyzji. Wytyczne AWS dotyczące idempotentnych API opisują identyfikator klienta i atomowość po stronie serwera, potrzebne, by było to bezpieczne. Sprawdź, jak długo dostawca przechowuje klucze: kontrakt Stripe pozwala na przykład usuwać je po co najmniej 24 godzinach, więc późniejsze ponowienie wymaga uzgodnienia zamiast ponownego wysłania.
Rysunek śledzi jedno wywołanie create_test_order, które przekroczyło limit czasu, w dwóch wariantach: raz ponowione na ślepo i raz ponowione z zapisanym identyfikatorem operacji.
Harness może podejmować te decyzje bez pytania modelu tylko wtedy, gdy każde narzędzie ma jawny kontrakt. Dla create_test_order ten kontrakt obejmuje:
- zwalidowane argumenty, aby niepoprawne dane wejściowe zostały odrzucone przed wykonaniem;
- ustrukturyzowany wynik, taki jak
{ "order_id": "123", "created": true }, aby późniejsze kontrole nie parsowały swobodnego tekstu; - kategorię efektu: czy wywołanie tylko czyta, czy zmienia plik, rekord albo usługę zewnętrzną, oraz czy jego powtórzenie jest bezpieczne;
- limit czasu i politykę ponowień, aby utracona odpowiedź nie uruchomiła nieograniczonej serii wywołań;
- regułę uprawnień: odczyt statusu zamówienia może działać automatycznie, a utworzenie zamówienia może wymagać potwierdzenia.
| Wynik zaobserwowany przez harness | Następna akcja |
|---|---|
Wywołanie tylko do odczytu get_order_status zwraca 503 | Ponów w ramach limitu, jeśli to sprawdzenie można bezpiecznie powtórzyć |
create_test_order przekracza limit czasu; sprawdzenie znajduje zamówienie pod jego identyfikatorem operacji | Użyj istniejącego zamówienia i zapisz uzgodniony wynik |
create_test_order przekracza limit czasu; usługa nie może deduplikować ani sprawdzić statusu | Pozostaw wynik jako niepewny i poproś o decyzję przed kolejnym utworzeniem |
Ten ostatni stan musi przetrwać awarię workera. Nazwanie go „nieudanym” byłoby fałszywe: zamówienie może istnieć. Trwały zapis operacji potrzebuje zatwierdzonego payloadu, identyfikatora operacji, statusu wysłania, wyniku z serwera lub sprawdzenia statusu oraz ewentualnego zatwierdzenia. Ślad pomaga znaleźć ten zapis; transkrypt pokazuje tylko to, co widział model.
Opis narzędzia pomaga modelowi wybrać akcję. Nie nadaje uprawnień ani nie dowodzi, że ponowienie jest bezpieczne. Jeśli usługa zamówień jest udostępniona przez MCP, klient nadal musi stosować własną walidację i politykę zaufania, a serwer musi egzekwować kontrolę dostępu. Specyfikacja narzędzi MCP mówi, że klienci muszą traktować adnotacje zachowania narzędzi jako niezaufane, chyba że pochodzą z zaufanego serwera. Serwer opisujący create_test_order jako tylko do odczytu nie sprawi, że tak będzie. Specyfikacja nie narzuca jednego ustawienia zaufania, więc napisz dla swojego wdrożenia jawną politykę, która określa, jakie metadane serwera mogą wpływać na decyzje o uprawnieniach lub ponowieniach.
MCP ma też standardowy sposób na zachowanie uchwytu do długo trwającego wywołania. W oficjalnym rozszerzeniu Tasks serwer może odpowiedzieć na tools/call uchwytem zadania zamiast wyniku końcowego. Klient odpytuje wtedy zadanie przez tasks/get albo zatrzymuje pracę przez tasks/cancel. Specyfikacja Tasks mówi, że klienci powinni utrwalać identyfikatory zadań, aby po awarii można było wznowić odpytywanie, więc zapisz identyfikator zadania w tym samym rekordzie operacji. Zadanie w stanie completed nie oznacza, że narzędzie się powiodło: wynik narzędzia z isError: true nadal kończy zadanie, a tylko błąd protokołu przenosi je do stanu failed. Klient i serwer uzgadniają obsługę przy każdym żądaniu, więc zanim na tym polegasz, upewnij się, że obie strony ją implementują.
Przekaż postęp następnej sesji
Teraz fikcyjny agent musi zmigrować kasę z adaptera płatności v1 na v2. Zmienił handler i klienta, uruchomił lokalny sandbox płatności i zostawił nieprzechodzący tests/payment_migration.spec.ts. Zadanie trwa dłużej niż jedna sesja modelu. Podsumowanie starej rozmowy może twierdzić, że sandbox działa, nawet gdy proces już zakończył działanie.
Następna sesja potrzebuje trzech różnych rodzajów stanu:
| Stan | Co następna sesja musi sprawdzić |
|---|---|
| Rozmowa | Żądanie, decyzje i istotne wyniki narzędzi |
| Obszar roboczy i runtime | Bieżące pliki, gałąź, procesy i środowisko testowe |
| Postęp zadania | Ukończone kontrole, oczekujące zatwierdzenie lub niepewny zapis oraz następna akcja |
Kompakcja zastępuje starsze wiadomości krótszym podsumowaniem, aby bieżąca sesja mogła trwać dalej. Przekazanie postępu to pamięć dokumentowa dla następnej sesji. Jeśli stara rozmowa niesie nieaktualne założenia, harness może rozpocząć nową sesję z przekazaniem i bieżącym obszarem roboczym; zastąpienie workera po awarii i przywrócenie jego procesów to osobne zadanie runtime’u.
Stan checkpoint może zachować stan wykonania, ale nie dowodzi, że zewnętrzna operacja płatności została zatwierdzona ani że proces nadal działa. Przekazanie postępu pomaga, gdy kontekstowi następnego modelu brakuje użytecznego statusu zadania. Zapisz gałąź, zmienione pliki, ostatnie polecenie i jego wynik, oczekujące identyfikatory operacji oraz następny nierozwiązany krok. Przy wznowieniu sprawdź te twierdzenia względem działającego obszaru roboczego i usługi, zanim podejmiesz działanie. Eksperymenty Anthropic z długo działającymi agentami programistycznymi używały historii git i pliku postępu, aby pomóc kolejnym sesjom odzyskać pracę. Późniejszy raport Anthropic o projektowaniu harnessu zauważa, że przekazania dodają orkiestrację, jednostki token i czas wykonania.
Przekazanie powinno być warunkowe. Mała edycja, która kończy się w jednej sesji, nie potrzebuje go wcale. Nawet długie zadanie może nie potrzebować kolejnego pliku, jeśli jego checkpoint zawiera już wymagany postęp, a następna sesja potrafi go wykorzystać. Sprawdź, czy wznowiona sesja powtarza ukończoną pracę, pomija oczekujący zapis albo działa na nieaktualnym środowisku. Uzupełnij brakujący stan zamiast domyślnie dodawać podsumowanie.
Zdiagnozuj awarię przed dodaniem komponentu
Trzy powyższe przypadki dają różne ślady: brakujący test akceptacyjny, niepewny zapis zewnętrzny i powtórzoną pracę po wznowieniu. Ich poprawki należą do różnych miejsc. Wynik z przeglądarki brakujący w zapisie akceptacji wymaga obowiązkowej kontroli ukończenia. Niepewne zamówienie wymaga deduplikacji lub uzgadniania po stronie serwera. Powtórzona edycja po nowej sesji wymaga użytecznego stanu postępu.
Przy następnym przebiegu zapisz zadanie i wersję harnessu, proponowaną akcję, zatwierdzenie, wynik narzędzia, przetestowany snapshot, wynik akceptacji, opóźnienie i koszt. Notuj liczbę jednostek token wejścia osobno od rozliczonego kosztu wejścia, w tym odczytów z cache’u: dwa harnessy zachowujące się identycznie mogą być rozliczane inaczej, zależnie od tego, jak każdy z nich składa żądanie i czy cache dostawcy był ciepły. Nie umieszczaj w śladach sekretów ani zbędnych danych osobowych. Łącz zewnętrzne zapisy operacji przez identyfikator, ponieważ przekroczenie limitu czasu po stronie klienta nie ujawni, co zrobił serwer. Gdy awaria się powtarza, napisz przypadek regresyjny, który ją odtwarza. Ewaluacja agentów AI w produkcji rozwija ten proces przejścia od śladów do testów.
Każdy powtarzający się objaw sugeruje małą zmianę i miarę, która pokazałaby, czy pomogła:
| Powtarzający się objaw | Mała zmiana do wypróbowania | Co mierzyć |
|---|---|---|
| Sprawdzenia tylko do odczytu przejściowo zawodzą | Ograniczone ponowienia z backoffem | Wskaźnik odzyskania, dodatkowe wywołania, czas wykonania |
| Wznowione sesje powtarzają ukończoną pracę | Ustrukturyzowane przekazanie postępu | Zduplikowane akcje narzędzi po wznowieniu |
| Przy ukończeniu brakuje wymaganych testów | Odrzucaj ukończenie, dopóki każda wymagana kontrola nie przejdzie | Zadania zaakceptowane bez wszystkich wymaganych kontroli |
| Wady wizualne przechodzą przez kontrole deterministyczne | Oceniający ze świeżym kontekstem i rubryką | Znalezione wady, fałszywe odrzucenia, czas przeglądu |
| Agent edytuje poza swoim zakresem | Węższe uprawnienie narzędzia | Zablokowane wywołania i ręczne obejścia |
| Przywołana pamięć wypiera bieżące zadanie | Ogranicz przywoływane fakty; szereguj przed wstawieniem | Jednostki token zużyte na przywołanie, ukończone zadania, koszt |
| Podana reguła lub status nigdy nie dociera do modelu | Przechwyć złożone żądanie, zanim wywołanie wyjdzie | Żądania bez reguły; rundy do jej ponownego pojawienia się |
Zanim dodasz politykę ponowień, przekazanie albo oceniającego, określ awarię, którą ma zmienić, i metrykę, która pokaże poprawę. Licz też koszt: więcej zaakceptowanych zadań nie jest użyteczne, jeśli dodatkowe wywołania podwajają czas przeglądu albo tworzą zduplikowane zamówienia. Autoryzacja, izolacja, zasady prywatności i obowiązkowe kontrole akceptacyjne są wymaganiami; mały benchmark skuteczności nie jest powodem, by je usunąć. Testuj te ograniczenia jawnymi przypadkami zabronionymi.
Mierz jedną opcjonalną zmianę naraz
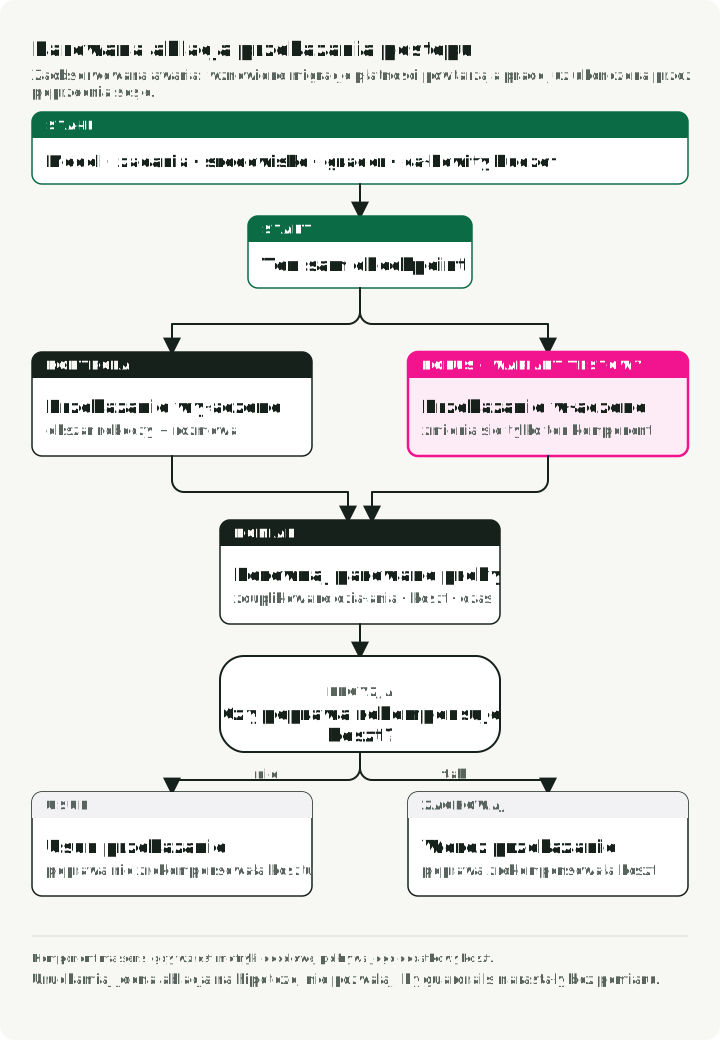
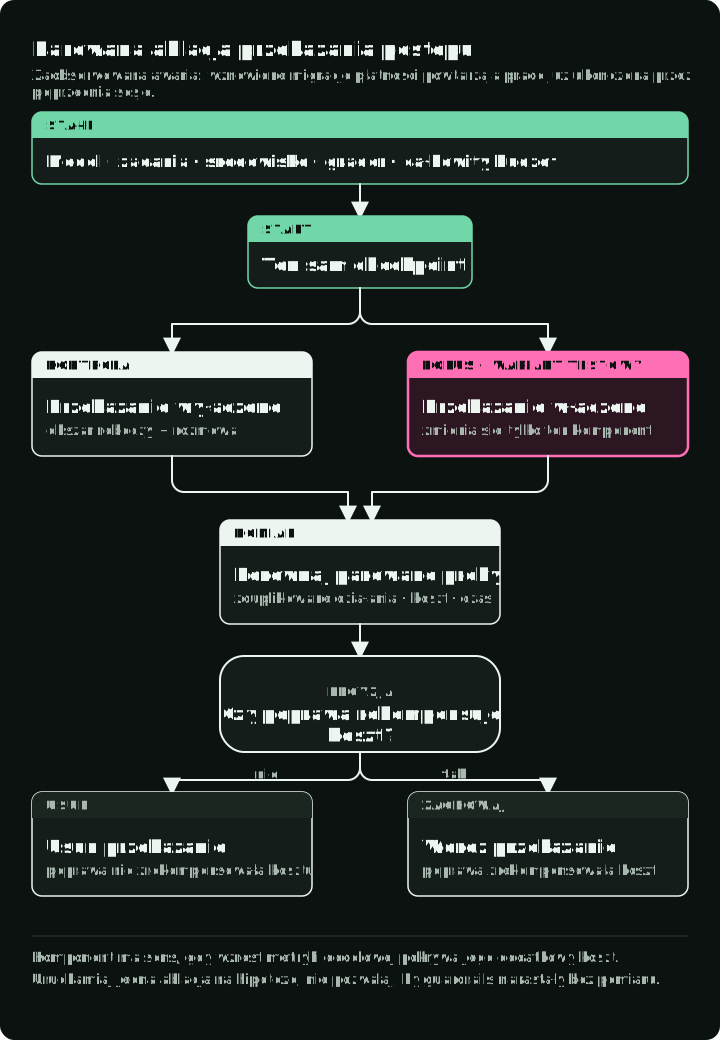
Ablacja porównuje harness z jednym komponentem i bez niego, utrzymując resztę eksperymentu bez zmian. Użyj tego protokołu:
- Zamroź wersję modelu i endpoint dostawcy, instancje zadań, środowisko wraz z jego limitami zasobów obliczeniowych, oceniającego i teksty prompt poza testowanym komponentem. Same limity zasobów mogą zmienić wynik benchmarku agenta; artykuł o ewaluacji opisuje pomiar Anthropic.
- Daj obu wariantom ten sam łączny budżet jednostek token, czasu i dolarów.
- Wybierz liczbę prób albo regułę zatrzymania przed uruchomieniem porównania.
- Uruchom te same instancje zadań w obu wariantach i powtarzaj każde zadanie, ponieważ wyniki modelu się różnią.
- Raportuj średnią z rozrzutem albo przedziałem ufności.
- Licz każdą rozpoczętą próbę, w tym przekroczenia limitu czasu, zatrzymania przez politykę, awarie harnessu i awarie oceniającego.
Dla migracji płatności kandydatem jest opcjonalne przekazanie postępu. Rozpocznij każdą parę kontrola–eksperyment od tego samego commita repozytorium i tego samego stanu checkpoint z danymi testowymi, z przekazaniem jako jedynym przełącznikiem.
Główną miarą mogłyby być zduplikowane akcje narzędzi po wznowieniu: operacja na artefakcie, który poprzednia sesja już ukończyła. Raportuj też zaakceptowane zadania, wady, które się przedostały, czas wykonania, koszt modelu i oceniającego oraz minuty przeglądu. Wybierz liczbę prób i regułę zatrzymania z góry, a potem raportuj zmienność, a nie tylko średnią. Jeśli przekazanie zmniejsza liczbę duplikatów, ale kosztuje więcej, niż oszczędza, to jest użyteczny wynik negatywny.
Artykuł o SWE-agent podaje ograniczony przykład ablacji interfejsu. Z GPT-4 Turbo na 300-zadaniowym podzbiorze SWE-bench Lite i limitem $4 na zadanie zmieniano jedną cechę interfejsu naraz:
| Zmiana interfejsu | Rozwiązane |
|---|---|
| Pełny interfejs SWE-agent (punkt odniesienia) | 18.0% |
| Edytor bez lintingu | 15.0% |
| Cały plik zamiast przeglądarki 100 linii | 12.7% |
| Pełna historia obserwacji zamiast ostatnich pięciu | 15.0% |
To wyniki dla tego modelu i benchmarku, a nie oczekiwane zyski dla tego fikcyjnego sklepu. Przenosi się metoda: testuj nazwany wybór interfejsu w stałej konfiguracji, a potem raportuj warunki razem z liczbą.
Porównania zbiorcze są częste i nie potrafią wskazać zmiany, która pomogła. LangChain raportuje wzrost wyniku deepagents-cli w Terminal-Bench 2.0 z 52.8% do 66.5% przy stałym modelu, po wspólnej zmianie systemowego tekstu prompt, narzędzi i middleware. Raport OpenAI o ARC-AGI-3 pokazuje odwrotne ryzyko: wynik prawie się potroił, gdy harness zachował reasoning i użył kompakcji, czyli zmieniono razem dwa ustawienia API. Zapisuj API, zachowywanie reasoningu, politykę kompakcji i budżety razem z identyfikatorem modelu; w przeciwnym razie pozorna regresja modelu może być brakującą funkcją w adapterze.
Testowanie jednej zmiany naraz wychwytuje też zmiany, które wyglądają na zbyt małe, by miały znaczenie. Postmortem Anthropic dotyczący Claude Code z kwietnia 2026 podaje, że API nie zostało dotknięte, a mimo to trzy zmiany w warstwie produktu obniżyły jakość: niższy domyślny wysiłek reasoningu, błąd, który czyścił wcześniejszy reasoning w każdej turze po bezczynnej sesji, oraz linijka w systemowym tekście prompt ograniczająca tekst między wywołaniami narzędzi. Gdy Anthropic przeprowadził ablację tej jednej linijki na szerszym zestawie ewaluacji, jedna z nich pokazała spadek o 3% zarówno dla Opus 4.6, jak i dla Opus 4.7. Linijka tekstu prompt lub ustawienie domyślne to zmiana harnessu; testuj ją jak zmianę.
Ponownie weryfikuj komponenty, gdy zmienia się model. Raport Anthropic o długo działających aplikacjach to jakościowe studium przypadku: gdy pojawił się Opus 4.6, zespół usuwał komponenty harnessu po jednym i stwierdził, że wywołania oceniającego stały się narzutem w zadaniach, które model teraz kończył sam, a nadal pomagały blisko granicy jego możliwości.
Uwzględnij w zestawie przypadków awarii zatrzymanie ze względów bezpieczeństwa po stronie dostawcy: powinno ono zatrzymać wysyłanie wywołań i przejść do przeglądu, a nie ponawiać. Szczegóły omawia Część 4.
Wypróbuj porównanie w dołączonym laboratorium
Projekt harness-demo w commicie 517353f3 pozwala uruchomić regułę ablacji. Jego dwanaście ogólnych syntetycznych zadań, takich jak fix-parser-edge-case, split-large-module i wire-browser-test, deklaruje trudność i cztery warunki: zawodne narzędzie, utracony postęp, przeoczoną lukę w implementacji i niejednoznaczne ukończenie. Symulator wyprowadza piąty warunek dla trudnych zadań, które potrzebują też pliku postępu: bez context_reset kompakcja zachowuje nieaktualne założenia. Czysta funkcja oznacza zadanie jako zaliczone, gdy wybrana konfiguracja obsługuje każdy mający zastosowanie warunek. Nie ma tu modelu, zewnętrznego narzędzia ani prawdziwego zadania programistycznego. Wyniki i liczby jednostek token są symulowanymi danymi dydaktycznymi, a nie dowodem, że harness z pięcioma komponentami poprawia działającego agenta.
Sklonuj przypiętą rewizję i uruchom kontrole oraz symulację z zainstalowanym uv:
git clone https://github.com/slavadubrov/harness-demo.git
cd harness-demo
git checkout 517353f3a47541d66099983170fe90812b6ef23b
make check
make run
make failures
make check uruchamia Ruff i siedem testów jednostkowych, w tym test, który odrzuca porównanie zmieniające dwa komponenty. make run wypisuje skumulowaną macierz dydaktyczną i pięć par „bez jednego komponentu”. make failures nazywa każdą symulowaną awarię; pełna konfiguracja kończy się komunikatem all synthetic tasks pass.
| Komponent przywrócony do pełnej konfiguracji | Bez niego | Z nim |
|---|---|---|
| Polityka ponowień | 8/12 | 12/12 |
| Przekazanie postępu | 7/12 | 12/12 |
| Świeży oceniający | 8/12 | 12/12 |
| Akceptacja typu fail-closed | 7/12 | 12/12 |
| Reset kontekstu | 10/12 | 12/12 |
Wiersze są deterministycznymi konsekwencjami flag zadań i kodu oceniającego. Nie są szacunkami wielkości efektu w działającym systemie. Wcześniejsza skumulowana macierz dodaje kilka komponentów w jednym przejściu i nie potrafi wskazać, który spowodował zmianę.
Plik model.py w laboratorium chroni przed nazwaniem zmiany zbiorczej ablacją: porównuje każde pole komponentu w parze, a jego test regresyjny podaje niepoprawną parę ze zmienionymi zarówno ponowieniami, jak i oceniającym. Ta samodzielna wersja zabezpieczenia działa na jednej poprawnej parze z przekazaniem postępu:
from dataclasses import dataclass, fields

@dataclass(frozen=True)
class Config:
    progress_handoff: bool = False
    evaluator: bool = False
    retry_policy: bool = False
    fail_closed_acceptance: bool = False
    context_reset: bool = False

def changed_components(control: Config, treatment: Config) -> tuple[str, ...]:
    return tuple(
        field.name
        for field in fields(control)
        if getattr(control, field.name) != getattr(treatment, field.name)
    )

control = Config(progress_handoff=False, evaluator=True, retry_policy=True)
treatment = Config(progress_handoff=True, evaluator=True, retry_policy=True)
assert changed_components(control, treatment) == ("progress_handoff",)
Aby przenieść tę metodę do rzeczywistego projektu, zastąp syntetyczne flagi zadań wersjonowanym zestawem zadań, a symulowane liczby jednostek token pomiarami ze śladów. Trzymaj reguły akceptacji poza kontrolą kandydata. Sam stały model nie daje kontrolowanego porównania, jeśli zmieniły się też teksty prompt, dane testowe, uprawnienia albo ustawienia reasoningu i kompakcji w API.
Znajdź kod stojący za zachowaniem
Harness, który przechodzi swoje ablacje, może nadal przetrwać model, pod który go dostrojono, a późniejsza zmiana wymaga znalezienia kodu implementującego dane zachowanie. Żądanie takie jak „maskuj sekrety w każdej ścieżce przechwytywania” nazywa zachowanie, a nie plik. W produkcyjnym harnessie takie zachowanie może obejmować kilka etapów wykonania i współdzielony stan.
Preprint Wang i in. z 2026 roku proponuje do tego wyszukiwania Harness Handbook, co artykuł nazywa lokalizacją zachowania. Analiza statyczna wyodrębnia graf programu, LLM grupuje jego jednostki w etapy wykonania, a opiekun lub agent programistyczny schodzi od przeglądu systemu do opartych na kodzie źródłowym wpisów dla funkcji lub pliku. Każdy wpis musi dać się odnaleźć w bieżącym repozytorium i jest ponownie synchronizowany po każdej zmianie.
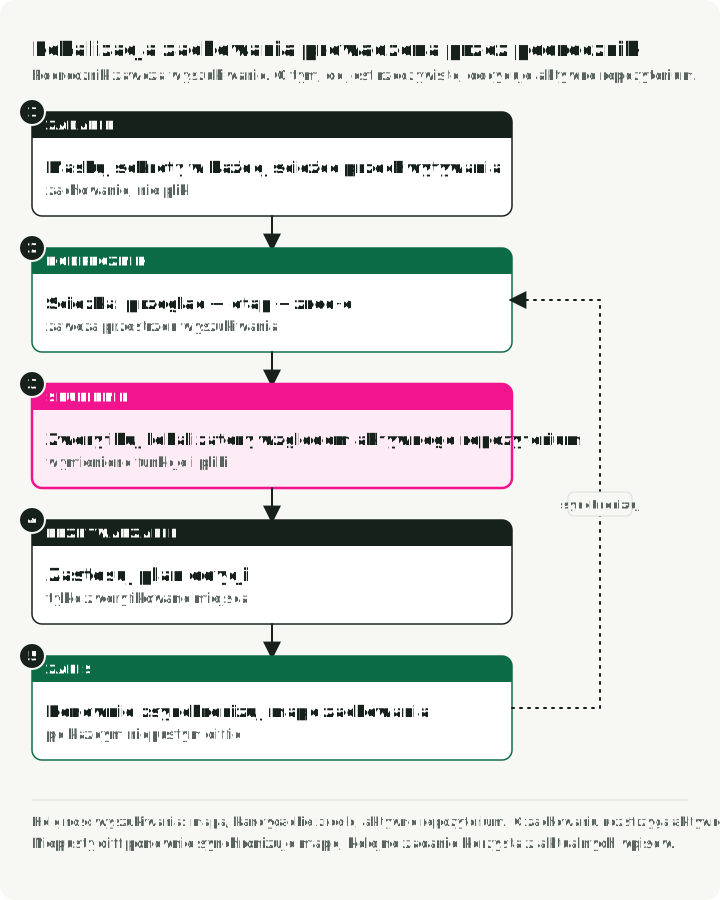
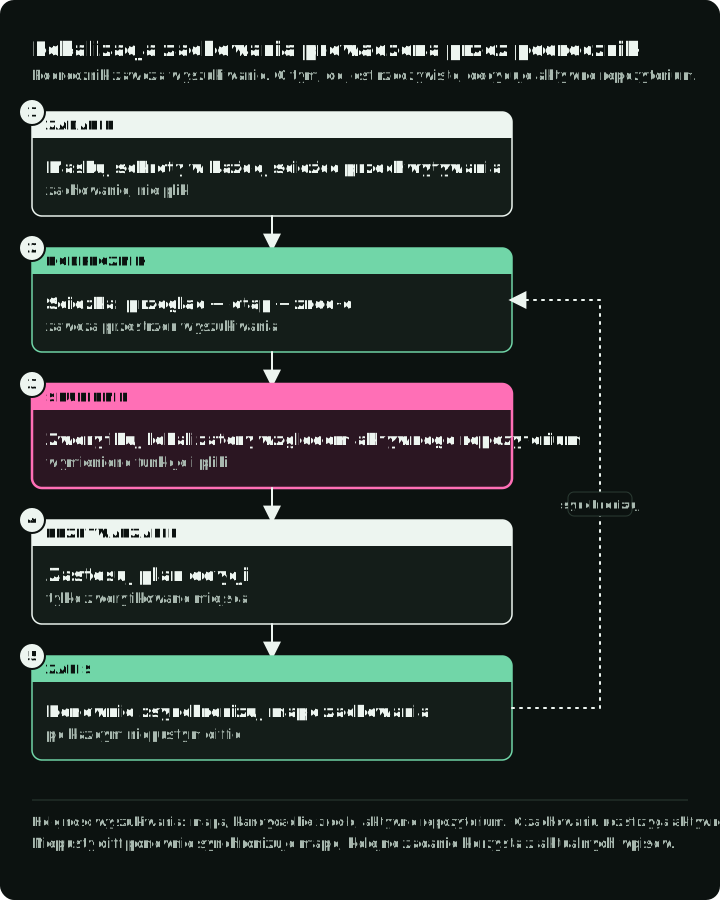
Na dwóch harnessach open source planner kierujący się podręcznikiem tworzył plany edycji, które sędziowie częściej preferowali, przy mniejszej liczbie jednostek token. Badanie oceniało plany, a nie wykonane zmiany, i nie podało niepewności, więc traktuj je jako podejście na etapie badań.
Użyj awarii, aby znaleźć odpowiedzialny element
Ta seria budowała kolejne warstwy na zewnątrz pętli rozumowania. Gdy przebieg się nie powiedzie, znajdź pierwszą odpowiedzialność, która może mu zapobiec albo go wykryć:
| Co się stało | Co zbadać |
|---|---|
| Słaby następny krok mimo dostępu do właściwych informacji | Model i pętla rozumowania |
| Utracona wcześniejsza decyzja albo powtórzona ukończona praca | Składanie kontekstu i pamięć |
| Nie dało się wyrazić akcji ani odczytać jej wyniku | Kontrakt narzędzia |
| Wykonano zabronioną akcję | Sprawdzenie uprawnień i usługa, która je egzekwuje |
| Worker uległ awarii, a jego środowisko zniknęło | Runtime i checkpoint |
| Ogłoszono sukces bez wymaganych dowodów | Reguła akceptacji harnessu i przetestowany snapshot |
Zacząłbym od jednego zdolnego modelu, wąskich narzędzi, sandboxa i jednej jawnej kontroli akceptacyjnej. Zapisz pierwszą awarię, dodaj najmniejszy mechanizm kontrolny, który ją rozwiązuje, i porównaj z wyłączonym mechanizmem. Trzymaj regułę i ślad razem, aby następna aktualizacja modelu dała ci powód do zachowania albo usunięcia komponentu. Dla każdego komponentu zapisz, kto go utrzymuje, ile jednostek token lub sekund dodaje i który test regresyjny uzasadniałby jego usunięcie. Pół roku później osoba, która zobaczy progress_handoff=True, powinna móc znaleźć nieudane ślady, które go uzasadniły, i przypadki regresyjne, które nadal go utrzymują.
Praktyczne zastosowanie tych decyzji przedstawia Projektowanie harnessu agenta, które rozpoczyna etap budowy w serii Recursive Harness Engineering od asystenta obsługi klienta.
Referencje
- OpenAI, Unrolling the Codex agent loop.
- OpenAI, Harness engineering: leveraging Codex in an agent-first world.
- Anthropic Engineering, Demystifying evals for AI agents.
- Anthropic Engineering, Effective harnesses for long-running agents.
- Anthropic Engineering, Harness design for long-running application development.
- Lopopolo, Harness engineering: anthology, field guide, and agent context bundle.
- LangChain, Improving Deep Agents with harness engineering.
- OpenAI, How two settings tripled our ARC-AGI-3 scores.
- Wang et al., Harness Handbook: Making Evolving Agent Harnesses Readable, Navigable, and Editable, arXiv:2607.13285, 2026.
- Stripe, Idempotent requests.
- Yang et al., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering.
- AWS, Making retries safe with idempotent APIs.
- Model Context Protocol, Tools specification.
- Model Context Protocol, Tasks extension i Tasks specification.
- Anthropic Engineering, An update on recent Claude Code quality reports.
Kod agenta Market Analyst Agent z tej serii jest dostępny na GitHubie.