AI Agent Tool Use: MCP, CLI, Skills en code execution

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Dit artikel is bedoeld voor engineers die een agent toegang geven tot data, commando’s of externe services. Je leert hoe je een actie definieert die de agent betrouwbaar kan gebruiken, hoe je er een uitvoeringsinterface voor kiest en hoe je controleert of die interface helpt bij jouw taken. Het doorlopende voorbeeld is de Market Analyst Agent, een research agent die marktdata ophaalt en rapporten opstelt.
In deel 1 koos het model een volgende stap in een reasoning loop. Deel 2 ging over wat het tussen stappen kan onthouden. Een tool geeft die keuze een effect buiten het model: hij kan een koers ophalen, een opgeslagen rapport lezen, code uitvoeren of een record wijzigen. Het programma rond het model, de harness, bepaalt nog steeds welke van die acties bestaan en of een voorgestelde call mag worden uitgevoerd.
De eerste ontwerpbeslissing is de actie zelf. Als de agent voor één rapport koers- en waarderingsdata nodig heeft, moet hij dan twee API-endpoints aanroepen, één aandelen-snapshot opvragen of een gegenereerd programma gebruiken? Het antwoord hangt af van de taak en de feedback die de agent nodig heeft, niet van het integratieprotocol.
Zie voor de korte interfacebeslissing AI Agent Tool Interfaces.
Wat een bedrijfsoverzicht nodig heeft
Stel dat de gebruiker de Market Analyst Agent vraagt om een actueel overzicht van een bedrijf. De agent heeft dan misschien een recente koers, handelsvolume, waarderingskengetallen, koershistorie en nieuws nodig. Dat zijn verschillende vragen. De laatste koers en de basiskengetallen horen vaak in hetzelfde antwoord, terwijl historische koersen en nieuws voor een kort antwoord overbodig kunnen zijn. Een ongerelateerde mogelijkheid om een trade uit te voeren hoort niet in dit researchpad.
Schrijf vier dingen op voordat je een API beschikbaar maakt:
- Actie: Wat kan de agent in één stap aanvragen? Kies bij voorkeur een operatie die past bij een vraag die hij echt moet beantwoorden.
- Argumenten: Welke invoer moet de aanroeper leveren, en welke kan de applicatie valideren voordat ze contact opneemt met de service?
- Resultaat: Welke feiten laten de agent zijn volgende stap bepalen, en welke herkomstgegevens of identifiers moeten bewaard blijven voor latere controles?
- Fout en effect: Wat kan er veranderen, hoe kan een aanroeper zien of de actie heeft plaatsgevonden, en wanneer is een retry veilig?
Deze vragen scheiden drie verantwoordelijkheden. Het model stelt een actie voor. De harness valideert en routeert die. De toolimplementatie voert haar uit en geeft een resultaat terug. Een JSON Schema kan een onjuist gevormde ticker afwijzen; het kan niet vaststellen dat een trade geautoriseerd is. Een protocol kan een tool call afleveren; het kan een mislukte schrijfactie niet veilig herhaalbaar maken.
De SWE-agent-paper noemt het ontwerp van deze interactie een Agent-Computer Interface (ACI), naar analogie van mens-computerinteractie: agents op basis van taalmodellen zijn een nieuw soort gebruiker en hebben baat bij interfaces die voor hen zijn gebouwd. De ablatie op 300 taken uit SWE-bench Lite haalde 18,0% met de volledige interface, tegenover 7,3% voor een shell-only conditie zonder uitgewerkte demonstratie en 11,0% met een demonstratie. De condities verschillen in meer dan één toolbeschrijving, dus deze cijfers voorspellen niet wat een herontwerp van je eigen tools oplevert. Ze laten wel zien dat de interface samen met het model getest moet worden. Anthropics Building Effective Agents zegt hetzelfde: besteed evenveel moeite aan de agent-computer interface als aan een interface voor mensen.
De figuur volgt één get_stock_snapshot-call door het model, de harness en de tool, en nummert elke stap met het principe uit de lijst hieronder dat erbij hoort. De controle op een ontbrekende prijs is een aanbeveling: de snapshotimplementatie op de vastgezette revisie zet een ontbrekende prijs momenteel standaard op nul.
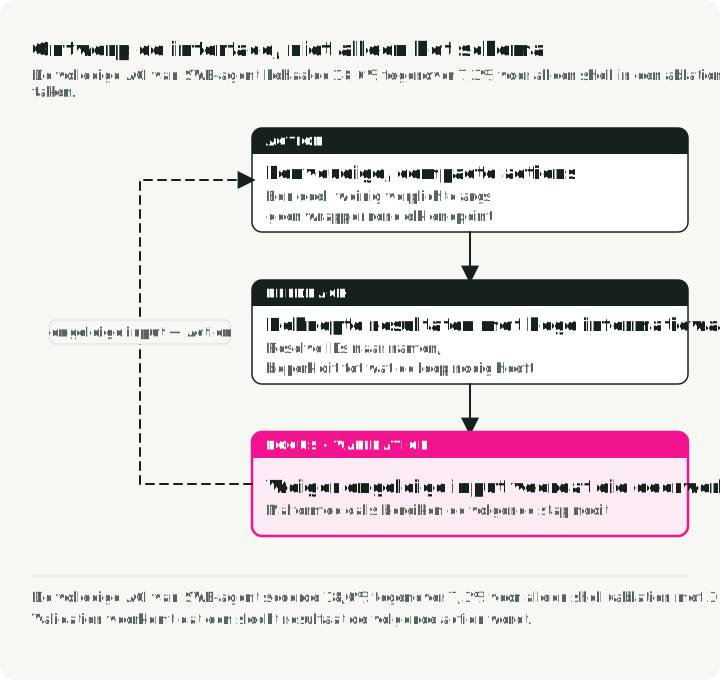
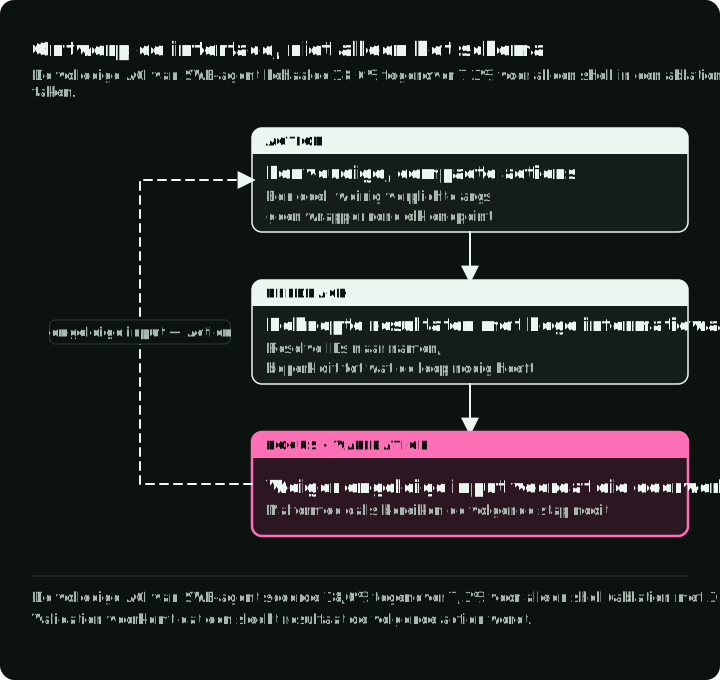
De vier ACI-principes gelden voor elke interface in dit artikel:
- Eenvoudige acties. Wrap API-endpoints niet één-op-één. Bied in plaats van
list_users,list_eventsencreate_eventéénschedule_eventaan, die beschikbaarheid zoekt en in één call boekt. Bied in plaats vanread_logseensearch_logsaan, die de relevante regels met context teruggeeft. - Compacte acties. Combineer operaties die één taak dienen, zoals de aandelen-snapshot hieronder doet.
- Beknopte, informatieve feedback. Geef semantische namen terug in plaats van ruwe HTML, volledige API-payloads of cryptische ID’s, maar bewaar elke ID die een latere call nodig heeft.
- Validatie die voorkomt dat fouten zich verspreiden. Controleer argumenten vóór de call en resultaten vóór de volgende actie. In SWE-agent wees een editor met ingebouwde linting syntaxfouten af; inschakelen verhoogde de editconditie van 15,0% naar 18,0%.
Maak een tool makkelijk te kiezen en te gebruiken
De Market Analyst Agent geeft een concreet voorbeeld. Een eerdere versie stelde get_stock_price en get_company_metrics apart beschikbaar. De executor stelt nu get_stock_snapshot, get_price_history, get_financials, search_news en search_competitors beschikbaar. De snapshot combineert koers, volume, marktkapitalisatie en koers-winstverhouding, omdat een basisoverzicht die normaal samen nodig heeft. Historie, financiële overzichten en nieuws blijven gescheiden, omdat de agent ze niet allemaal nodig heeft.
| Voor (oorspronkelijke tools) | Na (marktdatatools) | Waarom |
|---|---|---|
get_stock_price + get_company_metrics | get_stock_snapshot | Eén call geeft de basissnapshot van koers en waardering |
get_price_history | get_price_history | Behouden, met gevalideerde periodes en een samenvatting van het gemiddelde volume |
search_news | search_news | Geeft gestructureerde items met geëxtraheerde kernpunten |
search_competitors | search_competitors | Behoudt de zoekactie gericht op concurrenten |
| Geen tool voor financiële overzichten | get_financials | Kiest per parameter resultatenrekening, balans of kasstroom |
De toollijst van de agent bevat ook een skill loader, twee CLI-wrappers en een beperkte in-process Python-evaluator, en dekt dus drie van de interfaces die hieronder worden beschreven; MCP verschijnt als aparte sidecar.
Dat is een keuze over actiegrootte. Een één-op-één-wrapper rond elk upstream-endpoint dwingt het model te plannen rond de API-indeling van de provider. Eén tool met veel ongerelateerde modi verschuift het selectieprobleem alleen naar de argumenten. Groepeer velden die dezelfde taak dienen en test daarna of agents de juiste actie kiezen.
Schrijf de beschrijving voor het model
De beschrijving van de snapshot zegt wanneer je hem eerst aanroept, wat hij teruggeeft en wanneer je in plaats daarvan historie of financiële overzichten kiest. Die verwijzing naar naburige tools is even belangrijk als de naam. “Search for items” kan het model niet vertellen of search_news of search_competitors een verzoek beantwoordt. Anthropics gids voor toolontwerp raadt eveneens beschrijvingen, voorbeelden en resultaten aan die een model helpen de juiste actie te kiezen, en de documentatie over tooldefinities stelt minstens drie of vier zinnen voor over wanneer je de tool gebruikt, de parameters, de output en randgevallen:
# Vague: the model cannot tell when to use it.
vague = [{"name": "search", "description": "Search for items"}]

# Specific: when to use it, what it returns, and which tool to use instead.
specific = [{
    "name": "search_news",
    "description": (
        "Search for recent news articles about a specific stock or company. "
        "Use this tool when the user asks about recent events, earnings, "
        "announcements, or market-moving news for a specific ticker. "
        "Returns up to 10 articles sorted by relevance. "
        "For company competitors rather than news, use search_competitors instead."
    ),
    "input_schema": {
        "type": "object",
        "properties": {
            "query": {
                "type": "string",
                "description": "Search query. Examples: 'NVDA earnings Q3 2025', 'Tesla delivery numbers'",
            },
            "max_results": {
                "type": "integer",
                "description": "Max articles to return (1-10, default 5)",
                "default": 5,
            },
        },
        "required": ["query"],
    },
}]
Voeg voorbeelden toe waar parameters dubbelzinnig zijn; besteed geen context aan het herhalen van wat een eenvoudig schema al zegt. In Anthropics interne tests verhoogde een veld input_examples de nauwkeurigheid bij complexe parameterafhandeling van 72% naar 90%. Anthropic meldt ook dat namespacing met prefix of suffix (asana_search of search_asana) merkbare effecten had op de evaluaties, zonder te zeggen welke won; test dus beide op je eigen toolset. Daarna gaf het evaluatietranscripten aan Claude Code om de tools te herschrijven, en op achtergehouden tests presteerde die lus beter dan de door experts geschreven tools.
Valideer argumenten en vorm resultaten
De implementatie valideert de ticker vóór het marktdataverzoek. Dit fragment is aangepast uit de gelinkte broncode; de gedeelde normalizer verwijdert witruimte, zet de waarde in hoofdletters en accepteert achtervoegsels met punt of koppelteken zoals BRK.B en BF-B. De historiequery voegt een toegestane set periodes toe:
from pydantic import BaseModel, Field, field_validator

from market_analyst.utils import normalize_ticker

class StockQuery(BaseModel):
    ticker: str = Field(description="Stock ticker symbol (e.g., NVDA)")

    @field_validator("ticker")
    @classmethod
    def validate_ticker(cls, value: str) -> str:
        return normalize_ticker(value)

class StockHistoryQuery(StockQuery):
    period: str = Field(default="1mo", description="Time period: 1d, 5d, 1mo, 3mo, 6mo, 1y")

    @field_validator("period")
    @classmethod
    def validate_period(cls, value: str) -> str:
        valid = {"1d", "5d", "1mo", "3mo", "6mo", "1y"}
        if value not in valid:
            raise ValueError(f"Invalid period: {value}. Must be one of {valid}")
        return value
De aandelen- en nieuwstools geven met Pydantic gevalideerde resultaten terug in plaats van ruwe provider-payloads. Het veld summary geeft de agent een kant-en-klare string voor een rapport, en key_points besparen hem het parsen van artikelteksten:
from pydantic import BaseModel

class StockSnapshot(BaseModel):
    ticker: str
    price: float
    change_pct: float
    volume: int
    market_cap_b: float
    pe_ratio: float | None
    summary: str  # One line for direct use in a report

class NewsItem(BaseModel):
    headline: str
    source: str
    date: str
    relevance_score: float  # Pre-ranked by the tool
    key_points: list[str]  # Extracted by the tool, not the agent

class NewsSearchResult(BaseModel):
    query: str
    results: list[NewsItem]
    summary: str
Het snapshotresultaat heeft deze getypeerde velden voor koers, procentuele verandering, volume, marktkapitalisatie, koers-winstverhouding en een korte samenvatting. Voeg de databron en het peilmoment van de markt toe aan het resultaat en laat het rapport die vermelden. Het nu ophalen van data bewijst niet dat de koers actueel is.
Houd resultaten kort genoeg voor de volgende beslissing, maar gooi geen identifier of bron weg die een latere actie nodig heeft. Bij een zoekresultaat kunnen een titel en samenvatting genoeg zijn om kandidaten te rangschikken; de URL of ID moet beschikbaar blijven als de agent een specifiek item moet ophalen of citeren. Een beknopt en een gedetailleerd resultaat kunnen verschillende stappen dienen: Anthropics tests voegden een parameter response_format toe die in beknopte modus ongeveer 72 tokens teruggaf en in gedetailleerde modus 206. Ruwe upstream-payloads zijn zelden een nuttige standaard.
Geef fouten terug waarop de loop kan reageren
Fouten horen bij hetzelfde contract. Zet een ontbrekende koers niet standaard op nul, want dan ziet een niet-beschikbare koers eruit als een koers van nul dollar. Verpak ook niet elke definitieve fout in één exceptiontype, want dan kan de aanroeper geen retrycategorie kiezen. Wijs ontbrekende marktdata af en maak onderscheid tussen ongeldige invoer, tijdelijke providerstoringen en niet-beschikbare data. Een tool die externe state schrijft, moet ook een bekende fout onderscheiden van een uitkomst die mogelijk is voltooid ondanks een verloren antwoord. Geef genoeg detail terug om te kiezen tussen retry, verduidelijking of escalatie; voorkom dat providertekst een instructie aan het model wordt.
Vier mechanismen behandelen verschillende foutklassen: retry met backoff voor tijdelijke fouten, model-fallback voor provideruitval, classificatie die herstelbare fouten terugstuurt naar de agent en de rest escaleert, en checkpointherstel bij crashes (deel 2). Probeer alleen tijdelijke fouten opnieuw, zoals timeouts, netwerkfouten en 429- en 5xx-responses, met exponentiële backoff en een kleine limiet op het aantal pogingen; een library zoals Tenacity doet dit in een decorator. De aanroeper moet een definitieve exception, of een niet-herhaalbare 4xx, nog steeds omzetten in een stabiel resultaat dat zegt welke operatie mislukte en wat de volgende stap is. Een retry classificeert de fout niet, en is alleen veilig voor een leesactie of een idempotente schrijfactie. Meet herstelpercentage, retries en escalaties op je eigen takenset.
Probeer het contract uit
Installeer vanuit de begeleidende repository de vastgezette dependencies en voer de tooltests uit:
uv sync --locked
uv run pytest tests/test_tools.py -q
De snapshottest injecteert synthetische marktdata en controleert ticker, koers, volume, waarderingsvelden en samenvatting. Hij test het toolcontract zonder live koers of model; hij meet niet of een agent de juiste tool kiest. Met providercredentials geconfigureerd zoals de README van de repository beschrijft, kun je ook uv run market-analyst "NVDA price update" --mode flash --no-persist uitvoeren om een concept uit het agentpad te bekijken. Die run gebruikt live services en is een voorbeeld, geen benchmark.
Kies de uitvoeringsinterface
Zodra het actiecontract duidelijk is, kies je hoe de agent de actie bereikt. Deze interfaces beantwoorden verschillende vragen; een nieuwere vervangt geen oudere.
De figuur volgt elke route in de Market Analyst Agent van het model naar de operatie die ze bereikt.
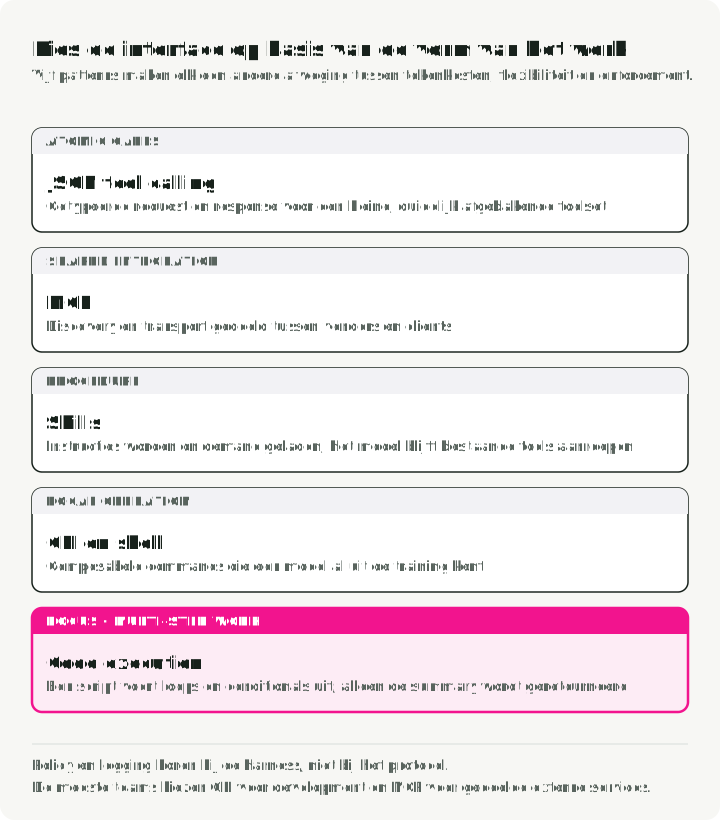
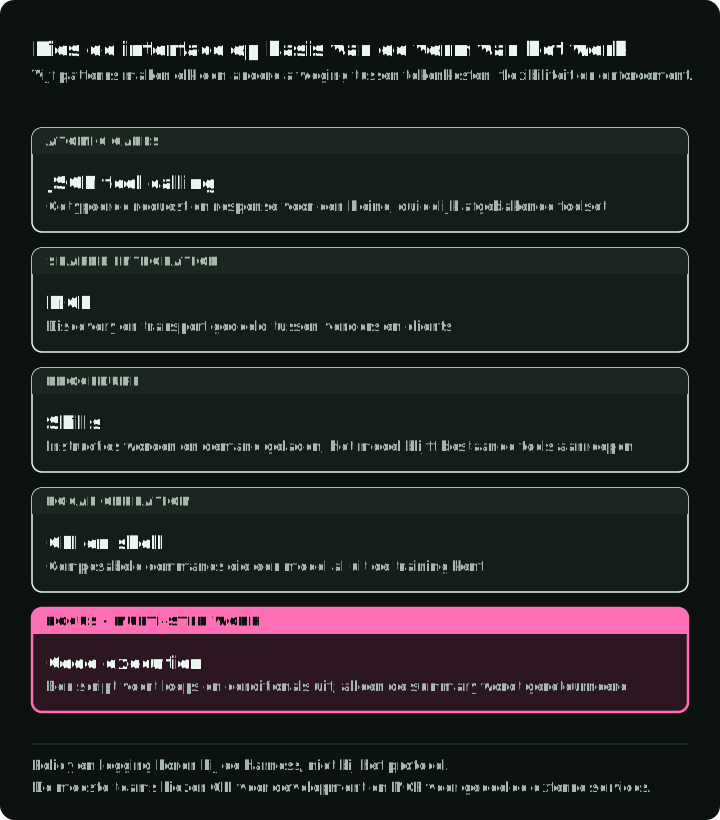
| Behoefte | Startinterface | Wat het toevoegt |
|---|---|---|
| Een kleine set getypeerde operaties in één applicatie | JSON tool calls | Expliciete namen, argumenten en resultaten |
| Dezelfde tools voor meerdere clients | MCP | Gedeelde discovery en gedeeld transport |
| Een bestaand commando met stabiele output | CLI-wrapper | Hergebruik van het commando en de help |
| Veel afhankelijke operaties of lokale dataverwerking | Code execution | Loops, condities en filtering binnen één run |
| Herbruikbare instructies voor al het bovenstaande | Skill | Instructies die worden geladen wanneer relevant |
De tabel geeft een eerste keuze; hij rangschikt de interfaces niet op prestatie. MCP-tools hebben nog steeds schema’s en gestructureerde calls. Een CLI kan achter een JSON-toolwrapper zitten. Een code runner kan toegestane tools aanroepen. Skills zijn instructies voor het gebruik van een mogelijkheid, geen extra uitvoeringskanaal.
Getypeerde calls voor afgebakende acties
Voor get_stock_snapshot(ticker) volstaat een getypeerde call. Het model levert een ticker; de harness controleert het argument, roept de implementatie aan en geeft een gestructureerd resultaat terug. De volgende call kan van dat resultaat afhangen. Onafhankelijke opvragingen kunnen vaak parallel draaien, maar een call waarvan de argumenten van het eerste resultaat afhangen, heeft een extra modelstap nodig, tenzij applicatiecode de operaties combineert.
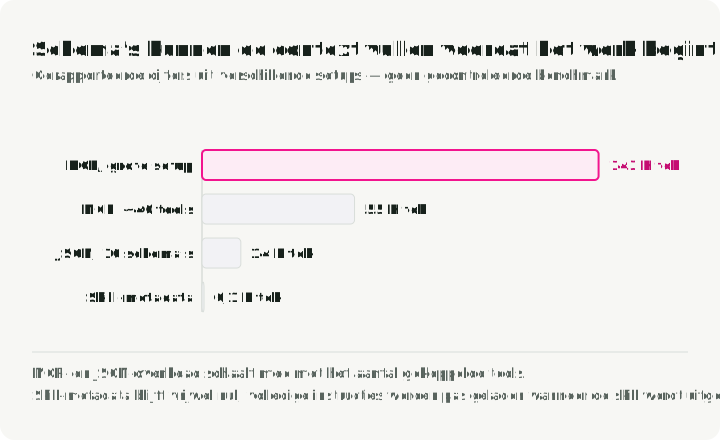
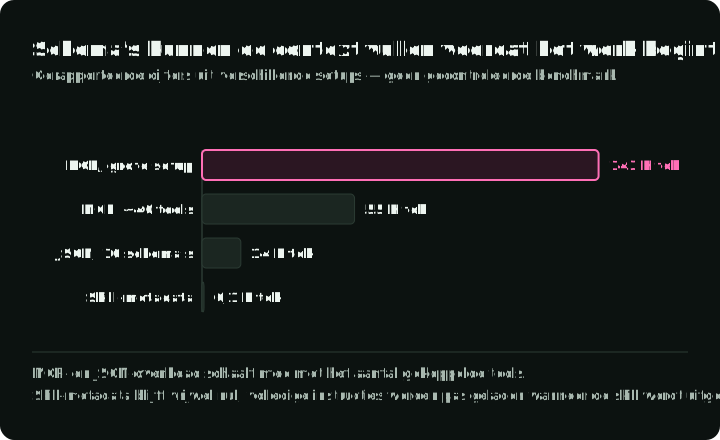
De lage opzetkosten zijn nuttig wanneer één applicatie een kleine toolset beheert. Schematokens tellen nog steeds mee wanneer tooldefinities in de context worden geladen, dus meet de omvang van je werkelijke definities. Als de catalogus groeit, kan uitgestelde discovery alleen waarschijnlijke kandidaten laden. In Anthropics Tool Search-voorbeeld daalde de geschatte context vóór het werk van 77.000 naar 8.700 tokens in een setup met meer dan 50 tools, door alleen de drie tot vijf tools te laden die een verzoek nodig heeft. Dat is een resultaat van die toolset en die retrievalmethode, en het voegt vóór elke call een discoverystap toe. Het helpt minder bij een kleine toolset die in elke session wordt gebruikt. Discovery moet ook getest worden op gemiste of verkeerde tools.
Het laden van een schema is doorgaans eenrichtingsverkeer: een definitie die het model twintig stappen later mag aanroepen, moet beschikbaar blijven, en het verwijderen ervan verandert het stabiele deel van het verzoek waar prefix caching van afhangt. Een discoverystap voegt dus meestal definities toe en wisselt er nooit een uit. Een schema dat het model nog kan zien, is ook geen permissie die het model nog heeft. Leg de schemaversie en de effectieve permissie vast op het moment van discovery en controleer de permissie opnieuw wanneer de call wordt uitgevoerd.
Wanneer een resultaat wordt ingekort om binnen het budget te passen, meld dat dan in het resultaat zelf en geef het model een manier om een regel- of bytebereik van de volledige uitvoer op te vragen, zodat het een kort antwoord kan onderscheiden van een afgekapt antwoord en de rest kan ophalen wanneer dat ertoe doet.
De grafiek zet dit voorbeeld op één tokenschaal met de MCP-setups die verderop in deze sectie worden beschreven.
MCP voor een gedeelde service
Met het Model Context Protocol kan een server tools en andere mogelijkheden aan clients aanbieden via stdio of HTTP. De MCP-client van de agent maakt verbinding, vraagt de server wat hij aanbiedt en stuurt de calls van het model door, zodat één server werkt met elke client die het protocol spreekt. Sinds december 2025 wordt MCP beheerd door de Agentic AI Foundation onder de Linux Foundation, niet door één leverancier.
Gebruik MCP wanneer een service bereikbaar moet zijn vanaf meerdere agent-hosts, voor SaaS-integraties zoals Figma, Notion of Salesforce, voor services zonder CLI, of wanneer gestandaardiseerde discovery, OAuth-afhandeling en remote integratie de kosten van het draaien van een server rechtvaardigen. De Market Analyst Agent stelt zijn researchtools ook beschikbaar via een MCP-sidecar. De aandelenactie is geen andere bedrijfsoperatie geworden alleen omdat de client haar via MCP ontdekt.
Het protocol autoriseert geen gevraagd bedrijfseffect. De server en de applicatie hebben nog steeds authenticatie, afgebakende permissies, invoercontroles en een auditrecord nodig voor operaties die ertoe doen. Toolbeschrijvingen en teruggegeven documenten zijn ook onbetrouwbare invoer; de tool-poisoningdemonstratie van Invariant Labs laat zien dat kwaadaardige instructies in toolmetadata een agent kunnen beïnvloeden voordat de tool wordt aangeroepen. De MCPTox-benchmark, die 20 LLM-agents testte tegen 45 live MCP-servers en 353 echte tools, rapporteerde het hoogste aanvalssuccespercentage, 72,8%, voor o1-mini in de tool-poisoningsetup; dat is het benchmarkresultaat van één model, geen incidentpercentage. Het Vulnerable MCP Project verzamelt meldingen die bruikbaar zijn als testcases. De host moet tooltekst behandelen als data, niet als toekenning van bevoegdheid.
Controleer welke MCP-revisie elke kant ondersteunt. De revisie 2026-07-28 maakt requests stateless, vervangt daarmee de initialisatie-handshake en verwijdert stream-hervatting, dus oudere tutorials passen mogelijk niet bij de SDK die je installeert. Een afgebroken responsestream heeft dan een nieuw request nodig, nog een reden om dubbele bedrijfseffecten in de tool zelf te voorkomen. Bekijk de geïnstalleerde SDK en het servercontract voordat je op een feature vertrouwt. Voor een aanroep die langer duurt dan één respons voegt de officiële Tasks-extensie een duurzame handle toe: de server geeft een taak-ID terug en de client vraagt het werk op of annuleert het met tasks/get en tasks/cancel. Deel 6 gebruikt die handle wanneer een aanroep een timeout krijgt.
Grote catalogi kunnen duur zijn als elke beschrijving voor elk verzoek wordt geladen. Apideck beschrijft een gangbare setup, GitHub, Slack en Sentry met ongeveer 40 tools, die zo’n 55.000 tokens aan definities laadt voordat de gebruiker iets vraagt, en noemt een team waarvan de drie MCP-servers 143.000 van 200.000 contexttokens gebruikten. Beide zijn gerapporteerde cijfers, geen metingen van jouw catalogus. Dit is een beslissing over het laden van schema’s, geen inherente prijs van het MCP-wireprotocol. Laad waar mogelijk een kleinere relevante set en meet of discovery nog steeds de juiste tool vindt.
CLI-wrappers voor gevestigde commando’s
Een CLI is aantrekkelijk wanneer de operatie al bestaat als commando met een bruikbare --help, stabiele exitcodes en machineleesbare output. De CLI-tools van de Market Analyst Agent wrappen twee specifieke commando’s voor het tonen van een lijst en het weergeven van opgeslagen rapporten. Ze geven een argumentenlijst door aan subprocess.run en vragen om JSON; de agent krijgt geen willekeurige shell. Dat onderscheid maakt de toegestane actie zichtbaar en voorkomt dat elke gegenereerde commandostring als betrouwbaar wordt behandeld.
Een breed gedocumenteerd commando zoals git, gh, docker, kubectl, curl of jq heeft voor een coding agent misschien weinig nieuwe documentatie nodig, maar een interne CLI heeft nog steeds voorbeelden en outputcontracten nodig. Ugo Enyioha’s gids Writing CLI Tools That AI Agents Actually Want to Use noemt acht regels voor zo’n commando:
- Ondersteun gestructureerde output met
--json. - Gebruik verschillende exitcodes voor verschillende fouttypen.
- Maak commando’s idempotent.
- Bied
--helpmet realistische voorbeelden. - Ondersteun compositie:
--quietvoor kale waarden en invoer via stdin. - Bied
--dry-runen--yes. - Rapporteer de versie van de tool.
- Haal credentials uit omgevingsvariabelen.
Een shell voegt pipes en compositie toe, samen met toegang tot bestanden, processen, credentials en netwerkpaden. Geef hem alleen de toegang die de taak vereist. Een CLI heeft geen discovery- of autorisatiemodel op protocolniveau; de harness moet beleid afdwingen en de calls vastleggen die hij moet auditen. Een praktische standaard is CLI voor ontwikkeling en lokale operaties, en MCP voor gedeelde externe services wanneer discovery over clients heen of OAuth-afhandeling het draaien van een server waard is.
In Scalekits vergelijking van 75 runs gebruikte CLI op vijf alleen-lezen GitHub-taken minder tokens dan een configuratie die 43 MCP tool schemas laadde. De zeven MCP-fouten waren verbindingstimeouts naar de remote server. Deze resultaten vergelijken die ingezette interfaces, geen algemene eigenschap dat CLI betrouwbaarder is of dat MCP meer context vereist. Voer de vergelijking uit met de commando’s, de server en het discoverybeleid die je werkelijk zou inzetten.
Code execution voor compositie
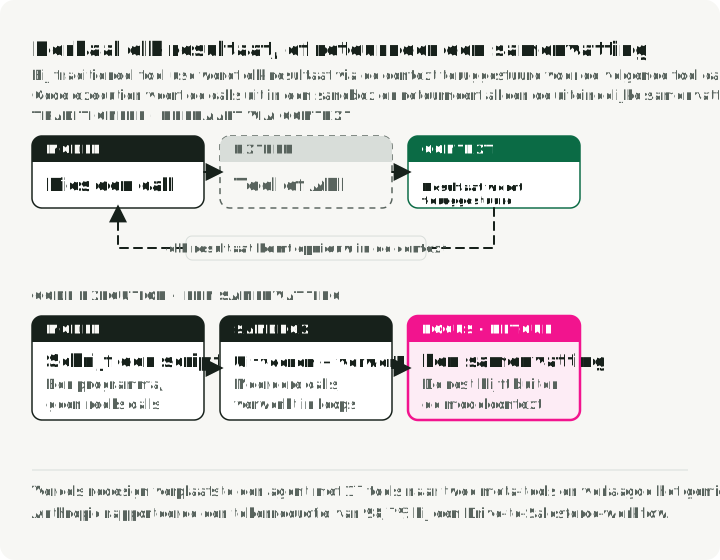
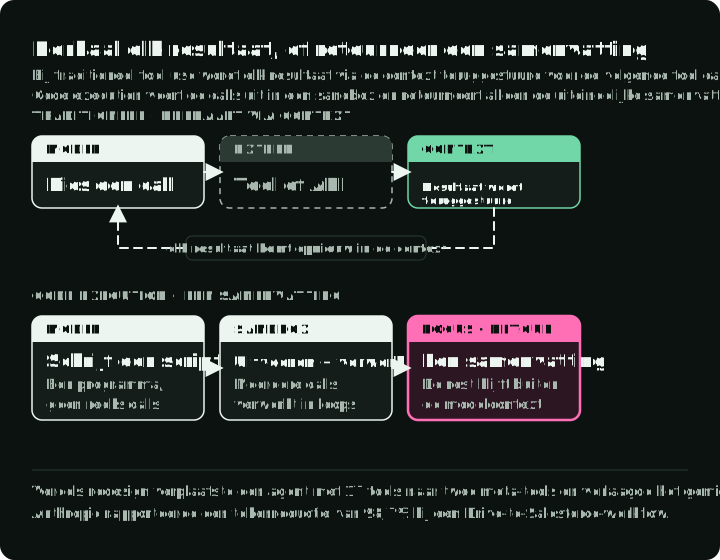
Een gegenereerd programma is nuttig wanneer de agent veel calls moet combineren, tussenliggende data moet filteren of over een groot resultaat moet rekenen. In plaats van elke rij door het model te sturen en het de volgende operatie te laten plannen, kan een runtime een loop uitvoeren en de relevante samenvatting teruggeven. De CodeAct-paper testte 17 modellen en vond op de 82 multi-tooltaken tot 20 procentpunt hoger taaksucces, met tot 30% minder acties dan JSON-alternatieven. Dat is een reden om de interface op vergelijkbaar werk uit te proberen, geen reden om één getypeerde opvraging te vervangen door een code runner.
De figuur voert Anthropics hieronder beschreven onkostencontrole op beide manieren uit en vergelijkt wat de context van het model bereikt.
Er zijn hier twee verschillende patronen. De codetool van de Market Analyst Agent accepteert Python voor berekeningen op data die al aan de tool is gegeven. Die code mag geen marktdatatools aanroepen. De tool controleert de knopen van de syntaxboom en voert de code daarna binnen het applicatieproces uit. Die allowlist is een didactische beperking, geen security-sandbox voor onbetrouwbare code. Voordat je willekeurige gegenereerde code of gevoelige procesresources blootstelt, heeft de uitvoering een geïsoleerde runtime met limieten op resources en toegang nodig.
Anthropics Programmatic Tool Calling (PTC) is een andere opzet: gegenereerde code kan specifiek ingeschakelde tools aanroepen binnen een beheerde uitvoeringsomgeving en een geselecteerd resultaat teruggeven aan de modelcontext. In Anthropics voorbeeld van onkostenanalyse vraagt tool-voor-tool calling meer dan 20 modelpassages, waarbij elke rij door de context gaat; gegenereerde code verminderde wat de context bereikte van ongeveer 200 KB aan onkostenrijen tot 1 KB aan resultaten. Het script hieronder toont die control flow met gewone asynchrone Python-adapters, niet met de native PTC-wrappers:
# Custom async adapters that return decoded Python objects, not native PTC wrappers.
import asyncio
import json

async def main() -> None:
    team = await get_team_members("engineering")
    levels = list({member["level"] for member in team})
    budgets = dict(zip(levels, await asyncio.gather(*(get_budget_by_level(l) for l in levels))))
    expenses = await asyncio.gather(*(get_expenses(member["id"], "Q3") for member in team))
    over_budget = []
    for member, rows in zip(team, expenses):
        total = sum(row["amount"] for row in rows)
        limit = budgets[member["level"]]["travel_limit"]
        if total > limit:
            over_budget.append({"name": member["name"], "spent": total, "limit": limit})
    print(json.dumps(over_budget))  # Only this summary returns to the model

asyncio.run(main())
Native PTC-wrappers verschillen van deze adapters in argument- en returnformaten, en niet elk tooltype kan vanuit code worden aangeroepen; bekijk de actuele gids voordat je een script overzet. De API-instelling allowed_callers stuurt de aanroep, maar vervangt niet de autorisatie door de host van elk onderliggend effect, inclusief een onverwachte directe call. Tussenliggende rijen buiten de modelcontext houden bespaart tokens, maar maakt ze niet vertrouwelijk tegenover de uitvoeringsomgeving en stelt ze niet vrij van logging en toegangscontroles.
Het voordeel hangt af van de vorm van de taak. In Anthropics interne evaluaties gebruikte een projectmanagementbenchmark met 75 tools ongeveer 38% minder gefactureerde inputtokens bij gelijke nauwkeurigheid. Op tau2-bench-taken met één of twee sequentiële calls per beurt bleven de scores gelijk en waren de kosten ongeveer 8% hoger. Een apart Drive-naar-Salesforce-voorbeeld daalde van ongeveer 150.000 naar 2.000 tokens, een reductie van 98,7% voor die workflow. Geen van deze cijfers is een universeel percentage voor code versus JSON. Codegeneratie, het opstarten van de runtime, fouten en outputverwerking kunnen bij eenvoudige taken zwaarder wegen dan de contextbesparing.
Twee casestudy’s van leveranciers laten hetzelfde ontwerp in producten zien. Vercel bouwde zijn text-to-SQL agent d0 opnieuw rond twee algemene tools, ExecuteCommand en ExecuteSQL, in plaats van de 17 uit het oude voorbeeld. Over vijf representatieve queries meldt het dat het succes steeg van 4/5 naar 5/5, de gemiddelde tijd daalde van 274,8 s naar 77,4 s en het tokengebruik met 37% daalde. Bij Cloudflares Code Mode schrijven agents TypeScript tegen een API in plaats van tool schemas aan te roepen, met als redenering dat modellen veel meer echte TypeScript hebben gezien dan voorbeelden van tool calls. Behandel beide als bewijs van leveranciers en herhaal de vergelijking op je eigen taken.
JSON tool calling blijft de betere keuze voor losse atomaire operaties, omgevingen zonder sandboxing, kleinere modellen met zwakke codegeneratie en auditregels die een record van elke afzonderlijke call vereisen.
Skills voor procedures
Een Agent Skill verpakt een bestand SKILL.md met een naam, beschrijving en instructies; het kan ook scripts en referenties bevatten. De open standaard vereist alleen name en description. Een minimale skill voor deze agent kan er zo uitzien:
---
name: stock-overview
description: Prepare a short overview of one stock. Use when the user asks for a current snapshot of a company.
---
1. Call get_stock_snapshot for the ticker.
2. If the result has no market timestamp, say that freshness is unknown.
3. Call search_news only if the user asked about recent events.
4. Cite every news item you use.
De skill vertelt de agent hoe hij zijn tools gebruikt; hij voegt geen nieuwe mogelijkheid toe. Gebruik skills voor domeinkennis, procedures met meerdere stappen en terugkerend werk zoals databasemigraties of betaalintegraties. De host bepaalt nog steeds welke tools de agent mag uitvoeren. De tekst van een skill is richtlijn, geen afdwinging van beleid.
Het formaat ondersteunt het laden van de korte naam en beschrijving, ongeveer 100 tokens, vóór de volledige instructies; gerefereerde scripts en bestanden worden alleen geladen wanneer nodig. Dat helpt wanneer er veel procedures zijn, maar de actieve skill en de bestanden die hij laadt verbruiken nog steeds context. Beoordeel de instructies en uitvoerbare bestanden zoals elke andere invoer voor de harness. Als een workflow veiligheidskritisch is, leg de vereiste validatie dan vast in de tool of de applicatie in plaats van te vertrouwen op een instructie die moet worden opgevolgd.
Een geladen skill kan resultaten ook verslechteren. Een studie uit 2026 naar SkillsBench en SWE-Skills-Bench schreef 307 mislukkingen toe aan specifieke geladen skills: 125 functionele fouten, waarbij het taakresultaat fout was, en 182 efficiëntieverliezen, waarbij de run meer kostte. Dit zijn mislukkingen die de auteurs in twee benchmarks konden toewijzen, geen faalpercentage voor skills in het algemeen. Draai een nieuwe skill op representatieve taken met en zonder die skill voordat je erop vertrouwt. De Agent Framework-richtlijnen van Microsoft beperken skills bovendien tot idempotente of laagrisico-operaties en geven de voorkeur aan een expliciete workflow wanneer een stap een neveneffect heeft, zoals een betaling, dat bij een retry niet mag worden herhaald. De skill-tools vragen standaard om goedkeuring.
Vergelijk de interfaces
| Vraag | JSON tool calls | MCP | Skills | CLI | Code execution |
|---|---|---|---|---|---|
| Het meest geschikt voor | Eenvoudige, losse acties | Gedeelde services voor meerdere clients | Herbruikbare procedures voor een andere interface | Ontwikkeling en lokale operaties | Werk in meerdere stappen over grote resultaten |
| Contextkosten | Geladen schema’s | Geladen of uitgestelde schema’s | Ongeveer 100 tokens tot activering | Helptekst, commando en output | Entry-schema’s, code en output |
| Afhankelijke calls | Meestal één modelbeurt per call | Eén modelbeurt plus transport | Volgt de onderliggende interface | Meestal één modelbeurt per call | Eén scriptbeurt; de runtime voert de flow uit |
| Beveiligingsoppervlak | Bevoegdheid over argumenten en effecten | Serveridentiteit en toolbevoegdheid | De host en de resources die hij toekent | Shell, paden, credentials | Code, datatoegang en uitgaand netwerkverkeer |
| Opzet | Laag | Serverdeployment | Laag; hangt af van de onderliggende interface | Zeer laag voor bestaande commando’s | Een sandbox-runtime |
| Debugging | Gestructureerde input en output | Voegt een transportlaag toe | Leesbare Markdown | Commando’s zijn zichtbaar | Leesbare code |
Skills sturen een van de andere vier aan, dus hun latency en opzet volgen de interface die ze kiezen. De rijen vatten de geciteerde voorbeelden samen, niet één gecontroleerde benchmark over alle vijf.
Een paar trade-offs lopen door de hele tabel. Code execution kan context besparen, maar voegt generatie- en containertijd toe. MCP bespaart integratiewerk, maar voegt een server toe die je moet draaien. CLI is gratis om mee te beginnen en lastiger te beheersen op schaal. Stem de interface af op je team: code execution veronderstelt een model dat betrouwbare code schrijft, CLI veronderstelt Unix-conventies en MCP veronderstelt vertrouwdheid met transports en OAuth. Tools consolideren kan ook te ver gaan, wanneer één tool ongerelateerde modi verzamelt. Gestructureerde calls zijn makkelijk te loggen, maar geen enkel protocol maakt op zichzelf een volledig auditrecord; de host, server of harness legt calls en resultaten vast en dwingt beleid af.
Een eerste testset voor de interface
Een kleinere toollijst of goedkopere prompt is alleen nuttig als de agent het werk nog steeds afmaakt. Vergelijk interfaces met dezelfde takenset, hetzelfde model, dezelfde data, toegestane operaties en voltooiingsregels. Neem gevallen op waarin de juiste volgende stap is om om verduidelijking te vragen of te stoppen.
Voor de Market Analyst Agent kan een eerste testset deze gevallen bevatten:
| Verzoek of conditie | Wat je controleert |
|---|---|
| Basisoverzicht van een aandeel | Juiste ticker, snapshotvelden, bron en markttijd in het antwoord |
| Koershistorie nodig, maar geen nieuws | De agent kiest de historie zonder ongerelateerde calls |
| Provider geeft geen geldige koers terug | Geen verzonnen koers; de run meldt niet-beschikbare data |
| Grote set onafhankelijke opvragingen | Kwaliteit van het eindantwoord, modelbeurten, input-/outputtokens, latency en runtimefouten |
| Voorgestelde trade tijdens een researchverzoek | Geen trade-effect; de toollijst voor research geeft die actie niet |
Leg de tool calls en hun resultaten vast, naast het eindantwoord. Een plausibel rapport kan een mislukte opvraging verbergen; een correcte eindkoers kan onnodige calls verbergen. Als een interface verandert, tel dan zowel geslaagde taken als nieuwe faalwijzen: verkeerde toolkeuze, ongeldige argumenten, gemiste discovery, herhaalde neveneffecten, syntaxfouten en timeouts. Leg ook discoverytokens, gecachete en niet-gecachete input en retries vast.
Daarna kun je de interface wijzigen wanneer een meting dat ondersteunt. Houd een getypeerde call zolang hij de taak netjes afhandelt. Voeg MCP toe wanneer gedeelde discovery nodig is, een CLI-wrapper wanneer een bestaand commando de duidelijkste operatie is, of code execution wanneer gemeten winst door compositie de runtime rechtvaardigt. Het actiecontract, dus wat mag gebeuren, welk resultaat dat bewijst en wat een fout betekent, moet nog steeds expliciet zijn.
Drie richtingen voor tool use op schaal
Tool retrieval. Haal, voordat het model kiest, de paar toolbeschrijvingen op die bij het verzoek passen. In de benchmark en MCP-stresstest van RAG-MCP verhoogde retrieval de nauwkeurigheid van toolselectie van 13,62% naar 43,13% en daalden de prompttokens van ongeveer 2.134 naar 1.084. De beschrijvingen van de setup verschillen tussen secties van de paper, wat beperkt hoe ver de cijfers reiken.
Agents die tools maken. Bij LATM schrijft een sterk model herbruikbare Python-functies die een kleiner model daarna aanroept. ToolMaker implementeerde 12 van 15 taken correct die waren gebouwd op papers met publieke code. Die kleine benchmark toont geen betrouwbaarheid in productie aan, maar wijst wel in de richting van het beheren van een bibliotheek met gegenereerde tools.
A2A naast MCP. Google droeg A2A in juni 2025 over aan de Linux Foundation. De A2A-documentatie verdeelt de rollen: MCP verbindt een agent met tools en resources, terwijl A2A afzonderlijke agents elkaar laat ontdekken, taken laat delen en werk laat delegeren.
Deel 4, AI Agent Security, volgt de voorgestelde actie tot aan de permissiecontrole. Deel 5, Agent Runtime, plaatst de uitvoering in een herstelbare runtime. Deel 6, Harness Engineering for AI Agents, brengt de loop, tools, het beleid en de voltooiingscontrole samen.
Referenties
Papers
- Executable Code Actions Elicit Better LLM Agents (CodeAct) — Wang et al., ICML 2024
- SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering — Yang, Jimenez et al., NeurIPS 2024
- RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection
- LLMs As Tool Makers (LATM) — Cai et al., 2023
- ToolMaker: LLM Agents Making Agent Tools — Wölflein et al., ACL 2025
- MCPTox: A Benchmark for Tool Poisoning Attack on Real-World MCP Servers
- Agent Skills Can Be Harmful: An Empirical Study of Skill-Induced Failures in LLM Agents — Dong et al., 2026
Engineering en documentatie van Anthropic
- Advanced tool use — Tool Search, Programmatic Tool Calling en inputvoorbeelden
- Programmatic tool calling — actuele API-gids en beperkingen
- Code execution with MCP — het Drive-naar-Salesforce-voorbeeld
- Writing effective tools for agents
- Building effective agents
Protocollen
- Model Context Protocol-specificatie, 2026-07-28 en changelog
- MCP Tasks extension
- Agent Skills-specificatie
- Microsoft Agent Framework: Agent Skills
- A2A and MCP
Casestudy’s en security
- Vercel: We removed 80% of our agent’s tools
- Cloudflare: Code Mode
- Apideck: MCP server eating your context window
- Scalekit: MCP vs CLI
- Invariant Labs: MCP tool poisoning attacks
- Vulnerable MCP Project
- Writing CLI Tools That AI Agents Actually Want to Use — Ugo Enyioha
Demoproject
- Market Analyst Agent — toolconsolidatie en ACI-patronen