Concevoir un harness d’agent : de la tâche à l’architecture

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Un harness d’agent est le code qui entoure un modèle de langage et lui permet d’accomplir une tâche. Il donne au modèle des instructions et des données, exécute les actions que le modèle demande, suit l’avancement et décide quand la tâche est terminée. Cet article s’adresse aux ingénieurs qui ajoutent un agent à leur propre application. Il montre comment concevoir ce code à partir de la tâche : quelles étapes le modèle choisit, quelles étapes votre code fixe à l’avance, et quelles règles votre code applique quoi que dise le modèle.
Prenez ces décisions avant de choisir un framework d’agent, car les réponses diffèrent d’une tâche à l’autre. Un assistant de support modifie des comptes clients ; il lui faut donc des contrôles de permissions et un moyen sûr de rejouer un paiement. Un agent de code modifie des fichiers et lance des tests ; il lui faut un endroit où son code peut s’exécuter sans rien abîmer d’autre. Un classifieur de documents ne renvoie qu’une étiquette ; il peut se passer d’outils. Si les trois partent de la même boucle, du même stockage de mémoire et du même ensemble d’outils, personne ne se demande ce dont chaque tâche a besoin.
Nous suivrons ces décisions sur un exemple, un assistant de support client qui émet des remboursements, de la description de la tâche à une première implémentation. L’article prolonge Harness Engineering for AI Agents, qui décrit les responsabilités d’un harness. Ici, nous choisissons ces responsabilités pour un projet précis.
Pourquoi le modèle a besoin d’un harness
Dans notre assistant de support, le modèle peut proposer un remboursement, mais il ne peut pas le mener à bien sans aide. Le code doit trouver le compte du client, charger la commande, vérifier que le remboursement est autorisé, appeler le service de paiement et enregistrer le résultat. Si le service de paiement dépasse le délai, le code doit aussi décider si une seconde tentative est sûre. Ces tâches subsistent même quand le modèle choisit très bien l’étape suivante.
Une partie de ce code existe peut-être déjà dans votre application. LangChain, le framework d’agent que cette série utilise plus loin, définit le harness de façon large : tout le code, la configuration et la logique d’exécution autour du modèle. L’authentification, l’accès à la base de données, une file de tâches et une étape d’approbation entrent tous dans cette définition. Concevoir un harness inclut de décider comment l’agent s’en sert. Vous n’avez pas à les reconstruire dans un framework d’agent.
Un harness peut être petit ou grand. Le plus petit fait un appel au modèle, valide la sortie et renvoie un résultat. Un harness plus grand laisse le modèle lire des fichiers, lancer des programmes et réviser son travail sur de nombreux tours. Les deux doivent répondre à deux questions : quelles parties de la tâche le modèle prend-il en charge, et comment vérifier qu’elles ont été bien exécutées ?
Décrire le résultat avant l’agent
« Traiter les demandes de remboursement » ne dit pas encore ce que l’assistant doit faire. Supposons qu’un client demande le remboursement d’une commande livrée. L’exécution réussit si elle rembourse la bonne commande pour le bon montant, explique le résultat au client et ne change rien d’autre sur le compte. Si la demande enfreint la politique de remboursement, un refus clair est le résultat correct. Si l’assistant ne sait pas de quelle commande parle le client, il doit poser la question.
Un remboursement, un refus et une question sont trois résultats corrects différents. Si nous comptons comme un succès toute conversation qui se termine sans erreur, nous ne pouvons ni les distinguer entre eux, ni les distinguer d’une mauvaise réponse formulée poliment.
Un remboursement correct dépend aussi de qui le demande. Un client peut saisir n’importe quel numéro de commande ; un numéro de commande dans un message ne prouve donc pas que la commande lui appartient. L’application doit fournir le compte connecté, et le service de remboursement doit vérifier que la commande en relève. Le modèle peut lire la demande ; il ne peut pas prouver qui est l’appelant.
Nous avons maintenant le début d’un contrat de tâche : les changements qui comptent comme un succès, les changements interdits, et les situations dans lesquelles l’assistant doit poser une question ou confier le dossier à une personne. Certaines de ces exigences ne peuvent pas être remplies par le prompt seul. Un montant maximal de remboursement doit être vérifié par le service qui émet les remboursements. Un objectif de temps de réponse demande un délai d’expiration dans le code. Reprendre un dossier demain demande un état sauvegardé.
Une fois la tâche décrite, nous pouvons décider quelle part le modèle doit contrôler.
Quelle part de la procédure connaissons-nous déjà ?
Si chaque demande suit les mêmes étapes (extraire un numéro de commande, récupérer la commande, vérifier l’éligibilité, effectuer un remboursement autorisé et expliquer le résultat), nous pouvons écrire ces étapes dans le code sous forme de pipeline fixe. Si une vérification échoue, le remboursement est omis. Le modèle gère le langage au début et à la fin. Il n’a pas besoin d’un appel supplémentaire pour décider s’il faut récupérer une commande que toute demande exige.
Un workflow explicite ajoute des branches et des états d’attente que le code contrôle. Un remboursement au-dessus d’un plafond peut attendre une approbation. Un changement d’adresse peut n’être permis qu’avant l’expédition de la commande. Nous pouvons dessiner ces étapes comme un graphe, et le code décide quelle étape vient ensuite.
Un agent loop laisse le modèle choisir chaque étape. Le modèle choisit une action, lit le résultat et choisit à nouveau, jusqu’à ce qu’il décide de répondre. C’est utile dans une conversation qui change de sujet : un client commence par une plainte sur la livraison, puis dit que ce n’est pas le bon article qui est arrivé, puis demande un échange. La prochaine recherche utile dépend de ce que l’assistant a trouvé jusque-là. Le coût est que la boucle peut emprunter davantage de chemins, et chacun doit être testé : le modèle peut faire des appels inutiles, répéter une recherche ou s’arrêter avant la fin de la tâche.
Le guide des workflows et des agents de LangGraph décrit la même séparation : les workflows suivent des chemins fixés à l’avance, et les agents choisissent leurs étapes pendant l’exécution. LangGraph, la bibliothèque de graphes sous LangChain, sait construire les deux ; un système construit comme un graphe peut donc contenir un agent.
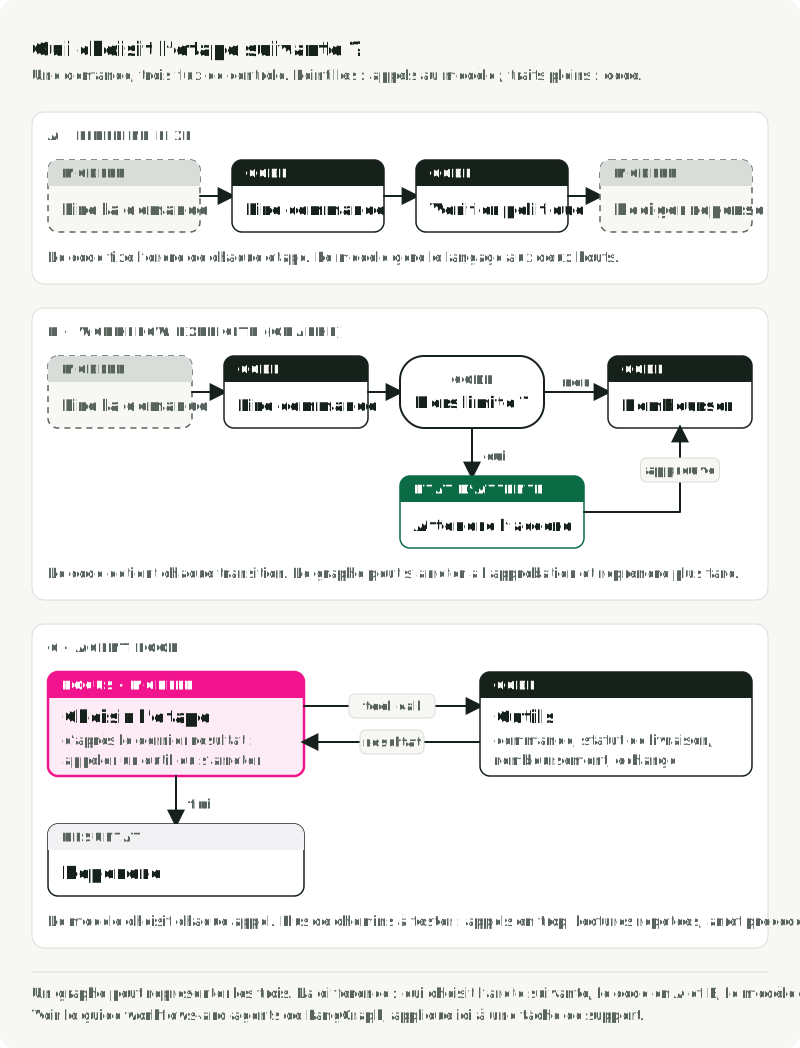
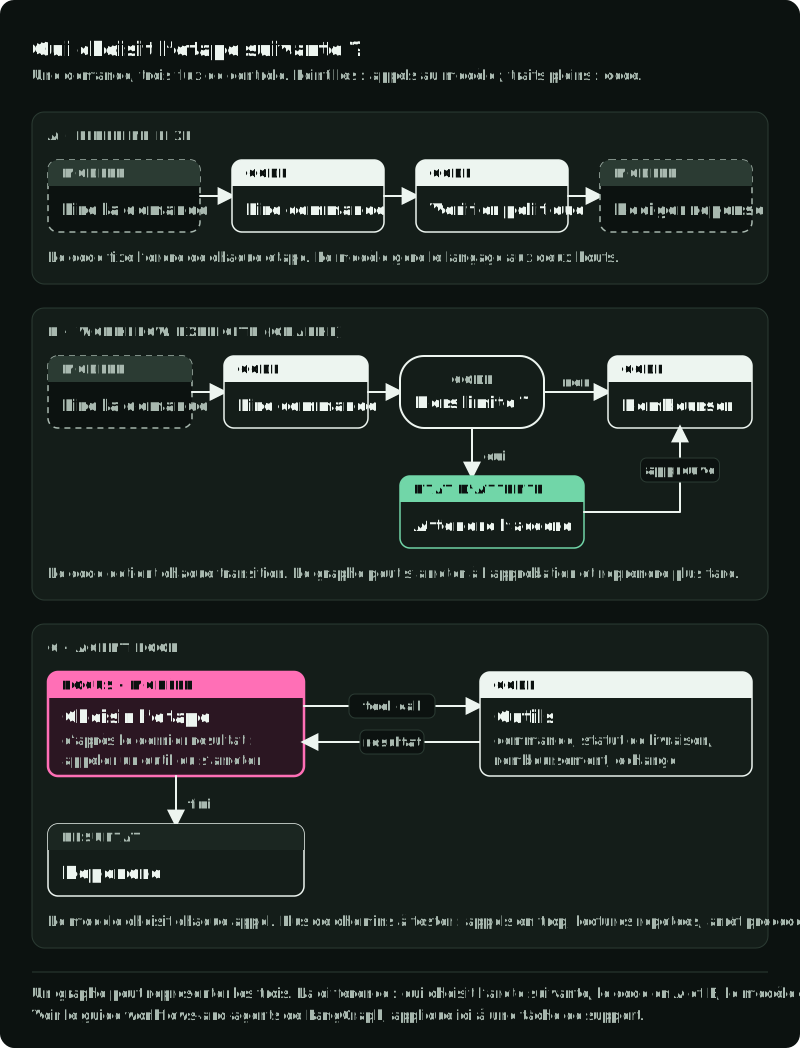
Pour notre assistant de support, une conception combine les deux. Un agent loop rassemble l’information et prépare une proposition de remboursement. Une étape de code fixe vérifie ensuite la proposition et effectue l’écriture. Le modèle peut explorer la conversation, mais seul le code décide si une écriture a lieu. Si nous savons déjà qu’il nous faut cette séparation, nous pouvons construire d’abord le workflow autour de l’agent.
L’autre option est de commencer par un seul agent loop avec une limite d’étapes, et de placer les vérifications dans les outils eux-mêmes. La première version reste ainsi petite pendant que nous apprenons quels chemins la tâche exige. Choisissez le workflow d’abord si des attentes d’approbation, des étapes fixes ou des règles de reprise sont déjà des exigences.
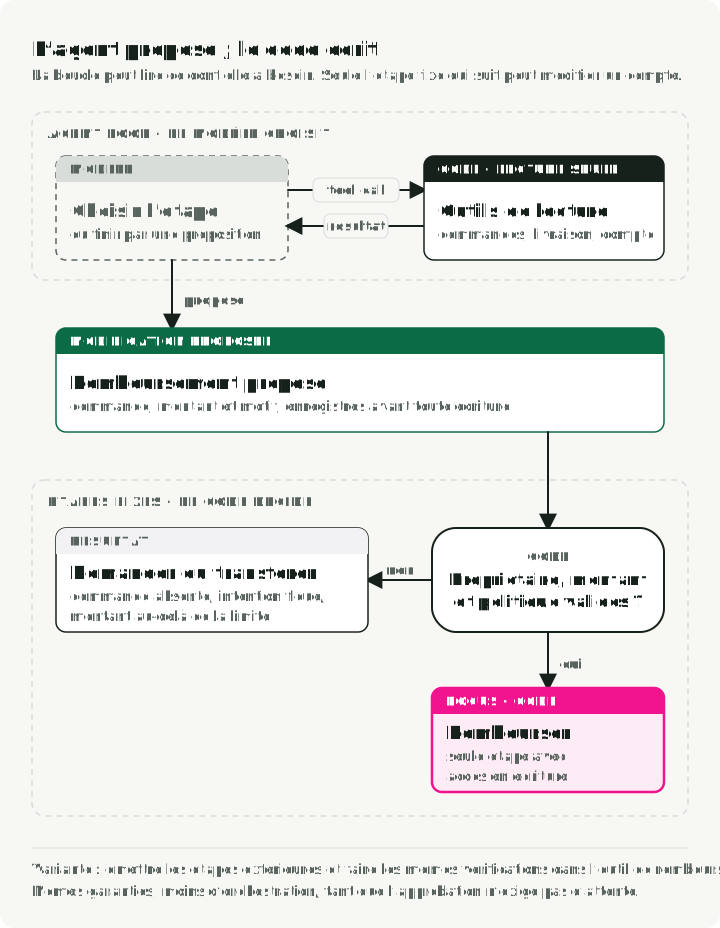
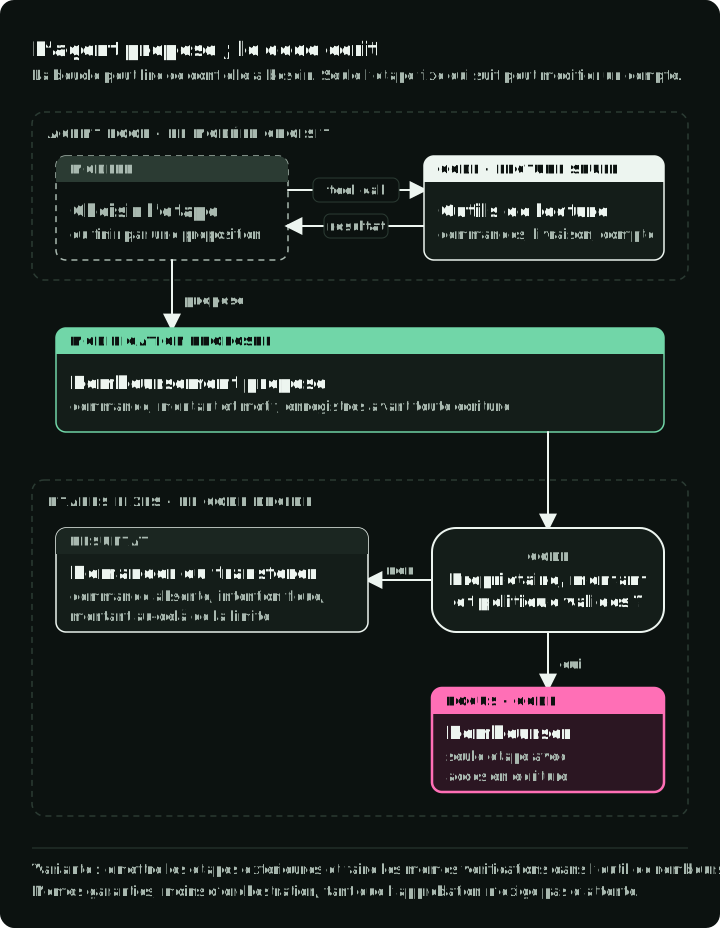
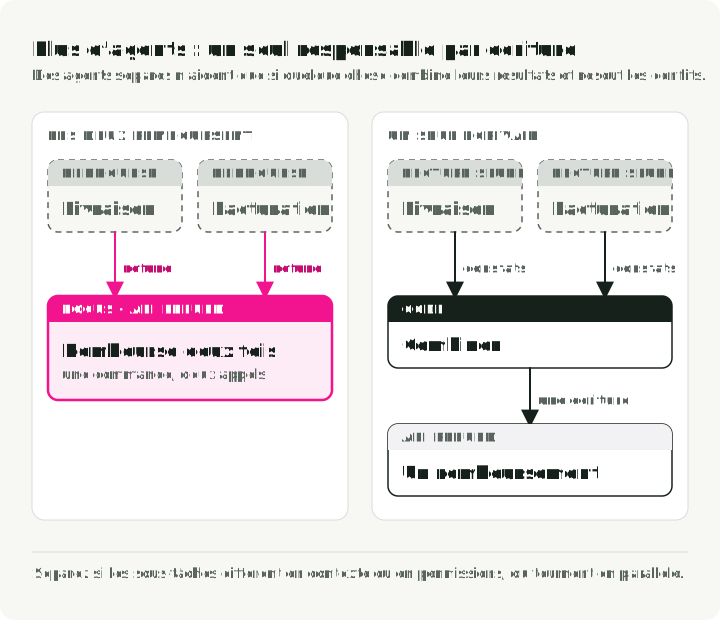
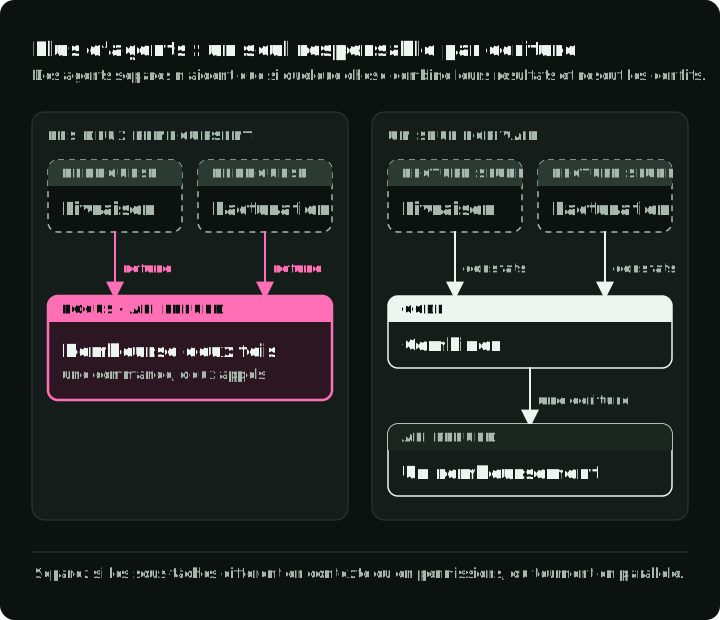
Répartir le travail entre plusieurs agents est un choix distinct, et un seul agent suffit souvent. Un deuxième agent aide quand une sous-tâche demande un autre contexte ou d’autres permissions, ou peut s’exécuter en même temps que la première. Il faut alors que quelque chose combine leurs résultats et arbitre les conflits entre leurs actions. Si un agent de livraison et un agent de facturation peuvent tous deux émettre des remboursements, une même commande peut être remboursée deux fois.
Tool calls ou code généré ?
Après avoir décidé qui choisit l’étape suivante, nous décidons comment le modèle demande une action. Il peut appeler un outil : une fonction nommée que votre code fournit et exécute pour le compte du modèle. Ou il peut écrire un court programme que votre code exécute. Qui choisit l’étape suivante et comment le modèle demande une action sont deux décisions distinctes. Un workflow fixe peut contenir une étape où le modèle écrit du code, et un agent loop ouvert peut n’utiliser que quelques outils aux fonctions limitées.
Pour l’assistant de support, un outil comme issue_refund(order_id, amount_cents) convient bien. Son schéma nomme l’action et ses arguments, donc la demande est explicite. L’outil renvoie un identifiant de remboursement en cas de succès, ou un motif structuré en cas de rejet. Nous pouvons tester cet outil seul, car le modèle n’écrit jamais la logique de remboursement.
Toutes les tâches n’ont pas besoin d’outils. Un classifieur qui reçoit toute son entrée dans le prompt peut renvoyer une étiquette validée. Ajoutez un outil de recherche quand la tâche demande des données absentes du prompt. Ajoutez un outil qui modifie des données seulement quand la tâche doit modifier quelque chose.
Le code généré convient à un autre type de travail. Supposons que l’assistant doive lire un tableau de commandes, regrouper les lignes par client et calculer plusieurs totaux. Avec des outils, chaque étape est un appel distinct, et chaque résultat intermédiaire retourne au modèle. Avec du code, le modèle écrit un seul programme Python qui garde les valeurs intermédiaires dans ses propres variables, et seuls les totaux reviennent.
La bibliothèque smolagents de Hugging Face propose les deux styles. ToolCallingAgent renvoie des tool calls structurés. CodeAgent écrit du Python qui appelle les mêmes outils, stocke des valeurs dans des variables et combine les résultats. Un agent de code utilise toujours des outils ; il les appelle depuis un programme.
Le code généré ajoute aussi du travail pour nous. Nous devons gérer les erreurs de syntaxe, limiter le temps d’exécution, gérer les dépendances et décider quels fichiers et quelles adresses réseau le code peut atteindre. Savoir si la réduction du nombre d’appels au modèle compense ce travail dépend de la tâche et du modèle. Mesurez-le sur votre tâche ; le code n’est pas meilleur par défaut.
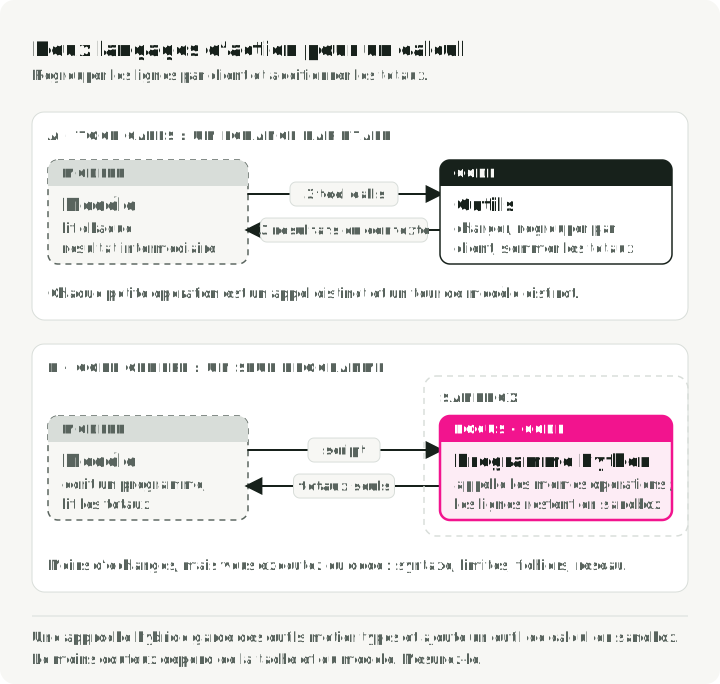
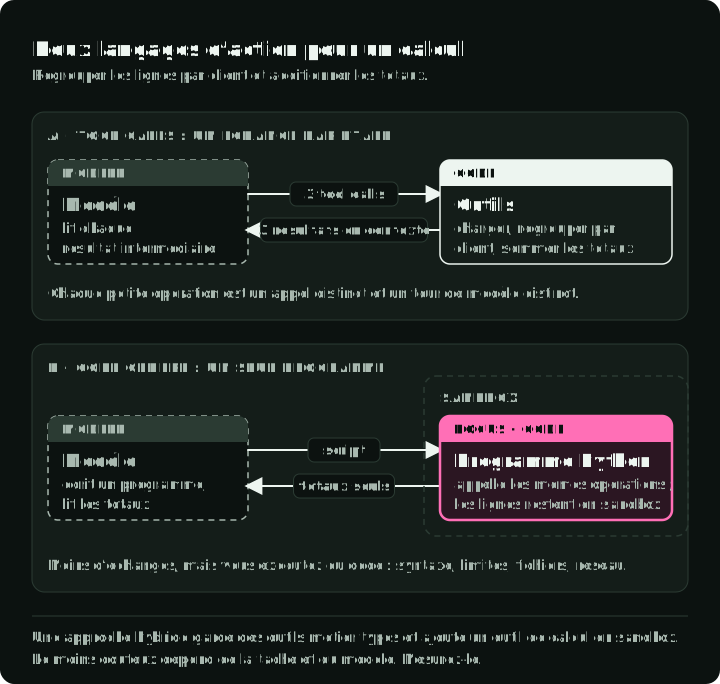
Plusieurs APIs hébergées combinent les deux styles : vos propres outils métier plus un outil intégré d’exécution de code qui s’exécute dans un sandbox, un environnement séparé à l’accès restreint. L’API Responses d’OpenAI, l’API Claude, l’API Gemini et AWS Bedrock AgentCore l’offrent toutes.
Le programmatic tool calling d’Anthropic va un cran plus loin : le code dans le sandbox peut appeler les outils que vous autorisez, et seuls les résultats que vous sélectionnez reviennent au modèle. Anthropic recommande toujours les tool calls directs par défaut, et le chemin par le code pour les gros résultats et pour les chaînes d’appels qui dépendent les uns des autres. Certaines conceptions n’utilisent que du code, comme le CodeAgent de smolagents et le Code Mode de Cloudflare.
Pour notre assistant de remboursement, je commencerais par des outils métier typés. Si une tâche ultérieure demande des calculs lourds, nous pourrons ajouter un exécuteur de code sans accès aux comptes clients.
Une troisième question est de savoir comment l’application se connecte à ses outils. Une fonction locale suffit quand une seule application possède le code. Le Model Context Protocol (MCP) est un moyen standard de servir des outils depuis un serveur séparé, pour que plusieurs applications les partagent. MCP définit comment l’application et le serveur échangent des tool calls. Il ne valide pas les arguments et ne décide pas qui peut appeler un outil : la spécification MCP des outils laisse ces vérifications à l’application et au serveur.
Placer les restrictions là où les actions ont lieu
La description d’un outil dit au modèle quand l’outil est utile. Elle ne décide pas si un appel donné peut s’exécuter. C’est au code qui effectue l’écriture d’en décider. Pour un remboursement, ce code vérifie le compte connecté, la commande, le montant, la politique de remboursement et toute approbation requise.
Certaines vérifications exigent une interprétation
Certaines vérifications ne peuvent pas s’écrire comme du code ordinaire. Supposons que le client demande : « Puis-je retourner cette commande ? » et que l’agent propose un remboursement. La commande appartient au client, le montant est valide et le délai de retour est ouvert. Toutes les vérifications du code passent, et pourtant le client demande peut-être seulement si un retour est possible, pas un remboursement immédiat. Quelqu’un doit lire le message pour en décider.
Le code ordinaire vérifie toujours la propriété, les montants et les dates. Le modèle principal peut interroger le client quand son intention est floue, ou l’application peut exiger une confirmation explicite avant un remboursement. Un modèle de décision distinct est une autre conception à évaluer : il répond à une question précise sur le sens, comme « Le client a-t-il demandé ce remboursement ? » Nous pouvons tester cette question seule, sans lancer toute la conversation. Comparez cette conception à une demande de clarification ou de confirmation avant d’ajouter un autre modèle.
Jev, un modèle de décision de TypeSafe, est une option pour ce rôle. Il prend l’état que nous fournissons et des questions typées, et renvoie des réponses structurées. Pour une question oui/non, il renvoie la probabilité que la réponse soit oui.
Je poserais deux questions séparées : le client a-t-il explicitement demandé le remboursement, et un message ultérieur a-t-il retiré cette demande ? TypeSafe recommande des questions précises dont les réponses sont combinées dans le code, et plusieurs questions peuvent partager un même appel d’API. Avec deux questions, une mauvaise réponse montre lequel des deux jugements a échoué.
Le code combine ensuite ces réponses avec les vérifications obligatoires. Si les réponses sont floues ou se contredisent, l’assistant interroge le client ou envoie le dossier à une personne. Si l’appel à Jev dépasse le délai, cette erreur a aussi besoin de son propre chemin. Un « oui » de Jev ne passe jamais outre une vérification de propriété échouée et ne remplace pas une confirmation requise. Sa probabilité est une sortie de modèle. Elle n’autorise pas le remboursement et ne prouve pas que la décision est correcte.
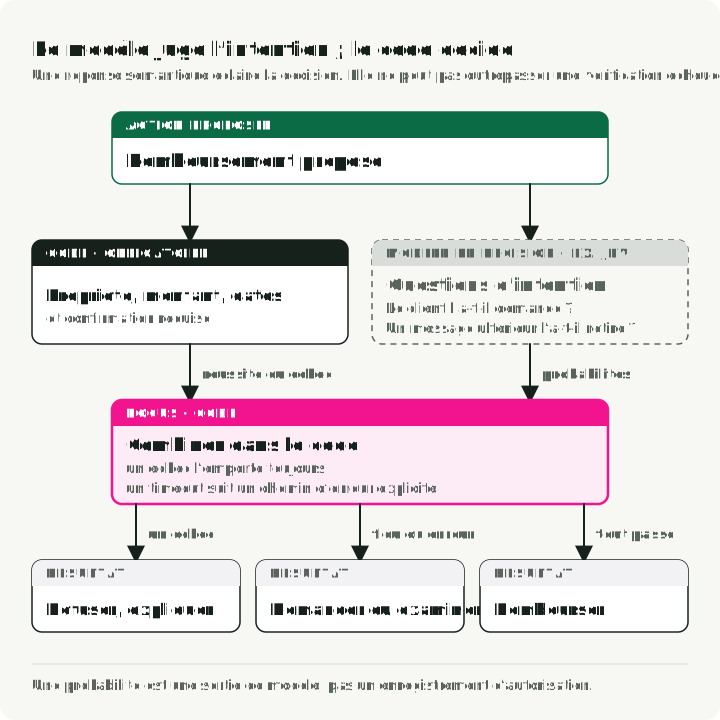
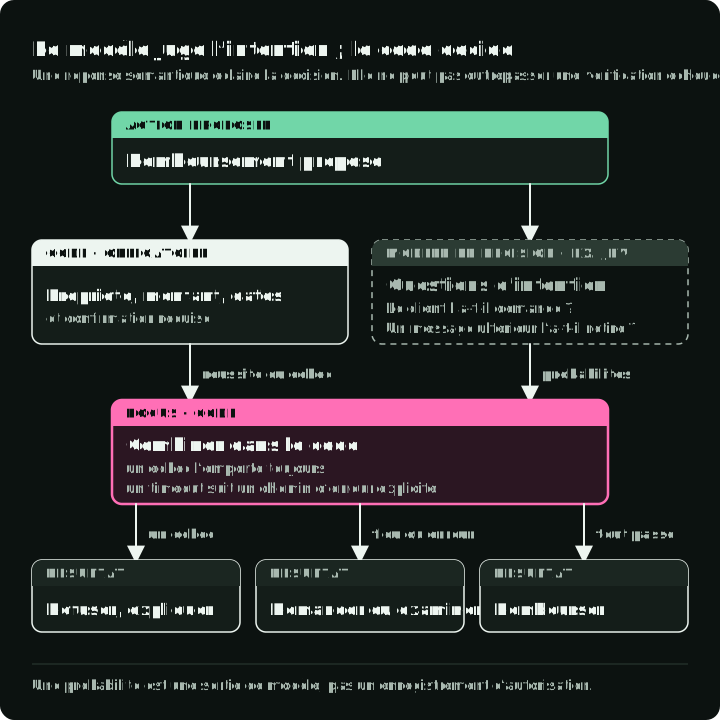
Le contexte que nous donnons à la vérification détermine ce qu’elle peut voir. Je fournirais l’action proposée, les messages du client dans l’ordre et les tool results dont la décision a besoin, chacun étiqueté avec sa source. Le dernier message seul pourrait manquer une annulation. L’historique complet du compte pourrait noyer la demande parmi des messages sans rapport. Un petit modèle généraliste avec structured output pourrait aussi répondre à ces questions. Comparez-le à Jev sur les mêmes exemples, pour la précision et le coût.
Restreindre l’accès indépendamment des jugements du modèle
Le texte d’un client ou d’un document récupéré peut contenir des instructions visant l’agent. Ce texte ne doit pas pouvoir accorder des permissions ni remplacer la politique de l’application. Si un document dit à l’agent d’exporter tous les dossiers clients, le système ne doit pas en avoir la permission, quelle que soit la force de la formulation.
Le code généré a besoin de ses propres limites d’accès. Si le modèle ne peut appeler que des fonctions relues, aux permissions étroites, un sandbox de code généraliste apporte peut-être peu. Ces fonctions ont tout de même besoin d’autorisation, de validation des entrées, de délais d’expiration et de requêtes de base de données sûres.
Avant d’autoriser du Python généré, des commandes shell ou des modifications de fichiers exécutables, nous devons décider ce que ce code peut atteindre. Dans quels répertoires peut-il écrire ? A-t-il besoin d’un accès réseau ? Quels identifiants peut-il voir ? Combien de temps CPU, de mémoire et de sortie une exécution peut-elle utiliser ? Exécuter le code dans un processus séparé ne répond pas à ces questions à lui seul.
Le guide d’exécution sécurisée de Hugging Face compare un interpréteur local restreint à des options plus isolées comme les conteneurs. Chaque option bloque des choses différentes. Un conteneur ayant un large accès aux fichiers de l’hôte et des identifiants puissants peut encore exposer les ressources que nous voulions protéger. Testez qu’une lecture interdite, une écriture interdite et une requête réseau interdite échouent, et qu’un programme normal réussit.
Nous pouvons omettre l’exécuteur de code tant que la tâche n’en a pas besoin, mais son isolation doit être prête le jour où nous l’activons. L’isolation ne peut pas non plus empêcher le mauvais usage d’une API que nous donnons volontairement au code ; le service de remboursement doit donc quand même appliquer ses propres règles.
Que reste-t-il quand une exécution s’arrête en cours de route ?
Supposons maintenant que l’assistant envoie une demande de remboursement, que le service crée le remboursement et que la réponse se perde au retour. Le modèle voit un délai dépassé. S’il rappelle, le client peut recevoir un second remboursement. S’il signale un échec, il dit au client quelque chose qui n’est plus vrai.
La solution est de rendre le remboursement idempotent : envoyer deux fois la même demande a le même effet que l’envoyer une fois. Avant d’envoyer le remboursement, l’application crée un identifiant d’opération et l’enregistre. Lors d’une nouvelle tentative, elle envoie le même identifiant, et le service renvoie le remboursement déjà effectué au lieu d’en faire un autre. Les recommandations d’AWS sur les APIs idempotentes expliquent ce schéma. Si le service ne le prend pas en charge, la reprise doit d’abord vérifier ce qui s’est passé, ou interroger une personne, avant toute seconde tentative.
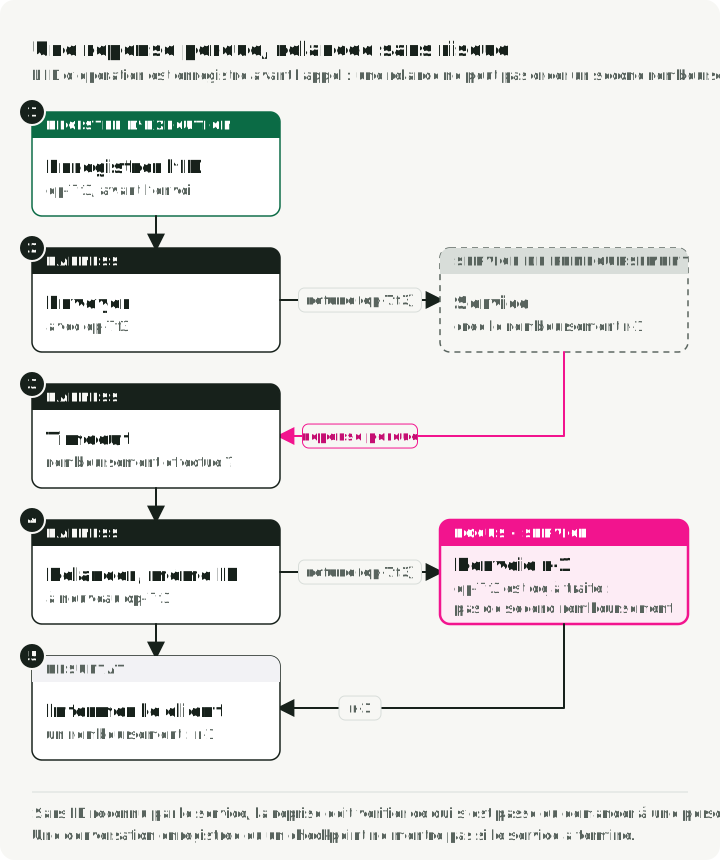
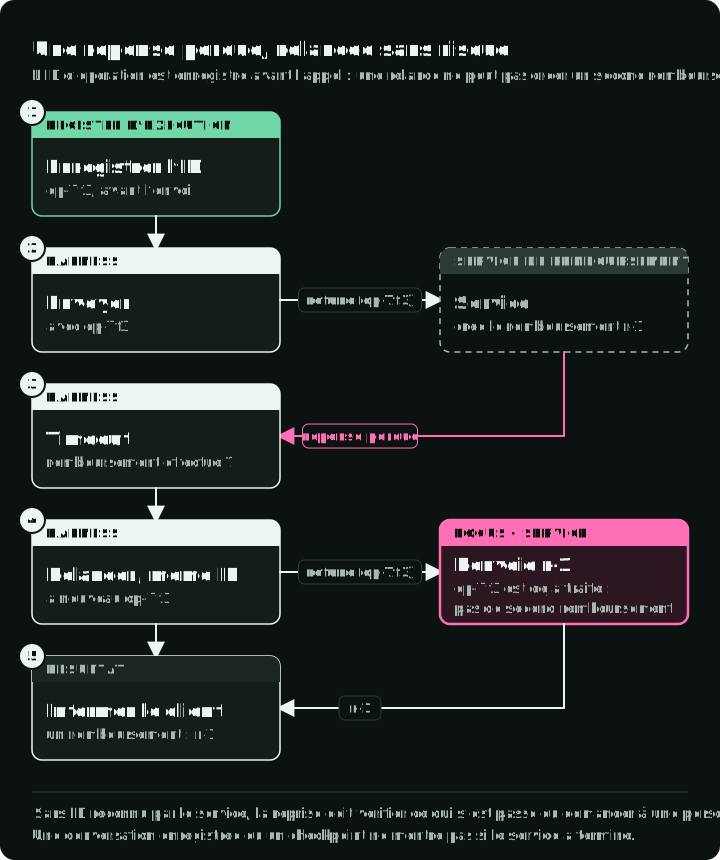
Sauvegarder la conversation ne résout pas ce problème. La conversation peut indiquer que le modèle a demandé un remboursement, mais pas si le service l’a mené à bien. Un checkpoint, une copie sauvegardée de l’état de l’agent, permet de reprendre une exécution arrêtée. Il ne peut pas annuler un remboursement que le service a déjà fait, et il ne rend pas sûre sa répétition.
Pour cet assistant, trois types d’état ont des rôles différents. La conversation contient la demande du client et les faits recueillis jusque-là. Les enregistrements de commandes et de remboursements contiennent l’état métier. Un journal d’exécution liste les opérations en attente et les approbations, afin qu’un worker redémarré puisse continuer en toute sécurité. Ils peuvent vivre dans la même base de données, mais aucun ne peut remplacer un autre.
La mémoire entre sessions est un choix distinct. Si l’assistant doit se souvenir de la préférence d’un client la semaine prochaine, il nous faut des règles sur son propriétaire, sur qui peut la modifier et sur la façon de la supprimer. Si chaque tâche est indépendante, nous n’avons peut-être pas besoin de service de mémoire du tout. Chaque morceau de texte sauvegardé est aussi une occasion de réutiliser plus tard quelque chose de périmé ou hors sujet.
Les longues conversations posent un problème voisin au sein d’une même session. Quand une conversation devient trop longue pour que le modèle l’exploite bien, nous pouvons en récupérer des parties ou remplacer les anciens tours par un résumé. Un résumé qui perd un identifiant de commande, une condition d’approbation ou une opération en attente peut casser la procédure. Gardez cet état opérationnel dans des champs explicites, et testez ce qui survit à un résumé avant de vous y fier.
Donner à la boucle un moyen de s’arrêter
Un agent loop trouve toujours autre chose à vérifier ; il lui faut donc une règle d’arrêt qui couvre le succès, l’information manquante, les limites épuisées et l’échec. Quand une exécution atteint une limite, elle doit signaler le vrai statut : le remboursement est fait, n’a jamais été tenté, ou reste incertain. « L’agent s’est arrêté » ne dit ni au client ni au worker suivant ce qui s’est passé.
Il est utile de nommer les façons dont une exécution peut se terminer avant d’écrire la boucle. Pour l’assistant de support, j’en utiliserais huit : terminée et vérifiée, refusée, information manquante demandée, transmise à une personne, bloquée par une vérification de politique, arrêtée par une limite, terminée par une erreur d’infrastructure et résultat de l’écriture inconnu.
Enregistrez ce statut séparément du respect du contrat de tâche. « Terminée et vérifiée » confirme l’écriture demandée. Un refus, une question ou un transfert peuvent être corrects si la tâche les exige. La réponse, les actions et l’état final doivent justifier ce verdict ; un arrêt seul ne suffit pas.
Une limite sur les appels au modèle ne couvre qu’une partie de l’exécution. Un outil peut se bloquer. Une nouvelle tentative peut répéter du travail. Un résumeur ou un modèle de décision comme Jev fait ses propres appels de modèle. Fixez des limites sur le temps écoulé, les tentatives, la taille de sortie et les dépenses, et comptez chaque composant qui s’exécute. Annuler une exécution doit aussi tenir compte des requêtes déjà envoyées à un service externe.
Le modèle lui-même ajoute des limites. Vérifiez qu’il produit le format d’action requis sur des tâches réalistes. Comparez la taille de contexte utilisable, la latence, le coût, et les endroits où les données de la tâche peuvent être envoyées. Un modèle que vous hébergez et une API hébergée peuvent partager une même interface mais différer par la capacité et par le traitement des données.
Choisissez un modèle et un endpoint initiaux, enregistrez leurs paramètres et gardez-les fixes pendant que vous évaluez un changement de harness. Sinon, une exécution plus rapide peut venir d’un autre fournisseur ou d’un autre modèle, et non du changement que vous vouliez tester.
Évaluer l’achèvement, y compris les cas qui ne doivent rien faire
Une fois que l’assistant peut mener une demande à terme, nous devons vérifier s’il a fait la bonne chose. Pour l’exemple du remboursement, nous pouvons observer trois choses : ce que l’assistant a dit, quelles actions il a tentées et ce qui a changé dans le service. Chacune détecte des défaillances que les autres manquent.
Une réponse peut dire « J’ai remboursé votre commande » alors que la base de données est inchangée. Un remboursement correct peut s’accompagner d’un changement d’adresse sans rapport que seul le journal des actions révèle. Et une base de données inchangée peut signifier quatre choses différentes : un refus correct, une question utile, un plantage ou un assistant qui n’a rien fait. L’état final seul ne permet pas de distinguer ces quatre cas.
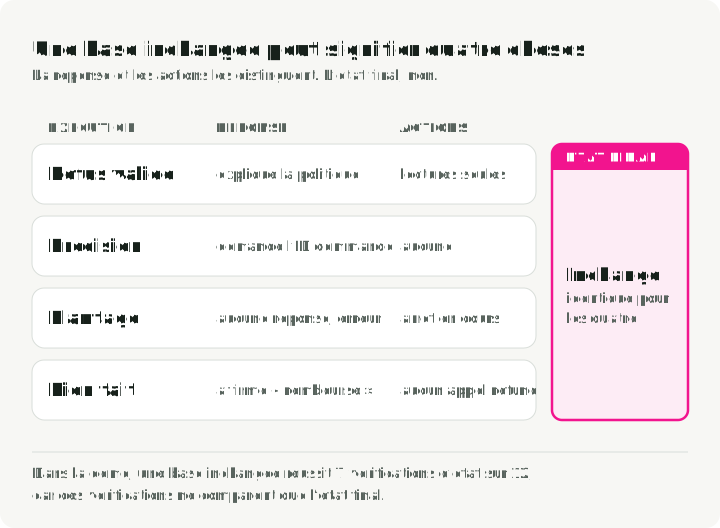
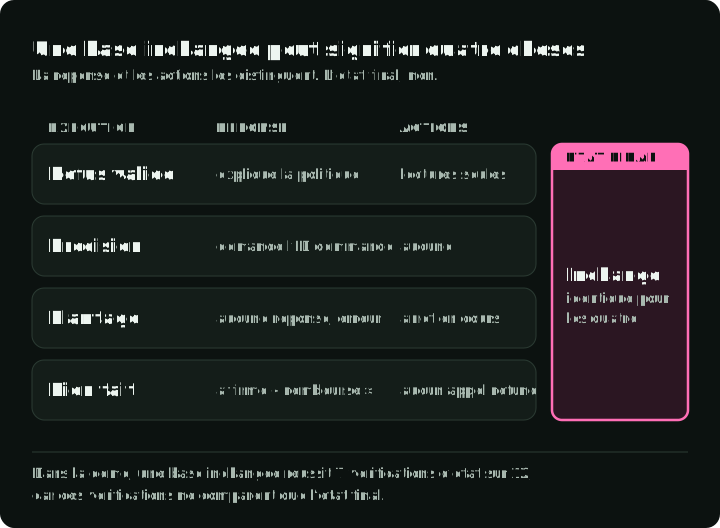
La démo associée, décrite à la fin de cet article, montre cette limite avec des chiffres réels. Elle comprend douze tâches de support, dont sept n’attendent aucun changement dans la base de données. Un agent qui ne change rien réussit donc 7 vérifications d’état sur 12. Ce nombre décrit les vérifications ; ce n’est pas un taux de réussite mesuré. Les définitions des tâches comparent uniquement la base de données finale, pas la réponse ni les actions intermédiaires. Une écriture faite puis annulée ne laisse pas non plus de trace dans cette comparaison.
Pour votre premier jeu d’évaluation, incluez une action réussie, un refus valide, une demande avec information manquante et une défaillance pendant l’exécution. Pour chaque cas, définissez la réponse attendue et les actions autorisées en plus de l’état final. Un cas de clarification doit exiger la bonne question. Un cas de refus doit exiger une explication utile. Ces cas montrent si l’agent comprend la tâche et si l’application la fait respecter.
Si nous ajoutons la vérification par Jev, elle a besoin de ses propres cas de test. Donnez-lui des actions proposées dont les décisions correctes ont été fixées à l’avance par une personne : une demande de remboursement explicite, une question sur l’éligibilité, une demande retirée et une instruction cachée dans un tool result. Le dernier cas teste aussi si le contexte que nous assemblons garde les messages du client séparés de la sortie des outils.
Comptez les mauvaises actions que Jev laisse passer et les actions valides qu’il bloque. Après chaque blocage, suivez la suite de la conversation. Bloquer une écriture n’aide que si l’assistant pose ensuite une question au client au lieu de boucler ou de s’arrêter. Jev renvoie une probabilité ; l’application a donc besoin d’un seuil qui la transforme en autorisation ou en blocage. Choisissez le seuil sur des exemples de développement, et fixez-le avant la comparaison finale sur des exemples que vous n’avez pas utilisés pour le régler. Enregistrez la version de la question, le contexte fourni, les probabilités renvoyées, la règle appliquée, les erreurs éventuelles et le coût. La démo enregistrée n’a jamais vu Jev rejeter une écriture ; elle ne montre donc pas que Jev aide.
Enregistrez de quoi diagnostiquer une défaillance : la tâche, les versions du modèle et du harness, les actions proposées, les résultats d’exécution, l’état final, les erreurs, la latence et le coût. Gardez les secrets et les données personnelles inutiles hors de cet enregistrement.
L’agent testé ne doit pas pouvoir modifier la façon dont il est noté. Donnez-lui l’entrée de la tâche et les règles dont il a besoin, mais pas les réponses de référence ni les cas de test réservés. Gardez l’évaluateur (le code qui note les exécutions) et ses enregistrements hors du contrôle de l’agent. Cela devient plus strict si un programme modifie plus tard le harness automatiquement pour augmenter son score : ce programme ne doit pas pouvoir modifier les vérifications qui le notent.
Ces enregistrements nous disent aussi quand ajouter un composant optionnel. Ajoutez un routeur, une première étape qui envoie chaque demande vers le bon gestionnaire, quand les exécutions enregistrées montrent que le choix du type de demande exige sa propre étape. Ajoutez des résumés quand de longs historiques causent une défaillance précise. Testez une garde contre les actions interdites, y compris sur les actions qu’elle doit laisser passer. Les contrôles d’accès requis découlent des règles de la tâche ; les composants optionnels demandent des preuves qu’ils valent leur coût.
Transformer la conception en première implémentation
Pour l’assistant de support, nous avons maintenant une conception de départ : un agent loop avec des limites pour interpréter des demandes variées, des outils aux fonctions limitées pour les opérations sur les comptes, des vérifications dans les services qui écrivent des données, et des enregistrements sauvegardés des actions en attente. Rien jusqu’ici n’exige de code généré ni de mémoire entre sessions.
Je construirais d’abord un chemin complet. Créez un petit compte de test et un résultat de remboursement attendu. Implémentez les outils de recherche et de remboursement, y compris leurs chemins de rejet. Connectez le modèle à ces outils. Lancez ensuite les cas de refus, d’information manquante et d’écriture interrompue. Les lacunes des exigences sont plus faciles à trouver maintenant, avec quelques tâches, que plus tard avec beaucoup.
Une boucle sans framework peut suffire à ce stade. Elle assemble le contexte, demande au modèle l’action suivante, valide et exécute cette action, puis renvoie le résultat au modèle. Écrire cette boucle vous-même, c’est aussi écrire la conversion des messages, l’annulation, la gestion de l’état et le traçage. Un framework vaut la peine quand il fait ce travail tout en vous laissant contrôler les décisions de cet article.
Cette série utilise create_agent de LangChain comme point de départ, car il fournit la boucle modèle-outils ainsi que des hooks pour modifier son comportement. Il s’exécute déjà sur LangGraph. Passer plus tard à un workflow LangGraph explicite revient à écrire nous-mêmes davantage d’étapes autour de l’agent, et non à ajouter un graphe à partir de rien.
Avant d’écrire l’implémentation, je mettrais les décisions sur une page. La première version n’a pas besoin de toutes les capacités évoquées plus haut. Elle n’a besoin que des parties qui accomplissent la tâche, plus des enregistrements qui montrent où une exécution échoue.
| Question | Décision à noter |
|---|---|
| Quelle tâche accomplissons-nous ? | L’appelant, le résultat attendu, le refus ou le transfert valides, et les effets interdits |
| Qui choisit l’étape suivante ? | Étapes connues dans le code ; décisions déléguées au modèle ; raison de chacune |
| Quelles vérifications exigent une interprétation ? | La question sur le sens, le contexte qu’elle voit, le modèle qui répond, que faire en cas de doute |
| Que peut demander le modèle ? | Pas d’outils, opérations typées, code généré ou une combinaison |
| Qui autorise et exécute ? | Données et actions permises, service qui les vérifie, approbations, limites du sandbox |
| Qu’est-ce qui doit survivre à une interruption ? | État de la conversation, enregistrements métier, opérations en attente et comportement de reprise |
| Quelles actions peut-on rejouer sans risque ? | Lectures ; écritures avec un ID d’opération que le service déduplique ; écritures à vérifier d’abord |
| Quelles limites s’appliquent ? | Contraintes de modèle et de fournisseur, traitement des données, appels, temps, dépenses et annulation |
| Qu’est-ce qui prouve l’achèvement ? | Vérifications de la réponse, des actions et de l’état ; qui possède leurs preuves |
| Qu’avons-nous laissé de côté ? | Composants optionnels et défaillance ou nouvelle exigence qui justifierait chacun |
Une bonne réponse est assez précise pour changer l’implémentation. « Besoin de mémoire » est vague. « Doit reprendre un remboursement approuvé après le redémarrage d’un worker sans créer de second remboursement » nous dit quoi persister et quelle défaillance tester.
La partie 2 demande quand un workflow explicite traite assez bien la tâche pour justifier ses étapes supplémentaires. Elle construit le plus petit workflow dont les tâches ont besoin autour de l’agent et le compare à la boucle. Les parties suivantes gardent l’évaluateur hors du contrôle de l’agent et mesurent comment les résultats varient quand on répète les exécutions.
Optionnel : examiner l’implémentation et ses limites
La démo associée est une version petite et exécutable de l’assistant de support. Elle s’exécute dans deux environnements :
- Tâches de support personnalisées : douze tâches, chacune sur une base SQLite neuve de clients et de commandes.
- τ³-bench retail : huit tâches de τ³-bench, un benchmark public où un modèle joue le client, parle à l’agent, et où des vérifications de base de données notent le résultat.
Cette section décrit ce que contient la démo, ce qu’elle omet volontairement, ce que montrent les résultats et comment l’exécuter. Vous pouvez la sauter et utiliser quand même le processus de conception ci-dessus.
Ce que contient la démo
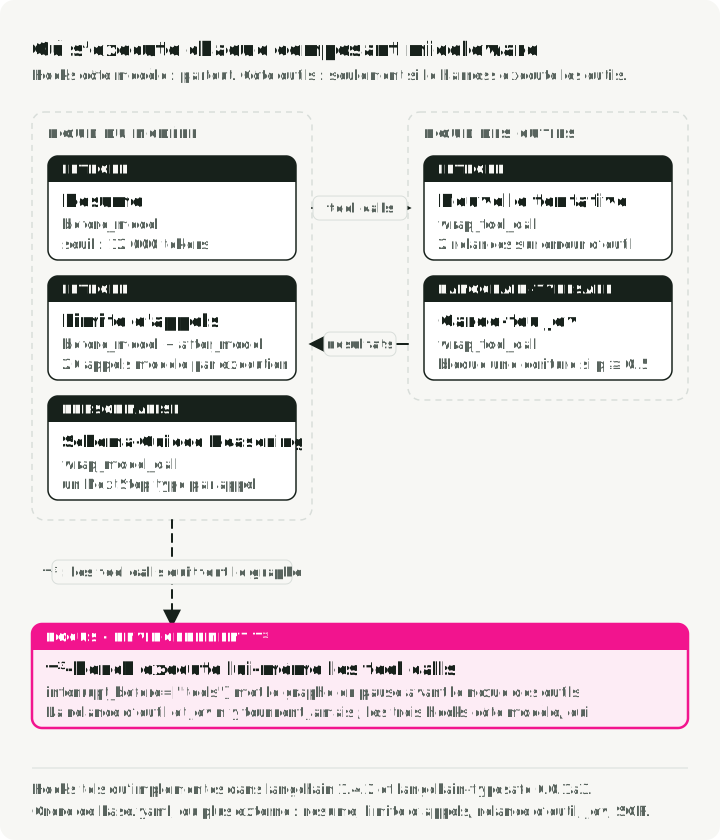
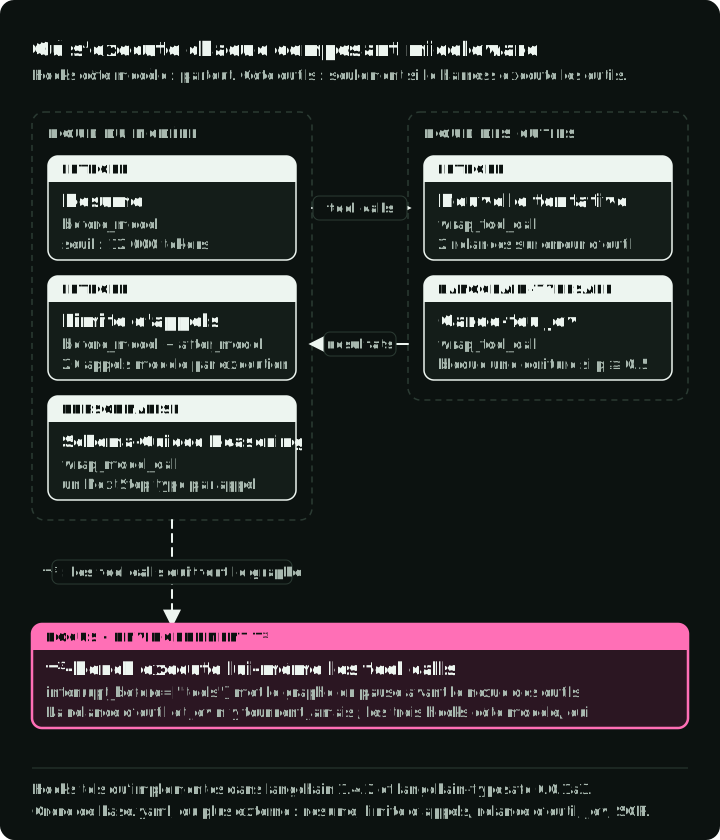
Un agent LangChain choisit les appels. Il dispose de cinq outils de compte (look_up_account, list_orders, issue_refund, update_address et set_preference) et d’un serveur MCP pour les recherches dans la politique et la FAQ. Un checkpointer en mémoire sauvegarde l’état de l’exécution entre les étapes. Il n’y a ni exécuteur de code ni mémoire entre sessions.
Chaque exécution lit une spec, un fichier YAML qui nomme le modèle et les composants à utiliser. La démo enregistre deux specs. Dans base, le Schema-Guided Reasoning (SGR) fait renvoyer au modèle un objet structuré de l’étape suivante au lieu d’un tool call natif. La garde d’écriture Jev, la vérification par modèle de décision décrite plus haut, s’exécute avant chaque écriture et pose une question composée : cet appel enfreindrait-il la politique ou irait-il au-delà de ce que le client a demandé ?
| Spec | Composants |
|---|---|
plain | Résumé, limite de 20 appels au modèle par exécution et 2 nouvelles tentatives sur erreur d’outil |
base | Tout plain, plus le Schema-Guided Reasoning et une garde d’écriture Jev |
Les deux questions séparées plus haut dans cet article, sur la demande et son retrait, sont une refonte proposée ; les exécutions enregistrées ne les ont pas utilisées. base ajoute SGR et Jev en une seule étape, donc les résultats personnalisés ne peuvent pas montrer si SGR ou Jev a causé une différence.
Ce que la démo laisse de côté volontairement
- Les outils vérifient l’intégrité des données mais laissent la politique métier à l’agent ; une expérience peut donc révéler une écriture que la politique interdit. Un vrai service appliquerait la politique au moment de l’écriture.
- Il n’y a pas de limite de temps ou de dépenses pour l’ensemble de la tâche.
- La nouvelle tentative d’outil s’applique à tous les outils, y compris les trois d’écriture, et les écritures rejouées n’ont pas de clé d’idempotence. La nouvelle tentative enveloppe la garde Jev, donc chaque écriture rejouée est aussi revérifiée.
ToolRetryMiddlewarede LangChain accepte une liste de noms d’outils ; un vrai service limiterait les nouvelles tentatives aux lectures. - L’évaluateur s’exécute dans le même processus que l’agent.
Ces résultats ne testent donc ni l’application des règles en production, ni la sûreté des nouvelles tentatives, ni la protection des preuves contre la falsification.
Résultats sur les tâches personnalisées
Chaque ligne correspond à une exécution de chaque tâche. Les prix sont ceux des endpoints enregistrés avec les résultats. Pour réussir, il faut la base de données finale attendue et aucune erreur d’exécution. Ces vérifications ne contrôlent ni la réponse ni toutes les actions intermédiaires. Le coût et la latence sont des moyennes par tâche ; le coût inclut Jev là où il s’exécute.
| Spec | Modèle | Réussies | Coût | Latence |
|---|---|---|---|---|
base | openai/gpt-6-luna | 12/12 | $0.00073 | 11.9 s |
plain | openai/gpt-6-luna | 12/12 | $0.00033 | 5.8 s |
base | z-ai/glm-5.3-flash | 12/12 | $0.00101 | 9.7 s |
base | xiaomi/mimo-v2.6-flash | 7/12 | $0.00087 | 18.6 s |
- Avec
gpt-6-luna, les deux specs ont réussi les douze tâches.basea coûté environ 2,2 fois plus et pris environ deux fois plus de temps. - Jev a autorisé toutes les écritures qu’il a vérifiées : six dans chacune des exécutions
gpt-6-lunaet GLM, et quatre dans l’exécution MiMo. Il n’a jamais bloqué une écriture ; ces exécutions ne testent donc pas s’il en arrête une mauvaise. - Les cinq échecs de MiMo étaient des erreurs de format de sortie SGR. Trois ont laissé la base de données inchangée, comme demandé, mais les erreurs d’exécution en ont tout de même fait des échecs. Il n’y a pas d’exécution MiMo
plain, donc nous ne pouvons pas dire si les tool calls natifs feraient mieux. - Le résumé ne s’est jamais exécuté. La plus grande requête des six exécutions enregistrées (ces quatre et les deux exécutions τ³-bench ci-dessous) avait 8 351 tokens d’entrée, sous le seuil de déclenchement de 12 000 tokens. Ces résultats ne peuvent pas montrer si le résumé aide. Quand il s’exécute, le middleware de résumé de LangChain remplace les messages plus anciens de l’état de l’agent par un seul message de résumé ; la transcription complète doit donc venir de la trace.
Résultats sur τ³-bench
τ³-bench note une exécution en rejouant les tool calls de l’agent dans un environnement neuf ; le benchmark doit donc exécuter lui-même les outils. L’adaptateur de la démo, le code qui connecte l’agent à τ³-bench, met le graphe en pause avant son nœud des outils, renvoie les tool calls et réécrit les résultats du benchmark avant de reprendre.
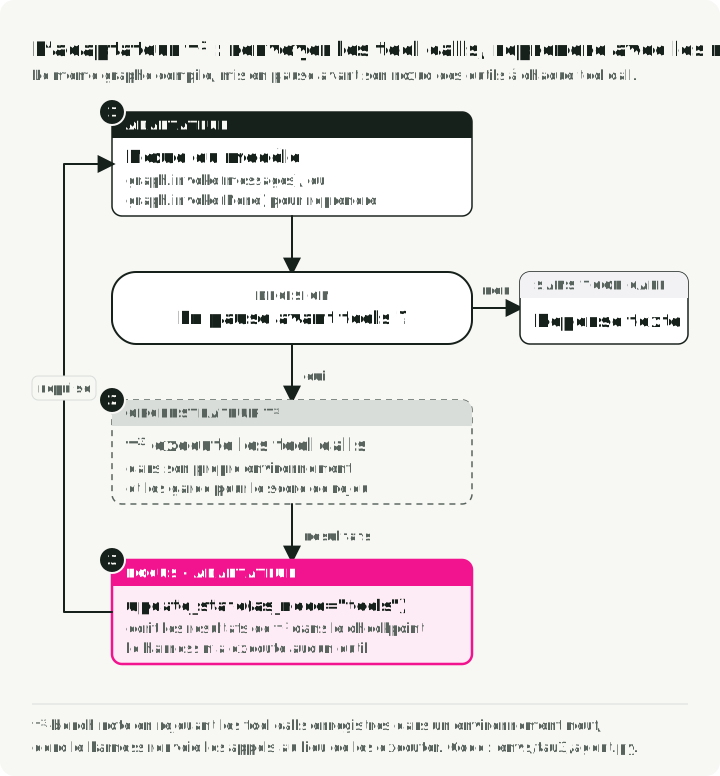
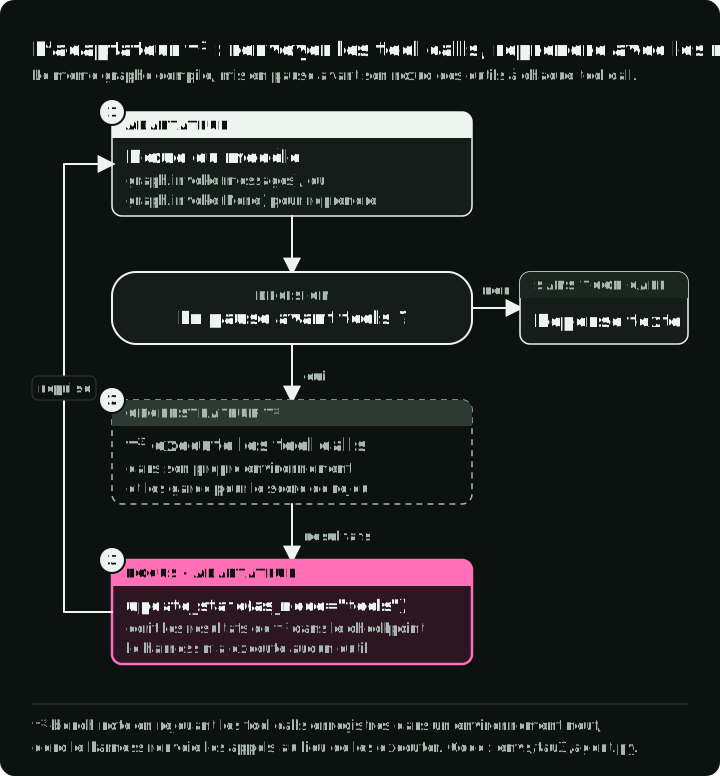
Cela a deux conséquences. D’abord, le prompt, les outils et la politique viennent de τ³-bench ; ces résultats ne sont donc pas comparables à ceux des tâches personnalisées, même avec le même fichier de spec. Ensuite, la nouvelle tentative d’outil et Jev ne s’exécutent jamais ici : la seule différence entre base et plain est SGR.
Les deux exécutions utilisent openai/gpt-6-luna pour l’agent et pour le client simulé. La latence de simulation inclut le travail du simulateur. Le coût de l’agent et la latence de simulation sont des moyennes par tâche ; le coût du simulateur est le total des huit tâches.
| Spec | Réussies | Coût de l’agent | Latence de simulation | Coût du simulateur, total |
|---|---|---|---|---|
base | 6/8 | $0.00238 | 59.0 s | $0.00453 |
plain | 7/8 | $0.00136 | 38.9 s | $0.00471 |
- Les huit tâches viennent du split de test retail et n’ont pas d’assertions en langage naturel ; seules les vérifications de base de données décident donc de la récompense.
- Les deux specs ont terminé les huit tâches sans erreur d’adaptateur. Chaque échec était une écriture manquante.
basea échoué aux tâches 9 et 26.plaina confié la tâche 27 à un humain au lieu de terminer l’échange. - Une exécution
baserépétée, non comptée dans les six, a aussi réussi 6/8 mais échoué aux tâches 9 et 17. Les tâches en échec changent d’une exécution à l’autre ; une différence d’une tâche n’est donc pas une raison de préférerplain. Ces exécutions ne mesurent pas cette variation.
Vérifier les chiffres enregistrés
Les rapports et traces sauvegardés conservent les résultats par tâche, les nombres de tokens, les configurations, les versions des paquets et les prix enregistrés. Pour les 393 appels de chat de l’agent dans les six exécutions enregistrées, le coût calculé à partir des tokens correspondait au montant facturé dans chaque réponse. Cette vérification exclut les appels à Jev et au client simulé. Les prix sont historiques, pas un devis pour votre exécution.
L’exécuter vous-même
Installez uv et utilisez la version taguée ci-dessous. Les tests s’exécutent hors ligne une fois les dépendances installées. Les deux exécutions d’environnement font des appels de modèle payants via OpenRouter et demandent une clé d’API.
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout v0.1.2-a1
cp .env.example .env # set OPENROUTER_API_KEY
make test
make a1-custom SPEC=harness/spec/plain.yaml
make a1-tau3 SPEC=harness/spec/plain.yaml
Chaque exécution remplace les résultats sous reports/article-a1/. Utilisez git diff pour les comparer à la référence validée. Le Makefile installe à partir du uv.lock figé.
Pour essayer un autre modèle ou un autre ensemble d’outils, copiez une spec sous harness/spec/, modifiez ces champs et passez son chemin via SPEC. Les paramètres du fournisseur et des composants personnalisés acceptent des clés libres ; la validation ne peut donc pas attraper toutes les fautes de frappe imbriquées.