Desenhar um agent harness: da tarefa à arquitetura

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Um agent harness é o código à volta de um modelo de linguagem que lhe permite concluir uma tarefa. Dá ao modelo instruções e dados, executa as ações que o modelo pede, acompanha o progresso e decide quando a tarefa está terminada. Este artigo é para engenheiros que estão a adicionar um agente à sua própria aplicação. Mostra como desenhar esse código a partir da tarefa: que passos o modelo escolhe, que passos o seu código fixa de antemão e que regras o seu código impõe, diga o modelo o que disser.
Tome estas decisões antes de escolher um framework de agentes, porque as respostas mudam de tarefa para tarefa. Um assistente de suporte altera contas de clientes, por isso precisa de verificações de permissões e de uma forma segura de repetir um pagamento. Um coding agent edita ficheiros e executa testes, por isso precisa de um local onde o seu código possa correr sem prejudicar mais nada. Um classificador de documentos só devolve uma etiqueta, pelo que pode não precisar de ferramentas. Se os três partirem do mesmo loop, do mesmo armazenamento de memória e do mesmo conjunto de ferramentas, ninguém pergunta o que cada tarefa exige.
Vamos seguir estas decisões num só exemplo, um assistente de suporte ao cliente que emite reembolsos, desde a descrição da tarefa até uma primeira implementação. O artigo continua Harness Engineering para AI Agents, que descreve as responsabilidades de um harness. Aqui escolhemos essas responsabilidades para um projeto.
Porque é que o modelo precisa de um harness
No nosso assistente de suporte, o modelo pode propor um reembolso, mas não o consegue concluir sozinho. O código tem de encontrar a conta do cliente, carregar a encomenda, verificar que o reembolso é permitido, chamar o serviço de pagamentos e registar o resultado. Se o serviço de pagamentos exceder o tempo limite, o código também tem de decidir se uma segunda tentativa é segura. Estas tarefas mantêm-se mesmo quando o modelo é muito bom a escolher o passo seguinte.
Parte deste código pode já existir na sua aplicação. A LangChain, o framework de agentes que esta série usa mais adiante, define um harness em sentido lato: todo o código, configuração e lógica de execução à volta do modelo. O início de sessão, o acesso à base de dados, uma fila de tarefas e um passo de aprovação cabem todos nessa definição. Desenhar um harness inclui decidir como o agente os usa. Não é preciso reconstruí-los dentro de um framework de agentes.
Um harness pode ser pequeno ou grande. O mais pequeno faz uma chamada ao modelo, valida o resultado e devolve-o. Um maior deixa o modelo ler ficheiros, executar programas e rever o seu trabalho ao longo de muitos turnos. Ambos têm de responder a duas perguntas: que partes da tarefa trata o modelo e como verificamos que foram bem feitas?
Descrever o resultado antes do agente
“Tratar pedidos de reembolso” ainda não diz o que o assistente tem de fazer. Imagine que um cliente pede o reembolso de uma encomenda entregue. A execução tem êxito se reembolsar a encomenda e o valor corretos, explicar o resultado ao cliente e não alterar mais nada na conta. Se o pedido violar a política de reembolsos, uma recusa clara é o resultado correto. Se o assistente não conseguir saber a que encomenda o cliente se refere, deve perguntar.
Um reembolso, uma recusa e uma pergunta são três resultados corretos diferentes. Se contarmos como êxito toda a conversa que termina sem erro, não os conseguimos distinguir entre si, nem distingui-los de uma resposta errada que terminou com boas maneiras.
Um reembolso correto também depende de quem pede. Um cliente pode escrever qualquer número de encomenda, por isso um número de encomenda numa mensagem não prova que a encomenda é dele. A aplicação tem de fornecer a conta autenticada, e o serviço de reembolsos tem de verificar que a encomenda lhe pertence. O modelo consegue ler o pedido; não consegue provar quem está a chamar.
Temos assim o início de um contrato da tarefa: as alterações que contam como êxito, as alterações proibidas e as situações em que o assistente tem de fazer uma pergunta ou passar o caso a uma pessoa. Alguns destes requisitos não se cumprem só com o prompt. O valor máximo de um reembolso tem de ser verificado pelo serviço que emite reembolsos. Um objetivo de tempo de resposta exige um tempo limite no código. Retomar um caso amanhã exige estado guardado.
Com a tarefa descrita, podemos decidir quanto dela o modelo deve controlar.
Quanto do procedimento já conhecemos?
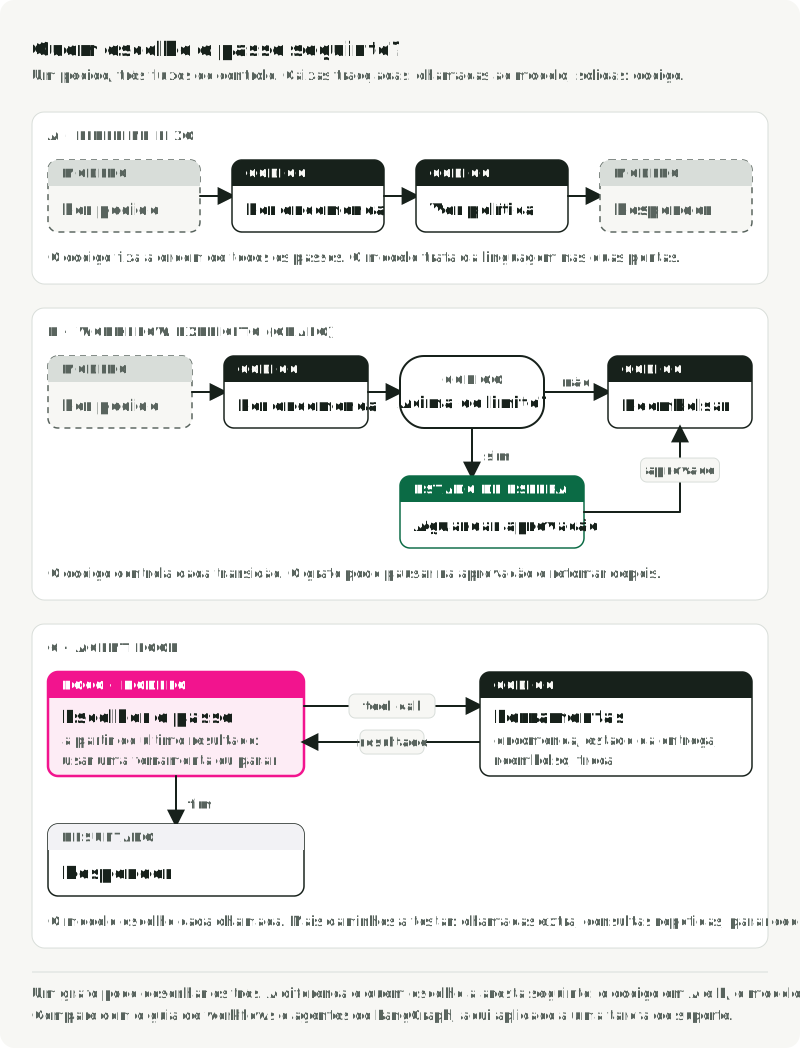
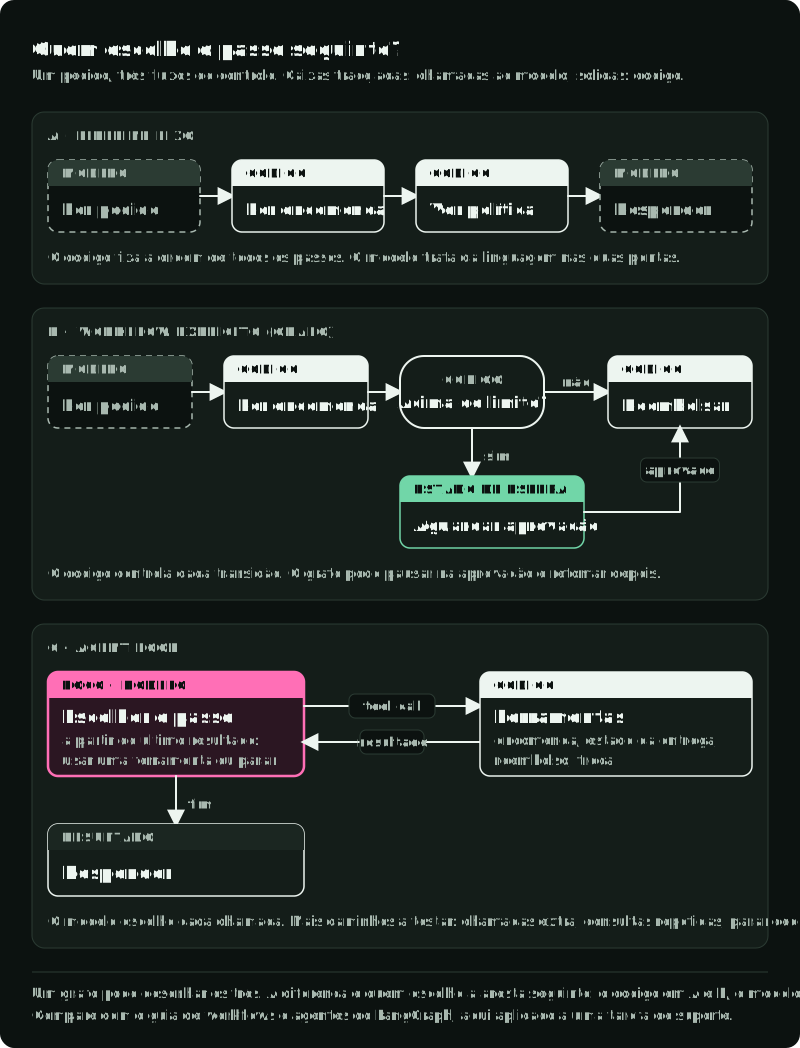
Se todos os pedidos seguirem os mesmos passos (extrair um número de encomenda, obter a encomenda, verificar a elegibilidade, emitir um reembolso permitido e explicar o resultado), podemos escrever esses passos no código como um pipeline fixo. Se uma verificação falhar, o reembolso é omitido. O modelo trata da linguagem no início e no fim. Não precisa de uma chamada extra ao modelo para decidir se deve obter uma encomenda de que todos os pedidos precisam.
Um fluxo de trabalho explícito acrescenta ramos e estados de espera controlados pelo código. Um reembolso acima de um limite pode esperar por aprovação. Uma alteração de morada pode ser permitida só antes de a encomenda ser enviada. Podemos desenhar estas fases como um grafo de passos, e é o código que decide qual é o passo seguinte.
Um agent loop deixa o modelo escolher cada passo. O modelo escolhe uma ação, lê o resultado e escolhe de novo, até decidir responder. Isto ajuda numa conversa mista: um cliente começa com uma queixa sobre a entrega, depois diz que chegou o artigo errado e por fim pede uma troca. A consulta útil seguinte depende do que o assistente já encontrou. O custo é que o loop pode seguir mais caminhos, e cada um precisa de ser testado: o modelo pode fazer chamadas desnecessárias, repetir uma consulta ou parar antes de a tarefa estar concluída.
O guia de fluxos de trabalho e agentes do LangGraph descreve a mesma divisão: os fluxos de trabalho seguem caminhos definidos de antemão, e os agentes escolhem os seus passos enquanto correm. O LangGraph, a biblioteca de grafos que está por baixo da LangChain, consegue construir ambos, pelo que um sistema construído como grafo pode continuar a conter um agente.
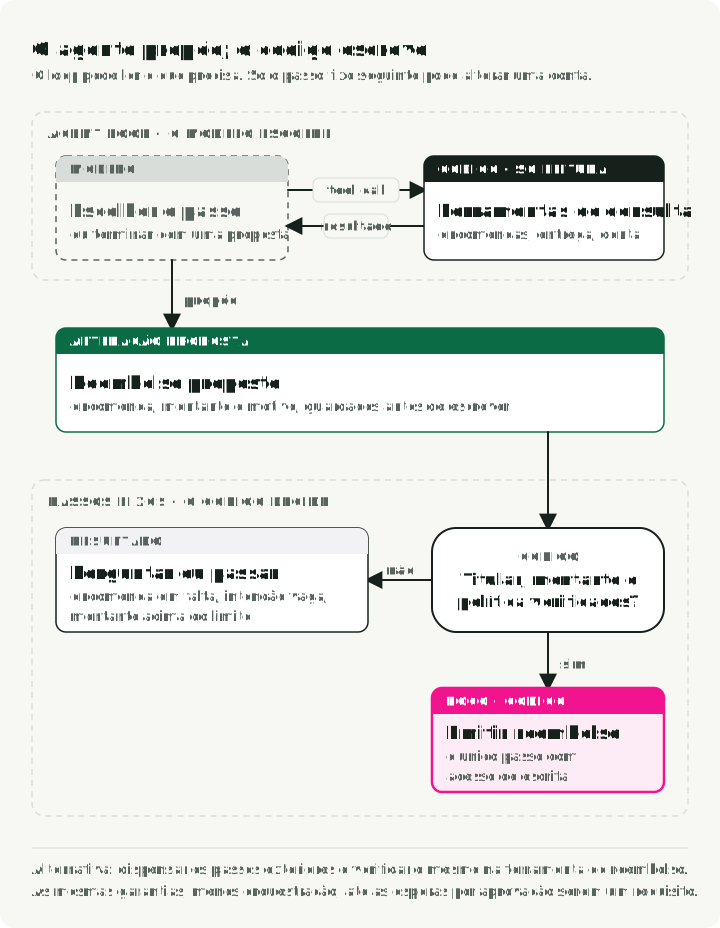
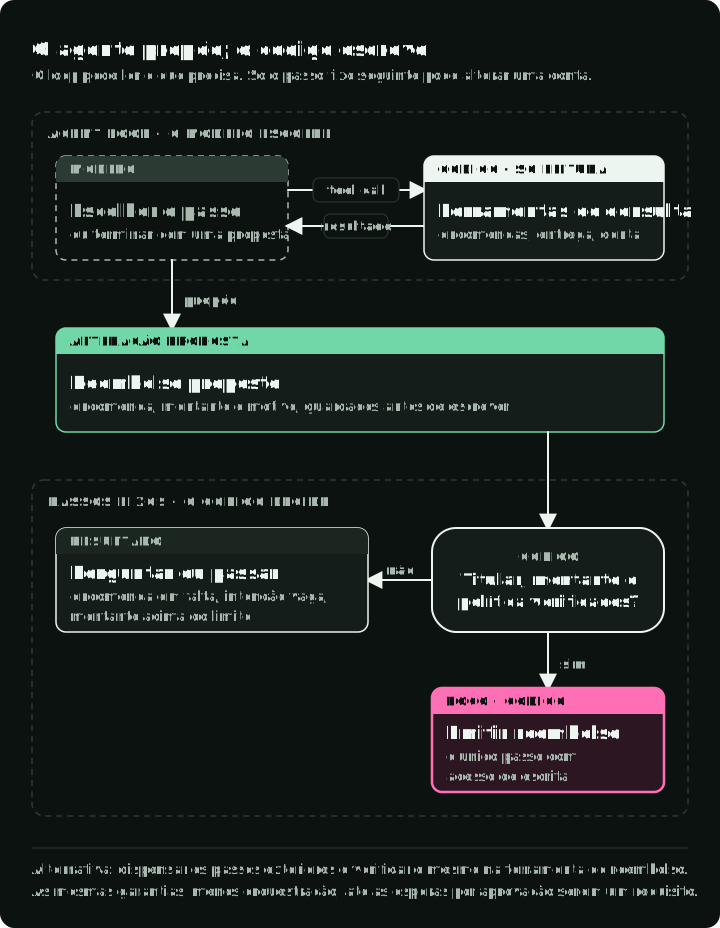
Para o nosso assistente de suporte, um desenho combina os dois. Um agent loop recolhe informação e prepara uma proposta de reembolso. Um passo fixo de código verifica então a proposta e faz a escrita. O modelo pode explorar a conversa, mas só o código decide se há uma escrita. Se já sabemos que precisamos desta divisão, podemos construir primeiro o fluxo de trabalho à volta do agente.
A outra opção é começar com um único agent loop com um limite de passos e pôr as verificações dentro das próprias ferramentas. Isso mantém a primeira versão pequena enquanto aprendemos que caminhos a tarefa exige. Escolha primeiro o fluxo de trabalho se as esperas por aprovação, as fases fixas ou as regras de recuperação já forem requisitos.
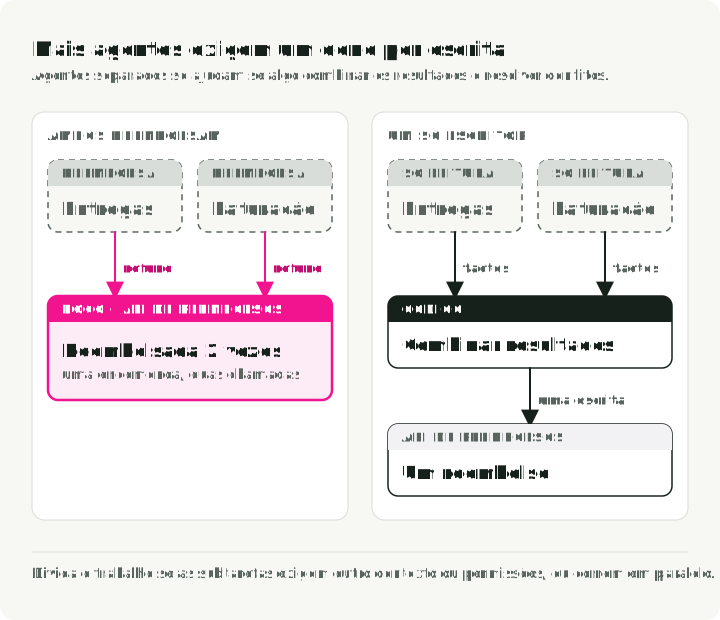
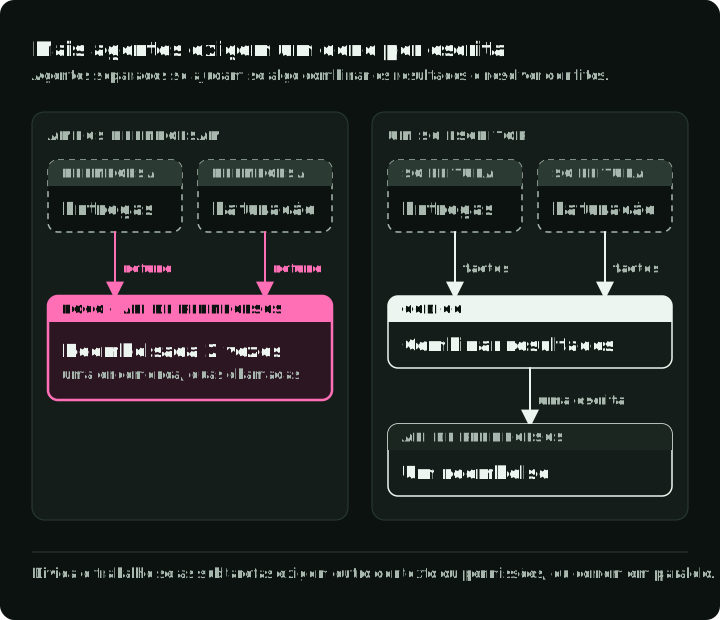
Dividir o trabalho por vários agentes é uma escolha à parte, e um só agente costuma bastar. Um segundo agente ajuda quando uma subtarefa precisa de outro contexto ou de outras permissões, ou pode correr ao mesmo tempo que a primeira. Alguma peça tem então de combinar os resultados e resolver conflitos entre as ações dos agentes. Se um agente de entregas e um agente de faturação puderem ambos emitir reembolsos, a mesma encomenda pode ser reembolsada duas vezes.
Tool calls ou código gerado?
Depois de decidir quem escolhe o passo seguinte, decidimos como o modelo pede uma ação. Pode chamar uma ferramenta: uma função com nome que o seu código fornece e executa em nome do modelo. Ou pode escrever um programa curto que o seu código executa. Quem escolhe o passo seguinte e como o modelo pede uma ação são decisões separadas. Um fluxo de trabalho fixo pode conter um passo em que o modelo escreve código, e um agent loop aberto pode usar apenas algumas ferramentas com funções limitadas.
Para o assistente de suporte, uma ferramenta como issue_refund(order_id, amount_cents) serve bem. O seu schema dá nome à ação e aos argumentos, por isso o pedido é explícito. A ferramenta devolve um ID de reembolso em caso de êxito ou um motivo estruturado em caso de rejeição. Podemos testar esta ferramenta isoladamente, porque o modelo nunca escreve a lógica do reembolso.
Nem todas as tarefas precisam de ferramentas. Um classificador que recebe toda a entrada no prompt pode devolver uma etiqueta validada. Adicione uma ferramenta de consulta quando a tarefa precisar de dados que não estão no prompt. Adicione uma ferramenta que altera dados apenas quando a tarefa tiver de alterar algo.
O código gerado serve outro tipo de trabalho. Imagine que o assistente tem de ler uma tabela de encomendas, agrupar as linhas por cliente e calcular vários totais. Com ferramentas, cada passo é uma chamada separada, e todos os resultados intermédios voltam ao modelo. Com código, o modelo escreve um programa Python que guarda os valores intermédios nas suas próprias variáveis, e só os totais voltam.
A biblioteca smolagents da Hugging Face oferece os dois estilos. ToolCallingAgent devolve tool calls estruturadas. CodeAgent escreve Python que chama as mesmas ferramentas, guarda valores em variáveis e combina os resultados. Um code agent continua a usar ferramentas; chama-as a partir de um programa.
O código gerado também nos dá trabalho extra. Temos de tratar erros de sintaxe, limitar o tempo de execução, gerir dependências e decidir que ficheiros e endereços de rede o código pode alcançar. Saber se menos chamadas ao modelo compensam esse trabalho depende da tarefa e do modelo. Meça-o na sua tarefa; o código não é melhor por defeito.
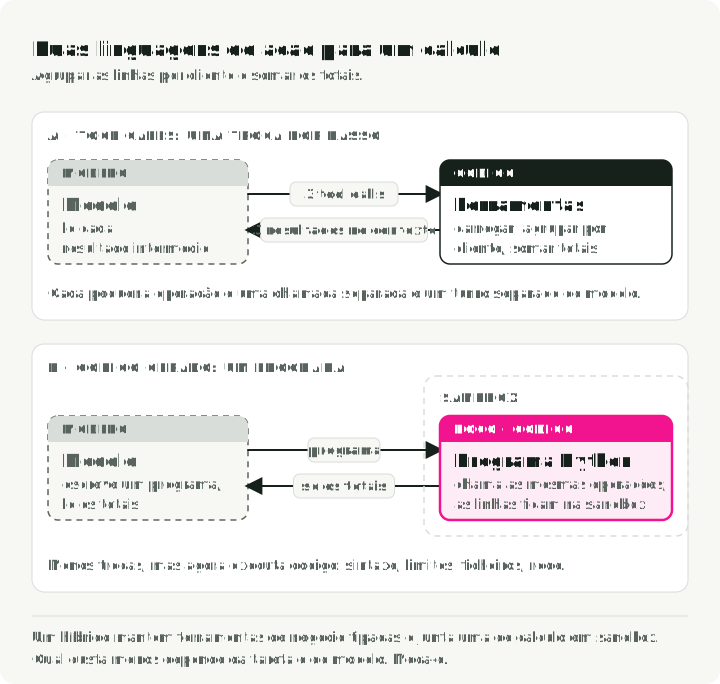
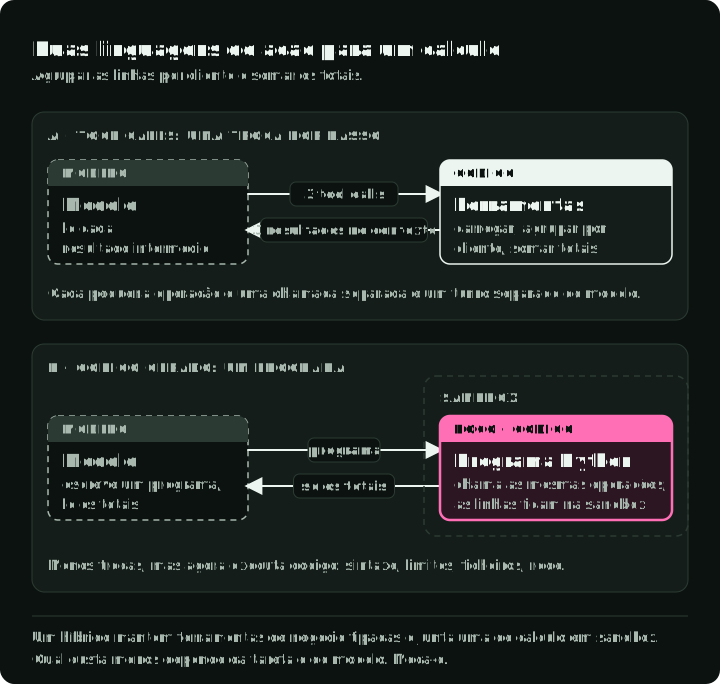
Várias APIs alojadas combinam os dois estilos: as suas próprias ferramentas de negócio e uma ferramenta de execução de código integrada que corre num sandbox, um ambiente separado com acesso restrito. A Responses API da OpenAI, a Claude API, a Gemini API e o AWS Bedrock AgentCore oferecem todos esta possibilidade.
O programmatic tool calling da Anthropic vai um passo mais longe: o código no sandbox pode chamar as ferramentas que permitir, e só os resultados que selecionar voltam ao modelo. A Anthropic continua a recomendar tool calls diretas por defeito, e o caminho do código para resultados grandes e para cadeias de chamadas que dependem umas das outras. Alguns desenhos usam apenas código, como o CodeAgent do smolagents e o Code Mode da Cloudflare.
Para o nosso assistente de reembolsos, eu começaria com ferramentas de negócio tipadas. Se uma tarefa posterior exigir cálculo pesado, podemos adicionar um executor de código sem acesso às contas dos clientes.
Uma terceira questão é como a aplicação se liga às suas ferramentas. Uma função local basta quando uma só aplicação é dona do código. O Model Context Protocol (MCP) é uma forma normalizada de servir ferramentas a partir de um servidor separado, para que várias aplicações as possam partilhar. O MCP define como a aplicação e o servidor trocam tool calls. Não valida argumentos nem decide quem pode chamar uma ferramenta: a especificação de ferramentas do MCP deixa essas verificações à aplicação e ao servidor.
Pôr as restrições onde as ações acontecem
A descrição de uma ferramenta diz ao modelo quando ela é útil. Não decide se uma chamada concreta pode correr. Quem decide isso é o código que faz a escrita. Num reembolso, esse código verifica a conta autenticada, a encomenda, o valor, a política de reembolsos e qualquer aprovação exigida.
Algumas verificações exigem interpretação
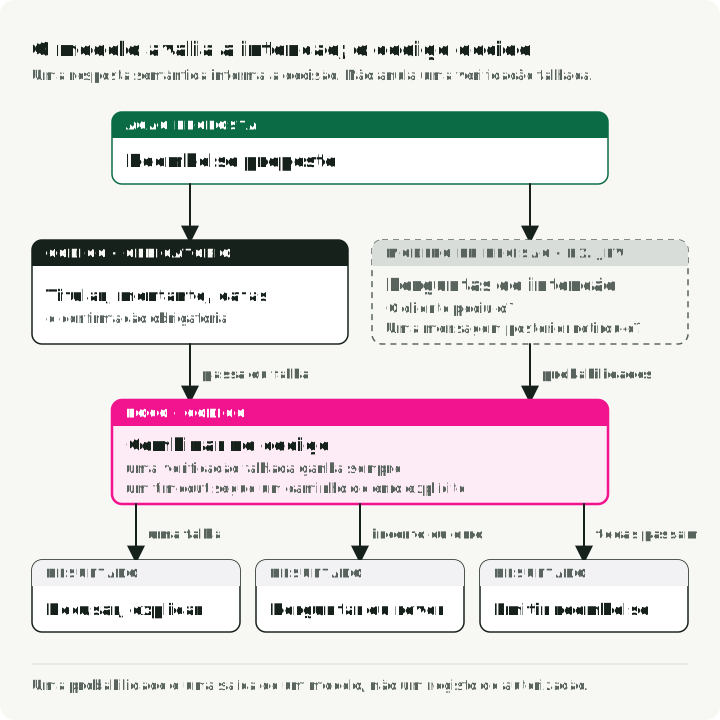
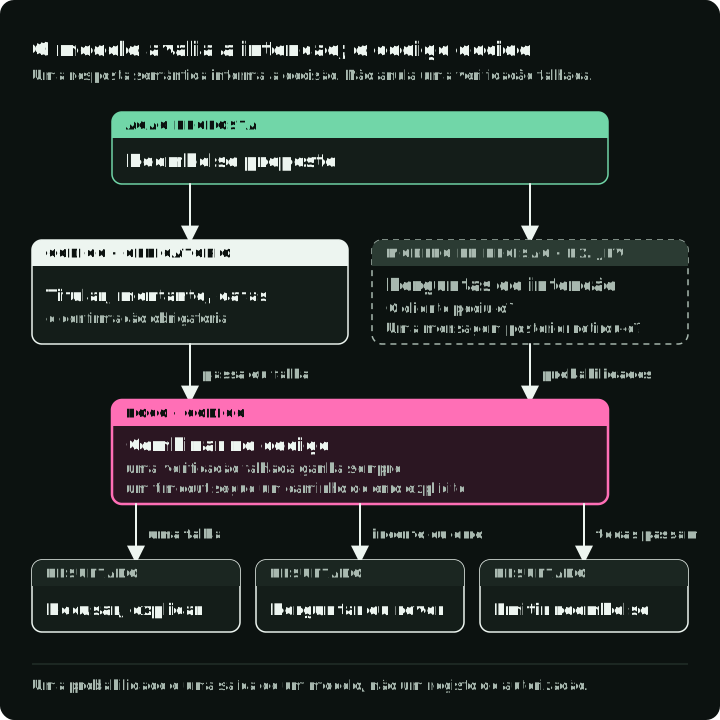
Algumas verificações não se conseguem escrever como código comum. Imagine que o cliente pergunta “Posso devolver esta encomenda?” e o agente propõe um reembolso. A encomenda pertence ao cliente, o valor é válido e o prazo de devolução está aberto. Todas as verificações do código passam, mas o cliente pode estar apenas a perguntar se a devolução é possível, sem pedir já um reembolso. Alguém tem de ler a mensagem para decidir.
O código comum continua a verificar titularidade, valores e datas. O modelo principal pode perguntar ao cliente quando a intenção não é clara, ou a aplicação pode exigir confirmação explícita antes de um reembolso. Um modelo de decisão à parte é outro desenho a avaliar: responde a uma pergunta concreta sobre o sentido, como “O cliente pediu este reembolso?” Podemos testar essa pergunta isoladamente, sem executar a conversa inteira. Compare este desenho com um pedido de esclarecimento ou de confirmação antes de adicionar outro modelo.
O Jev, um modelo de decisão da TypeSafe, é uma opção para esse papel. Recebe o estado que lhe fornecemos e perguntas tipadas, e devolve respostas estruturadas. Para uma pergunta de sim/não, devolve a probabilidade de a resposta ser sim.
Eu faria duas perguntas separadas: o cliente pediu explicitamente o reembolso, e uma mensagem posterior retirou esse pedido? A TypeSafe recomenda perguntas específicas cujas respostas se combinam no código, e várias perguntas podem partilhar uma única chamada à API. Com duas perguntas, uma resposta errada mostra qual das duas avaliações falhou.
O código combina então essas respostas com as verificações obrigatórias. Se as respostas forem pouco claras ou entrarem em conflito, o assistente pergunta ao cliente ou envia o caso a uma pessoa. Se a chamada ao Jev exceder o tempo limite, esse erro também precisa do seu próprio caminho. Um “sim” do Jev nunca anula uma verificação de titularidade falhada nem substitui uma confirmação obrigatória. A sua probabilidade é um resultado de um modelo. Não autoriza o reembolso e não prova que a decisão está correta.
O contexto que damos à verificação decide o que ela consegue ver. Eu forneceria a ação proposta, as mensagens do cliente por ordem e os tool results de que a decisão precisa, cada um com a indicação da origem. Só a última mensagem pode deixar passar um cancelamento. O histórico completo da conta pode esconder o pedido no meio de mensagens não relacionadas. Um modelo pequeno de uso geral com structured output também poderia responder a estas perguntas. Compare-o com o Jev nos mesmos exemplos, em precisão e custo.
Restringir o acesso independentemente das avaliações do modelo
O texto de um cliente ou de um documento obtido pode conter instruções dirigidas ao agente. Esse texto não deve poder conceder permissões nem substituir a política da aplicação. Se um documento mandar o agente exportar todos os registos de clientes, o sistema não pode ter a permissão para o fazer, por mais convincente que seja a formulação.
O código gerado precisa dos seus próprios limites de acesso. Se o modelo só puder chamar funções revistas com permissões estreitas, um sandbox de código de uso geral pode acrescentar pouco. Essas funções continuam a precisar de autorização, validação de entradas, tempos limite e consultas seguras à base de dados.
Antes de permitirmos Python gerado, comandos de shell ou edições a ficheiros executáveis, temos de decidir o que esse código pode alcançar. Em que diretórios pode escrever? Precisa de acesso à rede? Que credenciais pode ver? Quanto tempo de CPU, memória e saída pode usar uma execução? Executar o código num processo separado não responde a estas perguntas por si só.
O guia de execução segura da Hugging Face compara um interpretador local restrito com opções mais isoladas, como contentores. Cada opção bloqueia coisas diferentes. Um contentor com acesso amplo aos ficheiros do anfitrião e a credenciais poderosas ainda pode expor os recursos que queríamos proteger. Teste que uma leitura proibida, uma escrita proibida e um pedido de rede proibido falham, e também que um programa normal tem êxito.
Podemos dispensar o executor de código até a tarefa precisar de um, mas o seu isolamento tem de estar pronto no dia em que o ativarmos. O isolamento também não consegue impedir o uso indevido de uma API que damos ao código de propósito, por isso o serviço de reembolsos tem de continuar a impor as suas próprias regras.
O que sobrevive quando uma execução para a meio?
Imagine agora que o assistente envia um pedido de reembolso, o serviço cria o reembolso e a resposta perde-se no caminho de volta. O modelo vê um tempo limite excedido. Se chamar de novo, o cliente pode receber um segundo reembolso. Se comunicar uma falha, diz ao cliente algo que já não é verdade.
A solução é tornar o reembolso idempotente: enviar o mesmo pedido duas vezes tem o mesmo efeito que enviá-lo uma vez. Antes de enviar o reembolso, a aplicação cria um ID de operação e guarda-o. Numa repetição envia o mesmo ID, e o serviço devolve o reembolso que já fez em vez de fazer outro. As orientações da AWS sobre APIs idempotentes explicam este padrão. Se o serviço não o suportar, a recuperação tem de verificar primeiro o que aconteceu, ou perguntar a uma pessoa, antes de qualquer segunda tentativa.
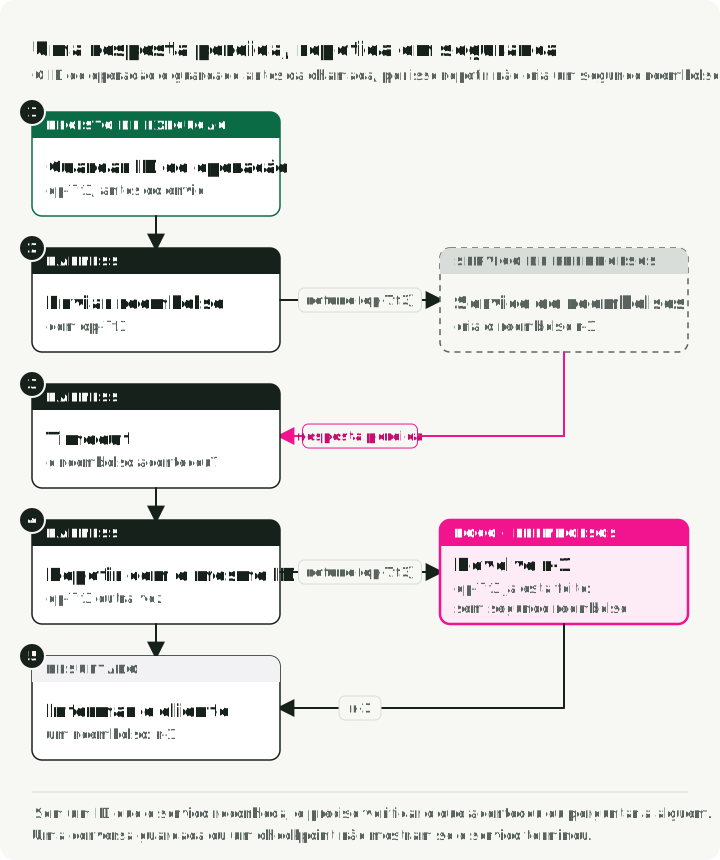
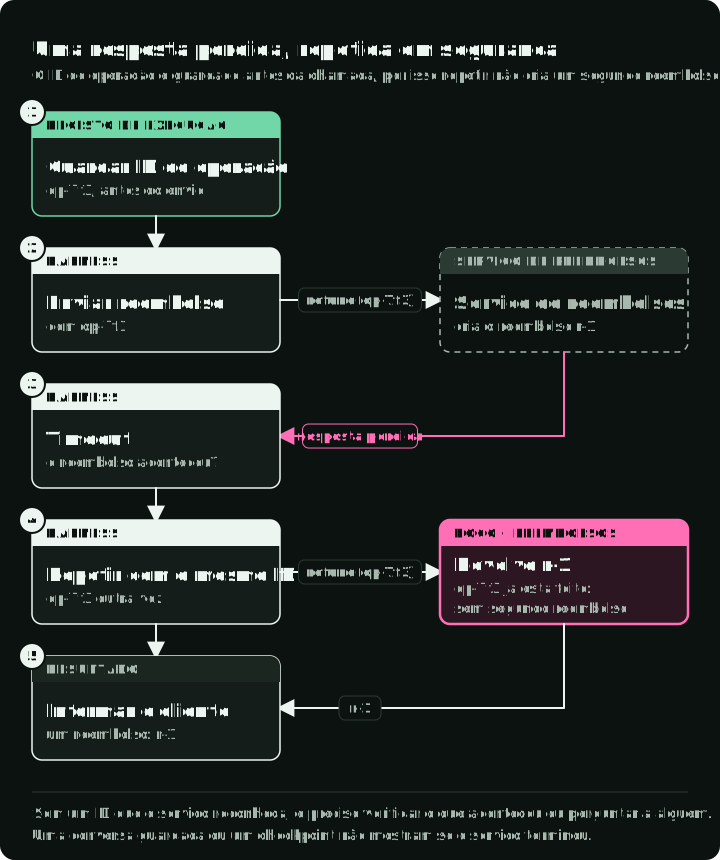
Guardar a conversa não resolve isto. A conversa pode registar que o modelo pediu um reembolso, mas não se o serviço o concluiu. Um checkpoint, uma cópia guardada do estado do agente, permite continuar uma execução parada. Não consegue desfazer um reembolso que o serviço já fez, e não torna seguro repeti-lo.
Neste assistente, três tipos de estado têm funções diferentes. A conversa contém o pedido do cliente e os factos reunidos até agora. Os registos de encomendas e reembolsos contêm o estado do negócio. Um registo de execução lista as operações pendentes e as aprovações, para que um worker reiniciado possa continuar em segurança. Podem viver na mesma base de dados, mas um não substitui os outros.
A memória entre sessões é uma escolha à parte. Se o assistente tiver de se lembrar da preferência de um cliente na semana seguinte, precisamos de regras sobre de quem é a preferência, quem a pode alterar e como é eliminada. Se cada tarefa for independente, talvez não precisemos de um serviço de memória. Cada pedaço de texto guardado é também uma oportunidade de reutilizar mais tarde algo desatualizado ou irrelevante.
As conversas longas levantam um problema semelhante dentro de uma só sessão. Quando uma conversa fica demasiado longa para o modelo a usar bem, podemos recuperar partes dela ou substituir os turnos mais antigos por um resumo. Um resumo que perca um ID de encomenda, uma condição de aprovação ou uma operação pendente pode comprometer o procedimento. Mantenha esse estado operacional em campos explícitos e teste o que sobrevive a um resumo antes de contar com ele.
Dar ao loop uma forma de parar
Um agent loop consegue sempre encontrar mais alguma coisa para verificar, por isso precisa de uma regra de paragem que cubra o êxito, a falta de informação, os limites esgotados e a falha. Quando uma execução atinge um limite, tem de comunicar o estado verdadeiro: o reembolso está feito, nunca foi tentado ou continua incerto. “O agente parou” não diz ao cliente nem ao worker seguinte o que aconteceu.
Ajuda nomear as formas como uma execução pode terminar antes de escrever o loop. Para o assistente de apoio, eu usaria oito: concluída e verificada, recusada, informação em falta solicitada, entregue a uma pessoa, bloqueada por uma verificação de política, parada por um limite, terminada por um erro de infraestrutura e resultado da escrita desconhecido.
Registe esse estado separadamente da avaliação de cumprimento do contrato da tarefa. “Concluída e verificada” confirma a escrita pedida. Uma recusa, pergunta ou passagem do caso pode estar correta quando a tarefa a exige. A resposta, as ações e o estado final têm de sustentar essa avaliação; parar não basta.
Um limite de chamadas ao modelo cobre só parte da execução. Uma ferramenta pode bloquear. Uma repetição pode duplicar trabalho. Um sumarizador ou um modelo de decisão como o Jev fazem chamadas a modelos por conta própria. Defina limites para o tempo decorrido, as tentativas, o tamanho da saída e a despesa, e conte todos os componentes que correm. Cancelar uma execução também tem de ter em conta os pedidos já enviados a um serviço externo.
O próprio modelo acrescenta limites. Verifique se produz o formato de ação exigido em tarefas realistas. Compare o tamanho de contexto utilizável, a latência, o custo e para onde os dados da tarefa podem ser enviados. Um modelo que aloja por si e uma API alojada podem partilhar uma interface mas diferir em capacidade e no tratamento dos dados.
Escolha um modelo e um endpoint iniciais, registe as suas definições e mantenha-os fixos enquanto avalia uma alteração ao harness. Caso contrário, uma execução mais rápida pode dever-se a outro fornecedor ou modelo, e não à alteração que queria testar.
Avaliar a conclusão, incluindo os casos que não devem fazer nada
Quando o assistente consegue concluir um pedido, precisamos de verificar se fez a coisa certa. No exemplo do reembolso, podemos observar três coisas: o que o assistente disse, que ações tentou e o que mudou no serviço. Cada uma apanha falhas que as outras deixam passar.
Uma resposta pode dizer “Reembolsei a sua encomenda” com a base de dados inalterada. Um reembolso correto pode vir com uma alteração de morada não relacionada que só o registo de ações revela. E uma base de dados inalterada pode significar quatro coisas diferentes: uma recusa correta, uma pergunta útil, uma falha ou um assistente que não fez nada. O estado final sozinho não distingue estas quatro.
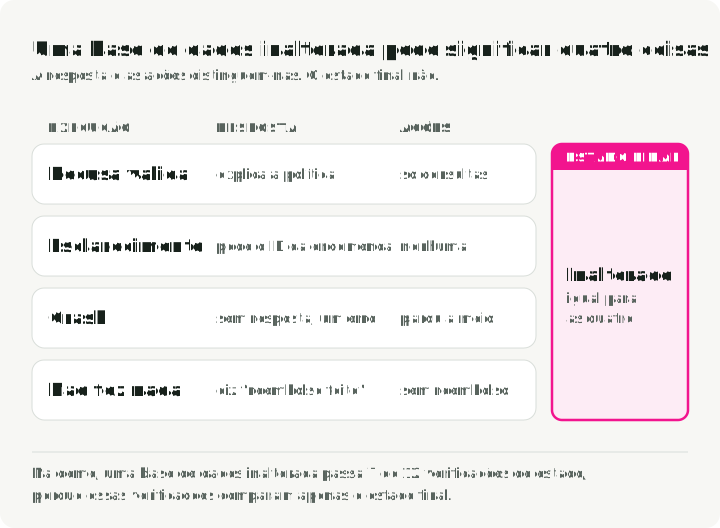
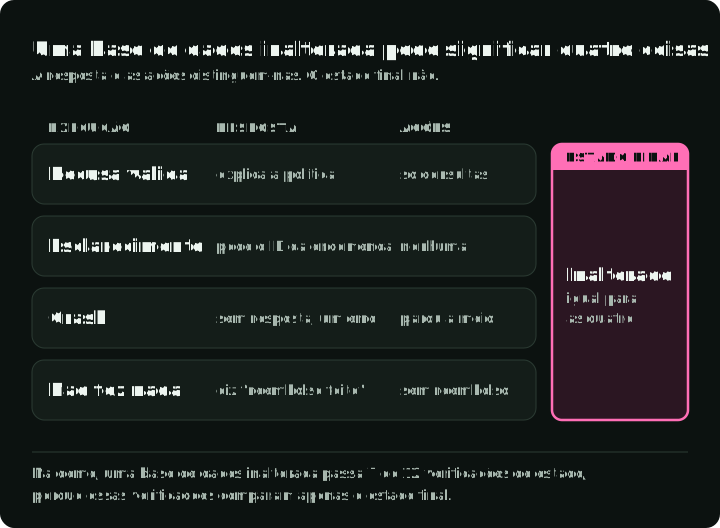
A demonstração associada, descrita no fim deste artigo, mostra este limite com números reais. Tem doze tarefas de suporte, e sete delas não esperam nenhuma alteração à base de dados. Um agente que não altera nada passa, por isso, 7 de 12 verificações de estado. Esse número descreve as verificações; não é uma taxa de êxito medida. As definições das tarefas comparam apenas a base de dados final, não a resposta nem as ações intermédias. Uma escrita que é feita e depois revertida também não deixa rasto nessa comparação.
Para o seu primeiro conjunto de avaliação, inclua uma ação bem-sucedida, uma recusa válida, um pedido com informação em falta e uma falha durante a execução. Para cada caso, defina a resposta esperada e as ações permitidas, além do estado final. Um caso de esclarecimento deve exigir a pergunta certa. Um caso de recusa deve exigir uma explicação útil. Estes casos mostram se o agente compreende a tarefa e se a aplicação a impõe.
Se adicionarmos a verificação com o Jev, ela precisa dos seus próprios casos de teste. Dê-lhe ações propostas cujas decisões corretas uma pessoa definiu de antemão: um pedido de reembolso explícito, uma pergunta sobre elegibilidade, um pedido retirado e uma instrução escondida num tool result. O último caso testa também se o contexto que montamos mantém as mensagens do cliente separadas da saída das ferramentas.
Conte as ações más que o Jev deixa passar e as ações válidas que bloqueia. Depois de cada bloqueio, acompanhe o resto da conversa. Bloquear uma escrita só ajuda se o assistente fizer então uma pergunta ao cliente, em vez de entrar em ciclo ou parar. O Jev devolve uma probabilidade, por isso a aplicação precisa de um limiar que a transforme em permitir ou bloquear. Escolha o limiar com exemplos de desenvolvimento e fixe-o antes da comparação final, feita com exemplos em que não o ajustou. Registe a versão da pergunta, o contexto fornecido, as probabilidades devolvidas, a regra aplicada, os erros e o custo. Na demonstração registada, o Jev nunca rejeitou uma escrita, por isso ela não mostra que o Jev ajuda.
Registe o suficiente para diagnosticar uma falha: a tarefa, as versões do modelo e do harness, as ações propostas, os resultados da execução, o estado final, os erros, a latência e o custo. Mantenha segredos e dados pessoais desnecessários fora desse registo.
O agente em teste não deve poder alterar a forma como é avaliado. Dê-lhe a entrada da tarefa e as regras de que precisa, mas não as respostas de referência nem os casos de teste reservados. Mantenha o avaliador (o código que pontua as execuções) e os seus registos fora do controlo do agente. Isto torna-se mais rigoroso se um programa editar mais tarde o harness automaticamente para subir a sua pontuação: esse programa não deve poder editar as verificações que o pontuam.
Estes registos também nos dizem quando adicionar um componente opcional. Adicione um router, um primeiro passo que envia cada pedido para o tratamento certo, quando as execuções registadas mostrarem que escolher o tipo de pedido exige uma fase própria. Adicione resumos quando os históricos longos causarem uma falha específica. Teste uma proteção contra ações proibidas, incluindo as ações que ela deve permitir. Os controlos de acesso obrigatórios decorrem das regras da tarefa; os componentes opcionais precisam de prova de que compensam o seu custo.
Transformar o desenho numa primeira implementação
Para o assistente de suporte, temos agora um desenho de partida: um agent loop com limites para interpretar pedidos variados, ferramentas com funções limitadas para operações de conta, verificações dentro dos serviços que escrevem dados e registos guardados das ações pendentes. Nada até aqui exige código gerado nem memória entre sessões.
Eu construiria primeiro um caminho completo. Crie uma pequena conta de teste e um resultado de reembolso esperado. Implemente as ferramentas de consulta e de reembolso, incluindo os seus caminhos de rejeição. Ligue o modelo a essas ferramentas. Depois execute os casos de recusa, de informação em falta e de escrita interrompida. As lacunas nos requisitos são mais fáceis de encontrar agora, com poucas tarefas, do que mais tarde, com muitas.
Nesta fase, um loop sem framework pode bastar. Monta o contexto, pede ao modelo a ação seguinte, valida e executa essa ação e devolve o resultado ao modelo. Escrever esse loop por si também significa escrever a conversão de mensagens, o cancelamento, o tratamento do estado e o tracing. Vale a pena usar um framework quando ele faz esse trabalho e ainda lhe deixa controlar as decisões deste artigo.
Esta série usa o create_agent da LangChain como ponto de partida, porque fornece o loop de modelo e ferramentas e ainda hooks para alterar o seu comportamento. Já corre sobre o LangGraph. Passar mais tarde para um fluxo de trabalho explícito do LangGraph significa escrever nós próprios mais fases à volta do agente, e não acrescentar um grafo do zero.
Antes de escrever a implementação, eu poria as decisões numa página. A primeira versão não precisa de todas as capacidades discutidas acima. Precisa apenas das partes que concluem a tarefa, mais registos que mostrem onde uma execução falha.
| Pergunta | Decisão a registar |
|---|---|
| Que tarefa estamos a concluir? | Quem chama, resultado esperado, recusa ou passagem válida e efeitos proibidos |
| Quem escolhe o passo seguinte? | Fases conhecidas no código; decisões delegadas ao modelo; o motivo de cada uma |
| Que verificações exigem interpretação? | A pergunta sobre o sentido, o contexto que vê, o modelo que responde, o que fazer em caso de dúvida |
| O que pode o modelo pedir para fazer? | Sem ferramentas, operações tipadas, código gerado ou uma combinação |
| Quem autoriza e executa? | Dados e ações permitidos, o serviço que os verifica, aprovações, limites do sandbox |
| O que tem de sobreviver a uma interrupção? | Estado da conversa, registos de negócio, operações pendentes e comportamento de recuperação |
| Que ações é seguro repetir? | Leituras; escritas com um ID de operação que o serviço deduplica; escritas que é preciso verificar primeiro |
| Que limites se aplicam? | Restrições de modelo/fornecedor, tratamento de dados, chamadas, tempo, despesa e cancelamento |
| O que prova a conclusão? | Verificações de resposta, ações e estado; quem é responsável pela sua evidência |
| O que deixámos de fora? | Componentes opcionais e a falha ou o novo requisito que justificaria cada um |
Uma resposta útil é específica o bastante para mudar a implementação. “Precisa de memória” é vago. “Tem de retomar um reembolso aprovado depois de um reinício do worker sem criar um segundo reembolso” diz-nos o que persistir e que falha testar.
A Parte 2 pergunta quando um fluxo de trabalho explícito trata a tarefa suficientemente bem para justificar as suas fases extra. Constrói o fluxo de trabalho mais pequeno de que as tarefas precisam à volta do agente e compara-o com o loop. As partes seguintes mantêm o avaliador fora do controlo do agente e medem como os resultados variam em execuções repetidas.
Opcional: inspecionar a implementação e os seus limites
A demonstração associada é uma versão pequena e executável do assistente de suporte. Corre em dois ambientes:
- Tarefas de suporte personalizadas: doze tarefas, cada uma contra uma base de dados SQLite nova de clientes e encomendas.
- τ³-bench retail: oito tarefas do τ³-bench, um benchmark público em que um modelo faz de cliente, fala com o agente e verificações à base de dados pontuam o resultado.
Esta secção descreve o que a demonstração contém, o que deixa de fora de propósito, o que os resultados mostram e como a executar. Pode saltá-la e continuar a usar o processo de desenho acima.
O que a demonstração contém
Um agente LangChain escolhe as chamadas. Tem cinco ferramentas de conta (look_up_account, list_orders, issue_refund, update_address e set_preference) e um servidor MCP para consultas de política e de FAQ. Um checkpointer em memória guarda o estado da execução entre passos. Não há executor de código nem memória entre sessões.
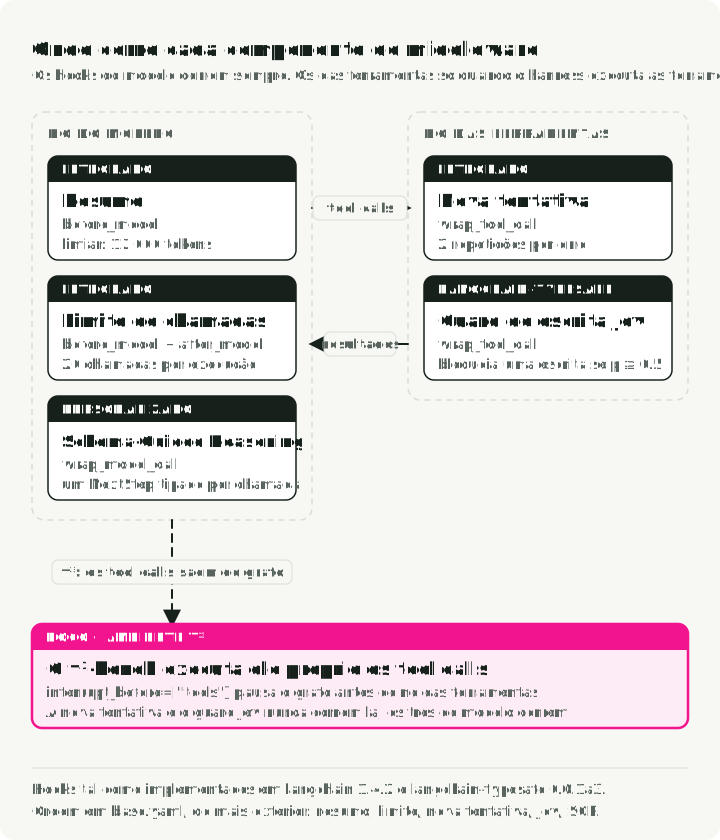
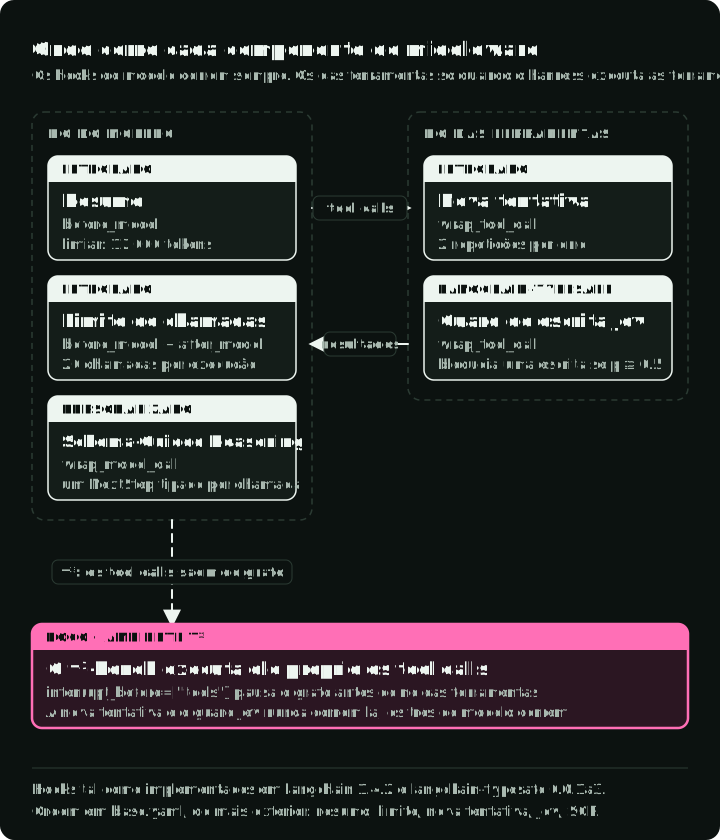
Cada execução lê uma spec, um ficheiro YAML que indica o modelo e os componentes a usar. A demonstração regista duas specs. Em base, o Schema-Guided Reasoning (SGR) faz o modelo devolver um objeto estruturado com o passo seguinte, em vez de uma tool call nativa. A proteção de escrita com o Jev, a verificação com o modelo de decisão descrita antes, corre antes de cada escrita e faz uma pergunta composta: esta chamada violaria a política ou iria além do que o cliente pediu?
| Spec | Componentes |
|---|---|
plain | Sumarização, um limite de 20 chamadas ao modelo por execução e 2 repetições perante um erro de ferramenta |
base | Tudo o que está em plain, mais Schema-Guided Reasoning e uma proteção de escrita com o Jev |
As duas perguntas separadas apresentadas antes neste artigo, sobre o pedido e a sua retirada, são uma proposta de redesenho; as execuções registadas não as usaram. O base adiciona SGR e Jev num só passo, por isso os resultados personalizados não conseguem mostrar se foi o SGR ou o Jev a causar uma diferença.
O que a demonstração deixa de fora de propósito
- As ferramentas verificam a integridade dos dados mas deixam a política de negócio ao agente, pelo que uma experiência pode expor uma escrita que a política proíbe. Um serviço real imporia a política na escrita.
- Não há limite global de tempo nem de despesa.
- A repetição de ferramentas aplica-se a todas as ferramentas, incluindo as três de escrita, e as escritas repetidas não têm chave de idempotência. A repetição envolve a proteção do Jev, por isso cada escrita repetida é também verificada de novo. O
ToolRetryMiddlewaredo LangChain aceita uma lista de nomes de ferramentas; um serviço real limitaria as repetições às leituras. - O avaliador corre no mesmo processo que o agente.
Estes resultados não testam, por isso, a imposição em produção, a segurança das repetições nem a proteção da evidência contra adulteração.
Resultados nas tarefas personalizadas
Cada linha é uma execução de cada tarefa. Os preços são os preços do endpoint registados com os resultados. Para passar, é necessário ter a base de dados final esperada e nenhum erro de execução. Estas verificações não validam a resposta nem todas as ações intermédias. O custo e a latência são médias por tarefa; o custo inclui o Jev onde ele corre.
| Spec | Modelo | Aprovadas | Custo | Latência |
|---|---|---|---|---|
base | openai/gpt-6-luna | 12/12 | $0.00073 | 11.9 s |
plain | openai/gpt-6-luna | 12/12 | $0.00033 | 5.8 s |
base | z-ai/glm-5.3-flash | 12/12 | $0.00101 | 9.7 s |
base | xiaomi/mimo-v2.6-flash | 7/12 | $0.00087 | 18.6 s |
- Com o
gpt-6-luna, ambas as specs passaram as doze tarefas. Obasecustou cerca de 2,2 vezes mais e demorou cerca do dobro do tempo. - O Jev permitiu todas as escritas que verificou: seis em cada uma das execuções com
gpt-6-lunae GLM, e quatro na execução com MiMo. Nunca bloqueou uma escrita, por isso estas execuções não testam se ele trava uma escrita má. - As cinco falhas do MiMo foram erros de formato de saída do SGR. Três deixaram a base de dados inalterada, conforme exigido, mas os erros de execução fizeram com que continuassem a ser falhas. Não há execução
plaincom o MiMo, por isso não podemos dizer se as tool calls nativas teriam melhor resultado. - A sumarização nunca correu. O maior pedido das seis execuções registadas (estas quatro e as duas execuções do τ³-bench abaixo) teve 8351 tokens de entrada, abaixo do limiar de 12 000 tokens. Estes resultados não conseguem mostrar se a sumarização ajuda. Quando corre, o middleware de sumarização do LangChain substitui as mensagens mais antigas no estado do agente por uma única mensagem de resumo, pelo que a transcrição completa tem de vir do trace.
Resultados no τ³-bench
O τ³-bench pontua uma execução repetindo as tool calls do agente num ambiente novo, por isso o próprio benchmark tem de executar as ferramentas. O adaptador da demonstração, o código que liga o agente ao τ³-bench, faz uma pausa no grafo antes do nó das ferramentas, devolve as tool calls e escreve de volta os resultados do benchmark antes de retomar.
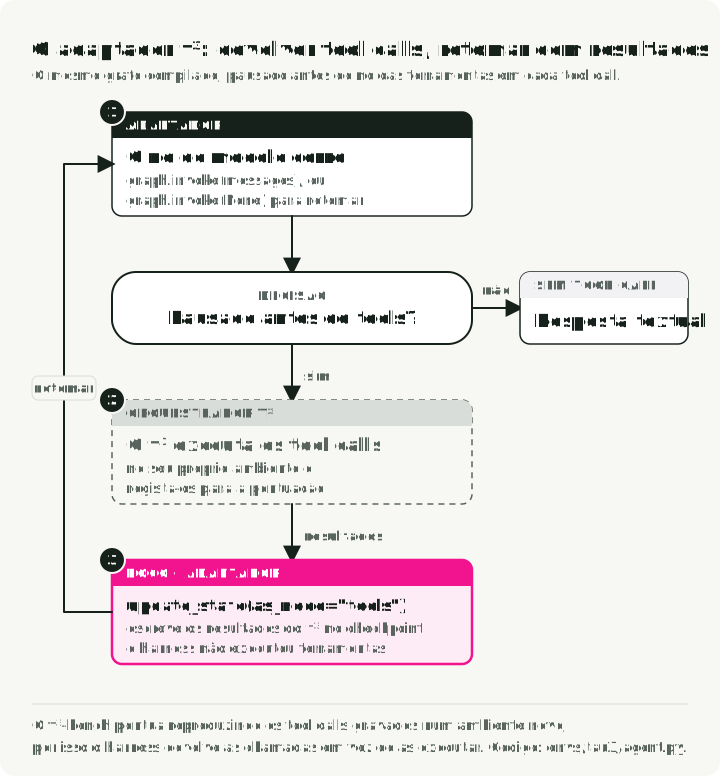
Isto tem duas consequências. Primeiro, o prompt, as ferramentas e a política vêm do τ³-bench, por isso estes resultados não são comparáveis com os personalizados, mesmo com o mesmo ficheiro de spec. Segundo, a repetição de ferramentas e o Jev nunca correm aqui: a única diferença entre base e plain é o SGR.
Ambas as execuções usam openai/gpt-6-luna para o agente e para o cliente simulado. A latência da simulação inclui o trabalho do simulador. O custo do agente e a latência da simulação são médias por tarefa; o custo do simulador é o total das oito tarefas.
| Spec | Aprovadas | Custo do agente | Latência da simulação | Custo do simulador, total |
|---|---|---|---|---|
base | 6/8 | $0.00238 | 59.0 s | $0.00453 |
plain | 7/8 | $0.00136 | 38.9 s | $0.00471 |
- As oito tarefas vêm da partição de teste de retail e não têm asserções em linguagem natural, por isso só as verificações à base de dados decidem a recompensa.
- Ambas as specs terminaram as oito tarefas sem erros do adaptador. Todas as falhas foram uma escrita em falta. O
basefalhou as tarefas 9 e 26. Oplainpassou a tarefa 27 a um humano em vez de concluir a troca. - Uma nova execução
base, não contada nas seis, também passou 6/8 mas falhou as tarefas 9 e 17. As tarefas que falham mudam entre execuções, por isso uma diferença de uma tarefa não é motivo para preferir oplain. Estas execuções não medem essa variação.
Verificar os números registados
Os relatórios e traces guardados conservam os resultados por tarefa, as contagens de tokens, as configurações, as versões dos pacotes e os preços registados. Nas 393 chamadas de chat do agente das seis execuções registadas, o custo calculado a partir dos tokens coincidiu com o valor faturado em cada resposta. Esta verificação exclui as chamadas ao Jev e ao cliente simulado. Os preços são históricos, não uma cotação para a sua execução.
Execute-o por si
Instale o uv e use a versão marcada abaixo. Os testes correm offline depois de as dependências estarem instaladas. As duas execuções de ambientes fazem chamadas pagas a modelos através do OpenRouter e precisam de uma chave de API.
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout v0.1.2-a1
cp .env.example .env # set OPENROUTER_API_KEY
make test
make a1-custom SPEC=harness/spec/plain.yaml
make a1-tau3 SPEC=harness/spec/plain.yaml
Cada execução substitui os resultados em reports/article-a1/. Use git diff para os comparar com a referência registada no repositório. O Makefile instala a partir do uv.lock congelado.
Para experimentar outro modelo ou conjunto de ferramentas, copie uma spec em harness/spec/, altere esses campos e passe o seu caminho através de SPEC. As definições do fornecedor e dos componentes personalizados aceitam chaves livres, por isso a validação não consegue apanhar todos os erros de escrita em níveis internos.