Проектирование харнесса агента: от задачи к архитектуре

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Харнесс агента — это код вокруг языковой модели, который позволяет ей выполнить задачу. Он даёт модели инструкции и данные, выполняет действия, которые она запрашивает, отслеживает прогресс и решает, когда задача завершена. Статья адресована инженерам, которые добавляют агента в собственное приложение. Она показывает, как проектировать этот код от задачи: какие шаги выбирает модель, какие шаги заранее фиксирует ваш код и какие правила ваш код применяет независимо от ответа модели.
Принимайте эти решения до выбора фреймворка для агентов, потому что от задачи к задаче ответы разные. Ассистент поддержки меняет аккаунты клиентов, поэтому ему нужны проверки прав и безопасный повтор платежа. Агент для программирования редактирует файлы и запускает тесты, поэтому ему нужно место, где его код может выполняться, ничему не навредив. Классификатор документов возвращает только метку, так что инструменты ему могут вообще не понадобиться. Если все три начинают с одного и того же цикла, хранилища памяти и набора инструментов, никто не спрашивает, что нужно каждой задаче.
Мы пройдём по этим решениям на одном примере — ассистенте поддержки, который оформляет возвраты, — от описания задачи до первой реализации. Статья продолжает Харнесс-инжиниринг для ИИ-агентов, где описано, за что отвечает харнесс. Здесь мы выбираем эти обязанности для одного проекта.
Зачем модели нужен харнесс
В нашем ассистенте поддержки модель может предложить возврат, но сама завершить его не может. Код должен найти аккаунт клиента, загрузить заказ, проверить, что возврат разрешён, вызвать платёжный сервис и записать результат. Если платёжный сервис не ответил по таймауту, код также должен решить, безопасна ли повторная попытка. Эти задачи остаются, даже когда модель очень хорошо выбирает следующий шаг.
Часть этого кода, возможно, уже есть в вашем приложении. LangChain, фреймворк для агентов, который эта серия использует дальше, определяет харнесс широко: это весь код, конфигурация и логика выполнения вокруг модели. Под это определение попадают вход в систему, доступ к базе данных, очередь задач и шаг согласования. Проектирование харнесса включает решение о том, как агент ими пользуется. Заново строить их внутри фреймворка для агентов не нужно.
Харнесс может быть маленьким или большим. Самый маленький делает один вызов модели, проверяет вывод и возвращает результат. Более крупный позволяет модели читать файлы, запускать программы и пересматривать свою работу на протяжении многих ходов. Оба должны ответить на два вопроса: какие части задачи выполняет модель и как мы проверяем, что они выполнены правильно?
Опишите результат до агента
«Обрабатывать запросы на возврат» ещё не говорит, что должен делать ассистент. Допустим, клиент просит вернуть деньги за доставленный заказ. Запуск успешен, если ассистент вернул деньги за правильный заказ на правильную сумму, объяснил результат клиенту и ничего больше в аккаунте не изменил. Если запрос нарушает политику возвратов, правильный результат — понятный отказ. Если ассистент не может понять, какой заказ имеет в виду клиент, он должен спросить.
Возврат, отказ и вопрос — три разных правильных результата. Если считать успехом любой разговор, который закончился без ошибки, мы не отличим их друг от друга, а также от неправильного ответа, который просто закончился вежливо.
Правильный возврат зависит и от того, кто просит. Клиент может ввести любой номер заказа, поэтому номер в сообщении не доказывает, что заказ его. Приложение должно передать аккаунт, под которым выполнен вход, а сервис возвратов — проверить, что заказ принадлежит этому аккаунту. Модель может прочитать запрос, но не может доказать, кто его отправил.
Так мы получаем начало контракта задачи: изменения, которые считаются успехом, изменения, которые запрещены, и ситуации, в которых ассистент должен задать вопрос или передать обращение человеку. Часть этих требований нельзя выполнить одним промптом. Максимальную сумму возврата должен проверять сервис, который оформляет возвраты. Целевое время ответа требует таймаута в коде. Чтобы завтра продолжить работу с обращением, нужно сохранённое состояние.
Когда задача описана, можно решать, какую часть управления отдать модели.
Насколько процедура нам уже известна?
Если каждый запрос проходит одни и те же шаги (извлечь номер заказа, получить заказ, проверить право на возврат, оформить разрешённый возврат и объяснить результат), мы можем записать эти шаги в коде как фиксированный пайплайн. Если проверка не пройдена, возврат пропускается. Модель отвечает за язык в начале и в конце. Ей не нужен лишний вызов, чтобы решить, получать ли заказ, который нужен каждому запросу.
Явный воркфлоу добавляет ветвления и состояния ожидания, которыми управляет код. Возврат выше лимита может ждать согласования. Смену адреса можно разрешить только до отправки заказа. Эти стадии можно нарисовать как граф шагов, а код решает, какой шаг следующий.
Агентный цикл позволяет модели выбирать каждый шаг. Модель выбирает действие, читает результат и выбирает снова, пока не решит ответить. Это помогает в смешанном разговоре: клиент начинает с жалобы на доставку, затем говорит, что пришёл не тот товар, затем просит обмен. Какой поиск полезен дальше, зависит от того, что ассистент уже нашёл. Цена такая: у цикла больше возможных путей, и каждый нужно тестировать. Модель может делать лишние вызовы, повторять поиск или остановиться до завершения задачи.
Руководство LangGraph по воркфлоу и агентам описывает то же разделение: воркфлоу идут по заранее заданным путям, а агенты выбирают шаги во время работы. LangGraph, библиотека графов под LangChain, умеет строить и то и другое, поэтому система, построенная как граф, всё равно может содержать агента.
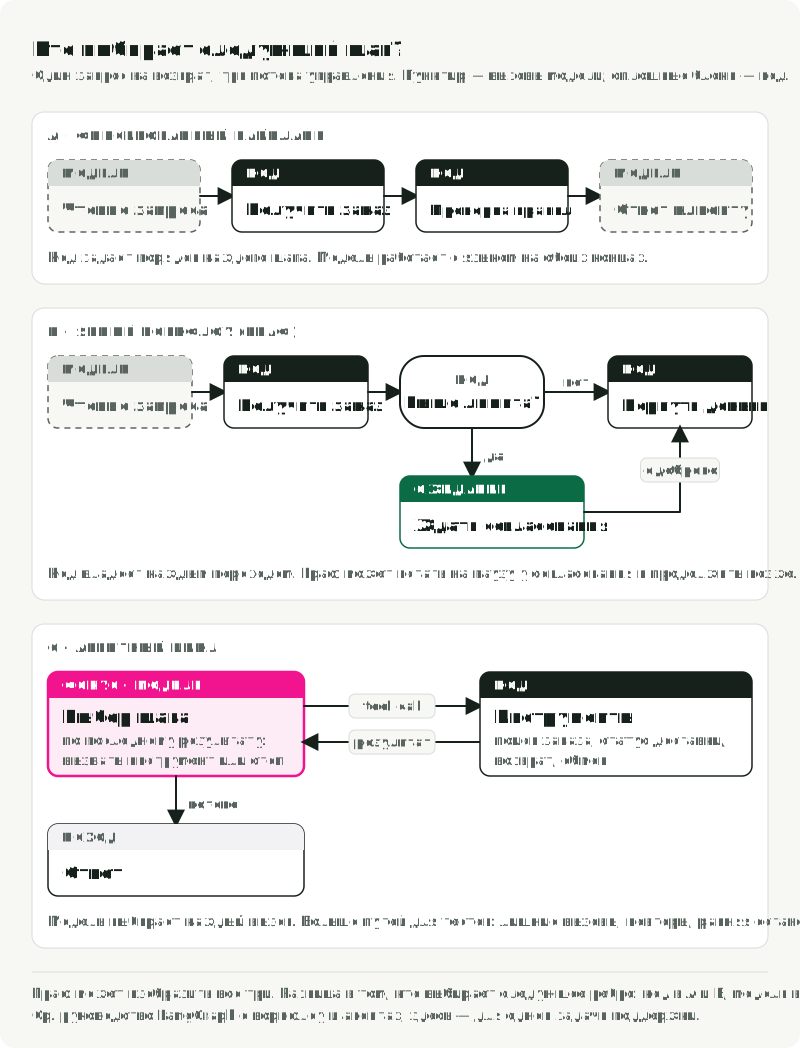
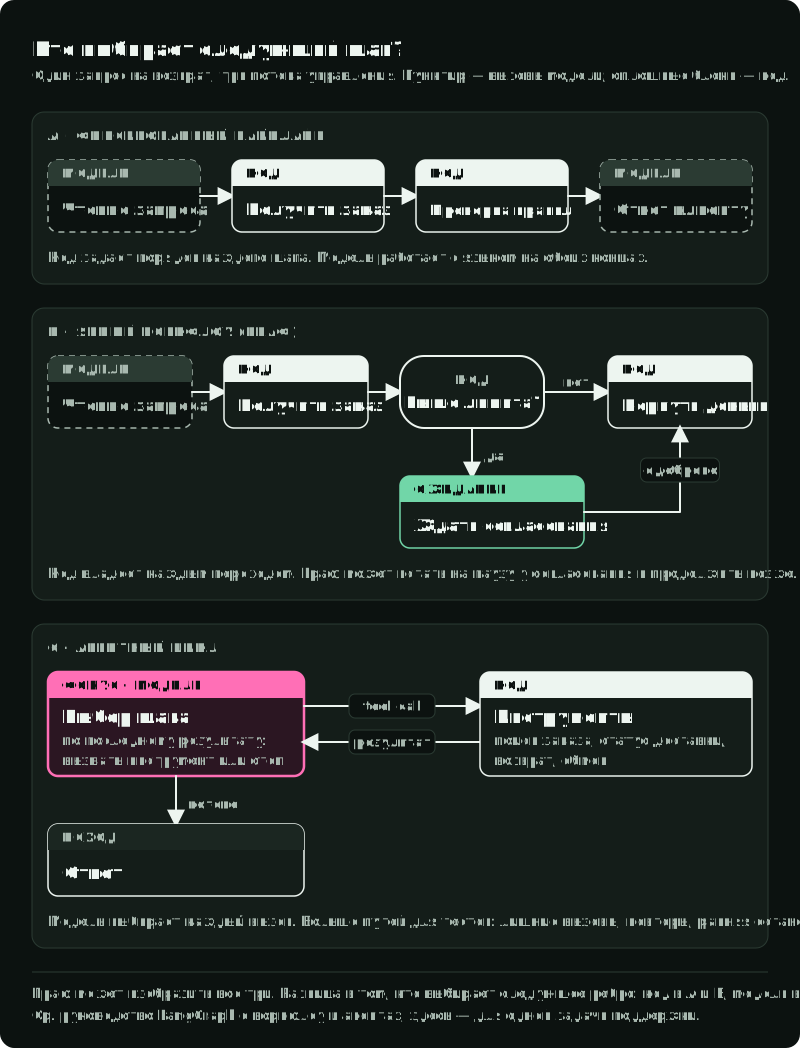
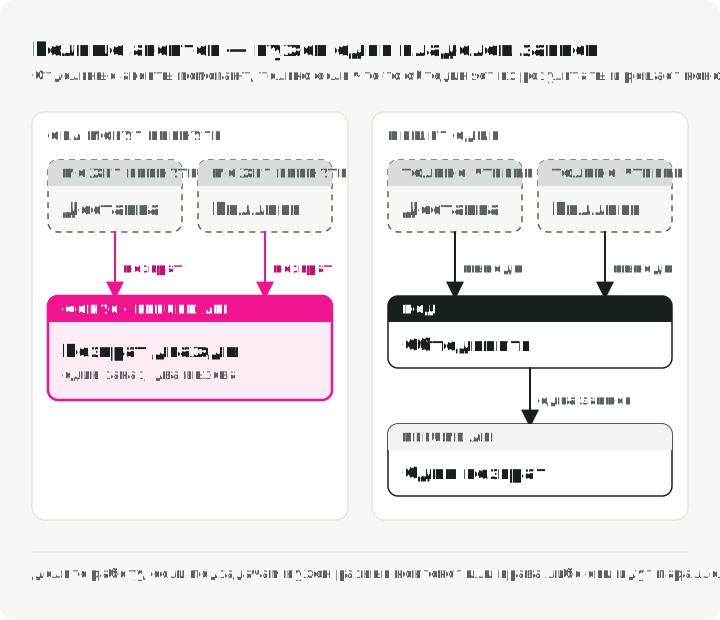
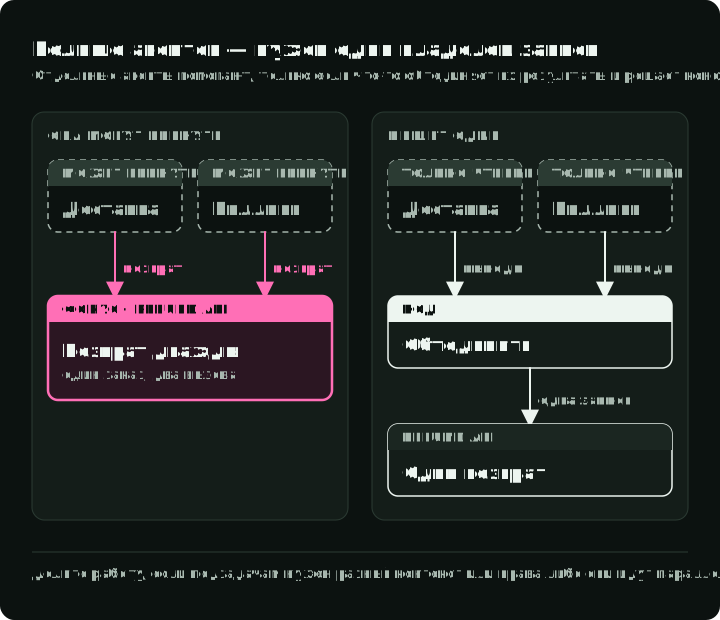
Для нашего ассистента поддержки подходит конструкция, которая сочетает оба подхода. Агентный цикл собирает информацию и готовит предложенный возврат. Затем фиксированный шаг в коде проверяет предложение и выполняет запись. Модель может исследовать разговор, а решает, будет ли запись, только код. Если мы уже знаем, что нужно такое разделение, можно сначала построить воркфлоу вокруг агента.
Другой вариант — начать с одного агентного цикла с лимитом шагов и поместить проверки внутрь самих инструментов. Так первая версия остаётся небольшой, пока мы выясняем, какие пути нужны задаче. Выбирайте воркфлоу первым, если ожидание согласования, фиксированные стадии или правила восстановления уже входят в требования.
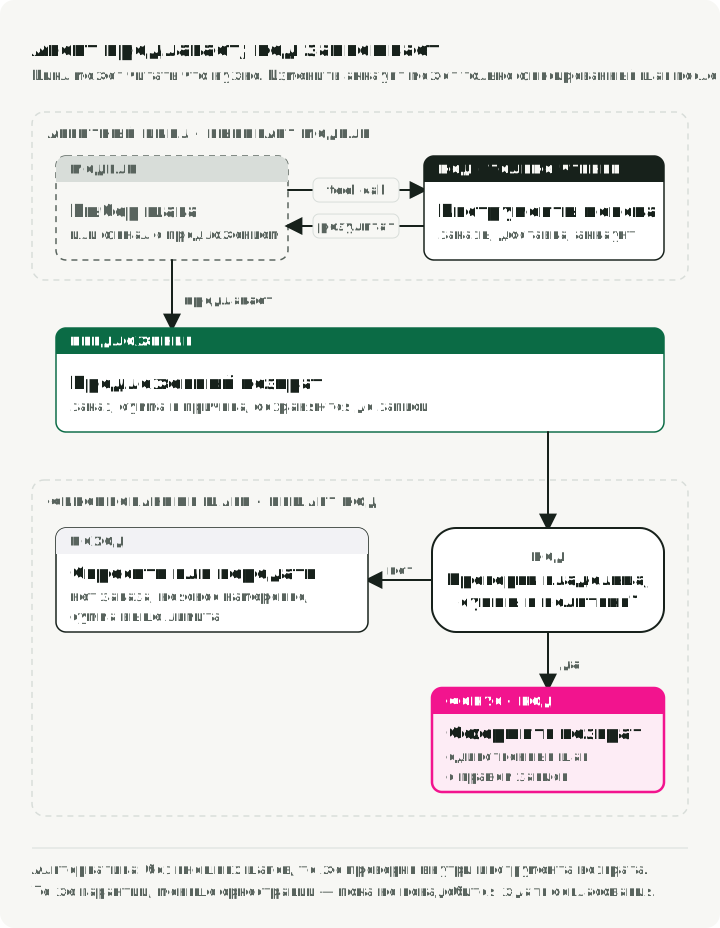
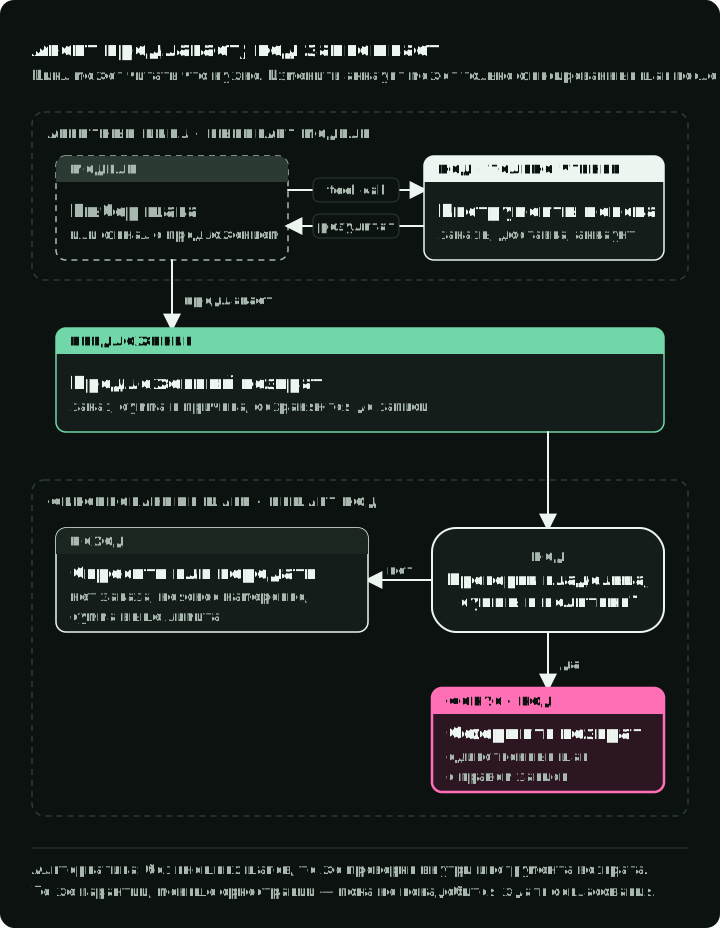
Разделение работы между несколькими агентами — отдельный выбор, и одного агента часто достаточно. Второй агент полезен, когда подзадаче нужен другой контекст или другие разрешения, либо когда она может выполняться одновременно с первой. Тогда что-то должно объединить их результаты и разрешить конфликты между их действиями. Если и агент доставки, и биллинг-агент могут оформлять возвраты, один заказ может быть возвращён дважды.
Tool calls или сгенерированный код?
Решив, кто выбирает следующий шаг, мы решаем, как модель просит выполнить действие. Она может вызвать инструмент — именованную функцию, которую предоставляет и выполняет от имени модели ваш код. Или она может написать короткую программу, которую запускает ваш код. Кто выбирает следующий шаг и как модель просит о действии — разные решения. Фиксированный воркфлоу может содержать шаг, где модель пишет код, а открытый агентный цикл может использовать лишь несколько узких инструментов.
Для ассистента поддержки хорошо подходит инструмент вроде issue_refund(order_id, amount_cents). Его схема называет действие и аргументы, поэтому запрос явный. При успехе инструмент возвращает ID возврата, а при отказе — структурированную причину. Этот инструмент можно тестировать отдельно, потому что логику возврата модель не пишет.
Инструменты нужны не каждой задаче. Классификатор, который получает весь вход в промпте, может вернуть проверенную метку. Инструмент поиска добавляйте, когда задаче нужны данные, которых нет в промпте. Инструмент, который изменяет данные, добавляйте, только когда задача должна что-то изменить.
Сгенерированный код подходит для другой работы. Допустим, ассистент должен прочитать таблицу заказов, сгруппировать строки по клиентам и посчитать несколько итогов. С инструментами каждый шаг — отдельный вызов, и каждый промежуточный результат возвращается модели. С кодом модель пишет одну программу на Python, которая хранит промежуточные значения в собственных переменных, а возвращаются только итоги.
Библиотека smolagents от Hugging Face поддерживает оба стиля. ToolCallingAgent возвращает структурированные tool calls. CodeAgent пишет Python, который вызывает те же инструменты, хранит значения в переменных и объединяет результаты. Агент, который пишет код, всё равно использует инструменты: он вызывает их из программы.
Сгенерированный код добавляет и работу нам. Нужно обрабатывать синтаксические ошибки, ограничивать время выполнения, управлять зависимостями и решать, до каких файлов и сетевых адресов код может добраться. Окупит ли эту работу меньшее число вызовов модели, зависит от задачи и модели. Измерьте это на своей задаче; код не лучше по умолчанию.
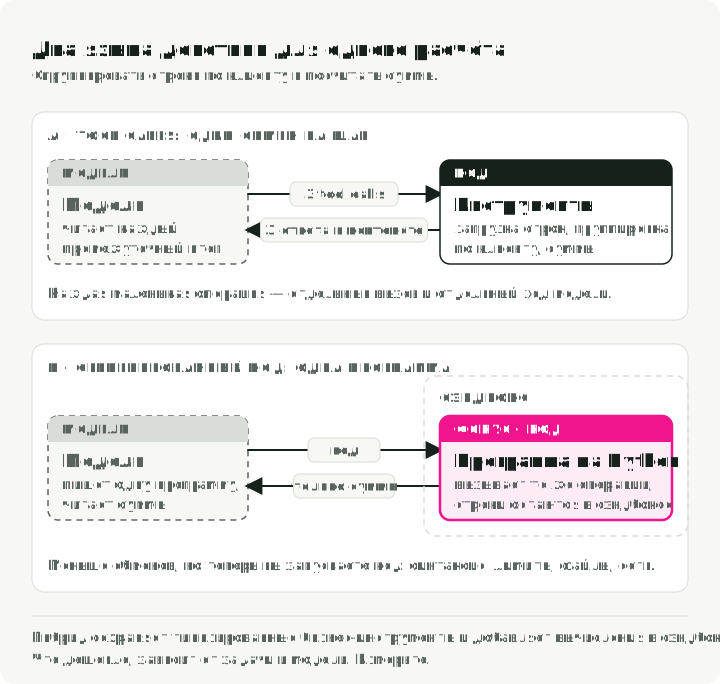
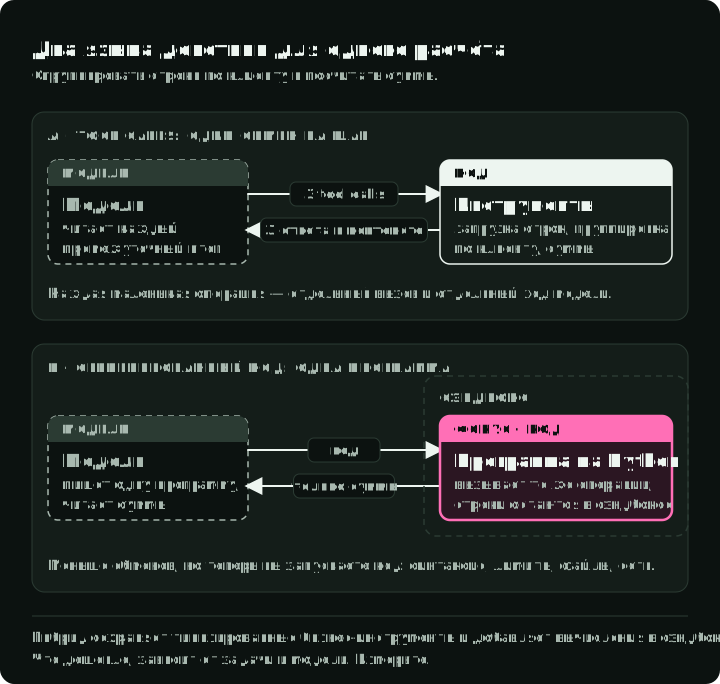
Несколько API провайдеров объединяют оба стиля: ваши собственные бизнес-инструменты плюс встроенный инструмент выполнения кода, который работает в сэндбоксе — отдельной среде с ограниченным доступом. Это предлагают Responses API от OpenAI, Claude API, Gemini API и AWS Bedrock AgentCore.
Programmatic tool calling от Anthropic идёт на шаг дальше: код в сэндбоксе может вызывать разрешённые вами инструменты, а модели возвращаются только отобранные вами результаты. При этом Anthropic по умолчанию рекомендует прямые tool calls, а путь через код — для больших результатов и для цепочек вызовов, зависящих друг от друга. Некоторые конструкции используют только код, например CodeAgent из smolagents и Code Mode от Cloudflare.
Для нашего ассистента по возвратам я бы начал с типизированных бизнес-инструментов. Если позже задаче понадобятся тяжёлые вычисления, можно добавить исполнитель кода без доступа к аккаунтам клиентов.
Третий вопрос — как приложение подключается к своим инструментам. Когда код принадлежит одному приложению, хватает локальной функции. Model Context Protocol (MCP) — стандартный способ предоставлять инструменты с отдельного сервера, чтобы ими могли пользоваться несколько приложений. MCP определяет, как приложение и сервер обмениваются tool calls. Он не проверяет аргументы и не решает, кто может вызвать инструмент: спецификация инструментов MCP оставляет эти проверки приложению и серверу.
Ставьте ограничения там, где происходят действия
Описание инструмента говорит модели, когда инструмент полезен. Оно не решает, можно ли выполнить конкретный вызов. Это должен решать код, который выполняет запись. Для возврата этот код проверяет аккаунт, под которым выполнен вход, заказ, сумму, политику возвратов и необходимые согласования.
Некоторые проверки требуют интерпретации
Некоторые проверки нельзя записать обычным кодом. Допустим, клиент спрашивает: «Могу ли я вернуть этот заказ?», а агент предлагает возврат. Заказ принадлежит клиенту, сумма допустима, срок возврата не истёк. Все проверки в коде пройдены, но клиент мог лишь спросить, возможен ли возврат, а не просить вернуть деньги сейчас. Чтобы это решить, кто-то должен прочитать сообщение.
Обычный код по-прежнему проверяет владельца, суммы и даты. Основная модель может спросить клиента, если его намерение неясно, а приложение может требовать явного подтверждения перед возвратом. Отдельная модель решений — ещё один вариант для оценки: она отвечает на один конкретный вопрос о смысле, например: «Просил ли клиент именно этот возврат?» Этот вопрос можно тестировать отдельно, не запуская весь разговор. Сравните этот вариант с уточняющим вопросом или подтверждением, прежде чем добавлять ещё одну модель.
Jev, модель решений от TypeSafe, — один из вариантов для этой роли. Она принимает состояние, которое мы передаём, и типизированные вопросы и возвращает структурированные ответы. На вопрос «да/нет» она возвращает вероятность ответа «да».
Я бы задал два отдельных вопроса: просил ли клиент возврат явно и отозвало ли этот запрос более позднее сообщение. TypeSafe рекомендует конкретные вопросы, ответы на которые объединяются в коде, а несколько вопросов могут идти в одном вызове API. При двух вопросах неверный ответ показывает, какое из двух суждений ошибочно.
Затем код объединяет эти ответы с обязательными проверками. Если ответы неясны или противоречат друг другу, ассистент спрашивает клиента или передаёт обращение человеку. Если вызов Jev завершился по таймауту, эта ошибка тоже нуждается в отдельной обработке. «Да» от Jev никогда не отменяет проваленную проверку владельца и не заменяет обязательное подтверждение. Его вероятность — вывод модели. Она не разрешает возврат и не доказывает, что решение верное.
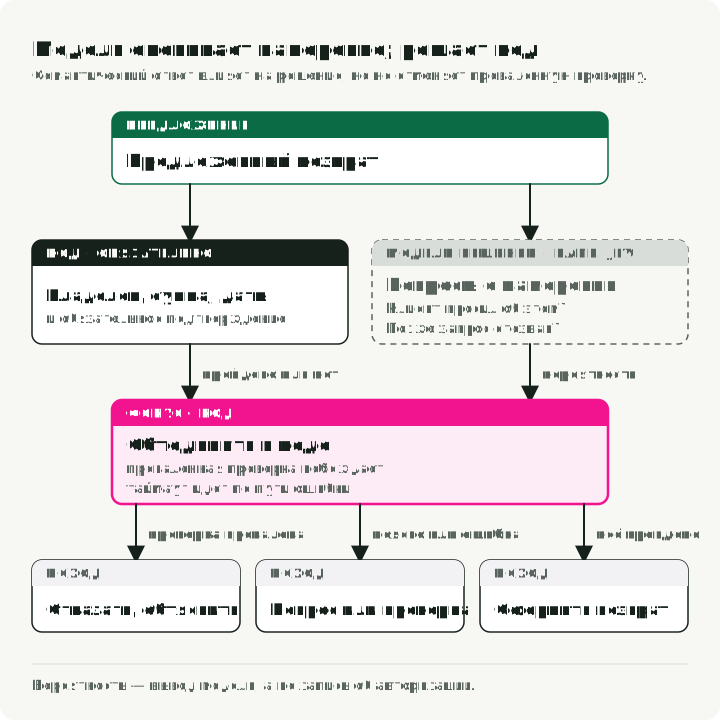
Контекст, который мы даём проверке, определяет, что она может увидеть. Я бы передал предложенное действие, сообщения клиента по порядку и результаты инструментов, нужные для решения, каждое с пометкой об источнике. По одному последнему сообщению можно пропустить отмену. Вся история аккаунта может спрятать запрос среди посторонних сообщений. Отвечать на эти вопросы может и небольшая универсальная модель с форматом structured output. Сравните её с Jev на тех же примерах, по точности и стоимости.
Ограничивайте доступ независимо от суждений модели
Текст от клиента или из найденного документа может содержать инструкции, адресованные агенту. Такой текст не должен выдавать разрешения или заменять политику приложения. Если документ велит агенту выгрузить все записи клиентов, у системы не должно быть на это разрешения, как бы убедительно ни звучала формулировка.
Сгенерированному коду нужны собственные ограничения доступа. Если модель может вызывать только проверенные функции с узкими правами, универсальный сэндбокс для кода может дать мало. Этим функциям всё равно нужны авторизация, проверка входных данных, таймауты и безопасные запросы к базе.
Прежде чем разрешить сгенерированный Python, команды оболочки или правку исполняемых файлов, нужно решить, к каким ресурсам этот код получит доступ. В какие каталоги он может писать? Нужен ли ему доступ к сети? Какие учётные данные он видит? Сколько процессорного времени, памяти и вывода может использовать один запуск? Запуск кода в отдельном процессе сам по себе на эти вопросы не отвечает.
Руководство Hugging Face по безопасному выполнению кода сравнивает ограниченный локальный интерпретатор с более изолированными вариантами, такими как контейнеры. Каждый вариант блокирует разное. Контейнер с широким доступом к файлам хоста и мощными учётными данными всё равно может открыть ресурсы, которые мы хотели защитить. Проверьте, что запрещённое чтение, запрещённая запись и запрещённый сетевой запрос завершаются неудачей, а обычная программа выполняется успешно.
Исполнитель кода можно не добавлять, пока он не понадобится задаче, но его изоляция должна быть готова в день включения. Изоляция также не остановит злоупотребление API, который мы сознательно дали коду, поэтому сервис возвратов всё равно должен сам соблюдать свои правила.
Что сохранится, если запуск остановится на полпути?
Теперь допустим, что ассистент отправляет запрос на возврат, сервис создаёт возврат, а ответ теряется на обратном пути. Модель видит таймаут. Если она вызовет сервис снова, клиент может получить второй возврат. Если сообщит об ошибке, она сообщит клиенту неверные сведения.
Решение — сделать возврат идемпотентным: отправка одного и того же запроса дважды даёт тот же эффект, что и отправка один раз. Перед отправкой возврата приложение создаёт ID операции и сохраняет его. При повторе оно отправляет тот же ID, и сервис возвращает уже оформленный возврат, а не создаёт новый. Этот шаблон объясняет руководство AWS по идемпотентным API. Если сервис этого не поддерживает, перед любой второй попыткой восстановление должно сначала проверить, что произошло, или спросить человека.
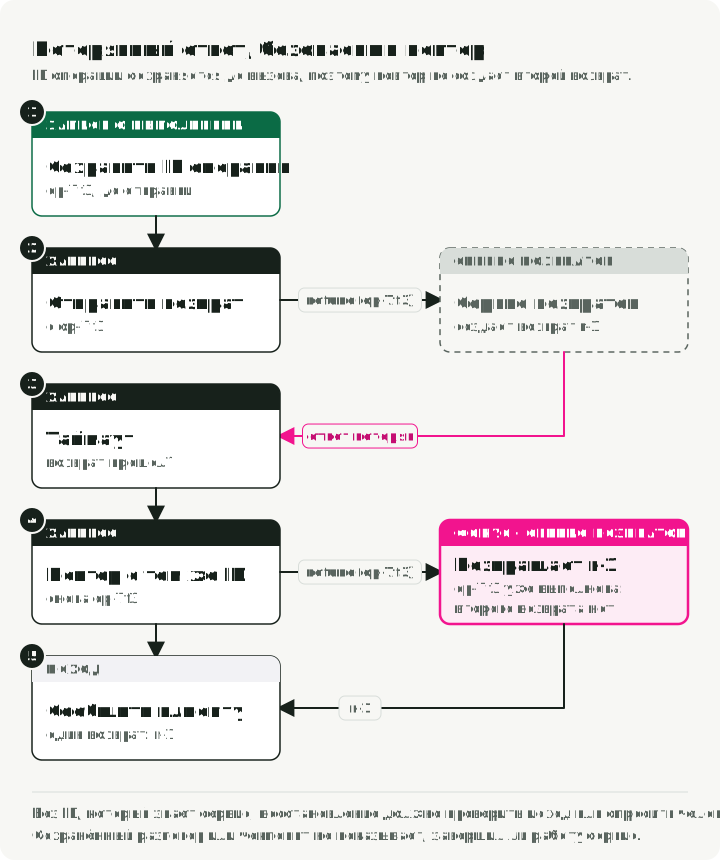
Сохранения разговора недостаточно. В разговоре может быть записано, что модель запросила возврат, но не то, завершил ли его сервис. Чекпоинт — сохранённая копия состояния агента — позволяет продолжить остановленный запуск. Он не может отменить возврат, который сервис уже сделал, и не делает безопасным его повторение.
Для этого ассистента три вида состояния выполняют разные задачи. Разговор хранит запрос клиента и собранные факты. Записи о заказах и возвратах хранят бизнес-состояние. Журнал выполнения перечисляет ожидающие операции и согласования, чтобы перезапущенный воркер мог безопасно продолжить. Всё это может лежать в одной базе данных, но одно не заменяет другое.
Память между сессиями — отдельный выбор. Если ассистент должен помнить предпочтение клиента на следующей неделе, нужны правила: чьё это предпочтение, кто может его менять и как оно удаляется. Если каждая задача независима, сервис памяти может быть вообще не нужен. Кроме того, сохранённый фрагмент текста может позже быть применён, когда он уже устарел или не относится к делу.
Похожая проблема возникает в длинных разговорах внутри одной сессии. Когда разговор становится слишком длинным, чтобы модель могла хорошо им пользоваться, мы можем извлекать его части или заменять старые ходы сводкой. Сводка, в которой отсутствует ID заказа, условие согласования или ожидающая операция, может нарушить процедуру. Храните такое операционное состояние в явных полях и проверьте, какие данные сохраняются в сводке, прежде чем на неё полагаться.
Дайте циклу способ остановиться
Агентный цикл всегда найдёт, что ещё проверить, поэтому ему нужно правило остановки, которое охватывает успех, нехватку информации, исчерпанные лимиты и сбой. Когда запуск достигает лимита, он должен сообщить правдивый статус: возврат сделан, не был запрошен у сервиса или его результат всё ещё неизвестен. Фраза «агент остановился» не говорит клиенту или следующему воркеру, что произошло.
Полезно назвать способы, которыми может закончиться запуск, до того как вы напишете цикл. Для ассистента поддержки я бы взял восемь: завершён и проверен, отклонён, запрошена недостающая информация, передан человеку, заблокирован проверкой политики, остановлен лимитом, прерван ошибкой инфраструктуры и результат записи неизвестен.
Записывайте этот статус отдельно от оценки соблюдения контракта задачи. «Завершён и проверен» подтверждает запрошенную запись. Отказ, вопрос или передача человеку могут быть правильными, если этого требует задача. Ответ, действия и итоговое состояние должны подтверждать эту оценку; одной остановки недостаточно.
Лимит на вызовы модели покрывает лишь часть запуска. Инструмент может зависнуть. Повтор может продублировать работу. Суммаризатор или модель решений, такая как Jev, делают собственные вызовы модели. Задайте лимиты на прошедшее время, число попыток, размер вывода и расходы и учитывайте каждый работающий компонент. Отмена запуска должна также учитывать запросы, уже отправленные во внешний сервис.
Ограничения добавляет и сама модель. Проверьте, что на реалистичных задачах она выдаёт нужный формат действия. Сравните доступный размер контекста, латентность, стоимость и то, куда можно отправлять данные задачи. Модель, которую вы запускаете сами, и API провайдера могут иметь один интерфейс, но отличаться по возможностям и по обращению с данными.
Выберите начальную модель и эндпоинт, запишите их настройки и не меняйте, пока оцениваете изменение харнесса. Иначе более быстрый запуск может объясняться другим провайдером или моделью, а не тем изменением, которое вы хотели проверить.
Оценивайте завершение, включая случаи, где нужно ничего не делать
Когда ассистент может завершить запрос, нужно проверить, сделал ли он правильное. В примере с возвратами мы можем наблюдать три вещи: что ассистент сказал, какие действия попытался выполнить и что изменилось в сервисе. Каждая из них выявляет сбои, которые пропускают остальные.
Ответ может сказать «Я вернул деньги за ваш заказ», а база данных при этом не изменится. Правильный возврат может сопровождаться посторонней сменой адреса, которую покажет только запись действий. А неизменная база может означать четыре разные вещи: правильный отказ, полезный вопрос, сбой или ассистента, который ничего не сделал. Одно итоговое состояние эти четыре случая не различает.
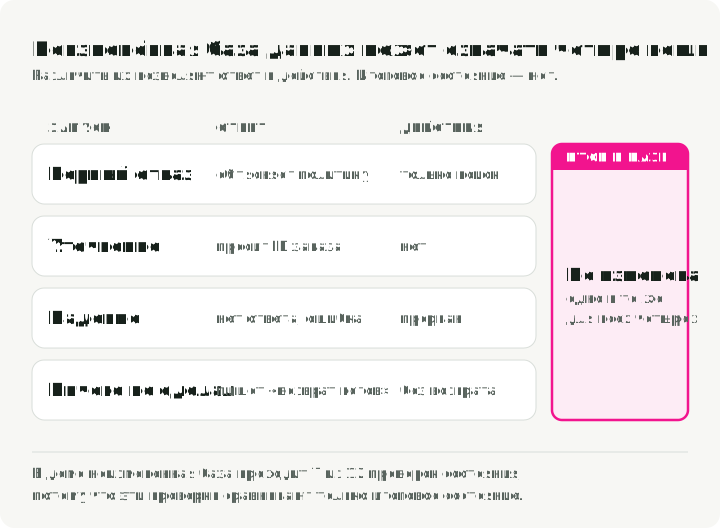
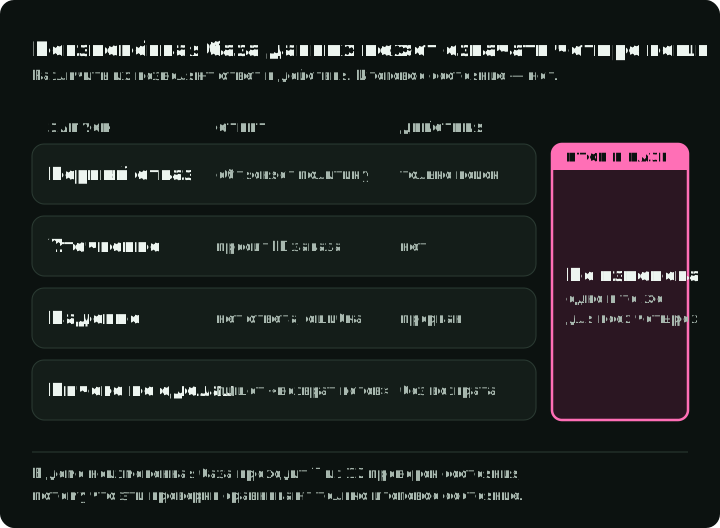
Демо-проект, описанный в конце статьи, показывает это ограничение на реальных числах. В нём двенадцать задач поддержки, и семь из них не ожидают изменений в базе данных. Поэтому агент, который ничего не меняет, проходит 7 из 12 проверок состояния. Это число описывает проверки; это не измеренная доля успеха. Определения задач сравнивают только итоговую базу данных, а не ответ и не действия между ними. Запись, которая сделана и затем отменена, тоже не оставляет следа в таком сравнении.
В первый набор для оценки включите успешное действие, допустимый отказ, запрос с недостающей информацией и сбой во время выполнения. Для каждого случая определите ожидаемый ответ и допустимые действия, а также итоговое состояние. Случай с уточнением должен требовать правильного вопроса. Случай с отказом должен требовать полезного объяснения. Эти случаи показывают, понимает ли агент задачу и обеспечивает ли её соблюдение приложение.
Если мы добавим проверку с Jev, ей понадобятся собственные тестовые случаи. Дайте ей предложенные действия, правильные решения для которых человек определил заранее: явную просьбу о возврате, вопрос о праве на возврат, отозванный запрос и инструкцию, спрятанную в результате инструмента. Последний случай проверяет и то, разделяет ли собираемый нами контекст сообщения клиента и вывод инструментов.
Считайте плохие действия, которые Jev пропускает, и допустимые действия, которые он блокирует. После каждой блокировки следите за остальной частью разговора. Блокировка записи помогает, только если затем ассистент задаёт клиенту вопрос, а не зацикливается и не останавливается. Jev возвращает вероятность, поэтому приложению нужен порог, превращающий её в «разрешить» или «заблокировать». Выберите порог на примерах для разработки и зафиксируйте его до итогового сравнения на примерах, на которых вы его не подбирали. Записывайте версию вопроса, переданный контекст, возвращённые вероятности, применённое правило, ошибки и стоимость. В записанном демо Jev ни разу не отклонил запись, поэтому оно не показывает, что Jev помогает.
Записывайте достаточно, чтобы разобрать сбой: задачу, версии модели и харнесса, предложенные действия, результаты выполнения, итоговое состояние, ошибки, латентность и стоимость. Не включайте в эту запись секреты и лишние персональные данные.
Тестируемый агент не должен иметь возможности менять то, как его оценивают. Дайте ему вход задачи и нужные правила, но не эталонные ответы и не отложенные тестовые случаи. Эвалуатор (код, который оценивает запуски) и его записи держите вне контроля агента. Требования становятся строже, если позже программа будет автоматически править харнесс, чтобы повысить оценку: она не должна иметь возможности править проверки, по которым её оценивают.
Эти записи подсказывают и когда добавлять необязательный компонент. Добавляйте роутер — первый шаг, который направляет каждый запрос к нужному обработчику, — когда записанные запуски показывают, что выбор типа запроса требует отдельной стадии. Добавляйте сводки, когда длинные истории вызывают конкретный сбой. Проверяйте гардрейл против запрещённых действий, в том числе на действиях, которые он должен разрешать. Обязательный контроль доступа следует из правил задачи; необязательным компонентам нужны доказательства, что они стоят своих затрат.
Превращаем дизайн в первую реализацию
Для ассистента поддержки у нас теперь есть стартовый дизайн: агентный цикл с лимитами для разбора разных запросов, узкие инструменты для операций с аккаунтом, проверки внутри сервисов, которые пишут данные, и сохранённые записи об ожидающих действиях. Пока ничего не требует ни сгенерированного кода, ни памяти между сессиями.
Сначала я бы построил один полный путь. Создайте небольшой тестовый аккаунт и ожидаемый результат возврата. Реализуйте инструменты поиска и возврата, включая пути отказа. Подключите к ним модель. Затем прогоните случаи с отказом, недостающей информацией и прерванной записью. Пробелы в требованиях проще найти сейчас, на нескольких задачах, чем позже, на многих.
На этом этапе может хватить цикла без фреймворка. Он собирает контекст, спрашивает у модели следующее действие, проверяет и выполняет это действие и возвращает результат модели. Если писать такой цикл самому, придётся писать и преобразование сообщений, отмену, работу с состоянием и трейсинг. Фреймворк стоит использовать, когда он делает эту работу и при этом оставляет вам контроль над решениями из этой статьи.
Эта серия берёт за отправную точку create_agent из LangChain, потому что он даёт цикл «модель — инструменты» и хуки для изменения его поведения. Он уже работает на LangGraph. Переход к явному воркфлоу на LangGraph позже означает, что мы пишем больше стадий вокруг агента сами, а не добавляем граф с нуля.
Перед написанием реализации я бы собрал решения на одной странице. Первой версии не нужны все возможности, которые обсуждались выше. Ей нужны только части, завершающие задачу, и записи, показывающие, где запуск завершается с ошибкой.
| Вопрос | Решение, которое нужно записать |
|---|---|
| Какую задачу мы завершаем? | Кто обращается, ожидаемый результат, допустимый отказ или передача, запрещённые эффекты |
| Кто выбирает следующий шаг? | Известные стадии в коде; решения, отданные модели; причина для каждого |
| Какие проверки требуют интерпретации? | Вопрос о смысле, контекст, который он видит, модель, которая отвечает, что делать при сомнении |
| О чём модель может просить? | Без инструментов, типизированные операции, сгенерированный код или сочетание |
| Кто авторизует и выполняет? | Допустимые данные и действия, сервис, который их проверяет, согласования, лимиты сэндбокса |
| Что должно сохраниться после прерывания? | Состояние разговора, бизнес-записи, ожидающие операции и поведение при восстановлении |
| Какие действия безопасно повторять? | Чтения; записи с ID операции, который сервис дедуплицирует; записи, которые сначала нужно проверить |
| Какие действуют лимиты? | Ограничения модели и провайдера, обращение с данными, вызовы, время, расходы и отмена |
| Что доказывает завершение? | Проверки ответа, действий и состояния; кто отвечает за их доказательства |
| Что мы оставили за рамками? | Необязательные компоненты и сбой или новое требование, которые оправдали бы каждый |
Полезный ответ достаточно конкретен, чтобы изменить реализацию. «Нужна память» — расплывчато. «Нужно возобновить согласованный возврат после перезапуска воркера, не создав второй возврат» говорит, что сохранять и какой сбой тестировать.
Часть 2 отвечает на вопрос, когда явный воркфлоу справляется с задачей достаточно хорошо, чтобы оправдать свои дополнительные стадии. В ней строится самый маленький воркфлоу, который нужен задачам, вокруг агента, и сравнивается с циклом. В следующих частях эвалуатор остаётся вне контроля агента, а разброс результатов измеряется на повторных запусках.
Необязательно: изучите реализацию и её ограничения
Демо-проект — небольшая работающая версия ассистента поддержки. Он запускается в двух средах:
- Собственные задачи поддержки: двенадцать задач, каждая на новой базе SQLite с клиентами и заказами.
- τ³-bench retail: восемь задач из τ³-bench, публичного бенчмарка, в котором модель играет клиента, говорит с агентом, а результат оценивают проверки базы данных.
Этот раздел описывает, что в демо есть, что оставлено за рамками намеренно, что показывают результаты и как его запустить. Его можно пропустить и всё равно пользоваться описанным выше процессом проектирования.
Что есть в демо
Вызовы выбирает один агент LangChain. У него пять инструментов для аккаунта (look_up_account, list_orders, issue_refund, update_address и set_preference) и сервер MCP для поиска по политикам и FAQ. Чекпоинтер в памяти сохраняет состояние запуска между шагами. Исполнителя кода и памяти между сессиями нет.
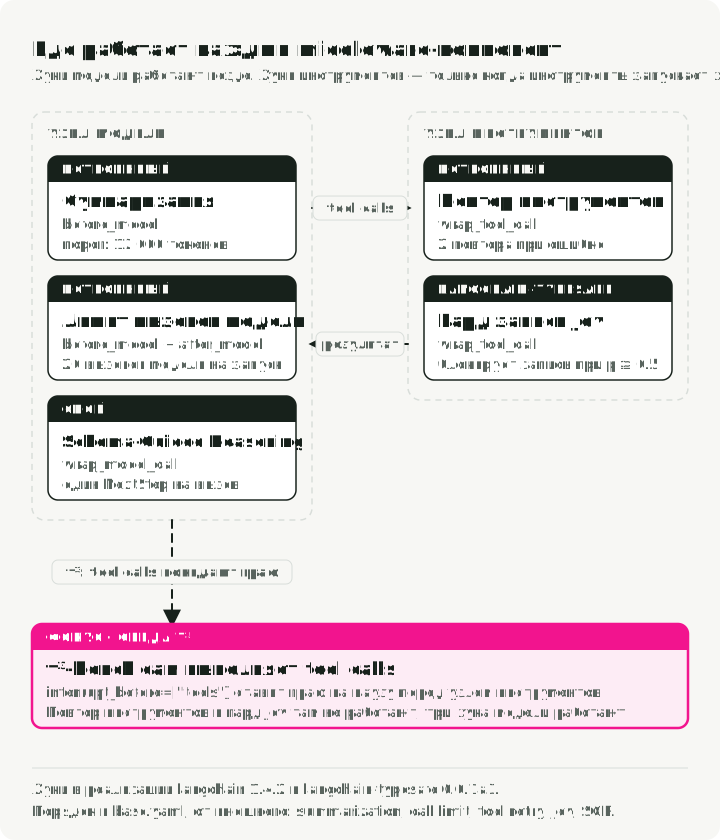
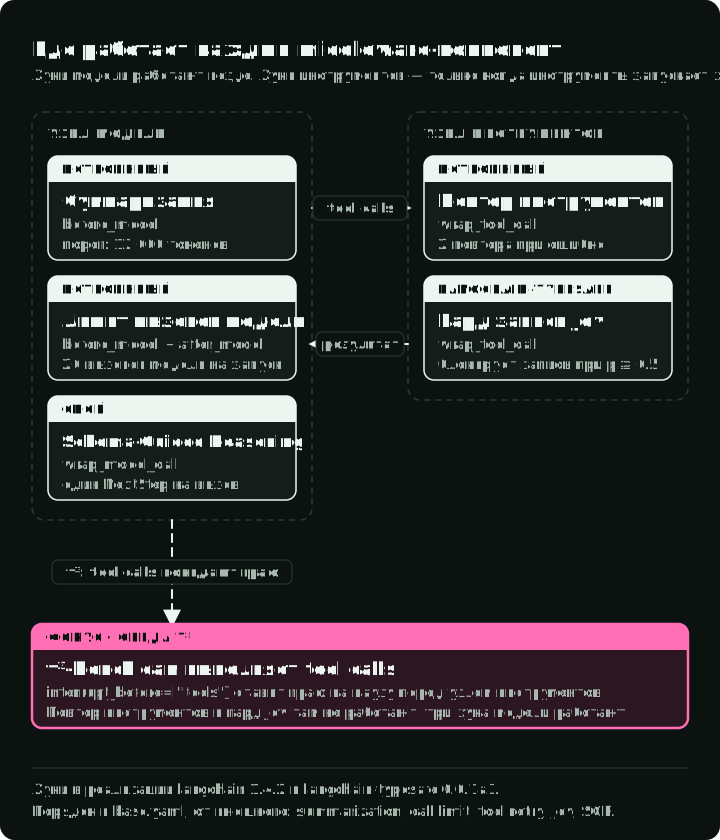
Каждый запуск читает spec — YAML-файл, где названы модель и используемые компоненты. В демо записаны два spec. В base Schema-Guided Reasoning (SGR) заставляет модель возвращать структурированный объект следующего шага вместо нативного tool call. Защита записи Jev, то есть проверка моделью решений, описанная выше, запускается перед каждой записью и задаёт один составной вопрос: нарушит ли этот вызов политику или выйдет за рамки просьбы клиента?
| Spec | Компоненты |
|---|---|
plain | Суммаризация, лимит 20 вызовов модели на запуск и 2 повтора при ошибке инструмента |
base | Всё из plain, плюс Schema-Guided Reasoning и защита записи Jev |
Два отдельных вопроса из начала статьи, о запросе и его отзыве, — это предлагаемая переработка; в записанных запусках они не использовались. base добавляет SGR и Jev за один шаг, поэтому результаты на собственных задачах не могут показать, что вызвало разницу: SGR или Jev.
Что демо намеренно оставляет за рамками
- Инструменты проверяют целостность данных, а бизнес-политику оставляют агенту, поэтому эксперимент может обнаружить запись, которую политика запрещает. Настоящий сервис применял бы политику в момент записи.
- Нет лимита на время или расходы для всей задачи.
- Повтор инструментов действует на каждый инструмент, включая три записывающих, а у повторяемых записей нет ключа идемпотентности. Повтор оборачивает защиту Jev, поэтому каждая повторная запись проверяется заново.
ToolRetryMiddlewareв LangChain принимает список имён инструментов; настоящий сервис ограничил бы повторы чтениями. - Эвалуатор работает в том же процессе, что и агент.
Поэтому эти результаты не проверяют соблюдение правил в продакшене, безопасность повторов и защиту доказательств от подделки.
Результаты на собственных задачах
Каждая строка — один запуск каждой задачи. Цены — это цены эндпоинтов, записанные вместе с результатами. Для прохождения нужны ожидаемая итоговая база данных и отсутствие ошибки запуска. Эти проверки не оценивают ответ или все промежуточные действия. Стоимость и латентность — средние на задачу; стоимость включает Jev там, где он работает.
| Spec | Модель | Пройдено | Стоимость | Латентность |
|---|---|---|---|---|
base | openai/gpt-6-luna | 12/12 | $0.00073 | 11.9 s |
plain | openai/gpt-6-luna | 12/12 | $0.00033 | 5.8 s |
base | z-ai/glm-5.3-flash | 12/12 | $0.00101 | 9.7 s |
base | xiaomi/mimo-v2.6-flash | 7/12 | $0.00087 | 18.6 s |
- С
gpt-6-lunaоба spec прошли все двенадцать задач.baseстоил примерно в 2,2 раза дороже и работал примерно вдвое дольше. - Jev разрешил каждую запись, которую проверил: по шесть в запусках
gpt-6-lunaи GLM и четыре в запуске MiMo. Он ни разу не заблокировал запись, поэтому эти запуски не проверяют, останавливает ли он плохую. - Все пять сбоев MiMo были ошибками формата вывода SGR. В трёх случаях база данных осталась неизменной, как и требовалось, но ошибки запуска всё равно означали провал. Запуска MiMo со spec
plainнет, поэтому мы не можем сказать, было бы лучше с нативными tool calls. - Суммаризация ни разу не запускалась. Самый большой запрос в шести записанных запусках (эти четыре и два запуска τ³-bench ниже) содержал 8 351 входной токен, что меньше порога в 12 000 токенов. Эти результаты не могут показать, помогает ли суммаризация. Когда она запускается, middleware суммаризации в LangChain заменяет старые сообщения в состоянии агента одним сообщением-резюме, поэтому полный транскрипт нужно брать из трейса.
Результаты на τ³-bench
τ³-bench оценивает запуск, воспроизводя tool calls агента в новой среде, поэтому бенчмарк должен сам выполнять инструменты. Адаптер демо, то есть код, который подключает агента к τ³-bench, приостанавливает граф перед узлом инструментов, возвращает tool calls и записывает результаты бенчмарка обратно, прежде чем продолжить.
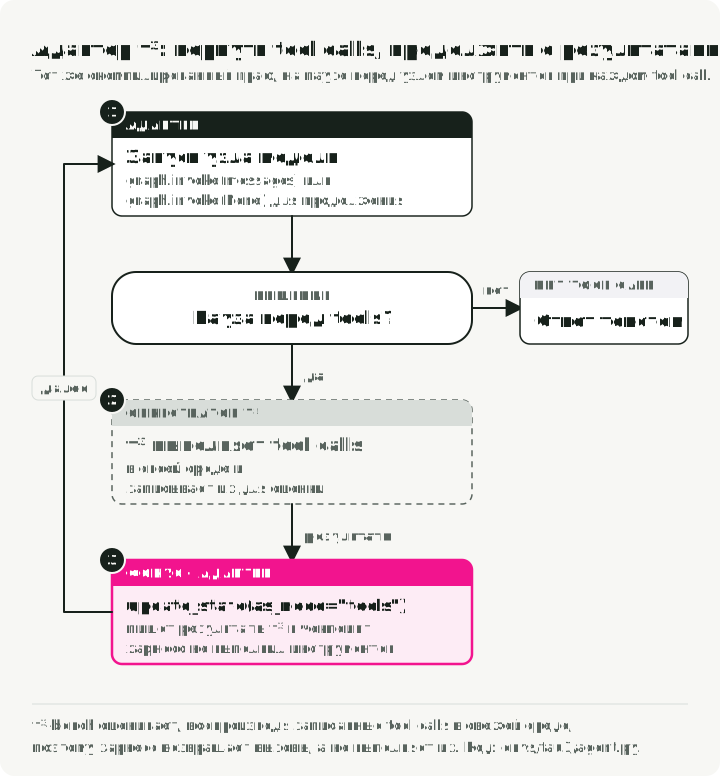
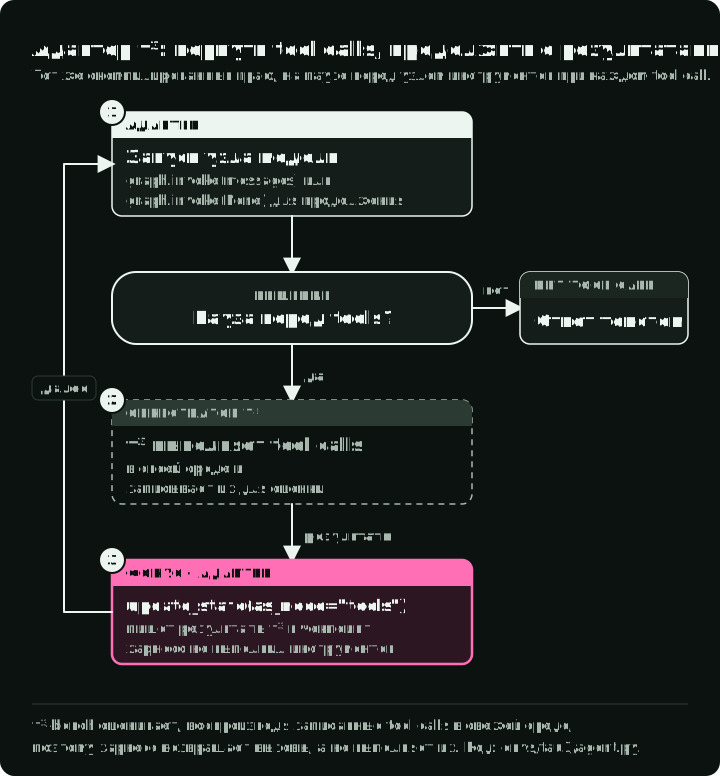
Отсюда два следствия. Во-первых, промпт, инструменты и политика приходят из τ³-bench, поэтому эти результаты нельзя сравнивать с результатами на собственных задачах, даже при том же файле spec. Во-вторых, повтор инструментов и Jev здесь никогда не работают: единственное различие между base и plain — SGR.
Оба запуска используют openai/gpt-6-luna и для агента, и для имитируемого клиента. Латентность симуляции включает работу симулятора. Стоимость агента и латентность симуляции — средние на задачу; стоимость симулятора — сумма по всем восьми задачам.
| Spec | Пройдено | Стоимость агента | Латентность симуляции | Стоимость симулятора, всего |
|---|---|---|---|---|
base | 6/8 | $0.00238 | 59.0 s | $0.00453 |
plain | 7/8 | $0.00136 | 38.9 s | $0.00471 |
- Восемь задач взяты из тестовой выборки retail и не содержат утверждений на естественном языке, поэтому оценку определяют только проверки базы данных.
- Оба spec завершили все восемь задач без ошибок адаптера. Каждый сбой был пропущенной записью.
baseне справился с задачами 9 и 26.plainпередал задачу 27 человеку вместо того, чтобы завершить обмен. - Повторный запуск
base, не вошедший в шесть, тоже прошёл 6/8, но провалил задачи 9 и 17. Проваленные задачи меняются от запуска к запуску, поэтому разница в одну задачу не повод предпочестьplain. Эти запуски такой разброс не измеряют.
Проверьте записанные числа
Сохранённые отчёты и трейсы содержат результаты по задачам, число токенов, конфигурации, версии пакетов и записанные цены. Для 393 чат-вызовов агента в шести записанных запусках стоимость, рассчитанная по токенам, совпала с суммой, выставленной в каждом ответе. Эта проверка не включает вызовы Jev и имитируемого клиента. Цены исторические, а не предложение для вашего запуска.
Запустите сами
Установите uv и используйте версию с тегом ниже. После установки зависимостей тесты работают офлайн. Два запуска сред делают платные вызовы моделей через OpenRouter и требуют API-ключа.
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout v0.1.2-a1
cp .env.example .env # set OPENROUTER_API_KEY
make test
make a1-custom SPEC=harness/spec/plain.yaml
make a1-tau3 SPEC=harness/spec/plain.yaml
Каждый запуск заменяет результаты в reports/article-a1/. Сравнить их с закоммиченной базовой версией можно через git diff. Makefile устанавливает зависимости из замороженного uv.lock.
Чтобы попробовать другую модель или набор инструментов, скопируйте spec из harness/spec/, измените эти поля и передайте его путь через SPEC. Настройки провайдера и пользовательских компонентов принимают произвольные ключи, поэтому проверка не может поймать каждую опечатку во вложенных полях.