Projektowanie harnessu agenta: od zadania do architektury

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Harness agenta to kod wokół modelu językowego, dzięki któremu model może wykonać zadanie. Dostarcza modelowi instrukcje i dane, uruchamia akcje, o które model prosi, śledzi postęp i decyduje, kiedy zadanie jest ukończone. Ten artykuł jest dla inżynierów, którzy dodają agenta do własnej aplikacji. Pokazuje, jak zaprojektować ten kod na podstawie zadania: które kroki wybiera model, które kroki kod ustala z góry i jakie reguły kod egzekwuje niezależnie od tego, co powie model.
Podejmij te decyzje, zanim wybierzesz framework do agentów, bo odpowiedzi różnią się w zależności od zadania. Asystent wsparcia zmienia konta klientów, więc potrzebuje kontroli uprawnień i bezpiecznego sposobu ponowienia płatności. Agent programistyczny edytuje pliki i uruchamia testy, więc potrzebuje miejsca, w którym jego kod może działać bez szkody dla reszty systemu. Klasyfikator dokumentów zwraca tylko etykietę, więc może w ogóle nie potrzebować narzędzi. Jeśli wszystkie trzy zaczynają od tej samej pętli, magazynu pamięci i zestawu narzędzi, nikt nie pyta, czego potrzebuje każde z zadań.
Prześledzimy te decyzje na jednym przykładzie, asystencie wsparcia klienta, który realizuje zwroty pieniędzy: od opisu zadania do pierwszej implementacji. Artykuł rozwija tekst Inżynieria harnessu dla agentów AI, który opisuje, za co odpowiada harness. Tutaj wybieramy te obowiązki dla jednego projektu.
Dlaczego model potrzebuje harnessu
W naszym asystencie wsparcia model może zaproponować zwrot, ale sam go nie zrealizuje. Kod musi znaleźć konto klienta, wczytać zamówienie, sprawdzić, czy zwrot jest dozwolony, wywołać usługę płatności i zapisać wynik. Jeśli usługa płatności przekroczy limit czasu, kod musi też zdecydować, czy druga próba jest bezpieczna. Te zadania zostają nawet wtedy, gdy model bardzo dobrze wybiera następny krok.
Część tego kodu może już istnieć w twojej aplikacji. LangChain, framework do agentów, którego ta seria używa dalej, definiuje harness szeroko: cały kod, konfiguracja i logika uruchamiania wokół modelu. Pod tę definicję podpadają logowanie, dostęp do bazy danych, kolejka zadań i krok zatwierdzania. Projektowanie harnessu obejmuje decyzję, jak agent z nich korzysta. Nie musisz ich odtwarzać wewnątrz frameworka do agentów.
Harness może być mały albo duży. Najmniejszy robi jedno wywołanie modelu, waliduje wynik i go zwraca. Większy pozwala modelowi czytać pliki, uruchamiać programy i poprawiać swoją pracę przez wiele tur. Oba muszą odpowiedzieć na dwa pytania: którymi częściami zadania zajmuje się model i jak sprawdzimy, że zrobił to poprawnie?
Opisz wynik, zanim opiszesz agenta
„Obsłuż prośby o zwrot” nie mówi jeszcze, co asystent ma zrobić. Załóżmy, że klient prosi o zwrot za dostarczone zamówienie. Przebieg kończy się sukcesem, jeśli zwraca pieniądze za właściwe zamówienie we właściwej kwocie, wyjaśnia klientowi wynik i niczego innego na koncie nie zmienia. Jeśli prośba łamie politykę zwrotów, poprawnym wynikiem jest jasna odmowa. Jeśli asystent nie wie, o które zamówienie chodzi klientowi, powinien zapytać.
Zwrot, odmowa i pytanie to trzy różne poprawne wyniki. Jeśli uznamy za sukces każdą rozmowę, która kończy się bez błędu, nie odróżnimy ich od siebie ani od błędnej odpowiedzi, która skończyła się uprzejmie.
Poprawny zwrot zależy też od tego, kto prosi. Klient może wpisać dowolny numer zamówienia, więc numer w wiadomości nie dowodzi, że zamówienie należy do niego. Aplikacja musi dostarczyć zalogowane konto, a usługa zwrotów musi sprawdzić, czy zamówienie do niego należy. Model potrafi przeczytać prośbę, ale nie potrafi udowodnić, kim jest wywołujący.
Mamy teraz początek kontraktu zadania: zmiany, które liczą się jako sukces, zmiany zakazane oraz sytuacje, w których asystent musi zadać pytanie albo przekazać sprawę człowiekowi. Niektórych z tych wymagań nie da się spełnić samym promptem. Maksymalną kwotę zwrotu musi sprawdzać usługa, która zwroty wystawia. Cel czasu odpowiedzi wymaga limitu czasu w kodzie. Wznowienie sprawy jutro wymaga zapisanego stanu.
Skoro zadanie jest opisane, możemy zdecydować, jak dużą część procedury oddać pod kontrolę modelu.
Ile procedury już znamy?
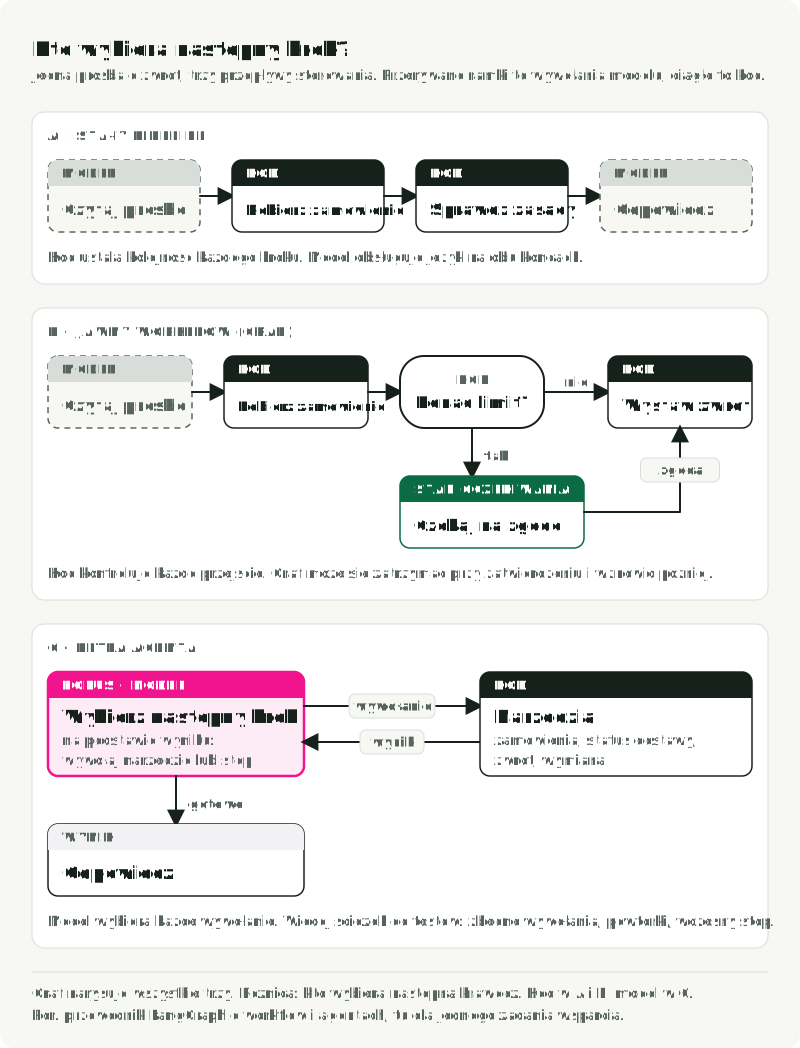
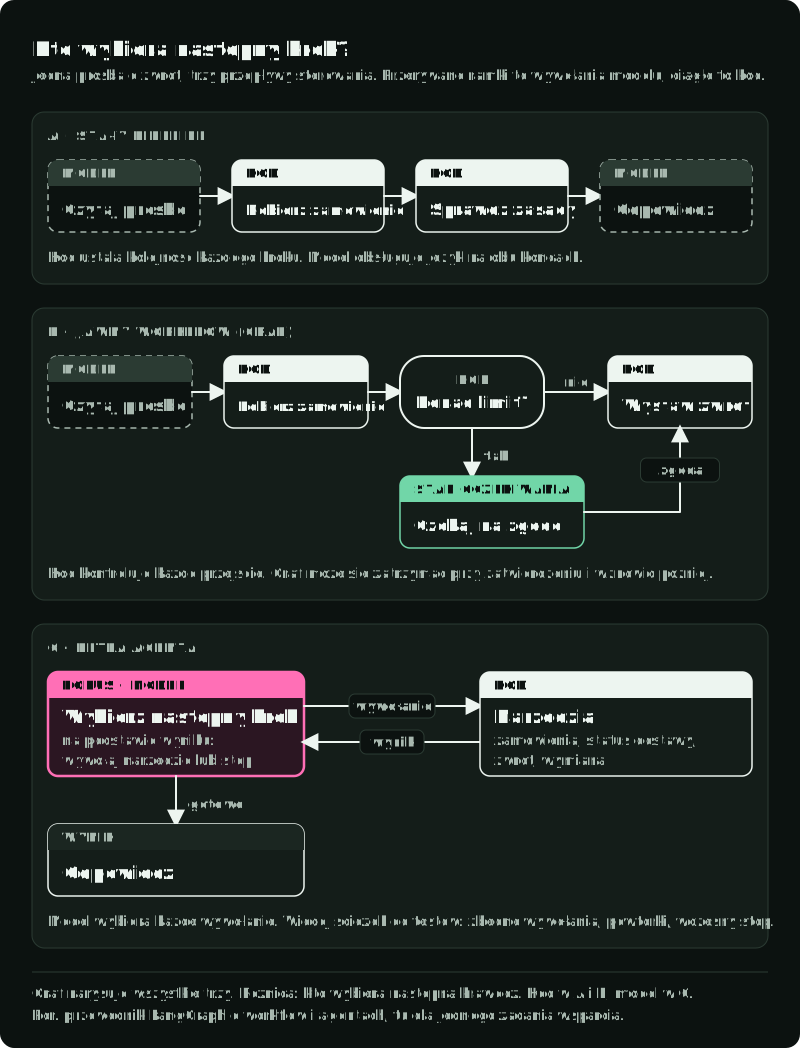
Jeśli każda prośba przechodzi te same kroki (wyodrębnij numer zamówienia, pobierz zamówienie, sprawdź uprawnienie do zwrotu, wykonaj dozwolony zwrot i wyjaśnij wynik), możemy zapisać te kroki w kodzie jako stały potok. Nieudana kontrola powoduje pominięcie zwrotu. Model zajmuje się językiem na początku i na końcu. Nie potrzebuje dodatkowego wywołania, żeby zdecydować, czy pobrać zamówienie, którego potrzebuje każda prośba.
Jawny przepływ pracy dodaje rozgałęzienia i stany oczekiwania, którymi steruje kod. Zwrot powyżej limitu może czekać na zatwierdzenie. Zmiana adresu może być dozwolona tylko przed wysyłką zamówienia. Te etapy możemy narysować jako graf kroków, a kod decyduje, który krok jest następny.
Pętla agenta pozwala modelowi wybierać każdy krok. Model wybiera akcję, czyta wynik i wybiera ponownie, aż zdecyduje się odpowiedzieć. To pomaga w rozmowie mieszanej: klient zaczyna od skargi na dostawę, potem mówi, że przyszedł zły produkt, a na końcu prosi o wymianę. Następne przydatne sprawdzenie zależy od tego, co asystent dotąd ustalił. Koszt jest taki, że pętla może przejść wieloma ścieżkami, a każdą trzeba przetestować: model może wykonywać zbędne wywołania, powtarzać sprawdzenie albo przestać, zanim zadanie jest skończone.
Przewodnik LangGraph o przepływach pracy i agentach opisuje ten sam podział: przepływy pracy idą ścieżkami ustalonymi z góry, a agenci wybierają kroki w trakcie działania. LangGraph, biblioteka grafów leżąca pod LangChain, potrafi zbudować jedno i drugie, więc system zbudowany jako graf nadal może zawierać agenta.
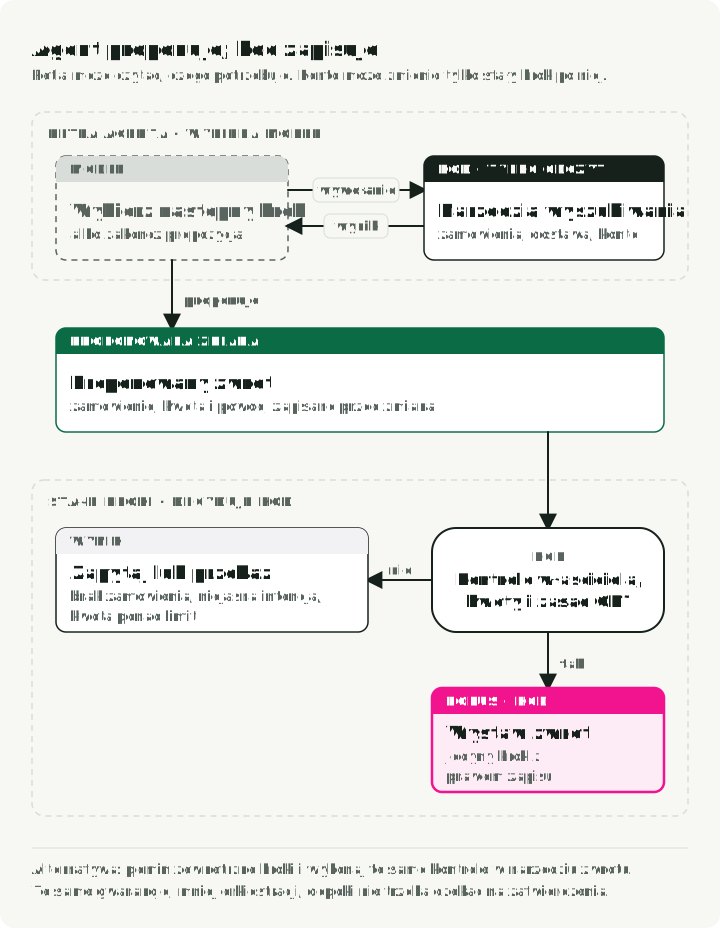
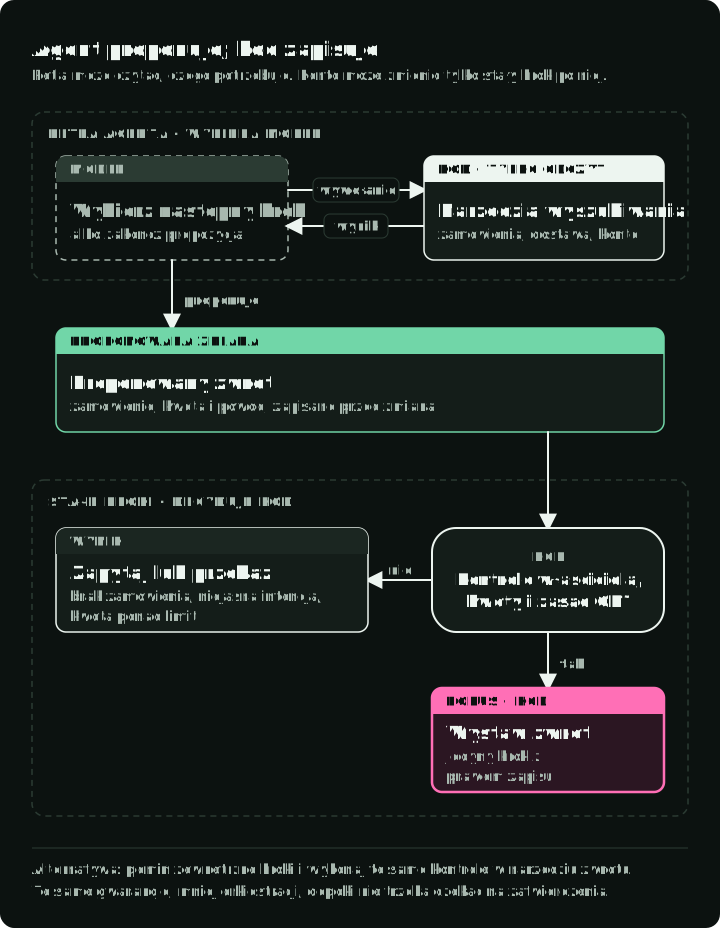
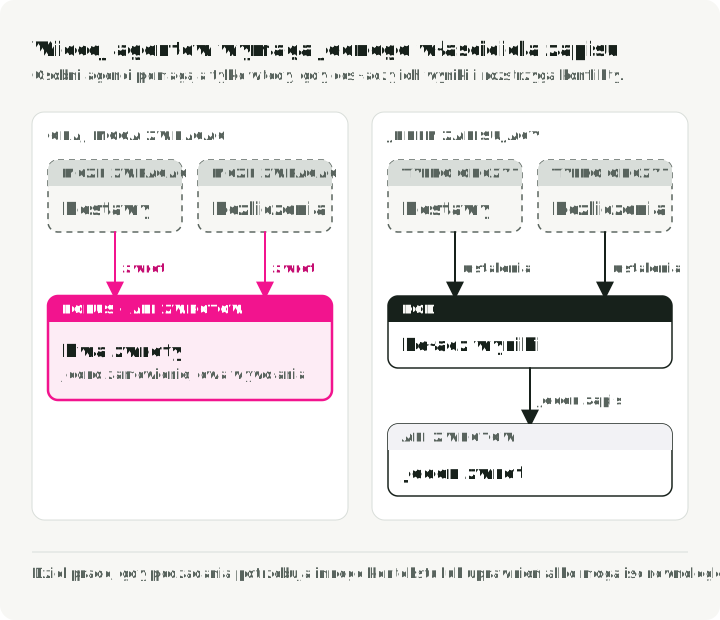
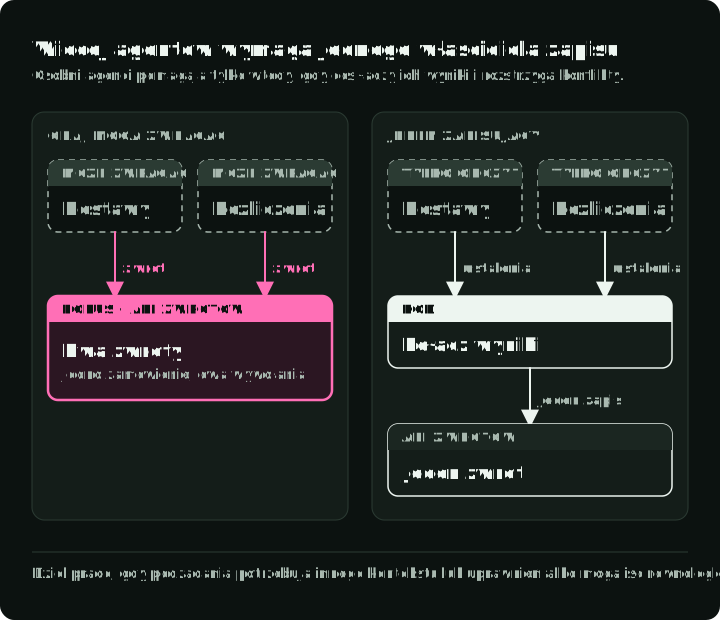
W naszym asystencie wsparcia jeden projekt łączy oba podejścia. Pętla agenta zbiera informacje i przygotowuje proponowany zwrot. Stały krok w kodzie sprawdza potem propozycję i wykonuje zapis. Model może badać rozmowę, ale tylko kod decyduje, czy zapis nastąpi. Jeśli od początku wiemy, że potrzebujemy tego podziału, możemy najpierw zbudować przepływ pracy wokół agenta.
Druga możliwość to zacząć od jednej pętli agenta z limitem kroków i umieścić kontrole w samych narzędziach. Dzięki temu pierwsza wersja jest mała, a my uczymy się, jakich ścieżek wymaga zadanie. Przepływ pracy wybierz na początku, jeśli czekanie na zatwierdzenie, stałe etapy lub reguły odzyskiwania są już wymaganiami.
Podział pracy między kilku agentów to osobna decyzja, a jeden agent często wystarcza. Drugi agent pomaga, gdy podzadanie wymaga innego kontekstu lub innych uprawnień albo może działać równocześnie z pierwszym. Wtedy coś musi połączyć ich wyniki i rozstrzygnąć konflikty między ich akcjami. Jeśli agent dostaw i agent rozliczeń mogą oba wystawiać zwroty, jedno zamówienie może zostać zwrócone dwa razy.
Wywołania narzędzi czy wygenerowany kod?
Gdy już wiemy, kto wybiera następny krok, decydujemy, jak model prosi o akcję. Może wywołać narzędzie: nazwaną funkcję, którą dostarcza i uruchamia w imieniu modelu twój kod. Może też napisać krótki program, który następnie uruchamia twój kod. To, kto wybiera następny krok, i to, jak model prosi o akcję, to osobne decyzje. Stały przepływ pracy może zawierać krok, w którym model pisze kod, a otwarta pętla agenta może używać tylko kilku wąskich narzędzi.
W asystencie wsparcia dobrze pasuje narzędzie takie jak issue_refund(order_id, amount_cents). Jego schemat nazywa akcję i jej argumenty, więc prośba jest jawna. Narzędzie zwraca identyfikator zwrotu w razie sukcesu albo ustrukturyzowany powód odrzucenia. To narzędzie możemy testować osobno, bo model nigdy nie pisze logiki zwrotu.
Nie każde zadanie potrzebuje narzędzi. Klasyfikator, który dostaje całe wejście w prompcie, może zwrócić zwalidowaną etykietę. Narzędzie do wyszukiwania dodaj wtedy, gdy zadanie wymaga danych spoza promptu. Narzędzie zmieniające dane dodaj tylko wtedy, gdy zadanie musi coś zmienić.
Wygenerowany kod nadaje się do innego rodzaju pracy. Załóżmy, że asystent ma przeczytać tabelę zamówień, pogrupować wiersze według klientów i obliczyć kilka sum. Z narzędziami każdy krok to osobne wywołanie, a każdy wynik pośredni wraca do modelu. Z kodem model pisze jeden program w Pythonie, który trzyma wartości pośrednie we własnych zmiennych, a wracają tylko sumy.
Biblioteka smolagents od Hugging Face oferuje oba style. ToolCallingAgent zwraca ustrukturyzowane wywołania narzędzi. CodeAgent pisze kod w Pythonie, który wywołuje te same narzędzia, zapisuje wartości w zmiennych i łączy wyniki. Agent kodujący nadal używa narzędzi; wywołuje je z poziomu programu.
Wygenerowany kod daje nam też dodatkową pracę. Musimy obsługiwać błędy składni, ograniczać czas działania, zarządzać zależnościami i decydować, do jakich plików i adresów sieciowych kod ma dostęp. To, czy mniejsza liczba wywołań modelu zwraca ten wysiłek, zależy od zadania i modelu. Zmierz to na swoim zadaniu; kod nie jest domyślnie lepszy.
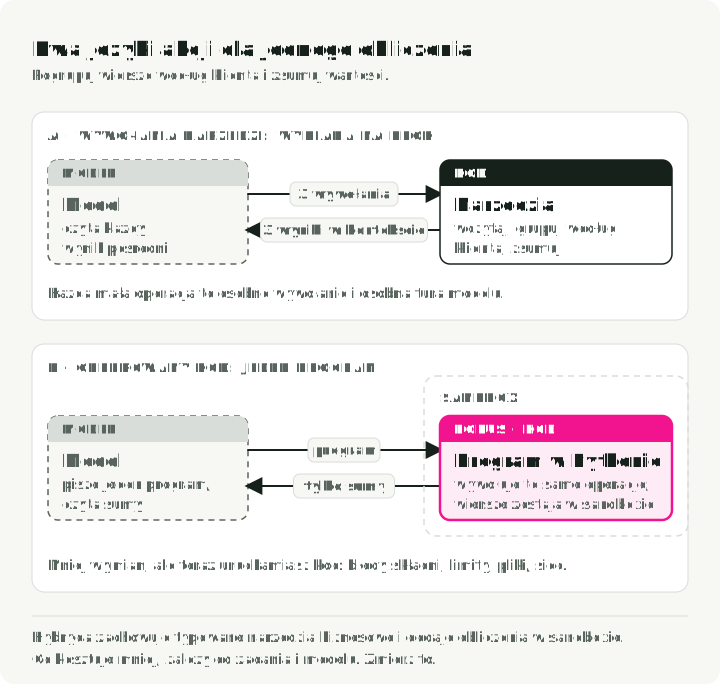
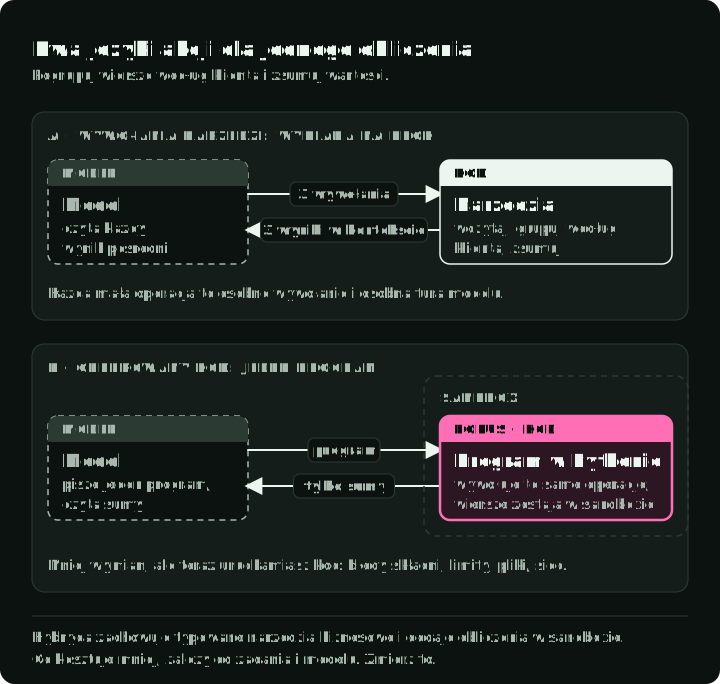
Kilka hostowanych API łączy oba style: twoje własne narzędzia biznesowe oraz wbudowane narzędzie do wykonywania kodu, które działa w sandboksie, czyli osobnym środowisku z ograniczonym dostępem. Oferują to Responses API od OpenAI, Claude API, Gemini API i AWS Bedrock AgentCore.
Programmatic tool calling od Anthropic idzie o krok dalej: kod w sandboksie może wywoływać dozwolone przez ciebie narzędzia, a do modelu wracają tylko wybrane przez ciebie wyniki. Anthropic nadal zaleca domyślnie bezpośrednie wywołania narzędzi, a ścieżkę z kodem zostawia dla dużych wyników i łańcuchów wywołań zależnych od siebie. Niektóre projekty używają wyłącznie kodu, na przykład CodeAgent ze smolagents i Code Mode od Cloudflare.
W naszym asystencie zwrotów zacząłbym od typowanych narzędzi biznesowych. Jeśli późniejsze zadanie będzie wymagać intensywnych obliczeń, możemy dodać wykonawcę kodu bez dostępu do kont klientów.
Trzecie pytanie dotyczy tego, jak aplikacja łączy się ze swoimi narzędziami. Funkcja lokalna wystarcza, gdy kod należy do jednej aplikacji. Model Context Protocol (MCP) to standardowy sposób udostępniania narzędzi z osobnego serwera, dzięki czemu może z nich korzystać kilka aplikacji. MCP określa, jak aplikacja i serwer wymieniają wywołania narzędzi. Nie waliduje argumentów ani nie decyduje, kto może wywołać narzędzie: specyfikacja narzędzi MCP zostawia te kontrole aplikacji i serwerowi.
Umieść ograniczenia tam, gdzie dzieją się akcje
Opis narzędzia mówi modelowi, kiedy narzędzie jest przydatne. Nie decyduje, czy dane wywołanie może się wykonać. Musi to rozstrzygnąć kod, który wykonuje zapis. W przypadku zwrotu ten kod sprawdza zalogowane konto, zamówienie, kwotę, politykę zwrotów i wymagane zatwierdzenie.
Niektóre kontrole wymagają interpretacji
Niektórych kontroli nie da się zapisać jako zwykły kod. Załóżmy, że klient pyta: „Czy mogę zwrócić to zamówienie?”, a agent proponuje zwrot. Zamówienie należy do klienta, kwota jest poprawna, a termin zwrotu jeszcze nie upłynął. Wszystkie kontrole w kodzie przechodzą, a jednak klient może tylko pytać, czy zwrot jest możliwy, a nie prosić o zwrot teraz. Ktoś musi przeczytać wiadomość, żeby to rozstrzygnąć.
Zwykły kod nadal sprawdza własność, kwoty i daty. Główny model może zapytać klienta, gdy jego zamiar jest niejasny, albo aplikacja może wymagać wyraźnego potwierdzenia przed zwrotem. Osobny model decyzyjny to kolejny projekt do oceny: odpowiada na jedno konkretne pytanie o znaczenie, na przykład: „Czy klient poprosił o ten zwrot?” Takie pytanie możemy testować osobno, bez uruchamiania całej rozmowy. Porównaj ten projekt z prośbą o doprecyzowanie lub potwierdzenie, zanim dodasz kolejny model.
Jev, model decyzyjny od TypeSafe, to jedna z opcji do tej roli. Przyjmuje stan, który mu dostarczymy, oraz typowane pytania i zwraca ustrukturyzowane odpowiedzi. Dla pytania tak/nie zwraca prawdopodobieństwo, że odpowiedź brzmi „tak”.
Zadałbym dwa osobne pytania: czy klient wyraźnie poprosił o zwrot i czy późniejsza wiadomość wycofała tę prośbę. TypeSafe zaleca szczegółowe pytania, których odpowiedzi łączy się w kodzie, a kilka pytań może korzystać z jednego wywołania API. Przy dwóch pytaniach błędna odpowiedź pokazuje, która z dwóch ocen zawiodła.
Kod łączy następnie te odpowiedzi z wymaganymi kontrolami. Jeśli odpowiedzi są niejasne lub sprzeczne, asystent pyta klienta albo kieruje sprawę do człowieka. Jeśli wywołanie Jev przekroczy limit czasu, ten błąd też wymaga własnej ścieżki. „Tak” od Jev nigdy nie unieważnia nieudanej kontroli własności ani nie zastępuje wymaganego potwierdzenia. Jego prawdopodobieństwo to wynik modelu. Nie autoryzuje zwrotu i nie dowodzi, że decyzja jest poprawna.
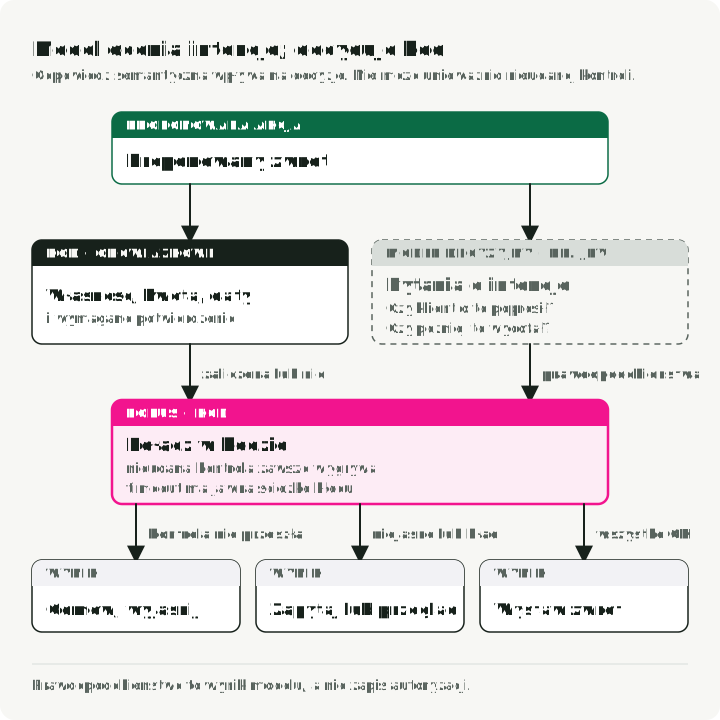
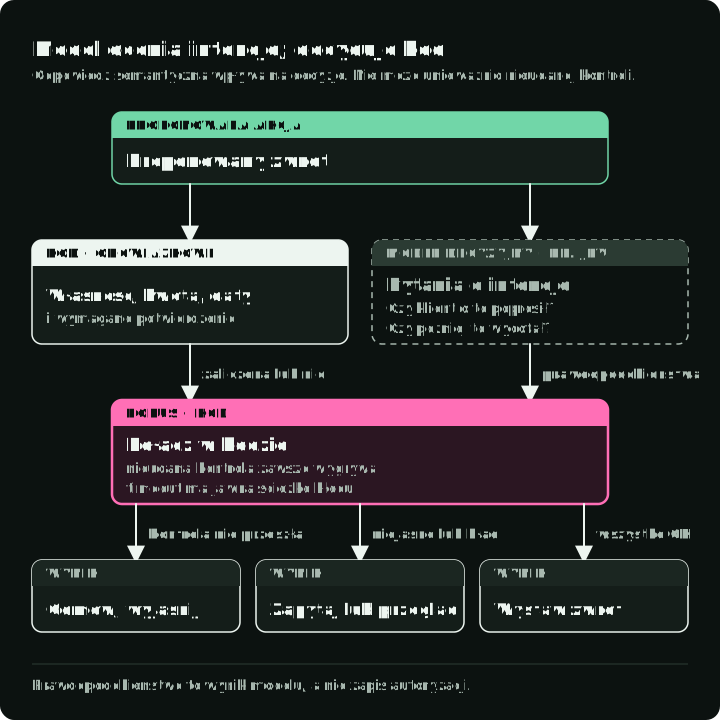
Kontekst, który dajemy kontroli, decyduje o tym, co ona widzi. Dostarczyłbym proponowaną akcję, wiadomości klienta w kolejności oraz wyniki narzędzi potrzebne do decyzji, wszystko z oznaczonym źródłem. Sama ostatnia wiadomość mogłaby pominąć anulowanie. Pełna historia konta mogłaby ukryć prośbę wśród niezwiązanych wiadomości. Na te pytania mógłby też odpowiedzieć mały model ogólnego przeznaczenia z ustrukturyzowanymi danymi wyjściowymi. Porównaj go z Jev na tych samych przykładach, pod względem dokładności i kosztu.
Ograniczaj dostęp niezależnie od ocen modelu
Tekst od klienta lub z pobranego dokumentu może zawierać instrukcje skierowane do agenta. Taki tekst nie może mieć możliwości nadawania uprawnień ani zastępowania polityki aplikacji. Jeśli dokument każe agentowi wyeksportować wszystkie rekordy klientów, system nie może mieć do tego uprawnienia, choćby sformułowanie było bardzo przekonujące.
Wygenerowany kod potrzebuje własnych ograniczeń dostępu. Jeśli model może wywoływać tylko sprawdzone funkcje z wąskimi uprawnieniami, ogólny sandbox do kodu może niewiele dodać. Te funkcje nadal wymagają autoryzacji, walidacji danych wejściowych, limitów czasu i bezpiecznych zapytań do bazy.
Zanim pozwolimy na wygenerowany kod w Pythonie, polecenia powłoki lub edycje plików wykonywalnych, musimy zdecydować, do czego ten kod ma dostęp. Do których katalogów może zapisywać? Czy potrzebuje dostępu do sieci? Jakie dane uwierzytelniające widzi? Ile czasu CPU, pamięci i danych wyjściowych może zużyć jeden przebieg? Uruchomienie kodu w osobnym procesie samo nie odpowiada na te pytania.
Przewodnik Hugging Face o bezpiecznym wykonywaniu kodu porównuje ograniczony interpreter lokalny z bardziej izolowanymi opcjami, takimi jak kontenery. Każda opcja blokuje co innego. Kontener z szerokim dostępem do plików hosta i danymi uwierzytelniającymi o szerokich uprawnieniach nadal może ujawnić zasoby, które chcieliśmy chronić. Sprawdź, że zabroniony odczyt, zabroniony zapis i zabronione żądanie sieciowe kończą się niepowodzeniem, a zwykły program działa.
Wykonawcę kodu możemy pominąć, dopóki zadanie go nie wymaga, ale jego izolacja musi być gotowa w dniu, w którym go włączymy. Izolacja nie powstrzyma też nadużycia API, które świadomie dajemy kodowi, więc usługa zwrotów nadal musi egzekwować własne reguły.
Co przetrwa, gdy wykonanie zatrzyma się w połowie?
Załóżmy teraz, że asystent wysyła żądanie zwrotu, usługa tworzy zwrot, a odpowiedź ginie w drodze powrotnej. Model widzi przekroczenie limitu czasu. Jeśli wywoła usługę ponownie, klient może dostać drugi zwrot. Jeśli zgłosi niepowodzenie, powie klientowi coś, co już nie jest prawdą.
Rozwiązaniem jest uczynienie zwrotu idempotentnym: dwukrotne wysłanie tego samego żądania ma ten sam skutek co wysłanie go raz. Przed wysłaniem zwrotu aplikacja tworzy identyfikator operacji i zapisuje go. Przy ponowieniu wysyła ten sam identyfikator, a usługa zwraca zwrot, który już wykonała, zamiast tworzyć kolejny. Wskazówki AWS dotyczące idempotentnych API wyjaśniają ten wzorzec. Jeśli usługa go nie obsługuje, odzyskiwanie musi najpierw sprawdzić, co się stało, albo zapytać człowieka, zanim nastąpi jakakolwiek druga próba.
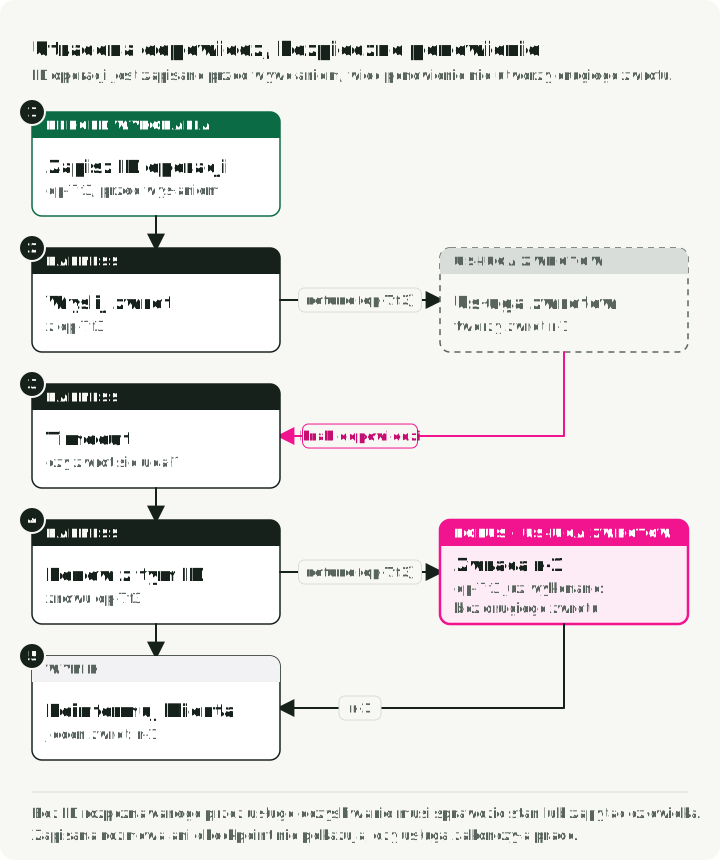
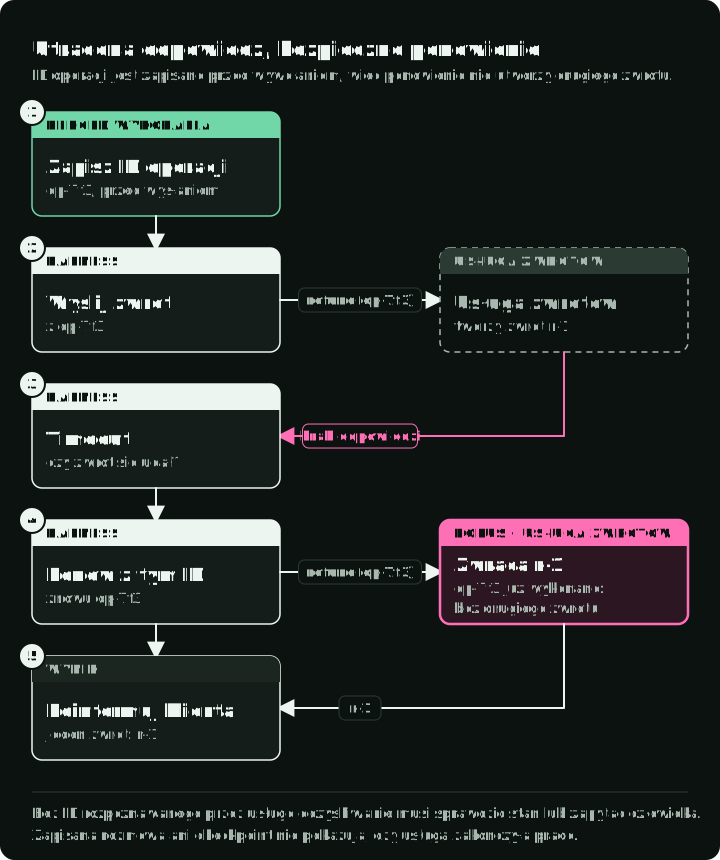
Zapisanie rozmowy tego nie rozwiązuje. Rozmowa może zapisywać, że model poprosił o zwrot, ale nie to, czy usługa go zakończyła. Checkpoint, czyli zapisana kopia stanu agenta, pozwala kontynuować zatrzymany przebieg. Nie cofnie zwrotu, który usługa już wykonała, i nie sprawia, że jego powtórzenie jest bezpieczne.
W tym asystencie trzy rodzaje stanu pełnią różne role. Rozmowa zawiera prośbę klienta i dotąd zebrane fakty. Rekordy zamówień i zwrotów zawierają stan biznesowy. Rekord wykonania wymienia oczekujące operacje i zatwierdzenia, dzięki czemu zrestartowany worker może bezpiecznie kontynuować. Mogą znajdować się w tej samej bazie danych, ale żaden z nich nie zastąpi pozostałych.
Pamięć między sesjami to osobna decyzja. Jeśli asystent ma pamiętać preferencję klienta w przyszłym tygodniu, potrzebujemy reguł: czyja to preferencja, kto może ją zmienić i jak się ją usuwa. Jeśli każde zadanie jest niezależne, możemy w ogóle nie potrzebować usługi pamięci. Każdy zapisany fragment tekstu to też szansa, że później użyjemy czegoś nieaktualnego lub nieistotnego.
Podobny problem pojawia się w obrębie jednej sesji przy długich rozmowach. Gdy rozmowa robi się zbyt długa, by model dobrze z niej korzystał, możemy wyszukiwać jej fragmenty albo zastąpić starsze tury streszczeniem. Streszczenie, które pomija identyfikator zamówienia, warunek zatwierdzenia lub oczekującą operację, może zepsuć procedurę. Trzymaj ten stan operacyjny w jawnych polach i przetestuj, co przetrwa streszczenie, zanim na nim polegasz.
Daj pętli sposób na zatrzymanie się
Pętla agenta zawsze znajdzie coś jeszcze do sprawdzenia, więc potrzebuje reguły zatrzymania, która obejmuje sukces, brakujące informacje, wyczerpane limity i porażkę. Gdy przebieg osiąga limit, musi zgłosić prawdziwy status: zwrot jest zrobiony, nigdy nie został podjęty albo wciąż jest niepewny. „Agent się zatrzymał” nie mówi klientowi ani następnemu workerowi, co się stało.
Warto nazwać sposoby, na jakie może się zakończyć przebieg, zanim napiszesz pętlę. Dla asystenta wsparcia użyłbym ośmiu: ukończony i zweryfikowany, odrzucony, z prośbą o brakujące informacje, przekazany człowiekowi, zablokowany przez kontrolę polityki, zatrzymany przez limit, zakończony błędem infrastruktury i wynik zapisu nieznany.
Zapisuj ten status osobno od oceny, czy przebieg spełnił kontrakt zadania. „Ukończony i zweryfikowany” potwierdza żądany zapis. Odmowa, pytanie lub przekazanie sprawy mogą być poprawne, gdy zadanie ich wymaga. Odpowiedź, akcje i stan końcowy muszą uzasadniać tę ocenę; samo zatrzymanie nie wystarczy.
Limit wywołań modelu obejmuje tylko część przebiegu. Narzędzie może się zawiesić. Ponowienie może powtórzyć pracę. Moduł streszczający lub model decyzyjny, taki jak Jev, wykonuje własne wywołania modelu. Ustaw limity czasu, prób, rozmiaru danych wyjściowych i wydatków i uwzględnij każdy działający komponent. Anulowanie przebiegu musi też uwzględniać żądania już wysłane do zewnętrznej usługi.
Sam model też dodaje ograniczenia. Sprawdź, czy na realistycznych zadaniach generuje wymagany format akcji. Porównaj użyteczny rozmiar kontekstu, opóźnienie, koszt i to, dokąd mogą trafiać dane zadania. Model, który sam hostujesz, i hostowane API mogą mieć wspólny interfejs, ale różnić się pojemnością i sposobem obchodzenia się z danymi.
Wybierz początkowy model i endpoint, zapisz ich ustawienia i trzymaj je bez zmian, gdy oceniasz zmianę w harnessie. W przeciwnym razie szybszy przebieg może wynikać z innego dostawcy lub modelu, a nie ze zmiany, którą chcesz przetestować.
Ewaluuj ukończenie, łącznie z przypadkami, w których nic nie powinno się stać
Gdy asystent potrafi zrealizować prośbę, musimy sprawdzić, czy zrobił właściwą rzecz. W przykładzie ze zwrotem możemy obserwować trzy rzeczy: co asystent powiedział, jakie akcje podjął i co zmieniło się w usłudze. Każda z nich wychwytuje błędy, których pozostałe nie widzą.
Odpowiedź może mówić „zwróciłem pieniądze za zamówienie”, podczas gdy baza danych się nie zmieniła. Poprawny zwrot może przyjść razem z niezwiązaną zmianą adresu, którą pokazuje tylko zapis akcji. A niezmieniona baza danych może oznaczać cztery różne rzeczy: poprawną odmowę, przydatne pytanie, awarię albo asystenta, który nic nie zrobił. Sam stan końcowy nie odróżni tych czterech przypadków.
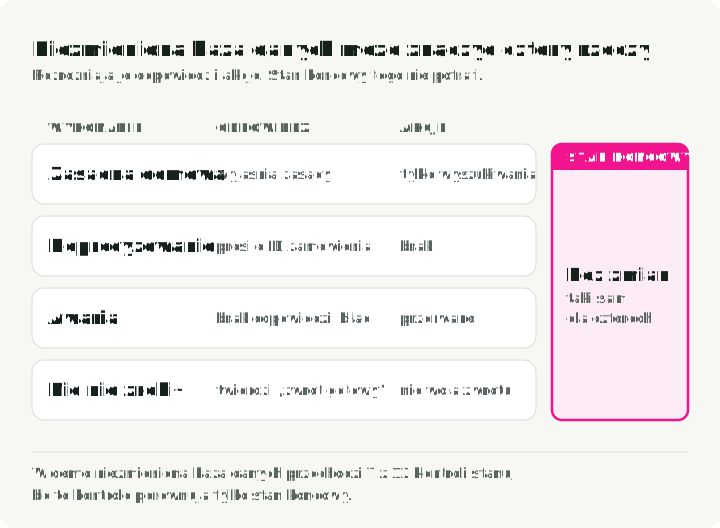
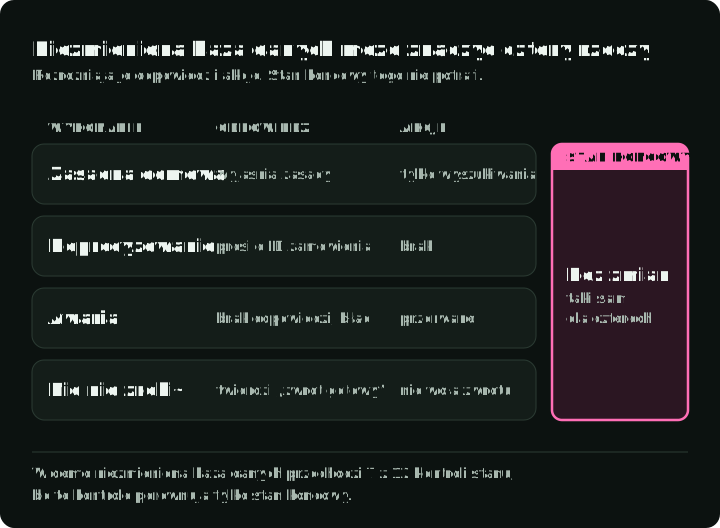
Demo towarzyszące, opisane na końcu artykułu, pokazuje to ograniczenie na prawdziwych liczbach. Ma dwanaście zadań wsparcia, a siedem z nich oczekuje braku zmian w bazie danych. Agent, który niczego nie zmienia, przechodzi więc 7 z 12 kontroli stanu. Ta liczba opisuje kontrole; nie jest zmierzonym odsetkiem sukcesów. Definicje zadań porównują tylko końcową bazę danych, nie odpowiedź ani akcje pomiędzy. Zapis, który został wykonany, a potem cofnięty, też nie zostawia śladu w tym porównaniu.
W pierwszym zestawie ewaluacyjnym uwzględnij udaną akcję, uzasadnioną odmowę, prośbę z brakującymi informacjami i awarię w trakcie wykonania. Dla każdego przypadku zdefiniuj oczekiwaną odpowiedź i dozwolone akcje, a także stan końcowy. Przypadek doprecyzowania powinien wymagać właściwego pytania. Przypadek odmowy powinien wymagać przydatnego wyjaśnienia. Te przypadki pokazują, czy agent rozumie zadanie i czy aplikacja je egzekwuje.
Jeśli dodamy kontrolę Jev, potrzebuje ona własnych przypadków testowych. Daj jej proponowane akcje, dla których człowiek wcześniej ustalił poprawne decyzje: wyraźną prośbę o zwrot, pytanie o uprawnienie, wycofaną prośbę i instrukcję ukrytą w wyniku narzędzia. Ostatni przypadek sprawdza też, czy kontekst, który składamy, oddziela wiadomości klienta od danych wyjściowych narzędzi.
Policz złe akcje, które Jev przepuszcza, i poprawne akcje, które blokuje. Po każdej blokadzie sprawdź dalszy ciąg rozmowy. Zablokowanie zapisu pomaga tylko wtedy, gdy asystent potem zada klientowi pytanie, zamiast kręcić się w pętli lub się zatrzymać. Jev zwraca prawdopodobieństwo, więc aplikacja potrzebuje progu, który zamienia je na decyzję „przepuść” lub „zablokuj”. Wybierz próg na przykładach rozwojowych i ustal go przed końcowym porównaniem na przykładach, których nie użyto do jego dostrojenia. Zapisz wersję pytania, dostarczony kontekst, zwrócone prawdopodobieństwa, zastosowaną regułę, ewentualne błędy i koszt. W zapisanym demo Jev nigdy nie odrzucił zapisu, więc demo nie pokazuje, że Jev pomaga.
Zapisuj tyle, by móc zdiagnozować awarię: zadanie, wersje modelu i harnessu, proponowane akcje, wyniki wykonania, stan końcowy, błędy, opóźnienie i koszt. Nie umieszczaj w tym zapisie sekretów ani zbędnych danych osobowych.
Testowany agent nie może mieć możliwości zmiany sposobu, w jaki jest oceniany. Daj mu wejście zadania i reguły, których potrzebuje, ale nie odpowiedzi wzorcowe ani ukryte przypadki testowe. Ewaluator (kod, który ocenia przebiegi) i jego zapisy trzymaj poza kontrolą agenta. To staje się ważniejsze, jeśli program później automatycznie edytuje harness, żeby podnieść wynik: ten program nie może mieć możliwości edycji kontroli, które go oceniają.
Te zapisy mówią nam też, kiedy dodać opcjonalny komponent. Router, czyli pierwszy krok kierujący każdą prośbę do właściwego handlera, dodaj wtedy, gdy zapisane przebiegi pokazują, że wybór typu prośby wymaga własnego etapu. Streszczenia dodaj, gdy długie historie powodują konkretną awarię. Przetestuj osłonę przed zabronionymi akcjami, łącznie z akcjami, które powinna przepuścić. Wymagane kontrole dostępu wynikają z reguł zadania; komponenty opcjonalne wymagają dowodów, że są warte swojego kosztu.
Zamień projekt w pierwszą implementację
Dla asystenta wsparcia mamy teraz projekt wyjściowy: pętla agenta z limitami do interpretowania zróżnicowanych próśb, wąskie narzędzia do operacji na kontach, kontrole wewnątrz usług zapisujących dane i zapisane rekordy oczekujących akcji. Dotąd nic nie wymaga wygenerowanego kodu ani pamięci między sesjami.
Najpierw zbudowałbym jedną kompletną ścieżkę. Utwórz małe konto testowe i oczekiwany wynik zwrotu. Zaimplementuj narzędzia wyszukiwania i zwrotu, łącznie ze ścieżkami odrzucenia. Połącz model z tymi narzędziami. Potem uruchom przypadki odmowy, brakujących informacji i przerwanego zapisu. Luki w wymaganiach łatwiej znaleźć teraz, przy kilku zadaniach, niż później, przy wielu.
Na tym etapie wystarczyć może pętla bez frameworka. Składa kontekst, prosi model o następną akcję, waliduje i uruchamia tę akcję, a wynik zwraca modelowi. Napisanie takiej pętli samodzielnie oznacza też napisanie konwersji wiadomości, anulowania, obsługi stanu i śledzenia. Framework warto stosować, gdy wykonuje tę pracę, a nadal pozwala kontrolować decyzje opisane w tym artykule.
Ta seria używa create_agent z LangChain jako punktu wyjścia, bo zapewnia pętlę model–narzędzia oraz punkty rozszerzeń do zmiany jej zachowania. Działa już na LangGraph. Przejście później na jawny przepływ pracy w LangGraph oznacza samodzielne napisanie większej liczby etapów wokół agenta, a nie dodanie grafu od zera.
Zanim napiszę implementację, zapisałbym decyzje na jednej stronie. Pierwsza wersja nie potrzebuje każdej opisanej wyżej możliwości. Potrzebuje tylko części, które kończą zadanie, oraz zapisów pokazujących, gdzie przebieg zawodzi.
| Pytanie | Decyzja do zapisania |
|---|---|
| Jakie zadanie realizujemy? | Wywołujący, oczekiwany wynik, uzasadniona odmowa lub przekazanie sprawy oraz zakazane skutki |
| Kto wybiera następny krok? | Znane etapy w kodzie; decyzje powierzone modelowi; powód każdej z nich |
| Które kontrole wymagają interpretacji? | Pytanie o znaczenie, kontekst, który widzi, model, który odpowiada, co robić przy wątpliwości |
| O co model może prosić? | Brak narzędzi, typowane operacje, wygenerowany kod lub ich połączenie |
| Kto to autoryzuje i wykonuje? | Dozwolone dane i akcje, usługa, która je sprawdza, zatwierdzenia, limity sandboksa |
| Co musi przetrwać przerwanie? | Stan rozmowy, rekordy biznesowe, oczekujące operacje i zachowanie przy odzyskiwaniu |
| Które akcje można bezpiecznie ponowić? | Odczyty; zapisy z identyfikatorem operacji, który usługa deduplikuje; zapisy, które trzeba najpierw sprawdzić |
| Jakie obowiązują limity? | Ograniczenia modelu i dostawcy, obsługa danych, wywołania, czas, wydatki i anulowanie |
| Co dowodzi ukończenia? | Kontrole odpowiedzi, akcji i stanu; kto jest właścicielem ich dowodów |
| Co pominęliśmy? | Komponenty opcjonalne oraz awaria lub nowe wymaganie, które uzasadniłyby każdy z nich |
Użyteczna odpowiedź jest na tyle konkretna, że zmienia implementację. „Potrzebuje pamięci” jest nieprecyzyjne. „Musi wznowić zatwierdzony zwrot po restarcie workera bez tworzenia drugiego zwrotu” mówi, co zapisać i jaką awarię przetestować.
Część 2 pyta, kiedy jawny przepływ pracy radzi sobie z zadaniem na tyle dobrze, by uzasadnić dodatkowe etapy. Buduje najmniejszy przepływ pracy, jakiego wymagają zadania, wokół agenta i porównuje go z pętlą. Kolejne części utrzymują ewaluator poza kontrolą agenta i mierzą, jak wyniki zmieniają się między powtórzonymi przebiegami.
Opcjonalnie: przejrzyj implementację i jej ograniczenia
Demo towarzyszące to mała, działająca wersja asystenta wsparcia. Działa w dwóch środowiskach:
- Własne zadania wsparcia: dwanaście zadań, każde na świeżej bazie SQLite z klientami i zamówieniami.
- τ³-bench retail: osiem zadań z τ³-bench, publicznego benchmarku, w którym model odgrywa klienta, rozmawia z agentem, a wynik oceniają kontrole bazy danych.
Ta sekcja opisuje, co zawiera demo, co celowo pomija, co pokazują wyniki i jak je uruchomić. Możesz ją pominąć i nadal korzystać z opisanego wyżej procesu projektowania.
Co zawiera demo
Jeden agent LangChain wybiera wywołania narzędzi. Ma pięć narzędzi do kont (look_up_account, list_orders, issue_refund, update_address i set_preference) oraz serwer MCP do wyszukiwania polityk i FAQ. Checkpointer w pamięci zapisuje stan przebiegu między krokami. Nie ma wykonawcy kodu ani pamięci między sesjami.
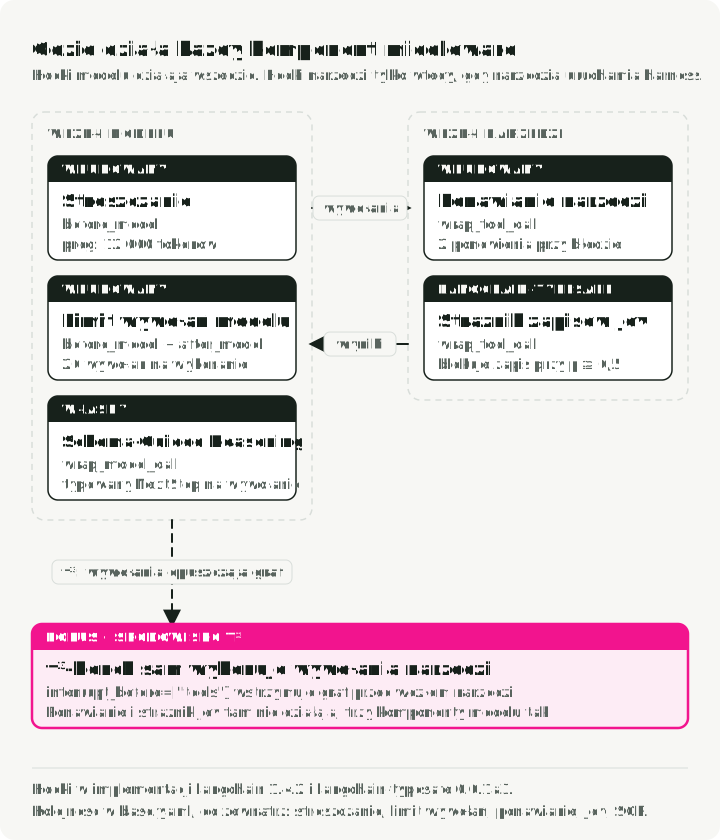
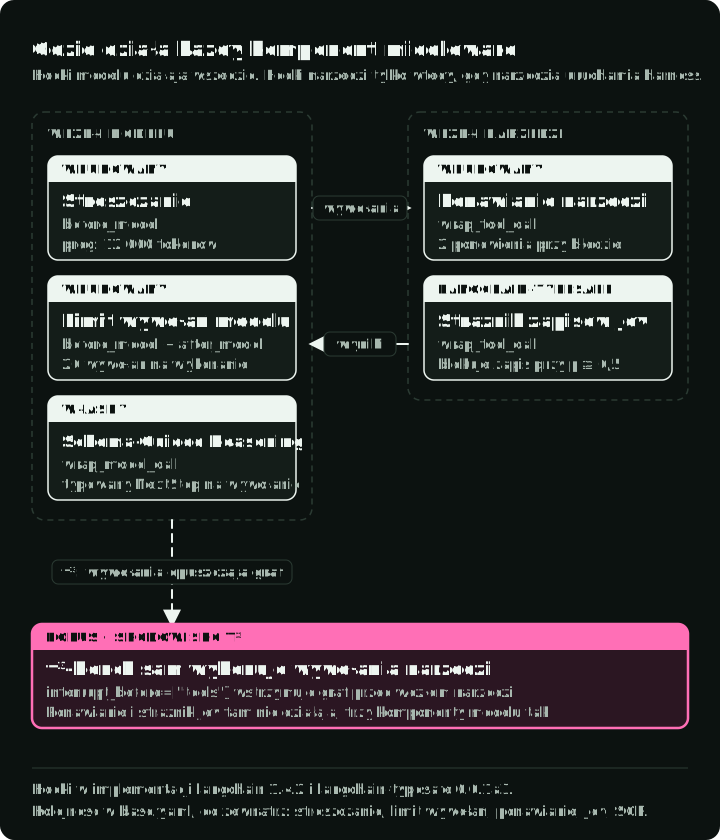
Każdy przebieg czyta spec, czyli plik YAML, który nazywa model i komponenty do użycia. Demo zapisuje dwa specy. W base Schema-Guided Reasoning (SGR) sprawia, że model zwraca ustrukturyzowany obiekt następnego kroku zamiast natywnego wywołania narzędzia. Osłona zapisu Jev, czyli opisana wcześniej kontrola modelem decyzyjnym, działa przed każdym zapisem i zadaje jedno złożone pytanie: czy to wywołanie złamałoby politykę lub wykroczyło poza to, o co prosił klient?
| Spec | Komponenty |
|---|---|
plain | Streszczanie, limit 20 wywołań modelu na przebieg i 2 ponowienia po błędzie narzędzia |
base | Wszystko z plain oraz Schema-Guided Reasoning i osłona zapisu Jev |
Dwa osobne pytania z wcześniejszej części artykułu, o prośbę i jej wycofanie, to proponowana przebudowa; zapisane przebiegi jej nie używały. base dodaje SGR i Jev w jednym kroku, więc wyniki na własnych zadaniach nie pokazują, czy różnicę spowodował SGR, czy Jev.
Co demo celowo pomija
- Narzędzia sprawdzają integralność danych, ale politykę biznesową zostawiają agentowi, więc eksperyment może ujawnić zapis, którego polityka zabrania. Prawdziwa usługa egzekwowałaby politykę przy zapisie.
- Nie ma limitu czasu ani wydatków dla całego zadania.
- Ponawianie narzędzi dotyczy każdego narzędzia, także trzech zapisujących, a ponawiane zapisy nie mają klucza idempotentności. Ponawianie obejmuje osłonę Jev, więc każdy ponowiony zapis jest sprawdzany jeszcze raz.
ToolRetryMiddlewarew LangChain przyjmuje listę nazw narzędzi; prawdziwa usługa ograniczyłaby ponowienia do odczytów. - Ewaluator działa w tym samym procesie co agent.
Wyniki nie testują więc egzekwowania w produkcji, bezpieczeństwa ponowień ani ochrony dowodów przed manipulacją.
Wyniki na własnych zadaniach
Każdy wiersz to jeden przebieg każdego zadania. Ceny to ceny endpointów zapisane razem z wynikami. Do zaliczenia wymagane są oczekiwana końcowa baza danych i brak błędu wykonania. Te kontrole nie weryfikują odpowiedzi ani wszystkich akcji pośrednich. Koszt i opóźnienie to średnie na zadanie; koszt obejmuje Jev tam, gdzie działa.
| Spec | Model | Zaliczone | Koszt | Opóźnienie |
|---|---|---|---|---|
base | openai/gpt-6-luna | 12/12 | $0.00073 | 11.9 s |
plain | openai/gpt-6-luna | 12/12 | $0.00033 | 5.8 s |
base | z-ai/glm-5.3-flash | 12/12 | $0.00101 | 9.7 s |
base | xiaomi/mimo-v2.6-flash | 7/12 | $0.00087 | 18.6 s |
- Z
gpt-6-lunaoba specy przeszły wszystkie dwanaście zadań.basekosztował około 2,2 razy więcej i trwał około dwa razy dłużej. - Jev przepuścił każdy sprawdzany zapis: sześć w każdym z przebiegów
gpt-6-lunai GLM oraz cztery w przebiegu MiMo. Nigdy nie zablokował zapisu, więc te przebiegi nie testują, czy powstrzyma zły zapis. - Pięć porażek MiMo to błędy formatu danych wyjściowych SGR. Trzy pozostawiły bazę danych bez zmian, zgodnie z wymaganiem, ale błędy wykonania nadal oznaczały porażkę. Nie ma przebiegu MiMo z
plain, więc nie wiemy, czy natywne wywoływanie narzędzi poradziłoby sobie lepiej. - Streszczanie nigdy się nie uruchomiło. Największa prośba w sześciu zapisanych przebiegach (te cztery i dwa przebiegi τ³-bench poniżej) miała 8 351 tokenów wejściowych, poniżej progu 12 000 tokenów. Te wyniki nie pokazują, czy streszczanie pomaga. Gdy się uruchamia, middleware streszczający w LangChain zastępuje starsze wiadomości w stanie agenta jedną wiadomością ze streszczeniem, więc pełny transkrypt musi pochodzić ze śladu.
Wyniki na τ³-bench
τ³-bench ocenia przebieg, odtwarzając wywołania narzędzi agenta w świeżym środowisku, więc benchmark musi sam uruchamiać narzędzia. Adapter demo, czyli kod łączący agenta z τ³-bench, wstrzymuje graf przed jego węzłem narzędzi, zwraca wywołania narzędzi i zapisuje wyniki benchmarku z powrotem, zanim wznowi działanie.
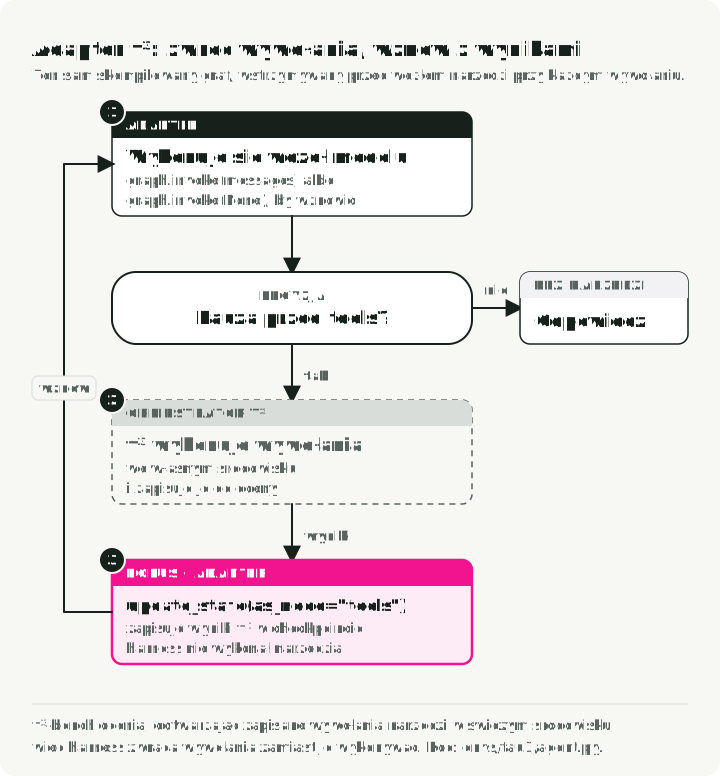
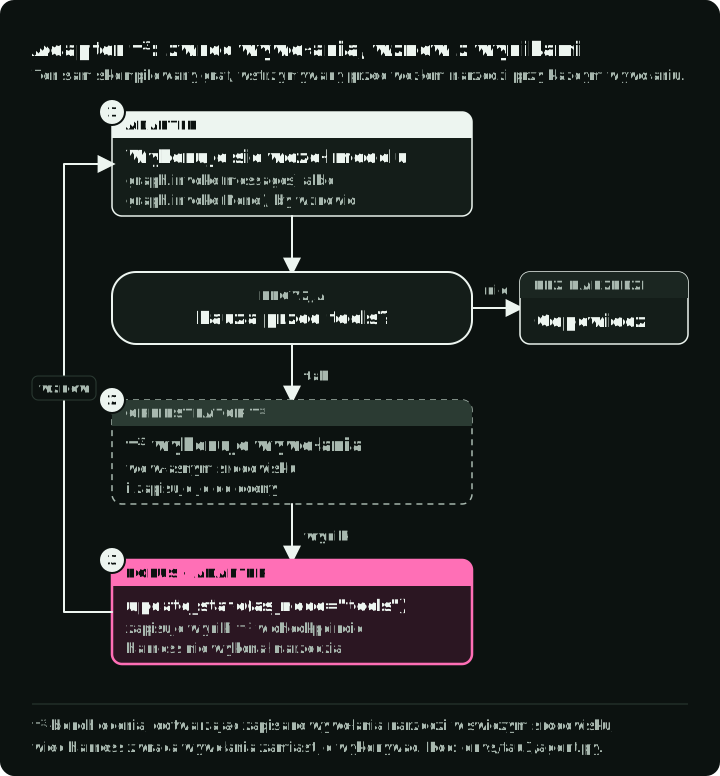
Ma to dwie konsekwencje. Po pierwsze, prompt, narzędzia i polityka pochodzą z τ³-bench, więc te wyniki nie są porównywalne z wynikami na własnych zadaniach, nawet przy tym samym pliku specu. Po drugie, ponawianie narzędzi i Jev tu nigdy nie działają: jedyną różnicą między base a plain jest SGR.
Oba przebiegi używają openai/gpt-6-luna dla agenta i dla symulowanego klienta. Opóźnienie symulacji obejmuje pracę symulatora. Koszt agenta i opóźnienie symulacji to średnie na zadanie; koszt symulatora to suma dla wszystkich ośmiu zadań.
| Spec | Zaliczone | Koszt agenta | Opóźnienie symulacji | Koszt symulatora, suma |
|---|---|---|---|---|
base | 6/8 | $0.00238 | 59.0 s | $0.00453 |
plain | 7/8 | $0.00136 | 38.9 s | $0.00471 |
- Osiem zadań pochodzi z podziału testowego retail i nie ma asercji w języku naturalnym, więc o nagrodzie decydują wyłącznie kontrole bazy danych.
- Oba specy ukończyły wszystkie osiem zadań bez błędów adaptera. Każda porażka polegała na brakującym zapisie.
baseoblał zadania 9 i 26.plainprzekazał zadanie 27 człowiekowi zamiast zrealizować wymianę. - Powtórny przebieg
base, niewliczony do sześciu, także zaliczył 6/8, ale oblał zadania 9 i 17. Zadania, które zawodzą, zmieniają się między przebiegami, więc różnica jednego zadania nie jest powodem, by preferowaćplain. Te przebiegi nie mierzą tej zmienności.
Sprawdź zapisane liczby
Zapisane raporty i ślady zawierają wyniki dla poszczególnych zadań, liczby tokenów, konfiguracje, wersje pakietów i zapisane ceny. Dla 393 wywołań czatu agenta w sześciu zapisanych przebiegach koszt obliczony z tokenów zgadzał się z kwotą naliczoną w każdej odpowiedzi. Ta kontrola nie obejmuje wywołań Jev ani symulowanego klienta. Ceny są historyczne i nie stanowią wyceny twojego przebiegu.
Uruchom samodzielnie
Zainstaluj uv i użyj oznaczonej wersji poniżej. Testy działają offline po zainstalowaniu zależności. Oba uruchomienia środowisk wykonują płatne wywołania modeli przez OpenRouter i wymagają klucza API.
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout v0.1.2-a1
cp .env.example .env # set OPENROUTER_API_KEY
make test
make a1-custom SPEC=harness/spec/plain.yaml
make a1-tau3 SPEC=harness/spec/plain.yaml
Każdy przebieg zastępuje wyniki w reports/article-a1/. Użyj git diff, aby porównać je z zatwierdzoną bazą odniesienia. Makefile instaluje zależności z zamrożonego uv.lock.
Aby wypróbować inny model lub zestaw narzędzi, skopiuj spec z harness/spec/, zmień te pola i przekaż jego ścieżkę przez SPEC. Ustawienia dostawcy i komponentów własnych przyjmują dowolne klucze, więc walidacja nie wychwyci każdej literówki w zagnieżdżonych polach.