Die Mathematik in arXiv-Papern zu AI lesen: ein praktischer Leitfaden
Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Die Mathematik in einem AI-Paper lesen zu können, ist eine nützliche Fähigkeit für Engineers, die ein Modell verstehen, eine Methode nachbauen oder eine experimentelle Behauptung einschätzen müssen. Dieser Leitfaden erklärt, wie man die Notation entschlüsselt, eine Gleichung an kleinen Zahlen prüft und sie mit dem umgebenden Paper und der Implementierung verbindet. Er setzt voraus, dass Sie Code lesen können, aber nicht, dass Ihnen die Notation der Forschung schon vertraut ist.
Eine Gleichung presst mehrere Entscheidungen in eine Zeile: welche Objekte bearbeitet werden, welche Dimensionen sie haben, welche Werte gesampelt werden und was gelernt wird oder fest bleibt. Diese Details zurückzugewinnen ist ein guter erster Schritt. Zu erklären, warum eine Methode funktioniert, und sie originalgetreu umzusetzen, erfordert weitere Arbeit.
Beginnen Sie mit dem Attention-Walkthrough: Er verbindet eine Gleichung mit Array-Formen, kleinen Zahlen und lauffähigem Python. Die Notationsreferenz erklärt die Ausdrücke, denen Sie in anderen Papern begegnen. Der Rest dieser Serie wendet dieselbe Methode auf Gleichungen aus konkreten Papern an: Architekturgleichungen wie RoPE, MLA und LoRA, Trainingsziele wie DPO und GRPO sowie generative Modelle und Metriken wie das ELBO, Diffusion und pass@k. Diese Teile sind noch nicht erschienen, deshalb sind die Walkthroughs, auf die dieser Teil verweist, nicht verlinkt. Für eine ausführlichere Behandlung der Grundlagen entwickelt Tianhua Chens The Little Book of Generative AI Foundations die lineare Algebra und Wahrscheinlichkeitsrechnung hinter generativen Modellen.
Attention, Symbol für Symbol gelesen
Attention erzeugt einen Ausgabevektor, indem sie einen gewichteten Mittelwert aus Value-Vektoren bildet. Die Gewichte erhält sie, indem sie einen Query-Vektor für die Ausgabeposition mit einem Key-Vektor für jede verfügbare Eingabeposition vergleicht. Die Matrizen , und sammeln diese Query-, Key- und Value-Vektoren. Scaled Dot-Product Attention fasst diese Schritte in Gleichung (1) von §3.2.1 (§ steht für „Abschnitt“) in Attention Is All You Need zusammen:
Die Definitionen stehen im Text, nicht in der Gleichung. Der Absatz vor Gleichung (1) sagt, dass Queries und Keys die Dimension haben und Values die Dimension . Die Methode bildet das Skalarprodukt jeder Query mit allen Keys, teilt jedes durch und wendet ein Softmax an, „to obtain the weights on the values“. Die Queries werden „packed together into a matrix “, Keys und Values in und . Jede Zeile dieser Matrizen ist also der Vektor eines Tokens, und das Softmax erzeugt pro Query einen Satz von Gewichten. Die gelernten Matrizen, die Token-Vektoren in , und überführen, folgen später, in §3.2.2.
Formen und Rollen. Ein Attention Head führt eine solche Berechnung mit eigenen Query-, Key- und Value-Vektoren aus. Schreiben Sie deren Formen auf, bevor Sie die Operatoren lesen. Für einen Head mit Queries und Keys:
| Symbol | Form | Was es ist | Woher es kommt |
|---|---|---|---|
| eine Query-Zeile pro Ausgabeposition | Token-Vektoren mal eine gelernte Matrix | ||
| eine Key-Zeile pro Position, die beachtet werden kann | Token-Vektoren mal eine gelernte Matrix | ||
| eine Value-Zeile pro Key | Token-Vektoren mal eine gelernte Matrix | ||
| transponiert: Zeilen werden zu Spalten | dieselben Zahlen wie | ||
| eine Zahl | die Breite jeder Query und jedes Keys | eine feste Einstellung: 64 im Basis-Transformer |
Paper geben eine Form an, indem sie die Menge nennen, zu der die Matrix gehört: bedeutet eine Matrix reeller Zahlen mit Zeilen und Spalten, ein Array der Form [n, dk].
Von innen nach außen lesen.
-
multipliziert eine -Matrix mit einer -Matrix. Das gemeinsame wird weggesummiert, das Ergebnis ist eine -Tabelle von Scores. Der Eintrag ist das Skalarprodukt von Query und Key : entsprechende Einträge multiplizieren, dann die Produkte addieren. Bei festen Vektorlängen ist dieser Score größer, wenn ihre Richtungen ähnlicher sind.
-
Die Division durch verhindert, dass die Scores mit der Vektorbreite wachsen. Fußnote 4 des Papers zeigt, warum unskalierte Skalarprodukte wachsen. Angenommen, die Komponenten einer Query und eines Keys sind voneinander unabhängig (wer einige kennt, erfährt nichts über die anderen), jeweils mit Mittelwert 0 und Varianz 1 (dem mittleren quadrierten Abstand vom Mittelwert). Dann gilt:
Die Zeilen nutzen zwei Regeln über unabhängige Zahlen. Erstens hat das Produkt zweier unabhängiger Zahlen, die jeweils Mittelwert 0 und Varianz 1 haben, ebenfalls Varianz 1. Zweitens addieren sich beim Addieren unabhängiger Zahlen ihre Varianzen, die Produkte ergeben also die Varianz . Die Standardabweichung ist die Quadratwurzel der Varianz, . Teilt man jeden Score durch , schrumpft die Streuung um denselben Faktor, zurück auf 1.
Warum die beiden Regeln gelten
Varianz bei Mittelwert 0. Die Varianz ist der mittlere quadrierte Abstand vom Mittelwert. Ist der Mittelwert 0, ist der quadrierte Abstand vom Mittelwert einfach das Quadrat der Zahl, die Varianz ist also der Mittelwert der Quadrate. Eine Komponente mit Mittelwert 0 und Varianz 1 hat daher im Mittel 1.
Der Mittelwert eines Produkts. Bei unabhängigen Zahlen ist der Mittelwert eines Produkts das Produkt der Mittelwerte. Nehmen Sie eine Zahl , die mit gleicher Wahrscheinlichkeit 1 oder 3 ist und daher im Mittel 2 beträgt, und eine Zahl , die mit gleicher Wahrscheinlichkeit 1 oder 5 ist, also im Mittel 3. Unabhängig heißt, dass jeden seiner Werte gleich oft annimmt, egal was für herauskam; alle vier Paare sind also gleich wahrscheinlich. Für sind die Produkte 1 und 5, im Mittel . Für sind sie 3 und 15, im Mittel . In beiden Fällen ist der Mittelwert , über beide Werte von also , das ist . Ohne Unabhängigkeit versagt die Regel: Wäre immer 5, wenn gleich 3 ist, und 1, wenn gleich 1 ist, träten nur die Produkte 1 und 15 auf, deren Mittelwert 8 ist. Wikipedia formuliert die Regel für beliebige unabhängige Zufallsvariablen, mit „expected value“ für den Mittelwert: independence and expectation.
Regel 1: Ein Produkt hat Varianz 1. Nehmen Sie ein Produkt . Sein Mittelwert ist das Produkt der Mittelwerte, , seine Varianz ist also der Mittelwert von . Die Quadrate sind unabhängig, weil und es sind, und jedes hat im Mittel 1, die Varianz ist also . Die allgemeine Formel ist die variance of a product of independent variables.
Regel 2: Die Varianzen unabhängiger Terme addieren sich. Nennen Sie die Produkte , das Skalarprodukt ist dann die Summe . Die Terme sind unabhängig, weil jeder andere Komponenten verwendet, und jeder hat Mittelwert 0 und Varianz 1. Auch die Summe hat den Mittelwert 0, ihre Varianz ist also der Mittelwert ihres Quadrats. Multipliziert man die Summe mit sich selbst, entsteht für jedes Paar von Termen ein Produkt , ein -Raster:
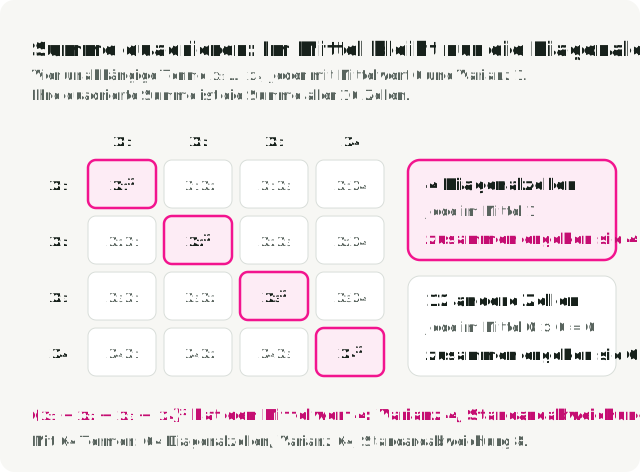
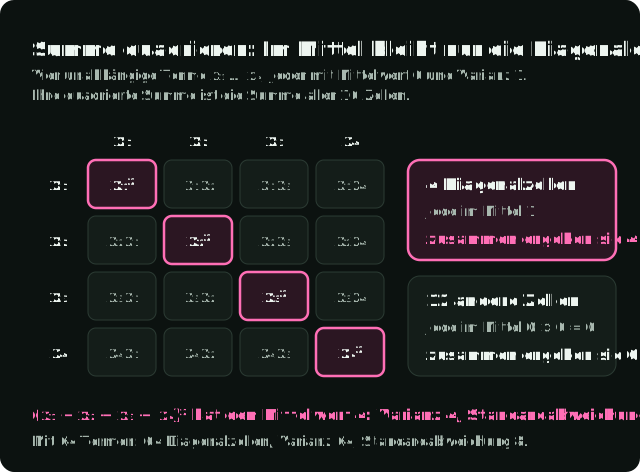
Die Diagonalzellen sind die Quadrate , jedes hat im Mittel 1. Jede andere Zelle multipliziert zwei verschiedene, unabhängige Terme, ihr Mittelwert ist also das Produkt ihrer Mittelwerte, : Ihre positiven und negativen Werte heben sich auf. Übrig bleiben nur die Diagonalzellen, die Varianz der Summe ist also und ihre Standardabweichung . Die Streuung wächst mit der Quadratwurzel der Breite, weil sich der größte Teil des Rasters aufhebt. Wikipedia gibt die allgemeine Aussage als variance of a sum of uncorrelated variables an; unabhängige Variablen sind stets unkorreliert, die Regel deckt sie also ab.
Bei streuen die rohen Scores typischerweise über etwa ; skaliert über etwa , bei jeder Breite.
Weit gestreute Scores sättigen das Softmax (Schritt 3), und seine Gradienten verschwinden. Liegt ein Score in einer Zeile weit über den anderen, gibt das Softmax diesem Key ein Gewicht nahe 1 und jedem anderen Key ein Gewicht nahe 0. Eine kleine Änderung an einem Score bewegt die Gewichte dann kaum, der Gradient, der Queries und Keys erreicht, liegt nahe null, und das Training hat fast nichts, womit es sie anpassen könnte. Das Paper bietet dies als wahrscheinliche Erklärung für ein früheres Ergebnis an: Ohne die Skalierung schnitt Dot-Product Attention bei großem schlechter ab als additive Attention, eine ältere Form, die Query und Key mit einem kleinen Netz bewertet (Britz et al., 2017). Die Gradienten selbst misst das Paper nicht.
-
Das Softmax macht aus jeder Score-Zeile Gewichte. Sei eine Zeile der skalierten Scores. Die Exponentialfunktion , auch geschrieben, verwendet die Konstante . Dann ist , wobei nur ein zweiter Indexname ist, die Summe also über alle Keys der Zeile läuft. Die Gewichte sind positiv, und jede Zeile summiert sich zu 1.
-
Multipliziert man die -Gewichte mit den -Values, wird die Key-Achse weggesummiert. Zeile der -Ausgabe ist ein gewichteter Mittelwert der Value-Zeilen, gewichtet danach, wie gut jeder Key zu Query passte.
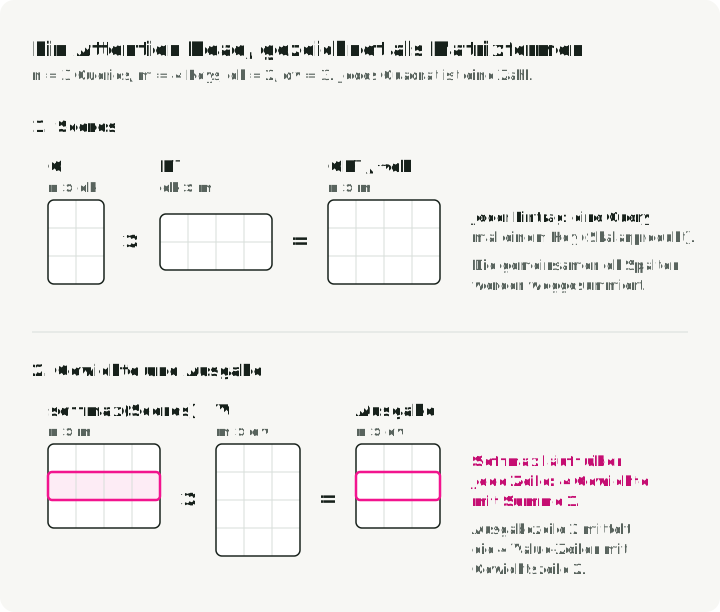
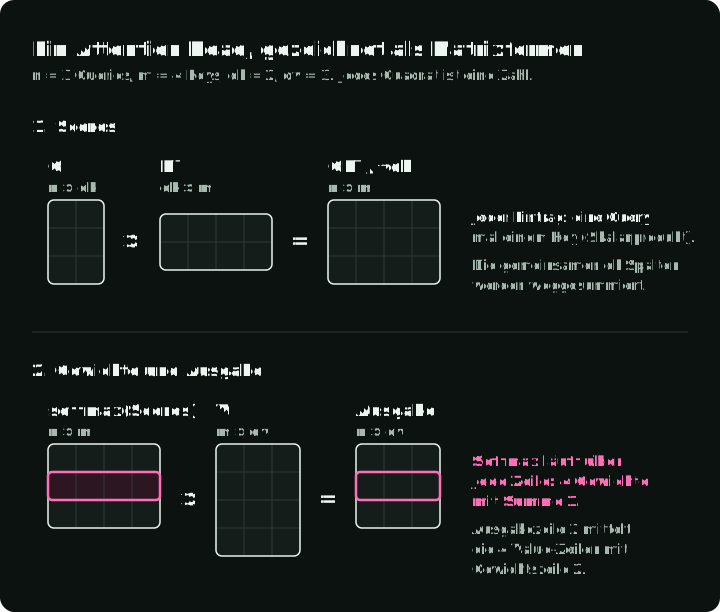
Zählen Sie die Quadrate in der Abbildung: Jedes Produkt entfernt die Achse, die seine beiden Raster teilen.
Prüfen Sie es mit zwei Zahlen. Nehmen Sie eine Query und zwei Keys, deren skalierte Scores sind, so gewählt, dass die Exponentialwerte 1 und 3 ergeben, und die Values und . Die Abbildung rechnet es durch, eine Operation pro Spalte:
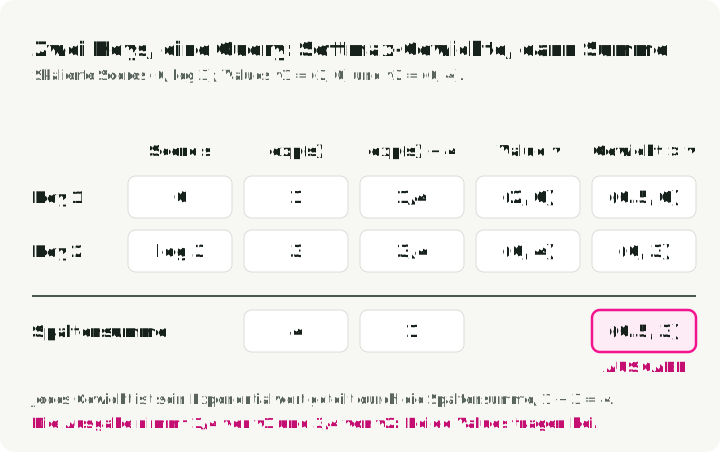
Attention hat beide Values gemischt; sie hat nicht das besser passende Token ausgewählt.
Vergleichen Sie es mit Code. Die NumPy-Funktion unten implementiert einen Head. k.T ist die Transponierte. axis=1 ist die Key-Achse, jede Query-Zeile wird also separat normalisiert. Das Zeilenmaximum wird vor np.exp abgezogen: Addiert man dieselbe Zahl zu jedem Score einer Zeile, kürzt sie sich im Softmax-Quotienten heraus, das Ergebnis bleibt also gleich, aber große Scores laufen nicht mehr über. Die optionale Maske setzt blockierte Scores auf , wodurch ihre Gewichte exakt null werden. Ein Decoder verwendet eine solche Maske, damit kein Token spätere Tokens beachtet (§3.2.3 des Papers).
Speichern Sie den Block als attention_example.py und führen Sie uv run --with numpy python attention_example.py aus. Die Prüfungen laufen ohne Ausgabe durch.
import numpy as np

def attention(q, k, v, allowed=None):
    """One head. q: [n, dk], k: [m, dk], v: [m, dv], allowed: bool [n, m]."""
    scores = q @ k.T / np.sqrt(q.shape[1])  # [n, m]
    if allowed is not None:
        if not allowed.any(axis=1).all():
            raise ValueError("every query needs at least one allowed key")
        scores = np.where(allowed, scores, -np.inf)
    scores = scores - scores.max(axis=1, keepdims=True)
    weights = np.exp(scores)
    weights = weights / weights.sum(axis=1, keepdims=True)  # rows sum to 1
    return weights @ v, weights  # [n, dv], [n, m]

# The two-key example from the text.
out, w = attention(
    np.array([[1.0]]),
    np.array([[0.0], [np.log(3.0)]]),
    np.array([[2.0, 0.0], [0.0, 4.0]]),
)
np.testing.assert_allclose(w, [[0.25, 0.75]])
np.testing.assert_allclose(out, [[0.5, 3.0]])

# A causal mask: query i may attend only to keys 0..i.
x = np.random.default_rng(0).normal(size=(3, 4))
out, w = attention(x, x, x, allowed=np.tril(np.ones((3, 3), dtype=bool)))
assert out.shape == (3, 4)
np.testing.assert_allclose(w.sum(axis=1), 1.0)
assert np.all(w[np.triu_indices(3, k=1)] == 0)
Eine Query, deren Keys alle blockiert sind, ist ein Fall, den die Gleichung offenlässt: Jedes Gewicht in ihrer Zeile wäre . Die Funktion löst einen Fehler aus, statt NaN zurückzugeben.
Von einem Head zu mehreren. Der Basis-Transformer führt acht Heads parallel aus, jeder mit eigenen gelernten Matrizen zur Erzeugung von , und und jeweils mit . Er konkateniert ihre Ausgaben und multipliziert das Ergebnis mit einer weiteren gelernten Matrix, (Attention Is All You Need, §3.2.2).
Eine Implementierung kann auch einen Batch verarbeiten: mehrere Eingabesequenzen gemeinsam. PyTorchs Scaled Dot-Product Attention akzeptiert zum Beispiel einen Query-Tensor Q der Form [batch, heads, n, d_k]. Die ersten beiden Dimensionen wählen eine Sequenz und einen Head aus; Q[b, h] ist die [n, d_k]-Matrix für dieses Paar. Die Attention-Formel wird auf jedes Paar getrennt angewendet. Die NumPy-Funktion hier behandelt nur ein solches Paar: Ihre Operationen .T und axis=1 setzen zweidimensionale Eingaben voraus.
Sechs Fragen an jede Gleichung
| Frage | Antwort für Attention |
|---|---|
| Was gibt die Gleichung zurück, und mit welcher Form? | Eine -Matrix: eine Ausgabezeile pro Query |
| Ist jedes Symbol Daten, ein trainiertes Gewicht, ein eingefrorenes Modell, eine Einstellung oder ein Sample? | , und werden aus Tokens durch gelernte Matrizen berechnet; ist eine feste Einstellung; nichts wird gesampelt |
| Über welchen Index oder welche Achse läuft jede Operation? | Das Softmax läuft über die Keys in der Zeile jeder Query; das Produkt der Gewichte mit summiert über die Keys |
| Wo stehen die Definitionen? | Im Absatz vor Gleichung (1), in Fußnote 4 und in §3.2.2 für die gelernten Projektionen |
| Was liefert eine Prüfung mit zwei oder drei Zahlen? | Gewichte und Ausgabe |
| Was musste der Code entscheiden, das die Gleichung offenlässt? | Das Abziehen des Zeilenmaximums, der Wert für maskierte Scores, eine Zeile ohne erlaubten Key |
Welche Art von Aussage eine Gleichung macht
Attention ist eine Berechnung: Sie sagt, wie man aus Eingaben eine Ausgabe erhält. Paper schreiben aber auch Gleichungen, die andere Aufgaben erfüllen:
| Art | Beispiel in dieser Serie | Worauf zu achten ist |
|---|---|---|
| Berechnung | Die Attention-Ausgabe; der komprimierte Vektor von MLA | Die Form jedes Zwischenergebnisses |
| Definition | GRPOs Score relativ zu anderen Antworten | Wofür der neue Name steht, damit Sie ihn zurückersetzen können |
| Zielfunktion: ein zu minimierender Loss oder ein zu maximierender Score | Der DPO-Loss | Ob minimiert oder maximiert wird und über welche Daten gemittelt wird |
| Update-Regel | Gradient Descent; der Speicher von Gated DeltaNet | Was sich in jedem Schritt ändert und was fest bleibt |
| Nebenbedingung oder Menge erlaubter Werte | Die erlaubten Mischungsmatrizen von mHC | Wie das Paper einen Wert erzeugt, der sie erfüllt |
| Schranke: eine obere oder untere Grenze für eine Größe | Die Evidence Lower Bound (ELBO) | Die Differenz zwischen den beiden Seiten und wann sie null ist |
| Schätzer oder Metrik | pass@k | Was gezählt wird und aus wie vielen Samples |
| Empirische Anpassung | Das Scaling Law von DeepSeek LLM | Der Datenbereich, an den die Kurve angepasst wurde |
Eine Nebenbedingung nennt eine Eigenschaft, die das Ergebnis haben muss. Für Attention-Gewichte lautet sie: Jedes Gewicht ist nichtnegativ, und jede Zeile summiert sich zu 1. Das Softmax ist eine Berechnung, die Gewichte mit dieser Eigenschaft erzeugt. Die Anforderung allein sagt Ihnen nicht, dass Sie Softmax verwenden sollen.
behauptet, dass zwei Ausdrücke gleich sind. bedeutet „ist definiert als“: Es gibt einem Ausdruck einen Namen. Eine Definition kann eine Metrik, einen Loss oder eine Menge erlaubter Werte benennen, wenn Sie sehen, sagt das Ihnen also nicht, um welche Art von Gleichung aus der Tabelle oben es sich handelt.
Zum Beispiel verwendet Evaluating Large Language Models Trained on Code, das Paper, das das Code-Generierungsmodell Codex vorstellte, , um seinen Schätzer für pass@k zu definieren (Gleichung 1). Diese Metrik misst die Wahrscheinlichkeit, dass mindestens eines von erzeugten Programmen die Tests besteht. Im DeepSeek-V4 Technical Report kombiniert Gleichung (2) zwei Aussagen: definiert eine Menge erlaubter Matrizen, und verlangt, dass die Mischungsmatrix des Modells zu dieser Menge gehört. Die Definition verwendet , die Nebenbedingung , „gehört zu“. Die Abschnitte zu pass@k und mHC rechnen diese Beispiele durch.
Die neue Gleichung, ihre Definitionen und ihren Code finden
Der Methodenteil eines Papers beschreibt, wie sein Modell oder Trainingsalgorithmus funktioniert. Die Überschrift kann „Method“, „Architecture“ oder etwas Konkreteres lauten. Autoren erklären oft zuerst eine bestehende Methode und zeigen dann, was sie geändert haben. Um den behaupteten Beitrag zu erkennen, beginnen Sie mit der Zusammenfassung der Neuerungen in der Einleitung. DeepSeekMath, §1.1 nennt zum Beispiel Group Relative Policy Optimization (GRPO), seine Methode, Modelle aus bewerteten Antworten zu trainieren. Abschnitts- und Gleichungsnummern beziehen sich hier auf das verlinkte Paper.
Vergleichen Sie dann die vorgeschlagene Methode mit der früheren Methode, die sie ändert. Zwei Paper zeigen das:
- Eine Architekturänderung. DeepSeek-V2 beschreibt Standard-Multi-Head-Attention in §2.1.1 und führt Multi-head Latent Attention (MLA) in §2.1.2 ein. Standard-Attention speichert Keys und Values jedes früheren Tokens. MLA speichert einen komprimierten Vektor, aus dem sie sich rekonstruieren lassen. Der Vergleich dieser Gleichungen zeigt, was das Modell anders speichert; der MLA-Walkthrough leitet die Speicherersparnis her.
- Eine Trainingsänderung. DeepSeekMath, §4.1.1 gibt die Zielfunktion von Proximal Policy Optimization (PPO) als Gleichung (1) an und GRPO als Gleichung (3). Beide verwenden einen Advantage: eine Zahl, die sagt, ob eine Antwort besser oder schlechter war als erwartet. PPO schätzt ihn mit einem zweiten gelernten Netz, dem Value Model, das die noch ausstehende Belohnung ausgehend von einer Teilantwort vorhersagt. GRPO vergleicht stattdessen die Belohnung der Antwort mit den Belohnungen anderer Antworten auf dieselbe Frage. Der GRPO-Walkthrough vergleicht diese Terme anhand der Notation für ganze Antworten aus DeepSeek-R1.
Die Definitionen rund um die Gleichung finden. Prüfen Sie den vorangehenden Absatz, jeden „where …“-Satz danach, Fußnoten und Anhänge. In Attention Is All You Need definiert der Absatz vor Gleichung (1) die Dimensionen, und Fußnote 4 erklärt den Skalierungsfaktor. DeepSeek-V3 definiert die meisten seiner Routing-Symbole direkt nach Gleichung (15) und den Bias kurz vor Gleichung (16). DeepSeek-V2 entwickelt MLA über die Gleichungen (9)–(19) und fasst die Berechnung dann in Anhang C zusammen.
Algorithmus und Code prüfen. Eine Algorithmus-Box ist ein nummeriertes Pseudocode-Listing, das die Reihenfolge der Operationen angibt. DeepSeekMaths Algorithm 1 zeigt, wann Antworten erzeugt und wann das Modell aktualisiert wird. Algorithm 1 in Denoising Diffusion Probabilistic Models (DDPM) legt fest, wie das Trainingsbild, die Rauschstärke und das Rauschen gesampelt werden. Implementierungen klären weitere Details: Standardmäßig teilt np.std die Summe der quadrierten Abweichungen durch , torch.std dagegen durch . Das GRPO-Beispiel zeigt, wie diese Wahl die aus denselben Belohnungen berechneten Advantage-Werte verändert.
arXiv-Versionen können Abschnitte verschieben und Gleichungen unter neuen Nummern wiederholen, zitieren Sie also die Version. In DeepSeek-R1 v1 steht die GRPO-Zielfunktion in §2.2.1, Gleichungen (1)–(3). In v2, im Januar 2026 veröffentlicht, steht sie in §2.1, und dieselben Gleichungen tauchen als (11)–(13) in Supplementary A.3 wieder auf. Ein Link ohne Version öffnet die neueste, deshalb enthält jeder arXiv-Link in dieser Serie die Version, gegen die er geprüft wurde.
Das eigene Verständnis mit einem LLM prüfen
Ein Chat-Modell kann die Symboltabelle, den Index jeder Summe und eine Prüfung mit kleinen Zahlen entwerfen, wenn Sie ihm die Definitionen geben und es bitten, Fehlendes zu markieren. Aus einem PDF kopierter Text drückt Indizes, Exponenten und Brüche in eine Zeile; die Links „HTML (experimental)“ und „TeX Source“ auf der arXiv-Abstract-Seite liefern sauberen Text zum Einfügen. Fügen Sie die Gleichung und die Absätze darum herum mit einem Prompt wie diesem ein:
Below is equation (N) from <paper title, arXiv ID and version>, followed by
the paragraphs that define its symbols.

1. Make a table with one row per symbol: shape or type, meaning, and whether
   it is input data, a trained weight, a frozen model, a fixed setting or a
   random sample. Quote the sentence that defines it.
2. List every symbol the pasted text does not define. Do not guess them.
3. For every sum, mean, softmax, min or expectation, name the index or the
   distribution it runs over.
4. Work through the equation with the smallest numbers that use every term.
5. Say which kind of statement it is: a computation, definition, objective,
   update rule, constraint, bound, estimator or empirical fit.
Ohne Schritt 2 hindert nichts das Modell daran, eine fehlende Definition mit der üblichen Bedeutung des Buchstabens zu füllen, etwa in DPO als Standardabweichung statt als Sigmoid zu lesen. Die Zitate aus Schritt 1 machen die Tabelle überprüfbar: Suchen Sie im PDF nach jedem einzelnen, und behandeln Sie eine Zeile, deren Zitat Sie nicht finden, als Vermutung.
Dasselbe Vorgehen als Agent Skills. paper-math-skills bündelt diesen Abschnitt und die Notationsreferenz unten als zwei Skills, die für Claude Code geschrieben sind; andere Agents, die SKILL.md-Dateien laden, können sie ebenfalls verwenden. read-paper-math holt die festgelegte arXiv-Version, zitiert den Satz, der jedes Symbol definiert, liest die Gleichung von innen nach außen und führt eine Prüfung mit kleinen Zahlen aus. check-paper-math prüft eine solche Lesart gegen das Paper: Es sucht jedes Zitat, rechnet die Zahlen erneut und markiert Aussagen, die stärker oder schwächer sind als die des Papers. paper-math-readings enthält die Lesarten der Skills für die Teile 2–4, eine für jeden der 15 Abschnitte mit einer Source:-Zeile.
Notationsreferenz
Wenn Ihnen ein griechischer Buchstabe unbekannt ist, öffnen Sie die Referenz der griechischen Buchstaben in diesem Artikel (Anhang A) für seinen Namen und seine üblichen Bedeutungen. Zum Weiterüben der Mathematik bietet Stanford CS229 Auffrischungen zu Wahrscheinlichkeitsrechnung und linearer Algebra mit Übungen; die Preliminaries von Dive into Deep Learning erklären die Grundlagen mit Code.
Indizes, Zeichen und Relationszeichen
Buchstaben sind lokale Variablennamen: Jedes Paper definiert seine eigenen. Tiefgestellte Zeichen sind meist Indizes. kann die Koordinate eines Vektors oder das Beispiel in einem Dataset sein, und ist der Vektor des Modells für Token , sein Hidden State.
Hochgestellte Zeichen in Modell-Papern sind oft Labels. In ist das eingeklammerte Hochgestellte meist eine Schichtnummer, keine Potenz; in und von DeepSeek-V3 kennzeichnet es geteilte und geroutete Experten, also diejenigen, die jedes Token nutzt, und diejenigen, die ein Router auswählt (siehe das MoE-Routing-Beispiel). In DeepSeek-V2 tragen und Labels, keine Exponenten; das MLA-Beispiel definiert diese Labels. ist eine Transponierte und ein Quadrat.
bedeutet die Positionen 1 bis einschließlich , anders als bei einem Python-Slice; Paper zählen meist ab 1. bedeutet jede Position vor . wählt die Zeile aus, wie beim NumPy-Slicing.
Zeichen auf einem Buchstaben ändern seine Bedeutung meist auf eine dieser Weisen:
| Zeichen | Übliche Lesart | Beispiel oder Ausnahme |
|---|---|---|
| Eine Vorhersage oder ein Schätzwert | Beispiel: in DeepSeekMath schätzt, wie viel besser eine Antwort abschnitt als erwartet | |
| Ein Mittelwert | Ausnahme: In DDPM multipliziert die Faktoren des Rauschplans von Schritt 1 bis | |
| Eine gestörte oder unbeschränkte Version | Beispiel: In DeepSeek-V4 ist eine Matrix, bevor die Normalisierung ihre Nebenbedingungen durchsetzt | |
| Das Optimum | Ausnahme: In DPO ist die wahre Belohnung, die die Methode nie beobachtet | |
| Ein neuer Wert oder ein Zwischenwert | Beispiel: In DeepSeek-V3 ist ein Expertengewicht vor der Normalisierung | |
| Die inverse Matrix | Nicht der elementweise Kehrwert: macht rückgängig, (die Einheitsmatrix), und im Allgemeinen |
Einige Symbole außer griechischen Buchstaben haben ebenfalls mehrere Aufgaben:
| Symbol | Bedeutungen |
|---|---|
| Bedingung in ; „sodass“ innerhalb einer Menge | |
| Ein Absolutbetrag; die Länge einer Sequenz, wie in , der Token-Anzahl von GRPOs Antwort ; die Größe einer Menge | |
| „Wird gesampelt aus“ in ; „ungefähr“ in informellem Text | |
| Eine Sequenzlänge; eine Softmax-Temperatur; die Anzahl der Diffusionsschritte | |
| Ein Query-Vektor (Attention); eine Frage (GRPO); das Student-Modell (Distillation); der Encoder (ELBO) |
Fünf Zeichen sagen, wie zwei Seiten zueinander stehen. , manchmal , definiert einen neuen Namen. kennzeichnet eine Näherung, etwa den gesampelten Mittelwert in Erwartungswerte und woher die Samples kommen. bedeutet „proportional zu“, wobei eine Normierungskonstante weggelassen ist: wird erst nach der Division durch zu einer Verteilung. bedeutet „viel kleiner als“, wie in von DeepSeek-V2: Die komprimierte Breite ist viel kleiner als die Gesamtbreite aller Heads. ist eine Zuweisung, wie in einer Update-Regel.
Summen, Zählungen, Intervalle und Logarithmen
Das große addiert Terme und multipliziert sie. Der Index unter jedem Operator beginnt hier bei 1 und läuft bis zur oberen Grenze :
Der Index gehört zum Operator, so wie eine Schleifenvariable zu ihrer Schleife gehört. In läuft die Summe über , während einen Ausgabeeintrag bezeichnet. Das Ergebnis ist ein Vektor mit einem Eintrag pro : das ausgeschriebene Matrix-Vektor-Produkt . Die Indizes auf der linken Seite verraten Ihnen die Form der Ausgabe.
Der Faktor vor einer Summe entscheidet, was gleiches Gewicht bekommt. Ein Batch mit einer Antwort aus 2 Tokens und einer aus 8 Tokens, wobei der Loss auf Token von Antwort ist (bei GRPO ist stattdessen ein zu maximierender Term), lässt sich auf zwei Arten mitteln:
Im ersten Fall bekommt jede Antwort das Gewicht , aufgeteilt auf ihre Tokens:
Im zweiten Fall hat jedes Token das Gewicht . GRPO sampelt Antworten auf jede Frage, und ist die Anzahl der Tokens in Antwort . Die beiden Mittelwerte lauten dann so, für DeepSeekMaths GRPO und für DAPO, eine spätere GRPO-Variante:
Mit sind das und von oben. DAPO wechselte zum Mittel pro Token (§3.3), weil das Mittel pro Antwort den Tokens langer Antworten zu wenig Gewicht gab: Das Modell lernte zu wenig aus langen guten Antworten und bestrafte lange, repetitive schlechte nicht genug.
Eine Summe kann auch zählen. Paper tun das mit einem Indikator: einer fettgedruckten Eins, gefolgt von einer Bedingung, , die 1 ist, wenn die Bedingung wahr ist, und 0, wenn sie falsch ist. Manche Paper setzen die Bedingung in runde Klammern oder drucken stattdessen eine doppelt durchgestrichene Eins; die Bedeutung ist dieselbe. Indikatoren aufzuaddieren zählt daher, wie oft die Bedingung zutrifft. Die Accuracy ist das übliche Beispiel. Wenn die vorhergesagte Klasse und die richtige Klasse für Beispiel ist, dann ist die Anzahl der richtigen Vorhersagen. Die Vorhersagen (Katze, Hund, Hund) gegen die richtigen Labels (Katze, Katze, Hund) ergeben die Indikatoren 1, 0 und 1, die Zählung ist also 2 und die Accuracy 2/3. In einer Mixture-of-Experts-Schicht (MoE) schickt ein Router jedes Token an einige von vielen Feed-Forward-Teilnetzen, den Experten. Im Balance-Loss von DeepSeek-V3 (Gleichung 18) ist der Indikator 1, wenn der Score eines Experten für ein Token zu den höchsten Scores für dieses Token gehört, wobei angibt, an wie viele Experten jedes Token geroutet wird. Seine Summe über die Tokens einer Sequenz zählt, wie oft das geschah. Der Score lässt hier den Bias aus, den das Routing hinzufügt, die Zählung kann also von den Experten abweichen, die der Router tatsächlich wählt (MoE-Routing).
Der Binomialkoeffizient , gelesen „ über “, zählt die Möglichkeiten, verschiedene Elemente aus ohne Beachtung der Reihenfolge auszuwählen. Für ganze Zahlen ist er gleich . Das Ausrufezeichen steht für die Fakultät: , mit . Zum Beispiel ist : Fünf Elemente haben zehn verschiedene Paare. DeepSeekMoE verwendet Binomialkoeffizienten, um Expertenkombinationen zu zählen, und der pass@k-Schätzer verwendet sie, um Mengen von Samples zu zählen.
Intervalle verwenden Klammern für eingeschlossene Enden: schließt beide ein, keines. In Gated DeltaNet bedeutet strikt zwischen 0 und 1. Anderswo ist ein Paar.
Der natürliche Logarithmus kehrt die Exponentiation um: . Logarithmen machen Produkte zu Summen und Quotienten zu Differenzen: und , aber lässt sich nicht aufspalten. Deshalb arbeiten Paper mit Log-Wahrscheinlichkeiten. Der Logarithmus eines Produkts von Token-Wahrscheinlichkeiten ist eine Summe, und der Logarithmus des Quotienten der Wahrscheinlichkeiten zweier Modelle ist eine Differenz, die Form, die in den Zielfunktionen von DPO und GRPO verwendet wird. ML-Paper meinen den natürlichen Logarithmus, sofern nichts anderes gesagt wird; die Ergebnisse sind in Nats, und Logarithmen zur Basis 2 ergeben Bits. Für eine Wahrscheinlichkeit gilt , und der Wert wächst unbegrenzt, wenn sich 0 nähert, sodass eine selbstsichere falsche Vorhersage teuer ist.
Log-Sum-Exp bedeutet: jeden Score exponenzieren, die Ergebnisse addieren, dann den Logarithmus nehmen. direkt zu berechnen kann überlaufen, wenn ein Score groß ist. Suchen Sie stattdessen den größten Score und nennen Sie ihn . Die Notation bedeutet „alle Einträge vergleichen und den größten nehmen“; in NumPy m = z.max().
Ziehen Sie vor dem Exponenzieren von jedem Score ab und addieren Sie es nach dem Logarithmus wieder hinzu:
Für ist der größte Score . Die verschobenen Scores sind , die Rechnung wird also zu . Keine der Exponentialfunktionen ist größer als 1. Der Attention-Code verwendet vor dem Softmax dieselbe Subtraktion; dort kürzt sich der gemeinsame Faktor in der Division heraus, sodass nichts wieder addiert wird.
Bedingte Wahrscheinlichkeit und die Wahrscheinlichkeit von Text
ist die Wahrscheinlichkeit, die das Modell mit den Parametern der Ausgabe bei gegebener Eingabe zuweist. Der Index benennt die Parameter; manche Paper schreiben , wobei das Semikolon ebenfalls Parameter statt einer Bedingung markiert. Mit einem Punkt anstelle der Ausgabe ist die ganze Verteilung über Ausgaben statt einer einzelnen Zahl. RL-Paper schreiben dasselbe Objekt als , die Wahrscheinlichkeit, dass das Modell die Antwort auf die Frage schreibt, und nennen das Modell eine Policy.
Vertauscht man Ereignis und Bedingung, ergibt sich eine andere Zahl. Angenommen, 100 Modellantworten: 60 sind korrekt, 50 sind gültiges JSON, und 40 sind beides. Dann gilt
Sei „die Antwort ist korrekt“ und „die Antwort ist gültiges JSON“. Die bedingte Wahrscheinlichkeit beschränkt die Zählung auf Antworten, die die Bedingung erfüllen: , sofern . Das Symbol bedeutet „beide Ereignisse treten ein“. Hier ist der Bruch , dasselbe wie 40 korrekte Antworten unter 50 Antworten mit gültigem JSON.
Zwei Ereignisse sind unabhängig, wenn das Wissen, dass das eine eingetreten ist, die Wahrscheinlichkeit des anderen nicht ändert. Das verlangt . In dieser Stichprobe ist , während ist; die beobachteten Anteile erfüllen die Unabhängigkeit also nicht.
Der Satz von Bayes, auch Bayes-Regel genannt, setzt die beiden Richtungen der Bedingung in Beziehung: . Er erlaubt es, die Wahrscheinlichkeit von gegeben aus der Wahrscheinlichkeit von gegeben und den Wahrscheinlichkeiten der beiden Ereignisse zu berechnen. Das ELBO-Beispiel nutzt ihn, um die Wahrscheinlichkeit eines verborgenen Codes bei einem beobachteten Bild zu finden.
Ein Sprachmodell bewertet eine Sequenz Token für Token. Nach der Kettenregel der Wahrscheinlichkeit gilt
Jeder Faktor ist durch alle früheren Tokens bedingt, die Formel nimmt also nicht an, dass Tokens unabhängig sind. Haben drei Tokens die bedingten Wahrscheinlichkeiten 0.5, 0.2 und 0.1:
Der übliche Trainings-Loss ist das Negative dieser Summe, geteilt durch die Länge:
Beim Training stammen die früheren Tokens aus dem Dataset. Bei der Generierung sind es die eigenen früheren Entscheidungen des Modells.
Erwartungswerte und woher die Samples kommen
Ein Erwartungswert ist ein wahrscheinlichkeitsgewichteter Mittelwert:
Lesen Sie als „den Mittelwert von , wenn aus gezogen wird“. Die Notation summiert über alle möglichen diskreten Werte von . Ohne Index mittelt eine Zufallsvariable über ihre eigene Verteilung: Ist mit Wahrscheinlichkeit 0.75 gleich 1 und mit Wahrscheinlichkeit 0.25 gleich 3, dann ist .
Hat eine Variable eine Dichte , also Wahrscheinlichkeit pro Einheit von , ist der gewichtete Mittelwert ein Integral, . Das kennzeichnet als die Integrationsvariable; ohne hier angegebene Grenzen deckt das Integral ihren gesamten Bereich ab. Das Dichtebeispiel erklärt Wahrscheinlichkeit pro Einheit und zeigt ein Integral als Fläche unter einer Kurve.
Trainingscode kann nicht über jede mögliche Eingabe summieren, deshalb sampelt und mittelt er: , wobei jedes unabhängig aus gezogen wird, was Paper als schreiben. Paper nennen das eine Monte-Carlo-Schätzung, und im Code ist es loss.mean() über einen Batch. Der Batch-Mittelwert schätzt den Erwartungswert nur, wenn der Batch aus der Verteilung im Index des gezogen wird, der Index sagt Ihnen also, wie die Trainingsdaten entstehen:
- DPO mittelt über gespeicherte Beispiele : einen Prompt, eine bevorzugte Antwort und eine abgelehnte Antwort. Die Antworten werden vor dieser Trainingsphase gesammelt und gelabelt; sie können aus früherer Modellgenerierung stammen. In jedem Trainingsschritt berechnet das Modell Wahrscheinlichkeiten für diese vorgegebenen Antworten und aktualisiert seine Gewichte. Es sampelt für diesen Schritt keine frischen Antworten.
- GRPO in DeepSeek-R1: Antworten erzeugen, dann ihre Belohnungen vergleichen. Das Training zieht eine Frage aus dem Dataset, erzeugt mehrere Antworten und bewertet sie mit einer Belohnungsfunktion, etwa durch Prüfen eines mathematischen Ergebnisses oder Ausführen von Unit-Tests. Das Update bevorzugt Antworten, die über dem Gruppendurchschnitt lagen. Die Notation bedeutet „ziehe eine Frage aus der Fragenverteilung“. Die Notation bedeutet „ziehe Antworten auf diese Frage aus der Modellkopie namens “. Der Index old markiert die Kopie, die diese Antworten erzeugt hat; diese Kopie bleibt fest, solange der Batch für Updates verwendet wird. Der GRPO-Walkthrough erklärt den Belohnungsvergleich und die Updates.
- On-Policy-Distillation in MiniLLM und DeepSeek-V4: Text erzeugen, dann aus den Wahrscheinlichkeiten des Teachers lernen. Das Modell, das trainiert wird, ist der Student. Er erzeugt Text; ein eingefrorener Teacher liefert Wahrscheinlichkeiten für das nächste Token für dieselben Präfixe, und das Training verschiebt die Wahrscheinlichkeiten des Students in Richtung der des Teachers. Diese Wahrscheinlichkeiten liefern das Trainingssignal, statt GRPOs Belohnungs-Score für eine Antwort. MiniLLM schreibt vom Student gesampelten Text als : ist der Text und benennt das Student-Modell. DeepSeek-V4 nennt seinen Student und verwendet mehrere spezialisierte Teacher. Das tatsächliche Sampling-Verfahren von MiniLLM mischt außerdem Tokens bei, die aus dem Teacher gezogen werden. Der Distillation-Walkthrough erklärt die Zielfunktionen und diese Sampling-Unterscheidung.
Die Reihenfolge sagt, was das Training optimiert. Angenommen, ein Modell weist den korrekten Ausgaben zweier gleich gewichteter Trainingsbeispiele die Wahrscheinlichkeiten 0.9 und 0.1 zu. Ihre Log-Wahrscheinlichkeiten zu mitteln heißt, zuerst jeden Logarithmus zu nehmen und dann zu mitteln: np.log(probs).mean(). Den Logarithmus ihres Mittelwerts zu nehmen heißt np.log(probs.mean()). Ist die Wahrscheinlichkeit, die der korrekten Ausgabe eines zufällig gewählten Beispiels zugewiesen wird:
Negiert man diese Scores, ergeben sich Losses von 1.20 und 0.69. Ein zweites Modell, das jeder korrekten Ausgabe 0.5 zuweist, erhält bei beiden Rechnungen 0.69. Mittelt man also Wahrscheinlichkeiten vor dem Logarithmus, werden die beiden Modelle als gleich gut behandelt, während die übliche mittlere negative Log-Wahrscheinlichkeit das erste Modell stärker für seine niedrige Wahrscheinlichkeit bei der zweiten korrekten Ausgabe bestraft. Wenn Sie einen Loss in Code übersetzen, behalten Sie die Reihenfolge von Logarithmus und Mittelwert bei.
Die Jensensche Ungleichung formuliert die allgemeine Beziehung für positives : . Sie hilft auch beim Konstruieren alternativer Trainingsziele. Wenn die Datenwahrscheinlichkeit eines Modells einen teuren Mittelwert über verborgene Variablen erfordert, kann ein Mittelwert von Log-Termen eine untere Schranke liefern, die leichter zu schätzen ist. Der ELBO-Walkthrough erklärt dieses Trainingsproblem; ELBO steht für evidence lower bound. Abschnitt 2.4 von Tianhua Chens The Little Book of Generative AI Foundations leitet die Schranke mit der Jensenschen Ungleichung her.
Dichten, Varianz und Fehlerbalken
hat zwei gängige Bedeutungen. Für diskrete Ergebnisse wie Tokens oder Klassen gibt es die Wahrscheinlichkeit des Ergebnisses an: eine Zahl von 0 bis 1, wobei sich die Wahrscheinlichkeiten über alle Ergebnisse zu 1 summieren.
Um die andere Bedeutung zu verstehen, nehmen Sie an, wird gleichverteilt zwischen 0 und 0.5 gewählt. Intervalle gleicher Länge haben gleiche Wahrscheinlichkeiten. Das Intervall von 0.1 bis 0.2 nimmt ein Fünftel des gesamten Bereichs ein, also
In diesem Bereich ist die Wahrscheinlichkeit die Breite des Intervalls mal 2. Dieser Faktor ist die Wahrscheinlichkeitsdichte: für und null außerhalb. Die Dichte beschreibt Wahrscheinlichkeit pro Einheit der Variablen, nicht die Wahrscheinlichkeit eines exakten Wertes.
Wahrscheinlichkeit null für einen Punkt heißt nicht, dass nichts gesampelt wird. Verengen Sie ein Intervall um 0.15: Seine Wahrscheinlichkeit ist das Doppelte seiner Breite und nähert sich null, wenn die Breite gegen null geht. Der einzelne exakte Punkt hat daher Wahrscheinlichkeit null. Eine Ziehung liefert trotzdem irgendeinen Wert in , und dieses ganze Intervall hat Wahrscheinlichkeit 1. Wenn Sie das Ergebnis auf zwei Dezimalstellen gerundet aufzeichnen, steht ein aufgezeichneter Wert von 0.15 für das Intervall von 0.145 bis 0.155, dessen Wahrscheinlichkeit ist.
Bei einer nicht gleichförmigen Dichte variiert der Faktor mit . Das Integral addiert die Beiträge über das Intervall:
Geometrisch ist das die Fläche unter der Dichtekurve zwischen und ; die Fläche über den ganzen Bereich ist 1. Im gleichförmigen Beispiel ist die Fläche einfach Höhe 2 mal Breite 0.5. Eine Dichte kann also größer als 1 sein, und ihr Logarithmus kann positiv sein, wie hier . Eine Wahrscheinlichkeit ist nie größer als 1.
Die Gauß-Verteilung, die in DDPM für das Rauschen verwendet wird, hat eine Dichte dieser Art. Nicht jede stetige Verteilung hat eine gewöhnliche Dichte: Die Cantor-Verteilung ist ein mathematisches Gegenbeispiel, außerhalb der hier besprochenen Modelle. Auch reellwertige Speicherung bedeutet keine stetige Verteilung: Eine Variable, die auf 0.0 und 1.0 beschränkt ist, hat weiterhin zwei diskrete Ergebnisse.
Paper verwenden oft denselben Buchstaben für Wahrscheinlichkeiten und Dichten. Prüfen Sie, wie das Paper die Verteilung der Variablen definiert und über welche Variable summiert oder integriert wird. Ein Integral über eine verborgene Variable , etwa den latenten Code im ELBO von Teil 4, sagt Ihnen nicht, ob ein beobachtetes diskret oder stetig ist. Manche Paper schreiben großes für Wahrscheinlichkeiten und kleines für Dichten, viele verwenden aber für beides.
Um zu beschreiben, wie stark eine Verteilung um ihren Mittelwert streut, verwenden Paper die Varianz: den mittleren quadrierten Abstand vom Mittelwert, , wobei . Die Standardabweichung ist ihre Quadratwurzel und hat daher dieselbe Einheit wie .
Diese Größen tauchen auch in Verteilungsnamen auf. Die Gauß-Verteilung, auch Normalverteilung genannt, wird geschrieben: ist ihr Mittelwert und ihre Varianz. Für einen Vektor verwendet eine Kovarianzmatrix : Der Eintrag misst, wie die Koordinaten und gemeinsam variieren, und die Diagonale enthält ihre Varianzen. beschreibt einen Vektor unabhängiger standardnormalverteilter Zahlen, jede mit Mittelwert 0 und Varianz 1; ist die Einheitsmatrix.
Benchmark-Tabellen geben oft einen Durchschnittswert zusammen mit einem Streuungsmaß an. Die Streuung einzelner Läufe unterscheidet sich von der Unsicherheit ihres Durchschnitts: Für unabhängige Läufe mit Standardabweichung ist der Standardfehler des Mittelwerts .
Bevor Sie zwei Einträge wie und vergleichen, finden Sie in der Beschriftung heraus, ob 0.4 eine Standardabweichung über Läufe, ein Standardfehler oder die halbe Breite eines Konfidenzintervalls ist. Um die Mittelwerte zu vergleichen, berechnen Sie ein Intervall für ihre Differenz. Ein 95-%-Konfidenzintervallverfahren erzeugt Bereiche, die die wahre Differenz in 95 % der wiederholten Experimente unter seinen Annahmen enthalten.
Für dieses Beispiel nehmen Sie vier unabhängige Läufe pro Modell, annähernd normalverteilte Lauf-Scores und gleiche Populationsvarianzen an. Sind die Läufe gepaart, etwa zwei Modelle, die auf denselben unabhängig gezogenen Aufgaben ausgewertet wurden, analysieren Sie stattdessen die Differenzen innerhalb der Paare. Der NIST-Leitfaden zu Zwei-Stichproben-Tests erklärt diese Fälle.
Bei unabhängigen Mittelwerten ist die Varianz ihrer Differenz die Summe ihrer Varianzen. Eine standardnormalverteilte Variable liegt mit Wahrscheinlichkeit von etwa 0.95 zwischen und , was den Faktor für eine Normalapproximation eines 95-%-Intervalls liefert. Ist 0.4 die Standardabweichung über vier Läufe, ergibt diese erste Rechnung:
Dieser Faktor 1.96 behandelt die geschätzte Streuung als bekannt. Bei nur vier Läufen pro Modell verwenden Sie die Student-t-Verteilung, um die Unsicherheit der Streuung zu berücksichtigen. Unter den obigen Annahmen sind ihre Freiheitsgrade (acht Läufe minus zwei geschätzte Mittelwerte). scipy.stats.t.ppf(0.975, 6) liefert etwa 2.447 statt 1.96; 0.975 lässt 2.5 % an jedem Ende eines 95-%-Intervalls außerhalb. Ist die Annahme gleicher Varianzen ungeeignet, verwenden Sie ein Welch-Intervall, dessen Freiheitsgrade anders berechnet werden.
Betrachten Sie nun die andere Lesart der Beschriftung: 0.4 ist bereits der Standardfehler jedes Mittelwerts, geschätzt aus diesen vier Läufen. Es wird nichts durch geteilt, und der Standardfehler der Differenz beträgt etwa 0.566. Der t-Faktor wird weiterhin gebraucht. Die beiden Lesarten ergeben:
Die Abbildung vergleicht die anfängliche Normalapproximation mit den beiden t-Intervallen:
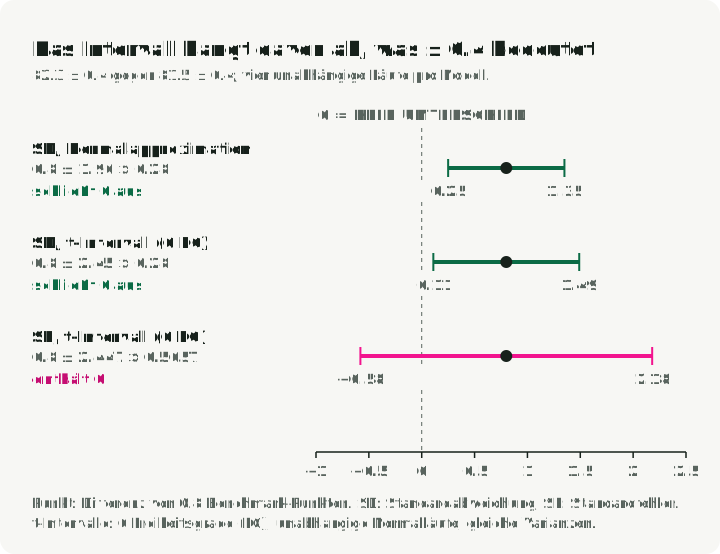
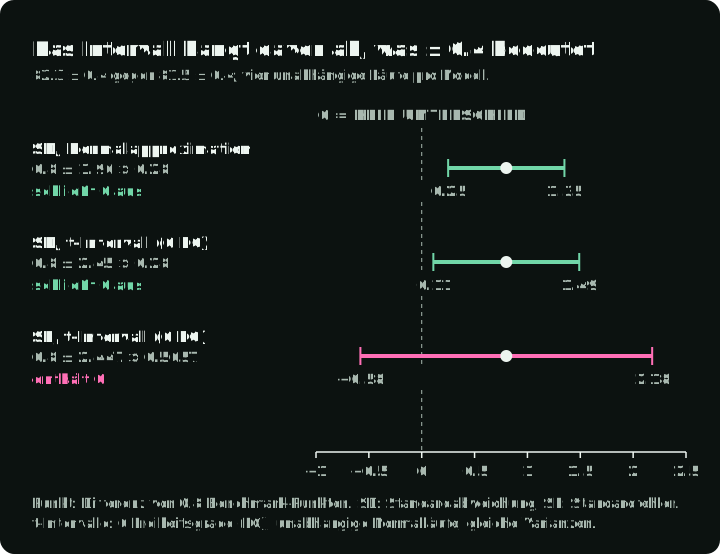
Ist 0.4 die Standardabweichung, schließt das t-Intervall null aus: Unter diesen Annahmen stützen die Ergebnisse eine positive Differenz. Ist 0.4 der geschätzte Standardfehler, enthält das Intervall null, die Ergebnisse stellen also nicht fest, welches Modell den höheren mittleren Score hat.
Kreuzentropie und KL-Divergenz
Beim Training braucht ein Modell einen numerischen Loss, der misst, wie gut seine vorhergesagten Wahrscheinlichkeiten mit dem Trainingsziel übereinstimmen. Der Trainingsalgorithmus ändert die Parameter des Modells, um diesen Loss zu senken. Die Kreuzentropie liefert einen solchen Loss für gelabelte Beispiele oder die Wahrscheinlichkeiten eines Teacher-Modells. Die Kullback-Leibler-Divergenz (KL) misst die Abweichung zwischen zwei Verteilungen. Paper verwenden sie, um einen Student zum Nachahmen eines Teachers zu trainieren oder Abweichungen von einem festen Referenzmodell zu bestrafen.
Hier sind die Ergebnisse diskret, etwa Tokens oder Klassen. Schreiben Sie die Zielverteilung als und die vorhergesagte Verteilung des Modells über dieselben Ergebnisse als . Beginnen Sie mit einem beobachteten Ergebnis : Hat das Modell ihm die Wahrscheinlichkeit gegeben, ist sein Loss . Er ist 0 für , etwa 0.69 für , etwa 2.3 für und unendlich für .
Die Kreuzentropie mittelt diesen Loss über Ergebnisse, die aus dem Ziel gezogen werden:
Bei einem One-Hot-Label , das auf der korrekten Klasse gleich 1 und sonst 0 ist, zählt nur die korrekte Klasse, und : der gewöhnliche Klassifikations-Loss. PyTorchs nn.CrossEntropyLoss berechnet ihn aus rohen Modell-Scores, den Logits, und wendet intern Log-Softmax an; seine Eingabe ist nicht der Wahrscheinlichkeitsvektor . Mit der weichen Verteilung eines Teacher-Modells als zählt jede Klasse proportional zur Wahrscheinlichkeit des Teachers. Klassische Distillation trainiert auf diese Weise ein kleines Modell auf den Wahrscheinlichkeiten eines großen. Für das Ziel haben zwei Modelle diese Kreuzentropien :
Das zweite Modell trifft das Ziel, und kein Modell kann besser abschneiden. Dieses Minimum, hier 0.325, ist , die Entropie von . Sie ist nur für ein One-Hot-Ziel 0: Ist das Ziel selbst unsicher, bleibt ein Loss, den kein Modell beseitigen kann.
Die KL-Divergenz zieht dieses Minimum ab und behält nur den Loss, der dadurch entsteht, dass von abweicht. Sie wird mit einem doppelten Strich geschrieben, der nur die beiden Argumente trennt; er ist weder der Strich der bedingten Wahrscheinlichkeit aus Bedingte Wahrscheinlichkeit und die Wahrscheinlichkeit von Text noch die Längenstriche der Vektoren-Referenz. Paper verwenden ihn statt eines Kommas, um zu markieren, dass die Reihenfolge zählt: Der Mittelwert läuft über Ergebnisse, die aus dem ersten Argument gezogen werden.
Für das erste Modell oben ist es . Die KL ist 0, wenn die beiden Verteilungen übereinstimmen, und sonst positiv.
Die Reihenfolge ändert, welche Abweichungen bestraft werden. Ein Term mit und ist unendlich, daher bestraft dafür, irgendetwas, das erzeugen kann, die Wahrscheinlichkeit null zuzuweisen. Ergebnisse mit tragen nichts bei (per Konvention ), sie verursachen also keine direkte Strafe, selbst wenn . Vertauscht man die Argumente, erhält man , das überall unendlich ist, wo und . Ergebnisse mit tragen nun nichts bei, selbst wenn . Mit als Ziel heißt die Forward-KL und die Reverse-KL.
Für und ist die Forward-KL unendlich, weil ein Ergebnis verfehlt, das erzeugt, während die Reverse-KL nur beträgt: Das Ergebnis, das überspringt, trägt nichts bei. Für und ist die Forward-KL die oben gefundene 0.37, hier Term für Term berechnet, und die Reverse-KL unterscheidet sich:
Diese Asymmetrie ist der Grund, warum die KL eine Divergenz heißt und kein Abstand.
Weil gilt und die Entropie eines festen Teachers nicht vom Student abhängt, liefert die Kreuzentropie gegen einen festen Teacher dem Student dieselben Gradienten wie . Ändert man einen Student-Parameter, ändern sich beide Losses um denselben Betrag, ihre fürs Training verwendeten Ableitungen sind also gleich; Gradienten und Optimierung erklärt diese Rechnung. Deshalb darf Klassifikations- und klassischer Distillation-Code die Kreuzentropie verwenden. Der Tausch funktioniert nur mit dem Teacher an erster Stelle. Mit dem Student an erster Stelle ist , und die eigene Entropie des Students ändert sich während des Trainings, sodass beide nicht mehr dieselben Gradienten liefern.
Vektoren und Matrizen
Architekturgleichungen beschreiben Berechnungen auf Arrays von Zahlen. Die Form eines Arrays sagt Ihnen, wie seine Zahlen angeordnet sind, welche Operationen gültig sind und was sie ergeben. Ein Vektor ist eine geordnete Liste von Zahlen. Eine Matrix ordnet Zahlen in Zeilen und Spalten an. In ML-Code ist Tensor der allgemeine Begriff für diese numerischen Arrays, einschließlich Arrays mit mehr als zwei Achsen. Eine Achse ist eine Dimension, entlang der man das Array indiziert: Eine Matrix hat eine Zeilenachse und eine Spaltenachse.
Der Hidden State eines Tokens ist ein Vektor von Zahlen, der im Modell berechnet wird, um dieses Token darzustellen. Angenommen, wir verarbeiten einen Batch von Sequenzen gemeinsam, jede mit Token-Positionen, und jeder Hidden State enthält Zahlen. Das Hidden-State-Array hat die Form [B, T, d], was Paper auch als schreiben. Seine drei Achsen wählen die Sequenz, die Token-Position und die Zahl innerhalb des Vektors dieses Tokens aus. Zum Beispiel enthält [2, 3, 4] zwei Sequenzen, drei Token-Vektoren pro Sequenz und vier Zahlen pro Vektor: insgesamt 24 Zahlen. Hier ist die Breite des Vektors. Die Form listet die drei Größen auf; ihr Produkt ergibt die Anzahl der Einträge.
Paper schreiben Formen oft als Mengenzugehörigkeit: bedeutet, dass ein Vektor aus reellen Zahlen ist, und , dass eine Matrix mit Zeilen und Spalten ist. Fettgedruckte Buchstaben kennzeichnen manchmal Vektoren oder Tensoren, aber die Definition im Paper bestimmt die Form.
In der Tabelle unten sind und Spaltenvektoren: Ihre Zahlen sind vertikal angeordnet. Das hochgestellte bedeutet Transponierte: Zeilen und Spalten vertauschen. ist also eine Zeile mit denselben Zahlen wie die Spalte . Die Großbuchstaben und bezeichnen hier Matrizen; bedeutet nicht mehr die Batch-Größe.
| Ausdruck | Verwendete Werte | Was die Operation tut | Ergebnis |
|---|---|---|---|
| — Skalarprodukt | Zwei Spaltenvektoren mit je Einträgen | Entsprechende Einträge multiplizieren, dann die Produkte addieren: | Eine Zahl |
| — äußeres Produkt | Eine Spalte mit Einträgen und eine Spalte mit Einträgen | Jeden Eintrag von mit jedem Eintrag von multiplizieren | Eine -Matrix; Eintrag ist |
| — Matrixprodukt | mit Zeilen und Spalten; mit Zeilen und Spalten | Für Eintrag die entsprechenden Zahlen in Zeile von und Spalte von multiplizieren, dann addieren | Eine -Matrix; die Spaltenzahl von muss der Zeilenzahl von entsprechen |
| — elementweises Produkt | Zwei Arrays derselben Form | Einträge an übereinstimmenden Positionen multiplizieren, ohne sie zu addieren | Ein Array derselben Form |
| — Konkatenation | Spalten und mit und Einträgen | Die Einträge von hinter die von setzen | Eine Spalte mit Einträgen; die Konvention des Papers für die Verbindungsachse prüfen |
Für einen konkreten Vergleich nehmen Sie und . Das Verschieben der Transponierten ändert sowohl die Rechnung als auch das Ergebnis:
Das Skalarprodukt liefert einen Score, wie beim Query-Key-Vergleich in Attention. Das äußere Produkt behält für jedes Paar von Einträgen einen eigenen Wert; das Update von Gated DeltaNet nutzt es, um aus zwei Vektoren ein Matrix-Update zu bilden.
Ein Matrixprodukt lässt sich umgruppieren, , aber nicht umordnen; die MLA-Herleitung nutzt das Umgruppieren, um das Neuaufbauen der Keys zu überspringen. NumPy schreibt die Matrixmultiplikation als @ und das elementweise Produkt als *. Paper übernehmen nicht NumPys Broadcasting-Regeln: Das Addieren eines Vektors zu einer Matrix braucht eine angegebene Achse. Paper unterscheiden sich auch darin, ob ein Vektor eine Zeile oder eine Spalte ist: Attention stapelt Tokens als Zeilen von , während MLA, Gated DeltaNet und LoRA mit Spaltenvektoren schreiben und PyTorchs nn.Linear x @ W.T auf Zeilen berechnet.
Eine Architekturgleichung kann auch die Größe eines Vektors beschreiben, einschränken, welche Matrizen erlaubt sind, oder ein Produkt umordnen:
| Notation | Bedeutung |
|---|---|
| Die euklidische Länge; , ohne die Wurzel, kommt in DDPMs Loss vor | |
| Die Summe der Absolutbeträge | |
| Die Spektralnorm: der größte Faktor, um den die Länge eines Vektors vergrößert; mHC hält sie bei höchstens 1 | |
| Die Anzahl der unabhängigen Spalten; das Update von LoRA hat Rang höchstens | |
| Die Determinante: ist der Faktor, um den Volumen skaliert, und das Vorzeichen zeigt an, ob die Orientierung umkehrt; das Change-of-Variables-Beispiel in Anhang B dieses Artikels verwendet sie | |
| Jeder Eintrag ist nichtnegativ, wie in mHC; ist eine andere Bedingung, positiv semidefinit: für jedes | |
| , | Die Einheitsmatrix (1 auf der Diagonale, sonst 0, also ); ein Vektor aus Einsen |
| Das Transponieren eines Produkts kehrt die Reihenfolge um; die RoPE- und MLA-Abschnitte von Teil 2 verwenden das |
Gradienten und Optimierung
Das Training nutzt Ableitungen, um zu entscheiden, wie die Parameter des Modells geändert werden. Sei ein skalarer Loss und der Vektor aller Parameter; ist ein Eintrag in diesem Vektor.
Die partielle Ableitung ist eine Zahl, ausgewertet an den aktuellen Parameterwerten. Sie misst die Änderungsrate des Losses, wenn sich nur ändert und die anderen Parameter fest bleiben. Lesen Sie sie als „die partielle Ableitung des Losses nach dem Parameter “.
Der Gradient sammelt diese Zahlen für jeden Parameter in einem Vektor. Sein -ter Eintrag ist . Das Symbol heißt Nabla; hier bedeutet es „bilde den Gradienten“. Bei nur einem Parameter hat der Gradient einen Eintrag, der der gewöhnlichen Ableitung entspricht.
Nehmen Sie als Beispiel . Bei und :
Die erste partielle Ableitung, 4, bedeutet: Erhöht man um 0.01, steigt der Loss um etwa 0.04, während fest bleibt. Der Gradient enthält diese Information für beide Parameter. Gradient Descent zieht die Ableitung jedes Parameters ab, multipliziert mit einer positiven Lernrate , die die Schrittweite steuert:
Mit ändert sich das Beispiel von zu , und der Loss fällt von 7 auf 3.04. Bei einem differenzierbaren Loss mit nichtverschwindendem Gradienten senkt ein ausreichend kleiner Schritt den Loss. Ein Gradient null ergibt kein Update.
Der Index an sagt, was variiert. variiert die Parameter; variiert die Eingabe, und Diffusions-Paper nennen ihn den Score, der nichts mit einem Benchmark-Score zu tun hat.
Eine Jacobi-Matrix hält Ableitungen für mehrere Ausgaben fest. Eine Schicht eines neuronalen Netzes kann viele Zahlen erzeugen, etwa die Komponenten des Hidden State eines Tokens. Um zu beschreiben, wie jede Ausgabe auf jede Eingabe reagiert, sammelt man die partiellen Ableitungen in einer Matrix, der Jacobi-Matrix. Für mit Eingabezahlen und Ausgabezahlen hat sie die Form : Zeilen entsprechen Ausgaben, Spalten Eingaben, und der Eintrag misst, wie sich Ausgabe ändert, wenn sich Eingabe ändert.
Eine Funktion nehme zum Beispiel zwei Zahlen und gebe und zurück. Ihre Jacobi-Matrix ist
Die zweite Spalte sagt, dass eine Erhöhung von um 0.1 bei festem den Wert um 0.2 erhöht und um 0.1 senkt. Dieses Beispiel ist linear, seine Jacobi-Matrix ist also konstant. Bei einer nichtlinearen Funktion können die Einträge vom aktuellen Input abhängen und kleine Änderungen lokal beschreiben. Mit nur einer skalaren Ausgabe hat die Jacobi-Matrix eine Zeile: dieselben Ableitungen wie der Gradient, bei unserer Spaltenvektor-Konvention transponiert. Deep Learning, §4.3, gibt die allgemeinen Definitionen.
Backpropagation nutzt diese Ableitungen, um den Loss-Gradienten durch aufeinanderfolgende Schichten zu berechnen. Das Change-of-Variables-Beispiel in Anhang B dieses Artikels nutzt eine andere Eigenschaft: Der Absolutbetrag der Determinante einer quadratischen Jacobi-Matrix gibt den lokalen Volumenskalierungsfaktor an, der zum Anpassen einer Wahrscheinlichkeitsdichte nötig ist.
Beim Training beschreiben Ableitungen lokale Änderungen; ein Optimierungsziel legt fest, was die Updates minimieren oder maximieren sollen. Paper unterscheiden den besten Wert einer Zielfunktion von den Parametern, die ihn erreichen: ist der kleinste Wert von , während die Parameterwerte angibt, die ihn erreichen. Für ist das Minimum 0 und das Argmin 3. Ein Argmin legt das gewünschte Ergebnis fest, lässt aber den Update-Algorithmus offen.
MiniLLM schreibt sein Ziel zum Beispiel als (Gleichung 1), wobei das Student-Modell ist und der Teacher, von dem es lernt. Abschnitt 2.2 leitet dann einen Gradienten her und ändert ihn, um das Training stabiler zu machen; Gleichung (7) ist der für Updates verwendete Gradient. Das On-Policy-Distillation-Beispiel erklärt diese Änderungen. Wer nur das Argmin liest, übersieht sie.
Ein Stop-Gradient, , gibt unverändert weiter, blockiert aber Gradienten durch sich hindurch, wie .detach() in PyTorch. Zwei Ausdrücke mit demselben Vorwärtswert können unterschiedlich trainieren, wenn einer von ihnen abgetrennt ist. Im GRPO-Beispiel behandelt Hugging Face TRL die Log-Wahrscheinlichkeit des alten Modells als fest. In der von DeepSeek-V4 besprochenen Distillation-Abkürzung liefert ein abgetrenntes Teacher-Student-Log-Verhältnis ein festes Gewicht für das Update.
Mengen und Nebenbedingungen
Eine Nebenbedingung sagt, welche Werte erlaubt sind. Paper drücken Nebenbedingungen oft mit Mengen aus: Sammlungen verschiedener Elemente, in geschweiften Klammern geschrieben, etwa . Die Reihenfolge spielt keine Rolle, benennt also dieselbe Menge. Wiederholte Einträge zählen nur einmal. Dagegen beschreiben die runden Klammern bei einem Vektor wie eine geordnete Liste: ist ein anderer Vektor.
Sobald ein Paper eine Menge definiert, kann es Zugehörigkeit testen, Mengen kombinieren, ihre Elemente zählen oder eine Bedingung über sie aufstellen. Nehmen Sie und :
| Notation | Bedeutung | Beispiel und wie man es liest |
|---|---|---|
| Zugehörigkeit: gehört zu | : 2 ist ein Element von | |
| Vereinigung: jedes Element beider Mengen aufnehmen | ; die 3 nur einmal aufnehmen | |
| Schnittmenge: nur Elemente behalten, die beide Mengen gemeinsam haben | ||
| Die Anzahl der verschiedenen Elemente | ||
| „Für jedes“: Eine Bedingung muss für alle genannten Elemente gelten | : Jedes Element von ist positiv | |
| „Es gibt“: Mindestens ein Element muss die Bedingung erfüllen | : hat ein Element größer als 2, nämlich 3 |
Die Formnotation aus Vektoren und Matrizen benennt ebenfalls Mengen: ist die Menge aller Vektoren aus reellen Zahlen und die Menge aller reellen Matrizen mit Zeilen und Spalten. legt also fest, welche Form haben muss.
Die Mengenschreibweise mit Bedingung beschreibt eine Menge durch eine Bedingung: liest sich „die Elemente von , die die Bedingung erfüllen“, wie die Python-Set-Comprehension {x for x in S if condition(x)}. Der Strich bedeutet „sodass“, nicht bedingte Wahrscheinlichkeit; manche Paper verwenden stattdessen einen Doppelpunkt. Beispiele in dieser Serie sind die erlaubten Matrizen von mHC, die ausgewählten Experten von MoE und die ausgewählten Tokens bei Sparse Attention.
DAPO, eine Trainingsmethode, die Gruppen erzeugter Antworten filtert, behält eine Frage nur, wenn einige Antworten korrekt und einige falsch sind. Für gesampelte Antworten und die Referenzantwort schreibt man die Menge der Indizes korrekter Antworten als
Der Filter ist . Die Verwendung von Indizes macht das Zählen explizit: Zwei Samples mit identischem Text zählen weiterhin als zwei Antworten. Das Paper von DAPO schreibt die Menge stattdessen über die Antworten ; wörtlich als Menge von Texten gelesen, zählt diese Form zwei identische Antworten einmal.
Übungen
- Formen. ist , ist und ist . Welche Formen haben die Scores und die Ausgabe? Über welche Achse läuft das Softmax?
- Softmax. Berechnen Sie das Softmax von . Ändert das Addieren von 100 zu beiden Eingaben das Ergebnis?
- Mittelwerte. Eine Antwort hat ein einziges Token mit Loss 4; eine andere hat drei Tokens mit Loss 0. Berechnen Sie den Mittelwert pro Token und den Mittelwert pro Antwort.
- Bedingen. Von 200 Antworten sind 120 korrekt, 80 bestehen die Formatvalidierung und 60 beides. Bestimmen Sie und .
- KL. Berechnen Sie für einen Teacher und einen Student beide KL-Richtungen.
- Mengen. DAPO behält eine Frage nur, wenn , wobei die Indizes der korrekten Antworten unter Samples enthält. Behält es mit eine Frage, deren Antworten erzielen? Eine, deren Antworten erzielen? Ändert sich die Antwort auf die erste Frage, wenn alle vier Samples identischen korrekten Text enthalten?
Antworten:
-
Die Scores haben die Form und die Ausgabe . Das Softmax läuft über die sechs Keys in der Zeile jeder Query.
-
. Das Addieren derselben Zahl zu jeder Eingabe lässt das Softmax unverändert, aber direkt zu berechnen läuft in 32-Bit-Floats über.
-
Die beiden Mittelwerte:
-
und .
-
und , weil der Student einem Ergebnis Wahrscheinlichkeit zuweist, das der Teacher ausschließt.
-
Nein: hat vier Elemente, was entspricht. Ja: hat drei Elemente, zwischen 0 und 4. Identischer Text ändert die erste Antwort nicht: Es sind vier getrennte Samples, ihre vier Indizes zählen also weiterhin.
Anhang A. Griechische Buchstaben
Die Rollen sind gängige Beispiele; jedes Paper definiert weiterhin selbst, was seine Symbole bedeuten.
| Buchstabe | Name | Gängige Rollen in ML-Papern |
|---|---|---|
| alpha | Ein Mischgewicht oder ein Skalierungsfaktor; ein Zerfall (Gated DeltaNet); ein Rauschplan (DDPM) | |
| beta | Eine Strafstärke (DPO, GRPO); eine Schreibstärke (Gated DeltaNet); ein Rauschplan (DDPM) | |
| gamma | Ein Diskontfaktor im RL; eine Schrittweite (das Bias-Update in DeepSeek-V3) | |
| delta | Eine Differenz oder eine Änderung | |
| epsilon | Rauschen (DDPM); ein Clipping-Bereich (GRPO); ein kleiner Stabilisator | |
| eta | Die Lernrate | |
| theta | Modellparameter; die Rotationswinkel von RoPE | |
| lambda | Ein Regularisierungsgewicht; ein Eigenwert | |
| mu | Ein Mittelwert; die Anzahl der Gradientenschritte pro Batch in Algorithm 1 von DeepSeekMath | |
| pi | Eine Policy; ist der Produktoperator | |
| rho | Ein Wahrscheinlichkeitsverhältnis, wie im GRPO-Abschnitt von Teil 3; eine Korrelation | |
| sigma | Die Sigmoid-Funktion (DPO); eine Standardabweichung; eine Kovarianz; ist der Summenoperator | |
| tau | Eine Temperatur; ein Schwellenwert; eine Trajektorie im RL | |
| phi | Die Parameter eines zweiten Netzes, etwa eines Encoders; Features; ein Winkel | |
| psi | Die Parameter eines weiteren Netzes, etwa des Value Models in DeepSeekMaths PPO | |
| omega | Eine Frequenz; ist außerdem eine untere Schranke in der Komplexität oder eine Ergebnismenge |
Varianten wie und sind meist derselbe Buchstabe in einer anderen Schrift, ein Paper kann aber beide für verschiedene Variablen verwenden.
Anhang B. Weitere Gleichungsfamilien
Gleichungsformen, die diese Serie nicht durchrechnet, mit den Definitionen, die jede braucht:
Selektive Zustandsraummodelle. Ein Zustandsraummodell verarbeitet eine Sequenz, indem es in jedem Schritt einen gespeicherten Zustand aktualisiert. Ein Update der Form , kombiniert den vorherigen Zustand mit der aktuellen Eingabe und berechnet dann eine Ausgabe. Hier ist die aktuelle Eingabe, der gespeicherte Zustand und die Ausgabe. Die Matrizen , und transformieren jeweils den vorherigen Zustand, fügen den Beitrag der Eingabe hinzu und erzeugen die Ausgabe. Die Querstriche kennzeichnen Parameter, die von einem zeitkontinuierlichen Modell in diskrete Schritte umgerechnet wurden; sie bedeuten keine Mittelwerte. In Mamba hängen die Update-Parameter von der aktuellen Eingabe ab, was „selektiv“ bedeutet.
Stochastische Differentialgleichungen. beschreibt, wie sich ein Zustand mit der Zeit ändert: ist seine Änderungsrate. Eine stochastische Differentialgleichung (SDE) fügt zufällige Änderungen hinzu, . Hier beschreibt die deterministische Änderung, legt die Rauschstärke fest, und ist ein Inkrement der Brownschen Bewegung. Um sie im Code zu approximieren, verwendet das Euler-Maruyama-Verfahren einen kleinen Zeitschritt und ersetzt durch Gauß-Rauschen mit der Varianz . Abschnitt 5.1 von Tianhua Chens The Little Book of Generative AI Foundations gibt ein solches Update an; §6.4 desselben Buches nutzt SDEs, um Diffusionsmodelle zu beschreiben.
Variablentransformation. Das Transformieren einer Zufallsvariablen ändert ihre Dichte danach, wie die Transformation das lokale Volumen verändert. Angenommen, bildet zwischen Räumen gleicher Dimension ab, und sowohl als auch die Umkehrfunktion sind differenzierbar. Die Dichten vor und nach der Transformation, und , erfüllen . Die Umkehrfunktion gewinnt aus zurück. Ihre Jacobi-Matrix ist die quadratische Matrix der ersten Ableitungen; der Absolutbetrag ihrer Determinante korrigiert die lokale Volumenänderung. Wenn zum Beispiel in einer Dimension gilt, wird die Dichte zu : Doppelte Breite halbiert die Dichte. Normalizing Flows nutzen invertierbare Transformationen dieser Art, um Dichten zu modellieren; Tianhua Chens Buch, §7.1, erklärt die Methode.
Min-Max-Zielfunktionen. In Generative Adversarial Networks (GANs) erzeugt ein Generator Beispiele, und ein Diskriminator versucht, sie von echten Daten zu unterscheiden. Die Zielfunktion misst den Erfolg des Diskriminators: maximiert sie, während sie minimiert. Das Ziel (Gleichung 1) sagt: Betrachte für jeden möglichen Generator den besten Diskriminator gegen ihn und wähle dann den Generator mit der kleinsten resultierenden Zielfunktion. Das Training löst diese innere Maximierung nicht exakt. Algorithm 1 des Papers wechselt Gradient-Ascent-Schritte auf mit einem Gradient-Descent-Schritt auf ab; seine Experimente verwendeten .
Der Wahrscheinlichkeitssimplex. Ein Wahrscheinlichkeitsvektor hat nichtnegative Einträge, die sich zu 1 addieren. Die Menge aller solchen Vektoren mit Einträgen heißt Wahrscheinlichkeitssimplex, geschrieben . Jede Softmax-Ausgabe liegt darin. Hier benennt eine Menge, und der Exponent ist ihre Dimension, keine Potenz: Sobald Wahrscheinlichkeiten gewählt sind, muss die letzte die Summe auf 1 bringen. Bei zwei Möglichkeiten hat jede Verteilung die Form mit , es ist also nur eine Zahl frei.
Normalisierung. Normalisierung skaliert Werte um Mittelwert und Streuung einer gewählten Gruppe. Eine gängige Form ist , wobei ein Mittelwert ist, eine Varianz und eine kleine positive Zahl, die eine Division durch null verhindert. Die Gleichung allein sagt nicht, welche Einträge für Mittelwert und Varianz verwendet werden. Bei einem Batch von Feature-Vektoren berechnet Batch Normalization sie getrennt für jedes Feature über die Beispiele. Die Layer Normalization eines Transformers berechnet sie getrennt für jedes Token über seine Features. Prüfen Sie beim Vergleich von Implementierungen die angegebenen Achsen.
Quellen und Versionen
Abschnitts- und Gleichungsnummern beziehen sich auf die hier verlinkten Versionen.
- Tianhua Chen. The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer. 2026. Version 2; §2.4 und §3.2 behandeln die Jensensche Ungleichung und das ELBO, §5.1 und §6.4 zeitkontinuierliches Rauschen.
- Vaswani et al. Attention Is All You Need. 2017. Version 7, §3.2.1, Gleichung (1) und Fußnote 4.
- Dai et al. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. 2024. Feingranulare Expertensegmentierung und die Kombinationszählungen, §3.1; Ablation, §4.4 und Figure 3.
- Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024. Version 3, §1.1, §4.1.1, Gleichungen (1)–(4) und Algorithm 1.
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. 2024. Version 5, §2.1.1–2.1.3, Gleichungen (9)–(19) und Appendix C.
- DeepSeek-AI. DeepSeek-V3 Technical Report. 2024–2025. Version 2, §2.1.2, Gleichungen (12)–(18).
- DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025. Version 1: §2.2.1, Gleichungen (1)–(3). Version 2, 2026: §2.1 und Supplementary A.3.
- DeepSeek-AI. DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence. 2026. Version 1: §2.2, Gleichungen (1)–(8); §5.1.2, Gleichung (29).
- Rafailov et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. 2023–2024. Version 3, §4, Gleichung (7).
- Gu et al. MiniLLM: Knowledge Distillation of Large Language Models. 2023–2024. Version 4, §2.1, Gleichung (1), und §2.2, Gleichungen (2) und (7).
- Yu et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. 2025. Version 2, §3.2–3.3, Gleichungen (11)–(12).
- Gu und Dao. Mamba: Linear-Time Sequence Modeling with Selective State Spaces. 2023–2024.
- Yang et al. Gated Delta Networks: Improving Mamba2 with Delta Rule. 2024–2025. Version 3, §3.1, Gleichung (10), und §3.3–3.4.
- Ho, Jain und Abbeel. Denoising Diffusion Probabilistic Models. 2020. Version 2, §2, Gleichungen (4)–(5); §3.2, Gleichung (12); §3.4, Gleichung (14); und Algorithms 1–2.
- Goodfellow et al. Generative Adversarial Nets. 2014. Gleichung (1) und Algorithm 1.
- Chen et al. Evaluating Large Language Models Trained on Code. 2021. Version 2, §2.1, Gleichung (1), und Figure 3.
- Hugging Face TRL.
GRPOTrainerundGRPOConfigbeim Commitc6eac19, Oktober 2026. - Stanford CS229. Probability Theory Review und Linear Algebra Review and Reference.
- Dive into Deep Learning. Preliminaries.
- Britz, Goldie, Luong und Le. Massive Exploration of Neural Machine Translation Architectures. 2017. Version 2, Table 5; von Attention Is All You Need für den Vergleich von Dot-Product und additiver Attention zitiert.