Jak czytać matematykę w artykułach AI z arXiv: praktyczny przewodnik
Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Czytanie matematyki w artykule o AI to przydatna umiejętność dla inżynierów, którzy muszą zrozumieć model, odtworzyć metodę albo ocenić wynik eksperymentu. Ten przewodnik pokazuje, jak odczytywać notację, sprawdzać równanie na małych liczbach i łączyć je z resztą artykułu oraz z implementacją. Zakłada, że umiesz czytać kod, ale nie zakłada, że notacja z publikacji naukowych jest ci już znana.
Równanie ściska w jednej linii kilka decyzji: jakie obiekty przetwarza, jakie mają wymiary, które wartości są losowane oraz co jest uczone, a co pozostaje stałe. Odtworzenie tych szczegółów to dobry pierwszy krok. Wyjaśnienie, dlaczego metoda działa, i wierna implementacja wymagają dalszej pracy.
Zacznij od omówienia mechanizmu uwagi: łączy ono jedno równanie z kształtami tablic, małymi liczbami i działającym kodem w Pythonie. Ściąga z notacji wyjaśnia wyrażenia, które spotkasz w innych artykułach. Dalsze części serii stosują tę samą metodę do równań z konkretnych artykułów: równań architektury, takich jak RoPE, MLA i LoRA; celów treningowych, takich jak DPO i GRPO; oraz modeli generatywnych i metryk, takich jak ELBO, dyfuzja i pass@k. Tych części jeszcze nie ma, więc omówienia, do których odwołuje się ta część, nie są podlinkowane. Dłuższe ujęcie podstaw znajdziesz w książce Tianhua Chena The Little Book of Generative AI Foundations, która rozwija algebrę liniową i rachunek prawdopodobieństwa stojące za modelami generatywnymi.
Uwaga (attention) – czytana symbol po symbolu
Uwaga tworzy wektor wyjściowy jako średnią ważoną wektorów wartości (value). Wagi uzyskuje, porównując wektor zapytania (query) dla pozycji wyjściowej z wektorem klucza (key) dla każdej dostępnej pozycji wejściowej. Macierze , i zbierają wektory zapytań, kluczy i wartości. Skalowana uwaga iloczynu skalarnego łączy te kroki w równaniu (1) w §3.2.1 (§ oznacza „sekcję”) artykułu Attention Is All You Need:
Definicje są w tekście, nie w równaniu. Akapit przed równaniem (1) mówi, że zapytania i klucze mają wymiar , a wartości wymiar . Metoda liczy iloczyn skalarny każdego zapytania ze wszystkimi kluczami, dzieli każdy z nich przez i stosuje softmax, „aby uzyskać wagi wartości”. Zapytania są „spakowane razem w macierz ”, a klucze i wartości w i . Każdy wiersz tych macierzy to więc wektor jednego tokena, a softmax daje jeden zestaw wag na zapytanie. Wyuczone macierze, które zamieniają wektory tokenów na , i , pojawiają się dalej, w §3.2.2.
Kształty i role. Głowica uwagi (head) wykonuje jedno takie obliczenie na własnych wektorach zapytań, kluczy i wartości. Zanim zaczniesz czytać operatory, zapisz ich kształty. Dla jednej głowicy z zapytaniami i kluczami:
| Symbol | Kształt | Czym jest | Skąd się bierze |
|---|---|---|---|
| jeden wiersz zapytania na każdą pozycję wyjściową | wektory tokenów razy wyuczona macierz | ||
| jeden wiersz klucza na każdą pozycję, na którą można patrzeć | wektory tokenów razy wyuczona macierz | ||
| jeden wiersz wartości na każdy klucz | wektory tokenów razy wyuczona macierz | ||
| transponowana: wiersze stają się kolumnami | te same liczby co w | ||
| liczba | szerokość każdego zapytania i klucza | stałe ustawienie: 64 w bazowym Transformerze |
Artykuły podają kształt, wskazując zbiór, do którego należy macierz: oznacza macierz liczb rzeczywistych o wierszach i kolumnach, czyli tablicę o kształcie [n, dk].
Czytaj od środka na zewnątrz.
-
mnoży macierz przez macierz . Wspólny wymiar zostaje zsumowany, więc wynikiem jest tabela wyników (scores) o wymiarach . Element to iloczyn skalarny zapytania i klucza : pomnóż odpowiadające sobie elementy, a potem dodaj iloczyny. Przy ustalonych długościach wektorów wynik jest tym większy, im bardziej podobne są ich kierunki.
-
Dzielenie przez powstrzymuje wzrost wyników wraz z szerokością wektora. Przypis 4 w artykule pokazuje, dlaczego nieskalowane iloczyny skalarne rosną. Załóżmy, że składowe zapytania i klucza są od siebie niezależne (znajomość części z nich nic nie mówi o pozostałych), każda ze średnią 0 i wariancją 1 (średnia kwadratu odległości od średniej). Wtedy:
Te linie korzystają z dwóch reguł dotyczących liczb niezależnych. Po pierwsze, iloczyn dwóch niezależnych liczb, z których każda ma średnią 0 i wariancję 1, też ma wariancję 1. Po drugie, przy dodawaniu liczb niezależnych ich wariancje się sumują, więc iloczynów daje wariancję . Odchylenie standardowe to pierwiastek kwadratowy z wariancji, czyli . Podzielenie każdego wyniku przez zmniejsza rozrzut o ten sam czynnik, z powrotem do 1.
Dlaczego te dwie reguły są prawdziwe
Wariancja przy średniej 0. Wariancja to średni kwadrat odległości od średniej. Gdy średnia wynosi 0, kwadrat odległości od średniej to po prostu kwadrat liczby, więc wariancja jest średnią z kwadratu. Składowa o średniej 0 i wariancji 1 ma więc ze średnią 1.
Średnia z iloczynu. Dla liczb niezależnych średnia z iloczynu jest iloczynem średnich. Weźmy liczbę , która z równym prawdopodobieństwem wynosi 1 lub 3, więc ma średnią 2, oraz liczbę , która z równym prawdopodobieństwem wynosi 1 lub 5, więc ma średnią 3. Niezależność oznacza, że przyjmuje każdą ze swoich wartości równie często bez względu na to, jaka wyszła , więc wszystkie cztery pary są jednakowo prawdopodobne. Gdy , iloczyny to 1 i 5, ze średnią . Gdy , iloczyny to 3 i 15, ze średnią . W obu przypadkach średnia wynosi , więc po obu wartościach jest to , czyli . Bez niezależności reguła zawodzi: gdyby wynosiło 5 zawsze, gdy wynosi 3, a 1 zawsze, gdy wynosi 1, pojawiłyby się tylko iloczyny 1 i 15, a ich średnia to 8. Wikipedia podaje tę regułę dla dowolnych niezależnych zmiennych losowych, używając określenia „wartość oczekiwana” na średnią: independence and expectation.
Reguła 1: jeden iloczyn ma wariancję 1. Weźmy jeden iloczyn . Jego średnia to iloczyn średnich, , więc jego wariancja jest średnią z . Kwadraty są niezależne, bo niezależne są i , a każdy ma średnią 1, więc wariancja wynosi . Ogólny wzór to variance of a product of independent variables.
Reguła 2: wariancje niezależnych składników się sumują. Nazwijmy iloczyny , tak że iloczyn skalarny jest sumą . Składniki są niezależne, bo każdy używa innych składowych, a każdy ma średnią 0 i wariancję 1. Suma też ma średnią 0, więc jej wariancja jest średnią z jej kwadratu. Pomnożenie sumy przez siebie daje jeden iloczyn dla każdej pary składników, czyli siatkę :
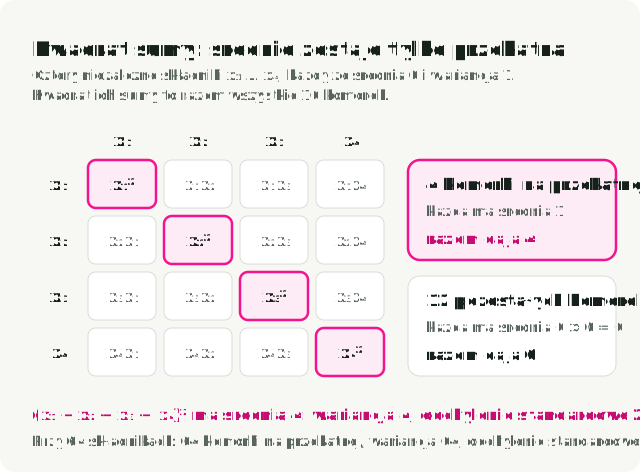
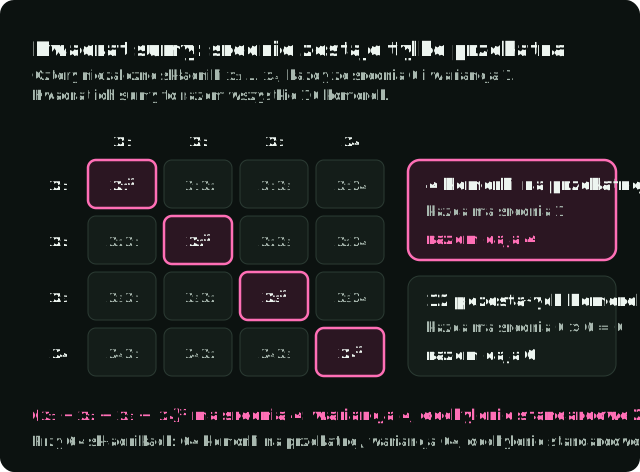
Komórki na przekątnej to kwadraty i każda ma średnią 1. Każda inna komórka mnoży dwa różne, niezależne składniki, więc jej średnia jest iloczynem ich średnich, : dodatnie i ujemne wartości się znoszą. Zostaje tylko komórek na przekątnej, więc wariancja sumy wynosi , a jej odchylenie standardowe . Rozrzut rośnie z pierwiastkiem kwadratowym z szerokości, bo większość siatki się znosi. Ogólne twierdzenie Wikipedia podaje jako variance of a sum of uncorrelated variables; zmienne niezależne są zawsze nieskorelowane, więc reguła je obejmuje.
Przy surowe wyniki rozkładają się zwykle w przedziale około ; po przeskalowaniu w około , przy dowolnej szerokości.
Szeroko rozrzucone wyniki nasycają softmax (krok 3), a jego gradienty zanikają. Jeśli jeden wynik w wierszu jest znacznie wyższy od pozostałych, softmax daje temu kluczowi wagę bliską 1, a każdemu innemu kluczowi wagę bliską 0. Mała zmiana któregokolwiek wyniku ledwo rusza wagami, więc gradient docierający do zapytań i kluczy jest bliski zeru, a trening prawie nie ma czym ich dostrajać. Artykuł podaje to jako prawdopodobne wyjaśnienie wcześniejszego wyniku: bez skalowania uwaga oparta na iloczynie skalarnym radziła sobie przy dużym gorzej niż uwaga addytywna, starsza forma, która ocenia parę zapytanie–klucz małą siecią (Britz et al., 2017). Sam artykuł nie mierzy gradientów.
-
Softmax zamienia każdy wiersz wyników na wagi. Niech będzie jednym wierszem przeskalowanych wyników. Wykładnicza , zapisywana też jako , używa stałej . Wtedy , gdzie to po prostu druga nazwa indeksu, więc suma przebiega po wszystkich kluczach w wierszu. Wagi są dodatnie, a każdy wiersz sumuje się do 1.
-
Pomnożenie wag przez wartości sumuje po osi kluczy. Wiersz wyjścia jest średnią ważoną wierszy wartości, z wagami zależnymi od tego, jak dobrze każdy klucz pasował do zapytania .
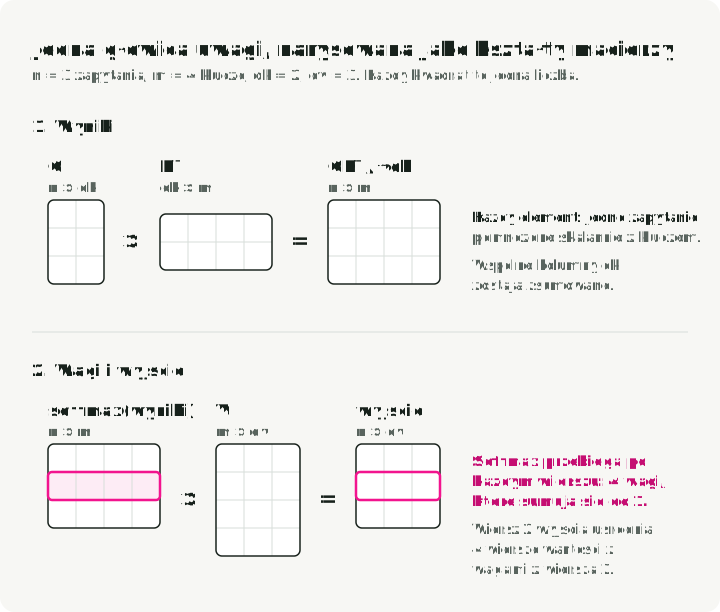
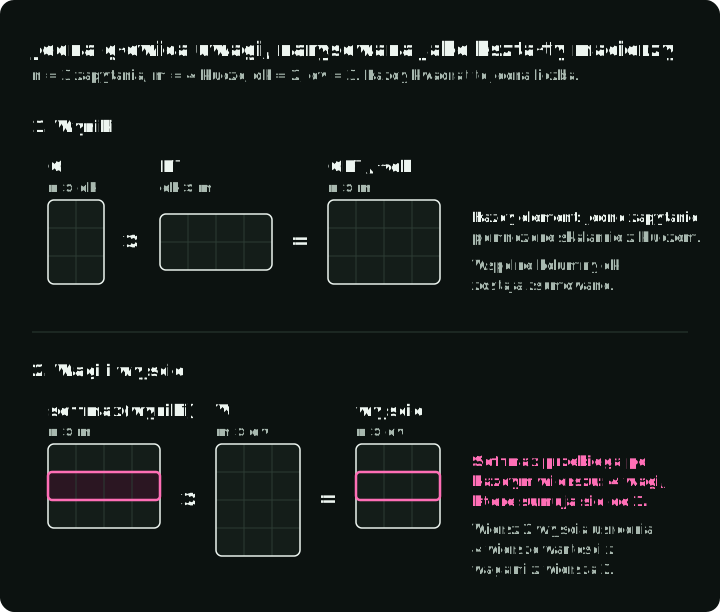
Policz kwadraty na rysunku: każdy iloczyn usuwa oś, którą dzielą jego dwie siatki.
Sprawdź to na dwóch liczbach. Weźmy jedno zapytanie i dwa klucze, których przeskalowane wyniki to , dobrane tak, by wykładnicze wyszły 1 i 3, oraz wartości i . Rysunek przelicza to po jednej operacji na kolumnę:
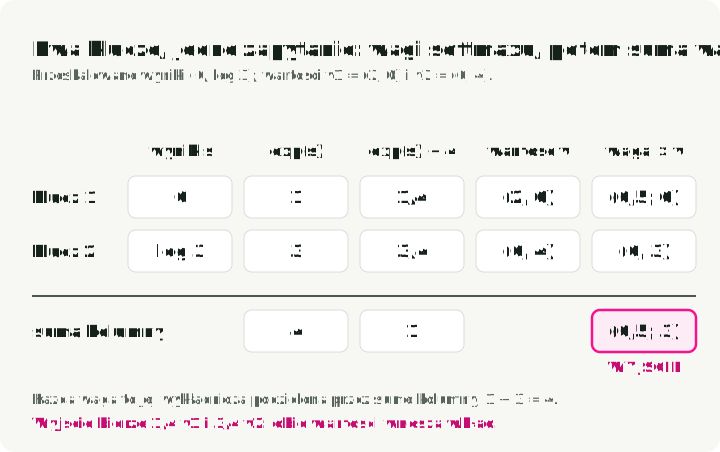
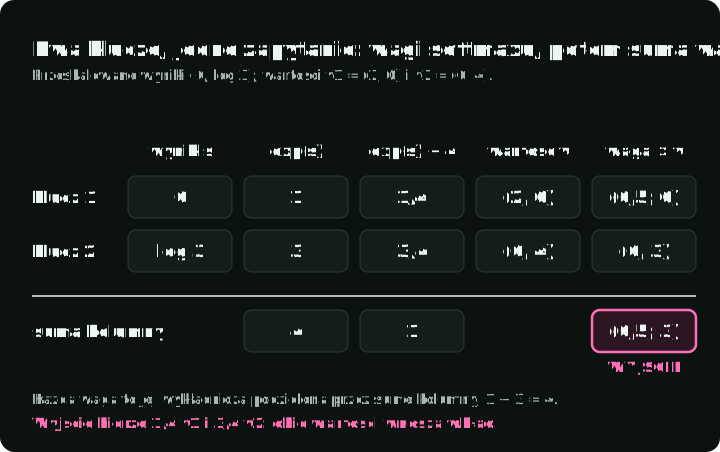
Uwaga wymieszała obie wartości; nie wybrała lepiej pasującego tokena.
Porównaj to z kodem. Poniższa funkcja NumPy implementuje jedną głowicę. k.T to transpozycja. axis=1 to oś kluczy, więc wiersz każdego zapytania jest normalizowany osobno. Maksimum wiersza jest odejmowane przed np.exp: dodanie tej samej liczby do każdego wyniku w wierszu skraca się w ilorazie softmaxu, więc wynik się nie zmienia, ale duże wyniki przestają powodować przepełnienie. Opcjonalna maska ustawia zablokowane wyniki na , co daje im wagi dokładnie równe zero. Dekoder używa takiej maski, by token nie patrzył na późniejsze tokeny (§3.2.3 artykułu).
Zapisz blok jako attention_example.py i uruchom uv run --with numpy python attention_example.py. Testy przechodzą bez żadnego komunikatu.
import numpy as np

def attention(q, k, v, allowed=None):
    """One head. q: [n, dk], k: [m, dk], v: [m, dv], allowed: bool [n, m]."""
    scores = q @ k.T / np.sqrt(q.shape[1])  # [n, m]
    if allowed is not None:
        if not allowed.any(axis=1).all():
            raise ValueError("every query needs at least one allowed key")
        scores = np.where(allowed, scores, -np.inf)
    scores = scores - scores.max(axis=1, keepdims=True)
    weights = np.exp(scores)
    weights = weights / weights.sum(axis=1, keepdims=True)  # rows sum to 1
    return weights @ v, weights  # [n, dv], [n, m]

# The two-key example from the text.
out, w = attention(
    np.array([[1.0]]),
    np.array([[0.0], [np.log(3.0)]]),
    np.array([[2.0, 0.0], [0.0, 4.0]]),
)
np.testing.assert_allclose(w, [[0.25, 0.75]])
np.testing.assert_allclose(out, [[0.5, 3.0]])

# A causal mask: query i may attend only to keys 0..i.
x = np.random.default_rng(0).normal(size=(3, 4))
out, w = attention(x, x, x, allowed=np.tril(np.ones((3, 3), dtype=bool)))
assert out.shape == (3, 4)
np.testing.assert_allclose(w.sum(axis=1), 1.0)
assert np.all(w[np.triu_indices(3, k=1)] == 0)
Zapytanie, którego wszystkie klucze są zablokowane, to przypadek, który równanie zostawia nierozstrzygnięty: każda waga w jego wierszu wyniosłaby . Funkcja zgłasza błąd zamiast zwracać NaN.
Od jednej głowicy do kilku. Bazowy Transformer uruchamia równolegle osiem głowic, każdą z własnymi wyuczonymi macierzami do tworzenia , i i każdą z . Łączy ich wyniki i mnoży rezultat przez kolejną wyuczoną macierz, (Attention Is All You Need, §3.2.2).
Implementacja może też przetwarzać batch: kilka sekwencji wejściowych naraz. Na przykład scaled dot-product attention w PyTorch przyjmuje tensor zapytań Q o kształcie [batch, heads, n, d_k]. Pierwsze dwa wymiary wybierają sekwencję i głowicę; Q[b, h] to macierz [n, d_k] dla tej pary. Wzór uwagi stosuje się osobno do każdej pary. Funkcja NumPy z tego artykułu obsługuje tylko jedną taką parę: jej operacje .T i axis=1 zakładają dwuwymiarowe dane wejściowe.
Sześć pytań do każdego równania
| Pytanie | Odpowiedź dla uwagi |
|---|---|
| Co zwraca równanie i o jakim kształcie? | Macierz : jeden wiersz wyjścia na zapytanie |
| Czy każdy symbol to dane, wytrenowana waga, zamrożony model, ustawienie czy próbka? | , i są obliczane z tokenów przez wyuczone macierze; to stałe ustawienie; nic nie jest losowane |
| Po którym indeksie lub osi przebiega każda operacja? | Softmax przebiega po kluczach w wierszu każdego zapytania; iloczyn wag z sumuje po kluczach |
| Gdzie są definicje? | Akapit przed równaniem (1), przypis 4 oraz §3.2.2 dla wyuczonych rzutowań |
| Co daje sprawdzenie na dwóch lub trzech liczbach? | Wagi i wyjście |
| Co musiał rozstrzygnąć kod, czego równanie nie rozstrzyga? | Odejmowanie maksimum wiersza, wartość użyta dla zamaskowanych wyników, wiersz bez dozwolonego klucza |
Jaki rodzaj twierdzenia zawiera równanie
Uwaga jest obliczeniem: mówi, jak z danych wejściowych uzyskać wynik. Artykuły zapisują też równania, które pełnią inne role:
| Rodzaj | Przykład w tej serii | Co sprawdzić |
|---|---|---|
| Obliczenie | Wyjście uwagi; skompresowany wektor w MLA | Kształt każdego wyniku pośredniego |
| Definicja | Wynik GRPO względem innych odpowiedzi | Co oznacza nowa nazwa, tak by można było ją podstawić z powrotem |
| Cel: strata do minimalizacji lub wynik do maksymalizacji | Strata DPO | Czy jest minimalizowany, czy maksymalizowany, i po jakich danych się uśrednia |
| Reguła aktualizacji | Spadek gradientu; pamięć w Gated DeltaNet | Co zmienia się w każdym kroku, a co pozostaje stałe |
| Ograniczenie, czyli zbiór dozwolonych wartości | Dozwolone macierze mieszania w mHC | Jak artykuł wytwarza wartość, która je spełnia |
| Granica: górny lub dolny kres wielkości | Dolna granica dowodu (evidence lower bound, ELBO) | Różnica między obiema stronami i kiedy wynosi zero |
| Estymator lub metryka | pass@k | Co jest zliczane i z ilu próbek |
| Dopasowanie empiryczne | Prawo skalowania z DeepSeek LLM | Zakres danych, na którym dopasowano krzywą |
Ograniczenie (constraint) stwierdza własność, którą musi mieć wynik. Dla wag uwagi ta własność brzmi: każda waga jest nieujemna, a każdy wiersz sumuje się do 1. Softmax to obliczenie, które wytwarza wagi o tej własności. Sam wymóg nie mówi, że trzeba użyć softmaxu.
stwierdza, że dwa wyrażenia są równe. oznacza „jest zdefiniowane jako”: nadaje wyrażeniu nazwę. Definicja może nazywać metrykę, stratę albo zbiór dozwolonych wartości, więc samo nie mówi, z jakim rodzajem równania z tabeli powyżej masz do czynienia.
Na przykład Evaluating Large Language Models Trained on Code, artykuł, który wprowadził model generowania kodu Codex, używa do zdefiniowania estymatora pass@k (równanie 1). Ta metryka mierzy szansę, że co najmniej jeden z wygenerowanych programów przejdzie testy. W raporcie technicznym DeepSeek-V4 równanie (2) łączy dwa twierdzenia: definiuje zbiór dozwolonych macierzy, a wymaga, by macierz mieszania modelu należała do tego zbioru. Definicja używa ; ograniczenie używa , czyli „należy do”. Sekcje o pass@k i mHC omawiają te przykłady.
Znajdowanie nowego równania, jego definicji i jego kodu
Sekcja metody artykułu opisuje, jak działa jego model lub algorytm treningowy. Nagłówek może brzmieć „Method”, „Architecture” albo bardziej szczegółowo. Autorzy często najpierw wyjaśniają istniejącą metodę, a potem pokazują, co zmienili. Aby ustalić deklarowany wkład, zacznij od podsumowania nowości we wstępie. Na przykład DeepSeekMath, §1.1 wymienia Group Relative Policy Optimization (GRPO), swoją metodę trenowania modeli na ocenionych odpowiedziach. Numery sekcji i równań odnoszą się tu do podlinkowanego artykułu.
Następnie porównaj proponowaną metodę z wcześniejszą, którą zmienia. Ilustrują to dwa artykuły:
- Zmiana architektury. DeepSeek-V2 opisuje standardową uwagę wielogłowicową w §2.1.1 i wprowadza multi-head latent attention (MLA) w §2.1.2. Standardowa uwaga przechowuje klucze i wartości każdego wcześniejszego tokena. MLA przechowuje skompresowany wektor, z którego można je odtworzyć. Porównanie tych równań pokazuje, co model przechowuje inaczej; omówienie MLA wyprowadza oszczędność pamięci.
- Zmiana treningu. DeepSeekMath, §4.1.1 podaje cel Proximal Policy Optimization (PPO) jako równanie (1), a GRPO jako równanie (3). Oba używają przewagi (advantage): liczby, która mówi, czy odpowiedź była lepsza, czy gorsza od oczekiwanej. PPO szacuje ją za pomocą drugiej wyuczonej sieci, modelu wartości, który przewiduje nagrodę, jaka jeszcze zostanie uzyskana z niepełnej odpowiedzi. GRPO zamiast tego porównuje nagrodę za odpowiedź z nagrodami za inne odpowiedzi na to samo pytanie. Omówienie GRPO porównuje te składniki, używając notacji całych odpowiedzi z DeepSeek-R1.
Znajdź definicje wokół równania. Sprawdź poprzedzający akapit, każde zdanie „gdzie …” po nim, przypisy i dodatki. W Attention Is All You Need akapit przed równaniem (1) definiuje wymiary, a przypis 4 wyjaśnia współczynnik skalowania. DeepSeek-V3 definiuje większość symboli routingu zaraz po równaniu (15), a składnik tuż przed równaniem (16). DeepSeek-V2 rozwija MLA w równaniach (9)–(19), a potem zbiera obliczenia w Dodatku C.
Sprawdź algorytm i kod. Ramka algorytmu to ponumerowany listing pseudokodu, który podaje kolejność operacji. Algorithm 1 w DeepSeekMath pokazuje, kiedy generować odpowiedzi, a kiedy aktualizować model. Algorithm 1 w Denoising Diffusion Probabilistic Models (DDPM) określa, jak losować obraz treningowy, poziom szumu i szum. Implementacje rozstrzygają dalsze szczegóły: domyślnie np.std dzieli sumę kwadratów odchyleń przez , a torch.std przez . Przykład GRPO pokazuje, jak ten wybór zmienia wartości przewagi obliczone z tych samych nagród.
Wersje arXiv mogą przenosić sekcje i powtarzać równania pod nowymi numerami, więc podawaj wersję. W DeepSeek-R1 v1 cel GRPO to §2.2.1, równania (1)–(3). W v2, opublikowanej w styczniu 2026, to §2.1, a te same równania wracają jako (11)–(13) w Supplementary A.3. Link bez wersji otwiera najnowszą, więc każdy link do arXiv w tej serii zawiera wersję, z którą go sprawdzono.
Sprawdzanie własnego odczytu za pomocą LLM
Model czatowy potrafi przygotować szkic tabeli symboli, indeks każdej sumy i sprawdzenie na małych liczbach, jeśli podasz mu definicje i poprosisz o wskazanie braków. Tekst skopiowany z PDF spłaszcza indeksy dolne, górne i ułamki do jednej linii; linki „HTML (experimental)” i „TeX Source” na stronie abstraktu arXiv dają czysty tekst do wklejenia. Wklej równanie i otaczające je akapity razem z takim poleceniem:
Below is equation (N) from <paper title, arXiv ID and version>, followed by
the paragraphs that define its symbols.

1. Make a table with one row per symbol: shape or type, meaning, and whether
   it is input data, a trained weight, a frozen model, a fixed setting or a
   random sample. Quote the sentence that defines it.
2. List every symbol the pasted text does not define. Do not guess them.
3. For every sum, mean, softmax, min or expectation, name the index or the
   distribution it runs over.
4. Work through the equation with the smallest numbers that use every term.
5. Say which kind of statement it is: a computation, definition, objective,
   update rule, constraint, bound, estimator or empirical fit.
Bez kroku 2 nic nie powstrzymuje modelu przed uzupełnieniem brakującej definicji zwykłym znaczeniem litery, na przykład odczytaniem w DPO jako odchylenia standardowego zamiast sigmoidy. Cytaty z kroku 1 pozwalają sprawdzić tabelę: wyszukaj każdy z nich w PDF i potraktuj wiersz, którego cytatu nie możesz znaleźć, jako zgadywanie.
Ta sama procedura jako umiejętności agenta. paper-math-skills pakuje tę sekcję i poniższą ściągę z notacji w dwie umiejętności (skills) napisane dla Claude Code; mogą z nich korzystać także inni agenci, którzy ładują pliki SKILL.md. read-paper-math pobiera przypiętą wersję arXiv, cytuje zdanie definiujące każdy symbol, czyta równanie od środka na zewnątrz i wykonuje sprawdzenie na małych liczbach. check-paper-math przegląda taki odczyt względem artykułu: wyszukuje każdy cytat, powtarza obliczenia i oznacza twierdzenia mocniejsze lub słabsze niż w artykule. paper-math-readings zawiera odczyty tych umiejętności dla części 2–4, po jednym dla każdej z 15 sekcji z linią Source:.
Ściąga z notacji
Jeśli jakaś grecka litera jest ci obca, otwórz tabelę liter greckich z tego artykułu (Dodatek A), by poznać jej nazwę i typowe znaczenia. Jeśli chcesz więcej ćwiczyć matematykę, Stanford CS229 udostępnia powtórki z rachunku prawdopodobieństwa i algebry liniowej wraz z ćwiczeniami; Preliminaries z Dive into Deep Learning wyjaśniają podstawy razem z kodem.
Indeksy, znaki nad literami i znaki relacji
Litery są lokalnymi nazwami zmiennych: każdy artykuł definiuje własne. Indeksy dolne są zwykle numerami pozycji. może być współrzędną wektora albo przykładem w zbiorze danych, a to wektor modelu dla tokena , zwany jego stanem ukrytym (hidden state).
Indeksy górne w artykułach o modelach często są etykietami. W indeks górny w nawiasie to zwykle numer warstwy, a nie potęga; w i z DeepSeek-V3 oznacza on ekspertów współdzielonych (shared) i kierowanych (routed), czyli tych, z których korzysta każdy token, i tych, które wybiera router (zobacz przykład routingu MoE). W DeepSeek-V2 i niosą etykiety, a nie wykładniki; przykład MLA definiuje te etykiety. to transpozycja, a to kwadrat.
oznacza pozycje od 1 do , w tym , inaczej niż wycinek (slice) w Pythonie; artykuły zwykle liczą od 1. oznacza każdą pozycję przed . wybiera wiersz , jak w wycinaniu w NumPy.
Znaki przy literze zwykle zmieniają jej znaczenie w jeden z tych sposobów:
| Znak | Zwykłe znaczenie | Przykład lub wyjątek |
|---|---|---|
| Predykcja lub estymata | Przykład: w DeepSeekMath szacuje, o ile lepszy od oczekiwanego był wynik odpowiedzi | |
| Średnia | Wyjątek: w DDPM mnoży czynniki harmonogramu szumu od kroku 1 do | |
| Wersja zaburzona lub nieograniczona | Przykład: w DeepSeek-V4 to macierz przed normalizacją, która wymusza jej ograniczenia | |
| Optimum | Wyjątek: w DPO to prawdziwa nagroda, której metoda nigdy nie obserwuje | |
| Nowa wartość lub wynik pośredni | Przykład: w DeepSeek-V3 to waga eksperta przed normalizacją | |
| Macierz odwrotna | Nie odwrotność element po elemencie: odwraca działanie , (macierz jednostkowa), a w ogólności |
Niektóre symbole inne niż greckie litery też pełnią kilka funkcji:
| Symbol | Znaczenia |
|---|---|
| Warunkowanie w ; „takie, że” wewnątrz zbioru | |
| Wartość bezwzględna; długość sekwencji, jak w , liczbie tokenów odpowiedzi w GRPO; liczność zbioru | |
| „Jest losowane z” w ; „mniej więcej” w tekście nieformalnym | |
| Długość sekwencji; temperatura softmaxu; liczba kroków dyfuzji | |
| Wektor zapytania (uwaga); pytanie (GRPO); model ucznia (destylacja); koder (ELBO) |
Pięć znaków mówi, jak powiązane są dwie strony. , czasem , definiuje nową nazwę. oznacza przybliżenie, na przykład uśrednienie po próbkach w sekcji Wartości oczekiwane i skąd biorą się próbki. znaczy „proporcjonalne do”, z pominiętą stałą normalizującą: staje się rozkładem dopiero po podzieleniu przez . znaczy „znacznie mniejsze niż”, jak w z DeepSeek-V2: skompresowana szerokość jest znacznie mniejsza niż łączna szerokość wszystkich głowic. to przypisanie, jak w regule aktualizacji.
Sumy, zliczanie, przedziały i logarytmy
Duże dodaje składniki, a je mnoży. Indeks pod każdym operatorem zaczyna się tu od 1 i biegnie do górnej granicy :
Indeks należy do operatora, tak jak zmienna pętli należy do swojej pętli. W suma przebiega po , a identyfikuje element wyniku. Wynikiem jest wektor z jednym elementem na każde : rozpisany iloczyn macierzy i wektora . Indeksy po lewej stronie mówią, jaki kształt ma wynik.
Czynnik przed sumą decyduje, co dostaje równą wagę. Batch z odpowiedzią o 2 tokenach i odpowiedzią o 8 tokenach, gdzie to strata na tokenie odpowiedzi (w GRPO jest zamiast tego składnikiem do maksymalizacji), można uśrednić na dwa sposoby:
W pierwszym sposobie każda odpowiedź dostaje wagę , dzieloną między jej tokeny:
W drugim każdy token ma wagę . GRPO losuje odpowiedzi na każde pytanie, a to liczba tokenów odpowiedzi . Oba uśrednienia wyglądają wtedy tak, dla GRPO z DeepSeekMath i dla DAPO, późniejszego wariantu GRPO:
Dla są to i z góry. DAPO przyjęło uśrednianie po tokenach (§3.3), ponieważ uśrednianie po odpowiedziach dawało tokenom długich odpowiedzi zbyt małą wagę: model uczył się zbyt mało z długich dobrych odpowiedzi i nie karał dostatecznie długich, powtarzalnych złych.
Suma może też zliczać. Artykuły robią to za pomocą wskaźnika (indicator): pogrubionej jedynki z warunkiem, , która równa się 1, gdy warunek jest prawdziwy, a 0, gdy jest fałszywy. Niektóre artykuły umieszczają warunek w nawiasach okrągłych albo drukują zamiast tego jedynkę w kroju podwójnie kreskowanym (double-struck); znaczenie jest to samo. Dodanie wskaźników zlicza więc, ile razy warunek jest spełniony. Typowym przykładem jest trafność (accuracy). Jeśli to przewidziana klasa, a poprawna klasa dla przykładu , to jest liczbą poprawnych predykcji. Predykcje (kot, pies, pies) wobec poprawnych etykiet (kot, kot, pies) dają wskaźniki 1, 0 i 1, więc liczba wynosi 2, a trafność 2/3. W warstwie mixture-of-experts (MoE) router wysyła każdy token do kilku z wielu podsieci feed-forward, zwanych ekspertami. W stracie bilansującej DeepSeek-V3 (równanie 18) wskaźnik wynosi 1, gdy wynik eksperta dla tokena należy do najwyższych wyników dla tego tokena, gdzie to liczba ekspertów, do których kierowany jest każdy token. Jego suma po tokenach sekwencji zlicza, jak często to się zdarzyło. Wynik użyty tutaj pomija obciążenie (bias) dodawane przez routing, więc zliczenie może się różnić od ekspertów, których router faktycznie wybiera (routing MoE).
Współczynnik dwumianowy , czytany „ po ”, zlicza sposoby wyboru różnych elementów spośród bez względu na kolejność. Dla liczb całkowitych równa się . Wykrzyknik oznacza silnię: , przy . Na przykład : pięć elementów daje dziesięć różnych par. DeepSeekMoE używa współczynników dwumianowych do zliczania kombinacji ekspertów, a estymator pass@k do zliczania zbiorów próbek.
Przedziały używają nawiasów do oznaczenia, które końce są wliczone: zawiera oba, żaden. W Gated DeltaNet oznacza ściśle między 0 a 1. W innych miejscach to para.
Logarytm naturalny odwraca potęgowanie: . Logarytmy zamieniają iloczyny na sumy, a ilorazy na różnice: i , ale się nie rozkłada. Dlatego artykuły pracują na logarytmach prawdopodobieństw. Logarytm iloczynu prawdopodobieństw tokenów jest sumą, a logarytm ilorazu prawdopodobieństw dwóch modeli jest różnicą, czyli postacią użytą w celach DPO i GRPO. Artykuły o ML mają na myśli logarytm naturalny, o ile nie powiedziano inaczej; wyniki są w natach, a logarytmy o podstawie 2 dają bity. Dla prawdopodobieństwa mamy , a wartość ta rośnie bez ograniczeń, gdy zbliża się do 0, więc pewna siebie błędna predykcja jest kosztowna.
Log-sum-exp oznacza: podnieś do potęgi wykładniczej każdy wynik , zsumuj rezultaty, a potem weź logarytm. Bezpośrednie obliczenie może przepełnić zakres, gdy któryś wynik jest duży. Zamiast tego znajdź największy wynik i nazwij go . Zapis oznacza „porównaj wszystkie elementy i weź największy”; w NumPy m = z.max().
Odejmij od każdego wyniku przed potęgowaniem, a po wzięciu logarytmu dodaj je z powrotem:
Dla największy wynik to . Przesunięte wyniki to , więc obliczenie przyjmuje postać . Żadna wykładnicza nie jest większa niż 1. Kod uwagi używa tego samego odejmowania przed softmaxem; tam wspólny czynnik skraca się w dzieleniu, więc nic nie trzeba dodawać z powrotem.
Prawdopodobieństwo warunkowe i prawdopodobieństwo tekstu
to prawdopodobieństwo, jakie model o parametrach przypisuje wynikowi przy danym wejściu . Indeks dolny nazywa parametry; niektóre artykuły piszą , gdzie średnik również oznacza parametry, a nie warunek. Z kropką w miejscu wyniku, jest całym rozkładem po wynikach, a nie pojedynczą liczbą. Artykuły o RL zapisują ten sam obiekt jako , czyli prawdopodobieństwo, że model napisze odpowiedź na pytanie , i nazywają model polityką (policy).
Zamiana zdarzenia z warunkiem daje inną liczbę. Przyjmijmy 100 odpowiedzi modelu: 60 jest poprawnych, 50 to poprawny JSON, a 40 spełnia oba warunki. Wtedy
Niech oznacza „odpowiedź jest poprawna”, a „odpowiedź jest poprawnym JSON-em”. Prawdopodobieństwo warunkowe ogranicza zliczanie do odpowiedzi spełniających warunek: , pod warunkiem że . Symbol oznacza „zachodzą oba zdarzenia”. Tutaj ułamek wynosi , tyle samo co 40 poprawnych odpowiedzi wśród 50 z poprawnym JSON-em.
Dwa zdarzenia są niezależne, gdy wiedza, że jedno zaszło, nie zmienia prawdopodobieństwa drugiego. Wymaga to . W tej próbce , podczas gdy , więc zaobserwowane proporcje nie spełniają niezależności.
Twierdzenie Bayesa, zwane też regułą Bayesa, wiąże oba kierunki warunkowania: . Pozwala obliczyć prawdopodobieństwo przy danym z prawdopodobieństwa przy danym i prawdopodobieństw obu zdarzeń. Przykład ELBO używa go do znalezienia prawdopodobieństwa ukrytego kodu przy danym zaobserwowanym obrazie.
Model językowy ocenia sekwencję token po tokenie. Z reguły łańcuchowej prawdopodobieństwa
Każdy czynnik warunkuje się na wszystkich wcześniejszych tokenach, więc wzór nie zakłada niezależności tokenów. Jeśli trzy tokeny mają prawdopodobieństwa warunkowe 0,5, 0,2 i 0,1:
Zwykła strata treningowa to ujemna wartość tej sumy podzielona przez długość:
Podczas treningu wcześniejsze tokeny pochodzą ze zbioru danych. Podczas generowania są to własne wcześniejsze wybory modelu.
Wartości oczekiwane i skąd biorą się próbki
Wartość oczekiwana to średnia ważona prawdopodobieństwami:
Czytaj jako „średnia z , gdy jest losowane z ”. Zapis sumuje po wszystkich możliwych wartościach dyskretnych . Bez indeksu dolnego uśrednia zmienną losową po jej własnym rozkładzie: jeśli wynosi 1 z prawdopodobieństwem 0,75 i 3 z prawdopodobieństwem 0,25, to .
Gdy zmienna ma gęstość , czyli prawdopodobieństwo na jednostkę , średnia ważona jest całką, . Symbol wskazuje jako zmienną, po której się całkuje; bez zapisanych granic całka obejmuje cały jej zakres. Przykład gęstości wyjaśnia prawdopodobieństwo na jednostkę i pokazuje całkę jako pole pod krzywą.
Kod treningowy nie może sumować po każdym możliwym wejściu, więc losuje i uśrednia: , gdzie każde jest losowane niezależnie z , co artykuły zapisują jako . Artykuły nazywają to estymatą Monte Carlo, a w kodzie jest to loss.mean() po batchu. Średnia z batcha estymuje wartość oczekiwaną tylko wtedy, gdy batch jest losowany z rozkładu podanego w indeksie , więc indeks mówi, jak powstają dane treningowe:
- DPO uśrednia po zapisanych przykładach : prompcie, odpowiedzi preferowanej i odpowiedzi odrzuconej. Odpowiedzi są zbierane i oznaczane przed tym etapem treningu; mogą pochodzić z wcześniejszego generowania przez model. W każdym kroku treningu model oblicza prawdopodobieństwa dla tych dostarczonych odpowiedzi i aktualizuje swoje wagi. Nie losuje w tym kroku nowych odpowiedzi.
- GRPO w DeepSeek-R1: wygeneruj odpowiedzi, potem porównaj ich nagrody. Trening losuje pytanie ze zbioru danych, generuje kilka odpowiedzi i ocenia je funkcją nagrody, na przykład sprawdzeniem wyniku matematycznego albo uruchomieniem testów jednostkowych. Aktualizacja faworyzuje odpowiedzi, które uzyskały wynik powyżej średniej grupy. Zapis oznacza „wylosuj pytanie z rozkładu pytań”. Zapis oznacza „wylosuj odpowiedzi na to pytanie z kopii modelu o nazwie ”. Indeks old oznacza kopię, która wygenerowała te odpowiedzi; ta kopia pozostaje stała, dopóki batch służy do aktualizacji. Omówienie GRPO wyjaśnia porównanie nagród i aktualizacje.
- Destylacja on-policy w MiniLLM i DeepSeek-V4: wygeneruj tekst, potem ucz się z prawdopodobieństw nauczyciela. Trenowany model to uczeń (student). Generuje tekst; zamrożony nauczyciel (teacher) dostarcza prawdopodobieństwa następnego tokena dla tych samych prefiksów, a trening dostraja prawdopodobieństwa ucznia do prawdopodobieństw nauczyciela. To te prawdopodobieństwa stanowią sygnał treningowy, a nie nagroda za odpowiedź jak w GRPO. MiniLLM zapisuje tekst wylosowany przez ucznia jako : to tekst, a nazywa model ucznia. DeepSeek-V4 nazywa swojego ucznia i używa kilku wyspecjalizowanych nauczycieli. Faktyczna procedura losowania w MiniLLM dodatkowo domieszkuje tokeny wylosowane od nauczyciela. Omówienie destylacji wyjaśnia cele i to rozróżnienie w losowaniu.
Kolejność mówi, co optymalizuje trening. Załóżmy, że model przypisuje prawdopodobieństwa 0,9 i 0,1 poprawnym wynikom dwóch jednakowo ważonych przykładów treningowych. Uśrednienie ich logarytmów prawdopodobieństwa oznacza, że najpierw bierzemy każdy logarytm, a potem uśredniamy: np.log(probs).mean(). Logarytm z ich średniej to np.log(probs.mean()). Jeśli to prawdopodobieństwo przypisane poprawnemu wynikowi losowo wybranego przykładu:
Zmiana znaku tych wyników daje straty 1,20 i 0,69. Drugi model, który przypisuje 0,5 każdemu poprawnemu wynikowi, dostaje 0,69 w obu obliczeniach. Zatem uśrednianie prawdopodobieństw przed wzięciem logarytmu traktuje oba modele jako równie dobre, podczas gdy zwykła średnia ujemnego logarytmu prawdopodobieństwa karze pierwszy model mocniej za niskie prawdopodobieństwo drugiego poprawnego wyniku. Przekładając stratę na kod, zachowaj kolejność logarytmu i średniej.
Nierówność Jensena podaje ogólną zależność dla dodatniego : . Pomaga też konstruować alternatywne cele treningowe. Gdy prawdopodobieństwo danych w modelu wymaga kosztownego uśredniania po zmiennych ukrytych, średnia z logarytmów może dać dolną granicę, którą łatwiej oszacować. Omówienie ELBO wyjaśnia ten problem treningowy; ELBO to skrót od evidence lower bound. Sekcja 2.4 książki Tianhua Chena The Little Book of Generative AI Foundations wyprowadza tę granicę za pomocą nierówności Jensena.
Gęstości, wariancja i słupki błędów
ma dwa częste znaczenia. Dla wyników dyskretnych, takich jak tokeny lub klasy, daje prawdopodobieństwo wyniku : liczbę od 0 do 1, przy czym prawdopodobieństwa po wszystkich wynikach sumują się do 1.
Aby zrozumieć drugie znaczenie, załóżmy, że jest wybierane jednostajnie między 0 a 0,5. Przedziały o równej długości mają równe prawdopodobieństwa. Przedział od 0,1 do 0,2 zajmuje jedną piątą całego zakresu, więc
W tym zakresie prawdopodobieństwo to szerokość przedziału pomnożona przez 2. Ten mnożnik to gęstość prawdopodobieństwa: dla i zero poza tym. Gęstość opisuje prawdopodobieństwo na jednostkę zmiennej, a nie prawdopodobieństwo jednej dokładnej wartości.
Zerowe prawdopodobieństwo punktu nie znaczy, że nic nie zostanie wylosowane. Zawężaj przedział wokół 0,15: jego prawdopodobieństwo to dwukrotność szerokości, więc zbliża się do zera, gdy szerokość dąży do zera. Pojedynczy dokładny punkt ma więc prawdopodobieństwo zero. Losowanie nadal daje jakąś wartość w , a cały ten przedział ma prawdopodobieństwo 1. Jeśli zapiszesz wynik zaokrąglony do dwóch miejsc po przecinku, zapisana wartość 0,15 reprezentuje przedział od 0,145 do 0,155, którego prawdopodobieństwo wynosi .
Dla gęstości niejednostajnej mnożnik zmienia się z . Całka sumuje wkłady na całym przedziale:
Geometrycznie jest to pole pod krzywą gęstości między i ; pole nad całym zakresem wynosi 1. W przykładzie jednostajnym pole to po prostu wysokość 2 razy szerokość 0,5. Gęstość może więc przekraczać 1, a jej logarytm może być dodatni, jak tutaj. Prawdopodobieństwo nigdy nie przekracza 1.
Rozkład Gaussa używany jako szum w DDPM ma gęstość tego rodzaju. Nie każdy rozkład ciągły ma zwykłą gęstość: rozkład Cantora jest matematycznym kontrprzykładem, spoza omawianych tu modeli. Przechowywanie wartości rzeczywistych nie oznacza też rozkładu ciągłego: zmienna ograniczona do 0.0 i 1.0 nadal ma dwa wyniki dyskretne.
Artykuły często używają tej samej litery dla prawdopodobieństw i gęstości. Sprawdź, jak artykuł definiuje rozkład zmiennej i po której zmiennej sumuje się lub całkuje. Całka po zmiennej ukrytej , takiej jak kod latentny w ELBO w części 4, nie mówi, czy zaobserwowane jest dyskretne, czy ciągłe. Niektóre artykuły piszą wielkie dla prawdopodobieństw, a małe dla gęstości, ale wiele używa dla obu.
Aby opisać, jak bardzo rozkład rozprasza się wokół średniej, artykuły używają wariancji: średniego kwadratu różnicy od średniej, , gdzie . Odchylenie standardowe jest jej pierwiastkiem kwadratowym, więc ma te same jednostki co .
Te wielkości pojawiają się też w nazwach rozkładów. Rozkład Gaussa, zwany też normalnym, zapisuje się : to jego średnia, a wariancja. Dla wektora używa macierzy kowariancji : element mierzy, jak współrzędne i zmieniają się razem, a przekątna zawiera ich wariancje. opisuje wektor niezależnych liczb o standardowym rozkładzie normalnym, każdej ze średnią 0 i wariancją 1; to macierz jednostkowa.
Tabele wyników benchmarków często podają średni wynik razem z miarą zmienności. Rozrzut pojedynczych przebiegów różni się od niepewności ich średniej: dla niezależnych przebiegów z odchyleniem standardowym błąd standardowy średniej wynosi .
Zanim porównasz dwa wpisy, takie jak i , ustal z podpisu, czy 0,4 to odchylenie standardowe między przebiegami, błąd standardowy, czy połowa szerokości przedziału ufności. Aby porównać średnie, oblicz przedział dla ich różnicy. Procedura 95-procentowego przedziału ufności daje zakresy, które w 95% powtórzonych eksperymentów zawierają prawdziwą różnicę, przy jej założeniach.
W tym przykładzie załóż cztery niezależne przebiegi na model, w przybliżeniu normalne wyniki przebiegów i równe wariancje populacji. Jeśli przebiegi są sparowane, na przykład dwa modele oceniane na tych samych niezależnie wylosowanych zadaniach, analizuj zamiast tego różnice wewnątrz par. Przewodnik NIST po testach dwóch prób wyjaśnia te przypadki.
Dla niezależnych średnich wariancja ich różnicy jest sumą ich wariancji. Standardowa zmienna normalna mieści się między a z prawdopodobieństwem około 0,95, co daje mnożnik dla przybliżenia normalnego 95-procentowego przedziału. Jeśli 0,4 to odchylenie standardowe w czterech przebiegach, to pierwsze obliczenie daje:
Mnożnik 1,96 traktuje oszacowany rozrzut jako znany. Przy zaledwie czterech przebiegach na model użyj rozkładu t Studenta, by uwzględnić niepewność rozrzutu. Przy powyższych założeniach liczba stopni swobody wynosi (osiem przebiegów minus dwie oszacowane średnie). scipy.stats.t.ppf(0.975, 6) daje około 2,447 zamiast 1,96; 0,975 zostawia 2,5% poza każdym końcem 95-procentowego przedziału. Jeśli założenie równych wariancji jest nieodpowiednie, użyj przedziału Welcha, w którym stopnie swobody liczy się inaczej.
Rozważmy teraz drugi sposób odczytania podpisu: 0,4 jest już błędem standardowym każdej średniej, oszacowanym z tych czterech przebiegów. Nic nie dzieli się przez , a błąd standardowy różnicy wynosi około 0,566. Mnożnik t nadal jest potrzebny. Oba odczyty dają:
Rysunek porównuje początkowe przybliżenie normalne z dwoma przedziałami t:
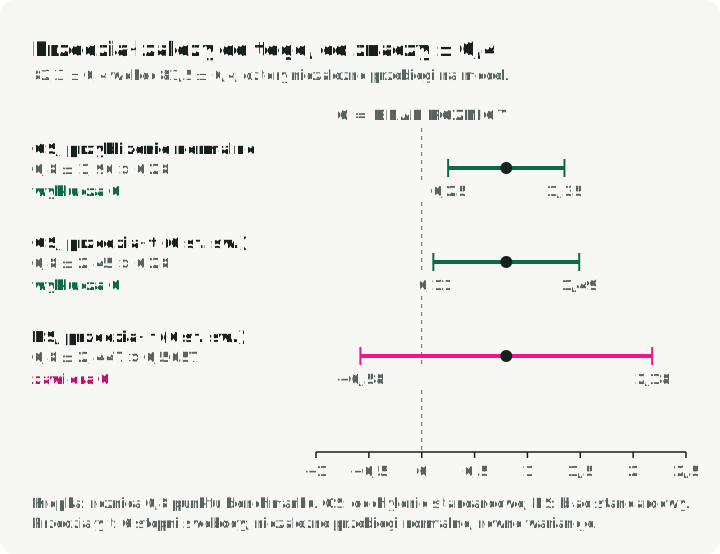
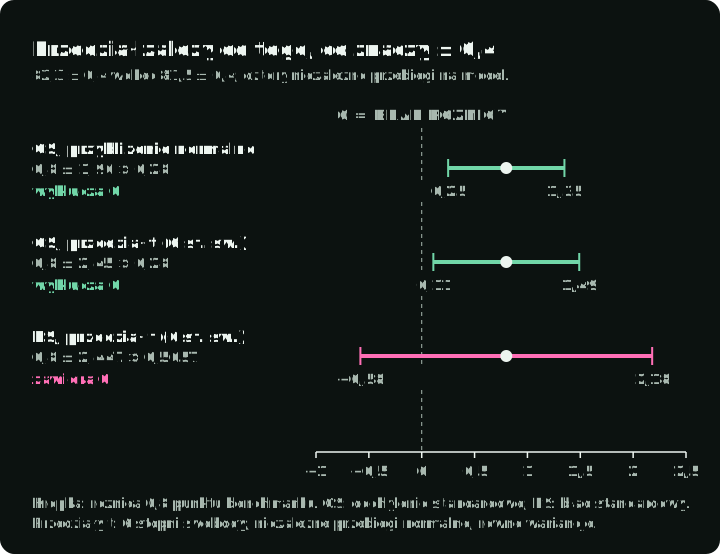
Gdy 0,4 jest odchyleniem standardowym, przedział t wyklucza zero: przy tych założeniach wyniki wspierają dodatnią różnicę. Gdy 0,4 jest oszacowanym błędem standardowym, przedział zawiera zero, więc wyniki nie rozstrzygają, który model ma wyższy średni wynik.
Entropia krzyżowa i dywergencja KL
W trakcie treningu model potrzebuje liczbowej straty (loss), która mierzy, jak dobrze jego przewidywane prawdopodobieństwa zgadzają się z celem treningowym. Algorytm treningowy zmienia parametry modelu, by tę stratę zmniejszyć. Entropia krzyżowa dostarcza taką stratę dla przykładów z etykietami lub dla prawdopodobieństw modelu-nauczyciela. Dywergencja Kullbacka–Leiblera (KL) mierzy rozbieżność między dwoma rozkładami. Artykuły używają jej, by wytrenować ucznia naśladującego nauczyciela albo by karać odchylenia od ustalonego modelu referencyjnego.
Tutaj wyniki są dyskretne, na przykład tokeny lub klasy. Rozkład docelowy zapisz jako , a przewidywany przez model rozkład po tych samych wynikach jako . Zacznij od jednego zaobserwowanego wyniku : gdy model przypisał mu prawdopodobieństwo , jego strata wynosi . Jest to 0 dla , około 0,69 dla , około 2,3 dla i nieskończoność dla .
Entropia krzyżowa uśrednia tę stratę po wynikach losowanych z celu:
Przy etykiecie one-hot , która wynosi 1 dla poprawnej klasy i 0 dla pozostałych, liczy się tylko poprawna klasa, a : zwykła strata klasyfikacji. nn.CrossEntropyLoss z PyTorch oblicza ją z surowych wyników modelu, zwanych logitami, i wewnętrznie stosuje log-softmax; jej wejściem nie jest wektor prawdopodobieństw . Gdy jako weźmiemy miękki rozkład modelu-nauczyciela, każda klasa liczy się proporcjonalnie do prawdopodobieństwa nauczyciela. Klasyczna destylacja w ten sposób trenuje mały model na prawdopodobieństwach dużego. Dla celu dwa modele mają takie entropie krzyżowe :
Drugi model odpowiada celowi i żaden model nie może być lepszy. To minimum, tu 0,325, to , czyli entropia rozkładu . Wynosi ona 0 tylko dla celu one-hot: gdy sam cel jest niepewny, pozostaje strata, której żaden model nie usunie.
Dywergencja KL odejmuje to minimum i zostawia tylko stratę wynikającą z tego, że różni się od . Zapisuje się ją z podwójną kreską , która jedynie oddziela dwa argumenty; nie jest to ani kreska prawdopodobieństwa warunkowego z sekcji Prawdopodobieństwo warunkowe i prawdopodobieństwo tekstu, ani kreski długości z wektorów i macierzy. Artykuły używają jej zamiast przecinka, by zaznaczyć, że kolejność ma znaczenie: uśrednianie przebiega po wynikach losowanych z pierwszego argumentu.
Dla pierwszego modelu powyżej . KL wynosi 0, gdy oba rozkłady się zgadzają, a poza tym jest dodatnia.
Kolejność zmienia to, które rozbieżności są karane. Składnik z i jest nieskończony, więc karze za przypisanie zerowego prawdopodobieństwa czemukolwiek, co może wytworzyć. Wyniki z nic nie dodają (z konwencji ), więc nie dają bezpośredniej kary, nawet jeśli . Zamiana argumentów daje , która jest nieskończona wszędzie tam, gdzie i . Wyniki z nic nie dodają, nawet jeśli . Gdy jest celem, nazywa się KL w przód (forward), a KL wstecz (reverse).
Dla i KL w przód jest nieskończona, bo pomija wynik, który wytwarza , podczas gdy KL wstecz wynosi tylko : wynik pominięty przez nic nie dodaje. Dla i KL w przód to 0,37 znalezione wyżej, tu obliczone składnik po składniku, a KL wstecz jest inna:
Ta asymetria jest powodem, dla którego KL nazywa się dywergencją, a nie odległością.
Ponieważ , a entropia ustalonego nauczyciela nie zależy od ucznia, entropia krzyżowa względem ustalonego nauczyciela daje uczniowi te same gradienty co . Zmiana parametru ucznia zmienia obie straty o tyle samo, więc ich pochodne używane w treningu są równe; Gradienty i optymalizacja wyjaśniają to obliczenie. Dzięki temu kod klasyfikacji i klasycznej destylacji może używać entropii krzyżowej. Zamiana działa tylko wtedy, gdy nauczyciel jest pierwszy. Gdy pierwszy jest uczeń, , a entropia samego ucznia zmienia się w trakcie treningu, więc obie wielkości nie dają już tych samych gradientów.
Wektory i macierze
Równania architektury opisują obliczenia na tablicach liczb. Kształt tablicy mówi, jak ułożone są jej liczby, jakie operacje są dozwolone i co one dają. Wektor to uporządkowana lista liczb. Macierz układa liczby w wiersze i kolumny. W kodzie ML tensor to ogólne określenie takich tablic liczbowych, także tych z więcej niż dwiema osiami. Oś to wymiar, wzdłuż którego indeksuje się tablicę: macierz ma oś wierszy i oś kolumn.
Stan ukryty tokena to wektor liczb obliczony wewnątrz modelu, by reprezentować ten token. Przypuśćmy, że przetwarzamy razem batch sekwencji, każda z pozycjami tokenów, a każdy stan ukryty zawiera liczb. Tablica stanów ukrytych ma kształt [B, T, d], który artykuły zapisują też jako . Jej trzy osie wybierają sekwencję, pozycję tokena i liczbę w wektorze tego tokena. Na przykład [2, 3, 4] zawiera dwie sekwencje, po trzy wektory tokenów w każdej i po cztery liczby w wektorze: łącznie 24 liczby. Tutaj to szerokość wektora. Kształt wymienia trzy rozmiary; ich pomnożenie daje liczbę elementów.
Artykuły często zapisują kształty jako przynależność do zbioru: oznacza, że jest wektorem liczb rzeczywistych, a oznacza, że jest macierzą o wierszach i kolumnach. Pogrubione litery czasem oznaczają wektory lub tensory, ale o kształcie rozstrzyga definicja z artykułu.
W tabeli poniżej i to wektory kolumnowe: ich liczby są ułożone pionowo. Indeks górny oznacza transpozycję: zamianę wierszy z kolumnami. Zatem to wiersz zawierający te same liczby co kolumna . Wielkie i nazywają tu macierze; nie oznacza już rozmiaru batcha.
| Wyrażenie | Używane wartości | Co robi operacja | Wynik |
|---|---|---|---|
| — iloczyn skalarny | Dwa wektory kolumnowe, każdy z elementami | Pomnóż odpowiadające sobie elementy, potem dodaj iloczyny: | Jedna liczba |
| — iloczyn zewnętrzny | Kolumna z elementami i kolumna z elementami | Pomnóż każdy element przez każdy element | Macierz ; element to |
| — iloczyn macierzy | z wierszami i kolumnami; z wierszami i kolumnami | Dla elementu pomnóż odpowiadające sobie liczby w wierszu macierzy i kolumnie macierzy , potem dodaj | Macierz ; liczba kolumn musi być równa liczbie wierszy |
| — iloczyn po elementach | Dwie tablice o tym samym kształcie | Pomnóż elementy na odpowiadających sobie pozycjach, bez dodawania | Tablica o tym samym kształcie |
| — konkatenacja | Kolumny i z i elementami | Umieść elementy za elementami | Jedna kolumna z elementami; sprawdź konwencję artykułu co do osi łączenia |
Dla konkretnego porównania weźmy i . Przesunięcie transpozycji zmienia zarówno obliczenie, jak i wynik:
Iloczyn skalarny daje jeden wynik, jak w porównaniu zapytania z kluczem w uwadze. Iloczyn zewnętrzny zachowuje osobną wartość dla każdej pary elementów; aktualizacja w Gated DeltaNet używa go do zbudowania z dwóch wektorów aktualizacji macierzy.
Iloczyn macierzy można pogrupować inaczej, , ale nie można zmieniać kolejności; wyprowadzenie MLA używa przegrupowania, by uniknąć odbudowywania kluczy. NumPy zapisuje mnożenie macierzy jako @, a iloczyn po elementach jako *. Artykuły nie dziedziczą reguł broadcastingu z NumPy: dodanie wektora do macierzy wymaga podanej osi. Artykuły różnią się też tym, czy wektor jest wierszem, czy kolumną: uwaga układa tokeny jako wiersze , podczas gdy MLA, Gated DeltaNet i LoRA zapisują z wektorami kolumnowymi, a nn.Linear w PyTorch oblicza x @ W.T na wierszach.
Równanie architektury może też opisywać rozmiar wektora, ograniczać dozwolone macierze albo przestawiać iloczyn:
| Notacja | Znaczenie |
|---|---|
| Długość euklidesowa; , bez pierwiastka, pojawia się w stracie DDPM | |
| Suma wartości bezwzględnych | |
| Norma spektralna: największy czynnik, przez który zwiększa długość wektora; mHC utrzymuje ją na poziomie co najwyżej 1 | |
| Liczba niezależnych kolumn; aktualizacja LoRA ma rząd co najwyżej | |
| Wyznacznik: to czynnik, przez który skaluje objętość, a znak zapisuje, czy odwraca orientację; używa go przykład zamiany zmiennych w Dodatku B tego artykułu | |
| Każdy element jest nieujemny, jak w mHC; to inny warunek, półdodatnia określoność: dla każdego | |
| , | Macierz jednostkowa (1 na przekątnej, 0 poza nią, więc ); wektor jedynek |
| Transpozycja iloczynu odwraca kolejność; korzystają z niej sekcje RoPE i MLA w części 2 |
Gradienty i optymalizacja
Trening używa pochodnych, by zdecydować, jak zmienić parametry modelu. Niech będzie jedną skalarną stratą, a wektorem wszystkich parametrów; to jeden element tego wektora.
Pochodna cząstkowa to jedna liczba, obliczona dla bieżących wartości parametrów. Mierzy tempo zmiany straty, gdy zmienia się tylko , a pozostałe parametry są stałe. Czytaj ją jako „pochodna cząstkowa straty względem parametru ”.
Gradient zbiera te liczby dla wszystkich parametrów w jeden wektor. Jego -ty element to . Symbol nazywa się nabla; tu znaczy „weź gradient”. Przy jednym parametrze gradient ma jeden element równy zwykłej pochodnej.
Na przykład weźmy . Dla i :
Pierwsza pochodna cząstkowa, 4, oznacza, że zwiększenie o 0,01 podnosi stratę o około 0,04, gdy pozostaje stałe. Gradient zawiera tę informację dla obu parametrów. Spadek gradientu (gradient descent) odejmuje pochodną każdego parametru pomnożoną przez dodatnią szybkość uczenia (learning rate) , która kontroluje wielkość kroku:
Dla przykład zmienia się z na , a strata spada z 7 do 3,04. Dla różniczkowalnej straty z niezerowym gradientem dostatecznie mały krok zmniejsza stratę. Zerowy gradient nie daje aktualizacji.
Indeks dolny przy mówi, co się zmienia. zmienia parametry; zmienia wejście, a artykuły o dyfuzji nazywają to score, co nie ma nic wspólnego z wynikiem w benchmarku.
Jakobian zapisuje pochodne dla wielu wyjść. Warstwa sieci neuronowej może produkować wiele liczb, takich jak składowe stanu ukrytego tokena. Aby opisać, jak każde wyjście reaguje na każde wejście, zbierz pochodne cząstkowe w macierz zwaną jakobianem (Jacobian). Dla z liczbami wejściowymi i liczbami wyjściowymi jej kształt to : wiersze odpowiadają wyjściom, kolumny wejściom, a element mierzy, jak zmienia się wyjście , gdy zmienia się wejście .
Na przykład niech funkcja przyjmuje dwie liczby i zwraca oraz . Jej jakobian to
Druga kolumna mówi, że zwiększenie o 0,1 przy stałym zwiększa o 0,2 i zmniejsza o 0,1. Ten przykład jest liniowy, więc jego jakobian jest stały. Dla funkcji nieliniowej elementy mogą zależeć od bieżącego wejścia i opisują małe zmiany lokalnie. Przy tylko jednym wyjściu skalarnym jakobian ma jeden wiersz: te same pochodne co gradient, transponowane w naszej konwencji wektorów kolumnowych. Ogólne definicje podaje Deep Learning, §4.3.
Propagacja wsteczna (backpropagation) używa tych pochodnych do obliczenia gradientu straty przez kolejne warstwy. Przykład zamiany zmiennych w Dodatku B tego artykułu korzysta z innej własności: wartość bezwzględna wyznacznika kwadratowego jakobianu daje lokalny współczynnik skalowania objętości, który jest potrzebny do skorygowania gęstości prawdopodobieństwa.
W treningu pochodne opisują zmiany lokalne; cel optymalizacji mówi, co aktualizacje mają minimalizować lub maksymalizować. Artykuły odróżniają najlepszą wartość celu od parametrów, które ją osiągają: to najmniejsza wartość , a daje wartości parametrów, które ją osiągają. Dla minimum wynosi 0, a argmin to 3. Argmin określa pożądany wynik, ale pozostawia otwarty algorytm aktualizacji.
Na przykład MiniLLM zapisuje swój cel jako (równanie 1), gdzie to model ucznia, a nauczyciel, od którego się uczy. Sekcja 2.2 wyprowadza następnie gradient i modyfikuje go, by trening był stabilniejszy; równanie (7) to gradient używany do aktualizacji. Przykład destylacji on-policy wyjaśnia te zmiany. Samo przeczytanie argmin by je pominęło.
Stop-gradient, , przekazuje do przodu bez zmian, ale blokuje przechodzące przez niego gradienty, jak .detach() w PyTorch. Dwa wyrażenia o tej samej wartości w przebiegu w przód mogą trenować się inaczej, jeśli jedno z nich jest odłączone. W przykładzie GRPO Hugging Face TRL traktuje logarytm prawdopodobieństwa starego modelu jako stały. W skrócie destylacji omawianym przez DeepSeek-V4 odłączony logarytm ilorazu nauczyciel–uczeń dostarcza stałej wagi dla aktualizacji.
Zbiory i ograniczenia
Ograniczenie (constraint) mówi, jakie wartości są dozwolone. Artykuły często wyrażają ograniczenia za pomocą zbiorów: kolekcji różnych elementów zapisywanych w klamrach, takich jak . Kolejność nie ma znaczenia, więc nazywa ten sam zbiór. Powtórzone elementy liczą się tylko raz. Dla porównania nawiasy okrągłe w wektorze takim jak opisują uporządkowaną listę: to inny wektor.
Gdy artykuł zdefiniuje zbiór, może sprawdzać przynależność, łączyć zbiory, zliczać ich elementy albo stawiać na nich warunek. Weźmy i :
| Notacja | Znaczenie | Przykład i jak go czytać |
|---|---|---|
| Przynależność: należy do | : 2 jest elementem | |
| Suma: weź każdy element któregokolwiek ze zbiorów | ; 3 wchodzi tylko raz | |
| Iloczyn (część wspólna): zostaw tylko elementy wspólne obu zbiorów | ||
| Liczba różnych elementów | ||
| „Dla każdego”: warunek musi zachodzić dla wszystkich wymienionych elementów | : każdy element jest dodatni | |
| „Istnieje”: co najmniej jeden element musi spełniać warunek | : ma element większy niż 2, mianowicie 3 |
Notacja kształtów z sekcji Wektory i macierze też nazywa zbiory: to zbiór wszystkich wektorów liczb rzeczywistych, a zbiór wszystkich macierzy rzeczywistych o wierszach i kolumnach. Zatem określa, jaki kształt musi mieć .
Notacja budowania zbioru opisuje zbiór warunkiem: czyta się „elementy , które spełniają warunek”, jak zbiór składany (set comprehension) w Pythonie {x for x in S if condition(x)}. Kreska oznacza „takie, że”, a nie prawdopodobieństwo warunkowe; niektóre artykuły używają zamiast niej dwukropka. Przykłady w tej serii to dozwolone macierze w mHC, wybrani eksperci w MoE i wybrane tokeny w uwadze rzadkiej.
DAPO, metoda treningu, która filtruje grupy wygenerowanych odpowiedzi, zachowuje pytanie tylko wtedy, gdy część odpowiedzi jest poprawna, a część błędna. Dla wylosowanych odpowiedzi i odpowiedzi referencyjnej zbiór indeksów poprawnych odpowiedzi zapisujemy jako
Filtr to . Użycie indeksów sprawia, że zliczanie jest jawne: dwie próbki o identycznym tekście nadal liczą się jako dwie odpowiedzi. Artykuł DAPO zapisuje natomiast zbiór po odpowiedziach ; czytany dosłownie jako zbiór tekstów, ten zapis liczy dwie identyczne odpowiedzi raz.
Ćwiczenia
- Kształty. ma kształt , ma , a ma . Jakie kształty mają wyniki (scores) i wyjście? Po której osi przebiega softmax?
- Softmax. Oblicz softmax dla . Czy dodanie 100 do obu wejść zmienia wynik?
- Średnie. Jedna odpowiedź ma jeden token ze stratą 4; druga ma trzy tokeny ze stratą 0. Oblicz średnią na token i średnią na odpowiedź.
- Warunkowanie. Spośród 200 odpowiedzi 120 jest poprawnych, 80 przechodzi walidację formatu, a 60 spełnia oba warunki. Znajdź i .
- KL. Dla nauczyciela i ucznia oblicz oba kierunki KL.
- Zbiory. DAPO zachowuje pytanie tylko wtedy, gdy , gdzie zawiera indeksy poprawnych odpowiedzi spośród próbek. Dla : czy zachowa pytanie, którego odpowiedzi dostają wyniki ? A takie, którego odpowiedzi dostają ? Czy pierwsza odpowiedź się zmieni, jeśli wszystkie cztery próbki zawierają identyczny poprawny tekst?
Odpowiedzi:
-
Wyniki mają kształt , a wyjście . Softmax przebiega po sześciu kluczach w wierszu każdego zapytania.
-
. Dodanie tej samej liczby do każdego wejścia nie zmienia softmaxu, ale bezpośrednie obliczenie przepełnia 32-bitowe liczby zmiennoprzecinkowe.
-
Dwie średnie:
-
i .
-
, a , ponieważ uczeń przypisuje prawdopodobieństwo wynikowi, który nauczyciel wyklucza.
-
Nie: ma cztery elementy, czyli tyle, ile wynosi . Tak: ma trzy elementy, między 0 a 4. Identyczny tekst nie zmienia pierwszej odpowiedzi: to cztery osobne próbki, więc ich cztery indeksy nadal się liczą.
Dodatek A. Litery greckie
Role są typowymi przykładami; każdy artykuł nadal sam definiuje, co oznaczają jego symbole.
| Litera | Nazwa | Typowe role w artykułach o ML |
|---|---|---|
| alfa | Waga mieszania lub skala; zanik (Gated DeltaNet); harmonogram szumu (DDPM) | |
| beta | Siła kary (DPO, GRPO); siła zapisu (Gated DeltaNet); harmonogram szumu (DDPM) | |
| gamma | Współczynnik dyskontowania w RL; rozmiar kroku (aktualizacja obciążenia w DeepSeek-V3) | |
| delta | Różnica lub zmiana | |
| epsilon | Szum (DDPM); zakres obcinania (GRPO); mały stabilizator | |
| eta | Szybkość uczenia | |
| theta | Parametry modelu; kąty obrotu w RoPE | |
| lambda | Waga regularyzacji; wartość własna | |
| mi | Średnia; liczba kroków gradientu na batch w Algorithm 1 z DeepSeekMath | |
| pi | Polityka; to operator iloczynu | |
| ro | Iloraz prawdopodobieństw, jak w sekcji GRPO w części 3; korelacja | |
| sigma | Sigmoida (DPO); odchylenie standardowe; kowariancja; to operator sumy | |
| tau | Temperatura; próg; trajektoria w RL | |
| fi | Parametry drugiej sieci, takiej jak koder; cechy; kąt | |
| psi | Parametry innej sieci, takiej jak model wartości w PPO z DeepSeekMath | |
| omega | Częstotliwość; to także dolne ograniczenie w teorii złożoności lub zbiór wyników |
Warianty takie jak i to zwykle ta sama litera w innym kroju, ale artykuł może używać obu do różnych zmiennych.
Dodatek B. Inne rodziny równań
Postacie równań, których ta seria nie rozpracowuje, razem z definicjami, których każda wymaga:
Selektywne modele przestrzeni stanów. Model przestrzeni stanów przetwarza sekwencję, aktualizując w każdym kroku zapisany stan. Aktualizacja w postaci , łączy poprzedni stan z bieżącym wejściem, a potem oblicza wynik. Tu to bieżące wejście, zapisany stan, a wynik. Macierze , i odpowiednio przekształcają poprzedni stan, dodają wkład wejścia i wytwarzają wynik. Kreski nad literami oznaczają parametry przekształcone z modelu ciągłego w czasie na kroki dyskretne; nie oznaczają średnich. W Mamba parametry aktualizacji zależą od bieżącego wejścia, co oznacza słowo „selektywny”.
Stochastyczne równania różniczkowe. opisuje, jak stan zmienia się z czasem : to jego tempo zmian. Stochastyczne równanie różniczkowe (SDE) dodaje zmiany losowe, . Tu opisuje zmianę deterministyczną, ustala skalę szumu, a jest przyrostem ruchów Browna. Aby przybliżyć je w kodzie, metoda Eulera–Maruyamy używa małego kroku czasowego i zastępuje szumem Gaussa o wariancji . Sekcja 5.1 książki Tianhua Chena The Little Book of Generative AI Foundations podaje taką aktualizację; §6.4 tej samej książki używa SDE do opisu modeli dyfuzyjnych.
Zamiana zmiennych. Przekształcenie zmiennej losowej zmienia jej gęstość zgodnie z tym, jak przekształcenie zmienia lokalną objętość. Załóżmy, że odwzorowuje między przestrzeniami o tym samym wymiarze, a zarówno , jak i jej odwrotność są różniczkowalne. Gęstości przed przekształceniem i po nim, i , spełniają . Odwrotność odtwarza z . Jej jakobian jest kwadratową macierzą pierwszych pochodnych; wartość bezwzględna jego wyznacznika koryguje lokalną zmianę objętości. Na przykład jeśli w jednym wymiarze, gęstość przyjmuje postać : podwojenie szerokości zmniejsza gęstość o połowę. Przepływy normalizujące (normalizing flows) używają takich odwracalnych przekształceń do modelowania gęstości; książka Tianhua Chena, §7.1, wyjaśnia tę metodę.
Cele min–max. W generatywnych sieciach przeciwstawnych (GAN) generator tworzy przykłady, a dyskryminator próbuje odróżnić je od prawdziwych danych. Cel mierzy sukces dyskryminatora: go maksymalizuje, a minimalizuje. Cel (równanie 1) mówi: dla każdego możliwego generatora rozważ najlepszy przeciw niemu dyskryminator, a potem wybierz generator o najmniejszej wynikowej wartości celu. Trening nie rozwiązuje tej wewnętrznej maksymalizacji dokładnie. Algorithm 1 w artykule na przemian wykonuje kroków wznoszenia gradientu dla i jeden krok spadku gradientu dla ; w jego eksperymentach .
Sympleks prawdopodobieństwa. Wektor prawdopodobieństw ma elementy nieujemne, które sumują się do 1. Zbiór wszystkich takich wektorów o elementach nazywa się sympleksem prawdopodobieństwa (probability simplex) i zapisuje . Należy do niego każdy wynik softmaxu. Tu nazywa zbiór, a indeks górny to jego wymiar, a nie potęga: gdy wybrano prawdopodobieństw, ostatnie musi dopełnić sumę do 1. Przy dwóch możliwościach każdy rozkład ma postać dla , więc swobodna jest tylko jedna liczba.
Normalizacja. Normalizacja przeskalowuje wartości względem średniej i rozrzutu wybranej grupy. Częsta postać to , gdzie to średnia, wariancja, a mała liczba dodatnia, która zapobiega dzieleniu przez zero. Samo równanie nie mówi, które elementy służą do obliczenia średniej i wariancji. Dla batcha wektorów cech normalizacja batcha (batch normalization) liczy je osobno dla każdej cechy po przykładach. Normalizacja warstwy (layer normalization) w Transformerze liczy je osobno dla każdego tokena po jego cechach. Porównując implementacje, sprawdź określone osie.
Źródła i wersje
Numery sekcji i równań odnoszą się do tu podlinkowanych wersji.
- Tianhua Chen. The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer. 2026. Wersja 2; §2.4 i §3.2 omawiają nierówność Jensena i ELBO, §5.1 i §6.4 szum w czasie ciągłym.
- Vaswani et al. Attention Is All You Need. 2017. Wersja 7, §3.2.1, równanie (1) i przypis 4.
- Dai et al. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. 2024. Drobnoziarnista segmentacja ekspertów i liczba kombinacji, §3.1; ablacja, §4.4 i Figure 3.
- Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024. Wersja 3, §1.1, §4.1.1, równania (1)–(4) i Algorithm 1.
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. 2024. Wersja 5, §2.1.1–2.1.3, równania (9)–(19) i Appendix C.
- DeepSeek-AI. DeepSeek-V3 Technical Report. 2024–2025. Wersja 2, §2.1.2, równania (12)–(18).
- DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025. Wersja 1: §2.2.1, równania (1)–(3). Wersja 2, 2026: §2.1 i Supplementary A.3.
- DeepSeek-AI. DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence. 2026. Wersja 1: §2.2, równania (1)–(8); §5.1.2, równanie (29).
- Rafailov et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. 2023–2024. Wersja 3, §4, równanie (7).
- Gu et al. MiniLLM: Knowledge Distillation of Large Language Models. 2023–2024. Wersja 4, §2.1, równanie (1) oraz §2.2, równania (2) i (7).
- Yu et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. 2025. Wersja 2, §3.2–3.3, równania (11)–(12).
- Gu and Dao. Mamba: Linear-Time Sequence Modeling with Selective State Spaces. 2023–2024.
- Yang et al. Gated Delta Networks: Improving Mamba2 with Delta Rule. 2024–2025. Wersja 3, §3.1, równanie (10) oraz §3.3–3.4.
- Ho, Jain and Abbeel. Denoising Diffusion Probabilistic Models. 2020. Wersja 2, §2, równania (4)–(5); §3.2, równanie (12); §3.4, równanie (14) oraz Algorithms 1–2.
- Goodfellow et al. Generative Adversarial Nets. 2014. Równanie (1) i Algorithm 1.
- Chen et al. Evaluating Large Language Models Trained on Code. 2021. Wersja 2, §2.1, równanie (1) i Figure 3.
- Hugging Face TRL.
GRPOTraineriGRPOConfigprzy commiciec6eac19, październik 2026. - Stanford CS229. Probability Theory Review i Linear Algebra Review and Reference.
- Dive into Deep Learning. Preliminaries.
- Britz, Goldie, Luong and Le. Massive Exploration of Neural Machine Translation Architectures. 2017. Wersja 2, Table 5; cytowane w Attention Is All You Need w porównaniu uwagi iloczynu skalarnego z addytywną.