Comment lire les mathématiques des articles d'AI sur arXiv : guide pratique
Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Savoir lire les mathématiques d’un article d’AI est une compétence utile pour les ingénieurs qui doivent comprendre un modèle, reproduire une méthode ou juger une affirmation expérimentale. Ce guide explique comment décoder la notation, vérifier une équation sur de petits nombres et la relier au reste de l’article et à l’implémentation. Il suppose que vous savez lire du code, mais pas que la notation de la recherche vous soit déjà familière.
Une équation compresse plusieurs décisions en une seule ligne : les objets manipulés, leurs dimensions, les valeurs qui sont échantillonnées, et ce qui est appris ou laissé fixe. Retrouver ces détails est un bon premier pas. Expliquer pourquoi une méthode fonctionne et l’implémenter fidèlement demande un travail supplémentaire.
Commencez par le parcours de l’attention : il relie une équation à des dimensions de tableaux, à de petits nombres et à du Python exécutable. La référence de notation explique les expressions que vous rencontrerez dans d’autres articles. Le reste de cette série applique la même méthode à des équations d’articles précis : des équations d’architecture comme RoPE, MLA et LoRA ; des objectifs d’entraînement comme DPO et GRPO ; des modèles génératifs et des métriques comme l’ELBO, la diffusion et pass@k. Ces parties ne sont pas encore publiées, donc les parcours auxquels cette partie renvoie ne sont pas liés. Pour un traitement plus long des fondements, The Little Book of Generative AI Foundations de Tianhua Chen développe l’algèbre linéaire et les probabilités qui sous-tendent les modèles génératifs.
Attention, lue symbole par symbole
L’attention produit un vecteur de sortie en calculant une moyenne pondérée de vecteurs valeur. Elle obtient les poids en comparant un vecteur requête de la position de sortie à un vecteur clé de chaque position d’entrée disponible. Les matrices , et rassemblent ces vecteurs requête, clé et valeur. L’attention par produit scalaire normalisé (scaled dot-product attention) combine ces étapes dans l’équation (1) du §3.2.1 (§ signifie « section ») de Attention Is All You Need :
Les définitions sont dans le texte, pas dans l’équation. Le paragraphe qui précède l’équation (1) dit que les requêtes et les clés ont la dimension et les valeurs la dimension . La méthode calcule le produit scalaire de chaque requête avec toutes les clés, divise chacun par et applique un softmax « pour obtenir les poids sur les valeurs ». Les requêtes sont « regroupées dans une matrice », et les clés et les valeurs dans et . Chaque ligne de ces matrices est donc le vecteur d’un token, et le softmax produit un jeu de poids par requête. Les matrices apprises qui transforment les vecteurs de tokens en , et apparaissent plus loin, au §3.2.2.
Dimensions et rôles. Une tête d’attention effectue un tel calcul avec ses propres vecteurs requête, clé et valeur. Notez leurs dimensions avant de lire les opérateurs. Pour une tête avec requêtes et clés :
| Symbole | Dimension | Ce que c’est | D’où cela vient |
|---|---|---|---|
| une ligne de requête par position de sortie | vecteurs de tokens multipliés par une matrice apprise | ||
| une ligne de clé par position pouvant être prise en compte | vecteurs de tokens multipliés par une matrice apprise | ||
| une ligne de valeur par clé | vecteurs de tokens multipliés par une matrice apprise | ||
| transposée : les lignes deviennent des colonnes | les mêmes nombres que | ||
| un nombre | la largeur de chaque requête et de chaque clé | un réglage fixe : 64 dans le Transformer de base |
Les articles donnent une forme en nommant l’ensemble auquel appartient la matrice : désigne une matrice de nombres réels à lignes et colonnes, un tableau de forme [n, dk].
Lisez de l’intérieur vers l’extérieur.
-
multiplie une matrice par une matrice . Le commun est sommé, si bien que le résultat est un tableau de scores. L’entrée est le produit scalaire de la requête et de la clé : on multiplie les entrées correspondantes, puis on additionne les produits. Pour des longueurs de vecteurs fixées, ce score est plus grand quand leurs directions sont plus proches.
-
Diviser par empêche les scores de croître avec la largeur des vecteurs. La note de bas de page 4 de l’article montre pourquoi les produits scalaires non normalisés croissent. Supposons que les composantes d’une requête et d’une clé soient indépendantes les unes des autres (en connaître certaines n’apprend rien sur les autres), chacune de moyenne 0 et de variance 1 (la distance quadratique moyenne à la moyenne). Alors :
Ces lignes utilisent deux règles sur les nombres indépendants. Première règle : le produit de deux nombres indépendants, chacun de moyenne 0 et de variance 1, a lui aussi une variance de 1. Seconde règle : quand on additionne des nombres indépendants, leurs variances s’additionnent, donc les produits donnent une variance de . L’écart-type est la racine carrée de la variance, . Diviser chaque score par réduit la dispersion du même facteur, qui retombe à 1.
Pourquoi ces deux règles sont vraies
Variance quand la moyenne vaut 0. La variance est la distance quadratique moyenne à la moyenne. Quand la moyenne vaut 0, la distance quadratique à la moyenne est simplement le carré du nombre, donc la variance est la moyenne du carré. Une composante de moyenne 0 et de variance 1 a donc un qui vaut 1 en moyenne.
La moyenne d’un produit. Pour des nombres indépendants, la moyenne d’un produit est le produit des moyennes. Prenons un nombre qui vaut 1 ou 3 avec la même probabilité, donc de moyenne 2, et un nombre qui vaut 1 ou 5, aussi avec la même probabilité, donc de moyenne 3. Indépendants signifie que prend chacune de ses valeurs aussi souvent quelle que soit la valeur de , donc les quatre paires sont équiprobables. Quand , les produits sont 1 et 5, de moyenne . Quand , ils sont 3 et 15, de moyenne . Dans les deux cas la moyenne est , donc sur les deux valeurs de elle vaut , soit . Sans indépendance, la règle échoue : si valait 5 chaque fois que vaut 3, et 1 chaque fois que vaut 1, seuls les produits 1 et 15 se produiraient, et leur moyenne est 8. Wikipedia énonce la règle pour toutes variables aléatoires indépendantes, avec « espérance » pour la moyenne : indépendance et espérance.
Règle 1 : un produit a une variance de 1. Prenons un produit . Sa moyenne est le produit des moyennes, , donc sa variance est la moyenne de . Les carrés sont indépendants parce que et le sont, et chacun vaut 1 en moyenne, donc la variance est . La formule générale est la variance d’un produit de variables indépendantes.
Règle 2 : les variances de termes indépendants s’additionnent. Notons les produits , de sorte que le produit scalaire est la somme . Les termes sont indépendants parce que chacun utilise des composantes différentes, et chacun a une moyenne de 0 et une variance de 1. La somme a elle aussi une moyenne de 0, donc sa variance est la moyenne de son carré. Multiplier la somme par elle-même donne un produit pour chaque paire de termes, une grille :
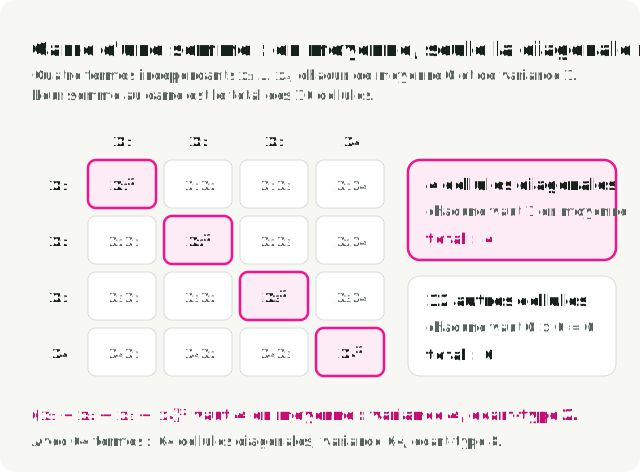
Les cellules diagonales sont les carrés , et chacune vaut 1 en moyenne. Toute autre cellule multiplie deux termes différents et indépendants, donc sa moyenne est le produit de leurs moyennes, : ses valeurs positives et négatives s’annulent. Il ne reste que les cellules diagonales, donc la variance de la somme est et son écart-type . La dispersion croît comme la racine carrée de la largeur parce que la majeure partie de la grille s’annule. Wikipedia donne l’énoncé général sous le nom de variance d’une somme de variables non corrélées ; des variables indépendantes sont toujours non corrélées, donc la règle les couvre.
Avec , les scores bruts s’étalent typiquement sur environ ; une fois normalisés, sur environ , quelle que soit la largeur.
Des scores très dispersés saturent le softmax (étape 3), et ses gradients s’évanouissent. Si un score d’une ligne est bien au-dessus des autres, le softmax donne à cette clé un poids proche de 1 et à toutes les autres un poids proche de 0. Une petite variation de n’importe quel score ne déplace alors presque pas les poids, donc le gradient qui atteint les requêtes et les clés est proche de zéro, et l’entraînement n’a presque rien pour les ajuster. L’article propose cela comme explication probable d’un résultat antérieur : sans la normalisation, l’attention par produit scalaire faisait moins bien que l’attention additive, une forme plus ancienne qui note une requête et une clé avec un petit réseau, pour un grand (Britz et al., 2017). L’article ne mesure pas lui-même les gradients.
-
Le softmax transforme chaque ligne de scores en poids. Soit une ligne des scores normalisés. L’exponentielle , aussi notée , utilise la constante . On a alors , où n’est qu’un second nom d’indice, de sorte que la somme parcourt toutes les clés de la ligne. Les poids sont positifs et chaque ligne somme à 1.
-
Multiplier les poids par les valeurs somme sur l’axe des clés. La ligne de la sortie est une moyenne pondérée des lignes de valeurs, pondérée par la qualité de la correspondance de chaque clé avec la requête .
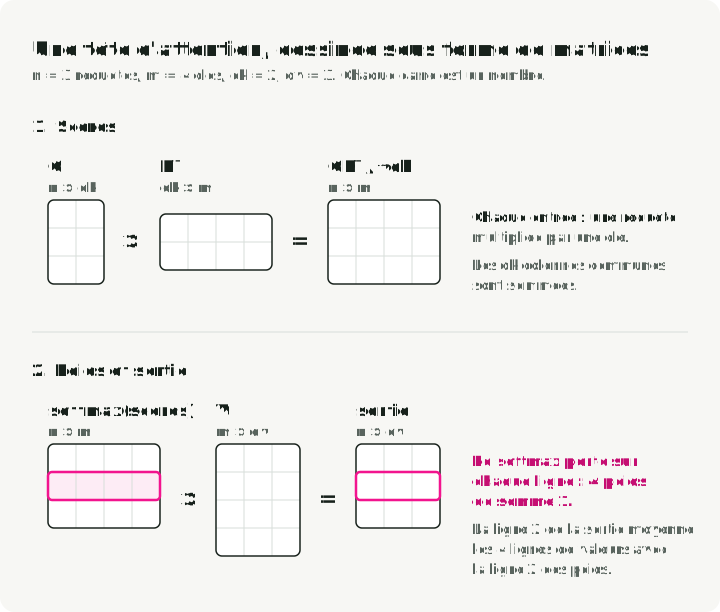
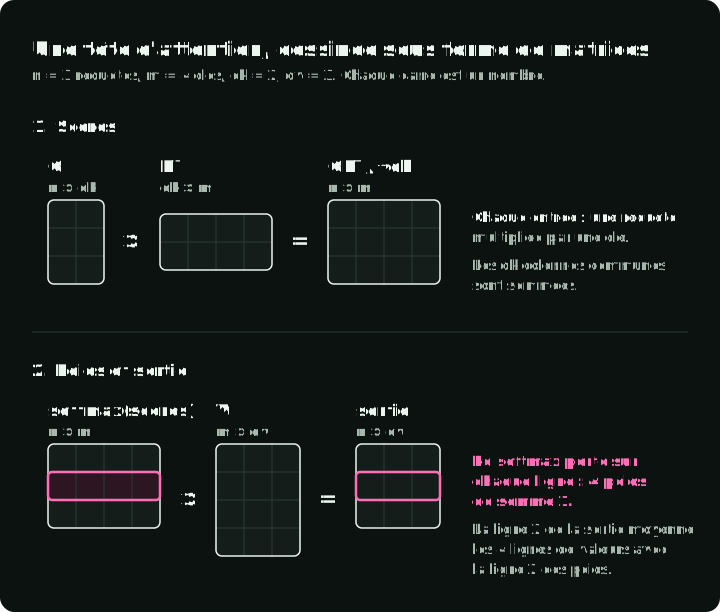
Comptez les carrés dans la figure : chaque produit supprime l’axe que ses deux grilles partagent.
Vérifiez avec deux nombres. Prenons une requête et deux clés dont les scores normalisés sont , choisis pour que les exponentielles valent 1 et 3, et les valeurs et . La figure déroule le calcul, une opération par colonne :
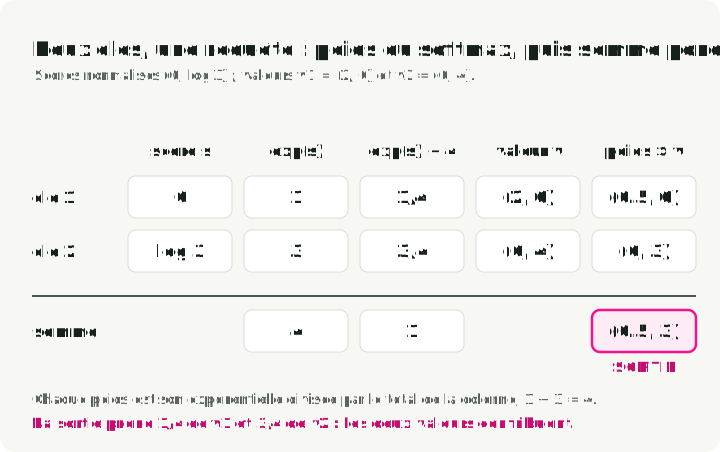
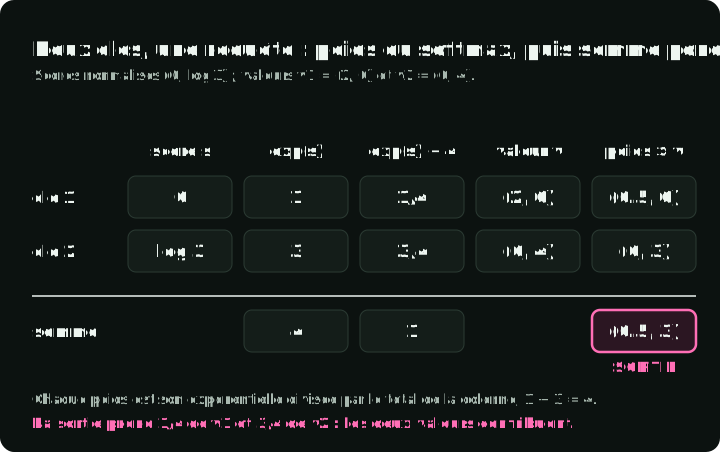
L’attention a mélangé les deux valeurs ; elle n’a pas choisi le token qui correspondait le mieux.
Comparez avec le code. La fonction NumPy ci-dessous implémente une tête. k.T est la transposée. axis=1 est l’axe des clés, donc la ligne de chaque requête est normalisée séparément. Le maximum de la ligne est soustrait avant np.exp : ajouter le même nombre à chaque score d’une ligne s’annule dans le rapport du softmax, donc le résultat est inchangé, mais les grands scores ne débordent plus. Le masque optionnel met les scores bloqués à , ce qui rend leurs poids exactement nuls. Un décodeur utilise un tel masque pour empêcher chaque token de prendre en compte les tokens suivants (§3.2.3 de l’article).
Enregistrez le bloc sous le nom attention_example.py et lancez uv run --with numpy python attention_example.py. Les vérifications passent en silence.
import numpy as np

def attention(q, k, v, allowed=None):
    """One head. q: [n, dk], k: [m, dk], v: [m, dv], allowed: bool [n, m]."""
    scores = q @ k.T / np.sqrt(q.shape[1])  # [n, m]
    if allowed is not None:
        if not allowed.any(axis=1).all():
            raise ValueError("every query needs at least one allowed key")
        scores = np.where(allowed, scores, -np.inf)
    scores = scores - scores.max(axis=1, keepdims=True)
    weights = np.exp(scores)
    weights = weights / weights.sum(axis=1, keepdims=True)  # rows sum to 1
    return weights @ v, weights  # [n, dv], [n, m]

# The two-key example from the text.
out, w = attention(
    np.array([[1.0]]),
    np.array([[0.0], [np.log(3.0)]]),
    np.array([[2.0, 0.0], [0.0, 4.0]]),
)
np.testing.assert_allclose(w, [[0.25, 0.75]])
np.testing.assert_allclose(out, [[0.5, 3.0]])

# A causal mask: query i may attend only to keys 0..i.
x = np.random.default_rng(0).normal(size=(3, 4))
out, w = attention(x, x, x, allowed=np.tril(np.ones((3, 3), dtype=bool)))
assert out.shape == (3, 4)
np.testing.assert_allclose(w.sum(axis=1), 1.0)
assert np.all(w[np.triu_indices(3, k=1)] == 0)
Une requête dont toutes les clés sont bloquées est un cas que l’équation laisse ouvert : chaque poids de sa ligne vaudrait . La fonction lève une erreur au lieu de renvoyer NaN.
D’une tête à plusieurs. Le Transformer de base exécute huit têtes en parallèle, chacune avec ses propres matrices apprises pour produire , et , et chacune avec . Il concatène leurs sorties et multiplie le résultat par une autre matrice apprise, (Attention Is All You Need, §3.2.2).
Une implémentation peut aussi traiter un batch : plusieurs séquences d’entrée ensemble. Par exemple, le scaled dot-product attention de PyTorch accepte un tenseur de requêtes Q de forme [batch, heads, n, d_k]. Les deux premières dimensions sélectionnent une séquence et une tête ; Q[b, h] est la matrice [n, d_k] de cette paire. La formule de l’attention s’applique séparément à chaque paire. La fonction NumPy ci-dessus ne gère qu’une seule de ces paires : ses opérations .T et axis=1 supposent des entrées à deux dimensions.
Six questions pour toute équation
| Question | Réponse pour l’attention |
|---|---|
| Que renvoie l’équation, et avec quelle forme ? | Une matrice : une ligne de sortie par requête |
| Chaque symbole est-il une donnée, un poids entraîné, un modèle figé, un réglage ou un échantillon ? | , et sont calculés à partir des tokens par des matrices apprises ; est un réglage fixe ; rien n’est échantillonné |
| Sur quel indice ou quel axe porte chaque opération ? | Le softmax porte sur les clés de la ligne de chaque requête ; le produit des poids avec somme sur les clés |
| Où sont les définitions ? | Le paragraphe avant l’équation (1), la note de bas de page 4, et le §3.2.2 pour les projections apprises |
| Que donne une vérification avec deux ou trois nombres ? | Des poids et une sortie |
| Qu’est-ce que le code a dû décider que l’équation laisse ouvert ? | Soustraire le maximum de la ligne, la valeur utilisée pour les scores masqués, une ligne sans clé autorisée |
Quel type d’énoncé une équation formule
L’attention est un calcul : elle dit comment obtenir une sortie à partir d’entrées. Les articles écrivent aussi des équations qui jouent d’autres rôles :
| Type | Exemple dans cette série | Ce qu’il faut vérifier |
|---|---|---|
| Calcul | La sortie de l’attention ; le vecteur compressé de MLA | La forme de chaque résultat intermédiaire |
| Définition | Le score de GRPO relatif aux autres réponses | Ce que représente le nouveau nom, pour pouvoir le remplacer par sa définition |
| Objectif : une perte à minimiser ou un score à maximiser | La perte DPO | S’il est minimisé ou maximisé, et sur quelles données porte la moyenne |
| Règle de mise à jour | La descente de gradient ; la mémoire de Gated DeltaNet | Ce qui change à chaque pas et ce qui reste fixe |
| Contrainte, ou ensemble de valeurs permises | Les matrices de mélange permises de mHC | Comment l’article produit une valeur qui la satisfait |
| Borne : une limite supérieure ou inférieure sur une quantité | La borne inférieure de l’évidence (evidence lower bound, ELBO) | La différence entre les deux côtés, et quand elle est nulle |
| Estimateur ou métrique | pass@k | Ce qui est compté, et à partir de combien d’échantillons |
| Ajustement empirique | La loi d’échelle de DeepSeek LLM | La plage de données sur laquelle la courbe a été ajustée |
Une contrainte énonce une propriété que le résultat doit avoir. Pour les poids d’attention, cette propriété est : chaque poids est positif ou nul et chaque ligne somme à 1. Le softmax est un calcul qui produit des poids ayant cette propriété. L’exigence seule ne dit pas qu’il faut utiliser le softmax.
affirme que deux expressions sont égales. signifie « est défini comme » : il donne un nom à une expression. Une définition peut nommer une métrique, une perte ou un ensemble de valeurs permises, donc voir ne vous dit pas quel type d’équation du tableau ci-dessus vous lisez.
Par exemple, Evaluating Large Language Models Trained on Code, l’article qui a présenté le modèle de génération de code Codex, utilise pour définir son estimateur de pass@k (équation 1). Cette métrique mesure la probabilité qu’au moins un des programmes générés passe les tests. Dans le rapport technique de DeepSeek-V4, l’équation (2) combine deux énoncés : définit un ensemble de matrices permises, et impose que la matrice de mélange du modèle appartienne à cet ensemble. La définition utilise ; la contrainte utilise , qui signifie « appartient à ». Les sections pass@k et mHC détaillent ces exemples.
Trouver la nouvelle équation, ses définitions et son code
La section des méthodes d’un article décrit comment fonctionne son modèle ou son algorithme d’entraînement. Le titre peut être « Method », « Architecture » ou quelque chose de plus précis. Les auteurs expliquent souvent d’abord une méthode existante, puis montrent ce qu’ils ont changé. Pour repérer la contribution revendiquée, partez du résumé de la nouveauté dans l’introduction. Par exemple, DeepSeekMath, §1.1 présente la Group Relative Policy Optimization (GRPO), sa méthode pour entraîner des modèles à partir de réponses notées. Les numéros de section et d’équation donnés ici renvoient à l’article lié.
Comparez ensuite la méthode proposée avec la méthode antérieure qu’elle modifie. Deux articles l’illustrent :
- Un changement d’architecture. DeepSeek-V2 décrit l’attention multi-têtes standard au §2.1.1 et introduit la multi-head latent attention (MLA) au §2.1.2. L’attention standard stocke les clés et les valeurs de chaque token précédent. MLA stocke un vecteur compressé à partir duquel on peut les reconstruire. Comparer ces équations révèle ce que le modèle stocke autrement ; le parcours de MLA en déduit le gain de mémoire.
- Un changement d’entraînement. DeepSeekMath, §4.1.1 donne l’objectif de la Proximal Policy Optimization (PPO) en équation (1) et celui de GRPO en équation (3). Les deux utilisent un avantage : un nombre qui dit si une réponse était meilleure ou moins bonne que prévu. PPO l’estime avec un second réseau appris, le modèle de valeur, qui prédit la récompense restant à venir à partir d’une réponse partielle. GRPO compare plutôt la récompense de la réponse aux récompenses d’autres réponses à la même question. Le parcours de GRPO compare ces termes avec la notation de réponse complète de DeepSeek-R1.
Trouvez les définitions autour de l’équation. Vérifiez le paragraphe précédent, toute phrase « où … » qui suit, les notes de bas de page et les annexes. Dans Attention Is All You Need, le paragraphe avant l’équation (1) définit les dimensions, et la note de bas de page 4 explique le facteur d’échelle. DeepSeek-V3 définit la plupart de ses symboles de routage juste après l’équation (15), et le biais juste avant l’équation (16). DeepSeek-V2 développe MLA sur les équations (9)–(19), puis rassemble le calcul dans l’Annexe C.
Consultez l’algorithme et le code. Une boîte d’algorithme est un pseudo-code numéroté qui donne l’ordre des opérations. L’Algorithm 1 de DeepSeekMath montre quand générer des réponses et quand mettre à jour le modèle. L’Algorithm 1 de Denoising Diffusion Probabilistic Models (DDPM) précise comment échantillonner l’image d’entraînement, le niveau de bruit et le bruit. Les implémentations tranchent d’autres détails : par défaut, np.std divise la somme des écarts quadratiques par , alors que torch.std divise par . L’exemple de GRPO montre comment ce choix modifie les valeurs d’avantage calculées à partir des mêmes récompenses.
Les versions d’arXiv peuvent déplacer des sections et reprendre des équations sous de nouveaux numéros, donc citez la version. Dans DeepSeek-R1 v1, l’objectif GRPO se trouve au §2.2.1, équations (1)–(3). Dans la v2, publiée en janvier 2026, il se trouve au §2.1, et les mêmes équations reviennent sous les numéros (11)–(13) dans le Supplementary A.3. Un lien sans version ouvre la dernière, donc chaque lien arXiv de cette série inclut la version par rapport à laquelle il a été vérifié.
Vérifier votre lecture avec un LLM
Un modèle de chat peut rédiger le tableau des symboles, l’indice de chaque somme et une vérification sur de petits nombres, si vous lui donnez les définitions et lui demandez de signaler ce qui manque. Le texte copié depuis un PDF aplatit les indices, les exposants et les fractions sur une seule ligne ; les liens « HTML (experimental) » et « TeX Source » de la page de résumé arXiv donnent un texte propre à coller. Collez l’équation et les paragraphes qui l’entourent avec un prompt comme celui-ci :
Below is equation (N) from <paper title, arXiv ID and version>, followed by
the paragraphs that define its symbols.

1. Make a table with one row per symbol: shape or type, meaning, and whether
   it is input data, a trained weight, a frozen model, a fixed setting or a
   random sample. Quote the sentence that defines it.
2. List every symbol the pasted text does not define. Do not guess them.
3. For every sum, mean, softmax, min or expectation, name the index or the
   distribution it runs over.
4. Work through the equation with the smallest numbers that use every term.
5. Say which kind of statement it is: a computation, definition, objective,
   update rule, constraint, bound, estimator or empirical fit.
Sans l’étape 2, rien n’empêche le modèle de combler une définition manquante par le sens habituel de la lettre, par exemple en lisant dans DPO comme un écart-type au lieu de la sigmoïde. Les citations de l’étape 1 rendent le tableau vérifiable : cherchez chacune dans le PDF, et traitez une ligne dont vous ne retrouvez pas la citation comme une supposition.
La même procédure sous forme d’agent skills. paper-math-skills regroupe cette section et la référence de notation ci-dessous en deux skills écrits pour Claude Code ; d’autres agents qui chargent des fichiers SKILL.md peuvent aussi les utiliser. read-paper-math récupère la version arXiv épinglée, cite la phrase qui définit chaque symbole, lit l’équation de l’intérieur vers l’extérieur et exécute une vérification sur de petits nombres. check-paper-math examine une telle lecture par rapport à l’article : il cherche chaque citation, relance les calculs et signale les affirmations plus fortes ou plus faibles que celles de l’article. paper-math-readings contient les lectures des skills pour les Parties 2 à 4, une pour chacune des 15 sections qui portent une ligne Source:.
Référence de notation
Si une lettre grecque ne vous est pas familière, ouvrez la référence des lettres grecques de cet article (Annexe A) pour son nom et ses sens courants. Pour s’exercer davantage aux mathématiques, Stanford CS229 propose des rappels de probabilités et d’algèbre linéaire avec exercices ; les préliminaires de Dive into Deep Learning expliquent les fondements avec du code.
Indices, marques et signes de relation
Les lettres sont des noms de variables locaux : chaque article définit les siens. Les indices inférieurs sont généralement des numéros de position. peut être la coordonnée d’un vecteur ou l’exemple d’un dataset, et est le vecteur du modèle pour le token , appelé son état caché.
Dans les articles sur les modèles, les exposants sont souvent des étiquettes. Dans , l’exposant entre parenthèses est généralement un numéro de couche, pas une puissance ; dans les et de DeepSeek-V3, il distingue les experts partagés des experts routés, ceux que chaque token utilise et ceux qu’un routeur choisit (voir l’exemple de routage MoE). Dans DeepSeek-V2, et portent des étiquettes, pas des exposants ; l’exemple de MLA définit ces étiquettes. est une transposée et est un carré.
désigne les positions 1 à , inclus, contrairement à une tranche Python ; les articles comptent généralement à partir de 1. désigne toutes les positions avant . sélectionne la ligne , comme dans le slicing de NumPy.
Les marques sur une lettre changent généralement son sens de l’une de ces façons :
| Marque | Lecture habituelle | Exemple ou exception |
|---|---|---|
| Une prédiction ou une estimation | Exemple : dans DeepSeekMath estime de combien une réponse a obtenu un meilleur score que prévu | |
| Une moyenne | Exception : dans DDPM, multiplie les facteurs du calendrier de bruit de l’étape 1 à l’étape | |
| Une version perturbée ou non contrainte | Exemple : dans DeepSeek-V4, est une matrice avant que la normalisation n’impose ses contraintes | |
| L’optimum | Exception : dans DPO, est la vraie récompense, que la méthode n’observe jamais | |
| Une nouvelle valeur ou une valeur intermédiaire | Exemple : dans DeepSeek-V3, est un poids d’expert avant normalisation | |
| L’inverse de la matrice | Pas l’inverse terme à terme : annule , (la matrice identité), et en général |
Certains symboles autres que les lettres grecques ont eux aussi plusieurs rôles :
| Symbole | Sens |
|---|---|
| Le conditionnement dans ; « tel que » à l’intérieur d’un ensemble | |
| Une valeur absolue ; la longueur d’une séquence, comme dans , le nombre de tokens de la réponse de GRPO ; la taille d’un ensemble | |
| « Est échantillonné selon » dans ; « environ » dans un texte informel | |
| Une longueur de séquence ; une température de softmax ; le nombre de pas de diffusion | |
| Un vecteur requête (attention) ; une question (GRPO) ; le modèle étudiant (distillation) ; l’encodeur (ELBO) |
Cinq signes disent comment deux côtés sont liés. , parfois , définit un nouveau nom. marque une approximation, comme la moyenne échantillonnée dans Espérances et origine des échantillons. signifie « proportionnel à », avec une constante de normalisation omise : ne devient une distribution qu’après division par . signifie « très inférieur à », comme dans le de DeepSeek-V2 : la largeur compressée est très inférieure à la largeur totale de toutes les têtes. est une affectation, comme dans une règle de mise à jour.
Sommes, comptages, intervalles et logarithmes
Le grand additionne des termes et les multiplie. L’indice sous l’opérateur commence ici à 1 et va jusqu’à la borne supérieure :
L’indice appartient à l’opérateur, comme une variable de boucle appartient à sa boucle. Dans , la somme parcourt , tandis que identifie une entrée de sortie. Le résultat est un vecteur avec une entrée par : le produit matrice-vecteur écrit en détail. Les indices du membre de gauche vous donnent la forme de la sortie.
Le facteur devant une somme décide de ce qui reçoit un poids égal. Un batch avec une réponse de 2 tokens et une réponse de 8 tokens, où est la perte sur le token de la réponse (dans GRPO, est plutôt un terme à maximiser), peut être moyenné de deux façons :
Dans la première, chaque réponse reçoit le poids , partagé entre ses tokens :
Dans la seconde, chaque token a le poids . GRPO échantillonne réponses à chaque question, et est le nombre de tokens de la réponse . Les deux moyennes s’écrivent alors ainsi, pour le GRPO de DeepSeekMath et pour DAPO, une variante ultérieure de GRPO :
Avec , on retrouve et ci-dessus. DAPO est passé à la moyenne par token (§3.3) parce que la moyenne par réponse donnait trop peu de poids aux tokens des longues réponses : le modèle apprenait trop peu des longues bonnes réponses et ne pénalisait pas assez les mauvaises réponses longues et répétitives.
Une somme peut aussi compter. Les articles le font avec une indicatrice : un 1 en gras suivi d’une condition, , qui vaut 1 quand la condition est vraie et 0 quand elle est fausse. Certains articles mettent la condition entre parenthèses ou impriment un 1 à double trait ; le sens est le même. Additionner des indicatrices compte donc combien de fois la condition est vérifiée. L’exactitude (accuracy) en est l’exemple habituel. Si est la classe prédite et la classe correcte pour l’exemple , alors est le nombre de prédictions correctes. Les prédictions (chat, chien, chien) face aux étiquettes correctes (chat, chat, chien) donnent les indicatrices 1, 0 et 1, donc le décompte est 2 et l’exactitude 2/3. Dans une couche mixture-of-experts (MoE), un routeur envoie chaque token vers quelques-uns de nombreux sous-réseaux feed-forward, appelés experts. Dans la perte d’équilibrage de DeepSeek-V3 (équation 18), l’indicatrice vaut 1 quand le score d’un expert pour un token figure parmi les scores les plus élevés pour ce token, où est le nombre d’experts vers lesquels chaque token est routé. Sa somme sur les tokens d’une séquence compte combien de fois cela s’est produit. Le score utilisé ici omet le biais que le routage ajoute, donc le décompte peut différer des experts que le routeur choisit réellement (routage MoE).
Le coefficient binomial , lu « parmi », compte les façons de choisir éléments distincts parmi sans tenir compte de l’ordre. Pour des entiers , il vaut . Le point d’exclamation désigne la factorielle : , avec . Par exemple, : cinq éléments forment dix paires distinctes. DeepSeekMoE utilise les coefficients binomiaux pour compter les combinaisons d’experts, et l’estimateur pass@k s’en sert pour compter les ensembles d’échantillons.
Les intervalles utilisent des crochets pour les bornes incluses : inclut les deux, aucune. Dans Gated DeltaNet, signifie strictement entre 0 et 1. Ailleurs, est un couple.
Le logarithme naturel inverse l’exponentiation : . Les logarithmes transforment les produits en sommes et les rapports en différences : et , mais ne se décompose pas. C’est pourquoi les articles travaillent avec des log-probabilités. Le log d’un produit de probabilités de tokens est une somme, et le log d’un rapport des probabilités de deux modèles est une différence, la forme utilisée dans les objectifs de DPO et de GRPO. Les articles de ML entendent le log naturel sauf indication contraire ; les résultats sont en nats, et les logs en base 2 donnent des bits. Pour une probabilité , , et cette valeur croît sans limite quand tend vers 0, si bien qu’une mauvaise prédiction confiante coûte cher.
Log-sum-exp signifie : exponentier chaque score , additionner les résultats, puis prendre le logarithme. Calculer directement peut déborder quand un score est grand. À la place, trouvez le plus grand score et appelez-le . La notation signifie « comparer toutes les entrées et prendre la plus grande » ; en NumPy, m = z.max().
Soustrayez de chaque score avant d’exponentier, puis rajoutez-le après avoir pris le logarithme :
Pour , le plus grand score est . Les scores décalés sont , donc le calcul devient . Aucune exponentielle n’est supérieure à 1. Le code de l’attention utilise la même soustraction avant le softmax ; là, le facteur commun s’annule dans la division, donc rien n’est rajouté.
Probabilité conditionnelle et probabilité d’un texte
est la probabilité que le modèle de paramètres attribue à la sortie étant donnée l’entrée . L’indice nomme les paramètres ; certains articles écrivent , où le point-virgule marque aussi des paramètres plutôt qu’une condition. Avec un point à la place de la sortie, est la distribution entière sur les sorties plutôt qu’un seul nombre. Les articles de RL écrivent le même objet , la probabilité que le modèle écrive la réponse à la question , et appellent le modèle une politique (policy).
Échanger l’événement et la condition donne un nombre différent. Supposons 100 réponses de modèle : 60 sont correctes, 50 sont du JSON valide, et 40 sont les deux. Alors
Soit « la réponse est correcte » et « la réponse est du JSON valide ». La probabilité conditionnelle restreint le décompte aux réponses qui satisfont la condition : , à condition que . Le symbole signifie « les deux événements se produisent ». Ici la fraction vaut , comme 40 réponses correctes parmi 50 réponses en JSON valide.
Deux événements sont indépendants quand savoir que l’un s’est produit ne change pas la probabilité de l’autre. Cela exige . Dans cet échantillon, , alors que , donc les proportions observées ne satisfont pas l’indépendance.
Le théorème de Bayes, aussi appelé règle de Bayes, relie les deux sens du conditionnement : . Il permet de calculer la probabilité de sachant à partir de la probabilité de sachant et des probabilités des deux événements. L’exemple de l’ELBO l’utilise pour trouver la probabilité d’un code caché étant donnée une image observée.
Un modèle de langage note une séquence un token à la fois. D’après la règle de la chaîne des probabilités,
Chaque facteur conditionne sur tous les tokens précédents, donc la formule ne suppose pas que les tokens sont indépendants. Si trois tokens ont pour probabilités conditionnelles 0.5, 0.2 et 0.1 :
La perte d’entraînement habituelle est l’opposé de cette somme, divisé par la longueur :
Pendant l’entraînement, les tokens précédents viennent du dataset. Pendant la génération, ce sont les propres choix antérieurs du modèle.
Espérances et origine des échantillons
Une espérance est une moyenne pondérée par les probabilités :
Lisez comme « la moyenne de quand est tiré selon ». La notation somme sur toutes les valeurs discrètes possibles de . Sans indice, moyenne une variable aléatoire selon sa propre distribution : si vaut 1 avec la probabilité 0.75 et 3 avec la probabilité 0.25, alors .
Quand une variable a une densité , c’est-à-dire une probabilité par unité de , la moyenne pondérée est une intégrale, . Le identifie comme la variable d’intégration ; sans bornes écrites ici, l’intégrale couvre toute sa plage. L’exemple de la densité explique la probabilité par unité et montre une intégrale comme l’aire sous une courbe.
Le code d’entraînement ne peut pas sommer sur toutes les entrées possibles, donc il échantillonne et fait la moyenne : , chaque étant tiré indépendamment selon , ce que les articles écrivent . Les articles appellent cela une estimation de Monte Carlo, et dans le code c’est loss.mean() sur un batch. La moyenne du batch n’estime l’espérance que si le batch est tiré selon la distribution de l’indice de , donc l’indice vous dit comment les données d’entraînement sont produites :
- DPO fait la moyenne sur des exemples enregistrés : un prompt, une réponse préférée et une réponse rejetée. Les réponses sont collectées et étiquetées avant cette étape d’entraînement ; elles peuvent provenir d’une génération antérieure du modèle. À chaque pas d’entraînement, le modèle calcule les probabilités de ces réponses fournies et met à jour ses poids. Il n’échantillonne pas de nouvelles réponses pour ce pas.
- GRPO dans DeepSeek-R1 : générer des réponses, puis comparer leurs récompenses. L’entraînement tire une question du dataset, génère plusieurs réponses et les note avec une fonction de récompense, par exemple en vérifiant un résultat mathématique ou en exécutant des tests unitaires. La mise à jour favorise les réponses dont le score dépasse la moyenne du groupe. La notation signifie « échantillonner une question dans la distribution des questions ». La notation signifie « échantillonner des réponses à cette question avec la copie du modèle nommée ». L’indice old marque la copie qui a généré ces réponses ; cette copie reste fixe pendant que le batch sert aux mises à jour. Le parcours de GRPO explique la comparaison des récompenses et les mises à jour.
- La distillation on-policy dans MiniLLM et DeepSeek-V4 : générer du texte, puis apprendre des probabilités de l’enseignant. Le modèle en cours d’entraînement est l’étudiant. Il génère du texte ; un enseignant figé fournit les probabilités du token suivant pour les mêmes préfixes, et l’entraînement ajuste les probabilités de l’étudiant vers celles de l’enseignant. Ces probabilités fournissent le signal d’entraînement, plutôt que le score de récompense d’une réponse comme dans GRPO. MiniLLM écrit le texte échantillonné par l’étudiant : est le texte et nomme le modèle étudiant. DeepSeek-V4 appelle son étudiant et utilise plusieurs enseignants spécialisés. La procédure d’échantillonnage réelle de MiniLLM mélange aussi des tokens tirés de l’enseignant. Le parcours de la distillation explique les objectifs et cette distinction d’échantillonnage.
L’ordre vous dit ce que l’entraînement optimise. Supposons qu’un modèle attribue les probabilités 0.9 et 0.1 aux sorties correctes de deux exemples d’entraînement de poids égal. Faire la moyenne de leurs log-probabilités signifie prendre d’abord chaque log, puis faire la moyenne : np.log(probs).mean(). Prendre le log de leur moyenne donne np.log(probs.mean()). Si est la probabilité attribuée à la sortie correcte d’un exemple choisi au hasard :
Prendre l’opposé de ces scores donne des pertes de 1.20 et 0.69. Un second modèle qui attribue 0.5 à chaque sortie correcte obtient 0.69 avec l’un ou l’autre calcul. Ainsi, faire la moyenne des probabilités avant de prendre le log traite les deux modèles comme équivalents, alors que la moyenne habituelle de la log-probabilité négative pénalise davantage le premier modèle pour sa faible probabilité sur la seconde sortie correcte. Quand vous traduisez une perte en code, conservez l’ordre du log et de la moyenne.
L’inégalité de Jensen énonce la relation générale pour positif : . Elle aide aussi à construire d’autres objectifs d’entraînement. Quand la probabilité des données d’un modèle exige une moyenne coûteuse sur des variables cachées, une moyenne de termes en log peut fournir une borne inférieure plus facile à estimer. Le parcours de l’ELBO explique ce problème d’entraînement ; ELBO signifie evidence lower bound. La section 2.4 de The Little Book of Generative AI Foundations de Tianhua Chen établit la borne avec l’inégalité de Jensen.
Densités, variance et barres d’erreur
a deux sens courants. Pour des résultats discrets comme des tokens ou des classes, il donne la probabilité du résultat : un nombre de 0 à 1, les probabilités sommant à 1 sur tous les résultats.
Pour comprendre l’autre sens, supposons que soit choisi uniformément entre 0 et 0.5. Des intervalles de même longueur ont les mêmes probabilités. L’intervalle de 0.1 à 0.2 occupe un cinquième de toute la plage, donc
Dans cette plage, la probabilité est la largeur de l’intervalle multipliée par 2. Ce multiplicateur est la densité de probabilité : pour , et zéro en dehors. La densité décrit la probabilité par unité de la variable, pas la probabilité d’une valeur exacte.
Une probabilité nulle pour un point ne signifie pas que rien n’est échantillonné. Rétrécissez un intervalle autour de 0.15 : sa probabilité est le double de sa largeur, donc elle tend vers zéro quand la largeur tend vers zéro. Le point exact seul a donc une probabilité nulle. Un tirage produit pourtant une valeur dans , et cet intervalle entier a une probabilité de 1. Si vous enregistrez le résultat arrondi à deux décimales, une valeur enregistrée de 0.15 représente l’intervalle de 0.145 à 0.155, dont la probabilité est .
Pour une densité non uniforme, le multiplicateur varie avec . L’intégrale additionne les contributions sur l’intervalle :
Géométriquement, c’est l’aire sous la courbe de densité entre et ; l’aire sur toute la plage vaut 1. Pour l’exemple uniforme, l’aire est simplement la hauteur 2 fois la largeur 0.5. Une densité peut donc dépasser 1, et son log peut être positif, comme ici. Une probabilité ne dépasse jamais 1.
La distribution gaussienne utilisée pour le bruit dans DDPM a une densité de ce type. Toutes les distributions continues n’ont pas une densité ordinaire : la distribution de Cantor est un contre-exemple mathématique, hors des modèles discutés ici. Stocker des nombres réels n’implique pas non plus une distribution continue : une variable restreinte à 0.0 et 1.0 a toujours deux résultats discrets.
Les articles utilisent souvent la même lettre pour les probabilités et les densités. Vérifiez comment l’article définit la distribution de la variable et quelle variable est sommée ou intégrée. Une intégrale sur une variable cachée , comme le code latent dans l’ELBO de la Partie 4, ne vous dit pas si un observé est discret ou continu. Certains articles écrivent majuscule pour les probabilités et minuscule pour les densités, mais beaucoup utilisent pour les deux.
Pour décrire à quel point une distribution s’étale autour de sa moyenne, les articles utilisent la variance : la différence quadratique moyenne à la moyenne, , où . L’écart-type en est la racine carrée, donc il a les mêmes unités que .
Ces quantités apparaissent aussi dans les noms de distributions. La distribution gaussienne, aussi appelée loi normale, s’écrit : est sa moyenne et sa variance. Pour un vecteur, utilise une matrice de covariance : l’entrée mesure comment les coordonnées et varient ensemble, et la diagonale contient leurs variances. décrit un vecteur de nombres normaux standard indépendants, chacun de moyenne 0 et de variance 1 ; est la matrice identité.
Les tableaux de benchmark rapportent souvent un score moyen accompagné d’une mesure de variation. La dispersion des exécutions individuelles diffère de l’incertitude sur leur moyenne : pour exécutions indépendantes d’écart-type , l’erreur-type de la moyenne est .
Avant de comparer deux entrées comme et , cherchez dans la légende si 0.4 est un écart-type entre exécutions, une erreur-type ou la demi-largeur d’un intervalle de confiance. Pour comparer les moyennes, calculez un intervalle pour leur différence. Une procédure d’intervalle de confiance à 95 % produit des plages qui contiennent la vraie différence dans 95 % des expériences répétées, sous ses hypothèses.
Pour cet exemple, supposons quatre exécutions indépendantes par modèle, des scores d’exécution approximativement normaux et des variances de population égales. Si les exécutions sont appariées, par exemple deux modèles évalués sur les mêmes tâches échantillonnées indépendamment, analysez plutôt les différences au sein des paires. Le guide à deux échantillons du NIST explique ces cas.
Pour des moyennes indépendantes, la variance de leur différence est la somme de leurs variances. Une variable normale standard tombe entre et avec une probabilité d’environ 0.95, ce qui fournit le multiplicateur d’une approximation normale d’un intervalle à 95 %. Si 0.4 est l’écart-type sur quatre exécutions, ce premier calcul donne :
Ce multiplicateur 1.96 traite la dispersion estimée comme connue. Avec seulement quatre exécutions par modèle, utilisez la loi de Student pour tenir compte de l’incertitude sur la dispersion. Sous les hypothèses ci-dessus, ses degrés de liberté sont (huit exécutions moins deux moyennes estimées). scipy.stats.t.ppf(0.975, 6) donne environ 2.447 au lieu de 1.96 ; 0.975 laisse 2.5 % hors de chaque extrémité d’un intervalle à 95 %. Si l’hypothèse de variances égales ne convient pas, utilisez un intervalle de Welch, dont les degrés de liberté se calculent différemment.
Considérons maintenant l’autre lecture de la légende : 0.4 est déjà l’erreur-type de chaque moyenne, estimée à partir de ces quatre exécutions. Rien n’est divisé par , et l’erreur-type de l’écart vaut environ 0.566. Le multiplicateur de Student reste nécessaire. Les deux lectures donnent :
La figure compare l’approximation normale initiale avec les deux intervalles de Student :
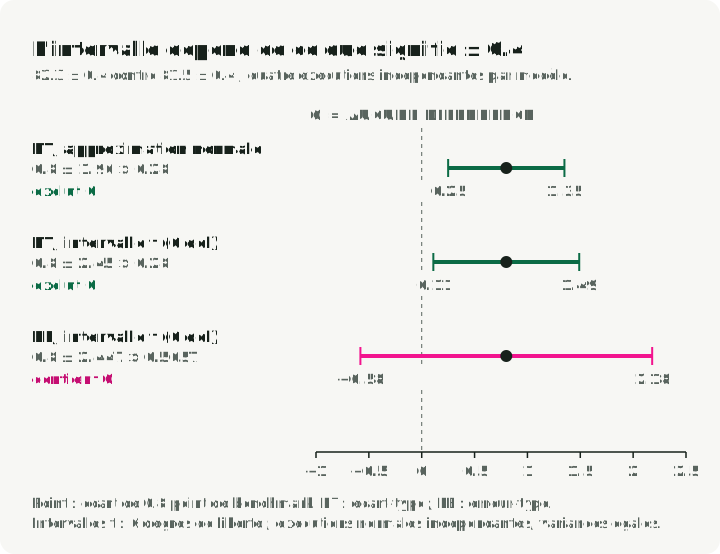
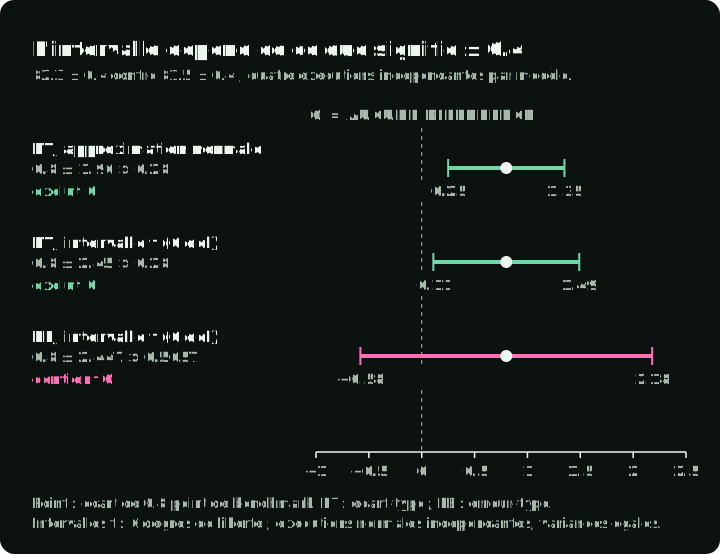
Quand 0.4 est l’écart-type, l’intervalle de Student exclut zéro : sous ces hypothèses, les résultats soutiennent une différence positive. Quand 0.4 est l’erreur-type estimée, l’intervalle contient zéro, donc les résultats n’établissent pas quel modèle a le score moyen le plus élevé.
Entropie croisée et divergence KL
Pendant l’entraînement, un modèle a besoin d’une perte numérique qui mesure à quel point ses probabilités prédites concordent avec la cible d’entraînement. L’algorithme d’entraînement modifie les paramètres du modèle pour réduire cette perte. L’entropie croisée fournit une telle perte pour des exemples étiquetés ou pour les probabilités d’un modèle enseignant. La divergence de Kullback–Leibler (KL) mesure l’écart entre deux distributions. Les articles l’utilisent pour entraîner un étudiant à imiter un enseignant ou pour pénaliser les écarts par rapport à un modèle de référence fixe.
Ici, les résultats sont discrets, comme des tokens ou des classes. Notons la distribution cible et la distribution prédite par le modèle sur les mêmes résultats. Partons d’un résultat observé : quand le modèle lui a donné la probabilité , sa perte est . Elle vaut 0 quand , environ 0.69 quand , environ 2.3 quand , et est infinie quand .
L’entropie croisée fait la moyenne de cette perte sur les résultats tirés de la cible :
Avec une étiquette one-hot , qui vaut 1 sur la classe correcte et 0 ailleurs, seule la classe correcte compte, et : la perte de classification ordinaire. nn.CrossEntropyLoss de PyTorch la calcule à partir des scores bruts du modèle, appelés logits, et applique le log-softmax en interne ; son entrée n’est pas le vecteur de probabilités . Avec la distribution souple d’un modèle enseignant comme , chaque classe compte en proportion de la probabilité de l’enseignant. La distillation classique entraîne ainsi un petit modèle sur les probabilités d’un grand modèle. Pour la cible , deux modèles ont ces entropies croisées :
Le second modèle correspond à la cible, et aucun modèle ne peut faire mieux. Ce minimum, 0.325 ici, est , l’entropie de . Elle ne vaut 0 que pour une cible one-hot : quand la cible elle-même est incertaine, il reste une perte qu’aucun modèle ne peut supprimer.
La divergence KL soustrait ce minimum et ne garde que la perte due à l’écart de par rapport à . Elle s’écrit avec une double barre , qui sépare seulement les deux arguments ; ce n’est ni la barre de probabilité conditionnelle de Probabilité conditionnelle et probabilité d’un texte, ni les barres de longueur de la référence sur les vecteurs. Les articles l’utilisent à la place d’une virgule pour marquer que l’ordre compte : la moyenne porte sur les résultats tirés du premier argument.
Pour le premier modèle ci-dessus, . La KL vaut 0 quand les deux distributions coïncident et est positive sinon.
L’ordre change les écarts qui sont pénalisés. Un terme avec et est infini, donc pénalise un qui attribue une probabilité nulle à tout ce que peut produire. Les résultats avec n’ajoutent rien (par convention ), donc ils n’apportent aucune pénalité directe même si . Inverser les arguments donne , qui est infinie partout où et . Les résultats avec n’ajoutent alors rien, même si . Avec comme cible, s’appelle la KL directe (forward) et la KL inverse (reverse).
Pour et , la KL directe est infinie, parce que manque un résultat que produit, alors que la KL inverse n’est que : le résultat que ignore n’ajoute rien. Pour et , la KL directe est le 0.37 trouvé plus haut, calculé ici terme à terme, et la KL inverse diffère :
Cette asymétrie explique pourquoi la KL s’appelle une divergence et non une distance.
Comme , et qu’un enseignant fixe a une entropie qui ne dépend pas de l’étudiant, l’entropie croisée contre un enseignant fixe donne à l’étudiant les mêmes gradients que . Modifier un paramètre de l’étudiant change les deux pertes de la même quantité, donc leurs dérivées utilisées pour l’entraînement sont égales ; Gradients et optimisation explique ce calcul. Cela permet au code de classification et de distillation classique d’utiliser l’entropie croisée. L’échange ne fonctionne qu’avec l’enseignant en premier. Avec l’étudiant en premier, , et l’entropie propre de l’étudiant change pendant son entraînement, donc les deux ne donnent plus les mêmes gradients.
Vecteurs et matrices
Les équations d’architecture décrivent des calculs sur des tableaux de nombres. La forme (shape) d’un tableau dit comment ses nombres sont organisés, quelles opérations sont valides et ce qu’elles produisent. Un vecteur est une liste ordonnée de nombres. Une matrice range des nombres en lignes et en colonnes. Dans le code de ML, tenseur est le terme général pour ces tableaux numériques, y compris ceux de plus de deux axes. Un axe est une dimension le long de laquelle on indexe le tableau : une matrice a un axe des lignes et un axe des colonnes.
L’état caché d’un token est un vecteur de nombres calculé à l’intérieur du modèle pour représenter ce token. Supposons que nous traitions ensemble un batch de séquences, chacune de positions de tokens, et que chaque état caché contienne nombres. Le tableau des états cachés a la forme [B, T, d], que les articles écrivent aussi . Ses trois axes sélectionnent la séquence, la position du token et le nombre dans le vecteur de ce token. Par exemple, [2, 3, 4] contient deux séquences, trois vecteurs de tokens par séquence et quatre nombres par vecteur : 24 nombres au total. Ici est la largeur du vecteur. La forme liste les trois tailles ; leur produit donne le nombre d’entrées.
Les articles écrivent souvent les formes comme une appartenance à un ensemble : signifie que est un vecteur de nombres réels, et que est une matrice de lignes et colonnes. Les lettres en gras marquent parfois des vecteurs ou des tenseurs, mais c’est la définition de l’article qui détermine la forme.
Dans le tableau ci-dessous, et sont des vecteurs colonnes : leurs nombres sont disposés verticalement. L’exposant désigne la transposée : échanger les lignes et les colonnes. Ainsi est une ligne contenant les mêmes nombres que la colonne . Les et majuscules nomment ici des matrices ; ne désigne plus la taille du batch.
| Expression | Valeurs utilisées | Ce que fait l’opération | Résultat |
|---|---|---|---|
| — produit scalaire | Deux vecteurs colonnes de entrées chacun | Multiplier les entrées correspondantes, puis additionner les produits : | Un nombre |
| — produit extérieur | Une colonne de entrées et une colonne de entrées | Multiplier chaque entrée de par chaque entrée de | Une matrice ; l’entrée est |
| — produit matriciel | à lignes et colonnes ; à lignes et colonnes | Pour l’entrée , multiplier les nombres correspondants de la ligne de et de la colonne de , puis additionner | Une matrice ; le nombre de colonnes de doit égaler le nombre de lignes de |
| — produit terme à terme | Deux tableaux de même forme | Multiplier les entrées aux positions correspondantes, sans les additionner | Un tableau de même forme |
| — concaténation | Des colonnes et de et entrées | Placer les entrées de après celles de | Une colonne de entrées ; vérifiez la convention de l’article pour l’axe de jonction |
Pour une comparaison concrète, prenons et . Déplacer la transposée change à la fois le calcul et le résultat :
Le produit scalaire donne un seul score, comme la comparaison requête–clé dans l’attention. Le produit extérieur garde une valeur distincte pour chaque paire d’entrées ; la mise à jour de Gated DeltaNet l’utilise pour construire une mise à jour matricielle à partir de deux vecteurs.
Un produit matriciel peut être regroupé autrement, , mais pas réordonné ; la dérivation de MLA utilise ce regroupement pour éviter de reconstruire les clés. NumPy écrit la multiplication matricielle @ et le produit terme à terme *. Les articles n’héritent pas des règles de broadcasting de NumPy : ajouter un vecteur à une matrice exige un axe explicite. Les articles diffèrent aussi sur la question de savoir si un vecteur est une ligne ou une colonne : l’attention empile les tokens comme lignes de , tandis que MLA, Gated DeltaNet et LoRA écrivent avec des vecteurs colonnes, et nn.Linear de PyTorch calcule x @ W.T sur des lignes.
Une équation d’architecture peut aussi décrire la taille d’un vecteur, restreindre les matrices permises ou réarranger un produit :
| Notation | Sens |
|---|---|
| La longueur euclidienne ; , sans la racine, apparaît dans la perte de DDPM | |
| La somme des valeurs absolues | |
| La norme spectrale : le plus grand facteur par lequel augmente la longueur d’un vecteur ; mHC la maintient à 1 au plus | |
| Le nombre de colonnes indépendantes ; la mise à jour de LoRA est de rang au plus | |
| Le déterminant : est le facteur par lequel met à l’échelle les volumes, et le signe indique si inverse l’orientation ; l’exemple de changement de variables de l’Annexe B de cet article l’utilise | |
| Chaque entrée est positive ou nulle, comme dans mHC ; est une condition différente, semi-définie positive : pour tout | |
| , | La matrice identité (1 sur sa diagonale, 0 ailleurs, donc ) ; un vecteur de uns |
| Transposer un produit inverse l’ordre ; les sections RoPE et MLA de la Partie 2 l’utilisent |
Gradients et optimisation
L’entraînement utilise des dérivées pour décider comment modifier les paramètres du modèle. Soit une perte scalaire et le vecteur de tous les paramètres ; est une entrée de ce vecteur.
La dérivée partielle est un nombre, évalué aux valeurs actuelles des paramètres. Elle mesure le taux de variation de la perte quand seul change et que les autres paramètres restent fixes. Lisez-la « la dérivée partielle de la perte par rapport au paramètre ».
Le gradient rassemble ces nombres pour tous les paramètres en un seul vecteur. Sa -ième entrée est . Le symbole s’appelle nabla ; ici il signifie « prendre le gradient ». Avec un seul paramètre, le gradient a une entrée égale à la dérivée ordinaire.
Par exemple, prenons . En et :
La première dérivée partielle, 4, signifie qu’augmenter de 0.01 fait monter la perte d’environ 0.04 tandis que reste fixe. Le gradient contient cette information pour les deux paramètres. La descente de gradient soustrait la dérivée de chaque paramètre, multipliée par un taux d’apprentissage positif qui contrôle la taille du pas :
Avec , l’exemple passe de à , et la perte tombe de 7 à 3.04. Pour une perte dérivable de gradient non nul, un pas suffisamment petit fait baisser la perte. Un gradient nul ne donne aucune mise à jour.
L’indice de dit ce qui varie. fait varier les paramètres ; fait varier l’entrée, et les articles sur la diffusion l’appellent le score, qui n’a rien à voir avec le score d’un benchmark.
Une jacobienne enregistre les dérivées de plusieurs sorties. Une couche de réseau de neurones peut produire beaucoup de nombres, comme les composantes de l’état caché d’un token. Pour décrire comment chaque sortie réagit à chaque entrée, on rassemble les dérivées partielles dans une matrice appelée jacobienne. Pour avec nombres en entrée et nombres en sortie, sa forme est : les lignes correspondent aux sorties, les colonnes aux entrées, et l’entrée mesure comment la sortie change quand l’entrée change.
Par exemple, soit une fonction qui prend deux nombres et renvoie et . Sa jacobienne est
La deuxième colonne dit qu’augmenter de 0.1 en gardant fixe augmente de 0.2 et diminue de 0.1. Cet exemple est linéaire, donc sa jacobienne est constante. Pour une fonction non linéaire, les entrées peuvent dépendre de l’entrée courante et décrivent de petits changements locaux. Avec une seule sortie scalaire, la jacobienne a une ligne : les mêmes dérivées que le gradient, transposées avec notre convention de vecteurs colonnes. Deep Learning, §4.3, donne les définitions générales.
La rétropropagation utilise ces dérivées pour calculer le gradient de la perte à travers les couches successives. L’exemple de changement de variables de l’Annexe B de cet article utilise une autre propriété : la valeur absolue du déterminant d’une jacobienne carrée donne le facteur local de mise à l’échelle des volumes, nécessaire pour ajuster une densité de probabilité.
Pour l’entraînement, les dérivées décrivent des changements locaux ; un objectif d’optimisation énonce ce que les mises à jour doivent minimiser ou maximiser. Les articles distinguent la meilleure valeur d’un objectif des paramètres qui l’atteignent : est la plus petite valeur de , tandis que donne les valeurs de paramètres qui l’atteignent. Pour , le minimum est 0 et l’argmin est 3. Un argmin précise le résultat voulu, mais laisse ouvert l’algorithme de mise à jour.
Par exemple, MiniLLM écrit son but (équation 1), où est le modèle étudiant et l’enseignant dont il apprend. Le §2.2 en dérive ensuite un gradient et le modifie pour stabiliser l’entraînement ; l’équation (7) est le gradient utilisé pour les mises à jour. L’exemple de la distillation on-policy explique ces changements. Lire seulement l’argmin les ferait manquer.
Un stop-gradient, , transmet vers l’avant inchangé mais bloque les gradients qui le traversent, comme .detach() dans PyTorch. Deux expressions de même valeur en passe avant peuvent s’entraîner différemment si l’une d’elles est détachée. Dans l’exemple de GRPO, Hugging Face TRL traite la log-probabilité de l’ancien modèle comme fixe. Dans le raccourci de distillation discuté par DeepSeek-V4, un log-rapport enseignant–étudiant détaché fournit un poids fixe pour la mise à jour.
Ensembles et contraintes
Une contrainte énonce quelles valeurs sont permises. Les articles expriment souvent les contraintes avec des ensembles : des collections de membres distincts, écrites entre accolades, comme . L’ordre n’a pas d’importance, donc nomme le même ensemble. Les entrées répétées ne comptent qu’une fois. En revanche, les parenthèses d’un vecteur comme décrivent une liste ordonnée : est un autre vecteur.
Une fois qu’un article a défini un ensemble, il peut tester l’appartenance, combiner des ensembles, compter leurs membres ou énoncer une condition à leur sujet. Prenons et :
| Notation | Sens | Exemple et façon de le lire |
|---|---|---|
| Appartenance : appartient à | : 2 est un membre de | |
| Union : inclure chaque membre de l’un ou l’autre ensemble | ; n’inclure 3 qu’une fois | |
| Intersection : ne garder que les membres communs aux deux ensembles | ||
| Le nombre de membres distincts | ||
| « Pour tout » : une condition doit valoir pour tous les membres nommés | : chaque membre de est positif | |
| « Il existe » : au moins un membre doit satisfaire la condition | : a un membre supérieur à 2, à savoir 3 |
La notation de forme de Vecteurs et matrices nomme aussi des ensembles : est l’ensemble de tous les vecteurs de nombres réels, et l’ensemble de toutes les matrices réelles à lignes et colonnes. Ainsi précise quelle forme doit avoir.
La notation par compréhension décrit un ensemble par une condition : se lit « les membres de qui satisfont la condition », comme la compréhension d’ensemble Python {x for x in S if condition(x)}. La barre signifie « tel que », pas la probabilité conditionnelle ; certains articles utilisent deux-points à la place. Les exemples de cette série incluent les matrices permises de mHC, les experts sélectionnés de MoE et les tokens sélectionnés de l’attention parcimonieuse.
DAPO, une méthode d’entraînement qui filtre des groupes de réponses générées, ne garde une question que lorsque certaines réponses sont correctes et d’autres fausses. Pour réponses échantillonnées et une réponse de référence , écrivons l’ensemble des indices des réponses correctes
Le filtre est . Utiliser des indices rend le décompte explicite : deux échantillons de texte identique comptent toujours pour deux réponses. L’article de DAPO écrit plutôt l’ensemble sur les réponses ; lu littéralement comme un ensemble de textes, cette forme compte une seule fois deux réponses identiques.
Exercices
- Formes. est , est et est . Quelles sont les formes des scores et de la sortie ? Sur quel axe le softmax porte-t-il ?
- Softmax. Calculez le softmax de . Ajouter 100 aux deux entrées change-t-il le résultat ?
- Moyennes. Une réponse a un seul token de perte 4 ; une autre a trois tokens de perte 0. Calculez la moyenne par token et la moyenne par réponse.
- Conditionnement. Sur 200 réponses, 120 sont correctes, 80 passent la validation de format et 60 font les deux. Trouvez et .
- KL. Pour un enseignant et un étudiant , calculez les deux sens de la KL.
- Ensembles. DAPO ne garde une question que si , où contient les indices des réponses correctes parmi échantillons. Avec , garde-t-il une question dont les réponses obtiennent ? Une dont les réponses obtiennent ? La première réponse change-t-elle si les quatre échantillons contiennent un texte correct identique ?
Réponses :
-
Les scores sont et la sortie est . Le softmax porte sur les six clés de la ligne de chaque requête.
-
. Ajouter le même nombre à chaque entrée laisse le softmax inchangé, mais calculer directement déborde en flottants 32 bits.
-
Les deux moyennes :
-
et .
-
, et , parce que l’étudiant met de la probabilité sur un résultat que l’enseignant exclut.
-
Non : a quatre membres, ce qui égale . Oui : a trois membres, entre 0 et 4. Un texte identique ne change pas la première réponse : ce sont quatre échantillons distincts, donc leurs quatre indices comptent toujours.
Annexe A. Lettres grecques
Les rôles indiqués sont des exemples courants ; chaque article définit toujours ce que signifient ses symboles.
| Lettre | Nom | Rôles courants dans les articles de ML |
|---|---|---|
| alpha | Un poids de mélange ou un facteur d’échelle ; une décroissance (Gated DeltaNet) ; un calendrier de bruit (DDPM) | |
| bêta | Une force de pénalité (DPO, GRPO) ; une force d’écriture (Gated DeltaNet) ; un calendrier de bruit (DDPM) | |
| gamma | Un facteur d’actualisation en RL ; un pas (la mise à jour du biais dans DeepSeek-V3) | |
| delta | Une différence ou un changement | |
| epsilon | Du bruit (DDPM) ; une plage de clipping (GRPO) ; un petit terme de stabilisation | |
| êta | Le taux d’apprentissage | |
| thêta | Les paramètres du modèle ; les angles de rotation de RoPE | |
| lambda | Un poids de régularisation ; une valeur propre | |
| mu | Une moyenne ; le nombre de pas de gradient par batch dans l’Algorithm 1 de DeepSeekMath | |
| pi | Une politique ; est l’opérateur produit | |
| rhô | Un rapport de probabilités, comme dans la section GRPO de la Partie 3 ; une corrélation | |
| sigma | La sigmoïde (DPO) ; un écart-type ; une covariance ; est l’opérateur somme | |
| tau | Une température ; un seuil ; une trajectoire en RL | |
| phi | Les paramètres d’un second réseau, comme un encodeur ; des features ; un angle | |
| psi | Les paramètres d’un autre réseau, comme le modèle de valeur dans la PPO de DeepSeekMath | |
| oméga | Une fréquence ; est aussi une borne inférieure en complexité, ou un ensemble de résultats |
Les variantes comme et sont généralement la même lettre dans une autre police, mais un article peut utiliser les deux pour des variables différentes.
Annexe B. Autres familles d’équations
Des formes d’équations que cette série ne détaille pas, avec les définitions dont chacune a besoin :
Modèles d’espace d’états sélectifs. Un modèle d’espace d’états traite une séquence en mettant à jour un état stocké à chaque pas. Une mise à jour de la forme , combine l’état précédent avec l’entrée courante, puis calcule une sortie. Ici est l’entrée courante, l’état stocké et la sortie. Les matrices , et transforment respectivement l’état précédent, ajoutent la contribution de l’entrée et produisent la sortie. Les barres marquent des paramètres convertis d’un modèle en temps continu vers des pas discrets ; elles ne signifient pas des moyennes. Dans Mamba, les paramètres de la mise à jour dépendent de l’entrée courante, ce que veut dire « sélectif ».
Équations différentielles stochastiques. décrit comment un état change avec le temps : est son taux de variation. Une équation différentielle stochastique (EDS, ou SDE en anglais) ajoute des changements aléatoires, . Ici décrit le changement déterministe, fixe l’échelle du bruit, et est un incrément de mouvement brownien. Pour l’approcher dans le code, la méthode d’Euler–Maruyama utilise un petit pas de temps et remplace par un bruit gaussien de variance . La section 5.1 de The Little Book of Generative AI Foundations de Tianhua Chen donne une telle mise à jour ; le §6.4 du même livre utilise les EDS pour décrire les modèles de diffusion.
Changement de variables. Transformer une variable aléatoire change sa densité selon la façon dont la transformation modifie le volume local. Supposons que relie des espaces de même dimension, et que et son inverse soient dérivables. Les densités avant et après la transformation, et , satisfont . L’inverse retrouve à partir de . Sa jacobienne est la matrice carrée des dérivées premières ; la valeur absolue de son déterminant corrige le changement local de volume. Par exemple, si en une dimension, la densité devient : doubler la largeur divise la densité par deux. Les normalizing flows utilisent de telles transformations inversibles pour modéliser des densités ; le §7.1 du livre de Tianhua Chen explique la méthode.
Objectifs min–max. Dans les generative adversarial networks (GAN), un générateur produit des exemples et un discriminateur essaie de les distinguer des données réelles. L’objectif mesure le succès du discriminateur : le maximise tandis que le minimise. Le but (équation 1) dit : pour chaque générateur possible, considérer le meilleur discriminateur contre lui, puis choisir le générateur qui donne l’objectif résultant le plus petit. L’entraînement ne résout pas exactement cette maximisation interne. L’Algorithm 1 de l’article alterne pas de montée de gradient sur avec un pas de descente de gradient sur ; ses expériences utilisaient .
Le simplexe de probabilités. Un vecteur de probabilités a des entrées positives ou nulles dont la somme vaut 1. L’ensemble de tous ces vecteurs à entrées s’appelle le simplexe de probabilités, noté . Chaque sortie de softmax y appartient. Ici nomme un ensemble, et l’exposant est sa dimension, pas une puissance : une fois probabilités choisies, la dernière est imposée par la somme, qui doit valoir 1. Avec deux choix, chaque distribution a la forme pour , donc un seul nombre est libre.
Normalisation. La normalisation remet des valeurs à l’échelle avec la moyenne et la dispersion d’un groupe choisi. Une forme courante est , où est une moyenne, une variance, et un petit nombre positif qui évite la division par zéro. L’équation seule ne dit pas quelles entrées servent à calculer la moyenne et la variance. Pour un batch de vecteurs de features, la batch normalization les calcule séparément pour chaque feature sur l’ensemble des exemples. La layer normalization d’un Transformer les calcule séparément pour chaque token sur l’ensemble de ses features. Vérifiez les axes précisés quand vous comparez des implémentations.
Sources et versions
Les numéros de section et d’équation renvoient aux versions liées ici.
- Tianhua Chen. The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer. 2026. Version 2 ; le §2.4 et le §3.2 couvrent l’inégalité de Jensen et l’ELBO, le §5.1 et le §6.4 le bruit en temps continu.
- Vaswani et al. Attention Is All You Need. 2017. Version 7, §3.2.1, équation (1), et note de bas de page 4.
- Dai et al. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. 2024. Segmentation fine des experts et décompte des combinaisons, §3.1 ; ablation, §4.4 et Figure 3.
- Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024. Version 3, §1.1, §4.1.1, équations (1)–(4), et Algorithm 1.
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. 2024. Version 5, §2.1.1–2.1.3, équations (9)–(19), et Annexe C.
- DeepSeek-AI. DeepSeek-V3 Technical Report. 2024–2025. Version 2, §2.1.2, équations (12)–(18).
- DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025. Version 1 : §2.2.1, équations (1)–(3). Version 2, 2026 : §2.1 et Supplementary A.3.
- DeepSeek-AI. DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence. 2026. Version 1 : §2.2, équations (1)–(8) ; §5.1.2, équation (29).
- Rafailov et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. 2023–2024. Version 3, §4, équation (7).
- Gu et al. MiniLLM: Knowledge Distillation of Large Language Models. 2023–2024. Version 4, §2.1, équation (1), et §2.2, équations (2) et (7).
- Yu et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. 2025. Version 2, §3.2–3.3, équations (11)–(12).
- Gu et Dao. Mamba: Linear-Time Sequence Modeling with Selective State Spaces. 2023–2024.
- Yang et al. Gated Delta Networks: Improving Mamba2 with Delta Rule. 2024–2025. Version 3, §3.1, équation (10), et §3.3–3.4.
- Ho, Jain et Abbeel. Denoising Diffusion Probabilistic Models. 2020. Version 2, §2, équations (4)–(5) ; §3.2, équation (12) ; §3.4, équation (14) ; et Algorithms 1–2.
- Goodfellow et al. Generative Adversarial Nets. 2014. Équation (1) et Algorithm 1.
- Chen et al. Evaluating Large Language Models Trained on Code. 2021. Version 2, §2.1, équation (1), et Figure 3.
- Hugging Face TRL.
GRPOTraineretGRPOConfigau commitc6eac19, octobre 2026. - Stanford CS229. Probability Theory Review et Linear Algebra Review and Reference.
- Dive into Deep Learning. Preliminaries.
- Britz, Goldie, Luong et Le. Massive Exploration of Neural Machine Translation Architectures. 2017. Version 2, Table 5 ; cité par Attention Is All You Need pour la comparaison entre attention par produit scalaire et attention additive.