Cómo leer las matemáticas de los artículos de AI en arXiv: una guía práctica
Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Saber leer las matemáticas de un artículo de AI es una habilidad útil para quien necesita entender un modelo, reproducir un método o valorar un resultado experimental. Esta guía explica cómo descifrar la notación, comprobar una ecuación con números pequeños y conectarla con el resto del artículo y con la implementación. Da por hecho que sabes leer código, pero no que la notación de investigación te resulte familiar.
Una ecuación condensa varias decisiones en una sola línea: los objetos que se manipulan, sus dimensiones, qué valores se muestrean y qué se aprende o se mantiene fijo. Recuperar esos detalles es un buen primer paso. Explicar por qué funciona un método e implementarlo con fidelidad exige más trabajo.
Empieza por el recorrido de la atención: conecta una ecuación con formas de arrays, números pequeños y Python ejecutable. La referencia de notación explica las expresiones que encontrarás en otros artículos. El resto de la serie aplica el mismo método a ecuaciones de artículos concretos: ecuaciones de arquitectura como RoPE, MLA y LoRA; objetivos de entrenamiento como DPO y GRPO; y modelos generativos y métricas como el ELBO, la difusión y pass@k. Esas partes aún no han salido, así que los recorridos a los que se refiere esta parte no están enlazados. Para un tratamiento más extenso de los fundamentos, The Little Book of Generative AI Foundations, de Tianhua Chen, desarrolla el álgebra lineal y la probabilidad que hay detrás de los modelos generativos.
Atención: leer un símbolo cada vez
La atención produce un vector de salida como media ponderada de vectores valor. Obtiene los pesos comparando un vector consulta de la posición de salida con un vector clave de cada posición de entrada disponible. Las matrices , y reúnen esos vectores de consulta, clave y valor. La atención de producto escalar escalado combina estos pasos en la ecuación (1) de §3.2.1 (§ significa «sección») de Attention Is All You Need:
Las definiciones están en el texto, no en la ecuación. El párrafo anterior a la ecuación (1) dice que las consultas y las claves tienen dimensión y que los valores tienen dimensión . El método calcula el producto escalar de cada consulta con todas las claves, divide cada resultado entre y aplica una softmax «para obtener los pesos de los valores». Las consultas se «agrupan en una matriz », y las claves y los valores en y . Así, cada fila de estas matrices es el vector de un token, y la softmax produce un conjunto de pesos por consulta. Las matrices aprendidas que convierten los vectores de los tokens en , y aparecen más adelante, en §3.2.2.
Formas y funciones. Una cabeza de atención realiza uno de estos cálculos con sus propios vectores de consulta, clave y valor. Anota sus formas antes de leer los operadores. Para una cabeza con consultas y claves:
| Símbolo | Forma | Qué es | De dónde sale |
|---|---|---|---|
| una fila de consulta por cada posición de salida | vectores de tokens por una matriz aprendida | ||
| una fila de clave por cada posición a la que se puede atender | vectores de tokens por una matriz aprendida | ||
| una fila de valor por cada clave | vectores de tokens por una matriz aprendida | ||
| transpuesta: las filas pasan a ser columnas | los mismos números que | ||
| un número | el ancho de cada consulta y cada clave | un ajuste fijo: 64 en el Transformer base |
Los artículos indican una forma nombrando el conjunto al que pertenece la matriz: significa una matriz de números reales con filas y columnas, es decir, un array de forma [n, dk].
Lee de dentro hacia fuera.
-
multiplica una matriz por una matriz . El compartido se suma y desaparece, así que el resultado es una tabla de puntuaciones de . La entrada es el producto escalar de la consulta y la clave : se multiplican las entradas correspondientes y después se suman los productos. Para longitudes de vector fijas, esta puntuación es mayor cuanto más se parecen sus direcciones.
-
Dividir entre evita que las puntuaciones crezcan con el ancho del vector. La nota al pie 4 del artículo muestra por qué crecen los productos escalares sin escalar. Supón que los componentes de una consulta y de una clave son independientes entre sí (saber algunos no dice nada sobre los demás), cada uno con media 0 y varianza 1 (la distancia media al cuadrado respecto de la media). Entonces:
Las líneas usan dos reglas sobre números independientes. Primera: el producto de dos números independientes, cada uno con media 0 y varianza 1, tiene también varianza 1. Segunda: cuando se suman números independientes, sus varianzas se suman, de modo que los productos dan varianza . La desviación típica es la raíz cuadrada de la varianza, . Dividir cada puntuación entre reduce la dispersión en el mismo factor, hasta volver a 1.
Por qué se cumplen las dos reglas
Varianza cuando la media es 0. La varianza es la distancia media al cuadrado respecto de la media. Cuando la media es 0, esa distancia al cuadrado es simplemente el cuadrado del número, así que la varianza es la media del cuadrado. Un componente con media 0 y varianza 1 tiene, por tanto, un cuya media es 1.
La media de un producto. Para números independientes, la media de un producto es el producto de las medias. Toma un número que vale 1 o 3 con la misma probabilidad, de modo que su media es 2, y un número que vale 1 o 5, también con la misma probabilidad, de modo que su media es 3. Independiente significa que toma cada uno de sus valores con la misma frecuencia sea cual sea el resultado de , así que los cuatro pares son igual de probables. Cuando , los productos son 1 y 5, que tienen media . Cuando , son 3 y 15, con media . En ambos casos la media es , así que sobre los dos valores de es , que es . Sin independencia la regla falla: si valiera 5 siempre que vale 3, y 1 siempre que vale 1, solo aparecerían los productos 1 y 15, cuya media es 8. Wikipedia enuncia la regla para cualesquiera variables aleatorias independientes, con «valor esperado» para la media: independencia y esperanza.
Regla 1: un producto tiene varianza 1. Toma un producto . Su media es el producto de las medias, , así que su varianza es la media de . Los cuadrados son independientes porque lo son y , y cada uno tiene media 1, así que la varianza es . La fórmula general es la varianza de un producto de variables independientes.
Regla 2: las varianzas de términos independientes se suman. Llama a los productos , de modo que el producto escalar es la suma . Los términos son independientes porque cada uno usa componentes distintos, y cada uno tiene media 0 y varianza 1. La suma también tiene media 0, así que su varianza es la media de su cuadrado. Al multiplicar la suma por sí misma sale un producto por cada pareja de términos, una cuadrícula de :
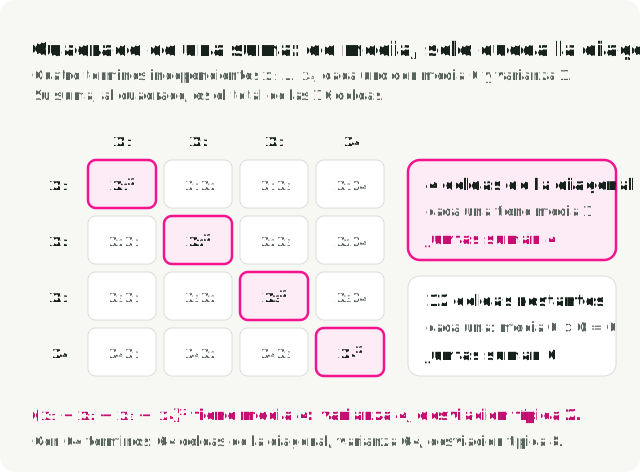
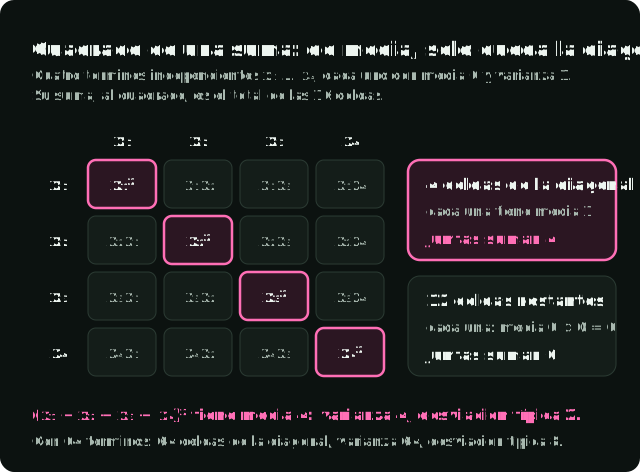
Las celdas de la diagonal son los cuadrados , y cada una tiene media 1. Cualquier otra celda multiplica dos términos distintos e independientes, así que su media es el producto de sus medias, : sus valores positivos y negativos se cancelan. Solo quedan las celdas de la diagonal, así que la varianza de la suma es y su desviación típica es . La dispersión crece con la raíz cuadrada del ancho porque la mayor parte de la cuadrícula se cancela. Wikipedia da el enunciado general como la varianza de una suma de variables incorrelacionadas; las variables independientes siempre son incorrelacionadas, así que la regla las cubre.
Con , las puntuaciones sin escalar se dispersan típicamente en torno a ; escaladas, en torno a , sea cual sea el ancho.
Las puntuaciones muy dispersas saturan la softmax (paso 3) y sus gradientes se anulan. Si una puntuación de una fila está muy por encima de las demás, la softmax da a esa clave un peso cercano a 1 y a todas las demás un peso cercano a 0. Un pequeño cambio en cualquier puntuación apenas mueve entonces los pesos, de modo que el gradiente que llega a las consultas y las claves es casi cero y el entrenamiento casi no tiene con qué ajustarlas. El artículo lo ofrece como explicación probable de un resultado anterior: sin el escalado, la atención de producto escalar rendía peor que la atención aditiva, una forma más antigua que puntúa una consulta y una clave con una red pequeña, cuando es grande (Britz et al., 2017). El artículo no mide los gradientes por sí mismo.
-
La softmax convierte cada fila de puntuaciones en pesos. Sea una fila de las puntuaciones escaladas. La exponencial , que también se escribe , usa la constante . Entonces , donde es solo un segundo nombre de índice, de modo que la suma recorre todas las claves de la fila. Los pesos son positivos y cada fila suma 1.
-
Multiplicar los pesos de por los valores de suma el eje de las claves y lo elimina. La fila de la salida es una media ponderada de las filas de valores, ponderada por lo bien que cada clave coincidió con la consulta .
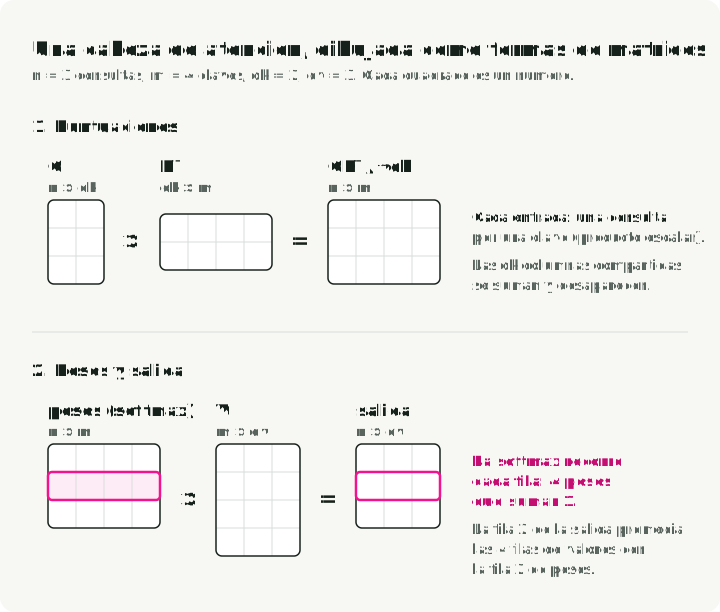
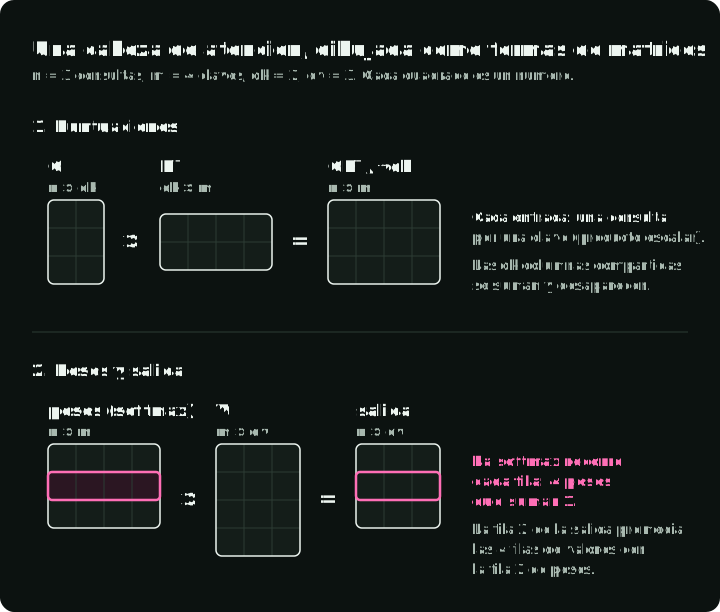
Cuenta los cuadrados de la figura: cada producto elimina el eje que comparten sus dos cuadrículas.
Compruébalo con dos números. Toma una consulta y dos claves cuyas puntuaciones escaladas son , elegidas para que las exponenciales sean 1 y 3, y valores y . La figura lo resuelve con una operación por columna:
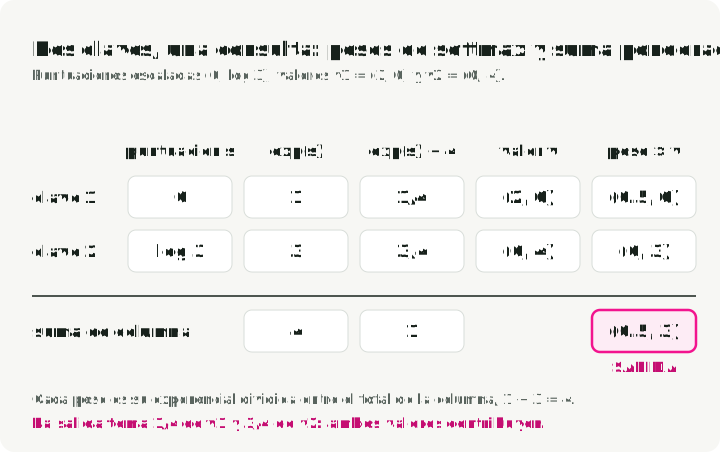
La atención mezcló ambos valores; no eligió el token que mejor coincidía.
Compárala con el código. La función de NumPy siguiente implementa una cabeza. k.T es la transpuesta. axis=1 es el eje de las claves, así que la fila de cada consulta se normaliza por separado. El máximo de la fila se resta antes de np.exp: sumar el mismo número a todas las puntuaciones de una fila se cancela en el cociente de la softmax, de modo que el resultado no cambia, pero las puntuaciones grandes dejan de desbordar. La máscara opcional pone las puntuaciones bloqueadas a , lo que hace que sus pesos sean exactamente cero. Un decodificador usa una máscara así para impedir que cada token atienda a los posteriores (§3.2.3 del artículo).
Guarda el bloque como attention_example.py y ejecuta uv run --with numpy python attention_example.py. Las comprobaciones pasan en silencio.
import numpy as np

def attention(q, k, v, allowed=None):
    """One head. q: [n, dk], k: [m, dk], v: [m, dv], allowed: bool [n, m]."""
    scores = q @ k.T / np.sqrt(q.shape[1])  # [n, m]
    if allowed is not None:
        if not allowed.any(axis=1).all():
            raise ValueError("every query needs at least one allowed key")
        scores = np.where(allowed, scores, -np.inf)
    scores = scores - scores.max(axis=1, keepdims=True)
    weights = np.exp(scores)
    weights = weights / weights.sum(axis=1, keepdims=True)  # rows sum to 1
    return weights @ v, weights  # [n, dv], [n, m]

# The two-key example from the text.
out, w = attention(
    np.array([[1.0]]),
    np.array([[0.0], [np.log(3.0)]]),
    np.array([[2.0, 0.0], [0.0, 4.0]]),
)
np.testing.assert_allclose(w, [[0.25, 0.75]])
np.testing.assert_allclose(out, [[0.5, 3.0]])

# A causal mask: query i may attend only to keys 0..i.
x = np.random.default_rng(0).normal(size=(3, 4))
out, w = attention(x, x, x, allowed=np.tril(np.ones((3, 3), dtype=bool)))
assert out.shape == (3, 4)
np.testing.assert_allclose(w.sum(axis=1), 1.0)
assert np.all(w[np.triu_indices(3, k=1)] == 0)
Una consulta cuyas claves están todas bloqueadas es un caso que la ecuación deja abierto: todos los pesos de su fila serían . La función lanza un error en lugar de devolver NaN.
De una cabeza a varias. El Transformer base ejecuta ocho cabezas en paralelo, cada una con sus propias matrices aprendidas para producir , y , y cada una con . Concatena sus salidas y multiplica el resultado por otra matriz aprendida, (Attention Is All You Need, §3.2.2).
Una implementación también puede procesar un lote (batch): varias secuencias de entrada a la vez. Por ejemplo, la atención de producto escalar escalado de PyTorch acepta un tensor de consultas Q con forma [batch, heads, n, d_k]. Las dos primeras dimensiones seleccionan una secuencia y una cabeza; Q[b, h] es la matriz [n, d_k] de ese par. La fórmula de la atención se aplica por separado a cada par. La función de NumPy de aquí maneja solo uno de esos pares: sus operaciones .T y axis=1 suponen entradas bidimensionales.
Seis preguntas para cualquier ecuación
| Pregunta | Respuesta para la atención |
|---|---|
| ¿Qué devuelve la ecuación y con qué forma? | Una matriz : una fila de salida por consulta |
| ¿Cada símbolo es un dato, un peso entrenado, un modelo congelado, un ajuste o una muestra? | , y se calculan a partir de los tokens con matrices aprendidas; es un ajuste fijo; no se muestrea nada |
| ¿Sobre qué índice o eje actúa cada operación? | La softmax recorre las claves de la fila de cada consulta; el producto de los pesos por suma sobre las claves |
| ¿Dónde están las definiciones? | El párrafo anterior a la ecuación (1), la nota al pie 4 y §3.2.2 para las proyecciones aprendidas |
| ¿Qué da una comprobación con dos o tres números? | Pesos y salida |
| ¿Qué tuvo que decidir el código que la ecuación deja abierto? | Restar el máximo de la fila, el valor que se usa para las puntuaciones enmascaradas, una fila sin ninguna clave permitida |
Qué tipo de afirmación hace una ecuación
La atención es un cálculo: dice cómo obtener una salida a partir de unas entradas. Los artículos también escriben ecuaciones que cumplen otras funciones:
| Tipo | Ejemplo en esta serie | Qué comprobar |
|---|---|---|
| Cálculo | La salida de la atención; el vector comprimido de MLA | La forma de cada resultado intermedio |
| Definición | La puntuación de GRPO relativa a otras respuestas | Qué representa el nombre nuevo, para poder sustituirlo en la ecuación |
| Objetivo: una pérdida que minimizar o una puntuación que maximizar | La pérdida de DPO | Si se minimiza o se maximiza, y qué datos promedia |
| Regla de actualización | El descenso de gradiente; la memoria de Gated DeltaNet | Qué cambia en cada paso y qué permanece fijo |
| Restricción, o conjunto de valores permitidos | Las matrices de mezcla permitidas de mHC | Cómo produce el artículo un valor que la cumpla |
| Cota: un límite superior o inferior de una cantidad | La cota inferior de la evidencia (ELBO) | La diferencia entre los dos lados y cuándo es cero |
| Estimador o métrica | pass@k | Qué se cuenta y a partir de cuántas muestras |
| Ajuste empírico | La ley de escalado de DeepSeek LLM | El rango de datos sobre el que se ajustó la curva |
Una restricción enuncia una propiedad que debe tener el resultado. Para los pesos de la atención, esa propiedad es: todo peso es no negativo y cada fila suma 1. La softmax es un cálculo que produce pesos con esa propiedad. El requisito por sí solo no te dice que uses softmax.
afirma que dos expresiones son iguales. significa «se define como»: da nombre a una expresión. Una definición puede nombrar una métrica, una pérdida o un conjunto de valores permitidos, así que ver no te dice qué tipo de ecuación de la tabla anterior estás leyendo.
Por ejemplo, Evaluating Large Language Models Trained on Code, el artículo que presentó el modelo de generación de código Codex, usa para definir su estimador de pass@k (ecuación 1). Esta métrica mide la probabilidad de que al menos uno de programas generados supere las pruebas. En el informe técnico de DeepSeek-V4, la ecuación (2) combina dos afirmaciones: define un conjunto de matrices permitidas, y exige que la matriz de mezcla del modelo pertenezca a ese conjunto. La definición usa ; la restricción usa , que significa «pertenece a». Las secciones de pass@k y mHC trabajan esos ejemplos.
Cómo encontrar la ecuación nueva, sus definiciones y su código
La sección de métodos de un artículo describe cómo funciona su modelo o su algoritmo de entrenamiento. El encabezado puede ser «Method», «Architecture» o algo más específico. Los autores suelen explicar primero un método existente y después mostrar qué han cambiado. Para identificar la contribución que se reivindica, empieza por el resumen de novedades de la introducción. Por ejemplo, DeepSeekMath, §1.1 presenta Group Relative Policy Optimization (GRPO), su método para entrenar modelos a partir de respuestas puntuadas. Los números de sección y de ecuación de aquí se refieren al artículo enlazado.
Después compara el método propuesto con el método anterior que modifica. Dos artículos lo ilustran:
- Un cambio de arquitectura. DeepSeek-V2 describe la atención multicabezal estándar en §2.1.1 e introduce la atención latente multicabezal (MLA) en §2.1.2. La atención estándar guarda las claves y los valores de todos los tokens anteriores. MLA guarda un vector comprimido a partir del cual se pueden reconstruir. Comparar esas ecuaciones revela qué guarda el modelo de forma distinta; el recorrido de MLA deriva el ahorro de memoria.
- Un cambio de entrenamiento. DeepSeekMath, §4.1.1 imprime el objetivo de Proximal Policy Optimization (PPO) como ecuación (1) y el de GRPO como ecuación (3). Ambos usan una ventaja (advantage): un número que indica si una respuesta fue mejor o peor de lo esperado. PPO la estima con una segunda red aprendida, el modelo de valor, que predice la recompensa que falta por obtener a partir de una respuesta parcial. GRPO, en cambio, compara la recompensa de la respuesta con las recompensas de otras respuestas a la misma pregunta. El recorrido de GRPO compara estos términos con la notación de respuesta completa de DeepSeek-R1.
Busca las definiciones alrededor de la ecuación. Revisa el párrafo anterior, cualquier frase «donde …» posterior, las notas al pie y los apéndices. En Attention Is All You Need, el párrafo anterior a la ecuación (1) define las dimensiones y la nota al pie 4 explica el factor de escala. DeepSeek-V3 define la mayoría de sus símbolos de enrutamiento justo después de la ecuación (15), y el sesgo justo antes de la ecuación (16). DeepSeek-V2 desarrolla MLA a lo largo de las ecuaciones (9)–(19) y después reúne el cálculo en el Apéndice C.
Revisa el algoritmo y el código. Una caja de algoritmo es un listado numerado de pseudocódigo que da el orden de las operaciones. El Algoritmo 1 de DeepSeekMath muestra cuándo generar respuestas y cuándo actualizar el modelo. El Algoritmo 1 de Denoising Diffusion Probabilistic Models (DDPM) especifica cómo muestrear la imagen de entrenamiento, el nivel de ruido y el ruido. Las implementaciones resuelven más detalles: por defecto, np.std divide la suma de las desviaciones al cuadrado entre , mientras que torch.std divide entre . El ejemplo de GRPO muestra cómo esa elección cambia los valores de la ventaja calculados a partir de las mismas recompensas.
Las versiones de arXiv pueden cambiar secciones de lugar y repetir ecuaciones con números nuevos, así que cita la versión. En DeepSeek-R1 v1, el objetivo de GRPO está en §2.2.1, ecuaciones (1)–(3). En la v2, publicada en enero de 2026, está en §2.1, y las mismas ecuaciones reaparecen como (11)–(13) en el Suplemento A.3. Un enlace sin versión abre la más reciente, así que todos los enlaces a arXiv de esta serie incluyen la versión con la que se comprobaron.
Cómo comprobar tu lectura con un LLM
Un modelo de chat puede redactar la tabla de símbolos, el índice de cada suma y una comprobación con números pequeños, si le das las definiciones y le pides que señale lo que falta. El texto copiado de un PDF aplana subíndices, superíndices y fracciones en una sola línea; los enlaces «HTML (experimental)» y «TeX Source» de la página de resumen de arXiv dan texto limpio para pegar. Pega la ecuación y los párrafos que la rodean con un prompt como este:
Below is equation (N) from <paper title, arXiv ID and version>, followed by
the paragraphs that define its symbols.

1. Make a table with one row per symbol: shape or type, meaning, and whether
   it is input data, a trained weight, a frozen model, a fixed setting or a
   random sample. Quote the sentence that defines it.
2. List every symbol the pasted text does not define. Do not guess them.
3. For every sum, mean, softmax, min or expectation, name the index or the
   distribution it runs over.
4. Work through the equation with the smallest numbers that use every term.
5. Say which kind of statement it is: a computation, definition, objective,
   update rule, constraint, bound, estimator or empirical fit.
Sin el paso 2, nada impide que el modelo rellene una definición ausente con el significado habitual de la letra, como leer en DPO como una desviación típica en lugar de como la sigmoide. Las citas del paso 1 hacen que la tabla sea comprobable: busca cada una en el PDF y trata una fila cuya cita no encuentres como una conjetura.
El mismo procedimiento como skills de agente. paper-math-skills empaqueta esta sección y la referencia de notación de más abajo como dos skills escritas para Claude Code; otros agentes que cargan archivos SKILL.md también pueden usarlas. read-paper-math obtiene la versión fijada de arXiv, cita la frase que define cada símbolo, lee la ecuación de dentro hacia fuera y ejecuta una comprobación con números pequeños. check-paper-math revisa una lectura así contra el artículo: busca cada cita, repite los números y señala las afirmaciones más fuertes o más débiles que las del artículo. paper-math-readings contiene las lecturas de las skills para las Partes 2–4, una para cada una de las 15 secciones con una línea Source:.
Referencia de notación
Si una letra griega no te resulta familiar, abre la referencia de letras griegas de este artículo (Apéndice A) para ver su nombre y sus significados habituales. Para practicar más con las matemáticas, Stanford CS229 ofrece repasos de probabilidad y de álgebra lineal con ejercicios; los preliminares de Dive into Deep Learning explican los fundamentos con código.
Subíndices, marcas y signos de relación
Las letras son nombres de variables locales: cada artículo define las suyas. Los subíndices suelen ser índices. puede ser la coordenada de un vector o el ejemplo de un dataset, y es el vector del modelo para el token , llamado su estado oculto (hidden state).
Los superíndices en los artículos de modelos suelen ser etiquetas. En , el superíndice entre paréntesis suele ser un número de capa, no una potencia; en y de DeepSeek-V3 marca los expertos compartidos y los enrutados, es decir, los que usan todos los tokens y los que elige un enrutador (véase el ejemplo de enrutamiento de MoE). En DeepSeek-V2, y llevan etiquetas, no exponentes; el ejemplo de MLA define esas etiquetas. es una transpuesta y es un cuadrado.
significa las posiciones de 1 a , incluida , a diferencia de un slice de Python; los artículos suelen contar desde 1. significa todas las posiciones anteriores a . selecciona la fila , como en el slicing de NumPy.
Las marcas sobre una letra suelen cambiar su significado de una de estas maneras:
| Marca | Lectura habitual | Ejemplo o excepción |
|---|---|---|
| Una predicción o una estimación | Ejemplo: en DeepSeekMath estima cuánto mejor puntuó una respuesta de lo esperado | |
| Una media | Excepción: en DDPM, multiplica los factores del calendario de ruido desde el paso 1 hasta el | |
| Una versión perturbada o sin restringir | Ejemplo: en DeepSeek-V4, es una matriz antes de que la normalización imponga sus restricciones | |
| El óptimo | Excepción: en DPO, es la recompensa verdadera, que el método nunca observa | |
| Un valor nuevo o intermedio | Ejemplo: en DeepSeek-V3, es el peso de un experto antes de normalizar | |
| La matriz inversa | No es el recíproco de cada entrada: deshace , (la matriz identidad), y en general |
Algunos símbolos que no son letras griegas también tienen varios usos:
| Símbolo | Significados |
|---|---|
| Condicionamiento en ; «tal que» dentro de un conjunto | |
| Un valor absoluto; la longitud de una secuencia, como en , el número de tokens de la respuesta de GRPO; el tamaño de un conjunto | |
| «Se muestrea de» en ; «aproximadamente» en texto informal | |
| Una longitud de secuencia; una temperatura de softmax; el número de pasos de difusión | |
| Un vector de consulta (atención); una pregunta (GRPO); el modelo estudiante (destilación); el codificador (ELBO) |
Cinco signos indican cómo se relacionan dos lados. , a veces , define un nombre nuevo. marca una aproximación, como el promedio muestreado de Esperanzas y de dónde salen las muestras. significa «proporcional a», con una constante de normalización omitida: se convierte en una distribución solo después de dividir entre . significa «mucho menor que», como en de DeepSeek-V2: el ancho comprimido es mucho menor que el ancho total de todas las cabezas. es una asignación, como en una regla de actualización.
Sumas, recuentos, intervalos y logaritmos
La grande suma términos y los multiplica. El índice bajo cada operador empieza aquí en 1 y llega hasta el límite superior :
El índice pertenece al operador, igual que una variable de bucle pertenece a su bucle. En , la suma recorre , mientras que identifica una entrada de la salida. El resultado es un vector con una entrada por cada : el producto matriz-vector escrito explícitamente. Los índices del lado izquierdo te dicen la forma de la salida.
El factor que precede a una suma decide qué recibe el mismo peso. Un lote con una respuesta de 2 tokens y otra de 8 tokens, donde es la pérdida del token de la respuesta (en GRPO, es un término que se maximiza), puede promediarse de dos maneras:
En la primera, cada respuesta recibe peso , repartido entre sus tokens:
En la segunda, cada token tiene peso . GRPO muestrea respuestas a cada pregunta, y es el número de tokens de la respuesta . Los dos promedios se leen entonces así, para el GRPO de DeepSeekMath y para DAPO, una variante posterior de GRPO:
Con , estos son y de arriba. DAPO pasó al promedio por token (§3.3) porque el promedio por respuesta daba demasiado poco peso a los tokens de las respuestas largas: el modelo aprendía muy poco de las respuestas largas buenas y no penalizaba lo bastante las respuestas largas, repetitivas y malas.
Una suma también puede contar. Los artículos lo hacen con un indicador: un uno en negrita seguido de una condición, , que vale 1 cuando la condición es verdadera y 0 cuando es falsa. Algunos artículos ponen la condición entre paréntesis o imprimen un uno de trazo doble; el significado es el mismo. Sumar indicadores cuenta, por tanto, cuántas veces se cumple la condición. La exactitud (accuracy) es el ejemplo habitual. Si es la clase predicha e la clase correcta del ejemplo , entonces es el número de predicciones correctas. Las predicciones (gato, perro, perro) frente a las etiquetas correctas (gato, gato, perro) dan los indicadores 1, 0 y 1, así que el recuento es 2 y la exactitud 2/3. En una capa de mezcla de expertos (MoE), un enrutador envía cada token a unas pocas de muchas subredes feed-forward, llamadas expertos. En la pérdida de equilibrio de DeepSeek-V3 (ecuación 18), el indicador vale 1 cuando la puntuación de un experto para un token está entre las más altas para ese token, donde es a cuántos expertos se enruta cada token. Su suma sobre los tokens de una secuencia cuenta cuántas veces ocurrió. La puntuación de aquí omite el sesgo que añade el enrutamiento, de modo que el recuento puede diferir de los expertos que el enrutador elige realmente (enrutamiento de MoE).
El coeficiente binomial , que se lee « sobre », cuenta las formas de elegir elementos distintos de sin tener en cuenta el orden. Para enteros , es igual a . El signo de exclamación significa factorial: , con . Por ejemplo, : cinco elementos tienen diez parejas distintas. DeepSeekMoE usa coeficientes binomiales para contar combinaciones de expertos, y el estimador de pass@k los usa para contar conjuntos de muestras.
Los intervalos usan corchetes para los extremos incluidos: incluye ambos, ninguno. En Gated DeltaNet, significa estrictamente entre 0 y 1. En otros contextos, es una pareja.
El logaritmo natural invierte la exponenciación: . Los logaritmos convierten productos en sumas y cocientes en diferencias: y , pero no se separa. Por eso los artículos trabajan con log-probabilidades. El logaritmo de un producto de probabilidades de tokens es una suma, y el logaritmo de un cociente de las probabilidades de dos modelos es una diferencia, la forma que usan los objetivos de DPO y GRPO. Los artículos de ML se refieren al logaritmo natural salvo que digan otra cosa; los resultados están en nats, y los logaritmos en base 2 dan bits. Para una probabilidad , , y crece sin límite cuando se acerca a 0, de modo que una predicción errónea hecha con seguridad resulta cara.
Log-sum-exp significa: exponenciar cada puntuación , sumar los resultados y después tomar el logaritmo. Calcular directamente puede desbordar cuando una puntuación es grande. En su lugar, busca la puntuación mayor y llámala . La notación significa «compara todas las entradas y toma la mayor»; en NumPy, m = z.max().
Resta de todas las puntuaciones antes de exponenciar y súmalo de nuevo después de tomar el logaritmo:
Para , la puntuación mayor es . Las puntuaciones desplazadas son , así que el cálculo pasa a ser . Ninguna exponencial es mayor que 1. El código de la atención usa la misma resta antes de la softmax; allí el factor común se cancela en la división, así que no hay que volver a sumar nada.
Probabilidad condicional y probabilidad de un texto
es la probabilidad que el modelo con parámetros asigna a la salida dada la entrada . El subíndice nombra los parámetros; algunos artículos escriben , donde el punto y coma también marca parámetros y no una condición. Con un punto en lugar de la salida, es la distribución completa sobre las salidas y no un solo número. Los artículos de RL escriben el mismo objeto como , la probabilidad de que el modelo escriba la respuesta a la pregunta , y llaman al modelo una política (policy).
Intercambiar el evento y la condición da un número distinto. Supón 100 respuestas del modelo: 60 son correctas, 50 son JSON válido y 40 son ambas cosas. Entonces
Sea «la respuesta es correcta» y «la respuesta es JSON válido». La probabilidad condicional restringe el recuento a las respuestas que cumplen la condición: , siempre que . El símbolo significa «ocurren ambos eventos». Aquí la fracción es , lo mismo que 40 respuestas correctas entre 50 con JSON válido.
Dos eventos son independientes cuando saber que uno ha ocurrido no cambia la probabilidad del otro. Eso exige que . En esta muestra, , mientras que , así que las proporciones observadas no cumplen la independencia.
El teorema de Bayes, también llamado regla de Bayes, relaciona las dos direcciones del condicionamiento: . Permite calcular la probabilidad de dado a partir de la probabilidad de dado y de las probabilidades de los dos eventos. El ejemplo del ELBO lo usa para hallar la probabilidad de un código oculto dada una imagen observada.
Un modelo de lenguaje puntúa una secuencia token a token. Por la regla de la cadena de la probabilidad,
Cada factor se condiciona a todos los tokens anteriores, así que la fórmula no supone que los tokens sean independientes. Si tres tokens tienen probabilidades condicionales 0.5, 0.2 y 0.1:
La pérdida de entrenamiento habitual es el negativo de esta suma, dividido entre la longitud:
Durante el entrenamiento, los tokens anteriores vienen del dataset. Durante la generación, son las elecciones previas del propio modelo.
Esperanzas y de dónde salen las muestras
Una esperanza es un promedio ponderado por probabilidades:
Lee como «la media de cuando se extrae de ». La notación suma sobre todos los valores discretos posibles de . Sin subíndice, promedia una variable aleatoria sobre su propia distribución: si vale 1 con probabilidad 0.75 y 3 con probabilidad 0.25, entonces .
Cuando una variable tiene una densidad , es decir, probabilidad por unidad de , el promedio ponderado es una integral, . El identifica como la variable que se integra; sin límites escritos aquí, la integral cubre todo su rango. El ejemplo de la densidad explica la probabilidad por unidad y muestra una integral como el área bajo una curva.
El código de entrenamiento no puede sumar sobre todas las entradas posibles, así que muestrea y promedia: , con cada extraído de forma independiente de , lo que los artículos escriben como . Los artículos lo llaman una estimación de Monte Carlo, y en el código es loss.mean() sobre un lote. La media del lote estima la esperanza solo si el lote se extrae de la distribución del subíndice de , así que el subíndice te dice cómo se producen los datos de entrenamiento:
- DPO promedia sobre ejemplos guardados : un prompt, una respuesta preferida y una respuesta rechazada. Las respuestas se recopilan y se etiquetan antes de esta fase de entrenamiento; pueden proceder de generaciones anteriores de un modelo. En cada paso de entrenamiento, el modelo calcula las probabilidades de esas respuestas ya dadas y actualiza sus pesos. No muestrea respuestas nuevas para ese paso.
- GRPO en DeepSeek-R1: generar respuestas y después comparar sus recompensas. El entrenamiento toma una pregunta del dataset, genera varias respuestas y las puntúa con una función de recompensa, como comprobar un resultado matemático o ejecutar pruebas unitarias. La actualización favorece las respuestas que puntuaron por encima de la media del grupo. La notación significa «muestrea una pregunta de la distribución de preguntas». La notación significa «muestrea respuestas a esa pregunta de la copia del modelo llamada ». El subíndice old marca la copia que generó estas respuestas; esa copia permanece fija mientras el lote se usa para las actualizaciones. El recorrido de GRPO explica la comparación de recompensas y las actualizaciones.
- Destilación on-policy en MiniLLM y DeepSeek-V4: generar texto y después aprender de las probabilidades del maestro. El modelo que se entrena es el estudiante. Genera texto; un maestro congelado aporta las probabilidades del siguiente token para los mismos prefijos, y el entrenamiento ajusta las probabilidades del estudiante hacia las del maestro. Estas probabilidades dan la señal de entrenamiento, en lugar de la puntuación de recompensa de una respuesta que usa GRPO. MiniLLM escribe el texto muestreado del estudiante como : es el texto y nombra al modelo estudiante. DeepSeek-V4 llama a su estudiante y usa varios maestros especialistas. El procedimiento de muestreo real de MiniLLM también mezcla tokens extraídos del maestro. El recorrido de la destilación explica los objetivos y esa distinción del muestreo.
El orden te dice qué optimiza el entrenamiento. Supón que un modelo asigna probabilidades 0.9 y 0.1 a las salidas correctas de dos ejemplos de entrenamiento con el mismo peso. Promediar sus log-probabilidades significa tomar primero cada logaritmo y después promediar: np.log(probs).mean(). Tomar el logaritmo de su promedio significa np.log(probs.mean()). Si es la probabilidad asignada a la salida correcta de un ejemplo elegido al azar:
Al cambiar el signo de estas puntuaciones se obtienen pérdidas de 1.20 y 0.69. Un segundo modelo que asigna 0.5 a cada salida correcta obtiene 0.69 con cualquiera de los dos cálculos. Así, promediar las probabilidades antes de tomar el logaritmo trata a los dos modelos como igual de buenos, mientras que la log-probabilidad negativa media habitual penaliza más al primer modelo por su baja probabilidad en la segunda salida correcta. Al traducir una pérdida a código, conserva el orden del logaritmo y del promedio.
La desigualdad de Jensen enuncia la relación general para positiva: . También ayuda a construir objetivos de entrenamiento alternativos. Cuando la probabilidad de los datos de un modelo exige un promedio costoso sobre variables ocultas, un promedio de términos logarítmicos puede dar una cota inferior más fácil de estimar. El recorrido del ELBO explica ese problema de entrenamiento; ELBO significa evidence lower bound (cota inferior de la evidencia). La sección 2.4 de The Little Book of Generative AI Foundations, de Tianhua Chen, deriva la cota con la desigualdad de Jensen.
Densidades, varianza y barras de error
tiene dos significados habituales. Para resultados discretos, como tokens o clases, da la probabilidad del resultado : un número de 0 a 1, de modo que las probabilidades suman 1 sobre todos los resultados.
Para entender el otro significado, supón que se elige de forma uniforme entre 0 y 0.5. Los intervalos de igual longitud tienen probabilidades iguales. El intervalo de 0.1 a 0.2 ocupa una quinta parte de todo el rango, así que
Dentro de este rango, la probabilidad es la anchura del intervalo multiplicada por 2. Ese multiplicador es la densidad de probabilidad: para , y cero fuera. La densidad describe la probabilidad por unidad de la variable, no la probabilidad de un valor exacto.
Probabilidad cero para un punto no significa que no se muestree nada. Estrecha un intervalo en torno a 0.15: su probabilidad es el doble de su anchura, así que se acerca a cero cuando la anchura se acerca a cero. El punto exacto único tiene, por tanto, probabilidad cero. Aun así, una extracción produce algún valor en , y ese intervalo completo tiene probabilidad 1. Si registras el resultado redondeado a dos decimales, un valor registrado de 0.15 representa el intervalo de 0.145 a 0.155, cuya probabilidad es .
Para una densidad no uniforme, el multiplicador varía con . La integral suma las contribuciones a lo largo del intervalo:
Geométricamente, es el área bajo la curva de densidad entre y ; el área sobre todo el rango es 1. En el ejemplo uniforme, el área es simplemente la altura 2 por la anchura 0.5. Una densidad puede, por tanto, superar 1, y su logaritmo puede ser positivo, como lo es aquí . Una probabilidad nunca supera 1.
La distribución gaussiana que se usa para el ruido en DDPM tiene una densidad de este tipo. No toda distribución continua tiene una densidad ordinaria: la distribución de Cantor es un contraejemplo matemático, ajeno a los modelos de los que hablamos aquí. Almacenar valores reales tampoco implica una distribución continua: una variable restringida a 0.0 y 1.0 sigue teniendo dos resultados discretos.
Los artículos suelen usar la misma letra para probabilidades y densidades. Comprueba cómo define el artículo la distribución de la variable y sobre qué variable se suma o se integra. Una integral sobre una variable oculta , como el código latente del ELBO de la Parte 4, no te dice si una observada es discreta o continua. Algunos artículos escriben mayúscula para las probabilidades y minúscula para las densidades, pero muchos usan para ambas.
Para describir cuánto se dispersa una distribución alrededor de su media, los artículos usan la varianza: la diferencia media al cuadrado respecto de la media, , donde . La desviación típica es su raíz cuadrada, así que tiene las mismas unidades que .
Estas cantidades también aparecen en los nombres de las distribuciones. La distribución gaussiana, también llamada distribución normal, se escribe : es su media y su varianza. Para un vector, usa una matriz de covarianza : la entrada mide cómo varían juntas las coordenadas y , y la diagonal contiene sus varianzas. describe un vector de números normales estándar independientes, cada uno con media 0 y varianza 1; es la matriz identidad.
Las tablas de benchmarks suelen dar una puntuación media junto con una medida de variación. La dispersión de las ejecuciones individuales no es lo mismo que la incertidumbre de su media: para ejecuciones independientes con desviación típica , el error típico de la media es .
Antes de comparar dos entradas como y , averigua en el pie de la tabla si 0.4 es una desviación típica entre ejecuciones, un error típico o la semianchura de un intervalo de confianza. Para comparar las medias, calcula un intervalo para su diferencia. Un procedimiento de intervalo de confianza del 95 % produce rangos que contienen la diferencia verdadera en el 95 % de los experimentos repetidos, bajo sus supuestos.
Para este ejemplo, supón cuatro ejecuciones independientes por modelo, puntuaciones de las ejecuciones aproximadamente normales y varianzas poblacionales iguales. Si las ejecuciones están emparejadas, como dos modelos evaluados en las mismas tareas muestreadas de forma independiente, analiza en su lugar las diferencias dentro de cada pareja. La guía de dos muestras del NIST explica estos casos.
Para medias independientes, la varianza de su diferencia es la suma de sus varianzas. Una variable normal estándar cae entre y con probabilidad aproximada de 0.95, lo que aporta el multiplicador de una aproximación normal para un intervalo del 95 %. Si 0.4 es la desviación típica entre cuatro ejecuciones, ese primer cálculo da:
Ese multiplicador 1.96 trata la dispersión estimada como si fuera conocida. Con solo cuatro ejecuciones por modelo, usa la distribución t de Student para tener en cuenta la incertidumbre de la dispersión. Bajo los supuestos anteriores, sus grados de libertad son (ocho ejecuciones menos dos medias estimadas). scipy.stats.t.ppf(0.975, 6) da aproximadamente 2.447 en lugar de 1.96; 0.975 deja un 2.5 % fuera en cada extremo de un intervalo del 95 %. Si el supuesto de varianzas iguales no es adecuado, usa un intervalo de Welch, cuyos grados de libertad se calculan de otra manera.
Considera ahora la otra lectura del pie de tabla: 0.4 ya es el error típico de cada media, estimado a partir de esas cuatro ejecuciones. No se divide nada entre , y el error típico de la diferencia es de unos 0.566. El multiplicador t sigue siendo necesario. Las dos lecturas dan:
La figura compara la aproximación normal inicial con los dos intervalos t:
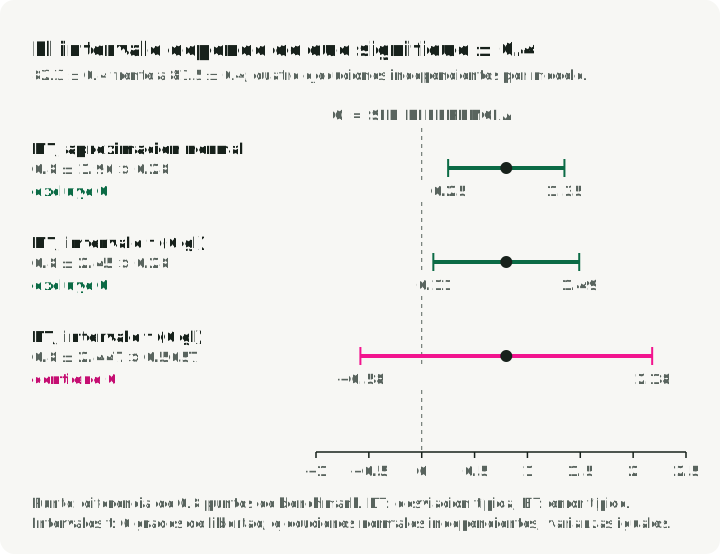
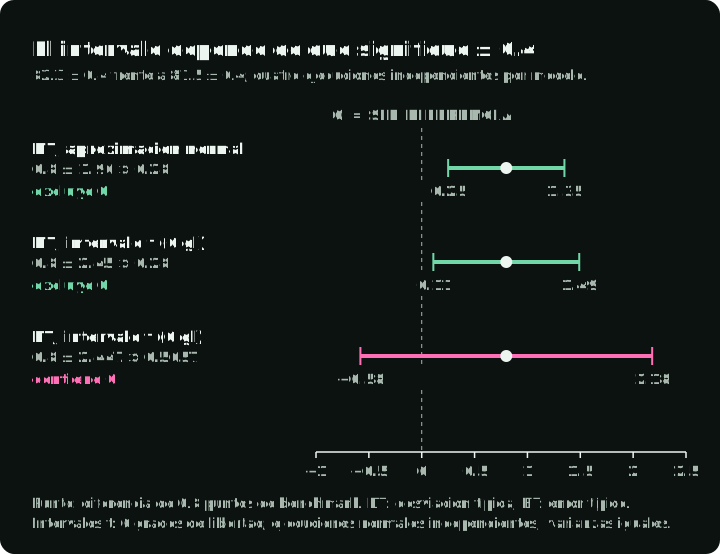
Cuando 0.4 es la desviación típica, el intervalo t excluye el cero: bajo estos supuestos, los resultados respaldan una diferencia positiva. Cuando 0.4 es el error típico estimado, el intervalo contiene el cero, así que los resultados no establecen qué modelo tiene la puntuación media más alta.
Entropía cruzada y divergencia KL
Durante el entrenamiento, un modelo necesita una pérdida numérica que mida lo bien que concuerdan sus probabilidades predichas con el objetivo de entrenamiento. El algoritmo de entrenamiento cambia los parámetros del modelo para reducir esa pérdida. La entropía cruzada aporta una pérdida así para ejemplos etiquetados o para las probabilidades de un modelo maestro. La divergencia de Kullback–Leibler (KL) mide la discrepancia entre dos distribuciones. Los artículos la usan para entrenar a un estudiante que imite a un maestro o para penalizar los cambios respecto de un modelo de referencia fijo.
Aquí los resultados son discretos, como tokens o clases. Escribe la distribución objetivo como y la distribución predicha por el modelo sobre los mismos resultados como . Empieza con un resultado observado : cuando el modelo le dio probabilidad , su pérdida es . Vale 0 cuando , unos 0.69 cuando , unos 2.3 cuando e infinito cuando .
La entropía cruzada promedia esa pérdida sobre los resultados extraídos del objetivo:
Con una etiqueta one-hot , que vale 1 en la clase correcta y 0 en el resto, solo cuenta la clase correcta, y : la pérdida de clasificación ordinaria. nn.CrossEntropyLoss de PyTorch la calcula a partir de las puntuaciones brutas del modelo, llamadas logits, y aplica internamente la log-softmax; su entrada no es el vector de probabilidades . Con la distribución suave de un modelo maestro como , cada clase cuenta en proporción a la probabilidad del maestro. La destilación clásica entrena así a un modelo pequeño con las probabilidades de uno grande. Para el objetivo , dos modelos tienen estas entropías cruzadas :
El segundo modelo coincide con el objetivo, y ningún modelo puede hacerlo mejor. Ese mínimo, 0.325 aquí, es , la entropía de . Es 0 solo para un objetivo one-hot: cuando el propio objetivo es incierto, queda cierta pérdida que ningún modelo puede eliminar.
La divergencia KL resta ese mínimo y conserva solo la pérdida causada por que difiera de . Se escribe con una barra doble , que solo separa los dos argumentos; no es la barra de probabilidad condicional de Probabilidad condicional y probabilidad de un texto ni las barras de longitud de la referencia de vectores. Los artículos la usan en lugar de una coma para marcar que el orden importa: el promedio recorre los resultados extraídos del primer argumento.
Para el primer modelo de arriba, . La KL es 0 cuando las dos distribuciones coinciden y positiva en caso contrario.
El orden cambia qué discrepancias se penalizan. Un término con y es infinito, así que penaliza a por asignar probabilidad cero a algo que puede producir. Los resultados con no suman nada (por convenio ), así que no aportan penalización directa aunque . Invertir los argumentos da , que es infinita siempre que y . Los resultados con ahora no suman nada, aunque . Con como objetivo, se llama KL directa (forward) y KL inversa (reverse).
Para y , la KL directa es infinita, porque pasa por alto un resultado que produce, mientras que la KL inversa es solo : el resultado que omite no suma nada. Para y , la KL directa es el 0.37 hallado arriba, calculado aquí término a término, y la KL inversa es distinta:
Esta asimetría es la razón por la que la KL se llama divergencia y no distancia.
Como , y la entropía de un maestro fijo no depende del estudiante, la entropía cruzada frente a un maestro fijo da al estudiante los mismos gradientes que . Cambiar un parámetro del estudiante cambia ambas pérdidas en la misma cantidad, así que sus derivadas usadas en el entrenamiento son iguales; Gradientes y optimización explica ese cálculo. Esto permite que el código de clasificación y de destilación clásica use la entropía cruzada. El intercambio funciona solo con el maestro en primer lugar. Con el estudiante en primer lugar, , y la propia entropía del estudiante cambia a medida que entrena, así que ya no dan los mismos gradientes.
Vectores y matrices
Las ecuaciones de arquitectura describen cálculos sobre arrays de números. La forma (shape) de un array te dice cómo están dispuestos sus números, qué operaciones son válidas y qué producen. Un vector es una lista ordenada de números. Una matriz dispone números en filas y columnas. En el código de ML, tensor es el término general para estos arrays numéricos, incluidos los que tienen más de dos ejes. Un eje es una dimensión a lo largo de la cual se indexa el array: una matriz tiene un eje de filas y un eje de columnas.
El estado oculto (hidden state) de un token es un vector de números calculado dentro del modelo para representar ese token. Supón que procesamos a la vez un lote de secuencias, cada una con posiciones de token, y que cada estado oculto contiene números. El array de estados ocultos tiene forma [B, T, d], que los artículos también escriben como . Sus tres ejes seleccionan la secuencia, la posición del token y el número dentro del vector de ese token. Por ejemplo, [2, 3, 4] contiene dos secuencias, tres vectores de token por secuencia y cuatro números por vector: 24 números en total. Aquí es el ancho del vector. La forma enumera los tres tamaños; multiplicarlos da el número de entradas.
Los artículos suelen escribir las formas como pertenencia a un conjunto: significa que es un vector de números reales, y significa que es una matriz con filas y columnas. Las letras en negrita a veces marcan vectores o tensores, pero la definición del artículo determina la forma.
En la tabla siguiente, y son vectores columna: sus números están dispuestos en vertical. El superíndice significa transpuesta: intercambiar filas y columnas. Así, es una fila con los mismos números que la columna . Las y mayúsculas de aquí nombran matrices; ya no significa el tamaño del lote.
| Expresión | Valores que usa | Qué hace la operación | Resultado |
|---|---|---|---|
| — producto escalar | Dos vectores columna, cada uno con entradas | Multiplica las entradas correspondientes y después suma los productos: | Un número |
| — producto externo | Una columna con entradas y una columna con entradas | Multiplica cada entrada de por cada entrada de | Una matriz ; la entrada es |
| — producto matricial | con filas y columnas; con filas y columnas | Para la entrada , multiplica los números correspondientes de la fila de y la columna de y súmalos | Una matriz ; el número de columnas de debe ser igual al de filas de |
| — producto elemento a elemento | Dos arrays de la misma forma | Multiplica las entradas de posiciones coincidentes, sin sumarlas | Un array de la misma forma |
| — concatenación | Columnas y con y entradas | Coloca las entradas de a continuación de las de | Una columna con entradas; comprueba el convenio del artículo para el eje de unión |
Para una comparación concreta, toma y . Mover la transpuesta cambia tanto el cálculo como el resultado:
El producto escalar da una sola puntuación, como en la comparación consulta–clave de la atención. El producto externo conserva un valor distinto para cada pareja de entradas; la actualización de Gated DeltaNet lo usa para construir una actualización matricial a partir de dos vectores.
Un producto de matrices puede reagruparse, , pero no reordenarse; la derivación de MLA usa el reagrupamiento para evitar reconstruir las claves. NumPy escribe la multiplicación de matrices como @ y el producto elemento a elemento como *. Los artículos no heredan las reglas de broadcasting de NumPy: sumar un vector a una matriz exige un eje indicado. Los artículos tampoco coinciden en si un vector es una fila o una columna: la atención apila los tokens como las filas de , mientras que MLA, Gated DeltaNet y LoRA escriben con vectores columna, y nn.Linear de PyTorch calcula x @ W.T sobre filas.
Una ecuación de arquitectura también puede describir el tamaño de un vector, restringir qué matrices están permitidas o reordenar un producto:
| Notación | Significado |
|---|---|
| La longitud euclídea; , sin la raíz, aparece en la pérdida de DDPM | |
| La suma de valores absolutos | |
| La norma espectral: el mayor factor por el que aumenta la longitud de un vector; mHC la mantiene en 1 como máximo | |
| El número de columnas independientes; la actualización de LoRA tiene rango como máximo | |
| El determinante: es el factor por el que escala el volumen, y el signo indica si invierte la orientación; el ejemplo de cambio de variables del Apéndice B de este artículo lo usa | |
| Toda entrada es no negativa, como en mHC; es una condición distinta, semidefinida positiva: para todo | |
| , | La matriz identidad (1 en la diagonal, 0 en el resto, de modo que ); un vector de unos |
| Transponer un producto invierte el orden; las secciones de RoPE y MLA de la Parte 2 lo usan |
Gradientes y optimización
El entrenamiento usa derivadas para decidir cómo cambiar los parámetros del modelo. Sea una pérdida escalar y el vector de todos los parámetros; es una entrada de ese vector.
La derivada parcial es un solo número, evaluado en los valores actuales de los parámetros. Mide la tasa de cambio de la pérdida cuando cambia solo y los demás parámetros se mantienen fijos. Léela como «la derivada parcial de la pérdida respecto del parámetro ».
El gradiente reúne esos números de todos los parámetros en un único vector. Su entrada -ésima es . El símbolo se llama nabla; aquí significa «toma el gradiente». Con un solo parámetro, el gradiente tiene una entrada igual a la derivada ordinaria.
Por ejemplo, toma . En y :
La primera derivada parcial, 4, significa que aumentar en 0.01 eleva la pérdida aproximadamente 0.04 mientras permanece fijo. El gradiente contiene esta información para ambos parámetros. El descenso de gradiente resta la derivada de cada parámetro, multiplicada por una tasa de aprendizaje (learning rate) positiva que controla el tamaño del paso:
Con , el ejemplo pasa de a , y la pérdida baja de 7 a 3.04. Para una pérdida derivable con gradiente no nulo, un paso suficientemente pequeño reduce la pérdida. Un gradiente cero no da ninguna actualización.
El subíndice de indica qué varía. varía los parámetros; varía la entrada, y los artículos de difusión lo llaman la puntuación (score), que no tiene nada que ver con la puntuación de un benchmark.
Un jacobiano registra las derivadas de varias salidas. Una capa de una red neuronal puede producir muchos números, como los componentes del estado oculto de un token. Para describir cómo responde cada salida a cada entrada, se reúnen las derivadas parciales en una matriz llamada jacobiano. Para con números de entrada y números de salida, su forma es : las filas corresponden a las salidas, las columnas a las entradas, y la entrada mide cómo cambia la salida cuando cambia la entrada .
Por ejemplo, sea una función que toma dos números y devuelve e . Su jacobiano es
La segunda columna dice que aumentar en 0.1 manteniendo fijo aumenta en 0.2 y disminuye en 0.1. Este ejemplo es lineal, así que su jacobiano es constante. Para una función no lineal, las entradas pueden depender de la entrada actual y describen cambios pequeños de forma local. Con una sola salida escalar, el jacobiano tiene una fila: las mismas derivadas que el gradiente, transpuestas según nuestro convenio de vectores columna. Deep Learning, §4.3, da las definiciones generales.
La retropropagación (backpropagation) usa estas derivadas para calcular el gradiente de la pérdida a través de capas sucesivas. El ejemplo de cambio de variables del Apéndice B de este artículo usa otra propiedad: el valor absoluto del determinante de un jacobiano cuadrado da el factor local de escala del volumen, que hace falta para ajustar una densidad de probabilidad.
En el entrenamiento, las derivadas describen cambios locales; un objetivo de optimización establece qué deben minimizar o maximizar las actualizaciones. Los artículos distinguen el mejor valor de un objetivo de los parámetros que lo alcanzan: es el menor valor de , mientras que da los valores de los parámetros que lo alcanzan. Para , el mínimo es 0 y el argmin es 3. Un argmin especifica el resultado deseado, pero deja abierto el algoritmo de actualización.
Por ejemplo, MiniLLM escribe su objetivo como (ecuación 1), donde es el modelo estudiante y el maestro del que aprende. La sección 2.2 deriva después un gradiente y lo modifica para que el entrenamiento sea más estable; la ecuación (7) es el gradiente que se usa para las actualizaciones. El ejemplo de destilación on-policy explica esos cambios. Leer solo el argmin los pasaría por alto.
Un stop-gradient, , pasa hacia delante sin cambios pero bloquea los gradientes a través de él, como .detach() en PyTorch. Dos expresiones con el mismo valor hacia delante pueden entrenar de forma distinta si una de ellas está separada del grafo. En el ejemplo de GRPO, Hugging Face TRL trata como fija la log-probabilidad del modelo antiguo. En el atajo de destilación que comenta DeepSeek-V4, un log-cociente maestro–estudiante separado del grafo aporta un peso fijo a la actualización.
Conjuntos y restricciones
Una restricción establece qué valores están permitidos. Los artículos suelen expresar las restricciones mediante conjuntos: colecciones de miembros distintos, escritas entre llaves, como . El orden no importa, así que nombra el mismo conjunto. Las entradas repetidas cuentan solo una vez. En cambio, los paréntesis de un vector como describen una lista ordenada: es un vector distinto.
Una vez que un artículo define un conjunto, puede comprobar la pertenencia, combinar conjuntos, contar sus miembros o enunciar una condición sobre ellos. Toma y :
| Notación | Significado | Ejemplo y cómo leerlo |
|---|---|---|
| Pertenencia: pertenece a | : 2 es un miembro de | |
| Unión: incluye todos los miembros de cualquiera de los dos conjuntos | ; incluye el 3 una sola vez | |
| Intersección: conserva solo los miembros comunes a ambos conjuntos | ||
| El número de miembros distintos | ||
| «Para todo»: una condición debe cumplirse para todos los miembros nombrados | : todos los miembros de son positivos | |
| «Existe»: al menos un miembro debe cumplir la condición | : tiene un miembro mayor que 2, a saber, 3 |
La notación de formas de Vectores y matrices también nombra conjuntos: es el conjunto de todos los vectores de números reales, y el conjunto de todas las matrices reales con filas y columnas. Así, especifica qué forma debe tener .
La notación de construcción de conjuntos describe un conjunto mediante una condición: se lee «los miembros de que cumplen la condición», como la comprensión de conjuntos de Python {x for x in S if condition(x)}. La barra significa «tal que», no probabilidad condicional; algunos artículos usan dos puntos en su lugar. Ejemplos de esta serie son las matrices permitidas de mHC, los expertos seleccionados de MoE y los tokens seleccionados de la atención dispersa.
DAPO, un método de entrenamiento que filtra grupos de respuestas generadas, conserva una pregunta solo cuando algunas respuestas son correctas y otras erróneas. Para respuestas muestreadas y la respuesta de referencia , escribe el conjunto de los índices de las respuestas correctas como
El filtro es . Usar índices hace explícito el recuento: dos muestras con texto idéntico siguen contando como dos respuestas. El artículo de DAPO escribe en cambio el conjunto sobre las respuestas ; leído literalmente como un conjunto de textos, esa forma cuenta una sola vez dos respuestas idénticas.
Ejercicios
- Formas. es , es y es . ¿Qué formas tienen las puntuaciones y la salida? ¿Sobre qué eje actúa la softmax?
- Softmax. Calcula la softmax de . ¿Cambia el resultado si se suma 100 a las dos entradas?
- Promedios. Una respuesta tiene un único token con pérdida 4; otra tiene tres tokens con pérdida 0. Calcula el promedio por token y el promedio por respuesta.
- Condicionamiento. De 200 respuestas, 120 son correctas, 80 pasan la validación de formato y 60 cumplen ambas cosas. Halla y .
- KL. Para un maestro y un estudiante , calcula las dos direcciones de la KL.
- Conjuntos. DAPO conserva una pregunta solo si , donde contiene los índices de las respuestas correctas entre muestras. Con , ¿conserva una pregunta cuyas respuestas puntúan ? ¿Y una cuyas respuestas puntúan ? ¿Cambia la primera respuesta si las cuatro muestras contienen un texto correcto idéntico?
Respuestas:
-
Las puntuaciones son y la salida es . La softmax recorre las seis claves de la fila de cada consulta.
-
. Sumar el mismo número a todas las entradas deja la softmax sin cambios, pero calcular directamente desborda en floats de 32 bits.
-
Los dos promedios:
-
y .
-
, y , porque el estudiante pone probabilidad en un resultado que el maestro descarta.
-
No: tiene cuatro miembros, que es igual a . Sí: tiene tres miembros, entre 0 y 4. El texto idéntico no cambia la primera respuesta: son cuatro muestras distintas, así que sus cuatro índices siguen contando.
Apéndice A. Letras griegas
Los usos indicados son ejemplos habituales; cada artículo sigue definiendo lo que significan sus símbolos.
| Letra | Nombre | Usos habituales en los artículos de ML |
|---|---|---|
| alfa | Un peso de mezcla o una escala; un decaimiento (Gated DeltaNet); un calendario de ruido (DDPM) | |
| beta | Una intensidad de penalización (DPO, GRPO); una intensidad de escritura (Gated DeltaNet); un calendario de ruido (DDPM) | |
| gamma | Un factor de descuento en RL; un tamaño de paso (la actualización del sesgo en DeepSeek-V3) | |
| delta | Una diferencia o un cambio | |
| épsilon | Ruido (DDPM); un rango de recorte (GRPO); un pequeño estabilizador | |
| eta | La tasa de aprendizaje | |
| theta | Parámetros del modelo; los ángulos de rotación de RoPE | |
| lambda | Un peso de regularización; un autovalor | |
| mu | Una media; el número de pasos de gradiente por lote en el Algoritmo 1 de DeepSeekMath | |
| pi | Una política; es el operador producto | |
| rho | Un cociente de probabilidades, como en la sección de GRPO de la Parte 3; una correlación | |
| sigma | La sigmoide (DPO); una desviación típica; una covarianza; es el operador suma | |
| tau | Una temperatura; un umbral; una trayectoria en RL | |
| phi | Los parámetros de una segunda red, como un codificador; características; un ángulo | |
| psi | Los parámetros de otra red, como el modelo de valor en el PPO de DeepSeekMath | |
| omega | Una frecuencia; es también una cota inferior en complejidad, o un conjunto de resultados |
Variantes como y suelen ser la misma letra en otra tipografía, pero un artículo puede usar ambas para variables distintas.
Apéndice B. Otras familias de ecuaciones
Formas de ecuación que esta serie no trabaja, con las definiciones que necesita cada una:
Modelos de espacio de estados selectivos. Un modelo de espacio de estados procesa una secuencia actualizando un estado almacenado en cada paso. Una actualización de la forma , combina el estado anterior con la entrada actual y después calcula una salida. Aquí es la entrada actual, el estado almacenado e la salida. Las matrices , y sirven, respectivamente, para transformar el estado anterior, añadir la contribución de la entrada y producir la salida. Las barras marcan parámetros convertidos de un modelo de tiempo continuo a pasos discretos; no significan medias. En Mamba, los parámetros de la actualización dependen de la entrada actual, que es lo que significa «selectivo».
Ecuaciones diferenciales estocásticas. describe cómo cambia un estado con el tiempo : es su tasa de cambio. Una ecuación diferencial estocástica (SDE, de stochastic differential equation) añade cambios aleatorios, . Aquí describe el cambio determinista, fija la escala del ruido y es un incremento de movimiento browniano. Para aproximarla en código, el método de Euler–Maruyama usa un paso de tiempo pequeño y sustituye por ruido gaussiano de varianza . La sección 5.1 de The Little Book of Generative AI Foundations, de Tianhua Chen, da una actualización así; la §6.4 del mismo libro usa SDE para describir los modelos de difusión.
Cambio de variables. Transformar una variable aleatoria cambia su densidad según cómo la transformación cambia el volumen local. Supón que transforma un espacio en otro de la misma dimensión, y que tanto como su inversa son derivables. Las densidades antes y después de la transformación, y , cumplen . La inversa recupera a partir de . Su jacobiano es la matriz cuadrada de derivadas primeras; el valor absoluto de su determinante corrige el cambio local de volumen. Por ejemplo, si en una dimensión, la densidad pasa a ser : duplicar la anchura divide la densidad entre dos. Los flujos normalizadores (normalizing flows) usan transformaciones invertibles como esta para modelar densidades; la §7.1 del libro de Tianhua Chen explica el método.
Objetivos min–max. En las redes generativas adversarias (GAN), un generador produce ejemplos y un discriminador intenta distinguirlos de los datos reales. El objetivo mide el éxito del discriminador: lo maximiza mientras lo minimiza. El objetivo (ecuación 1) dice: para cada generador posible, considera el mejor discriminador contra él y elige el generador con el menor objetivo resultante. El entrenamiento no resuelve esa maximización interna de forma exacta. El Algoritmo 1 del artículo alterna pasos de ascenso de gradiente sobre con un paso de descenso de gradiente sobre ; sus experimentos usaron .
El símplex de probabilidad. Un vector de probabilidad tiene entradas no negativas que suman 1. El conjunto de todos esos vectores con entradas se llama símplex de probabilidad y se escribe . Toda salida de una softmax pertenece a él. Aquí nombra un conjunto, y el superíndice es su dimensión, no una potencia: una vez elegidas probabilidades, la última debe hacer que la suma sea 1. Con dos opciones, toda distribución tiene la forma para , así que solo hay un número libre.
Normalización. La normalización reescala los valores según la media y la dispersión de un grupo elegido. Una forma habitual es , donde es una media, una varianza y un número positivo pequeño que evita la división por cero. La ecuación por sí sola no dice qué entradas se usan para calcular la media y la varianza. Para un lote de vectores de características, la normalización por lotes (batch normalization) las calcula por separado para cada característica a lo largo de los ejemplos. La normalización de capa (layer normalization) de un Transformer las calcula por separado para cada token a lo largo de sus características. Comprueba los ejes especificados al comparar implementaciones.
Fuentes y versiones
Los números de sección y de ecuación se refieren a las versiones enlazadas aquí.
- Tianhua Chen. The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer. 2026. Versión 2; §2.4 y §3.2 tratan la desigualdad de Jensen y el ELBO, §5.1 y §6.4 el ruido en tiempo continuo.
- Vaswani et al. Attention Is All You Need. 2017. Versión 7, §3.2.1, ecuación (1) y nota al pie 4.
- Dai et al. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. 2024. Segmentación fina de expertos y recuentos de combinaciones, §3.1; ablación, §4.4 y Figura 3.
- Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024. Versión 3, §1.1, §4.1.1, ecuaciones (1)–(4) y Algoritmo 1.
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. 2024. Versión 5, §2.1.1–2.1.3, ecuaciones (9)–(19) y Apéndice C.
- DeepSeek-AI. DeepSeek-V3 Technical Report. 2024–2025. Versión 2, §2.1.2, ecuaciones (12)–(18).
- DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025. Versión 1: §2.2.1, ecuaciones (1)–(3). Versión 2, 2026: §2.1 y Suplemento A.3.
- DeepSeek-AI. DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence. 2026. Versión 1: §2.2, ecuaciones (1)–(8); §5.1.2, ecuación (29).
- Rafailov et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. 2023–2024. Versión 3, §4, ecuación (7).
- Gu et al. MiniLLM: Knowledge Distillation of Large Language Models. 2023–2024. Versión 4, §2.1, ecuación (1) y §2.2, ecuaciones (2) y (7).
- Yu et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. 2025. Versión 2, §3.2–3.3, ecuaciones (11)–(12).
- Gu y Dao. Mamba: Linear-Time Sequence Modeling with Selective State Spaces. 2023–2024.
- Yang et al. Gated Delta Networks: Improving Mamba2 with Delta Rule. 2024–2025. Versión 3, §3.1, ecuación (10) y §3.3–3.4.
- Ho, Jain y Abbeel. Denoising Diffusion Probabilistic Models. 2020. Versión 2, §2, ecuaciones (4)–(5); §3.2, ecuación (12); §3.4, ecuación (14); y Algoritmos 1–2.
- Goodfellow et al. Generative Adversarial Nets. 2014. Ecuación (1) y Algoritmo 1.
- Chen et al. Evaluating Large Language Models Trained on Code. 2021. Versión 2, §2.1, ecuación (1) y Figura 3.
- Hugging Face TRL.
GRPOTraineryGRPOConfigen el commitc6eac19, octubre de 2026. - Stanford CS229. Probability Theory Review y Linear Algebra Review and Reference.
- Dive into Deep Learning. Preliminaries.
- Britz, Goldie, Luong y Le. Massive Exploration of Neural Machine Translation Architectures. 2017. Versión 2, Tabla 5; citado por Attention Is All You Need para la comparación entre atención de producto escalar y atención aditiva.