Como ler a matemática dos artigos de AI no arXiv: um guia prático
Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Saber ler a matemática de um artigo de AI é uma competência útil para engenheiros que precisam de perceber um modelo, reproduzir um método ou avaliar uma afirmação experimental. Este guia explica como decifrar a notação, verificar uma equação com números pequenos e ligá-la ao resto do artigo e à implementação. Pressupõe que sabe ler código, mas não que a notação de investigação já lhe seja familiar.
Uma equação comprime várias decisões numa só linha: os objetos manipulados, as suas dimensões, os valores que são amostrados e o que é aprendido ou mantido fixo. Recuperar esses pormenores é um bom primeiro passo. Explicar porque é que um método funciona e implementá-lo com fidelidade exige mais trabalho.
Comece pelo percurso da atenção: liga uma equação às formas dos arrays, a números pequenos e a Python executável. A referência de notação explica as expressões que vai encontrar noutros artigos. O resto desta série aplica o mesmo método a equações de artigos concretos: equações de arquitetura como RoPE, MLA e LoRA; objetivos de treino como DPO e GRPO; e modelos generativos e métricas como o ELBO, a difusão e o pass@k. Essas partes ainda não saíram, por isso os percursos a que esta parte se refere não têm ligação. Para um tratamento mais longo dos fundamentos, o livro de Tianhua Chen, The Little Book of Generative AI Foundations, desenvolve a álgebra linear e a probabilidade por trás dos modelos generativos.
Atenção, lida um símbolo de cada vez
A atenção produz um vetor de saída fazendo uma média ponderada de vetores valor. Obtém os pesos comparando um vetor consulta da posição de saída com um vetor chave de cada posição de entrada disponível. As matrizes , e reúnem esses vetores de consulta, chave e valor. A atenção de produto escalar com escala combina estes passos na equação (1) da §3.2.1 (§ significa «secção») de Attention Is All You Need:
As definições estão no texto, não na equação. O parágrafo anterior à equação (1) diz que as consultas e as chaves têm dimensão e que os valores têm dimensão . O método calcula o produto escalar de cada consulta com todas as chaves, divide cada um por e aplica uma softmax «para obter os pesos sobre os valores». As consultas são «agrupadas numa matriz », e as chaves e os valores em e . Assim, cada linha destas matrizes é o vetor de um token, e a softmax produz um conjunto de pesos por consulta. As matrizes aprendidas que transformam os vetores dos tokens em , e aparecem mais adiante, na §3.2.2.
Formas e papéis. Uma cabeça de atenção realiza um destes cálculos com os seus próprios vetores de consulta, chave e valor. Escreva as respetivas formas antes de ler os operadores. Para uma cabeça com consultas e chaves:
| Símbolo | Forma | O que é | De onde vem |
|---|---|---|---|
| uma linha de consulta por posição de saída | vetores dos tokens vezes uma matriz aprendida | ||
| uma linha de chave por posição a que se pode atender | vetores dos tokens vezes uma matriz aprendida | ||
| uma linha de valor por chave | vetores dos tokens vezes uma matriz aprendida | ||
| transposta: as linhas passam a colunas | os mesmos números de | ||
| um número | a largura de cada consulta e de cada chave | uma definição fixa: 64 no Transformer de base |
Os artigos indicam uma forma nomeando o conjunto a que a matriz pertence: significa uma matriz de números reais com linhas e colunas, um array de forma [n, dk].
Leia de dentro para fora.
-
multiplica uma matriz por uma matriz . O partilhado é somado e desaparece, pelo que o resultado é uma tabela de pontuações. A entrada é o produto escalar da consulta com a chave : multiplicam-se as entradas correspondentes e somam-se os produtos. Para comprimentos de vetor fixos, esta pontuação é maior quando as direções são mais parecidas.
-
Dividir por impede que as pontuações cresçam com a largura do vetor. A nota de rodapé 4 do artigo mostra porque é que os produtos escalares sem escala crescem. Suponha que as componentes de uma consulta e de uma chave são independentes entre si (saber algumas delas não diz nada sobre as outras), cada uma com média 0 e variância 1 (a distância quadrática média à média). Então:
As linhas usam duas regras sobre números independentes. Primeiro, o produto de dois números independentes, ambos com média 0 e variância 1, também tem variância 1. Segundo, quando se somam números independentes, as suas variâncias somam-se, pelo que os produtos dão variância . O desvio-padrão é a raiz quadrada da variância, . Dividir cada pontuação por reduz a dispersão no mesmo fator, de volta a 1.
Porque é que as duas regras se verificam
Variância quando a média é 0. A variância é a distância quadrática média à média. Quando a média é 0, a distância quadrática à média é simplesmente o quadrado do número, pelo que a variância é a média do quadrado. Uma componente com média 0 e variância 1 tem, portanto, com média 1.
A média de um produto. Para números independentes, a média de um produto é o produto das médias. Tome um número que é 1 ou 3 com igual probabilidade, pelo que tem média 2, e um número que é 1 ou 5, também com igual probabilidade, pelo que tem média 3. Independentes significa que toma cada um dos seus valores com a mesma frequência, qualquer que tenha sido o resultado de , pelo que os quatro pares são igualmente prováveis. Quando , os produtos são 1 e 5, com média . Quando , são 3 e 15, com média . Em qualquer dos casos a média é , pelo que, sobre os dois valores de , é , que é . Sem independência a regra falha: se fosse 5 sempre que é 3, e 1 sempre que é 1, só ocorreriam os produtos 1 e 15, cuja média é 8. A Wikipédia enuncia a regra para quaisquer variáveis aleatórias independentes, com «valor esperado» para a média: independência e valor esperado.
Regra 1: um produto tem variância 1. Tome um produto . A sua média é o produto das médias, , pelo que a sua variância é a média de . Os quadrados são independentes porque e o são, e cada um tem média 1, pelo que a variância é . A fórmula geral é a variância de um produto de variáveis independentes.
Regra 2: as variâncias de termos independentes somam-se. Chame aos produtos , de modo que o produto escalar é a soma . Os termos são independentes porque cada um usa componentes diferentes, e cada um tem média 0 e variância 1. A soma também tem média 0, pelo que a sua variância é a média do seu quadrado. Multiplicar a soma por si própria dá um produto para cada par de termos, uma grelha :
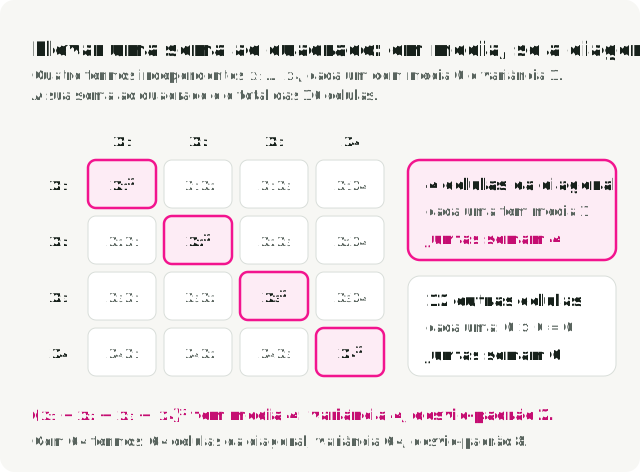
As células da diagonal são os quadrados , e cada uma tem média 1. Todas as outras células multiplicam dois termos diferentes e independentes, pelo que a sua média é o produto das médias, : os seus valores positivos e negativos anulam-se. Só ficam as células da diagonal, pelo que a variância da soma é e o seu desvio-padrão é . A dispersão cresce com a raiz quadrada da largura porque a maior parte da grelha se anula. A Wikipédia dá o enunciado geral como a variância de uma soma de variáveis não correlacionadas; as variáveis independentes são sempre não correlacionadas, por isso a regra também as cobre.
Com , as pontuações em bruto espalham-se tipicamente por cerca de ; com a escala, por cerca de , seja qual for a largura.
Pontuações muito dispersas saturam a softmax (passo 3), e os seus gradientes desaparecem. Se uma pontuação de uma linha estiver muito acima das outras, a softmax dá a essa chave um peso próximo de 1 e a todas as outras um peso próximo de 0. Uma pequena alteração a qualquer pontuação quase não move então os pesos, pelo que o gradiente que chega às consultas e às chaves é próximo de zero, e o treino quase não tem com que as ajustar. O artigo apresenta isto como a explicação provável de um resultado anterior: sem a escala, a atenção de produto escalar tinha pior desempenho do que a atenção aditiva, uma forma mais antiga que pontua uma consulta e uma chave com uma pequena rede, para grande (Britz et al., 2017). O artigo não mede os gradientes por si próprio.
-
A softmax transforma cada linha de pontuações em pesos. Seja uma linha das pontuações com escala. A exponencial , também escrita , usa a constante . Então , em que é apenas um segundo nome de índice, pelo que a soma percorre todas as chaves da linha. Os pesos são positivos e cada linha soma 1.
-
Multiplicar os pesos pelos valores soma o eixo das chaves. A linha da saída é uma média ponderada das linhas de valores, ponderada pela qualidade com que cada chave correspondeu à consulta .
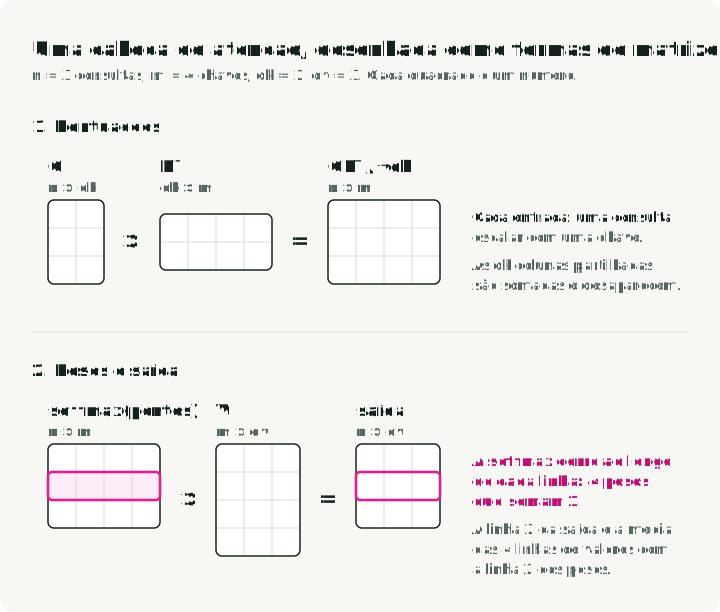
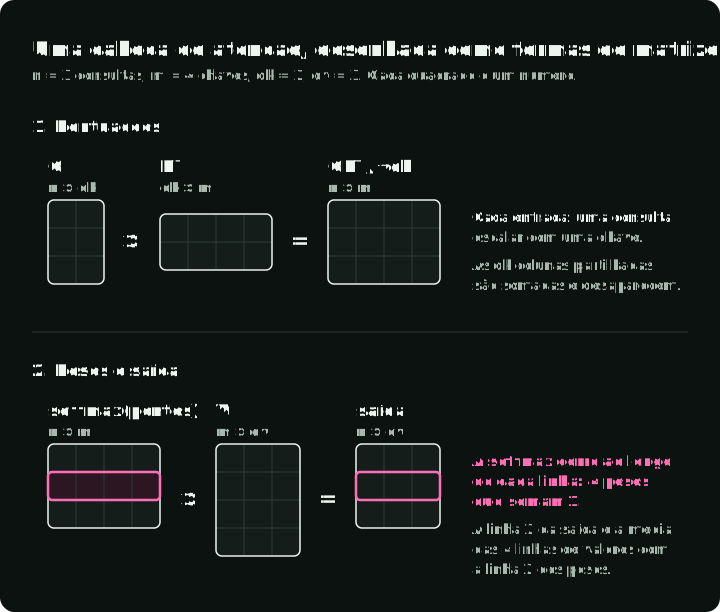
Conte os quadrados na figura: cada produto remove o eixo que as duas grelhas partilham.
Verifique com dois números. Tome uma consulta e duas chaves cujas pontuações com escala são , escolhidas para que as exponenciais dêem 1 e 3, e os valores e . A figura resolve-o com uma operação por coluna:
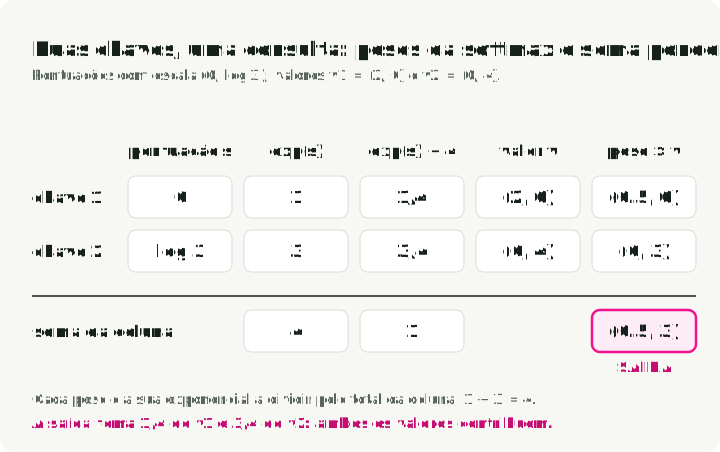
A atenção misturou os dois valores; não escolheu o token que correspondia melhor.
Compare com o código. A função NumPy abaixo implementa uma cabeça. k.T é a transposta. axis=1 é o eixo das chaves, pelo que a linha de cada consulta é normalizada em separado. O máximo da linha é subtraído antes de np.exp: somar o mesmo número a todas as pontuações de uma linha cancela-se na razão da softmax, pelo que o resultado não muda, mas as pontuações grandes deixam de provocar overflow. A máscara opcional põe as pontuações bloqueadas a , o que torna os seus pesos exatamente zero. Um decoder usa uma máscara destas para impedir que cada token atenda a tokens posteriores (§3.2.3 do artigo).
Guarde o bloco como attention_example.py e execute uv run --with numpy python attention_example.py. As verificações passam em silêncio.
import numpy as np

def attention(q, k, v, allowed=None):
    """One head. q: [n, dk], k: [m, dk], v: [m, dv], allowed: bool [n, m]."""
    scores = q @ k.T / np.sqrt(q.shape[1])  # [n, m]
    if allowed is not None:
        if not allowed.any(axis=1).all():
            raise ValueError("every query needs at least one allowed key")
        scores = np.where(allowed, scores, -np.inf)
    scores = scores - scores.max(axis=1, keepdims=True)
    weights = np.exp(scores)
    weights = weights / weights.sum(axis=1, keepdims=True)  # rows sum to 1
    return weights @ v, weights  # [n, dv], [n, m]

# The two-key example from the text.
out, w = attention(
    np.array([[1.0]]),
    np.array([[0.0], [np.log(3.0)]]),
    np.array([[2.0, 0.0], [0.0, 4.0]]),
)
np.testing.assert_allclose(w, [[0.25, 0.75]])
np.testing.assert_allclose(out, [[0.5, 3.0]])

# A causal mask: query i may attend only to keys 0..i.
x = np.random.default_rng(0).normal(size=(3, 4))
out, w = attention(x, x, x, allowed=np.tril(np.ones((3, 3), dtype=bool)))
assert out.shape == (3, 4)
np.testing.assert_allclose(w.sum(axis=1), 1.0)
assert np.all(w[np.triu_indices(3, k=1)] == 0)
Uma consulta cujas chaves estão todas bloqueadas é um caso que a equação deixa em aberto: todos os pesos da sua linha seriam . A função levanta um erro em vez de devolver NaN.
De uma cabeça para várias. O Transformer de base executa oito cabeças em paralelo, cada uma com as suas próprias matrizes aprendidas para produzir , e , e cada uma com . Concatena as suas saídas e multiplica o resultado por outra matriz aprendida, (Attention Is All You Need, §3.2.2).
Uma implementação também pode processar um lote (batch): várias sequências de entrada em conjunto. Por exemplo, a scaled dot-product attention do PyTorch aceita um tensor de consultas Q com forma [batch, heads, n, d_k]. As duas primeiras dimensões selecionam uma sequência e uma cabeça; Q[b, h] é a matriz [n, d_k] desse par. A fórmula da atenção aplica-se separadamente a cada par. A função NumPy aqui apresentada trata apenas um destes pares: as suas operações .T e axis=1 pressupõem entradas bidimensionais.
Seis perguntas para qualquer equação
| Pergunta | Resposta para a atenção |
|---|---|
| O que devolve a equação, e com que forma? | Uma matriz : uma linha de saída por consulta |
| Cada símbolo é um dado, um peso treinado, um modelo congelado, uma definição ou uma amostra? | , e são calculados a partir de tokens por matrizes aprendidas; é uma definição fixa; nada é amostrado |
| Sobre que índice ou eixo corre cada operação? | A softmax corre sobre as chaves da linha de cada consulta; o produto dos pesos por soma sobre as chaves |
| Onde estão as definições? | O parágrafo anterior à equação (1), a nota de rodapé 4, e a §3.2.2 para as projeções aprendidas |
| O que dá uma verificação com dois ou três números? | Pesos e saída |
| O que teve o código de decidir que a equação deixa em aberto? | Subtrair o máximo da linha, o valor usado para as pontuações mascaradas, uma linha sem nenhuma chave permitida |
Que tipo de afirmação faz uma equação
A atenção é um cálculo: diz como obter uma saída a partir de entradas. Os artigos também escrevem equações que cumprem outras funções:
| Tipo | Exemplo nesta série | O que verificar |
|---|---|---|
| Cálculo | A saída da atenção; o vetor comprimido da MLA | A forma de cada resultado intermédio |
| Definição | A pontuação da GRPO relativa a outras respostas | O que o novo nome representa, para o poder substituir de volta |
| Objetivo: uma perda a minimizar ou uma pontuação a maximizar | A perda da DPO | Se é minimizado ou maximizado, e sobre que dados se calcula a média |
| Regra de atualização | Descida do gradiente; a memória da Gated DeltaNet | O que muda em cada passo e o que fica fixo |
| Restrição, ou um conjunto de valores permitidos | As matrizes de mistura permitidas da mHC | Como o artigo produz um valor que a satisfaz |
| Limite: um máximo ou um mínimo de uma grandeza | O limite inferior da evidência (ELBO) | A diferença entre os dois lados, e quando é zero |
| Estimador ou métrica | pass@k | O que é contado, e a partir de quantas amostras |
| Ajuste empírico | A lei de escala do DeepSeek LLM | O intervalo de dados em que a curva foi ajustada |
Uma restrição enuncia uma propriedade que o resultado tem de ter. Para os pesos da atenção, essa propriedade é: todos os pesos são não negativos e cada linha soma 1. A softmax é um cálculo que produz pesos com essa propriedade. O requisito, por si só, não diz que se deve usar a softmax.
afirma que duas expressões são iguais. significa «é definido como»: dá um nome a uma expressão. Uma definição pode dar nome a uma métrica, a uma perda ou a um conjunto de valores permitidos, pelo que ver não lhe diz que tipo de equação da tabela acima está a ler.
Por exemplo, Evaluating Large Language Models Trained on Code, o artigo que apresentou o modelo de geração de código Codex, usa para definir o seu estimador do pass@k (equação 1). Esta métrica mede a probabilidade de pelo menos um de programas gerados passar nos testes. No relatório técnico do DeepSeek-V4, a equação (2) combina duas afirmações: define um conjunto de matrizes permitidas, e exige que a matriz de mistura do modelo pertença a esse conjunto. A definição usa ; a restrição usa , que significa «pertence a». As secções sobre pass@k e mHC percorrem esses exemplos.
Encontrar a nova equação, as suas definições e o seu código
A secção de métodos de um artigo descreve como funciona o seu modelo ou algoritmo de treino. O título pode ser «Method», «Architecture» ou algo mais específico. Os autores costumam explicar primeiro um método existente e depois mostrar o que mudaram. Para identificar a contribuição reivindicada, comece pelo resumo da introdução sobre o que há de novo. Por exemplo, DeepSeekMath, §1.1 apresenta a Group Relative Policy Optimization (GRPO), o seu método para treinar modelos a partir de respostas pontuadas. Os números de secção e de equação aqui referem-se ao artigo ligado.
Depois compare o método proposto com o método anterior que ele altera. Dois artigos ilustram isto:
- Uma mudança de arquitetura. O DeepSeek-V2 descreve a atenção multi-head padrão na §2.1.1 e apresenta a multi-head latent attention (MLA) na §2.1.2. A atenção padrão guarda as chaves e os valores de todos os tokens anteriores. A MLA guarda um vetor comprimido a partir do qual eles podem ser reconstruídos. Comparar essas equações revela o que o modelo guarda de forma diferente; o percurso da MLA deriva a poupança de memória.
- Uma mudança de treino. DeepSeekMath, §4.1.1 apresenta o objetivo da Proximal Policy Optimization (PPO) como equação (1) e o da GRPO como equação (3). Ambos usam uma vantagem: um número que diz se uma resposta foi melhor ou pior do que o esperado. A PPO estima-a com uma segunda rede aprendida, o modelo de valor, que prevê a recompensa ainda por vir a partir de uma resposta parcial. A GRPO, em vez disso, compara a recompensa da resposta com as recompensas de outras respostas à mesma pergunta. O percurso da GRPO compara estes termos usando a notação de resposta completa do DeepSeek-R1.
Encontre as definições à volta da equação. Verifique o parágrafo anterior, qualquer frase «onde …» que se lhe siga, as notas de rodapé e os apêndices. Em Attention Is All You Need, o parágrafo anterior à equação (1) define as dimensões, e a nota de rodapé 4 explica o fator de escala. O DeepSeek-V3 define a maioria dos seus símbolos de encaminhamento logo a seguir à equação (15), e o viés imediatamente antes da equação (16). O DeepSeek-V2 desenvolve a MLA ao longo das equações (9)–(19) e depois reúne o cálculo no Apêndice C.
Verifique o algoritmo e o código. Uma caixa de algoritmo é uma listagem numerada de pseudocódigo que dá a ordem das operações. O Algoritmo 1 do DeepSeekMath mostra quando gerar respostas e quando atualizar o modelo. O Algoritmo 1 de Denoising Diffusion Probabilistic Models (DDPM) especifica como amostrar a imagem de treino, o nível de ruído e o ruído. As implementações resolvem outros pormenores: por omissão, np.std divide a soma dos desvios quadráticos por , enquanto torch.std divide por . O exemplo da GRPO mostra como essa escolha altera os valores de vantagem calculados a partir das mesmas recompensas.
As versões do arXiv podem mover secções e repetir equações com novos números, por isso cite a versão. No DeepSeek-R1 v1, o objetivo da GRPO está na §2.2.1, equações (1)–(3). Na v2, publicada em janeiro de 2026, está na §2.1, e as mesmas equações reaparecem como (11)–(13) no Suplemento A.3. Uma ligação sem versão abre a mais recente, por isso todas as ligações do arXiv nesta série incluem a versão com que foram verificadas.
Verificar a sua leitura com um LLM
Um modelo de conversação pode redigir a tabela de símbolos, o índice de cada soma e uma verificação com números pequenos, se lhe der as definições e lhe pedir que assinale o que falta. O texto copiado de um PDF achata subscritos, sobrescritos e frações numa só linha; as ligações «HTML (experimental)» e «TeX Source» na página de resumo do arXiv dão texto limpo para colar. Cole a equação e os parágrafos à volta com um prompt como este:
Below is equation (N) from <paper title, arXiv ID and version>, followed by
the paragraphs that define its symbols.

1. Make a table with one row per symbol: shape or type, meaning, and whether
   it is input data, a trained weight, a frozen model, a fixed setting or a
   random sample. Quote the sentence that defines it.
2. List every symbol the pasted text does not define. Do not guess them.
3. For every sum, mean, softmax, min or expectation, name the index or the
   distribution it runs over.
4. Work through the equation with the smallest numbers that use every term.
5. Say which kind of statement it is: a computation, definition, objective,
   update rule, constraint, bound, estimator or empirical fit.
Sem o passo 2, nada impede o modelo de preencher uma definição em falta com o significado habitual da letra, como ler na DPO como um desvio-padrão em vez da sigmoide. As citações do passo 1 tornam a tabela verificável: procure cada uma no PDF e trate uma linha cuja citação não encontra como um palpite.
O mesmo procedimento como skills de agente. O paper-math-skills reúne esta secção e a referência de notação abaixo em duas skills escritas para o Claude Code; outros agentes que carregam ficheiros SKILL.md também as podem usar. A read-paper-math obtém a versão fixada do arXiv, cita a frase que define cada símbolo, lê a equação de dentro para fora e executa uma verificação com números pequenos. A check-paper-math revê uma dessas leituras face ao artigo: procura cada citação, volta a executar os números e assinala afirmações mais fortes ou mais fracas do que as do artigo. O paper-math-readings tem as leituras das skills para as Partes 2–4, uma para cada uma das 15 secções com uma linha Source:.
Referência de notação
Se uma letra grega lhe for desconhecida, abra a referência de letras gregas deste artigo (Apêndice A) para ver o nome e os significados habituais. Para praticar mais a matemática, a Stanford CS229 disponibiliza revisões de probabilidade e de álgebra linear com exercícios; os preliminares do Dive into Deep Learning explicam os fundamentos com código.
Subscritos, marcas e sinais de relação
As letras são nomes de variáveis locais: cada artigo define as suas. Os subscritos são normalmente índices. pode ser a coordenada de um vetor ou o exemplo de um dataset, e é o vetor do modelo para o token , chamado o seu estado oculto.
Nos artigos sobre modelos, os sobrescritos são muitas vezes etiquetas. Em , o sobrescrito entre parênteses é normalmente um número de camada, não uma potência; em e do DeepSeek-V3 marca os especialistas partilhados e os encaminhados, os que todos os tokens usam e os que um router escolhe (ver o exemplo de encaminhamento MoE). No DeepSeek-V2, e levam etiquetas, não expoentes; o exemplo da MLA define essas etiquetas. é uma transposta e é um quadrado.
significa as posições 1 a , inclusive , ao contrário de uma fatia de Python; os artigos costumam contar a partir de 1. significa todas as posições anteriores a . seleciona a linha , como na indexação por fatias do NumPy.
As marcas numa letra costumam alterar o seu significado de uma destas formas:
| Marca | Leitura habitual | Exemplo ou exceção |
|---|---|---|
| Uma previsão ou uma estimativa | Exemplo: no DeepSeekMath estima quanto melhor do que o esperado uma resposta foi pontuada | |
| Uma média | Exceção: no DDPM, multiplica os fatores do calendário de ruído do passo 1 até | |
| Uma versão perturbada ou sem restrição | Exemplo: no DeepSeek-V4, é uma matriz antes de a normalização impor as suas restrições | |
| O ótimo | Exceção: na DPO, é a verdadeira recompensa, que o método nunca observa | |
| Um valor novo ou intermédio | Exemplo: no DeepSeek-V3, é o peso de um especialista antes da normalização | |
| A matriz inversa | Não o recíproco entrada a entrada: desfaz , (a matriz identidade), e em geral |
Alguns símbolos que não são letras gregas também têm várias funções:
| Símbolo | Significados |
|---|---|
| Condicionamento em ; «tal que» dentro de um conjunto | |
| Um valor absoluto; o comprimento de uma sequência, como em , o número de tokens da resposta da GRPO; o tamanho de um conjunto | |
| «É amostrado de» em ; «aproximadamente» em texto informal | |
| Um comprimento de sequência; uma temperatura da softmax; o número de passos de difusão | |
| Um vetor de consulta (atenção); uma pergunta (GRPO); o modelo aluno (destilação); o codificador (ELBO) |
Cinco sinais dizem como dois lados se relacionam. , por vezes , define um novo nome. marca uma aproximação, como a média amostrada em Valores esperados e de onde vêm as amostras. significa «proporcional a», com uma constante de normalização omitida: só se torna uma distribuição depois de dividir por . significa «muito menor do que», como em do DeepSeek-V2: a largura comprimida é muito menor do que a largura total de todas as cabeças. é uma atribuição, como numa regra de atualização.
Somas, contagens, intervalos e logaritmos
O grande soma termos e o multiplica-os. O índice por baixo de cada operador começa aqui em 1 e percorre até ao limite superior :
O índice pertence ao operador, tal como uma variável de ciclo pertence ao seu ciclo. Em , a soma corre sobre , enquanto identifica uma entrada da saída. O resultado é um vetor com uma entrada por : o produto matriz-vetor escrito por extenso. Os índices do lado esquerdo dizem-lhe a forma da saída.
O fator à frente de uma soma decide o que recebe peso igual. Um lote com uma resposta de 2 tokens e outra de 8 tokens, em que é a perda no token da resposta (na GRPO, é antes um termo a maximizar), pode ter a média calculada de duas formas:
Na primeira, cada resposta recebe o peso , repartido pelos seus tokens:
Na segunda, cada token tem peso . A GRPO amostra respostas para cada pergunta, e é o número de tokens da resposta . As duas médias ficam então assim, para a GRPO do DeepSeekMath e para o DAPO, uma variante posterior da GRPO:
Com , estas são e acima. O DAPO passou para a média por token (§3.3) porque a média por resposta dava pouco peso aos tokens das respostas longas: o modelo aprendia pouco com respostas longas boas e não penalizava o suficiente as respostas longas, repetitivas e más.
Uma soma também pode contar. Os artigos fazem-no com um indicador: um «1» a negrito seguido de uma condição, , que é igual a 1 quando a condição é verdadeira e a 0 quando é falsa. Alguns artigos põem a condição entre parênteses ou imprimem um «1» de traço duplo; o significado é o mesmo. Somar indicadores conta, portanto, quantas vezes a condição se verifica. A exatidão é o exemplo habitual. Se é a classe prevista e a classe correta do exemplo , então é o número de previsões corretas. As previsões (gato, cão, cão) face às etiquetas corretas (gato, gato, cão) dão os indicadores 1, 0 e 1, pelo que a contagem é 2 e a exatidão 2/3. Numa camada mixture-of-experts (MoE), um router envia cada token para algumas de muitas sub-redes feed-forward, chamadas especialistas. Na perda de equilíbrio do DeepSeek-V3 (equação 18), o indicador é 1 quando a pontuação de um especialista para um token está entre as pontuações mais altas desse token, em que é o número de especialistas para onde cada token é encaminhado. A sua soma sobre os tokens de uma sequência conta quantas vezes isso aconteceu. A pontuação aqui deixa de fora o viés que o encaminhamento acrescenta, pelo que a contagem pode diferir dos especialistas que o router realmente escolhe (encaminhamento MoE).
O coeficiente binomial , que se lê « escolhe », conta as formas de escolher itens distintos de entre sem ter em conta a ordem. Para inteiros , é igual a . O ponto de exclamação significa fatorial: , com . Por exemplo, : cinco itens têm dez pares distintos. O DeepSeekMoE usa coeficientes binomiais para contar combinações de especialistas, e o estimador pass@k usa-os para contar conjuntos de amostras.
Os intervalos usam parênteses retos para as extremidades incluídas: inclui ambas, nenhuma. Na Gated DeltaNet, significa estritamente entre 0 e 1. Noutros contextos, é um par.
O logaritmo natural inverte a exponenciação: . Os logaritmos transformam produtos em somas e razões em diferenças: e , mas não se decompõe. É por isso que os artigos trabalham com log-probabilidades. O logaritmo de um produto de probabilidades de tokens é uma soma, e o logaritmo de uma razão das probabilidades de dois modelos é uma diferença, a forma usada nos objetivos da DPO e da GRPO. Os artigos de ML referem-se ao logaritmo natural, a menos que digam o contrário; os resultados estão em nats, e os logaritmos de base 2 dão bits. Para uma probabilidade , , e cresce sem limite à medida que se aproxima de 0, pelo que uma previsão errada com confiança é cara.
Log-sum-exp significa: exponenciar cada pontuação , somar os resultados e depois tomar o logaritmo. Calcular diretamente pode provocar overflow quando uma pontuação é grande. Em vez disso, encontre a maior pontuação e chame-lhe . A notação significa «compare todas as entradas e tome a maior»; em NumPy, m = z.max().
Subtraia a cada pontuação antes de exponenciar e some-o de volta depois de tomar o logaritmo:
Para , a maior pontuação é . As pontuações deslocadas são , pelo que o cálculo passa a . Nenhuma exponencial é maior do que 1. O código da atenção usa a mesma subtração antes da softmax; aí o fator comum cancela-se na divisão, pelo que nada é somado de volta.
Probabilidade condicional e a probabilidade de texto
é a probabilidade que o modelo com parâmetros atribui à saída dada a entrada . O subscrito nomeia os parâmetros; alguns artigos escrevem , em que o ponto e vírgula também marca parâmetros e não uma condição. Com um ponto no lugar da saída, é a distribuição completa sobre as saídas e não um único número. Os artigos de RL escrevem o mesmo objeto como , a probabilidade de o modelo escrever a resposta à pergunta , e chamam ao modelo uma política (policy).
Trocar o acontecimento e a condição dá um número diferente. Suponha 100 respostas de um modelo: 60 estão corretas, 50 são JSON válido e 40 são ambas as coisas. Então
Seja «a resposta está correta» e «a resposta é JSON válido». A probabilidade condicional restringe a contagem às respostas que satisfazem a condição: , desde que . O símbolo significa «ambos os acontecimentos ocorrem». Aqui a fração é , o mesmo que 40 respostas corretas entre 50 respostas com JSON válido.
Dois acontecimentos são independentes quando saber que um ocorreu não altera a probabilidade do outro. Isso exige . Nesta amostra, , enquanto , pelo que as proporções observadas não satisfazem a independência.
O teorema de Bayes, também chamado regra de Bayes, relaciona as duas direções do condicionamento: . Permite calcular a probabilidade de dado a partir da probabilidade de dado e das probabilidades dos dois acontecimentos. O exemplo do ELBO usa-o para encontrar a probabilidade de um código oculto dada uma imagem observada.
Um modelo de linguagem pontua uma sequência um token de cada vez. Pela regra da cadeia da probabilidade,
Cada fator condiciona-se a todos os tokens anteriores, pelo que a fórmula não pressupõe que os tokens são independentes. Se três tokens têm probabilidades condicionais 0.5, 0.2 e 0.1:
A perda de treino habitual é o negativo desta soma, dividido pelo comprimento:
Durante o treino, os tokens anteriores vêm do dataset. Durante a geração, são as escolhas anteriores do próprio modelo.
Valores esperados e de onde vêm as amostras
Um valor esperado é uma média ponderada pela probabilidade:
Leia como «a média de quando é extraído de ». A notação soma sobre todos os valores discretos possíveis de . Sem subscrito, calcula a média de uma variável aleatória sobre a sua própria distribuição: se é 1 com probabilidade 0.75 e 3 com probabilidade 0.25, então .
Quando uma variável tem uma densidade , isto é, probabilidade por unidade de , a média ponderada é um integral, . O identifica como a variável de integração; sem limites escritos aqui, o integral cobre todo o seu intervalo. O exemplo da densidade explica a probabilidade por unidade e mostra um integral como a área sob uma curva.
O código de treino não consegue somar sobre todas as entradas possíveis, por isso amostra e faz a média: , com cada extraído independentemente de , o que os artigos escrevem como . Os artigos chamam a isto uma estimativa de Monte Carlo, e em código é loss.mean() sobre um lote. A média do lote só estima o valor esperado se o lote for extraído da distribuição do subscrito do , pelo que o subscrito diz-lhe como os dados de treino são produzidos:
- A DPO calcula a média sobre exemplos guardados : um prompt, uma resposta preferida e uma resposta rejeitada. As respostas são recolhidas e etiquetadas antes desta fase de treino; podem vir de uma geração anterior do modelo. Em cada passo de treino, o modelo calcula as probabilidades dessas respostas fornecidas e atualiza os seus pesos. Não amostra respostas novas para esse passo.
- GRPO no DeepSeek-R1: gerar respostas e depois comparar as suas recompensas. O treino extrai uma pergunta do dataset, gera várias respostas e pontua-as com uma função de recompensa, como verificar um resultado matemático ou executar testes unitários. A atualização favorece as respostas que pontuaram acima da média do grupo. A notação significa «amostrar uma pergunta da distribuição das perguntas». A notação significa «amostrar respostas a essa pergunta a partir da cópia do modelo chamada ». O subscrito old marca a cópia que gerou estas respostas; essa cópia mantém-se fixa enquanto o lote é usado para atualizações. O percurso da GRPO explica a comparação de recompensas e as atualizações.
- Destilação on-policy no MiniLLM e no DeepSeek-V4: gerar texto e depois aprender com as probabilidades do professor. O modelo que está a ser treinado é o aluno. Gera texto; um professor congelado fornece probabilidades do token seguinte para os mesmos prefixos, e o treino ajusta as probabilidades do aluno em direção às do professor. Estas probabilidades fornecem o sinal de treino, em vez da pontuação de recompensa de uma resposta da GRPO. O MiniLLM escreve o texto amostrado pelo aluno como : é o texto e nomeia o modelo aluno. O DeepSeek-V4 chama ao seu aluno e usa vários professores especialistas. O procedimento de amostragem real do MiniLLM também mistura tokens extraídos do professor. O percurso da destilação explica os objetivos e essa distinção na amostragem.
A ordem diz-lhe o que o treino otimiza. Suponha que um modelo atribui as probabilidades 0.9 e 0.1 às saídas corretas de dois exemplos de treino com o mesmo peso. Calcular a média das suas log-probabilidades significa tomar primeiro cada logaritmo e depois fazer a média: np.log(probs).mean(). Tomar o logaritmo da sua média é np.log(probs.mean()). Se é a probabilidade atribuída à saída correta de um exemplo escolhido ao acaso:
Negar estas pontuações dá perdas de 1.20 e 0.69. Um segundo modelo que atribui 0.5 a cada saída correta obtém 0.69 em qualquer dos cálculos. Assim, calcular a média das probabilidades antes de tomar o logaritmo trata os dois modelos como igualmente bons, enquanto a média habitual da log-probabilidade negativa penaliza mais o primeiro modelo pela sua baixa probabilidade na segunda saída correta. Ao traduzir uma perda para código, preserve a ordem do logaritmo e da média.
A desigualdade de Jensen enuncia a relação geral para positivo: . Também ajuda a construir objetivos de treino alternativos. Quando a probabilidade dos dados segundo o modelo exige uma média dispendiosa sobre variáveis ocultas, uma média de termos logarítmicos pode fornecer um limite inferior mais fácil de estimar. O percurso do ELBO explica esse problema de treino; ELBO significa evidence lower bound (limite inferior da evidência). A secção 2.4 do livro de Tianhua Chen, The Little Book of Generative AI Foundations, deriva o limite usando a desigualdade de Jensen.
Densidades, variância e barras de erro
tem dois significados comuns. Para resultados discretos, como tokens ou classes, dá a probabilidade do resultado : um número entre 0 e 1, com as probabilidades a somar 1 sobre todos os resultados.
Para perceber o outro significado, suponha que é escolhido uniformemente entre 0 e 0.5. Intervalos com o mesmo comprimento têm probabilidades iguais. O intervalo de 0.1 a 0.2 ocupa um quinto de todo o intervalo, pelo que
Dentro deste intervalo, a probabilidade é a largura do intervalo multiplicada por 2. Esse multiplicador é a densidade de probabilidade: para , e zero fora. A densidade descreve a probabilidade por unidade da variável, não a probabilidade de um valor exato.
Probabilidade zero para um ponto não significa que nada seja amostrado. Estreite um intervalo à volta de 0.15: a sua probabilidade é o dobro da largura, pelo que se aproxima de zero quando a largura se aproxima de zero. O ponto exato tem, portanto, probabilidade zero. Uma extração produz mesmo assim algum valor em , e esse intervalo inteiro tem probabilidade 1. Se registar o resultado arredondado a duas casas decimais, um valor registado de 0.15 representa o intervalo de 0.145 a 0.155, cuja probabilidade é .
Para uma densidade não uniforme, o multiplicador varia com . O integral soma as contribuições ao longo do intervalo:
Geometricamente, é a área sob a curva da densidade entre e ; a área sobre todo o intervalo é 1. No exemplo uniforme, a área é simplesmente a altura 2 vezes a largura 0.5. Uma densidade pode, portanto, exceder 1, e o seu logaritmo pode ser positivo, como aqui. Uma probabilidade nunca excede 1.
A distribuição gaussiana usada para o ruído no DDPM tem uma densidade deste tipo. Nem toda a distribuição contínua tem uma densidade vulgar: a distribuição de Cantor é um contraexemplo matemático, fora dos modelos aqui discutidos. Armazenar valores reais também não implica uma distribuição contínua: uma variável restrita a 0.0 e 1.0 continua a ter dois resultados discretos.
Os artigos usam muitas vezes a mesma letra para probabilidades e densidades. Verifique como o artigo define a distribuição da variável e que variável é somada ou integrada. Um integral sobre uma variável oculta , como o código latente do ELBO da Parte 4, não lhe diz se um observado é discreto ou contínuo. Alguns artigos escrevem maiúsculo para probabilidades e minúsculo para densidades, mas muitos usam para ambos.
Para descrever quanto uma distribuição se dispersa à volta da sua média, os artigos usam a variância: a diferença quadrática média em relação à média, , com . O desvio-padrão é a sua raiz quadrada, pelo que tem as mesmas unidades que .
Estas grandezas também aparecem nos nomes das distribuições. A distribuição gaussiana, também chamada distribuição normal, escreve-se : é a sua média e a sua variância. Para um vetor, usa uma matriz de covariância : a entrada mede como as coordenadas e variam em conjunto, e a diagonal contém as suas variâncias. descreve um vetor de números normais padrão independentes, cada um com média 0 e variância 1; é a matriz identidade.
As tabelas de benchmarks costumam indicar uma pontuação média juntamente com uma medida de variação. A dispersão das execuções individuais difere da incerteza da sua média: para execuções independentes com desvio-padrão , o erro-padrão da média é .
Antes de comparar duas entradas como e , descubra na legenda se 0.4 é um desvio-padrão entre execuções, um erro-padrão ou a semilargura de um intervalo de confiança. Para comparar as médias, calcule um intervalo para a sua diferença. Um procedimento de intervalo de confiança a 95% produz intervalos que contêm a verdadeira diferença em 95% das experiências repetidas, sob os seus pressupostos.
Para este exemplo, assuma quatro execuções independentes por modelo, pontuações das execuções aproximadamente normais e variâncias populacionais iguais. Se as execuções forem emparelhadas, como dois modelos avaliados nas mesmas tarefas amostradas de forma independente, analise antes as diferenças dentro dos pares. O guia de duas amostras do NIST explica estes casos.
Para médias independentes, a variância da sua diferença é a soma das suas variâncias. Uma variável normal padrão cai entre e com probabilidade de cerca de 0.95, o que fornece o multiplicador para uma aproximação normal de um intervalo a 95%. Se 0.4 for o desvio-padrão entre quatro execuções, esse primeiro cálculo dá:
Esse multiplicador 1.96 trata a dispersão estimada como conhecida. Com apenas quatro execuções por modelo, use a distribuição t de Student para ter em conta a incerteza na dispersão. Sob os pressupostos acima, os seus graus de liberdade são (oito execuções menos duas médias estimadas). scipy.stats.t.ppf(0.975, 6) dá cerca de 2.447 em vez de 1.96; 0.975 deixa 2.5% fora em cada extremo de um intervalo a 95%. Se o pressuposto de variâncias iguais não for adequado, use um intervalo de Welch, cujos graus de liberdade são calculados de outra forma.
Considere agora a outra leitura da legenda: 0.4 já é o erro-padrão de cada média, estimado a partir dessas quatro execuções. Nada é dividido por , e o erro-padrão da diferença é cerca de 0.566. O multiplicador t continua a ser necessário. As duas leituras dão:
A figura compara a aproximação normal inicial com os dois intervalos t:
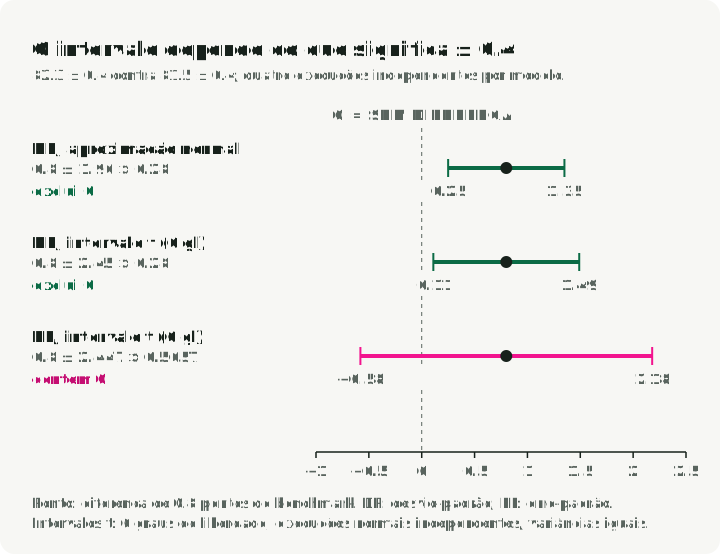
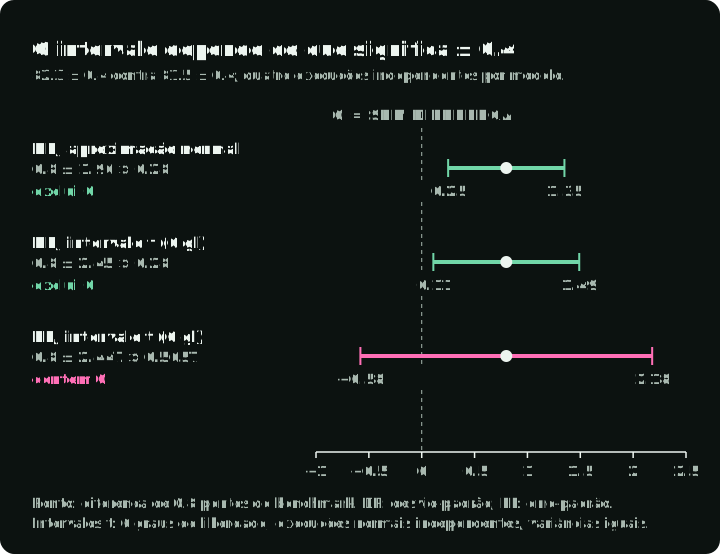
Quando 0.4 é o desvio-padrão, o intervalo t exclui o zero: sob estes pressupostos, os resultados sustentam uma diferença positiva. Quando 0.4 é o erro-padrão estimado, o intervalo contém o zero, pelo que os resultados não estabelecem qual dos modelos tem a pontuação média mais alta.
Entropia cruzada e divergência KL
Durante o treino, um modelo precisa de uma perda numérica que meça o grau de concordância das suas probabilidades previstas com o alvo de treino. O algoritmo de treino altera os parâmetros do modelo para reduzir essa perda. A entropia cruzada fornece uma perda dessas para exemplos etiquetados ou para as probabilidades de um modelo professor. A divergência de Kullback–Leibler (KL) mede a discrepância entre duas distribuições. Os artigos usam-na para treinar um aluno a imitar um professor ou para penalizar afastamentos de um modelo de referência fixo.
Aqui os resultados são discretos, como tokens ou classes. Escreva a distribuição alvo como e a distribuição prevista pelo modelo sobre os mesmos resultados como . Comece com um resultado observado : quando o modelo lhe atribuiu a probabilidade , a sua perda é . É 0 quando , cerca de 0.69 quando , cerca de 2.3 quando , e infinita quando .
A entropia cruzada faz a média dessa perda sobre resultados extraídos do alvo:
Com uma etiqueta one-hot , que é 1 na classe correta e 0 nas restantes, só conta a classe correta, e : a perda de classificação habitual. A nn.CrossEntropyLoss do PyTorch calcula-a a partir das pontuações em bruto do modelo, chamadas logits, e aplica internamente a log-softmax; a sua entrada não é o vetor de probabilidades . Com a distribuição suave de um modelo professor como , todas as classes contam em proporção da probabilidade do professor. A destilação clássica treina um modelo pequeno com as probabilidades de um modelo grande desta forma. Para o alvo , dois modelos têm estas entropias cruzadas :
O segundo modelo coincide com o alvo, e nenhum modelo pode fazer melhor. Esse mínimo, 0.325 aqui, é , a entropia de . Só é 0 para um alvo one-hot: quando o próprio alvo é incerto, resta alguma perda que nenhum modelo consegue remover.
A divergência KL subtrai esse mínimo e mantém apenas a perda causada por diferir de . Escreve-se com uma barra dupla , que apenas separa os dois argumentos; não é a barra de probabilidade condicional de Probabilidade condicional e a probabilidade de texto nem as barras de comprimento da referência de vetores. Os artigos usam-na em vez de uma vírgula para marcar que a ordem importa: a média corre sobre resultados extraídos do primeiro argumento.
Para o primeiro modelo acima, . A KL é 0 quando as duas distribuições coincidem e positiva caso contrário.
A ordem altera as discrepâncias que são penalizadas. Um termo com e é infinito, pelo que penaliza por atribuir probabilidade zero a algo que pode produzir. Os resultados com não acrescentam nada (por convenção ), pelo que não contribuem com penalização direta mesmo que . Trocar os argumentos dá , que é infinita sempre que e . Os resultados com passam agora a não acrescentar nada, mesmo que . Com como alvo, chama-se KL direta (forward) e KL inversa (reverse).
Para e , a KL direta é infinita, porque falha um resultado que produz, enquanto a KL inversa é apenas : o resultado que ignora não acrescenta nada. Para e , a KL direta é a 0.37 encontrada acima, calculada aqui termo a termo, e a KL inversa difere:
Esta assimetria é a razão por que a KL se chama divergência e não distância.
Como , e a entropia de um professor fixo não depende do aluno, a entropia cruzada face a um professor fixo dá ao aluno os mesmos gradientes que . Alterar um parâmetro do aluno altera as duas perdas na mesma quantidade, pelo que as suas derivadas usadas no treino são iguais; Gradientes e otimização explica esse cálculo. Isto permite que o código de classificação e de destilação clássica use a entropia cruzada. A troca só funciona com o professor em primeiro lugar. Com o aluno em primeiro lugar, , e a entropia do próprio aluno muda à medida que ele treina, pelo que os dois já não dão os mesmos gradientes.
Vetores e matrizes
As equações de arquitetura descrevem cálculos sobre arrays de números. A forma de um array diz-lhe como os seus números estão organizados, que operações são válidas e o que essas operações produzem. Um vetor é uma lista ordenada de números. Uma matriz organiza números em linhas e colunas. No código de ML, tensor é o termo geral para estes arrays numéricos, incluindo arrays com mais de dois eixos. Um eixo é uma dimensão ao longo da qual se indexa o array: uma matriz tem um eixo das linhas e um eixo das colunas.
O estado oculto de um token é um vetor de números calculado dentro do modelo para representar esse token. Suponha que processamos em conjunto um lote de sequências, cada uma com posições de token, e que cada estado oculto contém números. O array de estados ocultos tem a forma [B, T, d], que os artigos também escrevem como . Os seus três eixos selecionam a sequência, a posição do token e o número dentro do vetor desse token. Por exemplo, [2, 3, 4] contém duas sequências, três vetores de token por sequência e quatro números por vetor: 24 números no total. Aqui é a largura do vetor. A forma lista os três tamanhos; multiplicá-los dá o número de entradas.
Os artigos escrevem muitas vezes as formas como pertença a um conjunto: significa que é um vetor de números reais, e significa que é uma matriz com linhas e colunas. As letras a negrito marcam por vezes vetores ou tensores, mas é a definição do artigo que determina a forma.
Na tabela abaixo, e são vetores coluna: os seus números estão dispostos na vertical. O sobrescrito significa transposta: trocar linhas e colunas. Assim, é uma linha com os mesmos números da coluna . O e o maiúsculos aqui nomeiam matrizes; já não significa o tamanho do lote.
| Expressão | Valores que usa | O que a operação faz | Resultado |
|---|---|---|---|
| — produto escalar | Dois vetores coluna, cada um com entradas | Multiplicar as entradas correspondentes e somar os produtos: | Um número |
| — produto externo | Uma coluna com entradas e uma coluna com entradas | Multiplicar cada entrada de por cada entrada de | Uma matriz ; a entrada é |
| — produto de matrizes | com linhas e colunas; com linhas e colunas | Para a entrada , multiplicar os números correspondentes da linha de e da coluna de e somar | Uma matriz ; o número de colunas de tem de ser igual ao número de linhas de |
| — produto elemento a elemento | Dois arrays com a mesma forma | Multiplicar as entradas em posições correspondentes, sem as somar | Um array com a mesma forma |
| — concatenação | Colunas e com e entradas | Colocar as entradas de a seguir às de | Uma coluna com entradas; verifique a convenção do artigo para o eixo de junção |
Para uma comparação concreta, tome e . Mover a transposta altera tanto o cálculo como o resultado:
O produto escalar dá uma única pontuação, como na comparação consulta–chave da atenção. O produto externo mantém um valor separado para cada par de entradas; a atualização da Gated DeltaNet usa-o para construir uma atualização de matriz a partir de dois vetores.
Um produto de matrizes pode ser reagrupado, , mas não reordenado; a derivação da MLA usa o reagrupamento para evitar reconstruir as chaves. O NumPy escreve a multiplicação de matrizes como @ e o produto elemento a elemento como *. Os artigos não herdam as regras de broadcasting do NumPy: somar um vetor a uma matriz exige um eixo indicado. Os artigos também divergem quanto a um vetor ser uma linha ou uma coluna: a atenção empilha os tokens como linhas de , enquanto a MLA, a Gated DeltaNet e a LoRA escrevem com vetores coluna, e a nn.Linear do PyTorch calcula x @ W.T sobre linhas.
Uma equação de arquitetura também pode descrever o tamanho de um vetor, restringir as matrizes permitidas ou reorganizar um produto:
| Notação | Significado |
|---|---|
| O comprimento euclidiano; , sem a raiz, aparece na perda do DDPM | |
| A soma dos valores absolutos | |
| A norma espectral: o maior fator pelo qual aumenta o comprimento de um vetor; a mHC mantém-na no máximo em 1 | |
| O número de colunas independentes; a atualização da LoRA tem posto no máximo | |
| O determinante: é o fator pelo qual escala o volume, e o sinal regista se inverte a orientação; o exemplo de mudança de variáveis no Apêndice B deste artigo usa-o | |
| Todas as entradas são não negativas, como na mHC; é uma condição diferente, semidefinida positiva: para todo o | |
| , | A matriz identidade (1 na diagonal, 0 nas restantes entradas, pelo que ); um vetor de uns |
| Transpor um produto inverte a ordem; as secções de RoPE e MLA da Parte 2 usam-no |
Gradientes e otimização
O treino usa derivadas para decidir como alterar os parâmetros do modelo. Seja uma perda escalar e o vetor de todos os parâmetros; é uma entrada desse vetor.
A derivada parcial é um número, avaliado nos valores atuais dos parâmetros. Mede a taxa de variação da perda quando só muda e os outros parâmetros ficam fixos. Leia-a como «a derivada parcial da perda em relação ao parâmetro ».
O gradiente reúne esses números de todos os parâmetros num só vetor. A sua entrada é . O símbolo chama-se nabla; aqui significa «tome o gradiente». Com apenas um parâmetro, o gradiente tem uma entrada igual à derivada habitual.
Por exemplo, tome . Em e :
A primeira derivada parcial, 4, significa que aumentar em 0.01 faz subir a perda aproximadamente 0.04, enquanto fica fixo. O gradiente contém esta informação para os dois parâmetros. A descida do gradiente subtrai a derivada de cada parâmetro, multiplicada por uma taxa de aprendizagem positiva que controla o tamanho do passo:
Com , o exemplo passa de para , e a perda desce de 7 para 3.04. Para uma perda diferenciável com gradiente não nulo, um passo suficientemente pequeno reduz a perda. Um gradiente nulo não dá atualização.
O subscrito em diz o que varia. varia os parâmetros; varia a entrada, e os artigos de difusão chamam-lhe a pontuação (score), que nada tem a ver com a pontuação de um benchmark.
Uma jacobiana regista derivadas para várias saídas. Uma camada de uma rede neuronal pode produzir muitos números, como as componentes do estado oculto de um token. Para descrever como cada saída responde a cada entrada, reúnem-se as derivadas parciais numa matriz chamada jacobiana. Para com números de entrada e números de saída, a sua forma é : as linhas correspondem às saídas, as colunas às entradas, e a entrada mede como a saída muda quando a entrada muda.
Por exemplo, seja uma função que toma dois números e devolve e . A sua jacobiana é
A segunda coluna diz que aumentar em 0.1 mantendo fixo faz subir em 0.2 e descer em 0.1. Este exemplo é linear, pelo que a sua jacobiana é constante. Para uma função não linear, as entradas podem depender da entrada atual e descrevem pequenas variações locais. Com uma única saída escalar, a jacobiana tem uma linha: as mesmas derivadas do gradiente, transpostas segundo a nossa convenção de vetores coluna. Deep Learning, §4.3, dá as definições gerais.
A retropropagação (backpropagation) usa estas derivadas para calcular o gradiente da perda através de camadas sucessivas. O exemplo de mudança de variáveis no Apêndice B deste artigo usa outra propriedade: o valor absoluto do determinante de uma jacobiana quadrada dá o fator local de escala do volume, necessário para ajustar uma densidade de probabilidade.
No treino, as derivadas descrevem variações locais; um objetivo de otimização enuncia o que as atualizações devem minimizar ou maximizar. Os artigos distinguem o melhor valor de um objetivo dos parâmetros que o atingem: é o menor valor de , enquanto dá os valores dos parâmetros que o atingem. Para , o mínimo é 0 e o argmin é 3. Um argmin especifica o resultado pretendido, mas deixa em aberto o algoritmo de atualização.
Por exemplo, o MiniLLM escreve o seu objetivo como (equação 1), em que é o modelo aluno e o professor com quem aprende. A secção 2.2 deriva depois um gradiente e modifica-o para tornar o treino mais estável; a equação (7) é o gradiente usado nas atualizações. O exemplo da destilação on-policy explica essas alterações. Ler apenas o argmin perdê-las-ia.
Um stop-gradient, , passa para a frente inalterado mas bloqueia os gradientes através dele, como .detach() no PyTorch. Duas expressões com o mesmo valor direto podem treinar de forma diferente se uma delas for separada do grafo. No exemplo da GRPO, o Hugging Face TRL trata a log-probabilidade do modelo antigo como fixa. No atalho de destilação discutido pelo DeepSeek-V4, uma log-razão professor–aluno separada do grafo fornece um peso fixo à atualização.
Conjuntos e restrições
Uma restrição enuncia que valores são permitidos. Os artigos expressam muitas vezes restrições com conjuntos: coleções de membros distintos, escritas entre chavetas, como . A ordem não importa, pelo que nomeia o mesmo conjunto. As entradas repetidas contam apenas uma vez. Em comparação, os parênteses de um vetor como descrevem uma lista ordenada: é um vetor diferente.
Depois de um artigo definir um conjunto, pode testar a pertença, combinar conjuntos, contar os seus membros ou enunciar uma condição sobre eles. Tome e :
| Notação | Significado | Exemplo e como ler |
|---|---|---|
| Pertença: pertence a | : 2 é um membro de | |
| União: incluir todos os membros de qualquer dos conjuntos | ; incluir o 3 só uma vez | |
| Interseção: manter apenas os membros partilhados pelos dois conjuntos | ||
| O número de membros distintos | ||
| «Para todo»: uma condição tem de se verificar para todos os membros indicados | : todos os membros de são positivos | |
| «Existe»: pelo menos um membro tem de satisfazer a condição | : tem um membro maior do que 2, o 3 |
A notação de forma de Vetores e matrizes também nomeia conjuntos: é o conjunto de todos os vetores de números reais, e o conjunto de todas as matrizes reais com linhas e colunas. Assim, especifica que forma tem de ter.
A notação de construção de conjuntos descreve um conjunto por uma condição: lê-se «os membros de que satisfazem a condição», como a compreensão de conjuntos de Python {x for x in S if condition(x)}. A barra significa «tal que», não probabilidade condicional; alguns artigos usam antes dois pontos. Os exemplos desta série incluem as matrizes permitidas da mHC, os especialistas selecionados da MoE e os tokens selecionados da atenção esparsa.
O DAPO, um método de treino que filtra grupos de respostas geradas, só mantém uma pergunta quando algumas respostas estão corretas e outras erradas. Para respostas amostradas e a resposta de referência , escreva o conjunto dos índices das respostas corretas como
O filtro é . Usar índices torna a contagem explícita: duas amostras com texto idêntico contam na mesma como duas respostas. O artigo do DAPO escreve o conjunto sobre as respostas ; lido à letra como um conjunto de textos, essa forma conta duas respostas idênticas uma só vez.
Exercícios
- Formas. é , é e é . Quais são as formas das pontuações e da saída? Sobre que eixo corre a softmax?
- Softmax. Calcule a softmax de . Somar 100 às duas entradas altera o resultado?
- Médias. Uma resposta tem um único token com perda 4; outra tem três tokens com perda 0. Calcule a média por token e a média por resposta.
- Condicionamento. De 200 respostas, 120 estão corretas, 80 passam a validação de formato e 60 cumprem ambas. Encontre e .
- KL. Para um professor e um aluno , calcule as duas direções da KL.
- Conjuntos. O DAPO só mantém uma pergunta se , em que contém os índices das respostas corretas entre amostras. Com , mantém uma pergunta cujas respostas pontuam ? E uma cujas respostas pontuam ? A resposta à primeira muda se as quatro amostras contiverem texto correto idêntico?
Respostas:
-
As pontuações são e a saída é . A softmax corre ao longo das seis chaves da linha de cada consulta.
-
. Somar o mesmo número a todas as entradas deixa a softmax inalterada, mas calcular diretamente provoca overflow em floats de 32 bits.
-
As duas médias:
-
e .
-
, e , porque o aluno põe probabilidade num resultado que o professor exclui.
-
Não: tem quatro membros, o que é igual a . Sim: tem três membros, entre 0 e 4. O texto idêntico não altera a resposta à primeira: são quatro amostras separadas, pelo que os seus quatro índices continuam a contar.
Apêndice A. Letras gregas
Os papéis são exemplos comuns; cada artigo continua a definir o que os seus símbolos significam.
| Letra | Nome | Papéis comuns nos artigos de ML |
|---|---|---|
| alfa | Um peso de mistura ou uma escala; um decaimento (Gated DeltaNet); um calendário de ruído (DDPM) | |
| beta | Uma intensidade de penalização (DPO, GRPO); uma intensidade de escrita (Gated DeltaNet); um calendário de ruído (DDPM) | |
| gama | Um fator de desconto em RL; um tamanho de passo (a atualização do viés no DeepSeek-V3) | |
| delta | Uma diferença ou uma variação | |
| épsilon | Ruído (DDPM); um intervalo de clipping (GRPO); um pequeno estabilizador | |
| eta | A taxa de aprendizagem | |
| teta | Parâmetros do modelo; os ângulos de rotação da RoPE | |
| lambda | Um peso de regularização; um valor próprio | |
| mi | Uma média; o número de passos de gradiente por lote no Algoritmo 1 do DeepSeekMath | |
| pi | Uma política; é o operador de produto | |
| ró | Uma razão de probabilidades, como na secção da GRPO da Parte 3; uma correlação | |
| sigma | A sigmoide (DPO); um desvio-padrão; uma covariância; é o operador de soma | |
| tau | Uma temperatura; um limiar; uma trajetória em RL | |
| fi | Os parâmetros de uma segunda rede, como um codificador; características; um ângulo | |
| psi | Os parâmetros de outra rede, como o modelo de valor na PPO do DeepSeekMath | |
| ómega | Uma frequência; é também um limite inferior em complexidade, ou um conjunto de resultados |
Variantes como e são normalmente a mesma letra com outro tipo de letra, mas um artigo pode usar ambas para variáveis diferentes.
Apêndice B. Outras famílias de equações
Formas de equações que esta série não percorre, com as definições de que cada uma precisa:
Modelos de espaço de estados seletivos. Um modelo de espaço de estados processa uma sequência atualizando um estado guardado em cada passo. Uma atualização da forma , combina o estado anterior com a entrada atual e depois calcula uma saída. Aqui é a entrada atual, o estado guardado e a saída. As matrizes , e transformam, respetivamente, o estado anterior, acrescentam a contribuição da entrada e produzem a saída. As barras marcam parâmetros convertidos de um modelo em tempo contínuo para passos discretos; não significam médias. No Mamba, os parâmetros de atualização dependem da entrada atual, que é o que «seletivo» significa.
Equações diferenciais estocásticas. descreve como um estado muda com o tempo : é a sua taxa de variação. Uma equação diferencial estocástica (SDE) acrescenta variações aleatórias, . Aqui descreve a variação determinística, define a escala do ruído e é um incremento de movimento browniano. Para a aproximar em código, o método de Euler–Maruyama usa um pequeno passo de tempo e substitui por ruído gaussiano de variância . A secção 5.1 do livro de Tianhua Chen, The Little Book of Generative AI Foundations, dá uma atualização deste tipo; a §6.4 do mesmo livro usa SDEs para descrever modelos de difusão.
Mudança de variáveis. Transformar uma variável aleatória altera a sua densidade conforme a transformação altera o volume local. Suponha que faz a correspondência entre espaços com a mesma dimensão, e que tanto como a sua inversa são diferenciáveis. As densidades antes e depois da transformação, e , satisfazem . A inversa recupera a partir de . A sua jacobiana é a matriz quadrada das primeiras derivadas; o valor absoluto do seu determinante corrige a variação local do volume. Por exemplo, se numa dimensão, a densidade passa a : duplicar a largura reduz a densidade a metade. Os normalizing flows usam transformações invertíveis deste tipo para modelar densidades; o livro de Tianhua Chen, §7.1, explica o método.
Objetivos min–max. Nas generative adversarial networks (GANs), um gerador produz exemplos e um discriminador tenta distingui-los dos dados reais. O objetivo mede o sucesso do discriminador: maximiza-o enquanto o minimiza. A meta (equação 1) diz: para cada gerador possível, considere o melhor discriminador contra ele e depois escolha o gerador com o menor objetivo resultante. O treino não resolve essa maximização interna com exatidão. O Algoritmo 1 do artigo alterna passos de subida do gradiente em com um passo de descida do gradiente em ; as suas experiências usaram .
O simplex de probabilidade. Um vetor de probabilidade tem entradas não negativas que somam 1. O conjunto de todos esses vetores com entradas chama-se simplex de probabilidade, escrito . Toda a saída de uma softmax está nele. Aqui nomeia um conjunto, e o sobrescrito é a sua dimensão, não uma potência: depois de escolhidas probabilidades, a última tem de fazer a soma igualar 1. Com duas escolhas, toda a distribuição tem a forma para , pelo que só um número é livre.
Normalização. A normalização reescala valores pela média e pela dispersão de um grupo escolhido. Uma forma comum é , em que é uma média, uma variância e um número positivo pequeno que evita a divisão por zero. A equação, por si só, não diz que entradas são usadas para calcular a média e a variância. Para um lote de vetores de características, a batch normalization calcula-as separadamente para cada característica ao longo dos exemplos. A layer normalization de um Transformer calcula-as separadamente para cada token ao longo das suas características. Verifique os eixos especificados ao comparar implementações.
Fontes e versões
Os números de secção e de equação referem-se às versões ligadas aqui.
- Tianhua Chen. The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer. 2026. Versão 2; a §2.4 e a §3.2 tratam da desigualdade de Jensen e do ELBO, a §5.1 e a §6.4 do ruído em tempo contínuo.
- Vaswani et al. Attention Is All You Need. 2017. Versão 7, §3.2.1, equação (1) e nota de rodapé 4.
- Dai et al. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. 2024. Segmentação fina de especialistas e contagens de combinações, §3.1; ablação, §4.4 e Figura 3.
- Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024. Versão 3, §1.1, §4.1.1, equações (1)–(4) e Algoritmo 1.
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. 2024. Versão 5, §2.1.1–2.1.3, equações (9)–(19) e Apêndice C.
- DeepSeek-AI. DeepSeek-V3 Technical Report. 2024–2025. Versão 2, §2.1.2, equações (12)–(18).
- DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025. Versão 1: §2.2.1, equações (1)–(3). Versão 2, 2026: §2.1 e Suplemento A.3.
- DeepSeek-AI. DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence. 2026. Versão 1: §2.2, equações (1)–(8); §5.1.2, equação (29).
- Rafailov et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. 2023–2024. Versão 3, §4, equação (7).
- Gu et al. MiniLLM: Knowledge Distillation of Large Language Models. 2023–2024. Versão 4, §2.1, equação (1), e §2.2, equações (2) e (7).
- Yu et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. 2025. Versão 2, §3.2–3.3, equações (11)–(12).
- Gu e Dao. Mamba: Linear-Time Sequence Modeling with Selective State Spaces. 2023–2024.
- Yang et al. Gated Delta Networks: Improving Mamba2 with Delta Rule. 2024–2025. Versão 3, §3.1, equação (10) e §3.3–3.4.
- Ho, Jain e Abbeel. Denoising Diffusion Probabilistic Models. 2020. Versão 2, §2, equações (4)–(5); §3.2, equação (12); §3.4, equação (14); e Algoritmos 1–2.
- Goodfellow et al. Generative Adversarial Nets. 2014. Equação (1) e Algoritmo 1.
- Chen et al. Evaluating Large Language Models Trained on Code. 2021. Versão 2, §2.1, equação (1) e Figura 3.
- Hugging Face TRL.
GRPOTrainereGRPOConfigno commitc6eac19, outubro de 2026. - Stanford CS229. Probability Theory Review e Linear Algebra Review and Reference.
- Dive into Deep Learning. Preliminaries.
- Britz, Goldie, Luong e Le. Massive Exploration of Neural Machine Translation Architectures. 2017. Versão 2, Tabela 5; citado em Attention Is All You Need para a comparação entre atenção de produto escalar e atenção aditiva.