Как читать математику в статьях по AI на arXiv: практическое руководство
Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Умение читать математику в статьях по AI полезно инженеру, которому нужно разобраться в модели, воспроизвести метод или оценить заявленный экспериментальный результат. В этом руководстве разбирается, как расшифровывать нотацию, проверять уравнение на маленьких числах и связывать его с остальным текстом статьи и с реализацией. Предполагается, что вы умеете читать код, но не обязаны знать научную нотацию.
Уравнение сжимает в одну строку сразу несколько решений: над какими объектами выполняются операции, какие у них размерности, какие значения берутся выборкой, а что обучается или остаётся фиксированным. Восстановить эти детали — хороший первый шаг. Объяснить, почему метод работает, и точно реализовать его — задачи посложнее.
Начните с разбора аттеншна: в нём одно уравнение связывается с формами массивов, маленькими числами и работающим кодом на Python. Справочник по нотации объясняет выражения, которые встретятся в других статьях. В остальных частях серии тот же метод применяется к уравнениям из конкретных статей: уравнениям архитектуры, таким как RoPE, MLA и LoRA; целевым функциям обучения, таким как DPO и GRPO; генеративным моделям и метрикам, таким как ELBO, диффузия и pass@k. Эти части ещё не вышли, поэтому разборы, на которые ссылается эта часть, пока без ссылок. За более подробным изложением основ обратитесь к книге Tianhua Chen The Little Book of Generative AI Foundations: в ней развиваются линейная алгебра и теория вероятностей, лежащие в основе генеративных моделей.
Аттеншн: читаем по одному символу
Аттеншн получает выходной вектор как взвешенное среднее векторов значений (value). Веса он находит, сравнивая вектор запроса (query) для выходной позиции с вектором ключа (key) каждой доступной входной позиции. Матрицы , и собирают векторы запросов, ключей и значений. Scaled dot-product attention объединяет эти шаги в уравнении (1) из §3.2.1 (§ означает «раздел») статьи Attention Is All You Need:
Определения находятся в тексте, а не в уравнении. В абзаце перед уравнением (1) сказано, что у запросов и ключей размерность , а у значений — . Метод берёт скалярное произведение каждого запроса со всеми ключами, делит каждое на и применяет softmax, «чтобы получить веса значений». Запросы «собраны в матрицу », а ключи и значения — в и . Значит, каждая строка этих матриц — вектор одного токена, а softmax выдаёт по одному набору весов на каждый запрос. Обучаемые матрицы, которые превращают векторы токенов в , и , появляются позже, в §3.2.2.
Формы и роли. Attention head (далее — head) выполняет одно такое вычисление со своими векторами запросов, ключей и значений. Прежде чем читать операторы, запишите их формы. Для одного head с запросами и ключами:
| Символ | Форма | Что это | Откуда берётся |
|---|---|---|---|
| одна строка запроса на каждую выходную позицию | векторы токенов, умноженные на обучаемую матрицу | ||
| одна строка ключа на каждую позицию, доступную head | векторы токенов, умноженные на обучаемую матрицу | ||
| одна строка значения на каждый ключ | векторы токенов, умноженные на обучаемую матрицу | ||
| транспонированная: строки становятся столбцами | те же числа, что и в | ||
| число | ширина каждого запроса и ключа | фиксированная настройка: 64 в базовом Transformer |
Форму в статьях задают, указывая множество, которому принадлежит матрица: означает матрицу вещественных чисел с строками и столбцами, то есть массив формы [n, dk].
Читайте изнутри наружу.
-
умножает матрицу на матрицу . Общая размерность сворачивается суммой, и получается таблица оценок . Элемент — это скалярное произведение запроса и ключа : перемножьте соответствующие элементы, затем сложите произведения. При фиксированных длинах векторов эта оценка тем больше, чем ближе направления векторов.
-
Деление на не даёт оценкам расти вместе с шириной вектора. Почему ненормированные скалярные произведения растут, показывает сноска 4 статьи. Допустим, компоненты запроса и ключа независимы друг от друга (знание одних ничего не говорит о других), и у каждой среднее 0 и дисперсия 1 (средний квадрат отклонения от среднего). Тогда:
В этих строках использованы два правила про независимые числа. Первое: произведение двух независимых чисел, у каждого из которых среднее 0 и дисперсия 1, тоже имеет дисперсию 1. Второе: при сложении независимых чисел их дисперсии складываются, поэтому произведений дают дисперсию . Стандартное отклонение — квадратный корень из дисперсии, . Деление каждой оценки на уменьшает разброс в то же число раз, обратно до 1.
Почему эти два правила верны
Дисперсия при нулевом среднем. Дисперсия — это средний квадрат отклонения от среднего. Когда среднее равно 0, квадрат отклонения от среднего — просто квадрат самого числа, так что дисперсия равна среднему значению квадрата. Поэтому у компоненты со средним 0 и дисперсией 1 величина в среднем равна 1.
Среднее произведения. Для независимых чисел среднее произведения равно произведению средних. Возьмём число , которое с равной вероятностью равно 1 или 3, то есть в среднем 2, и число , которое с равной вероятностью равно 1 или 5, то есть в среднем 3. Независимость означает, что принимает каждое из своих значений одинаково часто, каким бы ни оказалось , поэтому все четыре пары равновероятны. При произведения равны 1 и 5, их среднее . При они равны 3 и 15, среднее . В обоих случаях среднее равно , поэтому по обоим значениям оно составляет , то есть . Без независимости правило ломается: если бы равнялось 5 всякий раз, когда равно 3, и 1, когда равно 1, встречались бы только произведения 1 и 15, а их среднее — 8. Википедия формулирует это правило для любых независимых случайных величин, называя среднее «математическим ожиданием» («expected value»): independence and expectation.
Правило 1: у одного произведения дисперсия 1. Возьмём одно произведение . Его среднее равно произведению средних, , поэтому его дисперсия — среднее значение . Квадраты независимы, потому что независимы и , и каждый в среднем равен 1, так что дисперсия равна . Общая формула — variance of a product of independent variables.
Правило 2: дисперсии независимых слагаемых складываются. Обозначим произведения , тогда скалярное произведение — это сумма . Слагаемые независимы, потому что каждое использует свои компоненты, и у каждого среднее 0 и дисперсия 1. У суммы среднее тоже 0, поэтому её дисперсия — среднее значение её квадрата. Если умножить сумму саму на себя, получится по одному произведению на каждую пару слагаемых, то есть сетка :
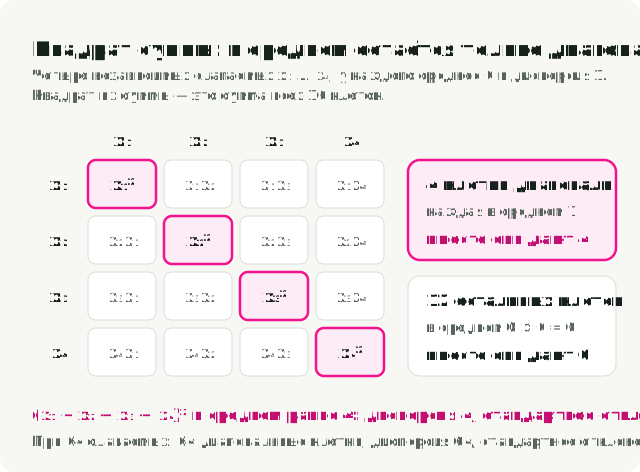
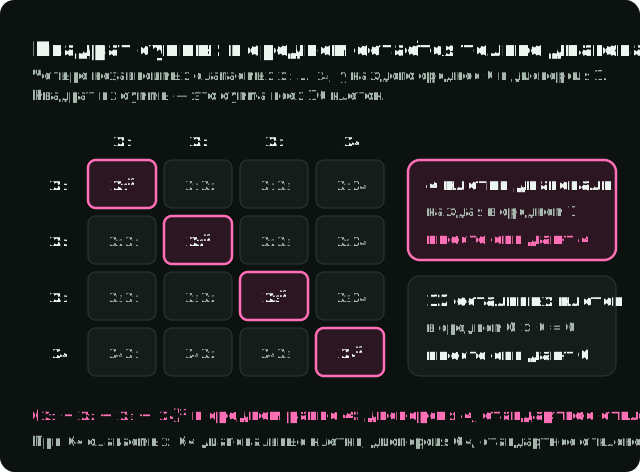
Диагональные клетки — это квадраты , и каждая в среднем равна 1. Любая другая клетка перемножает два разных независимых слагаемых, поэтому её среднее равно произведению их средних, : положительные и отрицательные значения взаимно сокращаются. Остаются только диагональных клеток, поэтому дисперсия суммы равна , а стандартное отклонение — . Разброс растёт как квадратный корень из ширины, потому что почти вся сетка сокращается. Общую формулировку Википедия приводит как variance of a sum of uncorrelated variables; независимые величины всегда некоррелированы, поэтому правило охватывает и их.
При сырые оценки обычно разбросаны примерно в пределах ; после масштабирования — примерно в пределах при любой ширине.
Сильно разбросанные оценки насыщают softmax (шаг 3), и его градиенты исчезают. Если одна оценка в строке намного выше остальных, softmax даёт этому ключу вес, близкий к 1, а всем остальным — близкий к 0. Небольшое изменение любой оценки тогда почти не двигает веса, поэтому градиент, доходящий до запросов и ключей, близок к нулю, и обучению почти нечем их подстраивать. Статья предлагает это как вероятное объяснение более раннего результата: без масштабирования dot-product attention при большом работал хуже additive attention, более старой формы, где оценка запроса и ключа считается небольшой сетью (Britz et al., 2017). Сами градиенты статья не измеряет.
-
Softmax превращает каждую строку оценок в веса. Пусть — одна строка масштабированных оценок. Экспонента , которую пишут и как , использует константу . Тогда , где — просто второе имя индекса, так что сумма идёт по всем ключам строки. Веса положительны, и каждая строка в сумме даёт 1.
-
Умножение весов на значения сворачивает ось ключей. Строка выхода — это взвешенное среднее строк значений, где вес показывает, насколько хорошо каждый ключ подошёл запросу .
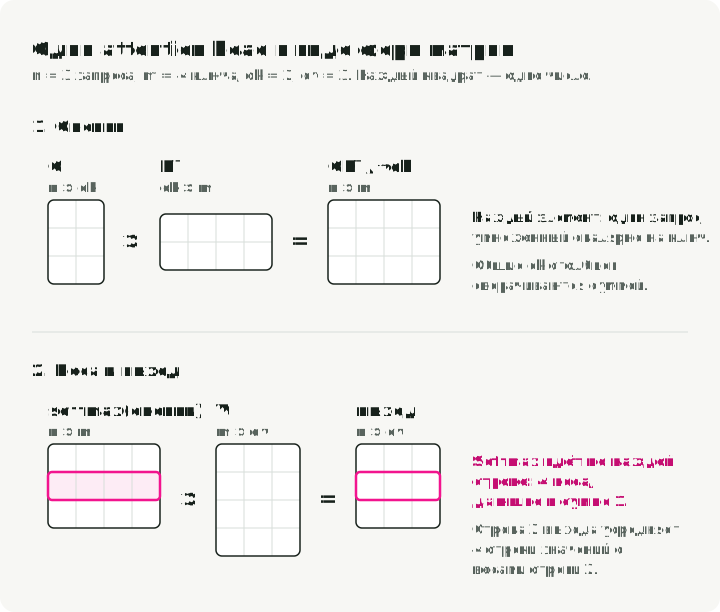
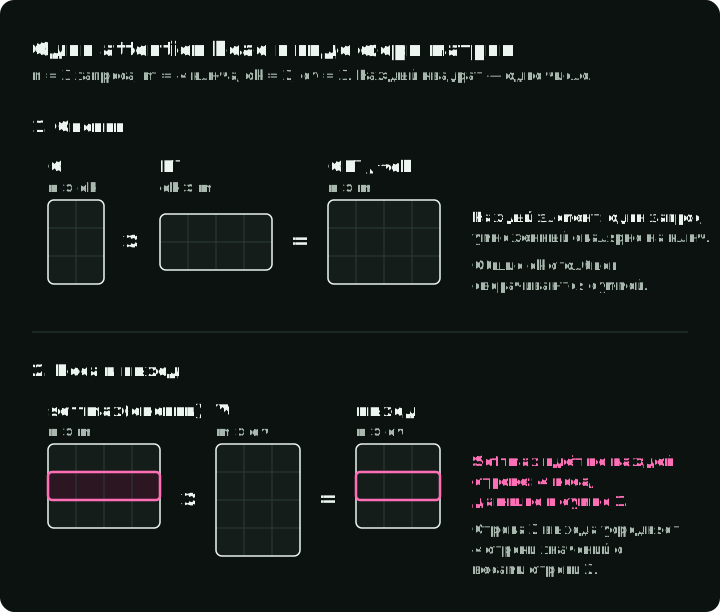
Посчитайте квадраты на рисунке: каждое произведение убирает ось, общую для двух таблиц.
Проверьте на двух числах. Возьмём один запрос и два ключа с масштабированными оценками , выбранными так, чтобы экспоненты получились 1 и 3, и значения и . На рисунке это разобрано по одной операции на столбец:
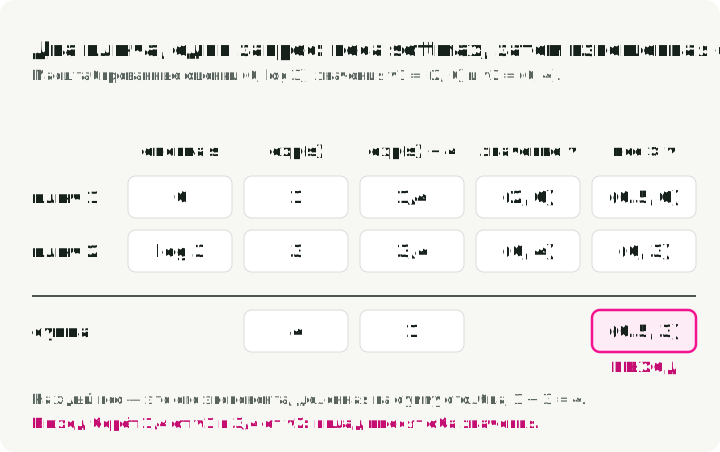
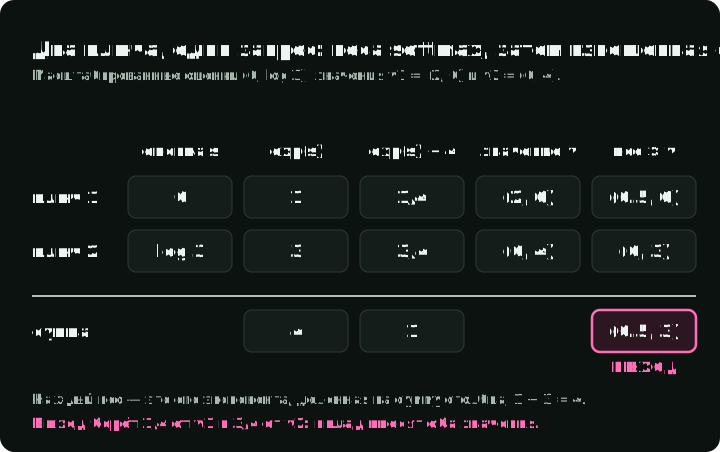
Аттеншн смешал оба значения; он не выбрал токен, который подошёл лучше.
Сравните с кодом. Функция на NumPy ниже реализует один head. k.T — транспонирование. axis=1 — ось ключей, поэтому строка каждого запроса нормируется отдельно. Максимум строки вычитается перед np.exp: если прибавить одно и то же число ко всем оценкам строки, оно сократится в отношении softmax, и результат не изменится, но большие оценки перестанут вызывать переполнение. Необязательная маска задаёт заблокированным оценкам значение , из-за чего их веса становятся ровно нулевыми. Декодер использует такую маску, чтобы каждый токен не смотрел на более поздние токены (§3.2.3 статьи).
Сохраните блок как attention_example.py и выполните uv run --with numpy python attention_example.py. Проверки проходят молча.
import numpy as np

def attention(q, k, v, allowed=None):
    """One head. q: [n, dk], k: [m, dk], v: [m, dv], allowed: bool [n, m]."""
    scores = q @ k.T / np.sqrt(q.shape[1])  # [n, m]
    if allowed is not None:
        if not allowed.any(axis=1).all():
            raise ValueError("every query needs at least one allowed key")
        scores = np.where(allowed, scores, -np.inf)
    scores = scores - scores.max(axis=1, keepdims=True)
    weights = np.exp(scores)
    weights = weights / weights.sum(axis=1, keepdims=True)  # rows sum to 1
    return weights @ v, weights  # [n, dv], [n, m]

# The two-key example from the text.
out, w = attention(
    np.array([[1.0]]),
    np.array([[0.0], [np.log(3.0)]]),
    np.array([[2.0, 0.0], [0.0, 4.0]]),
)
np.testing.assert_allclose(w, [[0.25, 0.75]])
np.testing.assert_allclose(out, [[0.5, 3.0]])

# A causal mask: query i may attend only to keys 0..i.
x = np.random.default_rng(0).normal(size=(3, 4))
out, w = attention(x, x, x, allowed=np.tril(np.ones((3, 3), dtype=bool)))
assert out.shape == (3, 4)
np.testing.assert_allclose(w.sum(axis=1), 1.0)
assert np.all(w[np.triu_indices(3, k=1)] == 0)
Запрос, у которого все ключи заблокированы, — случай, который уравнение оставляет открытым: каждый вес в его строке был бы равен . Функция выбрасывает ошибку вместо того, чтобы вернуть NaN.
От одного head к нескольким. Базовый Transformer запускает параллельно восемь head, у каждого свои обучаемые матрицы для получения , и и . Он конкатенирует их выходы и умножает результат на ещё одну обучаемую матрицу, (Attention Is All You Need, §3.2.2).
Реализация может также обрабатывать батч: несколько входных последовательностей сразу. Например, scaled dot-product attention в PyTorch принимает тензор запросов Q формы [batch, heads, n, d_k]. Первые два измерения выбирают последовательность и head; Q[b, h] — матрица [n, d_k] для этой пары. Формула аттеншна применяется к каждой паре отдельно. Функция на NumPy здесь обрабатывает только одну такую пару: её операции .T и axis=1 рассчитаны на двумерные входы.
Шесть вопросов к любому уравнению
| Вопрос | Ответ для аттеншна |
|---|---|
| Что возвращает уравнение и какой формы результат? | Матрицу : одна строка выхода на каждый запрос |
| Чем является каждый символ: данными, обученным весом, замороженной моделью, настройкой или выборкой? | , и вычисляются из токенов обучаемыми матрицами; — фиксированная настройка; выборки нет |
| По какому индексу или оси выполняется каждая операция? | Softmax идёт по ключам в строке каждого запроса; произведение весов на суммирует по ключам |
| Где находятся определения? | Абзац перед уравнением (1), сноска 4 и §3.2.2 для обучаемых проекций |
| Что даёт проверка на двух-трёх числах? | Веса и выход |
| Что пришлось решать коду, чего уравнение не определяет? | Вычитание максимума строки, значение для замаскированных оценок, строка без единого разрешённого ключа |
Какое утверждение делает уравнение
Аттеншн — вычисление: оно говорит, как получить выход из входов. Но статьи записывают и уравнения с другими задачами:
| Вид | Пример в этой серии | Что проверить |
|---|---|---|
| Вычисление | Выход аттеншна; сжатый вектор MLA | Форму каждого промежуточного результата |
| Определение | Оценка GRPO относительно других ответов | Что означает новое имя, чтобы можно было подставить его обратно |
| Целевая функция: потери для минимизации или оценка для максимизации | Потери DPO | Минимизируется она или максимизируется и по каким данным усредняется |
| Правило обновления | Градиентный спуск; память в Gated DeltaNet | Что меняется на каждом шаге и что остаётся фиксированным |
| Ограничение, или множество допустимых значений | Допустимые матрицы смешивания в mHC | Как статья получает значение, удовлетворяющее ограничению |
| Оценка границы: верхний или нижний предел величины | Evidence lower bound (ELBO) | Разность между двумя сторонами и когда она равна нулю |
| Оценщик (estimator) или метрика | pass@k | Что подсчитывается и по скольким сэмплам |
| Эмпирическая подгонка | Закон масштабирования DeepSeek LLM | Диапазон данных, на котором подогнана кривая |
Ограничение утверждает свойство, которым должен обладать результат. Для весов аттеншна это свойство такое: каждый вес неотрицателен, и каждая строка в сумме даёт 1. Softmax — вычисление, которое выдаёт веса с этим свойством. Одно требование ещё не говорит, что нужно использовать именно softmax.
утверждает, что два выражения равны. означает «определяется как»: оно даёт имя выражению. Определением можно назвать метрику, функцию потерь или множество допустимых значений, поэтому по одному нельзя сказать, какой вид уравнения из таблицы выше вы читаете.
Например, Evaluating Large Language Models Trained on Code, статья, в которой представили модель генерации кода Codex, использует для определения оценщика pass@k (уравнение 1). Эта метрика измеряет вероятность того, что хотя бы одна из сгенерированных программ пройдёт тесты. В техническом отчёте DeepSeek-V4 уравнение (2) объединяет два утверждения: определяет множество допустимых матриц, а требует, чтобы матрица смешивания модели принадлежала этому множеству. Определение использует , ограничение — , то есть «принадлежит». Разделы про pass@k и mHC разбирают эти примеры.
Как найти новое уравнение, его определения и его код
Раздел методов статьи описывает, как работает её модель или алгоритм обучения. Заголовок может быть «Method», «Architecture» или более конкретным. Авторы часто сначала объясняют существующий метод, а потом показывают, что изменили. Чтобы определить заявленный вклад, начните с описания новизны во введении. Например, DeepSeekMath, §1.1 называет Group Relative Policy Optimization (GRPO) — свой метод обучения моделей по оценённым ответам. Номера разделов и уравнений здесь относятся к статье по ссылке.
Затем сравните предлагаемый метод с более ранним, который он меняет. Это иллюстрируют две статьи:
- Изменение архитектуры. DeepSeek-V2 описывает стандартный multi-head attention в §2.1.1 и вводит multi-head latent attention (MLA) в §2.1.2. Стандартный аттеншн хранит ключи и значения каждого предыдущего токена. MLA хранит сжатый вектор, из которого их можно восстановить. Сравнение этих уравнений показывает, что модель хранит иначе; разбор MLA выводит выигрыш в памяти.
- Изменение обучения. DeepSeekMath, §4.1.1 приводит целевую функцию Proximal Policy Optimization (PPO) как уравнение (1), а GRPO — как уравнение (3). Обе используют преимущество (advantage): число, которое говорит, был ли ответ лучше или хуже ожидаемого. PPO оценивает его второй обучаемой сетью, value model, которая предсказывает награду, которую ещё предстоит получить после частичного ответа. GRPO вместо этого сравнивает награду за ответ с наградами за другие ответы на тот же вопрос. Разбор GRPO сравнивает эти слагаемые, используя нотацию целого ответа из DeepSeek-R1.
Найдите определения вокруг уравнения. Посмотрите предыдущий абзац, любое предложение вида «где …» после него, сноски и приложения. В Attention Is All You Need абзац перед уравнением (1) определяет размерности, а сноска 4 объясняет масштабирующий множитель. DeepSeek-V3 определяет большинство символов роутинга сразу после уравнения (15), а смещение — прямо перед уравнением (16). DeepSeek-V2 выводит MLA в уравнениях (9)–(19), а затем собирает вычисление в Приложении C.
Проверьте алгоритм и код. Блок алгоритма — это пронумерованный листинг псевдокода, задающий порядок операций. Algorithm 1 в DeepSeekMath показывает, когда генерировать ответы, а когда обновлять модель. Algorithm 1 в Denoising Diffusion Probabilistic Models (DDPM) определяет, как выбирать обучающее изображение, уровень шума и сам шум. Остальные детали решает реализация: по умолчанию np.std делит сумму квадратов отклонений на , а torch.std — на . Пример с GRPO показывает, как этот выбор меняет значения преимущества, вычисленные по одним и тем же наградам.
Версии arXiv могут переставлять разделы и повторять уравнения под новыми номерами, поэтому указывайте версию. В DeepSeek-R1 v1 целевая функция GRPO находится в §2.2.1, уравнения (1)–(3). В v2, опубликованной в январе 2026 года, это §2.1, а те же уравнения повторяются как (11)–(13) в Supplementary A.3. Ссылка без версии открывает последнюю, поэтому каждая ссылка на arXiv в этой серии содержит версию, по которой её проверяли.
Проверка прочтения с помощью LLM
Чат-модель может набросать таблицу символов, индекс каждой суммы и проверку на маленьких числах, если дать ей определения и попросить указать, чего не хватает. Текст, скопированный из PDF, сплющивает нижние и верхние индексы и дроби в одну строку; ссылки «HTML (experimental)» и «TeX Source» на странице аннотации arXiv дают чистый текст для вставки. Вставьте уравнение и окружающие его абзацы с таким промптом:
Below is equation (N) from <paper title, arXiv ID and version>, followed by
the paragraphs that define its symbols.

1. Make a table with one row per symbol: shape or type, meaning, and whether
   it is input data, a trained weight, a frozen model, a fixed setting or a
   random sample. Quote the sentence that defines it.
2. List every symbol the pasted text does not define. Do not guess them.
3. For every sum, mean, softmax, min or expectation, name the index or the
   distribution it runs over.
4. Work through the equation with the smallest numbers that use every term.
5. Say which kind of statement it is: a computation, definition, objective,
   update rule, constraint, bound, estimator or empirical fit.
Без шага 2 ничто не мешает модели заполнить недостающее определение привычным значением буквы, например прочесть в DPO как стандартное отклонение вместо сигмоиды. Цитаты из шага 1 делают таблицу проверяемой: найдите в PDF каждую из них, а строку, цитату из которой найти не удаётся, считайте догадкой.
Та же процедура в виде agent skills. paper-math-skills упаковывает этот раздел и справочник по нотации ниже в два skills, написанных для Claude Code; другие агенты, которые загружают файлы SKILL.md, тоже могут ими пользоваться. read-paper-math берёт зафиксированную версию arXiv, цитирует предложение, определяющее каждый символ, читает уравнение изнутри наружу и запускает проверку на маленьких числах. check-paper-math проверяет такое прочтение по статье: ищет каждую цитату, перезапускает числа и отмечает утверждения сильнее или слабее, чем в статье. В paper-math-readings лежат прочтения этих skills для частей 2–4, по одному на каждый из 15 разделов со строкой Source:.
Справочник по нотации
Если греческая буква незнакома, откройте справочник греческих букв в этой статье (Приложение A): там её название и типичные значения. Для дальнейшей практики с математикой в Stanford CS229 есть обзоры по теории вероятностей и линейной алгебре с упражнениями; Preliminaries в Dive into Deep Learning объясняют основы вместе с кодом.
Индексы, пометки и знаки отношений
Буквы — локальные имена переменных: каждая статья определяет свои. Нижние индексы обычно обозначают номера. может быть координатой вектора или примером в датасете, а — вектор модели для токена , его скрытое состояние (hidden state).
Верхние индексы в статьях о моделях часто служат метками. В верхний индекс в скобках — это, как правило, номер слоя, а не степень; в и из DeepSeek-V3 он отмечает общих и маршрутизируемых экспертов: тех, которыми пользуется каждый токен, и тех, которых выбирает роутер (см. пример роутинга в MoE). В DeepSeek-V2 и несут метки, а не показатели степени; пример с MLA определяет эти метки. — транспонирование, а — квадрат.
означает позиции с 1 по , включая , в отличие от среза в Python; статьи обычно считают с 1. означает все позиции до . выбирает строку , как срез в NumPy.
Пометки над буквой обычно меняют её смысл одним из следующих способов:
| Пометка | Обычное прочтение | Пример или исключение |
|---|---|---|
| Предсказание или оценка | Пример: в DeepSeekMath оценивает, насколько ответ оказался лучше ожидаемого | |
| Среднее | Исключение: в DDPM перемножает множители расписания шума с шага 1 по | |
| Возмущённая или неограниченная версия | Пример: в DeepSeek-V4 — матрица до нормализации, которая навязывает ей ограничения | |
| Оптимум | Исключение: в DPO — истинная награда, которую метод никогда не наблюдает | |
| Новое значение или промежуточное | Пример: в DeepSeek-V3 — вес эксперта до нормализации | |
| Обратная матрица | Не поэлементное обратное число: отменяет , (единичная матрица), и в общем случае |
Некоторые символы, кроме греческих букв, тоже выполняют несколько ролей:
| Символ | Значения |
|---|---|
| Условие в ; «такой, что» внутри множества | |
| Модуль числа; длина последовательности, как в , числе токенов в ответе в GRPO; размер множества | |
| «Выбирается из» в ; «примерно» в неформальном тексте | |
| Длина последовательности; температура softmax; число шагов диффузии | |
| Вектор запроса (аттеншн); вопрос (GRPO); модель-студент (дистилляция); энкодер (ELBO) |
Пять знаков показывают, как соотносятся две стороны. , иногда , определяет новое имя. отмечает приближение, как среднее по выборке в разделе Математическое ожидание и откуда берутся сэмплы. означает «пропорционально», с опущенной нормировочной константой: становится распределением только после деления на . означает «намного меньше», как в из DeepSeek-V2: сжатая ширина намного меньше суммарной ширины всех head. — присваивание, как в правиле обновления.
Суммы, подсчёты, интервалы и логарифмы
Крупный складывает слагаемые, а перемножает их. Индекс под оператором здесь начинается с 1 и идёт до верхней границы :
Индекс принадлежит оператору, как переменная цикла принадлежит своему циклу. В сумма идёт по , а определяет элемент выхода. Результат — вектор с одним элементом на каждое : записанное в развёрнутом виде произведение матрицы на вектор . Индексы в левой части говорят, какой формы выход.
Множитель перед суммой решает, что получает равный вес. Батч с ответом из 2 токенов и ответом из 8 токенов, где — потери на токене ответа (в GRPO — слагаемое, которое нужно максимизировать), можно усреднить двумя способами:
В первом каждый ответ получает вес , который делится между его токенами:
Во втором у каждого токена вес . GRPO выбирает ответов на каждый вопрос, а — число токенов в ответе . Тогда два усреднения записываются так, для GRPO из DeepSeekMath и для DAPO, более позднего варианта GRPO:
При это и выше. DAPO перешёл на усреднение по токенам (§3.3), потому что усреднение по ответам придавало токенам длинных ответов слишком малый вес: модель слишком мало училась на длинных хороших ответах и недостаточно штрафовала длинные повторяющиеся плохие.
Сумма может и считать. Статьи делают это с помощью индикатора: жирной единицы с условием, , которая равна 1, когда условие истинно, и 0, когда ложно. Некоторые статьи ставят условие в скобки или печатают вместо жирной единицы двойную; смысл тот же. Поэтому сумма индикаторов считает, сколько раз условие выполнилось. Типичный пример — accuracy. Если — предсказанный класс, а — правильный класс для примера , то — число верных предсказаний. Предсказания (кошка, собака, собака) при правильных метках (кошка, кошка, собака) дают индикаторы 1, 0 и 1, так что счёт равен 2, а accuracy — 2/3. В слое mixture-of-experts (MoE) роутер отправляет каждый токен в несколько из множества feed-forward подсетей, которые называют экспертами. В балансирующей функции потерь DeepSeek-V3 (уравнение 18) индикатор равен 1, когда оценка эксперта для токена входит в наибольших оценок для этого токена, где — число экспертов, в которые направляется каждый токен. Его сумма по токенам последовательности считает, как часто это случалось. Оценка здесь не включает смещение, которое добавляет роутинг, поэтому счёт может отличаться от экспертов, которых роутер выбирает на самом деле (роутинг в MoE).
Биномиальный коэффициент , читается « по », считает способы выбрать различных элементов из без учёта порядка. Для целых он равен . Восклицательный знак означает факториал: , при . Например, : из пяти элементов получается десять различных пар. DeepSeekMoE использует биномиальные коэффициенты для подсчёта комбинаций экспертов, а оценщик pass@k — для подсчёта наборов сэмплов.
Интервалы используют скобки для включённых концов: включает оба, — ни одного. В Gated DeltaNet означает строго между 0 и 1. В других местах — пара.
Натуральный логарифм обращает возведение в степень: . Логарифмы превращают произведения в суммы, а частные — в разности: и , но не раскладывается. Поэтому статьи работают с лог-вероятностями. Логарифм произведения вероятностей токенов — сумма, а логарифм отношения вероятностей двух моделей — разность, именно такая форма используется в целевых функциях DPO и GRPO. Статьи по ML подразумевают натуральный логарифм, если не сказано иное; результат измеряется в натах (nats), а логарифмы по основанию 2 дают биты. Для вероятности величина и неограниченно растёт по мере приближения к 0, поэтому уверенное неверное предсказание обходится дорого.
Log-sum-exp означает: возведите в экспоненту каждую оценку , сложите результаты, затем возьмите логарифм. Прямое вычисление может переполниться, если оценка велика. Вместо этого найдите наибольшую оценку и назовите её . Запись означает «сравнить все элементы и взять наибольший»; в NumPy это m = z.max().
Вычтите из каждой оценки перед возведением в экспоненту, а после взятия логарифма прибавьте обратно:
Для наибольшая оценка . Сдвинутые оценки равны , так что вычисление превращается в . Ни одна экспонента не больше 1. Код аттеншна делает то же вычитание перед softmax; там общий множитель сокращается при делении, поэтому ничего прибавлять обратно не нужно.
Условная вероятность и вероятность текста
— вероятность, которую модель с параметрами назначает выходу при входе . Нижний индекс называет параметры; некоторые статьи пишут , где точка с запятой тоже отмечает параметры, а не условие. Если вместо выхода поставить точку, — это всё распределение по выходам, а не одно число. В статьях по RL тот же объект записывают как , вероятность того, что модель напишет ответ на вопрос , и называют модель политикой (policy).
Если поменять местами событие и условие, получится другое число. Допустим, есть 100 ответов модели: 60 верны, 50 являются корректным JSON и 40 — и то и другое. Тогда
Пусть означает «ответ верен», а — «ответ является корректным JSON». Условная вероятность ограничивает подсчёт ответами, удовлетворяющими условию: , при условии . Символ означает «происходят оба события». Здесь дробь равна , то же самое, что 40 верных ответов среди 50 с корректным JSON.
Два события независимы, когда знание о том, что одно из них произошло, не меняет вероятность другого. Для этого требуется . В этой выборке , тогда как , так что в наблюдаемых долях независимости нет.
Теорема Байеса, или правило Байеса, связывает два направления условия: . Она позволяет вычислить вероятность при по вероятности при и вероятностям двух событий. Пример с ELBO использует её, чтобы найти вероятность скрытого кода при наблюдаемом изображении.
Языковая модель оценивает последовательность по одному токену. По цепному правилу вероятности
Каждый множитель зависит от всех предыдущих токенов, поэтому формула не предполагает независимости токенов. Если у трёх токенов условные вероятности 0.5, 0.2 и 0.1:
Обычные потери при обучении — это эта сумма с обратным знаком, делённая на длину:
Во время обучения предыдущие токены берутся из датасета. Во время генерации это собственные предыдущие выборы модели.
Математическое ожидание и откуда берутся сэмплы
Математическое ожидание — это среднее, взвешенное вероятностями:
Читайте как «среднее значение , когда берётся из ». Запись суммирует по всем возможным дискретным значениям . Без нижнего индекса усредняет случайную величину по её собственному распределению: если равно 1 с вероятностью 0.75 и 3 с вероятностью 0.25, то .
Когда у переменной есть плотность , то есть вероятность на единицу , взвешенное среднее становится интегралом, . Символ показывает, что интегрируется по ; если пределы не записаны, интеграл берётся по всему диапазону. Пример с плотностью объясняет вероятность на единицу и показывает интеграл как площадь под кривой.
Код обучения не может суммировать по всем возможным входам, поэтому он берёт выборку и усредняет: , где каждый независимо берётся из , что статьи пишут как . Статьи называют это оценкой Монте-Карло (Monte Carlo estimate), а в коде это loss.mean() по батчу. Среднее по батчу оценивает математическое ожидание, только если батч берётся из распределения, указанного в нижнем индексе , поэтому нижний индекс говорит, как порождаются обучающие данные:
- DPO усредняет по сохранённым примерам : промпту, предпочтённому ответу и отвергнутому ответу. Ответы собирают и размечают до этого этапа обучения; они могут происходить из более ранней генерации модели. На каждом шаге обучения модель вычисляет вероятности для этих готовых ответов и обновляет веса. Свежих ответов для этого шага она не генерирует.
- GRPO в DeepSeek-R1: сгенерировать ответы, затем сравнить их награды. Обучение берёт вопрос из датасета, генерирует несколько ответов и оценивает их функцией награды, например проверкой математического результата или запуском юнит-тестов. Обновление поощряет ответы, получившие оценку выше среднего по группе. Запись означает «выбрать вопрос из распределения вопросов». Запись означает «выбрать ответы на этот вопрос из копии модели ». Нижний индекс old отмечает копию, сгенерировавшую эти ответы; она остаётся фиксированной, пока батч используется для обновлений. Разбор GRPO объясняет сравнение наград и обновления.
- On-policy distillation в MiniLLM и DeepSeek-V4: сгенерировать текст, затем учиться по вероятностям учителя. Обучаемая модель — студент (student). Он генерирует текст; замороженный учитель (teacher) выдаёт вероятности следующего токена для тех же префиксов, и обучение подстраивает вероятности студента под вероятности учителя. Именно эти вероятности служат сигналом обучения, а не оценка награды за ответ, как в GRPO. MiniLLM записывает текст, сгенерированный студентом, как : — это текст, а называет модель-студента. DeepSeek-V4 называет своего студента и использует нескольких специализированных учителей. Реальная процедура выборки в MiniLLM к тому же подмешивает токены, взятые у учителя. Разбор дистилляции объясняет целевые функции и это различие в выборке.
Порядок показывает, что оптимизирует обучение. Допустим, модель назначает вероятности 0.9 и 0.1 правильным выходам двух равновзвешенных обучающих примеров. Усреднить их лог-вероятности значит сначала взять каждый логарифм, а потом усреднить: np.log(probs).mean(). Взять логарифм их среднего — np.log(probs.mean()). Если — вероятность, назначенная правильному выходу случайно выбранного примера:
Если поменять знак, получатся потери 1.20 и 0.69. Вторая модель, которая назначает 0.5 каждому правильному выходу, получает 0.69 при любом из двух вычислений. Значит, усреднение вероятностей до логарифма считает две модели одинаково хорошими, а обычное среднее отрицательных лог-вероятностей сильнее штрафует первую модель за низкую вероятность на втором правильном выходе. Переводя функцию потерь в код, сохраняйте порядок логарифма и усреднения.
Неравенство Йенсена формулирует общее соотношение для положительного : . Оно же помогает строить альтернативные целевые функции обучения. Когда вероятность данных в модели требует дорогого усреднения по скрытым переменным, среднее логарифмических слагаемых может дать нижнюю границу, которую легче оценить. Разбор ELBO объясняет эту задачу обучения; ELBO расшифровывается как evidence lower bound. В разделе 2.4 книги Tianhua Chen The Little Book of Generative AI Foundations граница выводится с помощью неравенства Йенсена.
Плотности, дисперсия и планки погрешностей
У два распространённых смысла. Для дискретных исходов, таких как токены или классы, оно даёт вероятность исхода : число от 0 до 1, причём вероятности по всем исходам в сумме дают 1.
Чтобы понять другой смысл, допустим, что выбирается равномерно между 0 и 0.5. Интервалы одинаковой длины имеют одинаковые вероятности. Интервал от 0.1 до 0.2 занимает одну пятую всего диапазона, поэтому
В этом диапазоне вероятность — это ширина интервала, умноженная на 2. Этот множитель и есть плотность вероятности: при и ноль вне этого отрезка. Плотность описывает вероятность на единицу переменной, а не вероятность одного точного значения.
Нулевая вероятность точки не означает, что ничего не выбирается. Сужайте интервал вокруг 0.15: его вероятность вдвое больше его ширины, поэтому она стремится к нулю вместе с шириной. Значит, у одной точной точки вероятность нулевая. Но выборка всё равно даёт какое-то значение в , а вероятность всего этого интервала равна 1. Если записать результат, округлив до двух знаков после запятой, записанное значение 0.15 представляет интервал от 0.145 до 0.155, вероятность которого .
Для неравномерной плотности множитель меняется с . Интеграл складывает вклады по интервалу:
Геометрически это площадь под кривой плотности между и ; площадь по всему диапазону равна 1. В равномерном примере площадь — это просто высота 2, умноженная на ширину 0.5. Поэтому плотность может превышать 1, а её логарифм — быть положительным, как здесь . Вероятность никогда не превышает 1.
Гауссово распределение, которое в DDPM используется для шума, имеет плотность такого рода. Не у каждого непрерывного распределения есть обычная плотность: распределение Кантора — математический контрпример, не относящийся к обсуждаемым здесь моделям. Хранение вещественных значений тоже не означает непрерывного распределения: переменная, ограниченная значениями 0.0 и 1.0, по-прежнему имеет два дискретных исхода.
Статьи часто обозначают вероятности и плотности одной и той же буквой. Проверьте, как статья определяет распределение переменной и по какой переменной ведётся суммирование или интегрирование. Интеграл по скрытой переменной , такой как латентный код в ELBO в части 4, не говорит, дискретна наблюдаемая или непрерывна. Некоторые статьи пишут заглавное для вероятностей и строчное для плотностей, но во многих используют для обеих.
Чтобы описать, насколько распределение разбросано вокруг среднего, статьи используют дисперсию (variance): средний квадрат отклонения от среднего, , где . Стандартное отклонение (standard deviation) — её квадратный корень, поэтому оно измеряется в тех же единицах, что и .
Эти величины присутствуют и в названиях распределений. Гауссово распределение, или нормальное, записывается : — его среднее, а — дисперсия. Для вектора использует ковариационную матрицу : элемент измеряет, как вместе меняются координаты и , а на диагонали стоят их дисперсии. описывает вектор независимых стандартных нормальных чисел, у каждого из которых среднее 0 и дисперсия 1; — единичная матрица.
Таблицы бенчмарков часто приводят средний результат вместе с мерой изменчивости. Разброс отдельных запусков отличается от неопределённости их среднего: для независимых запусков со стандартным отклонением стандартная ошибка среднего равна .
Прежде чем сравнивать две записи вроде и , выясните по подписи, является ли 0.4 стандартным отклонением по запускам, стандартной ошибкой или полушириной доверительного интервала. Чтобы сравнить средние, вычислите интервал для их разности. Процедура 95%-го доверительного интервала даёт диапазоны, которые содержат истинную разность в 95% повторных экспериментов при своих допущениях.
В этом примере предположим четыре независимых запуска на модель, приблизительно нормальные результаты запусков и равные дисперсии генеральных совокупностей. Если запуски парные, например две модели оцениваются на одних и тех же независимо выбранных задачах, анализируйте разности внутри пар. Эти случаи объясняет руководство NIST по двум выборкам.
Для независимых средних дисперсия их разности равна сумме их дисперсий. Стандартная нормальная величина попадает между и с вероятностью около 0.95, что даёт множитель для нормального приближения 95%-го интервала. Если 0.4 — стандартное отклонение по четырём запускам, то первый расчёт даёт:
Множитель 1.96 считает оценённый разброс известным. При всего четырёх запусках на модель используйте t-распределение Стьюдента, чтобы учесть неопределённость разброса. При перечисленных допущениях число степеней свободы равно (восемь запусков минус две оценённые средние). scipy.stats.t.ppf(0.975, 6) даёт около 2.447 вместо 1.96; 0.975 оставляет по 2.5% за каждым концом 95%-го интервала. Если допущение о равных дисперсиях не подходит, используйте интервал Уэлча (Welch), у которого степени свободы считаются иначе.
Теперь рассмотрим другое прочтение подписи: 0.4 — уже стандартная ошибка каждого среднего, оценённая по этим четырём запускам. Делить на ничего не нужно, и стандартная ошибка разности равна примерно 0.566. Множитель Стьюдента по-прежнему нужен. Два прочтения дают:
На рисунке начальное нормальное приближение сравнивается с двумя t-интервалами:
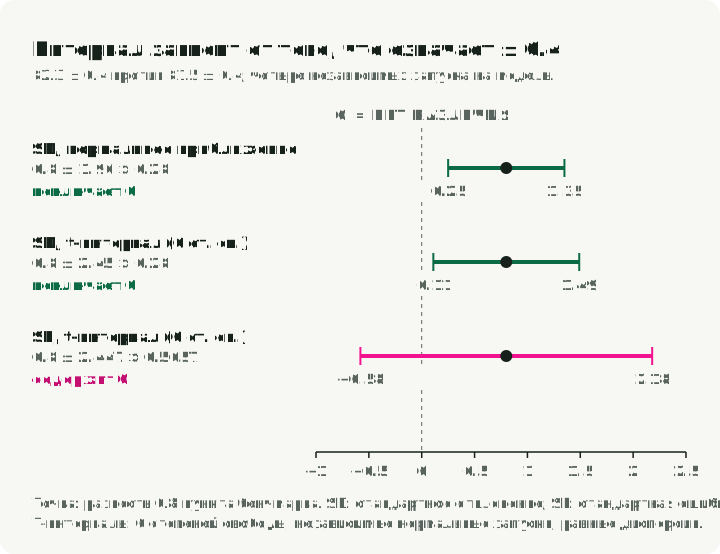
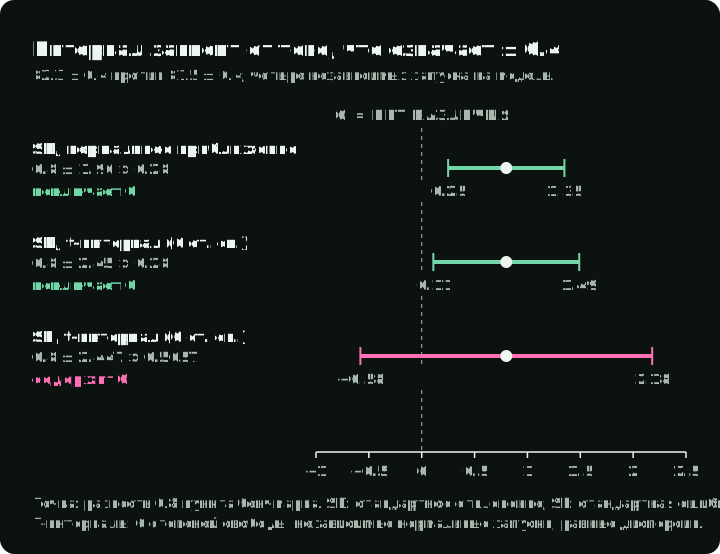
Когда 0.4 — стандартное отклонение, t-интервал исключает ноль: при этих допущениях результаты поддерживают положительную разность. Когда 0.4 — оценённая стандартная ошибка, интервал содержит ноль, поэтому результаты не позволяют установить, у какой модели средний результат выше.
Кросс-энтропия и KL-дивергенция
При обучении модели нужна числовая функция потерь (loss), которая измеряет, насколько предсказанные вероятности согласуются с обучающей целью. Алгоритм обучения меняет параметры модели, чтобы уменьшить эти потери. Кросс-энтропия даёт такие потери для размеченных примеров или вероятностей модели-учителя. Дивергенция Кульбака — Лейблера (KL) измеряет расхождение между двумя распределениями. Статьи используют её, чтобы научить студента имитировать учителя или чтобы штрафовать отклонения от фиксированной эталонной модели.
Здесь исходы дискретны, например токены или классы. Обозначим целевое распределение , а предсказанное моделью распределение по тем же исходам — . Начнём с одного наблюдаемого исхода : если модель дала ему вероятность , потери равны . Они равны 0 при , около 0.69 при , около 2.3 при и бесконечны при .
Кросс-энтропия усредняет эти потери по исходам, выбранным из цели:
Для one-hot метки , равной 1 для правильного класса и 0 для остальных, считается только правильный класс, и : обычные потери классификации. nn.CrossEntropyLoss в PyTorch вычисляет это по сырым оценкам модели, логитам (logits), и сам применяет log-softmax; на вход ему подаётся не вектор вероятностей . Если — мягкое распределение модели-учителя, каждый класс учитывается пропорционально вероятности учителя. Классическая дистилляция обучает небольшую модель на вероятностях большой именно так. Для цели у двух моделей такие кросс-энтропии :
Вторая модель совпадает с целью, и лучше не может быть ни одна модель. Этот минимум, здесь 0.325, равен , энтропии (entropy) . Он равен 0 только для one-hot цели: когда сама цель неопределённа, остаются потери, которые не может убрать никакая модель.
KL-дивергенция вычитает этот минимум и оставляет только потери, вызванные отличием от . Её записывают с двойной чертой , которая лишь разделяет два аргумента; это не вертикальная черта условной вероятности из раздела Условная вероятность и вероятность текста и не знак длины из справочника по векторам. Статьи используют её вместо запятой, чтобы показать, что порядок важен: усреднение идёт по исходам, выбранным из первого аргумента.
Для первой модели выше . KL равна 0, когда два распределения совпадают, и положительна в остальных случаях.
Порядок меняет то, какие несовпадения штрафуются. Слагаемое с и бесконечен, поэтому штрафует за нулевую вероятность чего-либо, что может выдать . Исходы с ничего не добавляют (по соглашению ), поэтому прямого штрафа они не несут, даже если . Если поменять аргументы местами, получится , которая бесконечна всюду, где и . Исходы с теперь ничего не добавляют, даже если . Если — цель, то называют прямой (forward) KL, а — обратной (reverse) KL.
Для и прямая KL бесконечна, потому что упускает исход, который выдаёт , а обратная KL равна всего : исход, который пропускает, ничего не добавляет. Для и прямая KL — это найденные выше 0.37, здесь вычисленные по слагаемым, а обратная KL отличается:
Из-за этой асимметрии KL называют дивергенцией, а не расстоянием.
Поскольку , а энтропия фиксированного учителя не зависит от студента, кросс-энтропия относительно фиксированного учителя даёт студенту те же градиенты, что и . Изменение параметра студента меняет обе функции потерь на одну и ту же величину, поэтому их производные, используемые при обучении, равны; вычисление объясняет раздел Градиенты и оптимизация. Благодаря этому код классификации и классической дистилляции может использовать кросс-энтропию. Такая замена работает только при учителе на первом месте. Если студент стоит первым, , а собственная энтропия студента меняется по ходу обучения, поэтому градиенты у них уже не совпадают.
Векторы и матрицы
Уравнения архитектуры описывают вычисления над массивами чисел. Форма (shape) массива говорит, как расположены его числа, какие операции допустимы и что они дают. Вектор — упорядоченный список чисел. Матрица располагает числа по строкам и столбцам. В коде ML тензор (tensor) — общий термин для таких числовых массивов, в том числе с более чем двумя осями. Ось (axis) — измерение, по которому индексируется массив: у матрицы есть ось строк и ось столбцов.
Скрытое состояние (hidden state) токена — вектор чисел, вычисленный внутри модели для представления этого токена. Допустим, мы обрабатываем вместе батч из последовательностей, в каждой позиций токенов, а каждое скрытое состояние содержит чисел. Массив скрытых состояний имеет форму [B, T, d], которую статьи пишут и как . Его три оси выбирают последовательность, позицию токена и число внутри вектора этого токена. Например, [2, 3, 4] содержит две последовательности, по три вектора токенов в каждой и по четыре числа в векторе: всего 24 числа. Здесь — ширина вектора. Форма перечисляет три размера; их произведение даёт число элементов.
Статьи часто записывают формы как принадлежность множеству: означает, что — вектор из вещественных чисел, а — что — матрица с строками и столбцами. Жирные буквы иногда отмечают векторы или тензоры, но форму определяет определение в статье.
В таблице ниже и — векторы-столбцы: их числа расположены вертикально. Верхний индекс означает транспонирование: обмен строк и столбцов. Так — строка с теми же числами, что и столбец . Заглавные и здесь называют матрицы; больше не означает размер батча.
| Выражение | Используемые значения | Что делает операция | Результат |
|---|---|---|---|
| — скалярное произведение | Два вектора-столбца, в каждом по элементов | Перемножить соответствующие элементы, затем сложить произведения: | Одно число |
| — внешнее произведение | Столбец с элементами и столбец с элементами | Умножить каждый элемент на каждый элемент | Матрица ; элемент равен |
| — матричное произведение | с строками и столбцами; с строками и столбцами | Для элемента перемножить соответствующие числа строки матрицы и столбца матрицы , затем сложить | Матрица ; число столбцов должно равняться числу строк |
| — поэлементное произведение | Два массива одной формы | Перемножить элементы на совпадающих позициях, не складывая их | Массив той же формы |
| — конкатенация | Столбцы и с и элементами | Поставить элементы после элементов | Один столбец с элементами; проверьте в статье соглашение об оси склейки |
Для конкретного сравнения возьмём и . Перенос транспонирования меняет и вычисление, и результат:
Скалярное произведение даёт одну оценку, как при сравнении запроса и ключа в аттеншне. Внешнее произведение сохраняет отдельное значение для каждой пары элементов; обновление в Gated DeltaNet использует его, чтобы построить матричное обновление из двух векторов.
Матричное произведение можно перегруппировать, , но нельзя переставить множители; вывод MLA использует перегруппировку, чтобы не восстанавливать ключи. NumPy записывает матричное умножение как @, а поэлементное произведение как *. Статьи не наследуют правила broadcasting из NumPy: чтобы прибавить вектор к матрице, нужно указать ось. Статьи расходятся и в том, строка вектор или столбец: аттеншн складывает токены в строки , тогда как MLA, Gated DeltaNet и LoRA пишут с векторами-столбцами, а nn.Linear в PyTorch вычисляет x @ W.T над строками.
Уравнение архитектуры может также описывать размер вектора, ограничивать допустимые матрицы или перестраивать произведение:
| Запись | Значение |
|---|---|
| Евклидова длина; , без корня, встречается в потерях DDPM | |
| Сумма модулей | |
| Спектральная норма: наибольший множитель, на который увеличивает длину вектора; mHC удерживает её не выше 1 | |
| Число независимых столбцов; у обновления LoRA ранг не выше | |
| Определитель: — множитель, на который масштабирует объём, а знак показывает, меняет ли ориентацию; пример замены переменных в Приложении B этой статьи использует его | |
| Каждый элемент неотрицателен, как в mHC; — другое условие, положительная полуопределённость: для каждого | |
| , | Единичная матрица (1 на диагонали, 0 в остальных местах, так что ); вектор из единиц |
| Транспонирование произведения меняет порядок на обратный; им пользуются разделы про RoPE и MLA в части 2 |
Градиенты и оптимизация
Обучение использует производные, чтобы решить, как менять параметры модели. Пусть — одна скалярная функция потерь, а — вектор всех параметров; — один элемент этого вектора.
Частная производная — одно число, вычисленное при текущих значениях параметров. Она измеряет скорость изменения потерь, когда меняется только , а остальные параметры остаются фиксированными. Читайте её как «частная производная потерь по параметру ».
Градиент собирает эти числа для всех параметров в один вектор. Его -й элемент равен . Символ называется набла; здесь он означает «взять градиент». При единственном параметре у градиента один элемент, равный обычной производной.
Например, возьмём . При и :
Первая частная производная, 4, означает, что увеличение на 0.01 повышает потери примерно на 0.04, пока фиксировано. Градиент содержит эту информацию для обоих параметров. Градиентный спуск вычитает производную каждого параметра, умноженную на положительную скорость обучения (learning rate) , которая задаёт размер шага:
При пример переходит от к , а потери падают с 7 до 3.04. Для дифференцируемой функции потерь с ненулевым градиентом достаточно малый шаг уменьшает потери. Нулевой градиент обновления не даёт.
Нижний индекс у говорит, что меняется. варьирует параметры; варьирует вход, и в статьях по диффузии его называют score, что не имеет отношения к оценке на бенчмарке.
Якобиан записывает производные для нескольких выходов. Слой нейросети может выдавать много чисел, например компоненты скрытого состояния токена. Чтобы описать, как каждый выход реагирует на каждый вход, частные производные собирают в матрицу, которую называют якобианом (Jacobian). Для с входными и выходными числами его форма : строки соответствуют выходам, столбцы — входам, а элемент измеряет, как меняется выход при изменении входа .
Например, пусть функция принимает два числа и возвращает и . Её якобиан равен
Второй столбец говорит, что увеличение на 0.1 при фиксированном увеличивает на 0.2 и уменьшает на 0.1. Этот пример линеен, поэтому его якобиан постоянен. У нелинейной функции элементы могут зависеть от текущего входа и описывают малые изменения локально. При единственном скалярном выходе у якобиана одна строка: те же производные, что и в градиенте, только транспонированные при нашем соглашении о векторах-столбцах. Общие определения даёт Deep Learning, §4.3.
Обратное распространение ошибки (backpropagation) использует эти производные, чтобы вычислить градиент потерь через последовательные слои. Пример замены переменных в Приложении B этой статьи использует другое свойство: абсолютное значение определителя квадратного якобиана даёт локальный коэффициент масштабирования объёма, который нужен для пересчёта плотности вероятности.
В обучении производные описывают локальные изменения; оптимизационная цель говорит, что обновления должны минимизировать или максимизировать. Статьи различают наилучшее значение цели и параметры, которые его достигают: — наименьшее значение , а даёт значения параметров, при которых оно достигается. Для минимум равен 0, а argmin равен 3. Argmin задаёт желаемый результат, но не определяет алгоритм обновления.
Например, MiniLLM записывает свою цель как (уравнение 1), где — модель-студент, а — учитель, у которого она учится. Затем в разделе 2.2 выводится градиент, который затем изменяется, чтобы сделать обучение устойчивее; уравнение (7) — градиент, который используется для обновлений. Пример с on-policy distillation объясняет эти изменения. Если прочесть только argmin, их можно пропустить.
Stop-gradient, , пропускает вперёд без изменений, но блокирует градиенты через себя, как .detach() в PyTorch. Два выражения с одинаковым значением в прямом проходе могут обучаться по-разному, если одно из них отсоединено. В примере с GRPO Hugging Face TRL считает лог-вероятность старой модели фиксированной. В упрощении дистилляции, которое обсуждает DeepSeek-V4, отсоединённое лог-отношение учителя и студента даёт фиксированный вес для обновления.
Множества и ограничения
Ограничение (constraint) говорит, какие значения допустимы. Статьи часто выражают ограничения через множества: наборы различных элементов, записываемые в фигурных скобках, например . Порядок не важен, поэтому — то же множество. Повторяющиеся элементы считаются один раз. Для сравнения, круглые скобки в векторе вроде описывают упорядоченный список: — уже другой вектор.
Когда статья определила множество, она может проверять принадлежность, объединять множества, считать их элементы или формулировать на них условие. Возьмём и :
| Запись | Значение | Пример и как его читать |
|---|---|---|
| Принадлежность: принадлежит | : 2 — элемент | |
| Объединение: включить каждый элемент любого из множеств | ; 3 включается только один раз | |
| Пересечение: оставить только общие элементы обоих множеств | ||
| Число различных элементов | ||
| «Для каждого»: условие должно выполняться для всех названных элементов | : каждый элемент положителен | |
| «Существует»: хотя бы один элемент должен удовлетворять условию | : в есть элемент больше 2, а именно 3 |
Нотация форм из раздела Векторы и матрицы тоже называет множества: — множество всех векторов из вещественных чисел, а — множество всех вещественных матриц с строками и столбцами. Таким образом, указывает, какую форму должна иметь .
Set-builder-нотация задаёт множество условием: читается «элементы , удовлетворяющие условию», как set comprehension в Python {x for x in S if condition(x)}. Черта здесь означает «такой, что», а не условную вероятность; некоторые статьи вместо неё используют двоеточие. Примеры в этой серии — допустимые матрицы в mHC, выбранные эксперты в MoE и выбранные токены в разреженном аттеншне.
DAPO, метод обучения, фильтрующий группы сгенерированных ответов, оставляет вопрос, только если часть ответов верна, а часть неверна. Для выбранных ответов и эталонного ответа запишем множество индексов верных ответов как
Фильтр — это . Индексы делают подсчёт явным: два сэмпла с одинаковым текстом по-прежнему считаются двумя ответами. Статья DAPO записывает множество через сами ответы ; если читать это буквально как множество текстов, два одинаковых ответа посчитаются один раз.
Упражнения
- Формы. имеет форму , — , — . Какие формы у оценок и у выхода? По какой оси идёт softmax?
- Softmax. Вычислите softmax от . Изменится ли результат, если прибавить 100 к обоим входам?
- Средние. У одного ответа один токен с потерями 4; у другого три токена с потерями 0. Вычислите среднее по токенам и среднее по ответам.
- Условие. Из 200 ответов 120 верны, 80 проходят проверку формата и 60 — и то и другое. Найдите и .
- KL. Для учителя и студента вычислите оба направления KL.
- Множества. DAPO оставляет вопрос, только если , где содержит индексы верных ответов среди сэмплов. При оставит ли он вопрос, ответы на который набрали оценки ? А вопрос с оценками ? Изменится ли первый ответ, если все четыре сэмпла содержат одинаковый верный текст?
Ответы:
-
Оценки имеют форму , а выход — . Softmax идёт по шести ключам в строке каждого запроса.
-
. Прибавление одного и того же числа ко всем входам не меняет softmax, но прямое вычисление переполняет 32-битные float.
-
Два средних:
-
и .
-
, а , потому что студент назначает вероятность исходу, который учитель исключает.
-
Нет: содержит четыре элемента, что равно . Да: содержит три элемента, между 0 и 4. Одинаковый текст первый ответ не меняет: это четыре отдельных сэмпла, поэтому их четыре индекса по-прежнему считаются.
Приложение A. Греческие буквы
Перечислены типичные роли; каждая статья всё равно сама определяет свои символы.
| Буква | Название | Типичные роли в статьях по ML |
|---|---|---|
| альфа | Вес смешивания или масштаб; затухание (Gated DeltaNet); расписание шума (DDPM) | |
| бета | Сила штрафа (DPO, GRPO); сила записи (Gated DeltaNet); расписание шума (DDPM) | |
| гамма | Коэффициент дисконтирования в RL; размер шага (обновление смещения в DeepSeek-V3) | |
| дельта | Разность или изменение | |
| эпсилон | Шум (DDPM); диапазон клиппинга (GRPO); малая стабилизирующая добавка | |
| эта | Скорость обучения | |
| тета | Параметры модели; углы поворота в RoPE | |
| лямбда | Вес регуляризации; собственное значение | |
| мю | Среднее; число градиентных шагов на батч в Algorithm 1 из DeepSeekMath | |
| пи | Политика; — оператор произведения | |
| ро | Отношение вероятностей, как в разделе про GRPO в части 3; корреляция | |
| сигма | Сигмоида (DPO); стандартное отклонение; ковариация; — оператор суммы | |
| тау | Температура; порог; траектория в RL | |
| фи | Параметры второй сети, например энкодера; признаки; угол | |
| пси | Параметры другой сети, например value model в PPO из DeepSeekMath | |
| омега | Частота; также означает нижнюю оценку в теории сложности или множество исходов |
Варианты вроде и обычно — одна и та же буква в другом начертании, но статья может использовать обе для разных переменных.
Приложение B. Другие семейства уравнений
Формы уравнений, которые эта серия не разбирает, с определениями, нужными каждой:
Selective state-space models. Модель пространства состояний (state-space model) обрабатывает последовательность, обновляя хранимое состояние на каждом шаге. Обновление вида , объединяет предыдущее состояние с текущим входом, а затем вычисляет выход. Здесь — текущий вход, — хранимое состояние, а — выход. Матрицы , и соответственно преобразуют предыдущее состояние, добавляют вклад входа и порождают выход. Черта отмечает параметры, преобразованные из модели с непрерывным временем в дискретные шаги; средних она не означает. В Mamba параметры обновления зависят от текущего входа, что и значит «selective».
Стохастические дифференциальные уравнения. описывает, как состояние меняется со временем : — скорость его изменения. Стохастическое дифференциальное уравнение (SDE) добавляет случайные изменения, . Здесь описывает детерминированное изменение, задаёт масштаб шума, а — приращение броуновского движения. Чтобы приблизить его в коде, метод Эйлера — Маруямы использует малый шаг по времени и заменяет гауссовым шумом с дисперсией . Раздел 5.1 книги Tianhua Chen The Little Book of Generative AI Foundations приводит такое обновление; в §6.4 той же книги SDE используются для описания диффузионных моделей.
Замена переменных. Преобразование случайной величины меняет её плотность в зависимости от того, как преобразование меняет локальный объём. Допустим, отображает между пространствами одной размерности, а и обратное к ней дифференцируемы. Плотности до и после преобразования, и , удовлетворяют . Обратное преобразование восстанавливает по . Его якобиан — квадратная матрица первых производных; абсолютное значение её определителя поправляет локальное изменение объёма. Например, если в одном измерении, плотность становится : удвоение ширины вдвое снижает плотность. Нормализующие потоки (normalizing flows) используют такие обратимые преобразования для моделирования плотностей; метод объясняет книга Tianhua Chen, §7.1.
Min–max-цели. В генеративно-состязательных сетях (GAN) генератор порождает примеры, а дискриминатор пытается отличить их от реальных данных. Целевая функция измеряет успех дискриминатора: максимизирует её, а минимизирует. Цель (уравнение 1) говорит: для каждого возможного генератора рассмотрите лучшего против него дискриминатора, затем выберите генератор с наименьшим получившимся значением цели. Обучение не решает эту внутреннюю максимизацию точно. Algorithm 1 в статье чередует шагов градиентного подъёма по с одним шагом градиентного спуска по ; в экспериментах использовалось .
Вероятностный симплекс. У вектора вероятностей неотрицательные элементы, дающие в сумме 1. Множество всех таких векторов с элементами называется вероятностным симплексом (probability simplex) и записывается . Каждый выход softmax лежит в нём. Здесь называет множество, а верхний индекс — его размерность, а не степень: после того как выбраны вероятностей, последняя должна довести сумму до 1. При двух вариантах каждое распределение имеет вид при , так что свободно только одно число.
Нормализация. Нормализация перемасштабирует значения по среднему и разбросу выбранной группы. Распространённая форма — , где — среднее, — дисперсия, а — малое положительное число, не допускающее деления на ноль. Само уравнение не говорит, по каким элементам считаются среднее и дисперсия. Для батча векторов признаков batch normalization считает их отдельно для каждого признака по примерам. Layer normalization в Transformer считает их отдельно для каждого токена по его признакам. При сравнении реализаций проверяйте указанные оси.
Источники и версии
Номера разделов и уравнений относятся к версиям, на которые даны ссылки.
- Tianhua Chen. The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer. 2026. Версия 2; §2.4 и §3.2 охватывают неравенство Йенсена и ELBO, §5.1 и §6.4 — шум в непрерывном времени.
- Vaswani et al. Attention Is All You Need. 2017. Версия 7, §3.2.1, уравнение (1) и сноска 4.
- Dai et al. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. 2024. Мелкозернистая сегментация экспертов и подсчёт комбинаций, §3.1; абляция, §4.4 и Figure 3.
- Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024. Версия 3, §1.1, §4.1.1, уравнения (1)–(4) и Algorithm 1.
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. 2024. Версия 5, §2.1.1–2.1.3, уравнения (9)–(19) и Appendix C.
- DeepSeek-AI. DeepSeek-V3 Technical Report. 2024–2025. Версия 2, §2.1.2, уравнения (12)–(18).
- DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025. Версия 1: §2.2.1, уравнения (1)–(3). Версия 2, 2026: §2.1 и Supplementary A.3.
- DeepSeek-AI. DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence. 2026. Версия 1: §2.2, уравнения (1)–(8); §5.1.2, уравнение (29).
- Rafailov et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. 2023–2024. Версия 3, §4, уравнение (7).
- Gu et al. MiniLLM: Knowledge Distillation of Large Language Models. 2023–2024. Версия 4, §2.1, уравнение (1) и §2.2, уравнения (2) и (7).
- Yu et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. 2025. Версия 2, §3.2–3.3, уравнения (11)–(12).
- Gu and Dao. Mamba: Linear-Time Sequence Modeling with Selective State Spaces. 2023–2024.
- Yang et al. Gated Delta Networks: Improving Mamba2 with Delta Rule. 2024–2025. Версия 3, §3.1, уравнение (10) и §3.3–3.4.
- Ho, Jain and Abbeel. Denoising Diffusion Probabilistic Models. 2020. Версия 2, §2, уравнения (4)–(5); §3.2, уравнение (12); §3.4, уравнение (14) и Algorithms 1–2.
- Goodfellow et al. Generative Adversarial Nets. 2014. Уравнение (1) и Algorithm 1.
- Chen et al. Evaluating Large Language Models Trained on Code. 2021. Версия 2, §2.1, уравнение (1) и Figure 3.
- Hugging Face TRL.
GRPOTrainerиGRPOConfigна коммитеc6eac19, октябрь 2026 года. - Stanford CS229. Probability Theory Review и Linear Algebra Review and Reference.
- Dive into Deep Learning. Preliminaries.
- Britz, Goldie, Luong and Le. Massive Exploration of Neural Machine Translation Architectures. 2017. Версия 2, Table 5; цитируется в Attention Is All You Need для сравнения dot-product и additive attention.