Hoe je de wiskunde in arXiv-papers over AI leest: een praktische gids
Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
De wiskunde in een AI-paper kunnen lezen is een nuttige vaardigheid voor engineers die een model willen begrijpen, een methode willen reproduceren of een experimentele claim willen beoordelen. Deze gids legt uit hoe je de notatie ontcijfert, een vergelijking met kleine getallen controleert en haar koppelt aan de rest van het paper en aan de implementatie. Ze gaat ervan uit dat je code kunt lezen, maar niet dat je al vertrouwd bent met onderzoeksnotatie.
Een vergelijking perst meerdere beslissingen samen in één regel: de objecten waarmee wordt gerekend, hun dimensies, welke waarden worden gesampled en wat er wordt geleerd of juist vast blijft staan. Die details terughalen is een goede eerste stap. Uitleggen waarom een methode werkt en haar getrouw implementeren kost extra werk.
Begin met de attention-uitwerking: daarin wordt één vergelijking gekoppeld aan arrayvormen, kleine getallen en uitvoerbare Python. Het notatieoverzicht legt de uitdrukkingen uit die je in andere papers tegenkomt. De rest van deze serie past dezelfde methode toe op vergelijkingen uit specifieke papers: architectuurvergelijkingen zoals RoPE, MLA en LoRA; trainingsdoelen zoals DPO en GRPO; en generatieve modellen en metrics zoals de ELBO, diffusion en pass@k. Die delen zijn nog niet verschenen, dus de uitwerkingen waarnaar dit deel verwijst zijn niet gelinkt. Voor een uitgebreidere behandeling van de basis ontwikkelt Tianhua Chen in The Little Book of Generative AI Foundations de lineaire algebra en kansrekening achter generatieve modellen.
Attention, lees één symbool tegelijk
Attention levert een outputvector door een gewogen gemiddelde te nemen van value-vectoren. De gewichten komen voort uit een vergelijking van een query-vector voor de outputpositie met een key-vector voor elke beschikbare inputpositie. De matrices , en bundelen die query-, key- en value-vectoren. Scaled dot-product attention vat deze stappen samen in vergelijking (1) van §3.2.1 (§ betekent “sectie”) in Attention Is All You Need:
De definities staan in de tekst, niet in de vergelijking. De alinea vóór vergelijking (1) zegt dat queries en keys dimensie hebben en values dimensie . De methode neemt het inproduct van elke query met alle keys, deelt elk door en past een softmax toe “to obtain the weights on the values”. Queries zijn “packed together into a matrix ”, en keys en values in en . Elke rij van deze matrices is dus de vector van één token, en de softmax levert één set gewichten per query. De geleerde matrices die tokenvectoren omzetten in , en komen later, in §3.2.2.
Vormen en rollen. Een attention head voert één zo’n berekening uit met eigen query-, key- en value-vectoren. Schrijf hun vormen op voordat je de operatoren leest. Voor één head met queries en keys:
| Symbool | Vorm | Wat het is | Waar het vandaan komt |
|---|---|---|---|
| één query-rij per outputpositie | tokenvectoren maal een geleerde matrix | ||
| één key-rij per positie waarop attention kan letten | tokenvectoren maal een geleerde matrix | ||
| één value-rij per key | tokenvectoren maal een geleerde matrix | ||
| getransponeerd: rijen worden kolommen | dezelfde getallen als | ||
| een getal | de breedte van elke query en key | een vaste instelling: 64 in de basis-Transformer |
Papers geven een vorm aan door de verzameling te noemen waartoe de matrix behoort: betekent een matrix van reële getallen met rijen en kolommen, een array met vorm [n, dk].
Lees van binnen naar buiten.
-
vermenigvuldigt een matrix van met een matrix van . De gedeelde wordt weggesommeerd, dus het resultaat is een tabel van scores. Element is het inproduct van query en key : vermenigvuldig overeenkomstige elementen en tel de producten op. Bij gelijke vectorlengtes is deze score groter naarmate hun richtingen meer op elkaar lijken.
-
Delen door voorkomt dat de scores meegroeien met de vectorbreedte. Voetnoot 4 van het paper laat zien waarom ongeschaalde inproducten groeien. Stel dat de componenten van een query en een key onafhankelijk van elkaar zijn (als je er een paar kent, weet je niets over de andere), elk met gemiddelde 0 en variantie 1 (de gemiddelde gekwadrateerde afstand tot het gemiddelde). Dan geldt:
De regels gebruiken twee eigenschappen van onafhankelijke getallen. Ten eerste: het product van twee onafhankelijke getallen die elk gemiddelde 0 en variantie 1 hebben, heeft ook variantie 1. Ten tweede: als je onafhankelijke getallen optelt, tellen hun varianties op, dus de producten geven variantie . De standaarddeviatie is de wortel uit de variantie, . Als je elke score door deelt, krimpt de spreiding met dezelfde factor, terug naar 1.
Waarom de twee regels gelden
Variantie als het gemiddelde 0 is. Variantie is de gemiddelde gekwadrateerde afstand tot het gemiddelde. Als het gemiddelde 0 is, is die afstand gewoon het getal zelf, dus de variantie is het gemiddelde van het kwadraat. Een component met gemiddelde 0 en variantie 1 heeft dus een die gemiddeld 1 is.
Het gemiddelde van een product. Voor onafhankelijke getallen is het gemiddelde van een product het product van de gemiddelden. Neem een getal dat met gelijke kans 1 of 3 is, dus gemiddeld 2, en een getal dat 1 of 5 is, eveneens met gelijke kans, dus gemiddeld 3. Onafhankelijk betekent dat elke waarde even vaak aanneemt, wat ook werd, zodat alle vier de paren even waarschijnlijk zijn. Als , zijn de producten 1 en 5, met gemiddelde . Als , zijn ze 3 en 15, met gemiddelde . In beide gevallen is het gemiddelde , dus over beide waarden van is het , oftewel . Zonder onafhankelijkheid faalt de regel: als 5 was wanneer 3 is, en 1 wanneer 1 is, kwamen alleen de producten 1 en 15 voor, en die hebben gemiddelde 8. Wikipedia geeft de regel voor willekeurige onafhankelijke stochastische variabelen, met “expected value” voor het gemiddelde: independence and expectation.
Regel 1: één product heeft variantie 1. Neem één product . Het gemiddelde is het product van de gemiddelden, , dus de variantie is het gemiddelde van . De kwadraten zijn onafhankelijk omdat en dat zijn, en elk is gemiddeld 1, dus de variantie is . De algemene formule is de variance of a product of independent variables.
Regel 2: de varianties van onafhankelijke termen tellen op. Noem de producten , zodat het inproduct de som is. De termen zijn onafhankelijk omdat ze elk andere componenten gebruiken, en elk heeft gemiddelde 0 en variantie 1. De som heeft ook gemiddelde 0, dus haar variantie is het gemiddelde van haar kwadraat. Als je de som met zichzelf vermenigvuldigt, krijg je één product voor elk paar termen, een raster van :
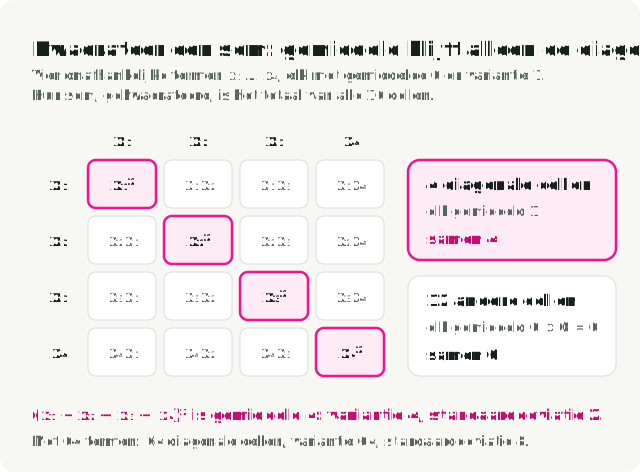
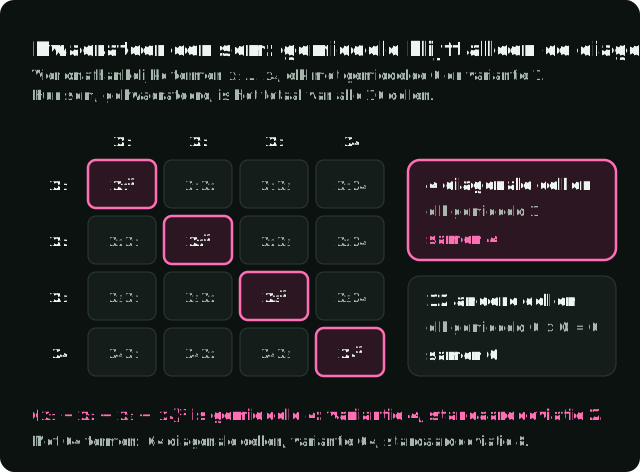
De diagonale cellen zijn de kwadraten , en elk is gemiddeld 1. Elke andere cel vermenigvuldigt twee verschillende, onafhankelijke termen, dus haar gemiddelde is het product van hun gemiddelden, : haar positieve en negatieve waarden heffen elkaar op. Alleen de diagonale cellen blijven over, dus de variantie van de som is en haar standaarddeviatie is . De spreiding groeit met de wortel van de breedte omdat het grootste deel van het raster wegvalt. Wikipedia geeft de algemene stelling als de variance of a sum of uncorrelated variables; onafhankelijke variabelen zijn altijd ongecorreleerd, dus de regel geldt ook voor hen.
Met liggen ruwe scores doorgaans binnen ongeveer ; geschaald binnen ongeveer , bij elke breedte.
Sterk gespreide scores verzadigen softmax (stap 3), en de gradients verdwijnen. Als één score in een rij ver boven de andere ligt, geeft softmax die key een gewicht dicht bij 1 en elke andere key een gewicht dicht bij 0. Een kleine verandering in een score verschuift de gewichten dan nauwelijks, dus de gradient die de queries en keys bereikt is bijna nul, en de training heeft vrijwel niets om ze mee bij te stellen. Het paper noemt dit als waarschijnlijke verklaring van een eerder resultaat: zonder de schaling presteerde dot-product attention bij grote slechter dan additive attention, een oudere vorm die een query en een key met een klein netwerk scoort (Britz et al., 2017). Het paper meet de gradients zelf niet.
-
Softmax zet elke rij scores om in gewichten. Laat één rij van de geschaalde scores zijn. De exponentiële functie , ook geschreven als , gebruikt de constante . Dan geldt , waarbij slechts een tweede indexnaam is, zodat de som over elke key in de rij loopt. De gewichten zijn positief en elke rij telt op tot 1.
-
Door de gewichten met de values te vermenigvuldigen, wordt de key-as weggesommeerd. Rij van de output is een gewogen gemiddelde van de value-rijen, gewogen naar hoe goed elke key bij query paste.
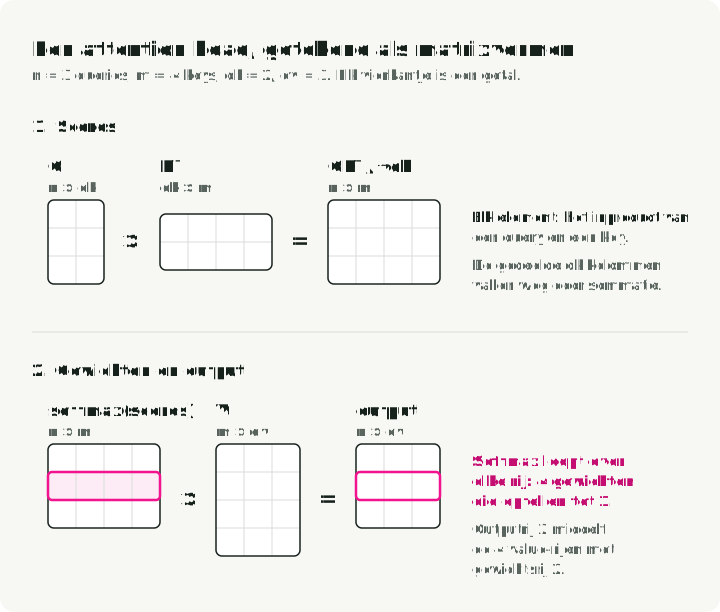
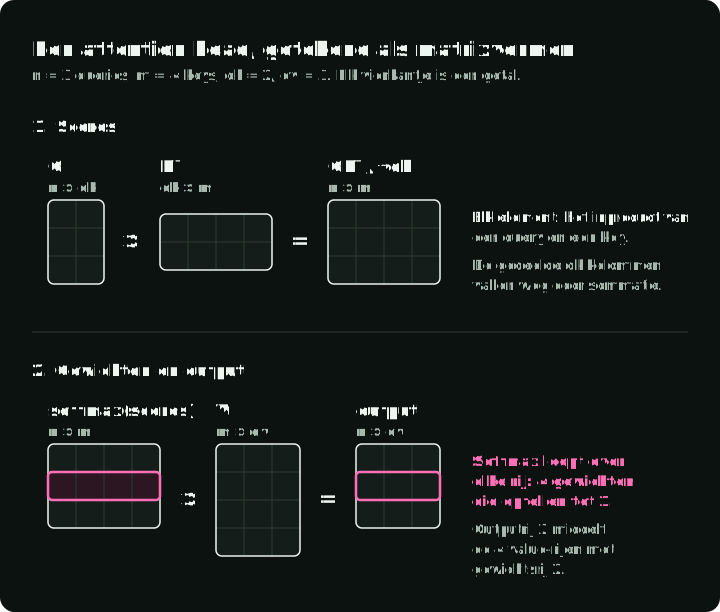
Tel de vierkantjes in de figuur: elk product laat de as verdwijnen die de twee rasters delen.
Controleer het met twee getallen. Neem één query en twee keys met geschaalde scores , zo gekozen dat de exponentiële waarden 1 en 3 worden, en values en . De figuur werkt het uit, één bewerking per kolom:
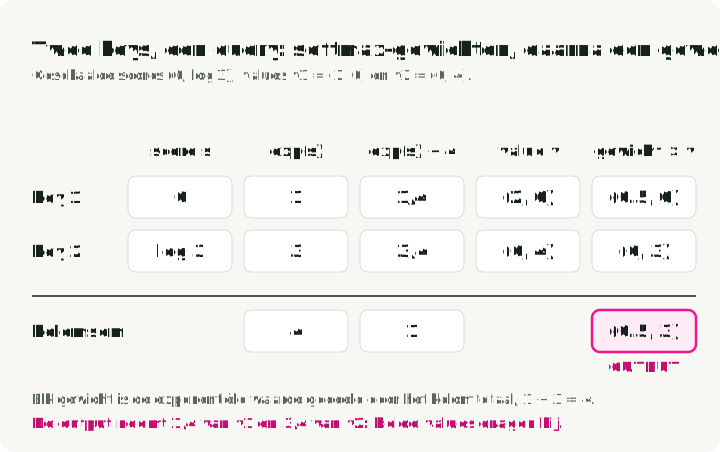
Attention mengde beide values; ze koos niet het token dat het beste paste.
Vergelijk het met code. De NumPy-functie hieronder implementeert één head. k.T is de getransponeerde. axis=1 is de key-as, dus de rij van elke query wordt apart genormaliseerd. Het maximum van de rij wordt afgetrokken vóór np.exp: als je hetzelfde getal bij elke score in een rij optelt, valt dat weg in de softmax-verhouding, dus het resultaat blijft gelijk, maar grote scores lopen niet meer over. De optionele mask zet geblokkeerde scores op , waardoor hun gewichten precies nul worden. Een decoder gebruikt zo’n mask om te voorkomen dat elk token naar latere tokens kijkt (§3.2.3 van het paper).
Sla het blok op als attention_example.py en voer uv run --with numpy python attention_example.py uit. De controles slagen zonder uitvoer.
import numpy as np

def attention(q, k, v, allowed=None):
    """One head. q: [n, dk], k: [m, dk], v: [m, dv], allowed: bool [n, m]."""
    scores = q @ k.T / np.sqrt(q.shape[1])  # [n, m]
    if allowed is not None:
        if not allowed.any(axis=1).all():
            raise ValueError("every query needs at least one allowed key")
        scores = np.where(allowed, scores, -np.inf)
    scores = scores - scores.max(axis=1, keepdims=True)
    weights = np.exp(scores)
    weights = weights / weights.sum(axis=1, keepdims=True)  # rows sum to 1
    return weights @ v, weights  # [n, dv], [n, m]

# The two-key example from the text.
out, w = attention(
    np.array([[1.0]]),
    np.array([[0.0], [np.log(3.0)]]),
    np.array([[2.0, 0.0], [0.0, 4.0]]),
)
np.testing.assert_allclose(w, [[0.25, 0.75]])
np.testing.assert_allclose(out, [[0.5, 3.0]])

# A causal mask: query i may attend only to keys 0..i.
x = np.random.default_rng(0).normal(size=(3, 4))
out, w = attention(x, x, x, allowed=np.tril(np.ones((3, 3), dtype=bool)))
assert out.shape == (3, 4)
np.testing.assert_allclose(w.sum(axis=1), 1.0)
assert np.all(w[np.triu_indices(3, k=1)] == 0)
Een query waarvan alle keys geblokkeerd zijn, is een geval dat de vergelijking openlaat: elk gewicht in haar rij zou zijn. De functie geeft een foutmelding in plaats van NaN terug te geven.
Van één head naar meerdere. De basis-Transformer draait acht heads parallel, elk met eigen geleerde matrices om , en te maken, en elk met . De outputs worden samengevoegd en vermenigvuldigd met nog een geleerde matrix, (Attention Is All You Need, §3.2.2).
Een implementatie kan ook een batch verwerken: meerdere inputsequenties tegelijk. PyTorch’s scaled dot-product attention accepteert bijvoorbeeld een query-tensor Q met vorm [batch, heads, n, d_k]. De eerste twee dimensies kiezen een sequentie en een head; Q[b, h] is de matrix [n, d_k] voor dat paar. De attention-formule geldt los voor elk paar. De NumPy-functie hier behandelt maar één zo’n paar: haar .T- en axis=1-bewerkingen gaan uit van tweedimensionale input.
Zes vragen bij elke vergelijking
| Vraag | Antwoord voor attention |
|---|---|
| Wat geeft de vergelijking terug, en met welke vorm? | Een matrix van : één outputrij per query |
| Is elk symbool data, een getrainde weight, een bevroren model, een instelling of een sample? | , en worden uit tokens berekend met geleerde matrices; is een vaste instelling; er wordt niets gesampled |
| Over welke index of as loopt elke bewerking? | Softmax loopt over de keys in de rij van elke query; het product van de gewichten met sommeert over keys |
| Waar staan de definities? | De alinea vóór vergelijking (1), voetnoot 4, en §3.2.2 voor de geleerde projecties |
| Wat levert een controle met twee of drie getallen op? | Gewichten en output |
| Welke keuzes moest de code maken die de vergelijking openlaat? | Het maximum van de rij aftrekken, de waarde voor gemaskeerde scores, een rij zonder toegestane key |
Wat voor soort uitspraak een vergelijking doet
Attention is een berekening: ze zegt hoe je uit inputs een output krijgt. Papers schrijven ook vergelijkingen met andere taken:
| Soort | Voorbeeld in deze serie | Wat je controleert |
|---|---|---|
| Berekening | De attention-output; MLA’s gecomprimeerde vector | De vorm van elk tussenresultaat |
| Definitie | GRPO’s score ten opzichte van andere antwoorden | Waar de nieuwe naam voor staat, zodat je haar kunt terugsubstitueren |
| Doel: een loss om te minimaliseren of een score om te maximaliseren | De DPO-loss | Of er wordt geminimaliseerd of gemaximaliseerd, en over welke data wordt gemiddeld |
| Updateregel | Gradient descent; het geheugen van Gated DeltaNet | Wat er bij elke stap verandert en wat vast blijft |
| Beperking, of een verzameling toegestane waarden | De toegestane mixmatrices van mHC | Hoe het paper een waarde produceert die eraan voldoet |
| Grens: een boven- of ondergrens van een grootheid | De evidence lower bound (ELBO) | Het verschil tussen de twee kanten, en wanneer het nul is |
| Schatter of metric | pass@k | Wat er wordt geteld, en uit hoeveel samples |
| Empirische fit | De scaling law van DeepSeek LLM | Het databereik waarop de curve is gefit |
Een beperking legt een eigenschap vast die het resultaat moet hebben. Voor attention-gewichten is die eigenschap: elk gewicht is niet-negatief en elke rij telt op tot 1. Softmax is een berekening die gewichten met die eigenschap oplevert. De eis alleen zegt je niet dat je softmax moet gebruiken.
stelt dat twee uitdrukkingen gelijk zijn. betekent “is gedefinieerd als”: het geeft een uitdrukking een naam. Een definitie kan een metric, een loss of een verzameling toegestane waarden een naam geven, dus als je ziet, weet je nog niet welke soort vergelijking uit de tabel hierboven je leest.
Evaluating Large Language Models Trained on Code, het paper dat het code-generatiemodel Codex introduceerde, gebruikt bijvoorbeeld om zijn schatter voor pass@k te definiëren (vergelijking 1). Deze metric meet de kans dat minstens één van gegenereerde programma’s de tests doorstaat. In het DeepSeek-V4 technical report combineert vergelijking (2) twee uitspraken: definieert een verzameling toegestane matrices, en eist dat de mixmatrix van het model tot die verzameling behoort. De definitie gebruikt ; de beperking gebruikt , “behoort tot”. De secties over pass@k en mHC werken die voorbeelden uit.
De nieuwe vergelijking, haar definities en haar code vinden
De methodesectie van een paper beschrijft hoe het model of trainingsalgoritme werkt. De kop kan “Method”, “Architecture” of iets specifiekers zijn. Auteurs leggen vaak eerst een bestaande methode uit en laten dan zien wat ze hebben veranderd. Om de gepretendeerde bijdrage te achterhalen, begin je bij de samenvatting van wat nieuw is in de introductie. DeepSeekMath, §1.1 noemt bijvoorbeeld Group Relative Policy Optimization (GRPO), de methode om modellen te trainen op basis van gescoorde antwoorden. Sectie- en vergelijkingsnummers verwijzen hier naar het gelinkte paper.
Vergelijk daarna de voorgestelde methode met de eerdere methode die ze aanpast. Twee papers illustreren dit:
- Een architectuurwijziging. DeepSeek-V2 beschrijft standaard multi-head attention in §2.1.1 en introduceert multi-head latent attention (MLA) in §2.1.2. Standaard attention slaat de keys en values van elk eerder token op. MLA slaat een gecomprimeerde vector op waaruit ze kunnen worden gereconstrueerd. Door die vergelijkingen naast elkaar te leggen zie je wat het model anders opslaat; de MLA-uitwerking leidt de geheugenbesparing af.
- Een trainingswijziging. DeepSeekMath, §4.1.1 drukt het doel van Proximal Policy Optimization (PPO) af als vergelijking (1) en dat van GRPO als vergelijking (3). Beide gebruiken een advantage: een getal dat zegt of een antwoord beter of slechter was dan verwacht. PPO schat het met een tweede geleerd netwerk, het value model, dat de beloning voorspelt die een deelantwoord nog zal opleveren. GRPO vergelijkt in plaats daarvan de beloning van het antwoord met de beloningen van andere antwoorden op dezelfde vraag. De GRPO-uitwerking vergelijkt deze termen met de notatie voor hele antwoorden uit DeepSeek-R1.
Zoek de definities rond de vergelijking. Kijk in de voorgaande alinea, in een eventuele “where …”-zin erna, in voetnoten en in bijlagen. In Attention Is All You Need definieert de alinea vóór vergelijking (1) de dimensies, en voetnoot 4 verklaart de schaalfactor. DeepSeek-V3 definieert de meeste routingsymbolen direct na vergelijking (15), en de bias vlak vóór vergelijking (16). DeepSeek-V2 ontwikkelt MLA over de vergelijkingen (9)–(19) en verzamelt de berekening daarna in Appendix C.
Controleer het algoritme en de code. Een algoritmebox is een genummerde pseudocodelijst die de volgorde van bewerkingen vastlegt. Algorithm 1 van DeepSeekMath laat zien wanneer je antwoorden genereert en wanneer je het model bijwerkt. Algorithm 1 in Denoising Diffusion Probabilistic Models (DDPM) beschrijft hoe je het trainingsbeeld, het ruisniveau en de ruis samplet. Implementaties leggen verdere details vast: np.std deelt standaard de som van gekwadrateerde afwijkingen door , terwijl torch.std door deelt. Het GRPO-voorbeeld laat zien hoe die keuze de advantage-waarden verandert die uit dezelfde beloningen worden berekend.
arXiv-versies kunnen secties verplaatsen en vergelijkingen onder nieuwe nummers herhalen, dus citeer de versie. In DeepSeek-R1 v1 is het GRPO-doel §2.2.1, vergelijkingen (1)–(3). In v2, geplaatst in januari 2026, is het §2.1, en dezelfde vergelijkingen komen terug als (11)–(13) in Supplementary A.3. Een link zonder versie opent de nieuwste, dus elke arXiv-link in deze serie bevat de versie waartegen hij is gecontroleerd.
Je lezing controleren met een LLM
Een chatmodel kan de symbooltabel, de index van elke som en een controle met kleine getallen opstellen, als je het de definities geeft en vraagt te markeren wat ontbreekt. Tekst die uit een pdf is gekopieerd, plet subscripts, superscripts en breuken tot één regel; de links “HTML (experimental)” en “TeX Source” op de arXiv-abstractpagina geven schone tekst om te plakken. Plak de vergelijking en de alinea’s eromheen met een prompt zoals deze:
Below is equation (N) from <paper title, arXiv ID and version>, followed by
the paragraphs that define its symbols.

1. Make a table with one row per symbol: shape or type, meaning, and whether
   it is input data, a trained weight, a frozen model, a fixed setting or a
   random sample. Quote the sentence that defines it.
2. List every symbol the pasted text does not define. Do not guess them.
3. For every sum, mean, softmax, min or expectation, name the index or the
   distribution it runs over.
4. Work through the equation with the smallest numbers that use every term.
5. Say which kind of statement it is: a computation, definition, objective,
   update rule, constraint, bound, estimator or empirical fit.
Zonder stap 2 houdt niets het model tegen om een ontbrekende definitie in te vullen met de gebruikelijke betekenis van de letter, bijvoorbeeld in DPO lezen als standaarddeviatie in plaats van als sigmoid. De citaten uit stap 1 maken de tabel controleerbaar: zoek elk citaat in de pdf, en behandel een rij waarvan je het citaat niet kunt vinden als een gok.
Dezelfde procedure als agent skills. paper-math-skills verpakt deze sectie en het notatieoverzicht hieronder als twee skills voor Claude Code; andere agents die SKILL.md-bestanden laden, kunnen ze ook gebruiken. read-paper-math haalt de vastgepinde arXiv-versie op, citeert de zin die elk symbool definieert, leest de vergelijking van binnen naar buiten en voert een controle met kleine getallen uit. check-paper-math toetst zo’n lezing aan het paper: het zoekt elk citaat op, rekent de getallen opnieuw door en markeert beweringen die sterker of zwakker zijn dan die van het paper. paper-math-readings bevat de lezingen van de skills voor deel 2 tot en met 4, één voor elk van de 15 secties met een Source:-regel.
Notatieoverzicht
Als een Griekse letter je onbekend is, open dan het Griekse-lettersoverzicht van dit artikel (Appendix A) voor haar naam en gangbare betekenissen. Voor meer oefening met de wiskunde bieden Stanford CS229 overzichten van kansrekening en lineaire algebra met oefeningen; de preliminaries van Dive into Deep Learning leggen de basis uit met code.
Subscripts, tekens en relatietekens
Letters zijn lokale variabelenamen: elk paper definieert de zijne. Subscripts zijn meestal indices. kan coördinaat van een vector zijn of voorbeeld in een dataset, en is de vector van het model voor token , zijn hidden state.
Superscripts in modelpapers zijn vaak labels. In is de superscript tussen haakjes meestal een laagnummer, geen macht; in en van DeepSeek-V3 geeft ze gedeelde en gerouteerde experts aan: degene die elk token gebruikt en degene die een router kiest (zie het MoE-routingvoorbeeld). In DeepSeek-V2 dragen en labels, geen exponenten; het MLA-voorbeeld definieert die labels. is een getransponeerde en is een kwadraat.
betekent de posities 1 tot en met , inclusief , anders dan een Python-slice; papers tellen meestal vanaf 1. betekent elke positie vóór . selecteert rij , zoals bij NumPy-slicing.
Tekens op een letter veranderen haar betekenis meestal op een van deze manieren:
| Teken | Gebruikelijke lezing | Voorbeeld of uitzondering |
|---|---|---|
| Een voorspelling of schatting | Voorbeeld: in DeepSeekMath schat hoeveel beter een antwoord scoorde dan verwacht | |
| Een gemiddelde | Uitzondering: in DDPM vermenigvuldigt de factoren van het ruisschema van stap 1 tot en met | |
| Een verstoorde of onbeperkte versie | Voorbeeld: in DeepSeek-V4 is een matrix voordat normalisatie haar beperkingen afdwingt | |
| Het optimum | Uitzondering: in DPO is de ware beloning, die de methode nooit waarneemt | |
| Een nieuwe waarde of een tussenwaarde | Voorbeeld: in DeepSeek-V3 is een expertgewicht vóór normalisatie | |
| De matrixinverse | Niet de elementsgewijze reciproke: maakt ongedaan, (de eenheidsmatrix), en in het algemeen geldt |
Sommige symbolen die geen Griekse letters zijn, hebben ook meerdere taken:
| Symbool | Betekenissen |
|---|---|
| Conditionering in ; “zodanig dat” binnen een verzameling | |
| Een absolute waarde; de lengte van een sequentie, zoals in , het aantal tokens van GRPO’s antwoord ; de grootte van een verzameling | |
| ”Wordt getrokken uit” in ; “ongeveer” in informele tekst | |
| Een sequentielengte; een softmax-temperatuur; het aantal diffusiestappen | |
| Een query-vector (attention); een vraag (GRPO); het studentmodel (distillation); de encoder (ELBO) |
Vijf tekens geven aan hoe twee kanten zich tot elkaar verhouden. , soms , definieert een nieuwe naam. markeert een benadering, zoals het gesamplede gemiddelde in Verwachtingswaarden en waar de samples vandaan komen. betekent “evenredig met”, waarbij een normaliseringsconstante is weggelaten: wordt pas een verdeling na deling door . betekent “veel kleiner dan”, zoals in van DeepSeek-V2: de gecomprimeerde breedte is veel kleiner dan de totale breedte van alle heads. is een toewijzing, zoals in een updateregel.
Sommen, tellingen, intervallen en logaritmen
De grote telt termen op en vermenigvuldigt ze. De index onder elke operator begint hier bij 1 en loopt tot en met de bovengrens :
De index hoort bij de operator, zoals een lusvariabele bij zijn lus hoort. In loopt de som over , terwijl een outputelement aanwijst. Het resultaat is een vector met één element per : het matrix-vectorproduct uitgeschreven. De indices aan de linkerkant vertellen je de vorm van de output.
De factor voor een som bepaalt wat gelijk gewicht krijgt. Een batch met een antwoord van 2 tokens en een van 8 tokens, waarbij de loss op token van antwoord is (in GRPO is in plaats daarvan een term om te maximaliseren), kan op twee manieren worden gemiddeld:
In de eerste krijgt elk antwoord gewicht , gedeeld over zijn tokens:
In de tweede heeft elk token gewicht . GRPO samplet antwoorden op elke vraag, en is het aantal tokens in antwoord . De twee gemiddelden luiden dan als volgt, voor DeepSeekMath’s GRPO en voor DAPO, een latere variant van GRPO:
Met zijn dit en hierboven. DAPO stapte over op het gemiddelde per token (§3.3) omdat het gemiddelde per antwoord de tokens van lange antwoorden te weinig gewicht gaf: het model leerde te weinig van lange goede antwoorden en strafte lange, repetitieve slechte antwoorden niet genoeg.
Een som kan ook tellen. Papers doen dat met een indicator: een vetgedrukte één gevolgd door een voorwaarde, , die gelijk is aan 1 als de voorwaarde waar is en aan 0 als ze onwaar is. Sommige papers zetten de voorwaarde tussen haakjes of drukken een één in blackboard bold af; de betekenis is dezelfde. Indicatoren optellen telt dus hoe vaak de voorwaarde geldt. Accuracy is het gebruikelijke voorbeeld. Als de voorspelde klasse is en de juiste klasse voor voorbeeld , dan is het aantal juiste voorspellingen. Voorspellingen (kat, hond, hond) tegen juiste labels (kat, kat, hond) geven de indicatoren 1, 0 en 1, dus de telling is 2 en de accuracy 2/3. In een mixture-of-experts-laag (MoE) stuurt een router elk token naar een paar van de vele feed-forward-subnetwerken, experts genoemd. In de balansloss van DeepSeek-V3 (vergelijking 18) is de indicator 1 wanneer de score van een expert voor een token tot de hoogste scores voor dat token behoort, waarbij het aantal experts is waarnaar elk token wordt gerouteerd. De som over de tokens van een sequentie telt hoe vaak dat gebeurde. De score laat hier de bias weg die de routing toevoegt, dus de telling kan afwijken van de experts die de router werkelijk kiest (MoE-routing).
De binomiaalcoëfficiënt , gelezen als ” boven ”, telt de manieren om verschillende items uit te kiezen, zonder rekening te houden met de volgorde. Voor gehele getallen is ze gelijk aan . Het uitroepteken betekent faculteit: , met . Bijvoorbeeld : vijf items hebben tien verschillende paren. DeepSeekMoE gebruikt binomiaalcoëfficiënten om combinaties van experts te tellen, en de pass@k-schatter gebruikt ze om verzamelingen samples te tellen.
Intervallen gebruiken haakjes voor meegenomen uiteinden: omvat beide, geen van beide. In Gated DeltaNet betekent strikt tussen 0 en 1. Elders is een paar.
De natuurlijke logaritme draait machtsverheffen om: . Logaritmen zetten producten om in sommen en quotiënten in verschillen: en , maar valt niet uiteen. Daarom werken papers met log-kansen. De log van een product van tokenkansen is een som, en de log van een quotiënt van de kansen van twee modellen is een verschil, de vorm die in de DPO- en GRPO-doelen wordt gebruikt. ML-papers bedoelen de natuurlijke log tenzij ze anders zeggen; de resultaten zijn in nats, en logaritmen met grondtal 2 geven bits. Voor een kans geldt , en die groeit onbegrensd als naar 0 gaat, dus een zelfverzekerde foute voorspelling is duur.
Log-sum-exp betekent: neem de exponentiële waarde van elke score , tel de resultaten op en neem dan de logaritme. direct berekenen kan overlopen als een score groot is. Zoek in plaats daarvan de grootste score en noem die . De notatie betekent “vergelijk alle elementen en neem de grootste”; in NumPy m = z.max().
Trek van elke score af vóór het exponentiëren en tel het na het nemen van de logaritme weer op:
Voor is de grootste score . De verschoven scores zijn , dus de berekening wordt . Geen van beide exponentiële waarden is groter dan 1. De attention-code gebruikt dezelfde aftrekking vóór softmax; daar valt de gemeenschappelijke factor weg in de deling, dus er hoeft niets bij te worden opgeteld.
Voorwaardelijke kans en de kans van tekst
is de kans die het model met parameters aan output toekent gegeven input . De subscript noemt de parameters; sommige papers schrijven , waarbij de puntkomma ook parameters aanduidt in plaats van een voorwaarde. Met een punt op de plaats van de output is de hele verdeling over outputs in plaats van één getal. RL-papers schrijven hetzelfde object als , de kans dat het model antwoord schrijft op vraag , en noemen het model een policy.
Als je de gebeurtenis en de voorwaarde omwisselt, krijg je een ander getal. Stel dat er 100 modelantwoorden zijn: 60 zijn juist, 50 zijn geldige JSON en 40 zijn beide. Dan geldt
Laat betekenen “het antwoord is juist” en “het antwoord is geldige JSON”. Voorwaardelijke kans beperkt de telling tot antwoorden die aan de voorwaarde voldoen: , mits . Het symbool betekent “beide gebeurtenissen treden op”. Hier is de breuk , hetzelfde als 40 juiste antwoorden onder 50 geldige JSON-antwoorden.
Twee gebeurtenissen zijn onafhankelijk wanneer weten dat de ene zich voordeed de kans op de andere niet verandert. Dat vereist . In deze steekproef is , terwijl , dus de waargenomen verhoudingen voldoen niet aan onafhankelijkheid.
De stelling van Bayes, ook wel de regel van Bayes genoemd, verbindt de twee richtingen van conditionering: . Daarmee bereken je de kans op gegeven uit de kans op gegeven en de kansen van de twee gebeurtenissen. Het ELBO-voorbeeld gebruikt haar om de kans op een verborgen code gegeven een waargenomen beeld te vinden.
Een taalmodel scoort een sequentie token voor token. Volgens de kettingregel van de kansrekening geldt
Elke factor conditioneert op alle eerdere tokens, dus de formule neemt niet aan dat tokens onafhankelijk zijn. Als drie tokens voorwaardelijke kansen 0.5, 0.2 en 0.1 hebben:
De gebruikelijke trainingsloss is het negatief van deze som, gedeeld door de lengte:
Tijdens het trainen komen de eerdere tokens uit de dataset. Tijdens het genereren zijn het de eerdere keuzes van het model zelf.
Verwachtingswaarden en waar de samples vandaan komen
Een verwachtingswaarde is een met kansen gewogen gemiddelde:
Lees als “het gemiddelde van wanneer uit wordt getrokken”. De notatie sommeert over alle mogelijke discrete waarden van . Zonder subscript middelt een stochastische variabele over haar eigen verdeling: als met kans 0.75 gelijk is aan 1 en met kans 0.25 aan 3, dan is .
Als een variabele een dichtheid heeft, dat wil zeggen kans per eenheid van , is het gewogen gemiddelde een integraal, . De geeft aan dat de variabele is waarover wordt geïntegreerd; zonder hier opgeschreven grenzen omvat de integraal het hele bereik. Het dichtheidsvoorbeeld legt kans per eenheid uit en toont een integraal als een oppervlakte onder een curve.
Trainingscode kan niet over elke mogelijke input sommeren, dus ze samplet en middelt: , waarbij elke onafhankelijk uit is getrokken, wat papers schrijven als . Papers noemen dit een Monte Carlo-schatting, en in code is het loss.mean() over een batch. Het batchgemiddelde schat de verwachtingswaarde alleen als de batch is getrokken uit de verdeling in de subscript van de , dus de subscript vertelt je hoe de trainingsdata tot stand komt:
- DPO middelt over opgeslagen voorbeelden : een prompt, een voorkeursantwoord en een afgewezen antwoord. De antwoorden worden vóór deze trainingsfase verzameld en gelabeld; ze kunnen uit eerdere modelgeneratie komen. Bij elke trainingsstap berekent het model kansen voor die aangeleverde antwoorden en werkt het zijn weights bij. Het model samplet voor die stap geen nieuwe antwoorden.
- GRPO in DeepSeek-R1: genereer antwoorden en vergelijk dan hun beloningen. De training trekt een vraag uit de dataset, genereert meerdere antwoorden en scoort ze met een beloningsfunctie, bijvoorbeeld door een wiskundig resultaat te controleren of unit tests uit te voeren. De update geeft de voorkeur aan antwoorden die boven het groepsgemiddelde scoorden. De notatie betekent “sample een vraag uit de vraagverdeling”. De notatie betekent “sample antwoorden op die vraag uit de modelkopie genaamd ”. De subscript old markeert de kopie die deze antwoorden genereerde; die kopie blijft vast terwijl de batch voor updates wordt gebruikt. De GRPO-uitwerking legt de beloningsvergelijking en de updates uit.
- On-policy distillation in MiniLLM en DeepSeek-V4: genereer tekst en leer dan van teacher-kansen. Het model dat wordt getraind is de student. Hij genereert tekst; een bevroren teacher levert de kansen voor het volgende token bij dezelfde prefixen, en de training past de kansen van de student aan naar die van de teacher. Deze kansen vormen het trainingssignaal, in plaats van GRPO’s beloningsscore voor een antwoord. MiniLLM schrijft door de student gesamplede tekst als : is de tekst en noemt het studentmodel. DeepSeek-V4 noemt zijn student en gebruikt meerdere gespecialiseerde teachers. De feitelijke samplingprocedure van MiniLLM mengt ook tokens bij die uit de teacher zijn getrokken. De distillation-uitwerking legt de doelen en dat samplingverschil uit.
De volgorde bepaalt wat de training optimaliseert. Stel dat een model kansen 0.9 en 0.1 toekent aan de juiste outputs van twee even zwaar wegende trainingsvoorbeelden. Hun log-kansen middelen betekent eerst elke log nemen en dan middelen: np.log(probs).mean(). De log van hun gemiddelde nemen is np.log(probs.mean()). Als de kans is die wordt toegekend aan de juiste output van een willekeurig gekozen voorbeeld:
Als je het teken van deze scores omdraait, krijg je losses van 1.20 en 0.69. Een tweede model dat aan elke juiste output 0.5 toekent, krijgt bij beide berekeningen 0.69. Kansen middelen vóór het nemen van de log behandelt de twee modellen dus als even goed, terwijl de gebruikelijke gemiddelde negatieve log-kans het eerste model zwaarder straft voor zijn lage kans op de tweede juiste output. Behoud bij het vertalen van een loss naar code de volgorde van de log en het gemiddelde.
De ongelijkheid van Jensen geeft de algemene relatie voor positieve : . Ze helpt ook bij het construeren van alternatieve trainingsdoelen. Wanneer de datakans van een model een dure middeling over verborgen variabelen vereist, kan een gemiddelde van logtermen een ondergrens leveren die makkelijker te schatten is. De ELBO-uitwerking legt dat trainingsprobleem uit; ELBO staat voor evidence lower bound. Sectie 2.4 van Tianhua Chens The Little Book of Generative AI Foundations leidt de grens af met de ongelijkheid van Jensen.
Dichtheden, variantie en foutbalken
heeft twee gangbare betekenissen. Voor discrete uitkomsten zoals tokens of klassen geeft ze de kans op uitkomst : een getal van 0 tot 1, waarbij de kansen over alle uitkomsten optellen tot 1.
Om de andere betekenis te begrijpen, stel dat uniform tussen 0 en 0.5 wordt gekozen. Intervallen van gelijke lengte hebben gelijke kansen. Het interval van 0.1 tot 0.2 beslaat een vijfde van het hele bereik, dus
Binnen dit bereik is de kans de breedte van het interval maal 2. Die vermenigvuldiger is de kansdichtheid: voor , en nul daarbuiten. Dichtheid beschrijft kans per eenheid van de variabele, niet de kans op één exacte waarde.
Kans nul voor een punt betekent niet dat er niets wordt gesampled. Verklein een interval rond 0.15: zijn kans is tweemaal zijn breedte, dus hij gaat naar nul als de breedte naar nul gaat. Het ene exacte punt heeft daarom kans nul. Een trekking levert nog steeds een waarde in op, en dat hele interval heeft kans 1. Als je het resultaat afgerond op twee decimalen noteert, staat een genoteerde waarde 0.15 voor het interval van 0.145 tot 0.155, met kans .
Bij een niet-uniforme dichtheid varieert de vermenigvuldiger met . De integraal telt de bijdragen over het interval op:
Meetkundig is dit de oppervlakte onder de dichtheidscurve tussen en ; de oppervlakte over het hele bereik is 1. Voor het uniforme voorbeeld is de oppervlakte simpelweg hoogte 2 maal breedte 0.5. Een dichtheid kan dus groter zijn dan 1, en haar log kan positief zijn, zoals hier. Een kans is nooit groter dan 1.
De Gauss-verdeling die in DDPM voor ruis wordt gebruikt, heeft een dichtheid van dit soort. Niet elke continue verdeling heeft een gewone dichtheid: de Cantor-verdeling is een wiskundig tegenvoorbeeld, buiten de modellen die hier worden besproken. Opslag met reële getallen impliceert ook geen continue verdeling: een variabele die beperkt is tot 0.0 en 1.0 heeft nog steeds twee discrete uitkomsten.
Papers gebruiken vaak dezelfde letter voor kansen en dichtheden. Kijk hoe het paper de verdeling van de variabele definieert en over welke variabele wordt gesommeerd of geïntegreerd. Een integraal over een verborgen variabele , zoals de latente code in de ELBO van deel 4, zegt je niet of een waargenomen discreet of continu is. Sommige papers schrijven hoofdletter voor kansen en kleine letter voor dichtheden, maar veel gebruiken voor beide.
Om te beschrijven hoeveel een verdeling rond haar gemiddelde spreidt, gebruiken papers variantie: het gemiddelde gekwadrateerde verschil met het gemiddelde, , waarbij . De standaarddeviatie is de wortel ervan, dus ze heeft dezelfde eenheden als .
Deze grootheden komen ook voor in namen van verdelingen. De Gauss-verdeling, ook normale verdeling genoemd, wordt geschreven als : is het gemiddelde en de variantie. Voor een vector gebruikt een covariantiematrix : element meet hoe de coördinaten en samen variëren, en de diagonaal bevat hun varianties. beschrijft een vector van onafhankelijke standaardnormale getallen, elk met gemiddelde 0 en variantie 1; is de eenheidsmatrix.
Benchmarktabellen geven vaak een gemiddelde score samen met een maat voor variatie. De spreiding van afzonderlijke runs verschilt van de onzekerheid van hun gemiddelde: voor onafhankelijke runs met standaarddeviatie is de standaardfout van het gemiddelde .
Zoek, voordat je twee vermeldingen zoals en vergelijkt, in het bijschrift uit of 0.4 een standaarddeviatie over runs is, een standaardfout of de halve breedte van een betrouwbaarheidsinterval. Om de gemiddelden te vergelijken, bereken je een interval voor hun verschil. Een 95%-betrouwbaarheidsintervalprocedure levert bereiken op die het ware verschil bevatten in 95% van herhaalde experimenten, onder haar aannames.
Neem voor dit voorbeeld aan dat er vier onafhankelijke runs per model zijn, ongeveer normale runscores en gelijke populatievarianties. Als de runs gepaard zijn, zoals twee modellen die op dezelfde onafhankelijk gesamplede taken worden geëvalueerd, analyseer dan in plaats daarvan de verschillen binnen de paren. NIST’s gids voor twee steekproeven legt deze gevallen uit.
Voor onafhankelijke gemiddelden is de variantie van hun verschil de som van hun varianties. Een standaardnormale variabele valt met kans ongeveer 0.95 tussen en , wat de vermenigvuldiger levert voor een normale benadering van een 95%-interval. Als 0.4 de standaarddeviatie over vier runs is, geeft die eerste berekening:
Die vermenigvuldiger 1.96 behandelt de geschatte spreiding als bekend. Met slechts vier runs per model gebruik je de t-verdeling van Student om de onzekerheid in de spreiding mee te nemen. Onder de bovenstaande aannames zijn de vrijheidsgraden (acht runs min twee geschatte gemiddelden). scipy.stats.t.ppf(0.975, 6) geeft ongeveer 2.447 in plaats van 1.96; 0.975 laat 2.5% buiten elk uiteinde van een 95%-interval. Als de aanname van gelijke variantie niet past, gebruik dan een Welch-interval, waarvan de vrijheidsgraden anders worden berekend.
Beschouw nu de andere lezing van het bijschrift: 0.4 is al de standaardfout van elk gemiddelde, geschat uit die vier runs. Er wordt niets door gedeeld, en de standaardfout van het verschil is ongeveer 0.566. De t-vermenigvuldiger is nog steeds nodig. De twee lezingen geven:
De figuur vergelijkt de eerste normale benadering met de twee t-intervallen:
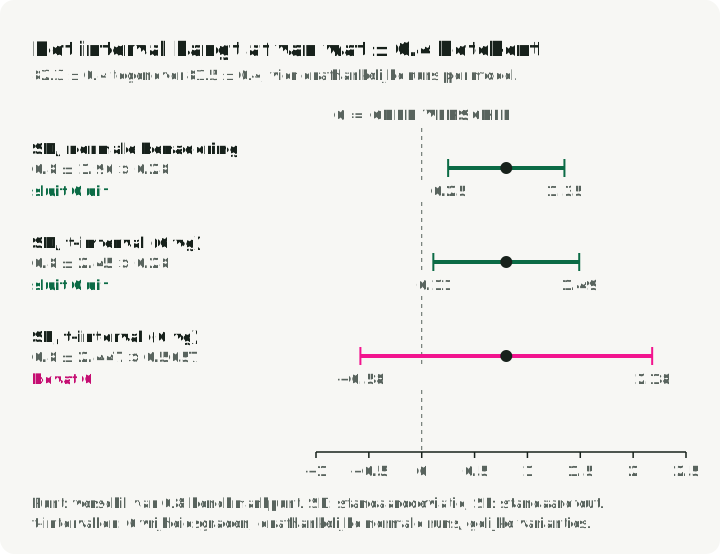
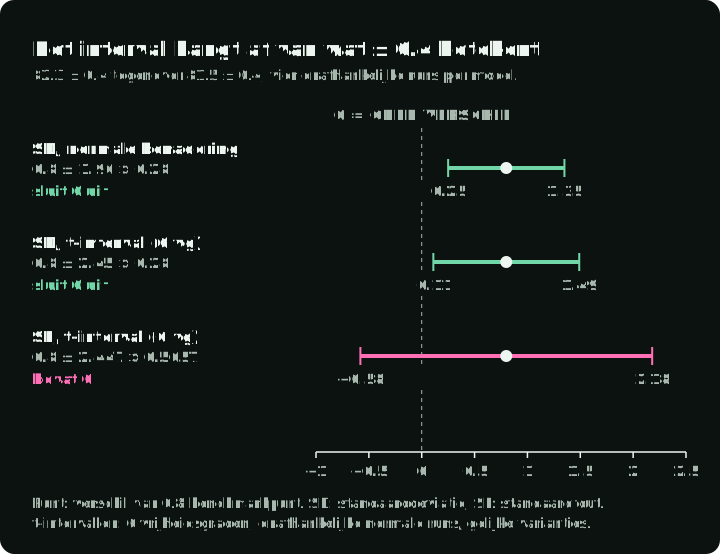
Wanneer 0.4 de standaarddeviatie is, sluit het t-interval nul uit: onder deze aannames ondersteunen de resultaten een positief verschil. Wanneer 0.4 de geschatte standaardfout is, bevat het interval nul, dus de resultaten stellen niet vast welk model de hogere gemiddelde score heeft.
Cross-entropy en KL-divergentie
Tijdens het trainen heeft een model een numerieke loss nodig die meet hoe goed zijn voorspelde kansen overeenkomen met het trainingsdoel. Het trainingsalgoritme verandert de parameters van het model om die loss te verkleinen. Cross-entropy levert zo’n loss voor gelabelde voorbeelden of de kansen van een teacher-model. Kullback–Leibler-divergentie (KL) meet het verschil tussen twee verdelingen. Papers gebruiken haar om een student een teacher te laten nabootsen of om afwijkingen van een vast referentiemodel te straffen.
Hier zijn de uitkomsten discreet, zoals tokens of klassen. Schrijf de doelverdeling als en de voorspelde verdeling van het model over dezelfde uitkomsten als . Begin met één waargenomen uitkomst : als het model er kans aan gaf, is haar loss . Die is 0 als , ongeveer 0.69 als , ongeveer 2.3 als , en oneindig als .
Cross-entropy middelt die loss over uitkomsten die uit het doel zijn getrokken:
Met een one-hot-label , dat 1 is bij de juiste klasse en elders 0, telt alleen de juiste klasse, en : de gewone classificatieloss. PyTorch’s nn.CrossEntropyLoss berekent dit uit ruwe modelscores, logits genoemd, en past intern log-softmax toe; haar input is niet de kansvector . Met de zachte verdeling van een teacher-model als telt elke klasse mee naar rato van de kans van de teacher. Klassieke distillation traint op die manier een klein model op de kansen van een groot model. Voor het doel hebben twee modellen deze cross-entropies :
Het tweede model komt overeen met het doel, en geen enkel model kan beter. Dat minimum, hier 0.325, is , de entropie van . Ze is alleen 0 voor een one-hot-doel: als het doel zelf onzeker is, blijft er een loss over die geen enkel model kan wegnemen.
KL-divergentie trekt dat minimum af en houdt alleen de loss over die ontstaat doordat van verschilt. Ze wordt geschreven met een dubbele streep , die alleen de twee argumenten scheidt; het is niet de voorwaardelijke-kansstreep uit Voorwaardelijke kans en de kans van tekst en ook niet de lengtestrepen uit het overzicht over vectoren. Papers gebruiken haar in plaats van een komma om aan te geven dat de volgorde telt: het gemiddelde loopt over uitkomsten die uit het eerste argument zijn getrokken.
Voor het eerste model hierboven geldt . KL is 0 wanneer de twee verdelingen overeenkomen en anders positief.
De volgorde bepaalt welke afwijkingen worden gestraft. Een term met en is oneindig, dus straft voor het toekennen van kans nul aan alles wat kan voortbrengen. Uitkomsten met voegen niets toe (volgens afspraak is ), dus ze geven geen directe straf, ook als . Als je de argumenten omdraait, krijg je , die oneindig is overal waar en . Uitkomsten met voegen nu niets toe, ook als . Met als doel heet de forward KL en de reverse KL.
Voor en is de forward KL oneindig, omdat een uitkomst mist die voortbrengt, terwijl de reverse KL slechts is: de uitkomst die overslaat voegt niets toe. Voor en is de forward KL de 0.37 die hierboven werd gevonden, hier term voor term berekend, en de reverse KL verschilt:
Deze asymmetrie is waarom KL een divergentie heet en geen afstand.
Omdat , en de entropie van een vaste teacher niet van de student afhangt, geeft cross-entropy tegen een vaste teacher de student dezelfde gradients als . Als een parameter van de student verandert, veranderen beide losses evenveel, dus hun afgeleiden die voor de training worden gebruikt zijn gelijk; Gradients en optimalisatie legt die berekening uit. Daardoor kunnen classificatiecode en klassieke distillation-code cross-entropy gebruiken. De omwisseling werkt alleen met de teacher eerst. Met de student eerst geldt , en de eigen entropie van de student verandert tijdens het trainen, dus de twee geven niet meer dezelfde gradients.
Vectoren en matrices
Architectuurvergelijkingen beschrijven berekeningen op arrays van getallen. De vorm van een array vertelt je hoe haar getallen zijn gerangschikt, welke bewerkingen geldig zijn en wat die bewerkingen opleveren. Een vector is een geordende lijst getallen. Een matrix rangschikt getallen in rijen en kolommen. In ML-code is tensor de algemene term voor deze numerieke arrays, ook voor arrays met meer dan twee assen. Een as is een dimensie waarlangs je de array indexeert: een matrix heeft een rij-as en een kolom-as.
De hidden state van een token is een vector getallen die binnen het model wordt berekend om dat token voor te stellen. Stel dat we een batch van sequenties tegelijk verwerken, elk met tokenposities, en elke hidden state bevat getallen. De hidden-statearray heeft vorm [B, T, d], wat papers ook schrijven als . Haar drie assen kiezen de sequentie, de tokenpositie en het getal binnen de vector van dat token. [2, 3, 4] bevat bijvoorbeeld twee sequenties, drie tokenvectoren per sequentie en vier getallen per vector: 24 getallen in totaal. Hier is de breedte van de vector. De vorm noemt de drie groottes; door ze te vermenigvuldigen krijg je het aantal elementen.
Papers schrijven vormen vaak als verzamelingslidmaatschap: betekent dat een vector van reële getallen is, en dat een matrix met rijen en kolommen is. Vetgedrukte letters markeren soms vectoren of tensoren, maar de definitie in het paper bepaalt de vorm.
In de tabel hieronder zijn en kolomvectoren: hun getallen staan verticaal. De superscript betekent transponeren: rijen en kolommen verwisselen. is dus een rij met dezelfde getallen als kolom . De hoofdletters en benoemen hier matrices; betekent niet langer de batchgrootte.
| Uitdrukking | Waarden die ze gebruikt | Wat de bewerking doet | Resultaat |
|---|---|---|---|
| — inproduct | Twee kolomvectoren, elk met elementen | Vermenigvuldig overeenkomstige elementen en tel de producten op: | Eén getal |
| — uitwendig product | Een kolom met elementen en een kolom met elementen | Vermenigvuldig elk element van met elk element van | Een matrix van ; element is |
| — matrixproduct | met rijen en kolommen; met rijen en kolommen | Vermenigvuldig voor element overeenkomstige getallen in rij van en kolom van en tel op | Een matrix van ; het aantal kolommen van moet gelijk zijn aan het aantal rijen van |
| — elementsgewijs product | Twee arrays met dezelfde vorm | Vermenigvuldig elementen op overeenkomstige posities, zonder op te tellen | Een array met dezelfde vorm |
| — concatenatie | Kolommen en met en elementen | Zet de elementen van achter die van | Eén kolom met elementen; controleer de afspraak van het paper voor de samenvoegas |
Neem voor een concrete vergelijking en . Door de transpositie te verplaatsen veranderen zowel de berekening als het resultaat:
Het inproduct geeft één score, zoals bij de query–key-vergelijking in attention. Het uitwendig product houdt een aparte waarde voor elk paar elementen; de update van Gated DeltaNet gebruikt het om uit twee vectoren een matrixupdate te bouwen.
Een matrixproduct kun je anders groeperen, , maar niet van volgorde veranderen; de MLA-afleiding gebruikt het hergroeperen om het opnieuw opbouwen van keys over te slaan. NumPy schrijft matrixvermenigvuldiging als @ en het elementsgewijze product als *. Papers erven NumPy’s broadcastingregels niet: een vector bij een matrix optellen vereist een benoemde as. Papers verschillen ook over de vraag of een vector een rij of een kolom is: attention stapelt tokens als de rijen van , terwijl MLA, Gated DeltaNet en LoRA met kolomvectoren schrijven, en PyTorch’s nn.Linear x @ W.T op rijen berekent.
Een architectuurvergelijking kan ook de grootte van een vector beschrijven, beperken welke matrices zijn toegestaan of een product herschikken:
| Notatie | Betekenis |
|---|---|
| De Euclidische lengte; , zonder de wortel, komt voor in DDPM’s loss | |
| De som van absolute waarden | |
| De spectrale norm: de grootste factor waarmee de lengte van een vector vergroot; mHC houdt haar hoogstens 1 | |
| Het aantal onafhankelijke kolommen; LoRA’s update heeft rang hoogstens | |
| De determinant: is de factor waarmee volume schaalt, en het teken geeft aan of de oriëntatie omkeert; het voorbeeld van variabelentransformatie in Appendix B van dit artikel gebruikt haar | |
| Elk element is niet-negatief, zoals in mHC; is een andere voorwaarde, positief semidefiniet: voor elke | |
| , | De eenheidsmatrix (1 op haar diagonaal, elders 0, dus ); een vector van enen |
| Het transponeren van een product keert de volgorde om; de RoPE- en MLA-secties van deel 2 gebruiken dit |
Gradients en optimalisatie
Training gebruikt afgeleiden om te bepalen hoe de parameters van het model moeten veranderen. Laat één scalaire loss zijn en de vector van alle parameters; is één element van die vector.
De partiële afgeleide is één getal, geëvalueerd bij de huidige parameterwaarden. Ze meet de veranderingssnelheid van de loss wanneer alleen verandert en de andere parameters vast blijven. Lees haar als “de partiële afgeleide van de loss naar parameter ”.
De gradient bundelt die getallen voor elke parameter in één vector. Haar -de element is . Het symbool heet nabla; hier betekent het “neem de gradient”. Met slechts één parameter heeft de gradient één element dat gelijk is aan de gewone afgeleide.
Neem bijvoorbeeld . Bij en :
De eerste partiële afgeleide, 4, betekent dat met 0.01 verhogen de loss met ongeveer 0.04 doet stijgen terwijl vast blijft. De gradient bevat deze informatie voor beide parameters. Gradient descent trekt de afgeleide van elke parameter af, vermenigvuldigd met een positieve learning rate die de stapgrootte bepaalt:
Met verandert het voorbeeld van naar , en de loss daalt van 7 naar 3.04. Bij een differentieerbare loss met een gradient ongelijk aan nul verlaagt een voldoende kleine stap de loss. Een gradient van nul geeft geen update.
De subscript op zegt wat varieert. laat de parameters variëren; laat de input variëren, en diffusionpapers noemen haar de score, wat niets te maken heeft met een benchmarkscore.
Een Jacobiaan legt afgeleiden voor meerdere outputs vast. Een laag van een neuraal netwerk kan veel getallen produceren, zoals de componenten van de hidden state van een token. Om te beschrijven hoe elke output op elke input reageert, bundel je de partiële afgeleiden in een matrix die de Jacobiaan heet. Voor met inputgetallen en outputgetallen heeft ze vorm : rijen komen overeen met outputs, kolommen met inputs, en element meet hoe output verandert wanneer input verandert.
Laat een functie bijvoorbeeld twee getallen nemen en en teruggeven. Haar Jacobiaan is
De tweede kolom zegt dat met 0.1 verhogen terwijl vast blijft met 0.2 verhoogt en met 0.1 verlaagt. Dit voorbeeld is lineair, dus de Jacobiaan is constant. Bij een niet-lineaire functie kunnen de elementen van de huidige input afhangen en lokaal kleine veranderingen beschrijven. Met slechts één scalaire output heeft de Jacobiaan één rij: dezelfde afgeleiden als de gradient, getransponeerd volgens onze afspraak met kolomvectoren. Deep Learning, §4.3, geeft de algemene definities.
Backpropagation gebruikt deze afgeleiden om de gradient van de loss door opeenvolgende lagen te berekenen. Het voorbeeld van variabelentransformatie in Appendix B van dit artikel gebruikt een andere eigenschap: de absolute waarde van de determinant van een vierkante Jacobiaan geeft de lokale volumeschaalfactor, die nodig is om een kansdichtheid aan te passen.
Voor training beschrijven afgeleiden lokale veranderingen; een optimalisatiedoel stelt wat de updates moeten minimaliseren of maximaliseren. Papers onderscheiden de beste waarde van een doel van de parameters die haar bereiken: is de kleinste waarde van , terwijl de parameterwaarden geeft die haar bereiken. Voor is het minimum 0 en de argmin 3. Een argmin legt het gewenste resultaat vast, maar laat het updatealgoritme open.
MiniLLM schrijft haar doel bijvoorbeeld als (vergelijking 1), waarbij het studentmodel is en de teacher waarvan hij leert. Sectie 2.2 leidt vervolgens een gradient af en past haar aan om de training stabieler te maken; vergelijking (7) is de gradient die voor updates wordt gebruikt. Het voorbeeld van on-policy distillation legt die wijzigingen uit. Wie alleen de argmin leest, mist ze.
Een stop-gradient, , geeft ongewijzigd door maar blokkeert gradients erdoorheen, zoals .detach() in PyTorch. Twee uitdrukkingen met dezelfde forward-waarde kunnen verschillend trainen als een van beide is losgekoppeld. In het GRPO-voorbeeld behandelt Hugging Face TRL de log-kans van het oude model als vast. In de vereenvoudigde distillation-aanpak die DeepSeek-V4 bespreekt, levert een losgekoppelde log-ratio van teacher en student een vast gewicht voor de update.
Verzamelingen en beperkingen
Een beperking legt vast welke waarden zijn toegestaan. Papers drukken beperkingen vaak uit met verzamelingen: collecties van verschillende elementen, geschreven tussen accolades, zoals . De volgorde doet er niet toe, dus is dezelfde verzameling. Herhaalde elementen tellen maar één keer. De haakjes in een vector zoals beschrijven daarentegen een geordende lijst: is een andere vector.
Zodra een paper een verzameling definieert, kan ze lidmaatschap testen, verzamelingen combineren, hun elementen tellen of er een voorwaarde voor stellen. Neem en :
| Notatie | Betekenis | Voorbeeld en hoe je het leest |
|---|---|---|
| Lidmaatschap: behoort tot | : 2 is een element van | |
| Vereniging: neem elk element van een van beide verzamelingen | ; neem 3 maar één keer | |
| Doorsnede: houd alleen elementen over die in beide voorkomen | ||
| Het aantal verschillende elementen | ||
| ”Voor elk”: een voorwaarde moet gelden voor alle genoemde elementen | : elk element van is positief | |
| ”Er bestaat”: minstens één element moet aan de voorwaarde voldoen | : heeft een element groter dan 2, namelijk 3 |
De vormnotatie uit Vectoren en matrices benoemt ook verzamelingen: is de verzameling van alle vectoren van reële getallen, en de verzameling van alle reële matrices met rijen en kolommen. legt dus vast welke vorm moet hebben.
Set-builder-notatie beschrijft een verzameling aan de hand van een voorwaarde: leest als “de elementen van die aan de voorwaarde voldoen”, net als de Python-set comprehension {x for x in S if condition(x)}. De streep betekent “zodanig dat”, niet voorwaardelijke kans; sommige papers gebruiken in plaats daarvan een dubbele punt. Voorbeelden in deze serie zijn de toegestane matrices van mHC, de geselecteerde experts van MoE en de geselecteerde tokens van sparse attention.
DAPO, een trainingsmethode die groepen gegenereerde antwoorden filtert, houdt een vraag alleen als sommige antwoorden juist zijn en sommige fout. Voor gesamplede antwoorden en referentieantwoord schrijf je de verzameling van indices van juiste antwoorden als
Het filter is . Met indices ligt het tellen vast: twee samples met identieke tekst tellen nog steeds als twee antwoorden. Het paper van DAPO schrijft de verzameling in plaats daarvan over de antwoorden ; letterlijk gelezen als verzameling teksten telt die vorm twee identieke antwoorden één keer.
Oefeningen
- Vormen. is , is en is . Welke vormen hebben de scores en de output? Over welke as loopt softmax?
- Softmax. Bereken de softmax van . Verandert het resultaat als je 100 bij beide inputs optelt?
- Gemiddelden. Eén antwoord heeft één token met loss 4; een ander heeft drie tokens met loss 0. Bereken het gemiddelde per token en het gemiddelde per antwoord.
- Conditioneren. Van 200 antwoorden zijn er 120 juist, 80 doorstaan de formaatvalidatie en 60 doen beide. Bepaal en .
- KL. Bereken voor een teacher en een student beide KL-richtingen.
- Verzamelingen. DAPO houdt een vraag alleen als , waarbij de indices van juiste antwoorden onder samples bevat. Houdt het met een vraag waarvan de antwoorden scoren? Een vraag met antwoorden die scoren? Verandert het eerste antwoord als alle vier de samples identieke juiste tekst bevatten?
Antwoorden:
-
De scores zijn en de output is . Softmax loopt over de zes keys in de rij van elke query.
-
. Hetzelfde getal bij elke input optellen laat softmax ongewijzigd, maar direct berekenen loopt over in 32-bit floats.
-
De twee gemiddelden:
-
en .
-
, en , omdat de student kans toekent aan een uitkomst die de teacher uitsluit.
-
Nee: heeft vier elementen, wat gelijk is aan . Ja: heeft drie elementen, tussen 0 en 4. Identieke tekst verandert het eerste antwoord niet: het zijn vier afzonderlijke samples, dus hun vier indices tellen nog steeds.
Appendix A. Griekse letters
De rollen zijn gangbare voorbeelden; elk paper definieert nog steeds wat zijn symbolen betekenen.
| Letter | Naam | Gangbare rollen in ML-papers |
|---|---|---|
| alfa | Een mixgewicht of schaal; een afname (Gated DeltaNet); een ruisschema (DDPM) | |
| bèta | Een strafsterkte (DPO, GRPO); een schrijfsterkte (Gated DeltaNet); een ruisschema (DDPM) | |
| gamma | Een discontofactor in RL; een stapgrootte (de bias-update in DeepSeek-V3) | |
| delta | Een verschil of een verandering | |
| epsilon | Ruis (DDPM); een clipbereik (GRPO); een kleine stabilisator | |
| eta | De learning rate | |
| theta | Modelparameters; de rotatiehoeken van RoPE | |
| lambda | Een regularisatiegewicht; een eigenwaarde | |
| mu | Een gemiddelde; het aantal gradientstappen per batch in Algorithm 1 van DeepSeekMath | |
| pi | Een policy; is de productoperator | |
| rho | Een kansverhouding, zoals in de GRPO-sectie van deel 3; een correlatie | |
| sigma | De sigmoid (DPO); een standaarddeviatie; een covariantie; is de somoperator | |
| tau | Een temperatuur; een drempel; een trajectorie in RL | |
| phi | De parameters van een tweede netwerk, zoals een encoder; features; een hoek | |
| psi | De parameters van een ander netwerk, zoals het value model in DeepSeekMath’s PPO | |
| omega | Een frequentie; is ook een ondergrens in complexiteit, of een verzameling uitkomsten |
Varianten zoals en zijn meestal dezelfde letter in een ander lettertype, maar een paper kan beide voor verschillende variabelen gebruiken.
Appendix B. Andere vergelijkingsfamilies
Vergelijkingsvormen die deze serie niet uitwerkt, met de definities die elk nodig heeft:
Selective state-space models. Een state-space model verwerkt een sequentie door bij elke stap een opgeslagen toestand bij te werken. Een update van de vorm , combineert de vorige toestand met de huidige input en berekent daarna een output. Hier is de huidige input, de opgeslagen toestand en de output. De matrices , en transformeren respectievelijk de vorige toestand, voegen de bijdrage van de input toe en produceren de output. De streepjes markeren parameters die van een continutijdmodel naar discrete stappen zijn omgezet; ze betekenen geen gemiddelden. In Mamba hangen de updateparameters af van de huidige input, wat “selective” betekent.
Stochastische differentiaalvergelijkingen. beschrijft hoe een toestand met de tijd verandert: is haar veranderingssnelheid. Een stochastische differentiaalvergelijking (SDE) voegt willekeurige veranderingen toe, . Hier beschrijft de deterministische verandering, bepaalt de ruisschaal en is een increment van Brownse beweging. Om haar in code te benaderen gebruikt de Euler–Maruyama-methode een kleine tijdstap en vervangt ze door Gauss-ruis met variantie . Sectie 5.1 van Tianhua Chens The Little Book of Generative AI Foundations geeft zo’n update; §6.4 van hetzelfde boek gebruikt SDE’s om diffusionmodellen te beschrijven.
Variabelentransformatie. Een stochastische variabele transformeren verandert haar dichtheid naargelang de transformatie het lokale volume verandert. Stel dat afbeeldt tussen ruimten van dezelfde dimensie, en dat zowel als haar inverse differentieerbaar zijn. De dichtheden vóór en na de transformatie, en , voldoen aan . De inverse herstelt uit . Haar Jacobiaan is de vierkante matrix van eerste afgeleiden; de absolute waarde van haar determinant corrigeert voor de lokale volumeverandering. Als bijvoorbeeld in één dimensie, wordt de dichtheid : de breedte verdubbelen halveert de dichtheid. Normalizing flows gebruiken zulke inverteerbare transformaties om dichtheden te modelleren; Tianhua Chens boek, §7.1, legt de methode uit.
Min–max-doelen. In generative adversarial networks (GAN’s) produceert een generator voorbeelden en probeert een discriminator ze van echte data te onderscheiden. Het doel meet het succes van de discriminator: maximaliseert het terwijl het minimaliseert. Het doel (vergelijking 1) zegt: beschouw voor elke mogelijke generator de beste discriminator ertegen, en kies dan de generator met het kleinste resulterende doel. De training lost die binnenste maximalisatie niet exact op. Algorithm 1 van het paper wisselt gradient-ascent-stappen op af met één gradient-descent-stap op ; de experimenten gebruikten .
De kanssimplex. Een kansvector heeft niet-negatieve elementen die optellen tot 1. De verzameling van alle zulke vectoren met elementen heet de kanssimplex, geschreven als . Elke softmax-output ligt erin. Hier benoemt een verzameling, en de superscript is haar dimensie, geen macht: zodra kansen zijn gekozen, moet de laatste de som op 1 brengen. Met twee keuzes heeft elke verdeling de vorm voor , dus slechts één getal is vrij.
Normalisatie. Normalisatie schaalt waarden naar het gemiddelde en de spreiding van een gekozen groep. Een gangbare vorm is , waarbij een gemiddelde is, een variantie en een klein positief getal dat deling door nul voorkomt. De vergelijking alleen zegt niet welke elementen worden gebruikt om het gemiddelde en de variantie te berekenen. Voor een batch featurevectoren berekent batch normalization ze apart voor elke feature over de voorbeelden heen. De layer normalization van een Transformer berekent ze apart voor elk token over zijn features heen. Controleer de gespecificeerde assen als je implementaties vergelijkt.
Bronnen en versies
Sectie- en vergelijkingsnummers verwijzen naar de versies die hier zijn gelinkt.
- Tianhua Chen. The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer. 2026. Versie 2; §2.4 en §3.2 behandelen de ongelijkheid van Jensen en de ELBO, §5.1 en §6.4 ruis in continue tijd.
- Vaswani et al. Attention Is All You Need. 2017. Versie 7, §3.2.1, vergelijking (1), en voetnoot 4.
- Dai et al. DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. 2024. Fijnmazige expertsegmentatie en de combinatietellingen, §3.1; ablatie, §4.4 en Figure 3.
- Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. 2024. Versie 3, §1.1, §4.1.1, vergelijkingen (1)–(4), en Algorithm 1.
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. 2024. Versie 5, §2.1.1–2.1.3, vergelijkingen (9)–(19), en Appendix C.
- DeepSeek-AI. DeepSeek-V3 Technical Report. 2024–2025. Versie 2, §2.1.2, vergelijkingen (12)–(18).
- DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025. Versie 1: §2.2.1, vergelijkingen (1)–(3). Versie 2, 2026: §2.1 en Supplementary A.3.
- DeepSeek-AI. DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence. 2026. Versie 1: §2.2, vergelijkingen (1)–(8); §5.1.2, vergelijking (29).
- Rafailov et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model. 2023–2024. Versie 3, §4, vergelijking (7).
- Gu et al. MiniLLM: Knowledge Distillation of Large Language Models. 2023–2024. Versie 4, §2.1, vergelijking (1), en §2.2, vergelijkingen (2) en (7).
- Yu et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. 2025. Versie 2, §3.2–3.3, vergelijkingen (11)–(12).
- Gu and Dao. Mamba: Linear-Time Sequence Modeling with Selective State Spaces. 2023–2024.
- Yang et al. Gated Delta Networks: Improving Mamba2 with Delta Rule. 2024–2025. Versie 3, §3.1, vergelijking (10), en §3.3–3.4.
- Ho, Jain and Abbeel. Denoising Diffusion Probabilistic Models. 2020. Versie 2, §2, vergelijkingen (4)–(5); §3.2, vergelijking (12); §3.4, vergelijking (14); en Algorithms 1–2.
- Goodfellow et al. Generative Adversarial Nets. 2014. Vergelijking (1) en Algorithm 1.
- Chen et al. Evaluating Large Language Models Trained on Code. 2021. Versie 2, §2.1, vergelijking (1), en Figure 3.
- Hugging Face TRL.
GRPOTrainerenGRPOConfigbij commitc6eac19, oktober 2026. - Stanford CS229. Probability Theory Review en Linear Algebra Review and Reference.
- Dive into Deep Learning. Preliminaries.
- Britz, Goldie, Luong and Le. Massive Exploration of Neural Machine Translation Architectures. 2017. Versie 2, Table 5; geciteerd door Attention Is All You Need voor dot-product tegenover additive attention.