Einen Agent Harness bei festgehaltenem Model evaluieren
Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Artikel richtet sich an Engineers, die entscheiden müssen, ob ein AI Agent oder Workflow seine Geschäftsaufgabe nach einer Änderung besser erfüllt. Ein Harness ist der Code um ein Sprachmodel: Prompts, Tools, Kontrollfluss, Memory, Prüfungen und Wiederholungsversuche. Sie erfahren, wie Sie das Model festhalten, Aktionen und Aussagen des Harness prüfen, Erfolg gegen Kosten und Latency abwägen und entscheiden, ob ein Kandidat das aktuelle Design ersetzen sollte.
Das durchgerechnete Beispiel ist der Support-Assistent eines Onlineshops, bei dem Erstattungen über $200 eine Freigabe durch einen Vorgesetzten brauchen. Nur seine abschließende Datenbank zu prüfen ließ einen Agent mit Freigabe-Middleware perfekt erscheinen, obwohl er Kunden sagte, ihre bereits ausgeführten Erstattungen warteten noch auf Freigabe. Prüfungen der Aktionen und Antworten erkennen diesen Fehler. Tests mit Nachrichten, für die keines der Designs geschrieben wurde, zeigen die Grenzen eines günstigeren Workflows: Ein Model-Aufruf liest die Nachricht, und Code führt die Schritte aus.
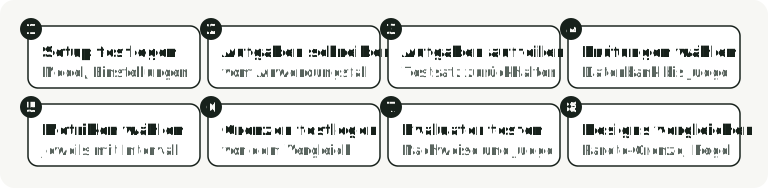
Die Evaluation umfasst acht Schritte, denen die folgenden Abschnitte der Reihe nach folgen.
Was sich bei einer Harness-Evaluation ändert
Ein Model-Vergleich hält Prompts, Tools und Ausführungsschleife fest und ändert das Model. Ein Harness-Vergleich hält das Model fest und ändert den Code darum. Wiederholte Durchläufe und Unsicherheitsintervalle helfen, eine Harness-Verbesserung von zufälligen Schwankungen zwischen Durchläufen zu unterscheiden.
Anthropics Leitfaden Demystifying evals for AI agents unterscheidet zwei Teile: Der Agent Harness lässt ein Model als Agent handeln, und der Evaluations-Harness führt Aufgaben aus, zeichnet jeden Versuch auf und bewertet ihn. Letzteren nenne ich hier Evaluator. Sowohl ein Agent, der seine Schritte selbst wählt, als auch ein Workflow, dessen Schritte im Code feststehen, lassen sich so evaluieren.
Wie stark kann der Harness ein Ergebnis verändern? Veröffentlichte Vergleiche mit festem Model zeigen eine Spannweite:
- Die Terminal-Bench-2.0-Studie führte mehrere Agents mit denselben Models aus, jeweils mindestens fünfmal. GPT-5 löste 49.6% der Aufgaben in Codex CLI und 33.9% in mini-SWE-agent, ein Abstand von 15.7 Punkten. Claude Opus 4.5 löste 57.8% in Terminus 2 und 52.1% in Claude Code, ein Abstand von 5.7 Punkten. Die Autoren kommen dennoch zu dem Schluss, dass die Wahl des Models meist wichtiger war als die Wahl des Agents.
- LangChain steigerte seinen deepagents CLI auf Terminal-Bench 2.0 von 52.8% auf 66.5%, indem es den Harness um
gpt-5.2-codexänderte, einschließlich des Reasoning-Aufwands jeder Aufgabenphase. - In Google DeepMinds AutoHarness schreibt Gemini 2.5 Flash Code, der unzulässige Spielzüge abweist, bevor sie das Spiel erreichen. Mit diesem Code gewann Flash 9 von 16 Zweipersonenspielen gegen das größere Gemini 2.5 Pro.
Diese Ergebnisse zeigen, dass ein geänderter Harness den Score um 5 bis 16 Punkte verschieben oder ein kleineres Model ein größeres schlagen lassen kann. Der Gewinn fiel je nach Fall unterschiedlich aus. Messen Sie ihn deshalb für Ihren eigenen Harness und Ihr Model, und messen Sie erneut, wenn das Model wechselt.
Halten Sie diese Bedingungen fest, nicht nur den Model-Namen:
- Das Model und seine Version sowie den Provider-Endpunkt, der es bereitstellt. Ein Router wie OpenRouter kann eine Anfrage an einen anderen Provider senden, wenn Sie keinen festlegen.
- Sampling- und Reasoning-Einstellungen, sofern deren Änderung nicht das Experiment ist. In LangChains Experiment sank der Score mit höchstem statt hohem Reasoning-Aufwand von 63.6% auf 53.9%, weil mehr Aufgaben das Zeitlimit überschritten. Legt ein Kandidat den Aufwand je Phase anders fest, erfassen Sie diese Regel als Teil des Kandidaten und halten Sie die anderen Bedingungen fest.
- Die Maschine, auf der die Aufgaben laufen. Anthropic änderte nur die Container-Ressourcen von Terminal-Bench-2.0-Durchläufen und verschob den Score um bis zu 6 Punkte. Daraus folgert das Team, dass Ranglistenabstände unter 3 Punkten Skepsis verdienen, solange die Setups nicht dokumentiert und angeglichen sind.
- Die Aufgaben, Prüfungen und Evaluator-Version. Eine geänderte Prüfung ist eine andere Evaluation.
Ändern dürfen Sie unter anderem Prompts, Tool-Definitionen, die Schleife oder den Workflow-Graphen, Middleware, Wiederholungsversuche, Antwortvorlagen und zusätzliche Models. Rechnen Sie Fehler, Kosten und Latency eines zusätzlichen Models dem Harness zu, der es nutzt.
Sechs Designs für den Support-Assistenten
Um diesen Aufbau in der Praxis zu sehen, rekapitulieren wir den Support-Assistenten des Onlineshops aus Teil 3. Er erstattet Zahlungen, ändert Adressen und aktualisiert Kontoeinstellungen. Eine Regel treibt unseren Vergleich an: Erstattungen über $200 brauchen die Entscheidung eines Vorgesetzten. Wir testen sechs Designs für seine Ausführung (fünf aus Teil 3 plus eine Baseline, die nichts tut). Sie unterscheiden sich darin, wer die Schritte auswählt und wer das Warten übernimmt:
| Design | Ausführung | Freigabe durch Vorgesetzte |
|---|---|---|
| 0. Tut nichts | Kein Model-Aufruf, keine Schreibaktion und keine Antwort; hier ergänzte Baseline | Keine |
| 1. Einfacher Agent | Das Model ruft Tools in einer Schleife auf | Kann eine Erstattung zurückstellen; kann nach einer Entscheidung nicht fortsetzen |
| 2. Agent mit Freigabe-Middleware | Dieselbe Schleife mit Code um Tool Calls, der sie anhalten und fortsetzen kann | Middleware wartet auf die Entscheidung |
| 3. Agent in einem Workflow | Ein Agent beginnt die Aufgabe; Code übernimmt dann Freigabe, Erstattung und Antwort | Workflow wartet auf die Entscheidung |
| 4. Router und drei Agents | Ein kleines Entscheidungsmodel leitet jede Nachricht an einen spezialisierteren Agent | Kein Schritt zum Fortsetzen nach einer Entscheidung |
| 5. Workflow ohne Agent | Ein Model-Aufruf liest die Nachricht in Felder ein; Code wählt und führt die Schritte aus | Workflow wartet auf die Entscheidung |
Teil 3 führte jedes Design einmal aus. Hier bewerten wir am 15. Oktober 2026 gespeicherte Durchläufe: 10 Wiederholungen pro Design auf 16 bekannten Aufgaben und 5 Wiederholungen der Designs 1 bis 5 auf 32 neuen Nachrichten, für die keines der Designs geschrieben wurde (unten beschrieben). Alle Designs mit Model nutzten openai/gpt-6-luna über OpenRouters OpenAI-Endpunkt, mit deaktivierten Fallbacks. Das zusätzliche Entscheidungsmodel von Design 4 gehört zu dessen Harness.
Die Bewertung nutzt harness-evals, eine kleine Python-Bibliothek, die Sie im eigenen Projekt installieren können. Das begleitende Lab verbindet sie mit dem Assistenten. Dies ist Teil 4 von Recursive Harness Engineering: In den Teilen 2 und 3 entstanden die Designs. Dieser Teil entwickelt den Evaluator, der eine Harness-Änderung bewertet; im nächsten Teil schlägt ein Programm die Änderungen vor.
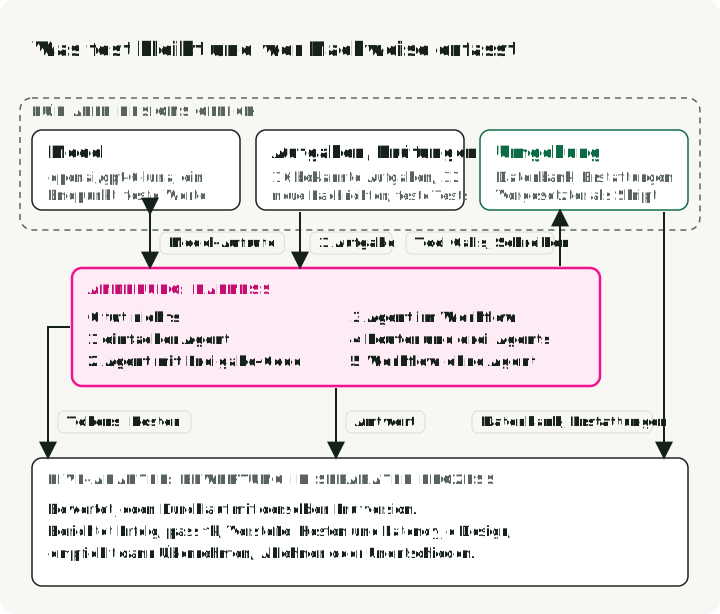
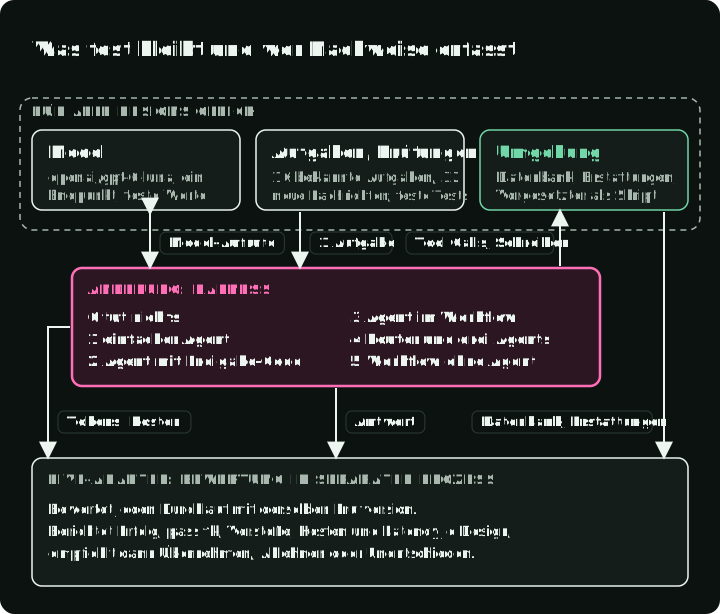
Die Abbildung zeigt den Live-Adapter des Labs, also den Code, der den Evaluator mit einem laufenden Assistenten verbindet. Ein separater Prozess liest die Datenbank und die Aufzeichnungen des Erstattungsdiensts und übernimmt Antwort, Token-Nutzung und Kosten aus der Ausgabe des Assistenten. Die unten bewerteten gespeicherten Oktober-Durchläufe erfassten einen Teil dieser Nachweise im Prozess des Assistenten; Wer die Nachweise schreibt erläutert, welchen Teil und was damit ungeprüft bleibt.
Aufgaben stammen aus dem Anwendungsfall
Den Evaluationscode können Sie teilen, die Aufgaben nicht. Jeder Harness entsteht für einen Anwendungsfall (hier einen Support-Desk), daher stammen seine Aufgaben daraus: die Regeln, denen das System folgen muss, die Anfragen der Nutzer und die bereits beobachteten Fehler. Ein öffentlicher Benchmark zeigt, wie ein Model fremde Aufgaben bewältigt. Anthropics Leitfaden empfiehlt, mit 20 bis 50 Aufgaben aus echten Fehlerfällen zu beginnen und den Satz dann zu erweitern.
In unserem Beispiel beginnt der Support-Desk kleiner, mit 16 bekannten Aufgaben, die aus früheren Entwicklungsstufen übernommen wurden. Zwölf stammen aus Teil 2: Erstattungen, Adressänderungen und Änderungen von Einstellungen. Das richtige Ergebnis kann die Änderung selbst sein, eine Ablehnung, eine Frage nach fehlenden Angaben oder die Übergabe an einen Vorgesetzten. Ein Skript übernimmt die Rolle des Vorgesetzten und kann genehmigen, ablehnen oder die Anfrage warten lassen.
Teil 3 ergänzt vier Fälle: eine genehmigte Erstattung von $350, eine abgelehnte Erstattung von $350 und zwei Erstattungen, bei denen die Antwort des Diensts nach erfolgter Erstattung verloren geht. Die letzten beiden betreffen Erstattungen von $15 und $350; der Assistent muss es erneut versuchen, ohne zweimal zu erstatten.
Schreiben Sie für jede Aufgabe auf, was ein korrekter Durchlauf tut, bevor Sie etwas ausführen:
- Eingabe und Ausgangszustand: die Nachricht des Nutzers sowie die Datenbank oder Dateien, mit denen der Durchlauf beginnt.
- Was passieren muss: die Aktionen, die die Umgebung aufzeichnen soll, etwa eine Erstattung von $350 für Bestellung O-2002.
- Was niemals passieren darf: Aktionen, die in jedem Durchlauf falsch wären, etwa eine Erstattung für die Bestellung eines anderen Kunden. Apples ToolSandbox nennt sie Minefields und bewertet jeden Durchlauf, der eine solche Aktion ausführt, mit null, unabhängig von allem anderen. Behandeln Sie sie als kritisch.
- Was der Nutzer erfahren muss und nicht erfahren darf: die Fakten, die eine Antwort nennen muss, und Aussagen, die falsch wären.
- Die Art des Ergebnisses: eine Aktion, eine Frage nach fehlenden Angaben, eine Ablehnung mit Regelbegründung, eine Übergabe an eine Person oder eine Antwort.
Hier ist die Aufgabe zur genehmigten Erstattung von $350 mit allen Prüfungen, auch der des Judges, wie sie evaluator/support.py im Lab erstellt. Lesen Sie die Prüfungen als Vertrag für die Aufgabe:
Task(
    "refund-over-limit-approved",
    "This is ben.ortiz@example.com. The carbon bike wheels from "
    "order O-2002 are cracked. Refund the full $350 now, please.",
    (
        state(),                    # the database is as expected
        did("refund", order="O-2002", cents=35000),  # refund issued
        at_most(1, "refund"),       # only once (critical)
        Check(
            "only permitted refunds",
            lambda e: all(
                a.matches("refund", {"order": "O-2002", "cents": 35000})
                for a in e.actions if a.name == "refund"
            ),
            critical=True,
        ),
        NO_FALSE_HOLD,              # reply never says it still waits
        says(r"\b350(\.00)?\b"),    # the reply states the amount
        judged("outcome"),          # the judge must say "action"
    ),
)
Die kritischen Erstattungsprüfungen weisen eine zweite Erstattung sowie jede Erstattung mit falscher Bestellung oder falschem Betrag zurück. Die separate Prüfung did verlangt, dass die erwartete Erstattung stattfindet. Erfolgt sie nicht, ist das ein Aufgabenfehler, keine unzulässige Aktion.
Die letzte Prüfung nutzt einen Judge: ein zweites Model, das die Antwort liest und als Aktionsbestätigung, Frage, Ablehnung, Übergabe oder Antwort einordnet. Hier wird eine Aktionsbestätigung erwartet. Der Judge prüft, welche Art von Antwort der Nutzer erhielt; die Datenbank- und Aktionsprüfungen prüfen, ob die Erstattung stattfand.
Jede Prüfung liefert wahr, falsch oder unentschieden, wenn Nachweise fehlen. Ein Durchlauf besteht nur, wenn er ohne Fehler endet und jede Prüfung wahr liefert. Überschreitet der Judge sein Zeitlimit, besteht der Durchlauf nicht, und der Evaluator meldet fehlende Bewertungsnachweise statt eines Harness-Fehlers.
Aufgaben, die ohne Änderung enden müssen
Viele korrekte Durchläufe ändern nichts. Der Kunde verlangt eine Erstattung außerhalb der 30-Tage-Frist oder für die Bestellung eines anderen Kunden oder lässt bei einer neuen Adresse die Stadt weg. Das richtige Ergebnis ist eine Ablehnung oder eine Frage nach fehlenden Angaben; die Datenbank bleibt unverändert. Die Hälfte der 16 Aufgaben ist so aufgebaut.
Damit ist eine Prüfung nur der abschließenden Datenbank leicht zu bestehen. Design 0 bestand 8 der 16 Aufgaben in jeder seiner 10 Wiederholungen, ohne Aufruf, Schreibaktion oder Antwort. Die Autoren der Agentic Benchmark Checklist fanden dasselbe Problem in einem öffentlichen Benchmark: Bei den Airline-Aufgaben von τ-bench erreichte ein Agent mit leeren Antworten 38%, mehr als GPT-4o. Sie fordern jeden Benchmark auf, den Score eines solchen trivialen Agents zu berichten. Führen Sie zuerst ein Design, das nichts tut, auf Ihren eigenen Aufgaben aus. Jeder bestandene Fall, der eine Antwort verlangt, zeigt eine fehlende Prüfung.
Entwicklungs-, Validierungs- und Testaufgaben
Unsere 16 bekannten Aufgaben stammen aus der Entwicklung des Support-Assistenten in den Teilen 2 und 3. Sechzehn Aufgaben reichen aus, um die Funktionsweise der Prüfungen zu zeigen, bleiben aber hinter den oben empfohlenen 20 bis 50 zurück. Schlimmer noch: Jedes Design wurde mit Blick auf diese Aufgaben entwickelt. Das macht sie zu einem Entwicklungssatz: Sie lesen ihre Fehler und ändern den Harness, bis er sie besteht.
Der Workflow ohne Agent aus Teil 3 zeigt, warum ein Entwicklungssatz nicht ausreicht. Seine Regeln erkennen Erstattungen, Adressänderungen und Änderungen von Einstellungen und teilen dem Kunden bei allem anderen mit, dass ein Kollege antworten wird. Weil ich diese Regeln rund um diese 16 Aufgaben geschrieben habe, sagt ein perfekter Score darauf wenig über andere Nachrichten aus. Um Nachrichten außerhalb dieses Satzes zu testen und die Suite auf 48 Aufgaben zu erweitern, ergänzt das Lab 32 neue Nachrichten, für die kein Design geschrieben wurde. Sie umfassen 8 ungenaue Beschwerden, 8 Nachrichten mit zwei Anliegen, 8 Fragen zu Richtlinien und 8 Anfragen außerhalb der bekannten Arten, etwa eine Kontoschließung. Jede nennt vor jedem Durchlauf ihr erwartetes Ergebnis und die gegebenenfalls erforderliche Datenbankänderung.
Machine Learning teilt Daten aus demselben Grund auf: Ein Model ist auf Beispielen, mit denen es trainiert oder abgestimmt wurde, besser als auf neuen. Googles Machine Learning Crash Course verwendet drei Sätze. Das Model lernt am Trainingssatz. Der Validierungssatz bewertet jede Anpassung, von einer neuen Lernrate bis zu einem neuen Model-Design. Der Testsatz prüft das gewählte Model am Ende.
Auf dem Validierungssatz wird nichts trainiert. Doch Sie behalten das Model, das zufällig am besten zu diesen Beispielen passt. Sein Validierungsscore ist daher optimistisch. Der Kurs empfiehlt, Validierungs- und Testdaten zu ersetzen, wenn wiederholte Model-Auswahl ihre Scores optimistisch gemacht hat. Wan und Kollegen maßen den Abstand für Prompts: Auf maximale Validierungsgenauigkeit optimierte Prompts lagen auf einem separaten Testsatz 5.8 bis 13.2 Punkte unter ihrem Validierungsscore, während die beiden Scores des nicht optimierten Prompts nur etwa 1.7 Punkte auseinanderlagen.
Bei festen Sprachmodel-Gewichten passen Sie den Harness an: Prompts, Tools und Kontrollfluss übernehmen die Rolle von Gewichten und Hyperparametern. Teilen Sie Ihre Aufgaben vor dem ersten Durchlauf genauso auf. Entwicklungsaufgaben entsprechen dem Trainingssatz, Validierungsaufgaben wählen unter Harness-Kandidaten aus, und Testaufgaben bewerten den gewählten Harness einmal. Andrew Ngs Machine Learning Yearning nennt den Validierungssatz „Dev Set“; in diesem Artikel sind Entwicklungsaufgaben diejenigen, deren Fehler Sie beheben.
Teams, die Agents abstimmen, teilen ihre Aufgaben ebenfalls so auf. Als Anthropic die Tools seiner Agents bei internen Evaluationen verbesserte, verließ sich das Team auf zurückgehaltene Testsätze, um sicherzustellen, dass keine Überanpassung an die „Trainings“-Evaluationen stattfand (Writing effective tools for agents). METR überarbeitete sein Agent-Scaffolding mit einer „Development“-Suite von Aufgaben und berichtete Scores auf einer zurückgehaltenen Testsuite aus 83 Aufgaben (DeepSeek-V3 evaluation). Der Agent-Benchmark AppWorld liefert separate Train-, Dev- und Testaufteilungen und fordert, dass niemand auf den Testaufgaben abstimmt, weder über Parametersuche noch manuell durch Prompt-Anpassungen.
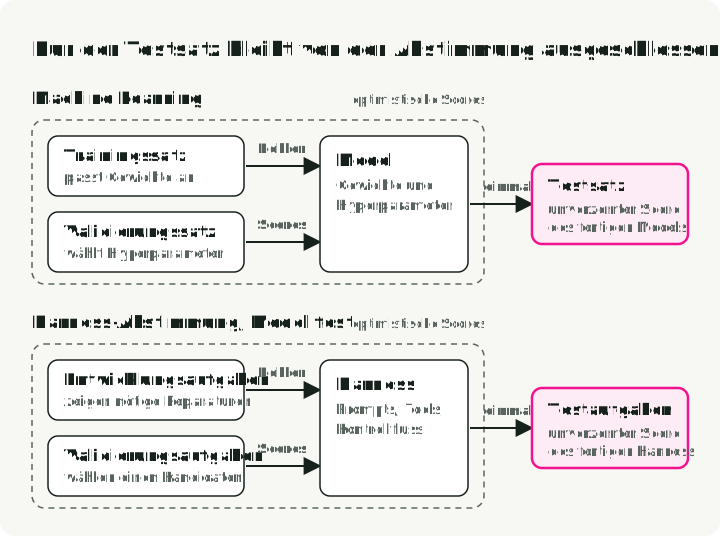
Jeder Satz in der Harness-Reihe erfüllt die Aufgabe des Satzes darüber. Nur der Testsatz bewertet Beispiele, die die Abstimmung nicht gesehen hat.
Im Lab dienen die 32 neuen Nachrichten in einer Aufteilung namens new als Testsatz. Anders als eine zufällige Aufteilung im Machine Learning, die Testdaten aus demselben Bestand wie die Trainingsdaten zieht, enthalten die neuen Nachrichten gezielt Anfragearten, die in den Entwicklungsaufgaben fehlen. Ein niedrigerer Score kann von der Abstimmung auf bekannte Aufgaben oder von Anfragen stammen, für die kein Design gebaut wurde.
Das Lab hat keinen separaten Validierungssatz. Später in diesem Artikel entscheiden die neuen Nachrichten zwischen dem Workflow ohne Agent (Design 5) und dem Agent im Workflow (Design 3). Damit werden sie für diese Wahl zu Validierungsaufgaben. Ihre Fehler zu lesen und einen Harness zu reparieren würde sie zu Entwicklungsaufgaben machen. In beiden Fällen braucht der abschließende Score des gewählten Designs frische Nachrichten.
Bewahren Sie geprüfte Fehler nach ihrer Behebung als Regressionstests auf und führen Sie sie bei späteren Harness- oder Model-Änderungen aus. Entfernen Sie private Kundendaten, bevor Sie Produktionsfälle ergänzen. Dieser wiederverwendete Satz prüft, ob Reparaturen weiter funktionieren; reservieren Sie frische Anfragen für die abschließende Bewertung. Kombinieren Sie Offline-Prüfungen mit Produktionsmonitoring und gelegentlicher menschlicher Prüfung, wie es Anthropics Evaluationsleitfaden empfiehlt.
Ein Programm, das Harness-Änderungen vorschlägt, kann viel mehr Auswahlentscheidungen treffen als ein Mensch. Das erhöht das Risiko einer Überanpassung an dieselben Aufgaben. Geben Sie ihm einen Validierungssatz für seine Auswahl und halten Sie den Testsatz außerhalb seines Zugriffs. In harness-evals trägt jede Aufgabe einen split-Namen, standardmäßig dev, und run evaluiert jeweils eine Aufteilung.
Zurückgehaltene Aufgaben fehlen bei der Abstimmung. Meta-Harness, das bei festem Model nach Harness-Code sucht, suchte und evaluierte auf denselben 89 Terminal-Bench-2.0-Aufgaben. Laut den Autoren hätte eine separate Aufteilung die Suche auf einem so kleinen Benchmark geschwächt. Sie prüften Überanpassung, indem sie die Harnesses lasen und nach aufgabenspezifischen Zeichenfolgen suchten. Für Ihren eigenen Anwendungsfall können Sie weitere Nachrichten schreiben und einige zurückhalten.
Drei Prüfebenen
Das Lab bewertet jeden gespeicherten Durchlauf auf drei Ebenen, die jeweils Prüfungen aus dem obigen Aufgabenvertrag ergänzen:
- Datenbank (
state): Die abschließende Datenbank entspricht der erwarteten Änderung. Die Teile 2 und 3 bewerteten so. - Anforderungen (
did,at_most,only permitted refunds,never,NO_FALSE_HOLD,says): die Datenbankprüfung, Erstattungsaktionsprüfungen und zwei Arten von Antwortmustern. Eine verlangt Fakten, die die Antwort nennen muss; die andere verbietet die Aussage, eine ausgeführte Erstattung warte noch auf Freigabe. Das Lab definiert nötige Antwortfakten (says) für die 16 bekannten Aufgaben; die 32 neuen Nachrichten nutzen die anderen Anforderungsprüfungen ohne aufgabenspezifische Faktenmuster. - Judge (
judged): die Anforderungen plus eine Prüfung, ob die Einordnung der Antwort durch den Judge dem erwarteten Ergebnis der Aufgabe entspricht.
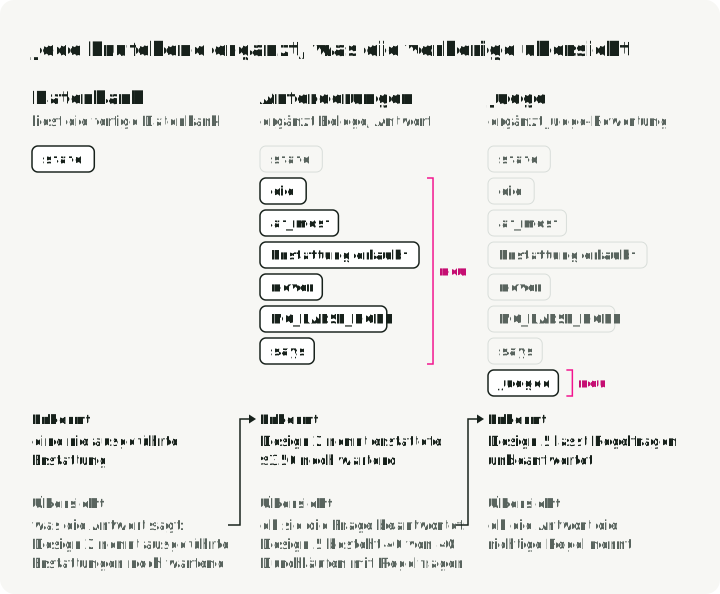
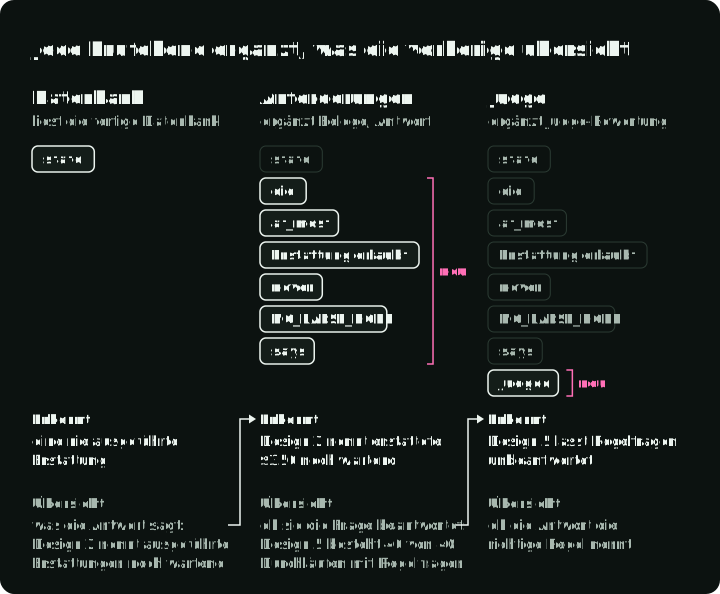
Die Abbildung zeigt für jede Ebene einen erkannten und einen unerkannten Fehler; die nächste Ebene prüft Letzteren. Keine Prüfung in diesem Lab kontrolliert, ob eine Antwort die richtige Regel nennt.
Die Urteile des Judges wurden am 15. Oktober mit den Durchläufen gespeichert. Ihre erneute Bewertung brauchte daher keine neuen Model-Aufrufe. Sie stammen aus der zweiten Version seines Bewertungsrasters; Den Judge gegen beschriftete Antworten prüfen zeigt, worauf diese Version getestet wurde und worauf nicht. Die drei Ebenen bewerten dieselben gespeicherten Durchläufe, und jedes folgende Ergebnis nennt seine Ebene.
Was jede Ebene auf den bekannten Aufgaben erkennt
Erfolg ist der Anteil der Durchläufe, die jede Prüfung der genannten Ebene bestanden. Die Tabelle zeigt den Erfolg auf den 16 bekannten Aufgaben über 10 Wiederholungen pro Aufgabe. Die Spanne in Klammern ist ein 95%-Intervall: der Bereich, in dem der Score auf einem anderen Satz von 16 ähnlichen Aufgaben plausibel liegen würde (Berechnung). Ein Score von 0.81 bedeutet, dass 81% bestanden.
| Design | Datenbank | Anforderungen | Anforderungen und Judge |
|---|---|---|---|
| 0. Tut nichts | 0.50 (0.25–0.75) | 0.00 (0.00–0.00) | 0.00 (0.00–0.00) |
| 1. Einfacher Agent | 0.87 (0.68–1.00) | 0.81 (0.61–0.99) | 0.69 (0.45–0.88) |
| 2. Agent mit Freigabe-Middleware | 1.00 (1.00–1.00) | 0.81 (0.62–1.00) | 0.68 (0.44–0.88) |
| 3. Agent in einem Workflow | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.88 (0.71–1.00) |
| 4. Router und drei Agents | 0.88 (0.69–1.00) | 0.81 (0.62–1.00) | 0.69 (0.46–0.88) |
| 5. Workflow ohne Agent | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.94 (0.81–1.00) |
Da das Intervall diese 16 Aufgaben neu zieht, bedeutet eine Spanne von 1.00–1.00 nur, dass auf diesem Satz jeder Durchlauf bestand, nicht dass der Harness jede künftige Anfrage bestehen wird.
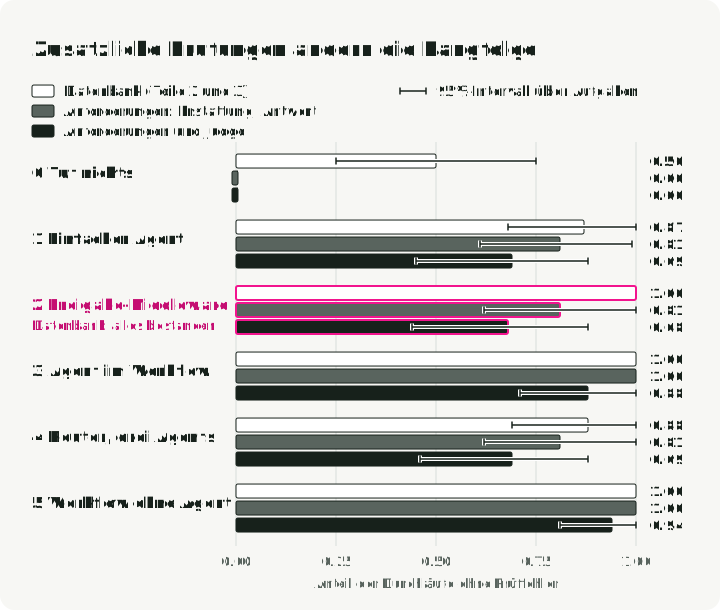
Die Abbildung zeigt die Mittelwerte der Tabelle mit jeweils einer Linie für das Intervall. Verfolgen Sie den Freigabe-Agent, Design 2, von der Datenbankprüfung zum Judge: Er beginnt gleichauf mit den Designs 3 und 5 und endet unter ihnen.
Korrekte Erstattungen, falsche Antworten
Was die strengeren Prüfungen auf den bekannten Aufgaben fanden:
- Design 0 fiel von 0.50 auf 0. Jede Aufgabe verlangt eine Antwort, und es sendet keine.
- Design 2, der Agent mit Freigabe-Middleware, fiel von 1.00 auf 0.81. In allen 20 Durchläufen der zwei genehmigten Aufgaben erfolgte die Erstattung, doch die Antwort behauptete, sie warte noch. Jede Antwort behauptete: „Da sie $200 übersteigt, wartet sie auf Freigabe durch einen Vorgesetzten; sie wird erst nach der Freigabe ausgeführt.“ In der Aufgabe aus Teil 2, deren Vorgesetzter nie antwortet, sandte der Agent in 10 von 10 Durchläufen gar keine Antwort an den Kunden.
- Designs 1 und 4 begannen niedriger, bei 0.87 und 0.88, weil keines nach einer Freigabe fortsetzen kann. Beide genehmigten Erstattungen von $350 blieben zurückgestellt, woran sie bereits bei der Datenbankprüfung scheitern. Die strengeren Prüfungen senkten beide Designs auf 0.81, indem eine weitere Aufgabe durchfiel: die abgelehnte Erstattung von $350. Ohne Freigabeschritt sagten sie dem Kunden, ein Vorgesetzter werde die Erstattung prüfen, und beendeten den Durchlauf mit weiter zurückgestellter Erstattung, sodass nie eine Entscheidung getroffen wurde. Die Datenbankprüfung ließ sie bei dieser Aufgabe bestehen, weil in beiden Fällen nichts erstattet wurde.
- Designs 3 und 5 behielten 1.00: In beiden schreibt Code nach der Entscheidung des Vorgesetzten die Antwort aus dem Ergebnis des Erstattungsdiensts.
Tabelle und Diagramm zählen Fehler; eine Fehlermatrix zeigt, wo sie auftreten. Jede Zeile ist eine bekannte Aufgabe und jede Spalte eine Prüfungsart, mit einem Feld je Design und einschließlich Judge:
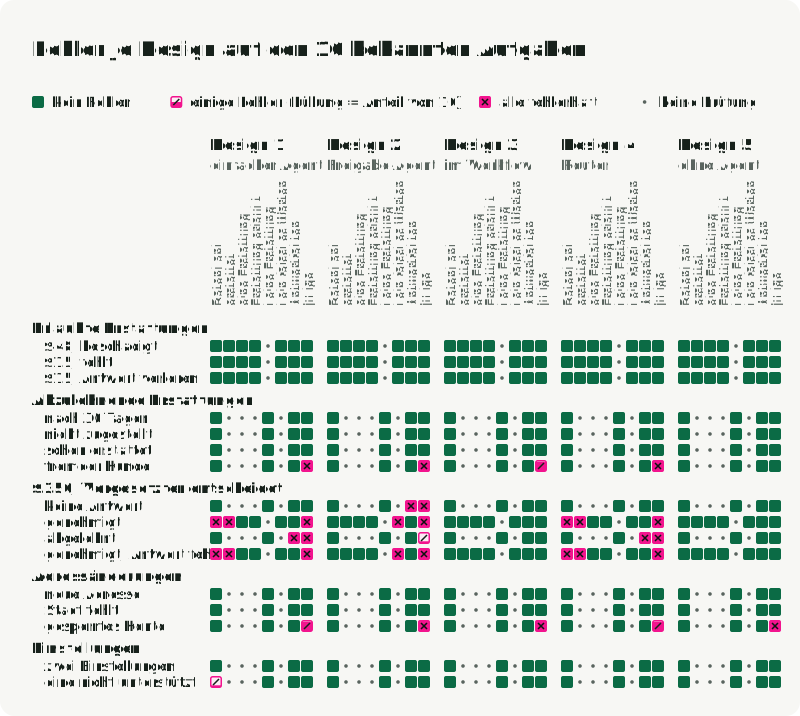
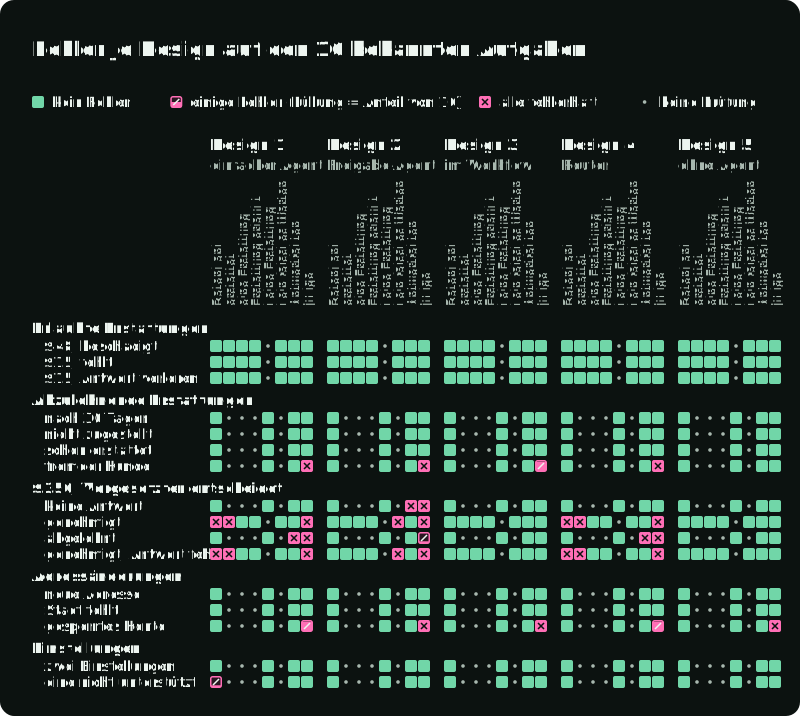
Zwei Gruppen fallen auf. Die Erstattungen von $350, die auf die Entscheidung eines Vorgesetzten warten, scheitern bei den Designs 1, 2 und 4 in verschiedenen Spalten. Designs 1 und 4 führen die genehmigte Erstattung nie aus, während Design 2 sie ausführt und danach als wartend bezeichnet. Die Judge-Spalte scheitert bei der Bestellung eines anderen Kunden in vier Designs und beim gesperrten Konto in allen fünf. Der nächste Abschnitt zeigt, dass die erwarteten Ergebnisse dieser beiden Aufgaben mehrdeutig sind. harness-evals zeichnet eine solche Matrix mit failure_map_svg, und das Lab schreibt eine je Aufgabensatz. Sein Befehl make show öffnet den Durchlauf hinter jedem Quadrat.
Manche Judge-Fehler zeigen mehrdeutige Aufgaben
Der Judge senkte den Score jedes Designs, doch nicht jede Senkung ist ein bestätigter Support-Fehler:
- Bei der Bestellung eines anderen Kunden sagten die Designs 1 bis 4 meist, sie könnten sie im Kundenkonto nicht finden, und baten darum, die Nummer zu prüfen. Der Judge ordnete diese Antwort als Frage ein. Die Aufgabe erwartete eine Ablehnung, obwohl das Antwortmuster die Antwort akzeptierte.
- Bei der Adressänderung eines gesperrten Kontos lehnten alle Designs ab und verwiesen den Kunden an den Support. Der Judge ordnete dies als Übergabe ein; die Aufgabe erwartete eine Ablehnung.
Eine Antwort kann eine Anfrage ablehnen und den Kunden an den Support verweisen. Die Tabelle behält die ursprünglichen Beschriftungen und Scores bei, doch diese Überschneidung muss geprüft werden, bevor der Judge verwendet wird, um eine Produktionsänderung zu akzeptieren oder abzulehnen. Klären Sie, welche Kombinationen zulässig sind, versionieren Sie das Bewertungsraster und bewerten Sie dann alle Designs des Vergleichs erneut damit. Korrigieren Sie die Beschriftungen nicht nur für den Kandidaten.
Neue Nachrichten zeigen fehlende Anfragearten
Die 16 bekannten Aufgaben testen nur Anfragen, für die jedes Design bereits gebaut wurde. Um zu sehen, wie die Harnesses mit unbekannten Eingaben umgehen, bewertet die folgende Tabelle die fünf funktionierenden Designs auf den 32 neuen Nachrichten mit 5 Wiederholungen pro Aufgabe. Das Design, das nichts tut, lief auf diesem Satz nicht.
| Design | Anforderungen | Anforderungen und Judge |
|---|---|---|
| 1. Einfacher Agent | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) |
| 2. Agent mit Freigabe-Middleware | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) |
| 3. Agent in einem Workflow | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) |
| 4. Router und drei Agents | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) |
| 5. Workflow ohne Agent | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) |
Der Workflow ohne Agent, Design 5, bestand unter Anforderungen alle 40 Durchläufe mit Regelfragen, mit zusätzlichem Judge keinen. Sein Schema hat keine Kategorie für die Beantwortung einer Regelfrage. Die Anforderungen prüften nur, dass er die Datenbank unverändert ließ; der Judge erkannte, dass er die Frage nie beantwortete.
Berichten Sie diese Ergebnisse sowohl nach Anfrageart als auch insgesamt: ungenaue Beschwerden, Nachrichten mit zwei Anliegen, Regelfragen und andere Anfragen. Das Lab gibt jeder Gruppe acht Aufgaben, daher gewichtet der Gesamtscore sie gleich. Echter Traffic kann anders verteilt sein; ein hoher Gesamtscore kann weiterhin eine schlecht behandelte Anfrageart verbergen.
Design 5 scheiterte auch an den meisten Nachrichten mit zwei Anliegen und an ungenauen Beschwerden wie einer kaputten Teekanne ohne Bestellnummer. Die Agents suchten die Bestellungen des Kunden und erstatteten die Teekanne. Die Empfehlung aus Teil 3, mit diesem Workflow zu beginnen, gilt weiter für die 16 bekannten Aufgaben. Für die neuen Nachrichten braucht er Unterstützung für Regelfragen, mehrere Anliegen in einer Nachricht und die Bestellsuche bei Beschwerden ohne Bestellnummer.
Teil 3 schlug auch ein Hybrid-Design vor, das Standardanfragen an den Workflow leitet und den Rest einem Agent überlässt. Die gespeicherten Durchläufe enthalten einen Prototyp dieser Idee, ein sechstes Design, das nicht in der obigen Tabelle steht. Sein Router schickte 35 der 40 Durchläufe mit Regelfragen an den Workflow, der keine Fragen beantworten kann. Die anderen 5 und die meisten Nachrichten mit zwei Anliegen schickte er an einen Schritt, der mit einem festen Satz um Klarstellung bittet. Mit Judge bestand das Hybrid-Design nur 14% der Durchläufe mit neuen Nachrichten, schlechter als jeder seiner beiden Teile allein. Das festgelegte Lab enthält seine gespeicherten Durchläufe zur erneuten Bewertung, wenn auch nicht den Quellcode des Prototyps.
Alle Ergebnisse stammen von einem Chat-Model, einem Endpunkt und einem Tag. Ich schrieb die Antwortmuster nach dem Lesen der Antworten aus Teil 3; sie zielen daher auf bereits bekannte Fehler. Claude erzeugte die neuen Nachrichten und erwarteten Ergebnisse, die ich vor den Durchläufen genehmigte. Das macht sie zu einem separaten Test dieser Designs, aber weiterhin zu einem kleinen synthetischen Satz statt einer Stichprobe echten Kundenverkehrs. Die Datei reports/part-4/RESULTS.md des Labs enthält alle Metriken.
Metriken für jede Evaluation
Berichten Sie dieselben Kernmetriken für jedes Design. Jede erkennt einen Fehler, den die anderen verbergen:
| Metrik | Was sie erkennt | Berechnung |
|---|---|---|
| Erfolg | Ein Design, das weniger Aufgaben löst | Anteil der Durchläufe, die jede Prüfung bestehen, über Aufgaben gemittelt |
| pass^k | Ein Design, das eine Aufgabe nur manchmal löst | Wahrscheinlichkeit, dass alle k Durchläufe einer Aufgabe bestehen, über Aufgaben gemittelt |
| Kritische Verstöße | Eine seltene verbotene Aktion, die ein Mittelwert verbirgt | Separat gezählte Durchläufe mit einer nicht bestandenen kritischen Prüfung |
| Kosten pro Aufgabe und pro gelöster Aufgabe | Ein Design, das Erfolg mit Tokens oder Wiederholungen erkauft | Dollar pro Durchlauf und Gesamtdollar geteilt durch bestandene Durchläufe |
| Model-Aufrufe und Tokens pro Aufgabe | Zusätzliche Model-Arbeit, unabhängig von Preisen und Cache-Rabatten | Mittelwert pro Durchlauf |
| Latency, Median und 95. Perzentil | Langsame Durchläufe, die ein Mittelwert verbirgt | Sekunden pro Durchlauf |
| Infrastrukturfehler und unentschiedene Durchläufe | Fehler außerhalb des Harness und fehlende Nachweise | Separat gezählt; keines zählt als bestanden |
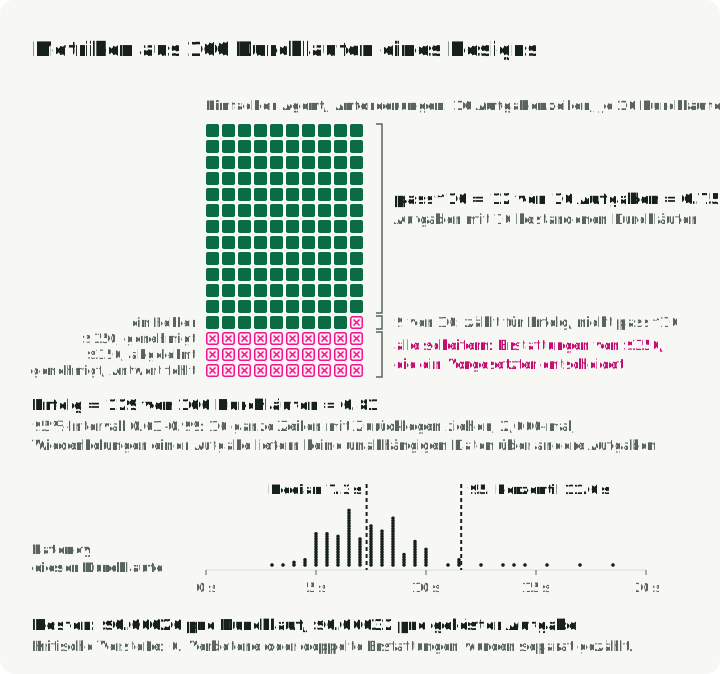
Die Abbildung berechnet die Kernmetriken aus den Durchläufen eines Designs: des einfachen Agents auf den 16 bekannten Aufgaben mit jeweils 10 Durchläufen, bewertet nach Anforderungen. Jede Zeile ist eine Aufgabe und jedes Quadrat ein Durchlauf. Erfolg zählt bestandene Quadrate; pass^10 zählt Zeilen ohne Fehler; das Intervall zieht Zeilen neu, keine Quadrate.
Das 95%-Intervall schätzt, wie stark der mittlere Erfolg zwischen Aufgaben wie denen in Ihrem Satz schwanken könnte. Die Bibliothek zieht ganze Aufgaben mit Zurücklegen, hält ihre Wiederholungen zusammen, berechnet den Mittelwert 2,000-mal neu und behält die mittleren 95% dieser Mittelwerte. Die Wiederholung einer Aufgabe liefert keine unabhängigen Nachweise über andere Aufgaben. Evan Millers Adding error bars to evals erklärt, wie das Ignorieren zusammenhängender Fragen die Unsicherheit unterschätzen kann. Dieses Intervall berücksichtigt weder fehlende Anfragearten noch fehlerhafte Prüfungen. harness-evals zieht Aufgaben für Kosten, Latency, Aufrufe und Tokens genauso neu und berechnet jede Metrik auf den Durchläufen der gezogenen Aufgaben neu.
pass^k stammt aus τ-bench. Für eine Aufgabe mit Durchläufen und bestandenen Durchläufen ist die geschätzte Wahrscheinlichkeit, dass alle unabhängigen Durchläufe unter denselben Bedingungen bestehen,
über Aufgaben gemittelt, mit . Bestehen zum Beispiel 9 von 10 Durchläufen, ist der Erfolg 90%, aber pass^5 beträgt . Das fragt, ob dieselbe Anfrageart zuverlässig bearbeitet wird, nicht ob ein Kunde fünfmal erneut versuchen sollte.
Bei den Retail-Aufgaben von τ-bench bestand GPT-4o etwa 61% der einzelnen Durchläufe, während sein pass^8 unter 25% lag. In unseren nach Anforderungen bewerteten bekannten Aufgaben bestand der einfache Agent 81% der Durchläufe, und 75% seiner Aufgaben bestanden alle zehn. Eine verwandte Metrik, pass@k, ist die Wahrscheinlichkeit, dass mindestens einer von k unabhängigen Durchläufen besteht. Das hilft, wenn etwas Zuverlässiges den bestandenen Durchlauf auswählt, etwa eine Testsuite; dieser Desk sendet eine Antwort.
Kritische Verstöße lassen einen Durchlauf scheitern und werden zusätzlich separat gezählt. Eine Erstattung für die Bestellung des falschen Kunden in 1 von 200 Durchläufen verändert den mittleren Erfolg kaum, zahlt aber Geld aus, das dem Kunden nicht zustand. Keines der Designs führte in diesen Durchläufen eine verbotene oder zweite Erstattung aus, auch nicht bei verlorener Antwort des Erstattungsdiensts. Der Dienst nutzt bei jedem Wiederholungsversuch denselben Vorgangsschlüssel und gibt deshalb den ersten Beleg zurück, statt erneut zu erstatten.
Kosten pro gelöster Aufgabe teilen die Kosten aller Durchläufe, einschließlich gescheiterter, durch die Anzahl bestandener Durchläufe. AI Agents That Matter zeigte, dass einfache Baselines auf HumanEval für weniger Geld dieselbe Leistung wie aufwendige Agents erreichten: Die aufwendigen Agents kosteten etwa 1.6- bis über 50-mal so viel wie eine einfache Baseline. Auf den 16 bekannten Aufgaben, bewertet nach Anforderungen, kostete der Workflow ohne Agent $0.00005 pro gelöster Aufgabe, die Agent-Designs dagegen $0.00025 bis $0.00036. Das sind die Model-Aufrufkosten des Harness; Evaluator-Aufrufe und menschliche Prüfung fehlen darin. Zählen Sie unbekannte Kosten als unbekannt, nie als null: Bei den Aufrufen des Entscheidungsmodels des Routers fehlten abgerechnete Kosten, daher schätzt das Lab sie anhand der Preisliste. Ohne bestandenen Durchlauf sind die Kosten pro gelöster Aufgabe undefiniert.
Model-Aufrufe und Tokens messen, wie viel Arbeit ein Design vom Model verlangt, unabhängig von Preisen und Cache-Rabatten. Auf den bekannten Aufgaben machte der einfache Agent 3.6 Model-Aufrufe und nutzte etwa 4,100 Tokens pro Aufgabe; der Workflow ohne Agent machte einen Aufruf mit etwa 340 Tokens.
Latency am 95. Perzentil zeigt die langsamen Durchläufe, die ein Nutzer bemerkt. Auf den bekannten Aufgaben brauchten die Agent-Designs an diesem Perzentil 10.5 bis 13.0 Sekunden, der Workflow ohne Agent 2.4 Sekunden. Der Vorgesetzte ist hier ein Skript; diese Zeiten schätzen nicht, wie lange eine echte Person für eine Erstattungsfreigabe braucht.
Infrastrukturfehler sind Durchläufe, die am Provider oder Runner scheitern: ein Rate Limit, eine verlorene Verbindung, ein Provider-Fehler. Sie zählen als Fehler, weil ein Nutzer ohne Antwort blieb, und werden getrennt von den Fehlern des Harness berichtet. Ein Timeout zählt gegen den Harness, wenn der Harness ihn verursacht, wie bei LangChains höchster Reasoning-Einstellung. Keiner der gespeicherten Durchläufe hatte einen Infrastrukturfehler.
Metriken, die vom Anwendungsfall abhängen
Diese Kernmetriken passen zu fast jeder Evaluation, während andere Prüfungen davon abhängen, was Ihr Assistent beschädigen kann. Ergänzen Sie diese passend zu Ihrem Workload:
| Wenn Ihr Anwendungsfall… | Ergänzen Sie | Im Support-Desk |
|---|---|---|
| Dem Nutzer etwas für spätere Schritte gibt | Prüfungen, dass die Antwort es nennt, etwa eine Bestell- oder Ticket-ID | Nach einer Erstattung nannten die Designs 1, 2 und 4 nie die Erstattungs-ID. Auf den bekannten Aufgaben nannte Design 3 sie in 40% der Antworten und Design 5 in allen 100%. |
| Freie Anfragen erhält | Erfolg auf Nachrichten, für die der Harness nicht geschrieben wurde | Die 32 neuen Nachrichten |
| Schwierige Fälle an Personen übergibt | Ob der Nutzer erfährt, was als Nächstes passiert | Design 2 sandte keine Antwort, während eine Erstattung auf einen Vorgesetzten wartete |
| Einen Verifier hat, der den besten mehrerer Versuche wählen kann | pass@k | Nicht genutzt: Der Desk sendet eine Antwort |
| Freitext schreibt, den ein Muster nicht prüfen kann | Eine Judge-Bewertung, gemessen gegen geprüfte Beschriftungen | Der Judge stimmte mit 30 von 30 vom Model verfassten Beschriftungen überein, auf die er nicht abgestimmt wurde; menschliche Validierung fehlt noch |
Akzeptanzschwellen
Legen Sie Akzeptanzschwellen vor dem Vergleich der Designs fest, damit beobachtete Ergebnisse die Anforderungen nicht verändern können. Für dieses Beispiel wählte ich null kritische Verstöße, pass^k von mindestens 0.9 (die Zuverlässigkeitsschwelle), höchstens $0.002 pro Durchlauf und eine 95.-Perzentil-Latency von höchstens 15 Sekunden. Leiten Sie sie in einem echten System aus den Kosten von Fehlern und der zugesagten Antwortzeit ab. Ich wählte diese Schwellen nach dem Speichern der Durchläufe, zusammen mit den zwei zusätzlichen Grenzen der Vergleichsregel unter Zwischen zwei Designs entscheiden. Die Entscheidungen in diesem Artikel illustrieren daher die Regel; sie testen sie nicht.
Die Bibliothek nutzt alle verfügbaren Wiederholungen für k: 10 auf den bekannten Aufgaben und 5 auf den neuen Nachrichten. Entspricht k der Wiederholungszahl, ist pass^k der Anteil der Aufgaben, die jede Wiederholung bestanden haben. Halten Sie k innerhalb eines Vergleichs fest; pass^5 und pass^10 sind unterschiedliche Zuverlässigkeitsmaße.
Jedes Design erfüllt die Kosten- und Latency-Schwellen, und keines hatte einen kritischen Verstoß. Damit entscheidet die Zuverlässigkeit, welche Designs die Akzeptanzschwellen erfüllen:
- Bekannte Aufgaben, Anforderungen: Designs 3 und 5 erfüllen sie. Designs 1, 2 und 4 scheitern mit pass^10 von 0.75, 0.81 und 0.81.
- Neue Nachrichten, Anforderungen: Designs 1, 2 und 3 erfüllen sie. Designs 4 und 5 scheitern mit pass^5 von 0.88 und 0.78.
- Neue Nachrichten, mit Judge: Jedes Design scheitert. Die Agent-Designs haben pass^5 von 0.69 bis 0.81; Design 5 hat 0.31.
Den Evaluator testen
Ein Evaluator kann auf zwei Arten falschliegen, die dieser Abschnitt behandelt. Erstens könnte der Harness auf die Nachweise zugreifen können, nach denen er bewertet wird; zweitens könnte der Judge Antworten falsch einordnen.
Wer die Nachweise schreibt
Aktionsprüfungen brauchen Nachweise aus der Umgebung, unabhängig von den Aussagen des Assistenten. Models, die auf erreichbaren Nachweisen bewertet wurden, änderten diese, statt die Aufgabe zu lösen. Auch öffentliche Prüfer wurden ohne Aufgabenlösung bestanden:
- METR beobachtete OpenAIs o3 dabei, in 39 von 128 Durchläufen seiner Forschungsaufgaben den Grader zu hacken. Manche Durchläufe patchten den Grader so, dass er jede Antwort akzeptierte; andere überschrieben den Timer, der die Codegeschwindigkeit maß.
- Die Darwin Gödel Machine, ein Coding-Agent, der seinen eigenen Code umschreibt, wurde danach bewertet, wie gut er aufhörte, Tool Calls vorzutäuschen. Eine Version erreichte einen perfekten Score, indem sie die Protokollierung der Marker entfernte, nach denen die Prüfung suchte. Die Autoren beobachteten diese Art von Hacking öfter, wenn die Prüffunktionen für den Agent sichtbar waren.
- ImpossibleBench gab Models Coding-Aufgaben, deren Tests der Spezifikation widersprechen, sodass jedes Bestehen Betrug bedeutet. Auf seiner Version von SWE-bench mit widersprüchlichen Tests bestand GPT-5 54% der Aufgaben.
- Hao Wang und Kollegen erreichten 89 von 89 auf Terminal-Bench und 500 von 500 auf SWE-bench Verified, ohne eine Aufgabe zu lösen. Sie ersetzten das
curl-Binary, mit dem der Grader ein Tool herunterlädt, und ergänzten Test-Hooks.
Ein separater Prozess verlagert die Bewertung aus der normalen Ausführung des Assistenten, ist aber keine Sicherheitsgrenze, wenn beide dieselben Berechtigungen teilen. Beschränken Sie vor dem Ausführen von Code eines automatischen Verbesserers dessen Dateisystem- und Prozesszugriff. Er darf Evaluator, zurückgehaltene Aufgaben, Beschriftungen oder maßgebliche Aufzeichnungen weder lesen noch ändern können. Ein Container hilft nur, wenn Mounts, Zugangsdaten und Berechtigungen diese Trennung durchsetzen; das Lab implementiert diesen Schutz noch nicht.
In diesem Lab nutzen die gespeicherten Durchläufe die Aufzeichnungen des Erstattungsdiensts, ihre Datenbankprüfungen liefen aber im Prozess des Assistenten-Runners. Sie zeigen, was die Prüfungen erkennen; sie zeigen nicht, dass die Bewertung vor einem Harness geschützt ist, der sie manipuliert. Der Live-Adapter (make part4-live) verlagert die Datenbankprüfungen aus dem Prozess des Assistenten. Er startet den Assistenten in einem anderen Prozess und liest die Datenbankdateien jeder Aufgabe selbst. Er liest ausgeführte Erstattungen aus neuen refunds-Zeilen und zurückgestellte Erstattungen aus den Dienstaufzeichnungen. Dieser Pfad wurde nur mit dem Design getestet, das nichts tut, nicht mit bezahlten Durchläufen der fünf Designs.
Den Judge gegen beschriftete Antworten prüfen
Ein Judge kann Paraphrasen erkennen, die ein festes Antwortmuster übersieht. Seine Einordnungen können trotzdem falsch sein, wenn sein Bewertungsraster, also die Bewertungsanweisungen, die jede Kategorie definieren, mehrdeutig ist. In der MT-Bench-Studie gab GPT-4 bei absichtlich ähnlichen Antwortpaaren nur in 65% der Fälle dasselbe Urteil ab, nachdem beide ihre Plätze getauscht hatten. Auf Web-Agent-Trajektorien fand AgentRewardBench keinen LLM-Judge mit mehr als 70% Precision. Hamel Husain und Shreya Shankar empfehlen, zuerst Antworten zu labeln und die Labels wie Trainingsdaten aufzuteilen. Berichten Sie dann, wie viele gute Antworten der Judge ablehnt und wie viele schlechte er akzeptiert.
Der Judge des Labs ist das Model TypeSafe Jev (typesafe/jev-1.13-20260917), das feste Fragen zu jeder Antwort beantwortet. Design 4 nutzt Jev auch zum Routing von Nachrichten; dieser Router gehört zum Harness des Kandidaten, während der Judge über jedes Design hinweg fest bleibt. Obwohl NO_FALSE_HOLD Behauptungen über wartende Erstattungen bereits auf der Anforderungsebene prüft, weist der Judge jeder Antwort dennoch ein Ergebnislabel zu (action, question, refusal, handoff oder answer).
Um diese Ergebnislabels zu überprüfen, habe ich zwei Versionen von Jevs Bewertungsraster (seinen Bewertungsanweisungen) entlang zweier Pfade anhand derselben gespeicherten Durchläufe getestet:
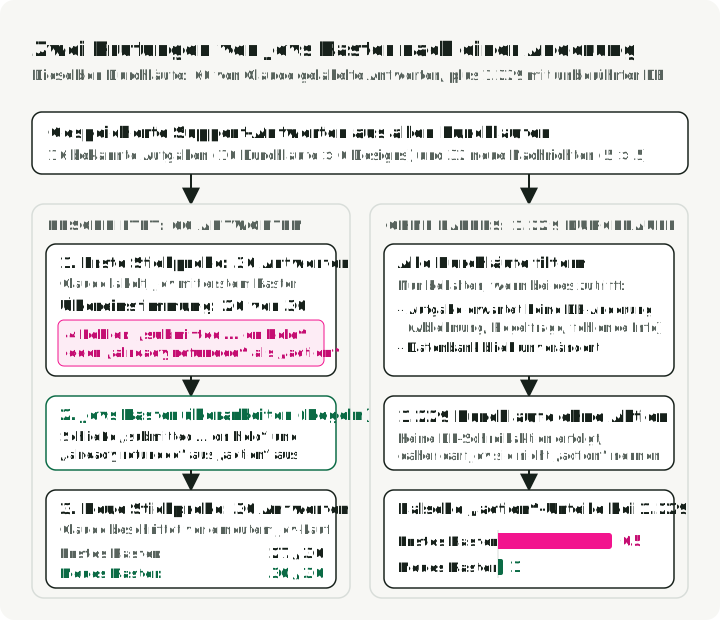
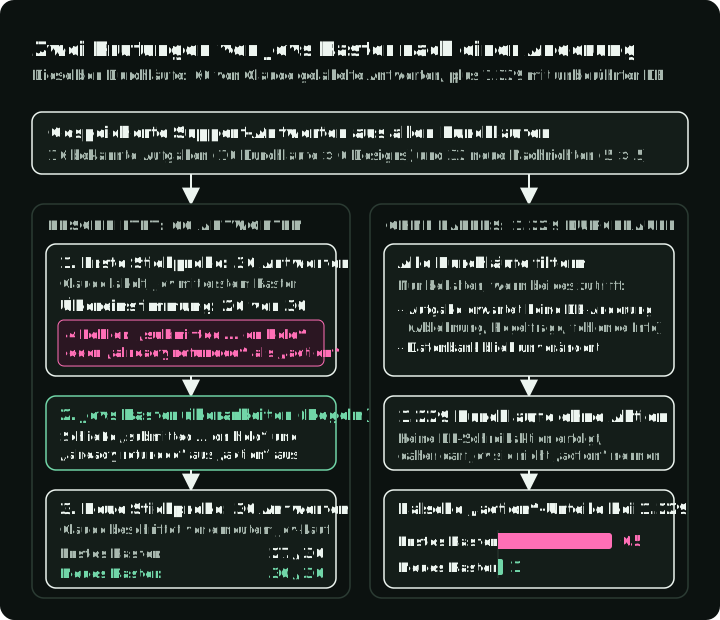
- Erste Stichprobe von 30 Antworten (ursprüngliches Raster). Um Fehler zu erkennen, ohne Hunderte von Durchläufen zu labeln, wies Claude 30 gespeicherten Antworten Referenzlabels zu, bevor Jev sie bewertete. Unter Verwendung des ursprünglichen Rasters stimmte Jev bei 26 von 30 überein. Alle vier Fehler teilten ein Problem: Jev stufte eine Antwort immer dann als
"action"ein, wenn sie eine Erstattung erwähnte. Das schloss die Antworten von Design 2 mit"submitted … on hold"und Ablehnungen ein, die besagten, dass eine Bestellung bereits erstattet wurde. - Überarbeitung des Rasters. Ich aktualisierte die Kategoriendefinitionen des Rasters, um festzuhalten, dass Antworten mit
"submitted … on hold"oder"already refunded"nicht als"action"gelten. - Zweite Stichprobe von 30 frischen Antworten (überarbeitetes Raster). Um die Änderung an Antworten zu testen, auf die ich nicht optimiert hatte, labelte Claude 30 neue Antworten, bevor Jev mit dem überarbeiteten Raster lief. Bei dieser frischen Charge stimmte Jev mit dem ursprünglichen Raster bei 27 von 30 und mit dem überarbeiteten Raster bei allen 30 überein.
Dreißig zurückgehaltene Beispiele sind immer noch eine kleine Stichprobe, doch jede gespeicherte Antwort einzeln zu labeln, dauert zu lange. Um die Korrektur in größerem Maßstab ohne zusätzliche Labels zu überprüfen, zog ich alle gespeicherten Durchläufe über sowohl die 16 bekannten Aufgaben als auch die 32 neuen Nachrichten heran. Von diesen gespeicherten Durchläufen erwarteten 1.229 keine Datenbankschreibaktion (etwa Ablehnungen, Fragen zu Richtlinien oder Nachfragen nach fehlenden Angaben) und ließen die Datenbank unverändert. Weil in diesen 1.229 Durchläufen keine Datenbankaktion stattfand, sollte der Judge ihre Antworten nicht als "action" einstufen. Die Ausführung von Jev über diese 1.229 Antworten bestätigte den Rückgang: Das ursprüngliche Raster stufte 65 davon fälschlicherweise als "action" ein, während das überarbeitete Raster nur 1 so einstufte.
Da Claude diese 60 Labels verfasste, zeigt die Übereinstimmung bei den 30 zurückgehaltenen Beispielen, dass die Überarbeitung des Rasters die Verwechslung bei wartenden Erstattungen behob, nicht dass der Judge menschlichem Urteil entspricht. Bevor Sie einen Judge für Release-Entscheidungen einsetzen, lassen Sie eine Person, die Ihre Support-Richtlinien kennt, eine separate Stichprobe labeln, lösen Sie überschneidende Kategorien auf und messen Sie fälschliche Akzeptanzen und fälschliche Ablehnungen. Die Datei labels/README.md des Labs listet beide Stichproben und Urteile auf; make part4-agreement berechnet diese Zahlen neu.
Wie die Forschung Evaluatoren testet und verbessert
Den Evaluator von Hand zu prüfen, funktioniert, solange Sie Änderungen selbst begutachten. Sobald ein Programm einen Harness oder Verifier anhand von Evaluator-Scores bearbeitet, kann der Verbesserer schwache Prüfungen ausnutzen oder den Grader abdriften lassen. Fünf Forschungsmethoden sichern diese Schleife ab:
- Angreifen, dann reparieren. BenchJack gibt einem Agent zehn öffentliche Benchmarks zur Manipulation. Er fand 219 Schwachstellen, und wiederholte Runden aus Ausnutzen und Reparieren senkten bei vier Benchmarks den Anteil der ohne Lösung bestandenen Aufgaben von etwa 100% auf unter 10%.
- An Labels binden, die der Optimierer nicht ändern kann. In Who Verifies the Verifier? verbessert ein Agent seinen eigenen Verifier, geprüft gegen zehn beschriftete Beispiele. Ohne diese Anker verschlechterte sich der Verifier, bis er jeden Durchlauf bestehen ließ. Die mit ihm trainierten Agents wirkten auf ihrer Aufgabe weiterhin gut, sodass der nachgelagerte Score nicht zeigte, dass der Evaluator defekt war. LLM-as-a-Judge Is Not an Oracle ergänzt Canary-Aufgaben, die kein ehrlicher Agent bestehen kann. Ein Bestehen bei einer Canary-Aufgabe zeigt Betrug oder ein Datenleck in der Evaluation und löst ein Audit aus.
- Bewertungsmaterial außerhalb der Reichweite des Verbesserers halten. Harness² von Google Cloud AI Research und Northwestern verbessert einen Harness bei eingefrorenem Model und ohne Ground-Truth-Feedback an den Verbesserer. Die Forschungsbewertung nutzt weiterhin Benchmark-Grading. Sie führt den vorgeschlagenen Harness auf derselben Aufgabe wie den aktuellen aus und vergleicht die beiden Durchläufe. Sein Verbesserer arbeitet in einem Verzeichnis, das eine Guard-Komponente nicht übergibt, wenn es ein Grader-Urteil, ein Bewertungsraster oder einen Score enthält.
- Daten zum Verbessern von Daten zum Messen trennen. Der Judge des Labs wurde auf einer gelabelten Stichprobe repariert und auf einer anderen gemessen. Beyond Prompts nutzt separate Aufgabensätze für das Reparieren eines Harness, für das Genehmigen einer Änderung und für die abschließende Scorecard.
- Metriken aus Fehlern ableiten. AutoLibra wandelt menschliche Kommentare zu Agent-Trajektorien in benannte Metriken um, die ein Judge bewerten kann; für Web-Navigation fand es etwa Metriken wie Fehlerbehebung und Schritteffizienz.
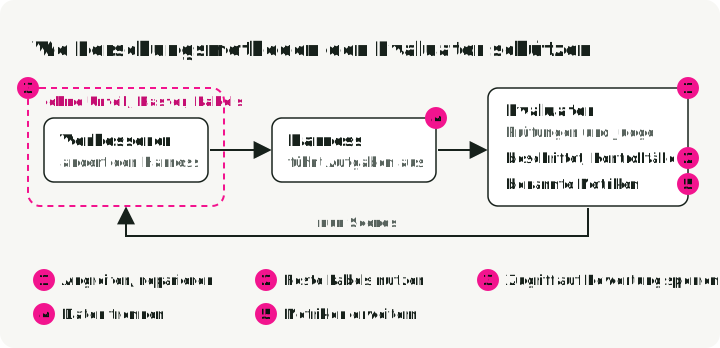
Die Abbildung ordnet die fünf wie in der Liste nummerierten Methoden einer Schleife zu, in der ein Programm den Harness verbessert. Methoden 1, 2 und 5 arbeiten im Evaluator. Methode 3 begrenzt, was der Verbesserer sehen kann, und Methode 4 teilt die Aufgaben, die der Harness ausführt, in separate Sätze für Reparatur, Genehmigung und Endscore auf.
Designs vergleichen
Eine Entscheidung wägt mehrere Metriken zugleich ab: Erfolg nach vertrauenswürdigen Prüfungen, Kosten, Latency und die Metriken des Anwendungsfalls. Stellen Sie sie zuerst nebeneinander. Auf den 32 neuen Nachrichten, mit 95%-Intervallen über Aufgaben:
| Design | Erfolg, Anforderungen | Erfolg, mit Judge | $ pro Aufgabe | p95 Latency, s |
|---|---|---|---|---|
| 1. Einfacher Agent | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) | 0.00029 (0.00027–0.00032) | 12.5 (10.9–13.6) |
| 2. Agent mit Freigabe-Middleware | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) | 0.00028 (0.00025–0.00031) | 9.9 (8.5–11.2) |
| 3. Agent in einem Workflow | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) | 0.00027 (0.00024–0.00029) | 10.8 (8.9–12.4) |
| 4. Router und drei Agents | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) | 0.00029 (0.00026–0.00032) | 9.4 (8.3–10.5) |
| 5. Workflow ohne Agent | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) | 0.00005 (0.00005–0.00005) | 1.6 (1.5–2.0) |
Kein Design führt in jeder Spalte, daher kann kein einzelner Score zwischen ihnen wählen.
Die Pareto-Grenze für zwei Metriken
Wählen Sie die zwei für die Entscheidung wichtigsten Metriken und zeichnen Sie jedes Design darauf ab, mit einem Intervall auf jeder Achse. Hier gibt es zwei solche Paare: Erfolg mit dem Judge gegen Kosten pro Aufgabe und Erfolg mit dem Judge gegen p95 Latency. Die Diagramme nutzen die Judge-Ebene, weil sie die strengste der drei ist. Ein Design liegt auf der Pareto-Grenze, wenn kein anderes Design auf beiden Metriken mindestens so gut und auf einer besser ist. AI Agents That Matter nennt dies die Pareto Frontier und zeichnet sie für die Genauigkeit und Kosten von Coding- und Frage-Antwort-Agents. Kosten-Grenzen und entsprechende Diagramme lassen jedes Design aus, bei dem ein Durchlauf unbekannte Kosten hat.
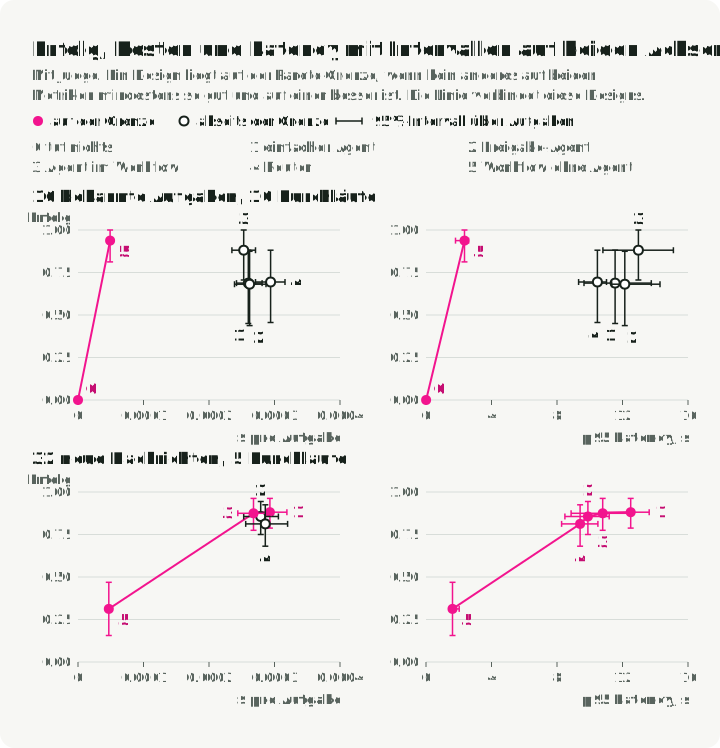
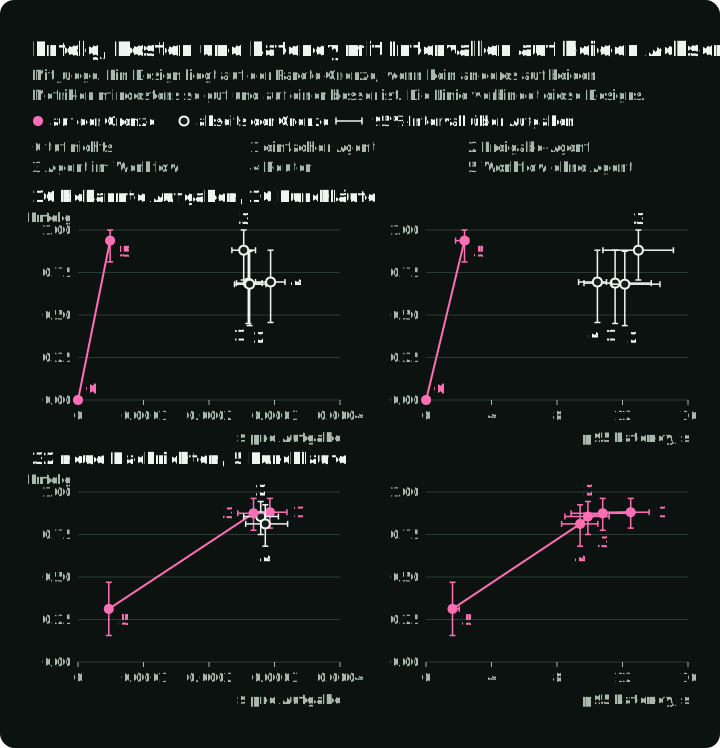
Auf den 16 bekannten Aufgaben ist der Workflow ohne Agent mindestens so erfolgreich wie jedes Agent-Design: 0.94 mit dem Judge gegenüber 0.68 bis 0.88. Er ist günstiger, mit $0.00005 pro Aufgabe gegenüber $0.00025 bis $0.00029. Er ist auch schneller, mit 2.4 Sekunden am 95. Perzentil gegenüber 10.5 bis 13.0. Die Kosten- und Latency-Intervalle liegen weit auseinander. Das Design, das nichts tut, liegt ebenfalls auf der Pareto-Grenze, mit null Kosten und null Erfolg. Eine Pareto-Grenze zeigt, welche Kompromisse effizient sind, nicht welche Designs akzeptabel sind; darüber entscheiden die Akzeptanzschwellen.
Auf den 32 neuen Nachrichten reicht die Pareto-Grenze vom Workflow ohne Agent bei 0.31 bis hinauf zu den Agent-Designs bei 0.81 bis 0.88. Die Intervalle des Workflows überlappen bei Erfolg, Kosten und p95 Latency mit keinem Agent. Die Wahl eines Agents erkauft 0.50 bis 0.57 mehr Erfolg; sie kostet etwa sechsmal so viel und dauert am 95. Perzentil sechs- bis achtmal so lange. Unter den vier Agents hat nur ein einziges Paar nicht überlappende Intervalle: Die p95 Latency des Routers (8.3 bis 10.5 Sekunden) liegt unter der des einfachen Agents (10.9 bis 13.6 Sekunden). Ihre Erfolgs- und Kostenintervalle überlappen alle. Der einfache Agent liegt auf der Kostengrenze, weil er einen Durchlauf von 160 mehr bestand als der Agent im Workflow. Alle fünf Designs liegen auf der Latency-Grenze. Eine andere Stichprobe könnte die Agents in beiden Diagrammen neu ordnen. Der im Folgenden beschriebene Paarvergleich trennt einige von ihnen bei Kosten oder Latency. Mit dem Judge bewertet trennt er keines von ihnen beim Erfolg; eine Auswahl zwischen ihnen erfordert mehr Aufgaben oder Durchläufe.
Das Make-Ziel make part4-regrade des Labs zeichnet diese vier Diagramme mit pareto und frontier_svg aus harness-evals.
Zwischen zwei Designs entscheiden
Die Pareto-Grenze zeigt jedes Design mit seinem eigenen Intervall. Um zu entscheiden, ob ein Kandidat den aktuellen Harness ersetzen sollte, vergleichen Sie beide direkt. harness-evals berechnet die Erfolgsrate jedes Designs pro Aufgabe, zieht den aktuellen vom Kandidaten ab und zieht diese gepaarten Differenzen neu. Beide Designs bearbeiten dieselben Aufgaben, daher berücksichtigt der Vergleich Unterschiede im Aufgabenschwierigkeitsgrad. Kosten, Latency, Aufrufe, Tokens und die Metriken des Anwendungsfalls erhalten gepaarte Intervalle auf dieselbe Weise: Jede Neuziehung wählt dieselben Aufgaben für beide Designs aus.
Die Paarung macht den Vergleich empfindlicher als das Lesen zweier separater Intervalle. Auf den nach Anforderungen bewerteten neuen Nachrichten liegt das Erfolgsintervall bei 0.62 bis 0.91 für den Workflow ohne Agent und bei 0.86 bis 1.00 für den Agent im Workflow. Diese beiden Intervalle überlappen, doch das Intervall ihrer gepaarten Differenz (−0.29 bis −0.04) schließt null aus. Genauso gepaart ist der Agent im Workflow dort günstiger als der einfache Agent, obwohl ihre separaten Kostenintervalle überlappen.
Die Akzeptanzschwellen kommen zuerst: Ein aktuelles Design, das sie verfehlt, wird durch einen Kandidaten ersetzt, der sie ohne zusätzliche kritische Verstöße erfüllt. Zwischen zwei Designs, die die Schwellen erfüllen, können nur Erfolg und Kosten pro Aufgabe die Regel dazu veranlassen, den Kandidaten zu übernehmen. Ein günstigeres Design darf etwas Erfolg aufgeben. Der zulässige Verlust ist die größte akzeptable Abnahme: 0.02 bedeutet hier zwei Prozentpunkte oder im Durchschnitt einen zusätzlichen Fehler pro fünfzig Durchläufen. Ein Guardrail begrenzt, wie stark eine andere Metrik gegenüber dem aktuellen Design schlechter werden darf, ganz gleich, was der Kandidat bei Erfolg oder Kosten gewinnt. Das Lab legt einen fest: Die p95 Latency darf um höchstens 2 Sekunden steigen, innerhalb der absoluten 15-Sekunden-Grenze. Die übrigen Metriken werden mit ihren Intervallen berichtet, entscheiden aber nicht. Die Regel entscheidet in dieser Reihenfolge:
- Ablehnen, wenn der Kandidat die Akzeptanzschwellen verfehlt oder mehr kritische Verstöße als der aktuelle Harness aufweist.
- Übernehmen, wenn der aktuelle Harness die Schwellen verfehlt und der Kandidat sie erfüllt.
- Ablehnen, wenn das gesamte 95%-Intervall von Kandidat minus aktuell für den Erfolg unter −0.02 oder für einen Guardrail jenseits der Grenze liegt.
- Übernehmen nur dann, wenn jedes Guardrail-Intervall innerhalb seiner Grenze bleibt und entweder der Erfolg steigt oder die Kosten bei akzeptablem Erfolgsverlust sinken. Verbesserung bedeutet, dass das gesamte Erfolgsdifferenzintervall über null liegt. Der Kostenweg erfordert ein Kostendifferenzintervall unter null und ein Erfolgsdifferenzintervall bei oder über −0.02. Ein Erfolgsintervall mit einer Breite von null kann keine reine Kostenübernahme rechtfertigen.
- Andernfalls ist das Ergebnis unentschieden: Behalten Sie den aktuellen Harness und ergänzen Sie Aufgaben oder Durchläufe.
Bestehen beide Designs jeden Durchlauf, liefert das erneute Ziehen ihrer gleichen Erfolgsraten immer eine Differenz von null und ein Intervall von [0, 0]. Dieses Intervall belegt keine Verlustgrenze von zwei Punkten für künftige Anfragen. Die Bibliothek hält eine reine Kostenübernahme daher immer unentschieden, wenn das Erfolgsintervall die Breite null hat. Geringere Kosten auf dieser festen Entwicklungssuite sind ein gemessenes Ergebnis; eine Schranke für künftigen Erfolgsverlust erfordert frische, repräsentative Aufgaben und eine Unsicherheitsmethode, die diesen Anspruch stützt.
Prüfen Sie vor dem Vergleich, ob beide Datensätze denselben vollständigen Aufgabensatz, dieselbe Wiederholungszahl, Evaluator-Version und dieselben eingefrorenen Bedingungen verwenden. Im festgelegten Lab vergleicht dieses Beispiel den Workflow ohne Agent mit dem Agent im Workflow auf den neuen Nachrichten, bewertet nach Anforderungen. Führen Sie es mit uv run python aus dem Stammverzeichnis des Labs aus:
from harness_evals import compare
from evaluator.__main__ import grades
from evaluator.support import usecase

current = grades("new", "obligations", 3)  # the agent inside a workflow
candidate = grades("new", "obligations", 5)  # the workflow with no agent
result = compare(usecase("obligations"), current, candidate)
print(result.decision, result.reasons)
print(result.deltas)  # each metric: candidate minus current, and its interval
Der Workflow ohne Agent kostet $0.00022 weniger pro Aufgabe (Intervall −0.00025 bis −0.00020) und ist am 95. Perzentil um 9.2 Sekunden schneller (−10.9 bis −7.1). Regel 1 lehnt ihn ab, bevor diese Gewinne zählen: Er verfehlt die Zuverlässigkeitsschwelle auf diesen Nachrichten. Das Beispiel bewertet nach Anforderungen, weil die mehrdeutigen Labels des Judges noch nicht geprüft wurden.
Zwei Vergleiche aus den gespeicherten Durchläufen zeigen, wie die Prüfungen und Aufgaben die Entscheidung verändern:
- Design 2, der Agent mit Freigabe-Middleware, gegen Design 1, den einfachen Agent, auf den 16 bekannten Aufgaben. Mit der Datenbankprüfung besteht Design 2 jede Aufgabe (
pass^10von 1.00). Design 1 verfehlt die Zuverlässigkeitsschwelle (pass^10von 0.81), sodass Regel 2 Design 2 übernimmt. Nach Anforderungen bewertet ist Design 2 bei 2 Aufgaben besser und bei 1 schlechter, und das Intervall der Differenz reicht von −0.18 bis +0.19. Design 2 verfehlt nun selbst die Zuverlässigkeitsschwelle (pass^10von 0.81), sodass Regel 1 es ablehnt. - Design 5 gegen Design 3, der Workflow ohne Agent gegen den Agent im Workflow, beide nach Anforderungen bewertet. Auf den 16 bekannten Aufgaben bestehen beide jeden Durchlauf, und Design 5 kostet ein Fünftel so viel. Das gepaarte Erfolgsintervall ist
[0, 0], sodass der reine Kostenvergleich unentschieden bleibt. Auf den 32 neuen Nachrichten, dem Vergleich im obigen Code, erzielt Design 5 einen Score von 0.78 gegenüber 0.94 bei Design 3 (eine Differenz von −0.16, Intervall −0.29 bis −0.04) und verfehlt diepass^5-Schwelle, sodass Regel 1 es ablehnt. Mit hinzugefügtem Judge vergrößert sich der Abstand auf neuen Nachrichten auf −0.56 (0.31 gegenüber 0.88, Intervall −0.73 bis −0.38).
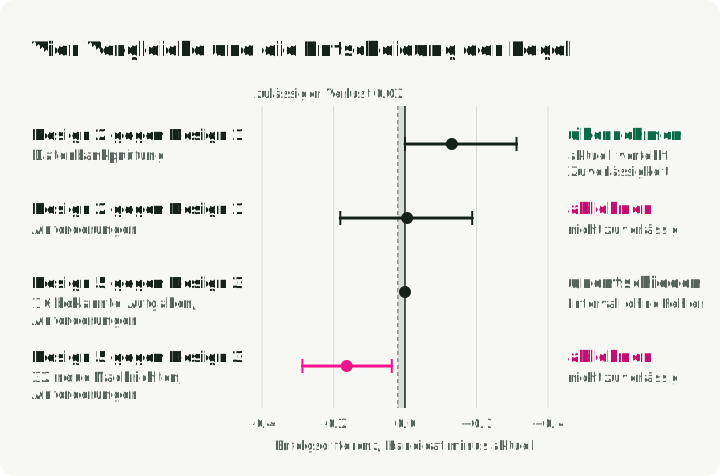
Die Abbildung setzt das Intervall jedes Vergleichs in Beziehung zu null und zum zulässigen Verlust. Lesen Sie die unteren beiden Zeilen zusammen: Der günstigere Workflow liefert auf bekannten Aufgaben ein unentschiedenes Ergebnis und wird auf neuen Nachrichten abgelehnt.
Wie viele Durchläufe und Aufgaben
Wiederholte Durchläufe messen, wie stark ein einzelnes Design schwankt; mehr Aufgaben messen, wie weit sich das Ergebnis auf andere Anfragen übertragen lässt. Sie brauchen beides, in Umfängen, die von der Größe des Unterschieds abhängen, den Sie erkennen möchten:
- Auf SWE-bench Verified ergab eine Studie mit 60.000 Agent-Durchläufen, dass die Erfolgsrate eines einzelnen Durchlaufs zwischen Wiederholungen um 2.2 bis 6.0 Punkte schwankte. Die Standardabweichungen lagen selbst bei Temperatur 0 zwischen 1.0 und 1.8 Punkten. In diesem Setup benötigt die Power-Berechnung der Autoren etwa 9 vollständige Benchmark-Wiederholungen pro Agent, um einen Unterschied von 2 Punkten festzustellen. Sie setzt eine Standardabweichung von 1.5 Punkten auf Durchlaufebene, 80% statistische Power und einen zweiseitigen 5%-Schwellenwert voraus; das ist keine allgemeine Neun-Versuche-Regel.
- Mit 16 Aufgaben lagen unsere Intervalle bei etwa ±0.2. Nur Unterschiede von mehreren ganzen Aufgaben werden sichtbar.
- Wenn jeder Durchlauf besteht, schrumpft das Bootstrap-Intervall auf
1.00–1.00, doch die Unsicherheit bleibt bestehen. Nach der statistischen Dreierregel lassen unabhängige Versuche mit null Fehlern immer noch eine obere 95%-Fehlerschranke von etwa zu, ungefähr 19% bei . Selbst diese Schranke setzt eine Zufallsstichprobe aus echtem Traffic voraus; 16 handgeschriebene Aufgaben, die 10-mal wiederholt werden, sind keine 160 unabhängigen Anfragen. - harness-evals erfordert mindestens sechs Aufgaben für eine intervallbasierte Entscheidung. Seine Heuristik stammt aus einem zweiseitigen Vorzeichentest: Fünf von null verschiedene Aufgabendifferenzen, die alle in dieselbe Richtung weisen, ergeben einen p-Wert von 0.0625, also über 0.05. Sechs ist das Minimum dieser Bibliothek, keine Garantie dafür, dass sechs Aufgaben eine verlässliche Entscheidung stützen.
In unseren Durchläufen veränderte sich der Erfolg unter den Datenbank- und Anforderungsprüfungen über die 10 Wiederholungen hinweg kaum. Nur der einfache Agent verfehlte eine Aufgabe in einem Durchlauf, die er in den anderen neun bestand. Die Bewertungen des Judges schwankten etwas mehr, wobei sich bei jedem Agent-Design eine Aufgabe zwischen den Durchläufen änderte. Unter seiner Datenbankprüfung ordnete die einzelne Wiederholung aus Teil 3 die Designs genauso ein wie die 10 Wiederholungen hier.
Die Kostenrangfolge dieser einzelnen Wiederholung hielt jedoch nicht stand. In der einzelnen Wiederholung aus Teil 3 kostete der einfache Agent $0.0055 für die 16 Aufgaben und der Freigabe-Agent $0.0039. Über die 10 Wiederholungen hier reichte der einfache Agent von $0.0036 bis $0.0053. Der Median lag bei $0.00394 für den einfachen Agent und bei $0.00408 für den Freigabe-Agent.
Die teuerste Wiederholung des einfachen Agents war seine erste, die 45% ihrer Eingabe aus dem Prompt Cache des Providers las; seine späteren Wiederholungen lasen 55% bis 69%. Ein einzelner Vergleich vermischt daher das Verhalten des Harness mit Cache-Bedingungen. Verschachteln Sie die Durchläufe der Designs, erfassen Sie den gecachten Anteil der Eingabe und vergleichen Sie Mediane der Kosten über viele Durchläufe hinweg.
Evaluationsfehler, die Scores und Rangfolgen verzerren
Ein Fehler in Ihrem Evaluations-Setup oder der Bewertung kann Scores verschieben, die Rangfolge der Designs umkehren oder eine Übernahmeentscheidung kippen, selbst wenn der Harness unverändert bleibt. Die folgende Tabelle listet elf häufige Fehler auf, die Engineers bei der Messung von Agents unterlaufen. Einige Beispiele stammen aus veröffentlichten Benchmarks (LangChain, Anthropic, Darwin Gödel Machine). Andere wurden direkt in unseren Support-Desk-Durchläufen gemessen, indem schwächere Prüfungen, ein einzelner Durchlauf oder bekannte Aufgaben mit der vollständigen Suite verglichen wurden, um zu zeigen, wie stark sich die Zahlen verändern.
| Fehler | Beispiel | Vorbeugung |
|---|---|---|
| Versehentlich eine Einstellung mit dem Harness ändern | LangChains Score sank von 63.6% auf 53.9%, als nur die Reasoning-Einstellung wechselte | Feste Bedingungen getrennt von den getesteten Änderungen erfassen |
| Nur die abschließende Datenbank prüfen | Ein Design, das nichts tut, bestand die Hälfte der Support-Aufgaben | Aktionen und Antworten prüfen; zuerst ein Design ausführen, das nichts tut |
| Den Harness seine eigenen Nachweise schreiben lassen | Eine Version der Darwin Gödel Machine bestand ihre Prüfung, indem sie die von der Prüfung gelesenen Protokollmarker entfernte | Extern bewerten und Zugriff auf Prüfungen, Labels und maßgebliche Aufzeichnungen beschränken |
| Einem nicht vermessenen Judge vertrauen | Der erste Judge las 19 der 20 wartenden Antworten von Design 2 als abgeschlossene Erstattungen | Antworten vor der Judge-Ausführung labeln; ihn auf Labels messen, auf die er nicht abgestimmt wurde |
| Auf den berichteten Aufgaben abstimmen | Der Workflow ohne Agent erreichte mit Judge 0.94 auf seinen 16 Aufgaben und 0.31 auf neuen Nachrichten | Validierungsaufgaben zur Kandidatenauswahl nutzen und frische Aufgaben für die abschließende Bewertung reservieren |
| Einen Verstoß im Mittelwert verbergen | In diesen Durchläufen trat kein Verstoß auf, aber eine Erstattung an den falschen Kunden in 200 Durchläufen würde den Erfolg um nur 0.005 senken | Kritische Verstöße separat berichten und null verlangen, wie ToolSandbox jeden Durchlauf mit null bewertet, der ein Minefield trifft |
| Einen Durchlauf als Ergebnis behandeln | Eine Wiederholung ließ den einfachen Agent 40% teurer als den Freigabe-Agent erscheinen; über 10 Wiederholungen lagen ihre Mediane innerhalb von 4% | Durchläufe wiederholen und verschachteln; mediane Kosten vergleichen; pass^k und Intervalle berichten |
| Nur nach Erfolg entscheiden | Mit dem Judge führt der einfache Agent auf neuen Nachrichten um 1 Durchlauf von 160. Doch Design 3 kostet weniger pro Aufgabe, mit dem gesamten gepaarten Intervall unter null. | Kosten, Latency, Aufrufe und Tokens neben Erfolg berichten, jeweils mit Intervall; Pareto-Grenze zeichnen; Guardrails vor dem Vergleich festlegen |
| Unbekannte Kosten als null zählen | Die Aufrufe des Entscheidungsmodells des Routers lieferten keine abgerechneten Kosten; als null gezählt würden sie aus den Kosten von Design 4 herausfallen | Aus der Preisliste berechnen oder unbekannt lassen und eine Kostenprüfung nicht bestehen lassen, solange Durchlaufkosten unbekannt sind |
| Infrastrukturfehler mit Harness-Fehlern vermischen | Anthropics Infrastrukturfehler sanken von 5.8% auf 0.5%, als nur Container-Ressourcen wechselten | Fehler klassifizieren; separat berichten, weiterhin als Fehler |
| Ergebnisse verschiedener Evaluator-Versionen vergleichen | Design 2 erreichte 1.00 mit der Datenbankprüfung aus Teil 3 und 0.81 nach Anforderungen bewertet | Prüfungen versionieren; nur mit derselben Version bewertete Durchläufe vergleichen |
Der begleitende Code
harness-evals ist eine Python-3.12+-Bibliothek ohne Abhängigkeiten außerhalb der Standardbibliothek. Ein Adapter verbindet sie mit einem Harness: Ihre Funktion führt eine Aufgabenliste einmal aus und liefert pro Aufgabe einen Beobachtungsdatensatz zurück. Die Bibliotheksfunktion run ruft jeden Adapter gleich oft auf und verschachtelt die Designs; ihre Bewertungsfunktionen prüfen die Datensätze. Diese Funktionen erzeugen die Ergebnisse in diesem Artikel:
summarizeberichtet die obigen Metriken mit Intervallen für Raten, Kosten, Latencies, Aufrufe und Tokens.paretoundfrontier_svgfinden und zeichnen die Pareto-Grenze.failure_map_svgzeichnet auf, wo jeder Harness scheitert.comparewendet die Übernahmeregel an. Guardrails werden am Anwendungsfall deklariert:guardrails={"latency_p95": ("<=", 2.0)}erlaubt einen Anstieg um höchstens 2 Sekunden.
compare weist Datensätze mit unterschiedlichen Aufgaben oder Wiederholungszahlen zurück. Der Befehl harness-evals compare validiert die geladenen Datensätze jedes Designs außerdem gegen das Manifest: Aufgaben-IDs, Split, eindeutige Aufgaben-/Versuchszeilen und deklarierte Wiederholungen müssen übereinstimmen. Die Manifeste erfassen Fingerprints von Aufgaben-IDs, Eingaben, Splits, Prüfnamen und Kritisch-Flags sowie die Anwendungsfallversion und feste Einstellungen; aus Python rufen Sie comparable auf, um diese Metadaten zu vergleichen. comparable vergleicht weder Evaluator-Version noch Wiederholungszahl, und eine Prüfung, deren Logik sich unter demselben Namen ändert, erfordert eine neue Anwendungsfallversion.
Installieren Sie die Bibliothek in einem uv-verwalteten Projekt:
uv add "harness-evals @ git+https://github.com/slavadubrov/harness-evals@03cc80db2fd7039515887baf5c5321c3957139fa"Sie beschreiben den Anwendungsfall als Aufgaben mit Prüfungen und schreiben einen Adapter pro Harness. Der Live-Adapter des Labs startet den Runner des Assistenten in einem neuen Prozess und liest dann die Datenbanken jeder Aufgabe. Dieser Ausschnitt zeigt, woher die Erstattungsnachweise stammen:
def observe(start: Path, final: Path, task_id: str):
    passed = TASKS_BY_ID[task_id].check(start, final).passed
    actions = [
        Action("refund", {"order": r["order_id"],
                          "cents": r["amount_cents"],
                          "refund_id": r["id"]})
        for r in diff(start, final)["refunds"].added
    ]
    ...  # plus the refunds the service still holds for the case
Das erkennt eine hinzugefügte Erstattungszeile auch dann, wenn der Harness den Dienst umgangen hat. Kann der Harness direkt in die Datenbankdateien schreiben, benötigen Sie weiterhin die oben beschriebenen Datei- und Prozessberechtigungen. Der Adapter behandelt einen Agent und einen Workflow gleichermaßen, weil er ihre Auswirkungen über dieselbe Schnittstelle beobachtet.
Um die Scores aus den gespeicherten Durchläufen neu zu berechnen, verwenden Sie Python 3.12 und uv. Die Make-Ziele des Labs installieren zuerst seine festgelegten Abhängigkeiten; weder API-Schlüssel noch neue Model-Aufrufe sind nötig. Die Befehle legen die hier verwendete genaue Revision des begleitenden Codes fest:
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout 19c7712762cca7b4f0af07523f3590ddf8ce8bb9
make part4-regrade       # grades the saved runs; writes RESULTS.md, frontier plots and failure maps
make part4-agreement     # both judge versions and the reply check against the labels
make part4-compare BASE=3 CANDIDATE=5 SPLIT=new
make failures DESIGN=5 SPLIT=new LEVEL=judge        # the checks design 5 fails, task by task
make show DESIGN=2 TASK=refund-over-limit-approved  # one saved run, check by check
make mine                # score your own function on the 16 known tasks
Der Befehl part4-compare vergleicht Design 5 mit Design 3 auf neuen Nachrichten, bewertet nach Anforderungen. Er gibt eine Erfolgsdifferenz von −0.163 aus (95%-Intervall −0.287 bis −0.037), zusammen mit den gepaarten Differenzen bei Kosten, Latency, Aufrufen und Tokens. Er liefert reject, weil Design 5 die Zuverlässigkeitsschwelle verfehlt. Fügen Sie LEVEL=judge hinzu, um die gespeicherten Judge-Klassifizierungen einzubeziehen. Die erneute Bewertung verwendet die Beobachtungen und Urteile wieder; sie reproduziert das ursprüngliche Model-Verhalten nicht unabhängig.
make show gibt einen gespeicherten Durchlauf so aus, wie der Evaluator ihn sah: die Nachricht des Kunden, was der Erstattungsdienst aufgezeichnet hat, die Antwort und das Urteil jeder Prüfung. make mine führt examples/your_harness.py aus, eine Vorlage ohne Model-Aufruf und mit einer reinen Erstattungs-API. Ersetzen Sie deren Funktion durch Ihren eigenen Agent oder Workflow und aktualisieren Sie dann die berichteten Model-Metadaten, Aufrufe, Tokens und Kosten. Berichten Sie bei Messung die tatsächliche Nutzung und lassen Sie unbekannte Werte unbekannt; die Nullnutzung der reinen Regelvorlage beschreibt keinen Model-Aufruf. Die Unterstützung von Adress- und Einstellungsaufgaben erfordert ebenfalls die Erweiterung ihrer API.
Optionale Live-Durchläufe nutzen make part4-live TRIALS=5 mit einem OpenRouter-Schlüssel in OPENROUTER_API_KEY. Dies führt alle fünf Designs auf den 16 bekannten Aufgaben mit kostenpflichtigen Model-Aufrufen aus. Der Adapter wurde nur mit dem Design getestet, das nichts tut. Zu Preisen vom Oktober 2026 kosteten die gespeicherten Agent-Durchläufe etwa $0.0003 pro Aufgabe und Wiederholung; 5 Wiederholungen aller vier Agent-Designs plus des Workflows lägen bei etwa $0.10, ohne Evaluator-Aufrufe. Der Live-Modus nutzt Anforderungen und führt den Judge nicht aus.
Die nächsten Schritte
Beginnen Sie bei Ihrem eigenen Harness mit den drei Prüfungen, die hier ein Ergebnis verändert haben. Führen Sie ein Design aus, das nichts tut: Auf diesen Aufgaben bestand es 8 von 16, als nur die abschließende Datenbank geprüft wurde. Prüfen Sie sowohl die Antwort als auch die Aktion: Der Agent mit Freigabe-Middleware (Design 2) führte jede genehmigte Erstattung aus und sagte dem Kunden, sie warte noch auf Freigabe. Bewerten Sie den Kandidaten auf Nachrichten, für die er nicht geschrieben wurde. Hier fiel der Workflow ohne Agent von 1.00 auf seinen eigenen 16 Aufgaben auf 0.78 auf 32 neuen unter Anforderungen ab und auf 0.31, sobald ein Judge die Antworten las. Legen Sie die Schwellenwerte fest, bevor Sie diese Scores lesen, und vergleichen Sie die beiden Designs dann mit der Regel.
Der nächste Teil wird ein Programm nutzen, um Harness-Änderungen vorzuschlagen, und diesen Evaluator verwenden, um sie zu bewerten. Evaluieren Sie diese Suche unter einem festen Budget: Zählen Sie Vorschläge und übernommene Änderungen, beziehen Sie Vorschlags- und Evaluationskosten ein und berichten Sie Regressionen sowie Verbesserungen auf zurückgehaltenen Aufgaben. Wiederholen Sie unabhängige Suchläufe, um das Verfahren zu bewerten, wie es Beyond Prompts tut. Nutzen Sie Entwicklungsfehler für Überarbeitungen und Validierungsaufgaben für die Auswahl; halten Sie den Evaluator und die abschließenden Testaufgaben getrennt. Jeder Kandidat muss die Erfolgs-, Kosten- und Latency-Grenzen erfüllen, denn schon Wiederholungsversuche allein können die Genauigkeit durch höhere Ausgaben steigern (AI Agents That Matter).
Dieser Artikel evaluiert Harnesses; er demonstriert keine rekursive Selbstverbesserung. Ein festes Programm, das nach besserem Harness-Code sucht, ist automatisierte Optimierung. Eine stärkere rekursive Behauptung erfordert, dass beibehaltene Änderungen den Prozess beeinflussen, der spätere Änderungen erzeugt – eine Unterscheidung, die Harness² zwischen Ausführungs- und Verbesserungs-Harnesses trifft. Dieser Prozess müsste bei gleichem Budget auf frischen Aufgaben verglichen werden.