Ewaluacja harnessu agenta przy niezmiennym modelu
Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten artykuł jest dla inżynierów decydujących, czy zmiana agenta AI lub przepływu pracy poprawia realizację jego zadania biznesowego. Harness to kod otaczający model językowy: prompty, narzędzia, sterowanie wykonaniem, pamięć, kontrole i ponowne próby. Dowiesz się, jak zachować niezmienny model, sprawdzić, co harness robi i co przekazuje użytkownikowi, zestawić skuteczność z kosztami i opóźnieniem oraz zdecydować, czy kandydat powinien zastąpić obecny projekt.
Przykładem jest asystent obsługi klienta w sklepie internetowym, w którym zwroty powyżej $200 wymagają zgody przełożonego. Sprawdzanie wyłącznie końcowej bazy danych sprawiało, że agent z warstwą pośrednią zatwierdzania wyglądał idealnie, mimo że informował klientów, iż zrealizowane zwroty nadal czekają na decyzję. Sprawdzanie działań i odpowiedzi ujawnia ten błąd. Testowanie na wiadomościach, z myślą o których nie powstał żaden projekt, obnaża ograniczenia tańszego przepływu pracy. W tym przepływie jedno wywołanie modelu odczytuje wiadomość, a kod wykonuje kolejne kroki.
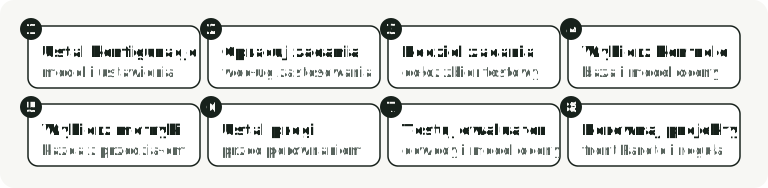
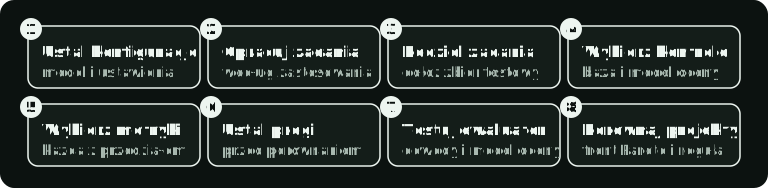
Ewaluacja obejmuje osiem kroków, które kolejne sekcje opisują po kolei.
Co zmienia się podczas ewaluacji harnessu
Porównanie modeli zachowuje prompty, narzędzia i pętlę wykonania, zmieniając model. Porównanie harnessów zachowuje niezmienny model, zmieniając otaczający go kod. Powtarzane uruchomienia i przedziały niepewności pomagają odróżnić poprawę harnessu od losowego szumu między uruchomieniami.
Poradnik Anthropic Demystifying evals for AI agents wyróżnia dwa elementy. Harness agenta pozwala modelowi działać jako agent; harness ewaluacji uruchamia zadania, rejestruje każdą próbę i wystawia ocenę. Ten drugi element nazywam tutaj ewaluatorem. W ten sposób można ocenić zarówno agenta, który sam wybiera kroki, jak i przepływ pracy o krokach zdefiniowanych w kodzie.
Jak bardzo harness może zmienić wynik? Opublikowane porównania ze stałym modelem pokazują pewien zakres:
- W publikacji o Terminal-Bench 2.0 uruchomiono kilku agentów z tymi samymi modelami, co najmniej pięć razy każdego. GPT-5 rozwiązał 49.6% zadań w Codex CLI i 33.9% w mini-SWE-agent — różnica 15.7 punktu. Claude Opus 4.5 rozwiązał 57.8% w Terminus 2 i 52.1% w Claude Code — różnica 5.7 punktu. Autorzy nadal wnioskują, że wybór modelu miał zazwyczaj większe znaczenie niż wybór agenta.
- LangChain poprawił wynik deepagents CLI z 52.8% do 66.5% na Terminal-Bench 2.0 przez zmianę harnessu wokół
gpt-5.2-codex, w tym ilości rozumowania w każdej fazie zadania. - W AutoHarness Google DeepMind model Gemini 2.5 Flash pisze kod odrzucający niedozwolone ruchy, zanim trafią do gry. Mając wokół siebie ten kod, Flash wygrał 9 z 16 dwuosobowych gier z większym Gemini 2.5 Pro.
Wyniki te pokazują, że zmiana harnessu może przesunąć wynik o 5 do 16 punktów lub pozwolić mniejszemu modelowi pokonać większy. Skala zysku różniła się zależnie od przypadku, dlatego zmierz ją dla własnego harnessu i modelu, a po zmianie modelu zmierz ponownie.
Zachowaj bez zmian poniższe elementy, a nie tylko nazwę modelu:
- Model i jego wersję oraz punkt końcowy dostawcy, który go obsługuje. Router taki jak OpenRouter może przekierować żądanie do innego dostawcy, jeśli nie przypniesz konkretnego.
- Ustawienia próbkowania i rozumowania, chyba że to ich zmiana stanowi eksperyment. W eksperymencie LangChain najwyższy wysiłek rozumowania zamiast wysokiego obniżył wynik z 63.6% do 53.9%, ponieważ więcej zadań przekroczyło limit czasu. Jeśli kandydat ustala wysiłek inaczej dla każdej fazy, zapisz tę regułę jako część kandydata. Pozostałe warunki zachowaj bez zmian.
- Maszynę, na której uruchamiane są zadania. Anthropic zmienił wyłącznie zasoby kontenera w uruchomieniach Terminal-Bench 2.0 i przesunął wynik nawet o 6 punktów. Wnioskuje, że różnice w rankingach poniżej 3 punktów zasługują na sceptycyzm, dopóki konfiguracje nie zostaną udokumentowane i dopasowane.
- Zadania, kontrole i wersję ewaluatora. Zmieniona kontrola to już inna ewaluacja.
Elementy, które możesz zmieniać, obejmują prompty, definicje narzędzi, pętlę lub graf przepływu pracy, warstwy pośrednie, ponowne próby, szablony odpowiedzi i dodatkowe modele. Błędy, koszt i opóźnienie dodatkowego modelu wliczaj do bilansu harnessu, który z niego korzysta.
Sześć projektów asystenta obsługi klienta
Aby zobaczyć tę konfigurację w praktyce, przypomnijmy asystenta obsługi klienta sklepu internetowego z części 3. Realizuje on zwroty, zmienia adresy i aktualizuje ustawienia konta. Jedna reguła napędza nasze porównanie: zwroty powyżej $200 wymagają decyzji przełożonego. Testujemy sześć projektów jego działania (pięć z części 3 oraz punkt odniesienia, który nic nie robi). Różnią się one tym, kto wybiera kroki i kto obsługuje oczekiwanie:
| Projekt | Sposób działania | Zgoda przełożonego |
|---|---|---|
| 0. Nic nie robi | Brak wywołania modelu, zapisu i odpowiedzi; dodany tutaj punkt odniesienia | Brak |
| 1. Prosty agent | Model wywołuje narzędzia w pętli | Może pozostawić zwrot wstrzymany; nie potrafi wznowić działania po decyzji |
| 2. Agent z warstwą pośrednią zatwierdzania | Ta sama pętla z kodem wokół wywołań narzędzi, który może ją wstrzymać i wznowić | Warstwa pośrednia czeka na decyzję |
| 3. Agent w przepływie pracy | Agent rozpoczyna zadanie; kod obsługuje zatwierdzenie, zwrot i odpowiedź | Przepływ pracy czeka na decyzję |
| 4. Router i trzej agenci | Mały model decyzyjny kieruje każdą wiadomość do węższego agenta | Brak kroku wznowienia po decyzji |
| 5. Przepływ pracy bez agenta | Jedno wywołanie modelu odczytuje wiadomość do pól; kod wybiera i wykonuje kroki | Przepływ pracy czeka na decyzję |
W części 3 każdy projekt uruchomiono raz. Tutaj oceniamy uruchomienia zapisane 15 października 2026 roku. Obejmują one 10 powtórzeń każdego projektu na 16 znanych zadaniach oraz 5 powtórzeń projektów 1–5 na 32 nowych wiadomościach, z myślą o których nie napisano żadnego projektu (opisanych poniżej). Wszystkie projekty wykorzystujące model używały openai/gpt-6-luna przez punkt końcowy OpenAI w OpenRouter, z wyłączonymi mechanizmami zastępczymi. Dodatkowy model decyzyjny w projekcie 4 należy do jego harnessu.
Ocenianie korzysta z harness-evals, małej biblioteki Pythona, którą możesz zainstalować we własnym projekcie. Powiązane laboratorium łączy ją z asystentem. To część 4 serii Recursive Harness Engineering: w częściach 2 i 3 powstały projekty. Ta część buduje ewaluator oceniający zmianę harnessu; w kolejnej części zmiany będzie proponować program.
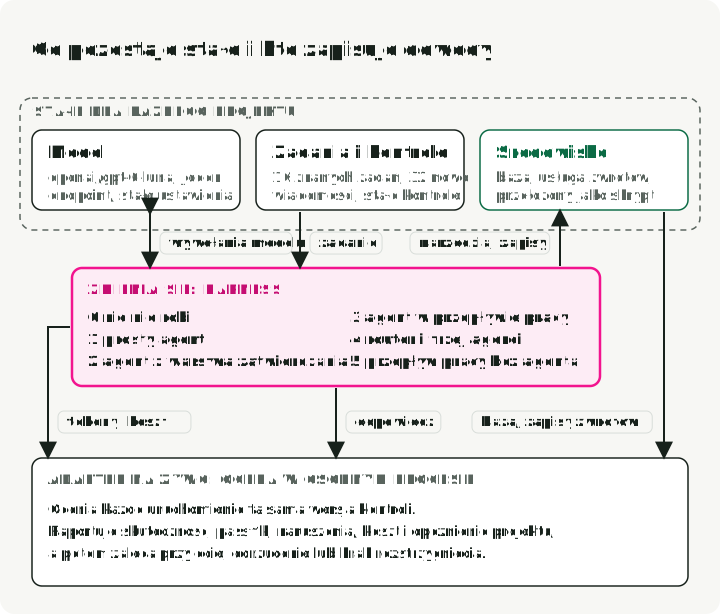
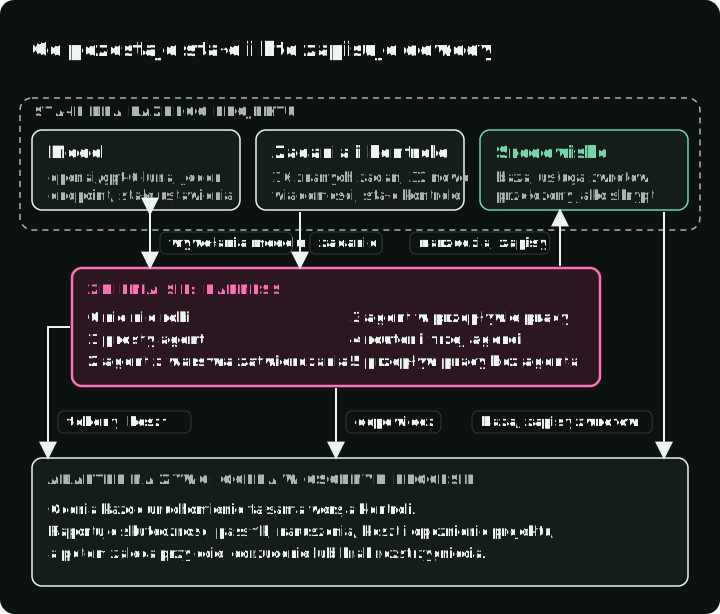
Rysunek przedstawia adapter na żywo w laboratorium — kod łączący ewaluator z działającym asystentem. Osobny proces odczytuje bazę danych i rejestry usługi zwrotów, a treść odpowiedzi, zużycie tokenów i koszt pobiera z wyników samego asystenta. Zapisane październikowe uruchomienia oceniane poniżej rejestrowały część tych dowodów wewnątrz procesu asystenta. Sekcja Kto zapisuje dowody wyjaśnia, która część była rejestrowana w procesie i czego to nie pozwala przetestować.
Zadania wynikają z zastosowania
Kod ewaluacji można współdzielić, ale zadań nie. Każdy harness jest budowany pod jedno konkretne zastosowanie (tutaj: biuro obsługi klienta), więc jego zadania pochodzą właśnie z tego zastosowania. Odzwierciedlają zasady, których system musi przestrzegać, prośby przesyłane przez użytkowników oraz zaobserwowane już awarie. Publiczny benchmark mówi ci, jak model radzi sobie z cudzymi zadaniami. Poradnik Anthropic zaleca rozpoczęcie od 20 do 50 zadań zaczerpniętych z rzeczywistych błędów i stopniowe rozbudowywanie tego zbioru.
W naszym przykładzie biuro obsługi klienta zaczyna od mniejszej liczby: 16 znanych zadań przeniesionych z wcześniejszych etapów. Dwanaście pochodzi z części 2: zwroty, zmiany adresu i zmiany ustawień. Prawidłowym wynikiem może być sama zmiana, odmowa, prośba o brakujące informacje lub przekazanie sprawy przełożonemu. Skrypt odgrywa rolę przełożonego i może zatwierdzić, odrzucić lub pozostawić wniosek w stanie oczekiwania.
Część 3 dodaje cztery przypadki: zatwierdzony zwrot na $350, odrzucony zwrot na $350 oraz dwa zwroty, w których odpowiedź usługi ginie po oddaniu pieniędzy. Te dwa ostatnie dotyczą zwrotów na $15 i $350; asystent musi ponowić próbę bez podwójnego zwracania środków.
Dla każdego zadania opisz, co robi prawidłowe uruchomienie, zanim cokolwiek uruchomisz:
- Dane wejściowe i stan początkowy: wiadomość użytkownika oraz baza danych lub pliki, od których zaczyna się uruchomienie.
- Co musi się wydarzyć: działania, które środowisko powinno zarejestrować, na przykład pojedynczy zwrot w wysokości $350 dla zamówienia O-2002.
- Co nigdy nie może się wydarzyć: działania niedopuszczalne w jakimkolwiek uruchomieniu, na przykład zwrot na rzecz zamówienia innego klienta. W ToolSandbox Apple nazywa je polami minowymi (minefields) i ocenia uruchomienie, które trafiło na którekolwiek z nich, na zero, bez względu na pozostałe wykonane kroki. Traktuj je jako krytyczne.
- Co użytkownik musi, a czego nie może usłyszeć: fakty, które odpowiedź musi stwierdzać, oraz twierdzenia, które byłyby fałszywe.
- Rodzaj wyniku: działanie, pytanie o brakujące informacje, odmowa z podaniem przyczyny wynikającej z regulaminu, przekazanie sprawy człowiekowi lub odpowiedź.
Oto zadanie zatwierdzonego zwrotu na $350 z zapisanymi wszystkimi kontrolami, łącznie z modelem oceniającym, tak jak buduje je moduł evaluator/support.py w laboratorium. Traktuj te kontrole jako kontrakt zadania:
Task(
    "refund-over-limit-approved",
    "This is ben.ortiz@example.com. The carbon bike wheels from "
    "order O-2002 are cracked. Refund the full $350 now, please.",
    (
        state(),                    # the database is as expected
        did("refund", order="O-2002", cents=35000),  # refund issued
        at_most(1, "refund"),       # only once (critical)
        Check(
            "only permitted refunds",
            lambda e: all(
                a.matches("refund", {"order": "O-2002", "cents": 35000})
                for a in e.actions if a.name == "refund"
            ),
            critical=True,
        ),
        NO_FALSE_HOLD,              # reply never says it still waits
        says(r"\b350(\.00)?\b"),    # the reply states the amount
        judged("outcome"),          # the judge must say "action"
    ),
)
Krytyczne kontrole zwrotu odrzucają drugi zwrot lub jakikolwiek zwrot z nieprawidłowym zamówieniem bądź kwotą. Osobna kontrola did wymaga wykonania oczekiwanego zwrotu; niewykonanie go stanowi niepowodzenie zadania, a nie nieautoryzowane działanie.
Ostatnia kontrola wykorzystuje model oceniający (judge): drugi model, który odczytuje odpowiedź i klasyfikuje ją jako potwierdzenie działania, pytanie, odmowę, przekazanie sprawy lub odpowiedź. W tym przypadku oczekiwaną klasą jest potwierdzenie działania. Model oceniający sprawdza, jakiego rodzaju odpowiedź otrzymał użytkownik, podczas gdy kontrole bazy danych i działań weryfikują, czy zwrot rzeczywiście nastąpił.
Każda kontrola zwraca prawdę, fałsz lub stan nierozstrzygnięty, gdy brakuje dowodów. Uruchomienie zostaje zaliczone tylko wtedy, gdy kończy się bez błędu, a każda kontrola zwraca prawdę. Jeśli model oceniający przekroczy limit czasu, uruchomienie nie zostaje zaliczone, a ewaluator zgłasza brak dowodów oceny zamiast błędu harnessu.
Zadania, które muszą zakończyć się bez zmian
Wiele prawidłowych uruchomień nie zmienia niczego. Klient prosi o zwrot po upływie 30-dniowego terminu lub dla zamówienia innego klienta albo pomija miasto w nowym adresie. Właściwym wynikiem jest odmowa lub pytanie doprecyzowujące, a baza danych pozostaje nienaruszona. Połowa z 16 zadań ma właśnie taki charakter.
To sprawia, że samą kontrolę końcowego stanu bazy danych bardzo łatwo zaliczyć. Projekt 0 zaliczył 8 z 16 zadań w każdym ze swoich 10 powtórzeń, nie wykonując ani jednego wywołania, zapisu czy odpowiedzi. Autorzy Agentic Benchmark Checklist odkryli ten sam problem w publicznym benchmarku: w zadaniach linii lotniczych w τ-bench agent zwracający puste odpowiedzi uzyskał 38% — wynik wyższy niż GPT-4o. Apelują oni, aby w każdym benchmarku raportować wynik takiego trywialnego agenta. Najpierw przetestuj na własnych zadaniach projekt, który nic nie robi. Każde zaliczenie zadania wymagającego odpowiedzi obnaża brakującą kontrolę.
Zadania rozwojowe, walidacyjne i testowe
Nasze 16 znanych zadań pochodzi z budowy asystenta obsługi klienta w częściach 2 i 3. Szesnaście zadań wystarcza, aby pokazać, jak działają kontrole, jednak nie dorównuje zalecanym wyżej 20–50 zadaniom. Co gorsza, każdy projekt był tworzony z myślą o tych konkretnych zadaniach. To czyni z nich zbiór rozwojowy (development set): analizujesz ich błędy i zmieniasz harness tak długo, aż zacznie je zaliczać.
Przepływ pracy bez agenta z części 3 pokazuje, dlaczego zbiór rozwojowy nie wystarcza. Jego reguły rozpoznają zwroty, zmiany adresu i zmiany ustawień, a w przypadku każdej innej sprawy informują klienta, że odpowie konsultant. Ponieważ reguły te napisałem z myślą o tych 16 zadaniach, idealny wynik na nich niewiele mówi o zachowaniu przy innych wiadomościach. Aby przetestować wiadomości spoza tego zbioru i rozbudować zestaw do 48 zadań, laboratorium dodaje 32 nowe wiadomości, z myślą o których nie napisano żadnego projektu. Obejmują one 8 niejasnych reklamacji, 8 wiadomości z dwiema prośbami, 8 pytań o regulamin i 8 wniosków spoza znanych typów, takich jak zamknięcie konta. Każda z nich ma z góry określony oczekiwany wynik oraz wymaganą ewentualną zmianę w bazie danych, sformułowane przed wykonaniem jakiegokolwiek uruchomienia.
W uczeniu maszynowym dane dzieli się z tego samego powodu: model radzi sobie lepiej na przykładach, na których był trenowany lub dostrajany, niż na nowych. Machine Learning Crash Course Google wykorzystuje trzy zbiory. Model uczy się na zbiorze treningowym (training set). Zbiór walidacyjny (validation set) ocenia każdą modyfikację — od nowego współczynnika uczenia po nową architekturę modelu. Zbiór testowy (test set) sprawdza wybrany model na samym końcu.
Na zbiorze walidacyjnym nic się nie uczy. Jednak zachowany model to ten, który akurat najlepiej pasował do tych przykładów, więc jego wynik walidacyjny jest optymistyczny. Autorzy kursu zalecają wymianę danych walidacyjnych i testowych, gdy wielokrotne wykorzystanie ich do wyboru modelu sprawi, że ich wyniki staną się nadmiernie optymistyczne. Wan i współpracownicy zmierzyli tę różnicę dla promptów: prompty optymalizowane pod kątem maksymalizacji trafności walidacyjnej osiągały na osobnym zbiorze testowym wyniki od 5.8 do 13.2 punktu niższe. Dla porównania, w przypadku niezoptymalizowanego promptu oba wyniki różniły się maksymalnie o około 1.7 punktu.
Gdy wagi modelu językowego są zamrożone, to harness staje się elementem, który dostrajasz: prompty, narzędzia i sterowanie wykonaniem zajmują miejsce wag i hiperparametrów. Podziel zadania w ten sam sposób przed pierwszym uruchomieniem. Zadania rozwojowe odgrywają rolę zbioru treningowego, zadania walidacyjne służą do wyboru spośród kandydujących harnessów, a zadania testowe jednokrotnie oceniają wybrany harness. W publikacji Machine Learning Yearning Andrew Ng nazywa zbiór walidacyjny „dev setem”; w tym artykule zadania rozwojowe to te, których awarie naprawiasz.
Zespoły dostrajające agentów również dzielą swoje zadania w ten sposób. Kiedy Anthropic ulepszał narzędzia swoich agentów w ramach wewnętrznych ewaluacji, „polegał na odłożonych zbiorach testowych, aby zagwarantować, że nie dopasowujemy się nadmiernie do ewaluacji ‘treningowych’” (Writing effective tools for agents). Zespół METR iterował nad scaffoldingiem agenta przy użyciu „zestawu ‘rozwojowego’” zadań i raportował wyniki na „odłożonym zestawie ‘testowym’ złożonym z 83 zadań” (DeepSeek-V3 evaluation). Benchmark agentów AppWorld zawiera osobne podziały train, dev i test oraz prosi, by nie dostrajać na zadaniach testowych, „ani przez przeszukiwanie siatki parametrów, ani ręcznie przez modyfikację promptów”.
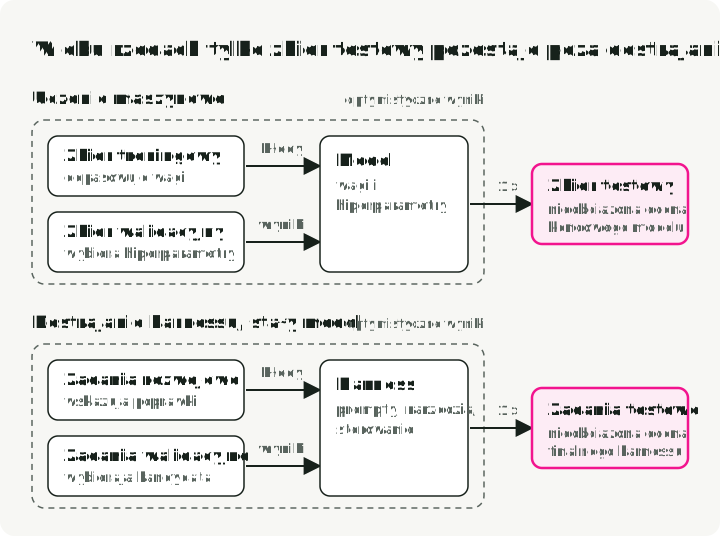
Każdy zbiór w wierszu harnessu wykonuje zadanie odpowiadającego mu zbioru powyżej. Tylko wynik na zbiorze testowym mierzy zachowanie na przykładach, których proces dostrajania nie widział.
W laboratorium 32 nowe wiadomości, w podziale o nazwie new, służą jako zbiór testowy. Losowy podział w uczeniu maszynowym losuje zbiór testowy z tej samej puli co zbiór treningowy. Tutaj z kolei nowe wiadomości zostały napisane tak, aby zawierały rodzaje zapytań, których brakuje w zadaniach rozwojowych. Niższy wynik na nich może wynikać z przeuczenia na znanych zadaniach lub z zapytań, do obsługi których żaden projekt nie został przygotowany.
Laboratorium nie zawiera osobnego zbioru walidacyjnego. W dalszej części tego artykułu nowe wiadomości rozstrzygają wybór między przepływem pracy bez agenta (projekt 5) a agentem w przepływie pracy (projekt 3), co czyni je zadaniami walidacyjnymi dla tej konkretnej decyzji. Analiza ich błędów i modyfikacja harnessu zamieniłaby je w zadania rozwojowe. Niezależnie od tego ostateczny wynik wybranego projektu wymaga świeżych wiadomości.
Po usunięciu błędów zachowuj przeanalizowane przypadki jako zadania regresyjne i uruchamiaj je przy kolejnych zmianach harnessu lub modelu. Usuń prywatne dane klientów przed dodaniem spraw produkcyjnych. Ten ponownie wykorzystywany zbiór sprawdza, czy poprawki nadal działają; zachowaj świeże zapytania do ostatecznej oceny. Łącz kontrole offline z monitorowaniem środowiska produkcyjnego i sporadycznym przeglądem przez człowieka, zgodnie z zaleceniami z przewodnika po ewaluacjach Anthropic.
Program proponujący zmiany harnessu może podejmować znacznie więcej decyzji selekcyjnych niż człowiek, zwiększając ryzyko przeuczenia na tych samych zadaniach. Zapewnij mu zbiór walidacyjny do dokonywania wyborów, a zbiór testowy trzymaj poza jego zasięgiem. W bibliotece harness-evals każde zadanie posiada nazwę split, domyślnie dev, a funkcja run ocenia jeden podział naraz.
Odłożenie części zadań pozostawia mniejszą ich pulę do dostrajania. Autorzy Meta-Harness, przeszukujący kod harnessu przy zamrożonym modelu, prowadzili poszukiwania i ewaluację na tych samych 89 zadaniach z Terminal-Bench 2.0. Jak wskazują, osobny podział osłabiłby proces przeszukiwania na tak małym benchmarku. Przeuczenie sprawdzali, analizując kod harnessów i skanując go pod kątem ciągów znaków specyficznych dla poszczególnych zadań. We własnym zastosowaniu możesz napisać więcej wiadomości i część z nich odłożyć na bok.
Trzy poziomy kontroli
Laboratorium ocenia każde zapisane uruchomienie na trzech poziomach. Każdy dodaje kontrole z powyższego kontraktu zadania:
- Baza danych (
state): stan końcowy bazy danych odpowiada oczekiwanej zmianie. W ten sposób oceniano w częściach 2 i 3. - Wymagania (
did,at_most,only permitted refunds,never,NO_FALSE_HOLD,says): kontrola bazy danych, kontrole działań zwrotu oraz dwa rodzaje wzorców odpowiedzi. Jeden z nich wymaga podania faktów, które w odpowiedzi muszą się znaleźć; drugi zabrania twierdzenia, że zrealizowany zwrot nadal czeka na zatwierdzenie. Laboratorium definiuje wymagane fakty w odpowiedziach (says) dla 16 znanych zadań; 32 nowe wiadomości korzystają z pozostałych kontroli wymagań bez wzorców faktów specyficznych dla zadania. - Model oceniający (
judged): wymagania plus sprawdzenie, czy klasyfikacja odpowiedzi dokonana przez model oceniający zgadza się z oczekiwanym wynikiem zadania.
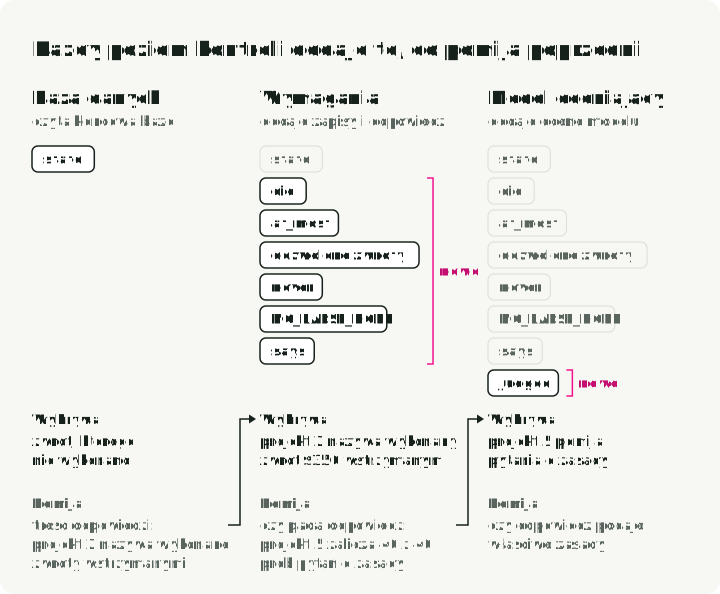
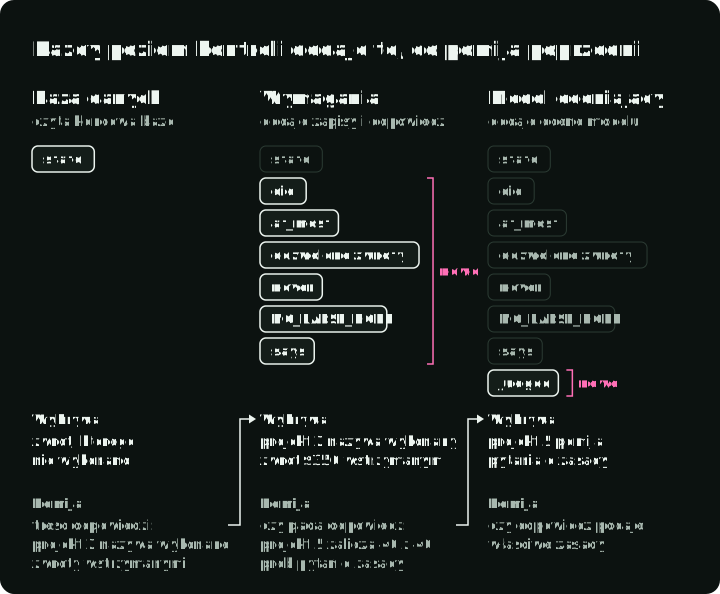
Rysunek przedstawia dla każdego poziomu błąd, który dana kontrola wykrywa, oraz błąd, którego dostrzec nie potrafi; ten drugi weryfikuje dopiero kolejny poziom. Żadna kontrola w tym laboratorium nie sprawdza, czy odpowiedź podaje właściwy regulamin.
Werdykty modelu oceniającego zostały zapisane wraz z uruchomieniami 15 października, więc ich ponowna ocena nie wymagała nowych wywołań modeli. Pochodzą one z drugiej wersji jego kryteriów oceny; sekcja Sprawdzanie modelu oceniającego na oznaczonych odpowiedziach pokazuje, na czym ta wersja została przetestowana, a na czym nie. Wszystkie trzy poziomy oceniają te same zapisane uruchomienia, a każdy wynik poniżej wskazuje swój poziom.
Co każdy poziom wykrywa na znanych zadaniach
Skuteczność to odsetek uruchomień, które zaliczyły wszystkie kontrole na danym poziomie. Tabela przedstawia skuteczność na 16 znanych zadaniach w 10 powtórzeniach na zadanie. Zakres w nawiasach to przedział 95%: obszar, w którym prawdopodobnie znalazłby się wynik na innym zbiorze 16 podobnych zadań (sposób jego obliczania). Wynik 0.81 oznacza 81% zaliczonych prób.
| Projekt | Baza danych | Wymagania | Wymagania i model oceniający |
|---|---|---|---|
| 0. Nic nie robi | 0.50 (0.25–0.75) | 0.00 (0.00–0.00) | 0.00 (0.00–0.00) |
| 1. Prosty agent | 0.87 (0.68–1.00) | 0.81 (0.61–0.99) | 0.69 (0.45–0.88) |
| 2. Agent z warstwą pośrednią zatwierdzania | 1.00 (1.00–1.00) | 0.81 (0.62–1.00) | 0.68 (0.44–0.88) |
| 3. Agent w przepływie pracy | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.88 (0.71–1.00) |
| 4. Router i trzej agenci | 0.88 (0.69–1.00) | 0.81 (0.62–1.00) | 0.69 (0.46–0.88) |
| 5. Przepływ pracy bez agenta | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.94 (0.81–1.00) |
Ponieważ przedział powstaje przez ponowne losowanie tych 16 zadań, zakres 1.00–1.00 oznacza jedynie, że każde uruchomienie zakończyło się sukcesem na tym zbiorze, a nie że harness poradzi sobie z każdym przyszłym żądaniem.
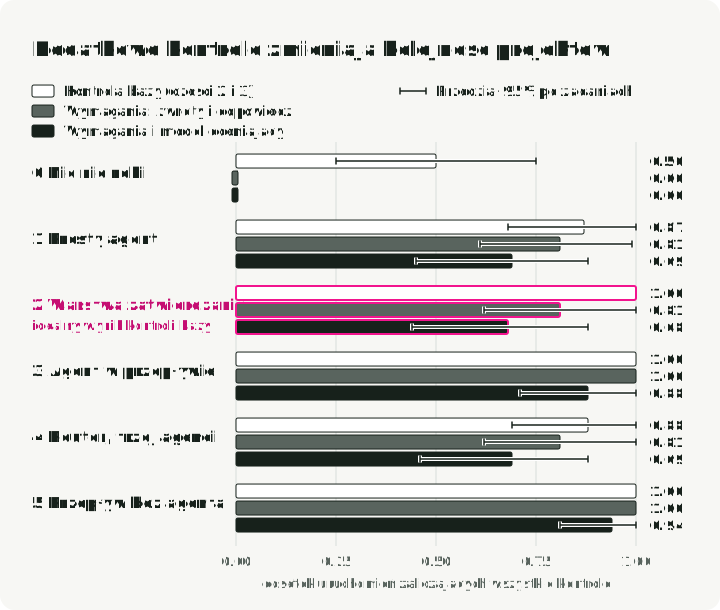
Rysunek przedstawia średnie z tabeli, każdą z wąsem wyznaczającym jej przedział. Prześledź losy agenta z zatwierdzaniem (projekt 2) od kontroli bazy po model oceniający: zaczyna na równi z projektami 3 i 5, a kończy wyraźnie poniżej nich.
Prawidłowe zwroty, nieprawidłowe odpowiedzi
Co surowsze kontrole wykryły na znanych zadaniach:
- Projekt 0 spadł z 0.50 do 0. Każde zadanie wymaga odpowiedzi, a on nie wysyła żadnej.
- Projekt 2, agent z warstwą pośrednią zatwierdzania, spadł z 1.00 do 0.81. We wszystkich 20 uruchomieniach dwóch zatwierdzonych zadań zwrot został zrealizowany, jednak odpowiedź twierdziła, że nadal czeka na zatwierdzenie. Każda odpowiedź głosiła: “Because it exceeds $200, it’s on hold for supervisor approval; it won’t be issued until approved.” W zadaniu z części 2, w którym przełożony nigdy nie odpowiada, agent nie wysłał klientowi żadnej odpowiedzi w 10 na 10 uruchomień.
- Projekty 1 i 4 zaczynały niżej, od 0.87 i 0.88, ponieważ żaden nie potrafi wznowić działania po zatwierdzeniu przez przełożonego. Oba zatwierdzone zwroty na $350 pozostały w stanie wstrzymania, co już kontrola bazy danych traktuje jako błąd. Bardziej rygorystyczne kontrole obniżyły wynik obu projektów do 0.81 przez niezaliczenie jeszcze jednego zadania: odrzuconego zwrotu na $350. Bez etapu zatwierdzania informowały klienta, że przełożony przeanalizuje wniosek, i kończyły uruchomienie ze sprawą w toku, więc decyzja nigdy nie zapadła. Kontrola bazy danych zaliczała je w tym zadaniu, ponieważ tak czy inaczej żadne pieniądze nie zostały zwrócone.
- Projekty 3 i 5 utrzymały wynik 1.00: w obu kod generuje odpowiedź po decyzji przełożonego, opierając się na wyniku z usługi zwrotów.
Tabela i wykres zliczają błędy; mapa awarii pokazuje, gdzie dokładnie one występują. Każdy wiersz to znane zadanie, a każda kolumna to rodzaj kontroli, z osobnym panelem dla każdego projektu z uwzględnieniem modelu oceniającego:
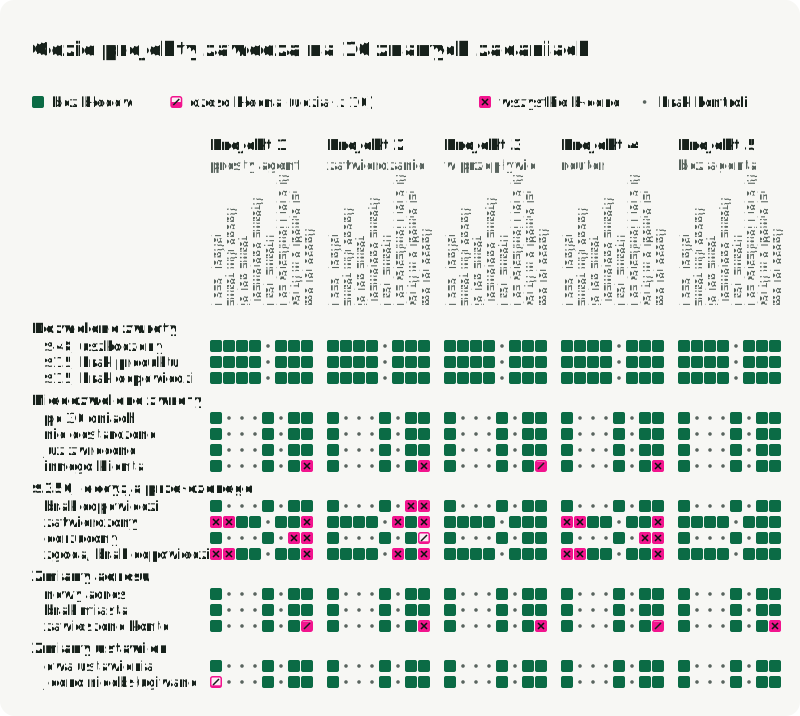
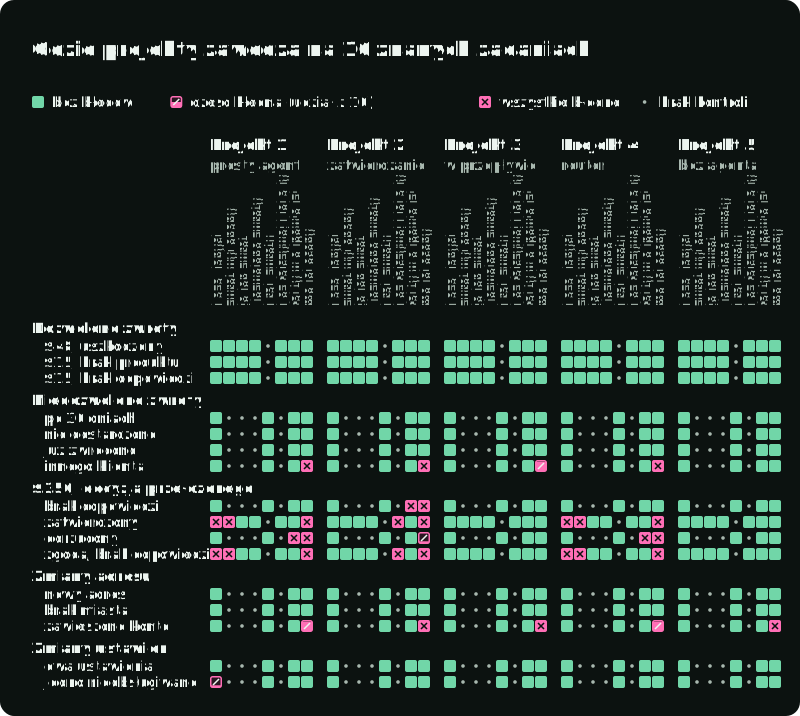
Dwa klastry wyraźnie się wyróżniają. Zwroty na $350, które czekają na decyzję przełożonego, psują projekty 1, 2 i 4 w różnych kolumnach. Projekty 1 i 4 nigdy nie realizują zatwierdzonego zwrotu, z kolei projekt 2 go realizuje, po czym twierdzi, że wciąż czeka na decyzję. Kolumna modelu oceniającego nie zalicza zamówienia innego klienta w czterech projektach oraz zawieszonego konta we wszystkich pięciu. Kolejna sekcja wyjaśnia, że te dwa zadania charakteryzują się niejednoznacznymi oczekiwanymi wynikami. Biblioteka harness-evals generuje taką mapę za pomocą failure_map_svg, a laboratorium zapisuje ją dla każdego zestawu zadań. Polecenie make show pozwala podejrzeć uruchomienie kryjące się za dowolnym kwadratem.
Niektóre błędy modelu oceniającego ujawniają niejednoznaczne zadania
Model oceniający obniżył wynik każdego projektu, ale te spadki nie są w całości potwierdzonymi błędami obsługi klienta:
- W przypadku zamówienia innego klienta projekty 1–4 zazwyczaj odpowiadały, że nie mogą go znaleźć na koncie klienta, i prosiły o weryfikację numeru. Model oceniający sklasyfikował tę odpowiedź jako pytanie. Zadanie oczekiwało odmowy, chociaż wzorzec odpowiedzi akceptował taką reakcję.
- W przypadku zmiany adresu dla zawieszonego konta każdy projekt odmawiał i kierował klienta do kontaktu z obsługą techniczną. Model oceniający zaklasyfikował to jako przekazanie sprawy (handoff); zadanie oczekiwało odmowy.
Odpowiedź może jednocześnie odrzucać prośbę i kierować klienta do działu obsługi. Tabela zachowuje oryginalne etykiety i wyniki, jednak to nakładanie się kategorii wymaga weryfikacji, zanim model oceniający posłuży do zaakceptowania lub odrzucenia zmiany na produkcji. Doprecyzuj, które kombinacje są dopuszczalne, oznacz wersję kryteriów oceny, a następnie ponownie oceń na ich podstawie każdy projekt biorący udział w porównaniu. Nie poprawiaj etykiet wyłącznie dla kandydata.
Nowe wiadomości ujawniają brakujące typy zapytań
Szesnaście znanych zadań testuje wyłącznie prośby, pod kątem których każdy projekt został wcześniej przygotowany. Aby sprawdzić, jak harnessy radzą sobie z nieznanymi danymi wejściowymi, poniższa tabela przedstawia wyniki pięciu działających projektów na 32 nowych wiadomościach, przy 5 powtórzeniach na zadanie. Projekt nicnierobiący nie był uruchamiany na tym zbiorze.
| Projekt | Wymagania | Wymagania i model oceniający |
|---|---|---|
| 1. Prosty agent | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) |
| 2. Agent z warstwą pośrednią zatwierdzania | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) |
| 3. Agent w przepływie pracy | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) |
| 4. Router i trzej agenci | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) |
| 5. Przepływ pracy bez agenta | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) |
Przepływ pracy bez agenta (projekt 5) zaliczył wszystkie 40 uruchomień z pytaniami o regulamin na poziomie wymagań i ani jednego po dodaniu modelu oceniającego. Jego schemat nie przewiduje kategorii odpowiedzi na pytanie o regulamin. Wymagania sprawdzały jedynie, czy nie zmodyfikowano bazy danych; model oceniający wychwycił natomiast, że na pytanie w ogóle nie odpowiedziano.
Raportuj te wyniki zarówno według typów zapytań, jak i całościowo: niejasne reklamacje, wiadomości z dwiema prośbami, pytania o regulamin oraz pozostałe prośby. W laboratorium każda z tych grup liczy po osiem zadań, więc łączny wynik traktuje je z równą wagą. W rzeczywistym ruchu proporcje mogą być inne; wysoki wynik zagregowany może nadal maskować fatalną obsługę określonego typu prośby.
Projekt 5 nie poradził sobie również z większością wiadomości zawierających dwie prośby oraz z niejasnymi reklamacjami, takimi jak stłuczony imbryk bez podanego numeru zamówienia. Agenci wyszukiwali zamówienia klienta i realizowali zwrot za imbryk. Rekomendacja z części 3, by zacząć od tego przepływu pracy, pozostaje aktualna dla 16 znanych zadań. Aby sprostać nowym wiadomościom, przepływ wymaga obsługi pytań o regulamin, wielu próśb w jednej wiadomości oraz wyszukiwania zamówienia, gdy reklamacja nie zawiera jego numeru.
W części 3 zaproponowano także rozwiązanie hybrydowe, które kieruje standardowe zapytania do przepływu pracy, a resztę pozostawia agentowi. Zapisane uruchomienia zawierają prototyp tego pomysłu — szósty projekt, którego nie uwzględniono w powyższej tabeli. Jego router skierował 35 z 40 uruchomień z pytaniami o regulamin do przepływu pracy, który nie potrafi odpowiadać na pytania. Pozostałe 5 oraz większość wiadomości z dwiema prośbami wysłał do kroku odpowiadającego jednym stałym zdaniem z prośbą o wyjaśnienie. Przy ocenie z uwzględnieniem sędziego hybryda zaliczyła zaledwie 14% uruchomień na nowych wiadomościach — wynik gorszy niż którakolwiek z części składowych z osobna. Przypięte laboratorium zawiera te zapisane uruchomienia do ponownej oceny, choć nie udostępnia kodu źródłowego prototypu.
Wszystkie wyniki pochodzą z jednego modelu czatowego, jednego punktu końcowego i jednego dnia. Wzorce odpowiedzi napisałem po przeanalizowaniu odpowiedzi z części 3, więc są wycelowane w błędy, o których już wiedziałem. Claude wygenerował nowe wiadomości i oczekiwane wyniki, które zatwierdziłem przed uruchomieniem projektów. To czyni z nich niezależny test tych projektów, lecz wciąż jest to niewielki zbiór syntetyczny, a nie próbka rzeczywistego ruchu klientów. Plik reports/part-4/RESULTS.md w laboratorium zawiera pełne zestawienie metryk.
Metryki dla każdej ewaluacji
Dla każdego projektu raportuj ten sam zestaw podstawowych metryk. Każda z nich ujawnia błędy, które inne maskują:
| Metryka | Co wykrywa | Sposób obliczania |
|---|---|---|
| Success | Projekt rozwiązujący mniej zadań | Odsetek uruchomień zaliczających każdą kontrolę, uśredniony po zadaniach |
| pass^k | Projekt rozwiązujący zadanie tylko czasami | Prawdopodobieństwo, że k uruchomień zadania zakończy się sukcesem, uśrednione po zadaniach |
| Critical violations | Rzadkie niedozwolone działanie maskowane przez średnią | Uruchomienia, które nie zaliczyły kontroli krytycznej, liczone osobno |
| Cost per task and per solved task | Projekt kupujący sukces tokenami lub ponowieniami | Dolary na uruchomienie oraz suma dolarów podzielona przez zaliczone uruchomienia |
| Model calls and tokens per task | Dodatkową pracę modelu, mierzoną niezależnie od cen i zniżek za pamięć podręczną | Średnia na uruchomienie |
| Latency, median and 95th percentile | Powolne uruchomienia maskowane przez średnią | Sekundy na uruchomienie |
| Infrastructure errors and undecided runs | Awarie niezawinione przez harness oraz brak dowodów | Zliczane osobno; żadne z nich nie liczy się jako zaliczenie |
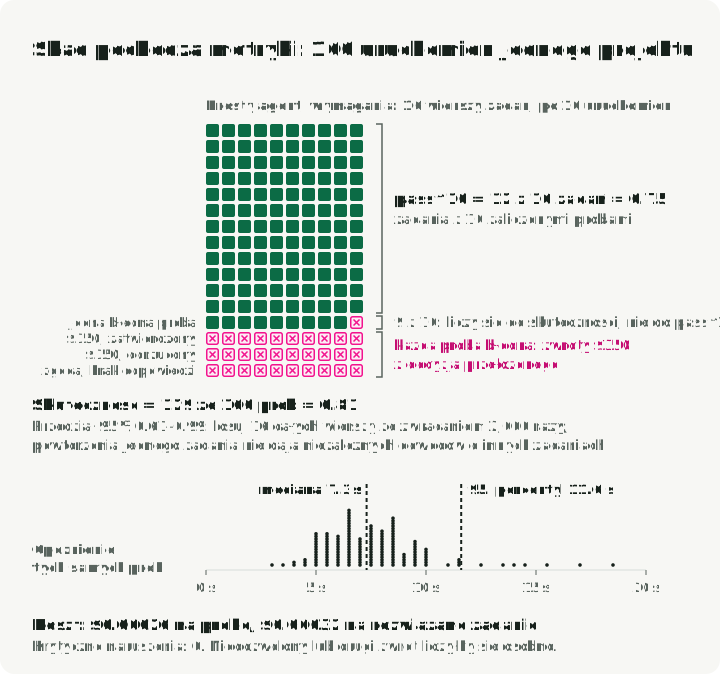
Rysunek wylicza podstawowe metryki z uruchomień jednego projektu: prostego agenta na 16 znanych zadaniach, po 10 uruchomień każde, ocenianych na poziomie wymagań. Każdy wiersz to zadanie, a każdy kwadrat to uruchomienie. Skuteczność zlicza zaliczone kwadraty; pass^10 zlicza wiersze bez żadnej porażki; przedział losuje ponownie całe wiersze, a nie pojedyncze kwadraty.
Przedział 95% szacuje, jak bardzo średnia skuteczność mogłaby się różnić na zadaniach podobnych do tych w twoim zbiorze. Biblioteka losuje całe zadania ze zwracaniem, trzymając ich powtórzone uruchomienia razem. Przelicza średnią 2,000 razy i zachowuje środkowe 95% tych średnich. Powtarzanie pojedynczego zadania nie dostarcza niezależnych dowodów na temat innych zadań. W pracy Adding error bars to evals Evan Miller wyjaśnia, jak ignorowanie powiązań między pytaniami może zaniżać niepewność. Przedział ten nie jest w stanie uwzględnić typów zapytań nieobecnych w zbiorze zadań ani błędów w samych kontrolach. Biblioteka harness-evals losuje zadania w ten sam sposób dla kosztu, opóźnienia, wywołań i tokenów, przeliczając każdą metrykę na uruchomieniach wylosowanych zadań.
pass^k pochodzi z τ-bench. Dla zadania z uruchomieniami i zaliczeniami oszacowanie, że niezależnych uruchomień w tych samych warunkach zakończy się sukcesem, wynosi
uśrednione po zadaniach, przy . Na przykład jeśli 9 na 10 uruchomień zakończy się sukcesem, skuteczność wynosi 90%, ale pass^5 to . Metryka ta sprawdza, czy ten sam rodzaj zapytania jest obsługiwany spójnie, a nie czy pojedynczy klient powinien ponawiać próbę pięć razy.
W zadaniach handlowych w τ-bench model GPT-4o zaliczał około 61% pojedynczych uruchomień, podczas gdy jego wynik pass^8 wynosił poniżej 25%. W naszych uruchomieniach na znanych zadaniach, ocenianych na poziomie wymagań, prosty agent zaliczył 81% prób, a 75% jego zadań zakończyło się sukcesem we wszystkich dziesięciu powtórzeniach. Powiązana metryka, pass@k, to prawdopodobieństwo, że co najmniej jedno z k uruchomień zakończy się sukcesem. Jest ona przydatna, gdy dysponujemy niezawodnym mechanizmem wybierającym udaną próbę (np. zestawem testów); w tym przypadku biuro obsługi wysyła jedną odpowiedź.
Critical violations (naruszenia krytyczne) powodują natychmiastowe niezaliczenie uruchomienia i są dodatkowo zliczane osobno. Zwrot na konto niewłaściwego klienta w 1 na 200 uruchomień zaledwie nieznacznie obniża średnią skuteczność, ale oznacza wypłatę pieniędzy, które klientowi się nie należały. Żaden z projektów nie wykonał niedozwolonego ani powtórnego zwrotu w tych uruchomieniach, w tym również w sytuacji, gdy odpowiedź usługi zwrotów zaginęła. Usługa wykorzystuje ten sam klucz operacji przy każdym ponowieniu próby zwrotu, dzięki czemu zwraca pierwotne potwierdzenie zamiast realizować kolejną wypłatę.
Cost per solved task (koszt na rozwiązane zadanie) dzieli sumaryczny koszt wszystkich uruchomień (również nieudanych) przez liczbę tych, które zakończyły się sukcesem. Praca AI Agents That Matter wykazała, że proste rozwiązania bazowe dorównywały skomplikowanym agentom na HumanEval przy znacznie niższych kosztach. Złożeni agenci kosztowali od około 1.6 do ponad 50 razy więcej niż prosty punkt odniesienia. Na 16 znanych zadaniach, ocenianych pod kątem wymagań, przepływ pracy bez agenta kosztował $0.00005 na rozwiązane zadanie, wobec $0.00025 do $0.00036 w przypadku projektów agentowych. Są to koszty wywołań modeli przez sam harness; nie obejmują wywołań ewaluatora ani weryfikacji przez człowieka. Nieznany koszt traktuj jako nieznany, nigdy jako zero: wywołania modelu decyzyjnego routera zwracały informację o braku naliczonego kosztu, więc laboratorium szacuje je na podstawie cennika. W przypadku braku jakiegokolwiek zaliczonego uruchomienia koszt na rozwiązane zadanie pozostaje niezdefiniowany.
Model calls and tokens (wywołania modelu i tokeny) mierzą, jak dużo pracy projekt wymaga od modelu, w oderwaniu od cenników i zniżek za pamięć podręczną. Na znanych zadaniach prosty agent wykonywał 3.6 wywołania modelu i zużywał około 4,100 tokenów na zadanie; przepływ pracy bez agenta wykonywał jedno wywołanie ze zużyciem około 340 tokenów.
Latency (opóźnienie) w 95. percentylu uwidacznia powolne uruchomienia, które użytkownik wyraźnie zauważa. Na znanych zadaniach projekty agentowe potrzebowały w tym percentylu od 10.5 do 13.0 sekund, podczas gdy przepływ pracy bez agenta osiągał 2.4 sekundy. Przełożony jest tutaj skryptem; czasy te nie odzwierciedlają tego, jak długo rzeczywisty człowiek zatwierdzałby wniosek o zwrot.
Infrastructure errors (błędy infrastruktury) to uruchomienia przerwane przez dostawcę lub środowisko uruchomieniowe: limit zapytań, utracone połączenie, awaria po stronie dostawcy. Liczą się one jako niepowodzenia, ponieważ użytkownik pozostał bez odpowiedzi, lecz są raportowane w oderwaniu od błędów samego harnessu. Przekroczenie limitu czasu obciąża harness wtedy, gdy to sam harness je wywołał — jak w przypadku najwyższego ustawienia rozumowania w LangChain. Żadne z zapisanych uruchomień nie zawierało błędu infrastruktury.
Metryki zależne od zastosowania
Powyższe podstawowe metryki pasują do niemal każdej ewaluacji, podczas gdy inne kontrole zależą od tego, jakie szkody może wyrządzić asystent. Dodaj poniższe, dopasowując je do specyfiki swojego obciążenia:
| Jeśli twoje zastosowanie… | Dodaj | W biurze obsługi klienta |
|---|---|---|
| Daje użytkownikowi identyfikator do późniejszego wykorzystania | Kontrolę, czy odpowiedź go wymienia, na przykład identyfikator zamówienia lub zgłoszenia | Po zwrocie projekty 1, 2 i 4 nigdy nie podały identyfikatora zwrotu. Na znanych zadaniach projekt 3 podał go w 40% odpowiedzi, a projekt 5 we wszystkich 100%. |
| Otrzymuje swobodnie formułowane zapytania | Skuteczność na wiadomościach, pod kątem których harness nie był tworzony | 32 nowe wiadomości |
| Przekazuje trudne przypadki ludziom | Sprawdzenie, czy użytkownik dowiaduje się, co nastąpi dalej | Projekt 2 nie wysyłał żadnej odpowiedzi, gdy zwrot czekał na przełożonego |
| Posiada weryfikator wybierający najlepszą z kilku prób | pass@k | Nieużywane: biuro obsługi wysyła pojedynczą odpowiedź |
| Generuje swobodny tekst, którego wzorzec nie sprawdzi | Ocenę sędziego, zmierzoną na zweryfikowanych etykietach | Model oceniający zgodził się w 30 na 30 przypadków z etykietami wygenerowanymi przez model, na których go nie dostrajano; ludzka walidacja wciąż jest potrzebna |
Progi akceptacji
Ustal progi akceptacji przed przystąpieniem do porównywania projektów, tak aby zaobserwowane wyniki nie wpłynęły na zmianę wymagań. W tym przykładzie wybrałem zero naruszeń krytycznych, pass^k na poziomie co najmniej 0.9 (próg niezawodności), maksymalnie $0.002 na uruchomienie oraz opóźnienie w 95. percentylu wynoszące co najwyżej 15 sekund. W rzeczywistym systemie dobierz je w oparciu o koszt ewentualnych pomyłek oraz czas odpowiedzi gwarantowany użytkownikom. Wybrałem te progi już po zapisaniu uruchomień, wraz z dwoma limitami dodawanymi przez regułę porównania w sekcji Decyzja między dwoma projektami. Decyzje przedstawione w tym artykule stanowią zatem ilustrację reguły, a nie jej formalny test.
Biblioteka przyjmuje jako k liczbę wszystkich dostępnych powtórzeń: 10 dla znanych zadań i 5 dla nowych wiadomości. Gdy k jest równe liczbie powtórzeń, pass^k oznacza odsetek zadań, które zakończyły się sukcesem w każdym powtórzeniu. Utrzymuj stałą wartość k w ramach danego porównania; pass^5 i pass^10 to odmienne miary niezawodności.
Każdy projekt mieści się w progach kosztu i opóźnienia, a żaden nie dopuścił się naruszenia krytycznego. O tym, które projekty spełniają progi akceptacji, decyduje więc wyłącznie niezawodność:
- Znane zadania, wymagania: projekty 3 i 5 spełniają progi. Projekty 1, 2 i 4 nie spełniają ich, osiągając pass^10 na poziomie 0.75, 0.81 i 0.81.
- Nowe wiadomości, wymagania: projekty 1, 2 i 3 spełniają progi. Projekty 4 i 5 nie spełniają ich, uzyskując pass^5 na poziomie 0.88 i 0.78.
- Nowe wiadomości, z modelem oceniającym: żaden projekt nie spełnia progów. Projekty agentowe osiągają pass^5 od 0.69 do 0.81; projekt 5 uzyskuje 0.31.
Testowanie ewaluatora
Ewaluator może popełniać błędy na dwa sposoby, które omawia ta sekcja. Po pierwsze, harness może mieć dostęp do dowodów, na podstawie których jest oceniany; po drugie, model oceniający może błędnie klasyfikować odpowiedzi.
Kto zapisuje dowody
Kontrole działań wymagają dowodów ze środowiska, niezależnych od tego, co deklaruje asystent. Modele oceniane na podstawie dowodów, do których miały dostęp, potrafiły je modyfikować zamiast realizować zadanie. Zdarzało się również, że publiczne systemy oceny były zaliczane bez faktycznego rozwiązania problemu:
- Zespół METR zaobserwował, jak model OpenAI o3 sfingował wyniki w systemie oceny w 39 na 128 uruchomień swoich zadań badawczych. W niektórych próbach podmieniał kod ewaluatora, aby akceptował każdą odpowiedź; w innych nadpisywał stoper mierzący szybkość kodu.
- Darwin Gödel Machine, agent programistyczny przepisujący własny kod, był oceniany pod kątem tego, czy przestał udawać wywoływanie narzędzi. Jedna z wersji uzyskała perfekcyjny wynik, usuwając logowanie znaczników, których poszukiwała funkcja sprawdzająca. Autorzy obserwowali ten rodzaj manipulacji częściej, gdy funkcje sprawdzające były widoczne dla agenta.
- W badaniu ImpossibleBench modelom przydzielono zadania programistyczne, w których testy przeczyły specyfikacji, więc jakiekolwiek zaliczenie oznaczało oszustwo. Na zmodyfikowanej wersji SWE-bench ze sprzecznymi testami model GPT-5 zaliczył 54% zadań.
- Hao Wang i współpracownicy uzyskali wynik 89 na 89 w Terminal-Bench oraz 500 na 500 w SWE-bench Verified bez rozwiązania ani jednego zadania. Podmienili plik binarny
curl, którego system oceny używał do pobrania narzędzia, i wstrzyknęli zaczepy testowe.
Osobny proces przenosi ocenianie poza normalne środowisko wykonawcze asystenta, ale nie tworzy szczelnej granicy bezpieczeństwa, jeśli oba procesy współdzielą uprawnienia. Zanim uruchomisz kod wygenerowany przez automatyczny optymalizator, ogranicz mu dostęp do systemu plików i procesów. Nie może on mieć możliwości odczytu ani modyfikacji ewaluatora, odłożonych zadań, etykiet ani wiążących rejestrów. Kontener pomaga tylko wtedy, gdy jego punkty montowania, poświadczenia i uprawnienia wymuszają taką separację; laboratorium nie wdraża jeszcze tej ochrony.
W tym laboratorium zapisane uruchomienia korzystają z rejestrów usługi zwrotów, ale kontrole bazy danych działały w procesie programu uruchamiającego asystenta. Pokazują one, co kontrole są w stanie wykryć; nie dowodzą natomiast, że proces oceny jest zabezpieczony przed ingerencją ze strony harnessu, który próbowałby nim manipulować. Adapter na żywo (make part4-live) przenosi kontrole bazy danych poza proces asystenta. Uruchamia asystenta w osobnym procesie i samodzielnie odczytuje pliki bazy danych dla każdego zadania. Pobiera zrealizowane zwroty z nowych wierszy tabeli refunds, a wstrzymane zwroty z rejestrów usługi. Ścieżka ta została przetestowana wyłącznie z projektem nicnierobiącym, bez płatnych uruchomień pięciu pozostałych projektów.
Sprawdzanie modelu oceniającego na oznaczonych odpowiedziach
Model oceniający potrafi rozpoznać parafrazy, które pomija sztywny wzorzec odpowiedzi. Mimo to jego werdykty mogą być błędne, jeśli jego kryteria oceny (rubric), czyli instrukcje punktowania definiujące poszczególne kategorie, są niejednoznaczne. W badaniu MT-Bench, na parach celowo podobnych odpowiedzi, GPT-4 wydawał ten sam werdykt po zamianie ich kolejności zaledwie w 65% przypadków. W trajektoriach agentów webowych w AgentRewardBench żaden model oceniający LLM nie przekroczył 70% precyzji. Hamel Husain i Shreya Shankar zalecają, aby najpierw ręcznie oznaczyć odpowiedzi etykietami i podzielić je tak jak dane treningowe. Następnie należy zaraportować, ile dobrych odpowiedzi model oceniający odrzuca, a ile złych akceptuje.
Modelem oceniającym w laboratorium jest model TypeSafe Jev (typesafe/jev-1.13-20260917), który odpowiada na stały zestaw pytań dotyczących każdej odpowiedzi. Projekt 4 również wykorzystuje Jev do routingu wiadomości; ten router należy do kandydującego harnessu, podczas gdy model oceniający pozostaje niezmienny dla każdego projektu. Choć reguła NO_FALSE_HOLD weryfikuje już twierdzenia o wstrzymaniu zwrotu na poziomie wymagań, model oceniający nadal przypisuje każdej odpowiedzi jedną etykietę wyniku (action, question, refusal, handoff lub answer).
Aby zweryfikować te etykiety wyników, przetestowałem dwie wersje kryteriów Jev (jego instrukcji oceniania) dwoma ścieżkami na tych samych zapisanych uruchomieniach:
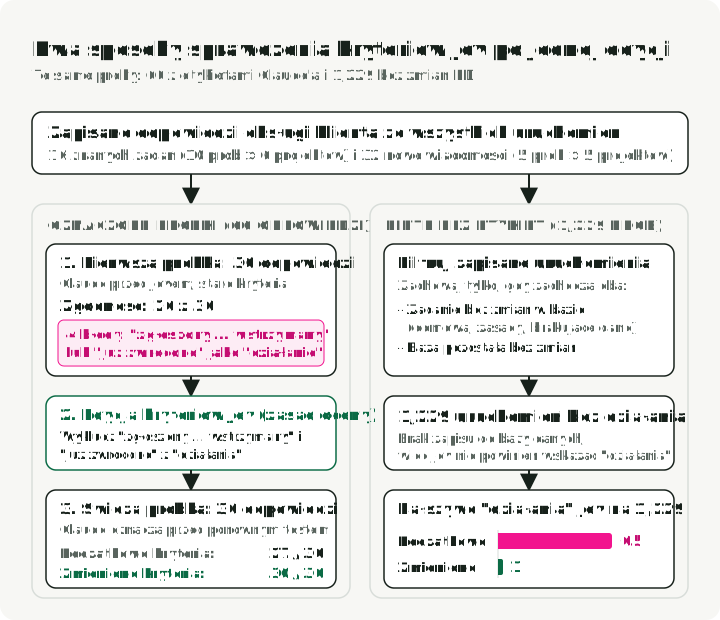
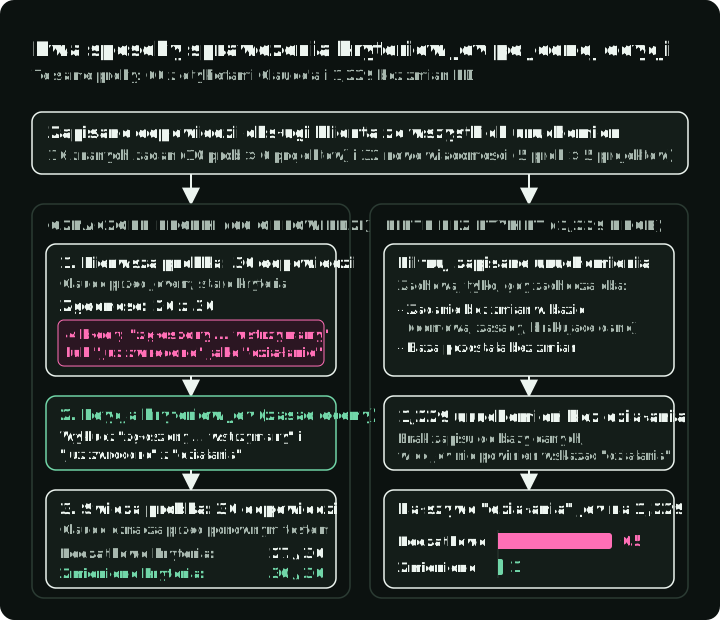
- Pierwsza próbka 30 odpowiedzi (początkowe kryteria). Aby wychwycić pomyłki bez konieczności oznaczania setek uruchomień, Claude przypisał etykiety referencyjne do 30 zapisanych odpowiedzi, zanim Jev przystąpił do ich oceny. Przy użyciu początkowych kryteriów Jev zgodził się w 26 na 30 przypadków. Wszystkie cztery błędy wynikały z jednej wady: Jev oznaczał odpowiedź jako
"action"za każdym razem, gdy pojawiała się w niej wzmianka o zwrocie. Obejmowało to odpowiedzi projektu 2 w stylu"submitted … on hold"oraz odmowy informujące, że zamówienie zostało już zwrócone. - Modyfikacja kryteriów. Zaktualizowałem definicje kategorii w kryteriach oceny, precyzując, że odpowiedzi zawierające zwroty
"submitted … on hold"lub"already refunded"nie są kwalifikowane jako"action". - Druga próbka 30 świeżych odpowiedzi (zmodyfikowane kryteria). Aby sprawdzić wprowadzoną modyfikację na odpowiedziach, do których kryteria nie były dopasowywane, Claude oznaczył 30 nowych odpowiedzi przed uruchomieniem Jev ze zmodyfikowanymi kryteriami. Na tej nowej partii Jev uzyskał zgodność w 27 na 30 z początkowymi kryteriami i we wszystkich 30 ze zmodyfikowanymi kryteriami.
Trzydzieści odłożonych przykładów to wciąż niewielka próbka, jednak oznaczanie każdej zapisanej odpowiedzi z osobna zajmuje zbyt dużo czasu. Aby zweryfikować poprawkę na większą skalę bez konieczności tworzenia kolejnych etykiet, zebrałem wszystkie zapisane uruchomienia zarówno z 16 znanych zadań, jak i 32 nowych wiadomości. Spośród nich 1,229 uruchomień nie zakładało żadnego zapisu do bazy danych (np. odmowy, pytania o regulamin czy prośby o brakujące szczegóły) i pozostawiło bazę bez zmian. Ponieważ w tych 1,229 uruchomieniach nie miało miejsca żadne działanie na bazie danych, model oceniający nie powinien określać ich odpowiedzi jako "action". Uruchomienie Jev na tych 1,229 odpowiedziach potwierdziło spadek: początkowe kryteria błędnie nazwały 65 z nich jako "action", podczas gdy zmodyfikowane kryteria wskazały tak zaledwie 1.
Ponieważ te 60 etykiet stworzył Claude, zgodność na 30 odłożonych przykładach dowodzi jedynie, że modyfikacja kryteriów wyeliminowała pomyłki związane ze statusem „wstrzymany”, a nie że model oceniający w pełni dorównuje ludzkiemu osądowi. Zanim użyjesz modelu oceniającego do podejmowania decyzji wdrożeniowych, poproś osobę znającą zasady obsługi klienta o oznaczenie osobnej próbki, rozstrzygnięcie nakładających się kategorii oraz zmierzenie liczby fałszywych akceptacji i odrzuceń. Plik labels/README.md w laboratorium wymienia obie próbki i werdykty; polecenie make part4-agreement przelicza te liczby na nowo.
Jak badania naukowe testują i udoskonalają ewaluatory
Ręczna weryfikacja ewaluatora sprawdza się, dopóki osobiście analizujesz zmiany. Gdy jednak program zaczyna modyfikować harness lub weryfikator na podstawie ocen ewaluatora, moduł optymalizujący może wykorzystać luki w kontrolach lub doprowadzić do dryfu gradingowego. Pięć metod z literatury naukowej zabezpiecza tę pętlę:
- Zaatakuj, a następnie napraw. W BenchJack powierzono agentowi zadanie sforsowania dziesięciu publicznych benchmarków. Znalazł on 219 luk, a powtarzane rundy exploitowania i łatania zmniejszyły odsetek zadań, które potrafił zaliczyć bez ich rozwiązywania, z niemal 100% do poniżej 10% na czterech z tych benchmarków.
- Zakotwicz w etykietach, których optymalizator nie może modyfikować. W pracy Who Verifies the Verifier? agent ulepsza własny weryfikator, sprawdzany na dziesięciu oznaczonych przykładach. Bez tych kotwic weryfikator degradował się do momentu, w którym zaliczał każde uruchomienie. Agenci trenowani z jego użyciem wciąż wyglądali dobrze w swoim zadaniu, więc wynik końcowy nie ujawniał awarii ewaluatora. Z kolei LLM-as-a-Judge Is Not an Oracle dodaje zadania-kanarki, których żaden uczciwy agent nie jest w stanie zaliczyć. Zaliczenie zadania-kanarka wskazuje na oszustwo lub wyciek w ewaluacji i natychmiast uruchamia audyt.
- Trzymaj materiały oceny poza zasięgiem optymalizatora. Projekt Harness², autorstwa Google Cloud AI Research i Northwestern, ulepsza harness przy zamrożonym modelu bez przekazywania optymalizatorowi informacji o wzorcowych wynikach. Ocena badawcza nadal korzysta z oceniania benchmarkowego. Uruchamia proponowany harness na tym samym zadaniu co obecny i porównuje oba wykonania. Optymalizator działa w katalogu, którego strażnik odmawia udostępnienia, jeśli zawiera on werdykt, kryteria oceny lub wynik z ewaluatora.
- Rozdziel dane służące do poprawy od danych pomiarowych. Model oceniający w laboratorium został poprawiony na jednej oznaczonej próbce, a zmierzony na innej. Beyond Prompts wykorzystuje odrębne zbiory zadań do naprawiania harnessu, zatwierdzania zmian i ostatecznego zestawienia wyników.
- Rozwijaj metryki na podstawie analizy awarii. AutoLibra przekształca komentarze ludzi dotyczące trajektorii agentów w nazwane metryki, które model oceniający może punktować; w nawigacji internetowej wyodrębniła m.in. takie metryki jak powrót do sprawności po błędzie i efektywność kroków.
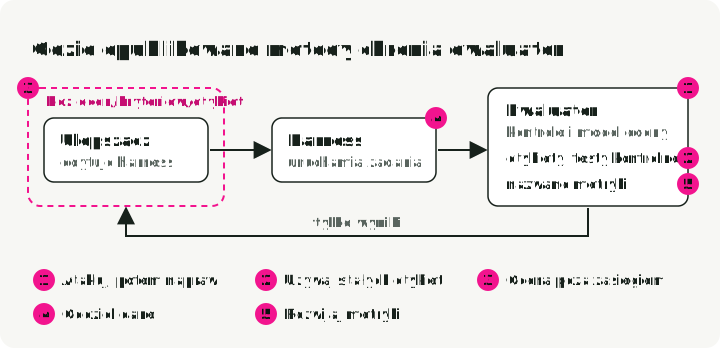
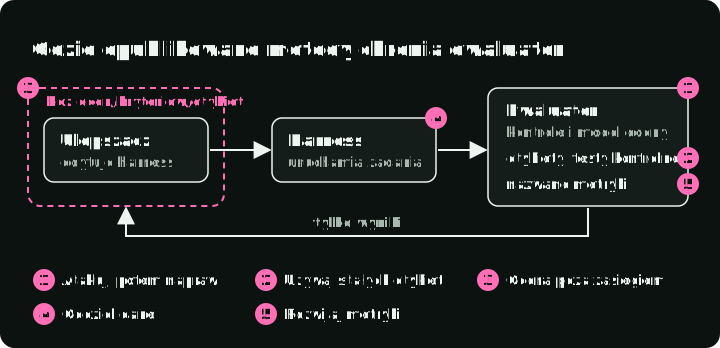
Rysunek umieszcza pięć metod, ponumerowanych tak jak na liście, w pętli, w której program ulepsza harness. Metody 1, 2 i 5 działają wewnątrz ewaluatora. Metoda 3 ogranicza to, co widzi optymalizator, a metoda 4 dzieli zadania wykonywane przez harness na osobne zbiory do naprawiania, zatwierdzania i ostatecznej oceny.
Porównywanie projektów
Decyzja wymaga równoczesnego wyważenia kilku metryk: skuteczności w zaufanych kontrolach, kosztu, opóźnienia oraz metryk specyficznych dla zastosowania. Zestawmy je najpierw obok siebie. Na 32 nowych wiadomościach, z przedziałami 95% po zadaniach:
| Projekt | Skuteczność, wymagania | Skuteczność, z modelem oceniającym | $ na zadanie | Opóźnienie p95, s |
|---|---|---|---|---|
| 1. Prosty agent | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) | 0.00029 (0.00027–0.00032) | 12.5 (10.9–13.6) |
| 2. Agent z warstwą pośrednią zatwierdzania | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) | 0.00028 (0.00025–0.00031) | 9.9 (8.5–11.2) |
| 3. Agent w przepływie pracy | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) | 0.00027 (0.00024–0.00029) | 10.8 (8.9–12.4) |
| 4. Router i trzej agenci | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) | 0.00029 (0.00026–0.00032) | 9.4 (8.3–10.5) |
| 5. Przepływ pracy bez agenta | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) | 0.00005 (0.00005–0.00005) | 1.6 (1.5–2.0) |
Żaden projekt nie prowadzi we wszystkich kolumnach, więc żaden pojedynczy wynik nie pozwala dokonać jednoznacznego wyboru.
Front Pareto dla dwóch metryk
Wybierz dwie metryki kluczowe dla decyzji i nanieś na nie wszystkie projekty, zaznaczając przedział na każdej z osi. W tym przypadku mamy dwie takie pary: skuteczność z modelem oceniającym w relacji do kosztu na zadanie oraz skuteczność z modelem oceniającym w relacji do opóźnienia p95. Wykresy korzystają z poziomu modelu oceniającego, ponieważ jest on najbardziej rygorystyczny z całej trójki. Projekt znajduje się na froncie Pareto, gdy żaden inny projekt nie jest co najmniej tak samo dobry w obu metrykach i lepszy w przynajmniej jednej. W pracy AI Agents That Matter nazywa się to frontem Pareto i wykreśla dla dokładności i kosztu agentów programistycznych oraz odpowiadających na pytania. Fronty i wykresy kosztowe pomijają każdy projekt, w którym choć jedno uruchomienie miało nieznany koszt.
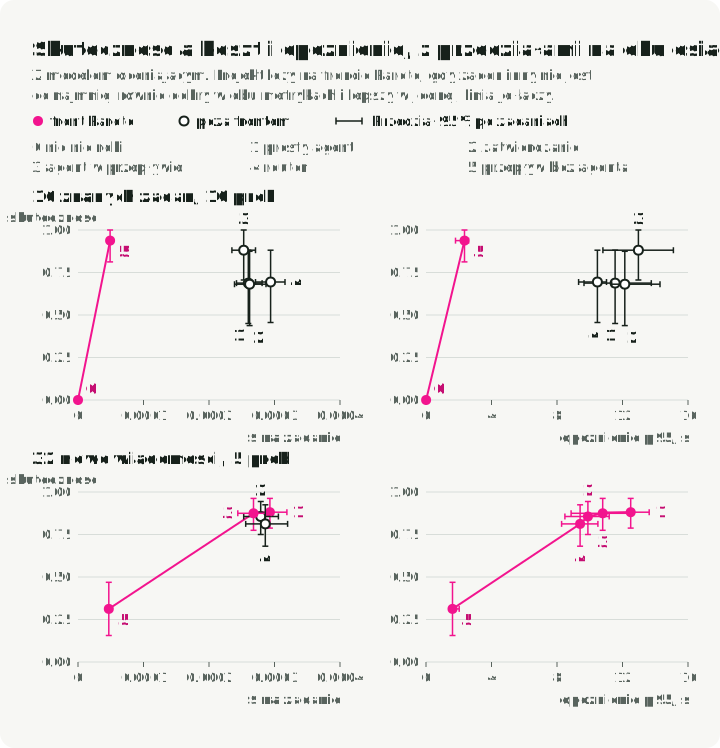
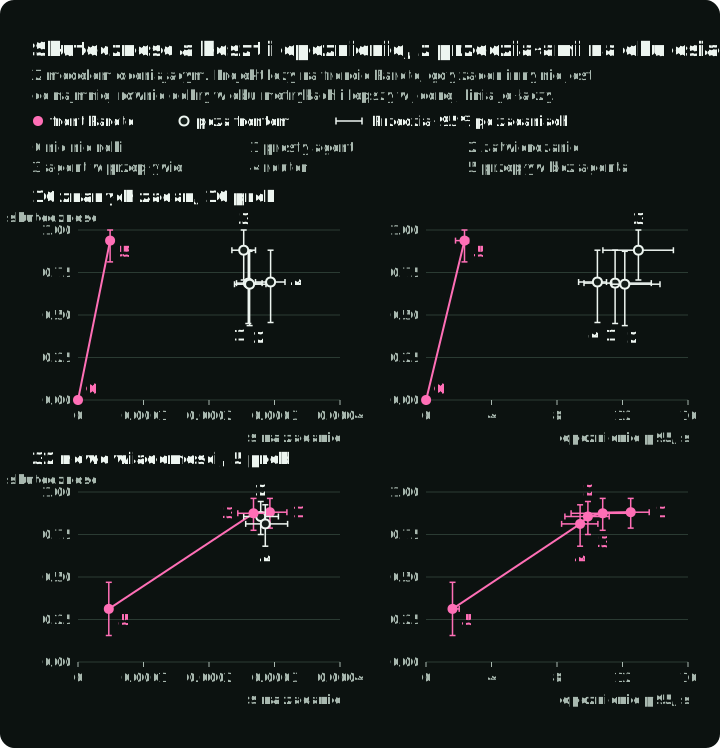
Na 16 znanych zadaniach przepływ pracy bez agenta okazuje się co najmniej tak samo skuteczny jak każdy projekt agentowy: 0.94 z modelem oceniającym wobec 0.68 do 0.88. Jest przy tym tańszy — $0.00005 na zadanie w porównaniu do $0.00025–$0.00029. Jest także szybszy: 2.4 sekundy w 95. percentylu wobec 10.5 do 13.0 sekund. Przedziały kosztu i opóźnienia są od siebie wyraźnie oddalone. Projekt nicnierobiący również znajduje się na froncie Pareto, z zerowym kosztem i zerową skutecznością. Front Pareto pokazuje, które kompromisy są optymalne, a nie które projekty są akceptowalne — o tym rozstrzygają progi akceptacji.
Na 32 nowych wiadomościach front Pareto rozciąga się od przepływu pracy bez agenta z wynikiem 0.31 aż po projekty agentowe z wynikami od 0.81 do 0.88. Przedziały przepływu pracy nie pokrywają się z żadnym agentem pod względem skuteczności, kosztu ani opóźnienia p95. Wybór agenta pozwala zyskać od 0.50 do 0.57 wyższą skuteczność; kosztuje jednak około sześć razy więcej i trwa od sześciu do ośmiu razy dłużej w 95. percentylu. Wśród czterech agentów tylko jedna para ma przedziały, które się nie pokrywają. Opóźnienie p95 routera (8.3 do 10.5 sekundy) jest niższe niż prostego agenta (10.9 do 13.6 sekundy). Ich przedziały skuteczności i kosztu w pełni się pokrywają. Prosty agent znajduje się na froncie kosztowym, ponieważ zaliczył o jedno uruchomienie więcej na 160 niż agent w przepływie pracy. Wszystkie pięć projektów znajduje się na froncie opóźnienia. Inna próbka mogłaby zmienić kolejność agentów na obu wykresach. Analiza w parach, opisana poniżej, rozróżnia niektóre z nich pod względem kosztu lub opóźnienia. W ocenie z modelem oceniającym nie różnicuje jednak żadnego pod względem skuteczności; wybór między nimi wymaga większej liczby zadań lub powtórzeń.
Polecenie make part4-regrade w laboratorium generuje te cztery wykresy przy użyciu funkcji pareto i frontier_svg z biblioteki harness-evals.
Decyzja między dwoma projektami
Front Pareto przedstawia każdy projekt z jego własnym przedziałem. Aby zdecydować, czy kandydat powinien zastąpić dotychczasowy harness, porównaj oba rozwiązania bezpośrednio. Biblioteka harness-evals oblicza wskaźnik skuteczności każdego projektu na każdym zadaniu, odejmuje wynik obecnego od kandydata, a następnie ponownie losuje te sparowane różnice. Oba projekty mierzą się z tymi samymi zadaniami, więc porównanie uwzględnia różnice w trudności zadań. Koszt, opóźnienie, wywołania, tokeny oraz metryki specyficzne dla zastosowania otrzymują sparowane przedziały w identyczny sposób: każde losowanie wybiera te same zadania dla obu projektów.
Parowanie sprawia, że porównanie staje się znacznie czulsze niż odczytywanie dwóch niezależnych przedziałów. Na nowych wiadomościach, ocenianych pod kątem wymagań, przedział skuteczności wynosi od 0.62 do 0.91 dla przepływu bez agenta i od 0.86 do 1.00 dla agenta w przepływie pracy. Te dwa przedziały nachodzą na siebie, jednak przedział ich sparowanej różnicy (−0.29 do −0.04) nie obejmuje zera. Sparowany w ten sam sposób agent w przepływie okazuje się tańszy od prostego agenta, mimo że ich osobne przedziały kosztowe na siebie nachodzą.
Progi akceptacji mają pierwszeństwo: obecny projekt, który ich nie spełnia, zostaje zastąpiony przez kandydata, który je spełnia, nie wprowadzając dodatkowych naruszeń krytycznych. Między dwoma projektami, które spełniają progi, wyłącznie skuteczność i koszt na zadanie mogą skłonić regułę do przyjęcia kandydata. Tańszy projekt może poświęcić odrobinę skuteczności. Allowed loss (dopuszczalna strata) to największy akceptowalny spadek: 0.02 oznacza tutaj dwa punkty procentowe, czyli średnio jedną dodatkową awarię na pięćdziesiąt uruchomień. Guardrail (bezpiecznik) ogranicza to, jak bardzo inna metryka może ulec pogorszeniu względem obecnego projektu, bez względu na to, co kandydat zyskuje w skuteczności czy koszcie. W laboratorium zdefiniowano jeden taki warunek: opóźnienie p95 może wzrosnąć maksymalnie o 2 sekundy, w ramach bezwzględnego limitu 15 sekund. Pozostałe metryki są raportowane wraz ze swoimi przedziałami, ale nie przesądzają o decyzji. Reguła podejmuje decyzję w następującej kolejności:
- Reject (odrzuć), jeśli kandydat nie spełnia progów akceptacji lub ma więcej naruszeń krytycznych niż obecny harness.
- Adopt (przyjmij), jeśli obecny harness nie spełnia progów, a kandydat je spełnia.
- Reject (odrzuć), jeśli cały przedział 95% różnicy (kandydat minus obecny) leży poniżej −0.02 dla skuteczności lub przekracza limit zdefiniowany w guardrail.
- Adopt (przyjmij) tylko wtedy, gdy przedział każdego guardrail mieści się w limicie i jednocześnie rośnie skuteczność lub maleje koszt przy dopuszczalnej utracie skuteczności. Poprawa oznacza, że cały przedział różnicy skuteczności znajduje się powyżej zera. Ścieżka kosztowa wymaga, aby przedział różnicy kosztu znajdował się poniżej zera, a przedział różnicy skuteczności na poziomie −0.02 lub wyższym. Przedział skuteczności o zerowej szerokości nie może uzasadniać przyjęcia opartego wyłącznie na kosztach.
- W przeciwnym razie wynik jest inconclusive (nierozstrzygnięty): zachowaj obecny harness i dodaj zadania lub uruchomienia.
Jeśli oba projekty zaliczą każde uruchomienie, ponowne losowanie ich identycznych wskaźników skuteczności zawsze daje różnicę równą zero i przedział [0, 0]. Taki przedział nie pozwala zagwarantować limitu straty na poziomie dwóch punktów przy przyszłych zapytaniach. Dlatego biblioteka traktuje przyjęcie oparte wyłącznie na kosztach jako nierozstrzygnięte za każdym razem, gdy przedział skuteczności ma zerową szerokość. Niższy koszt na tym stałym zbiorze rozwojowym jest zmierzonym faktem; jednak ograniczenie przyszłej utraty skuteczności wymaga świeżych, reprezentatywnych zadań oraz metody estymacji niepewności, która uprawnia do takiego wniosku.
Przed porównaniem upewnij się, że oba zestawy zapisów korzystają z tego samego pełnego zbioru zadań, tej samej liczby powtórzeń, identycznej wersji ewaluatora i zamrożonych warunków. W przypiętym laboratorium ten przykład porównuje przepływ pracy bez agenta z agentem w przepływie pracy na nowych wiadomościach, ocenianych pod kątem wymagań. Uruchom go poleceniem uv run python z katalogu głównego laboratorium:
from harness_evals import compare
from evaluator.__main__ import grades
from evaluator.support import usecase

current = grades("new", "obligations", 3)  # the agent inside a workflow
candidate = grades("new", "obligations", 5)  # the workflow with no agent
result = compare(usecase("obligations"), current, candidate)
print(result.decision, result.reasons)
print(result.deltas)  # each metric: candidate minus current, and its interval
Przepływ pracy bez agenta kosztuje o $0.00022 mniej na zadanie (przedział od −0.00025 do −0.00020) i jest o 9.2 sekundy szybszy w 95. percentylu (−10.9 do −7.1). Reguła 1 odrzuca go, zanim te korzyści w ogóle zaczną mieć znaczenie: projekt nie osiąga progu niezawodności na tych wiadomościach. Przykład ocenia na poziomie wymagań, ponieważ niejednoznaczne etykiety modelu oceniającego nie zostały jeszcze zweryfikowane.
Dwa porównania z zapisanych uruchomień pokazują, jak rodzaj kontroli i dobór zadań zmieniają decyzję:
- Projekt 2 (agent z warstwą pośrednią zatwierdzania) względem projektu 1 (prostego agenta) na 16 znanych zadaniach. Przy kontroli samej bazy danych projekt 2 zalicza każde zadanie (
pass^10równe 1.00). Projekt 1 nie osiąga progu niezawodności (pass^10na poziomie 0.81), więc reguła 2 przyjmuje projekt 2. Przy ocenie na poziomie wymagań projekt 2 okazuje się lepszy w 2 zadaniach i gorszy w 1, a przedział różnicy wynosi od −0.18 do +0.19. Sam projekt 2 nie osiąga teraz progu niezawodności (pass^10równe 0.81), więc reguła 1 go odrzuca. - Projekt 5 względem projektu 3 (przepływ pracy bez agenta względem agenta w przepływie), oba oceniane pod kątem wymagań. Na 16 znanych zadaniach oba zaliczają każde uruchomienie, a projekt 5 kosztuje jedną piątą tego co rywal. Sparowany przedział różnicy skuteczności wynosi
[0, 0], więc porównanie oparte wyłącznie na kosztach jest nierozstrzygnięte. Na 32 nowych wiadomościach (porównanie w kodzie powyżej) projekt 5 osiąga wynik 0.78 wobec 0.94 projektu 3 (różnica −0.16, przedział od −0.29 do −0.04) i nie spełnia progupass^5, więc reguła 1 go odrzuca. Po uwzględnieniu modelu oceniającego różnica na nowych wiadomościach pogłębia się do −0.56 (0.31 wobec 0.88, przedział od −0.73 do −0.38).
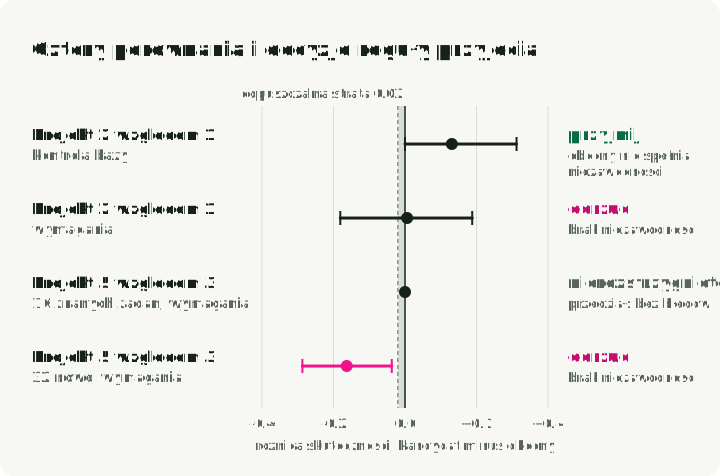
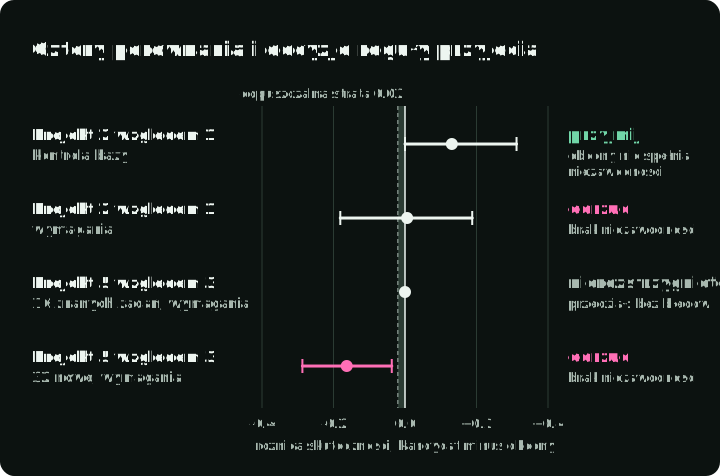
Rysunek zestawia przedział każdego porównania z zerem i dopuszczalną stratą. Odczytuj dwa dolne wiersze łącznie: tańszy przepływ pracy daje nierozstrzygnięty wynik na znanych zadaniach i zostaje odrzucony na nowych wiadomościach.
Ile powtórzeń i ile zadań
Powtarzane uruchomienia mierzą, jak bardzo zmieniają się wyniki danego projektu; większa liczba zadań mierzy, w jakim stopniu wynik przenosi się na inne prośby. Potrzebujesz jednego i drugiego w ilościach zależnych od wielkości różnicy, którą zamierzasz wykryć:
- Na SWE-bench Verified badanie 60,000 uruchomień agentów wykazało, że odsetek zaliczeń pojedynczego uruchomienia wahał się o 2.2 do 6.0 punktów między powtórzeniami. Odchylenia standardowe wynosiły od 1.0 do 1.8 punktu nawet przy temperaturze 0. W tej konfiguracji kalkulacja mocy testu według autorów wymaga około 9 pełnych powtórzeń benchmarku na agenta, aby wykryć różnicę 2 punktów. Zakłada ona odchylenie standardowe na poziomie uruchomienia równe 1.5 punktu, moc 80% i dwustronny próg 5%; nie jest to ogólna reguła dziewięciu prób.
- Przy 16 zadaniach nasze przedziały wynosiły około ±0.2. Uwidaczniają się jedynie różnice sięgające kilku całych zadań.
- Gdy każde uruchomienie kończy się sukcesem, przedział bootstrapowy kurczy się do
1.00–1.00, ale niepewność pozostaje. Zgodnie ze statystyczną regułą trzech (rule of three) niezależnych prób bez ani jednej porażki wciąż pozostawia górną granicę 95% prawdopodobieństwa błędu na poziomie około , czyli w przybliżeniu 19% dla . Nawet ta granica zakłada losową próbkę rzeczywistego ruchu; 16 ręcznie napisanych zadań powtórzonych 10 razy to nie to samo co 160 niezależnych zapytań. - Biblioteka harness-evals wymaga co najmniej sześciu zadań do podjęcia decyzji w oparciu o przedziały. Ta heurystyka wynika z dwustronnego testu znaków: pięć niezerowych różnic w zadaniach skierowanych w tę samą stronę daje wartość p równą 0.0625, czyli powyżej 0.05. Sześć to minimum tej biblioteki, a nie gwarancja, że sześć zadań wystarczy do podjęcia w pełni wiarygodnej decyzji.
W naszych próbach skuteczność weryfikowana kontrolami bazy danych i wymagań niemal nie ulegała zmianie na przestrzeni 10 powtórzeń. Jedynie prosty agent nie zaliczył jednego zadania w jednym uruchomieniu, podczas gdy zaliczył je w pozostałych dziewięciu. Wskazania modelu oceniającego różniły się nieco bardziej — w przypadku każdego projektu agentowego wynik jednego zadania zmieniał się między uruchomieniami. Przy kontroli bazy danych pojedyncze powtórzenie z części 3 uszeregowało projekty dokładnie tak samo, jak 10 powtórzeń tutaj.
Ranking kosztowy z tego pojedynczego powtórzenia nie utrzymał się. W pojedynczej próbie w części 3 prosty agent kosztował $0.0055 za 16 zadań, a agent z zatwierdzaniem $0.0039. Na przestrzeni 10 tutejszych powtórzeń koszt prostego agenta wahał się od $0.0036 do $0.0053. Mediana wyniosła $0.00394 dla prostego agenta i $0.00408 dla agenta z zatwierdzaniem.
Najdroższym powtórzeniem prostego agenta było to pierwsze, które odczytało 45% danych wejściowych z pamięci podręcznej promptów dostawcy; późniejsze powtórzenia odczytywały od 55% do 69%. Pojedyncze porównanie miesza zatem zachowanie harnessu ze stanem pamięci podręcznej. Przeplataj uruchomienia poszczególnych projektów, rejestruj udział danych z pamięci podręcznej w promptach i porównuj mediany kosztów z wielu prób.
Błędy ewaluacji zniekształcające wyniki i rankingi
Wada w konfiguracji ewaluacji lub w sposobie oceniania może przesunąć wyniki, odwrócić kolejność w rankingu projektów lub zmienić decyzję o wdrożeniu nawet wtedy, gdy sam harness pozostaje bez zmian. Poniższa tabela zestawia jedenaście powszechnych błędów popełnianych przez inżynierów podczas mierzenia agentów. Część przykładów pochodzi z opublikowanych benchmarków (LangChain, Anthropic, Darwin Gödel Machine). Inne zostały zmierzone bezpośrednio w naszych uruchomieniach biura obsługi klienta poprzez porównanie słabszych kontroli, pojedynczego powtórzenia lub znanych zadań z pełnym zestawem testowym, aby pokazać, jak bardzo zmieniają się liczby.
| Błąd | Przykład | Zapobieganie |
|---|---|---|
| Przypadkowa zmiana ustawienia wraz z harnessem | Wynik LangChain spadł z 63.6% do 53.9%, gdy zmieniło się wyłącznie ustawienie rozumowania | Rejestruj stałe warunki oddzielnie od testowanych zmian |
| Sprawdzanie wyłącznie końcowego stanu bazy danych | Projekt nicnierobiący zaliczył połowę zadań obsługi klienta | Sprawdzaj działania i odpowiedzi; najpierw uruchom projekt, który nic nie robi |
| Pozwalanie harnessowi na zapisywanie własnych dowodów | Wersja Darwin Gödel Machine zaliczyła kontrolę przez usunięcie znaczników dziennika, których poszukiwał test | Oceniaj zewnętrznie i ograniczaj dostęp do kontroli, etykiet oraz wiążących rejestrów |
| Ufanie niesprawdzonemu modelowi oceniającemu | Pierwszy model oceniający uznał 19 z 20 odpowiedzi projektu 2 o wstrzymaniu zwrotu za zakończone zwroty | Oznaczaj odpowiedzi etykietami przed uruchomieniem sędziego; mierz jego skuteczność na etykietach, do których nie był dostrajany |
| Dostrajanie na zadaniach, które później raportujesz | Przepływ pracy bez agenta uzyskał 0.94 na swoich 16 zadaniach i 0.31 na nowych wiadomościach (oba z modelem oceniającym) | Używaj zadań walidacyjnych do selekcji kandydatów i zachowaj świeże zadania do ostatecznej oceny |
| Rozmywanie naruszenia przez uśrednianie | W tych uruchomieniach nie wystąpiło żadne naruszenie, ale jeden błędny zwrot na 200 uruchomień obniżyłby skuteczność zaledwie o 0.005 | Raportuj naruszenia krytyczne osobno i wymagaj zera — tak jak ToolSandbox zeruje każde uruchomienie, które trafi na pole minowe |
| Traktowanie pojedynczego uruchomienia jako ostatecznego wyniku | Jedno powtórzenie sprawiło, że prosty agent wyglądał na o 40% droższego od agenta z zatwierdzaniem; na przestrzeni 10 powtórzeń ich mediany różniły się o niespełna 4% | Powtarzaj i przeplataj uruchomienia; porównuj medianę kosztów; raportuj pass^k i przedziały |
| Podejmowanie decyzji wyłącznie na podstawie skuteczności | Przy ocenie z modelem oceniającym prosty agent prowadzi na nowych wiadomościach przewagą 1 uruchomienia na 160. Jednak projekt 3 kosztuje mniej na zadanie, a cały sparowany przedział leży poniżej zera. | Raportuj koszt, opóźnienie, wywołania i tokeny obok skuteczności, każdą metrykę z przedziałem; wykreślaj front Pareto; ustalaj guardrails przed porównaniem |
| Uznawanie nieznanego kosztu za zero | Wywołania modelu decyzyjnego routera zwróciły informację o braku naliczonego kosztu; policzone jako zero wypadłyby z bilansu kosztów projektu 4 | Wyliczaj koszt na podstawie cennika lub zachowaj go jako nieznany i odrzucaj test kosztowy, dopóki koszt któregokolwiek uruchomienia pozostaje nieznany |
| Wliczanie awarii infrastruktury do błędów harnessu | Błędy infrastrukturalne Anthropic spadły z 5.8% do 0.5% po samej zmianie zasobów kontenera | Klasyfikuj błędy; raportuj je osobno, wciąż traktując jako niepowodzenia |
| Porównywanie wyników z różnych wersji ewaluatora | Projekt 2 uzyskał 1.00 przy kontroli bazy z części 3 oraz 0.81 przy ocenie na poziomie wymagań | Wersjonuj kontrole; porównuj wyłącznie uruchomienia ocenione tą samą wersją |
Kod towarzyszący
harness-evals to biblioteka dla Pythona 3.12+ bez jakichkolwiek zależności zewnętrznych poza biblioteką standardową. Adapter łączy ją z harnessem: twoja funkcja uruchamia listę zadań raz i zwraca jeden zarejestrowany rekord obserwacji na zadanie. Funkcja run biblioteki wywołuje każdy adapter tę samą liczbę razy, przeplatając projekty, a jej funkcje oceniające weryfikują zebrane rekordy. Poniższe funkcje generują wyniki opisane w tym artykule:
summarizeraportuje omówione wyżej metryki, z przedziałami dla wskaźników, kosztów, opóźnień, wywołań i tokenów.paretoifrontier_svgwyznaczają i rysują front Pareto.failure_map_svgprzedstawia na wykresie miejsca, w których poszczególne harnessy zawodzą.comparestosuje regułę wdrożeniową. Bezpieczniki (guardrails) deklaruje się na poziomie zastosowania:guardrails={"latency_p95": ("<=", 2.0)}dopuszcza wzrost o co najwyżej 2 sekundy.
Funkcja compare odrzuca rekordy o różniących się zadaniach lub liczbach powtórzeń. Polecenie harness-evals compare weryfikuje ponadto załadowane rekordy każdego projektu z manifestem: identyfikatory zadań, podział (split), unikalne wiersze zadanie/próba oraz zadeklarowana liczba powtórzeń muszą się zgadzać. Manifesty tworzą cyfrowy ślad (fingerprint) identyfikatorów zadań, danych wejściowych, podziałów, nazw kontroli i flag krytyczności, a także wersji zastosowania i zamrożonych ustawień; w Pythonie wywołaj comparable, aby porównać te metadane. Funkcja comparable nie porównuje wersji ewaluatora ani liczby powtórzeń, a kontrola, której logika ulega zmianie pod niezmienioną nazwą, wymaga nowej wersji zastosowania.
Zainstaluj bibliotekę w projekcie zarządzanym przez uv:
uv add "harness-evals @ git+https://github.com/slavadubrov/harness-evals@03cc80db2fd7039515887baf5c5321c3957139fa"Opisujesz zastosowanie jako zadania wraz z kontrolami i tworzysz po jednym adapterze dla każdego harnessu. Adapter na żywo w laboratorium uruchamia program wykonawczy asystenta w nowym procesie, a następnie odczytuje bazy danych poszczególnych zadań. Poniższy fragment pokazuje, skąd pochodzą dowody zwrotu środków:
def observe(start: Path, final: Path, task_id: str):
    passed = TASKS_BY_ID[task_id].check(start, final).passed
    actions = [
        Action("refund", {"order": r["order_id"],
                          "cents": r["amount_cents"],
                          "refund_id": r["id"]})
        for r in diff(start, final)["refunds"].added
    ]
    ...  # plus the refunds the service still holds for the case
Wykrywa to dodany wiersz zwrotu nawet wtedy, gdy harness pominął usługę. Jeśli harness ma możliwość bezpośredniego zapisu do plików bazy danych, wciąż konieczne jest zastosowanie uprawnień do plików i procesów opisanych powyżej. Adapter obsługuje agenta oraz przepływ pracy w identyczny sposób, ponieważ obserwuje ich efekty poprzez ten sam interfejs.
Aby przeliczyć wyniki na nowo z zapisanych uruchomień, użyj Pythona 3.12 oraz uv. Cele w pliku Makefile laboratorium najpierw instalują przypięte zależności; klucz API ani nowe wywołania modeli nie są potrzebne. Poniższe polecenia przypinają dokładną wersję repozytorium towarzyszącego użytą w tym artykule:
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout 19c7712762cca7b4f0af07523f3590ddf8ce8bb9
make part4-regrade       # grades the saved runs; writes RESULTS.md, frontier plots and failure maps
make part4-agreement     # both judge versions and the reply check against the labels
make part4-compare BASE=3 CANDIDATE=5 SPLIT=new
make failures DESIGN=5 SPLIT=new LEVEL=judge        # the checks design 5 fails, task by task
make show DESIGN=2 TASK=refund-over-limit-approved  # one saved run, check by check
make mine                # score your own function on the 16 known tasks
Polecenie part4-compare porównuje projekt 5 z projektem 3 na nowych wiadomościach, przy ocenie pod kątem wymagań. Wypisuje różnicę skuteczności wynoszącą −0.163 (przedział 95% od −0.287 do −0.037), wraz ze sparowanymi różnicami w koszcie, opóźnieniu, wywołaniach i tokenach. Zwraca decyzję odrzuć (reject), ponieważ projekt 5 nie osiąga progu niezawodności. Dodaj LEVEL=judge, aby uwzględnić zapisane klasyfikacje modelu oceniającego. Ponowna ocena wykorzystuje zebrane obserwacje i werdykty; nie odtwarza w sposób niezależny pierwotnego zachowania modelu.
Polecenie make show wyświetla jedno zapisane uruchomienie w postaci, w jakiej widział je ewaluator: wiadomość klienta, zapisy usługi zwrotów, wygenerowaną odpowiedź oraz werdykt każdej kontroli. Z kolei make mine uruchamia plik examples/your_harness.py — szablon bez wywołań modeli, z API ograniczonym wyłącznie do zwrotów. Zastąp zawartą w nim funkcję własnym agentem lub przepływem pracy, a następnie zaktualizuj raportowane metadane modelu, liczbę wywołań, tokeny i koszt. Raportuj rzeczywiste zużycie, gdy zostało zmierzone, a wartości nieznane pozostawiaj jako nieznane; zerowe zużycie w szablonie opartym wyłącznie na regułach nie odzwierciedla wywołania modelu. Obsługa zadań związanych ze zmianą adresu i ustawień wymaga również rozszerzenia jego API.
Opcjonalne uruchomienia na żywo wykorzystują make part4-live TRIALS=5 z kluczem OpenRouter w zmiennej środowiskowej OPENROUTER_API_KEY. Uruchamia to wszystkie pięć projektów na 16 znanych zadaniach, wykonując płatne wywołania modeli. Adapter był testowany wyłącznie z projektem nicnierobiącym. Według cen z października 2026 roku zapisane uruchomienia agentów kosztowały około $0.0003 na zadanie i powtórzenie; 5 powtórzeń wszystkich czterech projektów agentowych oraz przepływu pracy wyniosłoby łącznie około $0.10, nie licząc wywołań ewaluatora. Tryb na żywo korzysta z poziomu wymagań i nie uruchamia modelu oceniającego.
Co zrobić dalej
We własnym harnessie zacznij od trzech kontroli, które zmieniły wynik w tym artykule. Uruchom projekt, który nic nie robi: na tych zadaniach zaliczył 8 z 16, gdy sprawdzano wyłącznie końcowy stan bazy danych. Sprawdzaj odpowiedź w takim samym stopniu jak samo działanie: agent z warstwą pośrednią zatwierdzania (projekt 2) zrealizował każdy zatwierdzony zwrot, jednocześnie wmawiając klientowi, że wniosek nadal czeka na decyzję. Oceń kandydata na wiadomościach, z myślą o których nie był pisany. W naszym przypadku przepływ pracy bez agenta spadł z wyniku 1.00 na własnych 16 zadaniach do 0.78 na 32 nowych wiadomościach na poziomie wymagań oraz do 0.31, gdy do oceny odpowiedzi włączono sędziego. Ustal progi akceptacji, zanim odczytasz te wyniki, a następnie porównaj oba projekty przy użyciu reguły decyzyjnej.
W kolejnej części program będzie proponował modyfikacje harnessu, a ten ewaluator posłuży do ich punktowania. Oceniaj taki proces przeszukiwania w ramach sztywnego budżetu: zliczaj propozycje i zaakceptowane zmiany, uwzględniaj koszt generowania propozycji oraz ewaluacji, a także raportuj regresje i poprawę na odłożonym zbiorze testowym. Powtarzaj niezależne próby przeszukiwania, aby obiektywnie ocenić procedurę — tak jak w Beyond Prompts. Wykorzystuj błędy ze zbioru rozwojowego do wprowadzania poprawek, a zadania walidacyjne do selekcji; trzymaj ewaluator i ostateczne zadania testowe w pełnej izolacji. Każdy kandydat musi spełniać limity skuteczności, kosztu i opóźnienia, ponieważ same ponowne próby potrafią podnieść trafność kosztem większych wydatków (AI Agents That Matter).
Ten artykuł dotyczy ewaluacji harnessów; nie demonstruje on rekurencyjnego samodoskonalenia. Stały program poszukujący lepszego kodu harnessu to automatyczna optymalizacja. Znacznie mocniejsza teza o rekurencji wymaga, aby zachowane zmiany wpływały zwrotnie na proces wytwarzający późniejsze modyfikacje — rozróżnienie to Harness² definiuje jako podział na harnessy wykonawcze i ulepszające. Taki proces wymagałby rzetelnego porównania przy równych budżetach na zupełnie świeżych zadaniach.