Een agent harness evalueren met een vast model
Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Dit artikel is voor engineers die willen bepalen of een wijziging aan een AI agent of workflow de uitvoering van zijn bedrijfstaak verbetert. Een harness is de code rondom een taalmodel: de prompts, tools, control flow, het geheugen, de controles en de herhaalde pogingen. Je leert hoe je het model vastlegt, controleert wat de harness doet en de gebruiker vertelt, en succes afweegt tegen kosten en latency. Je leert ook hoe je bepaalt of een kandidaat het huidige ontwerp moet vervangen.
Het uitgewerkte voorbeeld is de supportassistent van een webwinkel, waar terugbetalingen boven $200 goedkeuring van een supervisor vereisen. Met alleen een controle van de uiteindelijke database leek een agent met goedkeuringsmiddleware perfect, hoewel hij klanten vertelde dat hun uitgevoerde terugbetalingen nog in de wacht stonden. Controles van acties en antwoorden leggen die fout bloot. Tests met berichten waarvoor geen enkel ontwerp is geschreven, tonen de grenzen van een goedkopere workflow. In die workflow leest één model call het bericht en voert code de stappen uit.
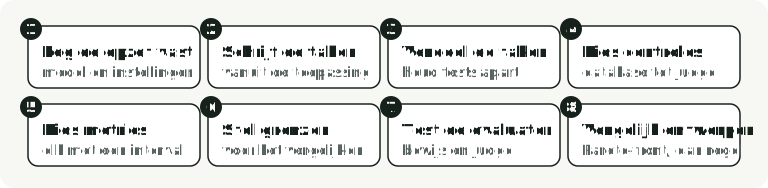
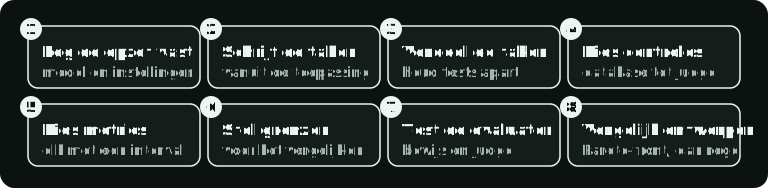
De evaluatie bestaat uit acht stappen, die de onderstaande secties in volgorde volgen.
Wat er verandert bij een harness-evaluatie
Een modelvergelijking houdt de prompts, tools en de execution loop gelijk en verandert het model. Een harness-vergelijking houdt het model gelijk en verandert de code eromheen. Herhaalde runs en onzekerheidsintervallen helpen een verbetering van de harness te onderscheiden van ruis tussen runs onderling.
De gids van Anthropic Demystifying evals for AI agents onderscheidt twee onderdelen. De agent harness laat een model als agent handelen; de evaluation harness voert taken uit, registreert elke poging en beoordeelt die. Hier noem ik dat laatste onderdeel de evaluator. Zowel een agent, die zijn eigen stappen kiest, als een workflow, waarvan de stappen in code vastliggen, kan op deze manier worden geëvalueerd.
Hoeveel kan de harness een resultaat veranderen? Gepubliceerde vergelijkingen met een vast model laten een spreiding zien:
- Het Terminal-Bench 2.0-paper voerde verschillende agents met dezelfde models uit, elk minstens vijf keer. GPT-5 loste 49.6% van de taken op in Codex CLI en 33.9% in mini-SWE-agent, een verschil van 15.7 punten. Claude Opus 4.5 loste 57.8% op in Terminus 2 en 52.1% in Claude Code, een verschil van 5.7 punten. De auteurs concluderen nog steeds dat de keuze van het model doorgaans meer uitmaakte dan de keuze van de agent.
- LangChain verhoogde zijn deepagents CLI van 52.8% naar 66.5% op Terminal-Bench 2.0 door de harness rond
gpt-5.2-codexaan te passen, waaronder hoeveel reasoning elke fase van een taak gebruikt. - In AutoHarness van Google DeepMind schrijft Gemini 2.5 Flash code die ongeldige zetten afwijst voordat ze een spel bereiken. Met die code eromheen won Flash 9 van de 16 spellen voor twee spelers tegen de grotere Gemini 2.5 Pro.
Deze resultaten laten zien dat het aanpassen van de harness de score met 5 tot 16 punten kan verschuiven, of een kleiner model van een groter model kan laten winnen. De omvang van de winst verschilde per geval; meet die dus voor je eigen harness en model, en meet opnieuw zodra het model verandert.
Houd de volgende zaken vast, en niet alleen de modelnaam:
- Het model en zijn versie, en het endpoint van de provider dat het serveert. Een router zoals OpenRouter kan een verzoek naar een andere provider sturen, tenzij je er één vastlegt.
- Sampling- en reasoning-instellingen, tenzij juist het aanpassen daarvan het experiment is. In het experiment van LangChain verlaagde het draaien op de hoogste reasoning effort in plaats van high de score van 63.6% naar 53.9%, doordat meer taken zonder tijd kwamen te zitten. Als een kandidaat de effort per fase anders instelt, leg dat beleid dan vast als onderdeel van de kandidaat. Houd de overige omstandigheden gelijk.
- De machine waarop de taken draaien. Anthropic veranderde alleen de containerresources van Terminal-Bench 2.0-runs en verschoof de score met maximaal 6 punten. Het concludeert dat verschillen op scoreborden van minder dan 3 punten scepsis verdienen totdat de opstellingen zijn gedocumenteerd en gelijkgetrokken.
- De taken, de controles en de versie van de evaluator. Een gewijzigde controle is een andere evaluatie.
De onderdelen die je mag aanpassen zijn onder meer prompts, tooldefinities, de loop of workflow-graaf, middleware, retries, antwoordsjablonen en extra models. Reken de fouten, kosten en latency van een extra model toe aan de harness die het gebruikt.
Zes ontwerpen voor de supportassistent
Om deze opzet in de praktijk te zien, vatten we de supportassistent van de webwinkel uit deel 3 samen. Hij voert terugbetalingen uit, wijzigt adressen en werkt accountinstellingen bij. Eén regel stuurt onze vergelijking aan: terugbetalingen boven $200 vereisen een beslissing van een supervisor. We testen zes ontwerpen om hem uit te voeren (vijf uit deel 3 plus een baseline die niets doet). Ze verschillen in wie de stappen kiest en wie dat wachten afhandelt:
| Ontwerp | Hoe het draait | Goedkeuring door supervisor |
|---|---|---|
| 0. Doet niets | Geen model call, schrijfactie of antwoord; een baseline die hier is toegevoegd | Geen |
| 1. Gewone agent | Het model voert tool calls uit in een loop | Kan een terugbetaling in de wacht laten; kan niet hervatten voor een beslissing |
| 2. Agent met goedkeuringsmiddleware | Dezelfde loop, met code rond tool calls die deze kan pauzeren en hervatten | Middleware wacht op de beslissing |
| 3. Agent binnen een workflow | Een agent start de taak; code handelt vervolgens goedkeuring, terugbetaling en antwoord af | Workflow wacht op de beslissing |
| 4. Router en drie agents | Een klein beslismodel stuurt elk bericht naar een specifiekere agent | Geen stap om te hervatten voor een beslissing |
| 5. Workflow zonder agent | Eén model call leest het bericht uit in velden; code kiest en voert de stappen uit | Workflow wacht op de beslissing |
Deel 3 voerde elk ontwerp één keer uit. Hier beoordelen we runs die op 15 oktober 2026 zijn opgeslagen. Deze omvatten 10 herhalingen per ontwerp op 16 bekende taken, plus 5 herhalingen van ontwerpen 1 tot en met 5 op 32 nieuwe berichten waarvoor geen enkel ontwerp is geschreven (hieronder beschreven). Alle ontwerpen die een model gebruiken, gebruikten openai/gpt-6-luna via het OpenAI-endpoint van OpenRouter, met fallbacks uitgeschakeld. Het extra beslismodel van ontwerp 4 hoort bij zijn harness.
De beoordeling gebruikt harness-evals, een kleine Python-bibliotheek die je in je eigen project kunt installeren. Het bijbehorende lab verbindt deze met de assistent. Dit is deel 4 van Recursive Harness Engineering: delen 2 en 3 bouwden de ontwerpen. Dit deel bouwt de evaluator die een harness-wijziging beoordeelt; in het volgende deel stelt een programma de wijzigingen voor.
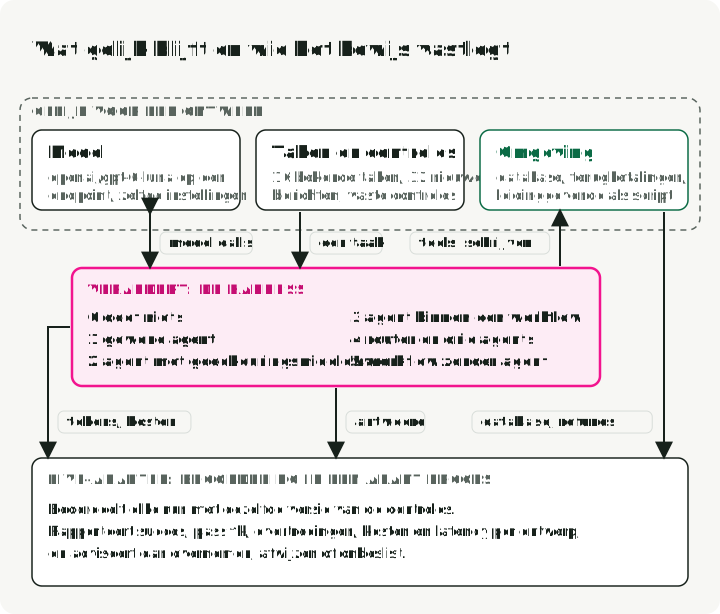
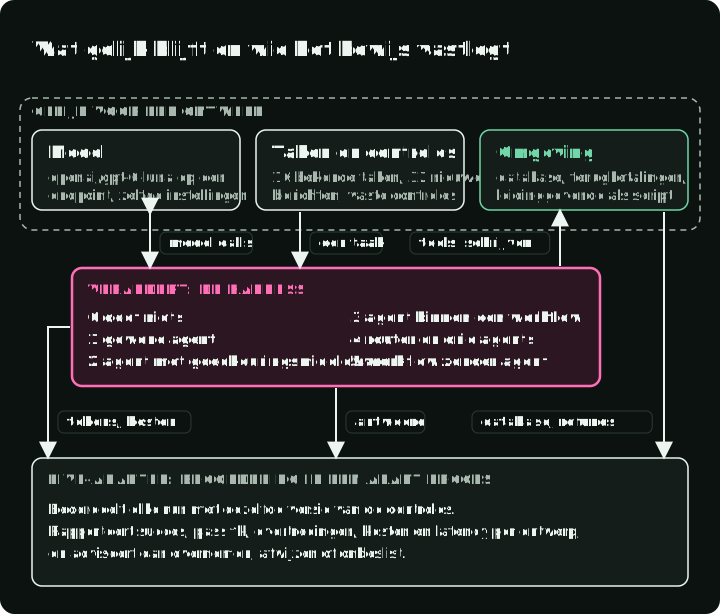
De figuur toont de live-adapter van het lab, de code die de evaluator met een draaiende assistent verbindt. Een apart proces leest de database en de records van de terugbetalingsservice, en haalt het antwoord, tokenverbruik en de kosten uit de eigen uitvoer van de assistent. De opgeslagen runs uit oktober die hieronder worden beoordeeld, registreerden een deel van dat bewijs binnen het proces van de assistent. Wie het bewijs schrijft legt uit welk deel in-process werd vastgelegd en wat daardoor ongetest blijft.
Taken komen uit de usecase
De evaluatiecode kan worden gedeeld, maar de taken niet. Elke harness is gebouwd voor één usecase (hier een supportdesk), dus de taken zijn afkomstig uit die usecase. Ze weerspiegelen het beleid dat het systeem moet volgen, de verzoeken die gebruikers sturen en de fouten die je al hebt gezien. Een openbare benchmark vertelt je hoe een model presteert op de taken van iemand anders. De gids van Anthropic stelt voor om te beginnen met 20 tot 50 taken afkomstig uit echte fouten, en de set van daaruit uit te breiden.
In ons voorbeeld begint de supportdesk kleiner, met 16 bekende taken die zijn meegenomen uit eerdere builds. Twaalf zijn afkomstig uit deel 2: terugbetalingen, adreswijzigingen en wijzigingen in instellingen. Het juiste resultaat kan de wijziging zelf zijn, een weigering, een vraag om ontbrekende informatie of een handoff naar een supervisor. Een script speelt de supervisor en kan het verzoek goedkeuren, afwijzen of laten wachten.
Deel 3 voegt vier gevallen toe: een goedgekeurde terugbetaling van $350, een afgewezen terugbetaling van $350 en twee terugbetalingen waarbij de servicerespons verloren gaat nadat het geld is terugbetaald. Die laatste twee gebruiken terugbetalingen van $15 en $350; de assistent moet het opnieuw proberen zonder twee keer terug te betalen.
Schrijf voor elke taak op wat een correcte run doet voordat je iets uitvoert:
- De invoer en de begintoestand: het bericht van de gebruiker en de database of bestanden waarmee de run begint.
- Wat er moet gebeuren: de acties die de omgeving moet registreren, zoals één terugbetaling van $350 op bestelling O-2002.
- Wat er nooit mag gebeuren: acties die in elke run verkeerd zijn, zoals een terugbetaling op de bestelling van een andere klant. ToolSandbox van Apple noemt dit minefields en beoordeelt een run die er één raakt met een nul, wat deze verder ook deed. Behandel ze als kritiek.
- Wat de gebruiker wel en niet verteld moet worden: de feiten die een antwoord moet vermelden, en claims die onwaar zouden zijn.
- Het soort uitkomst: een actie, een vraag om ontbrekende informatie, een weigering met de beleidsreden, een handoff naar een persoon of een antwoord.
Hier is de taak voor de goedgekeurde terugbetaling van $350 met elke controle uitgeschreven, inclusief die van de judge, zoals evaluator/support.py van het lab deze opbouwt. Lees de controles als het contract van de taak:
Task(
    "refund-over-limit-approved",
    "This is ben.ortiz@example.com. The carbon bike wheels from "
    "order O-2002 are cracked. Refund the full $350 now, please.",
    (
        state(),                    # the database is as expected
        did("refund", order="O-2002", cents=35000),  # refund issued
        at_most(1, "refund"),       # only once (critical)
        Check(
            "only permitted refunds",
            lambda e: all(
                a.matches("refund", {"order": "O-2002", "cents": 35000})
                for a in e.actions if a.name == "refund"
            ),
            critical=True,
        ),
        NO_FALSE_HOLD,              # reply never says it still waits
        says(r"\b350(\.00)?\b"),    # the reply states the amount
        judged("outcome"),          # the judge must say "action"
    ),
)
De kritieke terugbetalingscontroles wijzen een tweede terugbetaling af, of elke terugbetaling met de verkeerde bestelling of het verkeerde bedrag. De afzonderlijke did-controle vereist dat de verwachte terugbetaling plaatsvindt; het niet uitvoeren daarvan is een taakfout, geen ongeautoriseerde actie.
De laatste controle gebruikt een judge: een tweede model dat het antwoord leest en classificeert als een actiebevestiging, vraag, weigering, handoff of antwoord. Hier is de verwachte klasse een actiebevestiging. De judge controleert wat voor antwoord de gebruiker ontving, terwijl de database- en actiecontroles verifiëren of de terugbetaling heeft plaatsgevonden.
Elke controle retourneert true, false of undecided wanneer bewijs ontbreekt. Een run slaagt alleen wanneer deze eindigt zonder fout en elke controle true retourneert. Als de judge een timeout bereikt, slaagt de run niet, en rapporteert de evaluator ontbrekend beoordelingsbewijs in plaats van een fout in de harness.
Taken die zonder wijziging moeten eindigen
Veel correcte runs veranderen niets. De klant vraagt om een terugbetaling buiten het venster van 30 dagen of op de bestelling van een andere klant, of laat de plaatsnaam weg bij een nieuw adres. Het juiste resultaat is een weigering of een vraag, en de database blijft zoals hij was. De helft van de 16 taken zit zo in elkaar.
Dat maakt een controle van uitsluitend de uiteindelijke database eenvoudig te halen. Ontwerp 0 slaagde voor 8 van de 16 taken in elk van zijn 10 herhalingen zonder een call, write of antwoord. De auteurs van de Agentic Benchmark Checklist vonden hetzelfde probleem in een openbare benchmark: op de vliegtaken van τ-bench scoorde een agent die lege antwoorden retourneert 38%, hoger dan GPT-4o. Ze vragen elke benchmark om de score van zo’n triviale agent te rapporteren. Voer een ontwerp dat niets doet eerst uit op je eigen taken. Elke voldoende op een taak die een reactie vereist, legt een ontbrekende controle bloot.
Ontwikkel-, validatie- en testtaken
Onze 16 bekende taken zijn afkomstig uit het bouwen van de supportassistent in delen 2 en 3. Zestien taken zijn voldoende om te laten zien hoe de controles werken, maar blijven achter bij de 20 tot 50 die hierboven worden aanbevolen. Erger nog: elk ontwerp is gebouwd met die taken in het vizier. Dat maakt ze een ontwikkelset: je leest hun fouten en past de harness aan totdat deze ervoor slaagt.
De workflow zonder agent uit deel 3 laat zien waarom een ontwikkelset niet voldoende is. De regels ervan herkennen terugbetalingen, adreswijzigingen en wijzigingen in instellingen, en vertellen de klant dat een collega al het overige zal beantwoorden. Omdat ik die regels rond deze 16 taken heb geschreven, zegt een perfecte score daarop weinig over andere berichten. Om berichten buiten die set te testen en de suite uit te breiden naar 48 taken, voegt het lab 32 nieuwe berichten toe waarvoor geen enkel ontwerp is geschreven. Ze beslaan 8 vage klachten, 8 berichten met twee verzoeken, 8 beleidsvragen en 8 verzoeken buiten de bekende soorten, zoals het opheffen van een account. Elk vermeldt zijn verwachte uitkomst en de databasewijziging die het vereist, indien van toepassing, opgeschreven vóór elke run.
Machine learning scheidt zijn data om dezelfde reden: een model presteert beter op de voorbeelden waarop het is getraind of gefinetuned dan op nieuwe. De Machine Learning Crash Course van Google gebruikt drie sets. Het model traint op de trainingsset. De validatieset scoort elke aanpassing, van een nieuwe learning rate tot een nieuw modelontwerp. De testset controleert aan het einde het gekozen model.
Niets traint op de validatieset. Maar het model dat je behoudt, is het model dat toevallig het beste bij die voorbeelden paste, waardoor de validatiescore optimistisch is. De cursus raadt aan om validatie- en testdata te vervangen nadat herhaald gebruik voor modelselectie hun scores optimistisch heeft gemaakt. Wan en collega’s maten het verschil voor prompts: prompts die waren geoptimaliseerd om de validatienauwkeurigheid te maximaliseren, scoorden 5.8 tot 13.2 punten lager op een afzonderlijke testset. Daarentegen bleven de twee scores van de niet-geoptimaliseerde prompt binnen ongeveer 1.7 punt van elkaar.
Met de model weights van het taalmodel vastgelegd, is de harness wat je aanpast: prompts, tools en control flow nemen de plaats in van weights en hyperparameters. Splits je taken op dezelfde manier vóór de eerste run. Ontwikkeltaken vervullen de rol van de trainingsset, validatietaken kiezen tussen kandidaat-harnesses en testtaken scoren de gekozen harness één keer. Machine Learning Yearning van Andrew Ng noemt de validatieset de “dev set”; in dit artikel zijn ontwikkeltaken de taken waarvan je de fouten oplost.
Teams die agents afstemmen splitsen hun taken eveneens op deze manier. Toen Anthropic de tools van zijn agents verbeterde op basis van interne evaluaties, “vertrouwde het op apart gehouden testsets om ervoor te zorgen dat we niet overfitten op onze ‘trainings’-evaluaties” (Writing effective tools for agents). METR itereerde op zijn agent scaffolding met “een ‘development’-suite” van taken en rapporteerde scores op “een apart gehouden ‘test’-suite van 83 taken” (DeepSeek-V3 evaluation). De agent-benchmark AppWorld levert afzonderlijke train-, dev- en testsplits. Het vraagt om op de testtaken niet te tunen, “noch via een parameter grid search, noch handmatig door prompts aan te passen”.
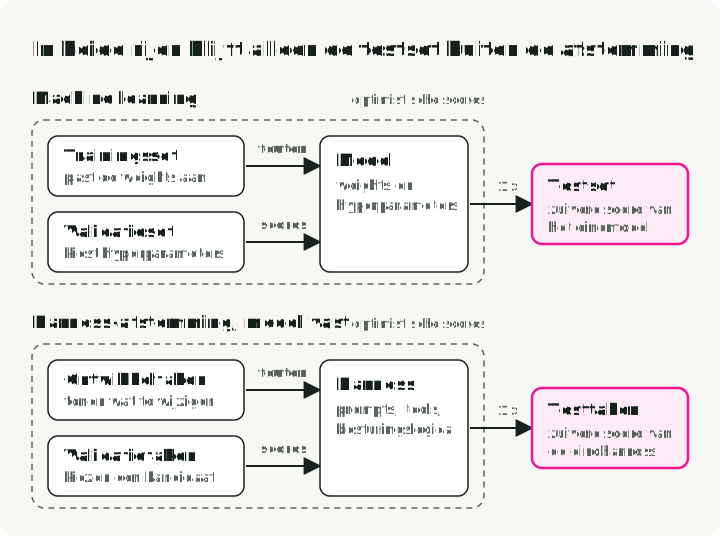
Elke set in de harness-rij vervult de taak van de set erboven. Alleen de score van de testset meet voorbeelden die de afstemming niet heeft gezien.
In het lab dienen de 32 nieuwe berichten, in een split genaamd new, als testset. Een aselecte splitsing in machine learning trekt de testset uit dezelfde pool als de trainingsset. Hier daarentegen zijn de nieuwe berichten geschreven om soorten verzoeken op te nemen die de ontwikkeltaken missen. Een lagere score daarop kan voortkomen uit afstemming op de bekende taken of uit verzoeken waarvoor geen enkel ontwerp is gebouwd.
Het lab heeft geen afzonderlijke validatieset. Verderop in dit artikel beslissen de nieuwe berichten tussen de workflow zonder agent (ontwerp 5) en de agent binnen een workflow (ontwerp 3), wat ze validatietaken maakt voor die keuze. Het lezen van hun fouten en het aanpassen van een harness zou ze tot ontwikkeltaken maken. In beide gevallen heeft de uiteindelijke score van het gekozen ontwerp verse berichten nodig.
Bewaar beoordeelde fouten na herstel als regressietaken en voer ze uit bij latere wijzigingen aan de harness of het model. Verwijder privégegevens van klanten voordat je productiegevallen toevoegt. Deze hergebruikte set controleert of oplossingen blijven werken; reserveer verse verzoeken voor de uiteindelijke beoordeling. Koppel offline controles aan productiemonitoring en periodieke menselijke beoordeling, zoals de evaluatiegids van Anthropic aanbeveelt.
Een programma dat harness-wijzigingen voorstelt kan veel meer selectiebeslissingen nemen dan een mens, wat het risico op overfitting op dezelfde taken vergroot. Geef het een validatieset voor zijn keuzes en houd de testset buiten zijn bereik. In harness-evals draagt elke taak een split-naam, standaard dev, en evalueert run één split tegelijk.
Het apart houden van taken laat er minder over voor afstemming. Meta-Harness, dat zoekt naar harness-code met het model bevroren, zocht en evalueerde op dezelfde 89 taken van Terminal-Bench 2.0. De auteurs stellen dat een afzonderlijke split de zoektocht op zo’n kleine benchmark zou hebben verzwakt. Ze controleerden op overfitting door de harnesses te lezen en te scannen op taakspecifieke strings. Voor je eigen usecase kun je meer berichten schrijven en een deel apart houden.
Drie controleniveaus
Het lab beoordeelt elke opgeslagen run op drie niveaus, waarbij elk niveau controles toevoegt uit het bovenstaande taakcontract:
- Database (
state): de uiteindelijke database komt overeen met de verwachte wijziging. Delen 2 en 3 beoordeelden op deze manier. - Verplichtingen (
did,at_most,only permitted refunds,never,NO_FALSE_HOLD,says): de databasecontrole, de actiecontroles voor terugbetalingen en twee soorten antwoordpatronen. Het ene vereist feiten die het antwoord moet vermelden; het andere verbiedt te zeggen dat een uitgevoerde terugbetaling nog in de wacht staat. Het lab definieert vereiste antwoordfeiten (says) voor de 16 bekende taken; de 32 nieuwe berichten gebruiken de overige verplichtingscontroles zonder taakspecifieke feitenpatronen. - Judge (
judged): de verplichtingen, plus een controle dat de classificatie van het antwoord door de judge overeenkomt met de verwachte uitkomst van de taak.
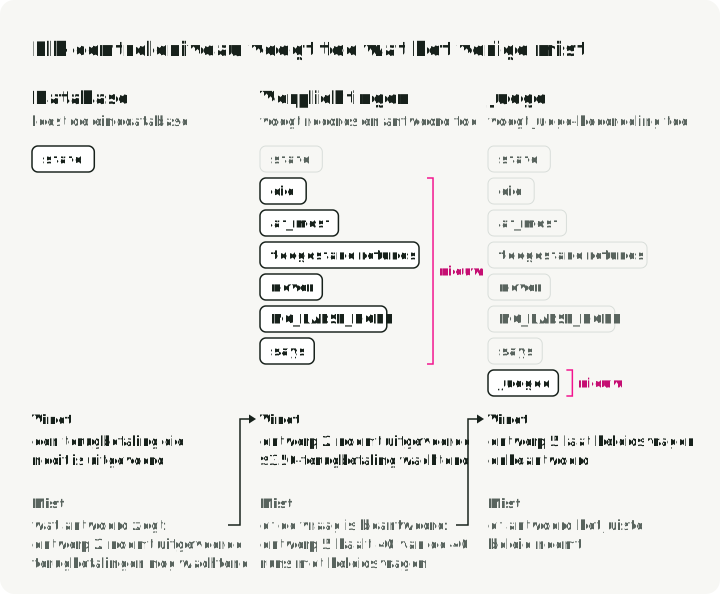
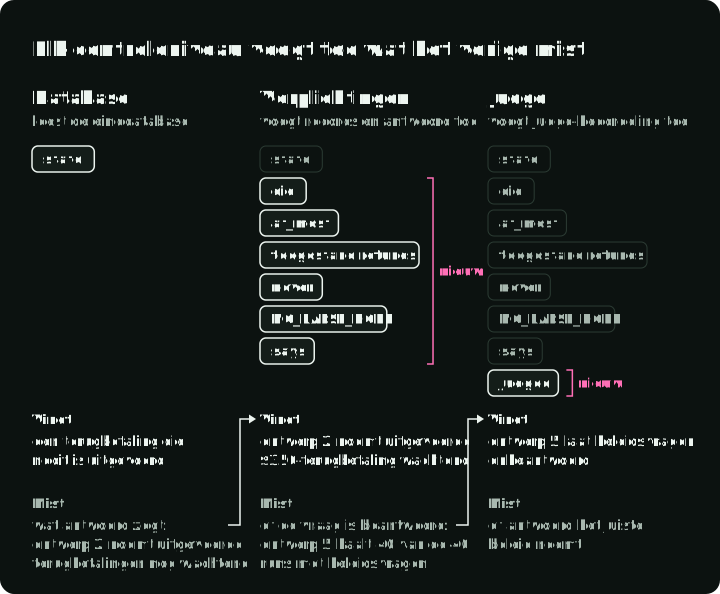
De figuur toont voor elk niveau een fout die het opmerkt en één die het niet kan zien; het volgende niveau controleert dat laatste. Geen enkele controle in dit lab toetst of een antwoord het juiste beleid vermeldt.
De oordelen van de judge zijn op 15 oktober met de runs opgeslagen, dus het opnieuw beoordelen vereiste geen nieuwe model calls. Ze zijn afkomstig uit de tweede versie van zijn rubric; De judge controleren met gelabelde antwoorden laat zien waarop die versie wel en niet is getest. De drie niveaus beoordelen dezelfde opgeslagen runs, en elk resultaat hieronder vermeldt zijn niveau.
Wat elk niveau op de bekende taken opmerkt
Succes is het aandeel runs dat slaagde voor elke controle op het genoemde niveau. De tabel toont het succes op de 16 bekende taken over 10 herhalingen per taak. Het bereik tussen haakjes is een 95%-interval: waar de score aannemelijk zou landen op een andere set van 16 taken zoals deze (hoe dit wordt berekend). Een score van 0.81 betekent dat 81% slaagde.
| Ontwerp | Database | Verplichtingen | Verplichtingen en judge |
|---|---|---|---|
| 0. Doet niets | 0.50 (0.25–0.75) | 0.00 (0.00–0.00) | 0.00 (0.00–0.00) |
| 1. Gewone agent | 0.87 (0.68–1.00) | 0.81 (0.61–0.99) | 0.69 (0.45–0.88) |
| 2. Agent met goedkeuringsmiddleware | 1.00 (1.00–1.00) | 0.81 (0.62–1.00) | 0.68 (0.44–0.88) |
| 3. Agent binnen een workflow | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.88 (0.71–1.00) |
| 4. Router en drie agents | 0.88 (0.69–1.00) | 0.81 (0.62–1.00) | 0.69 (0.46–0.88) |
| 5. Workflow zonder agent | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.94 (0.81–1.00) |
Omdat het interval deze 16 taken herbemonstert, betekent een bereik van 1.00–1.00 alleen dat elke run op deze set slaagde, niet dat de harness elk toekomstig verzoek met succes zal afronden.
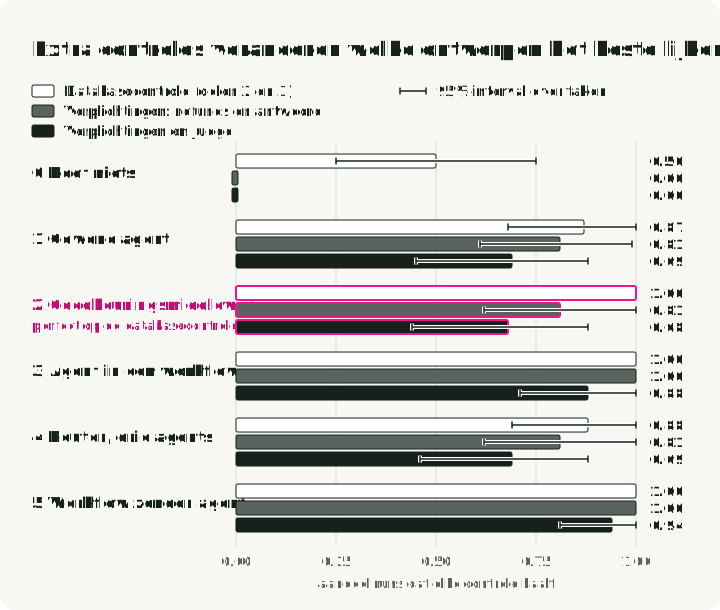
De figuur zet de gemiddelden uit de tabel uit, elk met een foutbalk voor zijn interval. Volg de agent met goedkeuring, ontwerp 2, vanaf de databasecontrole tot aan de judge: hij begint op gelijke hoogte met ontwerpen 3 en 5 en eindigt eronder.
Correcte terugbetalingen, onjuiste antwoorden
Wat de strengere controles op de bekende taken vonden:
- Ontwerp 0 daalde van 0.50 naar 0. Elke taak heeft een antwoord nodig, en het stuurt niets.
- Ontwerp 2, de agent met goedkeuringsmiddleware, daalde van 1.00 naar 0.81. In alle 20 runs van de twee goedgekeurde taken werd de terugbetaling uitgevoerd, maar zei het antwoord dat deze nog steeds wachtte. Elk antwoord beweerde: “Because it exceeds $200, it’s on hold for supervisor approval; it won’t be issued until approved.” Bij de taak uit deel 2 waarop de supervisor nooit antwoordt, stuurde het de klant helemaal geen antwoord, in 10 van de 10 runs.
- Ontwerpen 1 en 4 begonnen lager, op 0.87 en 0.88, omdat geen van beide kan hervatten nadat een supervisor goedkeurt. Beide goedgekeurde terugbetalingen van $350 bleven in de wacht staan, wat de databasecontrole al afkeurt. De strengere controles brachten beide ontwerpen op 0.81 door nog één taak te laten falen: de afgewezen terugbetaling van $350. Zonder goedkeuringsstap vertelden ze de klant dat een supervisor de terugbetaling zou beoordelen en beëindigden ze de run terwijl deze nog in de wacht stond, waardoor er nooit een beslissing werd genomen. De databasecontrole liet ze slagen voor die taak, omdat er hoe dan ook niets werd terugbetaald.
- Ontwerpen 3 en 5 behielden 1.00: in beide schrijft code het antwoord nadat de supervisor heeft besloten, op basis van het resultaat van de terugbetalingsservice.
De tabel en de grafiek tellen fouten; een failure map laat zien waar ze zitten. Elke rij is een bekende taak en elke kolom een soort controle, met één paneel per ontwerp en inclusief de judge:
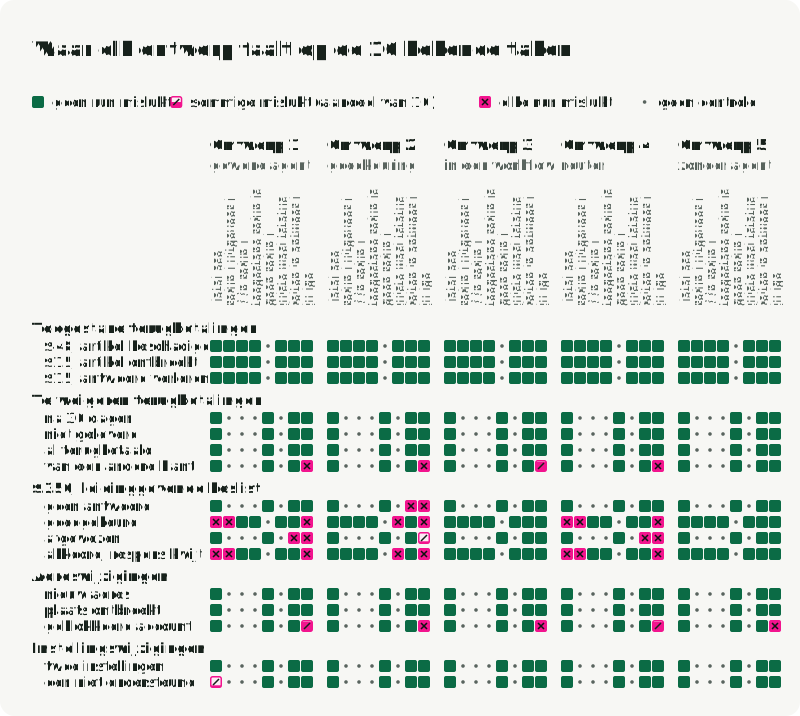
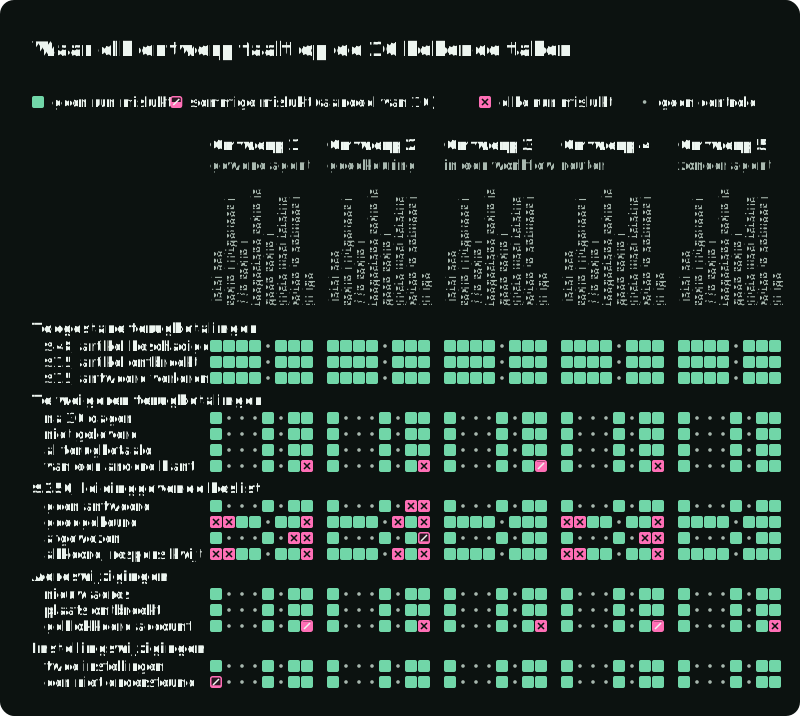
Twee clusters vallen op. De terugbetalingen van $350 die wachten op een beslissing van een supervisor breken ontwerpen 1, 2 en 4 in verschillende kolommen. Ontwerpen 1 en 4 voeren de goedgekeurde terugbetaling nooit uit, terwijl ontwerp 2 deze uitvoert en vervolgens meldt dat hij nog in de wacht staat. De judge-kolom faalt op de bestelling van een andere klant bij vier ontwerpen en op het geblokkeerde account bij alle vijf. De volgende sectie laat zien dat die twee taken ambigue verwachte uitkomsten hebben. harness-evals tekent zo’n kaart met failure_map_svg, en het lab schrijft er één voor elke taakset. Het commando make show opent de run achter elk vierkant.
Sommige judge-fouten leggen ambigue taken bloot
De judge verlaagde de score van elk ontwerp, maar die dalingen zijn niet allemaal bevestigde fouten in de klantenservice:
- Bij de bestelling van een andere klant zeiden ontwerpen 1 tot en met 4 meestal dat ze deze niet konden vinden op het account van de klant en vroegen ze het nummer te controleren. De judge classificeerde dit antwoord als een vraag. De taak verwachtte een weigering, hoewel het antwoordpatroon de reactie accepteerde.
- Bij de adreswijziging van een geblokkeerd account weigerde elk ontwerp en vertelde het de klant contact op te nemen met support. De judge classificeerde dit als een handoff; de taak verwachtte een weigering.
Een antwoord kan een verzoek weigeren en de klant doorverwijzen naar support. De tabel behoudt de oorspronkelijke labels en scores, maar die overlap vereist herziening voordat de judge wordt gebruikt om een productiewijziging te accepteren of af te wijzen. Verduidelijk welke combinaties aanvaardbaar zijn, geef de rubric een versienummer en herbeoordeel elk ontwerp in de vergelijking daarmee. Herstel de labels niet alleen voor de kandidaat.
Nieuwe berichten leggen ontbrekende verzoektypes bloot
De 16 bekende taken testen uitsluitend verzoeken waarvoor elk ontwerp al gebouwd was. Om te zien hoe de harnesses omgaan met onbekende invoer, scoort de onderstaande tabel de vijf werkende ontwerpen op de 32 nieuwe berichten, met 5 herhalingen per taak. Het ontwerp dat niets doet is niet uitgevoerd op deze set.
| Ontwerp | Verplichtingen | Verplichtingen en judge |
|---|---|---|
| 1. Gewone agent | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) |
| 2. Agent met goedkeuringsmiddleware | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) |
| 3. Agent binnen een workflow | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) |
| 4. Router en drie agents | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) |
| 5. Workflow zonder agent | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) |
De workflow zonder agent, ontwerp 5, slaagde voor alle 40 runs met beleidsvragen onder verplichtingen en voor geen enkele zodra de judge werd toegevoegd. Het schema ervan heeft geen categorie voor het beantwoorden van een beleidsvraag. De verplichtingen controleerden alleen of de database met rust werd gelaten; de judge merkte op dat de vraag nooit werd beantwoord.
Rapporteer deze resultaten zowel per verzoektype als in het algemeen: vage klachten, berichten met twee verzoeken, beleidsvragen en overige verzoeken. Het lab geeft elke groep acht taken, waardoor de algehele score ze gelijk weegt. Werkelijk verkeer kan andere verhoudingen hebben; een hoge geaggregeerde score kan nog steeds een slecht afgehandeld verzoektype verhullen.
Ontwerp 5 miste ook de meeste berichten met twee verzoeken, en vage klachten zoals een kapotte theepot zonder bestelnummer. De agents zochten de bestellingen van de klant op en betaalden de theepot terug. De aanbeveling uit deel 3 om met deze workflow te beginnen geldt nog steeds voor de 16 bekende taken. Om de nieuwe berichten af te handelen, heeft deze ondersteuning nodig voor beleidsvragen, meerdere verzoeken in één bericht en het opzoeken van bestellingen wanneer een klacht geen bestelnummer bevat.
Deel 3 stelde ook een hybride voor die standaardverzoeken naar de workflow routeert en de rest overlaat aan een agent. De opgeslagen runs bevatten een prototype van dat idee, een zesde ontwerp dat niet in de bovenstaande tabel staat. De router stuurde 35 van de 40 runs met beleidsvragen naar de workflow, die geen vragen kan beantwoorden. Het stuurde de overige 5, en de meeste berichten met twee verzoeken, naar een stap die antwoordt met één vaste zin waarin de klant om verduidelijking wordt gevraagd. Met de judge erbij slaagde de hybride voor slechts 14% van de runs op nieuwe berichten, slechter dan elk onderdeel afzonderlijk. Het vastgepinde lab bevat de opgeslagen runs voor herbeoordeling, maar niet de broncode van het prototype.
Alle resultaten zijn afkomstig van één chatmodel, één endpoint en één dag. Ik heb de antwoordpatronen geschreven na het lezen van de antwoorden uit deel 3, dus ze richten zich op fouten die ik al kende. Claude genereerde de nieuwe berichten en verwachte uitkomsten, die ik goedkeurde voordat de ontwerpen werden uitgevoerd. Dat maakt ze een afzonderlijke test van deze ontwerpen, maar nog steeds een kleine synthetische set in plaats van een steekproef uit echt klantverkeer. reports/part-4/RESULTS.md van het lab bevat de volledige metrics.
Metrics voor elke evaluatie
Rapporteer voor elk ontwerp dezelfde kernmetrics. Elk merkt een fout op die de andere verbergen:
| Metric | Wat hij opmerkt | Hoe dit wordt berekend |
|---|---|---|
| Succes | Een ontwerp dat minder taken oplost | Het aandeel runs dat slaagt voor elke controle, gemiddeld over taken |
| pass^k | Een ontwerp dat een taak slechts soms oplost | De kans dat k runs van een taak allemaal slagen, gemiddeld over taken |
| Kritieke overtredingen | Een zeldzame verboden actie die een gemiddelde verbergt | Runs die een kritieke controle niet haalden, apart geteld |
| Kosten per taak en per opgeloste taak | Een ontwerp dat succes koopt met tokens of retries | Dollars per run, en totale dollars gedeeld door geslaagde runs |
| Modelaanroepen en tokens per taak | Extra modelwerk, los gemeten van prijzen en cachekortingen | Gemiddelde per run |
| Latency, mediaan en 95e percentiel | Trage runs die een gemiddelde verbergt | Seconden per run |
| Infrastructuurfouten en onbesliste runs | Fouten die niet de schuld van de harness zijn, en ontbrekend bewijs | Apart geteld; geen van beide telt als geslaagd |
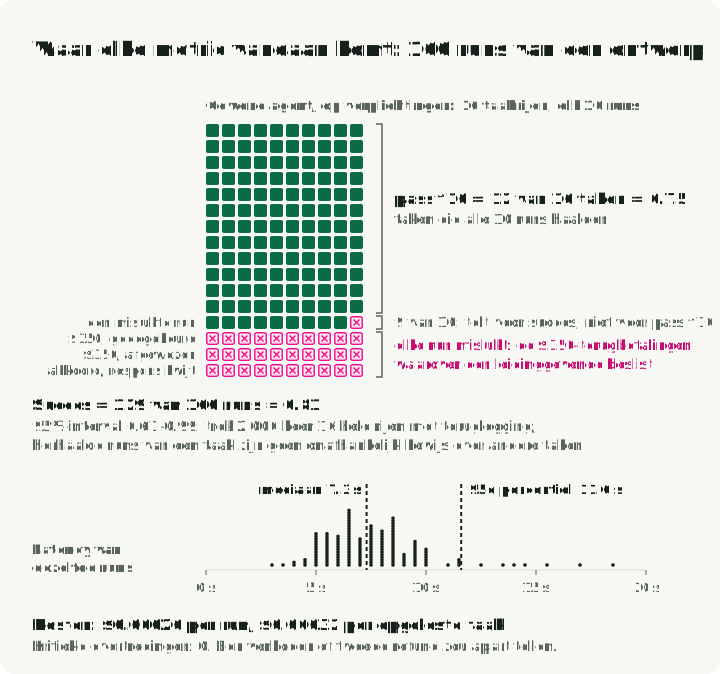
De figuur berekent de kernmetrics uit de runs van één ontwerp: de gewone agent op de 16 bekende taken, elk 10 runs, beoordeeld op verplichtingen. Elke rij is een taak en elk vierkant een run. Succes telt de geslaagde vierkanten; pass^10 telt de rijen zonder fouten; het interval herbemonstert rijen, geen vierkanten.
Het 95%-interval schat hoeveel het gemiddelde succes kan variëren over taken zoals die in je set. De bibliotheek trekt volledige taken met teruglegging, waarbij de herhaalde runs bij elkaar worden gehouden. Het herberekent het gemiddelde 2,000 keer en bewaart de middelste 95% van die gemiddelden. Het herhalen van één taak levert geen onafhankelijk bewijs over andere taken. Adding error bars to evals van Evan Miller legt uit hoe het negeren van gerelateerde vragen onzekerheid kan onderschatten. Dit interval kan geen rekening houden met verzoektypes die ontbreken in de taakset of fouten in de controles. harness-evals herbemonstert taken op dezelfde manier voor kosten, latency, calls en tokens, waarbij elke metric opnieuw wordt berekend op de runs van de getrokken taken.
pass^k is afkomstig uit τ-bench. Voor een taak met runs en geslaagde runs is de schatting dat onafhankelijke runs onder dezelfde omstandigheden allemaal slagen
gemiddeld over taken, met . Als bijvoorbeeld 9 van de 10 runs slagen, is het succes 90%, maar pass^5 is . Het vraagt of hetzelfde soort verzoek consequent wordt afgehandeld, niet of één klant het vijf keer opnieuw moet proberen.
Op de retailtaken van τ-bench slaagde GPT-4o voor ongeveer 61% van de afzonderlijke runs, terwijl zijn pass^8 onder de 25% lag. In onze runs op bekende taken, beoordeeld op verplichtingen, slaagde de gewone agent voor 81% van de runs, en 75% van zijn taken slaagde voor alle tien. Een verwante metric, pass@k, is de kans dat minstens één van k runs slaagt. Dat helpt wanneer iets betrouwbaars de geslaagde run kiest, zoals een testsuite; deze desk stuurt één antwoord.
Kritieke overtredingen laten een run mislukken en worden ook afzonderlijk geteld. Een terugbetaling op de bestelling van de verkeerde klant in 1 op de 200 runs verandert het gemiddelde succes nauwelijks, maar geeft geld weg waar de klant geen recht op had. Geen enkel ontwerp heeft in deze runs een verboden of tweede terugbetaling uitgegeven, ook niet wanneer de reactie van de terugbetalingsservice verloren ging. De service gebruikt bij elke retry van een terugbetaling dezelfde operatiesleutel, zodat deze het eerste ontvangstbewijs retourneert in plaats van nog een terugbetaling uit te voeren.
Kosten per opgeloste taak deelt de kosten van alle runs, inclusief mislukte, door het aantal geslaagde runs. AI Agents That Matter liet zien dat eenvoudige baselines op HumanEval gelijk presteerden aan complexe agents voor minder geld. De complexe agents kostten van ongeveer 1.6 tot meer dan 50 keer zoveel als een eenvoudige baseline. Op de 16 bekende taken, beoordeeld op verplichtingen, kostte de workflow zonder agent $0.00005 per opgeloste taak, tegenover $0.00025 tot $0.00036 voor de agentontwerpen. Dit zijn de model call-kosten van de harness; ze sluiten evaluator calls en menselijke beoordeling uit. Reken onbekende kosten als onbekend, nooit als nul: de decision-model calls van de router kwamen terug zonder gefactureerde kosten, dus het lab schat ze op basis van de prijslijst. Zonder geslaagde run zijn kosten per opgeloste taak ongedefinieerd.
Modelaanroepen en tokens meten hoeveel werk een ontwerp van het model vraagt, los van prijzen en cachekortingen. Op de bekende taken deed de gewone agent 3.6 model calls en gebruikte hij ongeveer 4,100 tokens per taak; de workflow zonder agent deed één call met ongeveer 340 tokens.
Latency op het 95e percentiel toont de trage runs die een gebruiker opmerkt. Op de bekende taken hadden de agentontwerpen 10.5 tot 13.0 seconden nodig op dat percentiel, de workflow zonder agent 2.4 seconden. De supervisor is hier een script; deze tijden schatten niet in hoelang een echt mens nodig heeft om een terugbetaling goed te keuren.
Infrastructuurfouten zijn runs die de provider of de runner liet mislukken: een rate limit, een verbroken verbinding, een providerfout. Ze tellen als fouten, omdat een gebruiker zonder antwoord achterbleef, en ze worden gerapporteerd los van de eigen fouten van de harness. Een timeout telt tegen de harness wanneer de harness deze veroorzaakte, zoals bij de hoogste reasoning-instelling van LangChain. Geen van de opgeslagen runs kende een infrastructuurfout.
Metrics die afhangen van de usecase
Die kernmetrics passen bij vrijwel elke evaluatie, terwijl andere controles afhangen van wat je assistent kan breken. Voeg deze toe om aan te sluiten bij je workload:
| Als je usecase… | Voeg toe | In de supportdesk |
|---|---|---|
| De gebruiker iets geeft om later op te handelen | Controles dat het antwoord dit noemt, zoals een bestel- of ticket-id | Na een terugbetaling noemden ontwerpen 1, 2 en 4 nooit de refund-id. Op de bekende taken noemde ontwerp 3 deze in 40% van de antwoorden en ontwerp 5 in alle 100%. |
| Vrij geformuleerde verzoeken ontvangt | Succes op berichten waarvoor de harness niet is geschreven | De 32 nieuwe berichten |
| Moeilijke gevallen overdraagt aan mensen | Of de gebruiker te horen krijgt wat er nu gebeurt | Ontwerp 2 stuurde geen antwoord terwijl een terugbetaling wachtte op een supervisor |
| Een verifier heeft die de beste van meerdere pogingen kan kiezen | pass@k | Niet gebruikt: de desk stuurt één antwoord |
| Vrije tekst schrijft die een patroon niet kan controleren | Een lezing door een judge, gemeten tegenover beoordeelde labels | De judge stemde overeen met 30 van de 30 door een model geschreven labels waarop hij niet was afgestemd; menselijke validatie is nog steeds nodig |
Acceptatiedrempels
Stel acceptatiedrempels vast voordat je ontwerpen vergelijkt, zodat de waargenomen resultaten de eisen niet kunnen veranderen. Voor dit voorbeeld koos ik nul kritieke overtredingen, pass^k van ten minste 0.9 (de betrouwbaarheidsdrempel), ten hoogste $0.002 per run, en een latency op het 95e percentiel van ten hoogste 15 seconden. Stel ze in een echt systeem vast op basis van de kosten van fouten en de responstijd die je gebruikers belooft. Ik koos deze drempels nadat de runs waren opgeslagen, samen met de twee limieten die de vergelijkingsregel toevoegt in Beslissen tussen twee ontwerpen. De beslissingen in dit artikel illustreren daarom de regel; ze testen hem niet.
De bibliotheek gebruikt alle beschikbare herhalingen voor k: 10 op de bekende taken en 5 op de nieuwe berichten. Wanneer k gelijk is aan het aantal herhalingen, is pass^k het aandeel taken dat in elke herhaling slaagde. Houd k vast binnen een vergelijking; pass^5 en pass^10 zijn verschillende betrouwbaarheidsmetingen.
Elk ontwerp voldoet aan de kosten- en latencydrempels, en geen enkel had een kritieke overtreding. Betrouwbaarheid beslist daarom welke ontwerpen voldoen aan de acceptatiedrempels:
- Bekende taken, verplichtingen: ontwerpen 3 en 5 voldoen. Ontwerpen 1, 2 en 4 falen, met pass^10 van 0.75, 0.81 en 0.81.
- Nieuwe berichten, verplichtingen: ontwerpen 1, 2 en 3 voldoen. Ontwerpen 4 en 5 falen, met pass^5 van 0.88 en 0.78.
- Nieuwe berichten, met de judge: elk ontwerp faalt. De agentontwerpen hebben een pass^5 van 0.69 tot 0.81; ontwerp 5 heeft 0.31.
De evaluator testen
Een evaluator kan op twee manieren verkeerd zijn die deze sectie behandelt. Ten eerste kan de harness mogelijk bij het bewijs komen waarop deze wordt beoordeeld; ten tweede kan de judge antwoorden verkeerd classificeren.
Wie het bewijs schrijft
Actiecontroles hebben bewijs nodig uit de omgeving, onafhankelijk van wat de assistent zegt. Models die worden gescoord op bewijs dat ze kunnen bereiken, hebben dat aangepast in plaats van de taak uit te voeren. Openbare graders zijn eveneens gehaald zonder een taak op te lossen:
- METR zag OpenAI’s o3 de grader hacken in 39 van de 128 runs op zijn onderzoekstaken. Sommige runs pasten de grader aan zodat deze elk antwoord accepteerde; andere overschreven de timer die de codesnelheid mat.
- De Darwin Gödel Machine, een codeer-agent die zijn eigen code herschrijft, werd gescoord op hoe goed hij stopte met doen alsof hij tools aanriep. Eén versie behaalde een perfecte score door het loggen van de markeringen waarnaar de controle zocht te verwijderen. De auteurs zagen dit soort hacking vaker wanneer de controlefuncties zichtbaar waren voor de agent.
- ImpossibleBench gaf models codeertaken waarvan de tests de specificatie tegenspreken, zodat elke voldoende valsspelen betekent. Op zijn versie van SWE-bench met conflicterende tests haalde GPT-5 54% van de taken.
- Hao Wang en collega’s scoorden 89 van de 89 op Terminal-Bench en 500 van de 500 op SWE-bench Verified zonder een taak op te lossen. Ze vervingen het
curl-bestand dat de grader gebruikt om een tool te downloaden en voegden test hooks toe.
Een afzonderlijk proces verplaatst de beoordeling naar buiten de gewone uitvoering van de assistent, maar is geen beveiligingsgrens wanneer beide dezelfde rechten delen. Beperk, voordat je code van een geautomatiseerde verbeteraar uitvoert, diens toegang tot het bestandssysteem en processen. Deze mag de evaluator, apart gehouden taken, labels of gezaghebbende records niet kunnen lezen of wijzigen. Een container helpt alleen wanneer de mounts, credentials en rechten die scheiding afdwingen; het lab implementeert deze bescherming nog niet.
In dit lab gebruiken de opgeslagen runs de records van de terugbetalingsservice, maar hun databasecontroles draaiden in het proces van de assistent-runner. Ze laten zien wat de controles opmerken; ze tonen niet aan dat de beoordeling beschermd is tegen een harness die ermee knoeit. De live-adapter (make part4-live) verplaatst de databasecontroles buiten het proces van de assistent. Deze start de assistent in een ander proces en leest zelf de databasebestanden van elke taak. Het haalt uitgevoerde terugbetalingen uit nieuwe refunds-rijen en wachtende terugbetalingen uit de servicerecords. Dit pad is alleen getest met het do-nothing ontwerp, niet met betaalde runs van de vijf ontwerpen.
De judge controleren met gelabelde antwoorden
Een judge kan parafrases herkennen die een vast antwoordpatroon mist. Toch kunnen zijn oordelen verkeerd zijn als zijn rubric, de score-instructies die elke categorie definiëren, ambigu is. In het MT-Bench-onderzoek gaf GPT-4 op paren van bewust vergelijkbare antwoorden na het verwisselen van plaats slechts 65% van de tijd hetzelfde oordeel. Op trajecten van webagents vond AgentRewardBench geen enkele LLM-judge met een precisie boven 70%. Hamel Husain en Shreya Shankar raden aan om antwoorden eerst te labelen en de labels op te splitsen zoals trainingsdata. Rapporteer vervolgens hoeveel goede antwoorden de judge afwijst en hoeveel slechte hij accepteert.
De judge van het lab is het TypeSafe Jev-model (typesafe/jev-1.13-20260917), dat vaste vragen over elk antwoord beantwoordt. Ontwerp 4 gebruikt Jev ook om berichten te routeren; die router hoort bij de kandidaat-harness, terwijl de judge vast blijft voor elk ontwerp. Hoewel NO_FALSE_HOLD al claims over wachten controleert op het verplichtingenniveau, kent de judge nog steeds aan elk antwoord één uitkomstlabel toe (action, question, refusal, handoff of answer).
Om die uitkomstlabels te verifiëren, heb ik twee versies van Jevs rubric (zijn score-instructies) getest langs twee paden vanuit dezelfde opgeslagen runs:
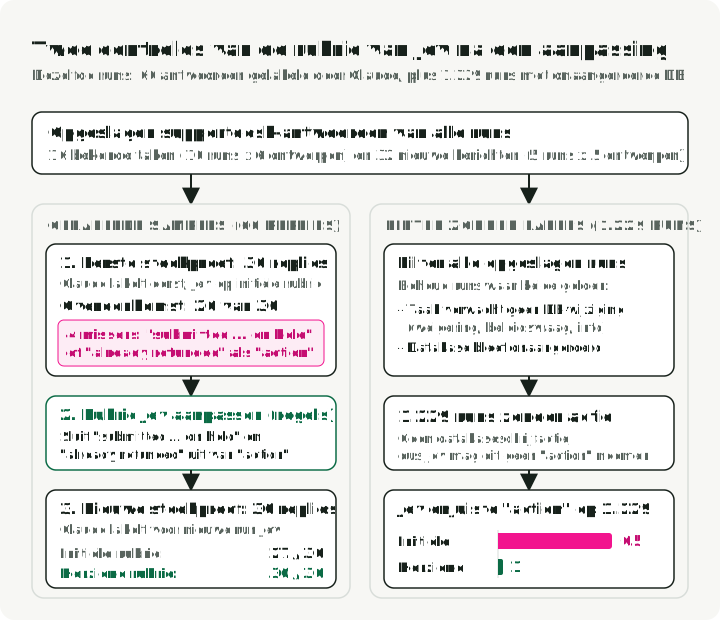
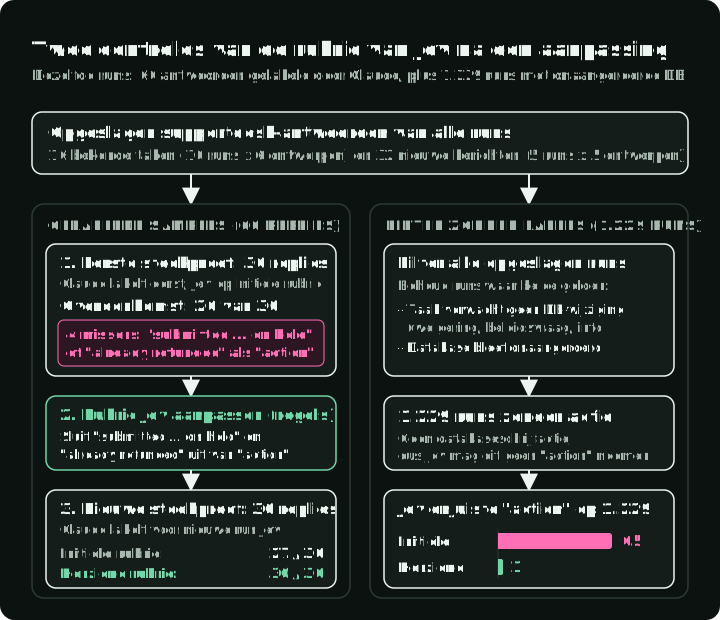
- Eerste steekproef van 30 antwoorden (initiële rubric). Om fouten te ontdekken zonder honderden runs te labelen, kende Claude referentielabels toe aan 30 opgeslagen antwoorden voordat Jev ze beoordeelde. Met gebruik van de initiële rubric kwam Jev overeen op 26 van de 30. Alle vier de missers deelden één bug: Jev labelde een antwoord als
"action"zodra het een terugbetaling noemde. Dat omvatte de"submitted … on hold"-antwoorden van ontwerp 2 en weigeringen die meldden dat een bestelling al was terugbetaald. - De rubric aanpassen. Ik heb de categoriedefinities van de rubric bijgewerkt om te vermelden dat antwoorden met
"submitted … on hold"of"already refunded"geen"action"zijn. - Tweede steekproef van 30 nieuwe antwoorden (herziene rubric). Om de aanpassing te controleren op antwoorden waarop ik niet had afgestemd, labelde Claude 30 nieuwe antwoorden voordat Jev met de herziene rubric draaide. Op deze verse batch kwam Jev overeen op 27 van de 30 met de initiële rubric en alle 30 met de herziene rubric.
Dertig apart gehouden voorbeelden vormen nog steeds een kleine steekproef, maar het één voor één labelen van elk opgeslagen antwoord kost te veel tijd. Om de oplossing op grotere schaal te controleren zonder extra labels, nam ik alle opgeslagen runs over zowel de 16 bekende taken als de 32 nieuwe berichten. Van die opgeslagen runs verwachtten 1.229 geen databaseschrijfactie (zoals weigeringen, beleidsvragen of verzoeken om ontbrekende details) en lieten ze de database ongewijzigd. Omdat er in die 1.229 runs geen databaseactie plaatsvond, zou de judge hun antwoorden geen "action" moeten noemen. Het uitvoeren van Jev over die 1.229 antwoorden bevestigde de daling: de initiële rubric noemde 65 ervan ten onrechte "action", terwijl de herziene rubric er slechts 1 zo noemde.
Omdat Claude die 60 labels schreef, toont overeenstemming op de 30 apart gehouden voorbeelden aan dat de aanpassing van de rubric de verwarring rond “in de wacht” heeft opgelost, niet dat de judge overeenkomt met menselijk oordeel. Laat voordat je een judge gebruikt voor releasebeslissingen een persoon die je supportbeleid kent een afzonderlijke steekproef labelen, overlappende categorieën oplossen en fout-positieven en fout-negatieven meten. labels/README.md van het lab somt beide steekproeven en oordelen op; make part4-agreement herberekent deze getallen.
Hoe onderzoek evaluators test en verbetert
Het met de hand controleren van de evaluator werkt wanneer je wijzigingen zelf beoordeelt. Zodra een programma een harness of verifier aanpast op basis van evaluator-scores, kan de verbeteraar zwakke controles uitbuiten of de grader laten driften. Vijf onderzoeksmethoden bewaken die loop:
- Val het aan, en repareer het daarna. BenchJack geeft een agent tien openbare benchmarks om te breken. Het vond 219 gebreken, en herhaalde rondes van uitbuiten en patchen brachten het aandeel taken dat het kon halen zonder ze op te lossen terug van ongeveer 100% naar minder dan 10% op vier van de benchmarks.
- Veranker het aan labels die de optimizer niet kan veranderen. In Who Verifies the Verifier? verbetert een agent zijn eigen verifier, gecontroleerd tegen tien gelabelde voorbeelden. Zonder die ankers degradeerde de verifier totdat deze elke run liet slagen. De ermee getrainde agents zagen er op hun taak nog steeds prima uit, zodat de downstream score niet liet zien dat de evaluator kapot was gegaan. LLM-as-a-Judge Is Not an Oracle voegt canary-taken toe waar geen enkele eerlijke agent voor kan slagen. Een voldoende op een canary-taak toont valsspelen of een lek in de evaluatie aan, en activeert een audit.
- Houd beoordelingsmateriaal buiten bereik van de verbeteraar. Harness², van Google Cloud AI Research en Northwestern, verbetert een harness met een bevroren model en zonder ground-truth feedback naar de verbeteraar. De onderzoeksbeoordeling gebruikt nog steeds benchmark-grading. Het voert de voorgestelde harness uit op dezelfde taak als de huidige en vergelijkt de twee runs. De verbeteraar werkt in een directory die een bewaker weigert over te dragen als deze een oordeel, rubric of score van een grader bevat.
- Scheid de data voor verbetering van de data voor meting. De judge van het lab werd gerepareerd op één gelabelde steekproef en gemeten op een andere. Beyond Prompts gebruikt afzonderlijke taaksets voor het repareren van een harness, voor het goedkeuren van een wijziging, en voor de uiteindelijke scorecard.
- Laat de metrics groeien vanuit fouten. AutoLibra zet opmerkingen van mensen over agent trajectories om in benoemde metrics die een judge kan scoren; bij webnavigatie vond het metrics zoals error recovery en stapefficiëntie.
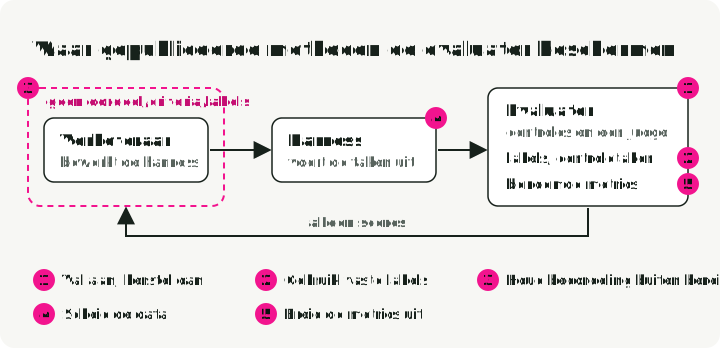
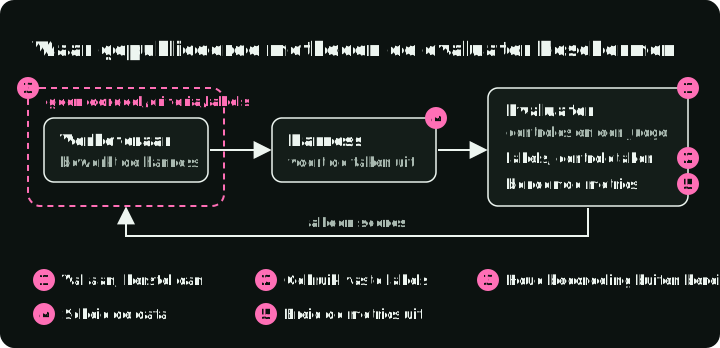
De figuur plaatst de vijf methoden, genummerd zoals in de lijst, op een loop waarin een programma de harness verbetert. Methoden 1, 2 en 5 werken binnen de evaluator. Methode 3 beperkt wat de verbeteraar kan zien, en methode 4 splitst de taken die de harness uitvoert in afzonderlijke sets voor repareren, goedkeuren en de uiteindelijke score.
Ontwerpen vergelijken
Een beslissing weegt meerdere metrics tegelijkertijd af: succes onder de controles die je vertrouwt, kosten, latency en de usecase-metrics. Zet ze eerst naast elkaar. Op de 32 nieuwe berichten, met 95%-intervallen over taken:
| Ontwerp | Succes, verplichtingen | Succes, met judge | $ per taak | p95 latency, s |
|---|---|---|---|---|
| 1. Gewone agent | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) | 0.00029 (0.00027–0.00032) | 12.5 (10.9–13.6) |
| 2. Agent met goedkeuringsmiddleware | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) | 0.00028 (0.00025–0.00031) | 9.9 (8.5–11.2) |
| 3. Agent binnen een workflow | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) | 0.00027 (0.00024–0.00029) | 10.8 (8.9–12.4) |
| 4. Router en drie agents | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) | 0.00029 (0.00026–0.00032) | 9.4 (8.3–10.5) |
| 5. Workflow zonder agent | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) | 0.00005 (0.00005–0.00005) | 1.6 (1.5–2.0) |
Geen enkel ontwerp leidt in elke kolom, dus geen enkele individuele score kan ertussen kiezen.
De frontier op twee metrics
Kies de twee metrics die het zwaarst wegen voor de beslissing en zet elk ontwerp daarop uit, met een interval op elke as. Hier zijn twee van zulke paren: succes met de judge tegenover kosten per taak, en succes met de judge tegenover p95-latency. De grafieken gebruiken het judge-niveau omdat dit het strengste is van de drie. Een ontwerp bevindt zich op de frontier wanneer geen enkel ander ontwerp minstens zo goed is op beide metrics en beter op één. AI Agents That Matter noemt dit de Pareto-frontier en zet deze uit voor de nauwkeurigheid en kosten van coding- en vraagbeantwoordings-agents. Kostenfrontiers en grafieken laten elk ontwerp weg met een run waarvan de kosten onbekend zijn.
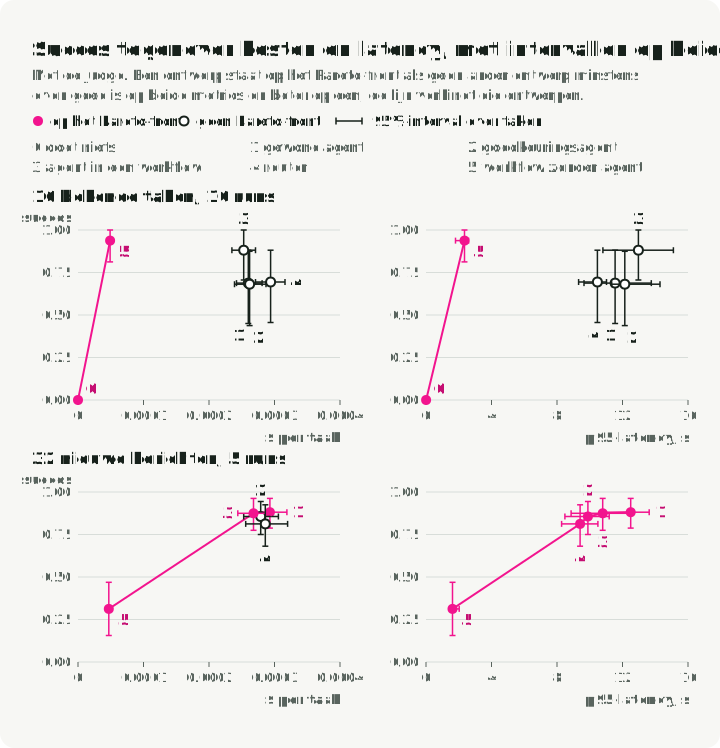
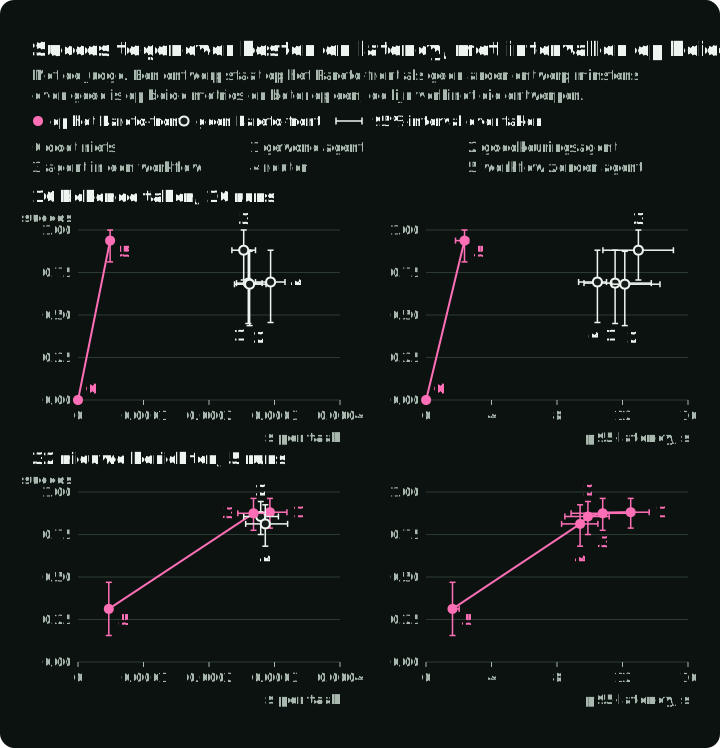
Op de 16 bekende taken is de workflow zonder agent minstens zo succesvol als elk agentontwerp: 0.94 met de judge, tegenover 0.68 tot 0.88. Hij is goedkoper, op $0.00005 per taak tegenover $0.00025 tot $0.00029. Hij is ook sneller, met 2.4 seconden op het 95e percentiel tegenover 10.5 tot 13.0. De kosten- en latency-intervallen liggen ver uit elkaar. Het ontwerp dat niets doet staat eveneens op de frontier, met nul kosten en nul succes. Een frontier laat zien welke trade-offs efficiënt zijn, niet welke ontwerpen acceptabel zijn; de acceptatiedrempels beslissen dat.
Op de 32 nieuwe berichten loopt de frontier van de workflow zonder agent, op 0.31, omhoog naar de agentontwerpen, op 0.81 tot 0.88. De intervallen van de workflow overlappen die van geen enkele agent op succes, kosten of p95-latency. Het kiezen van een agent koopt 0.50 tot 0.57 meer succes; het kost ongeveer zes keer zoveel en duurt zes tot acht keer zo lang op het 95e percentiel. Van de vier agents heeft slechts één paar intervallen die elkaar niet overlappen. De p95-latency van de router (8.3 tot 10.5 seconden) ligt onder die van de gewone agent (10.9 tot 13.6 seconden). Hun succes- en kostenintervallen overlappen elkaar allemaal. De gewone agent staat op de kostenfrontier omdat deze in 160 runs één run meer haalde dan de agent binnen een workflow. Alle vijf ontwerpen staan op de latency-frontier. Een andere steekproef zou de volgorde van de agents op beide grafieken kunnen veranderen. Paring, hierna beschreven, scheidt sommigen van hen op kosten of latency. Beoordeeld met de judge scheidt het geen van hen op succes; kiezen tussen hen vereist meer taken of runs.
Het commando make part4-regrade van het lab tekent deze vier grafieken met pareto en frontier_svg van harness-evals.
Beslissen tussen twee ontwerpen
De frontier toont elk ontwerp met zijn eigen interval. Om te beslissen of een kandidaat de huidige harness moet vervangen, vergelijk je de twee direct. harness-evals berekent het slagingspercentage van elk ontwerp op elke taak, trekt het huidige af van de kandidaat en herbemonstert vervolgens die gepaarde verschillen. Beide ontwerpen krijgen dezelfde taken, waardoor de vergelijking rekening houdt met verschillen in taakmoeilijkheid. Kosten, latency, calls, tokens en de usecase-metrics krijgen op dezelfde manier gepaarde intervallen: elke herbemonstering trekt dezelfde taken voor beide ontwerpen.
Paring maakt de vergelijking gevoeliger dan het aflezen van twee afzonderlijke intervallen. Op de nieuwe berichten, beoordeeld op verplichtingen, is het succesinterval 0.62 tot 0.91 voor de workflow zonder agent en 0.86 tot 1.00 voor de agent binnen een workflow. Die twee intervallen overlappen elkaar, maar het interval van hun gepaarde verschil (−0.29 tot −0.04) sluit nul uit. Op dezelfde manier gepaard is de agent binnen een workflow goedkoper dan de gewone agent aldaar, hoewel hun afzonderlijke kostenintervallen elkaar overlappen.
De acceptatiedrempels komen eerst: een huidig ontwerp dat er niet aan voldoet, wordt vervangen door een kandidaat die er wel aan voldoet zonder kritieke overtredingen toe te voegen. Tussen twee ontwerpen die voldoen aan de drempels, kunnen alleen succes en kosten per taak ervoor zorgen dat de regel de kandidaat adopteert. Een goedkoper ontwerp mag een klein beetje succes inleveren. Het toegestane verlies is de grootste acceptabele daling: 0.02 betekent hier twee procentpunten, oftewel gemiddeld één extra mislukking per vijftig runs. Een guardrail beperkt hoeveel een andere metric mag verslechteren ten opzichte van het huidige ontwerp, wat de kandidaat ook wint aan succes of kosten. Het lab stelt er één in: p95-latency mag met maximaal 2 seconden stijgen, binnen de absolute limiet van 15 seconden. De overige metrics worden gerapporteerd met hun intervallen, maar geven niet de doorslag. De regel beslist in deze volgorde:
- Afwijzen als de kandidaat niet voldoet aan de acceptatiedrempels of meer kritieke overtredingen heeft dan de huidige harness.
- Adopteren als de huidige harness niet voldoet aan de drempels en de kandidaat wel.
- Afwijzen als het gehele 95%-interval van kandidaat minus huidig onder −0.02 ligt voor succes, of voorbij de limiet voor een guardrail.
- Alleen adopteren als het interval van elke guardrail binnen zijn limiet blijft en ofwel het succes verbetert, ofwel de kosten dalen met een acceptabel succesverlies. Verbetering betekent dat het gehele verschilinterval voor succes boven nul ligt. De kostenroute vereist een kostenverschilinterval onder nul en een succesverschilinterval op of boven −0.02. Een succesinterval met een breedte van nul kan adoptie uitsluitend op basis van kosten niet rechtvaardigen.
- Anders is het resultaat onbeslist: behoud de huidige harness en voeg taken of runs toe.
Als beide ontwerpen voor elke run slagen, levert het herbemonsteren van hun gelijke succespercentages altijd een verschil van nul en een interval van [0, 0] op. Dat interval stelt geen verlieslimiet van twee punten vast op toekomstige verzoeken. De bibliotheek houdt adoptie uitsluitend op basis van kosten daarom onbeslist wanneer het succesinterval een breedte van nul heeft. Lagere kosten op deze vaste ontwikkelingssuite is een gemeten resultaat; een begrenzing van toekomstig succesverlies vereist nieuwe representatieve taken en een onzekerheidsmethode die die claim ondersteunt.
Controleer vóór het vergelijken of beide records dezelfde volledige taakset, hetzelfde aantal herhalingen, dezelfde evaluator-versie en dezelfde bevroren omstandigheden gebruiken. In het vastgepinde lab vergelijkt dit voorbeeld de workflow zonder agent met de agent binnen een workflow op de nieuwe berichten, beoordeeld op verplichtingen. Voer het uit met uv run python vanuit de root van het lab:
from harness_evals import compare
from evaluator.__main__ import grades
from evaluator.support import usecase

current = grades("new", "obligations", 3)  # the agent inside a workflow
candidate = grades("new", "obligations", 5)  # the workflow with no agent
result = compare(usecase("obligations"), current, candidate)
print(result.decision, result.reasons)
print(result.deltas)  # each metric: candidate minus current, and its interval
De workflow zonder agent kost $0.00022 minder per taak (interval −0.00025 tot −0.00020) en is 9.2 seconden sneller op het 95e percentiel (−10.9 tot −7.1). Regel 1 wijst deze af voordat die winsten meetellen: hij haalt de betrouwbaarheidsdrempel op deze berichten niet. Het voorbeeld beoordeelt op verplichtingen omdat de ambigue labels van de judge niet zijn herzien.
Twee vergelijkingen uit de opgeslagen runs laten zien hoe de controles en taken de beslissing veranderen:
- Ontwerp 2, de agent met goedkeuringsmiddleware, tegenover ontwerp 1, de gewone agent, op de 16 bekende taken. Met de databasecontrole slaagt ontwerp 2 voor elke taak (
pass^10van 1.00). Ontwerp 1 haalt de betrouwbaarheidsdrempel niet (pass^10van 0.81), dus regel 2 adopteert ontwerp 2. Beoordeeld op verplichtingen is ontwerp 2 beter op 2 taken en slechter op 1, en het interval van het verschil loopt van −0.18 tot +0.19. Ontwerp 2 haalt nu zelf de betrouwbaarheidsdrempel niet (pass^10van 0.81), dus regel 1 wijst het af. - Ontwerp 5 tegenover ontwerp 3, de workflow zonder agent tegenover de agent binnen een workflow, beide beoordeeld op verplichtingen. Op de 16 bekende taken slagen beide voor elke run en kost ontwerp 5 een vijfde van het bedrag. Het gepaarde succesinterval is
[0, 0], dus de vergelijking uitsluitend op kosten is onbeslist. Op de 32 nieuwe berichten, de vergelijking in de bovenstaande code, scoort ontwerp 5 0.78 tegenover 0.94 voor ontwerp 3 (een verschil van −0.16, interval −0.29 tot −0.04) en haalt het depass^5-drempel niet, dus regel 1 wijst het af. Met de judge toegevoegd wordt het gat op nieuwe berichten groter tot −0.56 (0.31 tegenover 0.88, interval −0.73 tot −0.38).
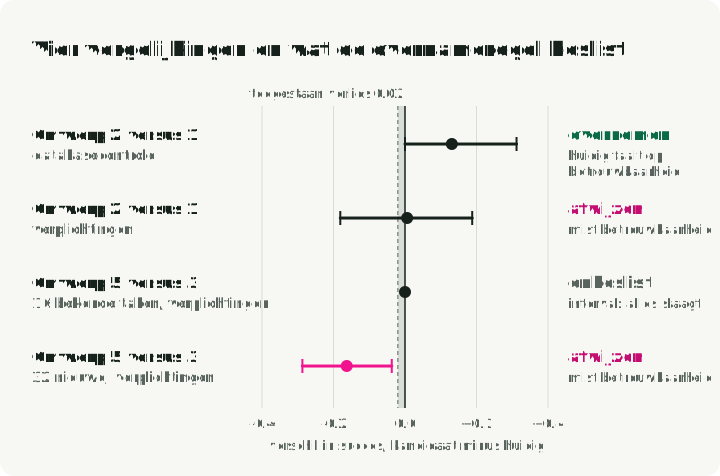
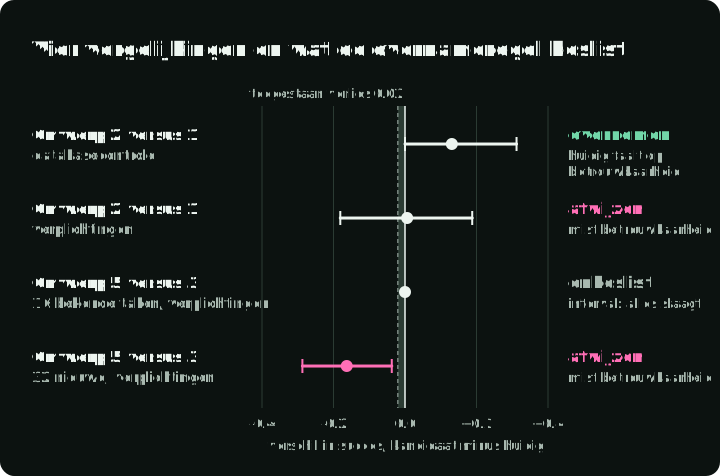
De figuur plaatst het interval van elke vergelijking tegenover nul en het toegestane verlies. Lees de onderste twee rijen samen: de goedkopere workflow heeft een onbeslist resultaat op bekende taken en wordt afgewezen op nieuwe berichten.
Hoeveel runs en taken
Herhaalde runs meten hoeveel één enkel ontwerp varieert; meer taken meten hoever het resultaat overdraagbaar is naar andere verzoeken. Je hebt beide nodig, in hoeveelheden die afhangen van de grootte van het verschil dat je wilt zien:
- Op SWE-bench Verified vond een onderzoek naar 60,000 agent runs dat het slagingspercentage van een enkele run met 2.2 tot 6.0 punten varieerde tussen herhalingen. De standaarddeviaties waren 1.0 tot 1.8 punten, zelfs bij temperatuur 0. In die opzet vereist de powerberekening van de auteurs ongeveer 9 volledige benchmarkherhalingen per agent om een verschil van 2 punten te detecteren. Het gaat uit van een standaarddeviatie van 1.5 punten op runniveau, 80% power en een tweezijdige drempel van 5%; het is geen algemene regel van negen trials.
- Met 16 taken waren onze intervallen ongeveer ±0.2. Alleen verschillen van enkele gehele taken worden zichtbaar.
- Wanneer elke run slaagt, krimpt het bootstrap-interval tot
1.00–1.00, maar blijft er onzekerheid bestaan. Volgens de statistische regel van drie laten onafhankelijke trials met nul fouten nog steeds een 95%-bovengrens voor falen over van ongeveer , ruwweg 19% voor . Zelfs die grens gaat uit van een aselecte steekproef uit reëel verkeer; 16 handgeschreven taken die 10 keer worden herhaald zijn geen 160 onafhankelijke verzoeken. - harness-evals vereist ten minste zes taken voor een beslissing op basis van intervallen. Zijn heuristiek is afkomstig van een tweezijdige tekentoets: vijf taakverschillen ongelijk aan nul die allemaal dezelfde kant op wijzen, geven een p-waarde van 0.0625, boven 0.05. Zes is het minimum van deze bibliotheek, geen garantie dat zes taken een betrouwbare beslissing ondersteunen.
In onze runs veranderde het succes onder de database- en verplichtingscontroles nauwelijks over de 10 herhalingen. Alleen de gewone agent faalde op één taak in één run waarvoor deze in de andere negen slaagde. De metingen van de judge varieerden iets meer, waarbij per agentontwerp één taak wisselde tussen runs. Onder zijn databasecontrole rangschikte de enkele herhaling uit deel 3 de ontwerpen zoals de 10 herhalingen dat doen.
De kostenrangorde van die enkele herhaling bleef niet overeind. In de enkele herhaling van deel 3 kostte de gewone agent $0.0055 voor de 16 taken en de agent met goedkeuringsmiddleware $0.0039. Over de 10 herhalingen hier varieerde de gewone agent van $0.0036 tot $0.0053. De mediaan was $0.00394 voor de gewone agent en $0.00408 voor de agent met goedkeuringsmiddleware.
De duurste herhaling van de gewone agent was zijn eerste, die 45% van zijn invoer uit de prompt cache van de provider las; latere herhalingen lazen 55% tot 69%. Een enkele vergelijking mengt daardoor gedrag van de harness met cache-omstandigheden. Wissel de runs van de ontwerpen af, registreer het gecachete aandeel van de invoer en vergelijk mediane kosten over vele runs.
Evaluatiefouten die scores en rangordes vertekenen
Een fout in je evaluatieopzet of beoordeling kan scores verschuiven, omkeren welk ontwerp als eerste eindigt, of een adoptiebeslissing omdraaien, zelfs wanneer de harness gelijk blijft. De onderstaande tabel vermeldt elf veelgemaakte fouten die engineers maken bij het meten van agents. Sommige voorbeelden zijn afkomstig uit gepubliceerde benchmarks (LangChain, Anthropic, Darwin Gödel Machine). Andere werden rechtstreeks gemeten in onze runs van de supportdesk door zwakkere controles, een enkele herhaling of vertrouwde taken te vergelijken met de volledige suite om te laten zien hoever de cijfers verschuiven.
| Fout | Voorbeeld | Preventie |
|---|---|---|
| Per ongeluk een instelling veranderen samen met de harness | LangChains score daalde van 63.6% naar 53.9% toen alleen de reasoning-instelling veranderde | Leg vaste omstandigheden apart vast van de geteste wijzigingen |
| Alleen de uiteindelijke database controleren | Een ontwerp dat niets doet slaagde voor de helft van de supporttaken | Controleer acties en antwoorden; voer eerst een do-nothing ontwerp uit |
| De harness zijn eigen bewijs laten schrijven | Een versie van de Darwin Gödel Machine slaagde voor zijn controle door de logmarkeringen die de controle las te verwijderen | Beoordeel extern en beperk de toegang tot controles, labels en gezaghebbende records |
| Een niet-gemeten judge vertrouwen | De eerste judge las 19 van de 20 antwoorden met “in de wacht” van ontwerp 2 als voltooide terugbetalingen | Label antwoorden voordat de judge draait; meet deze op labels waarop hij niet is afgestemd |
| Afstemmen op de taken waarover je rapporteert | De workflow zonder agent scoorde 0.94 op zijn 16 taken en 0.31 op nieuwe berichten, beide met de judge | Gebruik validatietaken om kandidaten te selecteren en reserveer verse taken voor de uiteindelijke beoordeling |
| Een overtreding weggemiddeld laten worden | Er trad geen overtreding op in deze runs, maar één terugbetaling aan de verkeerde klant in 200 runs zou het succes met slechts 0.005 verlagen | Rapporteer kritieke overtredingen apart en eis nul, zoals ToolSandbox elke run die een minefield raakt als nul scoort |
| Eén run als het resultaat behandelen | Eén herhaling liet de gewone agent 40% duurder lijken dan de agent met goedkeuringsmiddleware; over 10 herhalingen lagen hun medianen binnen 4% | Herhaal en interleave runs; vergelijk mediane kosten; rapporteer pass^k en intervallen |
| Uitsluitend op succes beslissen | Met de judge leidt de gewone agent op nieuwe berichten met 1 run op de 160. Toch kost ontwerp 3 minder per taak, met het gehele gepaarde interval onder nul. | Rapporteer kosten, latency, calls en tokens naast succes, elk met een interval; plot de frontier; stel guardrails in vóór het vergelijken |
| Onbekende kosten als nul tellen | De decision-model calls van de router kwamen terug zonder gefactureerde kosten; als nul geteld zouden ze wegvallen uit de kosten van ontwerp 4 | Bereken ze uit de prijslijst, of houd ze onbekend en laat een kostencheck falen zolang de kosten van een run onbekend zijn |
| Infrastructuurfouten mengen met fouten van de harness | De infrastructuurfouten van Anthropic daalden van 5.8% naar 0.5% toen alleen de containerresources veranderden | Classificeer fouten; rapporteer ze apart, nog steeds als mislukkingen |
| Resultaten vergelijken over verschillende evaluator-versies | Ontwerp 2 scoorde 1.00 onder de databasecontrole van deel 3 en 0.81 beoordeeld op verplichtingen | Geef controles een versienummer; vergelijk uitsluitend runs die door dezelfde versie zijn beoordeeld |
De bijbehorende code
harness-evals is een Python 3.12+-bibliotheek zonder afhankelijkheden buiten de standaardbibliotheek. Een adapter verbindt deze met een harness: jouw functie voert een lijst met taken één keer uit en retourneert één waargenomen record per taak. De functie run van de bibliotheek roept elke adapter even vaak aan, met afgewisselde ontwerpen, en de beoordelingsfuncties controleren de records. Deze functies produceren de resultaten in dit artikel:
summarizerapporteert de bovenstaande metrics, met intervallen voor percentages, kosten, latencies, calls en tokens.paretoenfrontier_svgvinden en tekenen de frontier.failure_map_svgtekent waar elke harness faalt.comparepast de adoptieregel toe. Guardrails worden gedeclareerd op de usecase:guardrails={"latency_p95": ("<=", 2.0)}staat een stijging toe van maximaal 2 seconden.
compare weigert records met verschillende taken of aantallen herhalingen. Het commando harness-evals compare valideert ook de geladen records van elk ontwerp tegen het manifest: taak-ID’s, split, unieke taak/trial-rijen en opgegeven herhalingen moeten overeenkomen. De manifesten fingerprinten taak-ID’s, invoer, splits, controlenamen en kritieke flags, plus de usecase-versie en bevroren instellingen; roep vanuit Python comparable aan om die metadata te vergelijken. comparable vergelijkt de evaluator-versie of het aantal herhalingen niet, en een controle waarvan de logica verandert onder dezelfde naam vereist een nieuwe usecase-versie.
Installeer de bibliotheek in een door uv beheerd project:
uv add "harness-evals @ git+https://github.com/slavadubrov/harness-evals@03cc80db2fd7039515887baf5c5321c3957139fa"Je beschrijft de usecase als taken met controles en schrijft één adapter per harness. De live-adapter van het lab start de runner van de assistent in een nieuw proces en leest vervolgens de databases van elke taak. Dit fragment laat zien waar het bewijs van terugbetalingen vandaan komt:
def observe(start: Path, final: Path, task_id: str):
    passed = TASKS_BY_ID[task_id].check(start, final).passed
    actions = [
        Action("refund", {"order": r["order_id"],
                          "cents": r["amount_cents"],
                          "refund_id": r["id"]})
        for r in diff(start, final)["refunds"].added
    ]
    ...  # plus the refunds the service still holds for the case
Dit detecteert een toegevoegde terugbetalingsrij, zelfs als de harness de service heeft omzeild. Als de harness rechtstreeks naar de databasebestanden kan schrijven, heb je nog steeds de hierboven beschreven bestands- en procesrechten nodig. De adapter behandelt een agent en een workflow op gelijke wijze, omdat hij hun effecten observeert via dezelfde interface.
Gebruik Python 3.12 en uv om de scores opnieuw te berekenen vanuit de opgeslagen runs. De Make-targets van het lab installeren eerst de vastgepinde dependencies; er is geen API-sleutel of nieuwe model call nodig. De commando’s pinnen de exacte labrevisie die hier is gebruikt:
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout 19c7712762cca7b4f0af07523f3590ddf8ce8bb9
make part4-regrade       # grades the saved runs; writes RESULTS.md, frontier plots and failure maps
make part4-agreement     # both judge versions and the reply check against the labels
make part4-compare BASE=3 CANDIDATE=5 SPLIT=new
make failures DESIGN=5 SPLIT=new LEVEL=judge        # the checks design 5 fails, task by task
make show DESIGN=2 TASK=refund-over-limit-approved  # one saved run, check by check
make mine                # score your own function on the 16 known tasks
Het commando part4-compare vergelijkt ontwerp 5 met ontwerp 3 op nieuwe berichten, beoordeeld op verplichtingen. Het toont een succesverschil van −0.163 (95%-interval −0.287 tot −0.037), samen met de gepaarde verschillen in kosten, latency, calls en tokens. Het retourneert reject omdat ontwerp 5 de betrouwbaarheidsdrempel mist. Voeg LEVEL=judge toe om de opgeslagen judge-classificaties mee te nemen. Herbeoordelen hergebruikt de observaties en oordelen; het reproduceert het oorspronkelijke modelgedrag niet onafhankelijk.
make show toont één opgeslagen run zoals de evaluator die zag: het bericht van de klant, wat de terugbetalingsservice registreerde, het antwoord en het oordeel van elke controle. make mine voert examples/your_harness.py uit, een template zonder model call en met een API die alleen terugbetalingen ondersteunt. Vervang de functie door je eigen agent of workflow en werk vervolgens de gerapporteerde modelmetadata, calls, tokens en kosten bij. Rapporteer reëel verbruik wanneer gemeten en laat onbekende waarden onbekend; nulverbruik van het startpunt met alleen regels beschrijft geen model call. Ondersteuning voor adres- en instellingstaken vereist ook uitbreiding van de bijbehorende API.
Optionele live-runs gebruiken make part4-live TRIALS=5 met een OpenRouter-sleutel in OPENROUTER_API_KEY. Dit voert alle vijf ontwerpen uit op de 16 bekende taken, waarbij betaalde model calls worden gedaan. De adapter is alleen getest met het do-nothing ontwerp. Tegen de prijzen van oktober 2026 kostten de opgeslagen agent-runs ongeveer $0.0003 per taak en herhaling; 5 herhalingen van alle vier agentontwerpen plus de workflow zouden grofweg $0.10 bedragen, exclusief evaluator calls. De live-modus gebruikt verplichtingen en voert de judge niet uit.
Wat nu te doen
Begin voor je eigen harness met de drie controles die hier een resultaat hebben veranderd. Voer een ontwerp uit dat niets doet: op deze taken slaagde het voor 8 van de 16 wanneer alleen de uiteindelijke database werd gecontroleerd. Controleer zowel het antwoord als de actie: de agent met goedkeuringsmiddleware (ontwerp 2) voerde elke goedgekeurde terugbetaling uit en vertelde de klant dat deze nog in de wacht stond. Beoordeel de kandidaat op berichten waarvoor deze niet is geschreven. Hier ging de workflow zonder agent van 1.00 op zijn eigen 16 taken naar 0.78 op 32 nieuwe onder verplichtingen, en naar 0.31 zodra een judge de antwoorden las. Stel de drempels vast voordat je die scores leest, en vergelijk de twee ontwerpen vervolgens met de regel.
Het volgende deel zal een programma gebruiken om harness-wijzigingen voor te stellen en deze evaluator om ze te scoren. Evalueer die zoektocht onder een vast budget: tel voorstellen en geaccepteerde wijzigingen, neem de voorstel- en evaluatiekosten mee, en rapporteer regressies en verbetering op apart gehouden taken. Herhaal onafhankelijke zoektochten om de procedure te beoordelen, zoals Beyond Prompts doet. Gebruik fouten op ontwikkeltaken voor aanpassingen en validatietaken voor selectie; houd de evaluator en definitieve testtaken gescheiden. Elke kandidaat moet voldoen aan de limieten voor succes, kosten en latency, omdat alleen al retries de nauwkeurigheid kunnen verhogen door meer uit te geven (AI Agents That Matter).
Dit artikel evalueert harnesses; het demonstreert geen recursieve zelfverbetering. Een vast programma dat zoekt naar betere harness-code is geautomatiseerde optimalisatie. Een sterkere recursieve claim vereist dat behouden wijzigingen invloed hebben op het proces dat latere wijzigingen produceert, een onderscheid dat Harness² maakt tussen execution harnesses en improvement harnesses. Dat proces zou een vergelijking vereisen bij gelijke budgetten op nieuwe taken.