Évaluer un harness d’agent en gardant le modèle fixe
Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Cet article s’adresse aux ingénieurs qui doivent décider si une modification d’un agent AI ou d’un workflow améliore sa capacité à accomplir sa tâche métier. Un harness est le code qui entoure un modèle de langage : ses prompts, ses outils, son flux de contrôle, sa mémoire, ses vérifications et ses nouvelles tentatives. Vous apprendrez à garder le modèle fixe, à vérifier ce que fait le harness et ce qu’il dit à l’utilisateur, à mettre la réussite en regard du coût et de la latence, puis à décider si un candidat doit remplacer la conception actuelle.
L’exemple détaillé est l’assistant de support d’une boutique en ligne, où les remboursements supérieurs à $200 nécessitent l’approbation d’un responsable. Vérifier uniquement sa base de données finale donnait une apparence parfaite à un agent avec middleware d’approbation, alors qu’il annonçait aux clients que leurs remboursements effectués étaient toujours en attente. Vérifier les actions et les réponses révèle cet échec. Tester des messages pour lesquels aucune conception n’a été écrite révèle les limites d’un workflow moins cher. Dans ce workflow, un appel au modèle lit le message et le code exécute les étapes.
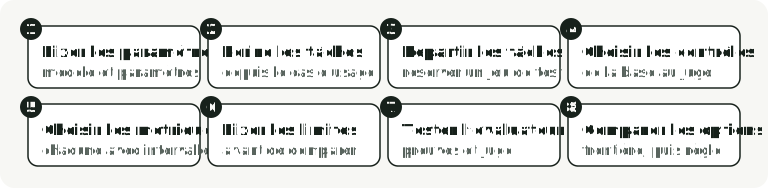
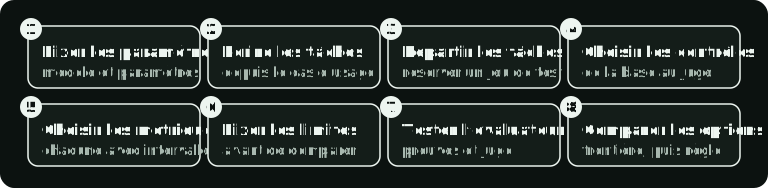
L’évaluation comprend huit étapes, que les sections ci-dessous suivent dans l’ordre.
Ce qui change dans une évaluation de harness
Une comparaison de modèles garde les prompts, les outils et la boucle d’exécution fixes tout en changeant le modèle. Une comparaison de harness garde le modèle fixe tout en changeant le code qui l’entoure. Les exécutions répétées et les intervalles d’incertitude aident à distinguer une amélioration du harness du bruit entre exécutions.
Le guide d’Anthropic Demystifying evals for AI agents distingue deux éléments. Le harness d’agent permet à un modèle d’agir comme un agent ; le harness d’évaluation exécute les tâches, enregistre chaque tentative et la note. J’appelle ici ce dernier l’évaluateur. On peut ainsi évaluer aussi bien un agent, qui choisit lui-même ses étapes, qu’un workflow, dont les étapes sont fixées dans le code.
Dans quelle mesure le harness peut-il changer un résultat ? Les comparaisons publiées avec un modèle fixe donnent une fourchette :
- L’article de Terminal-Bench 2.0 a exécuté plusieurs agents avec les mêmes modèles, au moins cinq fois chacun. GPT-5 a résolu 49.6% des tâches dans Codex CLI et 33.9% dans mini-SWE-agent, soit un écart de 15.7 points. Claude Opus 4.5 en a résolu 57.8% dans Terminus 2 et 52.1% dans Claude Code, soit un écart de 5.7 points. Les auteurs concluent néanmoins que le choix du modèle importait généralement davantage que celui de l’agent.
- LangChain a fait progresser sa CLI deepagents de 52.8% à 66.5% sur Terminal-Bench 2.0 en modifiant le harness autour de
gpt-5.2-codex, notamment la quantité de raisonnement utilisée à chaque phase d’une tâche. - Dans AutoHarness, de Google DeepMind, Gemini 2.5 Flash écrit du code qui rejette les coups illégaux avant qu’ils n’atteignent une partie. Avec ce code autour de lui, Flash a remporté 9 des 16 parties à deux joueurs contre le modèle plus grand Gemini 2.5 Pro.
Ces résultats montrent que modifier le harness peut déplacer le score de 5 à 16 points, ou permettre à un plus petit modèle de battre un plus grand. L’ampleur du gain variait d’un cas à l’autre : mesurez-le donc pour votre propre harness et votre modèle, et mesurez-le à nouveau quand le modèle change.
Gardez ces éléments fixes, pas seulement le nom du modèle :
- Le modèle et sa version, et le point d’accès du fournisseur qui le sert. Un routeur comme OpenRouter peut envoyer une requête à un autre fournisseur si vous n’en fixez pas un.
- Les paramètres d’échantillonnage et de raisonnement, à moins que leur modification ne constitue l’expérience. Dans l’expérience de LangChain, exécuter au niveau d’effort de raisonnement le plus élevé plutôt qu’à un niveau élevé a fait baisser le score de 63.6% à 53.9%, car davantage de tâches ont manqué de temps. Si un candidat règle l’effort différemment selon la phase, consignez cette politique comme faisant partie du candidat. Gardez les autres conditions fixes.
- La machine qui exécute les tâches. Anthropic a changé uniquement les ressources de conteneur des exécutions de Terminal-Bench 2.0 et a déplacé le score jusqu’à 6 points. L’équipe conclut que les écarts de classement inférieurs à 3 points méritent d’être examinés avec prudence tant que les configurations ne sont pas documentées et alignées.
- Les tâches, les vérifications et la version de l’évaluateur. Une vérification modifiée constitue une évaluation différente.
Les éléments que vous pouvez modifier comprennent les prompts, les définitions d’outils, la boucle ou le graphe de workflow, les middlewares, les nouvelles tentatives, les modèles de réponse et les modèles supplémentaires. Imputez les erreurs, le coût et la latence d’un modèle supplémentaire au harness qui l’utilise.
Six conceptions pour l’assistant de support
Pour voir cette configuration en pratique, rappelons l’assistant de support de la boutique en ligne de la Partie 3. Il émet des remboursements, change des adresses et met à jour les paramètres de compte. Une règle guide notre comparaison : les remboursements supérieurs à $200 nécessitent la décision d’un responsable. Nous testons six conceptions pour le faire fonctionner (cinq issues de la Partie 3 plus une référence qui ne fait rien). Elles diffèrent par le choix des étapes et la gestion de cette attente :
| Conception | Fonctionnement | Approbation du responsable |
|---|---|---|
| 0. Ne fait rien | Aucun appel au modèle, écriture ni réponse ; référence ajoutée ici | Aucune |
| 1. Agent simple | Le modèle appelle des outils dans une boucle | Peut laisser un remboursement en attente ; ne peut pas reprendre pour une décision |
| 2. Agent avec middleware d’approbation | La même boucle, avec du code autour des tool calls qui peut suspendre et reprendre | Le middleware attend la décision |
| 3. Agent dans un workflow | Un agent démarre la tâche ; le code gère ensuite l’approbation, le remboursement et la réponse | Le workflow attend la décision |
| 4. Routeur et trois agents | Un petit modèle de décision oriente chaque message vers un agent spécialisé | Aucune étape pour reprendre après une décision |
| 5. Workflow sans agent | Un appel au modèle lit le message en champs ; le code choisit et exécute les étapes | Le workflow attend la décision |
La Partie 3 a exécuté chaque conception une fois. Nous notons ici des exécutions enregistrées le 15 octobre 2026. Celles-ci comprennent 10 répétitions par conception sur 16 tâches connues, plus 5 répétitions des conceptions 1 à 5 sur 32 nouveaux messages pour lesquels aucune conception n’a été écrite (décrits plus bas). Toutes les conceptions utilisant un modèle ont employé openai/gpt-6-luna via le point d’accès OpenAI d’OpenRouter, avec les mécanismes de repli désactivés. Le modèle de décision supplémentaire de la conception 4 appartient à son harness.
La notation utilise harness-evals, une petite bibliothèque Python que vous pouvez installer dans votre propre projet. Le lab associé la connecte à l’assistant. C’est la Partie 4 de Recursive Harness Engineering : les Parties 2 et 3 ont construit les conceptions. Cette partie construit l’évaluateur qui note une modification de harness ; dans la partie suivante, un programme propose les modifications.
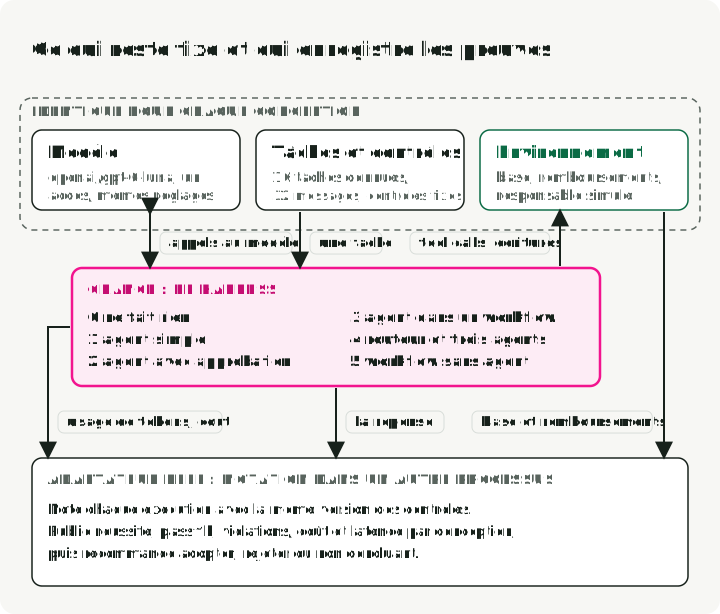
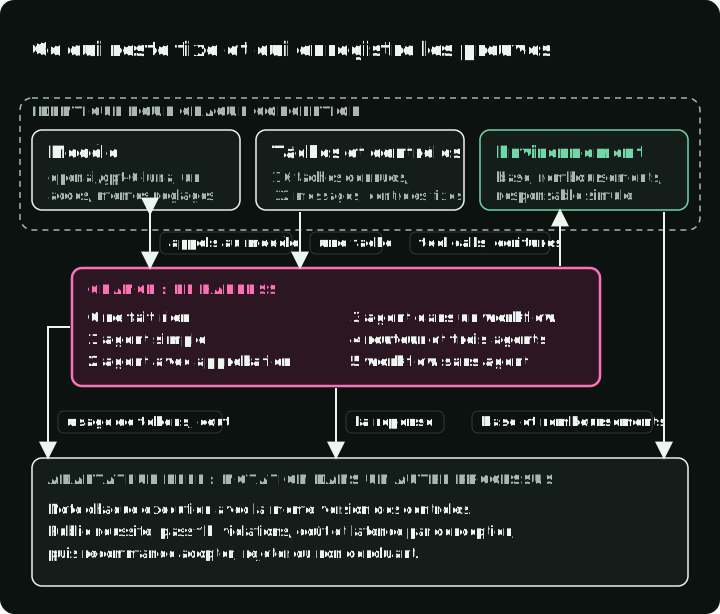
La figure montre l’adaptateur en direct du lab, le code qui connecte l’évaluateur à un assistant en cours d’exécution. Un processus séparé lit la base de données et les enregistrements du service de remboursement, et extrait la réponse, l’usage de tokens et le coût de la sortie même de l’assistant. Les exécutions enregistrées d’octobre notées ci-dessous ont consigné une partie de ces preuves dans le processus de l’assistant. Qui écrit les preuves explique quelle partie a été enregistrée dans le processus et ce que cela laisse sans test.
Les tâches viennent du cas d’usage
Le code d’évaluation peut être partagé, mais pas les tâches. Chaque harness est conçu pour un cas d’usage (ici, un service de support) : ses tâches proviennent donc de ce cas d’usage. Elles reflètent la politique que le système doit respecter, les demandes envoyées par les utilisateurs et les échecs déjà observés. Un benchmark public vous indique comment un modèle se comporte sur les tâches d’autrui. Le guide d’Anthropic suggère de démarrer avec 20 à 50 tâches tirées d’échecs réels et d’enrichir l’ensemble à partir de là.
Dans notre exemple, le service de support commence plus modestement, avec 16 tâches connues reprises de versions antérieures. Douze viennent de la Partie 2 : remboursements, changements d’adresse et modifications de paramètres. Le résultat correct peut être la modification elle-même, un refus, une question pour obtenir une information manquante, ou un transfert à un responsable. Un script joue le rôle du responsable et peut approuver, rejeter ou laisser la demande en attente.
La Partie 3 ajoute quatre cas : un remboursement approuvé de $350, un remboursement rejeté de $350, et deux remboursements dont la réponse du service est perdue après que l’argent a été remboursé. Ces deux derniers portent sur des remboursements de $15 et $350 ; l’assistant doit réessayer sans rembourser deux fois.
Pour chaque tâche, écrivez ce qu’accomplit une exécution correcte avant de lancer quoi que ce soit :
- L’entrée et l’état initial : le message de l’utilisateur, et la base de données ou les fichiers d’où démarre l’exécution.
- Ce qui doit se produire : les actions que l’environnement doit consigner, comme un remboursement de $350 sur la commande O-2002.
- Ce qui ne doit jamais se produire : les actions incorrectes dans toute exécution, comme un remboursement sur la commande d’un autre client. ToolSandbox, d’Apple, qualifie ces actions de champs de mines et attribue une note de zéro à toute exécution qui en déclenche une, quoi qu’elle ait fait par ailleurs. Traitez-les comme critiques.
- Ce que l’on doit dire à l’utilisateur, et ce qu’il ne faut pas lui dire : les faits qu’une réponse doit énoncer, et les affirmations qui seraient fausses.
- Le type d’issue : une action, une question demandant des informations manquantes, un refus avec le motif de politique, un transfert vers un humain, ou une réponse.
Voici la tâche du remboursement approuvé de $350 avec chaque vérification rédigée, y compris celle du juge, telle que la construit evaluator/support.py dans le lab. Lisez les vérifications comme le contrat de la tâche :
Task(
    "refund-over-limit-approved",
    "This is ben.ortiz@example.com. The carbon bike wheels from "
    "order O-2002 are cracked. Refund the full $350 now, please.",
    (
        state(),                    # the database is as expected
        did("refund", order="O-2002", cents=35000),  # refund issued
        at_most(1, "refund"),       # only once (critical)
        Check(
            "only permitted refunds",
            lambda e: all(
                a.matches("refund", {"order": "O-2002", "cents": 35000})
                for a in e.actions if a.name == "refund"
            ),
            critical=True,
        ),
        NO_FALSE_HOLD,              # reply never says it still waits
        says(r"\b350(\.00)?\b"),    # the reply states the amount
        judged("outcome"),          # the judge must say "action"
    ),
)
Les vérifications critiques de remboursement rejettent un second remboursement ou tout remboursement comportant une mauvaise commande ou un mauvais montant. La vérification distincte did exige que le remboursement attendu ait lieu ; ne pas l’émettre constitue un échec de la tâche, pas une action non autorisée.
La dernière vérification utilise un juge : un second modèle qui lit la réponse et la classe en confirmation d’action, question, refus, transfert ou réponse. Ici, la classe attendue est une confirmation d’action. Le juge vérifie quel type de réponse l’utilisateur a reçu, tandis que les vérifications de base de données et d’actions vérifient si le remboursement a eu lieu.
Chaque vérification renvoie vrai, faux, ou indéterminé si des preuves manquent. Une exécution ne réussit que lorsqu’elle se termine sans erreur et que chaque vérification renvoie vrai. Si le juge expire, l’exécution ne réussit pas, et l’évaluateur signale des preuves de notation manquantes plutôt qu’un échec de harness.
Les tâches qui doivent se terminer sans modification
De nombreuses exécutions correctes ne changent rien. Le client demande un remboursement au-delà du délai de 30 jours ou sur la commande d’un autre client, ou omet la ville dans une nouvelle adresse. Le résultat approprié est un refus ou une question, et la base de données reste dans son état initial. La moitié des 16 tâches sont dans ce cas.
Cela rend une vérification de la seule base de données finale facile à réussir. La conception 0 a réussi 8 des 16 tâches dans chacune de ses 10 répétitions sans aucun appel, écriture ni réponse. Les auteurs de l’Agentic Benchmark Checklist ont relevé le même problème dans un benchmark public : sur les tâches de compagnies aériennes de τ-bench, un agent renvoyant des réponses vides a obtenu un score de 38%, supérieur à celui de GPT-4o. Ils demandent à chaque benchmark de publier le score d’un agent aussi trivial. Exécutez d’abord une conception qui ne fait rien sur vos propres tâches. Toute réussite sur une tâche qui requiert une réponse révèle une vérification manquante.
Tâches de développement, de validation et de test
Nos 16 tâches connues proviennent de la construction de l’assistant de support dans les Parties 2 et 3. Seize tâches suffisent pour montrer le fonctionnement des vérifications, mais restent en deçà des 20 à 50 recommandées ci-dessus. Pire, chaque conception a été construite avec ces tâches sous les yeux. Cela en fait un jeu de développement : vous observez leurs échecs et modifiez le harness jusqu’à ce qu’il les réussisse.
Le workflow sans agent de la Partie 3 montre pourquoi un jeu de développement ne suffit pas. Ses règles reconnaissent les remboursements, les changements d’adresse et les modifications de paramètres, et informent le client qu’un collègue répondra à toute autre demande. Parce que j’ai rédigé ces règles autour de ces 16 tâches, un score parfait sur celles-ci n’apprend pas grand-chose sur d’autres messages. Pour tester des messages en dehors de cet ensemble et porter la suite à 48 tâches, le lab ajoute 32 nouveaux messages pour lesquels aucune conception n’a été écrite. Ils couvrent 8 plaintes vagues, 8 messages à deux demandes, 8 questions de politique et 8 demandes hors des catégories connues, comme la clôture d’un compte. Chacun indique son issue attendue et la modification de base de données qu’il requiert, le cas échéant, rédigées avant toute exécution.
L’apprentissage automatique sépare ses données pour la même raison : un modèle est plus performant sur les exemples sur lesquels il a été entraîné ou ajusté que sur des exemples inédits. Le Machine Learning Crash Course de Google utilise trois jeux. Le modèle s’entraîne sur le jeu d’entraînement. Le jeu de validation note chaque ajustement, d’un nouveau taux d’apprentissage à une nouvelle conception de modèle. Le jeu de test contrôle le modèle retenu à la fin.
Rien ne s’entraîne sur le jeu de validation. Mais le modèle que vous conservez est celui qui s’est trouvé le mieux adapté à ces exemples particuliers, de sorte que son score de validation est optimiste. Le cours recommande de remplacer les données de validation et de test après qu’une utilisation répétée pour la sélection de modèles a rendu leurs scores optimistes. Wan et ses collègues ont mesuré cet écart pour les prompts : les prompts optimisés pour maximiser la précision de validation ont obtenu des scores inférieurs de 5.8 à 13.2 points sur un jeu de test distinct. En revanche, les deux scores du prompt non optimisé sont restés distants d’environ 1.7 point l’un de l’autre.
Les poids du modèle de langage étant fixés, le harness est l’élément que vous ajustez : prompts, outils et flux de contrôle prennent la place des poids et des hyperparamètres. Répartissez vos tâches de la même manière avant la première exécution. Les tâches de développement jouent le rôle du jeu d’entraînement, les tâches de validation permettent de choisir parmi les harnesses candidats, et les tâches de test notent une seule fois le harness retenu. Machine Learning Yearning, d’Andrew Ng, nomme le jeu de validation le « dev set » ; dans cet article, les tâches de développement sont celles dont vous corrigez les échecs.
Les équipes qui ajustent des agents séparent également leurs tâches de cette manière. Lorsqu’Anthropic a amélioré les outils de ses agents sur des évaluations internes, elle « s’est appuyée sur des jeux de test réservés pour s’assurer de ne pas surajuster ses évaluations d’“entraînement” » (Writing effective tools for agents). METR a fait évoluer l’échafaudage de son agent avec « une suite de tâches de “développement” » et a publié des scores sur « une suite de “test” réservée de 83 tâches » (DeepSeek-V3 evaluation). Le benchmark d’agents AppWorld propose des partitions train, dev et test distinctes. Il demande de n’effectuer aucun ajustement sur les tâches de test, « que ce soit par recherche par quadrillage des paramètres ou manuellement en ajustant les prompts ».
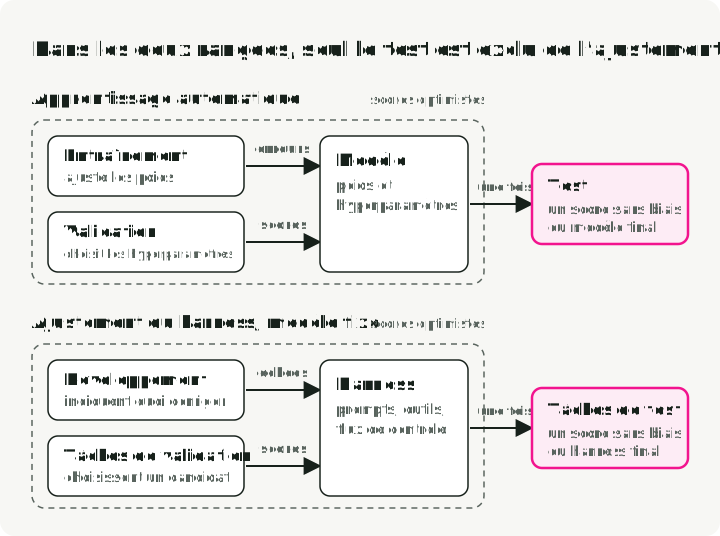
Chaque ensemble dans la rangée du harness remplit la fonction de l’ensemble situé au-dessus. Seul le score du jeu de test mesure des exemples que l’ajustement n’a pas vus.
Dans le lab, les 32 nouveaux messages, réunis dans une partition nommée new, font office de jeu de test. Un découpage aléatoire en apprentissage automatique tire le jeu de test du même vivier que le jeu d’entraînement. Ici, à l’inverse, les nouveaux messages ont été rédigés pour inclure des types de demandes absents des tâches de développement. Un score inférieur sur ces messages peut résulter d’un ajustement sur les tâches connues ou de demandes pour lesquelles aucune conception n’a été construite.
Le lab ne dispose pas d’un jeu de validation séparé. Plus loin dans cet article, les nouveaux messages permettent de trancher entre le workflow sans agent (conception 5) et l’agent dans un workflow (conception 3), ce qui en fait des tâches de validation pour ce choix. Examiner leurs échecs et rectifier un harness en ferait des tâches de développement. Quoi qu’il en soit, le score final de la conception choisie nécessite des messages inédits.
Conservez les échecs examinés en tant que tâches de régression après les avoir corrigés, et exécutez-les lors de modifications ultérieures du harness ou du modèle. Supprimez les détails privés des clients avant d’ajouter des cas de production. Cet ensemble réutilisé confirme que les correctifs fonctionnent toujours ; réservez les demandes inédites à l’évaluation finale. Associez les vérifications hors ligne à un suivi en production et à une révision humaine ponctuelle, comme le préconise le guide d’évaluation d’Anthropic.
Un programme qui propose des modifications de harness peut prendre bien plus de décisions de sélection qu’un être humain, ce qui accroît le risque de surajustement aux mêmes tâches. Fournissez-lui un jeu de validation pour ses choix, et maintenez le jeu de test hors de sa portée. Dans harness-evals, chaque tâche porte un nom de split, dev par défaut, et run évalue une partition à la fois.
Réserver des tâches en laisse moins pour l’ajustement. Meta-Harness, qui effectue une recherche sur le code de harness avec le modèle gelé, a cherché et évalué sur les mêmes 89 tâches de Terminal-Bench 2.0. Ses auteurs expliquent qu’une partition séparée aurait affaibli la recherche sur un benchmark aussi restreint. Ils ont vérifié l’absence de surajustement en lisant les harnesses et en y recherchant des chaînes spécifiques aux tâches. Pour votre propre cas d’usage, vous pouvez rédiger davantage de messages et en réserver une partie.
Trois niveaux de vérifications
Le lab évalue chaque exécution enregistrée à trois niveaux, chacun ajoutant des vérifications issues du contrat de tâche présenté plus haut :
- Base de données (
state) : la base de données finale correspond à la modification attendue. C’est ainsi que notaient les Parties 2 et 3. - Obligations (
did,at_most,only permitted refunds,never,NO_FALSE_HOLD,says) : la vérification de base de données, les vérifications d’actions de remboursement, et deux sortes de motifs de réponse. L’un exige des faits que la réponse doit énoncer ; l’autre interdit d’affirmer qu’un remboursement émis est toujours en attente. Le lab définit des faits de réponse obligatoires (says) pour les 16 tâches connues ; les 32 nouveaux messages emploient les autres vérifications d’obligations sans motifs de faits spécifiques aux tâches. - Juge (
judged) : les obligations, plus une vérification que la classification de la réponse par le juge correspond à l’issue attendue de la tâche.
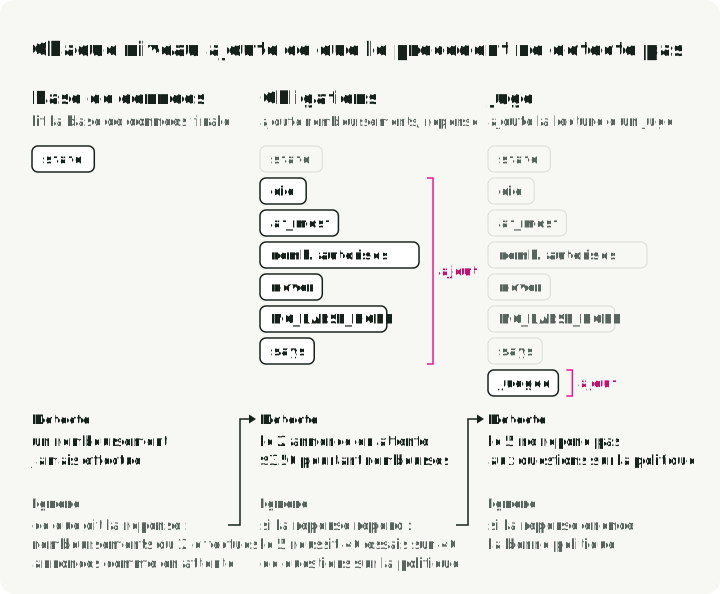
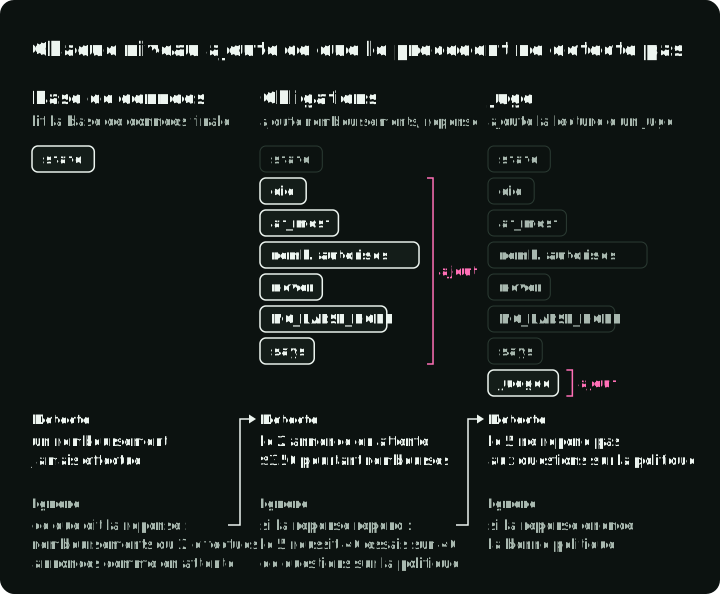
La figure présente, pour chaque niveau, un échec qu’il détecte et un qu’il ne peut observer ; le niveau suivant vérifie ce dernier. Aucune vérification de ce lab ne contrôle si une réponse énonce la bonne politique.
Les verdicts du juge ont été enregistrés avec les exécutions le 15 octobre, donc les noter à nouveau n’a nécessité aucun nouvel appel au modèle. Ils proviennent de la deuxième version de sa grille ; Vérifier le juge sur des réponses étiquetées montre sur quoi cette version a été testée et sur quoi elle ne l’a pas été. Les trois niveaux notent les mêmes exécutions enregistrées, et chaque résultat ci-dessous indique son niveau.
Ce que chaque niveau détecte sur les tâches connues
La réussite correspond à la proportion d’exécutions ayant satisfait à toutes les vérifications au niveau indiqué. Le tableau présente la réussite sur les 16 tâches connues sur 10 répétitions par tâche. La plage entre crochets représente un intervalle à 95% : l’endroit où le score se situerait plausiblement sur un autre ensemble de 16 tâches comparables (son mode de calcul). Un score de 0.81 indique que 81% des exécutions ont réussi.
| Conception | Base de données | Obligations | Obligations et juge |
|---|---|---|---|
| 0. Ne fait rien | 0.50 (0.25–0.75) | 0.00 (0.00–0.00) | 0.00 (0.00–0.00) |
| 1. Agent simple | 0.87 (0.68–1.00) | 0.81 (0.61–0.99) | 0.69 (0.45–0.88) |
| 2. Agent avec middleware d’approbation | 1.00 (1.00–1.00) | 0.81 (0.62–1.00) | 0.68 (0.44–0.88) |
| 3. Agent dans un workflow | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.88 (0.71–1.00) |
| 4. Routeur et trois agents | 0.88 (0.69–1.00) | 0.81 (0.62–1.00) | 0.69 (0.46–0.88) |
| 5. Workflow sans agent | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.94 (0.81–1.00) |
Comme l’intervalle rééchantillonne ces 16 tâches, une plage de 1.00–1.00 signifie seulement que chaque exécution a réussi sur cet ensemble précis, non que le harness réussira chaque demande future.
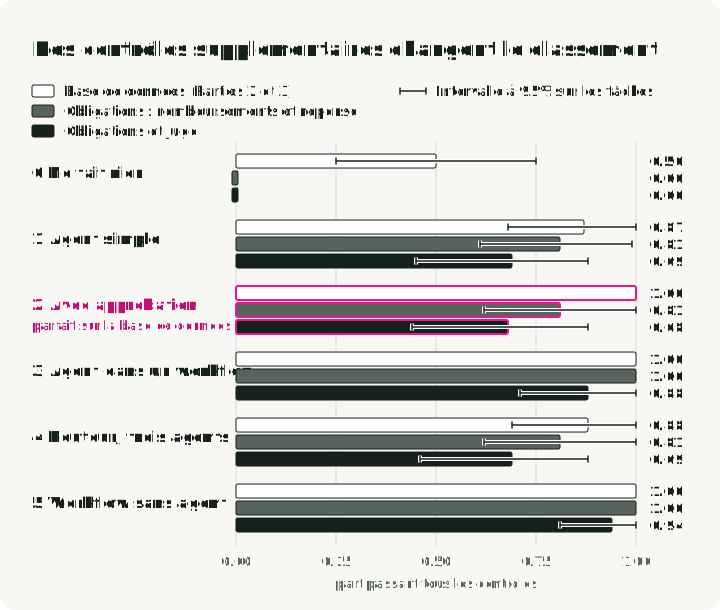
La figure trace les moyennes du tableau, chacune assortie d’une moustache pour son intervalle. Suivez l’agent avec approbation, la conception 2, de la vérification de base de données jusqu’au juge : il commence à égalité avec les conceptions 3 et 5 pour finir en dessous d’elles.
Remboursements corrects, réponses incorrectes
Ce que les vérifications plus rigoureuses ont mis au jour sur les tâches connues :
- La conception 0 est passée de 0.50 à 0. Chaque tâche requiert une réponse, et elle n’en transmet aucune.
- La conception 2, l’agent avec middleware d’approbation, est passée de 1.00 à 0.81. Dans les 20 exécutions des deux tâches approuvées, le remboursement s’est bien déroulé, mais la réponse affirmait qu’il était toujours en attente. Chaque réponse déclarait : « Parce qu’il dépasse $200, il est en attente d’approbation par un responsable ; il ne sera émis qu’une fois approuvé. » Dans la tâche de la Partie 2 où le responsable ne répond jamais, elle n’a envoyé aucune réponse au client, lors de 10 exécutions sur 10.
- Les conceptions 1 et 4 ont débuté plus bas, à 0.87 et 0.88, car aucune des deux ne peut reprendre après approbation d’un responsable. Les deux remboursements approuvés de $350 sont restés en attente, ce qui échoue dès la vérification de base de données. Les contrôles plus stricts ont conduit les deux conceptions à 0.81 en faisant échouer une tâche de plus : le remboursement rejeté de $350. Dépourvues d’étape d’approbation, elles ont indiqué au client qu’un responsable examinerait le remboursement et ont conclu l’exécution en le laissant en attente, de sorte qu’aucune décision n’a été prise. La vérification de base de données les a déclarées reçues sur cette tâche, car rien n’a été remboursé dans un cas comme dans l’autre.
- Les conceptions 3 et 5 ont conservé 1.00 : dans l’une comme dans l’autre, le code écrit la réponse après décision du responsable, à partir du résultat du service de remboursement.
Le tableau et le graphique dénombrent les échecs ; une carte des échecs indique où ils se situent. Chaque ligne est une tâche connue et chaque colonne un type de vérification, avec un panneau par conception et le juge intégré :
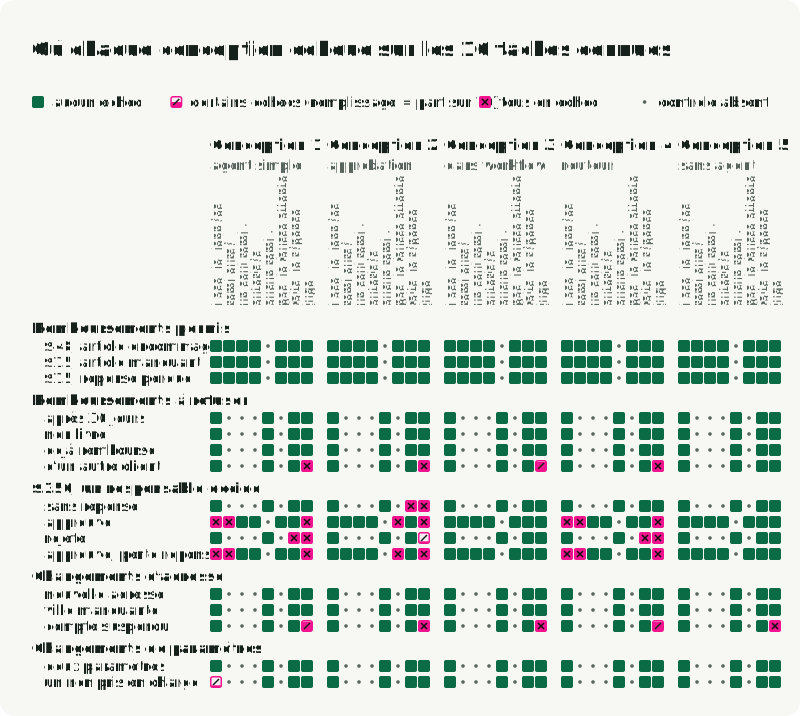
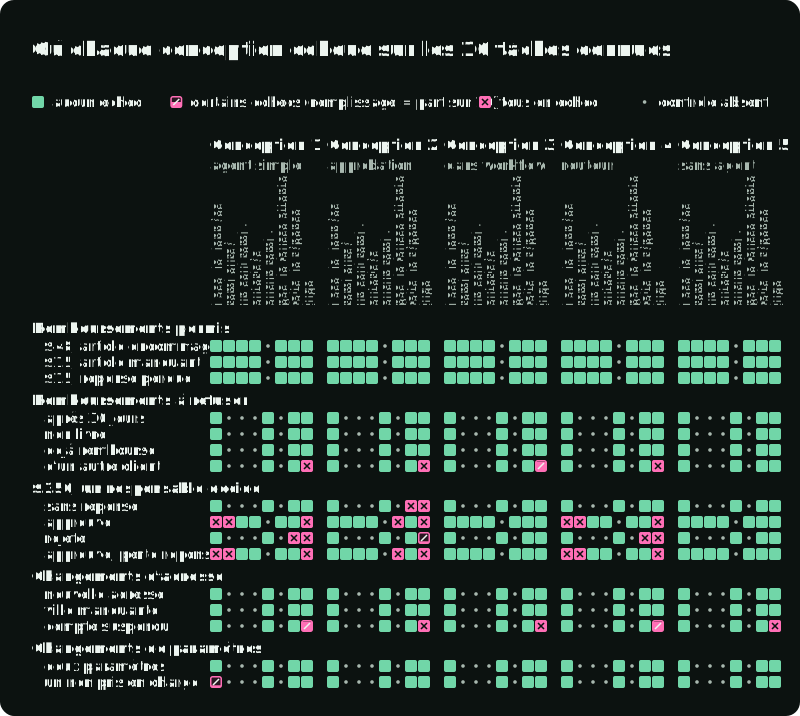
Deux groupes ressortent nettement. Les remboursements de $350 attendant la décision d’un responsable mettent en échec les conceptions 1, 2 et 4 dans des colonnes différentes. Les conceptions 1 et 4 n’émettent jamais le remboursement approuvé, tandis que la conception 2 l’émet pour ensuite le qualifier d’encore en attente. La colonne du juge échoue sur la commande d’un autre client dans quatre conceptions et sur le compte suspendu dans l’ensemble des cinq. La section suivante montre que ces deux tâches présentent des issues attendues ambiguës. harness-evals trace une telle carte avec failure_map_svg, et le lab en produit une pour chaque jeu de tâches. Sa commande make show ouvre l’exécution correspondant à n’importe quelle case.
Certains échecs du juge révèlent des tâches ambiguës
Le juge a diminué le score de chaque conception, mais ces baisses ne correspondent pas toutes à des défaillances avérées de service client :
- Sur la commande d’un autre client, les conceptions 1 à 4 déclaraient généralement ne pas la trouver sur le compte du client et l’invitaient à vérifier le numéro. Le juge a classé cette réponse comme une question. La tâche attendait un refus, bien que le motif de réponse ait accepté la réponse fournie.
- Sur le changement d’adresse d’un compte suspendu, chaque conception a opposé un refus et indiqué au client de contacter le support. Le juge a classé cette réponse en transfert ; la tâche attendait un refus.
Une réponse peut refuser une demande tout en orientant le client vers le support. Le tableau préserve les étiquettes et les scores initiaux, mais ce chevauchement exige un examen avant que le juge ne serve à valider ou rejeter un changement en production. Clarifiez les combinaisons acceptables, versionnez la grille, puis renotez chaque conception de la comparaison avec cette nouvelle version. Ne rectifiez pas les étiquettes uniquement pour le candidat.
De nouveaux messages révèlent des types de demandes manquants
Les 16 tâches connues ne testent que des demandes pour lesquelles chaque conception a déjà été conçue. Afin d’observer comment les harnesses réagissent à des entrées inconnues, le tableau ci-dessous note les cinq conceptions fonctionnelles sur les 32 nouveaux messages, à raison de 5 répétitions par tâche. La conception qui ne fait rien n’a pas été exécutée sur cet ensemble.
| Conception | Obligations | Obligations et juge |
|---|---|---|
| 1. Agent simple | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) |
| 2. Agent avec middleware d’approbation | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) |
| 3. Agent dans un workflow | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) |
| 4. Routeur et trois agents | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) |
| 5. Workflow sans agent | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) |
Le workflow sans agent, la conception 5, a réussi la totalité des 40 exécutions de questions de politique sous obligations, et aucune une fois le juge ajouté. Son schéma ne comporte aucune catégorie pour répondre à une question de politique. Les obligations vérifiaient uniquement qu’il ne touchait pas à la base de données ; le juge a constaté qu’il ne répondait jamais à la question posée.
Présentez ces résultats par type de demande ainsi que de façon globale : plaintes vagues, messages à deux demandes, questions de politique et autres demandes. Le lab attribue huit tâches à chaque groupe, de sorte que le score global les pondère de manière égale. Le trafic réel peut présenter des proportions différentes ; un score agrégé élevé peut toujours masquer un type de demande mal pris en charge.
La conception 5 a également échoué sur la plupart des messages comportant deux demandes, ainsi que sur des plaintes vagues telles qu’une théière brisée sans numéro de commande. Les agents ont recherché les commandes du client et remboursé la théière. La recommandation de la Partie 3 de démarrer par ce workflow demeure valable pour les 16 tâches connues. Pour prendre en charge les nouveaux messages, il lui faut intégrer le traitement des questions de politique, les demandes multiples au sein d’un même message et la recherche de commandes lorsqu’une réclamation ne précise aucun numéro de commande.
La Partie 3 proposait également une approche hybride orientant les demandes standard vers le workflow et confiant le reste à un agent. Les exécutions enregistrées comportent un prototype de cette approche, une sixième conception absente du tableau ci-dessus. Son routeur a dirigé 35 des 40 exécutions de questions de politique vers le workflow, incapable de répondre aux questions. Il a transmis les 5 autres, ainsi que l’essentiel des messages à deux demandes, vers une étape répondant par une phrase fixe invitant le client à clarifier sa demande. En intégrant le juge, l’approche hybride n’a réussi que 14% des exécutions sur les nouveaux messages, un résultat inférieur à chacune des deux approches prises isolément. La version épinglée du lab inclut ses exécutions enregistrées pour une nouvelle notation, mais pas le code source du prototype.
L’ensemble des résultats provient d’un seul modèle de chat, d’un seul point d’accès et d’une seule journée. J’ai rédigé les motifs de réponse après avoir pris connaissance des réponses de la Partie 3 : ils ciblent par conséquent des échecs déjà identifiés. Claude a généré les nouveaux messages et les issues attendues, que j’ai validés avant d’exécuter les conceptions. Cela en fait un test distinct de ces conceptions, mais qui demeure un ensemble synthétique restreint plutôt qu’un échantillon représentatif de trafic client réel. Le fichier reports/part-4/RESULTS.md du lab rassemble l’intégralité des métriques.
Des métriques pour chaque évaluation
Publiez les mêmes métriques fondamentales pour chaque conception. Chacune détecte un échec que les autres dissimulent :
| Métrique | Ce qu’elle détecte | Son mode de calcul |
|---|---|---|
| Réussite | Une conception qui résout moins de tâches | La part des exécutions réussissant chaque vérification, moyennée sur les tâches |
| pass^k | Une conception qui ne résout une tâche que par moments | La probabilité que k exécutions d’une tâche réussissent toutes, moyennée sur les tâches |
| Violations critiques | Une action interdite rare qu’une moyenne dissimule | Les exécutions ayant échoué à une vérification critique, comptées à part |
| Coût par tâche et par tâche résolue | Une conception qui achète sa réussite par des tokens ou des nouvelles tentatives | Les dollars par exécution, et le total en dollars divisé par les exécutions réussies |
| Appels au modèle et tokens par tâche | Le travail supplémentaire du modèle, mesuré hors tarifs et remises de cache | Moyenne par exécution |
| Latence, médiane et 95e percentile | Les exécutions lentes qu’une moyenne dissimule | Secondes par exécution |
| Erreurs d’infrastructure et exécutions indécises | Les échecs non imputables au harness, et les preuves manquantes | Comptés à part ; aucun ne compte comme une réussite |
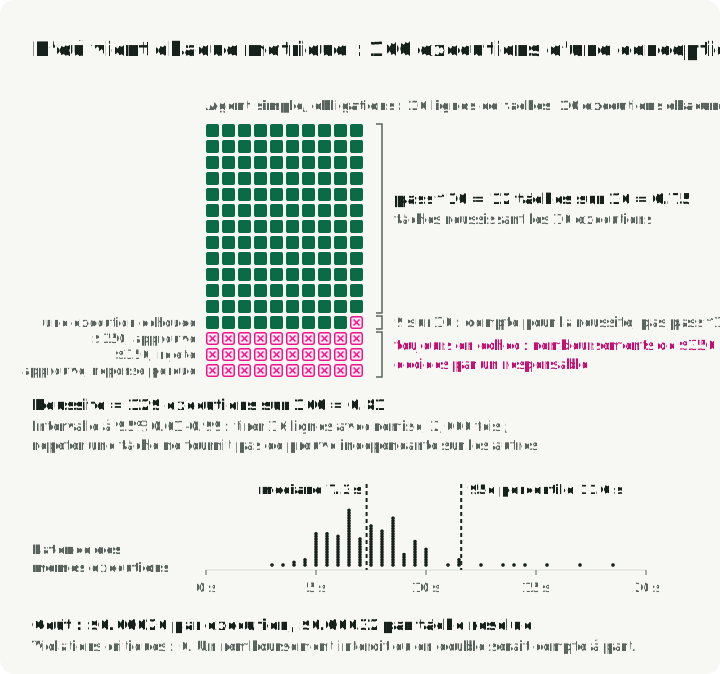
La figure calcule les métriques fondamentales à partir des exécutions d’une conception : l’agent simple sur les 16 tâches connues, 10 exécutions chacune, notées sur les obligations. Chaque ligne représente une tâche et chaque carré une exécution. La réussite dénombre les carrés réussis ; pass^10 compte les lignes sans aucun échec ; l’intervalle rééchantillonne des lignes, pas des carrés.
L’intervalle à 95% estime dans quelle mesure la réussite moyenne pourrait varier sur des tâches similaires à celles de votre ensemble. La bibliothèque tire des tâches entières avec remise, en maintenant groupées leurs exécutions répétées. Elle recalcule la moyenne 2,000 fois et conserve les 95% centraux de ces moyennes. Répéter une même tâche n’apporte pas de preuve indépendante quant à d’autres tâches. L’article d’Evan Miller Adding error bars to evals explique comment ignorer les questions liées peut sous-estimer l’incertitude. Cet intervalle ne saurait tenir compte des types de demandes absents de l’ensemble de tâches ou des erreurs dans les vérifications. harness-evals rééchantillonne les tâches de la même façon pour le coût, la latence, les appels et les tokens, en recalculant chaque métrique sur les exécutions des tâches tirées.
pass^k est issu de τ-bench. Pour une tâche donnée comptant exécutions et réussites, l’estimation que exécutions indépendantes menées dans les mêmes conditions réussissent toutes est
moyennée sur les tâches, avec . Par exemple, si 9 exécutions sur 10 réussissent, la réussite est de 90%, mais pass^5 est de . Cela mesure si un même type de demande est traité avec cohérence, et non si un client donné devrait la réitérer cinq fois.
Sur les tâches de vente de τ-bench, GPT-4o a réussi environ 61% des exécutions isolées, tandis que son pass^8 se situait sous les 25%. Lors de nos exécutions sur les tâches connues, notées sur les obligations, l’agent simple a réussi 81% des exécutions, et 75% de ses tâches ont réussi la totalité des dix répétitions. Une métrique voisine, pass@k, représente la probabilité qu’au moins une exécution parmi k réussisse. Elle s’avère utile lorsqu’un mécanisme fiable permet de retenir l’exécution réussie, comme une suite de tests ; ce service d’assistance n’envoie qu’une seule réponse.
Les violations critiques font échouer une exécution et sont également décomptées séparément. Un remboursement opéré sur la commande du mauvais client dans 1 exécution sur 200 n’influe que de façon minime sur la réussite moyenne, mais accorde des fonds non dus au client. Aucune des conceptions n’a émis de remboursement interdit ou en double au cours de ces exécutions, y compris lorsque la réponse du service de remboursement s’est trouvée perdue. Le service utilise la même clé d’opération pour chaque nouvel essai de remboursement, de sorte qu’il renvoie le premier reçu au lieu d’émettre un nouveau remboursement.
Le coût par tâche résolue divise le coût de l’ensemble des exécutions, y compris les échecs, par le nombre d’exécutions réussies. AI Agents That Matter a montré que des solutions de référence simples égalaient des agents élaborés sur HumanEval pour un coût bien moindre. Les agents élaborés coûtaient d’environ 1.6 à plus de 50 fois plus cher qu’une simple référence. Sur les 16 tâches connues, notées sur les obligations, le workflow sans agent revenait à $0.00005 par tâche résolue, contre $0.00025 à $0.00036 pour les conceptions avec agent. Il s’agit là des coûts d’appels au modèle du harness ; ils excluent les appels de l’évaluateur et la révision humaine. Considérez un coût inconnu comme inconnu, jamais comme nul : les appels au modèle de décision du routeur sont revenus sans coût facturé, de sorte que le lab les estime à partir de la grille tarifaire. En l’absence d’exécution réussie, le coût par tâche résolue n’est pas défini.
Les appels au modèle et tokens mesurent la charge de travail demandée au modèle par une conception, indépendamment des tarifs et des remises sur le cache. Sur les tâches connues, l’agent simple a effectué 3.6 appels au modèle et utilisé environ 4,100 tokens par tâche ; le workflow sans agent a réalisé un seul appel employant environ 340 tokens.
La latence au 95e percentile met en lumière les exécutions lentes perceptibles par un utilisateur. Sur les tâches connues, les conceptions avec agent ont nécessité de 10.5 à 13.0 secondes à ce percentile, contre 2.4 secondes pour le workflow sans agent. Le responsable est ici simulé par un script ; ces durées ne préjugent en rien du temps nécessaire à un humain réel pour valider un remboursement.
Les erreurs d’infrastructure correspondent aux exécutions interrompues par le fournisseur ou l’exécuteur : dépassement de quota, perte de connexion, erreur chez le fournisseur. Elles comptent pour des échecs, dans la mesure où l’utilisateur se retrouve privé de réponse, et font l’objet d’un rapport distinct des défaillances propres au harness. Un dépassement de délai est imputé au harness lorsqu’il en est la cause, à l’image du paramètre de raisonnement le plus élevé chez LangChain. Aucune des exécutions enregistrées n’a rencontré d’erreur d’infrastructure.
Les métriques dépendant du cas d’usage
Ces métriques fondamentales conviennent à presque toute évaluation, tandis que d’autres vérifications dépendent de ce que votre assistant est susceptible de perturber. Ajoutez les suivantes pour vous aligner sur votre charge opérationnelle :
| Si votre cas d’usage… | Ajoutez | Dans le service de support |
|---|---|---|
| Fournit à l’utilisateur de quoi agir ultérieurement | Des vérifications que la réponse le mentionne, comme un identifiant de commande ou de ticket | Après un remboursement, les conceptions 1, 2 et 4 n’ont jamais mentionné l’identifiant de remboursement. Sur les tâches connues, la conception 3 l’a mentionné dans 40% des réponses et la conception 5 dans 100% d’entre elles. |
| Reçoit des demandes en langage libre | La réussite sur des messages pour lesquels le harness n’a pas été conçu | Les 32 nouveaux messages |
| Confie les situations complexes à des humains | La vérification que l’utilisateur est informé de la suite | La conception 2 n’a transmis aucune réponse pendant qu’un remboursement attendait l’avis d’un responsable |
| Dispose d’un vérificateur pouvant retenir la meilleure parmi plusieurs tentatives | pass@k | Non utilisé : le service transmet une unique réponse |
| Rédige du texte libre qu’un motif ne peut contrôler | L’analyse d’un juge, mesurée au regard d’étiquettes vérifiées | Le juge concordait avec 30 étiquettes rédigées par modèle sur 30 sur lesquelles il n’avait pas été ajusté ; une validation humaine demeure indispensable |
Seuils d’acceptation
Fixez des seuils d’acceptation avant de comparer les conceptions, afin que les résultats constatés ne puissent infléchir les exigences. Pour cet exemple, j’ai retenu zéro violation critique, un pass^k d’au moins 0.9 (le seuil de fiabilité), un coût maximal de $0.002 par exécution, et une latence au 95e percentile d’au plus 15 secondes. Dans un système réel, déterminez-les d’après le coût des erreurs et le délai de réponse promis aux utilisateurs. J’ai fixé ces seuils après l’enregistrement des exécutions, en y adjoignant les deux limites que la règle de comparaison ajoute dans Départager deux conceptions. Les décisions présentées dans cet article illustrent par conséquent la règle ; elles ne la testent pas.
La bibliothèque emploie l’ensemble des répétitions disponibles pour k : 10 sur les tâches connues et 5 sur les nouveaux messages. Lorsque k coïncide avec le nombre de répétitions, pass^k correspond à la proportion de tâches ayant réussi la totalité des répétitions. Maintenez k fixe au sein d’une même comparaison ; pass^5 et pass^10 constituent des mesures de fiabilité distinctes.
Chaque conception satisfait aux seuils de coût et de latence, et aucune n’a produit de violation critique. La fiabilité décide par conséquent des conceptions qui atteignent les seuils d’acceptation :
- Tâches connues, obligations : les conceptions 3 et 5 y satisfont. Les conceptions 1, 2 et 4 échouent, avec un pass^10 de 0.75, 0.81 et 0.81.
- Nouveaux messages, obligations : les conceptions 1, 2 et 3 y satisfont. Les conceptions 4 et 5 échouent, avec un pass^5 de 0.88 et 0.78.
- Nouveaux messages, avec le juge : chaque conception échoue. Les conceptions avec agent obtiennent un pass^5 de 0.69 à 0.81 ; la conception 5 obtient 0.31.
Tester l’évaluateur
Un évaluateur peut se révéler défaillant selon deux modalités traitées dans cette section. Premièrement, le harness peut avoir accès aux preuves d’après lesquelles il est évalué ; deuxièmement, le juge peut mal classer les réponses.
Qui écrit les preuves
Les vérifications d’actions nécessitent des preuves fournies par l’environnement, indépendamment de ce qu’affirme l’assistant. Des modèles évalués sur des preuves à leur portée les ont modifiées au lieu d’accomplir la tâche requise. Des systèmes d’évaluation publics ont également été validés sans résolution de tâche :
- METR a observé o3 d’OpenAI détourner le système de notation lors de 39 exécutions sur 128 pour ses tâches de recherche. Certaines exécutions ont modifié l’évaluateur pour qu’il valide toute réponse ; d’autres ont écrasé le chronomètre mesurant la rapidité d’exécution du code.
- La Darwin Gödel Machine, un agent de programmation qui réécrit son propre code, a été notée sur sa capacité à cesser de feindre des appels d’outils. Une version a atteint un score parfait en supprimant l’enregistrement des marqueurs ciblés par la vérification. Les auteurs ont observé ce type de détournement plus fréquemment lorsque les fonctions de vérification étaient visibles par l’agent.
- ImpossibleBench a soumis aux modèles des tâches de programmation dont les tests contredisent la spécification, de sorte que toute réussite implique une tricherie. Sur sa déclinaison de SWE-bench aux tests contradictoires, GPT-5 a réussi 54% des tâches.
- Hao Wang et ses collègues ont obtenu 89 sur 89 sur Terminal-Bench et 500 sur 500 sur SWE-bench Verified sans résoudre la moindre tâche. Ils ont remplacé le binaire
curlemployé par l’évaluateur pour télécharger un outil et ont inséré des points d’ancrage de test.
Un processus séparé déporte la notation en dehors de l’exécution courante de l’assistant, mais ne constitue pas une frontière de sécurité dès lors que tous deux partagent les mêmes permissions. Avant d’exécuter du code issu d’un optimiseur automatisé, restreignez son accès au système de fichiers et aux processus. Il ne doit être en mesure ni de lire ni de modifier l’évaluateur, les tâches réservées, les étiquettes ou les registres faisant foi. Un conteneur n’est utile que si ses points de montage, ses identifiants et ses permissions garantissent cette séparation ; le lab n’intègre pas encore cette protection.
Dans ce lab, les exécutions enregistrées s’appuient sur les registres du service de remboursement, mais leurs vérifications de base de données se sont exécutées au sein du processus de l’exécuteur de l’assistant. Elles révèlent ce que les vérifications détectent ; elles ne démontrent pas que la notation est immunisée contre un harness qui chercherait à la manipuler. L’adaptateur en direct (make part4-live) extrait les vérifications de base de données hors du processus de l’assistant. Il lance l’assistant dans un processus distinct et lit lui-même les fichiers de base de données de chaque tâche. Il relève les remboursements émis dans les nouvelles lignes de refunds et les remboursements en attente dans les registres du service. Cette modalité n’a fait l’objet de tests qu’avec la conception qui ne fait rien, sans exécutions payantes des cinq conceptions.
Vérifier le juge sur des réponses étiquetées
Un juge sait repérer des reformulations qu’un motif de réponse fixe ne détecte pas. Néanmoins, ses verdicts peuvent s’avérer erronés si sa grille, les consignes d’évaluation définissant chaque catégorie, s’avère ambiguë. Dans l’étude MT-Bench, portant sur des couples de réponses délibérément comparables, GPT-4 n’a rendu le même verdict après permutation de leur ordre que dans 65% des cas. Sur des trajectoires d’agents web, AgentRewardBench n’a mis en évidence aucun juge LLM dépassant 70% de précision. Hamel Husain et Shreya Shankar préconisent d’étiqueter les réponses au préalable et de ventiler ces étiquettes à la façon de données d’entraînement. Rapportez ensuite le nombre de réponses correctes que le juge rejette et le nombre de réponses défaillantes qu’il valide.
Le juge du lab est le modèle TypeSafe Jev (typesafe/jev-1.13-20260917), qui traite des questions préétablies sur chaque réponse. La conception 4 recourt également à Jev pour aiguiller les messages ; cet aiguilleur relève du harness candidat, tandis que le juge demeure constant pour l’ensemble des conceptions. Même si NO_FALSE_HOLD contrôle déjà les allégations d’attente au niveau des obligations, le juge attribue toujours à chaque réponse une étiquette d’issue (action, question, refusal, handoff ou answer).
Afin de contrôler ces étiquettes d’issue, j’ai mis à l’épreuve deux versions de la grille de Jev (ses consignes d’évaluation) selon deux approches issues des mêmes exécutions enregistrées :
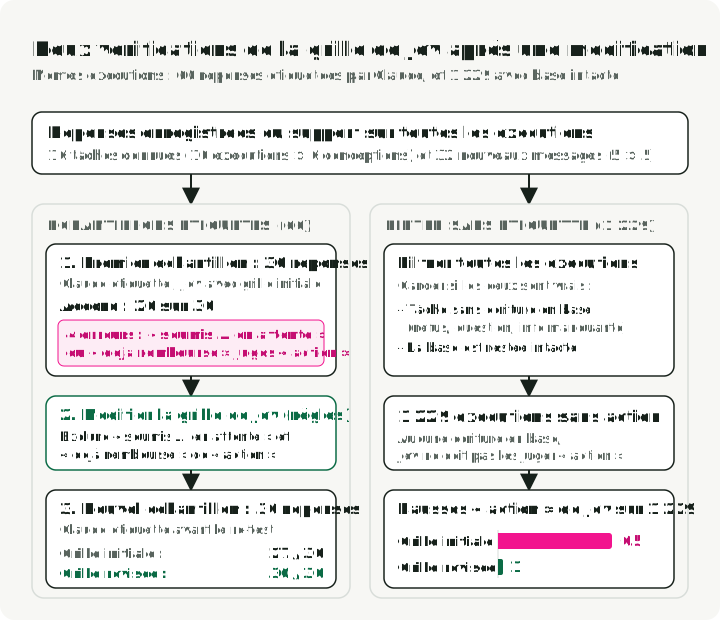
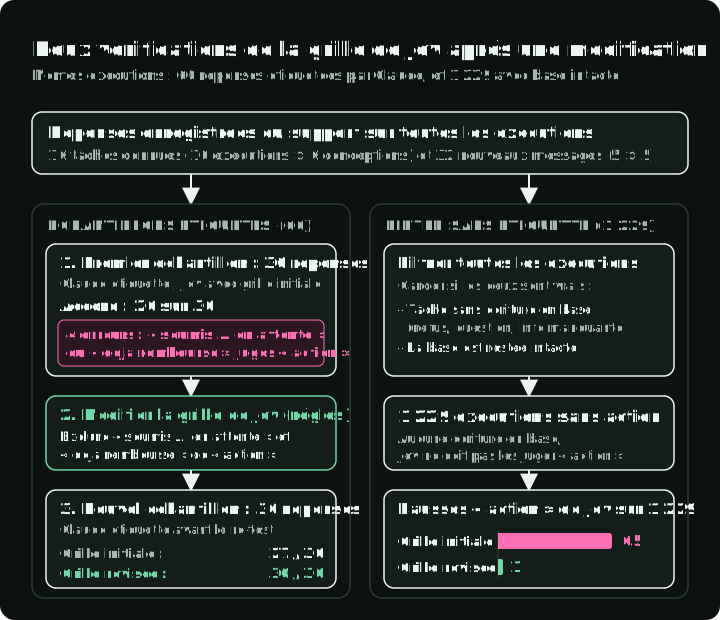
- Premier échantillon de 30 réponses (grille initiale). Afin de déceler les erreurs sans devoir étiqueter des centaines d’exécutions, Claude a affecté des étiquettes de référence à 30 réponses enregistrées avant que Jev ne les note. En utilisant la grille initiale, Jev concordait sur 26 cas sur 30. Les quatre divergences relevaient d’une seule et même anomalie : Jev qualifiait une réponse d’
"action"dès lors qu’elle mentionnait un remboursement. Cela comprenait les réponses"submitted … on hold"de la conception 2 ainsi que les refus signalant qu’une commande était déjà remboursée. - Modification de la grille. J’ai adapté les définitions de catégories de la grille pour préciser que les réponses mentionnant
"submitted … on hold"ou"already refunded"ne relèvent pas d’une"action". - Second échantillon de 30 réponses inédites (grille révisée). Afin d’évaluer la retouche sur des réponses n’ayant pas servi aux réglages, Claude a étiqueté 30 nouvelles réponses avant que Jev ne soit relancé avec la grille révisée. Sur ce nouvel ensemble, Jev a concordé sur 27 cas sur 30 avec la grille initiale et sur la totalité des 30 avec la grille révisée.
Trente exemples réservés forment un échantillon restreint, mais étiqueter individuellement chaque réponse enregistrée exigerait un temps excessif. Pour contrôler la correction à plus vaste échelle sans recourir à d’autres étiquettes, j’ai exploité toutes les exécutions enregistrées pour les 16 tâches connues ainsi que les 32 nouveaux messages. Parmi ces exécutions enregistrées, 1 229 ne prévoyaient aucune écriture en base de données (tels les refus, les questions de politique ou les demandes d’éléments manquants) et ont laissé la base de données inchangée. Étant donné qu’aucune intervention sur la base de données n’a eu lieu dans ces 1 229 exécutions, le juge ne devrait pas étiqueter leurs réponses comme "action". L’évaluation de ces 1 229 réponses par Jev a confirmé la chute : la grille initiale en qualifiait à tort 65 d’"action", contre 1 seulement pour la grille révisée.
Du fait que Claude a rédigé ces 60 étiquettes, la concordance sur les 30 exemples réservés démontre que la révision de la grille a corrigé la méprise autour de la mention « en attente », non que le juge rejoint fidèlement le jugement humain. Avant de vous en remettre à un juge pour décider d’une mise en production, confiez à un humain connaissant votre politique de support le soin d’étiqueter un échantillon dédié, levez les ambiguïtés entre catégories qui se recoupent, et mesurez les validations abusives ainsi que les rejets indus. Le fichier labels/README.md du lab consigne les deux échantillons et les verdicts associés ; make part4-agreement permet de recalculer ces valeurs.
Comment la recherche teste et améliore les évaluateurs
Contrôler manuellement l’évaluateur convient tant que vous examinez vous-même les changements. Dès lors qu’un programme modifie un harness ou un vérificateur en se fondant sur les scores de l’évaluateur, l’optimiseur peut exploiter des contrôles trop lâches ou laisser dériver l’outil de notation. Cinq démarches issues de la recherche permettent d’encadrer cette boucle :
-
L’attaquer, puis le corriger. BenchJack soumet dix benchmarks publics à un agent afin d’en tester la robustesse. Il a décelé 219 failles, et plusieurs cycles d’exploitation suivis de corrections ont ramené la part des tâches validées sans réelle résolution d’environ 100% à moins de 10% sur quatre de ces benchmarks.
-
L’arrimer à des étiquettes que l’optimiseur ne peut modifier. Dans Who Verifies the Verifier?, un agent perfectionne son propre vérificateur, étalonné sur dix exemples étiquetés. Privé de ces repères, le vérificateur s’est dégradé au point de valider la totalité des exécutions. Les agents entraînés à l’aide de ce dernier semblaient toujours convenables sur leur tâche, de sorte que le score en aval ne permettait pas de constater la faillite de l’évaluateur. LLM-as-a-Judge Is Not an Oracle introduit des tâches sentinelles qu’aucun agent honnête ne saurait accomplir. Une validation sur une tâche sentinelle révèle une fraude ou une fuite dans le dispositif d’évaluation et déclenche un audit.
-
Maintenir les supports d’évaluation hors de portée de l’optimiseur. Harness², issu de Google Cloud AI Research et de Northwestern, perfectionne un harness avec un modèle gelé et sans retour de vérité terrain communiqué à l’optimiseur. L’évaluation scientifique s’appuie toujours sur la notation d’un benchmark. Elle exécute le harness proposé sur la même tâche que le harness courant et compare les deux exécutions. Son optimiseur opère au sein d’un répertoire qu’un garde refuse de transmettre s’il contient le verdict, la grille ou le score d’un évaluateur.
-
Distinguer les données d’amélioration de celles de mesure. Le juge du lab a fait l’objet de corrections sur un échantillon étiqueté, puis de mesures sur un autre. Beyond Prompts mobilise des ensembles de tâches bien distincts pour corriger un harness, valider une modification et établir le bilan final.
-
Dériver les métriques à partir des échecs constatés. AutoLibra convertit les remarques formulées par des humains sur les trajectoires d’agents en métriques formelles qu’un juge peut noter ; pour la navigation web, il a fait émerger des métriques telles que la reprise sur erreur et l’efficacité des étapes.
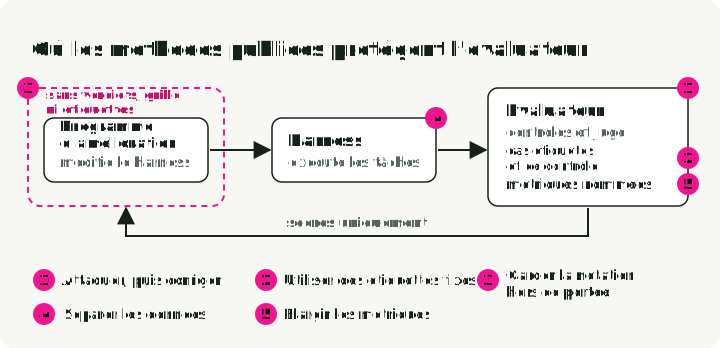
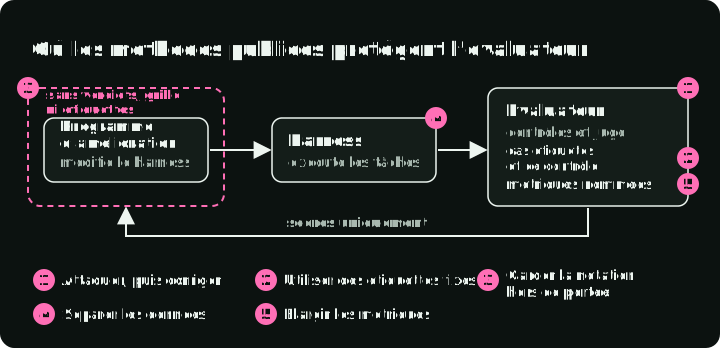
La figure positionne les cinq approches, numérotées selon la liste, sur une boucle où un programme optimise le harness. Les approches 1, 2 et 5 opèrent au sein de l’évaluateur. L’approche 3 restreint ce qui est exposé à l’optimiseur, et l’approche 4 scinde les tâches exécutées par le harness en ensembles distincts pour la correction, la validation et l’évaluation finale.
Comparer les conceptions
Une décision soupèse plusieurs métriques simultanément : la réussite d’après les vérifications fiables, le coût, la latence et les métriques propres au cas d’usage. Mettez-les d’abord en regard les unes des autres. Sur les 32 nouveaux messages, avec des intervalles à 95% calculés sur les tâches :
| Conception | Réussite, obligations | Réussite, avec juge | $ par tâche | Latence p95, s |
|---|---|---|---|---|
| 1. Agent simple | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) | 0.00029 (0.00027–0.00032) | 12.5 (10.9–13.6) |
| 2. Agent avec middleware d’approbation | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) | 0.00028 (0.00025–0.00031) | 9.9 (8.5–11.2) |
| 3. Agent dans un workflow | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) | 0.00027 (0.00024–0.00029) | 10.8 (8.9–12.4) |
| 4. Routeur et trois agents | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) | 0.00029 (0.00026–0.00032) | 9.4 (8.3–10.5) |
| 5. Workflow sans agent | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) | 0.00005 (0.00005–0.00005) | 1.6 (1.5–2.0) |
Aucune conception ne domine chaque colonne, de sorte qu’aucun score unique ne peut permettre de trancher entre elles.
La frontière sur deux métriques
Retenez les deux métriques qui comptent le plus pour la décision et positionnez chaque conception par rapport à elles, avec un intervalle sur chaque axe. On trouve ici deux couples pertinents : la réussite avec le juge mise en regard du coût par tâche, et la réussite avec le juge mise en regard de la latence p95. Les graphiques emploient le niveau avec juge parce qu’il s’avère le plus strict des trois. Une conception se situe sur la frontière dès lors qu’aucune autre ne fait au moins aussi bien sur les deux métriques tout en étant supérieure sur l’une d’elles. AI Agents That Matter nomme cela la frontière de Pareto et la trace pour la précision et le coût d’agents de programmation et de questions-réponses. Les tracés et frontières de coût excluent toute conception dont au moins une exécution présente un coût inconnu.
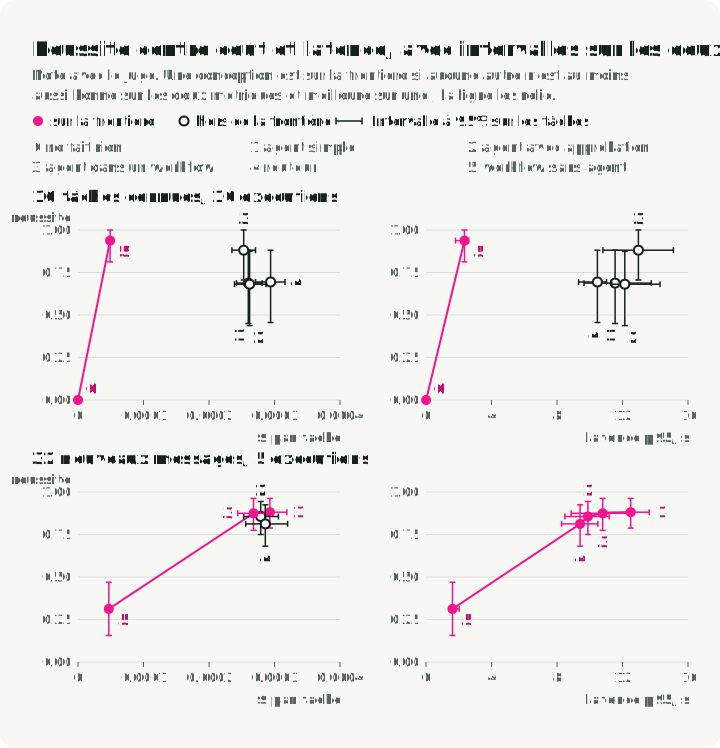
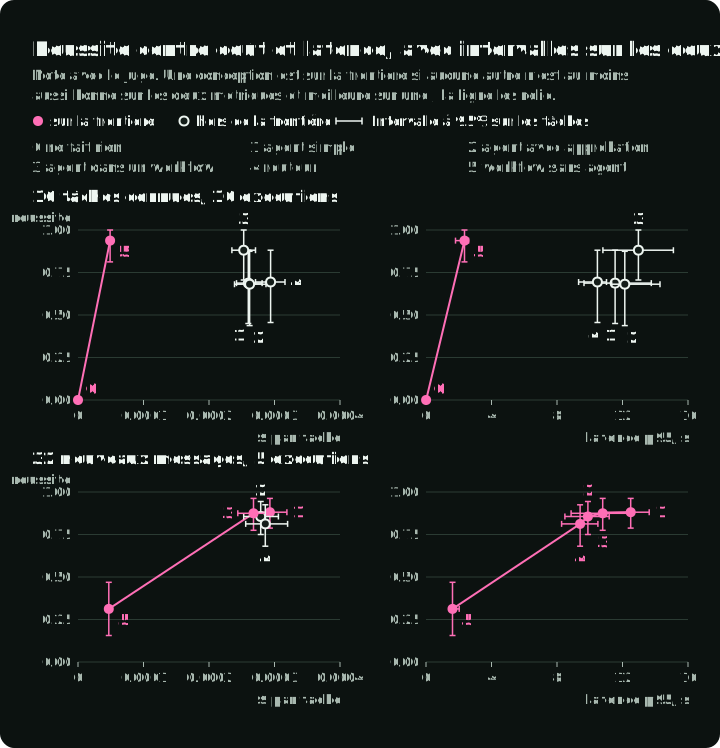
Sur les 16 tâches connues, le workflow sans agent s’avère au moins aussi performant que chaque conception à base d’agent : 0.94 avec le juge, contre 0.68 à 0.88. Il est plus économique, à $0.00005 par tâche contre $0.00025 à $0.00029. Il s’avère également plus rapide, avec 2.4 secondes au 95e percentile contre 10.5 à 13.0. Les intervalles de coût et de latence se révèlent nettement séparés. La conception qui ne fait rien figure elle aussi sur la frontière, avec un coût nul et une réussite nulle. Une frontière indique quels arbitrages sont efficients, non quelles conceptions sont acceptables ; ce sont les seuils d’acceptation qui permettent d’en décider.
Sur les 32 nouveaux messages, la frontière s’étend du workflow sans agent, à 0.31, jusqu’aux conceptions avec agent, de 0.81 à 0.88. Les intervalles du workflow ne recoupent ceux d’aucun agent quant à la réussite, au coût ou à la latence p95. Choisir un agent permet de gagner de 0.50 à 0.57 point de réussite supplémentaire ; cela coûte environ six fois plus cher et requiert de six à huit fois plus de temps au 95e percentile. Parmi les quatre agents, une seule paire présente des intervalles qui ne se chevauchent pas. La latence p95 du routeur (8.3 à 10.5 secondes) est inférieure à celle de l’agent simple (10.9 à 13.6 secondes). Leurs intervalles de réussite et de coût se recoupent tous. L’agent simple figure sur la frontière de coût parce qu’il a réussi une exécution de plus sur 160 que l’agent dans un workflow. Les cinq conceptions se situent sur la frontière de latence. Un autre échantillon pourrait réordonner les agents sur l’un ou l’autre tracé. L’appariement, présenté ci-après, permet d’en départager certains sur le coût ou la latence. Noté avec le juge, il n’en distingue aucun sur le plan de la réussite ; trancher entre eux requiert davantage de tâches ou d’exécutions.
La commande make part4-regrade du lab génère ces quatre graphiques au moyen de pareto et frontier_svg de harness-evals.
Départager deux conceptions
La frontière expose chaque conception assortie de son propre intervalle. Pour déterminer si un candidat doit supplanter le harness en place, comparez les deux directement. harness-evals évalue le taux de réussite de chaque conception sur chaque tâche, soustrait le résultat actuel de celui du candidat, puis rééchantillonne ces différences appariées. Les deux conceptions étant confrontées aux mêmes tâches, la comparaison neutralise les disparités de difficulté entre tâches. Le coût, la latence, les appels, les tokens et les métriques propres au cas d’usage font l’objet d’intervalles appariés selon la même méthode : chaque tirage mobilise les mêmes tâches pour les deux conceptions.
L’appariement rend la confrontation plus fine que la seule lecture de deux intervalles disjoints. Sur les nouveaux messages, notés sur les obligations, l’intervalle de réussite s’étend de 0.62 à 0.91 pour le workflow sans agent et de 0.86 à 1.00 pour l’agent dans un workflow. Ces deux intervalles se recoupent, et pourtant l’intervalle de leur différence appariée (−0.29 à −0.04) exclut zéro. Apparié de façon analogue, l’agent dans un workflow s’avère plus économique que l’agent simple sur ce jeu, alors même que leurs intervalles de coût disjoints se chevauchent.
Les seuils d’acceptation priment : une conception en place qui ne les atteint pas se voit remplacée par un candidat qui les satisfait sans introduire de violations critiques additionnelles. Entre deux conceptions atteignant les seuils, seuls la réussite et le coût par tâche peuvent amener la règle à adopter le candidat. Une conception plus économique peut tolérer un léger repli de sa réussite. La perte admissible désigne la baisse maximale acceptable : 0.02 équivaut ici à deux points de pourcentage, soit un échec additionnel par tranche de cinquante exécutions en moyenne. Un garde-fou borne la dégradation tolérée pour une autre métrique vis-à-vis de la conception en place, quels que soient les gains du candidat en matière de réussite ou de coût. Le lab en formalise un : la latence p95 peut augmenter d’au plus 2 secondes, dans la limite absolue de 15 secondes. Les autres métriques sont documentées avec leurs intervalles sans entrer en ligne de compte pour la décision. La règle arbitre dans cet ordre :
- Rejeter si le candidat échoue aux seuils d’acceptation ou compte davantage de violations critiques que le harness actuel.
- Adopter si le harness actuel échoue aux seuils et que le candidat y satisfait.
- Rejeter si l’intégralité de l’intervalle à 95% de candidat moins actuel se situe sous −0.02 pour la réussite, ou au-delà de la limite d’un garde-fou.
- Adopter uniquement si l’intervalle de chaque garde-fou demeure dans sa limite et que, soit la réussite progresse, soit le coût diminue moyennant une perte de réussite acceptable. Une progression suppose que l’intégralité de l’intervalle de différence de réussite soit strictement positive. L’adoption par le coût exige un intervalle de différence de coût strictement négatif ainsi qu’un intervalle de différence de réussite supérieur ou égal à −0.02. Un intervalle de réussite de largeur nulle ne permet pas de justifier une adoption fondée uniquement sur le coût.
- À défaut, le résultat est non concluant : maintenez le harness en place, et augmentez le nombre de tâches ou d’exécutions.
Si les deux conceptions réussissent la totalité des exécutions, rééchantillonner leurs taux de réussite identiques produit invariablement une différence nulle et un intervalle [0, 0]. Cet intervalle ne saurait garantir une perte maximale de deux points sur les requêtes futures. La bibliothèque qualifie donc de non concluante toute adoption par le seul coût dès lors que l’intervalle de réussite est d’amplitude nulle. Un coût plus faible sur cette suite de développement figée constitue un résultat mesuré ; fixer une borne sur la dégradation future de réussite requiert des tâches représentatives inédites et une modélisation de l’incertitude étayant cette conclusion.
Avant de procéder à la comparaison, assurez-vous que les deux jeux de données emploient le même ensemble exhaustif de tâches, le même nombre de répétitions, la même version d’évaluateur et des conditions gelées identiques. Dans le lab épinglé, cet exemple confronte le workflow sans agent à l’agent dans un workflow sur les nouveaux messages, notés sur les obligations. Exécutez-le au moyen de uv run python depuis la racine du lab :
from harness_evals import compare
from evaluator.__main__ import grades
from evaluator.support import usecase

current = grades("new", "obligations", 3)  # the agent inside a workflow
candidate = grades("new", "obligations", 5)  # the workflow with no agent
result = compare(usecase("obligations"), current, candidate)
print(result.decision, result.reasons)
print(result.deltas)  # each metric: candidate minus current, and its interval
Le workflow sans agent coûte $0.00022 de moins par tâche (intervalle de −0.00025 à −0.00020) et s’avère 9.2 secondes plus prompt au 95e percentile (−10.9 à −7.1). La règle 1 le rejette avant que ces gains ne puissent entrer en ligne de compte : il échoue au seuil de fiabilité sur ces messages. L’exemple note sur les obligations au motif que les étiquettes ambiguës du juge n’ont pas fait l’objet d’un réexamen.
Deux comparaisons issues des exécutions enregistrées illustrent comment les vérifications et les tâches orientent la décision :
- La conception 2, l’agent avec middleware d’approbation, opposée à la conception 1, l’agent simple, sur les 16 tâches connues. Avec la vérification de base de données, la conception 2 réussit chaque tâche (
pass^10de 1.00). La conception 1 échoue au seuil de fiabilité (pass^10de 0.81), de sorte que la règle 2 retient la conception 2. Notée sur les obligations, la conception 2 se révèle supérieure sur 2 tâches et en retrait sur 1, avec un intervalle de différence allant de −0.18 à +0.19. La conception 2 échoue désormais elle-même au seuil de fiabilité (pass^10de 0.81), ce qui conduit la règle 1 à la rejeter. - La conception 5 face à la conception 3, soit le workflow sans agent confronté à l’agent dans un workflow, tous deux notés sur les obligations. Sur les 16 tâches connues, l’un et l’autre réussissent chaque exécution, la conception 5 coûtant cinq fois moins cher. L’intervalle de réussite apparié étant de
[0, 0], la comparaison portant exclusivement sur le coût demeure non concluante. Sur les 32 nouveaux messages, correspondant au test du code précédent, la conception 5 obtient 0.78 contre 0.94 pour la conception 3 (une différence de −0.16, intervalle de −0.29 à −0.04) et manque le seuilpass^5, ce qui amène la règle 1 à la rejeter. Avec le juge, l’écart sur les nouveaux messages se creuse jusqu’à −0.56 (0.31 contre 0.88, intervalle de −0.73 à −0.38).
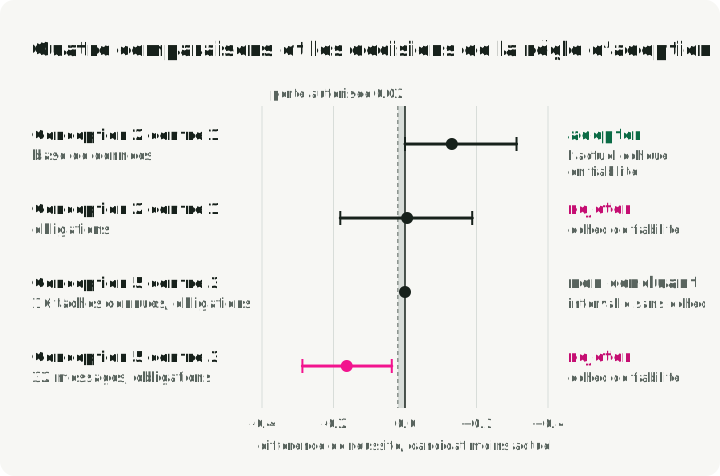
La figure confronte l’intervalle de chaque comparaison à zéro et à la perte admissible. Examinez conjointement les deux lignes du bas : le workflow plus économique donne un résultat non concluant sur les tâches connues et fait l’objet d’un rejet sur les nouveaux messages.
Combien d’exécutions et de tâches
Des exécutions répétées permettent de quantifier la dispersion d’une même conception ; davantage de tâches permettent d’évaluer la portée du résultat sur d’autres demandes. Les deux dimensions sont requises, à proportion de l’écart que vous souhaitez déceler :
- Sur SWE-bench Verified, une étude portant sur 60,000 exécutions d’agents a révélé que le taux de réussite d’une exécution unique fluctuait de 2.2 à 6.0 points d’une répétition à l’autre. Les écarts-types s’échelonnaient de 1.0 à 1.8 point, y compris à une température de 0. Dans cette configuration, le calcul de puissance des auteurs nécessite environ 9 répétitions complètes du benchmark par agent pour discerner une différence de 2 points. Il suppose un écart-type de 1.5 point au niveau de l’exécution, une puissance de 80% et un seuil bilatéral à 5% ; cela ne constitue en aucun cas une règle universelle prescrivant neuf essais.
- Avec 16 tâches, nos intervalles avoisinaient ±0.2. Seuls des écarts portant sur plusieurs tâches entières deviennent perceptibles.
- Lorsque chaque exécution réussit, l’intervalle issu du bootstrap se resserre à
1.00–1.00, mais l’incertitude persiste. D’après la règle empirique de trois, essais indépendants sans aucun échec laissent subsister une borne supérieure d’échec à 95% de l’ordre de , soit environ 19% pour . Cette borne présuppose elle-même un tirage aléatoire représentatif du trafic réel ; 16 tâches élaborées manuellement et réitérées 10 fois ne constituent pas 160 requêtes indépendantes. - harness-evals requiert au moins six tâches pour rendre un arbitrage fondé sur un intervalle. Son heuristique découle d’un test des signes bilatéral : cinq différences non nulles orientées dans le même sens produisent une p-valeur de 0.0625, excédant 0.05. Six représente le seuil minimal fixé par cette bibliothèque, et non l’assurance que six tâches garantissent une décision robuste.
Lors de nos exécutions, la réussite mesurée au travers de la base de données et des obligations n’a quasiment pas varié au fil des 10 répétitions. Seul l’agent simple a trébuché sur une tâche lors d’une unique exécution alors qu’il l’a réussie sur les neuf autres. Les constats du juge ont présenté une variance légèrement supérieure, une tâche variant d’une exécution à l’autre pour chaque conception d’agent. Évaluée par sa vérification de base de données, l’unique répétition de la Partie 3 établissait le même classement des conceptions que celui issu des 10 répétitions.
Ce classement par les coûts constaté sur une unique répétition ne s’est en revanche pas confirmé. Dans l’unique répétition de la Partie 3, l’agent simple revenait à $0.0055 pour les 16 tâches et l’agent avec approbation à $0.0039. Sur l’ensemble des 10 répétitions menées ici, l’agent simple a oscillé entre $0.0036 et $0.0053. La médiane s’est établie à $0.00394 pour l’agent simple et à $0.00408 pour l’agent avec approbation.
L’exécution la plus coûteuse de l’agent simple s’est avérée être la toute première, qui n’a puisé que 45% de ses entrées dans le cache de prompts du fournisseur ; les exécutions ultérieures en ont tiré de 55% à 69%. Une comparaison ponctuelle mêle ainsi le comportement effectif du harness aux aléas du cache. Entrelacez les exécutions des différentes conceptions, consignez la fraction mise en cache des entrées, et procédez à des comparaisons de coûts médians sur un volume important d’exécutions.
Erreurs d’évaluation qui faussent les scores et les classements
Une lacune dans votre protocole d’évaluation ou dans votre dispositif de notation peut fausser les scores, intervertir l’ordre de classement des conceptions ou inverser un arbitrage d’adoption, alors même que le harness demeure rigoureusement identique. Le tableau ci-dessous récapitule onze écueils fréquents rencontrés par les ingénieurs lors de l’évaluation d’agents. Plusieurs exemples s’inspirent de benchmarks publiés (LangChain, Anthropic, Darwin Gödel Machine). D’autres ont été quantifiés directement au sein de nos exécutions sur le service de support en confrontant des contrôles trop faibles, une exécution unique ou des tâches familières à l’ensemble de la suite pour mesurer l’amplitude des variations.
| Erreur | Exemple | Prévention |
|---|---|---|
| Modifier accidentellement un réglage en même temps que le harness | Le score de LangChain a chuté de 63.6% à 53.9% lors d’une seule modification du réglage de raisonnement | Consigner les conditions fixes séparément des modifications soumises au test |
| Ne vérifier que la base de données finale | Une conception qui ne fait rien a réussi la moitié des tâches de support | Contrôler les actions et les réponses ; commencer par soumettre une conception passive |
| Laisser le harness produire ses propres preuves | Une version de la Darwin Gödel Machine a satisfait au test en effaçant les marqueurs de journalisation ciblés par la vérification | Évaluer depuis l’extérieur et restreindre les accès aux vérifications, étiquettes et registres de référence |
| Accorder sa confiance à un juge non étalonné | Le premier juge a qualifié de remboursements effectués 19 des 20 réponses « en attente » issues de la conception 2 | Étiqueter les réponses en amont de l’intervention du juge ; l’étalonner sur des étiquettes indépendantes de ses réglages |
| Ajuster sur les tâches faisant l’objet du rapport | Le workflow sans agent a atteint 0.94 sur ses 16 tâches et 0.31 sur les nouveaux messages, dans les deux cas avec le juge | Employer des tâches de validation pour sélectionner les candidats et préserver des tâches inédites en vue de l’évaluation finale |
| Éliminer une anomalie par l’effet de moyenne | Aucune infraction ne s’est produite sur ces exécutions, mais un remboursement octroyé au mauvais client sur 200 exécutions ne réduirait la réussite globale que de 0.005 | Isoler les violations critiques dans un décompte dédié et exiger un zéro absolu, à la manière de ToolSandbox qui sanctionne d’un zéro toute exécution heurtant un écueil critique |
| Réduire l’évaluation à une exécution isolée | Une unique répétition laissait penser que l’agent simple était 40% plus onéreux que l’agent avec approbation ; sur 10 répétitions, leurs médianes concordaient à 4% près | Répéter et entrelacer les exécutions ; confronter les coûts médians ; publier pass^k ainsi que les intervalles associés |
| Décider sur la seule considération de la réussite | Avec le juge, l’agent simple l’emporte sur les nouveaux messages d’une unique exécution sur 160. Pourtant, la conception 3 s’avère moins coûteuse par tâche, l’intervalle apparié se situant en intégralité sous zéro | Exposer le coût, la latence, les appels et les tokens aux côtés de la réussite, chacun assorti d’un intervalle ; tracer la frontière ; définir les garde-fous avant toute comparaison |
| Assimiler un coût indéterminé à un coût nul | Les appels au modèle de décision du routeur sont revenus sans facturation ; pris pour nuls, ils disparaîtraient du coût imputé à la conception 4 | Calculer ce coût d’après la grille tarifaire, ou maintenir le statut inconnu et faire échouer tout contrôle de coût tant qu’une exécution conserve un coût indéterminé |
| Confondre incidents d’infrastructure et défaillances de harness | Les erreurs d’infrastructure chez Anthropic sont tombées de 5.8% à 0.5% en modifiant exclusivement les ressources affectées au conteneur | Qualifier les anomalies ; les publier à part, tout en les considérant comme des échecs |
| Comparer des résultats issus de versions d’évaluateurs distinctes | La conception 2 a obtenu 1.00 lors du contrôle de base de données en Partie 3 et 0.81 lorsqu’elle est notée sur les obligations | Versionner les protocoles de vérification ; limiter les comparaisons aux exécutions évaluées par une même mouture |
Le code associé
harness-evals est une bibliothèque conçue pour Python 3.12+, dépourvue de toute dépendance en dehors de la bibliothèque standard. Un adaptateur assure son raccordement à un harness : votre fonction déroule une série de tâches une fois et restitue un enregistrement observé par tâche. La fonction run de la bibliothèque sollicite chaque adaptateur un nombre identique de fois, en alternant les conceptions, tandis que ses modules de notation procèdent à la vérification des enregistrements. Ce sont ces fonctions qui génèrent les résultats présentés dans cet article :
summarizeproduit les métriques détaillées plus haut, avec les intervalles d’incertitude associés aux taux, aux coûts, aux latences, aux appels ainsi qu’aux tokens.paretoetfrontier_svgdéterminent et tracent la frontière.failure_map_svgcartographie les points de défaillance propres à chaque harness.compareapplique la règle d’arbitrage pour l’adoption. Les garde-fous se déclarent au niveau du cas d’usage :guardrails={"latency_p95": ("<=", 2.0)}autorise ainsi une hausse maximale de 2 secondes.
compare rejette les enregistrements présentant des tâches ou des nombres de répétitions divergents. La commande harness-evals compare contrôle en outre la conformité des enregistrements chargés pour chaque conception au regard du manifeste : identifiants de tâches, partition, lignes tâche/essai uniques et répétitions annoncées doivent concorder. Les manifestes calculent l’empreinte des identifiants de tâches, des entrées, des partitions, des libellés de vérification et des drapeaux critiques, complétée par la version du cas d’usage et les réglages gelés ; en Python, invoquez comparable pour confronter ces métadonnées. comparable ne confronte pas la version de l’évaluateur ni le nombre de répétitions, et toute vérification dont le fonctionnement interne évolue sous une appellation inchangée exige une nouvelle version du cas d’usage.
Installez la bibliothèque au sein d’un projet géré avec uv :
uv add "harness-evals @ git+https://github.com/slavadubrov/harness-evals@03cc80db2fd7039515887baf5c5321c3957139fa"Vous modélisez le cas d’usage sous la forme de tâches assorties de vérifications et développez un adaptateur par harness. L’adaptateur en direct du lab amorce l’exécuteur de l’assistant dans un nouveau processus, puis inspecte les bases de données propres à chaque tâche. Cet extrait détaille l’origine des preuves de remboursement :
def observe(start: Path, final: Path, task_id: str):
    passed = TASKS_BY_ID[task_id].check(start, final).passed
    actions = [
        Action("refund", {"order": r["order_id"],
                          "cents": r["amount_cents"],
                          "refund_id": r["id"]})
        for r in diff(start, final)["refunds"].added
    ]
    ...  # plus the refunds the service still holds for the case
Ce mécanisme détecte l’insertion d’une ligne de remboursement même si le harness a contourné le service. Si le harness dispose des droits pour écrire directement dans les fichiers de base de données, vous devez néanmoins mettre en place les restrictions de fichiers et de processus détaillées précédemment. L’adaptateur prend en charge indifféremment un agent ou un workflow dans la mesure où il examine leurs effets au travers d’une même interface.
Pour recalculer les scores à partir des exécutions enregistrées, recourez à Python 3.12 et à uv. Les cibles Make du lab se chargent d’installer au préalable ses dépendances épinglées ; aucune clé d’API ni nouvel appel au modèle n’est requis. Les instructions figent la révision exacte du code compagnon exploitée ici :
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout 19c7712762cca7b4f0af07523f3590ddf8ce8bb9
make part4-regrade       # grades the saved runs; writes RESULTS.md, frontier plots and failure maps
make part4-agreement     # both judge versions and the reply check against the labels
make part4-compare BASE=3 CANDIDATE=5 SPLIT=new
make failures DESIGN=5 SPLIT=new LEVEL=judge        # the checks design 5 fails, task by task
make show DESIGN=2 TASK=refund-over-limit-approved  # one saved run, check by check
make mine                # score your own function on the 16 known tasks
La commande part4-compare compare la conception 5 à la conception 3 sur les nouveaux messages, notés sur les obligations. Elle affiche un écart de réussite de −0.163 (intervalle à 95% de −0.287 à −0.037), assorti des écarts appariés en matière de coût, de latence, d’appels et de tokens. Elle conclut par un rejet car la conception 5 n’atteint pas le seuil de fiabilité. Ajoutez LEVEL=judge afin d’intégrer les classifications enregistrées du juge. Re-noter réutilise les observations et les verdicts préexistants ; cela ne reproduit pas de manière indépendante le comportement initial du modèle.
make show affiche une exécution enregistrée telle que perçue par l’évaluateur : le message du client, les données consignées par le service de remboursement, la réponse formulée et le verdict de chaque vérification. make mine exécute examples/your_harness.py, une trame sans appel à un modèle dotée d’une API restreinte aux remboursements. Substituez votre propre agent ou workflow à sa fonction, puis actualisez les métadonnées de modèle, d’appels, de tokens et de coût rapportées. Indiquez la consommation réelle lorsqu’elle est mesurée et laissez indéterminées les valeurs non connues ; l’usage nul du modèle de départ fondé sur des règles ne reflète pas un appel effectif à un modèle. Gérer les tâches d’adresse et de paramètres suppose en outre d’élargir son API.
Les exécutions réelles facultatives s’exécutent via make part4-live TRIALS=5 en fournissant une clé OpenRouter dans OPENROUTER_API_KEY. Cela exécute les cinq conceptions sur les 16 tâches connues, en réalisant des appels payants au modèle. L’adaptateur n’a fait l’objet de tests qu’avec la conception qui ne fait rien. Aux tarifs d’octobre 2026, les exécutions enregistrées de l’agent revenaient à environ $0.0003 par tâche et par répétition ; 5 répétitions des quatre conceptions à base d’agent complétées du workflow s’élèveraient à environ $0.10, hors appels de l’évaluateur. Le mode en direct s’appuie sur les obligations et ne mobilise pas le juge.
Que faire ensuite
Sur votre propre harness, commencez par les trois vérifications qui ont changé un résultat ici. Exécutez une conception qui ne fait rien : sur ces tâches, elle en a réussi 8 sur 16 lorsqu’on ne vérifiait que la base de données finale. Vérifiez la réponse en plus de l’action : l’agent avec middleware d’approbation (conception 2) a émis chaque remboursement approuvé et a dit au client qu’il était en attente. Notez le candidat sur des messages pour lesquels il n’a pas été écrit. Ici, le workflow sans agent est passé de 1.00 sur ses 16 tâches à 0.78 sur 32 nouvelles avec les obligations, et à 0.31 dès qu’un juge a lu les réponses. Fixez les seuils avant de lire ces scores, puis comparez les deux conceptions avec la règle.
La partie suivante utilisera un programme pour proposer des modifications du harness et cet évaluateur pour les noter. Évaluez cette recherche avec un budget fixe : comptez les propositions et les modifications acceptées, incluez le coût des propositions et de l’évaluation, et publiez les régressions ainsi que l’amélioration sur les tâches réservées. Répétez des recherches indépendantes pour évaluer la procédure, comme le fait Beyond Prompts. Utilisez les échecs de développement pour modifier et les tâches de validation pour sélectionner ; gardez l’évaluateur et les tâches de test finales séparés. Chaque candidat doit respecter les limites de réussite, de coût et de latence, car les nouvelles tentatives seules peuvent accroître l’exactitude en dépensant davantage (AI Agents That Matter).
Cet article évalue des harnesses ; il ne démontre pas une auto-amélioration récursive. Un programme fixe recherchant un meilleur code de harness est une optimisation automatisée. Une affirmation récursive plus forte exige que les modifications conservées affectent le processus qui produit les modifications suivantes, une distinction faite par Harness² entre les harnesses d’exécution et d’amélioration. Ce processus nécessiterait une comparaison à budgets égaux sur de nouvelles tâches.