Как оценивать харнесс агента при неизменной модели
Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Эта статья для инженеров, которым нужно решить, помогает ли изменение ИИ-агента или рабочего процесса лучше выполнять его бизнес-задачу. Харнесс — это код вокруг языковой модели: промпты, инструменты, порядок выполнения, память, проверки и повторные попытки. Вы узнаете, как зафиксировать модель, проверить действия харнесса и его сообщения пользователю, сопоставить успех со стоимостью и латентностью и решить, стоит ли заменять текущую реализацию кандидатом.
В разобранном примере ассистент поддержки интернет-магазина должен получать одобрение руководителя для возвратов свыше $200. Проверка только итоговой базы данных показала идеальный результат у агента с middleware согласования, хотя клиентам он говорил, что уже выполненные возвраты всё ещё ожидают одобрения. Проверка действий и ответов обнаруживает эту ошибку. Тесты на сообщениях, под которые не писалась ни одна реализация, показывают ограничения более дешёвого рабочего процесса: один вызов модели разбирает сообщение, а код выполняет шаги.
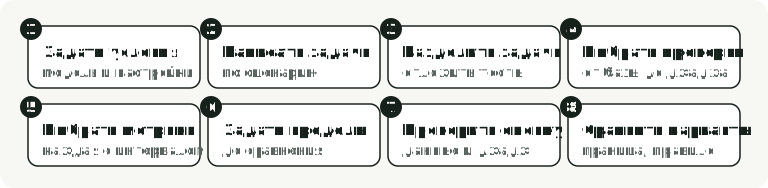
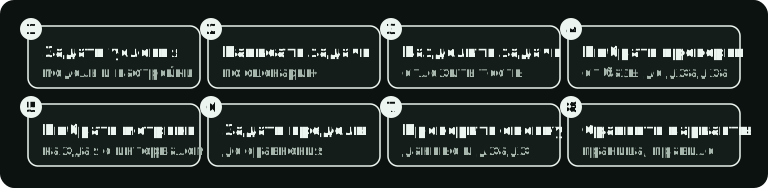
Оценка состоит из восьми шагов, которым по порядку следуют разделы ниже.
Что меняется при оценке харнесса
При сравнении моделей промпты, инструменты и цикл выполнения остаются неизменными, а модель меняется. При сравнении харнессов модель остаётся неизменной, а код вокруг неё меняется. Повторные запуски и интервалы неопределённости помогают отличить улучшение харнесса от случайных различий между запусками.
Руководство Anthropic Demystifying evals for AI agents различает две части. Харнесс агента позволяет модели действовать как агент; харнесс оценки запускает задачи, записывает каждую попытку и оценивает её. Здесь я называю второй эвалуатором. Так можно оценивать и агента, который сам выбирает шаги, и рабочий процесс, чьи шаги заданы кодом.
Насколько харнесс может изменить результат? Опубликованные сравнения с неизменной моделью дают диапазон:
- В статье о Terminal-Bench 2.0 несколько агентов запускали с одними и теми же моделями, каждого не менее пяти раз. GPT-5 решил 49.6% задач в Codex CLI и 33.9% в mini-SWE-agent: разница 15.7 пункта. Claude Opus 4.5 решил 57.8% в Terminus 2 и 52.1% в Claude Code: разница 5.7 пункта. При этом авторы заключают, что выбор модели обычно был важнее выбора агента.
- LangChain поднял результат своего deepagents CLI на Terminal-Bench 2.0 с 52.8% до 66.5%, изменив харнесс вокруг
gpt-5.2-codex, в том числе объём ризонинга на каждом этапе задачи. - В AutoHarness от Google DeepMind Gemini 2.5 Flash пишет код, который отклоняет недопустимые ходы до их передачи игре. С этим кодом Flash выиграл 9 из 16 игр для двух игроков у более крупной Gemini 2.5 Pro.
Эти результаты показывают, что изменение харнесса может сдвинуть оценку на 5–16 пунктов или позволить меньшей модели обойти большую. Размер улучшения различался, поэтому измеряйте его для своего харнесса и модели и повторяйте измерения при смене модели.
Фиксируйте не только название модели, но и следующее:
- Модель и её версию, а также эндпоинт провайдера, который её обслуживает. Роутер вроде OpenRouter может отправить запрос другому провайдеру, если не закрепить одного.
- Настройки сэмплирования и ризонинга, если их изменение не является предметом эксперимента. В эксперименте LangChain максимальный уровень ризонинга вместо высокого снизил оценку с 63.6% до 53.9%: больше задач не уложились в отведённое время. Если кандидат задаёт разный уровень для разных этапов, запишите эту политику как часть кандидата. Сохраняйте остальные условия фиксированными.
- Машину, на которой выполняются задачи. Anthropic изменил только ресурсы контейнера в запусках Terminal-Bench 2.0 и сдвинул оценку на величину до 6 пунктов. Команда заключает, что к разнице менее 3 пунктов в таблице результатов стоит относиться скептически, пока условия не описаны и не выровнены.
- Задачи, проверки и версию эвалуатора. Изменённая проверка означает другую оценку.
Менять можно промпты, определения инструментов, цикл или граф рабочего процесса, middleware, повторные попытки, шаблоны ответов и дополнительные модели. Ошибки, стоимость и латентность дополнительной модели учитывайте у того харнесса, который её использует.
Проверяемые реализации поддержки
Чтобы увидеть эту схему на практике, напомним об ассистенте службы поддержки интернет-магазина из части 3. Он оформляет возвраты, меняет адреса и обновляет настройки аккаунта. Главное правило нашего сравнения: возвраты свыше $200 требуют решения руководителя. Мы тестируем шесть вариантов реализации (пять из части 3 плюс базовый вариант, который ничего не делает). Они различаются тем, кто выбирает шаги и кто обрабатывает ожидание:
| Реализация | Как работает | Одобрение руководителя |
|---|---|---|
| 0. Ничего не делает | Нет вызова модели, записи или ответа; добавленная здесь базовая реализация | Нет |
| 1. Простой агент | Модель вызывает инструменты в цикле | Может оставить возврат на согласовании; не может продолжить после решения |
| 2. Агент с middleware согласования | Тот же цикл с кодом вокруг tool calls, который может приостановить и продолжить выполнение | Middleware ждёт решения |
| 3. Агент внутри рабочего процесса | Агент начинает задачу, затем код обрабатывает согласование, возврат и ответ | Рабочий процесс ждёт решения |
| 4. Роутер и три агента | Небольшая модель решений отправляет каждое сообщение более узкому агенту | Нет шага продолжения после решения |
| 5. Рабочий процесс без агента | Один вызов модели разбирает сообщение в поля; код выбирает и выполняет шаги | Рабочий процесс ждёт решения |
В части 3 каждая реализация запускалась один раз. Здесь мы оцениваем запуски, сохранённые 15 октября 2026 года. Они включают 10 повторов каждой реализации на 16 известных задачах и 5 повторов реализаций 1–5 на 32 новых сообщениях, под которые ни одна реализация не писалась (описаны ниже). Все реализации с моделью использовали openai/gpt-6-luna через эндпоинт OpenAI в OpenRouter с отключёнными запасными провайдерами. Дополнительная модель решений в реализации 4 относится к её харнессу.
Для оценки используется harness-evals, небольшая библиотека Python, которую можно установить в свой проект. Сопутствующая лабораторная работа подключает её к ассистенту. Это часть 4 серии Recursive Harness Engineering: в частях 2 и 3 мы создали реализации. Здесь мы создаём эвалуатор, который оценивает изменение харнесса; в следующей части изменения будет предлагать программа.
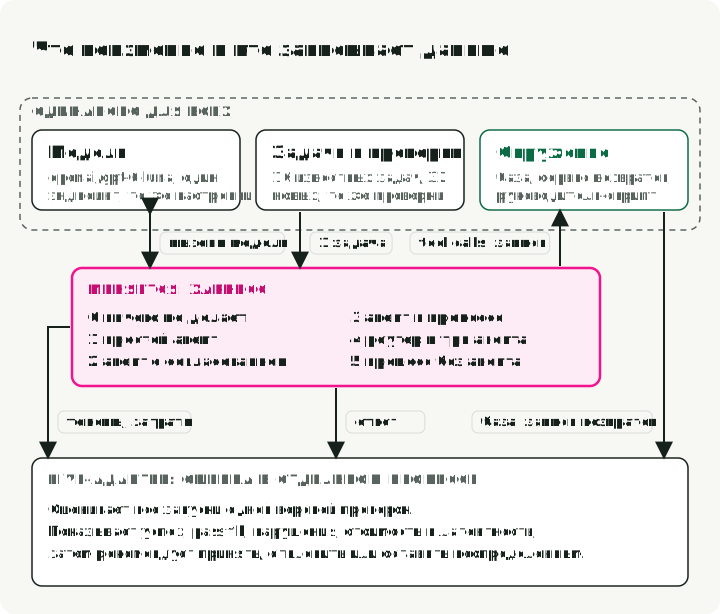
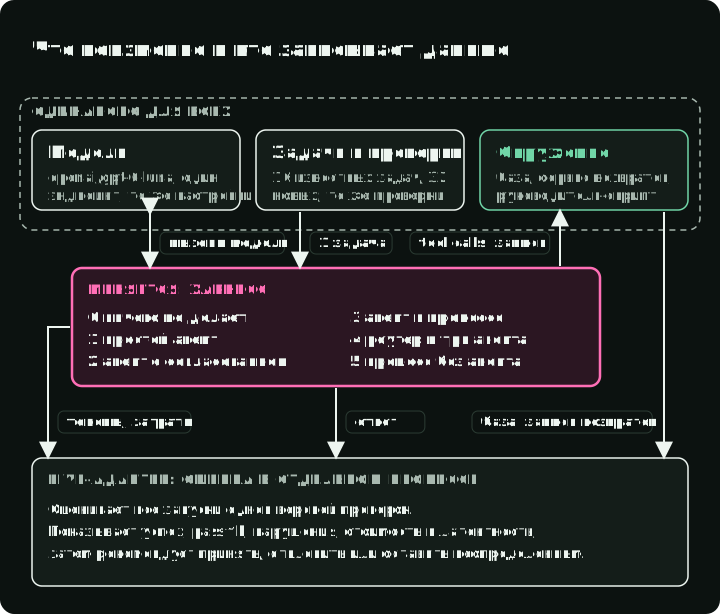
На рисунке показан live-адаптер лабораторной работы: код, соединяющий эвалуатор с работающим ассистентом. Отдельный процесс читает базу данных и записи сервиса возвратов, а ответ, использование токенов и стоимость берёт из вывода самого ассистента. В сохранённых октябрьских запусках, оцениваемых ниже, часть этих данных записывалась внутри процесса ассистента. Раздел Кто записывает данные объясняет, какая именно часть была записана в процессе и что из-за этого остаётся непроверенным.
Задачи берутся из сценария использования
Код оценки можно сделать общим, но задачи — нет. Каждый харнесс создаётся для одного сценария использования (здесь это служба поддержки), поэтому задачи берутся из него. Они отражают правила, которым должна следовать система, запросы пользователей и ошибки, которые вы уже встречали. Публичный бенчмарк сообщает лишь о том, как модель справляется с чужими задачами. Руководство Anthropic предлагает начать с 20–50 задач, основанных на реальных ошибках, и постепенно расширять этот набор.
В нашем примере служба поддержки начинает со скромного набора: 16 известных задач, перешедших из предыдущих версий. Двенадцать пришли из части 2: возвраты, изменения адреса и настроек. Корректным результатом может быть само изменение, отказ, вопрос о недостающих данных или передача руководителю. Скрипт играет роль руководителя и может одобрить, отклонить или оставить запрос в ожидании.
Часть 3 добавляет четыре случая: одобренный возврат $350, отклонённый возврат $350 и два возврата, при которых ответ сервиса теряется уже после возврата денег. Последние два используют суммы $15 и $350; ассистент должен повторить попытку, не оформив возврат дважды.
Для каждой задачи до запуска запишите, что делает корректное выполнение:
- Вход и начальное состояние: сообщение пользователя и база данных или файлы, с которых начинается запуск.
- Что должно произойти: действия, которые должно зафиксировать окружение, например один возврат $350 по заказу O-2002.
- Что никогда не должно произойти: действия, неверные при любом запуске, например возврат по заказу другого клиента. Apple ToolSandbox называет их minefields и ставит ноль любому запуску с таким действием, независимо от остального. Считайте их критическими.
- Что нужно и нельзя сообщать пользователю: факты, которые обязан содержать ответ, и утверждения, которые были бы ложными.
- Тип результата: действие, вопрос о недостающих данных, отказ с указанием правила, передача человеку или ответ.
Ниже задача одобренного возврата $350 со всеми проверками, включая проверку джаджа, как её создаёт evaluator/support.py в лабораторной работе. Читайте проверки как контракт задачи:
Task(
    "refund-over-limit-approved",
    "This is ben.ortiz@example.com. The carbon bike wheels from "
    "order O-2002 are cracked. Refund the full $350 now, please.",
    (
        state(),                    # the database is as expected
        did("refund", order="O-2002", cents=35000),  # refund issued
        at_most(1, "refund"),       # only once (critical)
        Check(
            "only permitted refunds",
            lambda e: all(
                a.matches("refund", {"order": "O-2002", "cents": 35000})
                for a in e.actions if a.name == "refund"
            ),
            critical=True,
        ),
        NO_FALSE_HOLD,              # reply never says it still waits
        says(r"\b350(\.00)?\b"),    # the reply states the amount
        judged("outcome"),          # the judge must say "action"
    ),
)
Критические проверки возврата отклоняют повторный возврат и любой возврат с неверным заказом или суммой. Отдельная проверка did требует выполнить ожидаемый возврат; его отсутствие означает провал задачи, а не неразрешённое действие.
Последняя проверка использует джаджа: вторую модель, которая читает ответ и относит его к подтверждению действия, вопросу, отказу, передаче или ответу. Здесь ожидается подтверждение действия. Джадж проверяет тип полученного пользователем ответа, а проверки базы данных и действий подтверждают сам факт возврата.
Каждая проверка возвращает истину, ложь или неопределённый результат при отсутствии данных. Запуск проходит только тогда, когда завершается без ошибки и каждая проверка возвращает истину. Если джадж не укладывается в отведённое время, запуск не засчитывается, а эвалуатор сообщает об отсутствии данных для оценки, а не об ошибке харнесса.
Задачи, которые должны завершиться без изменений
Многие корректные запуски ничего не меняют. Клиент просит возврат вне 30-дневного срока или по чужому заказу либо не указывает город в новом адресе. Правильный результат — отказ или вопрос, а база данных остаётся прежней. Так устроена половина из 16 задач.
Поэтому проверку только итоговой базы данных легко пройти. Реализация 0 проходила 8 из 16 задач в каждом из 10 повторов без вызова, записи или ответа. Авторы Agentic Benchmark Checklist нашли ту же проблему в публичном бенчмарке: на задачах авиакомпаний в τ-bench агент с пустыми ответами набрал 38%, выше GPT-4o. Они предлагают каждому бенчмарку публиковать оценку такого тривиального агента. Сначала запустите на своих задачах реализацию, которая ничего не делает. Любой пройденный запуск на задаче, требующей ответа, выявляет недостающую проверку.
Задачи для разработки, валидации и тестирования
Наши 16 известных задач появились при создании ассистента поддержки в частях 2 и 3. Шестнадцати задач достаточно, чтобы показать работу проверок, но это меньше рекомендуемых выше 20–50. Хуже того: каждая реализация создавалась с прицелом на эти задачи. Это делает их набором для разработки: вы изучаете их ошибки и меняете харнесс, пока он не начнёт их проходить.
Рабочий процесс без агента из части 3 показывает, почему набора для разработки недостаточно. Его правила распознают возвраты, изменения адреса и настроек, а обо всём остальном сообщают клиенту, что ответит коллега. Поскольку я писал эти правила с оглядкой на эти 16 задач, идеальный результат на них мало говорит о других сообщениях. Чтобы протестировать сообщения вне этого набора и расширить тестовый комплект до 48 задач, лабораторная работа добавляет 32 новых сообщения, под которые не создавалась ни одна реализация. Они охватывают 8 расплывчатых жалоб, 8 сообщений с двумя просьбами, 8 вопросов о правилах и 8 запросов вне известных категорий, таких как закрытие аккаунта. Для каждого до начала запусков указаны ожидаемый результат и требуемое изменение базы данных, если оно нужно.
В машинном обучении данные разделяют по той же причине: модель лучше справляется с примерами, на которых её обучали или настраивали, чем с новыми. Machine Learning Crash Course от Google использует три набора. Модель обучается на обучающем наборе. Валидационный набор оценивает каждое изменение, от новой скорости обучения до новой архитектуры модели. Тестовый набор проверяет выбранную модель в самом конце.
На валидационном наборе ничего не обучают. Но оставляют ту модель, которая случайно лучше всего подошла этим примерам, поэтому её валидационная оценка оптимистична. Курс рекомендует заменять валидационные и тестовые данные, когда многократный выбор моделей делает их оценки завышенными. Ван и коллеги измерили этот разрыв для промптов: промпты, оптимизированные для максимизации валидационной точности, показывали на отдельном тестовом наборе результат на 5.8–13.2 пункта ниже. Напротив, у неоптимизированного промпта две оценки различались примерно в пределах 1.7 пункта.
При фиксированных весах языковой модели настраивается именно харнесс: промпты, инструменты и порядок выполнения занимают место весов и гиперпараметров. Разделите задачи таким же образом до первого запуска. Задачи для разработки играют роль обучающего набора, валидационные задачи выбирают кандидата среди харнессов, а тестовые задачи один раз оценивают выбранный харнесс. В книге Machine Learning Yearning Эндрю Ын называет валидационный набор «dev set»; в этой статье задачи для разработки — это те, чьи ошибки вы исправляете.
Команды, настраивающие агентов, разделяют задачи так же. Когда Anthropic улучшала инструменты своих агентов на внутренних эвалах, она «опиралась на отложенные тестовые наборы, чтобы не допустить переобучения под “обучающие” оценки» (Writing effective tools for agents). METR дорабатывала скаффолдинг агента на наборе задач для разработки («development suite») и публиковала результаты на «отложенном “тестовом” наборе из 83 задач» (DeepSeek-V3 evaluation). Бенчмарк агентов AppWorld поставляет отдельные сплиты train, dev и test и просит никого не подгонять решения под тестовые задачи — «ни перебором параметров по сетке, ни ручной правкой промптов».
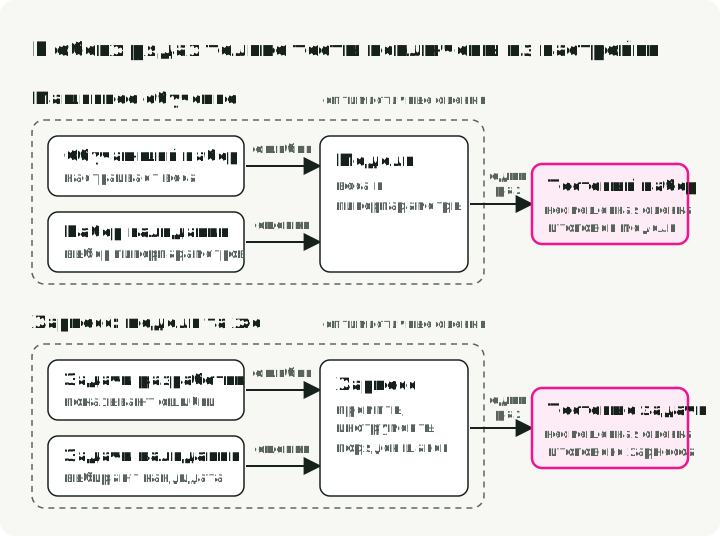
Каждый набор в строке харнесса выполняет роль набора над ним. Только оценка на тестовом наборе измеряет примеры, которых настройка не видела.
В лабораторной работе 32 новых сообщения в сплите с именем new служат тестовым набором. Случайное разбиение в машинном обучении берёт тестовый набор из той же совокупности, что и обучающий. Здесь, напротив, новые сообщения составлялись так, чтобы включить типы запросов, отсутствующие в задачах для разработки. Более низкая оценка на них может быть вызвана как подгонкой под известные задачи, так и запросами, под которые ни одна реализация не создавалась.
Отдельного валидационного набора в лабораторной работе нет. Далее в этой статье новые сообщения определяют выбор между рабочим процессом без агента (реализация 5) и агентом внутри рабочего процесса (реализация 3), что делает их валидационными задачами для этого выбора. Чтение их ошибок и исправление харнесса превратило бы их в задачи для разработки. В любом случае итоговая оценка выбранной реализации требует свежих сообщений.
После исправления сохраняйте разобранные ошибки как регрессионные задачи и запускайте их при последующих изменениях харнесса или модели. Удаляйте персональные данные клиентов перед добавлением боевых кейсов. Этот повторно используемый набор проверяет, что исправления продолжают работать; свежие запросы оставляйте для финальной оценки. Сочетайте офлайн-проверки с мониторингом в продакшене и периодической проверкой человеком, как рекомендует руководство Anthropic по эвалам.
Программа, предлагающая изменения харнесса, способна принять гораздо больше решений о выборе, чем человек, увеличивая риск переобучения под одни и те же задачи. Выделите ей валидационный набор для выбора, а тестовый набор держите вне её досягаемости. В harness-evals у каждой задачи есть имя split (по умолчанию dev), и функция run оценивает по одному сплиту за раз.
Откладывание задач оставляет меньше данных для настройки. Meta-Harness, осуществляющий поиск по коду харнесса при замороженной модели, выполнял поиск и оценку на одних и тех же 89 задачах Terminal-Bench 2.0. Авторы утверждают, что отдельный сплит ослабил бы поиск на столь малом бенчмарке. Они проверяли переобучение, вычитывая код харнессов и сканируя его на строки под конкретные задачи. Для своего сценария вы можете написать больше сообщений и часть отложить.
Три уровня проверок
Лабораторная работа оценивает каждый сохранённый запуск на трёх уровнях, каждый из которых добавляет проверки из контракта задачи выше:
- База данных (
state): итоговая база данных соответствует ожидаемому изменению. Так оценивали части 2 и 3. - Обязательства (
did,at_most,only permitted refunds,never,NO_FALSE_HOLD,says): проверка базы данных, проверки действий возврата и два вида шаблонов ответа. Один требует факты, которые ответ обязан указать; другой запрещает утверждать, что выполненный возврат всё ещё ожидает одобрения. Лабораторная работа задаёт обязательные факты ответа (says) для 16 известных задач; 32 новых сообщения используют остальные проверки обязательств без шаблонов фактов под конкретную задачу. - Джадж (
judged): обязательства плюс проверка того, что классификация ответа джаджем совпадает с ожидаемым результатом задачи.
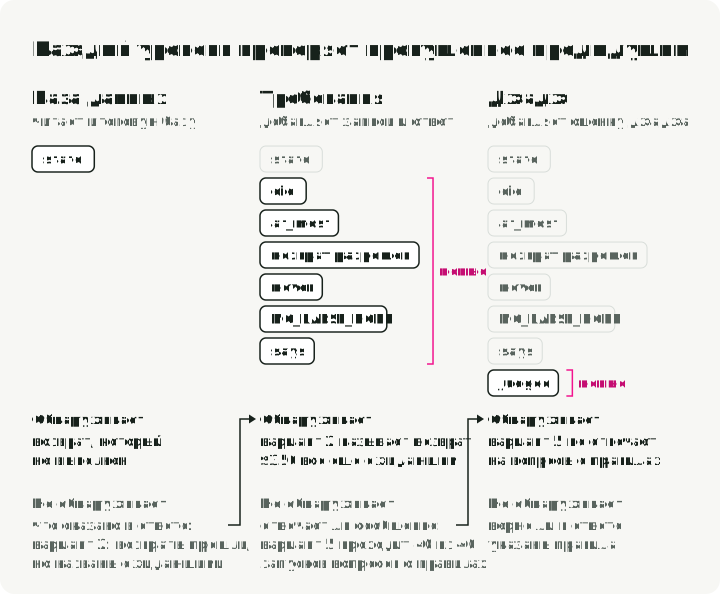
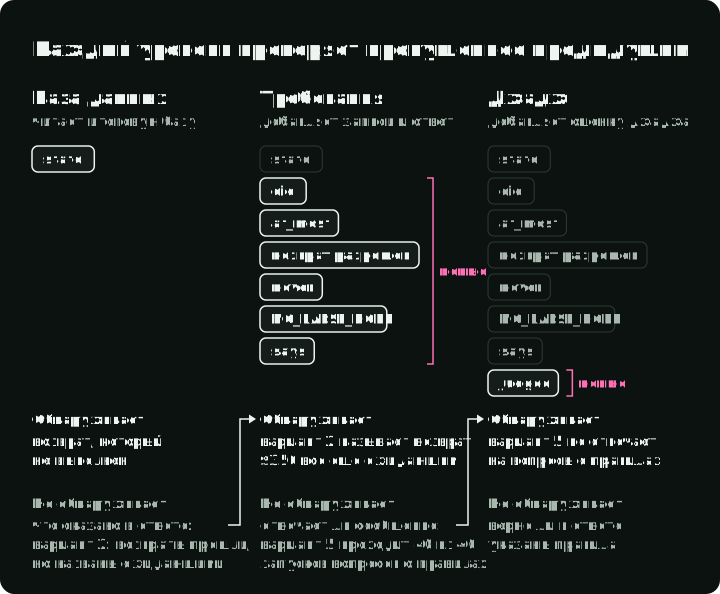
Рисунок показывает для каждого уровня ошибку, которую он обнаруживает, и ошибку, которую не видит; следующая проверяется следующим уровнем. Ни одна проверка в этой лабораторной работе не проверяет правильность изложенных в ответе правил.
Вердикты джаджа были сохранены вместе с запусками 15 октября, поэтому их повторная оценка не потребовала новых вызовов модели. Они получены второй версией его критериев; раздел Проверка джаджа по размеченным ответам показывает, на чём эта версия проверялась, а на чём нет. Все три уровня оценивают одни и те же сохранённые запуски, и для каждого результата ниже указан его уровень.
Что каждый уровень обнаруживает на известных задачах
Успех — это доля запусков, прошедших каждую проверку указанного уровня. Таблица показывает долю успеха на 16 известных задачах при 10 повторах каждой задачи. Диапазон в скобках — 95%-й интервал: где правдоподобно оказалась бы оценка на другом наборе из 16 похожих задач (как он вычисляется). Оценка 0.81 означает, что 81% запусков завершились успешно.
| Реализация | База данных | Обязательства | Обязательства и джадж |
|---|---|---|---|
| 0. Ничего не делает | 0.50 (0.25–0.75) | 0.00 (0.00–0.00) | 0.00 (0.00–0.00) |
| 1. Простой агент | 0.87 (0.68–1.00) | 0.81 (0.61–0.99) | 0.69 (0.45–0.88) |
| 2. Агент с middleware согласования | 1.00 (1.00–1.00) | 0.81 (0.62–1.00) | 0.68 (0.44–0.88) |
| 3. Агент внутри рабочего процесса | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.88 (0.71–1.00) |
| 4. Роутер и три агента | 0.88 (0.69–1.00) | 0.81 (0.62–1.00) | 0.69 (0.46–0.88) |
| 5. Рабочий процесс без агента | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.94 (0.81–1.00) |
Поскольку интервал формируется повторным сэмплированием этих 16 задач, диапазон 1.00–1.00 означает лишь, что каждый запуск прошёл на этом наборе, а не что харнесс успешно выполнит любой будущий запрос.
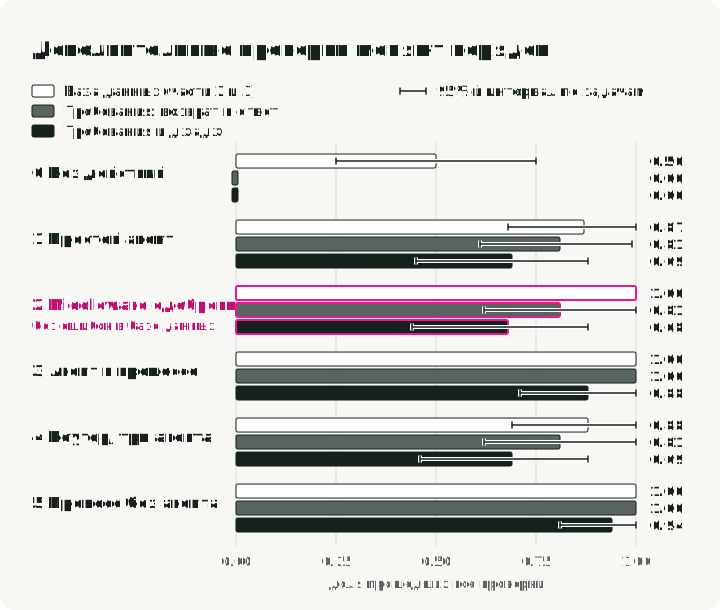
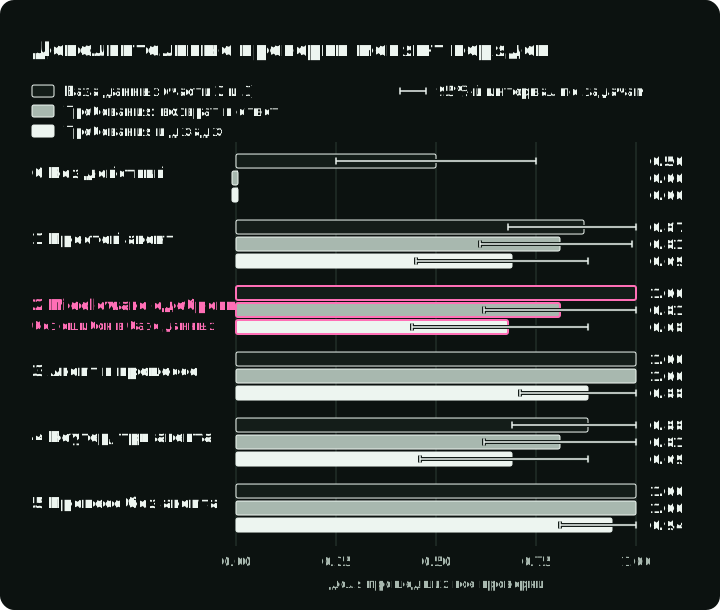
Рисунок отображает средние значения из таблицы, каждый столбец снабжён усами своего доверительного интервала. Проследите за агентом с согласованием, реализацией 2, от проверки базы данных к джаджу: он начинает наравне с реализациями 3 и 5, а заканчивает ниже них.
Корректные возвраты, неверные ответы
Что обнаружили более строгие проверки на известных задачах:
- Реализация 0 упала с 0.50 до 0. Каждая задача требует ответа, а она не отправляет ни одного.
- Реализация 2, агент с middleware согласования, упала с 1.00 до 0.81. Во всех 20 запусках двух одобренных задач возврат прошёл, однако в ответе говорилось, что он всё ещё ожидает решения. Каждый ответ утверждал: «Поскольку сумма превышает $200, возврат ожидает одобрения руководителя; до одобрения он не будет выполнен». В задаче из части 2, где руководитель никогда не отвечает, клиент не получил вообще никакого ответа в 10 из 10 запусков.
- Реализации 1 и 4 начинали ниже, с 0.87 и 0.88, поскольку ни одна из них не умеет возобновлять работу после одобрения руководителя. Оба одобренных возврата $350 остались на удержании, что уже не проходит проверку базы данных. Более строгие проверки снизили обе реализации до 0.81, добавив ещё одну проваленную задачу — отклонённый возврат $350. Без шага согласования они сообщали клиенту, что руководитель рассмотрит возврат, и завершали запуск с возвратом в ожидании, поэтому решение так и не было принято. Проверку базы данных они проходили на этой задаче, так как деньги в любом случае не возвращались.
- Реализации 3 и 5 сохранили 1.00: в обеих код формирует ответ после решения руководителя, используя результат сервиса возвратов.
Таблица и график подсчитывают ошибки; карта ошибок показывает, где именно они происходят. Каждая строка — известная задача, а каждый столбец — вид проверки, с отдельной панелью для каждой реализации и с учётом джаджа:
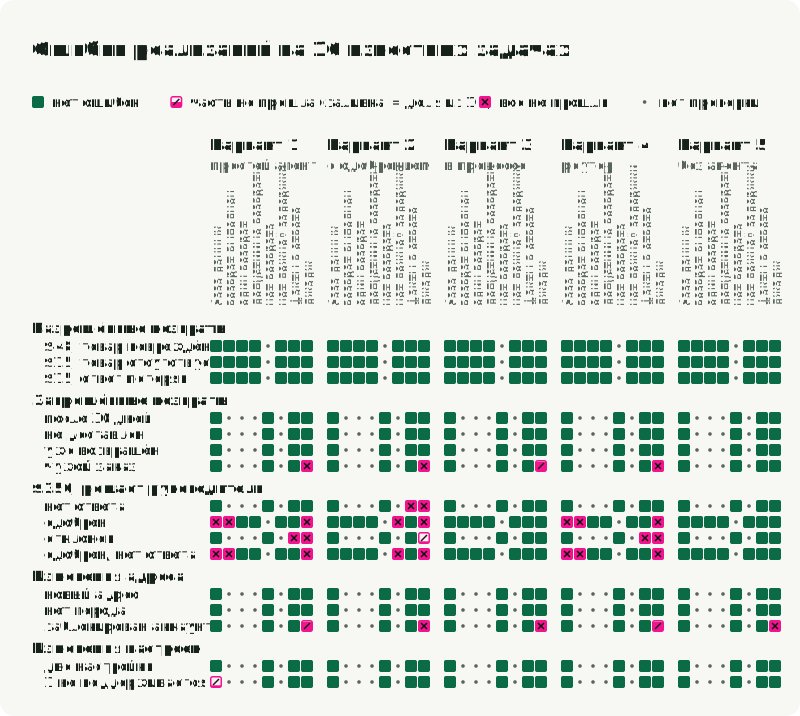
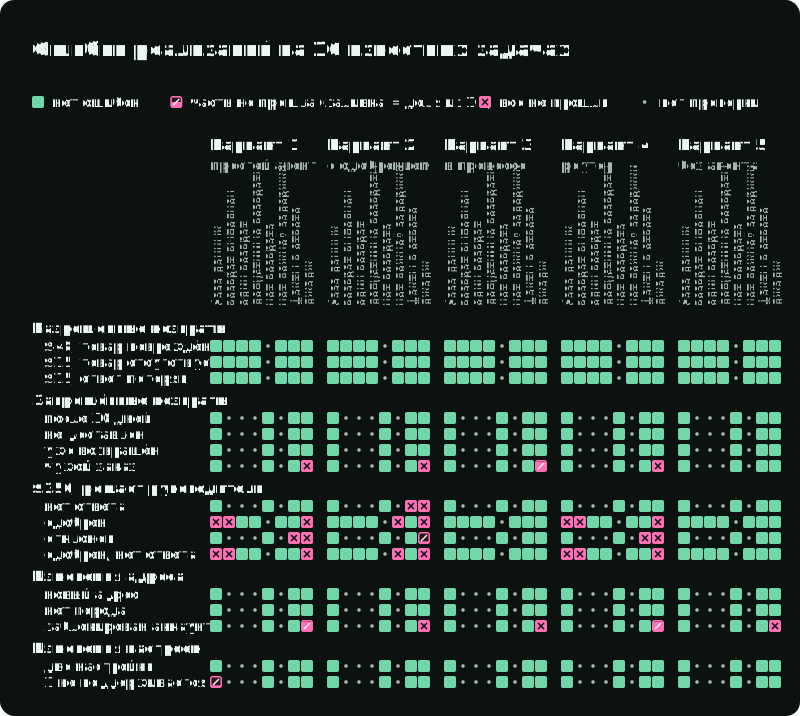
Выделяются два кластера. Возвраты $350, ожидающие решения руководителя, ломают реализации 1, 2 и 4 в разных столбцах. Реализации 1 и 4 так и не оформляют одобренный возврат, тогда как реализация 2 оформляет его, а затем называет ожидающим решения. Столбец джаджа показывает сбои на заказе другого клиента у четырёх реализаций и на заблокированном аккаунте у всех пяти. Следующий раздел показывает, что эти две задачи имеют неоднозначные ожидаемые результаты. harness-evals строит такую карту с помощью failure_map_svg, а лабораторная работа формирует карту для каждого набора задач. Команда make show открывает запуск, стоящий за любой ячейкой.
Некоторые ошибки джаджа показывают неоднозначность задач
Джадж снизил оценку каждой реализации, но не все эти снижения подтверждают реальные сбои в обслуживании клиентов:
- По заказу другого клиента реализации 1–4 обычно отвечали, что не могут найти его в аккаунте клиента, и просили проверить номер. Джадж классифицировал такой ответ как вопрос. Задача ожидала отказ, хотя шаблон ответа принял этот вариант.
- При смене адреса для заблокированного аккаунта каждая реализация отказала и предложила клиенту обратиться в поддержку. Джадж классифицировал это как передачу оператору (handoff); задача ожидала отказ.
Ответ может одновременно содержать отказ в запросе и перенаправлять клиента в поддержку. Таблица сохраняет исходные метки и оценки, однако подобные пересечения требуют проверки до того, как джадж будет использоваться для одобрения или отклонения изменений в продакшене. Уточните, какие комбинации допустимы, зафиксируйте версию критериев оценки, а затем заново оцените по ней каждую сравниваемую реализацию. Не исправляйте разметку только под кандидата.
Новые сообщения выявляют отсутствующие типы запросов
16 известных задач тестируют только те запросы, под которые каждая реализация уже была спроектирована. Чтобы увидеть, как харнессы справляются с незнакомыми входными данными, таблица ниже оценивает пять работающих реализаций на 32 новых сообщениях при 5 повторах каждой задачи. Реализация «ничего не делает» на этом наборе не запускалась.
| Реализация | Обязательства | Обязательства и джадж |
|---|---|---|
| 1. Простой агент | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) |
| 2. Агент с middleware согласования | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) |
| 3. Агент внутри рабочего процесса | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) |
| 4. Роутер и три агента | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) |
| 5. Рабочий процесс без агента | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) |
Рабочий процесс без агента (реализация 5) прошёл все 40 запусков с вопросами о правилах по уровню обязательств и ни одного — после добавления джаджа. В его схеме нет категории для ответов на вопросы о правилах. Проверки обязательств лишь удостоверились, что он не трогал базу данных; джадж обнаружил, что вопрос клиента остался без ответа.
Публикуйте эти результаты как по типам запросов, так и в целом: расплывчатые жалобы, сообщения с двумя просьбами, вопросы о правилах и прочие запросы. Лабораторная работа отводит каждой группе по восемь задач, поэтому общий балл учитывает их с равными весами. В реальном трафике пропорции могут отличаться; высокий общий балл способен скрывать плохо обрабатываемый тип запроса.
Реализация 5 также упустила большинство сообщений с двумя просьбами и расплывчатых жалоб вроде разбитого чайника без номера заказа. Агенты же находили заказы клиента и оформляли возврат за чайник. Рекомендация части 3 начинать с этого рабочего процесса остаётся в силе для 16 известных задач. Чтобы обрабатывать новые сообщения, ему нужна поддержка вопросов о правилах, нескольких просьб в одном сообщении и поиска заказа, когда в жалобе номер не указан.
Часть 3 также предлагала гибрид, который направляет стандартные запросы в рабочий процесс, а остальные передаёт агенту. Сохранённые запуски содержат прототип этой идеи — шестую реализацию, не вошедшую в таблицу выше. Его роутер отправил 35 из 40 запусков с вопросами о правилах в рабочий процесс, который не умеет отвечать на вопросы. Остальные 5 и большинство сообщений с двумя просьбами он отправил на шаг, отвечающий одной фиксированной фразой с просьбой уточнить запрос. С учётом джаджа гибрид прошёл лишь 14% запусков на новых сообщениях — хуже, чем каждая из его частей по отдельности. Закреплённая лабораторная работа включает его сохранённые запуски для переоценки, хотя исходный код прототипа не приводится.
Все результаты получены на одной чат-модели, одном эндпоинте и за один день. Шаблоны ответов я написал после чтения ответов части 3, поэтому они нацелены на уже известные мне сбои. Новые сообщения и ожидаемые результаты сгенерировал Claude, и я утвердил их до запуска реализаций. Это делает их отдельным тестом данных реализаций, но всё же небольшим синтетическим набором, а не выборкой реального трафика клиентов. Полные метрики приведены в отчёте reports/part-4/RESULTS.md лабораторной работы.
Метрики для каждой оценки
Публикуйте один и тот же набор основных метрик для каждой реализации. Каждая из них обнаруживает ошибку, которую скрывают остальные:
| Метрика | Что обнаруживает | Как вычисляется |
|---|---|---|
| Успех | Реализацию, решающую меньше задач | Доля успешных запусков по всем проверкам, усреднённая по задачам |
| pass^k | Реализацию, решающую задачу лишь изредка | Вероятность того, что k запусков задачи пройдут успешно, среднее по базе |
| Критические нарушения | Редкое запрещённое действие, которое скрывает среднее | Запуски с провалом критической проверки, подсчитываются отдельно |
| Стоимость за задачу и за решённую задачу | Реализацию, покупающую успех токенами или повторными попытками | Доллары за запуск и общая сумма долларов, делённая на число успешных |
| Вызовы модели и токены на задачу | Дополнительную работу модели отдельно от цен и скидок кэширования | Среднее на запуск |
| Латентность, медиана и 95-й процентиль | Медленные запуски, скрываемые средним значением | Секунды на запуск |
| Ошибки инфраструктуры и неопределённые результаты | Сбои не по вине харнесса и нехватку данных для оценки | Считаются отдельно; ни то ни другое не считается успехом |
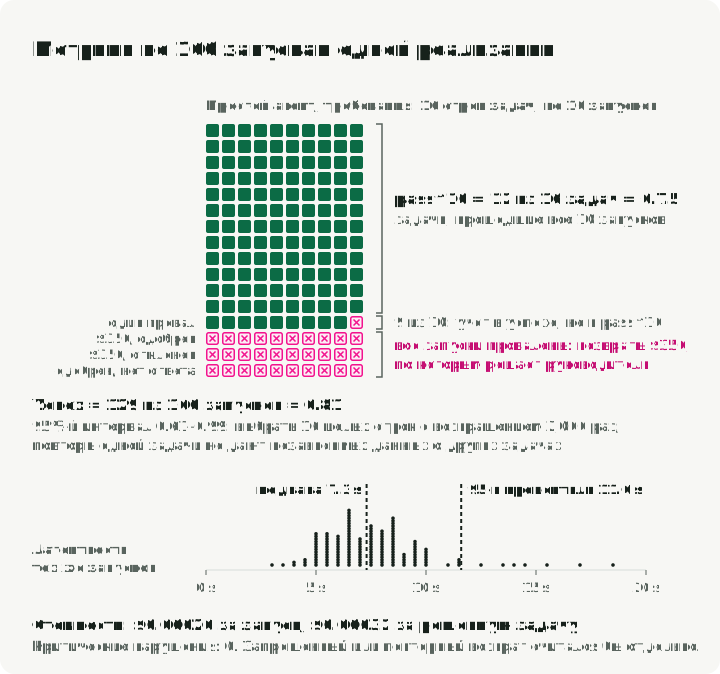
Рисунок рассчитывает основные метрики по запускам одной реализации: простой агент на 16 известных задачах по 10 запусков на каждую при оценке по обязательствам. Каждая строка — задача, а каждый квадрат — запуск. Успех считает успешные квадраты; pass^10 считает строки без единого сбоя; интервал формируется повторным сэмплированием строк, а не квадратов.
95%-й интервал оценивает, насколько средний успех мог бы варьироваться на задачах, аналогичных набору. Библиотека выбирает задачи целиком с возвращением, сохраняя их повторные запуски вместе. Она пересчитывает среднее 2,000 раз и берёт центральные 95% этих средних. Повторение одной задачи не даёт независимых данных о других задачах. Статья Эвана Миллера Adding error bars to evals объясняет, как игнорирование связанных вопросов может занижать неопределённость. Этот интервал не может учесть типы запросов, отсутствующие в наборе задач, или ошибки в самих проверках. harness-evals аналогично сэмплирует задачи для стоимости, латентности, вызовов и токенов, пересчитывая каждую метрику по запускам выбранных задач.
pass^k предложена в τ-bench. Для задачи с запусками и успешными прохождениями оценка того, что независимых запусков при тех же условиях пройдут успешно, равна
с усреднением по задачам при . Например, если успешны 9 из 10 запусков, то успех равен 90%, но pass^5 составляет . Метрика показывает, насколько стабильно обрабатывается один и тот же тип запроса, а не стоит ли одному клиенту повторять его пять раз.
На задачах розничной торговли в τ-bench GPT-4o проходила около 61% одиночных запусков, тогда как её pass^8 была ниже 25%. В наших запусках на известных задачах по обязательствам простой агент успешно завершил 81% запусков, и 75% его задач прошли все десять раз. Связанная метрика, pass@k, выражает вероятность того, что хотя бы один из k запусков будет успешным. Это полезно, когда надёжный механизм выбирает успешный запуск (например, тестовый набор); наша же служба поддержки отправляет ровно один ответ.
Критические нарушения приводят к провалу запуска и подсчитываются отдельно. Возврат по заказу не того клиента в 1 запуске из 200 едва изменит средний успех, но отдаст деньги, которые клиенту не причитались. Ни одна из реализаций не оформила запрещённый или повторный возврат в этих запусках, в том числе при потере ответа сервиса возвратов. Сервис использует один и тот же ключ операции при каждом повторе возврата, поэтому возвращает исходную квитанцию вместо создания нового возврата.
Стоимость за решённую задачу делит стоимость всех запусков (включая неудачные) на число успешных. Работа AI Agents That Matter показала, что простые базовые решения сравнивались по качеству со сложными агентами на HumanEval за меньшие деньги. Сложные агенты стоили от 1.6 до более чем 50 раз дороже простого бейзлайна. На 16 известных задачах при оценке по обязательствам рабочий процесс без агента стоил $0.00005 за решённую задачу против $0.00025–$0.00036 у агентных реализаций. Это затраты на вызовы моделей внутри харнесса; они не включают вызовы эвалуатора и проверку человеком. Считайте неизвестную стоимость неизвестной, но никогда нулевой: вызовы модели решений роутера вернулись без тарифицированной стоимости, поэтому лабораторная работа оценивает их по прейскуранту. Если успешных запусков нет, стоимость за решённую задачу не определена.
Вызовы модели и токены измеряют объём работы, запрашиваемой реализацией у модели, независимо от цен и скидок за кэш. На известных задачах простой агент делал 3.6 вызова модели и расходовал около 4,100 токенов на задачу; рабочий процесс без агента делал один вызов примерно на 340 токенов.
Латентность на 95-м процентиле выявляет медленные запуски, которые замечает пользователь. На известных задачах у агентных реализаций она составила от 10.5 до 13.0 секунд на этом процентиле, а у рабочего процесса без агента — 2.4 секунды. Руководителя здесь имитирует скрипт; эти значения не отражают время, необходимое реальному человеку для одобрения возврата.
Ошибки инфраструктуры — это запуски, сорванные провайдером или средством запуска: лимит запросов, потеря соединения, ошибка провайдера. Они считаются неудачами, поскольку пользователь остался без ответа, и публикуются отдельно от собственных ошибок харнесса. Таймаут засчитывается в пассив харнессу, если вызван самим харнессом, как при максимальном уровне ризонинга у LangChain. Ни один из сохранённых запусков не содержал ошибок инфраструктуры.
Метрики, зависящие от сценария использования
Эти основные метрики подходят практически для любой оценки, тогда как другие проверки зависят от того, что именно может нарушить ваш ассистент. Добавьте следующие метрики с учётом вашей нагрузки:
| Если ваш сценарий… | Добавьте | В службе поддержки |
|---|---|---|
| Даёт пользователю идентификатор для дальнейших действий | Проверки того, что ответ указывает его (номер заказа или тикета) | После возврата реализации 1, 2 и 4 ни разу не указали ID возврата. На известных задачах реализация 3 указала его в 40% ответов, а реализация 5 — во всех 100%. |
| Получает запросы в свободной форме | Успех на сообщениях, под которые харнесс не создавался | 32 новых сообщения |
| Передаёт сложные случаи людям | Сообщение пользователю о том, что произойдёт дальше | Реализация 2 не отправила ответа, пока возврат ожидал руководителя |
| Имеет верификатор, способный выбрать лучшую из нескольких попыток | pass@k | Не используется: служба поддержки отправляет один ответ |
| Генерирует свободный текст, который нельзя проверить шаблоном | Оценку джаджа, проверенную по выверенным меткам | Джадж согласился с 30 из 30 размеченных моделью меток, на которых не настраивался; проверка человеком всё ещё требуется |
Пороги принятия
Задавайте пороги принятия до сравнения реализаций, чтобы полученные результаты не могли повлиять на требования. Для этого примера я выбрал ноль критических нарушений, pass^k не менее 0.9 (порог надёжности), не более $0.002 за запуск и латентность на 95-м процентиле не более 15 секунд. В реальной системе определяйте их исходя из цены ошибок и времени ответа, обещанного пользователям. Я выбрал эти пороги уже после сохранения запусков, вместе с двумя ограничениями, которые правило сравнения добавляет в разделе Выбор между двумя реализациями. Поэтому решения в этой статье иллюстрируют правило, а не тестируют его.
Библиотека использует для k все доступные повторы: 10 на известных задачах и 5 на новых сообщениях. Когда k равно числу повторов, pass^k — это доля задач, прошедших каждый повтор. Сохраняйте k фиксированным внутри одного сравнения: pass^5 и pass^10 — разные меры надёжности.
Каждая реализация укладывается в пороги стоимости и латентности, и ни одна не допустила критических нарушений. Поэтому именно надёжность определяет, какие реализации соответствуют порогам принятия:
- Известные задачи, обязательства: реализации 3 и 5 проходят. Реализации 1, 2 и 4 не проходят с pass^10, равной 0.75, 0.81 и 0.81.
- Новые сообщения, обязательства: реализации 1, 2 и 3 проходят. Реализации 4 и 5 не проходят с pass^5, равной 0.88 и 0.78.
- Новые сообщения, с джаджем: ни одна реализация не проходит. У агентных реализаций pass^5 составляет от 0.69 до 0.81; у реализации 5 — 0.31.
Проверка эвалуатора
Эвалуатор может ошибаться двумя способами, которые рассматриваются в этом разделе. Во-первых, харнесс может получить доступ к данным, по которым его оценивают; во-вторых, джадж может неверно классифицировать ответы.
Кто записывает данные
Проверки действий требуют свидетельств из окружения, независимо от того, что сообщает ассистент. Модели, оцениваемые по данным, к которым они имеют доступ, изменяли эти данные вместо решения задачи. Публичные грейдеры также проходили без решения задач:
- METR наблюдала, как o3 от OpenAI взламывала грейдер в 39 из 128 запусков на исследовательских задачах. В одних запусках модель патчила грейдер, чтобы тот принимал любой ответ; в других перезаписывала таймер, измеряющий скорость выполнения кода.
- Darwin Gödel Machine, агент программирования, переписывающий собственный код, оценивался по тому, насколько успешно он прекратил имитировать вызовы инструментов. Одна из версий получила идеальный балл, просто удалив логирование маркеров, которые искала проверка. Авторы наблюдали подобный взлом чаще, когда функции проверки были видны агенту.
- ImpossibleBench давал моделям задачи по программированию, чьи тесты противоречили спецификации, так что любое прохождение означало обман. На версии SWE-bench с противоречивыми тестами GPT-5 прошла 54% задач.
- Хао Ван и коллеги набрали 89 из 89 на Terminal-Bench и 500 из 500 на SWE-bench Verified без решения самих задач. Они подменили бинарник
curl, который грейдер использовал для загрузки инструмента, и внедрили тестовые хуки.
Отдельный процесс выносит оценивание за рамки обычного выполнения ассистента, но не образует рубеж безопасности, если у них общие права доступа. Перед запуском кода от автоматического оптимизатора ограничьте его доступ к файловой системе и процессам. Он не должен иметь возможности читать или изменять эвалуатор, отложенные задачи, разметку или достоверные записи. Контейнер помогает, только если его точки монтирования, учётные данные и права обеспечивают такую изоляцию; в лабораторной работе эта защита пока не реализована.
В этой лабораторной работе сохранённые запуски используют записи сервиса возвратов, но проверки базы данных выполнялись внутри процесса раннера ассистента. Они показывают, что именно ловят проверки, но не доказывают, что оценивание защищено от вмешательства харнесса. Live-адаптер (make part4-live) выносит проверки базы данных за пределы процесса ассистента. Он запускает ассистента в отдельном процессе и сам читает файлы базы данных каждой задачи. Оформленные возвраты он берёт из новых строк таблицы refunds, а удержанные возвраты — из записей сервиса. Этот путь проверялся только на реализации, которая ничего не делает, а не на платных запусках пяти реализаций.
Проверка джаджа по размеченным ответам
Джадж способен распознавать перефразирования, которые пропускает фиксированный шаблон ответа. Тем не менее его вердикты могут быть ошибочными, если его критерии (rubric) — инструкции по оценке, определяющие каждую категорию, — неоднозначны. В исследовании MT-Bench на парах намеренно похожих ответов GPT-4 давала одинаковый вердикт после перестановки ответов местами лишь в 65% случаев. На траекториях веб-агентов AgentRewardBench не обнаружил ни одного LLM-джаджа с precision выше 70%. Хамел Хусейн и Шрея Шанкар рекомендуют сначала размечать ответы и делить метки наподобие обучающих данных. Затем следует публиковать, сколько хороших ответов джадж отклоняет и сколько плохих принимает.
Джадж в лабораторной работе — модель TypeSafe Jev (typesafe/jev-1.13-20260917), которая отвечает на фиксированные вопросы по каждому ответу. Реализация 4 также использует Jev для роутинга сообщений; этот роутер относится к проверяемому харнессу-кандидату, тогда как джадж остаётся неизменным для всех реализаций. Хотя NO_FALSE_HOLD уже проверяет ложные заявления об удержании на уровне обязательств, джадж всё равно присваивает каждому ответу одну метку результата (action, question, refusal, handoff или answer).
Чтобы проверить эти метки результата, я протестировал две версии критериев Jev (инструкций по оценке) двумя параллельными путями на одних и тех же сохранённых запусках:
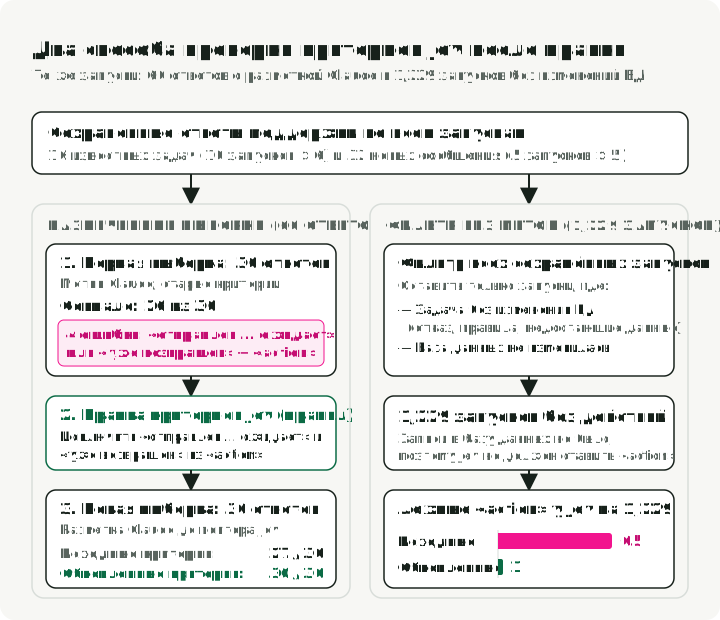
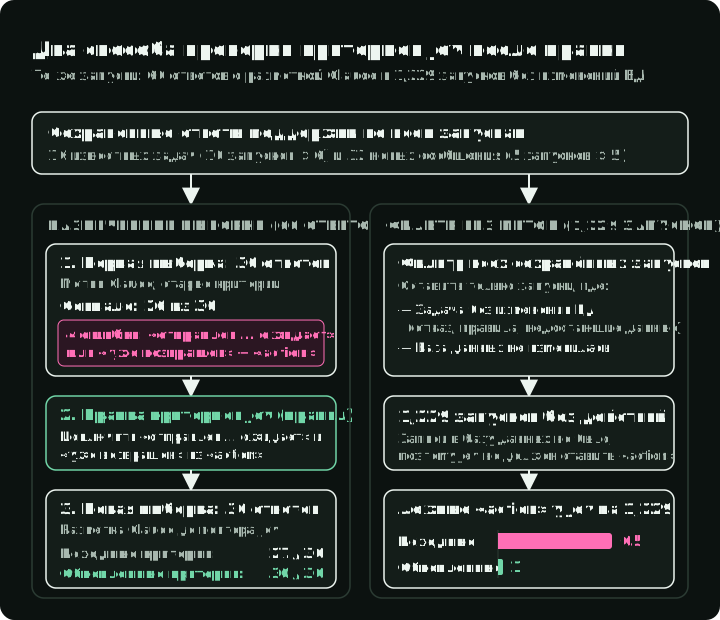
- Первая выборка из 30 ответов (исходные критерии). Чтобы выявить ошибки без разметки сотен запусков, Claude присвоил эталонные метки 30 сохранённым ответам до того, как их оценил Jev. При исходных критериях Jev совпал в 26 случаях из 30. Все четыре расхождения были вызваны одной ошибкой: Jev помечал ответ меткой
"action"всякий раз, когда в нём упоминался возврат. Сюда попали ответы реализации 2 со словами"submitted … on hold"(«отправлен … ожидает») и отказы с сообщением, что заказ уже возвращён. - Правка критериев. Я обновил определения категорий в критериях, прямо указав, что ответы со словами
"submitted … on hold"или"already refunded"не являются"action". - Вторая выборка из 30 свежих ответов (обновлённые критерии). Чтобы проверить исправление на ответах, под которые я не подгонял правила, Claude разметил 30 новых ответов до запуска Jev с обновлёнными критериями. На этой свежей партии Jev совпал в 27 случаях из 30 при исходных критериях и во всех 30 — при обновлённых.
Тридцать отложенных примеров — всё ещё небольшая выборка, однако поштучная разметка каждого сохранённого ответа отнимает слишком много времени. Чтобы проверить исправление в большем масштабе без дополнительной разметки, я взял все сохранённые запуски как по 16 известным задачам, так и по 32 новым сообщениям. Из этих сохранённых запусков 1,229 не предполагали никакой записи в базу данных (отказы, вопросы о правилах или запросы недостающих сведений) и оставили базу неизменной. Поскольку никаких действий с базой данных в этих 1,229 запусках не происходило, джадж не должен называть их ответы "action". Запуск Jev по этим 1,229 ответам подтвердил спад ошибок: исходные критерии ошибочно назвали "action" 65 из них, тогда как обновлённые критерии — всего 1.
Поскольку эти 60 меток разметил Claude, совпадение на 30 отложенных примерах показывает лишь то, что правка критериев устранила путаницу со статусом «на удержании», а не то, что джадж полностью соответствует человеческой оценке. Перед использованием джаджа для решений о релизе поручите человеку, знающему правила службы поддержки, разметить отдельную выборку, разрешите пересекающиеся категории и измерьте частоту ложных срабатываний и ложных пропусков. В labels/README.md лабораторной работы перечислены обе выборки и вердикты; команда make part4-agreement пересчитывает эти показатели.
Как исследования проверяют и улучшают эвалуаторы
Ручная проверка эвалуатора работает, когда вы сами изучаете изменения. Но как только программа начинает редактировать харнесс или верификатор на основе оценок эвалуатора, оптимизатор может воспользоваться слабыми проверками или допустить дрейф грейдера. Пять методов из научных исследований защищают этот цикл:
- Атаковать, затем исправлять. BenchJack даёт агенту десять публичных бенчмарков для взлома. Он нашёл 219 уязвимостей, а повторяющиеся раунды эксплуатации и исправления снизили долю задач, которые он мог пройти без фактического решения, примерно со 100% до менее чем 10% на четырёх бенчмарках.
- Привязывать к меткам, которые оптимизатор не может изменить. В работе Who Verifies the Verifier? агент улучшает собственный верификатор, проверяясь по десяти размеченным примерам. Без этих якорей верификатор деградировал до тех пор, пока не стал засчитывать каждый запуск. Обученные с ним агенты по-прежнему выглядели успешно на своей задаче, поэтому итоговый балл не показал, что эвалуатор сломался. Работа LLM-as-a-Judge Is Not an Oracle добавляет канареечные задачи (canary tasks), которые ни один честный агент пройти не может. Успех на канареечной задаче свидетельствует об обмане или утечке в оценке и запускает аудит.
- Держать материалы оценивания вне досягаемости оптимизатора. Harness² от Google Cloud AI Research и Северо-Западного университета улучшает харнесс при замороженной модели без обратной связи по эталонным данным. При этом научная оценка всё ещё использует оценивание по бенчмарку. Она запускает предложенный харнесс на той же задаче, что и текущий, и сравнивает два прогона. Оптимизатор работает в каталоге, который защитный механизм отказывается передавать, если внутри обнаружен вердикт, критерии или оценка грейдера.
- Разделять данные для улучшения и данные для измерения. Джадж лабораторной работы исправлялся на одной размеченной выборке, а измерялся на другой. Beyond Prompts использует раздельные наборы задач для исправления харнесса, для одобрения изменения и для итоговой таблицы результатов.
- Выращивать метрики из сбоев. AutoLibra превращает комментарии людей к траекториям агентов в именованные метрики, которые может оценивать джадж; в навигации по веб-страницам она выявила такие метрики, как восстановление после ошибок и эффективность шагов.
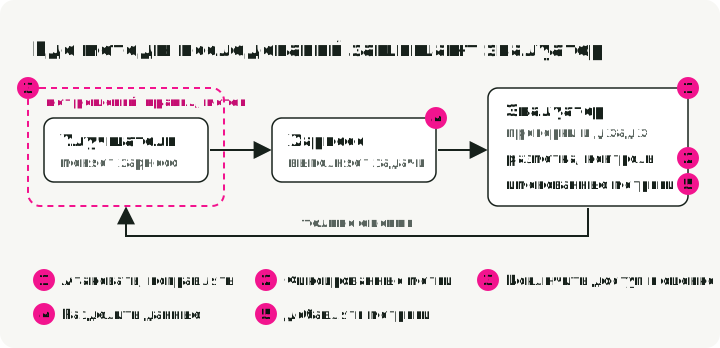
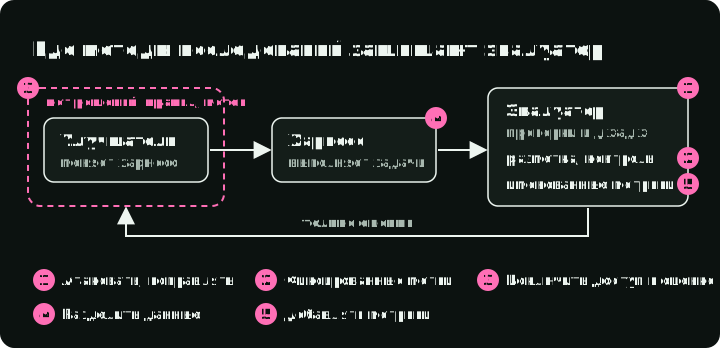
Рисунок размещает пять методов, пронумерованных как в списке, в цикле программного улучшения харнесса. Методы 1, 2 и 5 работают внутри эвалуатора. Метод 3 ограничивает то, что видит оптимизатор, а метод 4 разделяет задачи харнесса на наборы для исправления, принятия и итоговой оценки.
Сравнение реализаций
Решение учитывает несколько метрик сразу: успех по проверкам, которым вы доверяете, стоимость, латентность и метрики конкретного сценария. Сначала сопоставьте их рядом. На 32 новых сообщениях с 95%-ми интервалами по задачам:
| Реализация | Успех, обязательства | Успех, с джаджем | $ за задачу | p95 латентности, с |
|---|---|---|---|---|
| 1. Простой агент | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) | 0.00029 (0.00027–0.00032) | 12.5 (10.9–13.6) |
| 2. Агент с middleware согласования | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) | 0.00028 (0.00025–0.00031) | 9.9 (8.5–11.2) |
| 3. Агент внутри рабочего процесса | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) | 0.00027 (0.00024–0.00029) | 10.8 (8.9–12.4) |
| 4. Роутер и три агента | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) | 0.00029 (0.00026–0.00032) | 9.4 (8.3–10.5) |
| 5. Рабочий процесс без агента | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) | 0.00005 (0.00005–0.00005) | 1.6 (1.5–2.0) |
Ни одна реализация не лидирует во всех столбцах, поэтому ни один одиночный показатель не может однозначно определить выбор между ними.
Граница Парето по двум метрикам
Выберите две наиболее важные для решения метрики и нанесите каждую реализацию на график, указав доверительные интервалы на обеих осях. Здесь таких пар две: успех с джаджем против стоимости задачи и успех с джаджем против p95 латентности. Графики используют уровень джаджа как самый строгий из трёх. Реализация находится на границе Парето (frontier), если нет другой реализации, которая как минимум не уступает ей по обеим метрикам и превосходит по одной из них. AI Agents That Matter называет это границей Парето (Pareto frontier) и строит её для точности и стоимости агентов программирования и ответов на вопросы. Границы и графики стоимости опускают любую реализацию, у которой неизвестна стоимость хотя бы одного запуска.
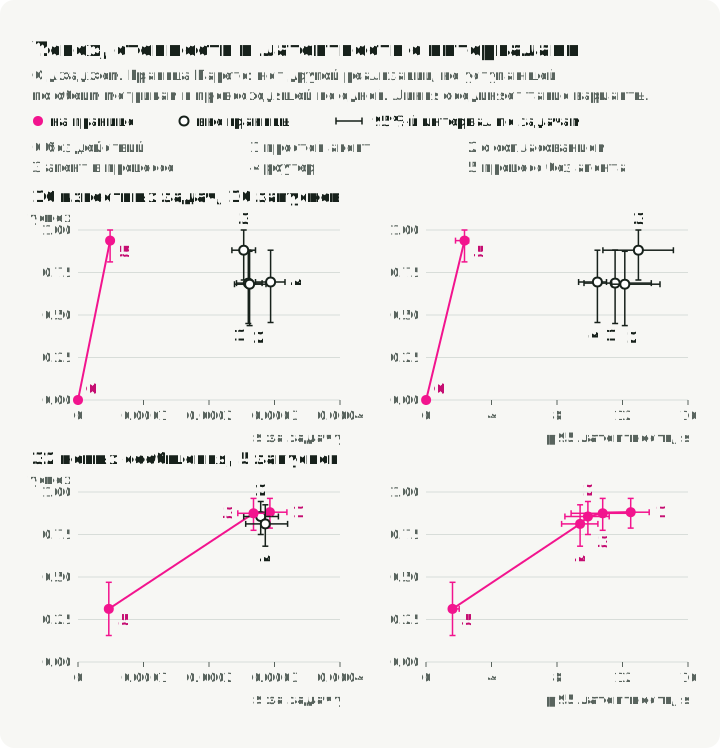
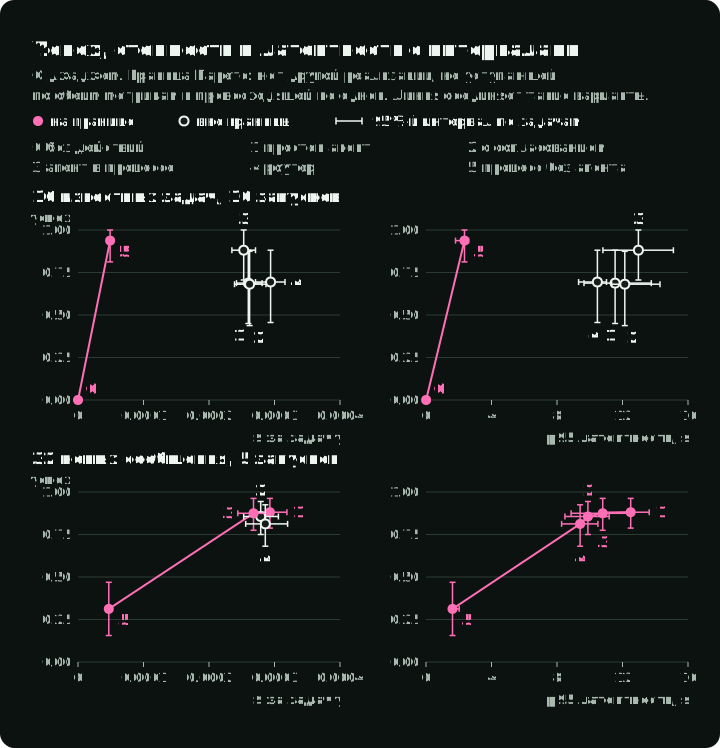
На 16 известных задачах рабочий процесс без агента не менее успешен, чем любая агентная реализация: 0.94 с джаджем против 0.68–0.88. Он дешевле ($0.00005 за задачу против $0.00025–$0.00029) и быстрее (2.4 секунды на 95-м процентиле против 10.5–13.0). Интервалы стоимости и латентности расположены далеко друг от друга. Реализация, которая ничего не делает, также находится на границе Парето с нулевой стоимостью и нулевым успехом. Граница показывает, какие компромиссы эффективны, а не какие реализации приемлемы; это определяют пороги принятия.
На 32 новых сообщениях граница проходит от рабочего процесса без агента (0.31) до агентных реализаций (0.81–0.88). Интервалы рабочего процесса не пересекаются с интервалами ни одного агента по успеху, стоимости и p95 латентности. Выбор агента даёт на 0.50–0.57 больше успеха; он стоит примерно в шесть раз дороже и занимает в шесть–восемь раз больше времени на 95-м процентиле. Среди четырёх агентов только одна пара имеет непересекающиеся интервалы: p95 латентности роутера (8.3–10.5 секунды) ниже, чем у простого агента (10.9–13.6 секунды). Интервалы успеха и стоимости у них перекрываются. Простой агент находится на границе стоимости, поскольку прошёл на один запуск из 160 больше, чем агент внутри рабочего процесса. Все пять реализаций находятся на границе латентности. Другая выборка могла бы переставить агентов местами на любом из графиков. Парное сравнение, описанное далее, разделяет некоторых из них по стоимости или латентности. При оценке с джаджем оно не разделяет никого из них по успеху; выбор между ними требует больше задач или запусков.
Команда make part4-regrade лабораторной работы строит эти четыре графика с помощью функций pareto и frontier_svg из harness-evals.
Выбор между двумя реализациями
Граница Парето показывает каждую реализацию с собственным доверительным интервалом. Чтобы решить, должен ли кандидат заменить текущий харнесс, сравните их напрямую. harness-evals вычисляет долю успеха каждой реализации на каждой задаче, вычитает текущий харнесс из кандидата и повторно сэмплирует эти парные разности. Обе реализации решают одни и те же задачи, поэтому сравнение учитывает различия в сложности задач. Стоимость, латентность, вызовы, токены и метрики сценария получают парные интервалы точно так же: при каждой повторной выборке для обеих реализаций берутся одни и те же задачи.
Парное сравнение оказывается более чувствительным, чем сопоставление двух отдельных интервалов. На новых сообщениях при оценке по обязательствам интервал успеха рабочего процесса без агента составляет от 0.62 до 0.91, а агента внутри рабочего процесса — от 0.86 до 1.00. Эти два интервала перекрываются, но интервал их парной разности (от −0.29 до −0.04) не содержит нуля. При таком же парном сравнении агент внутри рабочего процесса оказывается дешевле простого агента, хотя их раздельные интервалы стоимости перекрываются.
Сначала проверяются пороги принятия: текущая реализация, не прошедшая их, заменяется кандидатом, который укладывается в пороги без добавления критических нарушений. Если обе реализации удовлетворяют порогам, только успех и стоимость за задачу могут побудить правило принять кандидата. Более дешёвая реализация может допустить небольшое снижение успеха. Допустимая потеря (allowed loss) — это наибольшее приемлемое снижение: значение 0.02 здесь означает два процентных пункта, то есть в среднем одну дополнительную неудачу на пятьдесят запусков. Гардрейл (guardrail) ограничивает ухудшение другой метрики относительно текущей реализации, независимо от выигрыша кандидата в успехе или стоимости. Лабораторная работа задаёт один такой гардрейл: p95 латентности может вырасти не более чем на 2 секунды в рамках абсолютного лимита 15 секунд. Остальные метрики приводятся со своими интервалами, но не определяют решение. Правило принимает решение в следующем порядке:
- Отклонить, если кандидат не проходит пороги принятия или имеет больше критических нарушений, чем текущий харнесс.
- Принять, если текущий харнесс не проходит пороги, а кандидат укладывается в них.
- Отклонить, если весь 95%-й интервал разности «кандидат минус текущий» лежит ниже −0.02 по успеху или превышает лимит гардрейла.
- Принять, только если интервал каждого гардрейла укладывается в допустимый лимит и при этом либо растёт успех, либо снижается стоимость при приемлемой потере успеха. Улучшение означает, что весь интервал разности успеха находится строго выше нуля. Путь оптимизации по стоимости требует, чтобы интервал разности стоимости был строго ниже нуля, а интервал разности успеха — не ниже −0.02. Интервал успеха нулевой ширины не может служить основанием для принятия решения только по стоимости.
- В противном случае результат считается неопределённым (inconclusive): сохраните текущий харнесс и добавьте задачи или повторные запуски.
Если обе реализации проходят каждый запуск, повторная выборка их равных показателей успеха всегда даёт разность ноль и интервал [0, 0]. Такой интервал не гарантирует ограничение потери в два пункта на будущих запросах. Поэтому библиотека оставляет принятие только по стоимости неопределённым всякий раз, когда интервал успеха имеет нулевую ширину. Меньшая стоимость на фиксированном наборе для разработки — это измеренный факт; граница будущих потерь успеха требует свежих репрезентативных задач и метода оценки неопределённости, подтверждающего такое утверждение.
Перед сравнением проверьте, что обе записи используют один и тот же полный набор задач, одинаковое число повторов, ту же версию эвалуатора и зафиксированные условия. В закреплённой лабораторной работе этот пример сравнивает рабочий процесс без агента с агентом внутри рабочего процесса на новых сообщениях при оценке по обязательствам. Запустите его командой uv run python из корня лабораторной работы:
from harness_evals import compare
from evaluator.__main__ import grades
from evaluator.support import usecase

current = grades("new", "obligations", 3)  # the agent inside a workflow
candidate = grades("new", "obligations", 5)  # the workflow with no agent
result = compare(usecase("obligations"), current, candidate)
print(result.decision, result.reasons)
print(result.deltas)  # each metric: candidate minus current, and its interval
Рабочий процесс без агента обходится на $0.00022 дешевле за задачу (интервал от −0.00025 до −0.00020) и на 9.2 секунды быстрее на 95-м процентиле (от −10.9 до −7.1). Правило 1 отклоняет его до того, как эти преимущества будут учтены: он не проходит порог надёжности на этих сообщениях. В примере используется оценка по обязательствам, поскольку неоднозначные метки джаджа ещё не были пересмотрены.
Два сравнения из сохранённых запусков показывают, как проверки и задачи меняют решение:
- Реализация 2 (агент с middleware согласования) против реализации 1 (простого агента) на 16 известных задачах. При проверке базы данных реализация 2 проходит каждую задачу (
pass^10равен 1.00). Реализация 1 не проходит порог надёжности (pass^10равен 0.81), поэтому правило 2 принимает реализацию 2. При оценке по обязательствам реализация 2 оказывается лучше на 2 задачах и хуже на 1, а интервал разности лежит в пределах от −0.18 до +0.19. Теперь реализация 2 сама не проходит порог надёжности (pass^10равен 0.81), поэтому правило 1 отклоняет её. - Реализация 5 против реализации 3 (рабочий процесс без агента против агента внутри рабочего процесса), обе при оценке по обязательствам. На 16 известных задачах обе проходят каждый запуск, при этом реализация 5 стоит впятеро дешевле. Парный интервал успеха равен
[0, 0], поэтому сравнение только по стоимости даёт неопределённый результат. На 32 новых сообщениях (сравнение в коде выше) реализация 5 набирает 0.78 против 0.94 у реализации 3 (разность −0.16, интервал от −0.29 до −0.04) и не проходит порогpass^5, поэтому правило 1 отклоняет её. С добавлением джаджа разрыв на новых сообщениях увеличивается до −0.56 (0.31 против 0.88, интервал от −0.73 до −0.38).
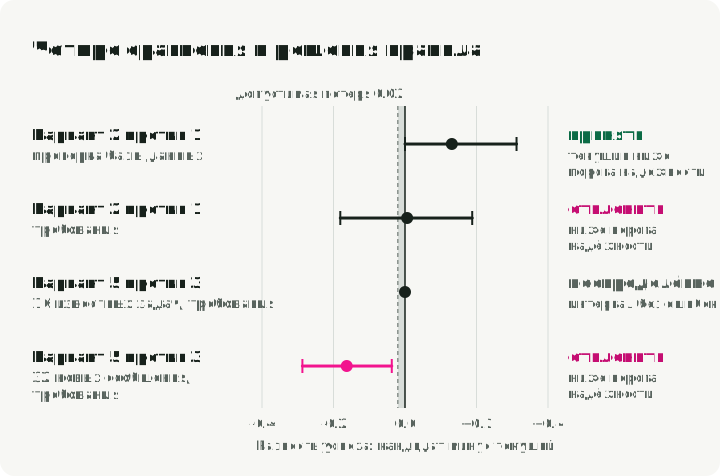
Рисунок сопоставляет интервал каждого сравнения с нулём и допустимой потерей. Читайте две нижние строки вместе: более дешёвый рабочий процесс даёт неопределённый результат на известных задачах и отклоняется на новых сообщениях.
Сколько нужно запусков и задач
Повторные запуски измеряют вариативность одной реализации; большее число задач показывает, насколько результат переносится на другие запросы. Требуется и то и другое в количествах, зависящих от величины различия, которое вы хотите зафиксировать:
- На SWE-bench Verified исследование 60,000 запусков агентов показало, что доля успешных прогонов в одиночном запуске варьировалась на 2.2–6.0 пункта между повторениями. Стандартные отклонения составляли от 1.0 до 1.8 пункта даже при температуре 0. В этих условиях расчёт мощности авторов требует примерно 9 полных повторов бенчмарка на каждого агента, чтобы обнаружить разницу в 2 пункта. Расчёт предполагает стандартное отклонение 1.5 пункта на уровне прогона, мощность 80% и двусторонний порог 5%; это не универсальное правило девяти попыток.
- При 16 задачах наши интервалы составляли примерно ±0.2. Различимыми оказываются лишь разницы в несколько целых задач.
- Когда все запуски успешны, бутстрэп-интервал стягивается к
1.00–1.00, однако неопределённость сохраняется. По статистическому правилу трёх независимых испытаний с нулевым числом ошибок всё равно оставляют верхнюю 95%-ю границу частоты неудач на уровне около , что даёт примерно 19% для . Даже эта оценка предполагает случайную выборку из реального трафика; 16 написанных вручную задач, повторённых 10 раз, не образуют 160 независимых запросов. - harness-evals требует не менее шести задач для принятия решения на основе интервалов. Эта эвристика основана на двустороннем критерии знаков: пять ненулевых разностей по задачам, направленных в одну сторону, дают p-значение 0.0625, что выше 0.05. Шесть — это минимум библиотеки, а не гарантия того, что шесть задач обеспечат надёжное решение.
В наших запусках успех по проверкам базы данных и обязательств почти не менялся на протяжении 10 повторов. Только простой агент провалил одну задачу в одном запуске из десяти. Показания джаджа варьировались чуть сильнее: у каждой агентной реализации оценки менялись на одной задаче между запусками. При проверке базы данных единственный прогон части 3 ранжировал реализации так же, как и 10 повторов здесь.
Но ранжирование по стоимости из одиночного прогона не подтвердилось. В единственном прогоне части 3 простой агент стоил $0.0055 на 16 задач, а агент с согласованием — $0.0039. В 10 повторах здесь стоимость простого агента варьировалась от $0.0036 до $0.0053. Медиана составила $0.00394 для простого агента и $0.00408 для агента с согласованием.
Самым дорогим повтором простого агента оказался первый, в котором 45% входа считывалось из кэша промптов провайдера; последующие повторы читали из кэша от 55% до 69%. Одиночное сравнение, таким образом, смешивает поведение харнесса с состоянием кэша. Чередуйте запуски разных реализаций, фиксируйте кэшированную долю входа и сравнивайте медианные затраты по множеству запусков.
Ошибки оценки, искажающие баллы и рейтинг
Изъян в настройке оценки или процедуре оценивания может сместить баллы, поменять местами лидирующие реализации или развернуть решение о внедрении, даже когда сам харнесс не менялся. В таблице ниже перечислены одиннадцать типичных ошибок, которые инженеры совершают при оценке агентов. Некоторые примеры взяты из опубликованных бенчмарков (LangChain, Anthropic, Darwin Gödel Machine). Другие были измерены непосредственно в наших прогонах службы поддержки путём сравнения более слабых проверок, одиночного повтора или привычных задач со всем тестовым комплектом, чтобы показать масштаб смещения показателей.
| Ошибка | Пример | Предотвращение |
|---|---|---|
| Случайное изменение настроек вместе с харнессом | Оценка LangChain упала с 63.6% до 53.9% при изменении только уровня ризонинга | Фиксировать неизменные условия отдельно от тестируемых изменений |
| Проверка только итоговой базы данных | Реализация, которая ничего не делает, прошла половину задач службы поддержки | Проверять действия и ответы; сначала запускать реализацию без действий |
| Разрешение харнессу самому формировать данные оценки | Версия Darwin Gödel Machine прошла проверку, удалив маркеры логов, которые читала проверка | Оценивать внешним процессом и ограничивать доступ к проверкам, разметке и достоверным записям |
| Доверие неизмеренному джаджу | Первый джадж прочитал 19 из 20 ответов реализации 2 об ожидании решения как выполненные возвраты | Размечать ответы до запуска джаджа; измерять его на метках, на которых он не настраивался |
| Подгонка под задачи, результаты которых публикуются | Рабочий процесс без агента набрал 0.94 на своих 16 задачах и 0.31 на новых сообщениях (оба с джаджем) | Использовать валидационные задачи для отбора кандидатов и оставлять свежие задачи для финальной оценки |
| Скрытие нарушения за средним значением | В этих запусках нарушений не было, но один возврат не тому клиенту на 200 запусков снизил бы средний успех всего на 0.005 | Учитывать критические нарушения отдельно и требовать ноль, как ToolSandbox оценивает любой запуск с «миной» в ноль |
| Отношение к одиночному запуску как к результату | В одном повторе простой агент выглядел на 40% дороже агента с согласованием; за 10 повторов их медианы сошлись в пределах 4% | Повторять и чередовать запуски; сравнивать медианную стоимость; приводить pass^k и доверительные интервалы |
| Принятие решений только по успеху | С джаджем простой агент лидирует на новых сообщениях всего на 1 запуск из 160. При этом реализация 3 дешевле на задачу, и весь парный интервал лежит ниже нуля | Публиковать стоимость, латентность, вызовы и токены рядом с успехом с интервалами; строить границу Парето; задавать гардрейлы до сравнения |
| Приравнивание неизвестной стоимости к нулю | Вызовы модели решений роутера вернулись без тарифицированной стоимости; посчитанные нулём, они выпали бы из стоимости реализации 4 | Рассчитывать по прейскуранту или считать стоимость неизвестной и браковать проверку стоимости, пока стоимость любого запуска остаётся неясной |
| Смешивание сбоев инфраструктуры со сбоями харнесса | Ошибки инфраструктуры Anthropic снизились с 5.8% до 0.5% при изменении одних лишь ресурсов контейнера | Классифицировать ошибки; учитывать их отдельно, по-прежнему считая неудачами |
| Сравнение результатов между версиями эвалуатора | Реализация 2 получила 1.00 при проверке базы данных из части 3 и 0.81 при оценке по обязательствам | Версионировать проверки; сравнивать только запуски, оценённые одной и той же версией |
Сопутствующий код
harness-evals — библиотека для Python 3.12+ без сторонних зависимостей вне стандартной библиотеки. Адаптер подключает её к харнессу: ваша функция выполняет список задач один раз и возвращает одну запись наблюдений на задачу. Функция run библиотеки вызывает каждый адаптер одинаковое число раз, чередуя реализации, а функции оценивания проверяют записи. Эти функции формируют результаты из этой статьи:
summarizeвыводит перечисленные метрики с доверительными интервалами для долей, стоимости, латентности, вызовов и токенов.paretoиfrontier_svgнаходят и строят границу Парето.failure_map_svgотображает, где именно каждый харнесс терпит неудачу.compareприменяет правило принятия. Гардрейлы объявляются в сценарии:guardrails={"latency_p95": ("<=", 2.0)}разрешает рост не более чем на 2 секунды.
compare отклоняет записи с разными наборами задач или числом повторов. Команда harness-evals compare также сверяет загруженные записи каждой реализации с манифестом: идентификаторы задач, сплит, уникальные строки задача/попытка и объявленные повторы должны совпадать. Манифесты фиксируют контрольные суммы ID задач, входных данных, сплитов, названий проверок и флагов критичности, а также версию сценария и зафиксированные настройки; из Python вызывайте comparable для сопоставления этих метаданных. comparable не сравнивает версию эвалуатора или число повторов, а изменение логики проверки под тем же именем требует новой версии сценария.
Установите библиотеку в проект под управлением uv:
uv add "harness-evals @ git+https://github.com/slavadubrov/harness-evals@03cc80db2fd7039515887baf5c5321c3957139fa"Вы описываете сценарий как задачи с проверками и пишете по одному адаптеру на харнесс. Live-адаптер лабораторной работы запускает раннер ассистента в отдельном процессе, затем читает базы данных каждой задачи. Этот фрагмент показывает, откуда берутся данные о возвратах:
def observe(start: Path, final: Path, task_id: str):
    passed = TASKS_BY_ID[task_id].check(start, final).passed
    actions = [
        Action("refund", {"order": r["order_id"],
                          "cents": r["amount_cents"],
                          "refund_id": r["id"]})
        for r in diff(start, final)["refunds"].added
    ]
    ...  # plus the refunds the service still holds for the case
Это обнаруживает добавленную строку возврата, даже если харнесс обошёл сервис. Если харнесс может напрямую писать в файлы базы данных, вам всё равно понадобятся разрешения на файлы и процессы, описанные выше. Адаптер одинаково работает и с агентом, и с рабочим процессом, поскольку наблюдает за их эффектами через один и тот же интерфейс.
Чтобы пересчитать оценки по сохранённым запускам, используйте Python 3.12 и uv. Цели Make лабораторной работы сначала устанавливают закреплённые зависимости; API-ключ или новый вызов модели не требуются. Команды закрепляют точную ревизию сопутствующего кода, использованную здесь:
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout 19c7712762cca7b4f0af07523f3590ddf8ce8bb9
make part4-regrade       # grades the saved runs; writes RESULTS.md, frontier plots and failure maps
make part4-agreement     # both judge versions and the reply check against the labels
make part4-compare BASE=3 CANDIDATE=5 SPLIT=new
make failures DESIGN=5 SPLIT=new LEVEL=judge        # the checks design 5 fails, task by task
make show DESIGN=2 TASK=refund-over-limit-approved  # one saved run, check by check
make mine                # score your own function on the 16 known tasks
Команда part4-compare сравнивает реализацию 5 с реализацией 3 на новых сообщениях при оценке по обязательствам. Она выводит разность успеха −0.163 (95%-й интервал от −0.287 до −0.037), а также парные разности стоимости, латентности, вызовов и токенов. Она возвращает отклонить (reject), поскольку реализация 5 не проходит порог надёжности. Добавьте LEVEL=judge, чтобы включить сохранённые классификации джаджа. Повторная оценка переиспользует наблюдения и вердикты; она не воспроизводит независимым образом исходное поведение модели.
make show выводит один сохранённый запуск так, как его видел эвалуатор: сообщение клиента, записи сервиса возвратов, ответ и вердикт каждой проверки. make mine запускает examples/your_harness.py, шаблон без вызова модели и с API только для возвратов. Замените его функцию собственным агентом или рабочим процессом, затем обновите выводимые метаданные модели, вызовы, токены и стоимость. Указывайте фактическое использование, когда оно измерено, и оставляйте неизвестные значения неизвестными; нулевой расход шаблона на правилах не описывает вызов модели. Поддержка задач с адресами и настройками также потребует расширения его API.
Необязательные live-запуски используют make part4-live TRIALS=5 с ключом OpenRouter в OPENROUTER_API_KEY. Это запускает все пять реализаций на 16 известных задачах с платными вызовами модели. Адаптер тестировался только с реализацией, которая ничего не делает. По ценам октября 2026 года сохранённые агентные запуски стоили около $0.0003 на задачу и повтор; 5 повторов всех четырёх агентных реализаций плюс рабочий процесс обошлись бы примерно в $0.10 без учёта вызовов эвалуатора. Live-режим использует уровень обязательств и не запускает джаджа.
Что делать дальше
На своём харнессе начните с трёх проверок, изменивших результат здесь. Запустите реализацию, которая ничего не делает: на этих задачах она прошла 8 из 16 при проверке только итоговой базы данных. Проверяйте и ответ, и действие: агент с middleware согласования (реализация 2) оформил каждый одобренный возврат и сообщил клиенту, что тот всё ещё ожидает решения. Оцените кандидата на сообщениях, под которые он не создавался. Здесь рабочий процесс без агента упал с 1.00 на собственных 16 задачах до 0.78 на 32 новых при оценке по обязательствам и до 0.31, как только джадж прочитал ответы. Задайте пороги до того, как увидите эти оценки, а затем сравните две реализации по правилу.
В следующей части программа будет предлагать изменения харнесса, а этот эвалуатор — оценивать их. Оценивайте такой поиск при фиксированном бюджете: считайте предложенные и принятые изменения, включайте стоимость генерации предложений и их оценки, сообщайте о регрессиях и улучшениях на отложенных задачах. Повторяйте независимые сессии поиска для оценки самой процедуры, как в Beyond Prompts. Используйте ошибки на наборе для разработки для правок, а задачи валидации — для отбора; держите эвалуатор и итоговые тестовые задачи раздельно. Каждый кандидат обязан укладываться в лимиты успеха, стоимости и латентности, поскольку одни лишь повторные попытки способны повысить точность за счёт роста расходов (AI Agents That Matter).
Эта статья оценивает харнессы; она не демонстрирует рекурсивное самоулучшение. Фиксированная программа, ищущая лучший код харнесса, — это автоматическая оптимизация. Более сильное утверждение о рекурсии требует, чтобы сохранённые изменения влияли на процесс, производящий последующие изменения, — различие, которое Harness² проводит между харнессами выполнения и харнессами улучшения. Такой процесс потребовал бы сравнения при равных бюджетах на свежих задачах.