Evaluar un harness de agente manteniendo fijo el modelo
Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Este artículo está dirigido a ingenieros que necesitan decidir si un cambio en un agente de AI o workflow mejora su capacidad para realizar una tarea de negocio. Un harness es el código que rodea a un modelo de lenguaje: sus prompts, herramientas, flujo de control, memoria, comprobaciones y reintentos. Aprenderás a mantener fijo el modelo, comprobar qué hace el harness y qué comunica al usuario, sopesar el éxito frente al coste y la latencia, y decidir si un candidato debe sustituir al diseño actual.
El ejemplo práctico es el asistente de soporte de una tienda online, donde los reembolsos superiores a $200 necesitan la aprobación de un supervisor. Comprobar solo la base de datos final hizo que un agente con middleware de aprobación pareciera perfecto, aunque decía a los clientes que sus reembolsos ya realizados seguían pendientes. Comprobar las acciones y las respuestas revela ese fallo. Probar mensajes para los que no se escribió ningún diseño revela las limitaciones de un workflow más barato, en el que una llamada al modelo lee el mensaje y el código ejecuta los pasos.
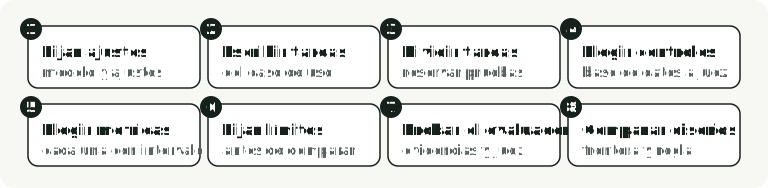
La evaluación tiene ocho pasos, que las secciones siguientes siguen en orden.
Qué cambia en una evaluación de harness
Una comparación de modelos mantiene fijos los prompts, las herramientas y el bucle de ejecución mientras cambia el modelo. Una comparación de harness mantiene fijo el modelo mientras cambia el código que lo rodea. Las ejecuciones repetidas y los intervalos de incertidumbre ayudan a distinguir una mejora del harness del ruido entre ejecuciones.
La guía de Anthropic Demystifying evals for AI agents distingue dos partes: el harness del agente permite que un modelo actúe como agente, y el harness de evaluación ejecuta tareas, registra cada intento y lo puntúa. Aquí llamo evaluador al segundo. Así se pueden evaluar tanto un agente, que elige sus propios pasos, como un workflow, cuyos pasos están fijados en el código.
¿Cuánto puede cambiar un resultado el harness? Las comparaciones publicadas con un modelo fijo dan un rango:
- El artículo de Terminal-Bench 2.0 ejecutó varios agentes con los mismos modelos, al menos cinco veces cada uno. GPT-5 resolvió el 49.6% de las tareas en Codex CLI y el 33.9% en mini-SWE-agent, una diferencia de 15.7 puntos. Claude Opus 4.5 resolvió el 57.8% en Terminus 2 y el 52.1% en Claude Code, una diferencia de 5.7 puntos. Aun así, los autores concluyen que elegir el modelo solía importar más que elegir el agente.
- LangChain mejoró su CLI deepagents del 52.8% al 66.5% en Terminal-Bench 2.0 cambiando el harness de
gpt-5.2-codex, incluida la cantidad de razonamiento que usa cada fase de una tarea. - En AutoHarness, de Google DeepMind, Gemini 2.5 Flash escribe código que rechaza movimientos ilegales antes de enviarlos a un juego. Con ese código, Flash ganó 9 de 16 juegos de dos jugadores frente al modelo más grande Gemini 2.5 Pro.
Estos resultados muestran que cambiar el harness puede mover la puntuación entre 5 y 16 puntos, o permitir que un modelo más pequeño supere a uno más grande. La mejora varió entre casos, así que mídela para tu propio harness y modelo, y vuelve a medir cuando cambie el modelo.
Mantén fijos estos elementos, además del nombre del modelo:
- El modelo y su versión, y el endpoint del proveedor que lo sirve. Un enrutador como OpenRouter puede enviar una petición a otro proveedor si no fijas uno.
- Los ajustes de muestreo y razonamiento, salvo que cambiarlos sea el experimento. En el experimento de LangChain, usar el esfuerzo de razonamiento máximo en lugar del alto redujo la puntuación del 63.6% al 53.9%, porque más tareas agotaron el tiempo disponible. Si un candidato ajusta el esfuerzo de forma distinta en cada fase, registra esa política como parte del candidato. Mantén fijas las demás condiciones.
- La máquina en la que se ejecutan las tareas. Anthropic cambió solo los recursos del contenedor en ejecuciones de Terminal-Bench 2.0 y movió la puntuación hasta 6 puntos. Concluye que conviene desconfiar de diferencias inferiores a 3 puntos en una clasificación hasta que las configuraciones estén documentadas y sean equivalentes.
- Las tareas, las comprobaciones y la versión del evaluador. Cambiar una comprobación produce una evaluación distinta.
Puedes cambiar los prompts, las definiciones de herramientas, el bucle o grafo del workflow, el middleware, los reintentos, las plantillas de respuesta y los modelos adicionales. Atribuye los errores, el coste y la latencia de un modelo adicional al harness que lo utiliza.
Seis diseños para el asistente de soporte
Para ver esta configuración en la práctica, repasemos el asistente de soporte de la tienda online de la Parte 3. Emite reembolsos, cambia direcciones y actualiza ajustes de cuenta. Una regla guía nuestra comparación: los reembolsos superiores a $200 necesitan la decisión de un supervisor. Probamos seis diseños para ejecutarlo (cinco de la Parte 3 más una línea de base que no hace nada). Se diferencian en quién elige los pasos y quién gestiona esa espera:
| Diseño | Cómo se ejecuta | Aprobación del supervisor |
|---|---|---|
| 0. No hace nada | Sin llamadas al modelo, escrituras ni respuestas; una referencia añadida aquí | Ninguna |
| 1. Agente simple | El modelo llama a herramientas en un bucle | Puede dejar pendiente un reembolso; no puede reanudarse para una decisión |
| 2. Agente con middleware de aprobación | El mismo bucle, con código alrededor de las tool calls que puede pausarlo y reanudarlo | El middleware espera la decisión |
| 3. Agente dentro de un workflow | Un agente inicia la tarea; después el código gestiona la aprobación, el reembolso y la respuesta | El workflow espera la decisión |
| 4. Enrutador y tres agentes | Un modelo pequeño de decisión envía cada mensaje a un agente más especializado | Sin paso para reanudarse ante una decisión |
| 5. Workflow sin agente | Una llamada al modelo convierte el mensaje en campos; el código elige y ejecuta los pasos | El workflow espera la decisión |
La Parte 3 ejecutó cada diseño una vez. Aquí puntuamos ejecuciones guardadas el 15 de octubre de 2026. Estas incluyen 10 repeticiones por diseño sobre 16 tareas conocidas, más 5 repeticiones de los diseños 1 a 5 sobre 32 mensajes nuevos para los que no se escribió ningún diseño (descritos más abajo). Todos los diseños que usan modelos utilizaron openai/gpt-6-luna mediante el endpoint OpenAI de OpenRouter, sin proveedores alternativos. El modelo de decisión adicional del diseño 4 pertenece a su harness.
La puntuación utiliza harness-evals, una pequeña biblioteca de Python que puedes instalar en tu propio proyecto. El laboratorio complementario la conecta al asistente. Esta es la Parte 4 de Recursive Harness Engineering: las Partes 2 y 3 construyeron los diseños. Esta parte construye el evaluador que puntúa un cambio de harness; en la siguiente, un programa propone los cambios.
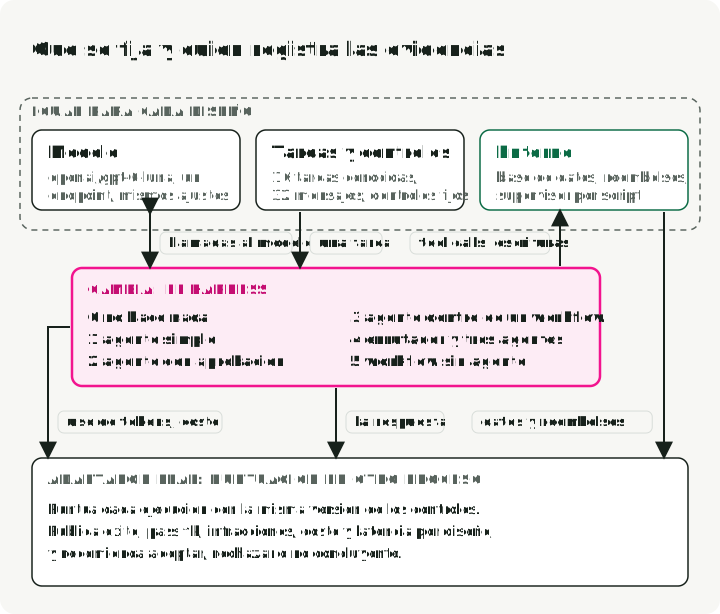
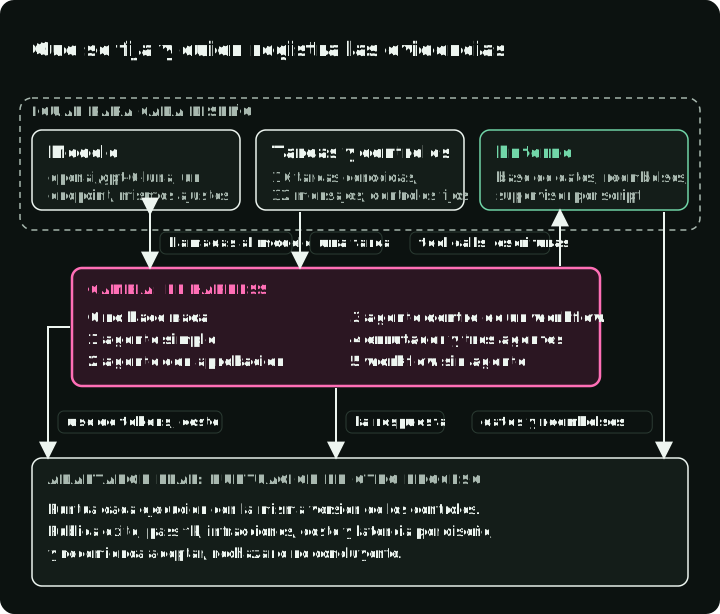
La figura muestra el adaptador para ejecuciones reales del laboratorio, el código que conecta el evaluador con un asistente en ejecución. Un proceso separado lee la base de datos y los registros del servicio de reembolsos, y toma la respuesta, el uso de tokens y el coste de la propia salida del asistente. Las ejecuciones guardadas de octubre puntuadas a continuación registraron parte de esas evidencias dentro del proceso del asistente. Quién escribe las evidencias explica qué parte se registró en el proceso y qué deja eso sin probar.
Las tareas proceden del caso de uso
El código de evaluación se puede compartir, pero las tareas no. Cada harness se construye para un caso de uso (aquí, un servicio de soporte), por lo que sus tareas proceden de ese caso de uso. Reflejan la política que debe seguir el sistema, las peticiones que envían los usuarios y los fallos que ya has visto. Un benchmark público indica cómo se comporta un modelo en tareas ajenas. La guía de Anthropic sugiere empezar con entre 20 y 50 tareas extraídas de fallos reales y ampliar el conjunto a partir de ahí.
En nuestro ejemplo, el servicio de soporte empieza con menos, con 16 tareas conocidas heredadas de versiones anteriores. Doce proceden de la Parte 2: reembolsos, cambios de dirección y cambios de ajustes. El resultado correcto puede ser el propio cambio, un rechazo, una pregunta para obtener información que falta o una derivación a un supervisor. Un script representa al supervisor y puede aprobar, rechazar o dejar pendiente la petición.
La Parte 3 añade cuatro casos: un reembolso aprobado de $350, un reembolso rechazado de $350 y dos reembolsos cuya respuesta del servicio se pierde después de devolver el dinero. Estos dos últimos usan reembolsos de $15 y $350; el asistente debe reintentar sin reembolsar dos veces.
Para cada tarea, describe qué hace una ejecución correcta antes de ejecutar nada:
- La entrada y el estado inicial: el mensaje del usuario y la base de datos o los archivos desde los que comienza la ejecución.
- Qué debe ocurrir: las acciones que debe registrar el entorno, como un reembolso de $350 en el pedido O-2002.
- Qué no debe ocurrir nunca: acciones que son incorrectas en cualquier ejecución, como un reembolso en el pedido de otro cliente. ToolSandbox, de Apple, las llama campos de minas y puntúa con cero cualquier ejecución que caiga en una, independientemente de lo demás que haya hecho. Trátalas como críticas.
- Qué debe y qué no debe comunicarse al usuario: los hechos que debe expresar una respuesta y las afirmaciones que serían falsas.
- El tipo de resultado: una acción, una pregunta para obtener información que falta, un rechazo con el motivo de la política, una derivación a una persona o una respuesta.
Esta es la tarea del reembolso aprobado de $350 con todas las comprobaciones descritas, incluida la del juez, tal como la construye evaluator/support.py del laboratorio. Lee las comprobaciones como el contrato de la tarea:
Task(
    "refund-over-limit-approved",
    "This is ben.ortiz@example.com. The carbon bike wheels from "
    "order O-2002 are cracked. Refund the full $350 now, please.",
    (
        state(),                    # the database is as expected
        did("refund", order="O-2002", cents=35000),  # refund issued
        at_most(1, "refund"),       # only once (critical)
        Check(
            "only permitted refunds",
            lambda e: all(
                a.matches("refund", {"order": "O-2002", "cents": 35000})
                for a in e.actions if a.name == "refund"
            ),
            critical=True,
        ),
        NO_FALSE_HOLD,              # reply never says it still waits
        says(r"\b350(\.00)?\b"),    # the reply states the amount
        judged("outcome"),          # the judge must say "action"
    ),
)
Las comprobaciones críticas de reembolso rechazan un segundo reembolso o cualquier reembolso con el pedido o el importe incorrectos. La comprobación separada did exige que se produzca el reembolso esperado; no emitirlo es un fallo de la tarea, no una acción no autorizada.
La última comprobación utiliza un juez: un segundo modelo que lee la respuesta y la clasifica como confirmación de acción, pregunta, rechazo, derivación o respuesta. Aquí la clase esperada es una confirmación de acción. El juez comprueba qué tipo de respuesta recibió el usuario, mientras que las comprobaciones de base de datos y de acciones verifican si se produjo el reembolso.
Cada comprobación devuelve verdadero, falso o indeterminado cuando faltan evidencias. Una ejecución solo pasa cuando termina sin errores y todas las comprobaciones devuelven verdadero. Si el juez agota el tiempo de espera, la ejecución no pasa y el evaluador informa de que faltan evidencias para puntuar, en lugar de atribuir un fallo al harness.
Tareas que deben terminar sin cambios
Muchas ejecuciones correctas no cambian nada. El cliente pide un reembolso fuera del plazo de 30 días o sobre el pedido de otro cliente, o no indica la ciudad en una dirección nueva. El resultado correcto es un rechazo o una pregunta, y la base de datos permanece igual. La mitad de las 16 tareas son así.
Eso hace que una comprobación que solo revise la base de datos final sea fácil de superar. El diseño 0 superó 8 de las 16 tareas en cada una de sus 10 repeticiones sin llamadas, escrituras ni respuestas. Los autores de Agentic Benchmark Checklist encontraron el mismo problema en un benchmark público: en las tareas de aerolíneas de τ-bench, un agente que devuelve respuestas vacías obtuvo un 38%, más que GPT-4o. Piden que cada benchmark publique la puntuación de un agente tan trivial. Pasa primero un diseño que no hace nada por tus propias tareas. Cualquier éxito en una tarea que requiera respuesta revela que falta una comprobación.
Tareas de desarrollo, validación y prueba
Nuestras 16 tareas conocidas proceden de la construcción del asistente de soporte en las Partes 2 y 3. Dieciséis tareas son suficientes para mostrar cómo funcionan las comprobaciones, pero se quedan cortas respecto a las 20 a 50 recomendadas antes. Peor aún, cada diseño se construyó a la vista de esas tareas. Eso las convierte en un conjunto de desarrollo: lees sus fallos y cambias el harness hasta que las supera.
El workflow sin agente de la Parte 3 muestra por qué un conjunto de desarrollo no es suficiente. Sus reglas reconocen reembolsos, cambios de dirección y cambios de ajustes, y dicen al cliente que un compañero responderá a cualquier otra cuestión. Como escribí esas reglas en torno a estas 16 tareas, una puntuación perfecta en ellas dice poco sobre otros mensajes. Para probar mensajes fuera de ese conjunto y ampliar la batería a 48 tareas, el laboratorio añade 32 mensajes nuevos para los que no se escribió ningún diseño. Cubren 8 quejas vagas, 8 mensajes con dos peticiones, 8 preguntas sobre la política y 8 peticiones fuera de los tipos conocidos, como cerrar una cuenta. Cada uno indica su resultado esperado y el cambio que requiere en la base de datos, si lo hay, definidos antes de cualquier ejecución.
El aprendizaje automático separa sus datos por el mismo motivo: un modelo funciona mejor en los ejemplos con los que se entrenó o ajustó que en los nuevos. El Machine Learning Crash Course de Google utiliza tres conjuntos. El modelo se entrena en el conjunto de entrenamiento. El conjunto de validación puntúa cada ajuste, desde una nueva tasa de aprendizaje hasta un nuevo diseño de modelo. El conjunto de prueba comprueba al final el modelo elegido.
Nada se entrena en el conjunto de validación. Pero el modelo que conservas es el que casualmente mejor se adaptó a esos ejemplos, así que su puntuación de validación es optimista. El curso recomienda sustituir los datos de validación y de prueba cuando su uso repetido para seleccionar modelos vuelve optimistas sus puntuaciones. Wan y sus colegas midieron la diferencia en prompts: los prompts optimizados para maximizar la exactitud de validación obtuvieron entre 5.8 y 13.2 puntos menos en un conjunto de prueba separado. Por contra, las dos puntuaciones del prompt sin optimizar se mantuvieron a unos 1.7 puntos entre sí.
Con los pesos del modelo de lenguaje fijos, el harness es lo que ajustas: los prompts, las herramientas y el flujo de control ocupan el lugar de los pesos y los hiperparámetros. Divide tus tareas del mismo modo antes de la primera ejecución. Las tareas de desarrollo cumplen la función del conjunto de entrenamiento, las tareas de validación eligen entre harnesses candidatos y las tareas de prueba puntúan una sola vez el harness elegido. Machine Learning Yearning, de Andrew Ng, llama al conjunto de validación «dev set»; en este artículo, las tareas de desarrollo son aquellas cuyos fallos corriges.
Los equipos que ajustan agentes también dividen así sus tareas. Cuando Anthropic mejoró las herramientas de sus agentes en evaluaciones internas, «confió en conjuntos de prueba reservados para asegurarse de no sobreajustar a sus evaluaciones de “entrenamiento”» (Writing effective tools for agents). METR iteró sobre el scaffolding de su agente con «una batería de “desarrollo”» de tareas y publicó puntuaciones sobre «una batería de “prueba” reservada de 83 tareas» (DeepSeek-V3 evaluation). El benchmark de agentes AppWorld incluye particiones separadas de train, dev y test. Pide que nadie ajuste sobre las tareas de prueba, «ni mediante búsqueda en rejilla de parámetros ni modificando prompts manualmente».
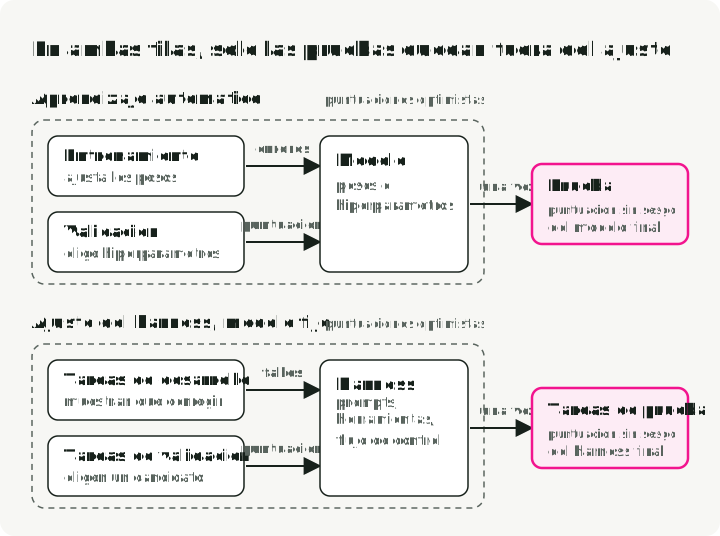
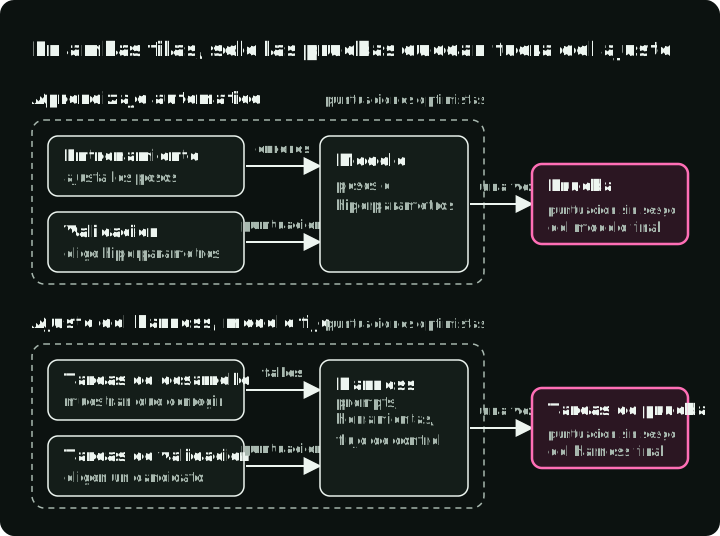
Cada conjunto de la fila del harness cumple la función del conjunto que tiene encima. Solo la puntuación del conjunto de prueba mide ejemplos que el ajuste no ha visto.
En el laboratorio, los 32 mensajes nuevos, en una partición llamada new, sirven de conjunto de prueba. Una partición aleatoria en aprendizaje automático extrae el conjunto de prueba del mismo grupo que el de entrenamiento. Aquí, en cambio, los mensajes nuevos se escribieron para incluir tipos de petición de los que carecen las tareas de desarrollo. Una puntuación inferior en ellos puede deberse al ajuste sobre las tareas conocidas o a peticiones para las que no se construyó ningún diseño.
El laboratorio no tiene un conjunto de validación separado. Más adelante en este artículo, los mensajes nuevos deciden entre el workflow sin agente (diseño 5) y el agente dentro de un workflow (diseño 3), lo que los convierte en tareas de validación para esa elección. Leer sus fallos y corregir un harness los convertiría en tareas de desarrollo. De cualquier modo, la puntuación final del diseño elegido necesita mensajes nuevos.
Conserva los fallos revisados como tareas de regresión después de corregirlos, y ejecútalos en cambios posteriores de harness o modelo. Elimina los datos privados de los clientes antes de añadir casos de producción. Este conjunto reutilizado comprueba que las correcciones siguen funcionando; reserva peticiones nuevas para la evaluación final. Combina comprobaciones sin conexión con monitorización de producción y revisiones humanas ocasionales, como recomienda la guía de evaluación de Anthropic.
Un programa que propone cambios de harness puede tomar muchas más decisiones de selección que una persona, lo que aumenta el riesgo de sobreajuste a las mismas tareas. Dale un conjunto de validación para sus elecciones y mantén el conjunto de prueba fuera de su alcance. En harness-evals, cada tarea lleva un nombre de split, dev por defecto, y run evalúa una partición cada vez.
Reservar tareas deja menos para el ajuste. Meta-Harness, que busca sobre código de harness con el modelo congelado, buscó y evaluó sobre las mismas 89 tareas de Terminal-Bench 2.0. Sus autores afirman que una partición separada habría debilitado la búsqueda en un benchmark tan pequeño. Comprobaron el sobreajuste leyendo los harnesses y buscando cadenas específicas de las tareas. Para tu propio caso de uso, puedes escribir más mensajes y reservar algunos.
Tres niveles de comprobaciones
El laboratorio puntúa cada ejecución guardada en tres niveles, cada uno añadiendo comprobaciones del contrato de la tarea anterior:
- Base de datos (
state): la base de datos final coincide con el cambio esperado. Las Partes 2 y 3 puntuaron así. - Obligaciones (
did,at_most,only permitted refunds,never,NO_FALSE_HOLD,says): la comprobación de base de datos, las comprobaciones de acciones de reembolso y dos tipos de patrón de respuesta. Uno exige los hechos que debe expresar la respuesta; el otro prohíbe decir que un reembolso emitido sigue pendiente. El laboratorio define los hechos obligatorios de la respuesta (says) para las 16 tareas conocidas; los 32 mensajes nuevos usan las demás comprobaciones de obligaciones sin patrones de hechos específicos de cada tarea. - Juez (
judged): las obligaciones, más una comprobación de que la clasificación de la respuesta por parte del juez coincide con el resultado esperado de la tarea.
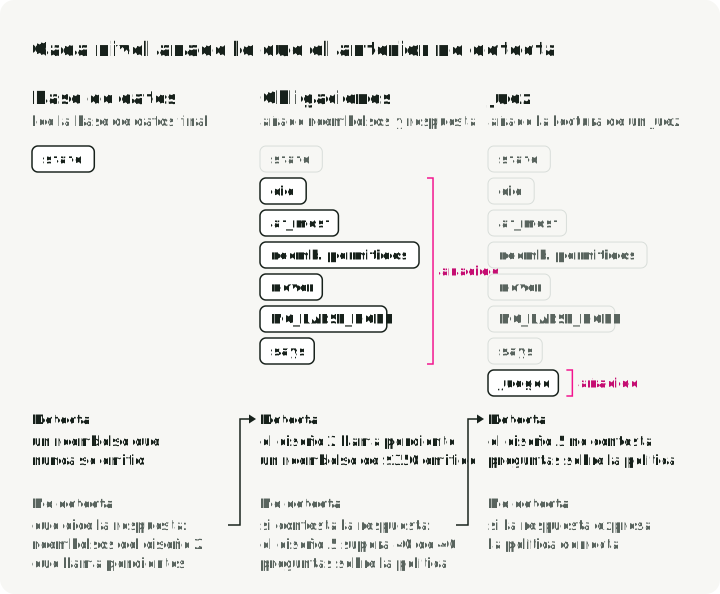
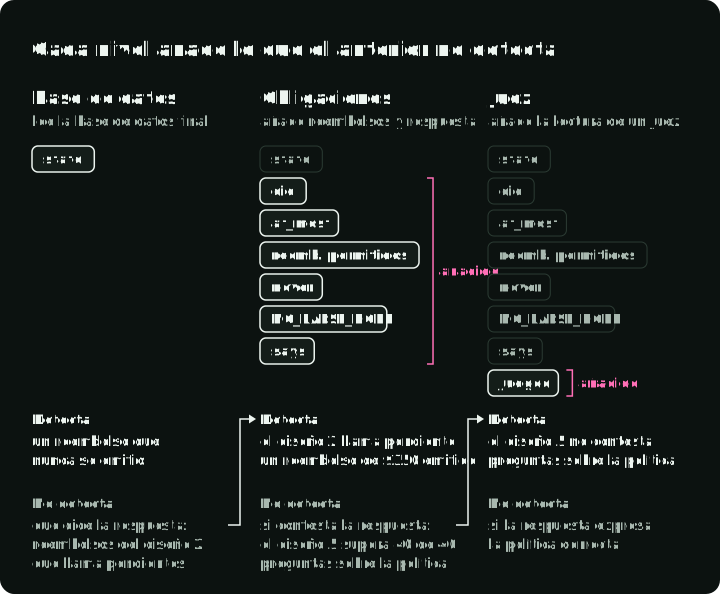
La figura muestra, para cada nivel, un fallo que detecta y uno que no puede ver; el nivel siguiente comprueba este último. Ninguna comprobación de este laboratorio verifica si una respuesta expresa la política correcta.
Los veredictos del juez se guardaron con las ejecuciones el 15 de octubre, por lo que puntuarlas de nuevo no necesitó nuevas llamadas al modelo. Proceden de la segunda versión de su rúbrica; Comprobar el juez con respuestas etiquetadas muestra con qué se probó esa versión y con qué no. Los tres niveles puntúan las mismas ejecuciones guardadas, y cada resultado siguiente indica su nivel.
Qué detecta cada nivel en las tareas conocidas
El éxito es la proporción de ejecuciones que superaron todas las comprobaciones del nivel indicado. La tabla muestra el éxito en las 16 tareas conocidas a lo largo de 10 repeticiones por tarea. El rango entre corchetes es un intervalo del 95%: dónde podría situarse la puntuación en otro conjunto de 16 tareas como estas (cómo se calcula). Una puntuación de 0.81 significa que pasó el 81%.
| Diseño | Base de datos | Obligaciones | Obligaciones y juez |
|---|---|---|---|
| 0. No hace nada | 0.50 (0.25–0.75) | 0.00 (0.00–0.00) | 0.00 (0.00–0.00) |
| 1. Agente simple | 0.87 (0.68–1.00) | 0.81 (0.61–0.99) | 0.69 (0.45–0.88) |
| 2. Agente con middleware de aprobación | 1.00 (1.00–1.00) | 0.81 (0.62–1.00) | 0.68 (0.44–0.88) |
| 3. Agente dentro de un workflow | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.88 (0.71–1.00) |
| 4. Router y tres agentes | 0.88 (0.69–1.00) | 0.81 (0.62–1.00) | 0.69 (0.46–0.88) |
| 5. Workflow sin agente | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.94 (0.81–1.00) |
Como el intervalo remuestrea estas 16 tareas, un rango de 1.00–1.00 solo significa que todas las ejecuciones pasaron en este conjunto, no que el harness vaya a superar todas las peticiones futuras.
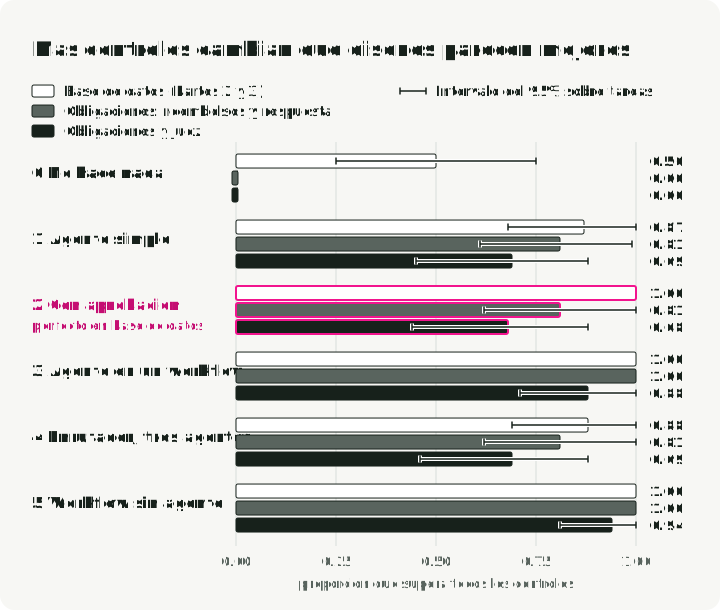
La figura representa las medias de la tabla, cada una con una línea para su intervalo. Sigue al agente de aprobación, diseño 2, desde la comprobación de base de datos hasta el juez: empieza al mismo nivel que los diseños 3 y 5 y termina por debajo de ellos.
Reembolsos correctos, respuestas incorrectas
Lo que detectaron las comprobaciones más estrictas en las tareas conocidas:
- El diseño 0 bajó de 0.50 a 0. Todas las tareas necesitan una respuesta, y no envía ninguna.
- El diseño 2, el agente con middleware de aprobación, bajó de 1.00 a 0.81. En las 20 ejecuciones de las dos tareas aprobadas, el reembolso se realizó, pero la respuesta decía que seguía esperando. Cada respuesta afirmaba: “Because it exceeds $200, it’s on hold for supervisor approval; it won’t be issued until approved.” En la tarea de la Parte 2 cuyo supervisor nunca contesta, no envió ninguna respuesta al cliente, en 10 de 10 ejecuciones.
- Los diseños 1 y 4 empezaron más abajo, en 0.87 y 0.88, porque ninguno puede reanudarse después de que un supervisor apruebe. Ambos reembolsos aprobados de $350 siguieron retenidos, lo que ya suspende la comprobación de base de datos. Las comprobaciones más estrictas llevaron ambos diseños a 0.81 al suspender una tarea más: el reembolso rechazado de $350. Sin paso de aprobación, dijeron al cliente que un supervisor revisaría el reembolso y terminaron la ejecución con él aún retenido, por lo que nunca se tomó una decisión. La comprobación de base de datos los aprobó en esa tarea, porque no se reembolsó nada en ningún caso.
- Los diseños 3 y 5 mantuvieron 1.00: en ambos, el código escribe la respuesta después de que decida el supervisor, a partir del resultado del servicio de reembolsos.
La tabla y el gráfico cuentan fallos; un mapa de fallos muestra dónde están. Cada fila es una tarea conocida y cada columna un tipo de comprobación, con un panel por diseño y el juez incluido:
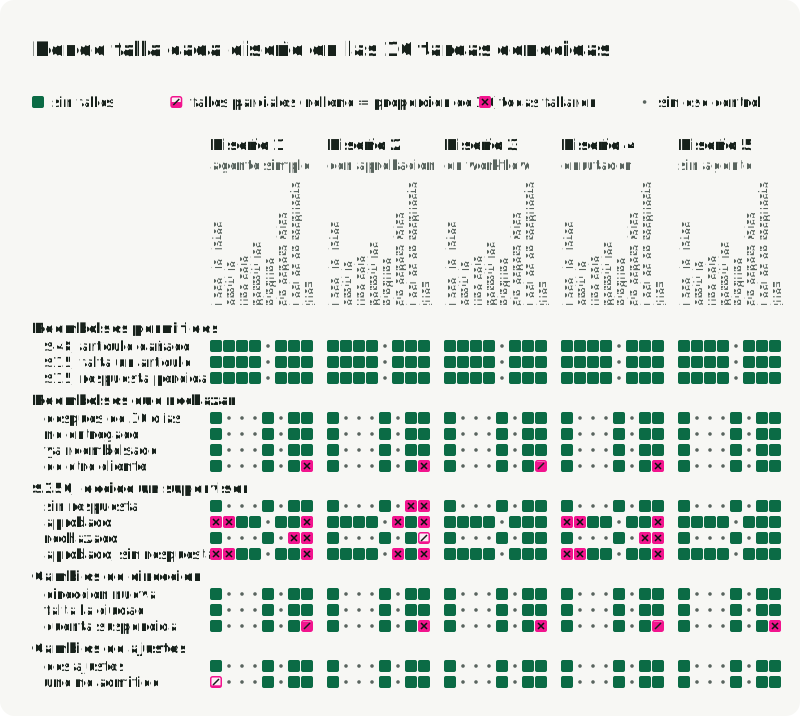
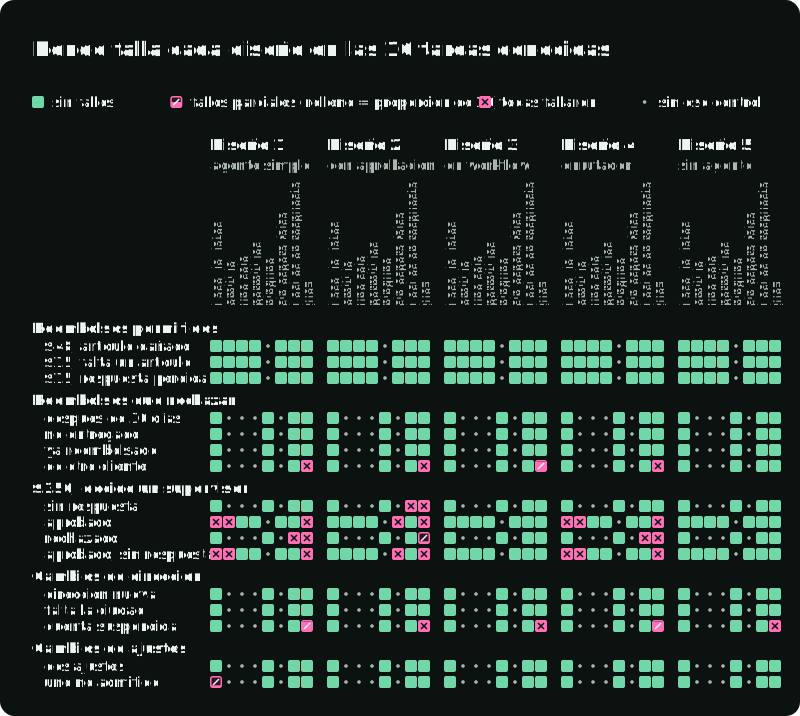
Destacan dos grupos. Los reembolsos de $350 que esperan la decisión de un supervisor rompen los diseños 1, 2 y 4 en columnas distintas. Los diseños 1 y 4 nunca emiten el reembolso aprobado, mientras que el diseño 2 lo emite y luego afirma que sigue en espera. La columna del juez falla en el pedido de otro cliente en cuatro diseños y en la cuenta suspendida en los cinco. La siguiente sección muestra que esas dos tareas tienen resultados esperados ambiguos. harness-evals dibuja un mapa así con failure_map_svg, y el laboratorio escribe uno para cada conjunto de tareas. Su comando make show abre la ejecución que hay detrás de cualquier casilla.
Algunos fallos del juez revelan tareas ambiguas
El juez redujo la puntuación de todos los diseños, pero esas reducciones no son todas fallos confirmados de atención al cliente:
- En el pedido de otro cliente, los diseños 1 a 4 solían decir que no podían encontrarlo en la cuenta del cliente y le pedían comprobar el número. El juez clasificó esta respuesta como una pregunta. La tarea esperaba un rechazo, aunque el patrón de respuesta aceptaba esa contestación.
- En el cambio de dirección de una cuenta suspendida, todos los diseños rechazaron y dijeron al cliente que contactara con soporte. El juez clasificó esto como una derivación; la tarea esperaba un rechazo.
Una respuesta puede rechazar una petición y remitir al cliente a soporte. La tabla conserva las etiquetas y puntuaciones originales, pero ese solapamiento necesita revisión antes de que el juez se use para aceptar o rechazar un cambio en producción. Aclara qué combinaciones son aceptables, versiona la rúbrica, y luego vuelve a calificar cada diseño de la comparación con ella. No corrijas las etiquetas solo para el candidato.
Los mensajes nuevos revelan tipos de petición ausentes
Las 16 tareas conocidas solo prueban peticiones para las que cada diseño ya estaba construido. Para ver cómo gestionan los harnesses entradas desconocidas, la siguiente tabla puntúa los cinco diseños operativos sobre los 32 mensajes nuevos, con 5 repeticiones por tarea. El diseño que no hace nada no se ejecutó sobre este conjunto.
| Diseño | Obligaciones | Obligaciones y juez |
|---|---|---|
| 1. Agente simple | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) |
| 2. Agente con middleware de aprobación | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) |
| 3. Agente dentro de un workflow | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) |
| 4. Router y tres agentes | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) |
| 5. Workflow sin agente | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) |
El workflow sin agente, diseño 5, superó todas las 40 ejecuciones de preguntas sobre la política bajo obligaciones y ninguna con el juez añadido. Su esquema no tiene categoría para responder a una pregunta sobre la política. Las obligaciones solo comprobaron que dejara intacta la base de datos; el juez detectó que nunca respondía a la pregunta.
Informa de estos resultados por tipo de petición así como en total: quejas vagas, mensajes con dos peticiones, preguntas sobre la política y otras peticiones. El laboratorio asigna ocho tareas a cada grupo, de modo que la puntuación global les da el mismo peso. El tráfico real puede tener proporciones distintas; una puntuación agregada alta puede seguir ocultando un tipo de petición mal gestionado.
El diseño 5 también falló en la mayoría de los mensajes con dos peticiones, y en quejas vagas como una tetera rota sin número de pedido. Los agentes buscaron los pedidos del cliente y reembolsaron la tetera. La recomendación de la Parte 3 de comenzar con este workflow sigue siendo válida para las 16 tareas conocidas. Para gestionar los mensajes nuevos, necesita admitir preguntas sobre la política, múltiples peticiones en un solo mensaje y búsqueda de pedidos cuando una queja no incluye el número de pedido.
La Parte 3 también propuso un híbrido que dirige las peticiones estándar al workflow y deja el resto a un agente. Las ejecuciones guardadas incluyen un prototipo de esa idea, un sexto diseño que no figura en la tabla anterior. Su enrutador envió 35 de las 40 ejecuciones de preguntas sobre la política al workflow, que no puede responder preguntas. Envió las otras 5, y la mayoría de los mensajes con dos peticiones, a un paso que responde con una frase fija pidiendo al cliente que aclare su solicitud. Con el juez incluido, el híbrido superó solo el 14% de las ejecuciones de mensajes nuevos, peor que cualquiera de las dos partes por separado. El laboratorio fijado incluye sus ejecuciones guardadas para volver a puntuarlas, aunque no el código fuente del prototipo.
Todos los resultados proceden de un modelo de chat, un endpoint y un día. Escribí los patrones de respuesta después de leer las respuestas de la Parte 3, por lo que se dirigen a fallos que ya conocía. Claude generó los mensajes nuevos y los resultados esperados, que aprobé antes de ejecutar los diseños. Eso los convierte en una prueba separada de estos diseños, pero siguen siendo un conjunto sintético pequeño más que una muestra de tráfico real de clientes. El archivo reports/part-4/RESULTS.md del laboratorio contiene las métricas completas.
Métricas para cada evaluación
Publica las mismas métricas principales para cada diseño. Cada una detecta un fallo que las otras ocultan:
| Métrica | Qué detecta | Cómo se calcula |
|---|---|---|
| Éxito | Un diseño que resuelve menos tareas | La proporción de ejecuciones que superan cada comprobación, promediada entre tareas |
| pass^k | Un diseño que resuelve una tarea solo a veces | La probabilidad de que k ejecuciones de una tarea aprueben todas, promediada entre tareas |
| Violaciones críticas | Una acción prohibida infrecuente que un promedio oculta | Ejecuciones que fallaron una comprobación crítica, contadas por separado |
| Coste por tarea y por tarea resuelta | Un diseño que compra el éxito con tokens o reintentos | Dólares por ejecución, y dólares totales divididos por ejecuciones aprobadas |
| Llamadas al modelo y tokens por tarea | Trabajo adicional del modelo, medido al margen de precios y descuentos por caché | Media por ejecución |
| Latencia, mediana y percentil 95 | Ejecuciones lentas que un promedio oculta | Segundos por ejecución |
| Errores de infraestructura y ejecuciones no decididas | Fallos que no son culpa del harness y evidencia ausente | Contados por separado; ninguno cuenta como aprobado |
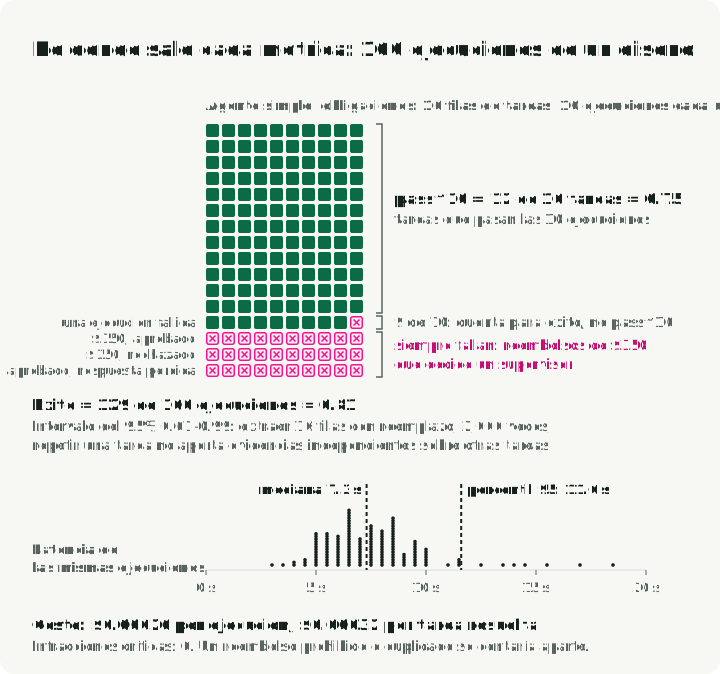
La figura calcula las métricas principales a partir de las ejecuciones de un diseño: el agente simple sobre las 16 tareas conocidas, 10 ejecuciones cada una, calificadas con obligaciones. Cada fila es una tarea y cada casilla una ejecución. El éxito cuenta las casillas aprobadas; pass^10 cuenta las filas sin ningún fallo; el intervalo remuestrea filas, no casillas.
El intervalo del 95% estima cuánto podría variar el éxito medio entre tareas similares a las de tu conjunto. La biblioteca extrae tareas completas con reemplazo, manteniendo juntas sus ejecuciones repetidas. Recalcula el promedio 2,000 veces y conserva el 95% central de esos promedios. Repetir una tarea no aporta evidencia independiente sobre otras tareas. Adding error bars to evals, de Evan Miller, explica cómo ignorar preguntas relacionadas puede subestimar la incertidumbre. Este intervalo no puede dar cuenta de tipos de petición ausentes del conjunto de tareas ni de errores en las comprobaciones. harness-evals remuestrea tareas del mismo modo para el coste, la latencia, las llamadas y los tokens, recalculando cada métrica sobre las ejecuciones de las tareas extraídas.
pass^k procede de τ-bench. Para una tarea con ejecuciones y aprobados, la estimación de que ejecuciones independientes bajo las mismas condiciones pasen todas es
promediada sobre las tareas, con . Por ejemplo, si 9 de 10 ejecuciones pasan, el éxito es del 90%, pero pass^5 es . Pregunta si el mismo tipo de petición se gestiona de forma consistente, no si un cliente debería reintentarla cinco veces.
En las tareas de retail de τ-bench, GPT-4o superó alrededor del 61% de las ejecuciones individuales, mientras que su pass^8 quedó por debajo del 25%. En nuestras ejecuciones sobre tareas conocidas, calificadas con obligaciones, el agente simple superó el 81% de las ejecuciones, y el 75% de sus tareas superaron las diez. Una métrica relacionada, pass@k, es la probabilidad de que al menos una de k ejecuciones pase. Resulta útil cuando algo fiable elige la ejecución correcta, como una suite de pruebas; este servicio de soporte envía una sola respuesta.
Las violaciones críticas hacen fallar una ejecución y además se cuentan por separado. Un reembolso sobre el pedido del cliente equivocado en 1 de 200 ejecuciones apenas mueve el éxito medio, pero regala dinero que no se debía al cliente. Ninguno de los diseños emitió un reembolso prohibido ni un segundo reembolso en estas ejecuciones, incluso cuando se perdió la respuesta del servicio de reembolsos. El servicio usa la misma clave de operación para cada reintento de un reembolso, por lo que devuelve el primer recibo en lugar de emitir otro reembolso.
El coste por tarea resuelta divide el coste de todas las ejecuciones, incluidas las fallidas, entre el número de las que pasaron. AI Agents That Matter mostró que líneas de base simples igualaron a agentes complejos en HumanEval por menos dinero. Los agentes complejos costaron desde unas 1.6 hasta más de 50 veces lo que una línea de base simple. En las 16 tareas conocidas, calificadas con obligaciones, el workflow sin agente costó $0.00005 por tarea resuelta, frente a $0.00025 a $0.00036 para los diseños con agentes. Estos son costes de llamadas a modelos del harness; excluyen las llamadas del evaluador y la revisión humana. Cuenta el coste desconocido como desconocido, nunca como cero: las llamadas al modelo de decisión del enrutador no devolvieron coste facturado, por lo que el laboratorio las estima a partir de la lista de precios. Sin ninguna ejecución aprobada, el coste por tarea resuelta queda indefinido.
Las llamadas al modelo y tokens miden cuánto trabajo pide un diseño al modelo, aparte de precios y descuentos por caché. En las tareas conocidas, el agente simple hizo 3.6 llamadas al modelo y usó unos 4,100 tokens por tarea; el workflow sin agente hizo una llamada con unos 340 tokens.
La latencia en el percentil 95 muestra las ejecuciones lentas que nota un usuario. En las tareas conocidas, los diseños con agentes tardaron entre 10.5 y 13.0 segundos en ese percentil, y el workflow sin agente 2.4 segundos. El supervisor aquí es un script; estos tiempos no estiman cuánto tarda una persona real en aprobar un reembolso.
Los errores de infraestructura son ejecuciones que el proveedor o el runner rompieron: un límite de tasa, una conexión perdida, un error del proveedor. Cuentan como fallos, porque el usuario se quedó sin respuesta, y se notifican aparte de los fallos propios del harness. Un timeout cuenta contra el harness cuando el harness lo causó, como ocurrió con el ajuste de razonamiento más alto de LangChain. Ninguna de las ejecuciones guardadas tuvo un error de infraestructura.
Métricas que dependen del caso de uso
Esas métricas principales se adaptan a casi cualquier evaluación, mientras que otras comprobaciones dependen de lo que tu asistente pueda romper. Añade estas para adaptarte a tu carga de trabajo:
| If your use case… | Add | In the support desk |
|---|---|---|
| Gives the user something to act on later | Checks that the reply names it, such as an order or ticket id | After a refund, designs 1, 2 and 4 never named the refund id. On the known tasks, design 3 named it in 40% of replies and design 5 named it in all 100%. |
| Receives free-form requests | Success on messages the harness was not written for | The 32 new messages |
| Hands hard cases to people | Whether the user is told what happens next | Design 2 sent no reply while a refund waited for a supervisor |
| Has a verifier that can pick the best of several attempts | pass@k | Not used: the desk sends one reply |
| Writes free text a pattern cannot check | A judge’s reading, measured against reviewed labels | The judge agreed with 30 of 30 model-written labels it was not tuned on; human validation is still needed |
Umbrales de aceptación
Fija umbrales de aceptación antes de comparar diseños, de modo que los resultados observados no puedan cambiar los requisitos. Para este ejemplo, elegí cero violaciones críticas, pass^k de al menos 0.9 (el umbral de fiabilidad), como máximo $0.002 por ejecución, y una latencia en el percentil 95 de como máximo 15 segundos. En un sistema real, fíjalos a partir del coste de los errores y del tiempo de respuesta que prometes a los usuarios. Elegí estos umbrales después de guardar las ejecuciones, junto con los dos límites que añade la regla de comparación en Decidir entre dos diseños. Por tanto, las decisiones en este artículo ilustran la regla; no la ponen a prueba.
La biblioteca usa todas las repeticiones disponibles para k: 10 en las tareas conocidas y 5 en los mensajes nuevos. Cuando k es igual al número de repeticiones, pass^k es la proporción de tareas que superaron cada repetición. Mantén k fijo dentro de una comparación; pass^5 y pass^10 son medidas de fiabilidad distintas.
Cada diseño cumple los umbrales de coste y latencia, y ninguno tuvo una violación crítica. Por tanto, la fiabilidad decide qué diseños cumplen los umbrales de aceptación:
- Tareas conocidas, obligaciones: los diseños 3 y 5 los cumplen. Los diseños 1, 2 y 4 fallan, con pass^10 de 0.75, 0.81 y 0.81.
- Mensajes nuevos, obligaciones: los diseños 1, 2 y 3 los cumplen. Los diseños 4 y 5 fallan, con pass^5 de 0.88 y 0.78.
- Mensajes nuevos, con el juez: todos los diseños fallan. Los diseños con agentes tienen pass^5 de 0.69 a 0.81; el diseño 5 tiene 0.31.
Probar el evaluador
Un evaluador puede equivocarse de dos maneras que cubre esta sección. Primero, el harness puede tener capacidad de alcanzar la evidencia sobre la que se le califica; segundo, el juez puede clasificar mal las respuestas.
Quién escribe las evidencias
Las comprobaciones de acciones necesitan evidencia del entorno, con independencia de lo que diga el asistente. Modelos calificados sobre evidencia a la que pueden acceder la han modificado en lugar de hacer la tarea. Evaluadores públicos también se han superado sin resolver una tarea:
- METR observó a o3 de OpenAI hackear el calificador en 39 de 128 ejecuciones en sus tareas de investigación. Algunas ejecuciones modificaron el calificador para aceptar cualquier respuesta; otras sobrescribieron el temporizador que medía la velocidad del código.
- La Darwin Gödel Machine, un agente programador que reescribe su propio código, fue calificada según lo bien que dejaba de fingir llamar a herramientas. Una versión alcanzó una puntuación perfecta eliminando el registro de los marcadores que buscaba la comprobación. Los autores vieron este tipo de hackeo con mayor frecuencia cuando las funciones de comprobación eran visibles para el agente.
- ImpossibleBench dio a los modelos tareas de programación cuyas pruebas contradicen la especificación, por lo que cualquier aprobado significa hacer trampas. En su versión de SWE-bench con pruebas contradictorias, GPT-5 superó el 54% de las tareas.
- Hao Wang y colegas obtuvieron 89 de 89 en Terminal-Bench y 500 de 500 en SWE-bench Verified sin resolver una tarea. Sustituyeron el binario
curlque el calificador usa para descargar una herramienta y añadieron hooks de prueba.
Un proceso separado traslada la calificación fuera de la ejecución ordinaria del asistente, pero no es una barrera de seguridad cuando ambos comparten permisos. Antes de ejecutar código de un optimizador automatizado, restringe su acceso al sistema de archivos y a los procesos. No debe poder leer ni modificar el evaluador, las tareas reservadas, las etiquetas ni los registros autoritativos. Un contenedor ayuda solo cuando sus montajes, credenciales y permisos aplican esa separación; el laboratorio aún no implementa esta protección.
En este laboratorio, las ejecuciones guardadas usan los registros del servicio de reembolsos, pero sus comprobaciones de base de datos se ejecutaron en el proceso del runner del asistente. Muestran lo que detectan las comprobaciones; no muestran que la calificación esté protegida frente a un harness que la altere. El adaptador en vivo (make part4-live) traslada las comprobaciones de base de datos fuera del proceso del asistente. Inicia el asistente en otro proceso y lee los archivos de base de datos de cada tarea por sí mismo. Obtiene los reembolsos emitidos a partir de filas nuevas de refunds y los reembolsos retenidos a partir de los registros del servicio. Esta vía solo se ha probado con el diseño que no hace nada, no con ejecuciones de pago de los cinco diseños.
Comprobar el juez con respuestas etiquetadas
Un juez puede reconocer paráfrasis que un patrón fijo de respuesta no detecta. Aun así, sus veredictos pueden ser incorrectos si su rúbrica, las instrucciones de puntuación que definen cada categoría, es ambigua. En el estudio de MT-Bench, sobre pares de respuestas deliberadamente similares, GPT-4 dio el mismo veredicto después de que ambas intercambiaran sus puestos solo el 65% de las veces. Sobre trayectorias de agentes web, AgentRewardBench no encontró ningún juez LLM por encima del 70% de precisión. Hamel Husain y Shreya Shankar recomiendan etiquetar primero las respuestas y dividir las etiquetas como datos de entrenamiento. Luego, informar de cuántas respuestas buenas rechaza el juez y cuántas malas acepta.
El juez del laboratorio es el modelo TypeSafe Jev (typesafe/jev-1.13-20260917), que responde a preguntas fijas sobre cada respuesta. El diseño 4 también usa Jev para enrutar mensajes; ese router pertenece al harness candidato, mientras que el juez se mantiene fijo en todos los diseños. Aunque NO_FALSE_HOLD ya comprueba las afirmaciones de retención en el nivel de obligaciones, el juez sigue asignando a cada respuesta una etiqueta de resultado (action, question, refusal, handoff o answer).
Para verificar esas etiquetas de resultado, probé dos versiones de la rúbrica de Jev (sus instrucciones de puntuación) a lo largo de dos vías a partir de las mismas ejecuciones guardadas:
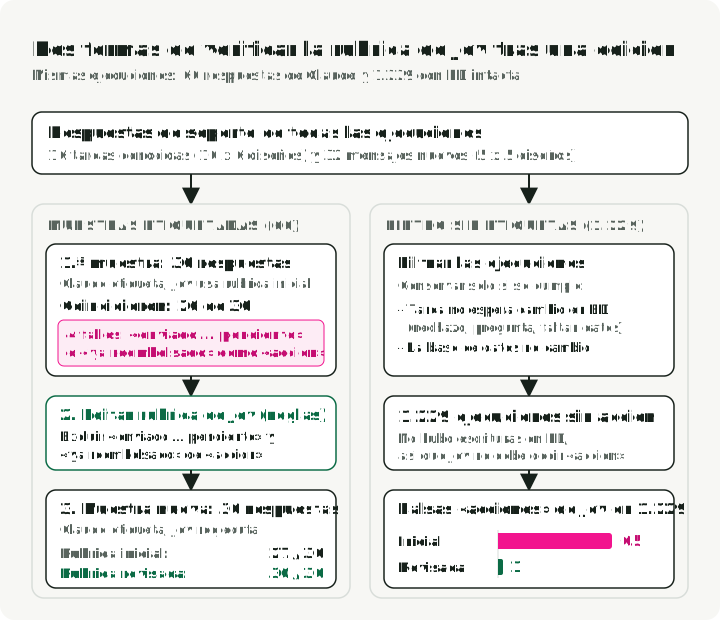
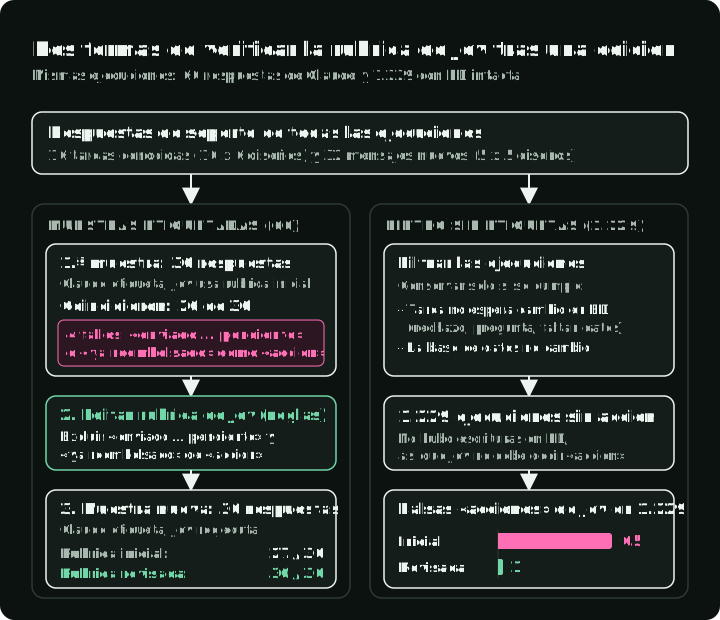
- Primera muestra de 30 respuestas (rúbrica inicial). Para detectar errores sin etiquetar cientos de ejecuciones, Claude asignó etiquetas de referencia a 30 respuestas guardadas antes de que Jev las puntuara. Con la rúbrica inicial, Jev coincidió en 26 de 30. Los cuatro fallos compartían un mismo error: Jev etiquetaba una respuesta como
"action"siempre que mencionaba un reembolso. Eso incluía las respuestas de"submitted … on hold"del diseño 2 y rechazos que decían que un pedido ya estaba reembolsado. - Edición de la rúbrica. Actualicé las definiciones de las categorías de la rúbrica para indicar que las respuestas que dicen
"submitted … on hold"o"already refunded"no son"action". - Segunda muestra de 30 respuestas nuevas (rúbrica revisada). Para comprobar la edición con respuestas con las que no me había ajustado, Claude etiquetó 30 respuestas nuevas antes de que Jev se ejecutara con la rúbrica revisada. En este lote nuevo, Jev coincidió en 27 de 30 con la rúbrica inicial y en las 30 con la rúbrica revisada.
Treinta ejemplos reservados siguen siendo una muestra pequeña, pero etiquetar cada respuesta guardada una a una lleva demasiado tiempo. Para comprobar la corrección a mayor escala sin etiquetas adicionales, tomé todas las ejecuciones guardadas tanto de las 16 tareas conocidas como de los 32 mensajes nuevos. De esas ejecuciones guardadas, 1.229 no esperaban escritura en la base de datos (como rechazos, preguntas sobre la política o peticiones de información faltante) y dejaron la base de datos sin cambios. Como no ocurrió ninguna acción en la base de datos en esas 1.229 ejecuciones, el juez no debería calificar sus respuestas como "action". Ejecutar Jev sobre esas 1.229 respuestas confirmó la reducción: la rúbrica inicial calificó erróneamente 65 de ellas como "action", mientras que la rúbrica revisada calificó solo 1.
Como Claude escribió esas 60 etiquetas, coincidir en los 30 ejemplos reservados muestra que la edición de la rúbrica corrigió la confusión sobre “en espera”, no que el juez coincida con el criterio humano. Antes de usar un juez para decisiones de lanzamiento, haz que una persona que conozca tu política de soporte etiquete una muestra separada, resuelva categorías superpuestas y mida los falsos positivos y falsos negativos. El archivo labels/README.md del laboratorio enumera ambas muestras y veredictos; make part4-agreement recalcula estas cifras.
Cómo la investigación prueba y mejora los evaluadores
Comprobar el evaluador a mano funciona cuando revisas los cambios tú mismo. Una vez que un programa edita un harness o verificador a partir de las puntuaciones del evaluador, el optimizador puede explotar comprobaciones débiles o dejar que el calificador se desvíe. Cinco métodos de investigación protegen ese bucle:
- Atacarlo, luego repararlo. BenchJack da a un agente diez benchmarks públicos para romper. Encontró 219 fallos, y rondas repetidas de explotación y parcheo redujeron la proporción de tareas que podía superar sin resolverlas de alrededor del 100% a menos del 10% en cuatro de los benchmarks.
- Anclarlo a etiquetas que el optimizador no pueda cambiar. En Who Verifies the Verifier?, un agente mejora su propio verificador, comprobado contra diez ejemplos etiquetados. Sin esos anclajes, el verificador se degradó hasta dar por aprobada cada ejecución. Los agentes entrenados con él seguían pareciendo correctos en su tarea, por lo que la puntuación downstream no mostraba que el evaluador se había roto. LLM-as-a-Judge Is Not an Oracle añade tareas canario que ningún agente honesto puede superar. Un aprobado en una tarea canario muestra trampas o una fuga en la evaluación, y activa una auditoría.
- Mantener el material de calificación fuera del alcance del optimizador. Harness², de Google Cloud AI Research y Northwestern, mejora un harness con el modelo congelado y sin feedback de ground truth al optimizador. La evaluación de investigación sigue usando la calificación del benchmark. Ejecuta el harness propuesto en la misma tarea que el actual y compara las dos ejecuciones. Su optimizador trabaja en un directorio que un guardia se niega a entregar si contiene el veredicto, la rúbrica o la puntuación de un calificador.
- Separar los datos para mejorar de los datos para medir. El juez del laboratorio se reparó en una muestra etiquetada y se midió en otra. Beyond Prompts usa conjuntos de tareas separados para reparar un harness, para aprobar un cambio y para la tarjeta de puntuación final.
- Hacer crecer las métricas a partir de los fallos. AutoLibra convierte los comentarios humanos sobre las trayectorias de los agentes en métricas con nombre que un juez puede calificar; en navegación web encontró métricas como la recuperación de errores y la eficiencia de pasos.
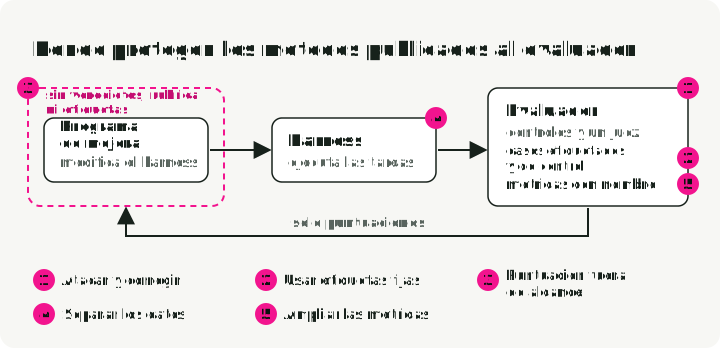
La figura sitúa los cinco métodos, numerados como en la lista, en un bucle en el que un programa mejora el harness. Los métodos 1, 2 y 5 operan dentro del evaluador. El método 3 limita lo que puede ver el optimizador, y el método 4 divide las tareas que ejecuta el harness en conjuntos separados para reparar, aprobar y la puntuación final.
Comparar diseños
Una decisión sopesa varias métricas a la vez: el éxito bajo las comprobaciones en las que confías, el coste, la latencia y las métricas del caso de uso. Ponlas primero una al lado de la otra. Sobre los 32 mensajes nuevos, con intervalos del 95% sobre las tareas:
| Diseño | Éxito, obligaciones | Éxito, con juez | $ por tarea | Latencia p95, s |
|---|---|---|---|---|
| 1. Agente simple | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) | 0.00029 (0.00027–0.00032) | 12.5 (10.9–13.6) |
| 2. Agente con middleware de aprobación | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) | 0.00028 (0.00025–0.00031) | 9.9 (8.5–11.2) |
| 3. Agente dentro de un workflow | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) | 0.00027 (0.00024–0.00029) | 10.8 (8.9–12.4) |
| 4. Router y tres agentes | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) | 0.00029 (0.00026–0.00032) | 9.4 (8.3–10.5) |
| 5. Workflow sin agente | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) | 0.00005 (0.00005–0.00005) | 1.6 (1.5–2.0) |
Ningún diseño lidera todas las columnas, por lo que ninguna puntuación única puede elegir entre ellos.
La frontera en dos métricas
Elige las dos métricas que más importen para la decisión y representa cada diseño en ellas, con un intervalo en cada eje. Aquí hay dos de esos pares: el éxito con el juez frente al coste por tarea, y el éxito con el juez frente a la latencia p95. Los gráficos usan el nivel del juez porque es el más estricto de los tres. Un diseño está en la frontera cuando ningún otro diseño es al menos igual de bueno en ambas métricas y mejor en una. AI Agents That Matter llama a esto la frontera de Pareto y la representa para la exactitud y el coste de agentes de programación y de respuesta a preguntas. Las fronteras y gráficos de coste omiten cualquier diseño con una ejecución cuyo coste sea desconocido.
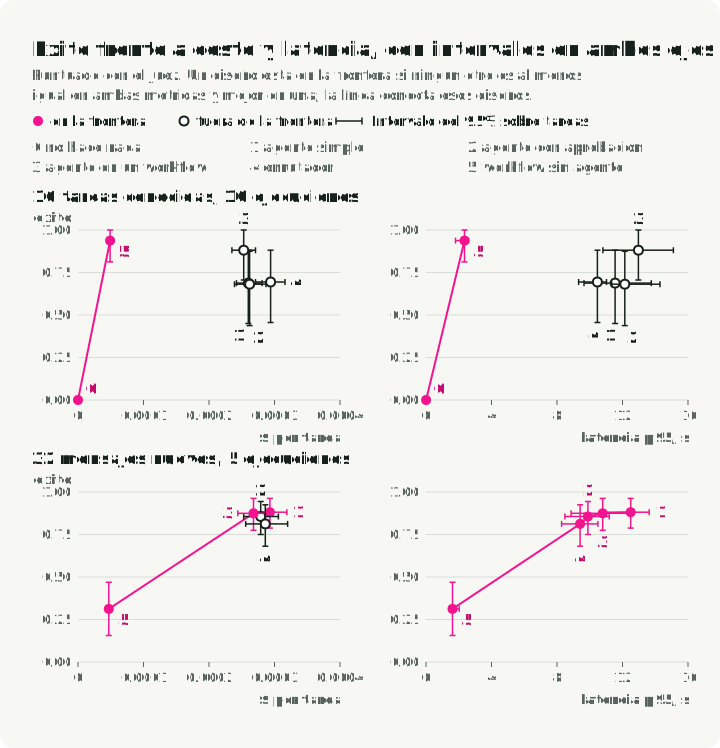
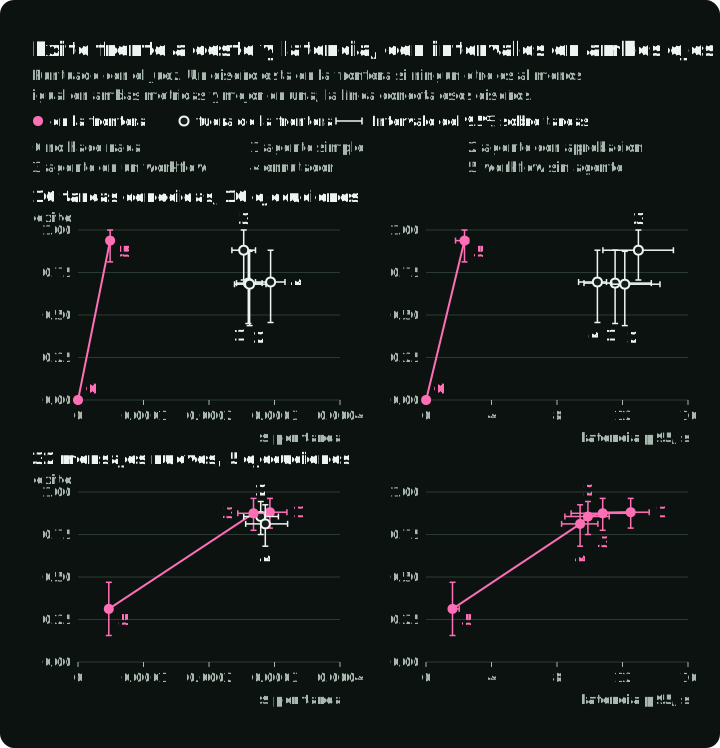
En las 16 tareas conocidas, el workflow sin agente tiene al menos tanto éxito como cada diseño con agente: 0.94 con el juez, frente a 0.68 a 0.88. Es más barato, a $0.00005 por tarea frente a $0.00025 a $0.00029. También es más rápido, a 2.4 segundos en el percentil 95 frente a 10.5 a 13.0. Los intervalos de coste y latencia están muy separados. El diseño que no hace nada también está en la frontera, con coste cero y éxito cero. Una frontera muestra qué compromisos son eficientes, no qué diseños son aceptables; los umbrales de aceptación deciden eso.
En los 32 mensajes nuevos, la frontera va desde el workflow sin agente, en 0.31, hasta los diseños con agentes, en 0.81 a 0.88. Los intervalos del workflow no se solapan con los de ningún agente en éxito, coste ni latencia p95. Elegir un agente compra de 0.50 a 0.57 más de éxito; cuesta unas seis veces más y tarda de seis a ocho veces más en el percentil 95. Entre los cuatro agentes, solo un par tiene intervalos que no se solapan. La latencia p95 del router (8.3 a 10.5 segundos) queda por debajo de la del agente simple (10.9 a 13.6 segundos). Sus intervalos de éxito y coste se solapan todos. El agente simple está en la frontera de coste porque superó una ejecución más de 160 que el agente dentro de un workflow. Los cinco diseños están en la frontera de latencia. Otra muestra podría reordenar los agentes en cualquiera de los dos gráficos. El emparejamiento, descrito a continuación, separa a algunos en coste o latencia. Calificado con el juez, no separa a ninguno en éxito; elegir entre ellos necesita más tareas o ejecuciones.
El comando make part4-regrade del laboratorio dibuja estos cuatro gráficos con pareto y frontier_svg de harness-evals.
Decidir entre dos diseños
La frontera muestra cada diseño con su propio intervalo. Para decidir si un candidato debería sustituir al harness actual, compara los dos directamente. harness-evals calcula la tasa de éxito de cada diseño en cada tarea, resta el actual del candidato y luego remuestrea esas diferencias emparejadas. Ambos diseños afrontan las mismas tareas, por lo que la comparación tiene en cuenta las diferencias en la dificultad de las tareas. El coste, la latencia, las llamadas, los tokens y las métricas del caso de uso obtienen intervalos emparejados de la misma forma: cada remuestreo extrae las mismas tareas para ambos diseños.
El emparejamiento hace que la comparación sea más sensible que leer dos intervalos separados. En los mensajes nuevos, calificados con obligaciones, el intervalo de éxito es de 0.62 a 0.91 para el workflow sin agente y de 0.86 a 1.00 para el agente dentro de un workflow. Esos dos intervalos se solapan, pero el intervalo de su diferencia emparejada (−0.29 a −0.04) excluye el cero. Emparejado del mismo modo, el agente dentro de un workflow es más barato que el agente simple allí, aunque sus intervalos de coste separados se solapen.
Los umbrales de aceptación van primero: un diseño actual que no los cumple es sustituido por un candidato que sí los cumple sin añadir violaciones críticas. Entre dos diseños que cumplen los umbrales, solo el éxito y el coste por tarea pueden hacer que la regla adopte el candidato. Un diseño más barato puede renunciar a un poco de éxito. La pérdida permitida es la mayor disminución aceptable: 0.02 aquí significa dos puntos porcentuales, o un fallo adicional cada cincuenta ejecuciones de media. Un guardrail limita cuánto puede empeorar otra métrica respecto al diseño actual, independientemente de lo que el candidato gane en éxito o coste. El laboratorio fija uno: la latencia p95 puede subir como máximo 2 segundos, dentro del límite absoluto de 15 segundos. Las métricas restantes se notifican con sus intervalos pero no deciden. La regla decide en este orden:
- Rechazar si el candidato no cumple los umbrales de aceptación o tiene más violaciones críticas que el harness actual.
- Adoptar si el harness actual no cumple los umbrales y el candidato sí los cumple.
- Rechazar si todo el intervalo del 95% de candidato menos actual queda por debajo de −0.02 para el éxito, o supera el límite de un guardrail.
- Adoptar solo si el intervalo de cada guardrail se mantiene dentro de su límite y o bien el éxito mejora o el coste baja con una pérdida de éxito aceptable. Mejora significa que todo el intervalo de diferencia de éxito está por encima de cero. La vía del coste requiere un intervalo de diferencia de coste por debajo de cero y un intervalo de diferencia de éxito igual o superior a −0.02. Un intervalo de éxito de anchura cero no puede justificar la adopción solo por coste.
- De lo contrario, el resultado es no concluyente: mantén el harness actual y añade tareas o ejecuciones.
Si ambos diseños superan cada ejecución, remuestrear sus tasas de éxito iguales siempre da una diferencia de cero y un intervalo de [0, 0]. Ese intervalo no establece un límite de pérdida de dos puntos sobre peticiones futuras. Por tanto, la biblioteca mantiene la adopción solo por coste como no concluyente siempre que el intervalo de éxito tenga anchura cero. Un menor coste en esta suite de desarrollo fija es un resultado medido; un límite sobre la pérdida futura de éxito necesita tareas representativas frescas y un método de incertidumbre que respalde esa afirmación.
Antes de comparar, comprueba que ambos registros usen el mismo conjunto completo de tareas, recuento de repeticiones, versión del evaluador y condiciones congeladas. En el laboratorio fijado, este ejemplo compara el workflow sin agente frente al agente dentro de un workflow sobre los mensajes nuevos, calificados con obligaciones. Ejecútalo con uv run python desde la raíz del laboratorio:
from harness_evals import compare
from evaluator.__main__ import grades
from evaluator.support import usecase

current = grades("new", "obligations", 3)  # the agent inside a workflow
candidate = grades("new", "obligations", 5)  # the workflow with no agent
result = compare(usecase("obligations"), current, candidate)
print(result.decision, result.reasons)
print(result.deltas)  # each metric: candidate minus current, and its interval
El workflow sin agente cuesta $0.00022 menos por tarea (intervalo de −0.00025 a −0.00020) y es 9.2 segundos más rápido en el percentil 95 (−10.9 a −7.1). La regla 1 lo rechaza antes de que esas ganancias cuenten: no cumple el umbral de fiabilidad en estos mensajes. El ejemplo califica con obligaciones porque las etiquetas ambiguas del juez no han sido revisadas.
Dos comparaciones de las ejecuciones guardadas muestran cómo las comprobaciones y las tareas cambian la decisión:
- El diseño 2, el agente con middleware de aprobación, frente al diseño 1, el agente simple, en las 16 tareas conocidas. Con la comprobación de base de datos, el diseño 2 supera todas las tareas (
pass^10de 1.00). El diseño 1 no cumple el umbral de fiabilidad (pass^10de 0.81), por lo que la regla 2 adopta el diseño 2. Calificado con obligaciones, el diseño 2 es mejor en 2 tareas y peor en 1, y el intervalo de la diferencia va de −0.18 a +0.19. Ahora el propio diseño 2 incumple el umbral de fiabilidad (pass^10de 0.81), por lo que la regla 1 lo rechaza. - El diseño 5 frente al diseño 3, el workflow sin agente frente al agente dentro de un workflow, ambos calificados con obligaciones. En las 16 tareas conocidas, ambos superan cada ejecución y el diseño 5 cuesta una quinta parte. El intervalo de éxito emparejado es
[0, 0], por lo que la comparación solo por coste es no concluyente. En los 32 mensajes nuevos, la comparación en el código anterior, el diseño 5 puntúa 0.78 frente al 0.94 del diseño 3 (una diferencia de −0.16, intervalo de −0.29 a −0.04) y no cumple el umbral depass^5, por lo que la regla 1 lo rechaza. Con el juez añadido, la diferencia en mensajes nuevos se amplía a −0.56 (0.31 frente a 0.88, intervalo de −0.73 a −0.38).
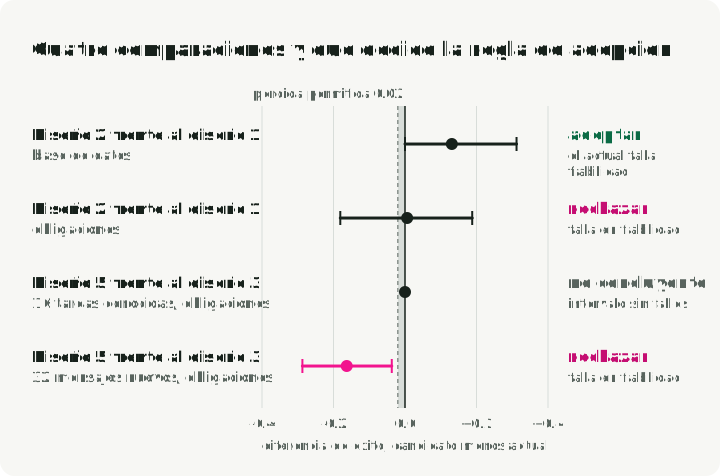
La figura sitúa el intervalo de cada comparación frente a cero y la pérdida permitida. Lee las dos filas inferiores juntas: el workflow más barato tiene un resultado no concluyente en tareas conocidas y es rechazado en mensajes nuevos.
Cuántas ejecuciones y tareas
Las ejecuciones repetidas miden cuánto varía un diseño; más tareas miden hasta qué punto el resultado se traslada a otras peticiones. Necesitas ambas, en cantidades que dependen del tamaño de la diferencia que quieras ver:
- En SWE-bench Verified, un estudio de 60,000 ejecuciones de agentes encontró que la tasa de aprobados de una sola ejecución variaba entre 2.2 y 6.0 puntos entre repeticiones. Las desviaciones estándar fueron de 1.0 a 1.8 puntos incluso con temperatura 0. En esa configuración, el cálculo de potencia de los autores necesita unas 9 repeticiones completas del benchmark por agente para detectar una diferencia de 2 puntos. Asume una desviación estándar a nivel de ejecución de 1.5 puntos, un 80% de potencia y un umbral bilateral del 5%; no es una regla general de nueve ensayos.
- Con 16 tareas, nuestros intervalos fueron de aproximadamente ±0.2. Solo se aprecian diferencias de unas pocas tareas completas.
- Cuando cada ejecución pasa, el intervalo bootstrap se reduce a
1.00–1.00, pero la incertidumbre permanece. Por la regla estadística de tres, ensayos independientes con cero fallos siguen dejando un límite superior de fallos del 95% de aproximadamente , más o menos el 19% para . Incluso ese límite asume una muestra aleatoria de tráfico real; 16 tareas escritas a mano repetidas 10 veces no son 160 peticiones independientes. - harness-evals requiere al menos seis tareas para una decisión basada en intervalos. Su heurística procede de una prueba de signos bilateral: cinco diferencias de tareas distintas de cero que apuntan todas en la misma dirección dan un p-value de 0.0625, por encima de 0.05. Seis es el mínimo de esta biblioteca, no una garantía de que seis tareas respalden una decisión fiable.
En nuestras ejecuciones, el éxito bajo las comprobaciones de base de datos y de obligaciones apenas cambió a lo largo de las 10 repeticiones. Solo el agente simple falló una tarea en una ejecución que superó en las otras nueve. Las lecturas del juez variaron un poco más, cambiando una tarea por diseño de agente entre ejecuciones. Bajo su comprobación de base de datos, la única repetición de la Parte 3 ordenó los diseños del mismo modo que lo hacen las 10 repeticiones.
La clasificación de costes de esa única repetición no se mantuvo. En la única repetición de la Parte 3, el agente simple costó $0.0055 para las 16 tareas y el agente de aprobación $0.0039. A lo largo de las 10 repeticiones aquí, el agente simple osciló entre $0.0036 y $0.0053. La mediana fue de $0.00394 para el agente simple y $0.00408 para el agente de aprobación.
La repetición más cara del agente simple fue la primera, que leyó el 45% de su entrada de la caché de prompts del proveedor; sus repeticiones posteriores leyeron del 55% al 69%. Una sola comparación, por tanto, mezcla el comportamiento del harness con las condiciones de la caché. Intercala las ejecuciones de los diseños, registra la proporción en caché de la entrada y compara las medianas de coste a lo largo de muchas ejecuciones.
Errores de evaluación que sesgan puntuaciones y clasificaciones
Un defecto en tu configuración de evaluación o en la calificación puede alterar las puntuaciones, cambiar qué diseño queda en primer lugar o invertir una decisión de adopción incluso cuando el harness sigue siendo el mismo. La tabla siguiente enumera once errores comunes que cometen los ingenieros al medir agentes. Algunos ejemplos proceden de benchmarks publicados (LangChain, Anthropic, Darwin Gödel Machine). Otros se midieron directamente en nuestras ejecuciones del soporte al comparar comprobaciones más débiles, una sola repetición o tareas familiares frente a la suite completa para mostrar cuánto se mueven las cifras.
| Error | Ejemplo | Prevención |
|---|---|---|
| Cambiar accidentalmente un ajuste junto con el harness | La puntuación de LangChain cayó del 63.6% al 53.9% cuando solo cambió el ajuste de razonamiento | Registra las condiciones fijas de forma separada a los cambios evaluados |
| Comprobar solo la base de datos final | Un diseño que no hace nada superó la mitad de las tareas de soporte | Comprueba acciones y respuestas; ejecuta primero un diseño que no haga nada |
| Dejar que el harness escriba sus propias evidencias | Una versión de Darwin Gödel Machine superó su comprobación eliminando los marcadores de registro que leía la comprobación | Califica externamente y restringe el acceso a comprobaciones, etiquetas y registros autoritativos |
| Confiar en un juez no medido | El primer juez interpretó 19 de las 20 respuestas «en espera» del diseño 2 como reembolsos completados | Etiqueta respuestas antes de ejecutar el juez; mídelo con etiquetas con las que no se ajustó |
| Ajustar con las tareas sobre las que informas | El workflow sin agente puntuó 0.94 en sus 16 tareas y 0.31 en mensajes nuevos, en ambos casos con el juez | Usa tareas de validación para seleccionar candidatos y reserva tareas frescas para la evaluación final |
| Diluir una violación en el promedio | No ocurrió ninguna violación en estas ejecuciones, pero un reembolso al cliente equivocado en 200 ejecuciones solo reduciría el éxito en 0.005 | Informa de las violaciones críticas por separado y exige cero, igual que ToolSandbox puntúa con cero cualquier ejecución que active un campo minado |
| Tratar una sola ejecución como el resultado definitivo | Una repetición hizo que el agente simple pareciera un 40% más caro que el agente de aprobación; a lo largo de 10 repeticiones sus medianas estuvieron a menos del 4% | Repite e intercala ejecuciones; compara el coste mediano; informa de pass^k e intervalos |
| Decidir únicamente por el éxito | Con el juez, el agente simple lidera en mensajes nuevos por 1 ejecución de 160. Sin embargo, el diseño 3 cuesta menos por tarea, con todo el intervalo emparejado por debajo de cero. | Informa del coste, latencia, llamadas y tokens junto al éxito, cada uno con un intervalo; representa la frontera; fija guardrails antes de comparar |
| Contar el coste desconocido como cero | Las llamadas al modelo de decisión del router se devolvieron sin coste facturado; si se contaran como cero, desaparecerían del coste del diseño 4 | Calcúlalo a partir de la lista de precios, o mantenlo como desconocido y haz fallar la comprobación de coste mientras haya ejecuciones con coste desconocido |
| Mezclar fallos de infraestructura con fallos del harness | Los errores de infraestructura de Anthropic cayeron del 5.8% al 0.5% cuando solo cambiaron los recursos del contenedor | Clasifica los errores; infórmalos por separado, manteniéndolos como fallos |
| Comparar resultados entre distintas versiones del evaluador | El diseño 2 puntuó 1.00 con la comprobación de base de datos de la Parte 3 y 0.81 calificado con obligaciones | Versiona las comprobaciones; compara solo ejecuciones calificadas con la misma versión |
El código complementario
harness-evals es una biblioteca para Python 3.12+ sin dependencias fuera de la biblioteca estándar. Un adaptador la conecta a un harness: tu función ejecuta una lista de tareas una vez y devuelve un registro observado por tarea. La función run de la biblioteca llama a cada adaptador el mismo número de veces, intercalando los diseños, y sus funciones de calificación comprueban los registros. Estas funciones producen los resultados de este artículo:
summarizeinforma de las métricas anteriores, con intervalos para tasas, costes, latencias, llamadas y tokens.paretoyfrontier_svgencuentran y dibujan la frontera.failure_map_svgdibuja dónde falla cada harness.compareaplica la regla de adopción. Los guardrails se declaran en el caso de uso:guardrails={"latency_p95": ("<=", 2.0)}permite un aumento de como máximo 2 segundos.
compare rechaza registros con tareas o recuentos de repeticiones diferentes. El comando harness-evals compare también valida los registros cargados de cada diseño frente al manifiesto: los ID de tarea, el split, las filas únicas de tarea/ensayo y las repeticiones declaradas deben coincidir. Los manifiestos identifican con huella digital los ID de tarea, entradas, splits, nombres de comprobación y flags críticas, además de la versión del caso de uso y los ajustes congelados; desde Python, llama a comparable para comparar esos metadatos. comparable no compara la versión del evaluador ni el recuento de repeticiones, y una comprobación cuya lógica cambie bajo el mismo nombre necesita una nueva versión del caso de uso.
Instala la biblioteca en un proyecto gestionado con uv:
uv add "harness-evals @ git+https://github.com/slavadubrov/harness-evals@03cc80db2fd7039515887baf5c5321c3957139fa"Describes el caso de uso como tareas con comprobaciones y escribes un adaptador por harness. El adaptador en vivo del laboratorio inicia el runner del asistente en un proceso nuevo y luego lee las bases de datos de cada tarea. Este extracto muestra de dónde procede la evidencia del reembolso:
def observe(start: Path, final: Path, task_id: str):
    passed = TASKS_BY_ID[task_id].check(start, final).passed
    actions = [
        Action("refund", {"order": r["order_id"],
                          "cents": r["amount_cents"],
                          "refund_id": r["id"]})
        for r in diff(start, final)["refunds"].added
    ]
    ...  # plus the refunds the service still holds for the case
Esto detecta una fila de reembolso añadida incluso si el harness eludió el servicio. Si el harness puede escribir en los archivos de la base de datos directamente, sigues necesitando los permisos de archivo y proceso descritos anteriormente. El adaptador maneja por igual un agente y un workflow porque observa sus efectos a través de la misma interfaz.
Para recalcular las puntuaciones a partir de las ejecuciones guardadas, usa Python 3.12 y uv. Los targets de Make del laboratorio instalan primero sus dependencias fijadas; no se necesita clave de API ni nuevas llamadas al modelo. Los comandos fijan la revisión exacta del código complementario utilizada aquí:
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout 19c7712762cca7b4f0af07523f3590ddf8ce8bb9
make part4-regrade       # grades the saved runs; writes RESULTS.md, frontier plots and failure maps
make part4-agreement     # both judge versions and the reply check against the labels
make part4-compare BASE=3 CANDIDATE=5 SPLIT=new
make failures DESIGN=5 SPLIT=new LEVEL=judge        # the checks design 5 fails, task by task
make show DESIGN=2 TASK=refund-over-limit-approved  # one saved run, check by check
make mine                # score your own function on the 16 known tasks
El comando part4-compare compara el diseño 5 con el diseño 3 sobre los mensajes nuevos, calificados con obligaciones. Imprime una diferencia de éxito de −0.163 (intervalo del 95% de −0.287 a −0.037), junto con las diferencias emparejadas en coste, latencia, llamadas y tokens. Devuelve rechazar porque el diseño 5 no alcanza el umbral de fiabilidad. Añade LEVEL=judge para incluir las clasificaciones guardadas del juez. Volver a calificar reutiliza las observaciones y veredictos; no reproduce de forma independiente el comportamiento original del modelo.
make show imprime una ejecución guardada tal como la vio el evaluador: el mensaje del cliente, lo que registró el servicio de reembolsos, la respuesta y el veredicto de cada comprobación. make mine ejecuta examples/your_harness.py, una plantilla sin llamada al modelo y con una API solo para reembolsos. Sustituye su función por tu propio agente o workflow, y luego actualiza los metadatos de modelo, llamadas, tokens y coste declarados. Informa del uso real cuando se mida y deja los valores desconocidos como desconocidos; el uso cero del starter basado solo en reglas no describe una llamada al modelo. Soportar tareas de dirección y ajustes también requiere ampliar su API.
Las ejecuciones en vivo opcionales usan make part4-live TRIALS=5 con una clave de OpenRouter en OPENROUTER_API_KEY. Esto ejecuta los cinco diseños sobre las 16 tareas conocidas, haciendo llamadas de pago al modelo. El adaptador solo se ha probado con el diseño que no hace nada. A precios de octubre de 2026, las ejecuciones guardadas de agentes costaron alrededor de $0.0003 por tarea y repetición; 5 repeticiones de los cuatro diseños con agentes más el workflow costarían aproximadamente $0.10, excluyendo las llamadas del evaluador. El modo en vivo usa obligaciones y no ejecuta el juez.
Qué hacer después
En tu propio harness, empieza con las tres comprobaciones que cambiaron un resultado aquí. Ejecuta un diseño que no hace nada: en estas tareas superó 8 de 16 cuando solo se comprobó la base de datos final. Comprueba la respuesta además de la acción: el agente con middleware de aprobación (diseño 2) emitió cada reembolso aprobado y dijo al cliente que seguía en espera. Puntúa el candidato en mensajes para los que no fue escrito. Aquí, el workflow sin agente pasó de 1.00 en sus 16 tareas a 0.78 en 32 nuevas bajo obligaciones, y a 0.31 una vez que un juez leyó las respuestas. Fija los umbrales antes de leer esas puntuaciones, y luego compara los dos diseños con la regla.
La siguiente parte usará un programa para proponer cambios de harness y este evaluador para puntuarlos. Evalúa esa búsqueda bajo un presupuesto fijo: cuenta propuestas y cambios aceptados, incluye el coste de propuestas y de evaluación, e informa de regresiones y de la mejora en el conjunto reservado. Repite búsquedas independientes para evaluar el procedimiento, como hace Beyond Prompts. Usa los fallos de desarrollo para ediciones y las tareas de validación para la selección; mantén el evaluador y las tareas finales de prueba separados. Cada candidato debe cumplir los límites de éxito, coste y latencia, porque los reintentos por sí solos pueden aumentar la exactitud gastando más (AI Agents That Matter).
Este artículo evalúa harnesses; no demuestra una mejora recursiva de sí mismos. Un programa fijo que busca mejor código de harness es optimización automatizada. Una afirmación recursiva más fuerte requiere que los cambios retenidos afecten al proceso que produce los cambios posteriores, una distinción que Harness² establece entre harnesses de ejecución y de mejora. Ese proceso necesitaría comparación a presupuestos iguales sobre tareas frescas.