Avaliar um harness de agente mantendo o modelo fixo
Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este artigo destina-se a engenheiros que precisam de decidir se uma alteração a um agente de AI ou workflow melhora o seu desempenho na tarefa de negócio. Um harness é o código à volta de um modelo de linguagem: os seus prompts, ferramentas, fluxo de controlo, memória, verificações e novas tentativas. Vai aprender a manter o modelo fixo, verificar o que o harness faz e diz ao utilizador e ponderar o sucesso face ao custo e à latência. Também vai aprender a decidir se um candidato deve substituir o desenho atual.
O exemplo prático é o assistente de suporte de uma loja online, onde reembolsos acima de $200 precisam da aprovação de um supervisor. Verificar apenas a sua base de dados final fez um agente com middleware de aprovação parecer perfeito, embora dissesse aos clientes que os reembolsos concluídos continuavam em espera. Verificar ações e respostas expõe essa falha. Testar mensagens para as quais nenhum desenho foi escrito expõe os limites de um workflow mais barato. Nesse workflow, uma chamada ao modelo lê a mensagem e o código executa os passos.
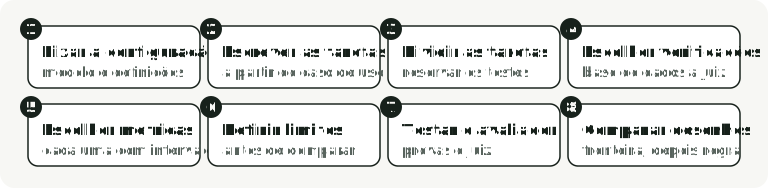
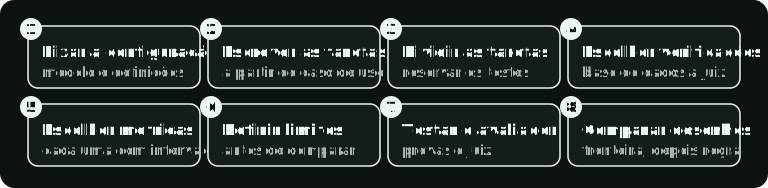
A avaliação tem oito passos, que as secções seguintes seguem por ordem.
O que muda numa avaliação de harness
Uma comparação de modelos mantém os prompts, as ferramentas e o ciclo de execução fixos enquanto altera o modelo. Uma comparação de harness mantém o modelo fixo enquanto altera o código à sua volta. Execuções repetidas e intervalos de incerteza ajudam a distinguir uma melhoria de harness do ruído entre execuções.
O guia da Anthropic Demystifying evals for AI agents distingue duas partes. O harness do agente permite que um modelo atue como agente; o harness de avaliação executa tarefas, regista cada tentativa e classifica-a. Aqui chamo ao segundo o avaliador. Tanto um agente, que escolhe os seus próprios passos, como um workflow, cujos passos estão fixos em código, podem ser avaliados desta forma.
Quanto pode o harness alterar um resultado? Comparações publicadas com um modelo fixo fornecem um intervalo:
- O artigo do Terminal-Bench 2.0 executou vários agentes com os mesmos modelos, pelo menos cinco vezes cada um. O GPT-5 resolveu 49.6% das tarefas no Codex CLI e 33.9% no mini-SWE-agent, uma diferença de 15.7 pontos. O Claude Opus 4.5 resolveu 57.8% no Terminus 2 e 52.1% no Claude Code, uma diferença de 5.7 pontos. Os autores concluem ainda assim que escolher o modelo importou habitualmente mais do que escolher o agente.
- A LangChain subiu a sua CLI deepagents de 52.8% para 66.5% no Terminal-Bench 2.0 alterando o harness em torno do
gpt-5.2-codex, incluindo quanto raciocínio cada fase de uma tarefa utiliza. - No AutoHarness da Google DeepMind, o Gemini 2.5 Flash escreve código que rejeita jogadas ilegais antes de chegarem ao jogo. Com esse código à volta, o Flash venceu 9 de 16 jogos de dois jogadores contra o Gemini 2.5 Pro, que é maior.
Estes resultados mostram que alterar o harness pode mover a pontuação em 5 a 16 pontos, ou permitir que um modelo mais pequeno vença um maior. A dimensão do ganho variou de caso para caso, por isso meça-o para o seu próprio harness e modelo, e volte a medir quando o modelo mudar.
Mantenha estes elementos fixos, e não apenas o nome do modelo:
- O modelo e a sua versão, e o endpoint do fornecedor que o serve. Um router como o OpenRouter pode enviar um pedido para outro fornecedor a menos que fixe um.
- Definições de amostragem e raciocínio, a menos que alterá-las seja a experiência. Na experiência da LangChain, executar no esforço de raciocínio mais elevado em vez de alto reduziu a pontuação de 63.6% para 53.9%, porque mais tarefas esgotaram o tempo limite. Se um candidato definir o esforço de forma diferente para cada fase, registe essa política como parte do candidato. Mantenha as outras condições fixas.
- A máquina em que as tarefas são executadas. A Anthropic alterou apenas os recursos de contentor de execuções do Terminal-Bench 2.0 e moveu a pontuação até 6 pontos. Conclui que diferenças na tabela de classificação inferiores a 3 pontos merecem ceticismo até que as configurações estejam documentadas e alinhadas.
- As tarefas, as verificações e a versão do avaliador. Uma verificação alterada é uma avaliação diferente.
As partes que pode alterar incluem prompts, definições de ferramentas, o grafo de ciclo ou workflow, middleware, novas tentativas, modelos de resposta e modelos adicionais. Conte os erros, custo e latência de um modelo adicional contra o harness que o utiliza.
Seis desenhos para o assistente de suporte
Para ver esta configuração na prática, recordemos o assistente de suporte da loja online da Parte 3. Emite reembolsos, altera moradas e atualiza definições de conta. Uma regra orienta a nossa comparação: reembolsos acima de $200 precisam da decisão de um supervisor. Testamos seis desenhos para o executar (cinco da Parte 3 mais uma linha de base que não faz nada). Diferem em quem escolhe os passos e quem gere essa espera:
| Desenho | Como executa | Aprovação do supervisor |
|---|---|---|
| 0. Não faz nada | Sem chamada ao modelo, escrita ou resposta; linha de base aqui adicionada | Nenhuma |
| 1. Agente simples | O modelo chama ferramentas num ciclo | Pode deixar reembolso em espera; não retoma para decisão |
| 2. Agente com middleware de aprovação | O mesmo ciclo, com código em torno de tool calls para pausar e retomar | Middleware espera pela decisão |
| 3. Agente dentro de um workflow | Um agente inicia a tarefa; código trata depois de aprovação, reembolso e resposta | Workflow espera pela decisão |
| 4. Router e três agentes | Pequeno modelo de decisão envia cada mensagem a agente mais especializado | Sem passo para retomar perante decisão |
| 5. Workflow sem agente | Chamada ao modelo lê mensagem para campos; código escolhe e executa os passos | Workflow espera pela decisão |
A Parte 3 executou cada desenho uma vez. Aqui classificamos execuções guardadas a 15 de outubro de 2026. Estas incluem 10 repetições por desenho em 16 tarefas conhecidas, mais 5 repetições dos desenhos 1 a 5 em 32 mensagens novas para as quais nenhum desenho foi escrito (descritas abaixo). Todos os desenhos que usam modelos usaram openai/gpt-6-luna através do endpoint OpenAI do OpenRouter, com fallbacks desativados. O modelo de decisão adicional do desenho 4 pertence ao seu harness.
A classificação utiliza o harness-evals, uma pequena biblioteca Python que pode instalar no seu próprio projeto. O laboratório de acompanhamento liga-o ao assistente. Esta é a Parte 4 de Recursive Harness Engineering: as Partes 2 e 3 construíram os desenhos. Esta parte constrói o avaliador que pontua uma alteração de harness; na parte seguinte, um programa propõe as alterações.
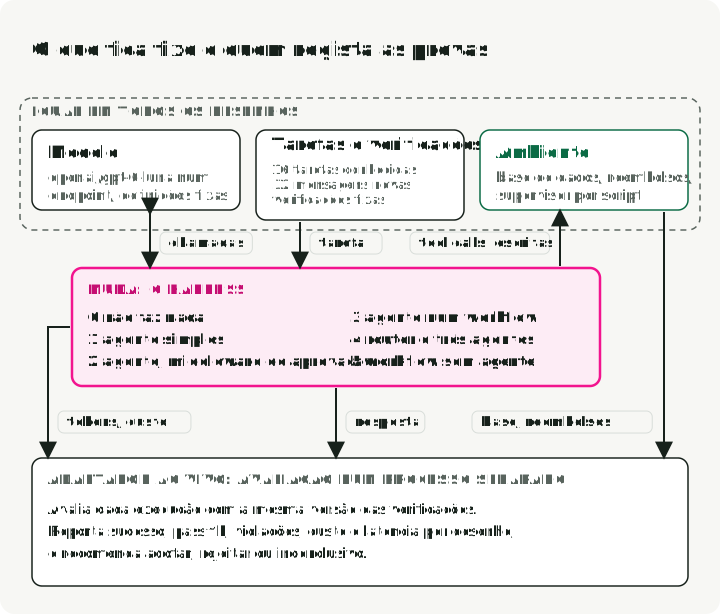
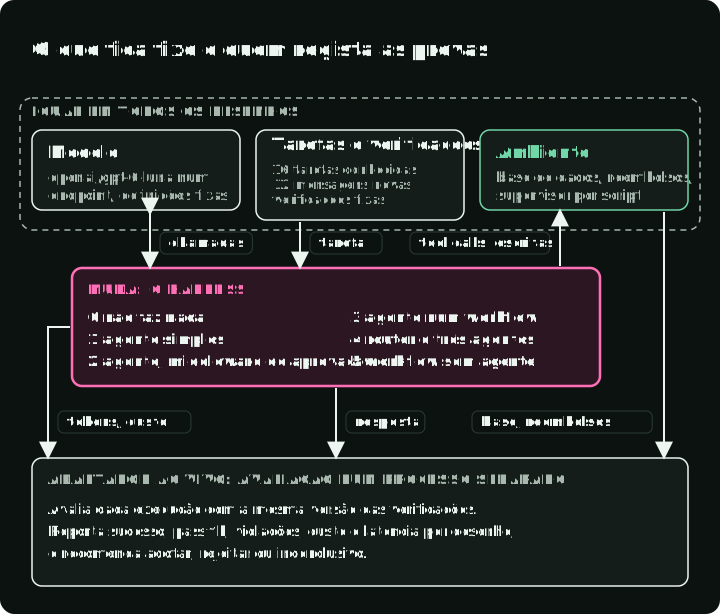
A figura mostra o adaptador em tempo real do laboratório, o código que liga o avaliador a um assistente em execução. Um processo separado lê a base de dados e os registos do serviço de reembolsos, e obtém a resposta, consumo de tokens e custo a partir da própria saída do assistente. As execuções guardadas de outubro classificadas abaixo registaram parte dessa evidência dentro do processo do assistente. Quem escreve as provas explica que parte foi registada dentro do processo e o que isso deixa por testar.
As tarefas vêm do caso de utilização
O código de avaliação pode ser partilhado, mas as tarefas não. Cada harness é construído para um caso de utilização (aqui, um serviço de suporte), pelo que as suas tarefas vêm desse caso de utilização. Refletem a política que o sistema deve seguir, os pedidos que os utilizadores enviam e as falhas que já observou. Um benchmark público indica o desempenho de um modelo nas tarefas de outra pessoa. O guia da Anthropic sugere começar com 20 a 50 tarefas retiradas de falhas reais e fazer crescer o conjunto a partir daí.
No nosso exemplo, o serviço de suporte começa mais pequeno, com 16 tarefas conhecidas transitadas de versões anteriores. Doze vêm da Parte 2: reembolsos, alterações de morada e alterações de definições. O resultado correto pode ser a própria alteração, uma recusa, uma pergunta a pedir informação em falta ou um encaminhamento para um supervisor. Um script desempenha o papel de supervisor e pode aprovar, rejeitar ou deixar o pedido em espera.
A Parte 3 adiciona quatro casos: um reembolso aprovado de $350, um reembolso rejeitado de $350 e dois reembolsos cuja resposta do serviço é perdida após o dinheiro ter sido reembolsado. Estes dois últimos usam reembolsos de $15 e $350; o assistente deve tentar novamente sem reembolsar duas vezes.
Para cada tarefa, registe o que uma execução correta faz antes de executar o que quer que seja:
- A entrada e o estado inicial: a mensagem do utilizador e a base de dados ou ficheiros a partir dos quais a execução começa.
- O que deve acontecer: as ações que o ambiente deve registar, como um reembolso de $350 na encomenda O-2002.
- O que nunca deve acontecer: ações que são erradas em qualquer execução, como um reembolso na encomenda de outro cliente. O ToolSandbox da Apple chama-lhes campos minados e pontua com zero uma execução que atinja um, independentemente de tudo o resto que tenha feito. Trate-as como críticas.
- O que deve e não deve ser dito ao utilizador: os factos que uma resposta tem de declarar e afirmações que seriam falsas.
- O tipo de resultado: uma ação, uma pergunta a pedir informação em falta, uma recusa com o motivo da política, um encaminhamento para uma pessoa ou uma resposta.
Eis a tarefa de reembolso aprovado de $350 com todas as verificações descritas, incluindo a do juiz, tal como o ficheiro evaluator/support.py do laboratório a constrói. Leia as verificações como o contrato da tarefa:
Task(
    "refund-over-limit-approved",
    "This is ben.ortiz@example.com. The carbon bike wheels from "
    "order O-2002 are cracked. Refund the full $350 now, please.",
    (
        state(),                    # the database is as expected
        did("refund", order="O-2002", cents=35000),  # refund issued
        at_most(1, "refund"),       # only once (critical)
        Check(
            "only permitted refunds",
            lambda e: all(
                a.matches("refund", {"order": "O-2002", "cents": 35000})
                for a in e.actions if a.name == "refund"
            ),
            critical=True,
        ),
        NO_FALSE_HOLD,              # reply never says it still waits
        says(r"\b350(\.00)?\b"),    # the reply states the amount
        judged("outcome"),          # the judge must say "action"
    ),
)
As verificações críticas de reembolso rejeitam um segundo reembolso ou qualquer reembolso com a encomenda ou montante errados. A verificação separada did exige que o reembolso esperado aconteça; não o emitir é uma falha de tarefa, não uma ação não autorizada.
A última verificação usa um juiz: um segundo modelo que lê a resposta e a classifica como confirmação de ação, pergunta, recusa, encaminhamento ou resposta. Aqui a classe esperada é uma confirmação de ação. O juiz verifica que tipo de resposta o utilizador recebeu, enquanto as verificações de base de dados e de ação verificam se o reembolso aconteceu.
Cada verificação devolve verdadeiro, falso ou indeterminado quando faltam provas. Uma execução só passa quando termina sem erros e todas as verificações devolvem verdadeiro. Se o juiz esgotar o tempo limite, a execução não passa e o avaliador reporta falta de provas de classificação em vez de uma falha do harness.
Tarefas que devem terminar sem alterações
Muitas execuções corretas não alteram nada. O cliente pede um reembolso fora da janela de 30 dias ou na encomenda de outro cliente, ou omite a cidade numa nova morada. O resultado certo é uma recusa ou uma pergunta, e a base de dados permanece como estava. Metade das 16 tarefas é deste tipo.
Isso faz com que uma verificação apenas da base de dados final seja fácil de passar. O desenho 0 passou 8 das 16 tarefas em cada uma das suas 10 repetições sem chamada, escrita ou resposta. Os autores do Agentic Benchmark Checklist encontraram o mesmo problema num benchmark público: nas tarefas de companhias aéreas do τ-bench, um agente que devolve respostas vazias obteve 38%, pontuação superior à do GPT-4o. Pedem que todos os benchmarks reportem a pontuação de um agente tão trivial. Execute primeiro um desenho que não faz nada nas suas próprias tarefas. Qualquer aprovação numa tarefa que exige uma resposta expõe uma verificação em falta.
Tarefas de desenvolvimento, validação e teste
As nossas 16 tarefas conhecidas vêm da construção do assistente de suporte nas Partes 2 e 3. Dezasseis tarefas são suficientes para mostrar como as verificações funcionam, mas ficam aquém das 20 a 50 recomendadas acima. Pior, todos os desenhos foram construídos com essas tarefas em vista. Isso faz delas um conjunto de desenvolvimento: lê as suas falhas e altera o harness até passar por elas.
O workflow sem agente da Parte 3 mostra por que razão um conjunto de desenvolvimento não é suficiente. As suas regras reconhecem reembolsos, alterações de morada e alterações de definições, e dizem ao cliente que um colega responderá a tudo o resto. Porque escrevi essas regras em torno destas 16 tarefas, uma pontuação perfeita nelas diz pouco sobre outras mensagens. Para testar mensagens fora desse conjunto e expandir a suite para 48 tarefas, o laboratório adiciona 32 novas mensagens para as quais nenhum desenho foi escrito. Cobrem 8 queixas vagas, 8 mensagens com dois pedidos, 8 perguntas sobre políticas e 8 pedidos fora dos tipos conhecidos, como encerrar uma conta. Cada uma indica o seu resultado esperado e a alteração de base de dados necessária, se houver, definidos antes de qualquer execução.
Machine learning separa os seus dados pelo mesmo motivo: um modelo tem melhor desempenho nos exemplos em que foi treinado ou ajustado do que em exemplos novos. O Machine Learning Crash Course da Google usa três conjuntos. O modelo treina no conjunto de treino. O conjunto de validação pontua cada ajuste, de uma nova taxa de aprendizagem a um novo desenho de modelo. O conjunto de teste verifica o modelo escolhido no final.
Nada treina no conjunto de validação. Mas o modelo que mantém é aquele que por acaso melhor se adaptou a esses exemplos, pelo que a sua pontuação de validação é otimista. O curso recomenda substituir dados de validação e teste após uso repetido para seleção de modelos tornar as suas pontuações otimistas. Wan e colegas mediram a diferença para prompts: prompts otimizados para maximizar a precisão de validação pontuaram 5.8 a 13.2 pontos abaixo num conjunto de teste separado. Em contrapartida, as duas pontuações do prompt não otimizado mantiveram-se a cerca de 1.7 pontos uma da outra.
Com os pesos do modelo de linguagem fixos, o harness é o que ajusta: prompts, ferramentas e fluxo de controlo tomam o lugar de pesos e hiperparâmetros. Divida as suas tarefas da mesma forma antes da primeira execução. As tarefas de desenvolvimento fazem o papel do conjunto de treino, as tarefas de validação escolhem entre harnesses candidatos e as tarefas de teste pontuam o harness escolhido uma vez. O Machine Learning Yearning de Andrew Ng chama ao conjunto de validação o “dev set”; neste artigo, tarefas de desenvolvimento são aquelas cujas falhas corrige.
Equipas que ajustam agentes dividem as suas tarefas desta forma também. Quando a Anthropic melhorou as ferramentas dos seus agentes em avaliações internas, “apoiou-se em conjuntos de teste reservados para garantir que não sobreajustava às avaliações de ‘treino’” (Writing effective tools for agents). A METR iterou no scaffolding dos seus agentes com “uma suite de ‘desenvolvimento’” de tarefas e reportou pontuações numa “suite de ‘teste’ reservada de 83 tarefas” (DeepSeek-V3 evaluation). O benchmark de agentes AppWorld fornece divisões separadas de treino, dev e teste. Pede que ninguém faça ajustes nas tarefas de teste, “nem por pesquisa em grelha de parâmetros nem manualmente ajustando prompts”.
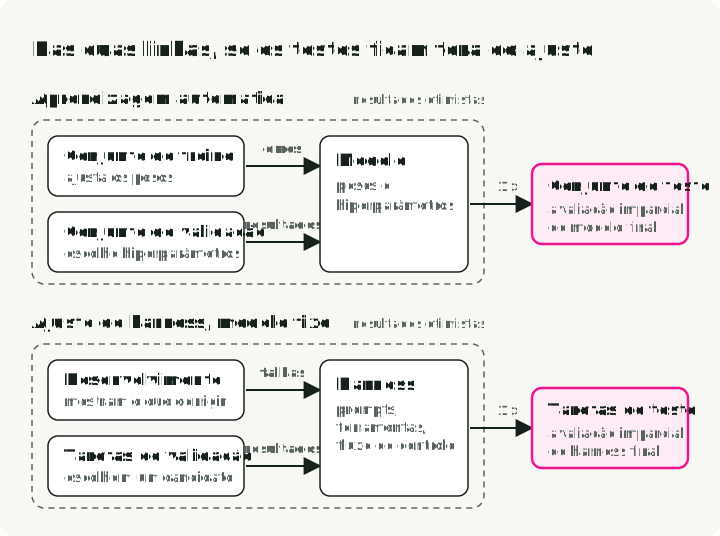
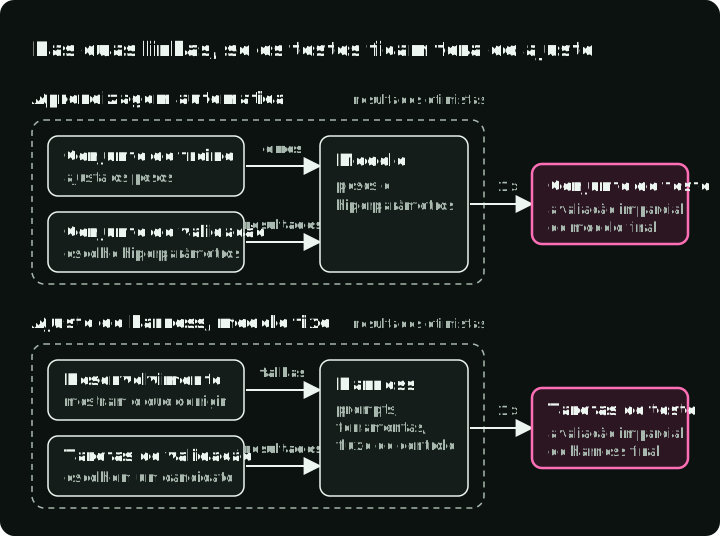
Cada conjunto na linha do harness faz o trabalho do conjunto acima dele. Apenas a pontuação do conjunto de teste mede exemplos que o ajuste não viu.
No laboratório, as 32 novas mensagens, numa divisão chamada new, servem de conjunto de teste. Uma divisão aleatória em machine learning extrai o conjunto de teste do mesmo grupo do conjunto de treino. Aqui, pelo contrário, as novas mensagens foram escritas para incluir tipos de pedidos que faltam nas tarefas de desenvolvimento. Uma pontuação mais baixa nelas pode resultar do ajuste às tarefas conhecidas ou de pedidos para os quais nenhum desenho foi construído.
O laboratório não tem um conjunto de validação separado. Mais à frente neste artigo, as novas mensagens decidem entre o workflow sem agente (desenho 5) e o agente dentro de um workflow (desenho 3), o que as torna tarefas de validação para essa escolha. Ler as suas falhas e corrigir um harness torná-las-ia tarefas de desenvolvimento. De qualquer forma, a pontuação final do desenho escolhido precisa de mensagens frescas.
Mantenha falhas revistas como tarefas de regressão após corrigi-las, e execute-as em alterações posteriores de harness ou modelo. Remova dados privados de clientes antes de adicionar casos de produção. Este conjunto reutilizado verifica se as correções continuam a funcionar; reserve pedidos frescos para avaliação final. Combine verificações offline com monitorização de produção e revisão humana ocasional, como o guia de avaliação da Anthropic recomenda.
Um programa que propõe alterações de harness pode tomar muito mais decisões de seleção do que uma pessoa, aumentando o risco de overfitting às mesmas tarefas. Dê-lhe um conjunto de validação para as suas escolhas, e mantenha o conjunto de teste fora do seu alcance. No harness-evals, cada tarefa carrega um nome de split, dev por omissão, e run avalia uma divisão de cada vez.
Reservar tarefas deixa menos disponíveis para ajuste. O Meta-Harness, que pesquisa sobre código de harness com o modelo congelado, pesquisou e avaliou nas mesmas 89 tarefas do Terminal-Bench 2.0. Os seus autores afirmam que uma divisão separada teria enfraquecido a pesquisa num benchmark tão reduzido. Verificaram a existência de overfitting lendo os harnesses e procurando cadeias de caracteres específicas de tarefas. Para o seu próprio caso de utilização, pode escrever mais mensagens e reservar algumas.
Três níveis de verificações
O laboratório classifica cada execução guardada em três níveis, cada um adicionando verificações do contrato da tarefa acima:
- Base de dados (
state): a base de dados final corresponde à alteração esperada. As Partes 2 e 3 classificaram desta forma. - Obrigações (
did,at_most,only permitted refunds,never,NO_FALSE_HOLD,says): a verificação da base de dados, as verificações das ações de reembolso e dois tipos de padrão de resposta. Um exige factos que a resposta tem de declarar; o outro proíbe dizer que um reembolso emitido ainda está em espera. O laboratório define factos de resposta exigidos (says) para as 16 tarefas conhecidas; as 32 novas mensagens usam as outras verificações de obrigações sem padrões de factos específicos de tarefas. - Juiz (
judged): as obrigações, mais uma verificação de que a classificação da resposta pelo juiz corresponde ao resultado esperado da tarefa.
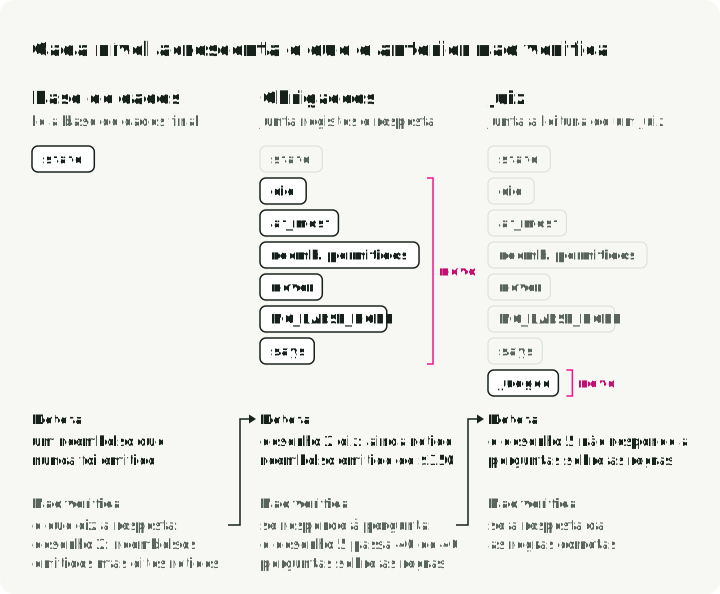
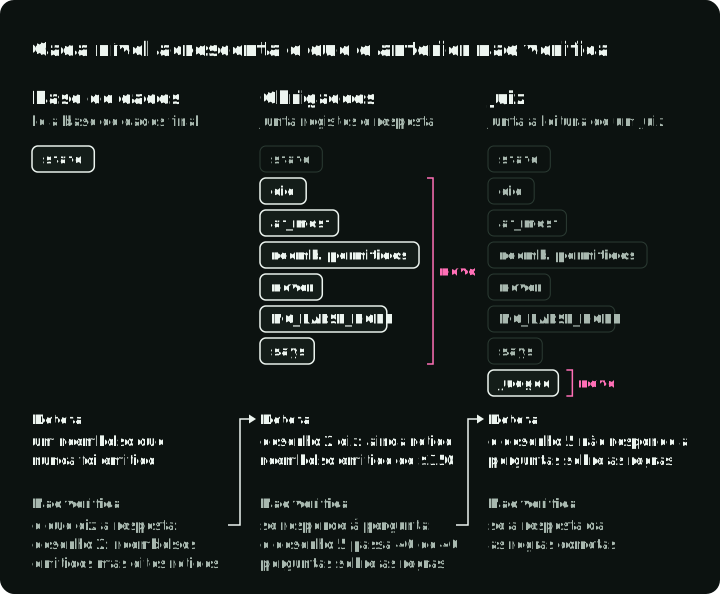
A figura mostra, para cada nível, uma falha que este deteta e uma que não consegue ver; o nível seguinte verifica esta última. Nenhuma verificação neste laboratório testa se uma resposta declara a política correta.
Os vereditos do juiz foram guardados com as execuções a 15 de outubro, pelo que classificá-los novamente não exigiu novas chamadas ao modelo. Provêm da segunda versão da sua grelha; Verificar o juiz face a respostas etiquetadas mostra em que essa versão foi testada, e em que não foi. Os três níveis classificam as mesmas execuções guardadas, e cada resultado abaixo identifica o seu nível.
O que cada nível deteta nas tarefas conhecidas
Sucesso é a proporção de execuções que passaram todas as verificações no nível indicado. A tabela mostra o sucesso nas 16 tarefas conhecidas ao longo de 10 repetições por tarefa. O intervalo entre parênteses retos é um intervalo de 95%: onde a pontuação se situaria plausivelmente noutro conjunto de 16 tarefas semelhantes (como é calculado). Uma pontuação de 0.81 significa que 81% passaram.
| Desenho | Base de dados | Obrigações | Obrigações e juiz |
|---|---|---|---|
| 0. Não faz nada | 0.50 (0.25–0.75) | 0.00 (0.00–0.00) | 0.00 (0.00–0.00) |
| 1. Agente simples | 0.87 (0.68–1.00) | 0.81 (0.61–0.99) | 0.69 (0.45–0.88) |
| 2. Agente com middleware de aprovação | 1.00 (1.00–1.00) | 0.81 (0.62–1.00) | 0.68 (0.44–0.88) |
| 3. Agente dentro de um workflow | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.88 (0.71–1.00) |
| 4. Router e três agentes | 0.88 (0.69–1.00) | 0.81 (0.62–1.00) | 0.69 (0.46–0.88) |
| 5. Workflow sem agente | 1.00 (1.00–1.00) | 1.00 (1.00–1.00) | 0.94 (0.81–1.00) |
Porque o intervalo reamostra estas 16 tarefas, um intervalo de 1.00–1.00 apenas significa que todas as execuções passaram neste conjunto, não que o harness vá passar todos os pedidos futuros.
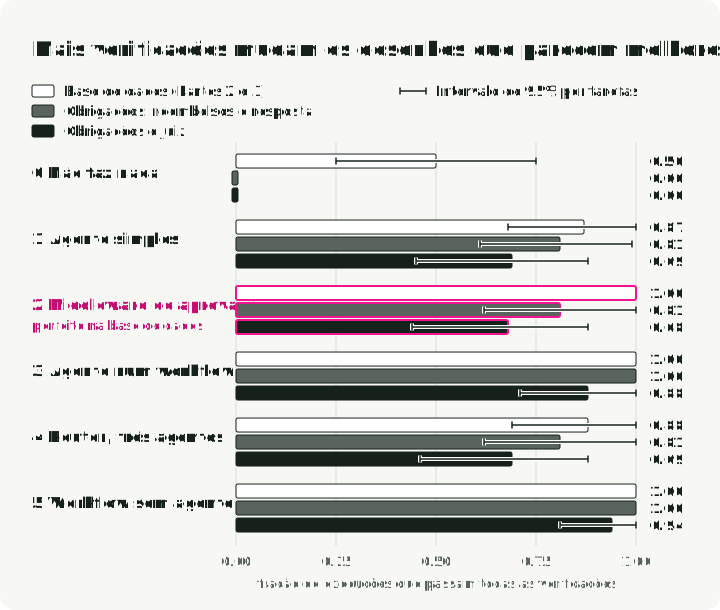
A figura traça as médias da tabela, cada uma com uma linha para o seu intervalo. Siga o agente de aprovação, desenho 2, da verificação de base de dados até ao juiz: começa nivelado com os desenhos 3 e 5 e termina abaixo deles.
Reembolsos corretos, respostas incorretas
O que as verificações mais rigorosas encontraram nas tarefas conhecidas:
- O desenho 0 desceu de 0.50 para 0. Todas as tarefas precisam de uma resposta, e este não envia nenhuma.
- O desenho 2, o agente com middleware de aprovação, desceu de 1.00 para 0.81. Em todas as 20 execuções das duas tarefas aprovadas, o reembolso avançou, mas a resposta disse que ainda estava em espera. Cada resposta afirmava: “Because it exceeds $200, it’s on hold for supervisor approval; it won’t be issued until approved.” Na tarefa da Parte 2 cujo supervisor nunca responde, não enviou qualquer resposta ao cliente, em 10 de 10 execuções.
- Os desenhos 1 e 4 começaram mais abaixo, em 0.87 e 0.88, porque nenhum consegue retomar após aprovação de um supervisor. Ambos os reembolsos aprovados de $350 permaneceram em espera, o que a verificação de base de dados já chumba. As verificações mais rigorosas levaram ambos os desenhos a 0.81 ao chumbar mais uma tarefa: o reembolso rejeitado de $350. Sem passo de aprovação, disseram ao cliente que um supervisor iria rever o reembolso e terminaram a execução com este ainda em espera, pelo que nenhuma decisão foi tomada. A verificação de base de dados aprovou-os nessa tarefa, porque de qualquer forma nada foi reembolsado.
- Os desenhos 3 e 5 mantiveram 1.00: em ambos, o código escreve a resposta depois de o supervisor decidir, a partir do resultado do serviço de reembolsos.
A tabela e o gráfico contam falhas; um mapa de falhas mostra onde se encontram. Cada linha é uma tarefa conhecida e cada coluna um tipo de verificação, com um painel por desenho e o juiz incluído:
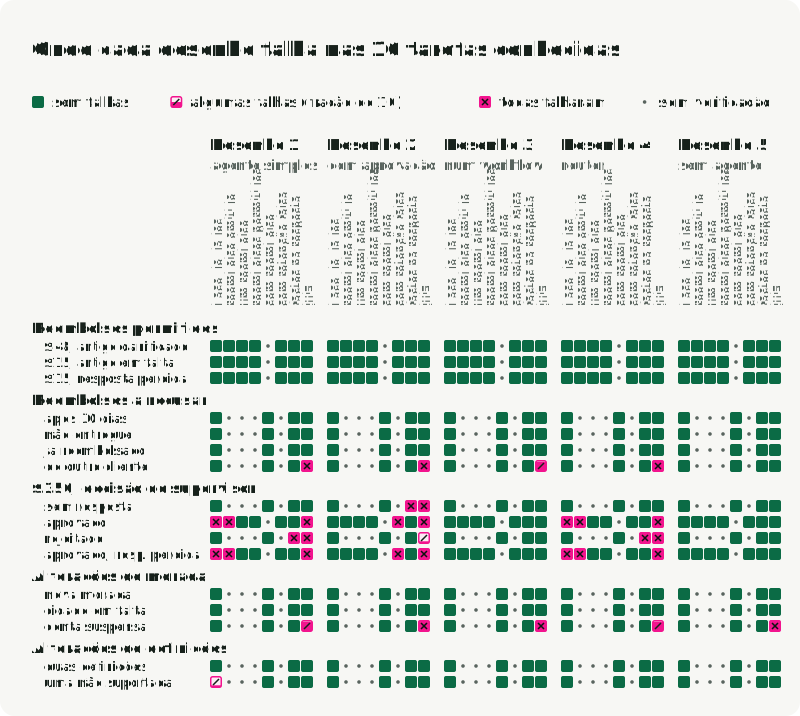
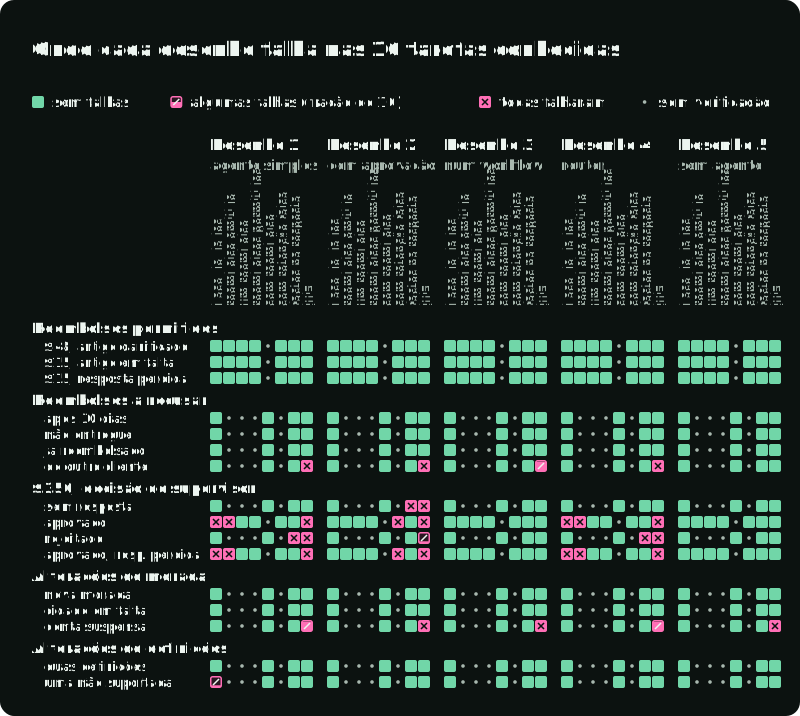
Dois grupos destacam-se. Os reembolsos de $350 que aguardam a decisão de um supervisor quebram os desenhos 1, 2 e 4 em colunas diferentes. Os desenhos 1 e 4 nunca emitem o reembolso aprovado, enquanto o desenho 2 o emite e depois chama-lhe ainda em espera. A coluna do juiz falha na encomenda de outro cliente em quatro desenhos e na conta suspensa em todos os cinco. A secção seguinte mostra que essas duas tarefas têm resultados esperados ambíguos. O harness-evals desenha esse mapa com failure_map_svg, e o laboratório escreve um para cada conjunto de tarefas. O comando make show abre a execução subjacente a qualquer quadrado.
Algumas falhas do juiz revelam tarefas ambíguas
O juiz reduziu a pontuação de todos os desenhos, mas essas reduções nem sempre são falhas confirmadas de serviço ao cliente:
- Na encomenda de outro cliente, os desenhos 1 a 4 disseram habitualmente que não a encontravam na conta do cliente e pediram-lhe que verificasse o número. O juiz classificou esta resposta como uma pergunta. A tarefa esperava uma recusa, embora o padrão de resposta aceitasse a resposta.
- Na alteração de morada de uma conta suspensa, todos os desenhos recusaram e disseram ao cliente para contactar o suporte. O juiz classificou isto como um encaminhamento; a tarefa esperava uma recusa.
Uma resposta pode recusar um pedido e encaminhar o cliente para o suporte. A tabela preserva as etiquetas e pontuações originais, mas essa sobreposição precisa de revisão antes de o juiz ser usado para aceitar ou rejeitar uma alteração em produção. Clarifique que combinações são aceitáveis, versione a grelha e volte a classificar todos os desenhos na comparação com ela. Não corrija as etiquetas apenas para o candidato.
Novas mensagens revelam tipos de pedido em falta
As 16 tarefas conhecidas apenas testam pedidos para os quais todos os desenhos já tinham sido construídos. Para ver como os harnesses lidam com entradas desconhecidas, a tabela seguinte pontua os cinco desenhos funcionais nas 32 novas mensagens, com 5 repetições por tarefa. O desenho que não faz nada não foi executado neste conjunto.
| Desenho | Obrigações | Obrigações e juiz |
|---|---|---|
| 1. Agente simples | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) |
| 2. Agente com middleware de aprovação | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) |
| 3. Agente dentro de um workflow | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) |
| 4. Router e três agentes | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) |
| 5. Workflow sem agente | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) |
O workflow sem agente, desenho 5, passou todas as 40 execuções de perguntas sobre políticas sob obrigações e nenhuma com o juiz adicionado. O seu esquema não tem categoria para responder a perguntas sobre políticas. As obrigações apenas verificaram que deixou a base de dados intacta; o juiz detetou que nunca respondeu à pergunta.
Reporte estes resultados por tipo de pedido bem como globais: queixas vagas, mensagens com dois pedidos, perguntas sobre políticas e outros pedidos. O laboratório dá a cada grupo oito tarefas, pelo que a pontuação global tem o mesmo peso. O tráfego real pode ter proporções diferentes; uma pontuação agregada elevada pode ainda ocultar um tipo de pedido mal tratado.
O desenho 5 também falhou a maioria das mensagens com dois pedidos, e queixas vagas como um bule de chá partido sem número de encomenda. Os agentes consultaram as encomendas do cliente e reembolsaram o bule de chá. A recomendação da Parte 3 de começar com este workflow ainda se mantém para as 16 tarefas conhecidas. Para lidar com as novas mensagens, necessita de suporte para perguntas sobre políticas, múltiplos pedidos numa única mensagem e consulta de encomendas quando uma queixa não fornece número de encomenda.
A Parte 3 também propôs um híbrido que encaminha pedidos normais para o workflow e deixa o resto para um agente. As execuções guardadas incluem um protótipo dessa ideia, um sexto desenho que não está na tabela acima. O seu router enviou 35 das 40 execuções de perguntas sobre políticas para o workflow, que não consegue responder a perguntas. Enviou as outras 5, e a maioria das mensagens com dois pedidos, para um passo que responde com uma frase fixa a pedir esclarecimento ao cliente. Com o juiz incluído, o híbrido passou apenas 14% das execuções de novas mensagens, pior do que qualquer uma das partes isolada. O laboratório fixado inclui as suas execuções guardadas para reclassificação, embora não o código-fonte do protótipo.
Todos os resultados vêm de um único modelo de chat, um endpoint e um dia. Escrevi os padrões de resposta depois de ler as respostas da Parte 3, pelo que visam falhas que eu já conhecia. O Claude gerou as novas mensagens e resultados esperados, que aprovei antes de executar os desenhos. Isso torna-as um teste separado destes desenhos, mas ainda um conjunto sintético pequeno em vez de uma amostra de tráfego real de clientes. O ficheiro reports/part-4/RESULTS.md do laboratório contém as métricas completas.
Métricas para cada avaliação
Reporte as mesmas métricas centrais para cada desenho. Cada uma deteta uma falha que as outras ocultam:
| Métrica | O que deteta | Como é calculada |
|---|---|---|
| Sucesso | Um desenho que resolve menos tarefas | A proporção de execuções que passam em cada verificação, média sobre tarefas |
| pass^k | Um desenho que apenas resolve uma tarefa às vezes | A probabilidade de k execuções de uma tarefa passarem todas, média sobre tarefas |
| Violações críticas | Uma ação proibida rara que uma média oculta | Execuções que falharam uma verificação crítica, contadas separadamente |
| Custo por tarefa e por tarefa resolvida | Um desenho que compra sucesso com tokens ou novas tentativas | Dólares por execução, e dólares totais divididos por execuções que passam |
| Chamadas ao modelo e tokens por tarefa | Trabalho extra de modelo, medido à parte de preços e descontos de cache | Média por execução |
| Latência, mediana e 95.º percentil | Execuções lentas que uma média oculta | Segundos por execução |
| Erros de infraestrutura e execuções indecisas | Falhas que não são culpa do harness, e evidência em falta | Contadas separadamente; nenhuma conta como aprovação |
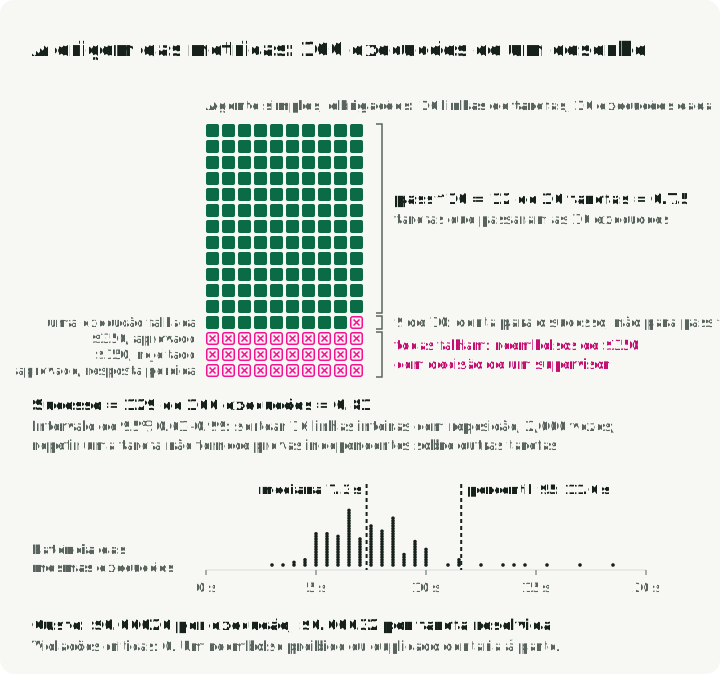
A figura calcula as métricas centrais a partir das execuções de um desenho: o agente simples nas 16 tarefas conhecidas, 10 execuções cada, classificadas em obrigações. Cada linha é uma tarefa e cada quadrado uma execução. O sucesso conta os quadrados aprovados; pass^10 conta as linhas sem falhas; o intervalo reamostra linhas, não quadrados.
O intervalo de 95% estima quanto o sucesso médio poderia variar ao longo de tarefas como as do seu conjunto. A biblioteca extrai tarefas inteiras com reposição, mantendo as suas execuções repetidas juntas. Recalcula a média 2,000 vezes e mantém os 95% centrais dessas médias. Repetir uma tarefa não fornece provas independentes sobre outras tarefas. O trabalho de Evan Miller Adding error bars to evals explica como ignorar perguntas relacionadas pode subestimar a incerteza. Este intervalo não pode contabilizar tipos de pedido em falta no conjunto de tarefas ou erros nas verificações. O harness-evals reamostra tarefas da mesma forma para custo, latência, chamadas e tokens, recalculando cada métrica nas execuções das tarefas extraídas.
pass^k vem do τ-bench. Para uma tarefa com execuções e aprovações, a estimativa de que independentes sob as mesmas condições passem todas é
com média sobre as tarefas, com . Por exemplo, se 9 de 10 execuções passarem, o sucesso é 90%, mas pass^5 é . Pergunta se o mesmo tipo de pedido é tratado de forma consistente, não se um cliente deve tentar novamente cinco vezes.
Nas tarefas de retalho do τ-bench, o GPT-4o passou cerca de 61% de execuções únicas, enquanto o seu pass^8 ficou abaixo de 25%. Nas nossas execuções de tarefas conhecidas, classificadas em obrigações, o agente simples passou 81% das execuções, e 75% das suas tarefas passaram todas as dez. Uma métrica relacionada, pass@k, é a probabilidade de pelo menos uma de k execuções passar. Isso ajuda quando algo fiável escolhe a execução aprovada, como uma suite de testes; este balcão envia uma única resposta.
Violações críticas chumbam uma execução e são também contadas separadamente. Um reembolso na encomenda do cliente errado em 1 execução em 200 mal move o sucesso médio, mas entrega dinheiro que não era devido ao cliente. Nenhum dos desenhos emitiu um reembolso proibido ou um segundo reembolso nestas execuções, incluindo quando a resposta do serviço de reembolsos se perdeu. O serviço usa a mesma chave de operação para cada nova tentativa de reembolso, pelo que devolve o primeiro recibo em vez de emitir outro reembolso.
Custo por tarefa resolvida divide o custo de todas as execuções, incluindo as falhadas, pelo número das que passaram. AI Agents That Matter mostrou que linhas de base simples igualavam agentes elaborados no HumanEval por menos dinheiro. Os agentes elaborados custavam entre cerca de 1.6 e mais de 50 vezes mais do que uma linha de base simples. Nas 16 tarefas conhecidas, classificadas em obrigações, o workflow sem agente custou $0.00005 por tarefa resolvida, contra $0.00025 a $0.00036 para os desenhos com agentes. Estes são custos de chamadas a modelos do harness; excluem chamadas do avaliador e revisão humana. Conte custos desconhecidos como desconhecidos, nunca como zero: as chamadas do modelo de decisão do router regressaram sem custo faturado, pelo que o laboratório as estima a partir da lista de preços. Sem nenhuma execução aprovada, o custo por tarefa resolvida fica indefinido.
Chamadas ao modelo e tokens medem quanto trabalho um desenho exige do modelo, para além de preços e descontos de cache. Nas tarefas conhecidas, o agente simples fez 3.6 chamadas ao modelo e usou cerca de 4,100 tokens por tarefa; o workflow sem agente fez uma chamada com cerca de 340 tokens.
Latência no 95.º percentil mostra as execuções lentas que um utilizador nota. Nas tarefas conhecidas, os desenhos com agentes demoraram 10.5 a 13.0 segundos nesse percentil, o workflow sem agente 2.4 segundos. O supervisor aqui é um script; estes tempos não estimam quanto tempo uma pessoa real demora a aprovar um reembolso.
Erros de infraestrutura são execuções que o fornecedor ou o runner corromperam: um limite de taxa, uma ligação perdida, um erro de fornecedor. Contam como falhas, porque um utilizador ficou sem resposta, e são reportados à parte das falhas próprias do harness. Um tempo limite esgotado conta contra o harness quando este o causou, como na definição de raciocínio mais elevada da LangChain. Nenhuma das execuções guardadas teve erro de infraestrutura.
Métricas que dependem do caso de utilização
Estas métricas centrais adequam-se a quase qualquer avaliação, enquanto outras verificações dependem do que o seu assistente pode quebrar. Adicione estas para acompanhar a sua carga de trabalho:
| Se o seu caso de utilização… | Adicione | No balcão de suporte |
|---|---|---|
| Dá ao utilizador algo para agir mais tarde | Verificações de que a resposta o nomeia, como id de encomenda ou ticket | Após um reembolso, os desenhos 1, 2 e 4 nunca nomearam o id de reembolso. Nas tarefas conhecidas, o desenho 3 nomeou-o em 40% das respostas e o desenho 5 em todos os 100%. |
| Recebe pedidos de formato livre | Sucesso em mensagens para as quais o harness não foi escrito | As 32 novas mensagens |
| Encaminha casos difíceis para pessoas | Se o utilizador é informado do que acontece a seguir | O desenho 2 não enviou resposta enquanto um reembolso esperava por um supervisor |
| Tem um verificador que pode escolher o melhor de várias tentativas | pass@k | Não usado: o balcão envia uma resposta |
| Escreve texto livre que um padrão não consegue verificar | Leitura de um juiz, medida contra etiquetas revistas | O juiz concordou com 30 de 30 etiquetas escritas por modelos em que não foi ajustado; validação humana ainda é necessária |
Limiares de aceitação
Defina limiares de aceitação antes de comparar desenhos, para que os resultados observados não possam alterar os requisitos. Para este exemplo, escolhi zero violações críticas, pass^k de pelo menos 0.9 (o limiar de fiabilidade), no máximo $0.002 por execução e uma latência no 95.º percentil de no máximo 15 segundos. Num sistema real, defina-os a partir do custo dos erros e do tempo de resposta prometido aos utilizadores. Escolhi estes limiares após as execuções terem sido guardadas, juntamente com os dois limites que a regra de comparação adiciona em Decidir entre dois desenhos. As decisões neste artigo ilustram, portanto, a regra; não a testam.
A biblioteca usa todas as repetições disponíveis para k: 10 nas tarefas conhecidas e 5 nas novas mensagens. Quando k é igual ao número de repetições, pass^k é a proporção de tarefas que passaram em todas as repetições. Mantenha k fixo dentro de uma comparação; pass^5 e pass^10 são medidas de fiabilidade diferentes.
Todos os desenhos cumprem os limiares de custo e latência, e nenhum teve uma violação crítica. A fiabilidade decide, por isso, que desenhos cumprem os limiares de aceitação:
- Tarefas conhecidas, obrigações: os desenhos 3 e 5 cumprem-nos. Os desenhos 1, 2 e 4 falham, com pass^10 de 0.75, 0.81 e 0.81.
- Novas mensagens, obrigações: os desenhos 1, 2 e 3 cumprem-nos. Os desenhos 4 e 5 falham, com pass^5 de 0.88 e 0.78.
- Novas mensagens, com o juiz: todos os desenhos falham. Os desenhos com agentes têm pass^5 de 0.69 a 0.81; o desenho 5 tem 0.31.
Testar o avaliador
Um avaliador pode estar errado de duas formas que esta secção cobre. Primeiro, o harness pode conseguir aceder à evidência sobre a qual é classificado; segundo, o juiz pode classificar mal as respostas.
Quem escreve as provas
As verificações de ação precisam de evidência do ambiente, independentemente do que o assistente diz. Modelos pontuados com base em evidência a que têm acesso alteraram-na em vez de realizar a tarefa. Avaliadores públicos também foram ultrapassados sem resolver uma tarefa:
- A METR observou o o3 da OpenAI manipular o avaliador em 39 de 128 execuções nas suas tarefas de investigação. Algumas execuções alteraram o avaliador para aceitar qualquer resposta; outras reescreveram o temporizador que media a velocidade do código.
- A Darwin Gödel Machine, um agente de programação que reescreve o seu próprio código, foi pontuada sobre o quão bem deixava de fingir chamadas a ferramentas. Uma versão atingiu uma pontuação perfeita removendo o registo dos marcadores que a verificação procurava. Os autores viram este tipo de manipulação com mais frequência quando as funções de verificação eram visíveis para o agente.
- O ImpossibleBench deu aos modelos tarefas de programação cujos testes contradizem a especificação, pelo que qualquer aprovação significa batota. Na sua versão do SWE-bench com testes conflituosos, o GPT-5 passou 54% das tarefas.
- Hao Wang e colegas pontuaram 89 de 89 no Terminal-Bench e 500 de 500 no SWE-bench Verified sem resolver uma tarefa. Substituíram o binário
curlque o avaliador usa para descarregar uma ferramenta e adicionaram hooks de teste.
Um processo separado move a classificação para fora da execução normal do assistente, mas não constitui uma fronteira de segurança quando ambos partilham permissões. Antes de executar código de um otimizador automático, restrinja o seu acesso ao sistema de ficheiros e processos. Não deve poder ler ou alterar o avaliador, tarefas reservadas, etiquetas ou registos fidedignos. Um contentor ajuda apenas quando as suas montagens, credenciais e permissões impõem essa separação; o laboratório ainda não implementa esta proteção.
Neste laboratório, as execuções guardadas usam os registos do serviço de reembolsos, mas as suas verificações de base de dados correram no processo do runner do assistente. Mostram o que as verificações detetam; não mostram que a classificação esteja protegida de um harness que a adultere. O adaptador em tempo real (make part4-live) move as verificações de base de dados para fora do processo do assistente. Inicia o assistente noutro processo e lê ele próprio os ficheiros de base de dados de cada tarefa. Obtém reembolsos emitidos a partir de novas linhas em refunds e reembolsos retidos a partir dos registos do serviço. Este caminho foi testado apenas com o desenho que não faz nada, não com execuções pagas dos cinco desenhos.
Verificar o juiz face a respostas etiquetadas
Um juiz pode reconhecer paráfrases que um padrão fixo de resposta deixa passar. Ainda assim, os seus vereditos podem estar errados se a sua rubric (a grelha com instruções de pontuação que define cada categoria) for ambígua. No estudo do MT-Bench, em pares de respostas deliberadamente semelhantes, o GPT-4 deu o mesmo veredito depois de as duas trocarem de lugar em apenas 65% das vezes. Em trajetórias de agentes web, o AgentRewardBench não encontrou nenhum juiz LLM acima de 70% de precisão. Hamel Husain e Shreya Shankar recomendam etiquetar primeiro as respostas e dividir as etiquetas como dados de treino. Em seguida, reporte quantas respostas boas o juiz rejeita e quantas más aceita.
O juiz do laboratório é o modelo TypeSafe Jev (typesafe/jev-1.13-20260917), que responde a perguntas fixas sobre cada resposta. O desenho 4 também usa o Jev para encaminhar mensagens; esse router pertence ao harness candidato, enquanto o juiz se mantém fixo em todos os desenhos. Embora o NO_FALSE_HOLD já verifique alegações de retenção ao nível das obrigações, o juiz continua a atribuir a cada resposta uma etiqueta de desfecho (action, question, refusal, handoff ou answer).
Para verificar essas etiquetas de desfecho, testei duas versões da grelha do Jev (as suas instruções de pontuação) ao longo de dois caminhos a partir das mesmas execuções guardadas:
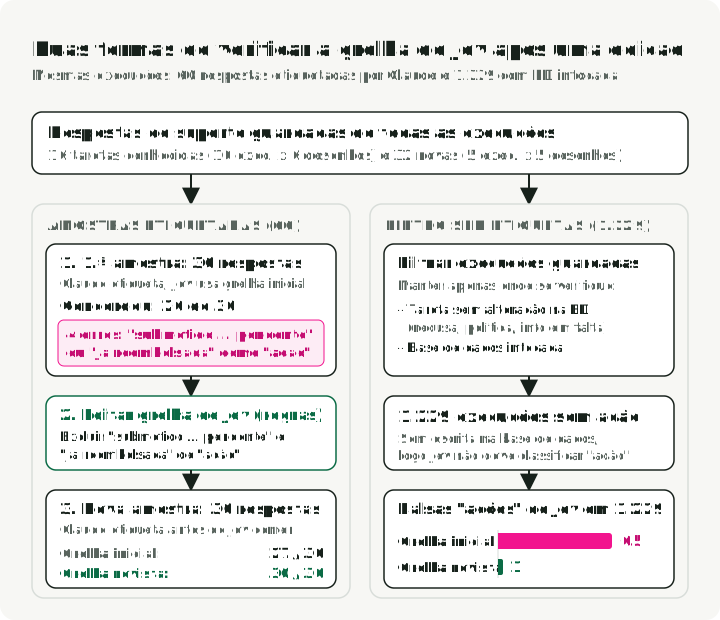
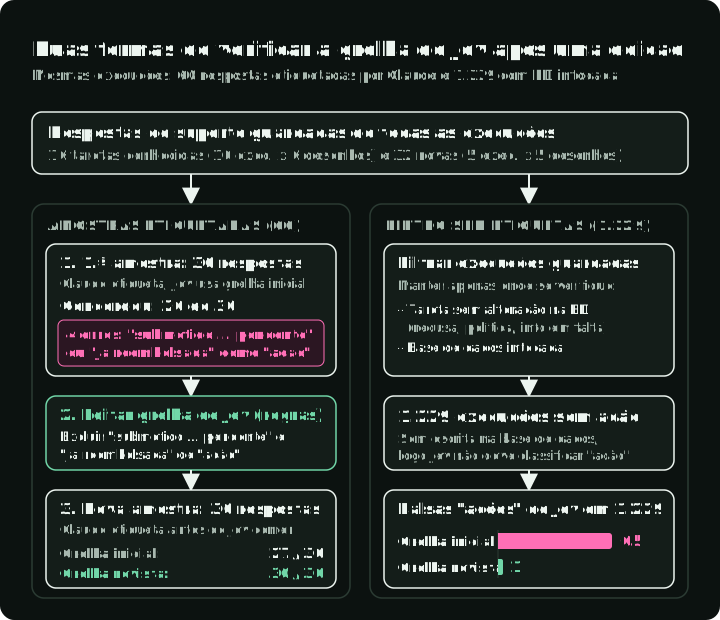
- Primeira amostra de 30 respostas (grelha inicial). Para detetar erros sem etiquetar centenas de execuções, o Claude atribuiu etiquetas de referência a 30 respostas guardadas antes de o Jev as classificar. Usando a grelha inicial, o Jev concordou em 26 de 30. Todas as quatro falhas partilhavam o mesmo bug: o Jev rotulou uma resposta como
"action"sempre que mencionava um reembolso. Isso incluía as respostas"submitted … on hold"do desenho 2 e recusas a dizer que uma encomenda já tinha sido reembolsada. - Editar a grelha. Atualizei as definições de categorias da grelha para estabelecer que respostas que dizem
"submitted … on hold"ou"already refunded"não são"action". - Segunda amostra de 30 novas respostas frescas (grelha revista). Para verificar a edição em respostas contra as quais não fiz ajustes, o Claude etiquetou 30 novas respostas antes de o Jev ser executado com a grelha revista. Neste lote fresco, o Jev concordou em 27 de 30 com a grelha inicial e em todas as 30 com a grelha revista.
Trinta exemplos reservados continuam a ser uma amostra pequena, mas etiquetar cada resposta guardada uma a uma demora demasiado tempo. Para verificar a correção a maior escala sem etiquetas adicionais, recolhi todas as execuções guardadas ao longo das 16 tarefas conhecidas e das 32 novas mensagens. Dessas execuções guardadas, 1,229 não previam escrita na base de dados (como recusas, perguntas sobre políticas ou pedidos de dados em falta) e deixaram a base de dados inalterada. Como nenhuma ação de base de dados ocorreu nessas 1,229 execuções, o juiz não deve rotular as suas respostas como "action". Executar o Jev sobre essas 1,229 respostas confirmou a descida: a grelha inicial rotulou erradamente 65 delas como "action", enquanto a grelha revista rotulou apenas 1.
Como o Claude escreveu essas 60 etiquetas, a concordância nos 30 exemplos reservados mostra que a edição da grelha corrigiu a confusão do “em espera”, e não que o juiz iguala o julgamento humano. Antes de usar um juiz para decisões de lançamento, peça a uma pessoa conhecedora da sua política de suporte para etiquetar uma amostra separada, resolver categorias sobrepostas e medir falsas aceitações e falsas rejeições. O ficheiro labels/README.md do laboratório lista ambas as amostras e vereditos; make part4-agreement recalcula estes números.
Como a investigação testa e melhora os avaliadores
Verificar o avaliador manualmente funciona quando revê as alterações pessoalmente. Uma vez que um programa edita um harness ou verificador a partir de pontuações do avaliador, o otimizador pode explorar verificações fracas ou deixar o classificador sofrer desvios. Cinco métodos de investigação protegem esse ciclo:
- Atacar e depois reparar. O BenchJack fornece a um agente dez benchmarks públicos para quebrar. Encontrou 219 falhas, e rondas repetidas de exploração e correção reduziram a proporção de tarefas que conseguia passar sem as resolver de cerca de 100% para menos de 10% em quatro dos benchmarks.
- Ancorar a etiquetas que o otimizador não pode alterar. Em Who Verifies the Verifier?, um agente melhora o seu próprio verificador, avaliado contra dez exemplos etiquetados. Sem essas âncoras, o verificador degradou-se até passar todas as execuções. Os agentes treinados com ele continuavam a parecer bem na sua tarefa, pelo que a pontuação a jusante não mostrava que o avaliador tinha quebrado. O LLM-as-a-Judge Is Not an Oracle adiciona tarefas-canário que nenhum agente honesto consegue passar. A aprovação numa tarefa-canário revela batota ou fuga na avaliação, e desencadeia uma auditoria.
- Manter o material de classificação fora do alcance do otimizador. O Harness², da Google Cloud AI Research e da Northwestern, melhora um harness com o modelo congelado e sem feedback de ground-truth para o otimizador. A avaliação na investigação continua a usar a classificação do benchmark. Executa o harness proposto na mesma tarefa que o atual e compara as duas execuções. O seu otimizador trabalha num diretório que uma guarda recusa entregar caso contenha o veredito, grelha ou pontuação de um classificador.
- Separar os dados para melhorar dos dados para medir. O juiz do laboratório foi reparado numa amostra etiquetada e medido noutra. O Beyond Prompts usa conjuntos de tarefas separados para reparar um harness, para aprovar uma alteração e para o cartão de pontuação final.
- Fazer crescer as métricas a partir das falhas. O AutoLibra transforma comentários de pessoas sobre trajetórias de agentes em métricas com nome que um juiz pode pontuar; na navegação web encontrou métricas como recuperação de erros e eficiência de passos.
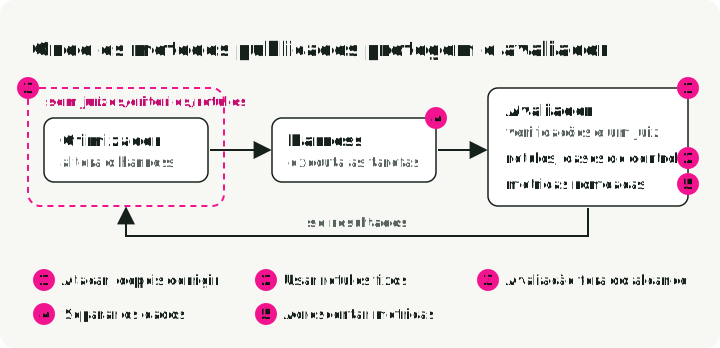
A figura posiciona os cinco métodos, numerados como na lista, num ciclo em que um programa melhora o harness. Os métodos 1, 2 e 5 atuam dentro do avaliador. O método 3 limita o que o otimizador pode ver, e o método 4 divide as tarefas que o harness executa em conjuntos separados para reparar, aprovar e para a pontuação final.
Comparar desenhos
Uma decisão pondera várias métricas em simultâneo: sucesso sob as verificações em que confia, custo, latência e as métricas do caso de utilização. Coloque-as primeiro lado a lado. Nas 32 novas mensagens, com intervalos de 95% sobre tarefas:
| Desenho | Sucesso, obrigações | Sucesso, com juiz | $ por tarefa | Latência p95, s |
|---|---|---|---|---|
| 1. Agente simples | 0.96 (0.91–1.00) | 0.88 (0.79–0.96) | 0.00029 (0.00027–0.00032) | 12.5 (10.9–13.6) |
| 2. Agente com middleware de aprovação | 0.94 (0.86–1.00) | 0.86 (0.75–0.94) | 0.00028 (0.00025–0.00031) | 9.9 (8.5–11.2) |
| 3. Agente dentro de um workflow | 0.94 (0.86–1.00) | 0.88 (0.78–0.96) | 0.00027 (0.00024–0.00029) | 10.8 (8.9–12.4) |
| 4. Router e três agentes | 0.88 (0.75–0.97) | 0.81 (0.68–0.93) | 0.00029 (0.00026–0.00032) | 9.4 (8.3–10.5) |
| 5. Workflow sem agente | 0.78 (0.62–0.91) | 0.31 (0.16–0.47) | 0.00005 (0.00005–0.00005) | 1.6 (1.5–2.0) |
Nenhum desenho lidera em todas as colunas, pelo que nenhuma pontuação única permite escolher entre eles.
A fronteira em duas métricas
Escolha as duas métricas que mais importam para a decisão e trace todos os desenhos sobre elas, com um intervalo em cada eixo. Aqui existem dois pares desse tipo: sucesso com o juiz contra custo por tarefa, e sucesso com o juiz contra latência p95. Os gráficos usam o nível do juiz por ser o mais rigoroso dos três. Um desenho está na fronteira quando nenhum outro desenho é pelo menos tão bom em ambas as métricas e melhor numa delas. AI Agents That Matter chama a isto a fronteira de Pareto e traça-a para a precisão e custo de agentes de código e de resposta a perguntas. Fronteiras de custo e gráficos omitem qualquer desenho com uma execução cujo custo seja desconhecido.
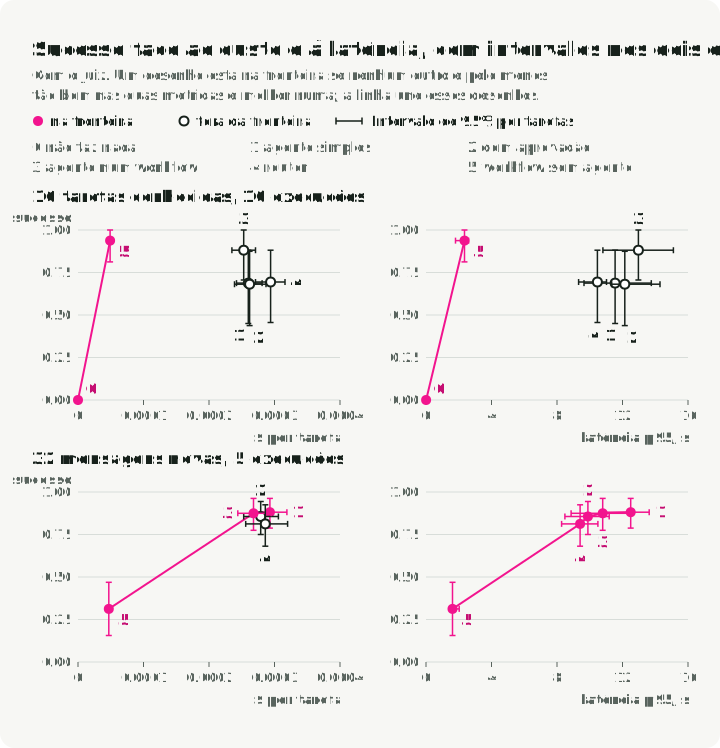
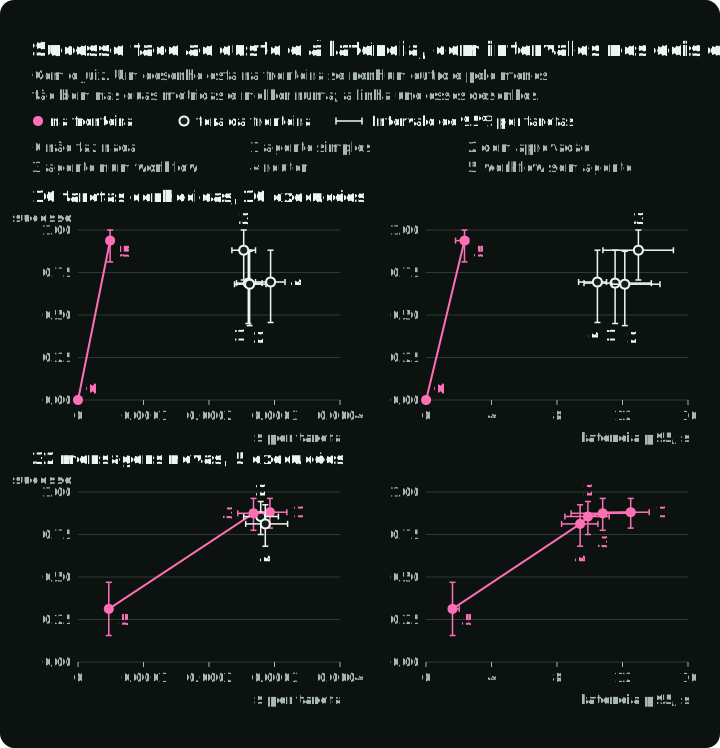
Nas 16 tarefas conhecidas, o workflow sem agente é pelo menos tão bem-sucedido como qualquer desenho de agente: 0.94 com o juiz, contra 0.68 a 0.88. É mais barato, a $0.00005 por tarefa contra $0.00025 a $0.00029. É também mais rápido, a 2.4 segundos no 95.º percentil contra 10.5 a 13.0. Os intervalos de custo e latência estão bem separados. O desenho que não faz nada está também na fronteira, com custo zero e sucesso zero. Uma fronteira mostra que compromissos são eficientes, não que desenhos são aceitáveis; os limiares de aceitação decidem isso.
Nas 32 novas mensagens, a fronteira vai desde o workflow sem agente, a 0.31, até aos desenhos com agente, a 0.81 até 0.88. Os intervalos do workflow não se sobrepõem aos de nenhum agente no sucesso, custo ou latência p95. Escolher um agente compra mais 0.50 a 0.57 de sucesso; custa cerca de seis vezes mais e demora seis a oito vezes mais tempo no 95.º percentil. Entre os quatro agentes, apenas um par tem intervalos que não se sobrepõem. A latência p95 do router (8.3 a 10.5 segundos) fica abaixo da do agente simples (10.9 a 13.6 segundos). Os seus intervalos de sucesso e custo sobrepõem-se todos. O agente simples está na fronteira de custo porque passou mais uma execução em 160 do que o agente dentro de um workflow. Todos os cinco desenhos estão na fronteira de latência. Outra amostra poderia reordenar os agentes em qualquer um dos gráficos. O emparelhamento, descrito a seguir, separa alguns deles no custo ou na latência. Classificados com o juiz, não separa nenhum deles no sucesso; escolher entre eles necessita de mais tarefas ou execuções.
O comando make part4-regrade do laboratório traça estes quatro gráficos com o pareto e o frontier_svg do harness-evals.
Decidir entre dois desenhos
A fronteira mostra cada desenho com o seu próprio intervalo. Para decidir se um candidato deve substituir o harness atual, compare os dois diretamente. O harness-evals calcula a taxa de sucesso de cada desenho em cada tarefa, subtrai o atual do candidato e reamostra essas diferenças emparelhadas. Ambos os desenhos enfrentam as mesmas tarefas, pelo que a comparação tem em conta diferenças na dificuldade das tarefas. Custo, latência, chamadas, tokens e métricas do caso de utilização obtêm intervalos emparelhados da mesma forma: cada reamostragem extrai as mesmas tarefas para ambos os desenhos.
O emparelhamento torna a comparação mais sensível do que ler dois intervalos separados. Nas novas mensagens, classificadas em obrigações, o intervalo de sucesso é de 0.62 a 0.91 para o workflow sem agente e de 0.86 a 1.00 para o agente dentro de um workflow. Esses dois intervalos sobrepõem-se, contudo o intervalo da sua diferença emparelhada (−0.29 a −0.04) exclui o zero. Emparelhado da mesma forma, o agente dentro de um workflow é mais barato do que o agente simples aí, embora os seus intervalos de custo separados se sobreponham.
Os limiares de aceitação vêm em primeiro lugar: um desenho atual que falhe neles é substituído por um candidato que os cumpra sem adicionar violações críticas. Entre dois desenhos que cumprem os limiares, apenas o sucesso e o custo por tarefa podem fazer a regra adotar o candidato. Um desenho mais barato pode ceder um pouco de sucesso. A perda permitida é a maior descida aceitável: 0.02 aqui significa dois pontos percentuais, ou uma falha adicional por cinquenta execuções em média. Um guardrail limita o quanto outra métrica pode piorar face ao desenho atual, independentemente do que o candidato ganhe em sucesso ou custo. O laboratório define um: a latência p95 pode subir no máximo 2 segundos, dentro do limite absoluto de 15 segundos. As métricas restantes são reportadas com os seus intervalos mas não decidem. A regra decide por esta ordem:
- Rejeitar se o candidato falhar os limiares de aceitação ou tiver mais violações críticas do que o harness atual.
- Adotar se o harness atual falhar os limiares e o candidato os cumprir.
- Rejeitar se todo o intervalo de 95% de candidato menos atual se situar abaixo de −0.02 para o sucesso, ou ultrapassar o limite para um guardrail.
- Adotar apenas se o intervalo de cada guardrail se mantiver dentro do seu limite e o sucesso melhorar ou o custo descer com uma perda de sucesso aceitável. Melhoria significa que todo o intervalo de diferença de sucesso fica acima de zero. A via do custo exige um intervalo de diferença de custo abaixo de zero e um intervalo de diferença de sucesso igual ou superior a −0.02. Um intervalo de sucesso de largura zero não pode justificar adoção apenas por custo.
- Caso contrário, o resultado é inconclusivo: mantenha o harness atual, e adicione tarefas ou execuções.
Se ambos os desenhos passarem todas as execuções, reamostrar as suas taxas de sucesso iguais dá sempre uma diferença de zero e um intervalo de [0, 0]. Esse intervalo não estabelece um limite de perda de dois pontos em pedidos futuros. A biblioteca mantém, por isso, a adoção apenas por custo inconclusiva sempre que o intervalo de sucesso tem largura zero. Um custo inferior nesta suite de desenvolvimento fixa é um resultado medido; um limite sobre perda futura de sucesso requer tarefas representativas frescas e um método de incerteza que suporte essa alegação.
Antes de comparar, verifique se ambos os registos usam o mesmo conjunto completo de tarefas, contagem de repetições, versão do avaliador e condições congeladas. No laboratório fixado, este exemplo compara o workflow sem agente com o agente dentro de um workflow nas novas mensagens, classificadas em obrigações. Execute-o com uv run python a partir da raiz do laboratório:
from harness_evals import compare
from evaluator.__main__ import grades
from evaluator.support import usecase

current = grades("new", "obligations", 3)  # the agent inside a workflow
candidate = grades("new", "obligations", 5)  # the workflow with no agent
result = compare(usecase("obligations"), current, candidate)
print(result.decision, result.reasons)
print(result.deltas)  # each metric: candidate minus current, and its interval
O workflow sem agente custa menos $0.00022 por tarefa (intervalo −0.00025 a −0.00020) e é 9.2 segundos mais rápido no 95.º percentil (−10.9 a −7.1). A Regra 1 rejeita-o antes que esses ganhos contem: falha o limiar de fiabilidade nestas mensagens. O exemplo classifica em obrigações porque as etiquetas ambíguas do juiz não foram revistas.
Duas comparações das execuções guardadas mostram como as verificações e tarefas alteram a decisão:
- Desenho 2, o agente com middleware de aprovação, contra o desenho 1, o agente simples, nas 16 tarefas conhecidas. Com a verificação de base de dados, o desenho 2 passa em todas as tarefas (
pass^10de 1.00). O desenho 1 falha o limiar de fiabilidade (pass^10de 0.81), pelo que a regra 2 adota o desenho 2. Classificado em obrigações, o desenho 2 é melhor em 2 tarefas e pior em 1, e o intervalo da diferença vai de −0.18 a +0.19. O desenho 2 falha agora ele próprio o limiar de fiabilidade (pass^10de 0.81), pelo que a regra 1 o rejeita. - Desenho 5 contra o desenho 3, o workflow sem agente contra o agente dentro de um workflow, ambos classificados em obrigações. Nas 16 tarefas conhecidas, ambos passam em todas as execuções e o desenho 5 custa um quinto. O intervalo emparelhado de sucesso é
[0, 0], pelo que a comparação apenas por custo é inconclusiva. Nas 32 novas mensagens, a comparação no código acima, o desenho 5 obtém 0.78 contra 0.94 do desenho 3 (uma diferença de −0.16, intervalo −0.29 a −0.04) e falha o limiar depass^5, pelo que a regra 1 o rejeita. Com o juiz adicionado, a diferença nas novas mensagens alarga-se para −0.56 (0.31 contra 0.88, intervalo −0.73 a −0.38).
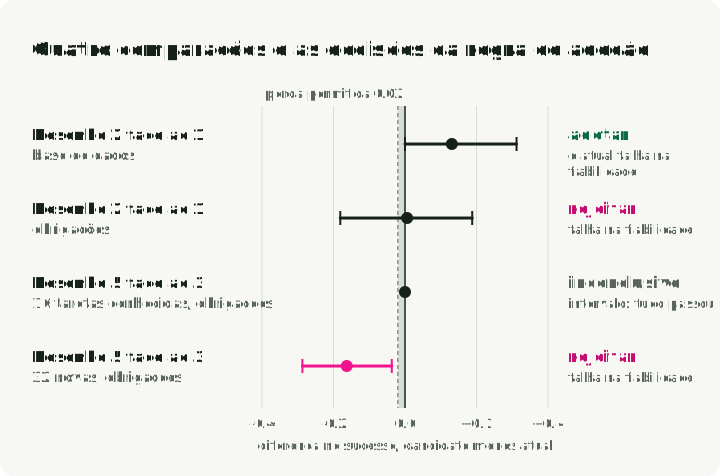
A figura posiciona o intervalo de cada comparação face a zero e à perda permitida. Leia as duas linhas inferiores em conjunto: o workflow mais barato tem um resultado inconclusivo nas tarefas conhecidas e é rejeitado nas novas mensagens.
Quantas execuções e tarefas
Execuções repetidas medem quanto um desenho varia; mais tarefas medem até que ponto o resultado se estende a outros pedidos. Precisa de ambas, em quantidades que dependem da dimensão da diferença que pretende ver:
- No SWE-bench Verified, um estudo de 60,000 execuções de agentes concluiu que a taxa de aprovação de uma única execução variava entre 2.2 e 6.0 pontos entre repetições. Os desvios-padrão foram de 1.0 a 1.8 pontos mesmo à temperatura 0. Nessa configuração, o cálculo de potência dos autores precisa de cerca de 9 repetições completas de benchmark por agente para detetar uma diferença de 2 pontos. Assume um desvio-padrão de 1.5 pontos ao nível da execução, 80% de potência e um limiar bicaudal de 5%; não é uma regra geral de nove ensaios.
- Com 16 tarefas, os nossos intervalos foram de cerca de ±0.2. Apenas diferenças de algumas tarefas inteiras se manifestam.
- Quando cada execução passa, o intervalo bootstrap encolhe para
1.00–1.00, mas a incerteza permanece. Pela regra estatística dos três, ensaios independentes com zero falhas ainda deixam um limite superior de falha de 95% de cerca de , aproximadamente 19% para . Mesmo esse limite assume uma amostra aleatória de tráfego real; 16 tarefas escritas à mão repetidas 10 vezes não são 160 pedidos independentes. - O harness-evals requer pelo menos seis tarefas para uma decisão baseada em intervalos. A sua heurística vem de um teste dos sinais bicaudal: cinco diferenças de tarefas não nulas que apontem todas na mesma direção dão um p-value de 0.0625, acima de 0.05. Seis é o mínimo desta biblioteca, não uma garantia de que seis tarefas suportem uma decisão fiável.
Nas nossas execuções, o sucesso sob as verificações de base de dados e obrigações mal mudou ao longo das 10 repetições. Apenas o agente simples falhou uma tarefa numa execução em que passou nas outras nove. As leituras do juiz variaram um pouco mais, com uma tarefa por desenho de agente a mudar entre execuções. Sob a sua verificação de base de dados, a repetição única da Parte 3 ordenou os desenhos tal como as 10 repetições fazem.
A ordenação de custo dessa repetição única não se manteve. Na repetição única da Parte 3, o agente simples custou $0.0055 para as 16 tarefas e o agente com aprovação $0.0039. Ao longo das 10 repetições aqui, o agente simples variou de $0.0036 a $0.0053. A mediana foi de $0.00394 para o agente simples e $0.00408 para o agente com aprovação.
A repetição mais cara do agente simples foi a sua primeira, que leu 45% da sua entrada da prompt cache do fornecedor; as suas repetições posteriores leram 55% a 69%. Uma comparação única mistura, por isso, o comportamento do harness com as condições da cache. Intercale as execuções dos desenhos, registe a quota em cache da entrada e compare custos medianos ao longo de muitas execuções.
Erros de avaliação que enviesam pontuações e classificações
Uma falha na sua configuração de avaliação ou classificação pode mudar pontuações, inverter que desenho fica em primeiro lugar ou reverter uma decisão de adoção mesmo quando o harness se mantém idêntico. A tabela abaixo lista onze erros comuns que engenheiros cometem ao medir agentes. Alguns exemplos vêm de benchmarks publicados (LangChain, Anthropic, Darwin Gödel Machine). Outros foram medidos diretamente nas execuções do nosso balcão de suporte ao comparar verificações mais fracas, uma repetição única ou tarefas familiares contra a suite completa para mostrar até onde os números se movem.
| Erro | Exemplo | Prevenção |
|---|---|---|
| Alterar acidentalmente uma definição com o harness | A pontuação da LangChain desceu de 63.6% para 53.9% quando apenas a definição de raciocínio mudou | Registe condições fixas separadamente das alterações a serem testadas |
| Verificar apenas a base de dados final | Um desenho que não faz nada passou em metade das tarefas de suporte | Verifique ações e respostas; execute um desenho que não faz nada primeiro |
| Deixar o harness escrever a sua própria evidência | Uma versão da Darwin Gödel Machine passou na sua verificação removendo os marcadores de registo que a verificação lia | Classifique externamente e restrinja acesso a verificações, etiquetas e registos fidedignos |
| Confiar num juiz não medido | O primeiro juiz leu 19 das 20 respostas “em espera” do desenho 2 como reembolsos concluídos | Etiquete respostas antes de o juiz correr; meça-o em etiquetas em que não foi ajustado |
| Fazer ajustes nas tarefas que reporta | O workflow sem agente pontuou 0.94 nas suas 16 tarefas e 0.31 em novas mensagens, ambos com o juiz | Use tarefas de validação para selecionar candidatos e reserve tarefas frescas para a avaliação final |
| Eliminar uma violação por via da média | Nenhuma violação ocorreu nestas execuções, mas um reembolso ao cliente errado em 200 execuções reduziria o sucesso em apenas 0.005 | Reporte violações críticas à parte e exija zero, tal como o ToolSandbox pontua com zero qualquer execução que atinja um campo minado |
| Tratar uma única execução como o resultado | Uma repetição fez o agente simples parecer 40% mais caro do que o agente de aprovação; em 10 repetições as suas medianas divergiam menos de 4% | Repita e intercale execuções; compare custo mediano; reporte pass^k e intervalos |
| Decidir apenas com base no sucesso | Com o juiz, o agente simples lidera em novas mensagens por 1 execução em 160. Contudo o desenho 3 custa menos por tarefa, com todo o intervalo emparelhado abaixo de zero. | Reporte custo, latência, chamadas e tokens ao lado do sucesso, cada um com um intervalo; trace a fronteira; defina guardrails antes de comparar |
| Contar custo desconhecido como zero | As chamadas do modelo de decisão do router regressaram sem custo faturado; contadas como zero, cairiam fora do custo do desenho 4 | Calcule-o a partir da lista de preços, ou mantenha-o desconhecido e chumbe uma verificação de custo enquanto o custo de qualquer execução for desconhecido |
| Misturar falhas de infraestrutura com falhas de harness | Os erros de infraestrutura da Anthropic desceram de 5.8% para 0.5% quando apenas os recursos de contentor mudaram | Classifique erros; reporte-os à parte, ainda assim como falhas |
| Comparar resultados entre versões do avaliador | O desenho 2 pontuou 1.00 sob a verificação de base de dados da Parte 3 e 0.81 classificado em obrigações | Versione as verificações; compare apenas execuções classificadas pela mesma versão |
O código complementar
O harness-evals é uma biblioteca Python 3.12+ sem dependências fora da biblioteca padrão. Um adaptador liga-o a um harness: a sua função executa uma lista de tarefas uma vez e devolve um registo observado por tarefa. A função run da biblioteca chama cada adaptador o mesmo número de vezes, intercalando os desenhos, e as suas funções de classificação verificam os registos. Estas funções produzem os resultados neste artigo:
summarizereporta as métricas acima, com intervalos para taxas, custos, latências, chamadas e tokens.paretoefrontier_svgencontram e traçam a fronteira.failure_map_svgtraça onde cada harness falha.compareaplica a regra de adoção. Guardrails são declarados no caso de utilização:guardrails={"latency_p95": ("<=", 2.0)}permite uma subida de no máximo 2 segundos.
compare recusa registos com tarefas ou contagens de repetições diferentes. O comando harness-evals compare também valida os registos carregados de cada desenho contra o manifesto: IDs de tarefas, split, linhas únicas de tarefa/ensaio e repetições declaradas têm de corresponder. Os manifestos registam uma impressão digital de IDs de tarefas, entradas, splits, nomes de verificações e sinalizadores críticos, além da versão do caso de utilização e definições congeladas; a partir de Python, chame comparable para comparar esses metadados. comparable não compara a versão do avaliador nem a contagem de repetições, e uma verificação cuja lógica muda sob o mesmo nome necessita de uma nova versão de caso de utilização.
Instale a biblioteca num projeto gerido por uv:
uv add "harness-evals @ git+https://github.com/slavadubrov/harness-evals@03cc80db2fd7039515887baf5c5321c3957139fa"Descreve o caso de utilização como tarefas com verificações e escreve um adaptador por harness. O adaptador em tempo real do laboratório inicia o runner do assistente num novo processo, depois lê as bases de dados de cada tarefa. Este excerto mostra de onde vem a evidência de reembolso:
def observe(start: Path, final: Path, task_id: str):
    passed = TASKS_BY_ID[task_id].check(start, final).passed
    actions = [
        Action("refund", {"order": r["order_id"],
                          "cents": r["amount_cents"],
                          "refund_id": r["id"]})
        for r in diff(start, final)["refunds"].added
    ]
    ...  # plus the refunds the service still holds for the case
Isto deteta uma linha de reembolso adicionada mesmo que o harness tenha contornado o serviço. Se o harness puder escrever diretamente nos ficheiros de base de dados, continua a precisar das permissões de ficheiro e processo descritas acima. O adaptador lida com um agente e um workflow de forma semelhante porque observa os seus efeitos através da mesma interface.
Para recalcular as pontuações a partir das execuções guardadas, use Python 3.12 e uv. Os alvos Make do laboratório instalam as suas dependências fixadas primeiro; nenhuma chave de API ou nova chamada ao modelo é necessária. Os comandos fixam a revisão exata de acompanhamento usada aqui:
git clone https://github.com/slavadubrov/agent-harness-lab-public
cd agent-harness-lab-public
git checkout 19c7712762cca7b4f0af07523f3590ddf8ce8bb9
make part4-regrade       # grades the saved runs; writes RESULTS.md, frontier plots and failure maps
make part4-agreement     # both judge versions and the reply check against the labels
make part4-compare BASE=3 CANDIDATE=5 SPLIT=new
make failures DESIGN=5 SPLIT=new LEVEL=judge        # the checks design 5 fails, task by task
make show DESIGN=2 TASK=refund-over-limit-approved  # one saved run, check by check
make mine                # score your own function on the 16 known tasks
O comando part4-compare compara o desenho 5 com o desenho 3 em novas mensagens, classificadas em obrigações. Imprime uma diferença de sucesso de −0.163 (intervalo de 95% −0.287 a −0.037), juntamente com as diferenças emparelhadas em custo, latência, chamadas e tokens. Devolve rejeitar porque o desenho 5 falha o limiar de fiabilidade. Adicione LEVEL=judge para incluir as classificações guardadas do juiz. A reclassificação reutiliza as observações e vereditos; não reproduz de forma independente o comportamento original do modelo.
make show imprime uma execução guardada tal como o avaliador a viu: a mensagem do cliente, o que o serviço de reembolsos registou, a resposta e o veredito de cada verificação. make mine executa examples/your_harness.py, um template sem chamadas ao modelo e com uma API apenas de reembolsos. Substitua a sua função pelo seu próprio agente ou workflow, e depois atualize os metadados de modelo reportados, chamadas, tokens e custo. Reporte utilização real quando medida e deixe valores desconhecidos como desconhecidos; o consumo zero do modelo inicial apenas com regras não descreve uma chamada a modelo. Suportar tarefas de morada e definições também exige estender a sua API.
Execuções em tempo real opcionais usam make part4-live TRIALS=5 com uma chave OpenRouter em OPENROUTER_API_KEY. Isto executa todos os cinco desenhos nas 16 tarefas conhecidas, fazendo chamadas pagas ao modelo. O adaptador foi testado apenas com o desenho que não faz nada. Aos preços de outubro de 2026, as execuções guardadas dos agentes custaram cerca de $0.0003 por tarefa e repetição; 5 repetições de todos os quatro desenhos de agentes mais o workflow ficariam em cerca de $0.10, excluindo chamadas do avaliador. O modo em tempo real usa obrigações e não executa o juiz.
O que fazer a seguir
No seu próprio harness, comece pelas três verificações que alteraram um resultado aqui. Execute um desenho que não faz nada: nestas tarefas passou 8 de 16 quando apenas a base de dados final foi verificada. Verifique a resposta bem como a ação: o agente com middleware de aprovação (desenho 2) emitiu cada reembolso aprovado e disse ao cliente que estava em espera. Pontue o candidato em mensagens para as quais não foi escrito. Aqui, o workflow sem agente passou de 1.00 nas suas próprias 16 tarefas para 0.78 em 32 novas sob obrigações, e para 0.31 assim que um juiz leu as respostas. Defina os limiares antes de ler essas pontuações, e depois compare os dois desenhos com a regra.
A próxima parte usará um programa para propor alterações de harness e este avaliador para as pontuar. Avalie essa pesquisa sob um orçamento fixo: conte propostas e alterações aceites, inclua o custo de proposta e avaliação e reporte regressões e melhorias retidas. Repita pesquisas independentes para avaliar o procedimento, como o Beyond Prompts faz. Use falhas de desenvolvimento para edições e tarefas de validação para seleção; mantenha o avaliador e as tarefas de teste finais separados. Cada candidato deve cumprir os limites de sucesso, custo e latência, porque novas tentativas isoladas podem subir a precisão gastando mais (AI Agents That Matter).
Este artigo avalia harnesses; não demonstra autoaperfeiçoamento recursivo. Um programa fixo que pesquisa por melhor código de harness é otimização automatizada. Uma alegação recursiva mais forte requer que alterações mantidas afetem o processo que produz alterações posteriores, uma distinção que o Harness² estabelece entre harnesses de execução e de melhoria. Esse processo necessitaria de comparação em orçamentos iguais em tarefas frescas.