Trainingsziele lesen: Distillation, DPO und GRPO

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Distillation, Direct Preference Optimization (DPO) und Group Relative Policy Optimization (GRPO) verändern alle die Wahrscheinlichkeiten eines Sprachmodells, verwenden aber unterschiedliche Trainingsbeispiele und Rückmeldungen. Dieser Leitfaden richtet sich an Ingenieure, die diese Unterschiede verstehen möchten, bevor sie die vollständigen Zielfunktionen lesen. Die Diagramme zeigen, woher die Rückmeldungen stammen und wie sie Wahrscheinlichkeitsvergleiche verändern; die Gleichungen beschreiben die entsprechenden Rechenschritte.
Beim gewöhnlichen überwachten Fine-Tuning lernt das Model, das nächste Token in gespeicherten Beispielen vorherzusagen. Die folgenden Methoden verändern die Rückmeldung: Ein Teacher liefert Wahrscheinlichkeiten, ein Präferenzpaar gibt die bessere Antwort an, oder ein Reward bewertet Antworten, die während des Trainings gesampelt werden. Eine Policy ist einfach das Model, das Antworten erzeugt. Alle folgenden Logarithmen sind natürliche Logarithmen.
Teil 1 erklärt, wie man eine Gleichung liest, und enthält eine Notationsübersicht. Hier erklärt jeder Abschnitt die benötigten Begriffe und lässt sich unabhängig lesen.
Klassische Distillation: eine Temperatur für beide Softmax-Funktionen
Ein Trainingslabel bezeichnet das richtige Ergebnis: Bei der Vorhersage des nächsten Tokens ist es das nächste Token in einem gespeicherten Beispiel. Ein Teacher-Model liefert mehr Informationen: seine Wahrscheinlichkeiten für alle möglichen Tokens, einschließlich plausibler Alternativen. Distillation trainiert einen kleineren Student, diese Wahrscheinlichkeiten nachzubilden. Das Training verringert einen numerischen Loss, indem es die Parameter des Students verändert; die des Teachers bleiben unverändert.
Das Distillation-Paper von Hinton et al., §2, flacht die Wahrscheinlichkeitsverteilungen beider Models vor dem Vergleich ab. Dazu wird jedes Logit, der Rohwert vor Softmax, durch eine Temperatur geteilt:
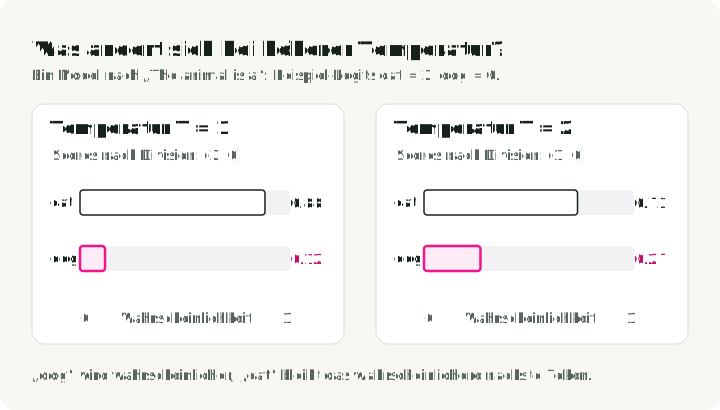
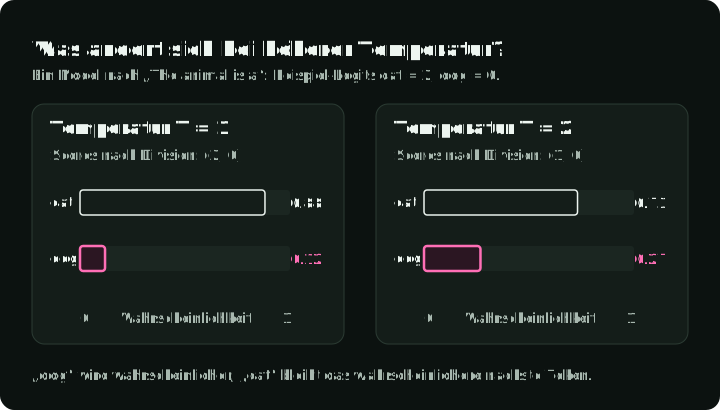
Hier ist der Score des Kandidaten und seine Wahrscheinlichkeit. Angenommen, ein einfaches Beispielmodel hat nur zwei mögliche nächste Tokens, „cat“ und „dog“, und weist ihnen nach „The animal is a“ die Scores zu. Bei betragen die Wahrscheinlichkeiten ungefähr ; bei werden daraus . Der kleinere Score trägt nun stärker zum Vergleich bei. Teacher und Student verwenden dieselbe Temperatur.
Die Balken zeigen, wie aus denselben beiden Scores mit steigender Temperatur eine weniger konzentrierte Verteilung entsteht.
Der Trainingsloss kombiniert den gewöhnlichen Label-Loss mit einem Loss zum Abgleich mit der abgeflachten Teacher-Verteilung. bezeichnet die Wahrscheinlichkeiten des Teachers und die des Students bei Temperatur . Für eine Eingabe mit Label gilt:
Hier ist der Loss, das richtige nächste Token, und bestimmt die Mischung. Hochgestellte Ausdrücke in Klammern bezeichnen Temperaturen, keine Potenzen. Der erste Term bedeutet: „Eine niedrige Wahrscheinlichkeit für das richtige Token bei bestrafen“. Der zweite bedeutet: „Die abgeflachten Wahrscheinlichkeiten des Teachers nachbilden“. Das Training mittelt diese Losses über die gespeicherten Eingaben und verändert nur den Student.
ist die KL-Divergenz vom Teacher zum Student . Sie misst, wie sich zwei Wahrscheinlichkeitsverteilungen unterscheiden: Bei Übereinstimmung ist sie null. Die erste Verteilung liefert die Gewichtungsfaktoren für den Vergleich; beim Teacher wahrscheinliche Ergebnisse erhalten somit mehr Gewicht. Hinton et al. beschreiben einen Abgleichterm mit Kreuzentropie; diese KL-Form zieht eine nur vom Teacher abhängige Konstante ab und ergibt dieselben Gradienten für den Student.
Der Faktor gleicht die kleineren Gradienten bei höheren Temperaturen näherungsweise aus. Dies ist eine Trainingseinstellung; beim Einsatz verwendet der Student für diese Softmax-Funktion normalerweise wieder .
Ein Präfix ist der Text, der vor dem nächsten Token bereits vorliegt: der Prompt und alle bisherigen Antwort-Tokens. Beispielsweise ist „The animal is a“ das Präfix vor „cat“. In der Abbildung lesen beide Models dasselbe Präfix und erzeugen Wahrscheinlichkeiten für das nächste Token. Links stammen die Präfixe aus gespeicherten Beispielen. Rechts stammen sie aus Antworten, die der Student während des Trainings erzeugt. Beide Abläufe verwenden den Vergleichsloss, um nur den Student zu aktualisieren.
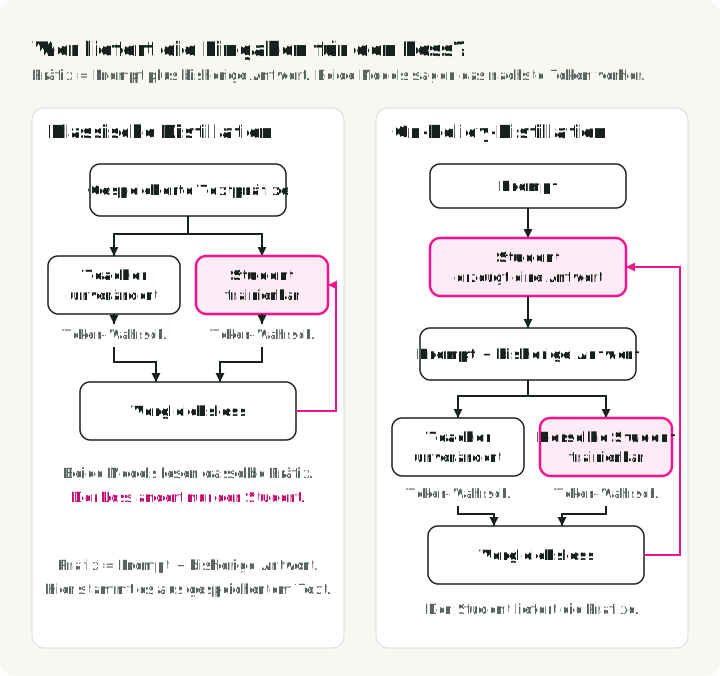
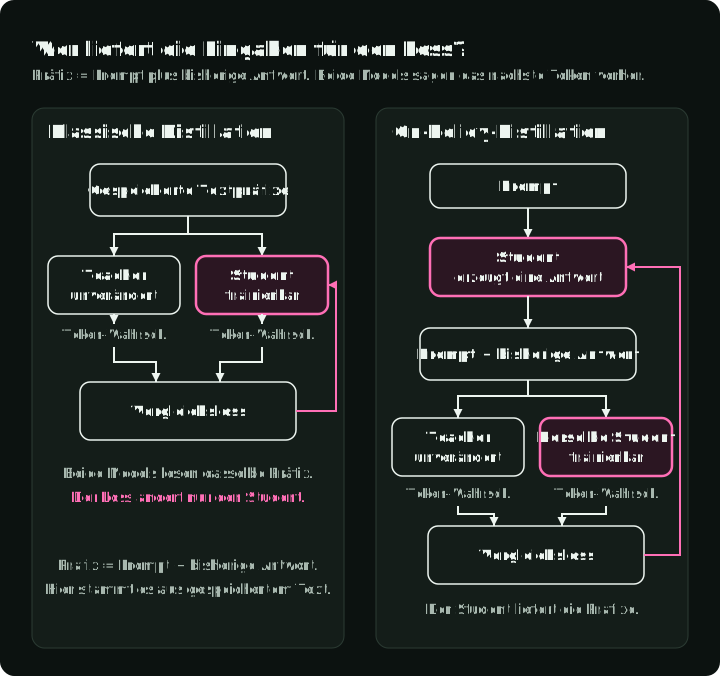
Es gibt auch Distillation ohne Wahrscheinlichkeitsabgleich. Die distillierten Models von DeepSeek-R1, §2.4, wurden mit 800.000 Beispielen feinabgestimmt, die zuvor mithilfe von DeepSeek-R1 zusammengestellt worden waren. Sie verwendeten einen überwachten Loss auf gespeichertem Text; während dieses Trainings musste kein Teacher ausgeführt werden.
Die ausführliche Distillation-Lektüre erklärt den gemischten Loss und die Temperaturskalierung.
On-Policy-Distillation: Der Student steht im KL an erster Stelle
Ein Student, der eigene Antworten erzeugt, kann Präfixe erreichen, also Prompt und bisherige Antwort, die im Trainingsdataset nie vorkamen. On-Policy-Distillation liefert Rückmeldungen zu Text, den der Student tatsächlich erzeugt. Für einen Prompt sampelt der Student eine Antwort. Ein unveränderter Teacher bewertet dann dieselben Präfixe. Das Training vergleicht die beiden Models somit dort, wo der Student Anleitung braucht.
On-Policy beschreibt diese Herkunft des Trainingstexts. Der Begriff allein schreibt keinen bestimmten Loss vor. Die Beispiele hier verwenden Reverse-KL mit dem Student an erster Stelle:
Für einen festen Prompt ist der Student mit trainierbaren Parametern , der Teacher und eine vom Student gesampelte Antwort. Der Ausdruck vergleicht die Wahrscheinlichkeit, die der Student seiner Antwort zuweist, mit der Wahrscheinlichkeit des Teachers. Über Student-Antworten gemittelt bestraft er den Student dafür, Text eine hohe Wahrscheinlichkeit zu geben, den der Teacher für unwahrscheinlich hält.
Dies unterscheidet sich von der Forderung, alle möglichen Ausgaben des Teachers abzudecken. Wenn ein kleiner Student die vollständige Verteilung des Teachers nicht nachbilden kann, kann Reverse-KL eine Konzentration auf einige wahrscheinliche Teacher-Ausgaben begünstigen. MiniLLM, §2.1, Gleichung (1), verwendet diese Zielfunktion. Das tatsächliche Trainingsverfahren mischt außerdem Teacher-Samples in die Generierung und passt den Gradienten an, um Varianz und Längenverzerrung zu verringern; das Diagramm zeigt den grundlegenden On-Policy-Aufbau, nicht alle Anpassungen von MiniLLM.
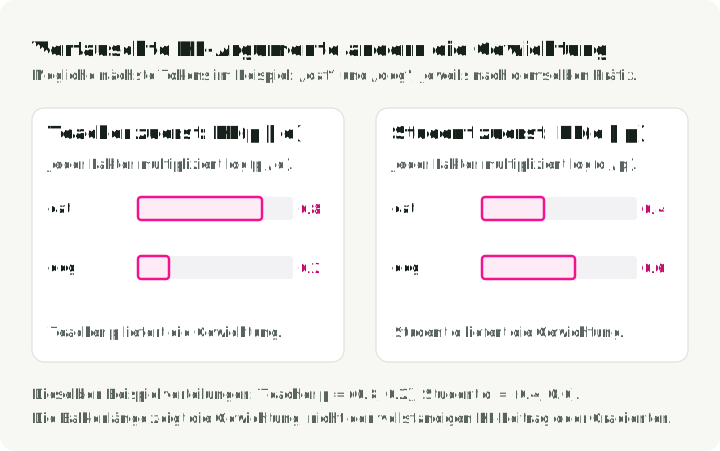
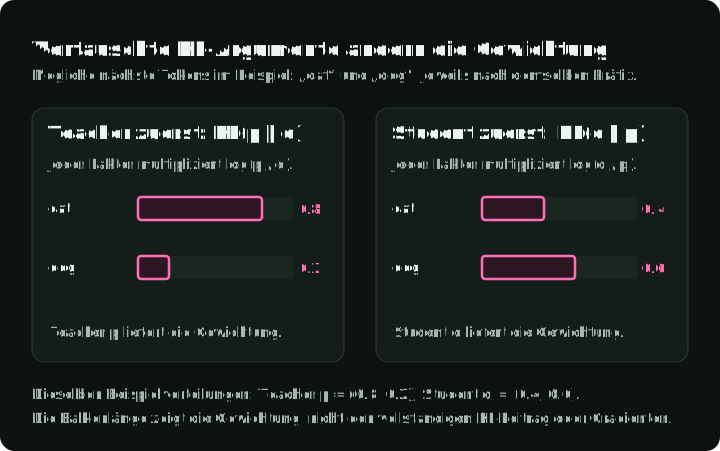
Im folgenden einfachen Beispiel weisen Teacher und Student „cat“ und „dog“ nach demselben Präfix unterschiedliche Wahrscheinlichkeiten zu. KL multipliziert das logarithmierte Verhältnis jedes Tokens mit dessen Gewichtungsfaktor und addiert die beiden Terme. Ein anderes erstes Argument verschiebt das größere Gewicht von „cat“ zu „dog“. Die Balken zeigen die Gewichtungsfaktoren, nicht die vollständigen Loss-Beiträge.
Von Sequenz-KL zu Token-KL
Die Wahrscheinlichkeit einer Antwort setzt sich aus ihren Wahrscheinlichkeiten für das jeweils nächste Token zusammen. An jedem Präfix einer Student-Antwort sagen beide Models das nächste Token vorher. Ihre Unterschiede lassen sich daher Position für Position vergleichen und dann über die Antwort aufsummieren. DeepSeek-V4, §5.1.2, Gleichung (29), verwendet Reverse-KL-Distillation von mehreren spezialisierten Teacher-Models in einen Student. Diese Teachers sind eigenständige Models, keine Experten-Teilnetze innerhalb einer Mixture-of-Experts-Schicht.
An Position sei die Wahrscheinlichkeit des Students für das mögliche Token . Das Präfix enthält den Prompt und die vorhergehenden Antwort-Tokens ; ist die Wahrscheinlichkeit des Teachers an demselben Präfix. Dann gilt:
ist das Vokabular und die Next-Token-KL an einem Präfix. Die innere Summe bedeutet: „Alle möglichen Tokens vergleichen, gewichtet mit der Wahrscheinlichkeit des Students“. Diese Vergleiche werden über die Positionen summiert und dann über die vom Student erzeugten Antworten gemittelt. Der äußere Erwartungswert sampelt weiterhin Text, auch wenn jedes das ganze Vokabular aufsummiert.
Ein gesampeltes Token oder das gesamte Vokabular
Der Teacher kann nur das vom Student gewählte Token bewerten oder Wahrscheinlichkeiten für das gesamte Vokabular liefern. Die erste Option überträgt weniger Informationen; die zweite vergleicht alle möglichen nächsten Tokens an diesem Präfix. DeepSeek-V4 berichtet von instabilem Training mit seiner Ein-Token-Schätzung und verwendet den Vergleich über das ganze Vokabular. Dadurch wird der Token-Vergleich an einem gegebenen Präfix exakt; die Präfixe stammen weiterhin aus gesampelten Antworten.
Beide Models lesen „The animal is a“ und liefern die unten gezeigten Wahrscheinlichkeiten. Die hervorgehobenen Zeilen gehen in den Loss ein, mit dem der Student aktualisiert wird. Die Variante mit vollständigem Vokabular umfasst „dog“ und „fox“, obwohl der Student „cat“ gewählt hat; die Ein-Token-Variante schätzt diesen Vergleich allein anhand des gewählten Tokens.
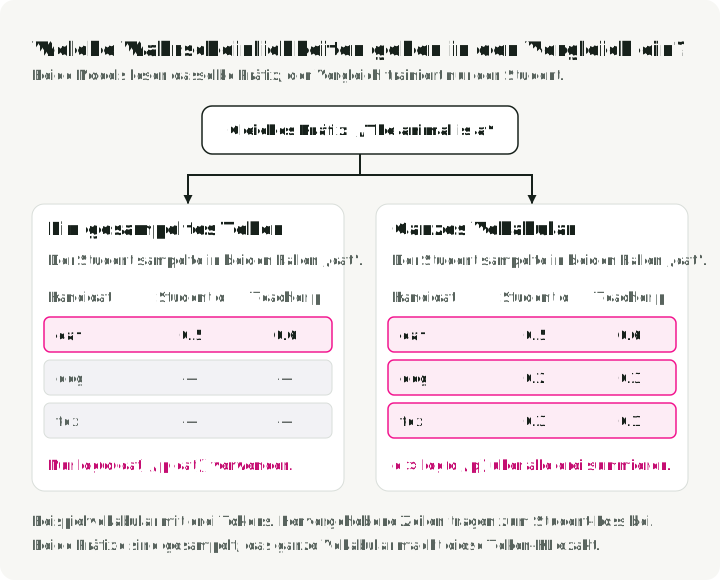
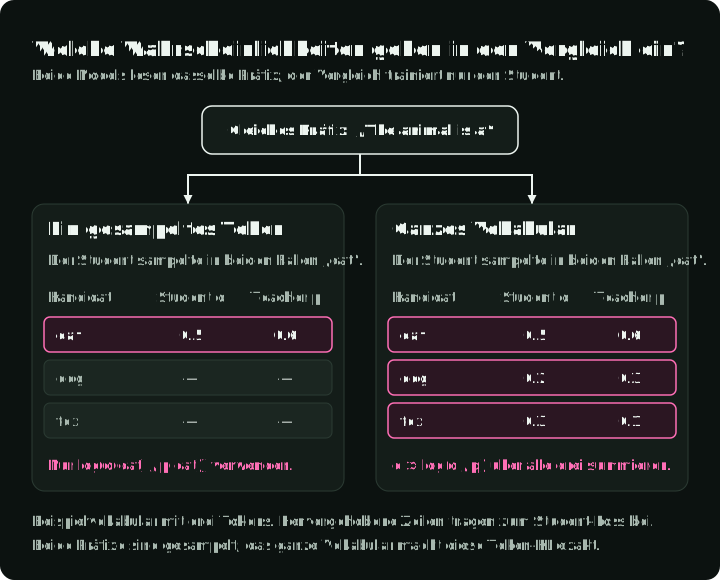
Mit den drei Zeilen ergibt sich . Das logarithmierte Verhältnis für das gesampelte „cat“ allein beträgt ungefähr . Ein einzelnes Sample kann negativ sein, obwohl die vollständige KL nichtnegativ ist.
Die ausführliche On-Policy-Lektüre behandelt die Herleitung von Sequenzen zu Tokens, Sampling-Korrekturen und Gradientenschätzungen.
DPO: ein logistischer Loss auf zwei logarithmierten Verhältnissen
DPO beginnt mit einem gespeicherten Präferenzpaar: einem Prompt, einer bevorzugten und einer abgelehnten Antwort. Das Paar kann aus menschlichen Bewertungen früherer Model-Ausgaben stammen. Während des Trainings liest das Model jede gespeicherte Antwort Token für Token und erfasst ihre Wahrscheinlichkeit unter Berücksichtigung des Prompts und der vorhergehenden Tokens. Die Summe dieser Log-Wahrscheinlichkeiten ergibt die Log-Wahrscheinlichkeit der Antwort. Das bewertet, wie wahrscheinlich der Text unter dem Model ist; das gespeicherte Präferenzlabel gibt an, welche Antwort besser ist.
Bei einem üblichen RLHF-Verfahren trainieren Präferenzpaare zuerst ein separates Reward-Model. Anschließend trainiert Reinforcement Learning das Sprachmodell anhand dieses Rewards. DPO, §4, Gleichung (7), trainiert das Sprachmodell stattdessen direkt mit den Paaren. Ein unverändertes Referenzmodel bewertet dieselben Antworten zum Vergleich. Das Training verändert nur das aktuelle Model; für diesen Schritt muss keines der beiden Models neue Antworten erzeugen.
Für jede Antwort wird ihre Referenz-Log-Wahrscheinlichkeit von ihrer aktuellen Log-Wahrscheinlichkeit abgezogen. Diese Änderung nennen wir ihren Zuwachs. DPO vergleicht den Zuwachs der bevorzugten Antwort mit dem der abgelehnten Antwort:
Hier ist der Prompt, und sind seine bevorzugte und abgelehnte Antwort, und und sind das aktuelle Model und das Referenzmodel. Die Sigmoidfunktion bildet eine Zahl auf ab, und ist ein positiver Skalierungsfaktor. Die letzte Zeile bedeutet: „Den eingeklammerten Paar-Loss über die gespeicherten Paare im Dataset mitteln“. Ein größeres verringert diesen Loss; das Training minimiert , indem es die Parameter des aktuellen Models verändert.
Wenn beispielsweise die bevorzugte Antwort 2 an Log-Wahrscheinlichkeit gewinnt und die abgelehnte Antwort 1 verliert, gilt . Die Präferenz hat sich relativ zur Referenz in die gewünschte Richtung verändert. Der Loss hat keinen separaten KL-Term und erzwingt keinen maximalen Abstand zur Referenz.
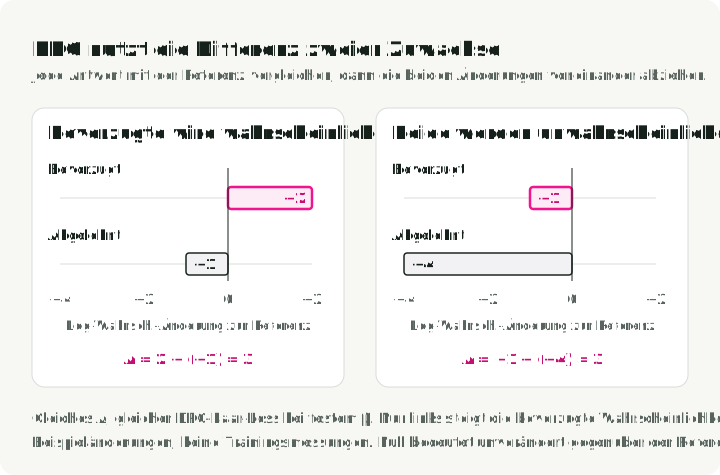
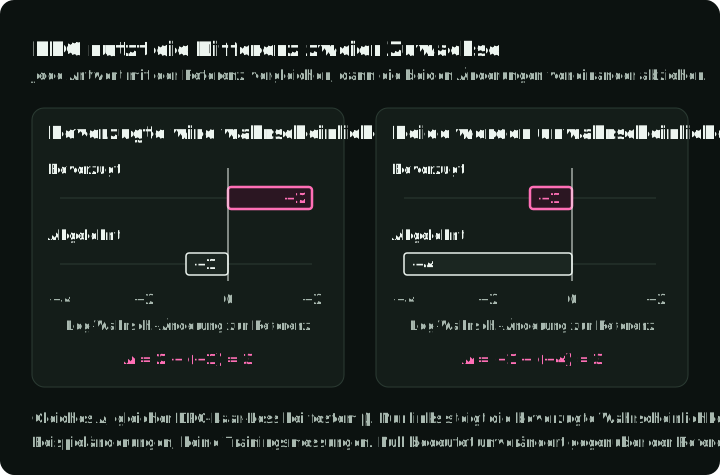
Die Differenz allein kann ein Problem verbergen: Die bevorzugte Antwort kann unwahrscheinlicher werden, während die abgelehnte Antwort noch schneller unwahrscheinlicher wird. Der Loss verbessert sich trotzdem. Smaug untersucht diesen Fehler; prüfe daher neben dem Präferenzloss auch die einzelnen Antwortwahrscheinlichkeiten.
Die beiden folgenden Fälle ergeben dasselbe und damit bei festem denselben Paar-Loss. Nur im linken Fall wird die bevorzugte Antwort wahrscheinlicher als unter der Referenz.
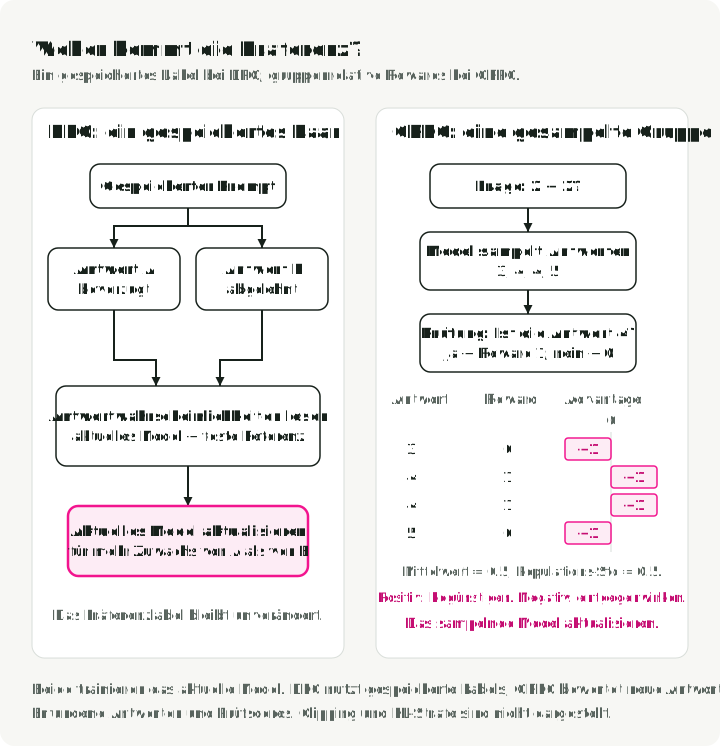
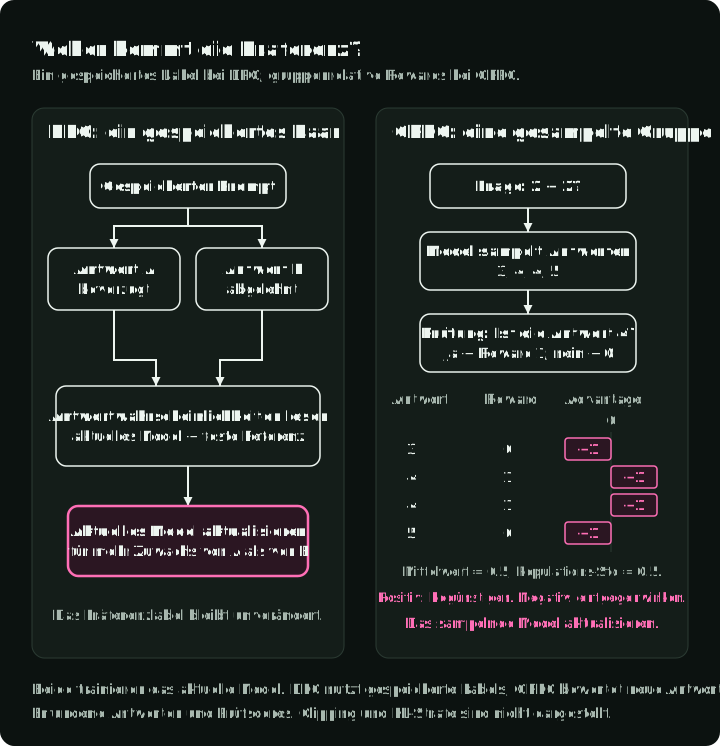
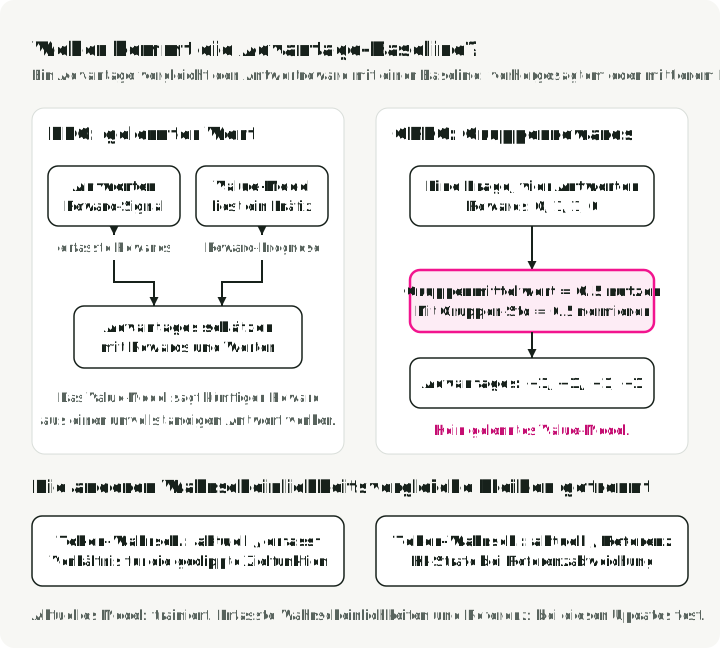
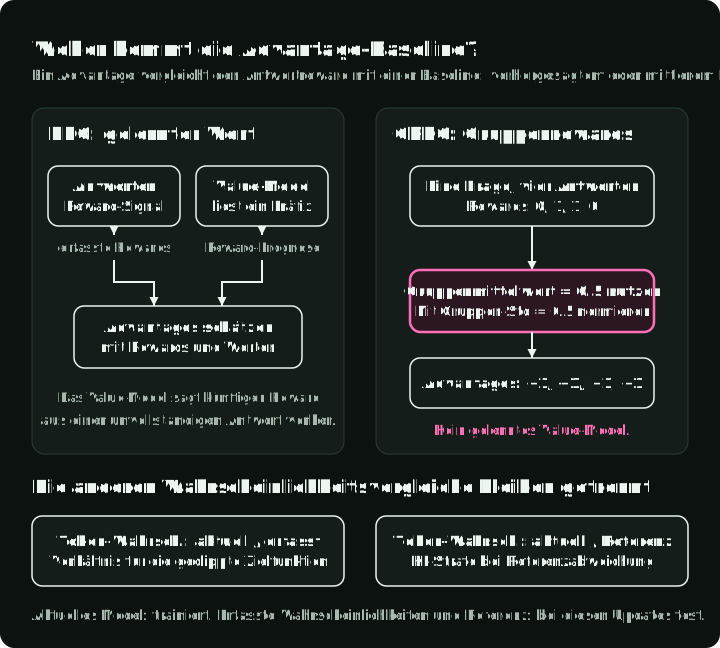
In der nächsten Abbildung gehört die DPO-Rückmeldung zu einem gespeicherten Paar. GRPO erzeugt während des Trainings vier Antworten auf „2 + 2?“. Eine Antwortprüfung vergibt 1 für „4“ und sonst 0. Der Vergleich jedes Rewards mit dem Gruppendurchschnitt ergibt einen Advantage: Positive Rückmeldung begünstigt die Tokens der gesampelten Antwort, negative Rückmeldung wirkt ihnen entgegen. Der nächste Abschnitt zeigt diese Berechnung und die Grenzen ihrer Wirkung.
Die ausführliche DPO-Lektüre leitet den Loss aus der durch Rewards regularisierten Zielfunktion ab und erläutert seinen Gradienten.
GRPO: die PPO-Zielfunktion mit Gruppenbaseline
Group Relative Policy Optimization sampelt mehrere Antworten auf dieselbe Frage, bewertet sie und vergleicht jeden Score mit dem Gruppendurchschnitt. Eine richtige Antwort unter überwiegend falschen Antworten erhält positive Rückmeldung; eine falsche Antwort unter richtigen Antworten erhält negative Rückmeldung. Für Mathematik oder Code können eine Antwortprüfung oder Tests die Bewertung übernehmen. Andere Aufgaben können ein Reward-Model verwenden.
DeepSeekMath, §4.1.1, führte GRPO als Variante von Proximal Policy Optimization (PPO) ein. DeepSeek-R1, §2.2.1, verwendete es später ebenfalls. Die wesentliche Änderung betrifft die Berechnung des Advantage, des relativen Rewards, der die Aktualisierung steuert:
ist der Reward von Antwort und die Anzahl der Antworten auf eine Frage. Durch Subtraktion des Mittelwerts erkennen wir, welche Antworten über oder unter dem Gruppendurchschnitt liegen. Die Division durch die Standardabweichung skaliert diese Differenzen. In der dargestellten Gruppe beträgt der Mittelwert und die Populationsstandardabweichung . Daraus ergeben sich die Advantages .
Was sich gegenüber PPO ändert
PPO trainiert üblicherweise ein separates Value-Model, das den künftigen Reward aus einer unvollständigen Antwort schätzt. GRPO verwendet stattdessen die Gruppenscores als Baseline und trainiert daher dieses Value-Model nicht. Es benötigt weiterhin Reward-Rückmeldungen, und seine ursprüngliche Zielfunktion verwendet weiterhin ein Referenzmodel für eine KL-Strafe. Das Entfernen des Value-Models beseitigt diese anderen Aufgaben nicht.
Der folgende Vergleich zeigt, welches Value-Model ersetzt wird. Die untere Zeile zeigt zwei weitere Trainingseingaben. Das alte oder Sampling-Model ist die Version, die diesen Antwortbatch erzeugt hat; seine erfassten Token-Wahrscheinlichkeiten bleiben unverändert, während das aktuelle Model auf diesem Batch trainiert. Ein separates Referenzmodel, das während dieser Aktualisierungen ebenfalls unverändert bleibt, liefert Wahrscheinlichkeiten für den KL-Vergleich. Beide Vergleiche bewerten dasselbe Token nach demselben Präfix.
GRPO behält die PPO-Zielfunktion mit geclipptem Wahrscheinlichkeitsverhältnis bei. Hatte ein gesampeltes Token die Wahrscheinlichkeit und weist das aktuelle Model ihm am selben Präfix nun zu, beträgt das Verhältnis . Die Zielfunktion gewichtet dieses Verhältnis mit dem Advantage der Antwort. Das Training verändert das aktuelle Model, um diese Zielfunktion zu erhöhen. Eine separate KL-Strafe wirkt einer Abweichung von der Referenz entgegen.
Für eine gesampelte Antwort bezeichnet den Prompt und die Antwort-Tokens vor Position , und das Token an dieser Position. Der im Diagramm dargestellte Teil von Gleichung (3) aus DeepSeekMath lautet:
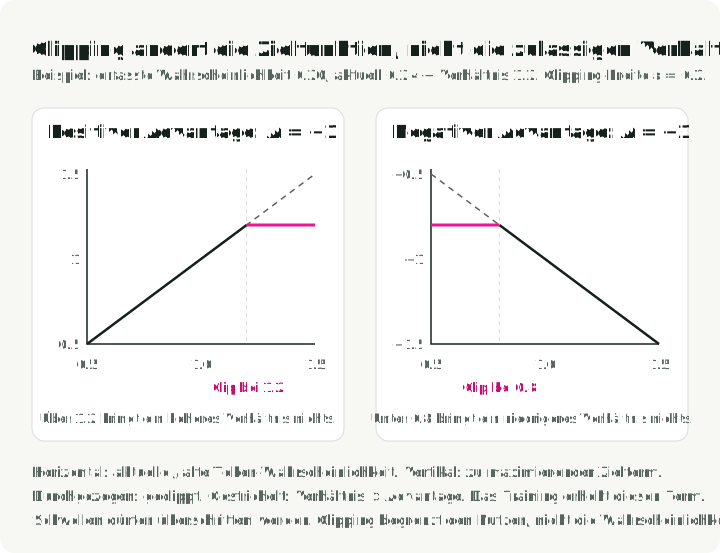
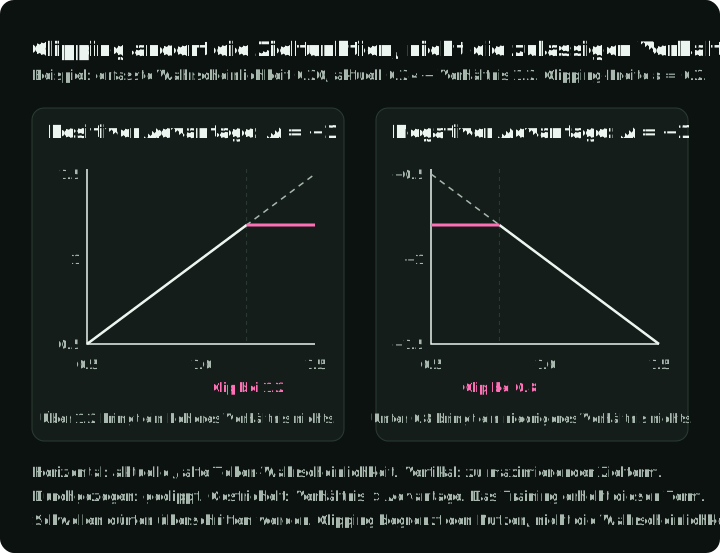
ist das aktuelle Model, die Sampling-Kopie und der Gruppen-Advantage dieser Antwort. Die Breite legt das Clipping-Intervall fest. bedeutet: „Ein Verhältnis außerhalb des Intervalls durch den nächstgelegenen Endpunkt ersetzen“. bedeutet anschließend: „Den kleineren der beiden mit dem Advantage gewichteten Terme nehmen“. ist ein zu maximierender Beitrag. GRPO zieht seine KL-Strafe ab und mittelt über Tokens innerhalb der Antworten, Antworten innerhalb der Gruppen und gesampelte Fragen.
Mit , und sind die beiden Terme und , also gilt . Mit und sind sie und , also gilt . Dies sind die beiden flachen Abschnitte des Diagramms.
Das Diagramm zeigt den Beitrag eines einzelnen Tokens bei festem Advantage. Ein positiver Advantage begünstigt ein höheres Verhältnis; ein negativer begünstigt ein niedrigeres. Clipping macht die Linie dort flach, wo eine günstige Änderung diesen Term nicht weiter verbessert. Es setzt keine feste Grenze für die tatsächlichen Wahrscheinlichkeiten des Models.
Die Sampling-Kopie und die Referenz können mit denselben Weights beginnen, dienen aber unterschiedlichen Vergleichen. Die Sampling-Kopie wird beim Sammeln eines neuen Batches aktualisiert; ihre erfassten Wahrscheinlichkeiten bleiben der Nenner für Aktualisierungen auf diesem Batch.
Wenn jede Antwort denselben Reward erhält, gibt es keine relative Präferenz zu lernen. Die Advantage-Formel dividiert dann null durch null. Implementierungen brauchen dafür eine Regel, etwa Advantages von null zu erzeugen; DAPO, §3.2, schließt diese Gruppen stattdessen aus und sampelt Ersatzgruppen.
Die ausführliche GRPO-Lektüre behandelt die vollständige Zielfunktion, Clipping-Fälle, Gradienten, den gesampelten KL-Schätzer und die Auswirkungen einer Mittelung pro Antwort oder pro Token.
Optionale Erläuterungen der Gleichungen
Die verlinkten ausführlichen Texte enthalten Herleitungen und Prüfungen mit kleinen Zahlen. Sie wurden mit den Coding-Agent-Skills aus paper-math-skills erstellt und sind in paper-math-readings gesammelt.
Quellen und Versionen
- Hinton et al. Distilling the Knowledge in a Neural Network, §2, Gleichung (1).
- Gu et al. MiniLLM, §2.1–2.2.
- DeepSeek-AI. DeepSeek-V4, §5.1.2, Gleichung (29).
- Rafailov et al. Direct Preference Optimization, §4, Gleichung (7).
- Shao et al. DeepSeekMath, §4.1.1, Gleichungen (1)–(4).
- DeepSeek-AI. DeepSeek-R1, §2.2.1 und §2.4.