Jak czytać funkcje celu: destylacja, DPO i GRPO

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Destylacja, Direct Preference Optimization (DPO) i Group Relative Policy Optimization (GRPO) zmieniają prawdopodobieństwa modelu językowego, ale korzystają z różnych przykładów treningowych i informacji zwrotnych. Ten przewodnik jest dla inżynierów, którzy chcą zrozumieć te różnice przed przeczytaniem pełnych funkcji celu. Diagramy pokazują, skąd pochodzi informacja zwrotna i jak zmienia porównania prawdopodobieństw; równania przedstawiają odpowiadające im operacje.
W zwykłym nadzorowanym fine-tuningu model uczy się przewidywać kolejny token w zapisanych przykładach. Poniższe metody zmieniają informację zwrotną: nauczyciel dostarcza prawdopodobieństwa, para preferencji wskazuje lepszą odpowiedź albo nagroda ocenia odpowiedzi wylosowane podczas treningu. Polityka to po prostu model generujący odpowiedzi. Wszystkie poniższe logarytmy są naturalne.
Część 1 wyjaśnia, jak czytać równanie, i zawiera zestawienie notacji. Tutaj każda sekcja wyjaśnia potrzebne pojęcia i można ją czytać niezależnie.
Klasyczna destylacja: temperatura w obu funkcjach softmax
Etykieta treningowa wskazuje poprawny wynik: przy przewidywaniu kolejnego tokenu jest nim następny token w zapisanym przykładzie. Model nauczyciela dostarcza więcej informacji: prawdopodobieństwa wszystkich tokenów kandydujących, w tym wiarygodnych alternatyw. Destylacja uczy mniejszy model ucznia odtwarzać te prawdopodobieństwa. Trening zmniejsza liczbową stratę, zmieniając parametry ucznia; parametry nauczyciela pozostają stałe.
W pracy o destylacji Hintona i współautorów, §2, rozkłady obu modeli zostają wygładzone przed porównaniem. Dzielimy każdy logit — surowy wynik przed funkcją softmax — przez temperaturę :
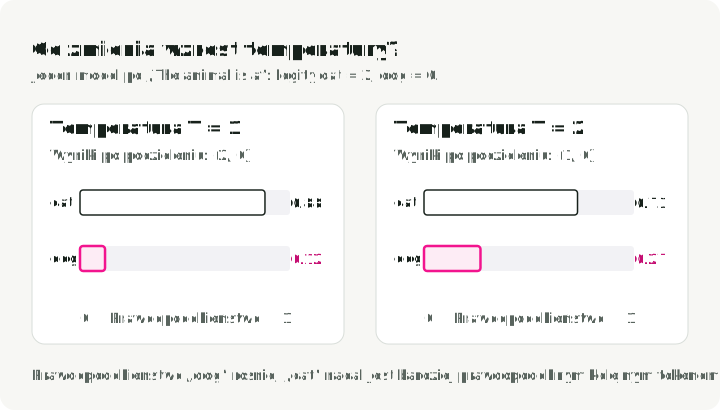
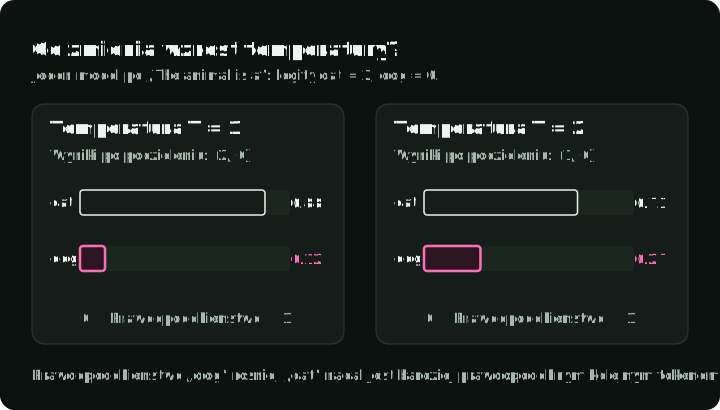
Tutaj to wynik kandydata , a to jego prawdopodobieństwo. Załóżmy, że uproszczony model ma tylko dwa możliwe kolejne tokeny, „cat” i „dog”, i przypisuje im wyniki po przeczytaniu „The animal is a”. Przy prawdopodobieństwa wynoszą około ; przy stają się równe . Mniejszy wynik ma teraz większy udział w porównaniu. Nauczyciel i uczeń używają tej samej temperatury.
Słupki pokazują, jak te same dwa wyniki dają mniej skoncentrowany rozkład wraz ze wzrostem temperatury.
Strata treningowa łączy zwykłą stratę względem etykiety ze stratą za niedopasowanie do wygładzonego rozkładu nauczyciela. Oznaczmy prawdopodobieństwa nauczyciela przez , a ucznia przez przy temperaturze . Dla jednego wejścia z etykietą:
Tutaj to strata, to poprawny kolejny token, a ustala proporcje składników. Indeksy górne w nawiasach oznaczają temperatury, a nie potęgi. Pierwszy składnik czytamy jako „karz niskie prawdopodobieństwo poprawnego tokenu przy ”. Drugi jako „dopasuj wygładzone prawdopodobieństwa nauczyciela”. Trening uśrednia te straty po zapisanych wejściach i zmienia tylko ucznia.
to dywergencja KL od nauczyciela do ucznia . Mierzy różnicę między dwoma rozkładami prawdopodobieństwa: wynosi zero, gdy są jednakowe. Pierwszy rozkład dostarcza wag do porównania, więc wyniki prawdopodobne według nauczyciela otrzymują większą wagę. Hinton i współautorzy opisują składnik dopasowania oparty na entropii krzyżowej; ta postać KL odejmuje stałą zależną tylko od nauczyciela i daje te same gradienty ucznia.
Czynnik w przybliżeniu kompensuje mniejsze gradienty przy wyższych temperaturach. To ustawienie treningowe; wdrożony uczeń zwykle wraca do w tej funkcji softmax.
Prefiks to tekst dostępny przed kolejnym tokenem: prompt wraz z dotychczasowymi tokenami odpowiedzi. Na przykład „The animal is a” jest prefiksem przed „cat”. Na rysunku oba modele czytają ten sam prefiks i wyznaczają prawdopodobieństwa kolejnego tokenu. Po lewej prefiksy pochodzą z zapisanych przykładów. Po prawej pochodzą z odpowiedzi generowanych przez ucznia podczas treningu. Obie ścieżki używają straty porównawczej do aktualizacji wyłącznie ucznia.
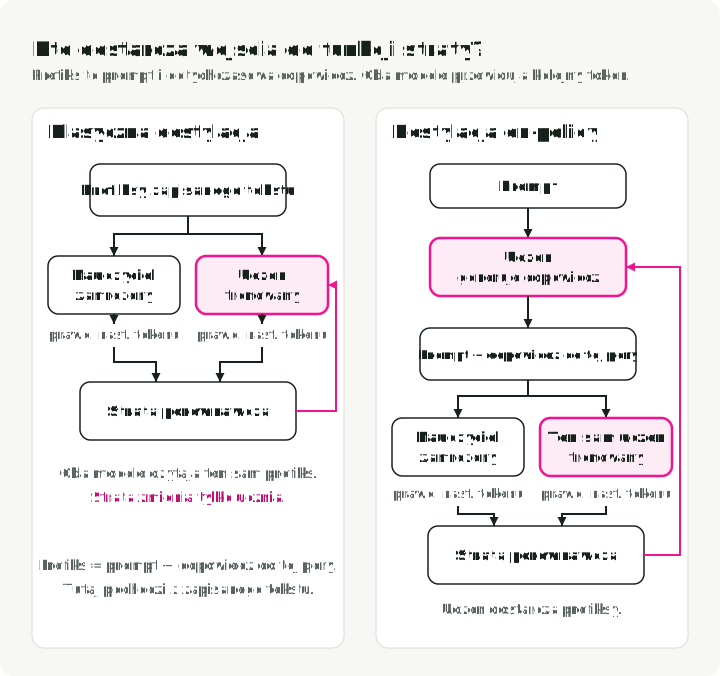
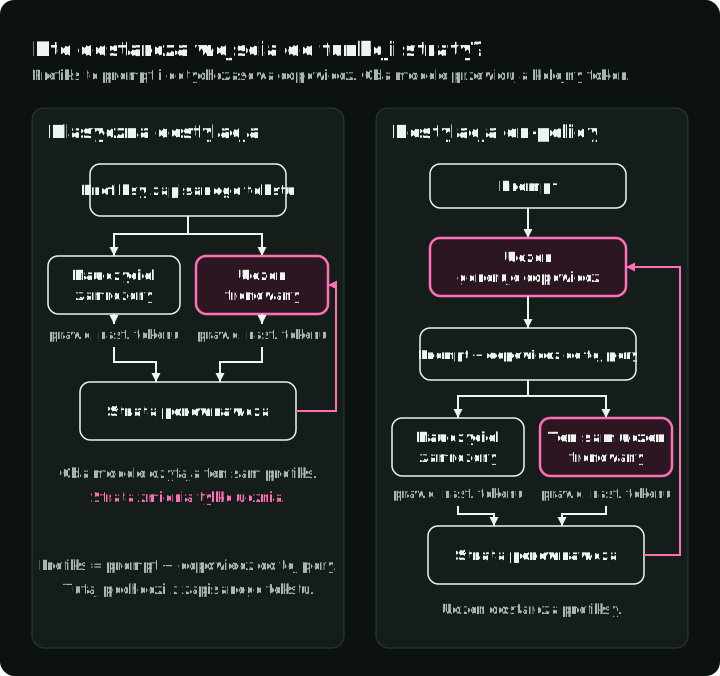
Istnieje też destylacja bez dopasowywania prawdopodobieństw. Modele destylowane z DeepSeek-R1, §2.4, poddano fine-tuningowi na 800 000 przykładów przygotowanych wcześniej z użyciem DeepSeek-R1. Używały nadzorowanej funkcji straty na zapisanym tekście; nauczyciel nie musiał działać podczas tego treningu.
Szczegółowe omówienie destylacji wyjaśnia mieszaną funkcję straty i skalowanie temperaturą.
Destylacja on-policy: uczeń na pierwszym miejscu w KL
Uczeń generujący własną odpowiedź może dojść do prefiksów — promptu wraz z dotychczasową odpowiedzią — które nigdy nie wystąpiły w zbiorze treningowym. Destylacja on-policy uzyskuje informację zwrotną dla tekstu rzeczywiście wytwarzanego przez ucznia. Dla danego promptu uczeń losuje odpowiedź. Zamrożony nauczyciel ocenia następnie te same prefiksy, więc trening porównuje modele tam, gdzie uczeń potrzebuje wskazówek.
On-policy opisuje to źródło tekstu treningowego. Samo w sobie nie narzuca konkretnej funkcji straty. W poniższych przykładach używamy odwrotnej KL, z uczniem na pierwszym miejscu:
Dla ustalonego promptu , to uczeń z trenowanymi parametrami , to nauczyciel, a to odpowiedź wylosowana z modelu ucznia. Wyrażenie porównuje prawdopodobieństwo, które uczeń przypisał swojej odpowiedzi, z prawdopodobieństwem według nauczyciela. Po uśrednieniu po odpowiedziach ucznia karze przypisywanie wysokiego prawdopodobieństwa tekstom, które nauczyciel uważa za mało prawdopodobne.
Różni się to od wymagania, aby uczeń uwzględnił każdy wynik, jaki mógłby wygenerować nauczyciel. Gdy mały uczeń nie potrafi dopasować pełnego rozkładu nauczyciela, odwrotna KL może sprzyjać skupieniu na części jego prawdopodobnych wyników. MiniLLM, §2.1, równanie (1), używa tej funkcji celu. Rzeczywista procedura treningowa włącza też próbki nauczyciela do generowania i koryguje gradient, by ograniczyć wariancję i obciążenie związane z długością; diagram pokazuje podstawowy układ on-policy, a nie wszystkie modyfikacje MiniLLM.
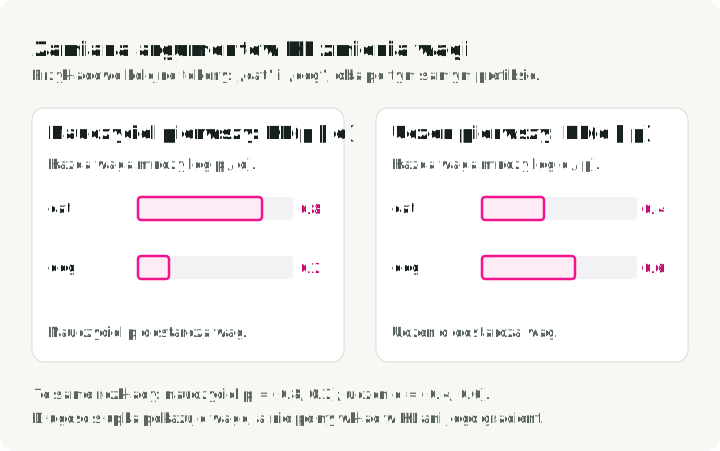
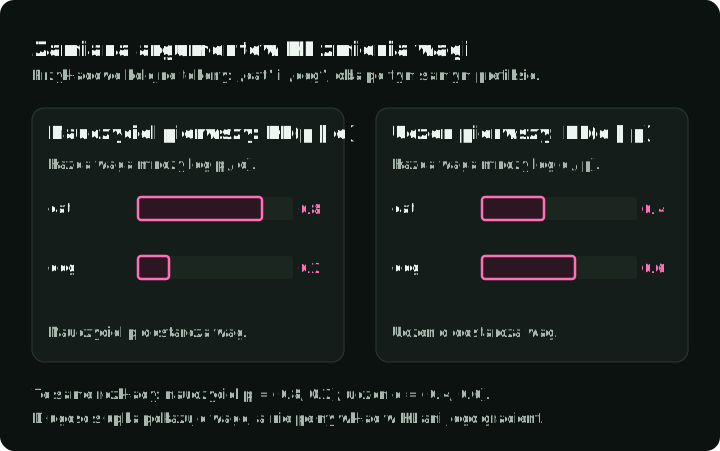
W uproszczonym przykładzie poniżej nauczyciel i uczeń przypisują różne prawdopodobieństwa tokenom „cat” i „dog” po tym samym prefiksie. KL mnoży logarytm ilorazu dla każdego tokenu przez jego wagę, a potem dodaje oba składniki. Zmiana pierwszego argumentu przenosi większą wagę z „cat” na „dog”. Słupki pokazują wagi, a nie pełny wkład w stratę.
Od KL sekwencji do KL tokenów
Prawdopodobieństwo odpowiedzi wynika z prawdopodobieństw jej kolejnych tokenów. Dla każdego prefiksu odpowiedzi ucznia oba modele przewidują kolejny token. Można więc porównywać ich różnice pozycja po pozycji, a potem sumować je dla całej odpowiedzi. DeepSeek-V4, §5.1.2, równanie (29), używa destylacji z odwrotną KL od kilku wyspecjalizowanych nauczycieli do jednego ucznia. Ci nauczyciele to osobne modele, a nie podsieci ekspertów wewnątrz warstwy mixture-of-experts.
Na pozycji niech oznacza prawdopodobieństwo tokenu kandydującego według ucznia. Prefiks zawiera prompt i wcześniejsze tokeny odpowiedzi ; to prawdopodobieństwo nauczyciela dla tego samego prefiksu. Wtedy:
to słownik, a to KL kolejnego tokenu dla jednego prefiksu. Wewnętrzną sumę czytamy jako „porównaj każdy token kandydujący z wagą równą prawdopodobieństwu ucznia”. Sumujemy te porównania po pozycjach, a następnie uśredniamy po odpowiedziach generowanych przez ucznia. Zewnętrzna wartość oczekiwana nadal opiera się na losowanym tekście, nawet gdy każde sumuje cały słownik.
Jeden wylosowany token czy cały słownik
Nauczyciel może ocenić tylko token wybrany przez ucznia albo zwrócić prawdopodobieństwa dla całego słownika. Pierwsza opcja przekazuje mniej informacji; druga porównuje wszystkie możliwe kolejne tokeny dla danego prefiksu. DeepSeek-V4 opisuje niestabilny trening przy estymatorze opartym na jednym tokenie i stosuje porównanie całego słownika. Dzięki temu porównanie tokenów jest dokładne dla danego prefiksu; same prefiksy nadal pochodzą z losowanych odpowiedzi.
Oba modele czytają „The animal is a” i zwracają prawdopodobieństwa pokazane poniżej. Wyróżnione wiersze wchodzą do straty używanej do aktualizacji ucznia. Wariant z pełnym słownikiem uwzględnia „dog” i „fox”, choć uczeń wybrał „cat”; wariant jednotokenowy szacuje to porównanie wyłącznie na podstawie wybranego tokenu.
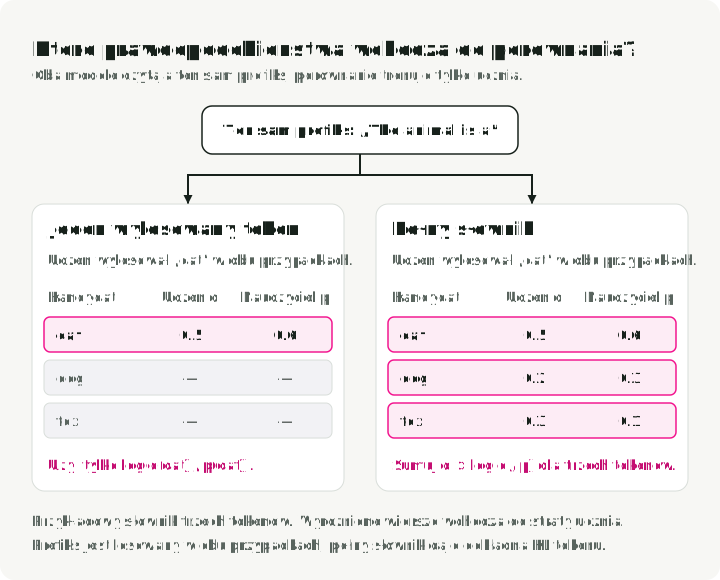
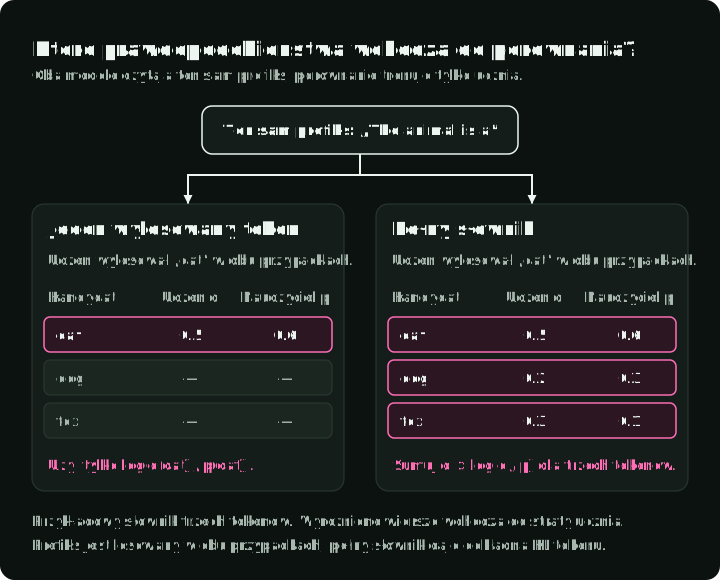
Korzystając z trzech wierszy, otrzymujemy . Sam logarytm ilorazu dla wylosowanego „cat” wynosi około . Jedna próbka może dać wynik ujemny, chociaż pełna KL jest nieujemna.
Szczegółowe omówienie on-policy przedstawia wyprowadzenie od sekwencji do tokenów, korekty próbkowania i estymatory gradientu.
DPO: logistyczna funkcja straty dla dwóch logarytmów ilorazów
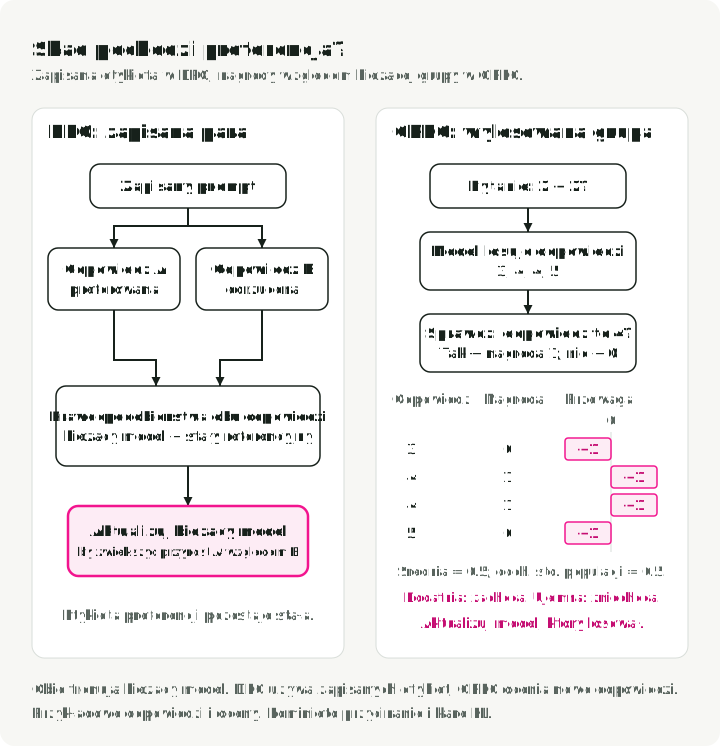
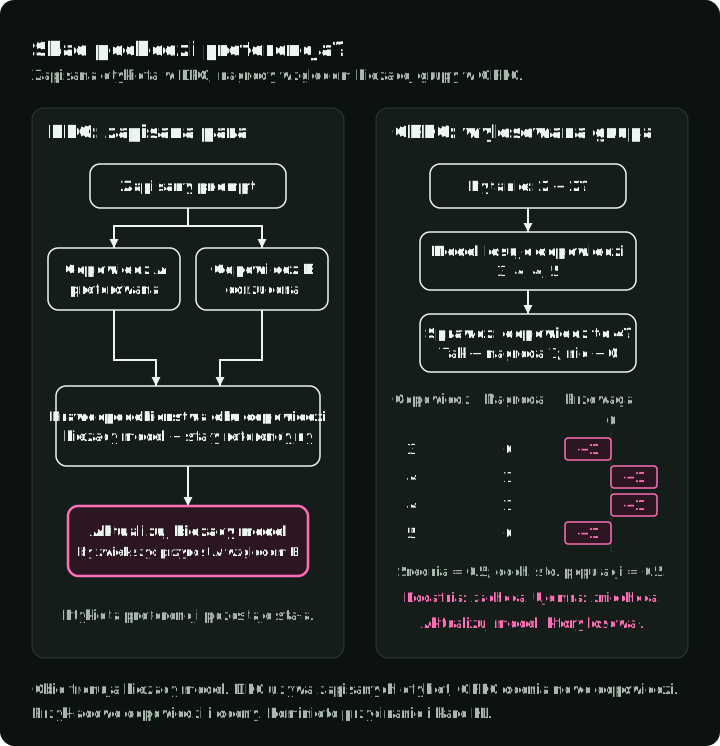
DPO zaczyna od zapisanej pary preferencji: jednego promptu, preferowanej odpowiedzi i odrzuconej odpowiedzi. Para może pochodzić z ocen ludzi dotyczących wcześniejszych wyników modeli. Podczas treningu model czyta każdą zapisaną odpowiedź token po tokenie i zapisuje jego prawdopodobieństwo przy danym prompcie i wcześniejszych tokenach. Suma tych logarytmów prawdopodobieństw daje logarytm prawdopodobieństwa odpowiedzi. Ocenia to prawdopodobieństwo tekstu według modelu; zapisana etykieta preferencji wskazuje, która odpowiedź jest lepsza.
W typowej procedurze RLHF pary preferencji najpierw służą do treningu osobnego modelu nagrody, a następnie uczenie ze wzmocnieniem trenuje model językowy względem tej nagrody. DPO, §4, równanie (7), trenuje natomiast model językowy bezpośrednio na parach. Zamrożony model referencyjny ocenia te same odpowiedzi do porównania. Trening zmienia tylko bieżący model; żaden z modeli nie musi w tym kroku generować nowych odpowiedzi.
Dla każdej odpowiedzi odejmujemy referencyjny logarytm prawdopodobieństwa od bieżącego. Nazwijmy tę zmianę przyrostem. DPO porównuje przyrost preferowanej odpowiedzi z przyrostem odrzuconej:
Tutaj to prompt, i to preferowana i odrzucona odpowiedź, a i to model bieżący i referencyjny. Sigmoida odwzorowuje liczbę na , a to dodatnia skala. Ostatni wiersz czytamy jako „uśrednij stratę pary w nawiasach po zapisanych parach ze zbioru ”. Zwiększenie obniża tę stratę; trening minimalizuje , zmieniając parametry bieżącego modelu.
Na przykład jeśli preferowana odpowiedź zyskuje 2 w logarytmie prawdopodobieństwa, a odrzucona traci 1, to . Preferencja zmieniła się w zamierzonym kierunku względem modelu referencyjnego. Strata nie ma osobnego składnika KL i nie narzuca maksymalnej odległości od modelu referencyjnego.
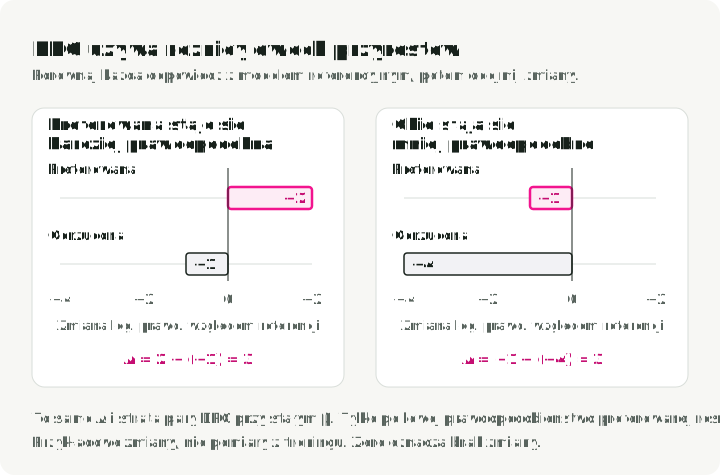
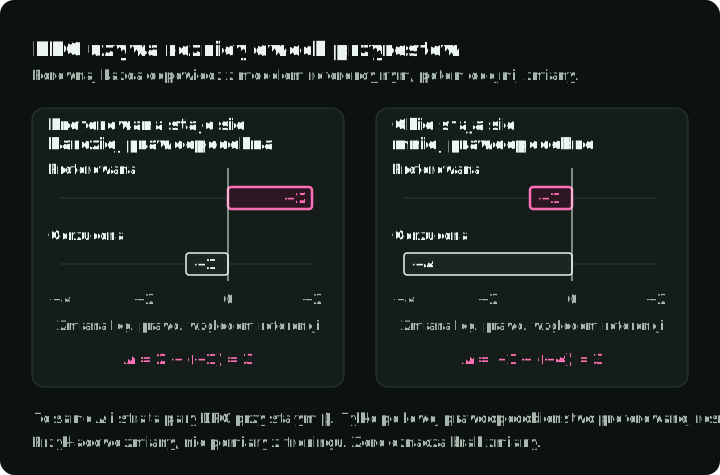
Sama różnica może ukryć problem: preferowana odpowiedź może stawać się mniej prawdopodobna, podczas gdy prawdopodobieństwo odrzuconej spada jeszcze szybciej. Strata nadal się poprawia. Smaug bada ten problem, więc oprócz straty preferencji należy sprawdzać prawdopodobieństwa poszczególnych odpowiedzi.
Oba poniższe przypadki dają takie samo , a więc tę samą stratę pary przy ustalonym . Tylko po lewej preferowana odpowiedź staje się bardziej prawdopodobna niż w modelu referencyjnym.
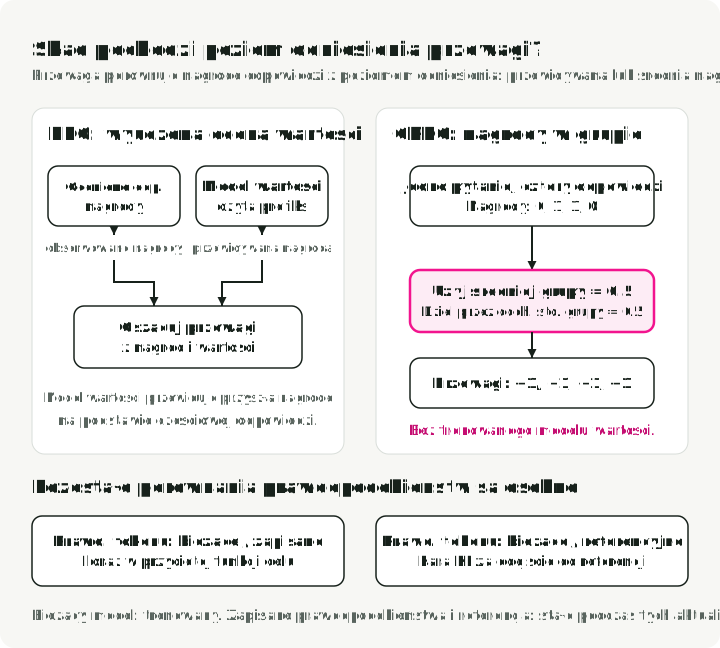
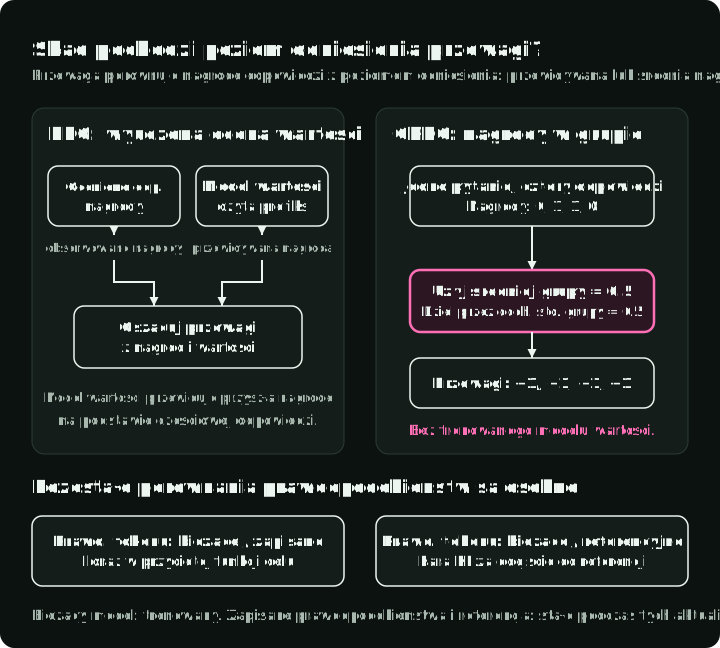
Na następnym rysunku informacja zwrotna DPO jest przypisana do zapisanej pary. GRPO generuje podczas treningu cztery odpowiedzi na „2 + 2?”. Weryfikator odpowiedzi przyznaje 1 za „4” i 0 w pozostałych przypadkach. Porównanie każdej nagrody ze średnią grupy daje przewagę: dodatnia informacja zwrotna sprzyja tokenom wylosowanej odpowiedzi, a ujemna działa przeciwko nim. Następna sekcja pokazuje te obliczenia i ograniczenia ich wpływu.
Szczegółowe omówienie DPO wyprowadza stratę z funkcji celu z regularyzacją nagrody i analizuje jej gradient.
GRPO: funkcja celu PPO z grupowym poziomem odniesienia
Group Relative Policy Optimization losuje kilka odpowiedzi na to samo pytanie, ocenia je i porównuje każdą ocenę ze średnią grupy. Poprawna odpowiedź wśród głównie niepoprawnych otrzymuje dodatnią informację zwrotną; niepoprawna wśród poprawnych otrzymuje ujemną. W matematyce lub kodzie oceny mogą pochodzić z weryfikatora odpowiedzi albo testów. Inne zadania mogą używać modelu nagrody.
DeepSeekMath, §4.1.1, wprowadził GRPO jako wariant Proximal Policy Optimization (PPO). DeepSeek-R1, §2.2.1, wykorzystał go później. Główna zmiana dotyczy sposobu obliczania przewagi, czyli względnej nagrody kierującej aktualizacją:
to nagroda odpowiedzi , a to liczba odpowiedzi na jedno pytanie. Odjęcie średniej wskazuje, które odpowiedzi uzyskały wynik powyżej lub poniżej średniej grupy. Dzielenie przez odchylenie standardowe skaluje te różnice. W pokazanej grupie średnia wynosi , a populacyjne odchylenie standardowe , co daje przewagi .
Co zmienia się względem PPO
PPO zwykle trenuje osobny model wartości do szacowania przyszłej nagrody na podstawie częściowej odpowiedzi. GRPO używa zamiast tego ocen grupy jako poziomu odniesienia, więc nie trenuje tego modelu wartości. Nadal potrzebuje informacji o nagrodzie, a jego oryginalna funkcja celu nadal używa modelu referencyjnego do kary KL. Usunięcie modelu wartości nie usuwa tych pozostałych ról.
Poniższe porównanie wskazuje zastępowany model wartości. Dolny wiersz pokazuje dwa inne wejścia do treningu. Stary model lub model próbkujący to wersja, która wygenerowała tę partię odpowiedzi; zapisane prawdopodobieństwa tokenów pozostają stałe podczas treningu bieżącego modelu na tej partii. Osobny model referencyjny, również niezmienny podczas tych aktualizacji, dostarcza prawdopodobieństwa do porównania KL. Oba porównania oceniają ten sam token po tym samym prefiksie.
GRPO zachowuje funkcję celu PPO z przyciętym ilorazem prawdopodobieństw. Jeśli wylosowany token miał prawdopodobieństwo , a bieżący model przypisuje mu teraz dla tego samego prefiksu, iloraz wynosi . Funkcja celu waży ten iloraz przewagą odpowiedzi. Trening zmienia bieżący model, aby zwiększać tę funkcję celu, a osobna kara KL ogranicza odchylenie od modelu referencyjnego.
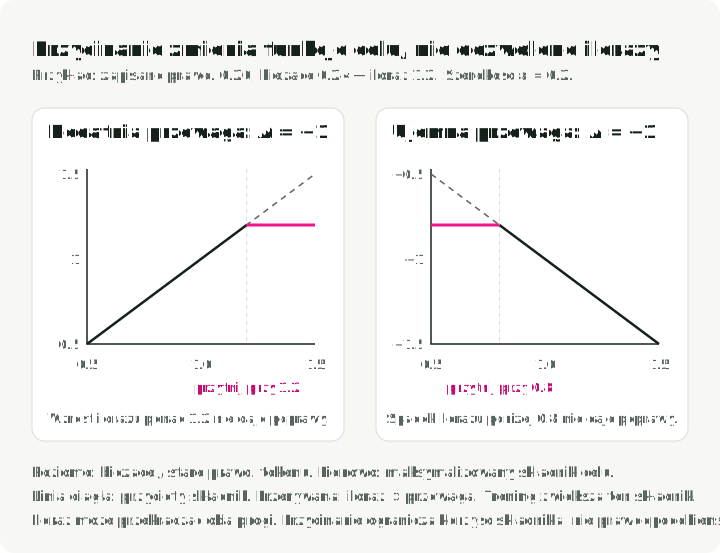
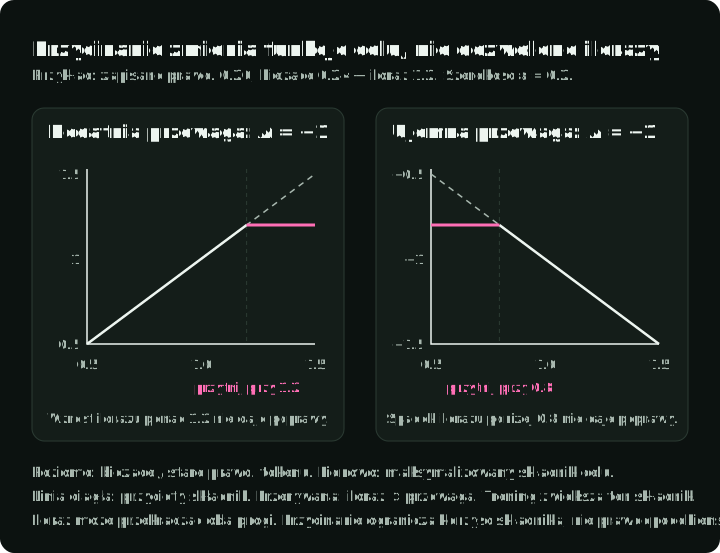
Dla jednej wylosowanej odpowiedzi oznaczmy przez prompt wraz z tokenami odpowiedzi przed pozycją , a przez token na tej pozycji. Część równania (3) z DeepSeekMath pokazana na wykresie to:
to bieżący model, to kopia próbkująca, a to przewaga tej odpowiedzi względem grupy. Szerokość ustala przedział przycinania. czytamy jako „zastąp iloraz spoza przedziału najbliższym końcem przedziału”, a następnie jako „wybierz mniejszy z dwóch składników ważonych przewagą”. to wkład, który maksymalizujemy. GRPO odejmuje karę KL i uśrednia po tokenach w odpowiedziach, odpowiedziach w grupach i wylosowanych pytaniach.
Przy , i oba składniki wynoszą i , więc . Przy i wynoszą i , więc . To dwa płaskie fragmenty wykresu.
Wykres pokazuje wkład jednego tokenu przy ustalonej przewadze. Dodatnia przewaga sprzyja wyższemu ilorazowi; ujemna sprzyja niższemu. Przycinanie sprawia, że linia staje się płaska tam, gdzie korzystna zmiana przestaje poprawiać ten składnik. Nie narzuca sztywnego ograniczenia rzeczywistych prawdopodobieństw modelu.
Kopia próbkująca i model referencyjny mogą zaczynać od tych samych wag, ale służą różnym porównaniom. Kopia próbkująca jest odświeżana przy zbieraniu nowej partii; zapisane przez nią prawdopodobieństwa pozostają mianownikiem podczas aktualizacji na tej partii.
Jeśli każda odpowiedź otrzymuje tę samą nagrodę, nie ma względnej preferencji do nauczenia. Wzór na przewagę dzieli wtedy zero przez zero. Implementacje potrzebują reguły dla tego przypadku, na przykład zwracania zerowych przewag; DAPO, §3.2, zamiast tego wyklucza takie grupy i losuje nowe w ich miejsce.
Szczegółowe omówienie GRPO przedstawia pełną funkcję celu, przypadki przycinania, gradienty, estymator KL oparty na próbkach i wpływ uśredniania po odpowiedziach lub tokenach.
Opcjonalne szczegółowe analizy równań
Podlinkowane szczegółowe omówienia zawierają wyprowadzenia i sprawdzenia na małych liczbach. Powstały przy użyciu umiejętności agentów programistycznych z paper-math-skills i są zebrane w paper-math-readings.
Źródła i wersje
- Hinton i współautorzy. Distilling the Knowledge in a Neural Network, §2, równanie (1).
- Gu i współautorzy. MiniLLM, §2.1–2.2.
- DeepSeek-AI. DeepSeek-V4, §5.1.2, równanie (29).
- Rafailov i współautorzy. Direct Preference Optimization, §4, równanie (7).
- Shao i współautorzy. DeepSeekMath, §4.1.1, równania (1)–(4).
- DeepSeek-AI. DeepSeek-R1, §2.2.1 i §2.4.