Lire les objectifs d'entraînement : distillation, DPO et GRPO

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
La distillation, Direct Preference Optimization (DPO) et Group Relative Policy Optimization (GRPO) modifient toutes les probabilités d’un modèle de langage, mais utilisent des exemples d’entraînement et des signaux de retour différents. Ce guide s’adresse aux ingénieurs qui veulent comprendre ces différences avant de lire les objectifs complets. Les schémas montrent l’origine du signal de retour et son effet sur les comparaisons de probabilités ; les équations donnent les opérations correspondantes.
Dans un fine-tuning supervisé ordinaire, le modèle apprend à prédire le token suivant dans des exemples enregistrés. Les méthodes ci-dessous changent le signal de retour : un enseignant fournit des probabilités, une paire de préférences indique quelle réponse est meilleure, ou une récompense évalue des réponses échantillonnées pendant l’entraînement. Une politique est simplement le modèle qui génère les réponses. Tous les logarithmes ci-dessous sont naturels.
La partie 1 explique comment lire une équation et fournit un guide des notations. Ici, chaque section explique les termes nécessaires et peut se lire indépendamment.
Distillation classique : une température pour les deux softmax
Une étiquette d’entraînement indique le résultat correct : pour la prédiction du token suivant, c’est le token suivant dans un exemple enregistré. Un modèle enseignant fournit davantage d’informations : ses probabilités pour chaque token candidat, y compris les autres possibilités plausibles. La distillation entraîne un élève plus petit à reproduire ces probabilités. L’entraînement réduit une perte numérique en modifiant les paramètres de l’élève ; ceux de l’enseignant restent fixes.
L’article de Hinton et al. sur la distillation, §2, rend les distributions des deux modèles moins concentrées avant de les comparer. On divise chaque logit — le score brut avant softmax — par une température :
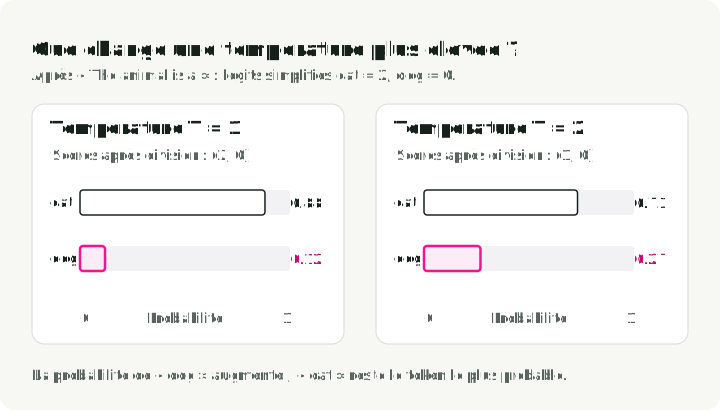
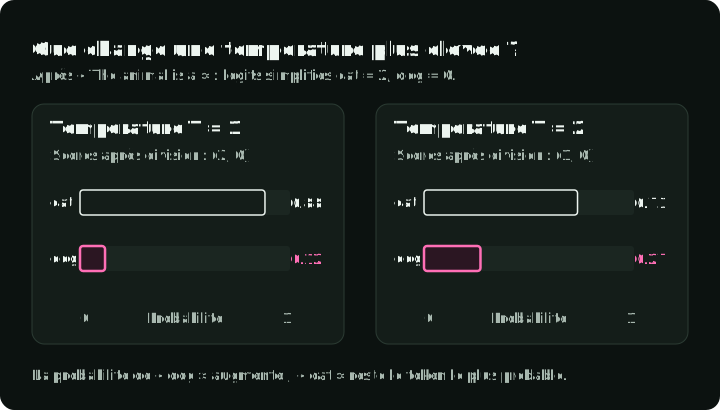
Ici, est le score du candidat et sa probabilité. Supposons qu’un modèle simplifié n’ait que deux tokens suivants possibles, « cat » et « dog », et leur attribue les scores après avoir lu « The animal is a ». À , les probabilités sont environ ; à , elles deviennent . Le plus petit score contribue désormais davantage à la comparaison. L’enseignant et l’élève utilisent la même température.
Les barres montrent comment les deux mêmes scores donnent une distribution moins concentrée quand la température augmente.
La perte d’entraînement combine la perte habituelle sur les étiquettes et une perte qui rapproche l’élève de la distribution adoucie de l’enseignant. Notons les probabilités de l’enseignant et celles de l’élève à la température . Pour une entrée étiquetée :
Ici, est la perte, le token suivant correct et règle le mélange. Les exposants entre parenthèses désignent des températures, pas des puissances. Le premier terme se lit « pénaliser une faible probabilité du token correct à ». Le second se lit « reproduire les probabilités adoucies de l’enseignant ». L’entraînement moyenne ces pertes sur les entrées enregistrées et modifie uniquement l’élève.
est la divergence KL de l’enseignant vers l’élève . Elle mesure la différence entre deux distributions de probabilités : elle vaut zéro lorsqu’elles coïncident. La première distribution fournit les poids de la comparaison ; les résultats que l’enseignant juge probables reçoivent donc plus de poids. Hinton et al. décrivent un terme de correspondance par entropie croisée ; cette forme KL soustrait une constante qui dépend uniquement de l’enseignant et donne les mêmes gradients pour l’élève.
Le facteur compense approximativement la diminution des gradients aux températures élevées. Ce réglage concerne l’entraînement ; l’élève déployé revient généralement à pour ce softmax.
Un préfixe est le texte déjà disponible avant le token suivant : le prompt et les tokens de réponse déjà produits. Par exemple, « The animal is a » est le préfixe avant « cat ». Dans la figure, les deux modèles lisent le même préfixe et produisent des probabilités du token suivant. À gauche, les préfixes proviennent d’exemples enregistrés. À droite, ils proviennent de réponses que l’élève génère pendant l’entraînement. Dans les deux cas, la perte de comparaison met à jour uniquement l’élève.
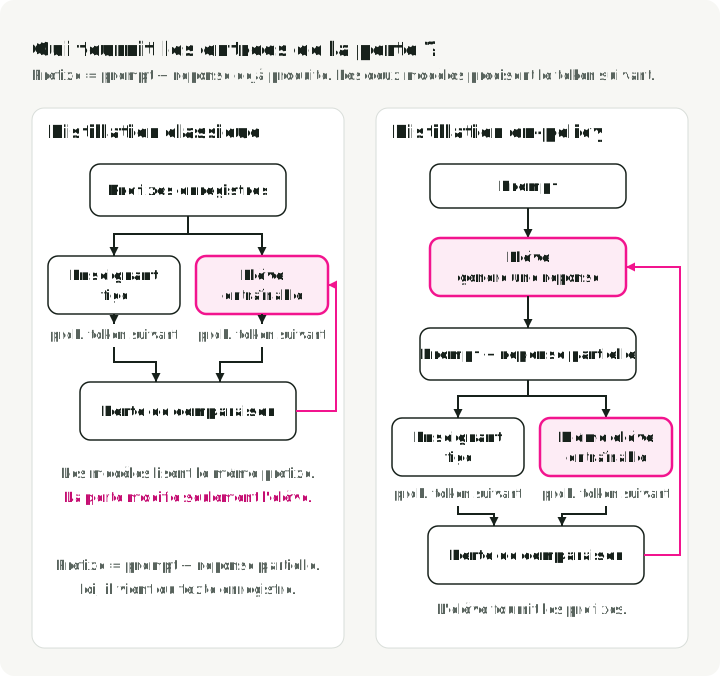
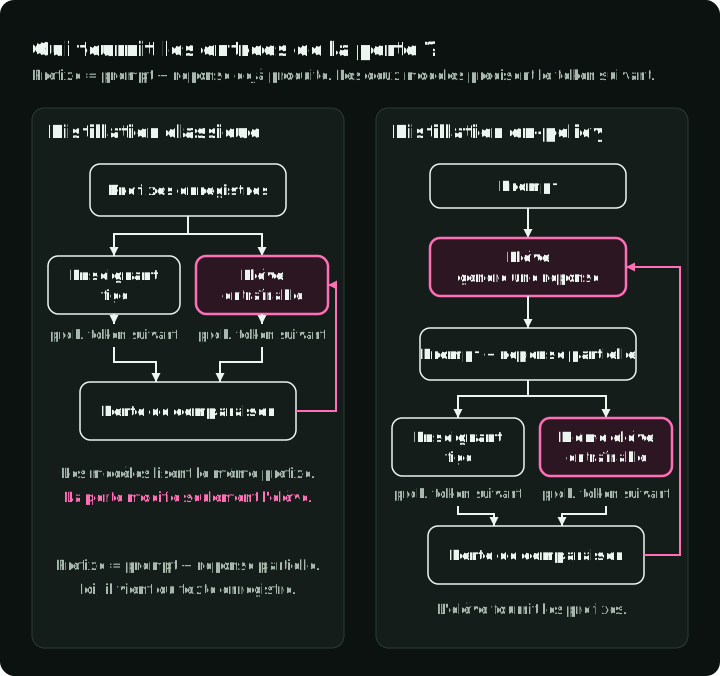
Il existe aussi une distillation sans correspondance des probabilités. Les modèles distillés de DeepSeek-R1, §2.4, ont subi un fine-tuning sur 800 000 exemples sélectionnés au préalable avec DeepSeek-R1. Ils utilisaient une perte supervisée sur du texte enregistré ; il n’était pas nécessaire d’exécuter un enseignant pendant cet entraînement.
La lecture détaillée sur la distillation explique la perte mixte et le réglage de température.
Distillation on-policy : l’élève en premier dans la KL
Un élève qui génère sa propre réponse peut rencontrer des préfixes — prompt et réponse déjà produite — absents du dataset d’entraînement. La distillation on-policy obtient un signal de retour sur le texte que l’élève produit réellement. À partir d’un prompt, l’élève échantillonne une réponse. Un enseignant figé évalue ensuite les mêmes préfixes : l’entraînement compare ainsi les deux modèles là où l’élève a besoin d’indications.
On-policy décrit cette origine du texte d’entraînement. Ce terme n’impose pas à lui seul une perte particulière. Les exemples présentés ici utilisent la KL inverse, avec l’élève en premier :
Pour un prompt fixe , est l’élève aux paramètres entraînables , l’enseignant et une réponse échantillonnée par l’élève. L’expression compare la probabilité que l’élève a attribuée à sa réponse avec celle de l’enseignant. En moyenne sur les réponses de l’élève, elle pénalise l’attribution d’une forte probabilité à un texte que l’enseignant juge peu probable.
Cela diffère d’une demande de reproduire tous les résultats possibles de l’enseignant. Quand un petit élève ne peut pas reproduire la distribution complète de l’enseignant, la KL inverse peut favoriser une concentration sur certaines de ses sorties probables. MiniLLM, §2.1, équation (1), utilise cet objectif. Sa procédure réelle d’entraînement intègre aussi des échantillons de l’enseignant à la génération et ajuste le gradient pour réduire la variance et le biais de longueur ; le schéma montre la configuration on-policy de base, pas toutes les modifications de MiniLLM.
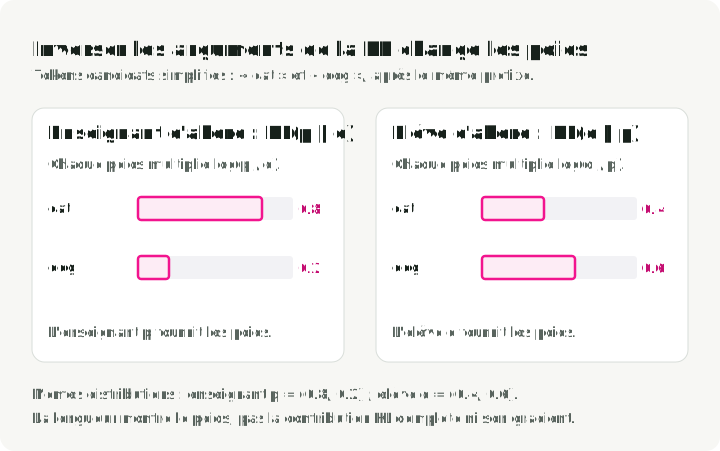
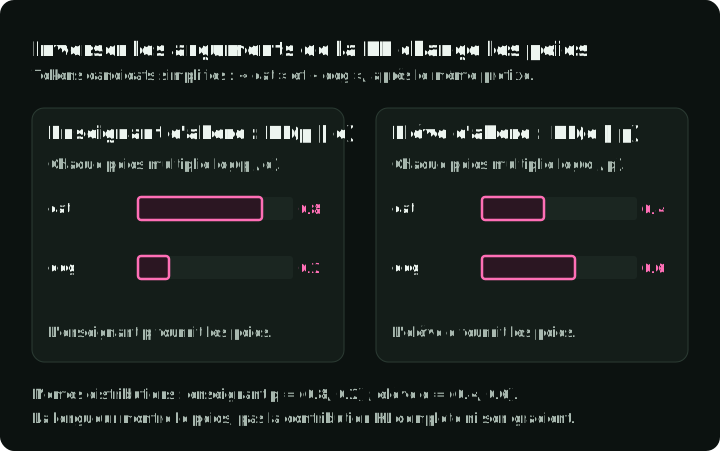
Dans l’exemple simplifié ci-dessous, enseignant et élève attribuent des probabilités différentes à « cat » et « dog » après le même préfixe. La KL multiplie le log-rapport de chaque token par son poids, puis additionne les deux termes. Changer le premier argument transfère le poids le plus élevé de « cat » à « dog ». Les barres montrent les poids, pas les contributions complètes à la perte.
De la KL de séquence à la KL par token
La probabilité d’une réponse se construit à partir des probabilités de ses tokens successifs. À chaque préfixe d’une réponse de l’élève, les deux modèles prédisent le token suivant. On peut donc comparer leurs différences position par position, puis les cumuler sur la réponse. DeepSeek-V4, §5.1.2, équation (29), utilise une distillation par KL inverse de plusieurs modèles enseignants spécialisés vers un élève. Ces enseignants sont des modèles distincts, pas les sous-réseaux experts d’une couche de mélange d’experts.
À la position , notons la probabilité que l’élève attribue au token candidat . Le préfixe contient le prompt et les tokens de réponse précédents ; est la probabilité de l’enseignant au même préfixe. Alors :
est le vocabulaire et la KL du token suivant à un préfixe donné. La somme intérieure se lit « comparer chaque token candidat, pondéré par sa probabilité selon l’élève ». Additionnez ces comparaisons sur les positions, puis moyennez sur les réponses générées par l’élève. L’espérance extérieure échantillonne toujours du texte, même si chaque somme tout le vocabulaire.
Un token échantillonné ou tout le vocabulaire
L’enseignant peut évaluer uniquement le token choisi par l’élève, ou renvoyer les probabilités de tout le vocabulaire. La première option transmet moins d’informations ; la seconde compare tous les tokens suivants possibles à ce préfixe. DeepSeek-V4 signale un entraînement instable avec son estimation à un token et utilise la comparaison sur tout le vocabulaire. La comparaison par token est alors exacte pour un préfixe donné ; les préfixes proviennent toujours de réponses échantillonnées.
Les deux modèles lisent « The animal is a » et renvoient les probabilités ci-dessous. Les lignes mises en évidence entrent dans la perte utilisée pour mettre à jour l’élève. La version sur tout le vocabulaire inclut « dog » et « fox » même si l’élève a choisi « cat » ; la version à un token estime cette comparaison à partir du seul token choisi.
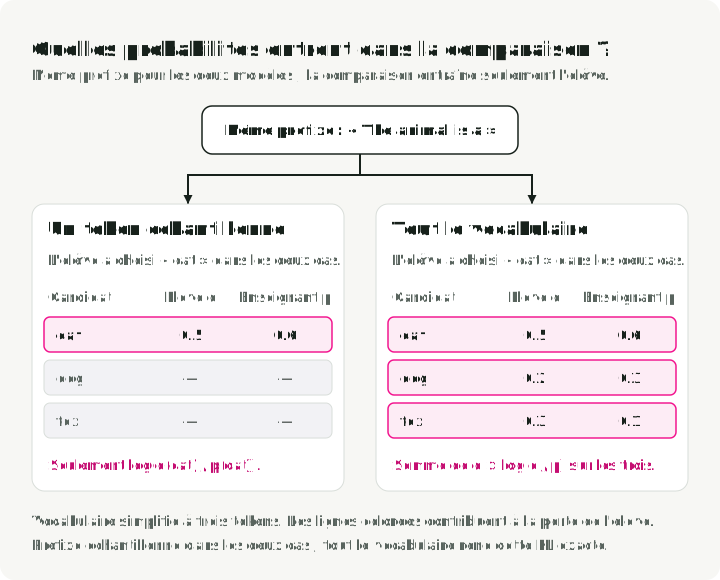
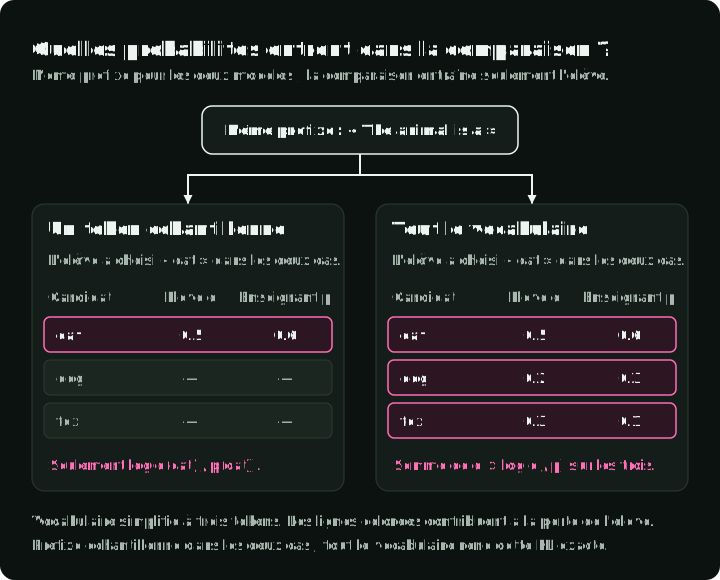
Avec les trois lignes, . Le seul log-rapport de « cat » échantillonné vaut environ . Un échantillon peut être négatif même si la KL complète est positive ou nulle.
La lecture détaillée sur la distillation on-policy traite du passage des séquences aux tokens, des corrections d’échantillonnage et des estimations du gradient.
DPO : une perte logistique sur deux log-rapports
DPO part d’une paire de préférences enregistrée : un prompt, une réponse préférée et une réponse rejetée. La paire peut provenir de jugements humains sur des sorties antérieures du modèle. Pendant l’entraînement, le modèle lit chaque réponse enregistrée token par token et calcule sa probabilité conditionnellement au prompt et aux tokens précédents. L’addition de ces log-probabilités donne la log-probabilité de la réponse. Ce calcul mesure la probabilité du texte selon le modèle ; l’étiquette de préférence enregistrée indique quelle réponse est meilleure.
Dans une procédure RLHF classique, les paires de préférences entraînent d’abord un modèle de récompense distinct, puis l’apprentissage par renforcement entraîne le modèle de langage à partir de cette récompense. DPO, §4, équation (7), entraîne directement le modèle de langage à partir des paires. Un modèle de référence figé évalue les mêmes réponses pour la comparaison. L’entraînement modifie uniquement le modèle courant ; aucun des deux modèles n’a besoin de générer de nouvelles réponses à cette étape.
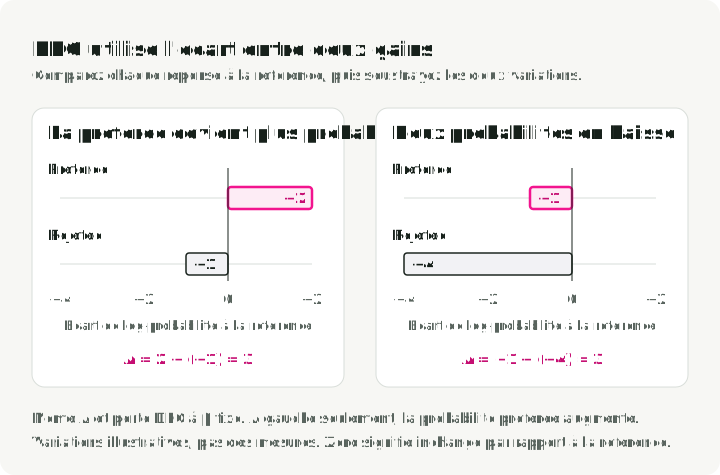
Pour chaque réponse, soustrayez sa log-probabilité de référence de sa log-probabilité courante. Appelons cette variation son gain. DPO compare le gain de la réponse préférée à celui de la réponse rejetée :
Ici, est le prompt, et ses réponses préférée et rejetée, et et les modèles courant et de référence. La sigmoïde transforme un nombre en une valeur dans , et est un facteur d’échelle positif. La dernière ligne se lit « moyenner la perte entre crochets sur les paires enregistrées du dataset ». Augmenter réduit cette perte ; l’entraînement minimise en modifiant les paramètres du modèle courant.
Par exemple, si la réponse préférée gagne 2 en log-probabilité et que la réponse rejetée perd 1, alors . La préférence a évolué dans le sens voulu par rapport à la référence. La perte ne contient pas de terme KL distinct et n’impose aucune distance maximale par rapport à la référence.
La différence seule peut masquer un problème : la réponse préférée peut devenir moins probable tandis que la réponse rejetée devient moins probable encore plus vite. La perte s’améliore quand même. Smaug étudie cet échec ; examinez donc les probabilités de chaque réponse en plus de la perte de préférence.
Les deux cas ci-dessous donnent le même , donc la même perte par paire à fixé. Seul le cas de gauche rend la réponse préférée plus probable qu’avec la référence.
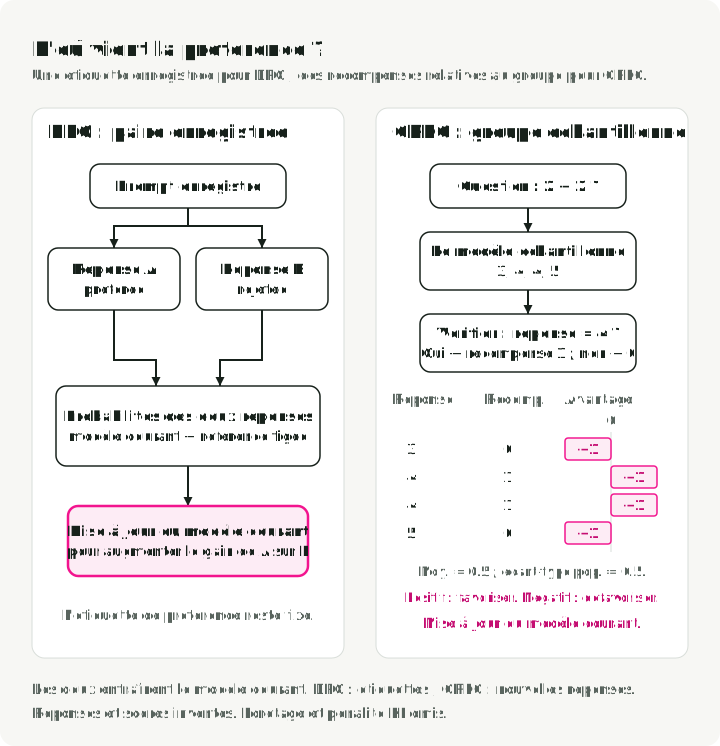
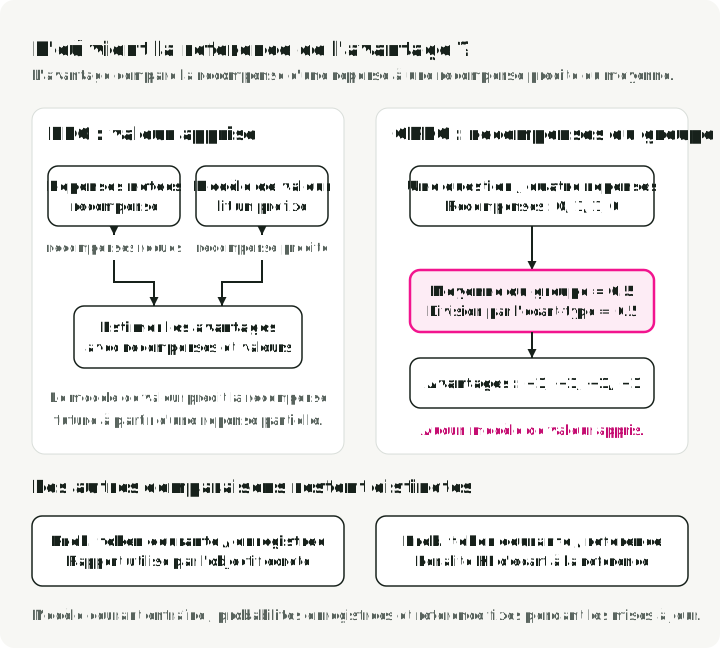
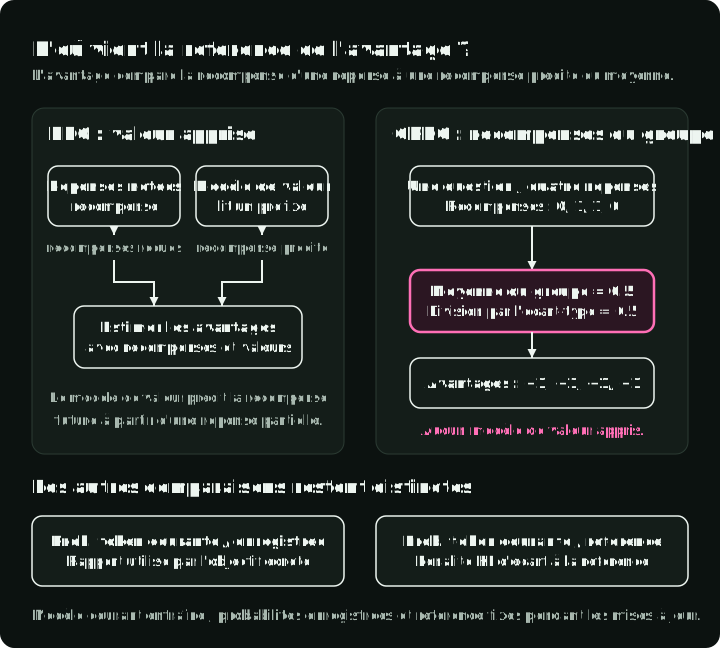
Dans la figure suivante, le signal de retour de DPO est associé à une paire enregistrée. GRPO génère quatre réponses à « 2 + 2 ? » pendant l’entraînement. Un vérificateur de réponses attribue 1 à « 4 » et 0 sinon. Comparer chaque récompense à la moyenne du groupe produit un avantage : un signal positif favorise les tokens de la réponse échantillonnée, et un signal négatif les défavorise. La section suivante présente ce calcul et les limites de son effet.
La lecture détaillée sur DPO dérive la perte à partir de l’objectif régularisé par la récompense et détaille son gradient.
GRPO : l’objectif de PPO avec une référence de groupe
Group Relative Policy Optimization échantillonne plusieurs réponses à la même question, les évalue et compare chaque score à la moyenne du groupe. Une réponse correcte parmi des réponses majoritairement incorrectes reçoit un signal positif ; une réponse incorrecte parmi des réponses correctes reçoit un signal négatif. Pour les mathématiques ou le code, l’évaluation peut utiliser un vérificateur de réponses ou des tests. D’autres tâches peuvent utiliser un modèle de récompense.
DeepSeekMath, §4.1.1, a introduit GRPO comme variante de Proximal Policy Optimization (PPO). DeepSeek-R1, §2.2.1, l’a utilisé ensuite. Le changement principal concerne le calcul de l’avantage, la récompense relative qui guide la mise à jour :
est la récompense de la réponse et le nombre de réponses à une question. Soustraire la moyenne indique quelles réponses ont obtenu un score supérieur ou inférieur à celui du groupe. Diviser par l’écart-type met ces différences à l’échelle. Dans le groupe illustré , la moyenne vaut et l’écart-type de population , ce qui donne les avantages .
Ce qui change par rapport à PPO
PPO entraîne couramment un modèle de valeur distinct pour estimer la récompense future à partir d’une réponse partielle. GRPO utilise plutôt les scores du groupe comme référence de comparaison et n’entraîne donc pas ce modèle de valeur. Il lui faut toujours un signal de récompense, et son objectif d’origine utilise toujours un modèle de référence pour une pénalité KL. Supprimer le modèle de valeur ne supprime pas ces autres rôles.
La comparaison ci-dessous situe le modèle de valeur remplacé. La ligne inférieure montre deux autres entrées de l’entraînement. Le modèle ancien ou d’échantillonnage est la version qui a généré ce lot de réponses ; ses probabilités de tokens enregistrées restent fixes pendant que le modèle courant s’entraîne sur ce lot. Un modèle de référence distinct, également figé pendant ces mises à jour, fournit les probabilités pour la comparaison KL. Les deux comparaisons évaluent le même token après le même préfixe.
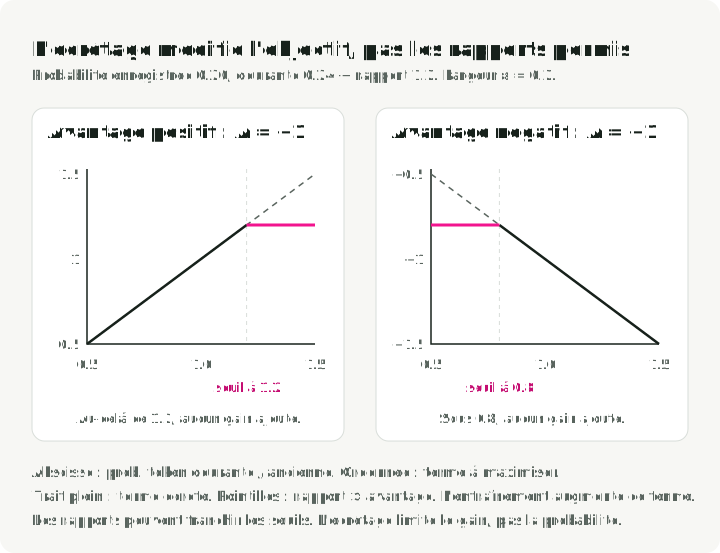
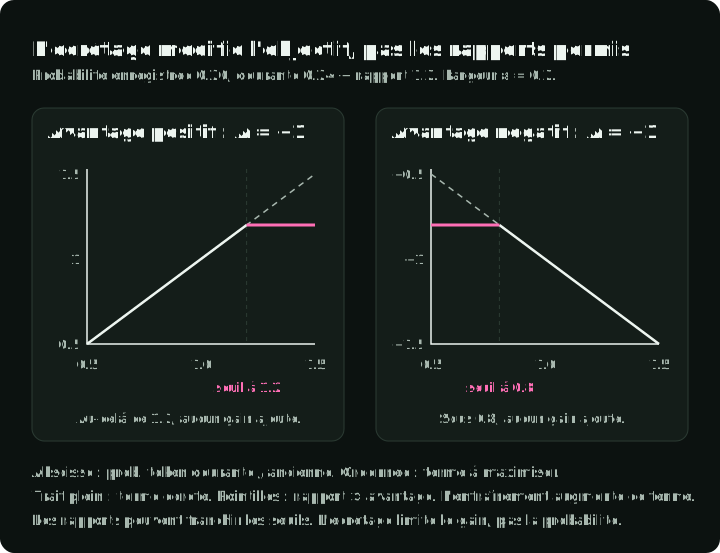
GRPO conserve l’objectif de PPO fondé sur un rapport de probabilités écrêté. Si un token échantillonné avait la probabilité et que le modèle courant lui attribue maintenant au même préfixe, le rapport vaut . L’objectif pondère ce rapport par l’avantage de la réponse. L’entraînement modifie le modèle courant pour augmenter cet objectif ; une pénalité KL distincte décourage les écarts par rapport à la référence.
Pour une réponse échantillonnée, notons le prompt et les tokens de réponse avant la position , et le token à cette position. La partie de l’équation (3) de DeepSeekMath montrée dans le graphique est :
est le modèle courant, la copie d’échantillonnage et l’avantage de groupe de cette réponse. La largeur définit l’intervalle d’écrêtage. Lisez comme « remplacer un rapport hors intervalle par la borne la plus proche », puis comme « prendre le plus petit des deux termes pondérés par l’avantage ». est une contribution à maximiser. GRPO soustrait sa pénalité KL et moyenne sur les tokens des réponses, les réponses des groupes et les questions échantillonnées.
Avec , et , les deux termes valent et , donc . Avec et , ils valent et , donc . Ce sont les deux portions horizontales du graphique.
Le graphique isole la contribution d’un token en maintenant son avantage fixe. Un avantage positif favorise un rapport plus élevé ; un avantage négatif favorise un rapport plus faible. L’écrêtage rend la courbe horizontale lorsqu’une variation favorable cesse d’améliorer ce terme. Il n’impose pas de limite stricte aux probabilités réelles du modèle.
La copie d’échantillonnage et la référence peuvent avoir les mêmes poids au départ, mais servent à des comparaisons différentes. La copie d’échantillonnage est actualisée lors de la collecte d’un nouveau lot ; ses probabilités enregistrées restent le dénominateur pour les mises à jour sur ce lot.
Si toutes les réponses obtiennent la même récompense, aucune préférence relative ne peut être apprise. La formule de l’avantage divise alors zéro par zéro. Les implémentations doivent prévoir une règle pour ce cas, par exemple produire des avantages nuls ; DAPO, §3.2, exclut plutôt ces groupes et en échantillonne d’autres.
La lecture détaillée sur GRPO traite de l’objectif complet, des cas d’écrêtage, des gradients, de l’estimateur KL échantillonné et de l’effet d’une moyenne par réponse ou par token.
Explications détaillées facultatives des équations
Les lectures détaillées liées présentent des dérivations et des vérifications avec de petits nombres. Elles ont été produites avec les compétences pour agents de programmation de paper-math-skills et sont réunies dans paper-math-readings.
Sources et versions
- Hinton et al. Distilling the Knowledge in a Neural Network, §2, équation (1).
- Gu et al. MiniLLM, §2.1–2.2.
- DeepSeek-AI. DeepSeek-V4, §5.1.2, équation (29).
- Rafailov et al. Direct Preference Optimization, §4, équation (7).
- Shao et al. DeepSeekMath, §4.1.1, équations (1)–(4).
- DeepSeek-AI. DeepSeek-R1, §2.2.1 et §2.4.