Leer objetivos de entrenamiento: destilación, DPO y GRPO

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
La destilación, Direct Preference Optimization (DPO) y Group Relative Policy Optimization (GRPO) modifican las probabilidades de un modelo de lenguaje, pero utilizan distintos ejemplos de entrenamiento y señales de evaluación. Esta guía se dirige a ingenieros que quieren entender esas diferencias antes de leer las funciones objetivo completas. Los diagramas muestran de dónde proceden las señales y cómo cambian las comparaciones de probabilidades; las ecuaciones expresan las operaciones correspondientes.
En el fine-tuning supervisado habitual, el modelo aprende a predecir el siguiente token en ejemplos guardados. Los métodos siguientes cambian la señal de evaluación: un profesor aporta probabilidades, un par de preferencias indica qué respuesta es mejor o una recompensa puntúa respuestas muestreadas durante el entrenamiento. Una política es simplemente el modelo que genera respuestas. Todos los logaritmos que aparecen a continuación son naturales.
La parte 1 explica cómo leer una ecuación e incluye una referencia de notación. Aquí, cada sección explica los términos que necesita y puede leerse de forma independiente.
Destilación clásica: una temperatura en ambas funciones softmax
Una etiqueta de entrenamiento indica el resultado correcto: para predecir el siguiente token, es el siguiente token de un ejemplo guardado. Un modelo profesor aporta más información: sus probabilidades para cada token candidato, incluidas las alternativas plausibles. La destilación entrena a un alumno más pequeño para que reproduzca esas probabilidades. El entrenamiento reduce una pérdida numérica modificando los parámetros del alumno; los del profesor permanecen fijos.
El artículo sobre destilación de Hinton et al., §2, suaviza las probabilidades de ambos modelos antes de compararlas. Se divide cada logit, la puntuación sin normalizar anterior a softmax, por una temperatura :
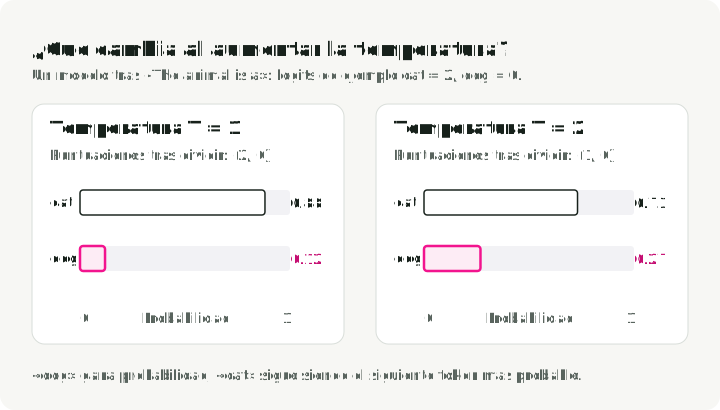
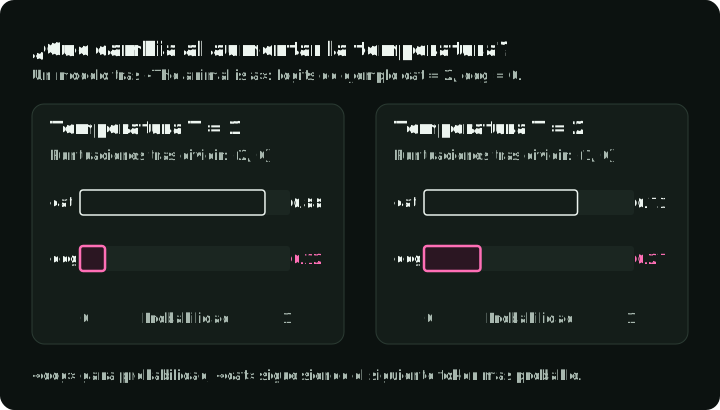
Aquí es la puntuación del candidato y su probabilidad. Supongamos que un modelo de ejemplo solo tiene dos posibles tokens siguientes, «cat» y «dog», y les asigna las puntuaciones tras leer «The animal is a». Con , las probabilidades son aproximadamente ; con , pasan a ser . La puntuación menor contribuye ahora más a la comparación. Profesor y alumno usan la misma temperatura.
Las barras muestran cómo las mismas dos puntuaciones producen una distribución menos concentrada al aumentar la temperatura.
La pérdida de entrenamiento combina la pérdida habitual de las etiquetas con una pérdida para reproducir la distribución suavizada del profesor. Denotamos por las probabilidades del profesor y por las del alumno a temperatura . Para una entrada etiquetada:
Aquí es la pérdida, es el siguiente token correcto y determina la mezcla. Los superíndices entre paréntesis indican temperaturas, no potencias. El primer término se lee como «penalizar una probabilidad baja del token correcto con ». El segundo se lee como «reproducir las probabilidades suavizadas del profesor». El entrenamiento promedia estas pérdidas sobre las entradas guardadas y modifica solo al alumno.
es la divergencia KL del profesor al alumno . Mide en qué difieren dos distribuciones de probabilidad: vale cero cuando coinciden. La primera distribución aporta los pesos de la comparación, por lo que los resultados probables según el profesor reciben más peso. Hinton et al. describen un término de ajuste basado en entropía cruzada; esta forma KL resta una constante que solo depende del profesor y produce los mismos gradientes para el alumno.
El factor compensa aproximadamente los gradientes menores a temperaturas más altas. Es una configuración de entrenamiento; el alumno desplegado suele volver a para esta función softmax.
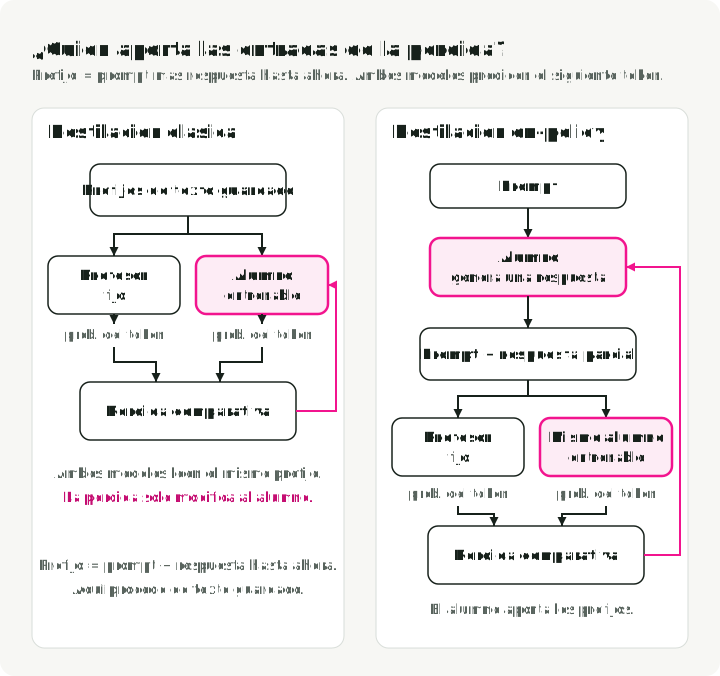
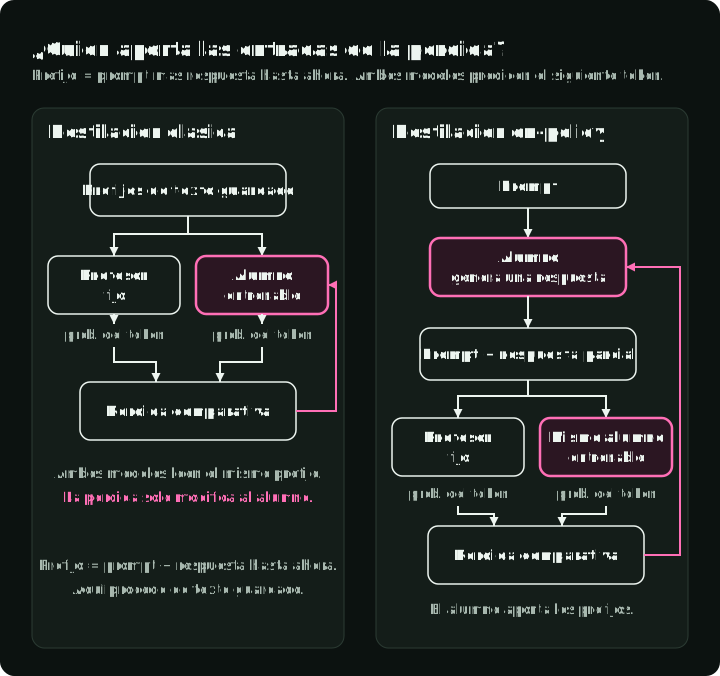
Un prefijo es el texto disponible antes del siguiente token: el prompt más los tokens de respuesta generados hasta ese momento. Por ejemplo, «The animal is a» es el prefijo anterior a «cat». En la figura, ambos modelos leen el mismo prefijo y producen probabilidades del siguiente token. A la izquierda, los prefijos proceden de ejemplos guardados. A la derecha, proceden de respuestas que el alumno genera durante el entrenamiento. Ambos procedimientos usan la pérdida de comparación para actualizar solo al alumno.
También existe destilación sin ajuste de probabilidades. Los modelos destilados de DeepSeek-R1, §2.4, se ajustaron con 800.000 ejemplos seleccionados previamente con DeepSeek-R1. Usaron una pérdida supervisada sobre texto guardado; no era necesario ejecutar un profesor durante ese entrenamiento.
La lectura detallada sobre destilación explica la pérdida combinada y el escalado de temperatura.
Destilación on-policy: el alumno ocupa el primer lugar en la KL
Un alumno que genera su propia respuesta puede alcanzar prefijos, el prompt más la respuesta hasta ese momento, que nunca aparecieron en el dataset de entrenamiento. La destilación on-policy obtiene señales de evaluación sobre el texto que el alumno produce realmente. Dado un prompt, el alumno muestrea una respuesta. Un profesor con parámetros fijos evalúa después los mismos prefijos, de modo que el entrenamiento compara los dos modelos donde el alumno necesita orientación.
On-policy describe esa procedencia del texto de entrenamiento. Por sí solo, no prescribe una pérdida concreta. Los ejemplos de aquí utilizan KL inversa, con el alumno en primer lugar:
Para un prompt fijo , es el alumno con parámetros entrenables , es el profesor e es una respuesta muestreada del alumno. La expresión compara la probabilidad que el alumno asignó a su respuesta con la del profesor. Promediada sobre las respuestas del alumno, penaliza que este asigne una probabilidad alta a texto que el profesor considera poco probable.
Esto difiere de pedir al alumno que cubra todos los resultados que podría producir el profesor. Cuando un alumno pequeño no puede reproducir la distribución completa del profesor, la KL inversa puede favorecer que se concentre en algunas de las salidas probables del profesor. MiniLLM, §2.1, ecuación (1), utiliza este objetivo. Su procedimiento de entrenamiento real también incorpora muestras del profesor en la generación y ajusta el gradiente para reducir la varianza y el sesgo de longitud; el diagrama muestra la configuración on-policy básica, no todas las modificaciones de MiniLLM.
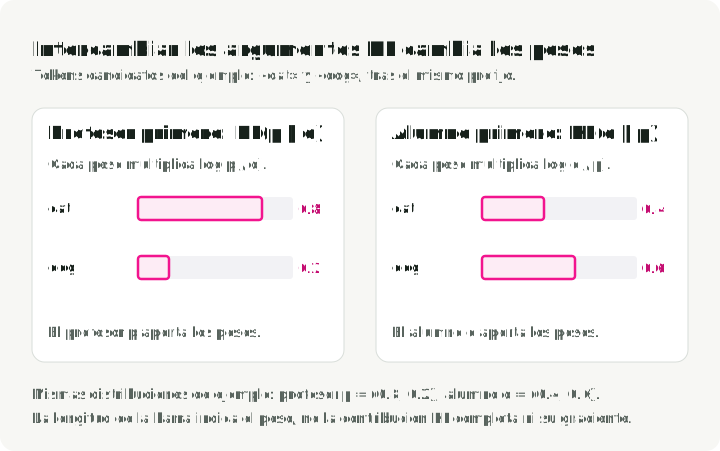
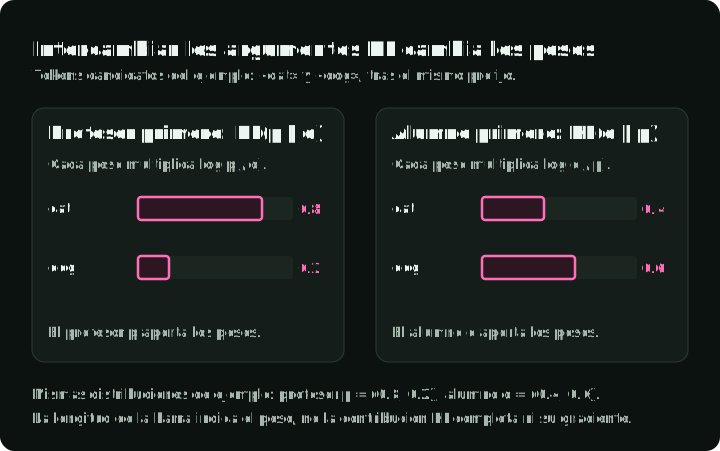
En el ejemplo siguiente, profesor y alumno asignan distintas probabilidades a «cat» y «dog» tras el mismo prefijo. La KL multiplica el logaritmo del cociente de cada token por su peso y suma los dos términos. Al cambiar el primer argumento, el peso mayor pasa de «cat» a «dog». Las barras muestran los pesos, no las contribuciones completas a la pérdida.
De la KL de secuencia a la KL de token
La probabilidad de una respuesta se construye a partir de sus probabilidades del siguiente token. En cada prefijo de una respuesta del alumno, ambos modelos predicen el siguiente token. Por tanto, sus diferencias pueden compararse posición a posición y acumularse a lo largo de la respuesta. DeepSeek-V4, §5.1.2, ecuación (29), usa destilación mediante KL inversa de varios modelos profesores especializados a un único alumno. Estos profesores son modelos separados, no las subredes expertas de una capa de mezcla de expertos.
En la posición , sea la probabilidad del alumno para el token candidato . El prefijo contiene el prompt y los tokens anteriores de la respuesta ; es la probabilidad del profesor en ese mismo prefijo. Entonces:
es el vocabulario y es la KL del siguiente token en un prefijo. La suma interior se lee como «comparar cada token candidato, ponderado por la probabilidad del alumno». Estas comparaciones se suman sobre las posiciones y después se promedian sobre las respuestas que genera el alumno. La esperanza exterior sigue muestreando texto, aunque cada sume todo el vocabulario.
Un token muestreado o todo el vocabulario
El profesor puede puntuar solo el token elegido por el alumno o devolver probabilidades para todo el vocabulario. La primera opción transfiere menos información; la segunda compara todos los posibles tokens siguientes en ese prefijo. DeepSeek-V4 informa de inestabilidad en el entrenamiento con su estimación de un token y utiliza la comparación del vocabulario completo. Así, la comparación de tokens es exacta en un prefijo dado; los prefijos siguen procediendo de respuestas muestreadas.
Ambos modelos leen «The animal is a» y devuelven las probabilidades que se muestran a continuación. Las filas resaltadas entran en la pérdida usada para actualizar al alumno. La versión de vocabulario completo incluye «dog» y «fox», aunque el alumno eligió «cat»; la versión de un token estima esa comparación a partir del token elegido únicamente.
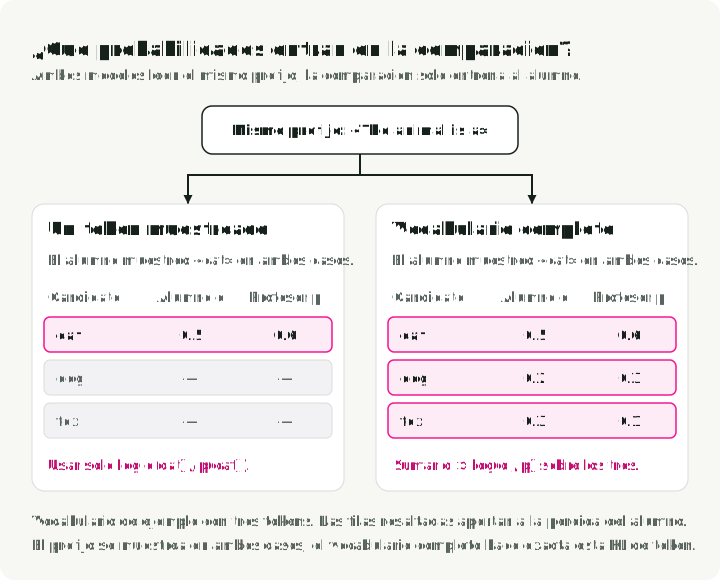
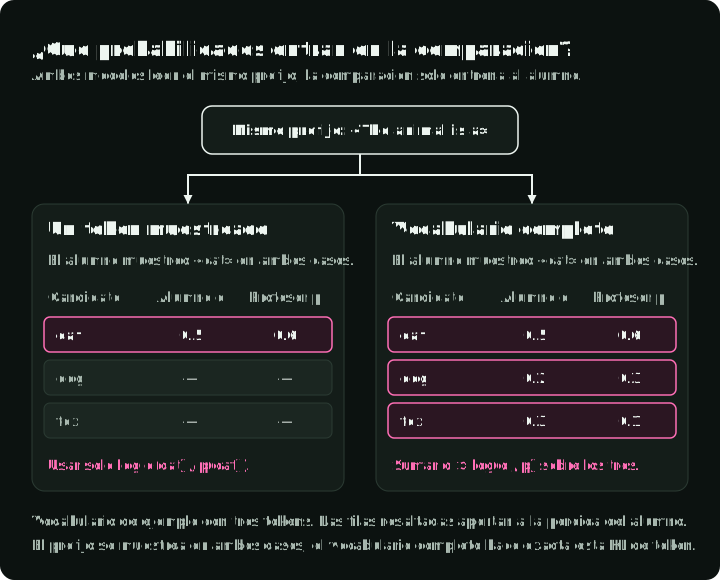
Con las tres filas, . El logaritmo del cociente de «cat» muestreado por sí solo es aproximadamente . Una muestra puede ser negativa aunque la KL completa no lo sea.
La lectura detallada sobre on-policy aborda la derivación de secuencia a token, las correcciones de muestreo y las estimaciones del gradiente.
DPO: una pérdida logística sobre dos logaritmos de cocientes
DPO comienza con un par de preferencias guardado: un prompt, una respuesta preferida y una respuesta rechazada. El par puede proceder de evaluaciones humanas de salidas anteriores del modelo. Durante el entrenamiento, el modelo lee cada respuesta guardada token a token y registra su probabilidad dados el prompt y los tokens anteriores. La suma de esos logaritmos de probabilidades da el logaritmo de la probabilidad de la respuesta. Esto puntúa lo probable que es el texto según el modelo; la etiqueta de preferencia guardada indica qué respuesta es mejor.
En un procedimiento RLHF convencional, los pares de preferencias entrenan primero un modelo de recompensa separado, y después el aprendizaje por refuerzo entrena el modelo de lenguaje con esa recompensa. DPO, §4, ecuación (7), entrena en cambio el modelo de lenguaje directamente con los pares. Un modelo de referencia con parámetros fijos puntúa esas mismas respuestas para compararlas. El entrenamiento solo modifica el modelo actual; ninguno de los dos necesita generar respuestas nuevas en este paso.
Para cada respuesta, se resta el logaritmo de su probabilidad de referencia del logaritmo de su probabilidad actual. Llamaremos ganancia a este cambio. DPO compara la ganancia de la respuesta preferida con la de la rechazada:
Aquí es el prompt, e son sus respuestas preferida y rechazada, y y son los modelos actual y de referencia. La sigmoide transforma un número en un valor de , y es una escala positiva. La última línea se lee como «promediar la pérdida del par entre corchetes sobre los pares guardados del dataset ». Aumentar reduce esa pérdida; el entrenamiento minimiza modificando los parámetros del modelo actual.
Por ejemplo, si la respuesta preferida gana 2 en logaritmo de probabilidad y la rechazada pierde 1, entonces . La preferencia ha cambiado en la dirección deseada respecto a la referencia. La pérdida no tiene un término KL separado ni impone una distancia máxima a la referencia.
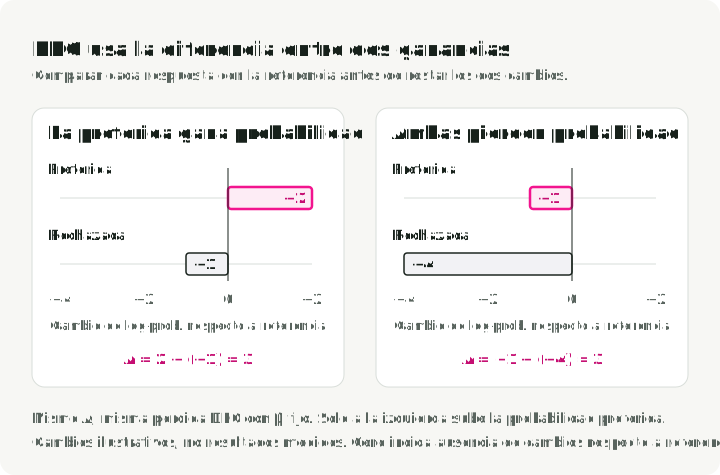
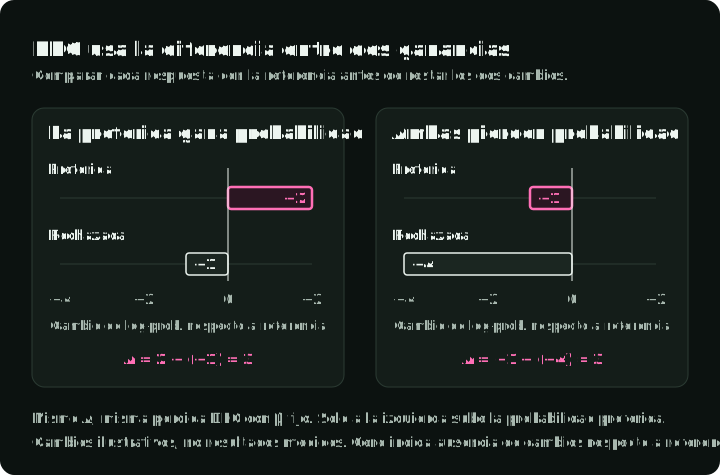
La diferencia por sí sola puede ocultar un problema: la respuesta preferida puede volverse menos probable mientras que la rechazada se vuelve menos probable aún más deprisa. La pérdida sigue mejorando. Smaug estudia este fallo, por lo que conviene examinar las probabilidades individuales de las respuestas además de la pérdida de preferencias.
Los dos casos siguientes dan el mismo y, por tanto, la misma pérdida del par con un fijo. Solo el caso de la izquierda hace que la respuesta preferida sea más probable que con la referencia.
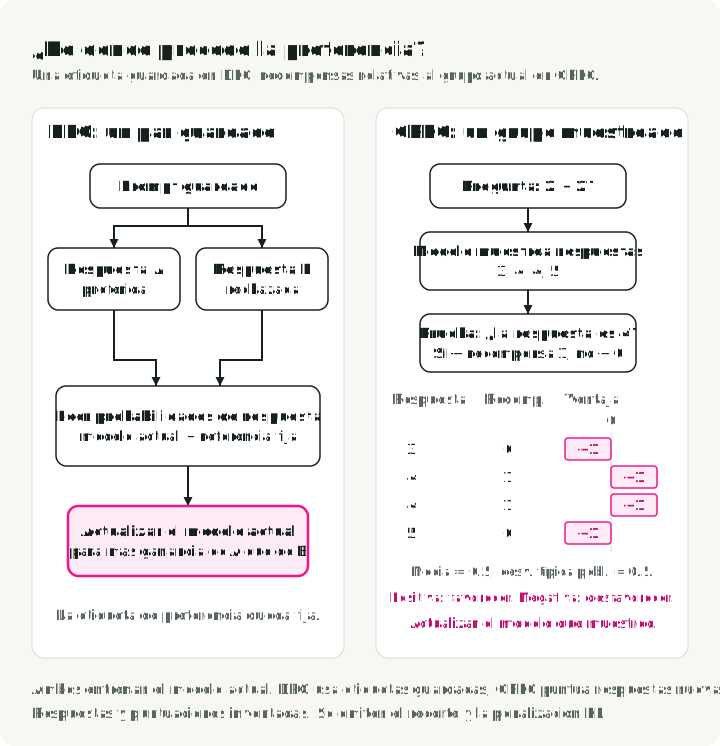
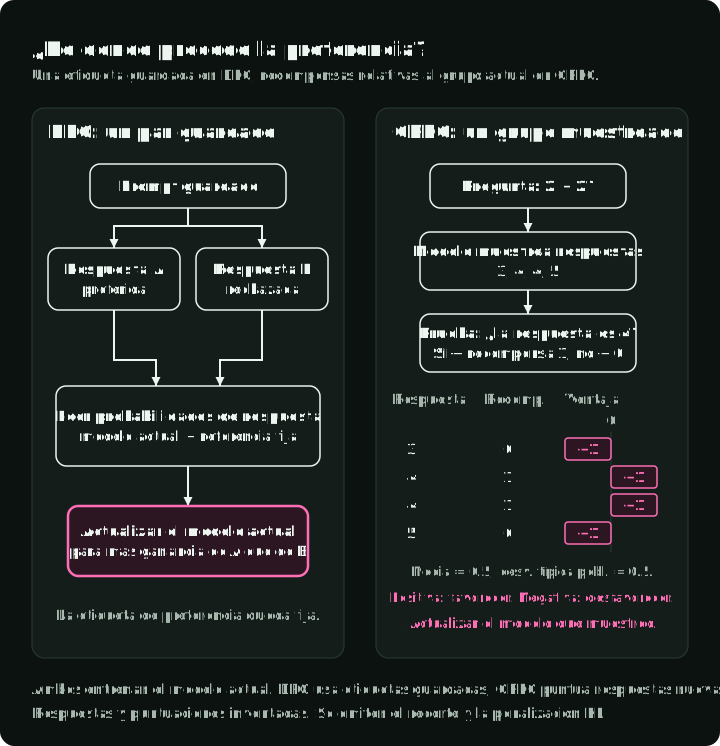
En la figura siguiente, la señal de DPO está asociada a un par guardado. GRPO genera cuatro respuestas a «2 + 2?» durante el entrenamiento. Un verificador de respuestas asigna 1 a «4» y 0 al resto. Comparar cada recompensa con la media del grupo produce una ventaja: una señal positiva favorece los tokens de la respuesta muestreada, y una negativa los desfavorece. La siguiente sección muestra ese cálculo y los límites de su efecto.
La lectura detallada sobre DPO deriva la pérdida a partir del objetivo regularizado de recompensa y desarrolla su gradiente.
GRPO: el objetivo de PPO con una referencia de grupo
Group Relative Policy Optimization muestrea varias respuestas a la misma pregunta, las puntúa y compara cada puntuación con la media del grupo. Una respuesta correcta entre respuestas mayoritariamente incorrectas recibe una señal positiva; una incorrecta entre respuestas correctas recibe una señal negativa. Para matemáticas o código, la puntuación puede obtenerse con un verificador de respuestas o con pruebas. Otras tareas pueden utilizar un modelo de recompensa.
DeepSeekMath, §4.1.1, presentó GRPO como variante de Proximal Policy Optimization (PPO). DeepSeek-R1, §2.2.1, lo utilizó después. El cambio principal está en cómo calcula la ventaja, la recompensa relativa que guía la actualización:
es la recompensa de la respuesta y es el número de respuestas a una pregunta. Restar la media indica qué respuestas puntuaron por encima o por debajo del grupo. Dividir por la desviación típica escala esas diferencias. En el grupo ilustrado , la media es y la desviación típica poblacional es , lo que da ventajas .
Qué cambia respecto a PPO
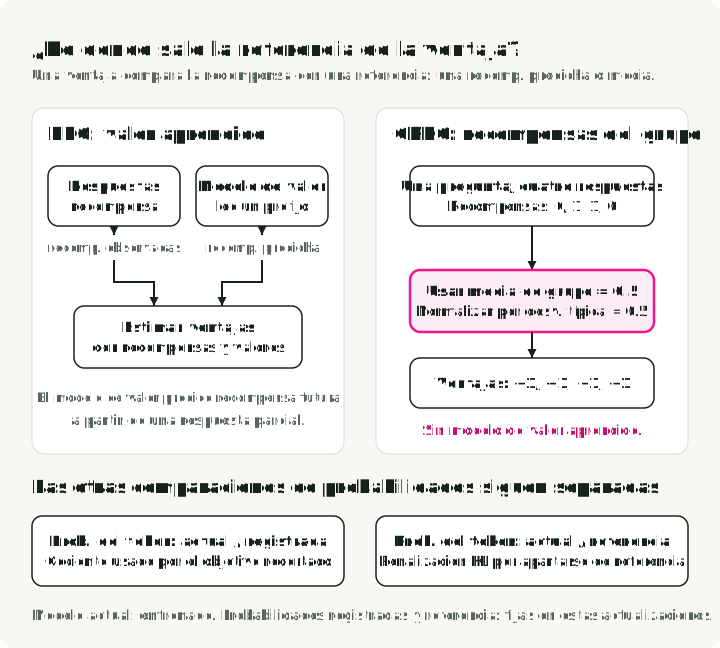
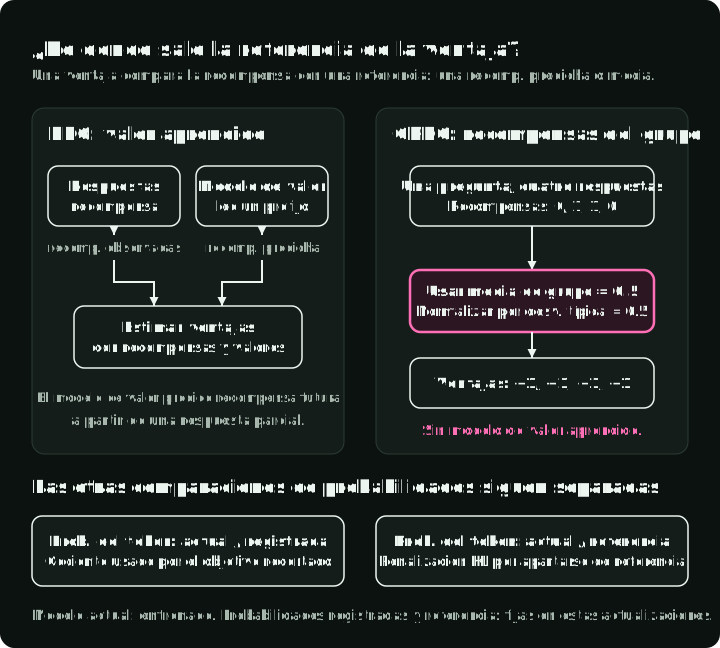
PPO suele entrenar un modelo de valor separado para estimar la recompensa futura a partir de una respuesta parcial. GRPO utiliza en su lugar las puntuaciones del grupo como referencia, por lo que no entrena ese modelo de valor. Sigue necesitando señales de recompensa y su objetivo original sigue usando un modelo de referencia para una penalización KL. Eliminar el modelo de valor no elimina esas otras funciones.
La comparación siguiente identifica el modelo de valor que se sustituye. Su fila inferior muestra otras dos entradas del entrenamiento. El modelo anterior o de muestreo es la versión que generó este lote de respuestas; sus probabilidades de tokens registradas permanecen fijas mientras el modelo actual se entrena con ese lote. Un modelo de referencia separado, que también permanece fijo durante estas actualizaciones, aporta probabilidades para la comparación KL. Ambas comparaciones puntúan el mismo token tras el mismo prefijo.
GRPO conserva el objetivo de PPO con recorte del cociente de probabilidades. Si un token muestreado tenía probabilidad y el modelo actual le asigna ahora en el mismo prefijo, el cociente es . El objetivo pondera este cociente por la ventaja de la respuesta. El entrenamiento modifica el modelo actual para aumentar este objetivo, mientras una penalización KL separada desincentiva que se aparte de la referencia.
Para una respuesta muestreada, denota el prompt más los tokens de respuesta anteriores a la posición , e el token de esa posición. La parte de la ecuación (3) de DeepSeekMath mostrada en el gráfico es:
es el modelo actual, la copia de muestreo y la ventaja de grupo de esta respuesta. La anchura establece el intervalo de recorte. se lee como «sustituir un cociente fuera del intervalo por el extremo más cercano» y, después, como «tomar el menor de los dos términos ponderados por la ventaja». es una contribución que se maximiza. GRPO resta su penalización KL y promedia sobre los tokens de cada respuesta, las respuestas de cada grupo y las preguntas muestreadas.
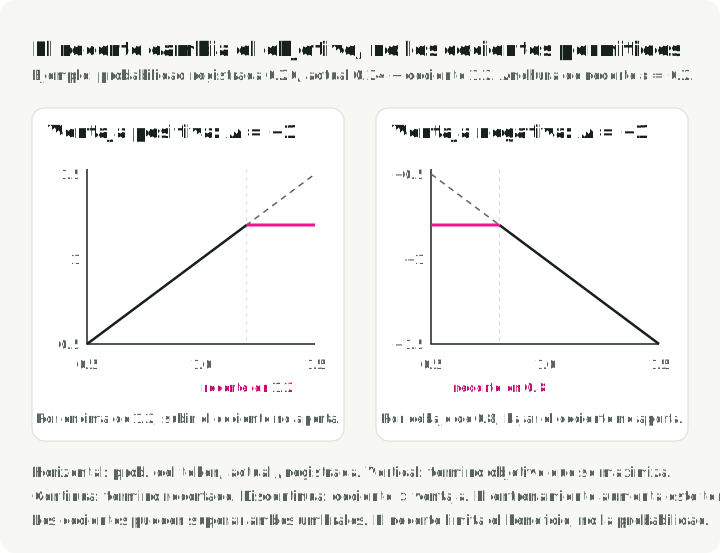
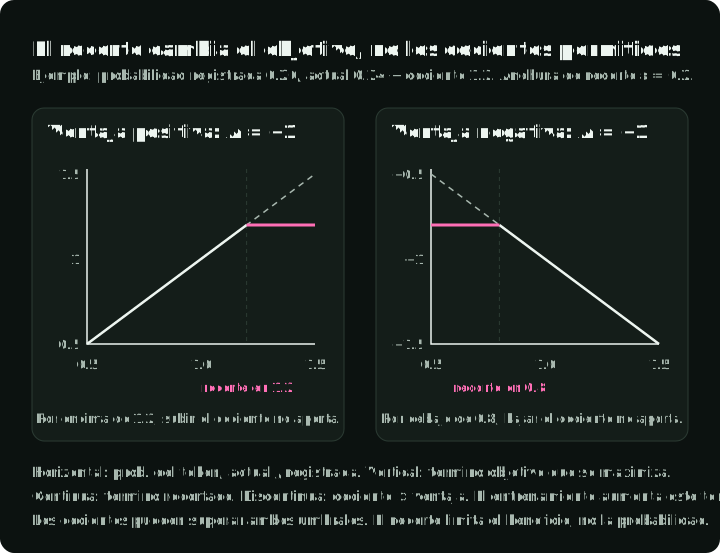
Con , y , los dos términos son y , por lo que . Con y , son y , por lo que . Son los dos tramos planos del gráfico.
El gráfico muestra por separado la contribución de un token manteniendo fija su ventaja. Una ventaja positiva favorece un cociente mayor; una negativa favorece uno menor. El recorte hace que la línea sea plana donde un cambio favorable deja de mejorar este término. No impone un límite estricto a las probabilidades reales del modelo.
La copia de muestreo y la referencia pueden empezar con los mismos pesos, pero sirven para comparaciones distintas. La copia de muestreo se actualiza al recopilar un lote nuevo; sus probabilidades registradas siguen siendo el denominador de las actualizaciones de ese lote.
Si todas las respuestas reciben la misma recompensa, no hay ninguna preferencia relativa que aprender. La fórmula de ventaja divide entonces cero entre cero. Las implementaciones necesitan una regla para este caso, como producir ventajas nulas; DAPO, §3.2, excluye en cambio estos grupos y muestrea otros en su lugar.
La lectura detallada sobre GRPO aborda el objetivo completo, los casos de recorte, los gradientes, el estimador KL muestreado y el efecto de promediar por respuesta o por token.
Explicaciones opcionales de las ecuaciones
Las lecturas detalladas enlazadas incluyen derivaciones y comprobaciones con números pequeños. Se elaboraron con las habilidades de agentes de programación de paper-math-skills y se recopilan en paper-math-readings.
Fuentes y versiones
- Hinton et al. Distilling the Knowledge in a Neural Network, §2, ecuación (1).
- Gu et al. MiniLLM, §2.1–2.2.
- DeepSeek-AI. DeepSeek-V4, §5.1.2, ecuación (29).
- Rafailov et al. Direct Preference Optimization, §4, ecuación (7).
- Shao et al. DeepSeekMath, §4.1.1, ecuaciones (1)–(4).
- DeepSeek-AI. DeepSeek-R1, §2.2.1 y §2.4.