Trainingsdoelen lezen: distillatie, DPO en GRPO

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Distillatie, Direct Preference Optimization (DPO) en Group Relative Policy Optimization (GRPO) veranderen alle drie de kansen van een taalmodel, maar gebruiken verschillende trainingsvoorbeelden en feedback. Deze gids is voor ingenieurs die die verschillen willen begrijpen voordat ze de volledige doelfuncties lezen. De diagrammen tonen waar de feedback vandaan komt en hoe die kansvergelijkingen verandert; de vergelijkingen geven de bijbehorende bewerkingen.
Bij gewone supervised fine-tuning leert het model de volgende token in opgeslagen voorbeelden te voorspellen. De onderstaande methoden veranderen de feedback: een teacher levert kansen, een voorkeurspaar geeft aan welk antwoord beter is, of een beloning beoordeelt antwoorden die tijdens de training worden gesampled. Een policy is gewoon het model dat antwoorden genereert. Alle logaritmen hieronder zijn natuurlijke logaritmen.
Deel 1 legt uit hoe je een vergelijking leest en bevat een notatieoverzicht. Hier legt elke sectie de benodigde termen uit en kun je die zelfstandig lezen.
Klassieke distillatie: een temperatuur voor beide softmaxfuncties
Een trainingslabel geeft de juiste uitkomst aan: bij next-token prediction is dat de volgende token in een opgeslagen voorbeeld. Een teachermodel levert meer informatie: de kansen voor elke kandidaat-token, inclusief aannemelijke alternatieven. Distillatie traint een kleinere student om die kansen te benaderen. De training verlaagt een numerieke loss door de parameters van de student te veranderen; die van de teacher blijven vast.
Het distillatieartikel van Hinton et al., §2, maakt de kansverdelingen van beide models minder geconcentreerd voordat het ze vergelijkt. Deel elke logit — de ruwe score vóór softmax — door een temperatuur :
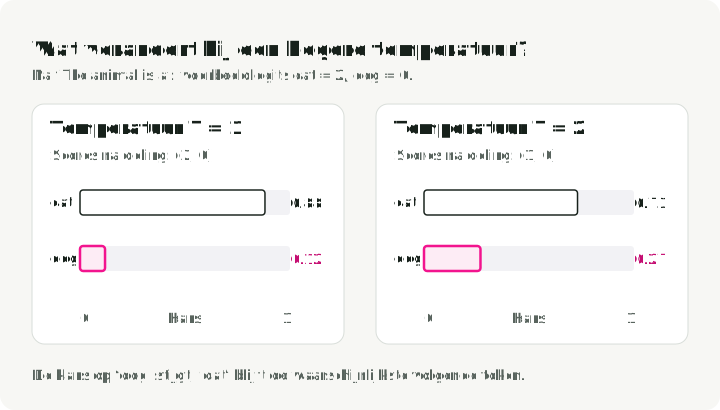
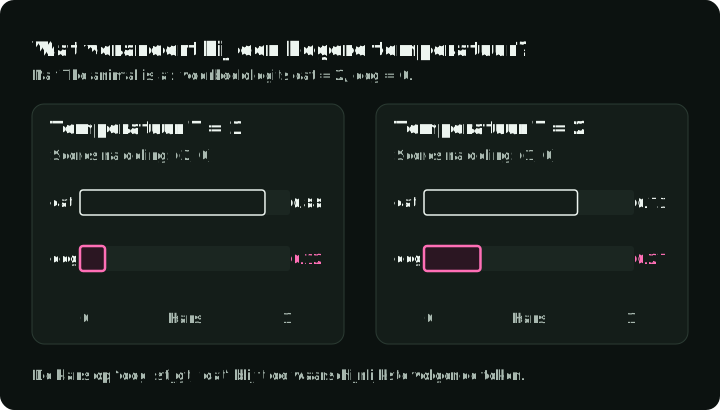
Hier is de score van kandidaat en de kans ervan. Stel dat een eenvoudig voorbeeldmodel maar twee mogelijke volgende tokens heeft, ‘cat’ en ‘dog’, en die de scores geeft na het lezen van ‘The animal is a’. Bij zijn de kansen ongeveer ; bij worden ze . De kleinere score draagt nu meer bij aan de vergelijking. Teacher en student gebruiken dezelfde temperatuur.
De balken laten zien hoe dezelfde twee scores een minder geconcentreerde verdeling opleveren als de temperatuur stijgt.
De trainingsloss combineert de gewone label-loss met een loss om de afgevlakte teacherverdeling te benaderen. Schrijf voor de kansen van de teacher en voor die van de student bij temperatuur . Voor één gelabelde invoer:
Hier is de loss, de juiste volgende token en bepaalt de mengverhouding. Superscripts tussen haakjes geven temperaturen aan, geen machten. Lees de eerste term als ‘bestraf een lage kans op de juiste token bij ’. Lees de tweede als ‘benader de afgevlakte kansen van de teacher’. De training neemt het gemiddelde van deze losses over de opgeslagen invoer en verandert alleen de student.
is de KL-divergentie van teacher naar student . Die meet hoe twee kansverdelingen verschillen: nul als ze overeenkomen. De eerste verdeling levert de gewichten in de vergelijking, dus uitkomsten die volgens de teacher waarschijnlijk zijn, krijgen meer gewicht. Hinton et al. beschrijven een matchingterm met cross-entropy; deze KL-vorm trekt een constante af die alleen van de teacher afhangt en geeft dezelfde gradients voor de student.
De factor compenseert bij benadering voor kleinere gradients bij hogere temperaturen. Dit is een trainingsinstelling; de gedeployde student gaat voor deze softmax gewoonlijk terug naar .
Een prefix is de tekst die al beschikbaar is vóór de volgende token: de prompt plus de antwoordtokens tot dan toe. Zo is ‘The animal is a’ de prefix vóór ‘cat’. In de figuur lezen beide models dezelfde prefix en produceren ze kansen voor de volgende token. Links komen de prefixes uit opgeslagen voorbeelden. Rechts komen ze uit antwoorden die de student tijdens de training genereert. Beide routes gebruiken de vergelijkingsloss om alleen de student bij te werken.
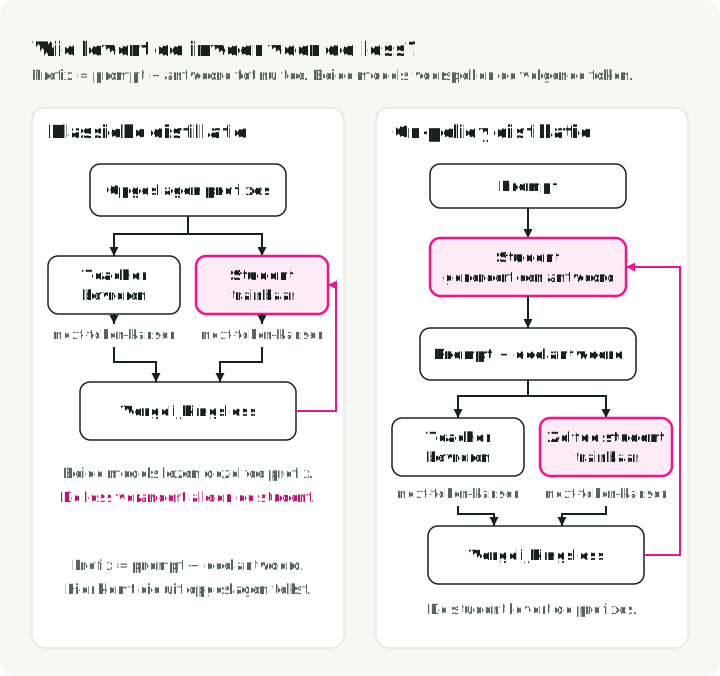
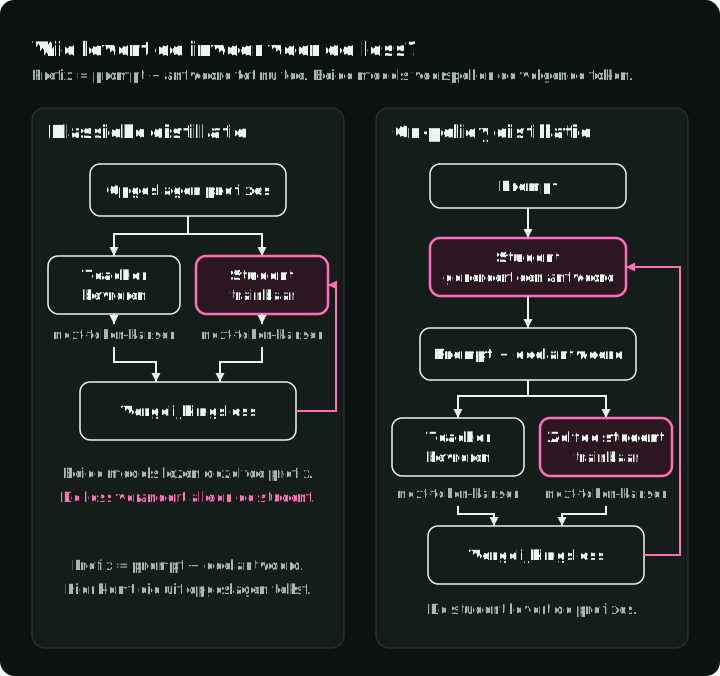
Er bestaat ook distillatie zonder kansmatching. De gedistilleerde models van DeepSeek-R1, §2.4, kregen fine-tuning op 800.000 voorbeelden die vooraf met DeepSeek-R1 waren samengesteld. Ze gebruikten een supervised loss op opgeslagen tekst; tijdens die training hoefde geen teacher te draaien.
De uitgebreide uitleg over distillatie behandelt de gemengde loss en temperatuurschaling.
On-policy distillatie: de student staat vooraan in de KL
Een student die zelf antwoorden genereert, kan prefixes bereiken — prompt plus antwoord tot dan toe — die nooit in de trainingsdataset voorkwamen. On-policy distillatie verzamelt feedback op tekst die de student daadwerkelijk produceert. Bij een prompt samplet de student een antwoord. Een bevroren teacher beoordeelt vervolgens dezelfde prefixes, zodat de training beide models vergelijkt waar de student begeleiding nodig heeft.
On-policy beschrijft die herkomst van de trainingstekst. Het schrijft op zichzelf geen bepaalde loss voor. De voorbeelden hier gebruiken reverse KL, met de student vooraan:
Voor een vaste prompt is de student met trainbare parameters , de teacher en een antwoord dat de student heeft gesampled. De uitdrukking vergelijkt de kans die de student aan zijn antwoord gaf met de kans van de teacher. Gemiddeld over studentantwoorden bestraft ze de student voor een hoge kans op tekst die de teacher onwaarschijnlijk vindt.
Dat verschilt van de eis dat de student elke mogelijke uitkomst van de teacher moet kunnen reproduceren. Als een kleine student de volledige verdeling van de teacher niet kan benaderen, kan reverse KL concentratie op enkele waarschijnlijke teacheruitkomsten bevorderen. MiniLLM, §2.1, vergelijking (1), gebruikt deze doelfunctie. De daadwerkelijke trainingsprocedure mengt ook teachersamples door de generatie en past de gradient aan om variantie en lengtebias te verminderen; het diagram toont de basisopzet van on-policy training, niet alle wijzigingen van MiniLLM.
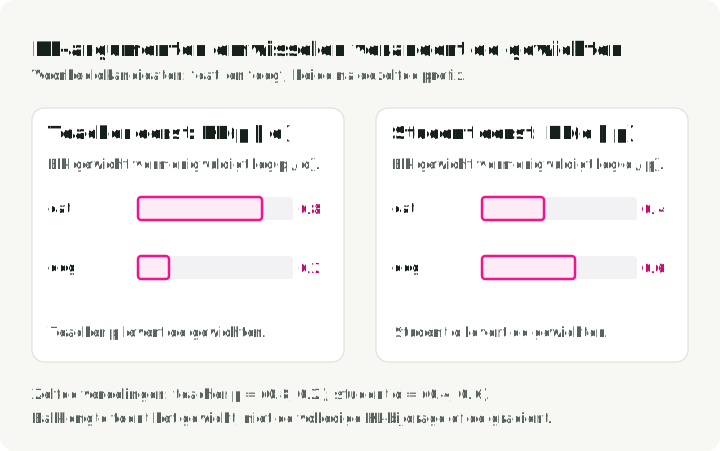
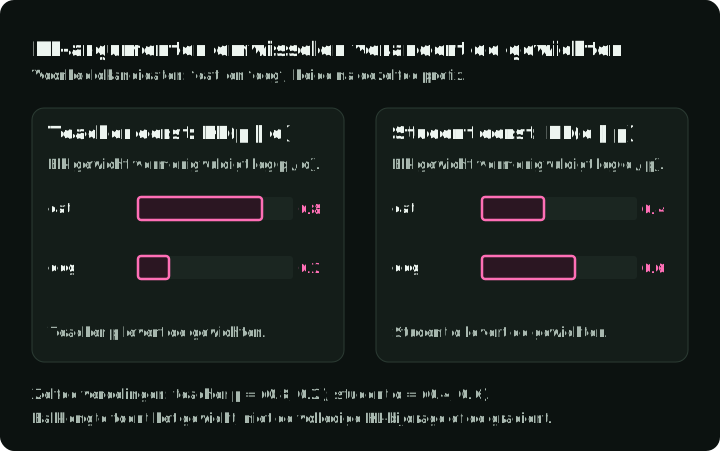
In het eenvoudige voorbeeld hieronder geven teacher en student verschillende kansen aan ‘cat’ en ‘dog’ na dezelfde prefix. KL vermenigvuldigt de log-ratio van elke token met het bijbehorende gewicht en telt de twee termen op. Door het eerste argument te veranderen, verschuift het grootste gewicht van ‘cat’ naar ‘dog’. De balken tonen de gewichten, niet de volledige bijdragen aan de loss.
Van sequence-KL naar token-KL
De kans op een antwoord wordt opgebouwd uit de kansen op de opeenvolgende tokens. Bij elke prefix van een studentantwoord voorspellen beide models de volgende token. Je kunt hun verschillen dus per positie vergelijken en daarna over het antwoord optellen. DeepSeek-V4, §5.1.2, vergelijking (29), gebruikt reverse-KL-distillatie van meerdere gespecialiseerde teachermodels naar één student. Deze teachers zijn afzonderlijke models, niet de expert-subnetwerken binnen een mixture-of-experts-laag.
Op positie is de kans die de student aan kandidaat-token geeft. De prefix bevat prompt en de voorgaande antwoordtokens ; is de teacherkans bij diezelfde prefix. Dan geldt:
is het vocabulaire en de next-token-KL bij één prefix. Lees de binnenste som als ‘vergelijk elke kandidaat-token, gewogen met de studentkans’. Tel deze vergelijkingen op over de posities en neem daarna het gemiddelde over de antwoorden die de student genereert. De buitenste verwachtingswaarde samplet nog steeds tekst, ook als elke het hele vocabulaire sommeert.
Eén gesamplede token of het volledige vocabulaire
De teacher kan alleen de token beoordelen die de student koos, of kansen voor het hele vocabulaire teruggeven. De eerste optie draagt minder informatie over; de tweede vergelijkt alle mogelijke volgende tokens bij die prefix. DeepSeek-V4 meldt instabiele training met zijn schatting op basis van één token en gebruikt de vergelijking over het volledige vocabulaire. Dat maakt de tokenvergelijking exact bij een gegeven prefix; de prefixes komen nog steeds uit gesamplede antwoorden.
Beide models lezen ‘The animal is a’ en geven de onderstaande kansen terug. De gemarkeerde rijen gaan de loss in waarmee de student wordt bijgewerkt. De versie met het volledige vocabulaire bevat ‘dog’ en ‘fox’, hoewel de student ‘cat’ koos; de versie met één token schat die vergelijking op basis van alleen de gekozen token.
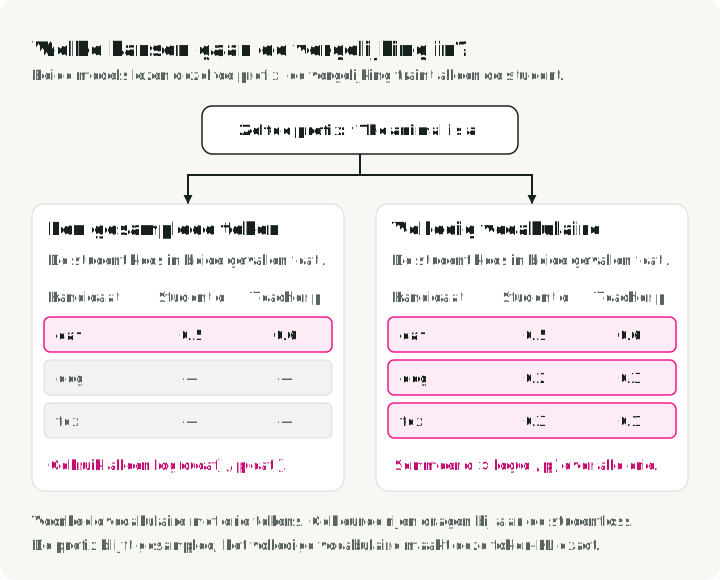
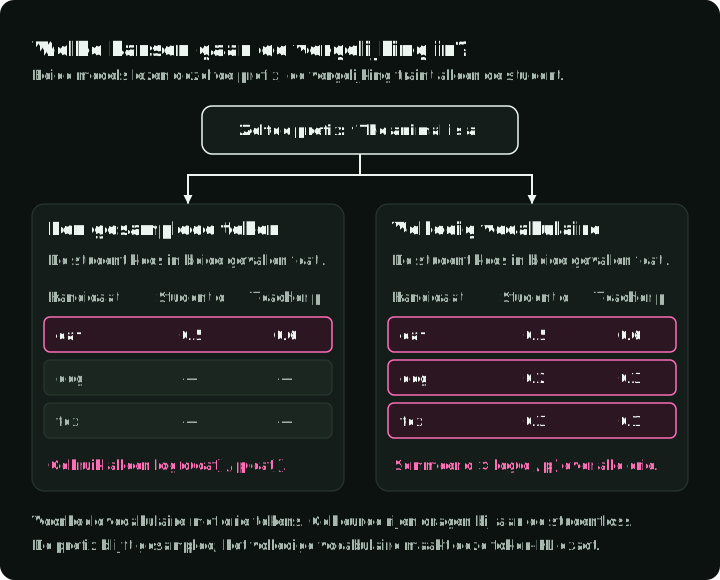
Met de drie rijen geldt . De log-ratio voor alleen de gesamplede ‘cat’ is ongeveer . Eén sample kan negatief zijn, hoewel de volledige KL niet-negatief is.
De uitgebreide uitleg over on-policy distillatie behandelt de afleiding van sequence-KL naar token-KL, samplingcorrecties en gradientschattingen.
DPO: een logistische loss op twee log-ratio’s
DPO begint met een opgeslagen voorkeurspaar: één prompt, een voorkeursantwoord en een afgewezen antwoord. Het paar kan afkomstig zijn van menselijke beoordelingen van eerdere modeluitvoer. Tijdens de training leest het model elk opgeslagen antwoord token voor token en legt de kans vast, gegeven de prompt en de voorgaande tokens. Het optellen van die log-kansen geeft de log-kans van het antwoord. Dat beoordeelt hoe waarschijnlijk de tekst volgens het model is; het opgeslagen voorkeurslabel geeft aan welk antwoord beter is.
Bij een gebruikelijke RLHF-procedure trainen voorkeursparen eerst een afzonderlijk beloningsmodel, waarna reinforcement learning het taalmodel op die beloning traint. DPO, §4, vergelijking (7), traint het taalmodel rechtstreeks met de paren. Een bevroren referentiemodel beoordeelt dezelfde antwoorden ter vergelijking. De training verandert alleen het huidige model; geen van beide models hoeft voor deze stap nieuwe antwoorden te genereren.
Trek voor elk antwoord de referentie-log-kans af van de huidige log-kans. Noem deze verandering de winst. DPO vergelijkt de winst van het voorkeursantwoord met die van het afgewezen antwoord:
Hier is de prompt, zijn en het voorkeursantwoord en het afgewezen antwoord, en zijn en het huidige model en het referentiemodel. De sigmoid zet een getal om naar en is een positieve schaalfactor. Lees de laatste regel als ‘neem het gemiddelde van de paar-loss tussen haakjes over de opgeslagen paren in dataset ’. Een hogere verlaagt die loss; de training minimaliseert door de parameters van het huidige model te veranderen.
Als het voorkeursantwoord bijvoorbeeld 2 aan log-kans wint en het afgewezen antwoord 1 verliest, dan is . De voorkeur is in de bedoelde richting veranderd ten opzichte van de referentie. De loss bevat geen afzonderlijke KL-term en dwingt geen maximale afstand tot de referentie af.
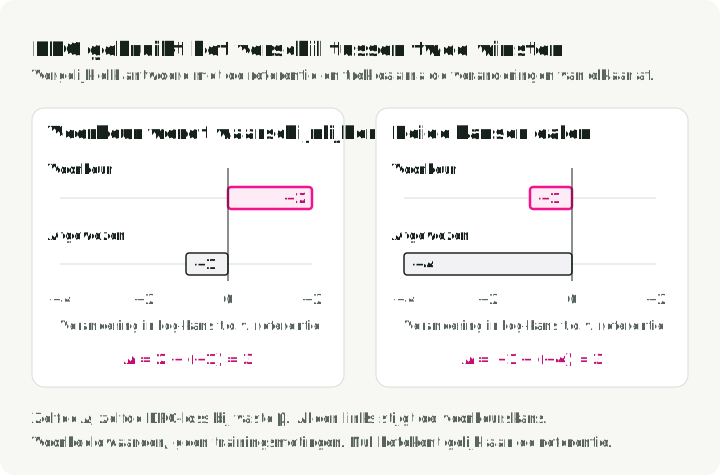
Alleen het verschil bekijken kan een probleem verbergen: het voorkeursantwoord kan minder waarschijnlijk worden terwijl het afgewezen antwoord nog sneller minder waarschijnlijk wordt. De loss verbetert dan nog steeds. Smaug onderzoekt dit probleem; bekijk dus naast de voorkeursloss ook de kansen van de afzonderlijke antwoorden.
De twee gevallen hieronder geven dezelfde en dus dezelfde paar-loss bij een vaste . Alleen links wordt het voorkeursantwoord waarschijnlijker dan onder de referentie.
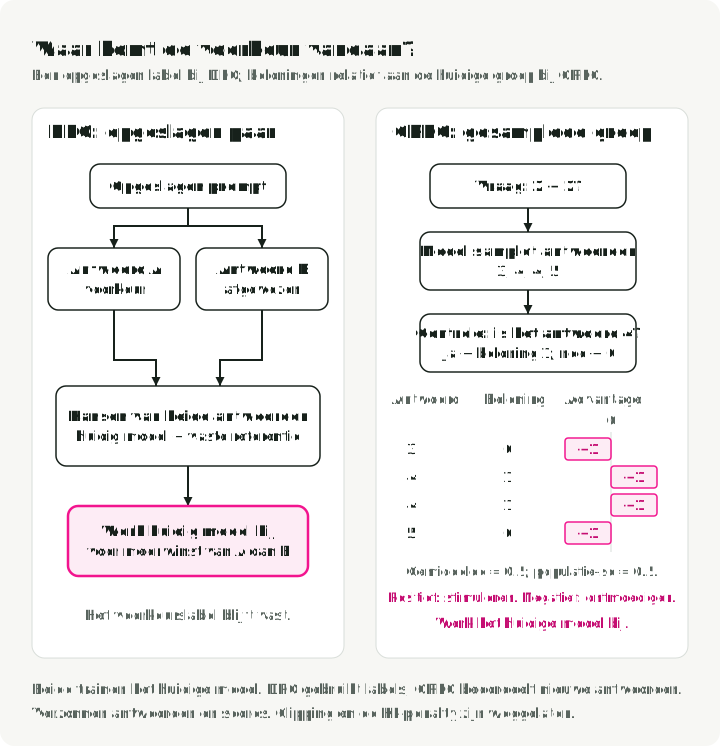
In de volgende figuur hoort de feedback van DPO bij een opgeslagen paar. GRPO genereert tijdens de training vier antwoorden op ‘2 + 2?’. Een antwoordcontrole geeft 1 voor ‘4’ en anders 0. Elke beloning vergelijken met het groepsgemiddelde levert een advantage op: positieve feedback stimuleert de tokens van het gesamplede antwoord en negatieve feedback ontmoedigt ze. De volgende sectie laat die berekening zien en de grenzen aan het effect ervan.
De uitgebreide uitleg over DPO leidt de loss af uit de met beloning geregulariseerde doelfunctie en werkt de gradient uit.
GRPO: de doelfunctie van PPO met een groepsbaseline
Group Relative Policy Optimization samplet meerdere antwoorden op dezelfde vraag, beoordeelt ze en vergelijkt elke score met het groepsgemiddelde. Een juist antwoord tussen overwegend onjuiste antwoorden krijgt positieve feedback; een onjuist antwoord tussen juiste antwoorden krijgt negatieve feedback. Voor wiskunde of code kan de beoordeling een antwoordcontrole of tests gebruiken. Andere taken kunnen een beloningsmodel gebruiken.
DeepSeekMath, §4.1.1, introduceerde GRPO als variant van Proximal Policy Optimization (PPO). DeepSeek-R1, §2.2.1, gebruikte het later. De belangrijkste verandering is de berekening van de advantage, de relatieve beloning die de update stuurt:
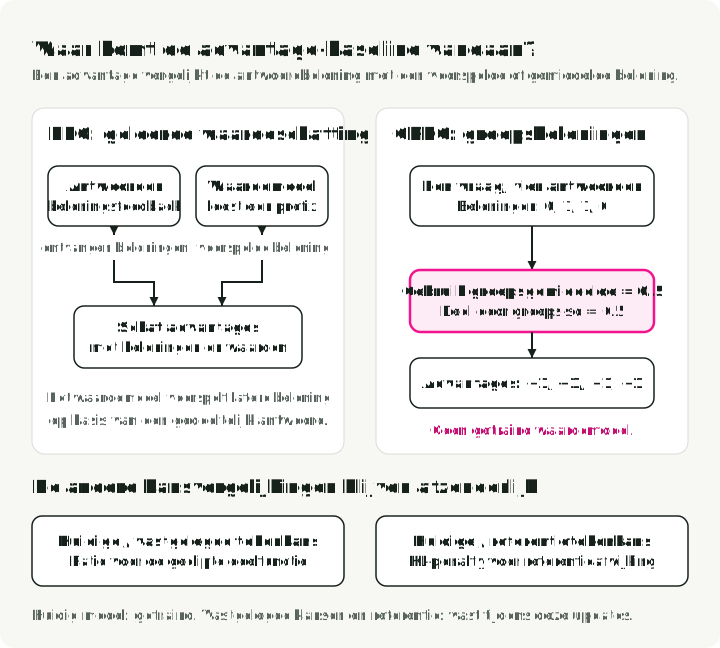
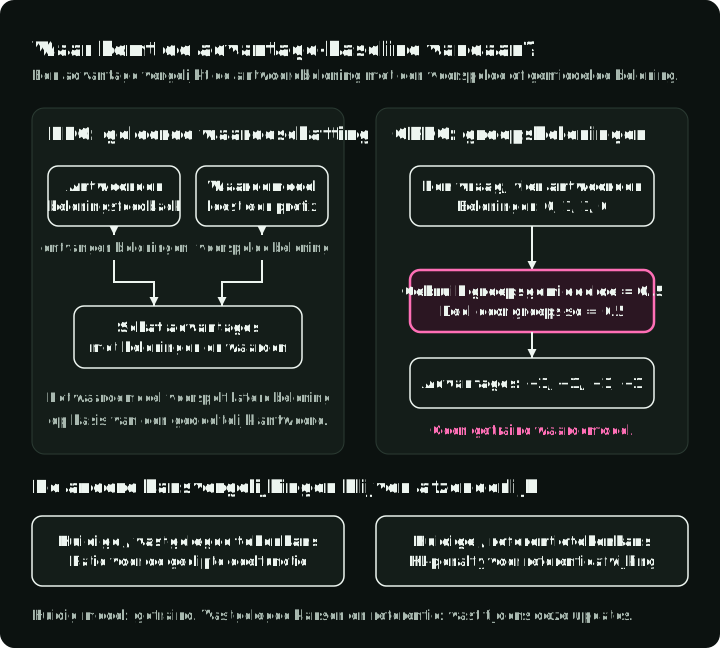
is de beloning van antwoord en het aantal antwoorden op één vraag. De gemiddelde score aftrekken laat zien welke antwoorden boven of onder het groepsgemiddelde scoren. Delen door de standaardafwijking schaalt die verschillen. In de afgebeelde groep is het gemiddelde en de populatiestandaardafwijking , wat advantages geeft.
Wat verandert ten opzichte van PPO
PPO traint doorgaans een afzonderlijk waardemodel om toekomstige beloning te schatten op basis van een gedeeltelijk antwoord. GRPO gebruikt de groepsscores als baseline en traint dat waardemodel dus niet. Het heeft nog steeds beloningsfeedback nodig en de oorspronkelijke doelfunctie gebruikt nog steeds een referentiemodel voor een KL-penalty. Het verwijderen van het waardemodel verwijdert die andere rollen niet.
De vergelijking hieronder laat zien waar het vervangen waardemodel zat. De onderste rij toont twee andere invoeren voor de training. Het oude model, of samplingmodel, is de versie die deze batch antwoorden genereerde; de vastgelegde tokenkansen blijven vast terwijl het huidige model op die batch traint. Een afzonderlijk referentiemodel, dat tijdens deze updates ook vast blijft, levert kansen voor de KL-vergelijking. Beide vergelijkingen beoordelen dezelfde token na dezelfde prefix.
GRPO behoudt de geclipte kansratio-doelfunctie van PPO. Als een gesamplede token kans had en het huidige model die nu kans geeft bij dezelfde prefix, is de ratio . De doelfunctie weegt die ratio met de advantage van het antwoord. De training verandert het huidige model om deze doelfunctie te verhogen, terwijl een afzonderlijke KL-penalty afwijkingen van de referentie ontmoedigt.
Schrijf voor één gesampled antwoord voor de prompt plus de antwoordtokens vóór positie , en voor de token op die positie. Het deel van vergelijking (3) van DeepSeekMath dat de grafiek toont, is:
is het huidige model, de samplingkopie en de groepsadvantage van dit antwoord. De breedte bepaalt het clippinginterval. Lees als ‘vervang een ratio buiten het interval door het dichtstbijzijnde eindpunt’ en daarna als ‘neem de kleinste van de twee met de advantage gewogen termen’. is een bijdrage om te maximaliseren. GRPO trekt de KL-penalty ervan af en neemt het gemiddelde over tokens binnen antwoorden, antwoorden binnen groepen en gesamplede vragen.
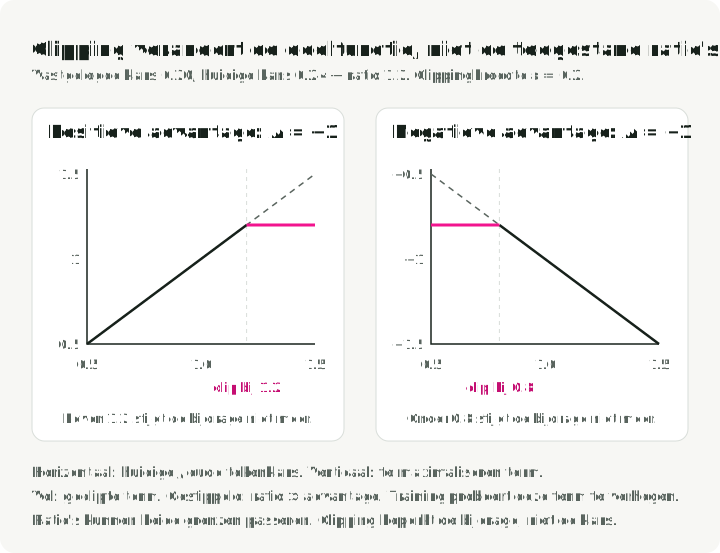
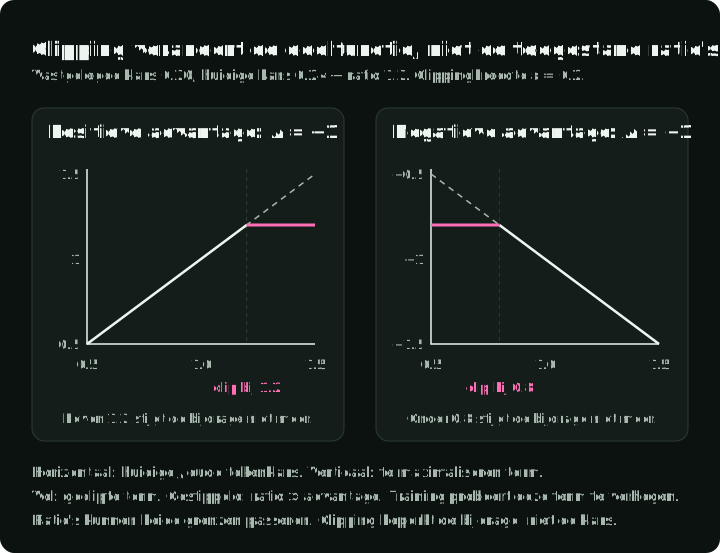
Met , en zijn de twee termen en , dus . Met en zijn ze en , dus . Dit zijn de twee horizontale delen van de grafiek.
De grafiek toont de bijdrage van één token bij een vaste advantage. Een positieve advantage stimuleert een hogere ratio; een negatieve advantage stimuleert een lagere. Clipping maakt de lijn horizontaal waar een gunstige verandering deze term niet verder verbetert. Het legt geen harde grens op aan de daadwerkelijke kansen van het model.
De samplingkopie en de referentie kunnen beginnen met dezelfde weights, maar dienen voor verschillende vergelijkingen. De samplingkopie wordt vernieuwd bij het verzamelen van een nieuwe batch; de vastgelegde kansen blijven de noemer voor updates op die batch.
Als elk antwoord dezelfde beloning krijgt, valt er geen relatieve voorkeur te leren. De advantage-formule deelt dan nul door nul. Implementaties hebben hiervoor een regel nodig, zoals nul-advantages produceren; DAPO, §3.2, sluit zulke groepen juist uit en samplet vervangende groepen.
De uitgebreide uitleg over GRPO behandelt de volledige doelfunctie, clippinggevallen, gradients, de gesamplede KL-schatter en het effect van middelen per antwoord of per token.
Optionele uitwerkingen van de vergelijkingen
De gelinkte uitgebreide uitleg bevat afleidingen en controles met kleine getallen. De teksten zijn gemaakt met de coding-agent-skills uit paper-math-skills en verzameld in paper-math-readings.
Bronnen en versies
- Hinton et al. Distilling the Knowledge in a Neural Network, §2, vergelijking (1).
- Gu et al. MiniLLM, §2.1–2.2.
- DeepSeek-AI. DeepSeek-V4, §5.1.2, vergelijking (29).
- Rafailov et al. Direct Preference Optimization, §4, vergelijking (7).
- Shao et al. DeepSeekMath, §4.1.1, vergelijkingen (1)–(4).
- DeepSeek-AI. DeepSeek-R1, §2.2.1 en §2.4.