Architectuurvergelijkingen lezen: RoPE, MLA, MoE en LoRA

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Dit artikel legt uit wat zes methoden voor modelarchitecturen veranderen: waar attention positie-informatie krijgt, wat het in het geheugen bewaart, welke tokens of experts het gebruikt en welke weights fine-tuning bijwerkt. Het is voor engineers die de hoofdlijnen van een Transformer kennen, maar RoPE, MLA, sparse attention, Gated DeltaNet, MoE en LoRA willen begrijpen zonder alle afleidingen in de papers door te werken. De diagrammen vergelijken de mechanismen; de vergelijkingen leggen de belangrijkste verandering uit.
Een token komt het model binnen als een numerieke vector, een embedding. Elke laag werkt die representatie bij. Bij attention zetten drie vermenigvuldigingen met aangeleerde matrices, of projecties, de binnenkomende tokenvectoren om in queries (), keys () en values (). De labels , en in de diagrammen staan voor die aangeleerde matrices.
Een attention-laag vergelijkt queries met keys om te bepalen hoeveel gewicht de value van elk token krijgt. Voor één head is de berekening:
Lees de bewerkingen in volgorde: vergelijkt elke query met elke key; transponeert de keymatrix zodat de vectoren passen voor vermenigvuldiging. Deel door de vierkantswortel van hun lengte en pas dan softmax toe op elke rij om weights te krijgen. Vermenigvuldiging met middelt de values met die weights. Het resultaat is een bijgewerkte vector voor elk token, die verder door de laag gaat. In een causaal taalmodel sluit attention toekomstige tokens uit vóór softmax. Deel 1 werkt die berekening uit met kleine matrices.
De eerste vier secties veranderen deze berekening of het geheugen ervan. MoE verandert het feed-forward-netwerk en LoRA verandert hoe weights worden getraind. Je kunt de secties los lezen; het MLA-diagram gebruikt het positiemechanisme dat bij RoPE wordt geïntroduceerd.
RoPE: positie als rotatie
Een query–key-inproduct vergelijkt inhoudsvectoren. Op zichzelf zegt het niet of twee tokens naast elkaar staan of honderd posities uit elkaar. De oorspronkelijke Transformer telt vóór de eerste attention-laag een positievector bij elke tokenembedding op. Positie-informatie beïnvloedt vervolgens de queries, keys en values die uit die inputs worden berekend. Het roteert ze niet. Zie Attention Is All You Need, §3.5.
RoPE verwerkt positie in de query–key-vergelijking zelf. Bereken eerst de queries en keys met de gebruikelijke aangeleerde projecties. Roteer vervolgens paren coördinaten onder hoeken die door de positie van elk token worden bepaald. Bereken de attention-scores uit die geroteerde vectoren. RoPE roteert de values niet.
De twee panelen hieronder tonen waar positie wordt toegevoegd. De berekening met gewogen values blijft in beide gevallen na de scoreberekening staan.
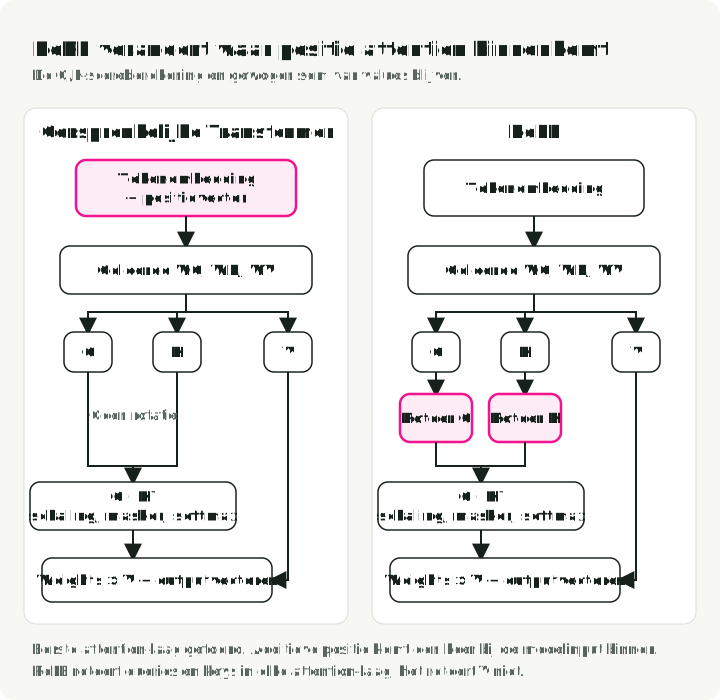
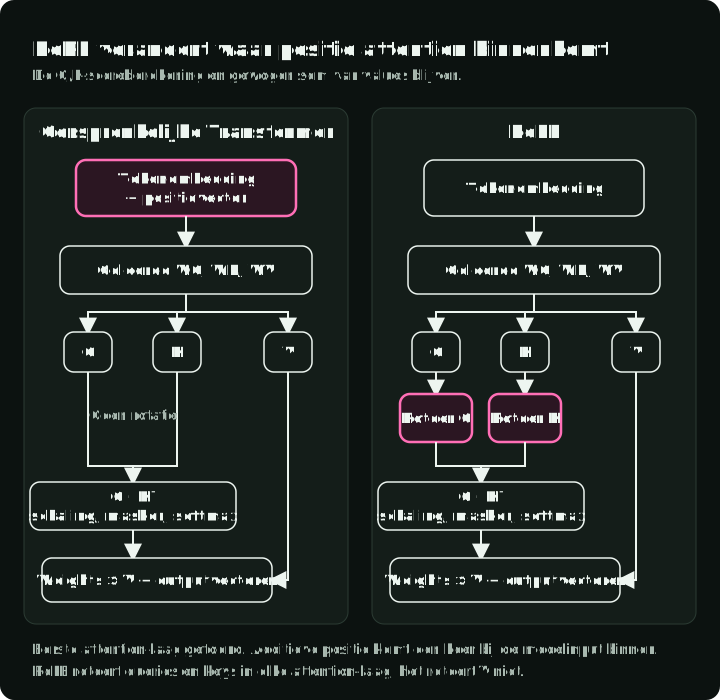
Voor één coördinatenpaar is rotatie een matrixvermenigvuldiging:
is de rotatiehoek. Deze matrix vermenigvuldigen met geeft ; bij 90° is dat , de omhoog gerichte querypijl in het volgende diagram.
Waarom een rotatie? Een inproduct hangt af van de hoek tussen vectoren. Beide vectoren over dezelfde extra hoek roteren laat hun inproduct ongewijzigd. Als een query op positie 2 en een key op positie 3 naar posities 3 en 4 verschuiven, blijft hun positieverschil één. Met dezelfde onderliggende inhoudsvectoren geeft RoPE dezelfde score:
Hier zijn en één paar query- en keycoördinaten, roteert ze, zijn en tokenposities en is de rotatiehoek per positie. De rechterkant toont de nuttige eigenschap: de expliciete positieterm gebruikt het verschil . De score hangt nog steeds af van de inhoudsvectoren, niet alleen van de afstand.
Het diagram houdt beide oorspronkelijke vectoren vast op en gebruikt een rotatie van 45° per positie. Dit zijn gekozen voorbeeldwaarden: met vaste inhoud kunnen we het effect zien van het verschuiven van beide posities.
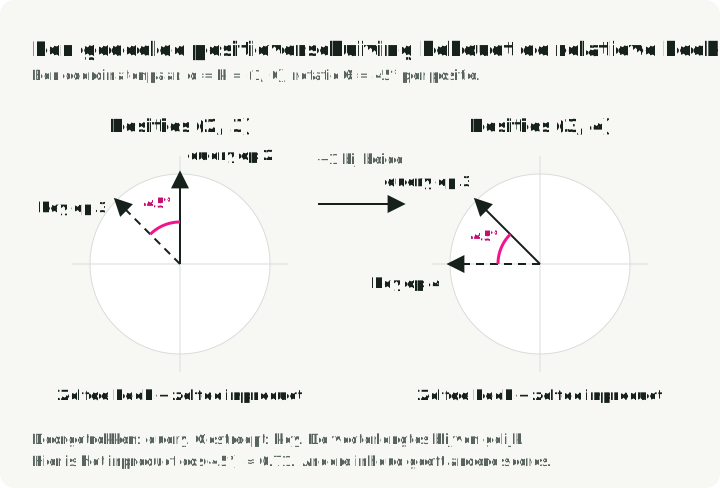
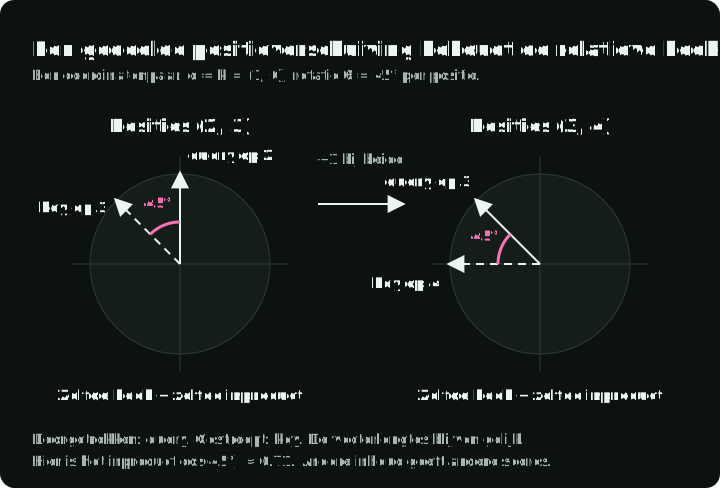
Een volledige query of key heeft veel coördinatenparen. RoPE roteert ze met verschillende snelheden, zodat ze positieverschillen op meerdere schalen voorstellen. Dat garandeert geen goede attention bij willekeurige contextlengtes, en ook niet dat elke score met de afstand afneemt.
De rotatiematrices en hun afleiding staan in RoFormer v5, §3.2, vergelijkingen (12)–(16). De gedetailleerde RoPE-uitleg bevat de tussenliggende algebra en numerieke controles.
MLA: cache een kleine vector in plaats van keys en values
Attention heads bestonden al vóór MLA. De multi-head attention van de oorspronkelijke Transformer, §3.2.2, voert meerdere attention-berekeningen met verschillende aangeleerde projecties uit en combineert hun outputs. DeepSeek behoudt meerdere heads. Het verandert hoe hun keys en values worden voorgesteld en gecachet.
Tijdens generatie slaat gewone multi-head attention een key en een value op voor elk eerder token, voor elke head. Deze KV cache groeit met de sequentie. MLA gebruikt in plaats daarvan een aangeleerde projectie om de binnenkomende tokenrepresentatie direct om te zetten in één korte vector. Daaruit kunnen de content-keys en values van de heads worden berekend. Alle heads delen deze opgeslagen vector, maar gebruiken verschillende projecties en attention-weights; het worden geen identieke heads.
Het diagram volgt één token van de binnenkomende vector tot de opgeslagen gegevens in één laag. Latere queries lezen die gegevens aan beide kanten via meerdere heads; de outputs van de heads worden tot de attention-output gecombineerd.
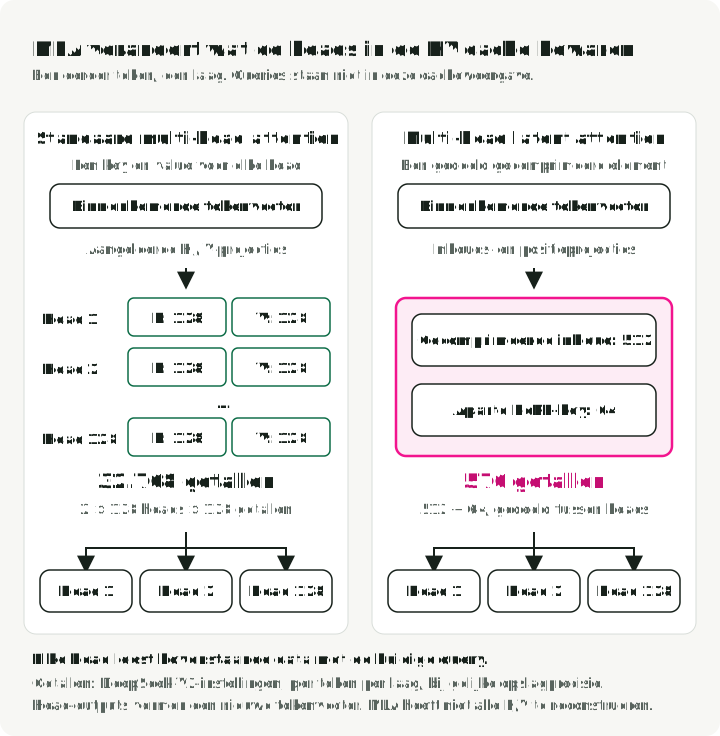
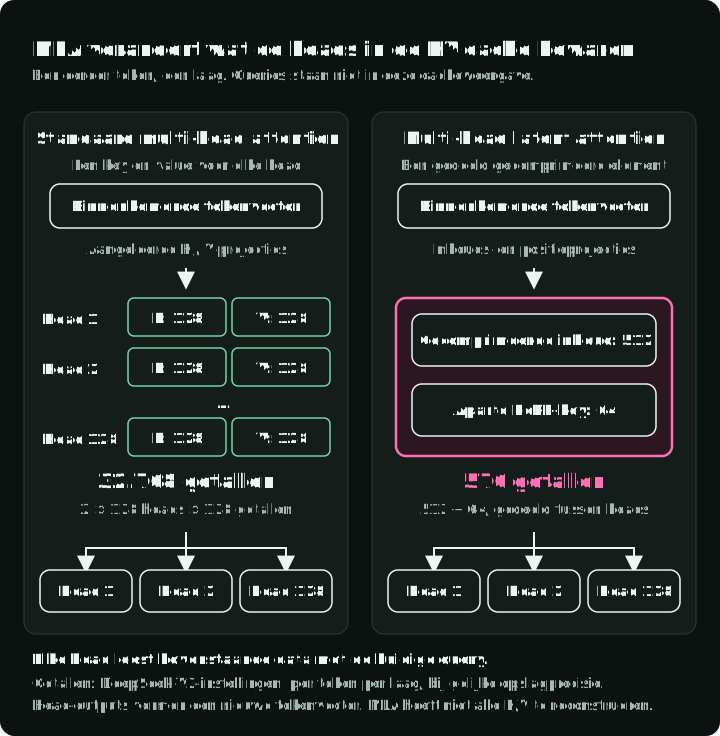
De inhoudsberekening in het diagram komt overeen met drie vergelijkingen uit DeepSeek-V2:
is de binnenkomende vector van token . De eerste regel zet die om in de kortere gecachete vector . De volgende twee zetten dezelfde vector om in content-keys en values voor alle heads. De superscripts zijn labels, geen machten: noemt de down-projectie, en de up-projecties voor keys en values, en markeert het inhoudsdeel. Alle drie de matrices worden aangeleerd. De aparte positiekey staat buiten deze drie vergelijkingen.
Voor de configuratie van DeepSeek-V2 is de vergelijking 32.768 getallen tegenover 576: gewone attention met 128 heads en 128 getallen in elke key en value heeft nodig; MLA bewaart een gecomprimeerde vector van 512 getallen en een positiekey van 64 getallen. Dat zijn bij dezelfde precisie ongeveer 57 keer minder gecachete getallen. Het vergelijkt deze configuratie met gewone multi-head attention, niet met elk cacheontwerp, en betekent niet dat inference 57 keer sneller wordt.
Zou het uitvouwen van de gecomprimeerde vector voor elk oud token het voordeel wegnemen? MLA kan dat uitvouwen vermijden. Kort voor één head af tot en noem de rijen van van die head de key-expansiematrix . Dan:
De linkerkant vouwt elke gecachete vector uit tot een key voordat die met query wordt vergeleken. De rechterkant transformeert de huidige query één keer en vergelijkt die daarna direct met de gecachete vectoren. Het is dezelfde berekening, anders gegroepeerd. De value-berekening heeft een vergelijkbare herschikking: middel eerst de gecomprimeerde vectoren en pas daarna de outputprojecties toe. Een implementatie kan de vermenigvuldigingsvolgorde kiezen die bij de hardware past.
RoPE vereist een aparte behandeling. De uitgevouwen content-keys roteren zou een positieafhankelijke bewerking binnen die herschikking plaatsen. MLA laat die keys daarom ongeroteerd en voegt een aparte query–key-vergelijking voor positie toe. Daarom bevat de cache zowel de gecomprimeerde inhoudsvector als een kleine geroteerde positiekey.
MLA is een aangeleerde architectuur, geen verliesloze compressor die je op elke bestaande attention-laag kunt toepassen. DeepSeek-V2 v5, §2.1.2–2.1.3, vergelijkingen (9)–(19) definieert de projecties en het aparte RoPE-onderdeel. De gedetailleerde MLA-uitleg geeft de volledige vormen en matrixherschikkingen.
Sparse attention (DSA): een goedkope scorer kiest de keys
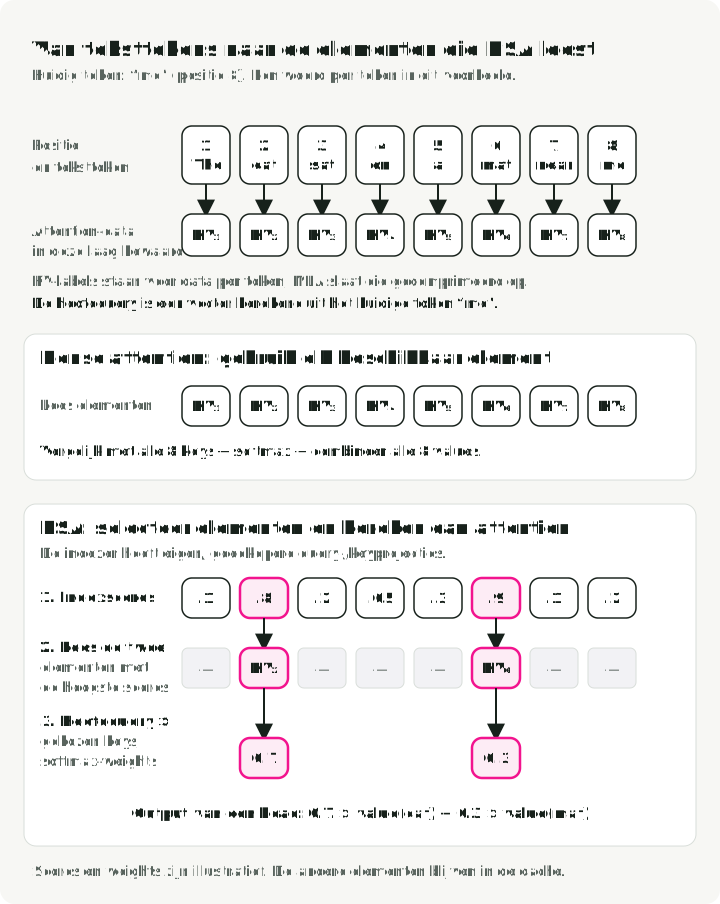
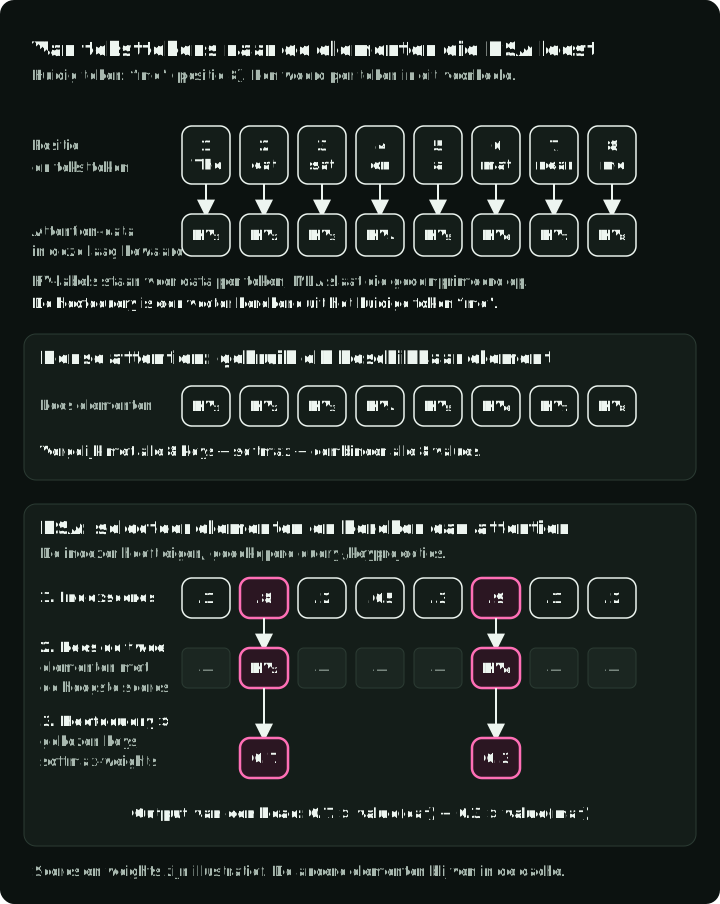
DSA vermindert het aantal tokens dat aan elke attention-berekening meedoet. Stel dat een model de tekst “The cat sat on a mat near me” voortzet. Behandel elk woord voor dit voorbeeld als één token. Het model verwerkt het laatste token, “me”, op positie 8.
Binnen één attention-laag levert de representatie van het huidige token een query-vector. Elk beschikbaar token heeft een key, waarmee de query wordt vergeleken, en een value, die informatie aan de output levert. Tijdens generatie bewaart de laag de attention-gegevens van eerdere tokens in de KV cache, zodat die vectoren opnieuw kunnen worden gebruikt. “Positie 2” identificeert de opgeslagen gegevens voor “cat”; de cache bevat numerieke vectoren, niet alleen positienummers. MLA slaat deze gegevens in de hierboven beschreven gecomprimeerde vorm op.
Dense causal attention vergelijkt de huidige query met elke beschikbare key, inclusief die van het huidige token. Softmax zet die scores om in weights en de laag combineert de values met die weights. DSA voegt vóór die berekening een goedkopere selectiestap toe:
- Scoor de beschikbare tokens goedkoop. Een klein aangeleerd netwerk, de lightning indexer, gebruikt eigen query- en keyprojecties om elke positie voor het huidige token te scoren. Het schat welke tokens de hoofd-attention het meest zal gebruiken.
- Selecteer de posities met de hoogste scores. In het voorbeeld krijgen “cat” en “mat” de twee hoogste indexscores. Posities 2 en 6 selecteren vertelt de hoofd-attention welke opgeslagen elementen moeten worden gelezen.
- Bereken attention op die elementen. De hoofd-attention berekent eigen query–key-scores voor de geselecteerde elementen, past softmax toe op die deelverzameling en combineert hun values. De indexscores kiezen de elementen; ze zijn niet de uiteindelijke attention-weights.
Volg een kolom van het teksttoken naar het opgeslagen element en vergelijk daarna de dense en sparse berekeningen. Alle scores en weights hieronder zijn ter illustratie.
De indexervergelijking van het paper geeft de eerste rij scores in het DSA-paneel:
is de huidige positie en een kandidaatpositie. Het superscript markeert de eigen vectoren van de indexer. Vergelijk voor elk van de heads query met key , vervang een negatief inproduct door nul met ReLU, vermenigvuldig met de aangeleerde tokenafhankelijke weight en sommeer over heads . Het resultaat is een selectiescore.
We kunnen de selectie en de output van één hoofd-attention-head schrijven als:
is de scorerij voor beschikbare posities 1 tot en met . TopKIndices geeft de posities van de hoogste scores terug, tot maximaal elementen. De som leest als “tel alleen de gewogen values op voor posities in ”. Hier is een nieuw berekende softmax-weight van de hoofd-attention, de value-vector en de output. In de figuur geldt en . Dit herschrijft de notatie van het paper voor geselecteerde elementen als een expliciete som; MLA kan die in gecomprimeerde vorm berekenen.
De andere elementen blijven in de cache. Een andere query kan een andere deelverzameling selecteren. Training leert de indexer om de tokenverdeling van de hoofd-attention te benaderen, eerst met dense attention en daarna samen met sparse attention. Een slechte selectie kan nuttige informatie weglaten.
DeepSeek-V3.2 past DSA toe op de gecomprimeerde cache van MLA en selecteert maximaal 2.048 posities per query. Op de laatste positie van een context met 131.072 tokens leest de hoofd-attention één element op 64. Als er minder dan 2.048 posities beschikbaar zijn, kan het die allemaal gebruiken.
De besparing komt door minder dure attention-vergelijkingen. De indexer scoort nog steeds elke beschikbare positie, maar gebruikt minder heads en kan in FP8 rekenen. Over een sequentie met lengte daalt het aantal vergelijkingen van de hoofd-attention van ongeveer tot , waarbij het geselecteerde aantal is. Het werk van de indexer over alle paren blijft kwadratisch, dus de volledige methode is niet strikt lineair in de sequentielengte.
Zie DeepSeek-V3.2 v1, §2.1, vergelijkingen (1)–(4) en de gedetailleerde DSA-uitleg voor de score- en trainingsvergelijkingen.
Gated DeltaNet: een geheugen met vaste grootte dat overschrijft
Dense attention, MLA en DSA bewaren een groeiende registratie van eerdere tokens. Gated DeltaNet werkt in plaats daarvan één matrix met vaste grootte bij. De laag berekent een key, value en query uit binnenkomende tokenrepresentaties met aangeleerde projecties en korte filters over nabijgelegen tokens. De key en value werken de matrix bij; de query leest de bijgewerkte matrix om een outputvector te maken. Het kan niet elke oude key en value apart opnieuw raadplegen.
Een nuttige vergelijking is die met een eenvoudig additief geheugen. Stel dat het geheugen nu 2 teruggeeft voor een bepaalde key en het volgende token value 5 voor diezelfde key levert. De nieuwe value optellen zou 7 geven. Een delta-update telt de correctie, , op, zodat schrijven op volle sterkte 5 geeft.
Het voorbeeld gebruikt key , die de eerste kolom van de matrix leest: één keer de eerste kolom plus nul keer de tweede. De gemarkeerde kolom toont de correctie. Na het schrijven leest een query er uit. De matrix houdt dezelfde grootte.
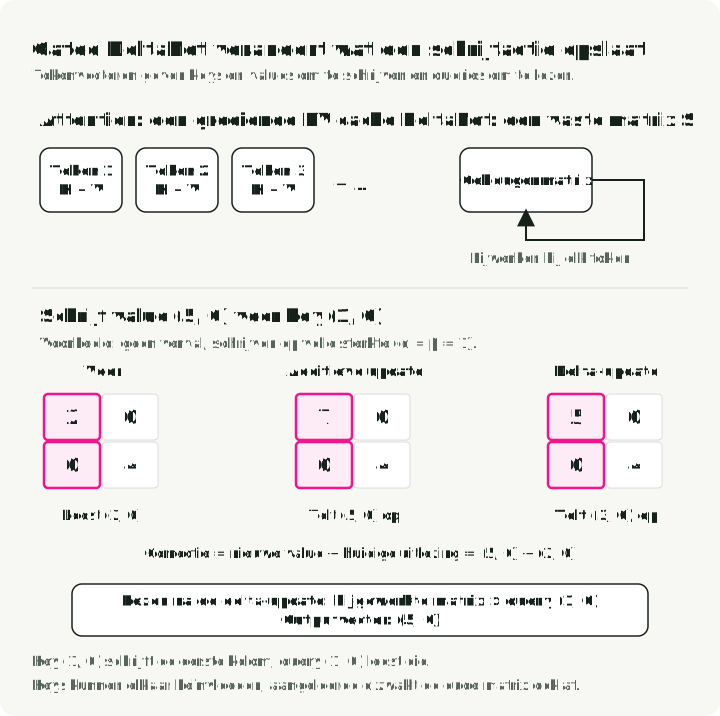
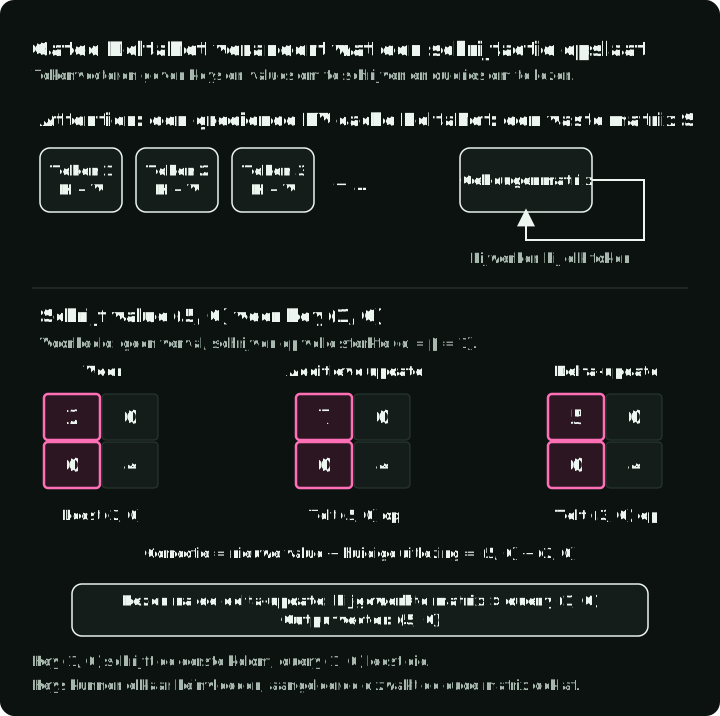
Gated DeltaNet leert ook hoeveel oud geheugen het behoudt en hoe sterk elke correctie wordt toegepast:
is de geheugenmatrix, de huidige key met lengte één en de nieuwe value. De factor zwakt het oude geheugen af. Het afgezwakte geheugen lezen met geeft het huidige antwoord; dat antwoord van aftrekken geeft de correctie. De factor bepaalt hoeveel er wordt geschreven. Beide factoren worden uit het huidige token berekend. De bijgewerkte matrix vermenigvuldigen met de query geeft het leesresultaat, dat de laag vervolgens normaliseert, met een gate moduleert en naar de output projecteert. Het voorbeeld van 2 naar 5 gebruikt hun grenswaarde 1.
Een vast geheugen bespaart ruimte, maar schrijfbewerkingen kunnen elkaar beïnvloeden: het antwoord voor één key veranderen kan het ook veranderen voor een andere, niet-orthogonale key. Verval verwijdert ook oude informatie. Dat helpt verklaren waarom het paper recurrente lagen combineert met sliding-window attention in hybride modellen, met aparte elementen voor recente tokens.
De getoonde vorm herschikt Gated Delta Networks v3, §3.1, vergelijking (10). De gedetailleerde uitleg leidt haar af en werkt de matrixupdate uit.
MoE-routing: de bias kiest experts, de score weegt hun outputs
Een mixture-of-experts-laag (MoE) heeft meerdere feed-forward-netwerken, experts genoemd, en selecteert er slechts enkele voor elk token. Dat vergroot de modelcapaciteit zonder elke expert voor elke input uit te voeren. Het verandert het feed-forward-deel van een Transformer, niet de attention heads.
De specifieke routingregel van DeepSeek-V3 scheidt twee beslissingen: welke experts worden uitgevoerd en hoe zwaar hun outputs meetellen. Een aangeleerde router neemt de vector van het huidige token en geeft elke expert een score . Een load-balancing-bias verandert de selectiescore in . Na selectie komen de outputgewichten uit de oorspronkelijke scores, genormaliseerd over de geselecteerde experts. De bias maakt geen deel uit van die gewichten.
Het voorbeeld selecteert twee van vier experts. Expert 1 heeft de hoogste ruwe score, maar wordt door de negatieve bias uitgesloten; experts 2 en 3 worden in plaats daarvan uitgevoerd. Beide krijgen dezelfde tokenvector . Elke expert maakt een nieuwe vector, geschreven als of , en de laag telt die outputs met gewichten 0.56 en 0.44 op. Het diagram toont alleen deze bijdrage van gerouteerde experts.
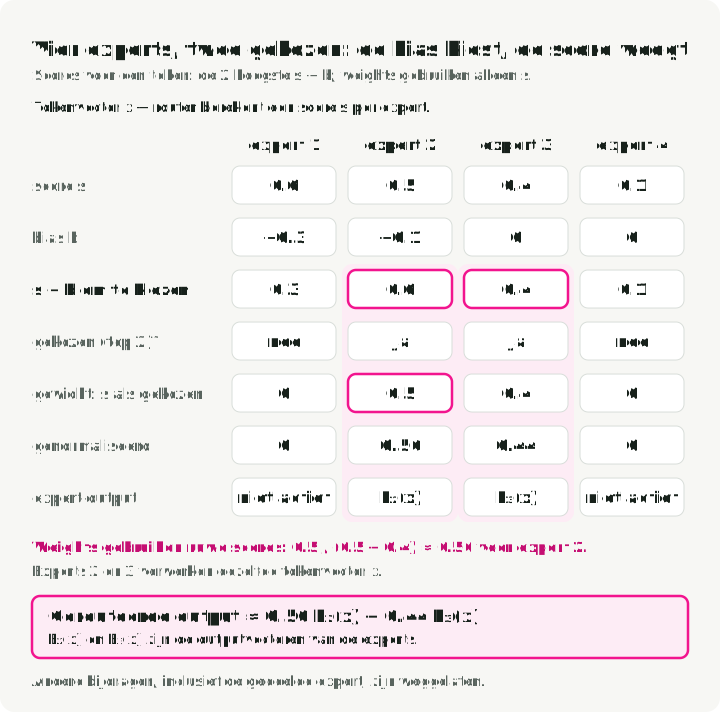
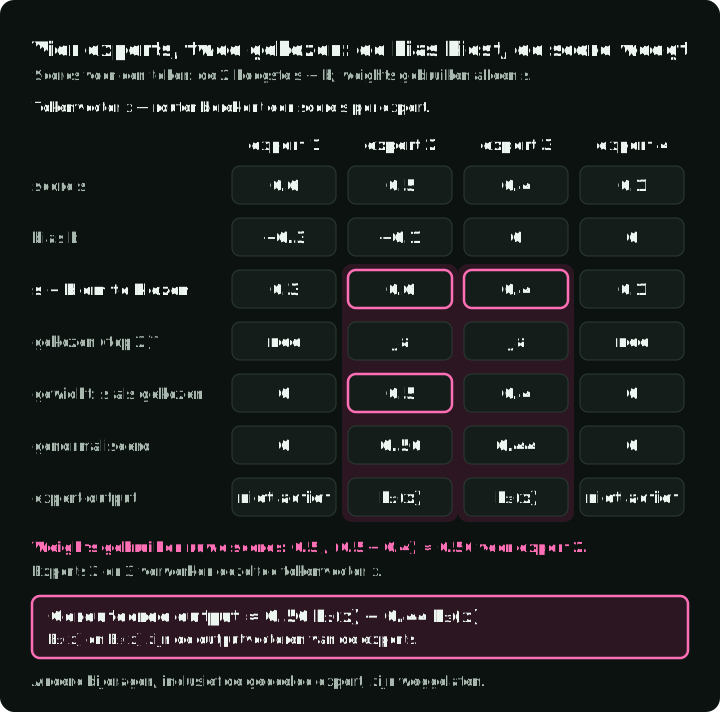
Een compacte vorm van de routingregel van DeepSeek-V3, voor één token, is:
en bevatten de scores en biases van alle experts; is het aantal om te selecteren. De eerste regel geeft de geselecteerde expertindices terug. De accolade in de tweede regel is een if/else: deel de oorspronkelijke score van een geselecteerde expert door de som van de geselecteerde scores, of ken nul toe als die expert niet is geselecteerd. De laatste regel telt de outputvectoren van de experts met die gewichten op. In de figuur is , dus en . De bias komt alleen in de selectie voor. De bijdragen van de residual connection en de gedeelde expert staan buiten .
Tijdens training daalt de bias van een te vaak gebruikte expert en stijgt die van een te weinig gebruikte expert. Dat bevordert een gelijkmatigere belasting. DeepSeek-V3 behoudt ook een kleine balanceringsloss per sequentie, dus “auxiliary-loss-free” betekent niet dat het model helemaal geen balanceringsloss heeft.
De configuratie activeert 8 van 256 gerouteerde experts per token, plus één gedeelde expert die altijd wordt uitgevoerd. Die aantallen en de gedeelde expert horen bij dit model, niet bij de definitie van MoE. Zie DeepSeek-V3 v2, §2.1.2, vergelijkingen (12)–(17) en de routing-uitleg.
mHC: residual mixing beperkt tot gewogen gemiddelden
Een gewone residual connection leidt een tokenvector langs een sublaag en telt het resultaat van de sublaag erbij op. mHC bewaart meerdere van die vectoren, residual streams genoemd, en verandert hoe ze tussen lagen worden gemengd. De ideale mixmatrix heeft niet-negatieve elementen met rij- en kolomsommen van één. Die menging vormt gewogen gemiddelden en behoudt tegelijk het totaal over de streams. De implementatie benadert die beperking met een eindig aantal normalisatiestappen; het beperkt niet elke bewerking in het netwerk.
Het aparte mHC-artikel legt het mechanisme, de normalisatie en de beperkingen uit met diagrammen. Gebruik dat artikel voor dit onderwerp; de vergelijkingsuitleg geeft de afleiding.
LoRA: een update met lage rang naast een vaste weight
Volledige fine-tuning werkt de weightmatrices van het model bij. LoRA zet een voorgetrainde matrix vast en leert daarnaast een kleinere correctie:
is de tokenvector die de gekozen lineaire laag binnenkomt en is de outputvector die verder door het model gaat. De oorspronkelijke vermenigvuldiging wordt nog steeds uitgevoerd. In de correctie zet de input om in een veel kleinere vector en zet die terug naar de grootte van de output. Trainingsvoorbeelden en de taakloss bepalen updates voor en ; blijft vast. Hun gedeelde kleine dimensie is de ranginstelling ; de resulterende update heeft rang hoogstens .
Voor een weightmatrix van en heeft een volledige update ongeveer 16.8 miljoen elementen. De twee LoRA-matrices hebben er : 256 keer minder trainbare elementen voor deze matrix. Dat vermindert de opslag van gradients en optimizerstatus, maar de volledige basisweight neemt nog steeds geheugen in en doet mee aan de berekening.
Volg de twee berekeningen vanuit dezelfde input: de vaste matrix berekent nog steeds haar output, terwijl de trainbare correctie via slechts acht getallen loopt.
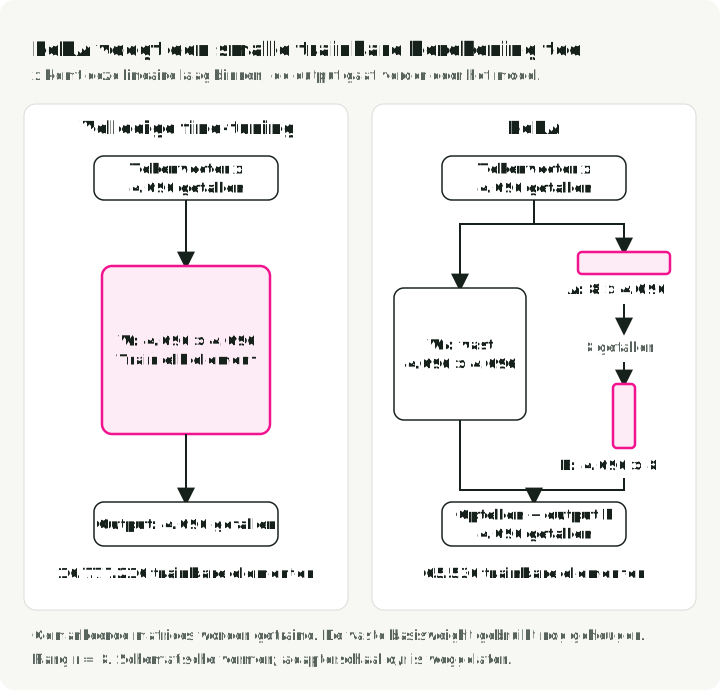
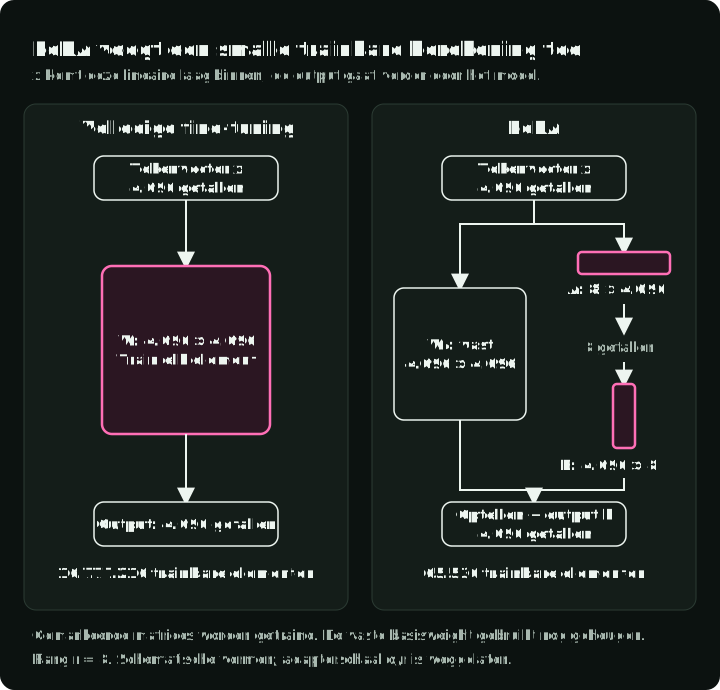
In de oorspronkelijke methode begint op nul, zodat de correctie aanvankelijk niets verandert. Het paper schaalt de update met , een instelling die hierboven uit vergelijking (3) is weggelaten. Na training kan de geschaalde correctie bij worden opgeteld; de samengevoegde laag heeft dan alleen de oorspronkelijke matrixvermenigvuldiging nodig. Adapters apart houden voegt berekeningen toe, maar maakt ze uitwisselbaar.
Zie LoRA v2, §4.1, vergelijking (3) en de gedetailleerde LoRA-uitleg. QLoRA slaat de vaste basisweights bovendien in 4-bit-vorm op en dequantiseert ze voor de berekening; het maakt niet al het trainingsgeheugen 4-bit. De fine-tuning-gids vergelijkt de praktische opties.
Optionele uitwerkingen van vergelijkingen
De gekoppelde vergelijkingsuitwerkingen bevatten symbooldefinities, tussenliggende afleidingen en controles met kleine getallen. Ze zijn gemaakt met de instructies voor coding agents in paper-math-skills. Het zijn aanvullende verklaringen; de papers die bij elk mechanisme staan, zijn de primaire bronnen.
Bronnen en versies
De paperlinks hierboven geven de versies aan die voor sectie- en vergelijkingsnummers zijn gebruikt. Zie voor de oorspronkelijke attention ter vergelijking Attention Is All You Need v7, §3.2 en §3.5. Zie voor het aparte onderwerp residual mixing mHC v2.