Ler equações de arquitetura: RoPE, MLA, MoE e LoRA

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este artigo explica o que seis métodos de arquitetura de modelos alteram: onde a atenção recebe informação de posição, o que guarda em memória, que tokens ou especialistas utiliza e que pesos o fine-tuning atualiza. Destina-se a engenheiros que conhecem a estrutura geral de um Transformer, mas querem perceber RoPE, MLA, atenção esparsa, Gated DeltaNet, MoE e LoRA sem percorrer as derivações de cada artigo. Os diagramas comparam os mecanismos; as equações explicam a principal alteração.
Um token entra no modelo como um vetor numérico chamado embedding. Cada camada atualiza essa representação. Na atenção, três multiplicações por matrizes aprendidas, ou projeções, transformam os vetores de entrada dos tokens em consultas (), chaves () e valores (). As etiquetas , e do diagrama designam essas matrizes aprendidas.
Uma camada de atenção compara consultas com chaves para decidir o peso a dar ao valor de cada token. Para uma cabeça, o cálculo é:
Leia as operações por ordem: compara cada consulta com cada chave; transpõe a matriz de chaves para alinhar os vetores para a multiplicação. Divida pela raiz quadrada do seu comprimento e aplique softmax a cada linha para obter pesos. A multiplicação por calcula a média dos valores com esses pesos. O resultado é um vetor atualizado para cada token, passado adiante pela camada. Num modelo de linguagem causal, a atenção exclui os tokens futuros antes da softmax. A Parte 1 percorre esse cálculo com matrizes pequenas.
As primeiras quatro secções alteram este cálculo ou a sua memória. A MoE altera a rede feed-forward e a LoRA altera a forma como os pesos são treinados. Pode ler as secções de forma independente; o diagrama da MLA usa o mecanismo de posição apresentado na RoPE.
RoPE: posição como rotação
O produto escalar entre consulta e chave compara vetores de conteúdo. Por si só, não indica se dois tokens são adjacentes ou estão separados por cem posições. O Transformer original soma um vetor de posição ao embedding de cada token antes da primeira camada de atenção. A informação de posição influencia depois as consultas, chaves e valores calculados a partir dessas entradas. Não os roda. Consulte Attention Is All You Need, §3.5.
A RoPE introduz a posição na própria comparação entre consulta e chave. Primeiro, calcule as consultas e chaves com as projeções aprendidas habituais. Depois, rode pares das suas coordenadas por ângulos determinados pela posição de cada token. Calcule as pontuações de atenção a partir desses vetores rodados. A RoPE não roda os valores.
Os dois painéis abaixo mostram onde entra a posição. O cálculo dos valores ponderados continua a seguir ao cálculo das pontuações em ambos os casos.
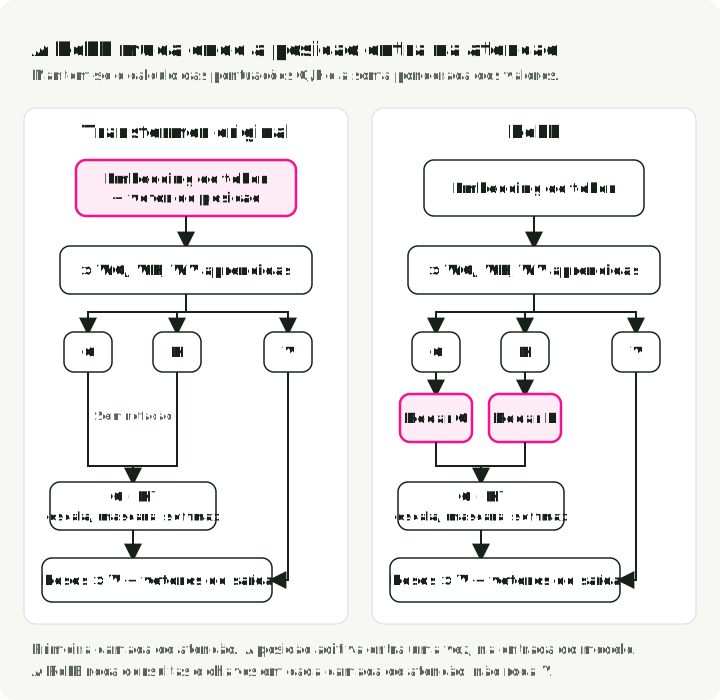
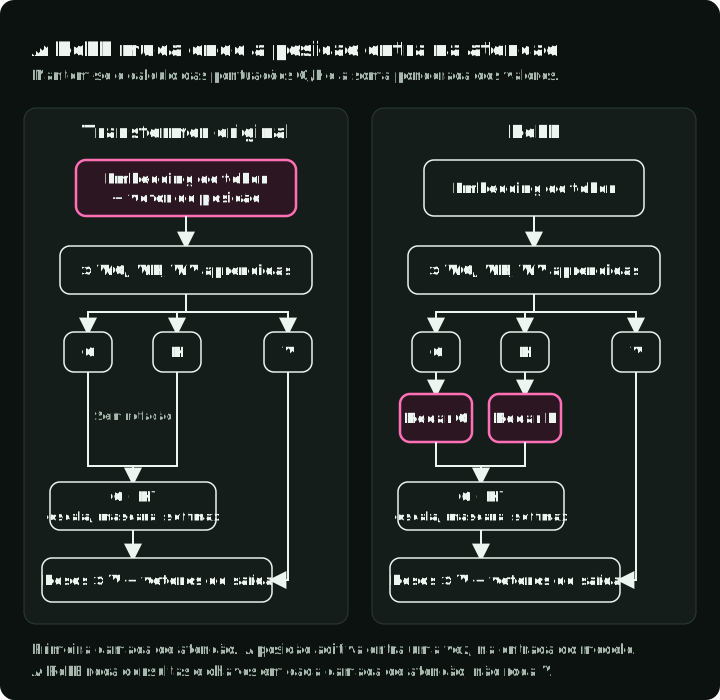
Para um par de coordenadas, a rotação é uma multiplicação de matrizes:
é o ângulo de rotação. Multiplicar esta matriz por dá ; a 90° é , a seta da consulta que aponta para cima no diagrama seguinte.
Porquê uma rotação? Um produto escalar depende do ângulo entre vetores. Rodar ambos pelo mesmo ângulo adicional mantém o produto escalar. Se uma consulta na posição 2 e uma chave na posição 3 passarem para as posições 3 e 4, a diferença de posição continua a ser um. Com os mesmos vetores de conteúdo subjacentes, a RoPE dá a mesma pontuação:
Aqui e são um par de coordenadas da consulta e da chave, roda-os, e são posições de tokens e é o ângulo de rotação por posição. O lado direito mostra a propriedade útil: o termo explícito de posição usa a diferença . A pontuação continua a depender dos vetores de conteúdo, não apenas da distância.
O diagrama fixa ambos os vetores originais em e usa uma rotação de 45° por posição. São valores escolhidos para o exemplo: manter o conteúdo fixo permite ver o efeito de deslocar ambas as posições.
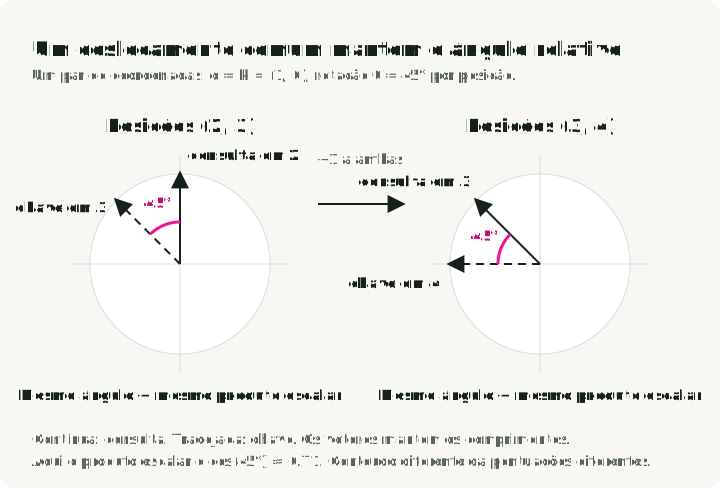
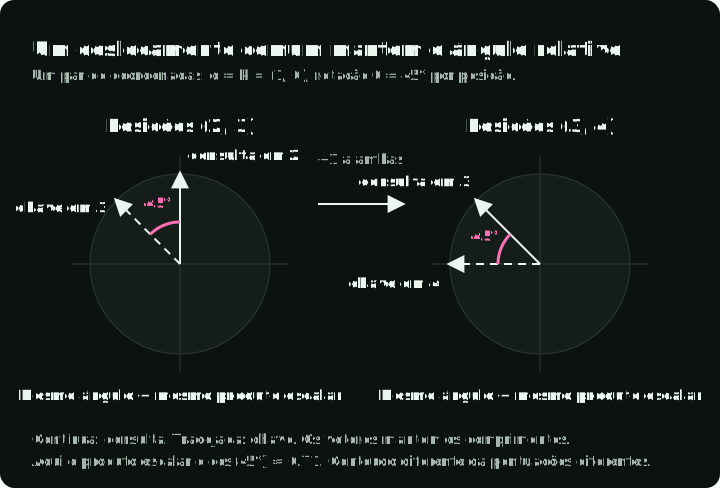
Uma consulta ou chave completa tem muitos pares de coordenadas. A RoPE roda-os a ritmos diferentes, pelo que representam diferenças de posição em várias escalas. Isso não garante boa atenção para comprimentos de contexto arbitrários nem que todas as pontuações diminuam com a distância.
As matrizes de rotação e a sua derivação estão em RoFormer v5, §3.2, equações (12)–(16). A leitura detalhada da RoPE inclui a álgebra intermédia e verificações numéricas.
MLA: guardar um vetor pequeno em vez de chaves e valores
As cabeças de atenção já existiam antes da MLA. A atenção multi-head do Transformer original, §3.2.2 executa vários cálculos de atenção com projeções aprendidas diferentes e combina as suas saídas. O DeepSeek mantém várias cabeças. A sua alteração é a forma como representa e guarda as respetivas chaves e valores.
Durante a geração, a atenção multi-head habitual guarda uma chave e um valor para cada token anterior por cada cabeça. Esta KV cache cresce com a sequência. A MLA usa uma projeção aprendida para transformar diretamente a representação de entrada do token num vetor curto. As chaves de conteúdo e os valores das cabeças podem ser calculados a partir dele. Todas as cabeças partilham esse vetor guardado, mas usam projeções e pesos de atenção diferentes; não passam a ser cabeças idênticas.
O diagrama segue um token desde o seu vetor de entrada aos dados guardados numa camada. As consultas posteriores leem esses dados através de várias cabeças de ambos os lados; as saídas das cabeças são combinadas na saída da atenção.
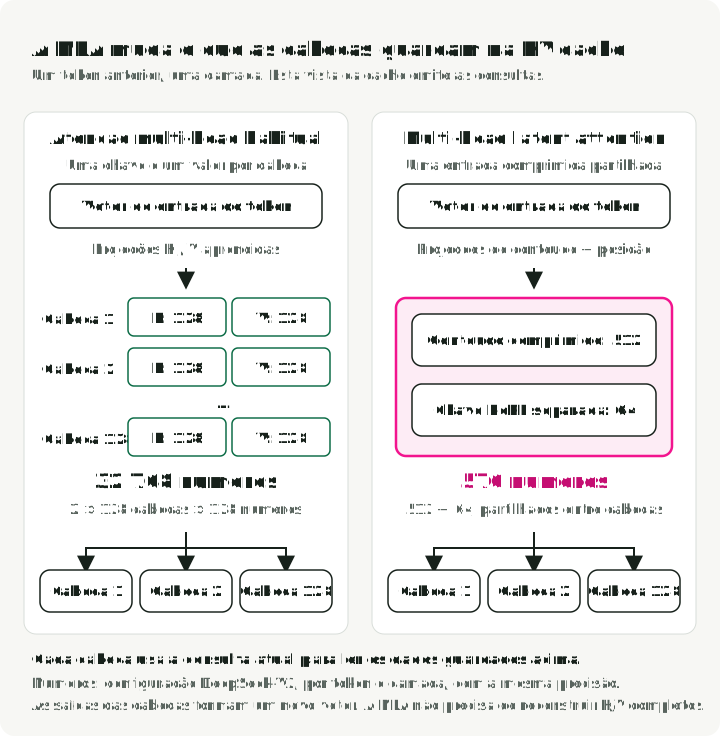
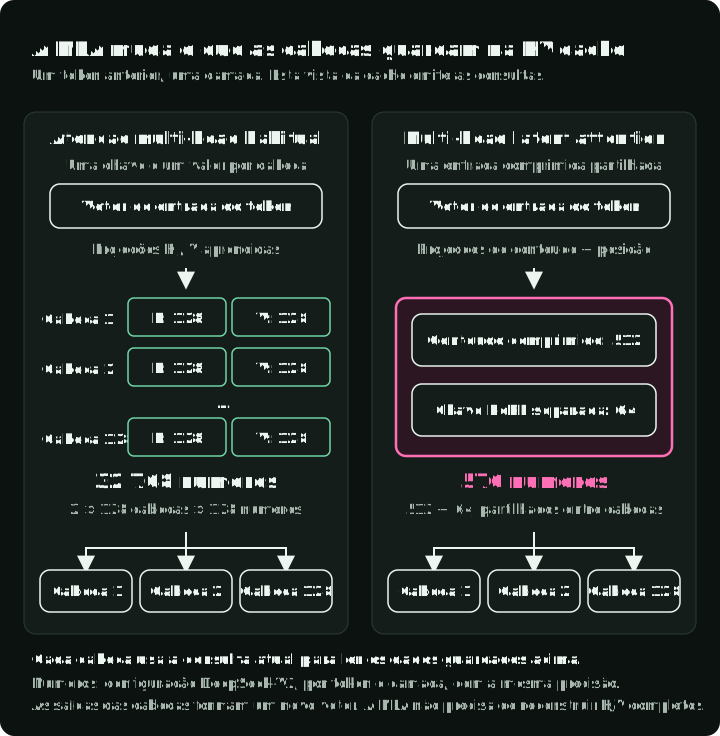
O percurso do conteúdo no diagrama corresponde a três equações do DeepSeek-V2:
é o vetor de entrada do token . A primeira linha transforma-o no vetor mais curto guardado na cache, . As duas seguintes transformam esse mesmo vetor em chaves de conteúdo e valores de todas as cabeças. Os sobrescritos são etiquetas, não potências: designa a projeção de redução, e as projeções de expansão da chave e do valor, e marca a parte de conteúdo. As três matrizes são aprendidas. A chave de posição separada está fora destas três equações.
Para a configuração do DeepSeek-V2, a comparação é 32 768 números contra 576: a atenção habitual com 128 cabeças e 128 números em cada chave e valor precisa de ; a MLA mantém um vetor comprimido de 512 números e uma chave de posição de 64. São cerca de 57 vezes menos números guardados com a mesma precisão. Compara esta configuração com a atenção multi-head habitual, não com todos os desenhos de cache, e não implica inferência 57 vezes mais rápida.
Expandir o vetor comprimido de cada token antigo eliminaria o benefício? A MLA pode evitar essa expansão. Para uma cabeça, abrevie para e chame às linhas de dessa cabeça a sua matriz de expansão da chave, . Então:
O lado esquerdo expande cada vetor em cache numa chave antes de o comparar com a consulta . O lado direito transforma a consulta atual uma vez e depois compara-a diretamente com os vetores em cache. É o mesmo cálculo, agrupado de outra forma. O cálculo dos valores tem uma reorganização semelhante: primeiro faça a média dos vetores comprimidos e depois aplique as projeções de saída. Uma implementação pode escolher a ordem de multiplicação que se adequa ao seu hardware.
A RoPE precisa de tratamento separado. Rodar as chaves de conteúdo expandidas introduziria uma operação dependente da posição nessa reorganização. Por isso, a MLA deixa essas chaves sem rotação e acrescenta uma comparação consulta–chave separada para a posição. É por isso que a cache contém tanto o vetor de conteúdo comprimido como uma pequena chave de posição rodada.
A MLA é uma arquitetura aprendida, não um compressor sem perdas aplicável a qualquer camada de atenção existente. DeepSeek-V2 v5, §2.1.2–2.1.3, equações (9)–(19) define as projeções e o componente RoPE separado. A leitura detalhada da MLA apresenta as formas completas e as reorganizações de matrizes.
Atenção esparsa (DSA): um avaliador barato escolhe as chaves
A DSA reduz quantos tokens participam em cada cálculo de atenção. Suponha que um modelo continua o texto «The cat sat on a mat near me». Trate cada palavra como um token neste exemplo. O modelo está a processar o último token, «me», na posição 8.
Numa camada de atenção, a representação do token atual produz um vetor de consulta. Cada token disponível tem uma chave, com a qual se compara a consulta, e um valor, que fornece informação à saída. Durante a geração, a camada guarda os dados de atenção dos tokens anteriores na sua KV cache, para reutilizar esses vetores. «Posição 2» identifica os dados guardados de «cat»; a cache contém vetores numéricos, não apenas números de posição. A MLA guarda esses dados na forma comprimida descrita acima.
A atenção causal densa compara a consulta atual com todas as chaves disponíveis, incluindo a do token atual. A softmax converte essas pontuações em pesos e a camada combina os valores com esses pesos. A DSA acrescenta um passo de seleção mais barato antes desse cálculo:
- Pontuar os tokens disponíveis com baixo custo. Uma pequena rede aprendida, o lightning indexer, usa as suas próprias projeções de consulta e chave para pontuar cada posição para o token atual. Estima quais os tokens que a atenção principal mais usará.
- Selecionar as posições com maior pontuação. No exemplo, «cat» e «mat» recebem as duas maiores pontuações do indexador. Selecionar as posições 2 e 6 diz à atenção principal que entradas guardadas deve ler.
- Calcular a atenção nessas entradas. A atenção principal calcula as suas próprias pontuações consulta–chave para as entradas selecionadas, aplica softmax a esse subconjunto e combina os seus valores. As pontuações do indexador escolhem as entradas; não são os pesos finais da atenção.
Siga uma coluna desde o token de texto à sua entrada guardada e compare os cálculos denso e esparso. Todas as pontuações e pesos abaixo são ilustrativos.
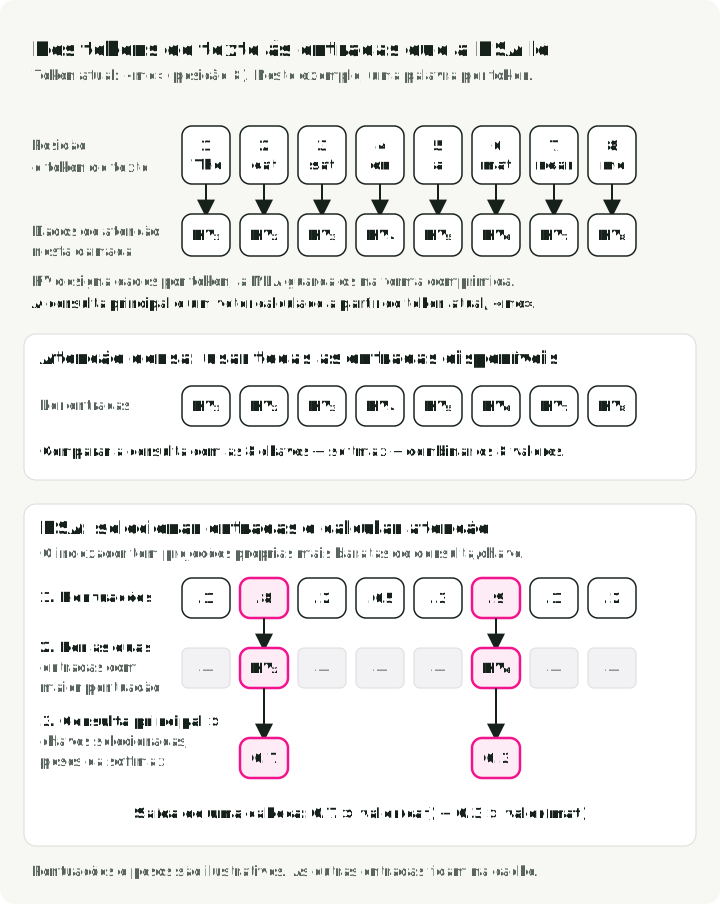
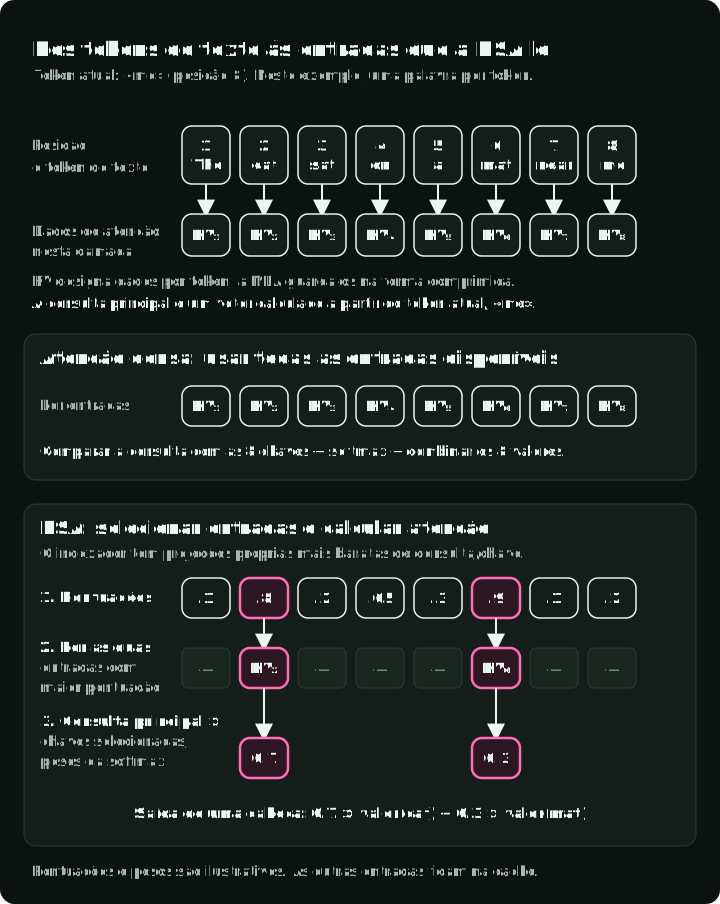
A equação do indexador no artigo dá a primeira linha de pontuações no painel DSA:
é a posição atual e uma posição candidata. O sobrescrito identifica os vetores próprios do indexador. Para cada uma das suas cabeças, compare a consulta com a chave , substitua um produto escalar negativo por zero com ReLU, multiplique pelo peso aprendido dependente do token e some sobre as cabeças . O resultado é uma pontuação de seleção.
Podemos escrever a seleção e a saída de uma cabeça da atenção principal como:
é a linha de pontuações das posições disponíveis de 1 a . TopKIndices devolve as posições das maiores pontuações, até entradas. A soma lê-se «somar os valores ponderados apenas nas posições de ». Aqui é um peso de softmax da atenção principal acabado de calcular, o seu vetor de valor e a saída. Na figura, e . Isto reescreve a notação de entradas selecionadas do artigo como uma soma explícita; a MLA pode calculá-la na forma comprimida.
As outras entradas mantêm-se na cache. Uma consulta diferente pode selecionar outro subconjunto. O treino ensina o indexador a aproximar a distribuição da atenção principal sobre os tokens, primeiro com atenção densa e depois em conjunto com atenção esparsa. Uma seleção fraca pode omitir informação útil.
O DeepSeek-V3.2 aplica a DSA à cache comprimida da MLA e seleciona até 2048 posições por consulta. Na última posição de um contexto de 131 072 tokens, a atenção principal lê uma entrada em cada 64. Quando há menos de 2048 posições disponíveis, pode usá-las todas.
A poupança vem de fazer menos comparações de atenção dispendiosas. O indexador continua a pontuar todas as posições disponíveis, mas usa menos cabeças e pode calcular em FP8. Numa sequência de comprimento , as comparações da atenção principal passam de aproximadamente para , em que é a quantidade selecionada. O trabalho do indexador sobre todos os pares continua quadrático, pelo que o método completo não é estritamente linear no comprimento da sequência.
Consulte DeepSeek-V3.2 v1, §2.1, equações (1)–(4) e a leitura detalhada da DSA para as equações de pontuação e treino.
Gated DeltaNet: uma memória de tamanho fixo que sobrescreve
A atenção densa, a MLA e a DSA mantêm um registo crescente dos tokens anteriores. A Gated DeltaNet atualiza antes uma única matriz de tamanho fixo. A camada calcula uma chave, um valor e uma consulta a partir das representações de entrada dos tokens, usando projeções aprendidas e filtros curtos sobre tokens próximos. A chave e o valor atualizam a matriz; a consulta lê a matriz atualizada para produzir um vetor de saída. Não pode voltar separadamente à chave e ao valor de cada token antigo.
A comparação útil é com uma memória aditiva simples. Suponha que a memória devolve atualmente 2 para uma certa chave e que o token seguinte fornece o valor 5 para a mesma chave. Somar o novo valor produziria 7. Uma atualização delta soma a correção, , pelo que uma escrita com intensidade total produz 5.
O exemplo usa a chave , que lê a primeira coluna da matriz: um vezes a primeira coluna mais zero vezes a segunda. A coluna realçada mostra a correção. Depois da escrita, uma consulta lê a partir dela. A matriz mantém o mesmo tamanho.
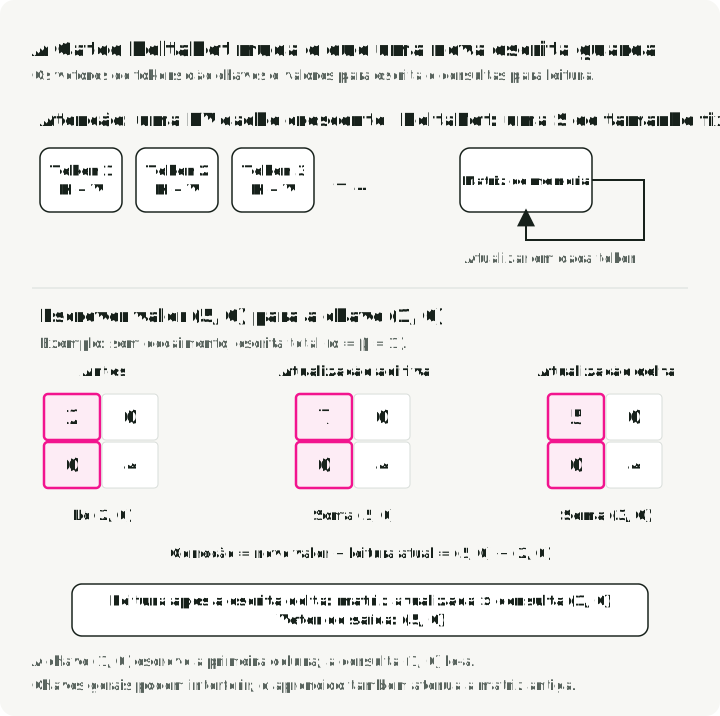
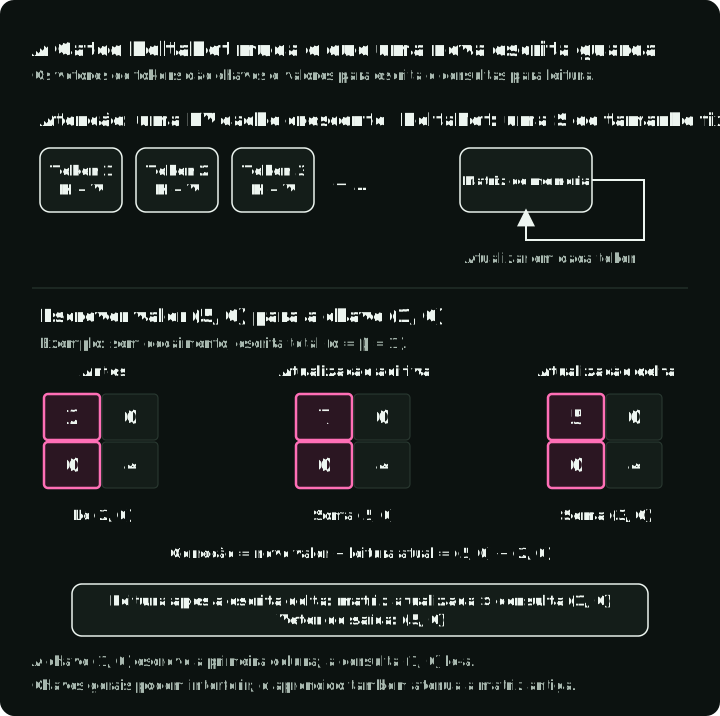
A Gated DeltaNet também aprende quanto da memória antiga deve manter e com que intensidade deve aplicar cada correção:
é a matriz de memória, é a chave atual de comprimento unitário e o seu novo valor. O fator atenua a memória antiga. Ler a memória atenuada com dá a sua resposta atual; subtrair essa resposta a dá a correção. O fator controla quanto escrever. Ambos os fatores são calculados a partir do token atual. Multiplicar a matriz atualizada pela consulta dá a leitura, que a camada depois normaliza, modula e projeta na sua saída. O exemplo de 2 para 5 usa o seu valor limite de 1.
A memória fixa poupa espaço, mas as escritas podem interferir: mudar a resposta para uma chave pode alterá-la para outra chave não ortogonal. O decaimento também elimina informação antiga. Isto ajuda a explicar por que razão o artigo combina camadas recorrentes com atenção de janela deslizante em modelos híbridos, mantendo entradas separadas para tokens recentes.
A forma apresentada reorganiza Gated Delta Networks v3, §3.1, equação (10). A leitura detalhada deriva-a e percorre a atualização da matriz.
Encaminhamento MoE: o viés escolhe especialistas, a pontuação dá-lhes peso
Uma camada de mistura de especialistas (MoE) tem várias redes feed-forward, chamadas especialistas, e seleciona apenas algumas para cada token. Isto acrescenta capacidade ao modelo sem executar todos os especialistas para todas as entradas. Altera a parte feed-forward de um Transformer, não as suas cabeças de atenção.
A regra de encaminhamento específica do DeepSeek-V3 separa duas decisões: que especialistas executam e quanto contam as suas saídas. Um router aprendido recebe o vetor do token atual e dá a cada especialista uma pontuação . Um viés de equilíbrio de carga muda a pontuação de seleção para . Depois da seleção, os pesos de saída vêm das pontuações originais, normalizadas sobre os especialistas selecionados. O viés não entra nesses pesos.
O exemplo seleciona dois de quatro especialistas. O especialista 1 tem a maior pontuação bruta, mas o seu viés negativo exclui-o; executam antes os especialistas 2 e 3. Ambos recebem o mesmo vetor de token . Cada um produz um novo vetor, escrito ou , e a camada soma essas saídas com pesos 0,56 e 0,44. O diagrama mostra apenas esta contribuição dos especialistas encaminhados.
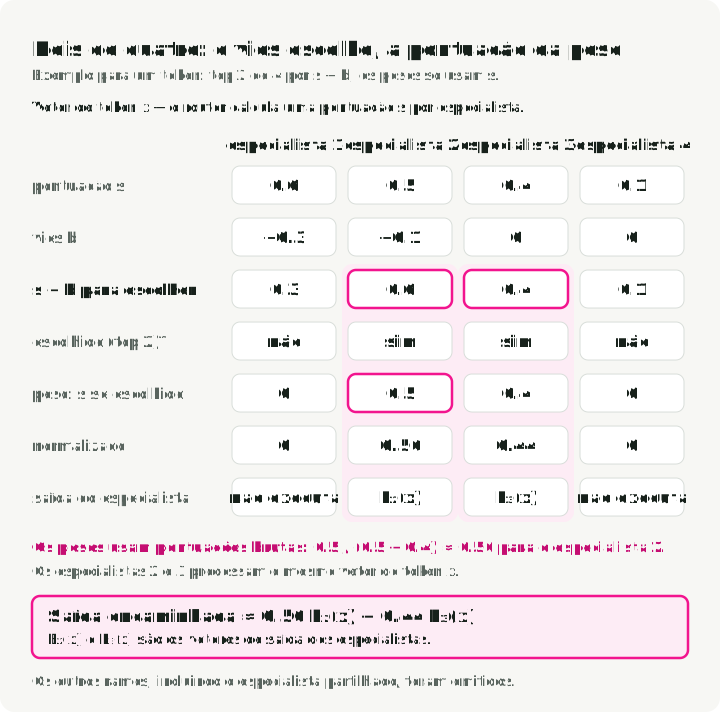
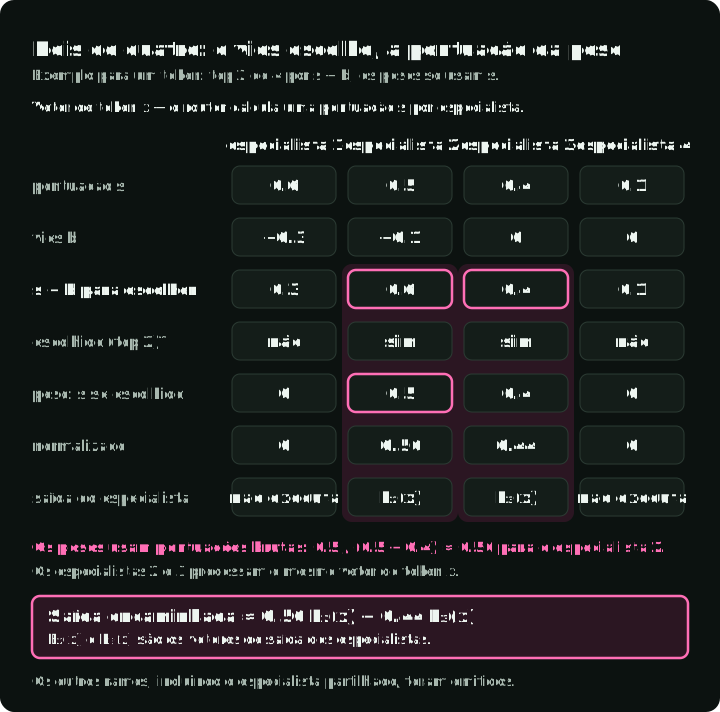
Uma forma compacta da regra de encaminhamento do DeepSeek-V3, para um token, é:
e reúnem as pontuações e os vieses de todos os especialistas; é a quantidade a selecionar. A primeira linha devolve os índices dos especialistas selecionados, . A chaveta na segunda linha é um if/else: divida a pontuação original de um especialista selecionado pela soma das pontuações selecionadas, ou atribua zero se não tiver sido selecionado. A última linha soma os vetores de saída dos especialistas com esses pesos. Na figura, , pelo que e . O viés só aparece na seleção. As contribuições residual e do especialista partilhado estão fora de .
Durante o treino, o viés de um especialista demasiado usado desce e o de um especialista pouco usado sobe. Isto promove uma carga mais uniforme. O DeepSeek-V3 também mantém uma pequena perda de equilíbrio por sequência, pelo que «auxiliary-loss-free» não significa que o modelo não tenha nenhuma perda de equilíbrio.
A sua configuração ativa 8 de 256 especialistas encaminhados por token, mais um especialista partilhado que executa sempre. Estas quantidades e o especialista partilhado pertencem a este modelo, não à definição de MoE. Consulte DeepSeek-V3 v2, §2.1.2, equações (12)–(17) e a leitura do encaminhamento.
mHC: mistura residual restrita a médias ponderadas
Uma ligação residual habitual leva um vetor de token a contornar uma subcamada e soma-lhe o resultado dessa subcamada. A mHC mantém vários desses vetores, chamados fluxos residuais, e altera a forma como se misturam entre camadas. A sua matriz de mistura ideal tem entradas não negativas, com linhas e colunas a somar um. Essa mistura forma médias ponderadas preservando o total entre fluxos. A implementação aproxima esta restrição com um número finito de passos de normalização; não restringe todas as operações da rede.
O artigo separado sobre mHC explica o mecanismo, a normalização e os limites com diagramas. Use-o para esse tema; a leitura da equação fornece a derivação.
LoRA: uma atualização de baixo posto ao lado de um peso congelado
O fine-tuning completo atualiza as matrizes de pesos do modelo. A LoRA congela uma matriz pré-treinada e aprende uma correção menor em paralelo:
é o vetor de token que entra na camada linear escolhida, e o vetor de saída passado adiante pelo modelo. A multiplicação original continua a ser executada. Na correção, transforma a entrada num vetor muito menor, e transforma-o de volta para o tamanho da saída. Os exemplos de treino e a perda da tarefa determinam as atualizações de e ; fica fixo. A pequena dimensão partilhada é a configuração de posto ; a atualização resultante tem posto no máximo .
Para uma matriz de pesos e , uma atualização completa tem cerca de 16,8 milhões de entradas. As duas matrizes LoRA têm : 256 vezes menos entradas treináveis para esta matriz. Isto reduz o armazenamento de gradientes e do estado do otimizador, mas o peso de base completo continua a ocupar memória e a participar no cálculo.
Siga os dois percursos a partir da mesma entrada: a matriz congelada continua a calcular a sua saída, enquanto a correção treinável passa por apenas oito números.
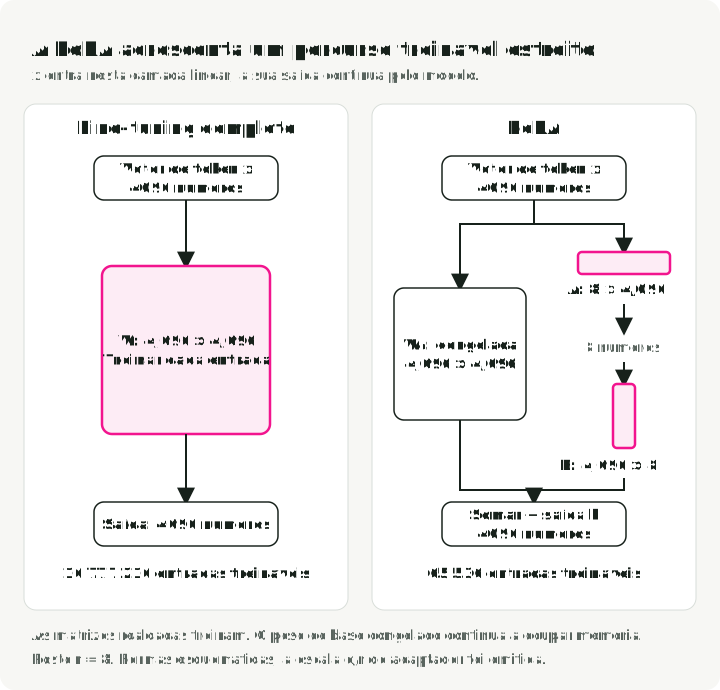
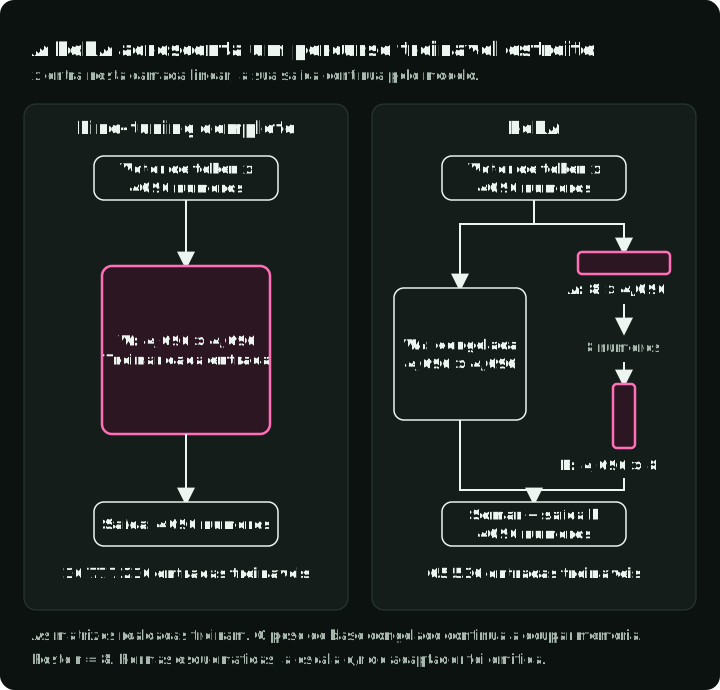
No método original, começa a zero, pelo que a correção inicialmente não altera nada. O artigo escala a atualização por , uma configuração omitida da sua equação (3) acima. Depois do treino, a correção escalada pode ser somada a ; a camada fundida só precisa então da multiplicação de matrizes original. Manter os adaptadores separados acrescenta cálculo, mas permite trocá-los.
Consulte LoRA v2, §4.1, equação (3) e a leitura detalhada da LoRA. A QLoRA guarda adicionalmente os pesos de base congelados em formato de 4 bits e desquantiza-os para o cálculo; não torna toda a memória de treino de 4 bits. O guia de fine-tuning compara as opções práticas.
Leituras opcionais de equações
As leituras de equações indicadas contêm definições de símbolos, derivações intermédias e verificações com números pequenos. Foram produzidas com as instruções para agentes de programação de paper-math-skills. São explicações suplementares; os artigos científicos ligados junto de cada mecanismo são as fontes primárias.
Fontes e versões
As ligações acima identificam as versões usadas para os números de secção e de equação. Para a atenção original de referência, consulte Attention Is All You Need v7, §3.2 e §3.5. Para o tema separado da mistura residual, consulte mHC v2.