Czytanie równań architektury: RoPE, MLA, MoE i LoRA

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten artykuł wyjaśnia, co zmienia sześć metod architektury modeli: skąd uwaga bierze informację o pozycji, co przechowuje w pamięci, których tokenów lub ekspertów używa i które wagi aktualizuje fine-tuning. Jest przeznaczony dla inżynierów, którzy znają ogólną budowę Transformera, ale chcą zrozumieć RoPE, MLA, rzadką uwagę, Gated DeltaNet, MoE i LoRA bez przechodzenia przez wyprowadzenia w każdej publikacji. Diagramy porównują mechanizmy; równania wyjaśniają główną zmianę.
Token wchodzi do modelu jako wektor liczbowy o nazwie embedding. Każda warstwa aktualizuje tę reprezentację. W uwadze trzy mnożenia przez wyuczone macierze, czyli rzutowania, przekształcają wejściowe wektory tokenów w zapytania (), klucze () i wartości (). Etykiety , i na diagramie oznaczają te wyuczone macierze.
Warstwa uwagi porównuje zapytania z kluczami, aby ustalić wagę wartości każdego tokena. Dla jednej głowicy obliczenie wygląda tak:
Czytaj operacje po kolei: porównuje każde zapytanie z każdym kluczem; transponuje macierz kluczy, aby wektory pasowały do mnożenia. Podziel przez pierwiastek z ich długości , a potem zastosuj softmax do każdego wiersza, aby otrzymać wagi. Mnożenie przez uśrednia wartości z tymi wagami. Wynikiem jest zaktualizowany wektor każdego tokena, przekazywany dalej przez warstwę. W przyczynowym modelu językowym uwaga wyklucza przyszłe tokeny przed softmaxem. Część 1 przechodzi przez to obliczenie na małych macierzach.
Pierwsze cztery sekcje zmieniają to obliczenie lub jego pamięć. MoE zmienia sieć feed-forward, a LoRA zmienia sposób trenowania wag. Sekcje można czytać niezależnie; diagram MLA korzysta z mechanizmu pozycji wprowadzonego w sekcji RoPE.
RoPE: pozycja jako obrót
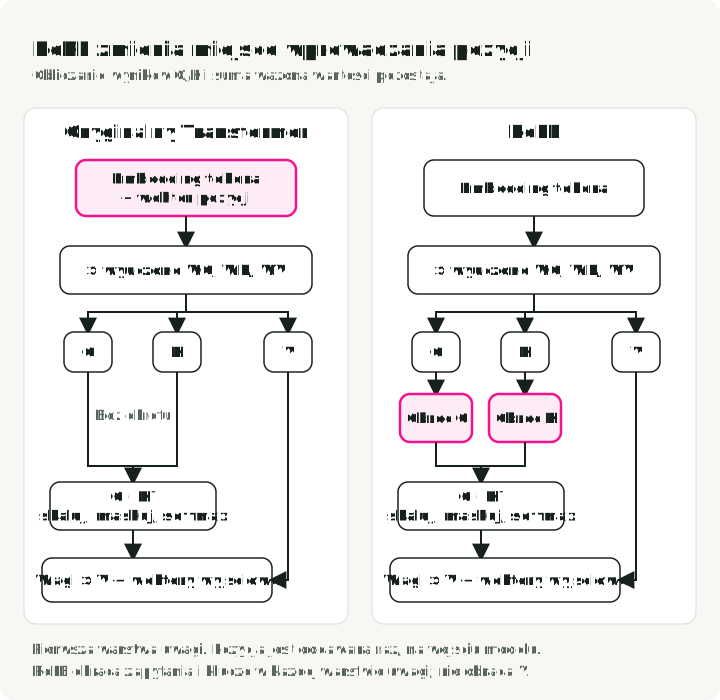
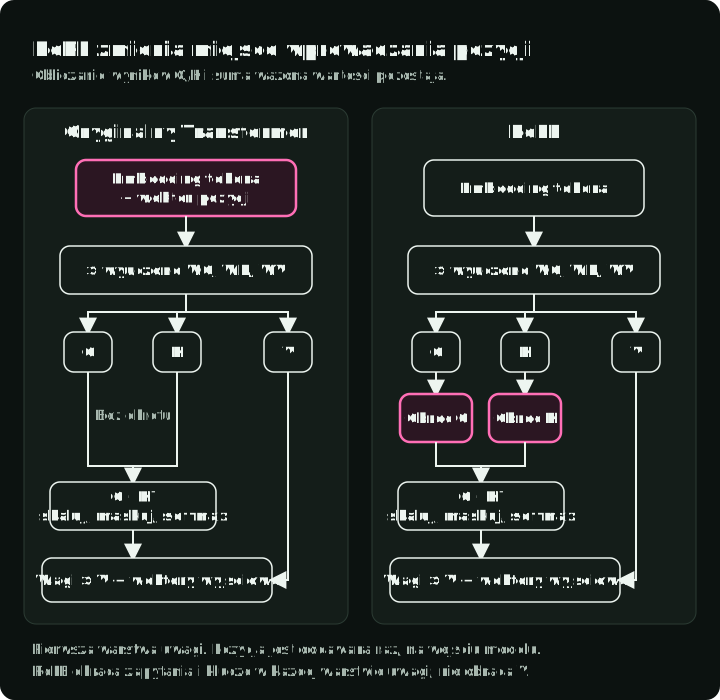
Iloczyn skalarny zapytania i klucza porównuje wektory treści. Sam nie mówi, czy dwa tokeny są obok siebie, czy dzieli je sto pozycji. Oryginalny Transformer dodaje wektor pozycji do embeddingu każdego tokena przed pierwszą warstwą uwagi. Informacja o pozycji wpływa następnie na zapytania, klucze i wartości obliczane z tych wejść. Nie obraca ich. Zobacz Attention Is All You Need, §3.5.
RoPE dodaje pozycję do samego porównania zapytania z kluczem. Najpierw oblicz zapytania i klucze za pomocą zwykłych wyuczonych rzutowań. Następnie obróć pary ich współrzędnych o kąty określone przez pozycję każdego tokena. Oblicz wyniki uwagi z obróconych wektorów. RoPE nie obraca wartości.
Dwa poniższe panele pokazują, gdzie wprowadzana jest pozycja. W obu przypadkach obliczanie wartości ważonych nadal następuje po obliczaniu wyników.
Dla jednej pary współrzędnych obrót jest mnożeniem macierzy:
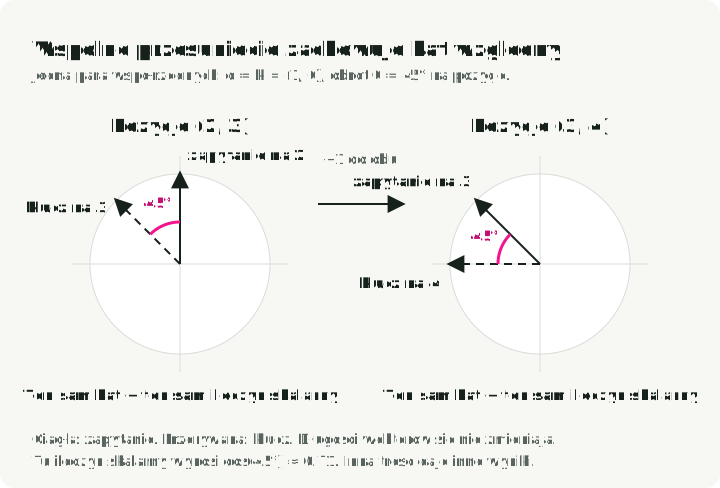
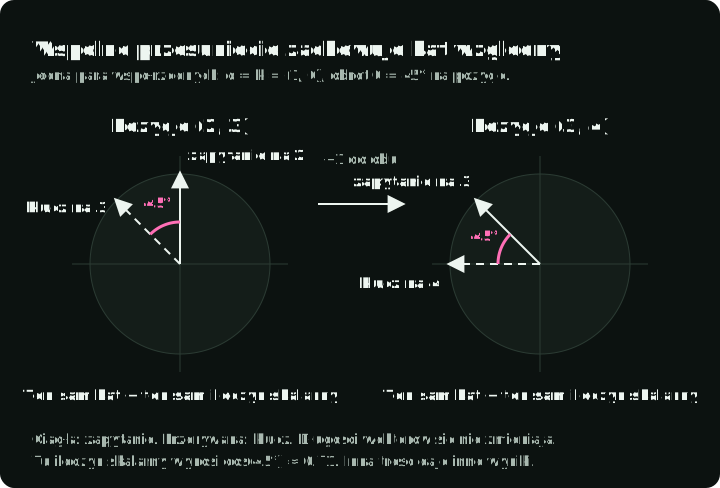
to kąt obrotu. Pomnożenie tej macierzy przez daje ; dla 90° jest to , czyli skierowana w górę strzałka zapytania na następnym diagramie.
Dlaczego obrót? Iloczyn skalarny zależy od kąta między wektorami. Obrót obu wektorów o ten sam dodatkowy kąt nie zmienia ich iloczynu skalarnego. Jeśli zapytanie z pozycji 2 i klucz z pozycji 3 przesuną się na pozycje 3 i 4, różnica ich pozycji nadal wynosi jeden. Przy tych samych wektorach treści RoPE daje ten sam wynik:
Tutaj i to po jednej parze współrzędnych zapytania i klucza, je obraca, i to pozycje tokenów, a to kąt obrotu na pozycję. Prawa strona pokazuje przydatną własność: jawny składnik pozycyjny używa różnicy . Wynik nadal zależy od wektorów treści, nie tylko od odległości.
Na diagramie oba początkowe wektory wynoszą , a obrót to 45° na pozycję. Są to wybrane wartości przykładowe: utrzymanie stałej treści pozwala zobaczyć efekt przesunięcia obu pozycji.
Pełne zapytanie lub klucz ma wiele par współrzędnych. RoPE obraca je z różnymi szybkościami, więc reprezentują różnice pozycji w kilku skalach. Nie gwarantuje to dobrej uwagi przy dowolnej długości kontekstu ani tego, że każdy wynik maleje z odległością.
Macierze obrotu i ich wyprowadzenie znajdują się w RoFormer v5, §3.2, równania (12)–(16). Szczegółowy rozbiór RoPE zawiera pośrednie przekształcenia algebraiczne i sprawdzenia liczbowe.
MLA: przechowuj mały wektor zamiast kluczy i wartości
Głowice uwagi istniały przed MLA. Uwaga wielogłowicowa oryginalnego Transformera, §3.2.2 wykonuje kilka obliczeń uwagi z różnymi wyuczonymi rzutowaniami i łączy ich wyniki. DeepSeek zachowuje wiele głowic. Zmienia sposób reprezentacji i przechowywania ich kluczy i wartości.
Podczas generowania zwykła uwaga wielogłowicowa przechowuje klucz i wartość każdego poprzedniego tokena dla każdej głowicy. Ten KV cache rośnie wraz z sekwencją. MLA używa wyuczonego rzutowania, aby bezpośrednio przekształcić wejściową reprezentację tokena w jeden krótki wektor. Można z niego obliczyć klucze treści i wartości głowic. Wszystkie głowice współdzielą ten przechowywany wektor, lecz używają różnych rzutowań i wag uwagi; nie stają się identycznymi głowicami.
Diagram przedstawia jeden token od jego wektora wejściowego do danych przechowywanych w jednej warstwie. Po obu stronach późniejsze zapytania odczytują te dane przez wiele głowic; wyniki głowic są łączone w wynik uwagi.
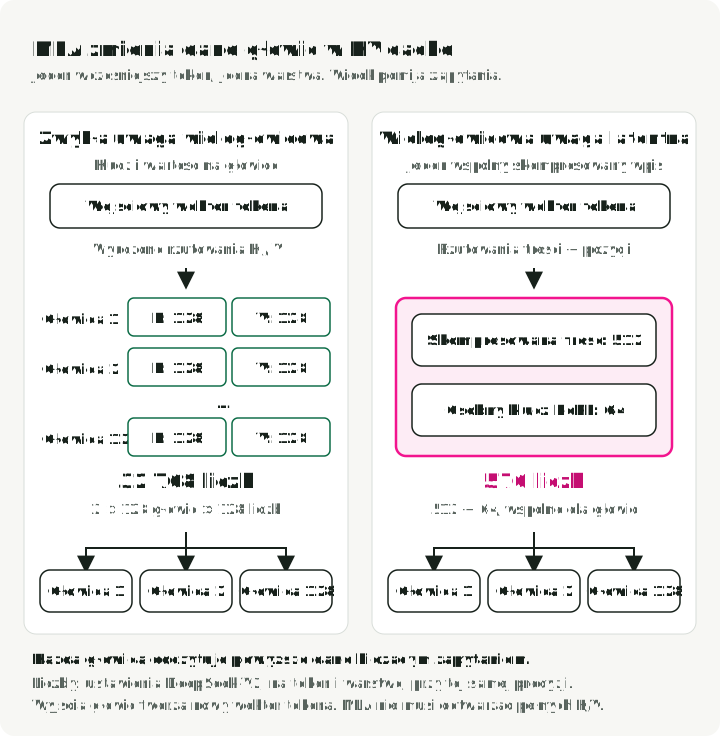
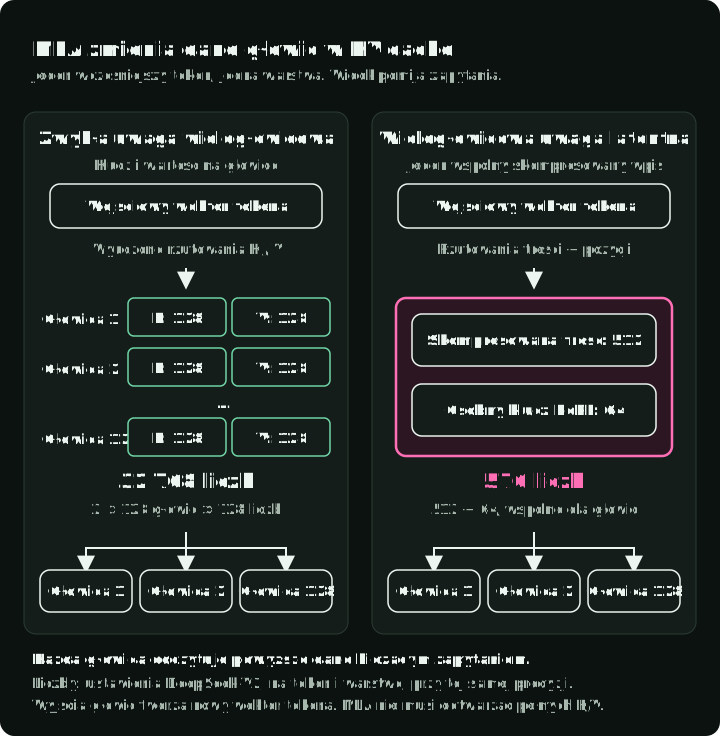
Ścieżka treści na diagramie odpowiada trzem równaniom z DeepSeek-V2:
to wektor wejściowy tokena . Pierwsza linia przekształca go w krótszy przechowywany wektor . Kolejne dwie przekształcają ten sam wektor w klucze treści i wartości dla wszystkich głowic. Indeksy górne to etykiety, nie potęgi: oznacza rzutowanie zmniejszające wymiar, i oznaczają rzutowania zwiększające wymiar kluczy i wartości, a oznacza część treści. Wszystkie trzy macierze są wyuczone. Osobny klucz pozycji pozostaje poza tymi trzema równaniami.
Dla konfiguracji DeepSeek-V2 porównanie wynosi 32 768 liczb wobec 576: zwykła uwaga ze 128 głowicami i 128 liczbami w każdym kluczu i wartości wymaga ; MLA zachowuje skompresowany wektor 512 liczb i klucz pozycji 64 liczb. To około 57 razy mniej przechowywanych liczb przy tej samej precyzji. Porównanie dotyczy tej konfiguracji i zwykłej uwagi wielogłowicowej, nie każdego projektu pamięci podręcznej, i nie oznacza 57 razy szybszej inferencji.
Czy rozwijanie skompresowanego wektora każdego starego tokena usunęłoby tę korzyść? MLA może uniknąć tego rozwijania. Dla jednej głowicy skróć do , a należące do tej głowicy wiersze nazwij jej macierzą rozwijania klucza . Wtedy:
Lewa strona rozwija każdy przechowywany wektor w klucz przed porównaniem go z zapytaniem . Prawa strona przekształca bieżące zapytanie raz, a potem porównuje je bezpośrednio z przechowywanymi wektorami. To samo obliczenie, inaczej pogrupowane. Obliczenie wartości ma podobne przekształcenie: najpierw uśrednij skompresowane wektory, a potem zastosuj rzutowania wyjściowe. Implementacja może wybrać kolejność mnożenia pasującą do jej sprzętu.
RoPE wymaga osobnego potraktowania. Obracanie rozwiniętych kluczy treści wprowadziłoby do tego przekształcenia operację zależną od pozycji. Dlatego MLA pozostawia te klucze bez obrotu i dodaje osobne porównanie zapytania z kluczem dla pozycji. To dlatego pamięć podręczna zawiera zarówno skompresowany wektor treści, jak i mały obrócony klucz pozycji.
MLA to wyuczona architektura, a nie bezstratny kompresor, który można zastosować do dowolnej istniejącej warstwy uwagi. DeepSeek-V2 v5, §2.1.2–2.1.3, równania (9)–(19) definiuje rzutowania i osobny składnik RoPE. Szczegółowy rozbiór MLA podaje pełne kształty i przekształcenia macierzy.
Rzadka uwaga (DSA): tani moduł oceniający wybiera klucze
DSA zmniejsza liczbę tokenów uczestniczących w każdym obliczeniu uwagi. Załóżmy, że model kontynuuje tekst „The cat sat on a mat near me”. Na potrzeby przykładu traktuj każde słowo jako jeden token. Model przetwarza ostatni token, „me”, na pozycji 8.
W jednej warstwie uwagi reprezentacja bieżącego tokena tworzy wektor zapytania. Każdy dostępny token ma klucz, z którym porównuje się zapytanie, i wartość, która dostarcza informacji do wyniku. Podczas generowania warstwa przechowuje dane uwagi wcześniejszych tokenów w swoim KV cache, aby ponownie używać tych wektorów. „Pozycja 2” identyfikuje przechowywane dane dla „cat”; pamięć podręczna zawiera wektory liczbowe, nie tylko numery pozycji. MLA przechowuje te dane w opisanej wyżej skompresowanej postaci.
Gęsta uwaga przyczynowa porównuje bieżące zapytanie z każdym dostępnym kluczem, w tym z kluczem bieżącego tokena. Softmax zamienia te wyniki na wagi, a warstwa łączy wartości z tymi wagami. DSA dodaje przed tym obliczeniem tańszy krok wyboru:
- Tanio oceń dostępne tokeny. Mała wyuczona sieć, lightning indexer, używa własnych rzutowań zapytań i kluczy, aby ocenić każdą pozycję dla bieżącego tokena. Szacuje, z których tokenów główna uwaga skorzysta najbardziej.
- Wybierz pozycje z najwyższymi wynikami. W przykładzie „cat” i „mat” dostają dwa najwyższe wyniki indeksatora. Wybór pozycji 2 i 6 mówi głównej uwadze, które przechowywane wpisy odczytać.
- Oblicz uwagę na tych wpisach. Główna uwaga oblicza własne wyniki zapytanie–klucz dla wybranych wpisów, stosuje softmax na tym podzbiorze i łączy ich wartości. Wyniki indeksatora wybierają wpisy; nie są końcowymi wagami uwagi.
Prześledź kolumnę od tokena tekstu do jego przechowywanego wpisu, a następnie porównaj obliczenia gęste i rzadkie. Wszystkie poniższe wyniki i wagi są przykładowe.
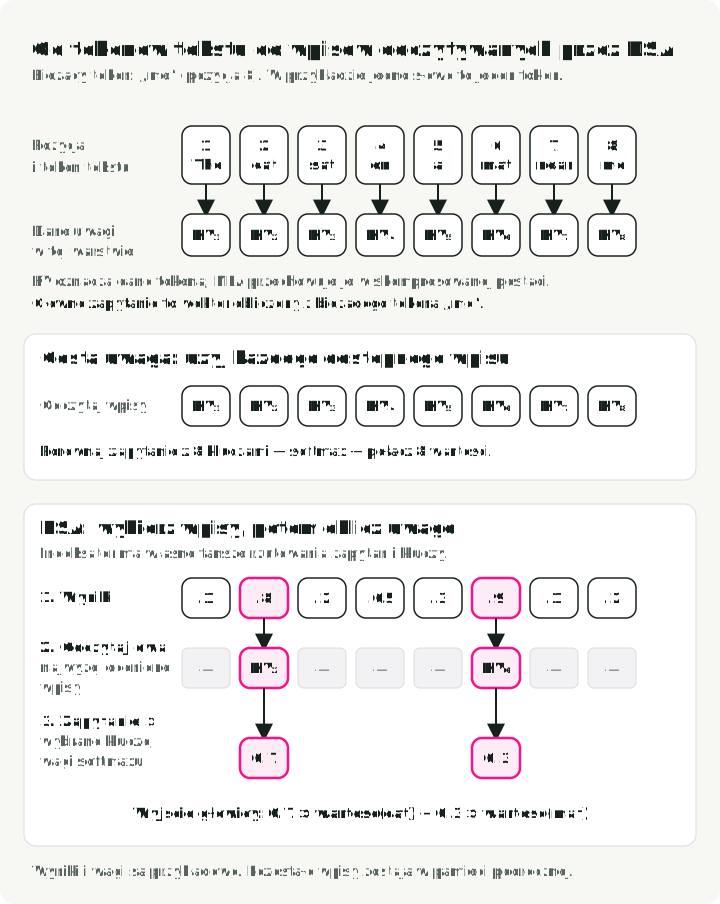
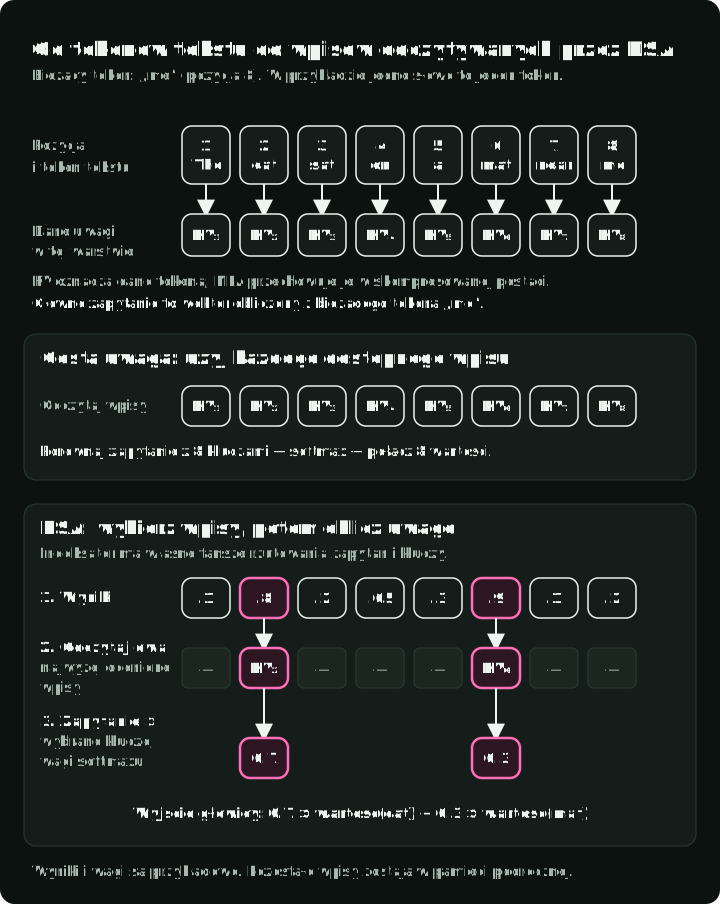
Równanie indeksatora z publikacji daje pierwszy wiersz wyników w panelu DSA:
to bieżąca pozycja, a pozycja kandydująca. Indeks górny oznacza własne wektory indeksatora. Dla każdej z jego głowic porównaj zapytanie z kluczem , zamień ujemny iloczyn skalarny na zero za pomocą ReLU, pomnóż przez wyuczoną wagę zależną od tokena i zsumuj po głowicach . Wynik jest oceną do wyboru.
Wybór i wynik jednej głowicy głównej uwagi można zapisać jako:
to wiersz wyników dla dostępnych pozycji od 1 do . TopKIndices zwraca pozycje o najwyższych wynikach, do wpisów. Sumę czytaj jako „dodaj wartości ważone tylko dla pozycji w ”. Tutaj jest nowo obliczoną wagą softmaxu głównej uwagi, jej wektorem wartości, a wynikiem. Na rysunku i . To zapis notacji wybranych wpisów z publikacji jako jawnej sumy; MLA może obliczyć ją w skompresowanej postaci.
Pozostałe wpisy pozostają w pamięci podręcznej. Inne zapytanie może wybrać inny podzbiór. Trening uczy indeksator przybliżać rozkład głównej uwagi po tokenach, najpierw z gęstą uwagą, a potem równolegle z rzadką uwagą. Zły wybór może pominąć przydatne informacje.
DeepSeek-V3.2 stosuje DSA do skompresowanej pamięci podręcznej MLA i wybiera do 2048 pozycji na zapytanie. Na ostatniej pozycji kontekstu 131 072 tokenów główna uwaga odczytuje jeden wpis na 64. Gdy dostępnych jest mniej niż 2048 pozycji, może użyć wszystkich.
Oszczędność wynika z mniejszej liczby kosztownych porównań uwagi. Indeksator nadal ocenia każdą dostępną pozycję, ale używa mniej głowic i może liczyć w FP8. Dla sekwencji długości liczba porównań głównej uwagi spada z około do , gdzie to liczba wybranych wpisów. Praca indeksatora nad wszystkimi parami pozostaje kwadratowa, więc cała metoda nie jest ściśle liniowa względem długości sekwencji.
Równania oceniania i treningu znajdziesz w DeepSeek-V3.2 v1, §2.1, równania (1)–(4) i szczegółowym rozbiorze DSA.
Gated DeltaNet: pamięć o stałym rozmiarze, która nadpisuje
Gęsta uwaga, MLA i DSA zachowują rosnący zapis wcześniejszych tokenów. Gated DeltaNet aktualizuje zamiast tego jedną macierz o stałym rozmiarze. Warstwa oblicza klucz, wartość i zapytanie z wejściowych reprezentacji tokenów za pomocą wyuczonych rzutowań i krótkich filtrów obejmujących pobliskie tokeny. Klucz i wartość aktualizują macierz; zapytanie odczytuje zaktualizowaną macierz, tworząc wektor wyjściowy. Nie może oddzielnie wrócić do klucza i wartości każdego starego tokena.
Przydatne jest porównanie z prostą pamięcią addytywną. Załóżmy, że dla danego klucza pamięć zwraca teraz 2, a następny token dostarcza dla tego samego klucza wartość 5. Dodanie nowej wartości dałoby 7. Aktualizacja delta dodaje korektę, , więc zapis z pełną siłą daje 5.
Przykład używa klucza , który odczytuje pierwszą kolumnę macierzy: jeden razy pierwsza kolumna plus zero razy druga. Wyróżniona kolumna pokazuje korektę. Po zapisie zapytanie odczytuje z niej . Macierz zachowuje ten sam rozmiar.
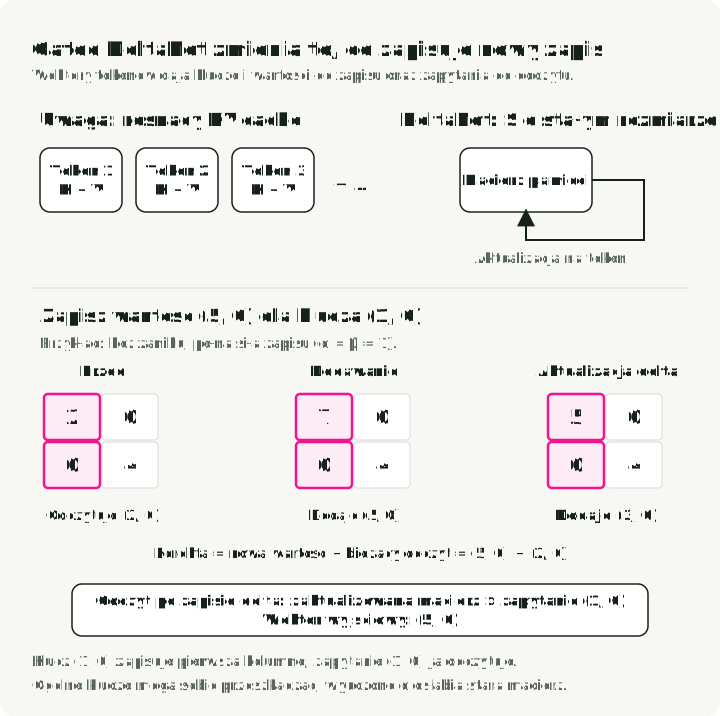
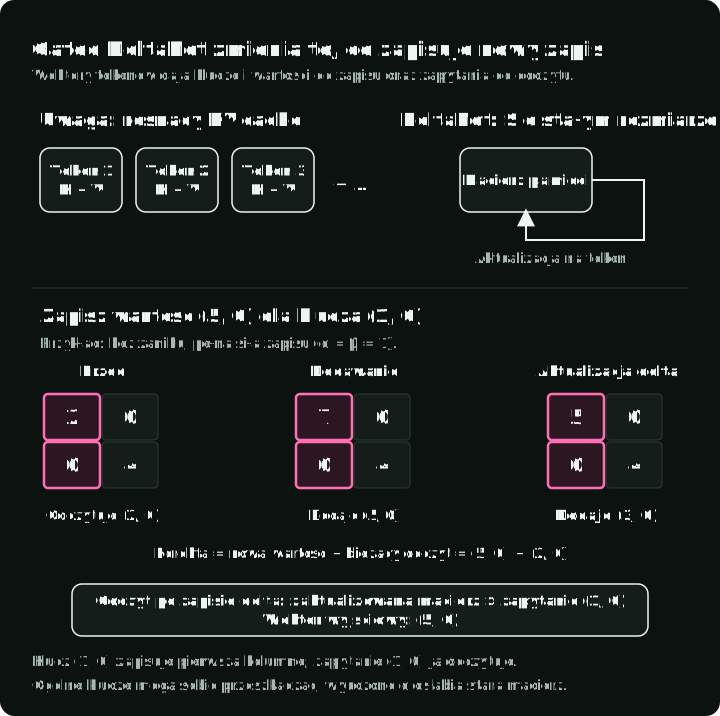
Gated DeltaNet uczy się też, ile starej pamięci zachować i jak silnie stosować każdą korektę:
to macierz pamięci, to bieżący klucz o długości jednostkowej, a to jego nowa wartość. Czynnik osłabia starą pamięć. Odczyt osłabionej pamięci kluczem daje jej bieżącą odpowiedź; odjęcie tej odpowiedzi od daje korektę. Czynnik kontroluje siłę zapisu. Oba czynniki są obliczane z bieżącego tokena. Pomnożenie zaktualizowanej macierzy przez zapytanie daje odczyt, który warstwa następnie normalizuje, bramkuje i rzutuje na swoje wyjście. Przykład od 2 do 5 używa ich granicznej wartości 1.
Stała pamięć oszczędza miejsce, ale zapisy mogą sobie przeszkadzać: zmiana odpowiedzi dla jednego klucza może zmienić ją dla innego, nieortogonalnego klucza. Zanik również usuwa stare informacje. Pomaga to wyjaśnić, dlaczego publikacja łączy warstwy rekurencyjne z uwagą w przesuwanym oknie w modelach hybrydowych, zachowując osobne wpisy dla niedawnych tokenów.
Przedstawiona postać przekształca Gated Delta Networks v3, §3.1, równanie (10). Szczegółowy rozbiór wyprowadza ją i przechodzi przez aktualizację macierzy.
Routing MoE: przesunięcie wybiera ekspertów, wynik nadaje im wagi
Warstwa mixture-of-experts (MoE) ma kilka sieci feed-forward, zwanych ekspertami, i wybiera tylko niektóre dla każdego tokena. Zwiększa to pojemność modelu bez uruchamiania każdego eksperta dla każdego wejścia. Zmienia część feed-forward Transformera, nie jego głowice uwagi.
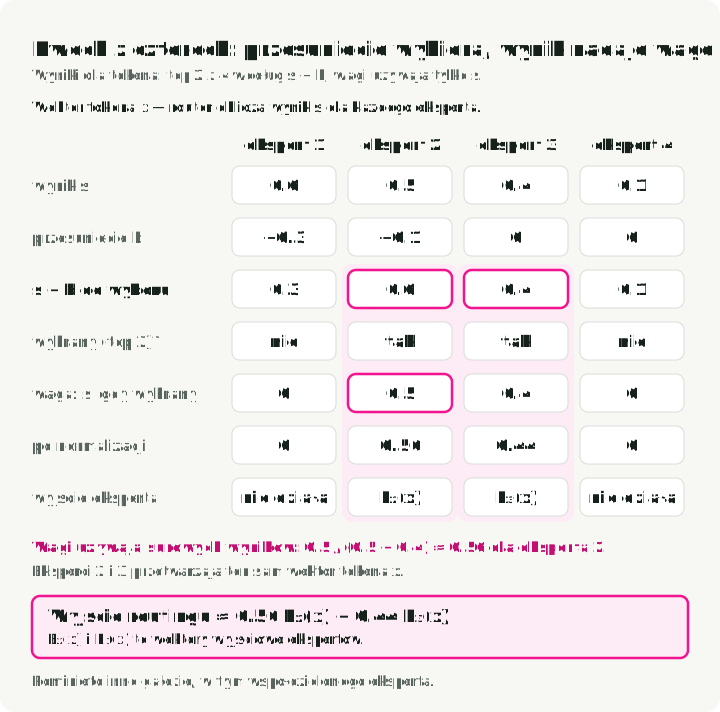
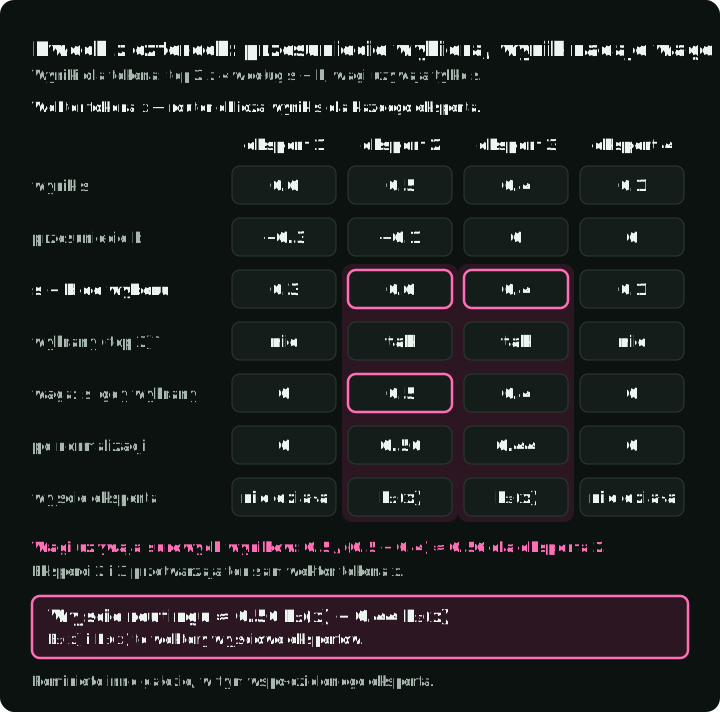
Reguła routingu DeepSeek-V3 rozdziela dwie decyzje: którzy eksperci działają i ile liczą się ich wyniki. Wyuczony router przyjmuje wektor bieżącego tokena i nadaje każdemu ekspertowi wynik . Przesunięcie równoważące zmienia wynik wyboru na . Po wyborze wagi wyjściowe pochodzą z pierwotnych wyników, znormalizowanych po wybranych ekspertach. Przesunięcie nie wchodzi do tych wag.
Prosty przykład wybiera dwóch z czterech ekspertów. Ekspert 1 ma najwyższy surowy wynik, ale jego ujemne przesunięcie go wyklucza; zamiast niego działają eksperci 2 i 3. Obaj otrzymują ten sam wektor tokena . Każdy tworzy nowy wektor, zapisany lub , a warstwa dodaje te wyniki z wagami 0,56 i 0,44. Diagram pokazuje tylko wkład ekspertów wybieranych przez router.
Zwięzła postać reguły routingu DeepSeek-V3 dla jednego tokena:
i zbierają wyniki i przesunięcia wszystkich ekspertów; to liczba wybieranych ekspertów. Pierwsza linia zwraca indeksy wybranych ekspertów . Klamra w drugiej linii to if/else: podziel pierwotny wynik wybranego eksperta przez sumę wybranych wyników albo przypisz zero, jeśli nie został wybrany. Ostatnia linia dodaje wektory wyjściowe ekspertów z tymi wagami. Na rysunku , więc i . Przesunięcie pojawia się tylko w wyborze. Wkłady połączenia rezydualnego i współdzielonego eksperta pozostają poza .
Podczas treningu przesunięcie zbyt często używanego eksperta maleje, a zbyt rzadko używanego rośnie. Sprzyja to bardziej równomiernemu obciążeniu pracą. DeepSeek-V3 zachowuje również małą stratę równoważącą na sekwencję, więc „auxiliary-loss-free” nie oznacza, że model w ogóle nie ma straty równoważącej.
Jego konfiguracja aktywuje 8 z 256 ekspertów kierowanych na token oraz jednego współdzielonego eksperta, który działa zawsze. Te liczby i współdzielony ekspert należą do tego modelu, nie do definicji MoE. Zobacz DeepSeek-V3 v2, §2.1.2, równania (12)–(17) i rozbiór routingu.
mHC: mieszanie rezydualne ograniczone do średnich ważonych
Zwykłe połączenie rezydualne przekazuje wektor tokena z pominięciem podwarstwy i dodaje do niego wynik podwarstwy. mHC utrzymuje kilka takich wektorów, zwanych strumieniami rezydualnymi, i zmienia ich mieszanie między warstwami. Idealna macierz mieszania ma elementy nieujemne, a sumy wierszy i kolumn równe jeden. To mieszanie tworzy średnie ważone, zachowując sumę po strumieniach. Implementacja przybliża to ograniczenie skończoną liczbą kroków normalizacji; nie ogranicza każdej operacji w sieci.
Osobny artykuł o mHC wyjaśnia mechanizm, normalizację i ograniczenia za pomocą diagramów. Sięgnij po niego w tym temacie; rozbiór równań podaje wyprowadzenie.
LoRA: aktualizacja niskiego rzędu obok zamrożonej wagi
Pełny fine-tuning aktualizuje macierze wag modelu. LoRA zamraża macierz po treningu wstępnym i uczy mniejszej korekty obok niej:
to wektor tokena wchodzący do wybranej warstwy liniowej, a to wektor wyjściowy przekazywany dalej przez model. Pierwotne mnożenie nadal się wykonuje. W korekcie przekształca wejście w znacznie mniejszy wektor, a przekształca go z powrotem do rozmiaru wyjścia. Przykłady treningowe i strata zadania określają aktualizacje i ; pozostaje stałe. Wspólny mały wymiar to ustawienie rzędu ; wynikowa aktualizacja ma rząd co najwyżej .
Dla macierzy wag i pełna aktualizacja ma około 16,8 miliona elementów. Dwie macierze LoRA mają : 256 razy mniej trenowanych elementów dla tej macierzy. Zmniejsza to pamięć gradientów i stanu optymalizatora, ale pełna waga bazowa nadal zajmuje pamięć i uczestniczy w obliczeniach.
Prześledź dwie ścieżki od tego samego wejścia: zamrożona macierz nadal oblicza swoje wyjście, a trenowana korekta przechodzi przez zaledwie osiem liczb.
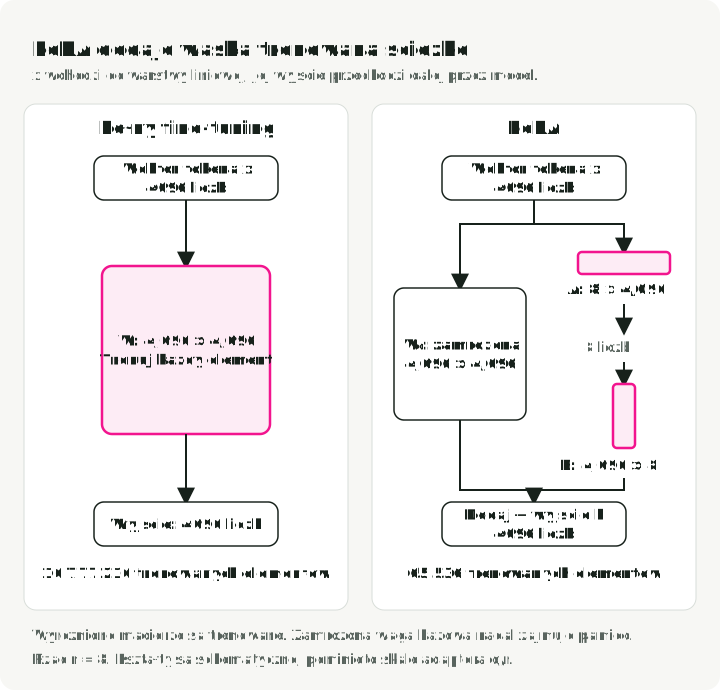
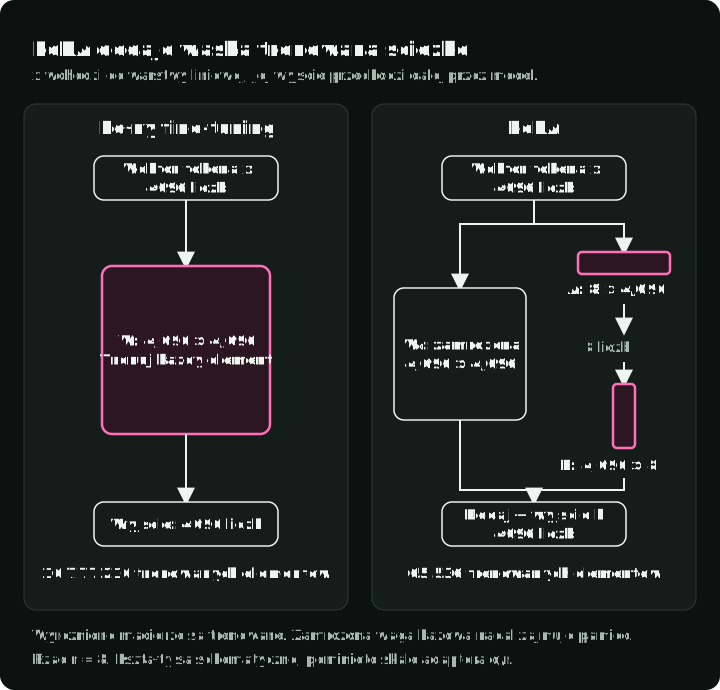
W oryginalnej metodzie zaczyna od zera, więc korekta początkowo niczego nie zmienia. Publikacja skaluje aktualizację przez , ustawienie pominięte w jej równaniu (3) powyżej. Po treningu można dodać przeskalowaną korektę do ; scalona warstwa potrzebuje wtedy tylko pierwotnego mnożenia macierzy. Oddzielne adaptery dodają obliczenia, ale pozwalają je wymieniać.
Zobacz LoRA v2, §4.1, równanie (3) i szczegółowy rozbiór LoRA. QLoRA dodatkowo przechowuje zamrożone wagi bazowe w postaci 4-bitowej i dekwantyzuje je do obliczeń; nie sprawia, że cała pamięć treningu jest 4-bitowa. Przewodnik po fine-tuningu porównuje praktyczne możliwości.
Opcjonalne omówienia równań
Podlinkowane rozbiory równań zawierają definicje symboli, pośrednie wyprowadzenia i sprawdzenia na małych liczbach. Powstały z użyciem instrukcji dla agentów kodujących w paper-math-skills. To wyjaśnienia uzupełniające; publikacje podlinkowane przy każdym mechanizmie są źródłami pierwotnymi.
Źródła i wersje
Powyższe linki do publikacji wskazują wersje użyte do numeracji sekcji i równań. Oryginalny punkt odniesienia dla uwagi znajdziesz w Attention Is All You Need v7, §3.2 i §3.5. Osobny temat mieszania rezydualnego opisuje mHC v2.