Lire les équations d'architecture : RoPE, MLA, MoE et LoRA

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Cet article explique ce que changent six méthodes d’architecture de modèles : où l’attention reçoit les informations de position, ce qu’elle garde en mémoire, quels tokens ou experts elle utilise et quels poids le fine-tuning met à jour. Il s’adresse aux ingénieurs qui connaissent les grandes lignes d’un Transformer et veulent comprendre RoPE, MLA, l’attention parcimonieuse, Gated DeltaNet, MoE et LoRA sans reprendre les démonstrations de chaque article. Les schémas comparent les mécanismes ; les équations expliquent le changement principal.
Un token entre dans le modèle sous la forme d’un vecteur numérique appelé embedding. Chaque couche met à jour cette représentation. Dans l’attention, trois multiplications par des matrices apprises, ou projections, transforment les vecteurs de tokens entrants en requêtes (), clés () et valeurs (). Les étiquettes , et des schémas désignent ces matrices apprises.
Une couche d’attention compare les requêtes aux clés pour décider du poids à donner à la valeur de chaque token. Pour une tête, le calcul est :
Lisez les opérations dans l’ordre : compare chaque requête à chaque clé ; transpose la matrice des clés pour aligner les vecteurs lors de la multiplication. Divisez par la racine carrée de leur longueur , puis appliquez le softmax à chaque ligne pour obtenir les poids. La multiplication par calcule la moyenne des valeurs avec ces poids. Le résultat est un vecteur mis à jour pour chaque token, transmis au reste de la couche. Dans un modèle de langage causal, l’attention exclut les tokens futurs avant le softmax. La Partie 1 détaille ce calcul avec de petites matrices.
Les quatre premières sections modifient ce calcul ou sa mémoire. MoE modifie le réseau feed-forward et LoRA la façon d’entraîner les poids. Vous pouvez lire les sections séparément ; le schéma de MLA utilise le mécanisme de position présenté dans RoPE.
RoPE : la position comme rotation
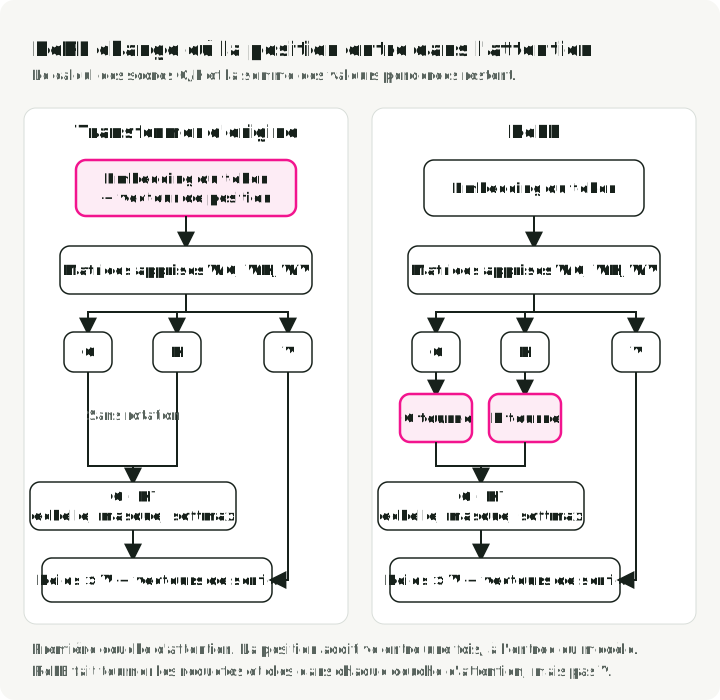
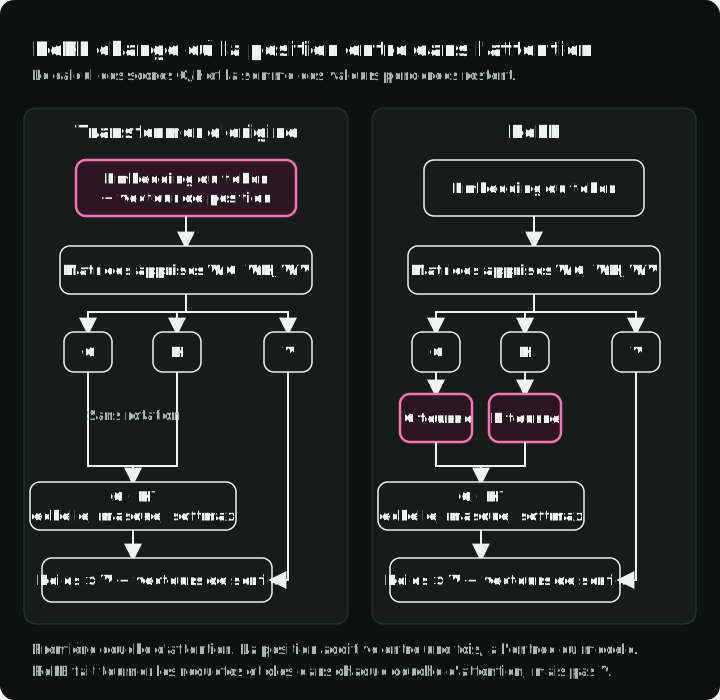
Un produit scalaire requête–clé compare des vecteurs de contenu. À lui seul, il ne dit pas si deux tokens sont voisins ou séparés de cent positions. Le Transformer d’origine ajoute un vecteur de position à l’embedding de chaque token avant la première couche d’attention. Les informations de position influencent alors les requêtes, clés et valeurs calculées à partir de ces entrées. Il ne les fait pas tourner. Voir Attention Is All You Need, §3.5.
RoPE introduit la position dans la comparaison requête–clé elle-même. Calculez d’abord les requêtes et les clés avec les projections apprises habituelles. Faites ensuite tourner leurs coordonnées par paires selon des angles déterminés par la position de chaque token. Calculez les scores d’attention avec ces vecteurs tournés. RoPE ne fait pas tourner les valeurs.
Les deux panneaux ci-dessous montrent où intervient la position. Dans les deux cas, le calcul des valeurs pondérées suit celui des scores.
Pour une paire de coordonnées, la rotation est une multiplication matricielle :
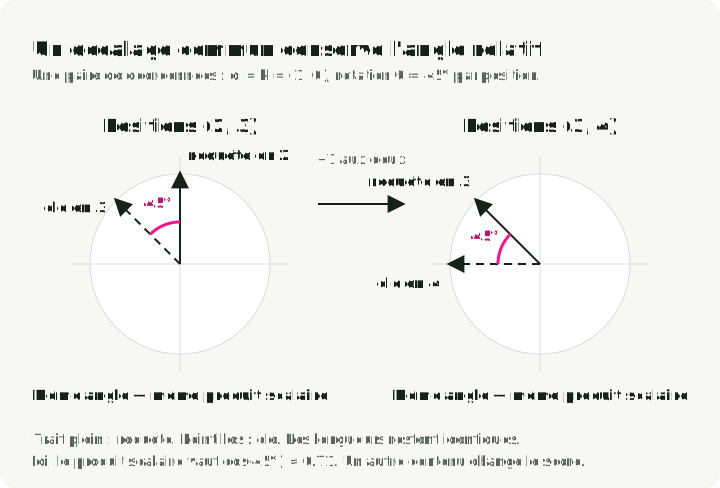
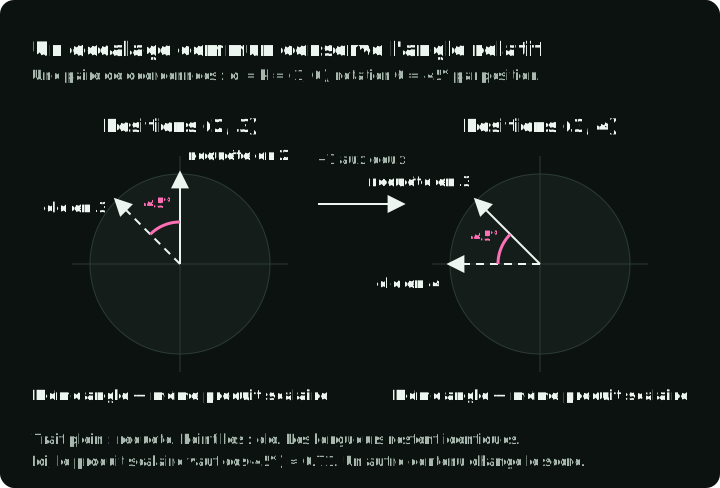
est l’angle de rotation. Multiplier cette matrice par donne ; à 90°, cela donne , la flèche de requête dirigée vers le haut dans le schéma suivant.
Pourquoi une rotation ? Un produit scalaire dépend de l’angle entre les vecteurs. Faire tourner les deux vecteurs du même angle supplémentaire laisse leur produit scalaire inchangé. Si une requête à la position 2 et une clé à la position 3 passent aux positions 3 et 4, leur différence de position reste égale à un. Avec les mêmes vecteurs de contenu sous-jacents, RoPE donne le même score :
Ici et sont une paire de coordonnées de requête et de clé, les fait tourner, et sont les positions des tokens et l’angle de rotation par position. Le membre de droite montre la propriété utile : le terme explicite de position utilise la différence . Le score dépend toujours des vecteurs de contenu, pas seulement de la distance.
Le schéma fixe les deux vecteurs d’origine à et utilise une rotation de 45° par position. Ce sont des valeurs choisies pour l’exemple : garder le contenu fixe permet de voir l’effet du décalage des deux positions.
Une requête ou une clé complète a de nombreuses paires de coordonnées. RoPE les fait tourner à des vitesses différentes ; elles représentent donc les différences de position à plusieurs échelles. Cela ne garantit ni une bonne attention pour des longueurs de contexte arbitraires, ni que chaque score diminue avec la distance.
Les matrices de rotation et leur démonstration figurent dans RoFormer v5, §3.2, équations (12)–(16). La lecture détaillée de RoPE donne les étapes d’algèbre intermédiaires et les vérifications numériques.
MLA : mettre en cache un petit vecteur plutôt que des clés et des valeurs
Les têtes d’attention existaient avant MLA. L’attention multi-têtes du Transformer d’origine, §3.2.2, effectue plusieurs calculs d’attention avec des projections apprises différentes et combine leurs sorties. DeepSeek conserve plusieurs têtes. Son changement concerne la représentation et la mise en cache de leurs clés et valeurs.
Pendant la génération, l’attention multi-têtes ordinaire stocke une clé et une valeur pour chaque token précédent pour chaque tête. Ce KV cache grandit avec la séquence. MLA utilise plutôt une projection apprise pour transformer directement la représentation entrante du token en un seul vecteur court. On peut en calculer les clés de contenu et les valeurs des têtes. Toutes les têtes partagent ce vecteur stocké, mais utilisent des projections et des poids d’attention différents ; elles ne deviennent pas identiques.
Le schéma suit un token, de son vecteur entrant aux données stockées pour lui dans une couche. Dans les deux cas, les requêtes ultérieures lisent ces données à travers plusieurs têtes ; leurs sorties sont combinées pour former la sortie de l’attention.
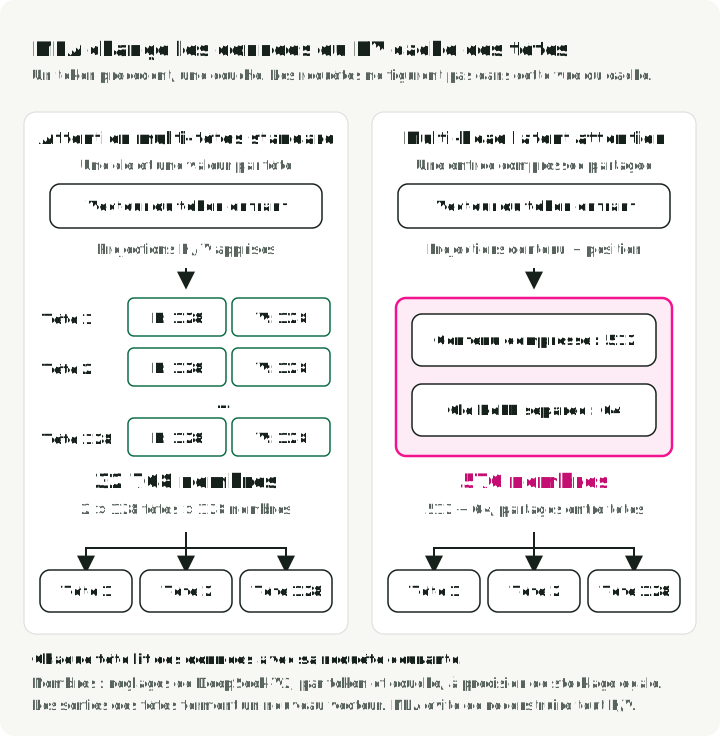
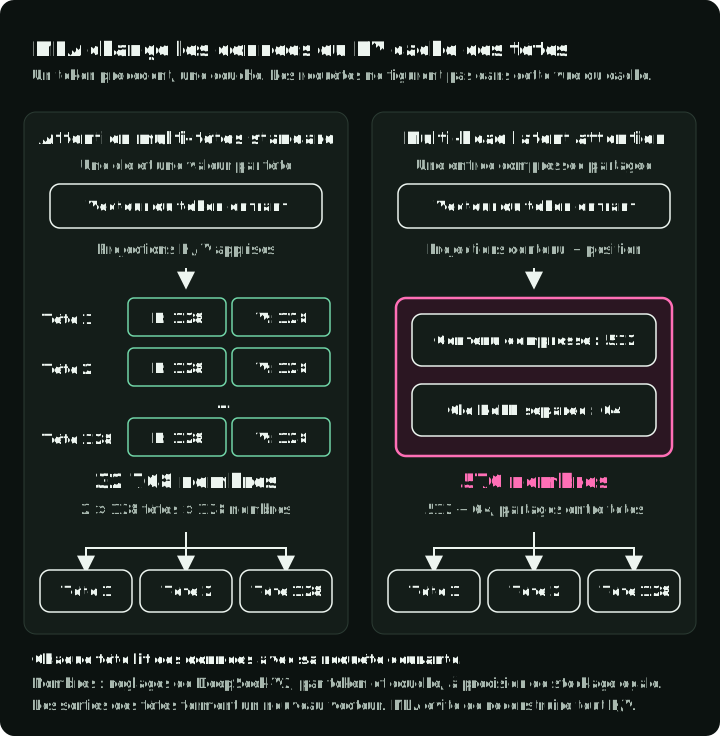
Le calcul du contenu dans le schéma correspond à trois équations de DeepSeek-V2 :
est le vecteur entrant du token . La première ligne le transforme en un vecteur plus court mis en cache, . Les deux suivantes transforment ce même vecteur en clés de contenu et en valeurs pour toutes les têtes. Les exposants sont des étiquettes, pas des puissances : désigne la projection vers la petite dimension, et les projections vers les dimensions des clés et des valeurs, et la partie de contenu. Les trois matrices sont apprises. La clé de position séparée ne figure pas dans ces trois équations.
Pour la configuration de DeepSeek-V2, la comparaison est 32 768 nombres contre 576 : l’attention ordinaire avec 128 têtes et 128 nombres dans chaque clé et valeur nécessite ; MLA conserve un vecteur compressé de 512 nombres et une clé de position de 64 nombres. Cela représente environ 57 fois moins de nombres mis en cache à précision égale. Cette comparaison oppose cette configuration à l’attention multi-têtes ordinaire, pas à toutes les conceptions de cache, et n’implique pas une inférence 57 fois plus rapide.
Développer le vecteur de chaque ancien token annulerait-il le bénéfice ? MLA peut éviter cette opération. Pour une tête, abrégeons en et appelons la matrice d’expansion des clés constituée des lignes de de cette tête. Alors :
Le membre de gauche développe chaque vecteur en cache en une clé avant de la comparer à la requête . Le membre de droite transforme une seule fois la requête courante, puis la compare directement aux vecteurs en cache. C’est le même calcul regroupé autrement. Le calcul des valeurs admet un réarrangement similaire : faites d’abord la moyenne des vecteurs compressés, puis appliquez les projections de sortie. Une implémentation peut choisir l’ordre des multiplications qui convient à son matériel.
RoPE nécessite un traitement séparé. Faire tourner les clés de contenu développées introduirait une opération dépendante de la position dans ce réarrangement. MLA laisse donc ces clés sans rotation et ajoute une comparaison requête–clé séparée pour la position. C’est pourquoi le cache contient à la fois le vecteur de contenu compressé et une petite clé de position tournée.
MLA est une architecture apprise, pas un compresseur sans perte applicable à n’importe quelle couche d’attention existante. DeepSeek-V2 v5, §2.1.2–2.1.3, équations (9)–(19) définit les projections et la composante RoPE séparée. La lecture détaillée de MLA donne les dimensions complètes et les réarrangements matriciels.
Attention parcimonieuse (DSA) : un calcul de scores peu coûteux choisit les clés
DSA réduit le nombre de tokens qui participent à chaque calcul d’attention. Supposons qu’un modèle continue le texte “The cat sat on a mat near me”. Pour cet exemple, traitez chaque mot comme un token. Le modèle traite le dernier token, “me”, à la position 8.
Dans une couche d’attention, la représentation du token courant produit un vecteur de requête. Chaque token disponible possède une clé, à laquelle on compare la requête, et une valeur, qui fournit des informations à la sortie. Pendant la génération, la couche conserve les données d’attention des tokens précédents dans son KV cache pour réutiliser ces vecteurs. « Position 2 » identifie les données stockées pour “cat” ; le cache contient des vecteurs numériques, pas seulement des numéros de position. MLA stocke ces données sous la forme compressée décrite plus haut.
L’attention causale dense compare la requête courante à chaque clé disponible, y compris celle du token courant. Le softmax transforme ces scores en poids et la couche combine les valeurs avec ces poids. DSA ajoute une étape de sélection moins coûteuse avant ce calcul :
- Noter les tokens disponibles à faible coût. Un petit réseau appris, le lightning indexer, utilise ses propres projections de requêtes et de clés pour noter chaque position pour le token courant. Il estime quels tokens l’attention principale utilisera le plus.
- Sélectionner les positions aux scores les plus élevés. Dans l’exemple, “cat” et “mat” reçoivent les deux plus grands scores d’index. Sélectionner les positions 2 et 6 indique à l’attention principale quelles entrées stockées lire.
- Calculer l’attention sur ces entrées. L’attention principale calcule ses propres scores requête–clé pour les entrées sélectionnées, applique le softmax à ce sous-ensemble et combine leurs valeurs. Les scores de l’indexeur choisissent les entrées ; ce ne sont pas les poids d’attention finaux.
Suivez une colonne du token de texte à son entrée stockée, puis comparez les calculs dense et parcimonieux. Tous les scores et poids ci-dessous sont donnés à titre d’illustration.
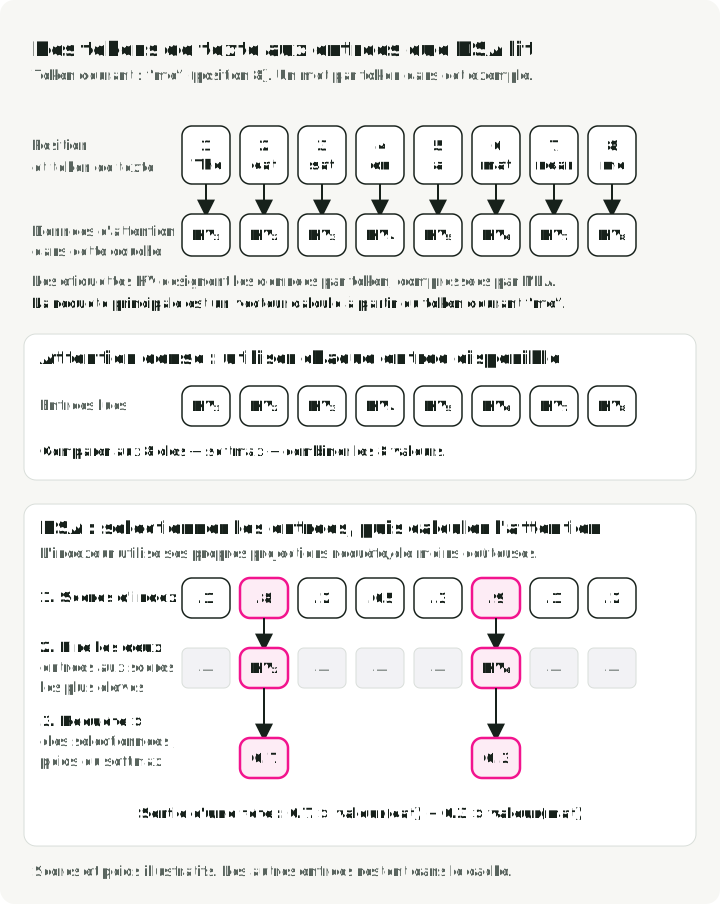
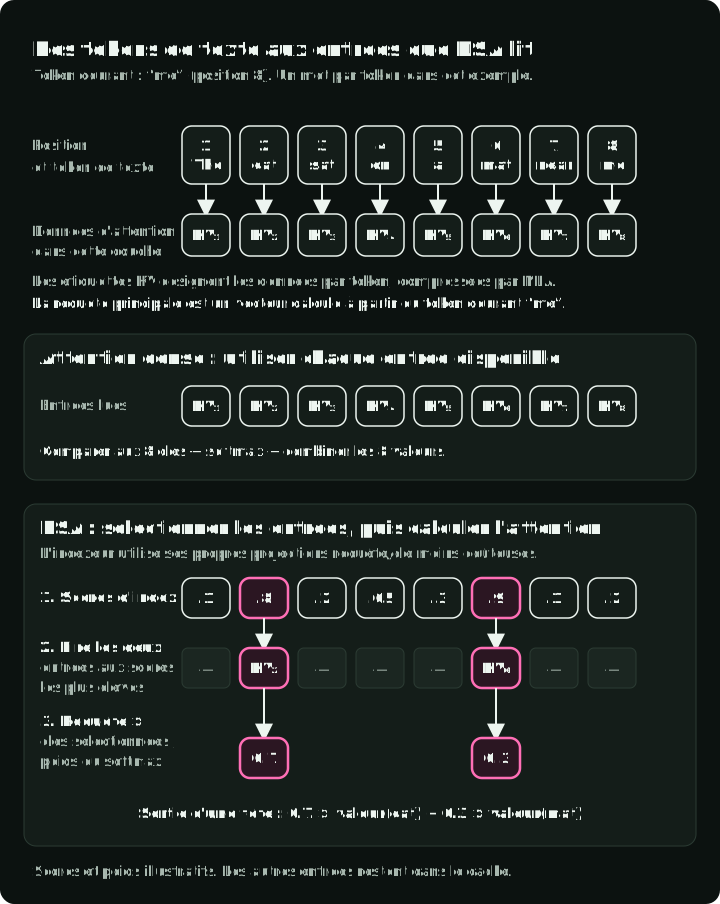
L’équation de l’indexeur dans l’article donne la première ligne de scores du panneau DSA :
est la position courante et une position candidate. L’exposant désigne les vecteurs propres à l’indexeur. Pour chacune de ses têtes, comparez la requête à la clé , remplacez un produit scalaire négatif par zéro avec ReLU, multipliez par le poids appris dépendant du token et sommez sur les têtes . Le résultat est un score de sélection.
On peut écrire la sélection et la sortie d’une tête d’attention principale ainsi :
est la ligne des scores pour les positions disponibles de 1 à . TopKIndices renvoie les positions des plus grands scores, jusqu’à entrées. La somme se lit « additionner les valeurs pondérées uniquement pour les positions de ». Ici est un poids de softmax de l’attention principale nouvellement calculé, son vecteur de valeur et la sortie. Dans la figure, et . Cela réécrit la notation des entrées sélectionnées de l’article en une somme explicite ; MLA peut la calculer sous forme compressée.
Les autres entrées restent dans le cache. Une autre requête peut sélectionner un autre sous-ensemble. L’entraînement apprend à l’indexeur à approcher la distribution de l’attention principale sur les tokens, d’abord avec l’attention dense, puis en parallèle de l’attention parcimonieuse. Une mauvaise sélection peut omettre des informations utiles.
DeepSeek-V3.2 applique DSA au cache compressé de MLA et sélectionne jusqu’à 2 048 positions par requête. À la dernière position d’un contexte de 131 072 tokens, l’attention principale lit une entrée sur 64. Quand moins de 2 048 positions sont disponibles, elle peut toutes les utiliser.
Le gain vient du nombre réduit de comparaisons d’attention coûteuses. L’indexeur note toujours chaque position disponible, mais utilise moins de têtes et peut calculer en FP8. Sur une séquence de longueur , les comparaisons de l’attention principale passent d’environ à , où est le nombre sélectionné. Le travail de l’indexeur sur toutes les paires reste quadratique ; la méthode complète n’est donc pas strictement linéaire en la longueur de séquence.
Voir DeepSeek-V3.2 v1, §2.1, équations (1)–(4) et la lecture détaillée de DSA pour les équations de calcul des scores et d’entraînement.
Gated DeltaNet : une mémoire de taille fixe qui réécrit ses valeurs
L’attention dense, MLA et DSA conservent un historique croissant des tokens passés. Gated DeltaNet met plutôt à jour une seule matrice de taille fixe. La couche calcule une clé, une valeur et une requête à partir des représentations entrantes des tokens, avec des projections apprises et des filtres courts sur les tokens voisins. La clé et la valeur mettent à jour la matrice ; la requête lit la matrice mise à jour pour produire un vecteur de sortie. Elle ne peut pas revenir séparément sur la clé et la valeur de chaque ancien token.
La comparaison utile est celle d’une mémoire additive simple. Supposons que la mémoire renvoie actuellement 2 pour une clé donnée et que le token suivant fournisse la valeur 5 pour cette même clé. Ajouter la nouvelle valeur produirait 7. Une mise à jour delta ajoute la correction, , de sorte qu’une écriture à pleine intensité produit 5.
L’exemple utilise la clé , qui lit la première colonne de la matrice : une fois la première colonne plus zéro fois la seconde. La colonne mise en évidence montre la correction. Après l’écriture, une requête y lit . La matrice conserve la même taille.
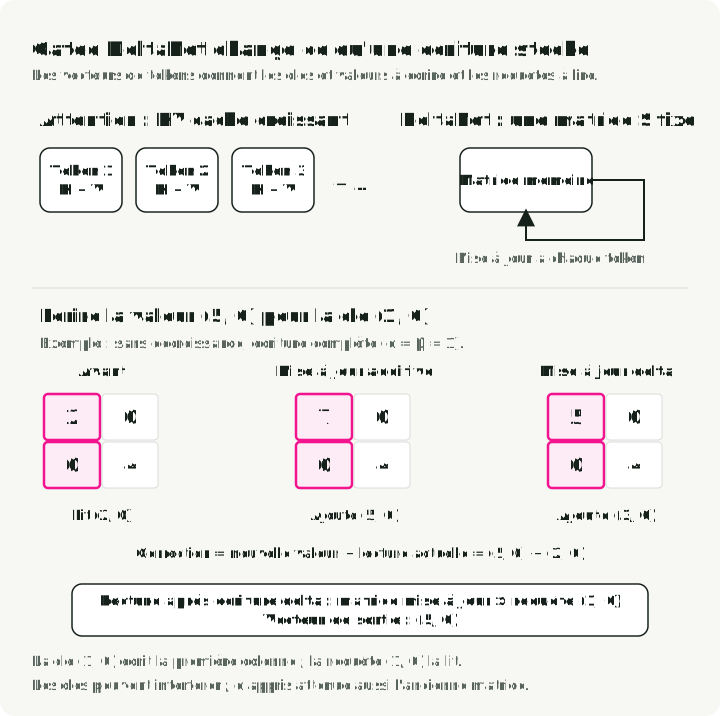
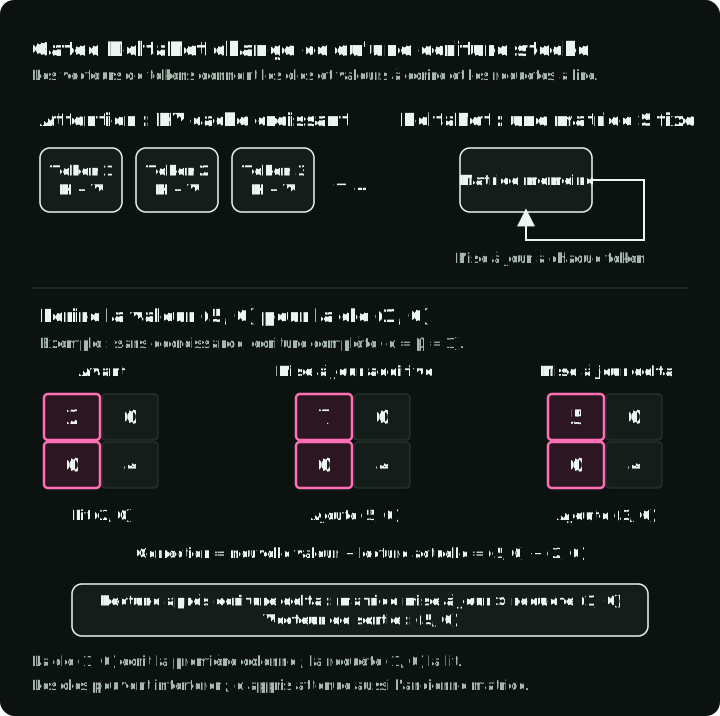
Gated DeltaNet apprend aussi quelle quantité de l’ancienne mémoire conserver et avec quelle intensité appliquer chaque correction :
est la matrice mémoire, la clé courante de longueur unitaire et sa nouvelle valeur. Le facteur atténue l’ancienne mémoire. Lire la mémoire atténuée avec donne sa réponse actuelle ; soustraire cette réponse à donne la correction. Le facteur contrôle la quantité écrite. Les deux facteurs sont calculés à partir du token courant. Multiplier la matrice mise à jour par la requête donne le résultat de lecture, que la couche normalise, module et projette ensuite vers sa sortie. L’exemple de 2 à 5 utilise leur valeur limite de 1.
Une mémoire fixe économise de l’espace, mais les écritures peuvent interférer : changer la réponse pour une clé peut la changer pour une autre clé non orthogonale. La décroissance supprime aussi des informations anciennes. Cela aide à comprendre pourquoi l’article combine des couches récurrentes et de l’attention à fenêtre glissante dans des modèles hybrides, en conservant des entrées séparées pour les tokens récents.
La forme affichée réarrange Gated Delta Networks v3, §3.1, équation (10). La lecture détaillée la démontre et détaille la mise à jour matricielle.
Routage MoE : le biais choisit les experts, le score pondère leurs sorties
Une couche mixture-of-experts (MoE) possède plusieurs réseaux feed-forward, appelés experts, et n’en sélectionne que certains pour chaque token. Cela augmente la capacité du modèle sans exécuter chaque expert pour chaque entrée. Elle modifie la partie feed-forward d’un Transformer, pas ses têtes d’attention.
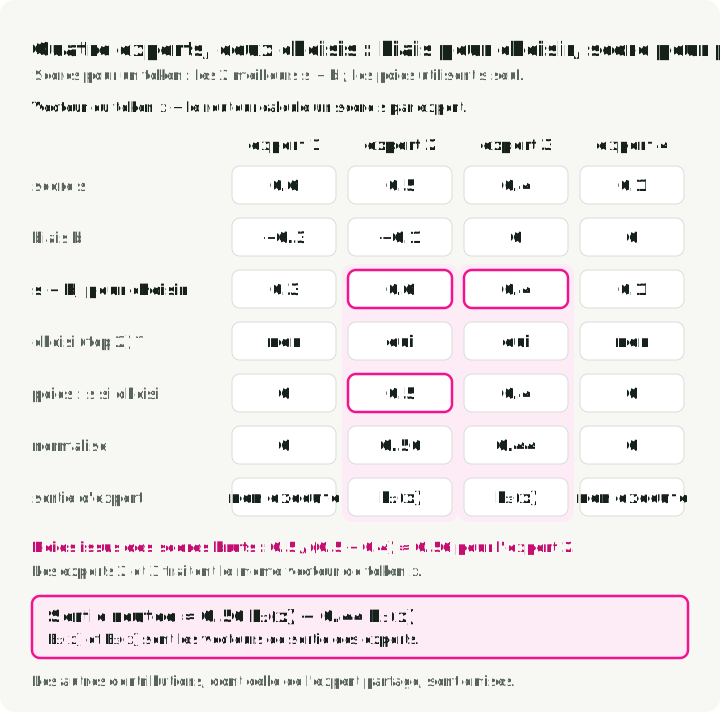
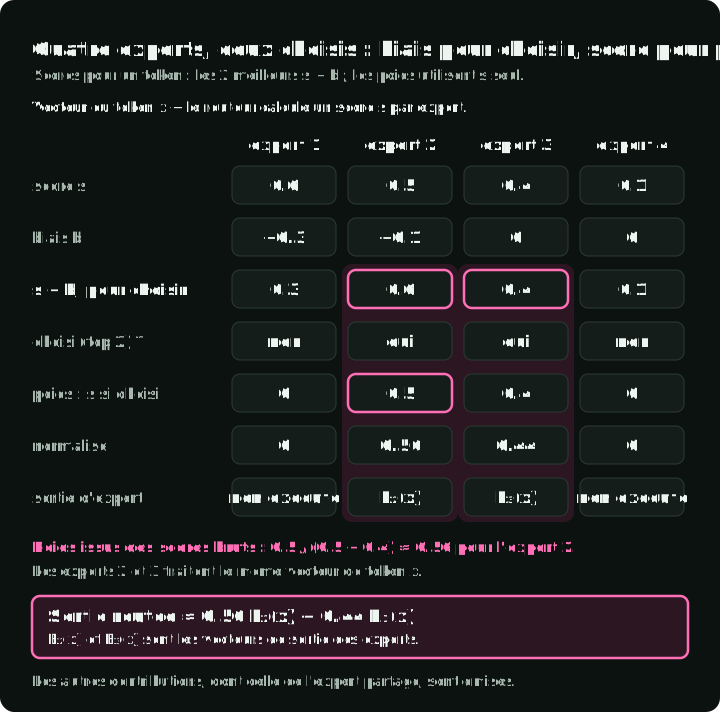
La règle de routage particulière de DeepSeek-V3 sépare deux décisions : quels experts exécuter et quel poids donner à leurs sorties. Un routeur appris prend le vecteur du token courant et donne à chaque expert un score . Un biais d’équilibrage de charge porte le score de sélection à . Après la sélection, les poids des sorties proviennent des scores d’origine, normalisés sur les experts sélectionnés. Le biais n’intervient pas dans ces poids.
L’exemple sélectionne deux experts sur quatre. L’expert 1 a le plus grand score brut, mais son biais négatif l’exclut ; les experts 2 et 3 s’exécutent à sa place. Tous deux reçoivent le même vecteur de token . Chacun produit un nouveau vecteur, noté ou , et la couche additionne ces sorties avec les poids 0.56 et 0.44. Le schéma montre uniquement cette contribution des experts routés.
Une forme compacte de la règle de routage de DeepSeek-V3, pour un token, est :
et rassemblent les scores et les biais de tous les experts ; est le nombre à sélectionner. La première ligne renvoie les indices des experts sélectionnés . L’accolade de la deuxième ligne est un if/else : diviser le score d’origine d’un expert sélectionné par la somme des scores sélectionnés, ou lui attribuer zéro s’il n’est pas sélectionné. La dernière ligne additionne les vecteurs de sortie des experts avec ces poids. Dans la figure, , donc et . Le biais n’apparaît que dans la sélection. Les contributions résiduelles et des experts partagés ne figurent pas dans .
Pendant l’entraînement, le biais d’un expert trop utilisé diminue et celui d’un expert peu utilisé augmente. Cela favorise une charge plus égale. DeepSeek-V3 conserve aussi une petite perte d’équilibrage par séquence ; « auxiliary-loss-free » ne signifie donc pas que le modèle n’a aucune perte d’équilibrage.
Sa configuration active 8 experts routés sur 256 par token, plus un expert partagé qui s’exécute toujours. Ces nombres et l’expert partagé appartiennent à ce modèle, pas à la définition de MoE. Voir DeepSeek-V3 v2, §2.1.2, équations (12)–(17) et la lecture du routage.
mHC : un mélange résiduel limité aux moyennes pondérées
Une connexion résiduelle ordinaire transmet le vecteur d’un token en contournant une sous-couche et lui ajoute le résultat de cette sous-couche. mHC maintient plusieurs vecteurs de ce type, appelés flux résiduels, et modifie leur mélange entre les couches. Sa matrice de mélange idéale a des entrées positives ou nulles dont chaque ligne et chaque colonne somme à un. Ce mélange forme des moyennes pondérées tout en conservant le total sur les flux. L’implémentation approche cette contrainte avec un nombre fini d’étapes de normalisation ; elle ne contraint pas chaque opération du réseau.
L’article séparé sur mHC explique le mécanisme, la normalisation et les limites avec des schémas. Consultez-le pour ce sujet ; la lecture de l’équation fournit la démonstration.
LoRA : une mise à jour de faible rang à côté d’un poids figé
Le fine-tuning complet met à jour les matrices de poids du modèle. LoRA fige une matrice préentraînée et apprend une correction plus petite en parallèle :
est le vecteur du token entrant dans la couche linéaire choisie et le vecteur de sortie transmis au reste du modèle. La multiplication d’origine s’exécute toujours. Dans la correction, transforme l’entrée en un vecteur beaucoup plus petit et lui redonne la taille de la sortie. Les exemples d’entraînement et la perte de la tâche déterminent les mises à jour de et ; reste fixe. Leur petite dimension commune est le réglage de rang ; la mise à jour résultante a un rang d’au plus .
Pour une matrice de poids et , une mise à jour complète a environ 16.8 millions d’entrées. Les deux matrices LoRA en ont : 256 fois moins d’entrées entraînables pour cette matrice. Cela réduit le stockage des gradients et des états de l’optimiseur, mais la matrice de poids de base complète occupe toujours de la mémoire et participe au calcul.
Suivez les deux calculs à partir de la même entrée : la matrice figée calcule toujours sa sortie, tandis que la correction entraînable passe par seulement huit nombres.
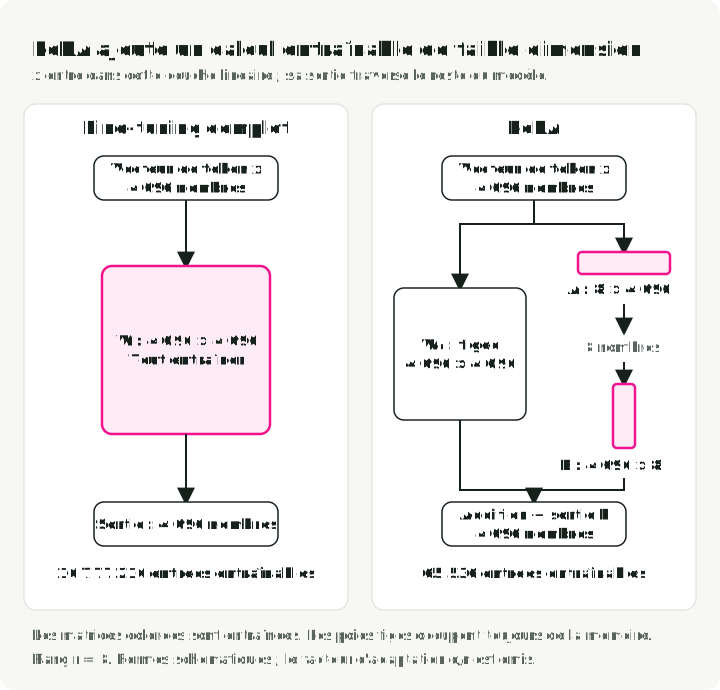
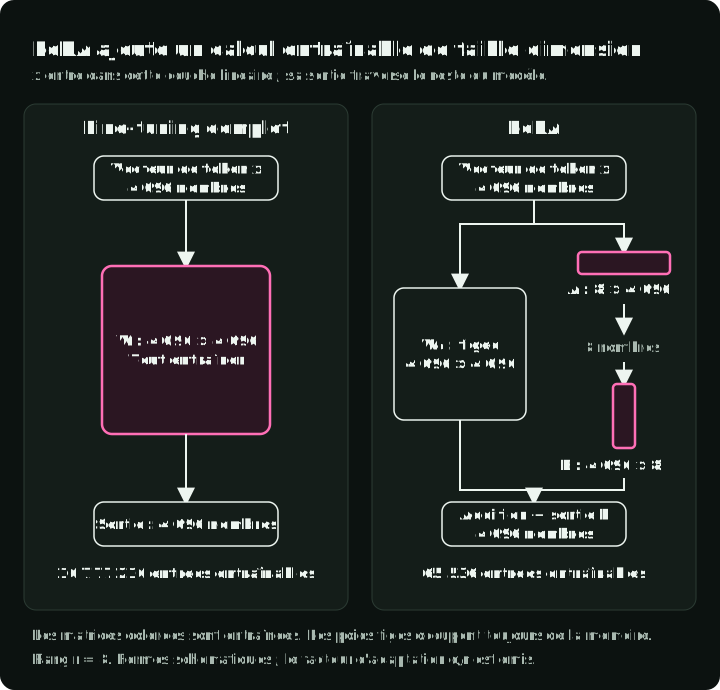
Dans la méthode d’origine, commence à zéro ; la correction ne change donc rien initialement. L’article multiplie la mise à jour par , un réglage omis de son équation (3) ci-dessus. Après l’entraînement, la correction mise à l’échelle peut être ajoutée à ; la couche fusionnée n’a alors besoin que de la multiplication matricielle d’origine. Garder les adaptateurs séparés ajoute du calcul, mais permet de les échanger.
Voir LoRA v2, §4.1, équation (3) et la lecture détaillée de LoRA. QLoRA stocke en plus les poids de base figés sous forme 4 bits et les déquantifie pour le calcul ; cela ne rend pas toute la mémoire d’entraînement 4 bits. Le guide du fine-tuning compare les options pratiques.
Lectures d’équations facultatives
Les lectures d’équations liées contiennent les définitions des symboles, les étapes intermédiaires des démonstrations et des vérifications sur de petits nombres. Elles ont été produites avec les instructions pour agents de programmation de paper-math-skills. Ce sont des explications complémentaires ; les articles liés à côté de chaque mécanisme sont les sources primaires.
Sources et versions
Les liens vers les articles ci-dessus identifient les versions utilisées pour les numéros de section et d’équation. Pour l’attention d’origine servant de comparaison, voir Attention Is All You Need v7, §3.2 et §3.5. Pour le sujet séparé du mélange résiduel, voir mHC v2.