Как читать уравнения архитектур: RoPE, MLA, MoE и LoRA

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Эта статья объясняет, что меняют шесть методов архитектуры моделей: откуда аттеншн получает информацию о позиции, что хранит в памяти, какие токены или экспертов использует и какие веса обновляет файн-тюнинг. Она предназначена для инженеров, которые знают общую структуру Transformer, но хотят понять RoPE, MLA, разреженный аттеншн, Gated DeltaNet, MoE и LoRA без разбора всех выводов в каждой статье. Диаграммы сравнивают механизмы; уравнения объясняют главное изменение.
Токен поступает в модель как числовой вектор, который называется эмбеддингом. Каждый слой обновляет это представление. В аттеншне три умножения на обученные матрицы, или проекции, превращают входные векторы токенов в запросы (), ключи () и значения (). Обозначения , и на диаграмме называют эти обученные матрицы.
Слой аттеншна сравнивает запросы с ключами, чтобы определить вес значения каждого токена. Для одного attention head вычисление выглядит так:
Читайте операции по порядку: сравнивает каждый запрос с каждым ключом; транспонирует матрицу ключей, чтобы расположить векторы для умножения. Разделите на квадратный корень из их длины , затем примените softmax к каждой строке, чтобы получить веса. Умножение на усредняет значения с этими весами. Результат — обновлённый вектор каждого токена, который передаётся дальше по слою. В каузальной языковой модели аттеншн исключает будущие токены перед softmax. В части 1 это вычисление разобрано на маленьких матрицах.
Первые четыре раздела меняют это вычисление или его память. MoE меняет сеть прямого распространения, а LoRA — способ обучения весов. Разделы можно читать независимо; диаграмма MLA использует механизм позиции из раздела RoPE.
RoPE: позиция как поворот
Скалярное произведение запроса и ключа сравнивает векторы содержания. Само по себе оно не говорит, стоят ли два токена рядом или между ними сто позиций. Исходный Transformer добавляет вектор позиции к эмбеддингу каждого токена перед первым слоем аттеншна. Затем информация о позиции влияет на запросы, ключи и значения, вычисленные из этих входов. Она не поворачивает их. См. Attention Is All You Need, §3.5.
RoPE вводит позицию в само сравнение запроса и ключа. Сначала вычислите запросы и ключи с помощью обычных обученных проекций. Затем поверните пары их координат на углы, определяемые позицией каждого токена. Вычислите оценки аттеншна по повёрнутым векторам. RoPE не поворачивает значения.
Два блока ниже показывают, где вводится позиция. Вычисление взвешенных значений в обоих случаях по-прежнему идёт после вычисления оценок.
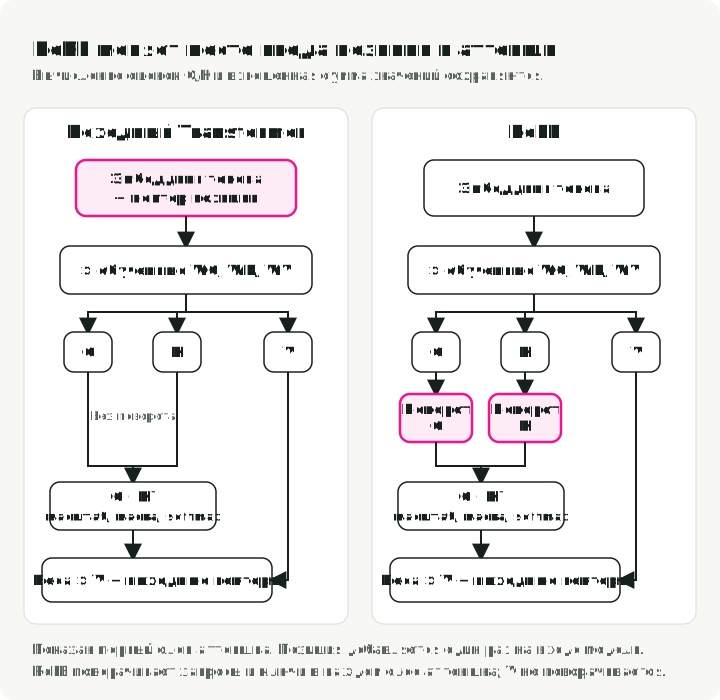
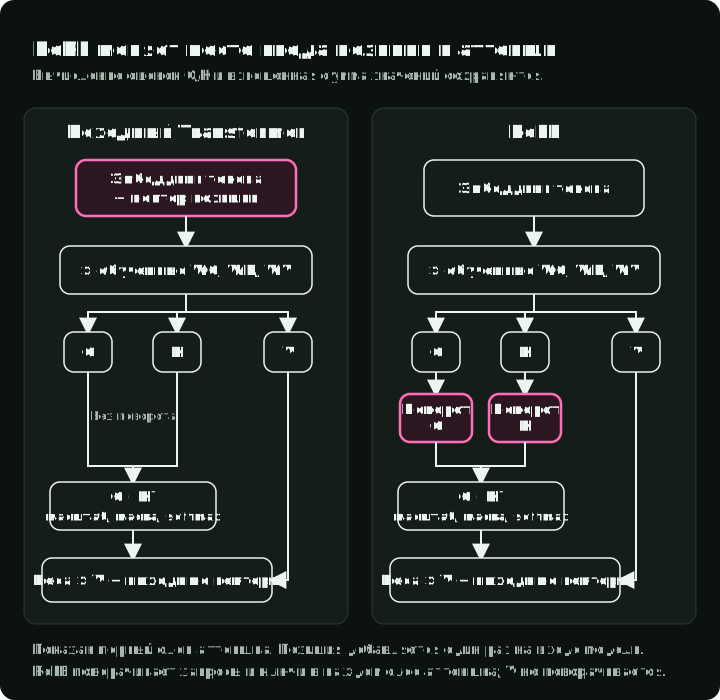
Для одной пары координат поворот — это умножение матрицы:
— угол поворота. Умножение этой матрицы на даёт ; при 90° это , то есть направленная вверх стрелка запроса на следующей диаграмме.
Почему поворот? Скалярное произведение зависит от угла между векторами. Поворот обоих векторов на один и тот же дополнительный угол не меняет их скалярного произведения. Если запрос на позиции 2 и ключ на позиции 3 переместятся на позиции 3 и 4, разность их позиций по-прежнему равна одному. При тех же исходных векторах содержания RoPE даёт ту же оценку:
Здесь и — по одной паре координат запроса и ключа, поворачивает их, и — позиции токенов, а — угол поворота на позицию. Правая часть показывает полезное свойство: явный позиционный член использует разность . Оценка по-прежнему зависит от векторов содержания, а не только от расстояния.
На диаграмме оба исходных вектора равны , а поворот составляет 45° на позицию. Эти значения выбраны для примера: фиксированное содержание позволяет увидеть эффект сдвига обеих позиций.
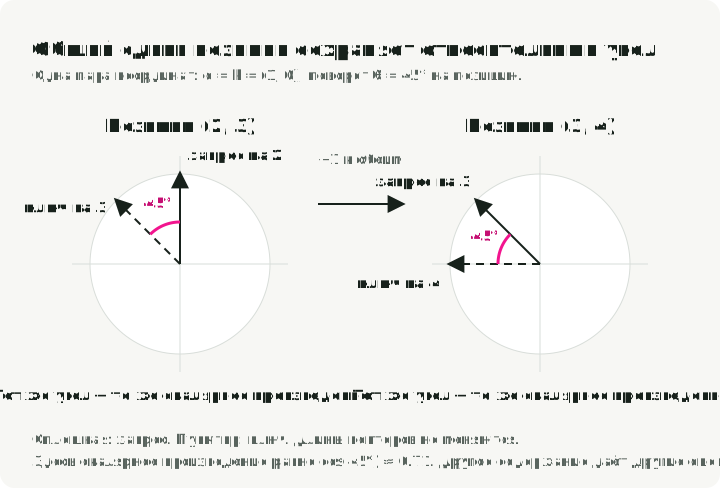
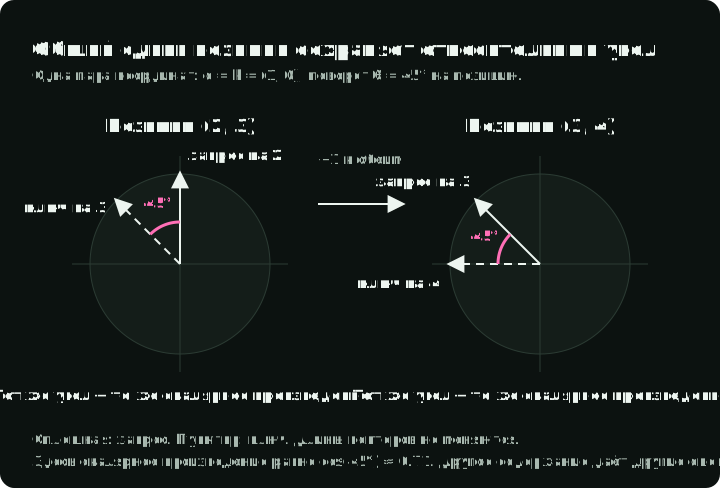
Полный запрос или ключ содержит много пар координат. RoPE поворачивает их с разными скоростями, поэтому они представляют разности позиций в нескольких масштабах. Это не гарантирует хороший аттеншн при произвольной длине контекста или уменьшение каждой оценки с расстоянием.
Матрицы поворота и их вывод приведены в RoFormer v5, §3.2, уравнения (12)–(16). Подробный разбор RoPE содержит промежуточные алгебраические преобразования и числовые проверки.
MLA: хранить маленький вектор вместо ключей и значений
Attention heads существовали до MLA. Многоголовый аттеншн исходного Transformer, §3.2.2 выполняет несколько вычислений аттеншна с разными обученными проекциями и объединяет их выходы. DeepSeek сохраняет несколько attention heads. Меняется то, как представлены и кэшируются их ключи и значения.
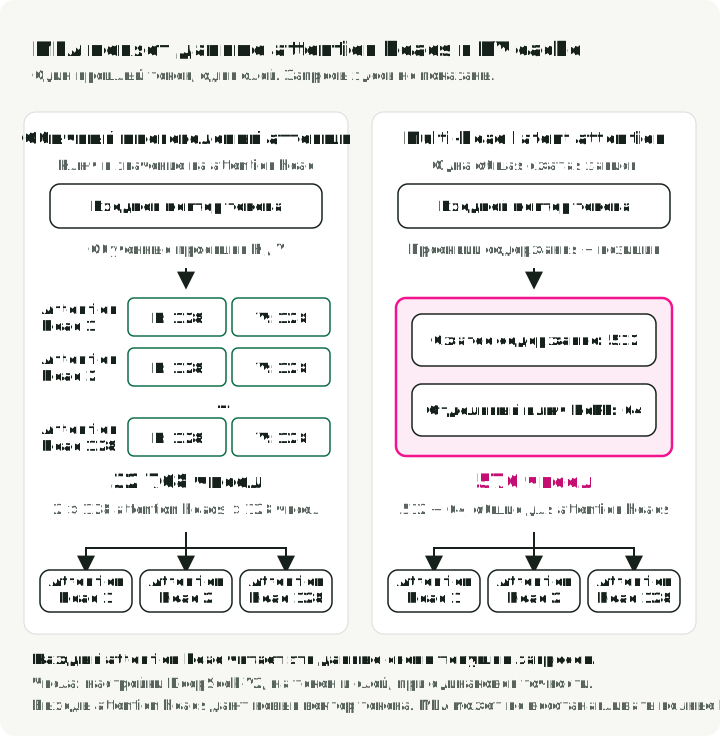
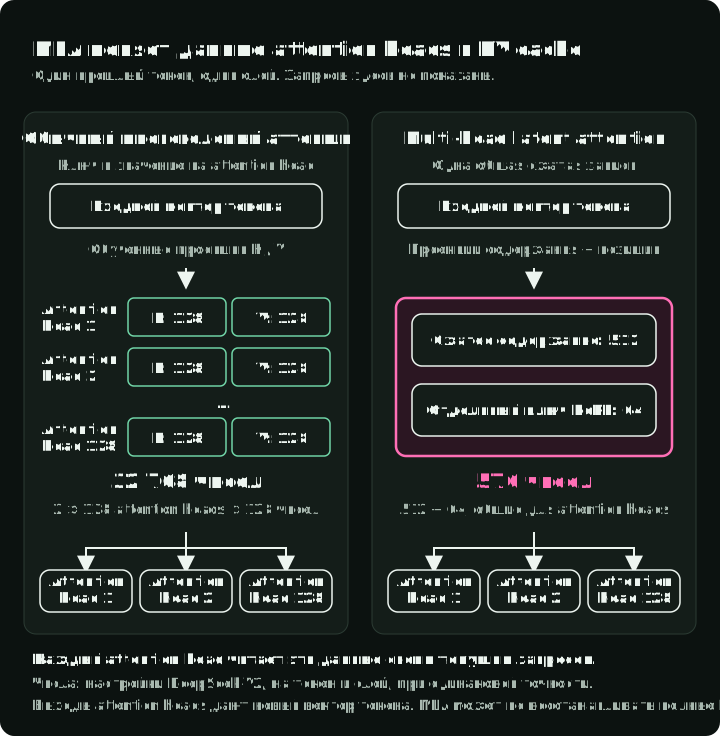
При генерации обычный многоголовый аттеншн хранит ключ и значение каждого предыдущего токена для каждого attention head. Этот KV cache растёт вместе с последовательностью. Вместо этого MLA с помощью обученной проекции превращает входное представление токена непосредственно в один короткий вектор. Из него можно вычислить ключи содержания и значения всех attention heads. Все attention heads используют общий сохранённый вектор, но разные проекции и веса аттеншна; они не становятся одинаковыми.
Диаграмма показывает один токен от входного вектора до сохранённых данных в одном слое. С обеих сторон последующие запросы читают эти данные через несколько attention heads; их выходы объединяются в выход аттеншна.
Вычислению содержания на диаграмме соответствуют три уравнения из DeepSeek-V2:
— входной вектор токена . Первая строка преобразует его в более короткий кэшируемый вектор . Следующие две преобразуют этот же вектор в ключи содержания и значения для всех attention heads. Верхние индексы — метки, а не степени: обозначает проекцию с уменьшением размерности, и — проекции с увеличением размерности для ключей и значений, а отмечает содержательную часть. Все три матрицы обучаются. Отдельный позиционный ключ находится за пределами этих трёх уравнений.
Для конфигурации DeepSeek-V2 сравнение составляет 32 768 чисел против 576: обычному аттеншну со 128 attention heads и 128 числами в каждом ключе и значении нужно ; MLA хранит сжатый вектор из 512 чисел и позиционный ключ из 64 чисел. Это примерно в 57 раз меньше кэшируемых чисел при одинаковой точности. Сравнивается эта конфигурация с обычным многоголовым аттеншном, а не со всеми вариантами кэша; это не означает ускорения инференса в 57 раз.
Не исчезнет ли преимущество, если разворачивать сжатый вектор каждого старого токена? MLA может избежать такого разворачивания. Для одного attention head сократим до , а его строки назовём матрицей разворачивания ключа . Тогда:
Левая часть разворачивает каждый кэшируемый вектор в ключ перед сравнением с запросом . Правая часть один раз преобразует текущий запрос, затем сравнивает его непосредственно с кэшируемыми векторами. Это то же вычисление с другой группировкой. Для значений есть похожее преобразование: сначала усреднить сжатые векторы, затем применить выходные проекции. Реализация может выбрать порядок умножения, подходящий оборудованию.
RoPE требует отдельного рассмотрения. Поворот развёрнутых ключей содержания внёс бы в эту перегруппировку операцию, зависящую от позиции. Поэтому MLA оставляет эти ключи без поворота и добавляет отдельное сравнение запроса и ключа для позиции. Именно поэтому кэш содержит и сжатый вектор содержания, и маленький повёрнутый позиционный ключ.
MLA — обучаемая архитектура, а не компрессор без потерь, применимый к любому существующему слою аттеншна. DeepSeek-V2 v5, §2.1.2–2.1.3, уравнения (9)–(19) определяет проекции и отдельный компонент RoPE. Подробный разбор MLA даёт полные формы и перегруппировки матриц.
Разреженный аттеншн (DSA): дешёвый оценщик выбирает ключи
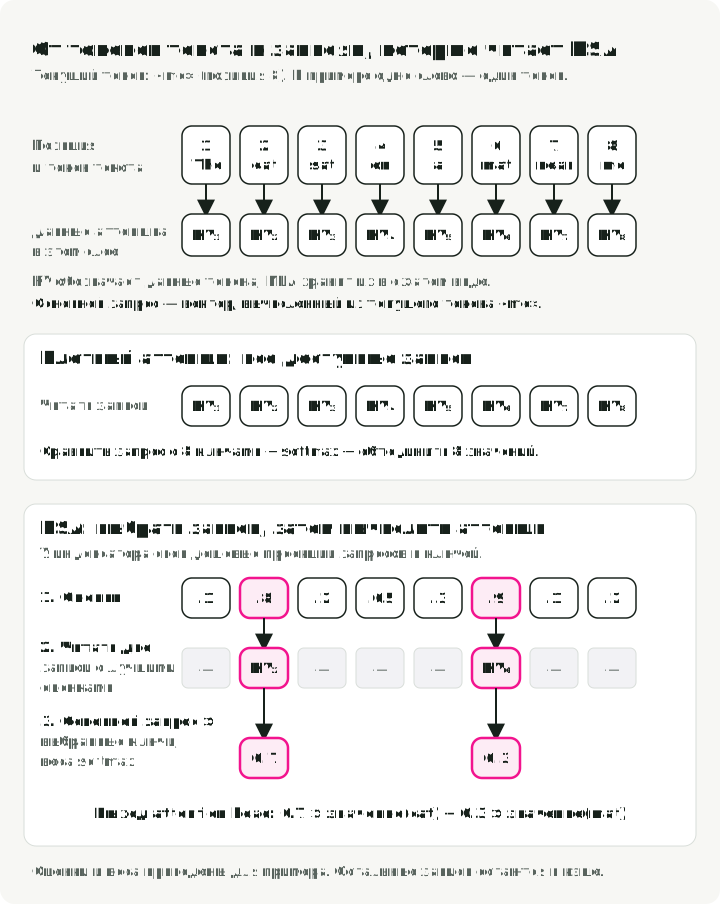
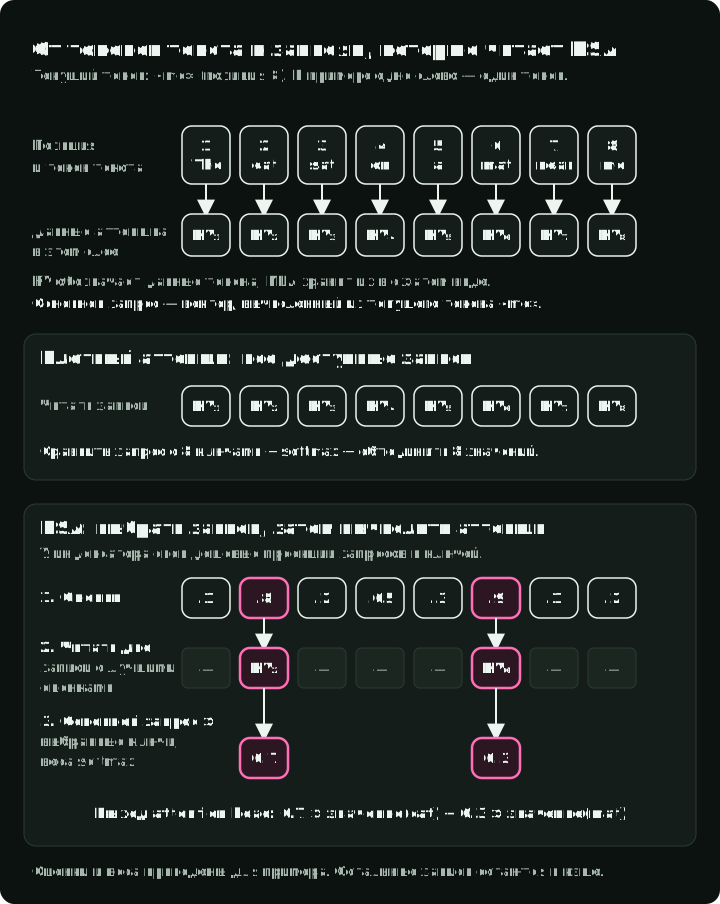
DSA уменьшает число токенов, участвующих в каждом вычислении аттеншна. Допустим, модель продолжает текст «The cat sat on a mat near me». В этом примере считайте каждое слово одним токеном. Модель обрабатывает последний токен, «me», на позиции 8.
Внутри одного слоя аттеншна представление текущего токена даёт вектор запроса. У каждого доступного токена есть ключ, с которым сравнивается запрос, и значение, которое передаёт информацию в выход. При генерации слой хранит данные аттеншна предыдущих токенов в своём KV cache, чтобы повторно использовать эти векторы. «Позиция 2» обозначает сохранённые данные для «cat»; кэш содержит числовые векторы, а не просто номера позиций. MLA хранит эти данные в описанном выше сжатом виде.
Плотный каузальный аттеншн сравнивает текущий запрос с каждым доступным ключом, включая ключ текущего токена. Softmax превращает эти оценки в веса, и слой объединяет значения с этими весами. DSA добавляет более дешёвый шаг выбора перед этим вычислением:
- Дёшево оценить доступные токены. Небольшая обученная сеть, lightning indexer, использует собственные проекции запросов и ключей, чтобы оценить каждую позицию для текущего токена. Она оценивает, какие токены основной аттеншн будет использовать больше всего.
- Выбрать позиции с наибольшими оценками. В примере «cat» и «mat» получают две наибольшие оценки индексатора. Выбор позиций 2 и 6 указывает основному аттеншну, какие сохранённые записи читать.
- Вычислить аттеншн по этим записям. Основной аттеншн вычисляет собственные оценки запроса и ключа для выбранных записей, применяет softmax к этому подмножеству и объединяет их значения. Оценки индексатора выбирают записи; это не итоговые веса аттеншна.
Проследите столбец от текстового токена к его сохранённой записи, затем сравните плотное и разреженное вычисления. Все оценки и веса ниже приведены для иллюстрации.
Уравнение индексатора из статьи даёт первую строку оценок в блоке DSA:
— текущая позиция, а — позиция-кандидат. Верхний индекс отмечает собственные векторы индексатора. Для каждого из его attention heads сравните запрос с ключом , замените отрицательное скалярное произведение нулём с помощью ReLU, умножьте на обученный вес , зависящий от токена, и просуммируйте по attention heads . Результат — оценка для выбора.
Выбор и выход одного attention head основного аттеншна можно записать так:
— строка оценок для доступных позиций от 1 до . TopKIndices возвращает позиции с наибольшими оценками, не более записей. Сумма читается «сложить взвешенные значения только для позиций в ». Здесь — заново вычисленный вес softmax основного аттеншна, — его вектор значения, а — выход. На рисунке и . Это переписывает обозначение выбранных записей из статьи в виде явной суммы; MLA может вычислить её в сжатом виде.
Остальные записи остаются в кэше. Другой запрос может выбрать другое подмножество. Обучение учит индексатор приближать распределение основного аттеншна по токенам: сначала с плотным аттеншном, затем вместе с разреженным. Неудачный выбор может исключить полезную информацию.
DeepSeek-V3.2 применяет DSA к сжатому кэшу MLA и выбирает до 2048 позиций на запрос. На последней позиции контекста из 131 072 токенов основной аттеншн читает одну запись из 64. Если доступно меньше 2048 позиций, он может использовать их все.
Экономия получается за счёт меньшего числа дорогих сравнений аттеншна. Индексатор по-прежнему оценивает каждую доступную позицию, но использует меньше attention heads и может вычислять в FP8. В последовательности длины число сравнений основного аттеншна уменьшается примерно с до , где — число выбранных записей. Работа индексатора над всеми парами остаётся квадратичной, поэтому метод в целом не является строго линейным по длине последовательности.
Уравнения оценивания и обучения приведены в DeepSeek-V3.2 v1, §2.1, уравнения (1)–(4) и подробном разборе DSA.
Gated DeltaNet: память фиксированного размера с перезаписью
Плотный аттеншн, MLA и DSA хранят растущий набор прошлых токенов. Вместо этого Gated DeltaNet обновляет одну матрицу фиксированного размера. Слой вычисляет ключ, значение и запрос из входных представлений токенов с помощью обученных проекций и коротких фильтров по соседним токенам. Ключ и значение обновляют матрицу; запрос читает обновлённую матрицу и получает выходной вектор. Он не может отдельно вернуться к ключу и значению каждого старого токена.
Полезно сравнить это с простой аддитивной памятью. Допустим, для некоторого ключа память сейчас возвращает 2, а следующий токен передаёт значение 5 для того же ключа. Прибавление нового значения дало бы 7. Дельта-обновление прибавляет поправку, , поэтому запись с полной силой даёт 5.
Пример использует ключ , который читает первый столбец матрицы: один первый столбец плюс ноль вторых. Выделенный столбец показывает поправку. После записи запрос читает из него . Размер матрицы не меняется.
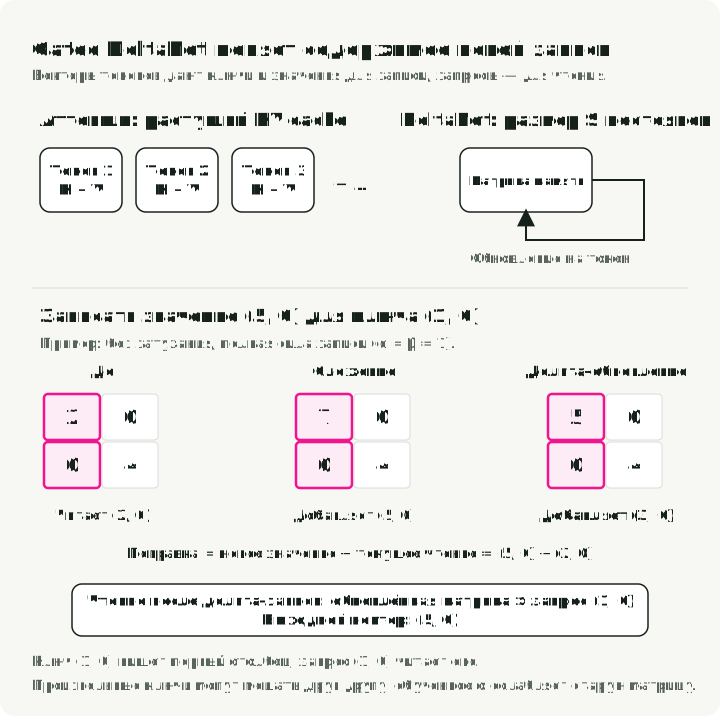
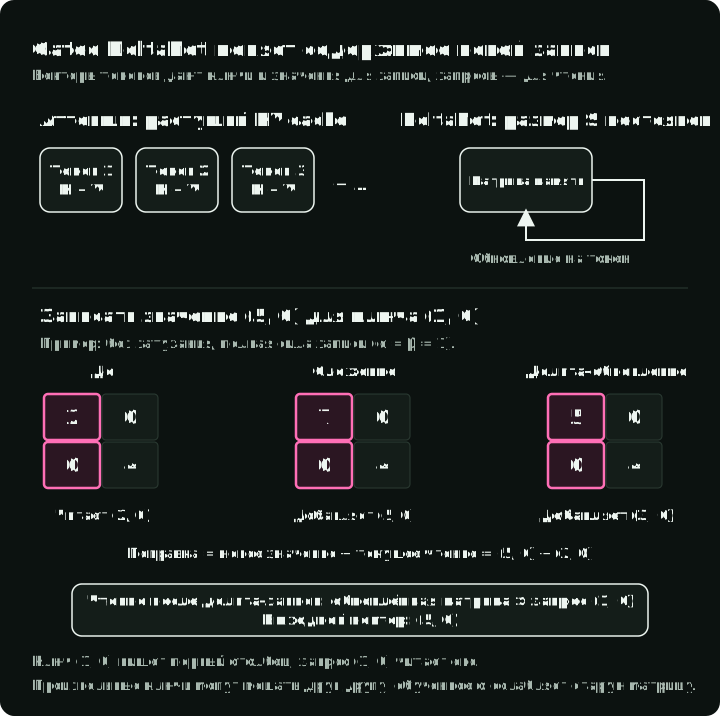
Gated DeltaNet также учится определять, сколько старой памяти сохранять и насколько сильно применять каждую поправку:
— матрица памяти, — текущий ключ единичной длины, а — его новое значение. Множитель ослабляет старую память. Чтение ослабленной памяти с ключом даёт её текущий ответ; вычитание этого ответа из даёт поправку. Множитель управляет силой записи. Оба множителя вычисляются из текущего токена. Умножение обновлённой матрицы на запрос даёт результат чтения, который слой затем нормализует, модулирует и проецирует в свой выход. Пример с изменением 2 на 5 использует их предельное значение 1.
Фиксированная память экономит место, но записи могут мешать друг другу: изменение ответа для одного ключа может изменить ответ для другого, неортогонального ключа. Затухание тоже удаляет старую информацию. Это помогает объяснить, почему статья объединяет рекуррентные слои с аттеншном в скользящем окне в гибридных моделях, сохраняя отдельные записи для недавних токенов.
Показанная форма перегруппирует Gated Delta Networks v3, §3.1, уравнение (10). Подробный разбор выводит её и показывает обновление матрицы.
Роутинг MoE: смещение выбирает экспертов, оценка задаёт веса
Слой смеси экспертов (MoE) содержит несколько сетей прямого распространения, которые называют экспертами, и выбирает лишь некоторые для каждого токена. Это увеличивает ёмкость модели без запуска каждого эксперта для каждого входа. Меняется часть Transformer с сетью прямого распространения, а не его attention heads.
Конкретное правило роутинга DeepSeek-V3 разделяет два решения: какие эксперты запускаются и каков вес их выходов. Обученный роутер получает вектор текущего токена и даёт каждому эксперту оценку . Смещение балансировки нагрузки меняет оценку для выбора на . После выбора выходные веса вычисляются из исходных оценок, нормализованных по выбранным экспертам. Смещение в эти веса не входит.
В примере выбираются два из четырёх экспертов. У эксперта 1 наибольшая исходная оценка, но отрицательное смещение исключает его; вместо него запускаются эксперты 2 и 3. Оба получают один и тот же вектор токена . Каждый выдаёт новый вектор, обозначенный или , а слой складывает эти выходы с весами 0,56 и 0,44. Диаграмма показывает только этот вклад выбираемых экспертов.
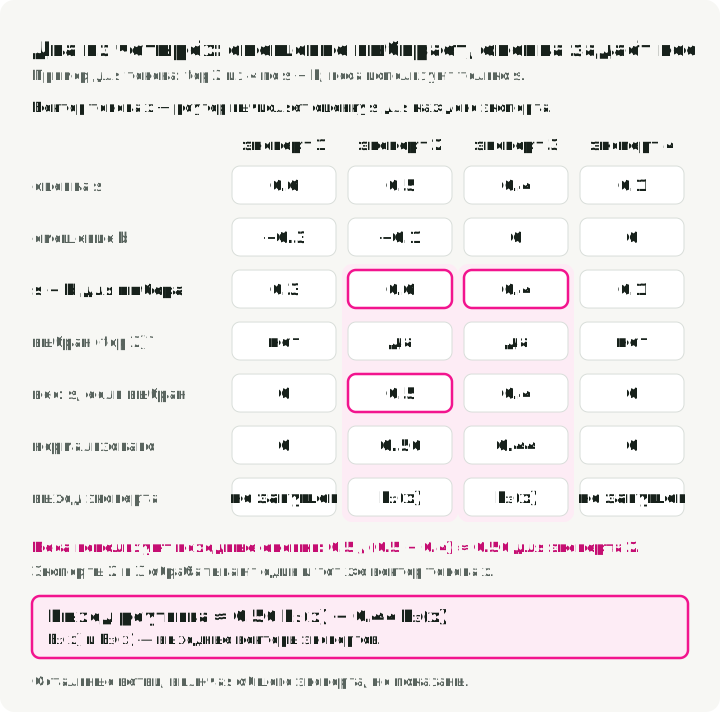
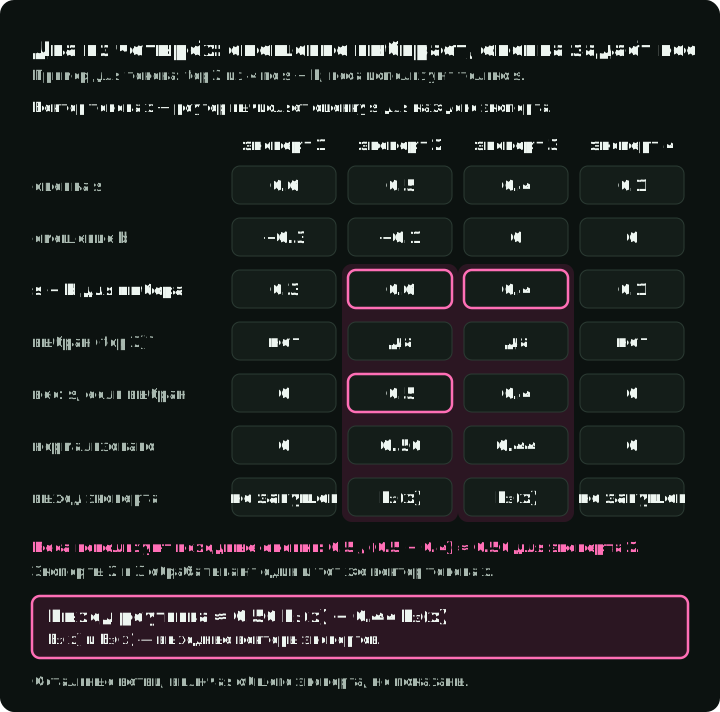
Компактная форма правила роутинга DeepSeek-V3 для одного токена:
и собирают оценки и смещения всех экспертов; — число выбираемых экспертов. Первая строка возвращает индексы выбранных экспертов . Фигурная скобка во второй строке — это if/else: разделить исходную оценку выбранного эксперта на сумму выбранных оценок или присвоить ноль, если эксперт не выбран. Последняя строка складывает выходные векторы экспертов с этими весами. На рисунке , поэтому и . Смещение появляется только при выборе. Вклады остаточного соединения и общего эксперта не входят в .
При обучении смещение слишком часто используемого эксперта уменьшается, а слишком редко используемого — увеличивается. Это способствует более равномерной нагрузке. DeepSeek-V3 также сохраняет небольшие балансирующие потери для каждой последовательности, поэтому «auxiliary-loss-free» не означает полного отсутствия балансирующих потерь.
Его конфигурация активирует 8 из 256 выбираемых экспертов на токен плюс одного общего эксперта, который запускается всегда. Эти числа и общий эксперт относятся к данной модели, а не к определению MoE. См. DeepSeek-V3 v2, §2.1.2, уравнения (12)–(17) и разбор роутинга.
mHC: остаточное смешивание ограничено взвешенными средними
Обычное остаточное соединение передаёт вектор токена в обход подслоя и добавляет к нему результат подслоя. mHC поддерживает несколько таких векторов, называемых остаточными потоками, и меняет их смешивание между слоями. Идеальная матрица смешивания имеет неотрицательные элементы с суммами строк и столбцов, равными единице. Такое смешивание образует взвешенные средние, сохраняя сумму по потокам. Реализация приближённо выполняет это ограничение конечным числом шагов нормализации; она не ограничивает каждую операцию в сети.
Отдельная статья о mHC объясняет механизм, нормализацию и ограничения с диаграммами. Для этой темы используйте её; разбор уравнения содержит вывод.
LoRA: низкоранговое обновление рядом с замороженным весом
Полный файн-тюнинг обновляет матрицы весов модели. LoRA замораживает предобученную матрицу и обучает рядом с ней меньшую поправку:
— вектор токена на входе выбранного линейного слоя, а — выходной вектор, который передаётся дальше по модели. Исходное умножение по-прежнему выполняется. В поправке отображает вход в гораздо меньший вектор, а возвращает его к размеру выхода. Обучающие примеры и потери задачи определяют обновления и ; остаётся фиксированной. Их общая малая размерность — настройка ранга ; полученное обновление имеет ранг не выше .
Для матрицы весов и полное обновление содержит около 16,8 миллиона элементов. Две матрицы LoRA содержат : в 256 раз меньше обучаемых элементов для этой матрицы. Это уменьшает память для градиентов и состояния оптимизатора, но полный базовый вес по-прежнему занимает память и участвует в вычислении.
Проследите два пути от одного входа: замороженная матрица по-прежнему вычисляет свой выход, а обучаемая поправка проходит всего через восемь чисел.
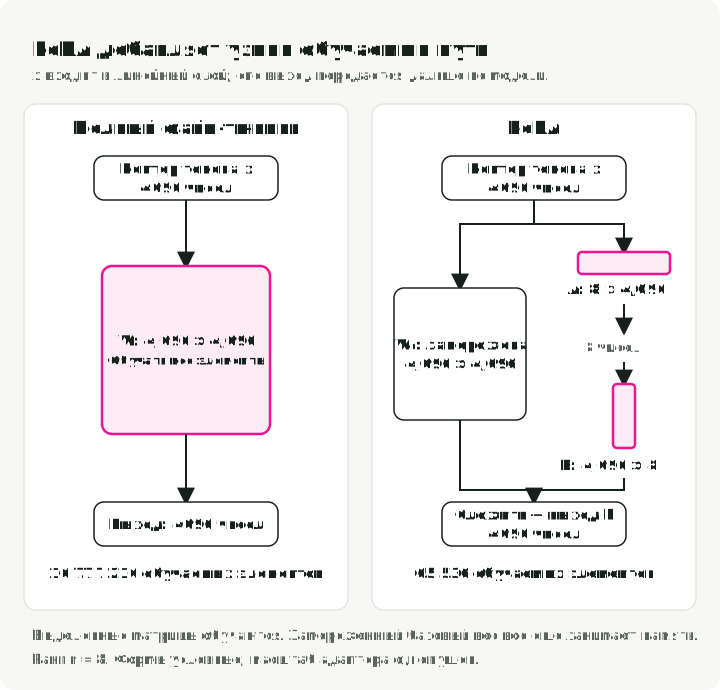
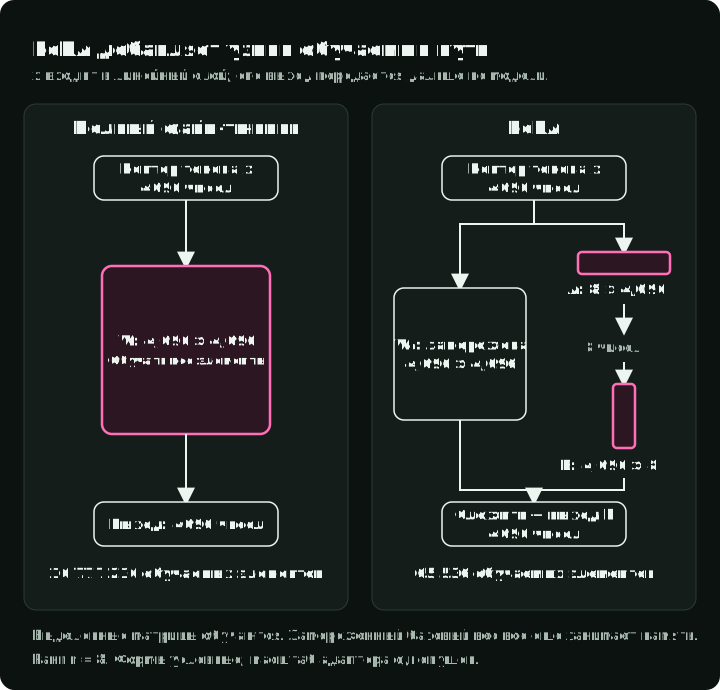
В исходном методе начинается с нуля, поэтому поправка сначала ничего не меняет. Статья масштабирует обновление на — настройку, опущенную в её уравнении (3) выше. После обучения масштабированную поправку можно добавить к ; объединённому слою требуется только исходное матричное умножение. Отдельные адаптеры добавляют вычисления, но позволяют заменять их.
См. LoRA v2, §4.1, уравнение (3) и подробный разбор LoRA. QLoRA дополнительно хранит замороженные базовые веса в 4-битном виде и деквантизирует их для вычислений; это не делает всю память обучения 4-битной. Руководство по файн-тюнингу сравнивает практические варианты.
Дополнительные разборы уравнений
Разборы уравнений по ссылке содержат определения символов, промежуточные выводы и проверки на маленьких числах. Они подготовлены с помощью инструкций для агентов программирования из paper-math-skills. Это дополнительные объяснения; первичные источники — статьи, на которые даны ссылки рядом с каждым механизмом.
Источники и версии
Ссылки на статьи выше указывают версии, использованные для номеров разделов и уравнений. Исходный вариант аттеншна описан в Attention Is All You Need v7, §3.2 и §3.5. Отдельная тема остаточного смешивания рассмотрена в mHC v2.