Architekturgleichungen lesen: RoPE, MLA, MoE und LoRA

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Artikel erklärt, was sechs Methoden für Modellarchitekturen ändern: woher Attention Positionsinformationen erhält, was sie im Speicher hält, welche Tokens oder Experten sie nutzt und welche Gewichte Fine-Tuning aktualisiert. Er richtet sich an Ingenieure, die den Aufbau eines Transformers in Grundzügen kennen, aber RoPE, MLA, Sparse Attention, Gated DeltaNet, MoE und LoRA verstehen wollen, ohne die Herleitungen jedes Papers durchzuarbeiten. Die Diagramme vergleichen die Mechanismen; die Gleichungen erklären die wesentliche Änderung.
Ein Token gelangt als Zahlenvektor in das Modell, als sogenanntes Embedding. Jede Schicht aktualisiert diese Darstellung. Bei Attention überführen drei gelernte Matrixmultiplikationen, auch Projektionen genannt, die eingehenden Token-Vektoren in Queries (), Keys () und Values (). Die Diagrammbeschriftungen , und bezeichnen diese gelernten Matrizen.
Eine Attention-Schicht vergleicht Queries mit Keys, um zu bestimmen, welches Gewicht der Value jedes Tokens erhält. Für einen Head lautet die Berechnung:
Lesen Sie die Operationen der Reihe nach: vergleicht jede Query mit jedem Key; transponiert die Key-Matrix, damit die Vektoren für die Multiplikation passend angeordnet sind. Teilen Sie durch die Quadratwurzel ihrer Länge und wenden Sie dann Softmax auf jede Zeile an, um Gewichte zu erhalten. Die Multiplikation mit mittelt die Values mit diesen Gewichten. Das Ergebnis ist ein aktualisierter Vektor für jedes Token, der innerhalb der Schicht weitergegeben wird. In einem kausalen Sprachmodell schließt Attention zukünftige Tokens vor Softmax aus. Teil 1 rechnet dies mit kleinen Matrizen durch.
Die ersten vier Abschnitte ändern diese Berechnung oder ihren Speicher. MoE ändert das Feed-Forward-Netz, und LoRA ändert, wie Gewichte trainiert werden. Sie können die Abschnitte unabhängig voneinander lesen; das MLA-Diagramm verwendet den bei RoPE eingeführten Positionsmechanismus.
RoPE: Position als Rotation
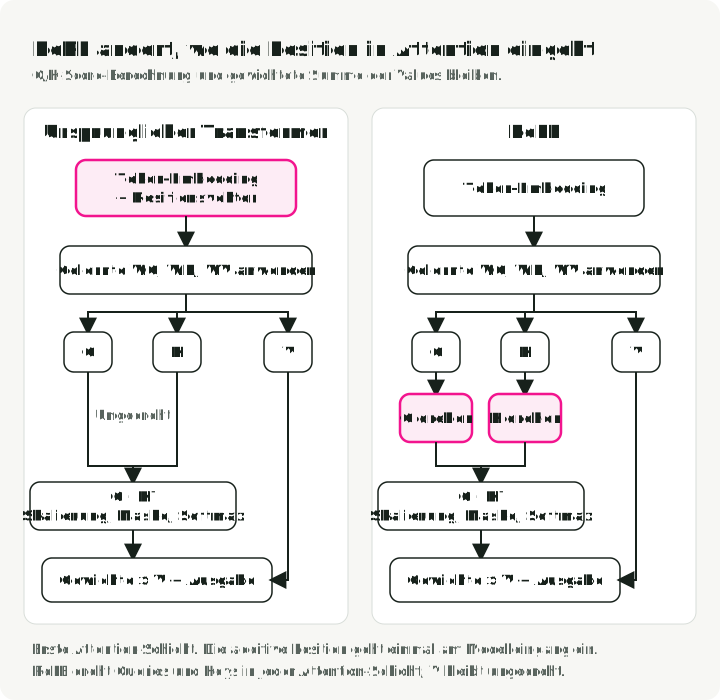
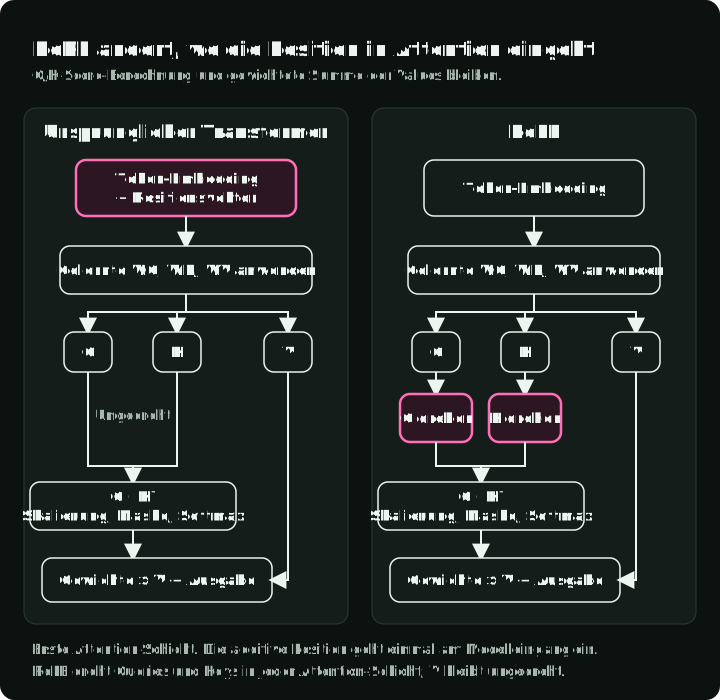
Ein Query-Key-Skalarprodukt vergleicht Inhaltsvektoren. Für sich genommen sagt es nicht, ob zwei Tokens nebeneinander oder hundert Positionen auseinanderliegen. Der ursprüngliche Transformer addiert vor der ersten Attention-Schicht einen Positionsvektor zu jedem Token-Embedding. Positionsinformationen beeinflussen dann die Queries, Keys und Values, die aus diesen Eingaben berechnet werden. Er dreht sie nicht. Siehe Attention Is All You Need, §3.5.
RoPE integriert die Position direkt in den Query-Key-Vergleich. Berechnen Sie zuerst Queries und Keys mit den üblichen gelernten Projektionen. Drehen Sie dann Paare ihrer Koordinaten um Winkel, die von der Position des jeweiligen Tokens abhängen. Berechnen Sie die Attention-Scores aus diesen gedrehten Vektoren. RoPE dreht die Values nicht.
Die beiden Darstellungen unten zeigen, wo die Position eingeht. In beiden Fällen folgt die Berechnung der gewichteten Values auf die Score-Berechnung.
Für ein Koordinatenpaar ist die Rotation eine Matrixmultiplikation:
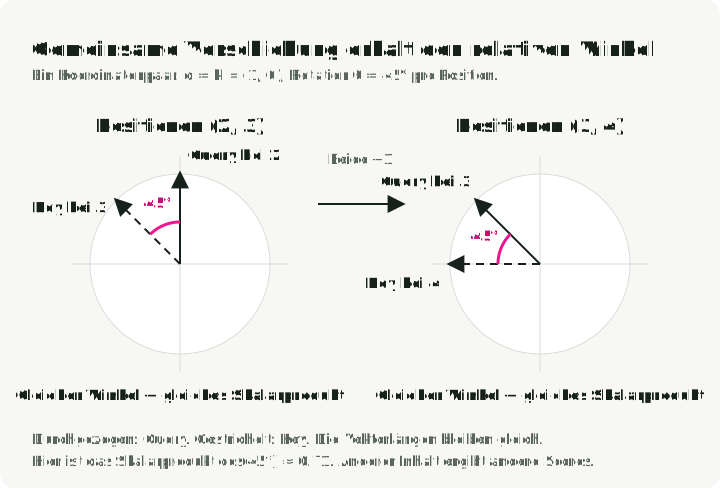
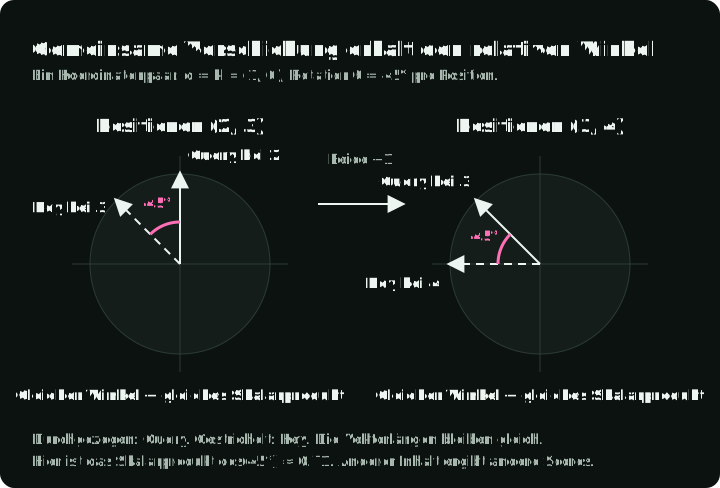
ist der Drehwinkel. Multipliziert man diese Matrix mit , erhält man ; bei 90° ist das , der nach oben gerichtete Query-Pfeil im nächsten Diagramm.
Warum eine Rotation? Ein Skalarprodukt hängt vom Winkel zwischen Vektoren ab. Dreht man beide Vektoren um denselben zusätzlichen Winkel, bleibt ihr Skalarprodukt unverändert. Verschieben sich eine Query an Position 2 und ein Key an Position 3 auf die Positionen 3 und 4, bleibt ihr Positionsabstand eins. Bei denselben zugrunde liegenden Inhaltsvektoren liefert RoPE denselben Score:
Hier sind und jeweils ein Koordinatenpaar von Query und Key, dreht sie, und sind Token-Positionen, und ist der Drehwinkel pro Position. Die rechte Seite zeigt die nützliche Eigenschaft: Der explizite Positionsterm verwendet die Differenz . Der Score hängt weiterhin von den Inhaltsvektoren ab, nicht nur vom Abstand.
Das Diagramm setzt beide ursprünglichen Vektoren auf fest und verwendet eine Rotation von 45° pro Position. Dies sind gewählte Beispielwerte: Bei festem Inhalt lässt sich der Effekt einer Verschiebung beider Positionen erkennen.
Eine vollständige Query oder ein vollständiger Key hat viele Koordinatenpaare. RoPE dreht sie mit unterschiedlichen Geschwindigkeiten, sodass sie Positionsabstände auf mehreren Skalen darstellen. Das garantiert weder gute Attention bei beliebigen Kontextlängen noch, dass jeder Score mit dem Abstand abnimmt.
Die Rotationsmatrizen und ihre Herleitung stehen in RoFormer v5, §3.2, Gleichungen (12)–(16). Die detaillierte RoPE-Analyse enthält die algebraischen Zwischenschritte und numerische Prüfungen.
MLA: einen kleinen Vektor statt Keys und Values speichern
Attention Heads gab es schon vor MLA. Die Multi-Head Attention des ursprünglichen Transformers, §3.2.2, führt mehrere Attention-Berechnungen mit unterschiedlichen gelernten Projektionen aus und kombiniert deren Ausgaben. DeepSeek behält mehrere Heads bei. Es ändert, wie ihre Keys und Values dargestellt und zwischengespeichert werden.
Während der Generierung speichert gewöhnliche Multi-Head Attention für jedes frühere Token für jeden Head einen Key und einen Value. Dieser KV cache wächst mit der Sequenz. MLA verwendet stattdessen eine gelernte Projektion, die die eingehende Darstellung des Tokens direkt in einen kurzen Vektor überführt. Daraus lassen sich die Inhalts-Keys und Values der Heads berechnen. Alle Heads teilen diesen gespeicherten Vektor, verwenden aber unterschiedliche Projektionen und Attention-Gewichte; sie werden nicht zu identischen Heads.
Das Diagramm zeigt ein Token vom eingehenden Vektor bis zu seinen gespeicherten Daten in einer Schicht. Auf beiden Seiten lesen spätere Queries diese Daten durch mehrere Heads; die Head-Ausgaben werden zur Attention-Ausgabe kombiniert.
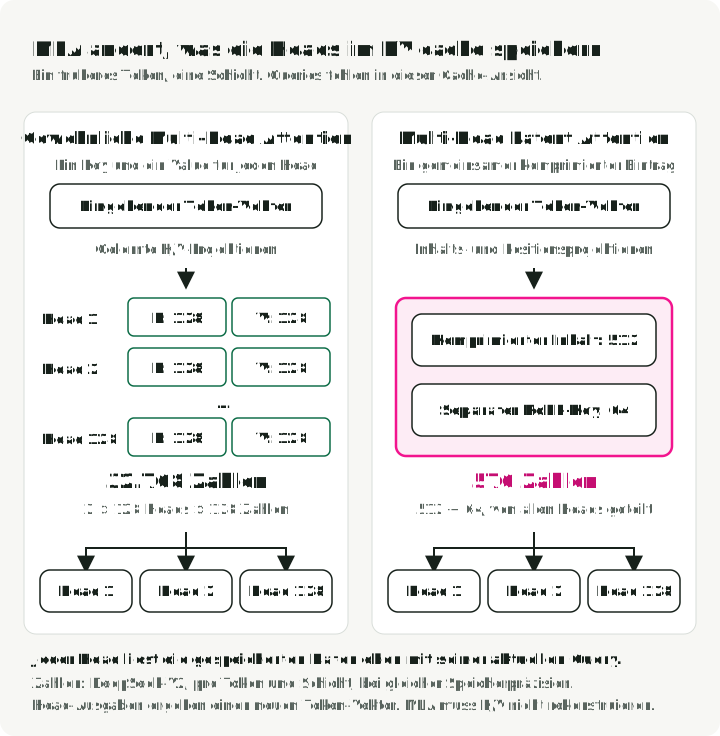
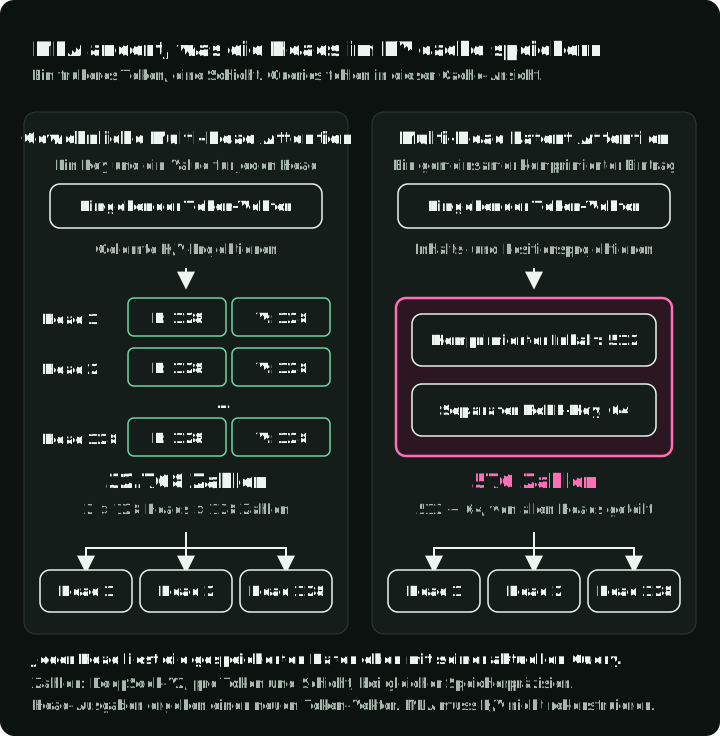
Die Inhaltsberechnung im Diagramm entspricht drei Gleichungen aus DeepSeek-V2:
ist der eingehende Vektor von Token . Die erste Zeile bildet ihn auf den kürzeren gespeicherten Vektor ab. Die nächsten beiden bilden denselben Vektor auf Inhalts-Keys und Values für alle Heads ab. Die Hochstellungen sind Bezeichnungen, keine Potenzen: bezeichnet die verkleinernde Projektion, und die erweiternden Projektionen für Keys und Values, und kennzeichnet den Inhaltsanteil. Alle drei -Matrizen sind gelernt. Der separate Positions-Key liegt außerhalb dieser drei Gleichungen.
Für die Konfiguration von DeepSeek-V2 lautet der Vergleich 32.768 Zahlen gegenüber 576: Gewöhnliche Attention mit 128 Heads und 128 Zahlen in jedem Key und Value benötigt ; MLA hält einen komprimierten Vektor mit 512 Zahlen und einen Positions-Key mit 64 Zahlen vor. Bei gleicher Präzision sind das etwa 57-mal weniger gespeicherte Zahlen. Der Vergleich gilt für diese Konfiguration gegenüber gewöhnlicher Multi-Head Attention, nicht gegenüber jedem Cache-Entwurf, und bedeutet keine 57-mal schnellere Inference.
Würde die Erweiterung des komprimierten Vektors für jedes alte Token den Vorteil aufheben? MLA kann diese Erweiterung vermeiden. Kürzen Sie für einen Head zu ab und bezeichnen Sie dessen Zeilen von als seine Key-Erweiterungsmatrix . Dann gilt:
Die linke Seite erweitert jeden gespeicherten Vektor zu einem Key, bevor sie ihn mit der Query vergleicht. Die rechte Seite transformiert die aktuelle Query einmal und vergleicht sie dann direkt mit den gespeicherten Vektoren. Es ist dieselbe Berechnung mit anderer Gruppierung. Die Value-Berechnung lässt sich ähnlich umstellen: erst die komprimierten Vektoren mitteln, dann die Ausgabeprojektionen anwenden. Eine Implementierung kann die Multiplikationsreihenfolge passend zu ihrer Hardware wählen.
RoPE erfordert eine separate Behandlung. Würde man die erweiterten Inhalts-Keys drehen, käme eine positionsabhängige Operation in diese Umgruppierung. MLA lässt diese Keys daher ungedreht und ergänzt einen separaten Query-Key-Vergleich für die Position. Deshalb enthält der Cache sowohl den komprimierten Inhaltsvektor als auch einen kleinen gedrehten Positions-Key.
MLA ist eine gelernte Architektur, kein verlustfreier Kompressor für beliebige bestehende Attention-Schichten. DeepSeek-V2 v5, §2.1.2–2.1.3, Gleichungen (9)–(19) definiert die Projektionen und die separate RoPE-Komponente. Die detaillierte MLA-Analyse enthält die vollständigen Formen und Matrixumgruppierungen.
Sparse Attention (DSA): eine günstige Bewertung wählt die Keys
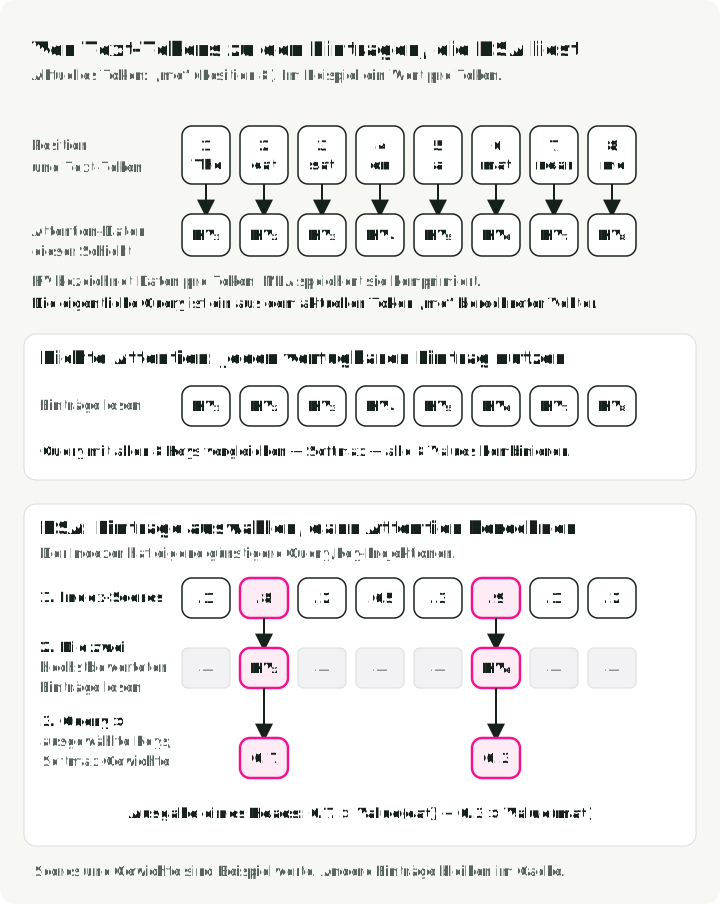
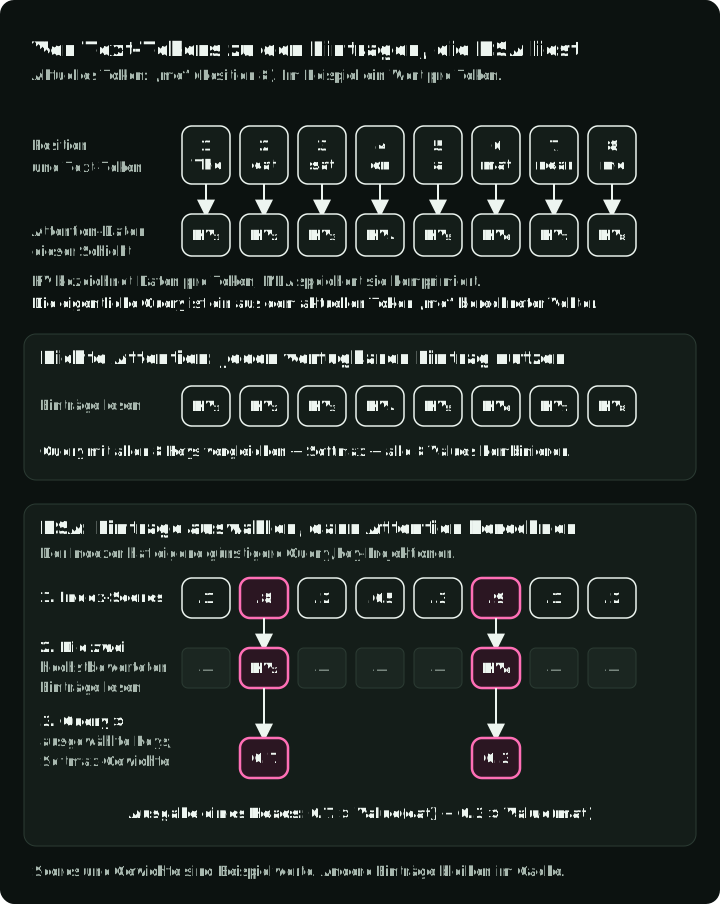
DSA reduziert die Anzahl der Tokens, die an jeder Attention-Berechnung teilnehmen. Angenommen, ein Modell setzt den Text „The cat sat on a mat near me“ fort. Behandeln Sie für dieses Beispiel jedes Wort als ein Token. Das Modell verarbeitet das letzte Token, „me“, an Position 8.
Innerhalb einer Attention-Schicht erzeugt die Darstellung des aktuellen Tokens einen Query-Vektor. Jedes verfügbare Token hat einen Key, mit dem die Query verglichen wird, und einen Value, der Informationen zur Ausgabe beiträgt. Während der Generierung hält die Schicht die Attention-Daten früherer Tokens in ihrem KV cache, um diese Vektoren wiederzuverwenden. „Position 2“ bezeichnet die gespeicherten Daten für „cat“; der Cache enthält Zahlenvektoren, nicht nur Positionsnummern. MLA speichert diese Daten in der oben beschriebenen komprimierten Form.
Dichte kausale Attention vergleicht die aktuelle Query mit jedem verfügbaren Key, einschließlich des Keys des aktuellen Tokens. Softmax wandelt diese Scores in Gewichte um, und die Schicht kombiniert die Values mit diesen Gewichten. DSA ergänzt vor dieser Berechnung einen günstigeren Auswahlschritt:
- Die verfügbaren Tokens günstig bewerten. Ein kleines gelerntes Netz, der Lightning Indexer, bewertet mit eigenen Query- und Key-Projektionen jede Position für das aktuelle Token. Es schätzt, welche Tokens die eigentliche Attention am stärksten nutzen wird.
- Die Positionen mit den höchsten Scores auswählen. Im kleinen Beispiel erhalten „cat“ und „mat“ die beiden höchsten Index-Scores. Die Auswahl der Positionen 2 und 6 legt fest, welche gespeicherten Einträge die eigentliche Attention liest.
- Attention auf diesen Einträgen berechnen. Die eigentliche Attention berechnet ihre eigenen Query-Key-Scores für die ausgewählten Einträge, wendet Softmax auf diese Teilmenge an und kombiniert deren Values. Die Scores des Indexers wählen die Einträge aus; sie sind nicht die endgültigen Attention-Gewichte.
Verfolgen Sie eine Spalte vom Text-Token zu seinem gespeicherten Eintrag und vergleichen Sie dann die dichte mit der dünn besetzten Berechnung. Alle Scores und Gewichte unten sind Beispielwerte.
Die Indexer-Gleichung des Papers ergibt die erste Score-Zeile in der DSA-Darstellung:
ist die aktuelle Position und eine Kandidatenposition. Die Hochstellung bezeichnet die eigenen Vektoren des Indexers. Vergleichen Sie für jeden seiner Heads Query mit Key , ersetzen Sie ein negatives Skalarprodukt mit ReLU durch null, multiplizieren Sie mit dem gelernten tokenabhängigen Gewicht und summieren Sie über die Heads . Das Ergebnis ist ein Auswahl-Score.
Die Auswahl und die Ausgabe eines Heads der eigentlichen Attention lassen sich so schreiben:
ist die Score-Zeile für die verfügbaren Positionen 1 bis . TopKIndices gibt die Positionen der höchsten Scores zurück, bis zu Einträge. Die Summe liest sich „die gewichteten Values nur für Positionen in addieren“. Hier ist ein neu berechnetes Softmax-Gewicht der eigentlichen Attention, der zugehörige Value-Vektor und die Ausgabe. In der Abbildung gilt und . Dies schreibt die Notation des Papers für ausgewählte Einträge als explizite Summe; MLA kann sie in komprimierter Form berechnen.
Die anderen Einträge bleiben im Cache. Eine andere Query kann eine andere Teilmenge auswählen. Das Training bringt dem Indexer bei, die Token-Verteilung der eigentlichen Attention anzunähern, zuerst mit dichter Attention und dann zusammen mit Sparse Attention. Eine schlechte Auswahl kann nützliche Informationen auslassen.
DeepSeek-V3.2 wendet DSA auf MLAs komprimierten Cache an und wählt bis zu 2.048 Positionen pro Query. An der letzten Position eines Kontexts mit 131.072 Tokens liest die eigentliche Attention einen Eintrag von 64. Sind weniger als 2.048 Positionen verfügbar, kann sie alle verwenden.
Die Ersparnis entsteht durch weniger teure Attention-Vergleiche. Der Indexer bewertet weiterhin jede verfügbare Position, verwendet aber weniger Heads und kann in FP8 rechnen. Über eine Sequenz der Länge fallen die Vergleiche der eigentlichen Attention von ungefähr auf , wobei die ausgewählte Anzahl ist. Die Arbeit des Indexers für alle Paare bleibt quadratisch; die gesamte Methode ist daher nicht streng linear in der Sequenzlänge.
Die Bewertungs- und Trainingsgleichungen stehen in DeepSeek-V3.2 v1, §2.1, Gleichungen (1)–(4) und der detaillierten DSA-Analyse.
Gated DeltaNet: ein Speicher fester Größe mit Überschreiben
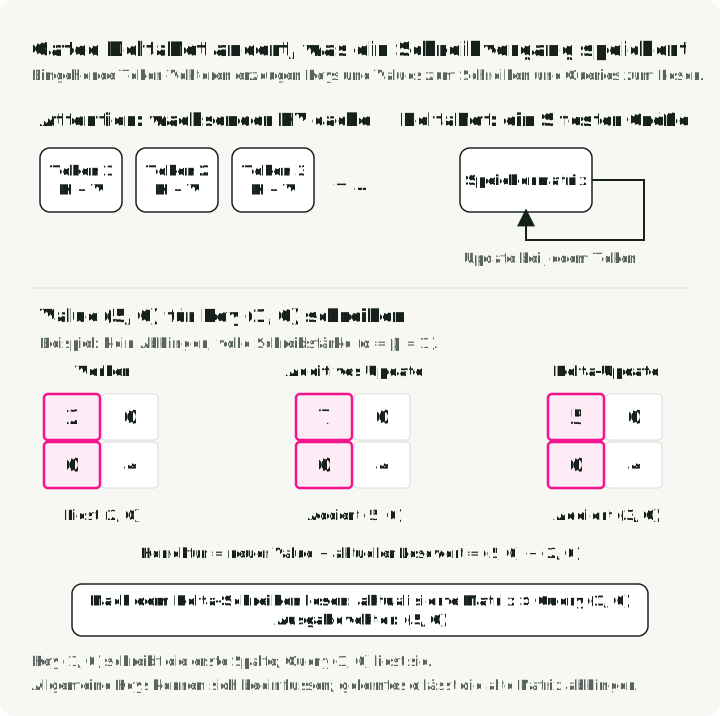
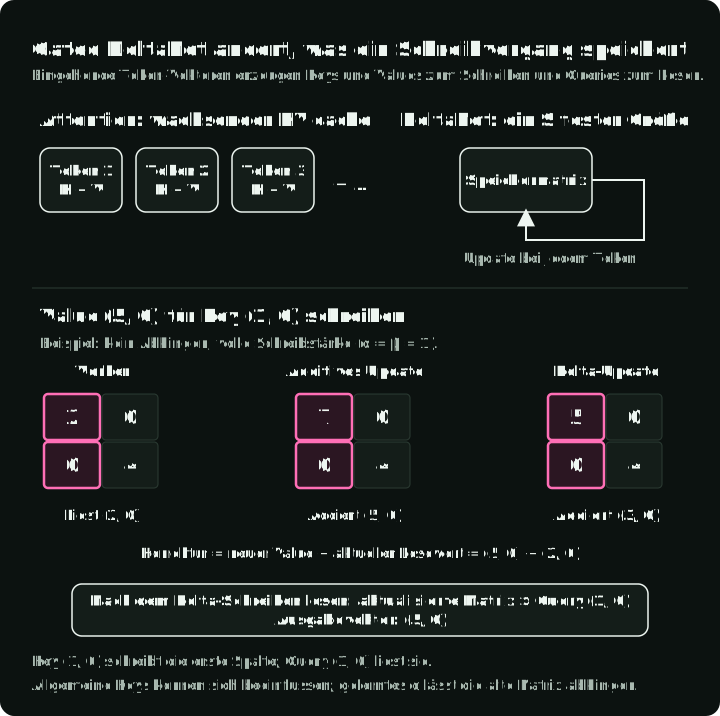
Dichte Attention, MLA und DSA halten eine wachsende Aufzeichnung früherer Tokens vor. Gated DeltaNet aktualisiert stattdessen eine einzige Matrix fester Größe. Die Schicht berechnet aus eingehenden Token-Darstellungen mit gelernten Projektionen und kurzen Filtern über benachbarte Tokens einen Key, einen Value und eine Query. Key und Value aktualisieren die Matrix; die Query liest die aktualisierte Matrix und erzeugt einen Ausgabevektor. Sie kann nicht den Key und Value jedes alten Tokens einzeln erneut abrufen.
Hilfreich ist der Vergleich mit einem einfachen additiven Speicher. Angenommen, der Speicher gibt derzeit für einen bestimmten Key 2 zurück und das nächste Token liefert für denselben Key den Value 5. Die Addition des neuen Values ergäbe 7. Ein Delta-Update addiert die Korrektur, , sodass ein Schreibvorgang mit voller Stärke 5 ergibt.
Das Beispiel verwendet den Key , der die erste Spalte der Matrix liest: einmal die erste Spalte plus nullmal die zweite. Die hervorgehobene Spalte zeigt die Korrektur. Nach dem Schreiben liest eine Query daraus . Die Matrix behält dieselbe Größe.
Gated DeltaNet lernt außerdem, wie viel des alten Speichers erhalten bleiben und wie stark jede Korrektur wirken soll:
ist die Speichermatrix, der aktuelle Key mit Länge eins und sein neuer Value. Der Faktor lässt den alten Speicher abklingen. Liest man den abgeklungenen Speicher mit , erhält man seine aktuelle Antwort; zieht man sie von ab, ergibt sich die Korrektur. Der Faktor steuert die Schreibstärke. Beide Faktoren werden aus dem aktuellen Token berechnet. Die Multiplikation der aktualisierten Matrix mit der Query ergibt den ausgelesenen Vektor, den die Schicht dann normalisiert, mit einem Gate gewichtet und auf ihre Ausgabe projiziert. Das Beispiel von 2 auf 5 verwendet den Grenzwert 1 für beide Faktoren.
Fester Speicher spart Platz, aber Schreibvorgänge können sich gegenseitig beeinflussen: Die Änderung der Antwort für einen Key kann auch die Antwort für einen anderen, nicht orthogonalen Key ändern. Das Abklingen entfernt ebenfalls alte Informationen. Dies hilft zu erklären, warum das Paper rekurrente Schichten in hybriden Modellen mit Sliding-Window Attention kombiniert, die separate Einträge für die letzten Tokens beibehält.
Die dargestellte Form gruppiert Gated Delta Networks v3, §3.1, Gleichung (10) um. Die detaillierte Analyse leitet sie her und rechnet das Matrix-Update durch.
MoE-Routing: Der Bias wählt Experten, der Score gewichtet sie
Eine Mixture-of-Experts-Schicht (MoE) hat mehrere Feed-Forward-Netze, die Experten, und wählt für jedes Token nur einige davon aus. Das erhöht die Modellkapazität, ohne jeden Experten für jede Eingabe auszuführen. Es ändert den Feed-Forward-Teil eines Transformers, nicht seine Attention Heads.
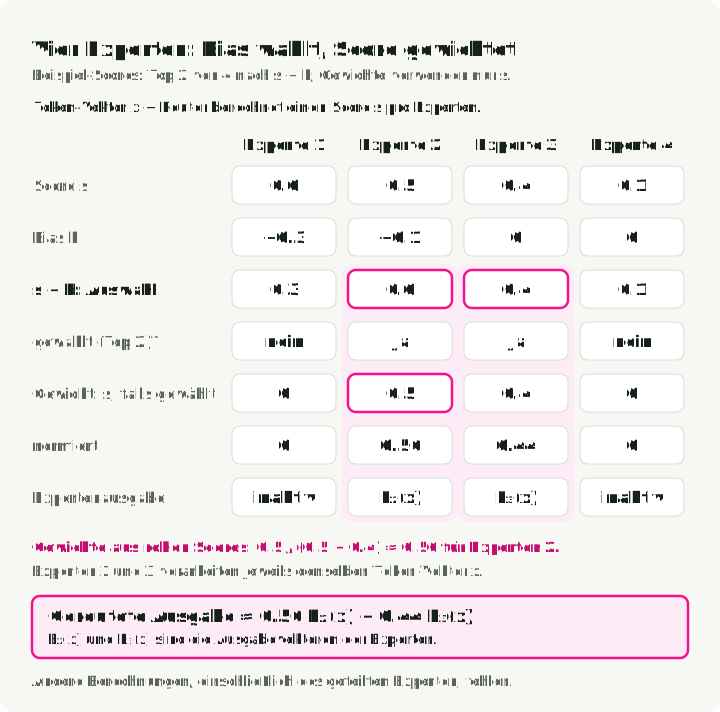
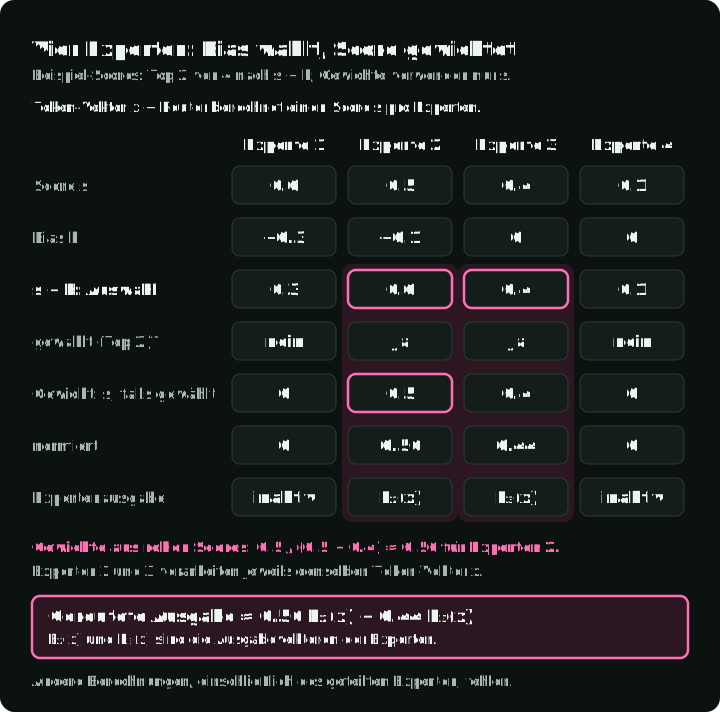
Die konkrete Routing-Regel von DeepSeek-V3 trennt zwei Entscheidungen: welche Experten ausgeführt werden und wie stark ihre Ausgaben zählen. Ein gelernter Router erhält den Vektor des aktuellen Tokens und gibt jedem Experten einen Score . Ein Bias zur Lastverteilung ändert den Auswahl-Score zu . Nach der Auswahl stammen die Ausgabegewichte aus den ursprünglichen Scores, normalisiert über die ausgewählten Experten. Der Bias geht nicht in diese Gewichte ein.
Das kleine Beispiel wählt zwei von vier Experten. Experte 1 hat den höchsten rohen Score, sein negativer Bias schließt ihn aber aus; stattdessen werden die Experten 2 und 3 ausgeführt. Beide erhalten denselben Token-Vektor . Jeder erzeugt einen neuen Vektor, geschrieben als oder , und die Schicht addiert diese Ausgaben mit den Gewichten 0.56 und 0.44. Das Diagramm zeigt nur diesen Beitrag der gerouteten Experten.
Eine kompakte Form der Routing-Regel von DeepSeek-V3 für ein Token lautet:
und enthalten die Scores und Biases aller Experten; ist die auszuwählende Anzahl. Die erste Zeile gibt die Indizes der ausgewählten Experten zurück. Die geschweifte Klammer in der zweiten Zeile ist ein If/Else: Den ursprünglichen Score eines ausgewählten Experten durch die Summe der ausgewählten Scores teilen oder null zuweisen, wenn er nicht ausgewählt wurde. Die letzte Zeile addiert die Ausgabevektoren der Experten mit diesen Gewichten. In der Abbildung gilt , also und . Der Bias erscheint nur bei der Auswahl. Die Beiträge der Residualverbindung und der geteilten Experten liegen außerhalb von .
Während des Trainings sinkt der Bias eines zu oft verwendeten Experten, und der eines zu selten verwendeten steigt. Das fördert eine gleichmäßigere Last. DeepSeek-V3 behält außerdem einen kleinen Balance-Loss pro Sequenz bei; „auxiliary-loss-free“ bedeutet also nicht, dass das Modell überhaupt keinen Balance-Loss hat.
Seine Konfiguration aktiviert pro Token 8 von 256 gerouteten Experten sowie einen geteilten Experten, der immer ausgeführt wird. Diese Anzahlen und der geteilte Experte gehören zu diesem Modell, nicht zur Definition von MoE. Siehe DeepSeek-V3 v2, §2.1.2, Gleichungen (12)–(17) und die Routing-Analyse.
mHC: Residualmischung auf gewichtete Mittelwerte beschränkt
Eine gewöhnliche Residualverbindung führt einen Token-Vektor an einer Teilschicht vorbei und addiert deren Ergebnis zu ihm. mHC hält mehrere solcher Vektoren vor, die Residual Streams, und ändert ihre Mischung zwischen Schichten. Seine ideale Mischungsmatrix hat nichtnegative Einträge, und jede Zeile und Spalte summiert sich zu eins. Diese Mischung bildet gewichtete Mittelwerte und erhält die Gesamtsumme über die Streams. Die Implementierung nähert diese Nebenbedingung mit einer endlichen Anzahl von Normalisierungsschritten an; sie beschränkt nicht jede Operation im Netz.
Der separate mHC-Artikel erklärt den Mechanismus, die Normalisierung und die Grenzen mit Diagrammen. Verwenden Sie ihn für dieses Thema; die Gleichungsanalyse liefert die Herleitung.
LoRA: ein Update mit niedrigem Rang neben einem eingefrorenen Gewicht
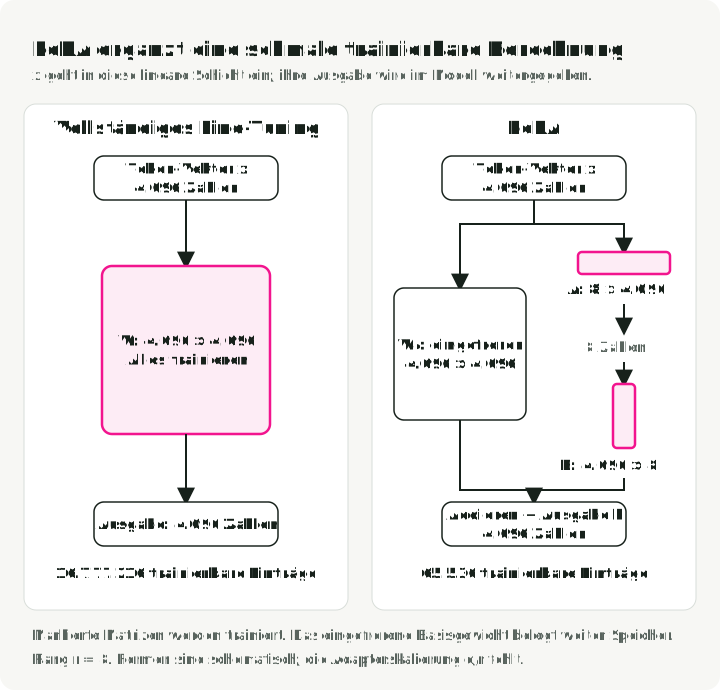
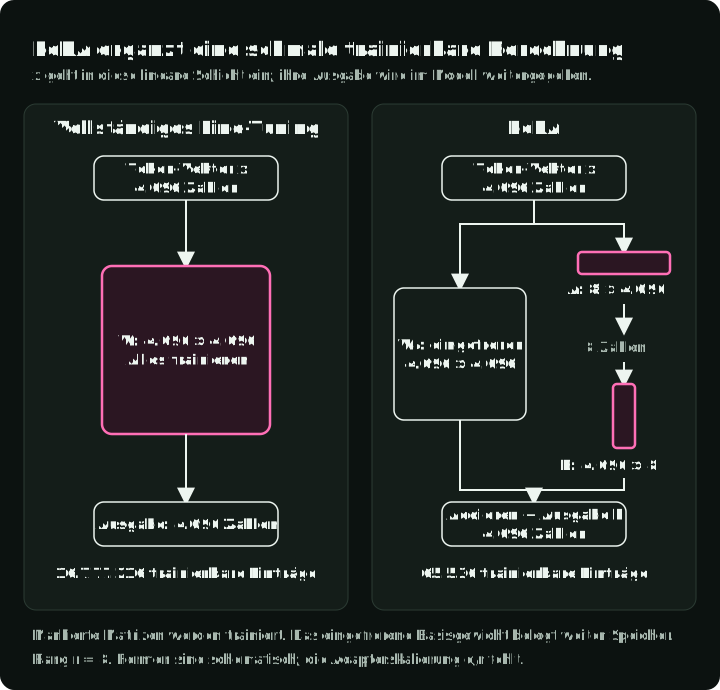
Vollständiges Fine-Tuning aktualisiert die Gewichtsmatrizen des Modells. LoRA friert eine vortrainierte Matrix ein und lernt daneben eine kleinere Korrektur:
ist der Token-Vektor, der in die gewählte lineare Schicht eingeht, und der Ausgabevektor, der im Modell weitergegeben wird. Die ursprüngliche Multiplikation wird weiterhin ausgeführt. In der Korrektur bildet die Eingabe auf einen viel kleineren Vektor ab, und bildet ihn zurück auf die Größe der Ausgabe ab. Trainingsbeispiele und der Loss der Aufgabe bestimmen die Updates für und ; bleibt fest. Ihre gemeinsame kleine Dimension ist die Einstellung für den Rang ; das resultierende Update hat höchstens Rang .
Für eine Gewichtsmatrix der Form und hat ein vollständiges Update etwa 16,8 Millionen Einträge. Die beiden LoRA-Matrizen haben : 256-mal weniger trainierbare Einträge für diese Matrix. Das reduziert den Speicher für Gradienten und Optimiererzustände; das vollständige Basisgewicht belegt aber weiterhin Speicher und wird in der Berechnung verwendet.
Verfolgen Sie die beiden Berechnungen von derselben Eingabe aus: Die eingefrorene Matrix berechnet weiterhin ihre Ausgabe, während die trainierbare Korrektur durch einen Vektor mit nur acht Zahlen verläuft.
In der ursprünglichen Methode beginnt bei null, sodass die Korrektur zunächst nichts ändert. Das Paper skaliert das Update mit , einer Einstellung, die in seiner Gleichung (3) oben weggelassen wurde. Nach dem Training lässt sich die skalierte Korrektur zu addieren; die zusammengeführte Schicht benötigt dann nur die ursprüngliche Matrixmultiplikation. Separate Adapter verursachen zusätzliche Berechnungen, lassen sich aber austauschen.
Siehe LoRA v2, §4.1, Gleichung (3) und die detaillierte LoRA-Analyse. QLoRA speichert die eingefrorenen Basisgewichte zusätzlich in 4-Bit-Form und dequantisiert sie für die Berechnung; dadurch wird nicht der gesamte Trainingsspeicher zu 4-Bit-Speicher. Der Fine-Tuning-Leitfaden vergleicht die praktischen Möglichkeiten.
Optionale ausführliche Gleichungsanalysen
Die verlinkten Gleichungsanalysen enthalten Symboldefinitionen, Zwischenschritte der Herleitungen und Prüfungen mit kleinen Zahlen. Sie wurden mit den Coding-Agent-Anweisungen aus paper-math-skills erstellt. Es sind ergänzende Erklärungen; die bei jedem Mechanismus verlinkten Paper sind die Primärquellen.
Quellen und Versionen
Die Paper-Links oben nennen die Versionen, auf die sich die Abschnitts- und Gleichungsnummern beziehen. Für die ursprüngliche Attention als Vergleich siehe Attention Is All You Need v7, §3.2 und §3.5. Für das separate Thema der Residualmischung siehe mHC v2.