Cómo leer ecuaciones de arquitecturas: RoPE, MLA, MoE y LoRA

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Este artículo explica qué cambian seis métodos de arquitectura de modelos: dónde obtiene la atención la información de posición, qué conserva en memoria, qué tokens o expertos usa y qué pesos actualiza el fine-tuning. Está dirigido a ingenieros que conocen el esquema de un Transformer pero quieren entender RoPE, MLA, la atención dispersa, Gated DeltaNet, MoE y LoRA sin trabajar las derivaciones de cada artículo. Los diagramas comparan los mecanismos; las ecuaciones explican el cambio principal.
Un token entra en el modelo como un vector numérico llamado embedding. Cada capa actualiza esa representación. En la atención, tres multiplicaciones matriciales aprendidas, o proyecciones, convierten los vectores de tokens entrantes en consultas (), claves () y valores (). Las etiquetas , y del diagrama nombran esas matrices aprendidas.
Una capa de atención compara consultas con claves para decidir qué peso dar al valor de cada token. Para una cabeza, el cálculo es:
Lee las operaciones en orden: compara cada consulta con cada clave; transpone la matriz de claves para disponer los vectores de forma adecuada para la multiplicación. Divide entre la raíz cuadrada de su longitud y aplica softmax a cada fila para obtener pesos. Multiplicar por promedia los valores con esos pesos. El resultado es un vector actualizado para cada token, que se pasa al resto de la capa. En un modelo de lenguaje causal, la atención excluye los tokens futuros antes de softmax. La Parte 1 desarrolla ese cálculo con matrices pequeñas.
Las cuatro primeras secciones cambian este cálculo o su memoria. MoE cambia la red feed-forward, y LoRA cambia cómo se entrenan los pesos. Puedes leer las secciones por separado; el diagrama de MLA usa el mecanismo de posición presentado en RoPE.
RoPE: la posición como rotación
Un producto escalar entre consulta y clave compara vectores de contenido. Por sí solo, no dice si dos tokens son adyacentes o están separados por cien posiciones. El Transformer original añade un vector de posición a cada embedding de token antes de la primera capa de atención. La información de posición influye entonces en las consultas, claves y valores calculados a partir de esas entradas. No los rota. Véase Attention Is All You Need, §3.5.
RoPE introduce la posición en la propia comparación entre consulta y clave. Primero calcula las consultas y las claves con las proyecciones aprendidas habituales. Después rota pares de sus coordenadas según ángulos determinados por la posición de cada token. Calcula las puntuaciones de atención a partir de esos vectores rotados. RoPE no rota los valores.
Los dos paneles siguientes muestran dónde entra la posición. En ambos casos, el cálculo de los valores ponderados sigue al cálculo de las puntuaciones.
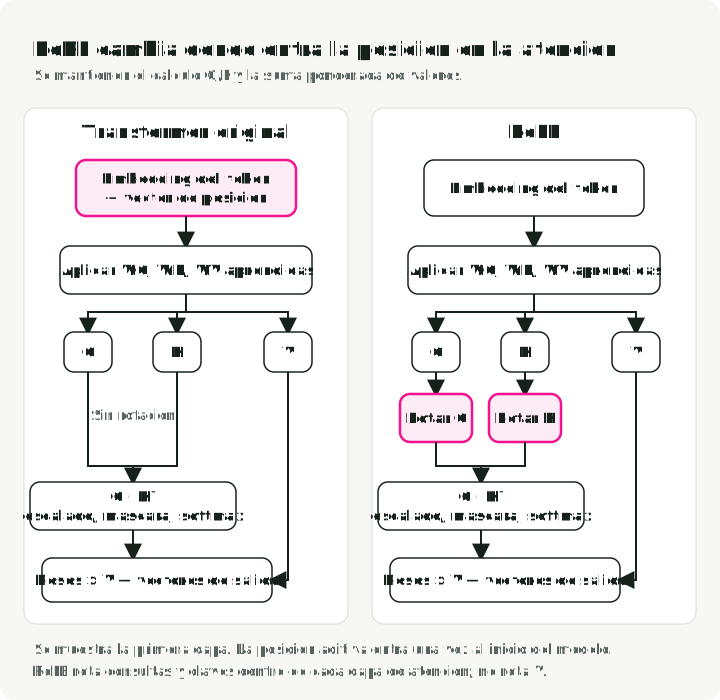
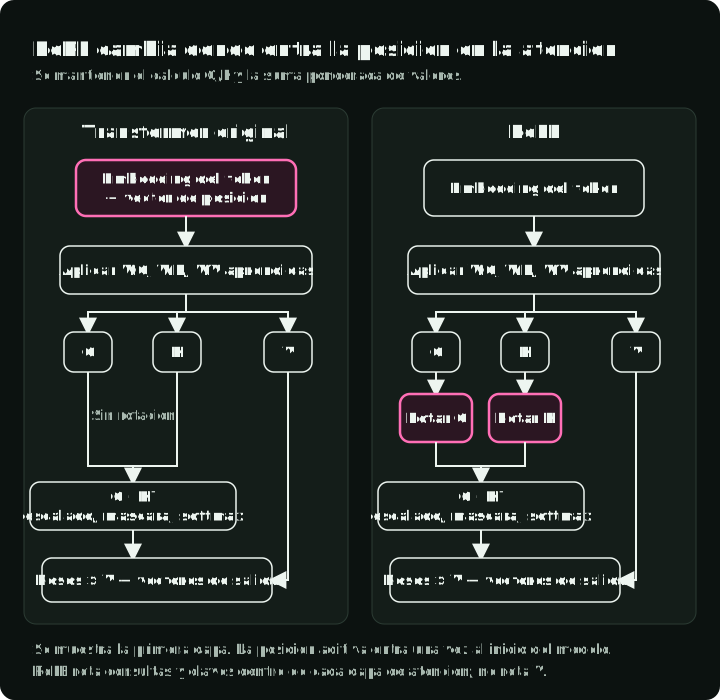
Para un par de coordenadas, la rotación es una multiplicación matricial:
es el ángulo de rotación. Multiplicar esta matriz por da ; a 90° es , la flecha de consulta que apunta hacia arriba en el siguiente diagrama.
¿Por qué una rotación? Un producto escalar depende del ángulo entre vectores. Rotar ambos vectores el mismo ángulo adicional deja su producto escalar sin cambios. Si una consulta en la posición 2 y una clave en la posición 3 pasan a las posiciones 3 y 4, su diferencia de posiciones sigue siendo uno. Con los mismos vectores de contenido subyacentes, RoPE da la misma puntuación:
Aquí y son un par de coordenadas de consulta y de clave, respectivamente, los rota, y son posiciones de tokens y es el ángulo de rotación por posición. El lado derecho muestra la propiedad útil: el término explícito de posición usa la diferencia . La puntuación sigue dependiendo de los vectores de contenido, no solo de la distancia.
El diagrama fija ambos vectores originales en y usa una rotación de 45° por posición. Son valores elegidos para el ejemplo: mantener fijo el contenido permite ver el efecto de desplazar ambas posiciones.
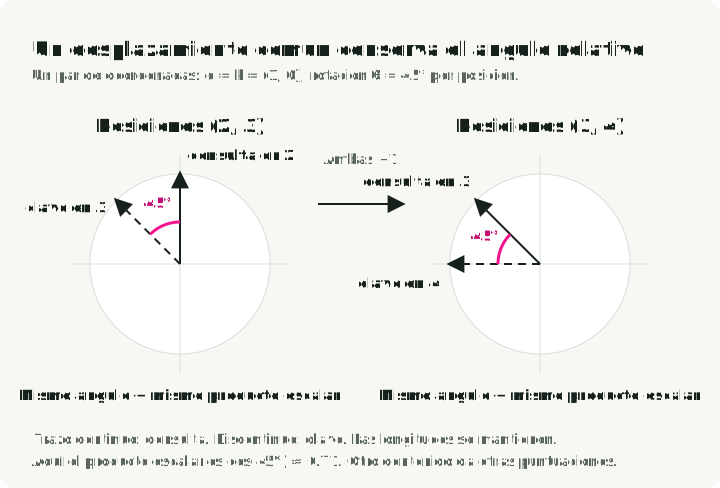
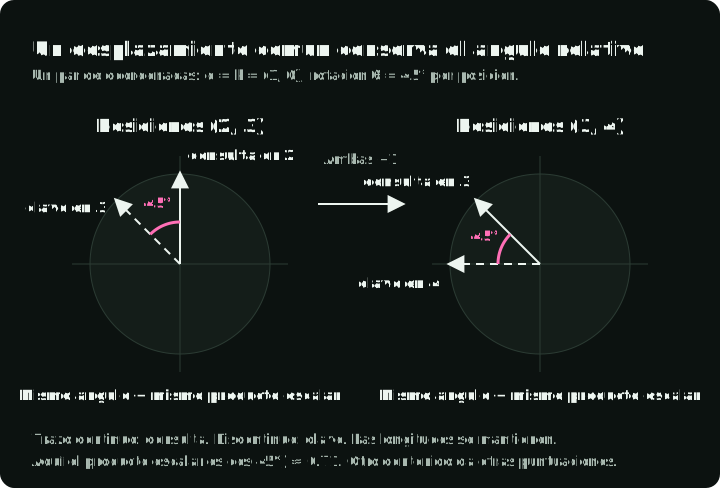
Una consulta o clave completa tiene muchos pares de coordenadas. RoPE los rota a distintas velocidades para representar diferencias de posición a varias escalas. Eso no garantiza una buena atención a cualquier longitud de contexto ni que todas las puntuaciones disminuyan con la distancia.
Las matrices de rotación y su derivación están en RoFormer v5, §3.2, ecuaciones (12)–(16). La lectura detallada de RoPE incluye los pasos algebraicos intermedios y las comprobaciones numéricas.
MLA: guardar en caché un vector pequeño en lugar de claves y valores
Las cabezas de atención existían antes de MLA. La atención multicabezal del Transformer original, §3.2.2, realiza varios cálculos de atención con distintas proyecciones aprendidas y combina sus salidas. DeepSeek conserva varias cabezas. Su cambio es cómo representa y almacena en caché sus claves y valores.
Durante la generación, la atención multicabezal ordinaria guarda una clave y un valor para cada token anterior por cada cabeza. Esta KV cache crece con la secuencia. MLA usa, en cambio, una proyección aprendida para convertir la representación entrante del token directamente en un vector corto. A partir de él se pueden calcular las claves de contenido y los valores de las cabezas. Todas comparten ese vector almacenado, pero usan distintas proyecciones y pesos de atención; no se convierten en cabezas idénticas.
El diagrama sigue un token desde su vector entrante hasta sus datos almacenados en una capa. En ambos lados, las consultas posteriores leen esos datos mediante varias cabezas; sus salidas se combinan en la salida de atención.
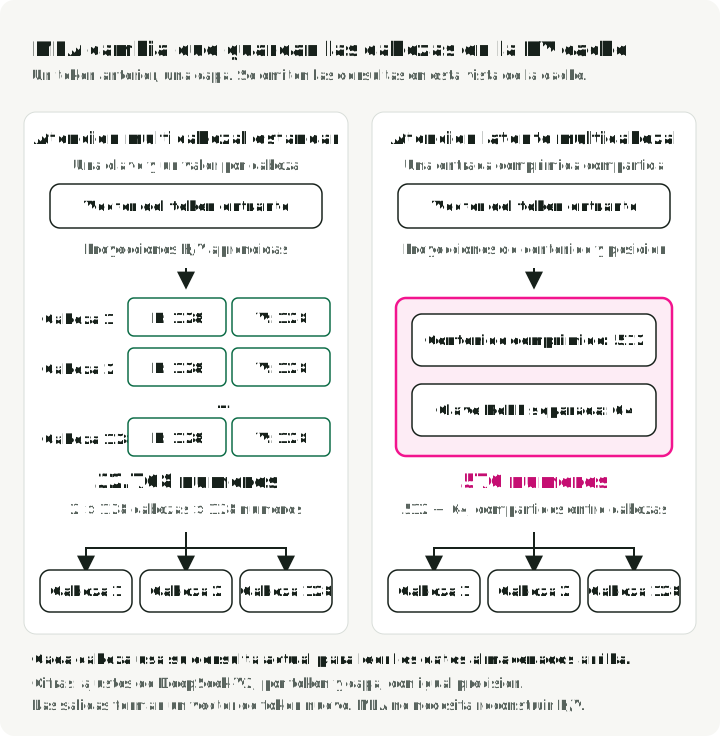
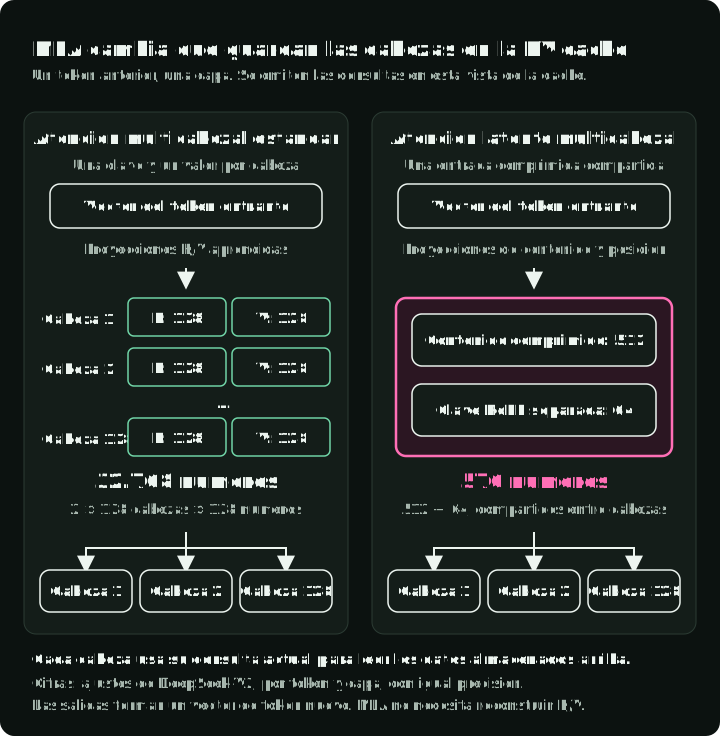
El cálculo del contenido en el diagrama corresponde a tres ecuaciones de DeepSeek-V2:
es el vector entrante del token . La primera línea lo transforma en el vector más corto , almacenado en caché. Las dos siguientes transforman ese mismo vector en claves de contenido y valores para todas las cabezas. Los superíndices son etiquetas, no potencias: nombra la proyección reductora, y las proyecciones expansoras de claves y valores, y marca la parte de contenido. Las tres matrices son aprendidas. La clave de posición separada queda fuera de estas tres ecuaciones.
Para la configuración de DeepSeek-V2, la comparación es 32.768 números frente a 576: la atención ordinaria con 128 cabezas y 128 números por clave y valor necesita ; MLA conserva un vector comprimido de 512 números y una clave de posición de 64 números. Son unas 57 veces menos números almacenados con la misma precisión. Se compara esta configuración con la atención multicabezal ordinaria, no con cualquier diseño de caché, y no implica una inferencia 57 veces más rápida.
¿Expandir el vector comprimido para cada token antiguo eliminaría la ventaja? MLA puede evitar esa expansión. Para una cabeza, abrevia como y llama a las filas de de esa cabeza su matriz de expansión de claves . Entonces:
El lado izquierdo expande cada vector almacenado en caché a una clave antes de compararlo con la consulta . El lado derecho transforma la consulta actual una vez y después la compara directamente con los vectores almacenados. Es el mismo cálculo agrupado de otra manera. El cálculo de los valores tiene una reorganización similar: primero se promedian los vectores comprimidos y después se aplican las proyecciones de salida. Una implementación puede elegir el orden de multiplicación adecuado para su hardware.
RoPE necesita un tratamiento separado. Rotar las claves de contenido expandidas introduciría una operación dependiente de la posición en esa reorganización. Por eso MLA deja esas claves sin rotar y añade una comparación consulta-clave separada para la posición. De ahí que la caché contenga tanto el vector de contenido comprimido como una pequeña clave de posición rotada.
MLA es una arquitectura aprendida, no un compresor sin pérdidas que pueda aplicarse a cualquier capa de atención existente. DeepSeek-V2 v5, §2.1.2–2.1.3, ecuaciones (9)–(19) define las proyecciones y el componente RoPE separado. La lectura detallada de MLA aporta todas las formas y reorganizaciones matriciales.
Atención dispersa (DSA): un evaluador barato elige las claves
DSA reduce cuántos tokens participan en cada cálculo de atención. Supón que un modelo continúa el texto «The cat sat on a mat near me». Para este ejemplo, trata cada palabra como un token. El modelo está procesando el último token, «me», en la posición 8.
Dentro de una capa de atención, la representación del token actual produce un vector de consulta. Cada token disponible tiene una clave, con la que se compara la consulta, y un valor, que aporta información a la salida. Durante la generación, la capa guarda los datos de atención de los tokens anteriores en su KV cache para reutilizar esos vectores. «Posición 2» identifica los datos almacenados de «cat»; la caché contiene vectores numéricos, no solo números de posición. MLA almacena estos datos en la forma comprimida descrita antes.
La atención causal densa compara la consulta actual con todas las claves disponibles, incluida la del token actual. Softmax convierte esas puntuaciones en pesos, y la capa combina los valores con esos pesos. DSA añade un paso de selección más barato antes de ese cálculo:
- Puntuar los tokens disponibles con poco coste. Una pequeña red aprendida, el lightning indexer, usa sus propias proyecciones de consulta y clave para puntuar cada posición para el token actual. Estima qué tokens usará más la atención principal.
- Seleccionar las posiciones con mayor puntuación. En el ejemplo, «cat» y «mat» reciben las dos mayores puntuaciones del índice. Seleccionar las posiciones 2 y 6 indica a la atención principal qué entradas almacenadas debe leer.
- Calcular la atención sobre esas entradas. La atención principal calcula sus propias puntuaciones consulta-clave para las entradas seleccionadas, aplica softmax sobre ese subconjunto y combina sus valores. Las puntuaciones del indexador eligen las entradas; no son los pesos finales de atención.
Sigue una columna desde el token de texto hasta su entrada almacenada y compara los cálculos denso y disperso. Todas las puntuaciones y pesos siguientes son ilustrativos.
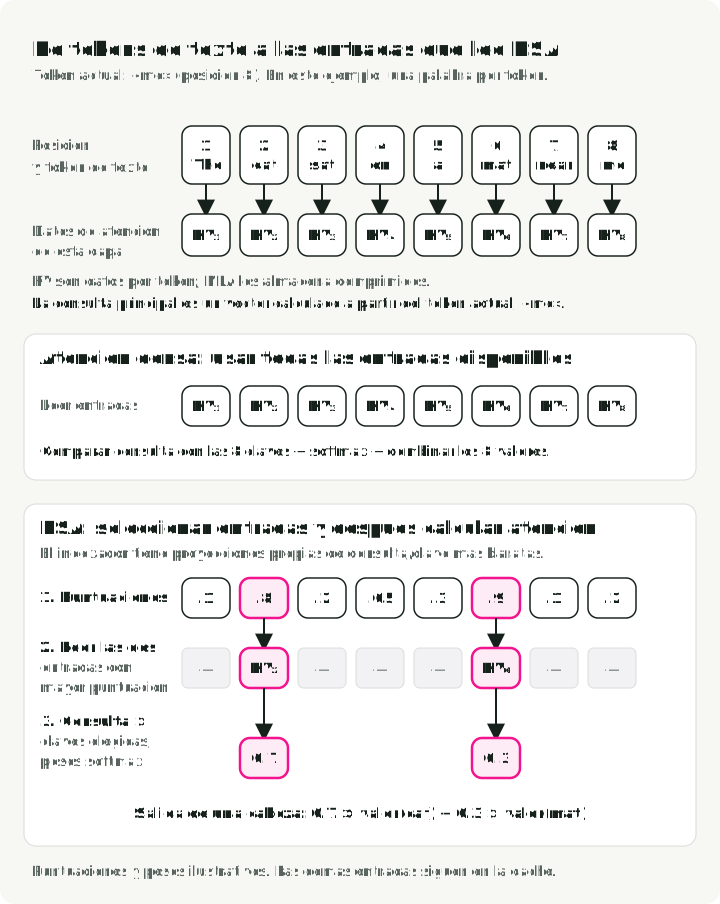
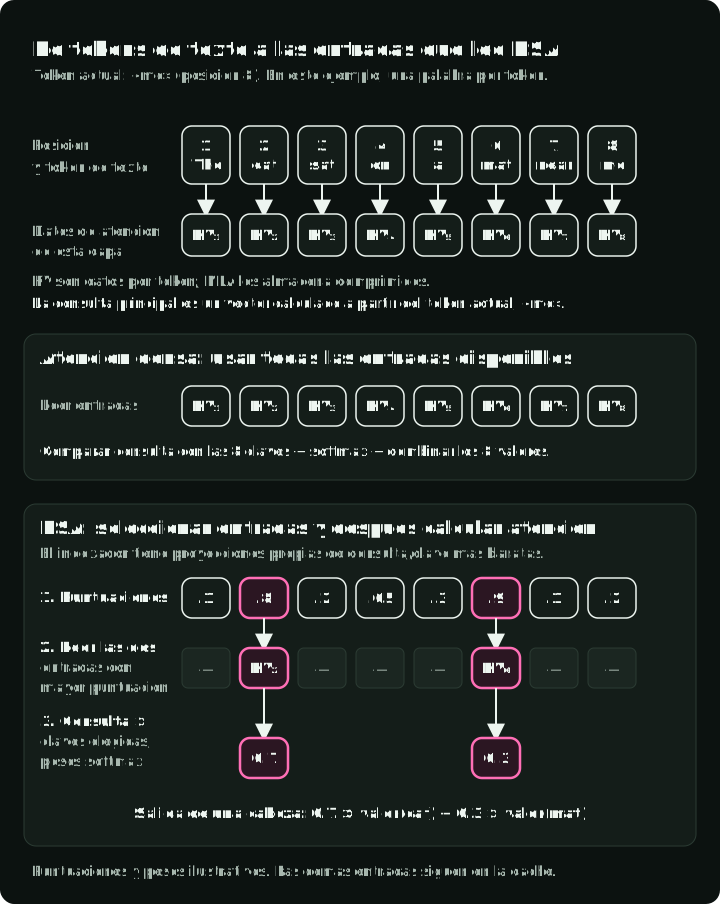
La ecuación del indexador del artículo da la primera fila de puntuaciones del panel de DSA:
es la posición actual y una posición candidata. El superíndice etiqueta los vectores propios del indexador. Para cada una de sus cabezas, compara la consulta con la clave , sustituye un producto escalar negativo por cero mediante ReLU, multiplica por el peso aprendido dependiente del token y suma sobre las cabezas . El resultado es una puntuación de selección.
Podemos escribir la selección y la salida de una cabeza de la atención principal como:
es la fila de puntuaciones para las posiciones disponibles de 1 a . TopKIndices devuelve las posiciones de las puntuaciones más altas, hasta entradas. La suma se lee «sumar los valores ponderados solo para las posiciones de ». Aquí es un peso softmax de la atención principal recién calculado, su vector de valor y la salida. En la figura, y . Esto reescribe la notación de entradas seleccionadas del artículo como una suma explícita; MLA puede calcularla en forma comprimida.
Las demás entradas permanecen en la caché. Otra consulta puede seleccionar otro subconjunto. El entrenamiento enseña al indexador a aproximar la distribución de la atención principal sobre los tokens, primero con atención densa y después junto con la atención dispersa. Una mala selección puede omitir información útil.
DeepSeek-V3.2 aplica DSA a la caché comprimida de MLA y selecciona hasta 2.048 posiciones por consulta. En la última posición de un contexto de 131.072 tokens, la atención principal lee una entrada de cada 64. Cuando hay menos de 2.048 posiciones disponibles, puede usarlas todas.
El ahorro viene de hacer menos comparaciones de atención costosas. El indexador sigue puntuando todas las posiciones disponibles, pero usa menos cabezas y puede calcular en FP8. A lo largo de una secuencia de longitud , las comparaciones de la atención principal pasan de aproximadamente a , donde es la cantidad seleccionada. El trabajo del indexador sobre todos los pares sigue siendo cuadrático, así que el método completo no es estrictamente lineal en la longitud de la secuencia.
Las ecuaciones de puntuación y entrenamiento están en DeepSeek-V3.2 v1, §2.1, ecuaciones (1)–(4) y en la lectura detallada de DSA.
Gated DeltaNet: una memoria de tamaño fijo que sobrescribe
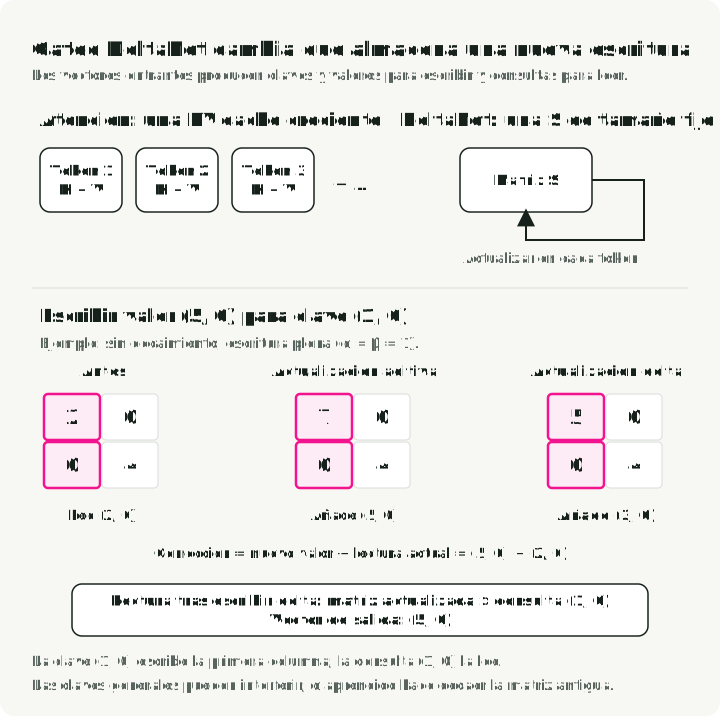
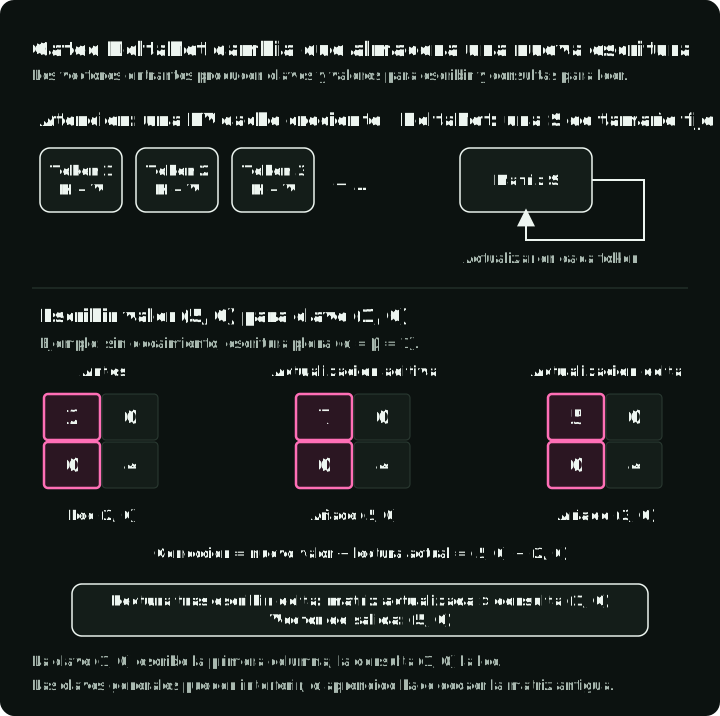
La atención densa, MLA y DSA conservan un registro creciente de tokens anteriores. Gated DeltaNet actualiza, en cambio, una sola matriz de tamaño fijo. La capa calcula una clave, un valor y una consulta a partir de las representaciones de tokens entrantes, mediante proyecciones aprendidas y filtros cortos sobre tokens cercanos. La clave y el valor actualizan la matriz; la consulta lee la matriz actualizada para producir un vector de salida. No puede volver a consultar por separado la clave y el valor de cada token antiguo.
La comparación útil es con una memoria aditiva sencilla. Supón que la memoria devuelve ahora 2 para una clave concreta, y el siguiente token aporta el valor 5 para esa misma clave. Añadir el nuevo valor produciría 7. Una actualización delta añade la corrección, , de modo que una escritura a plena intensidad produce 5.
El ejemplo usa la clave , que lee la primera columna de la matriz: una vez la primera columna más cero veces la segunda. La columna resaltada muestra la corrección. Tras la escritura, una consulta lee de ella. La matriz mantiene el mismo tamaño.
Gated DeltaNet también aprende cuánto conservar de la memoria antigua y con qué intensidad aplicar cada corrección:
es la matriz de memoria, la clave actual de longitud uno y su nuevo valor. El factor hace decaer la memoria antigua. Leer la memoria tras ese decaimiento con da su respuesta actual; restar esa respuesta de da la corrección. El factor controla cuánto escribir. Ambos factores se calculan a partir del token actual. Multiplicar la matriz actualizada por la consulta da el vector leído, que la capa normaliza, pondera mediante una compuerta y proyecta a su salida. El ejemplo de 2 a 5 usa el valor límite de 1 para ambos factores.
La memoria fija ahorra espacio, pero las escrituras pueden interferir: cambiar la respuesta para una clave puede cambiarla para otra clave no ortogonal. El decaimiento también elimina información antigua. Esto ayuda a explicar por qué el artículo combina capas recurrentes con atención de ventana deslizante en modelos híbridos, conservando entradas separadas para los tokens recientes.
La forma mostrada reorganiza Gated Delta Networks v3, §3.1, ecuación (10). La lectura detallada la deriva y desarrolla la actualización matricial.
Enrutamiento MoE: el sesgo elige expertos y la puntuación los pondera
Una capa de mezcla de expertos (MoE) tiene varias redes feed-forward, llamadas expertos, y selecciona solo algunas para cada token. Esto añade capacidad al modelo sin ejecutar todos los expertos para cada entrada. Cambia la parte feed-forward de un Transformer, no sus cabezas de atención.
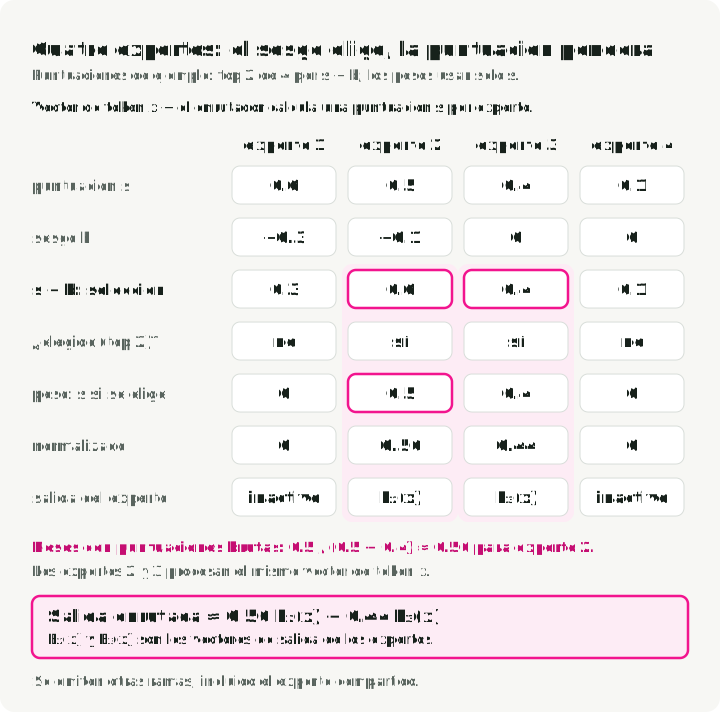
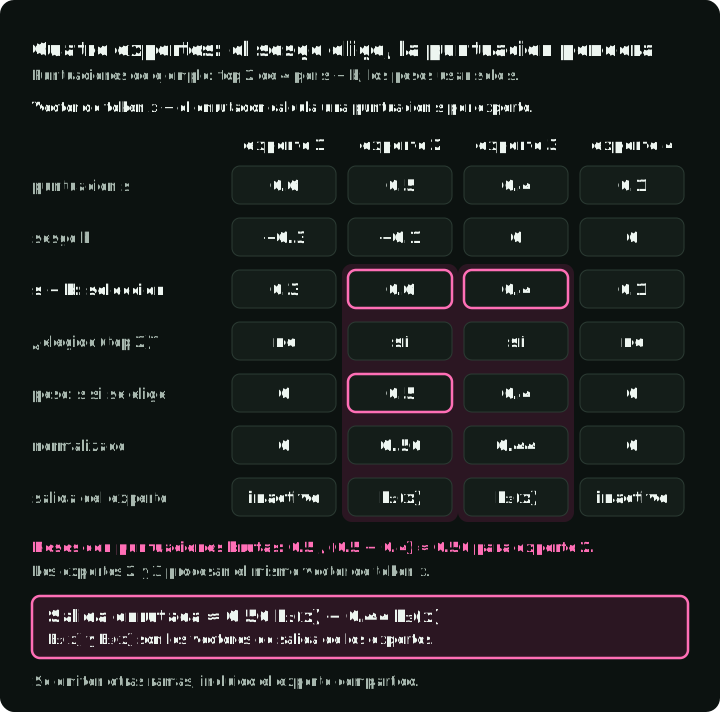
La regla concreta de enrutamiento de DeepSeek-V3 separa dos decisiones: qué expertos se ejecutan y cuánto cuentan sus salidas. Un enrutador aprendido recibe el vector del token actual y da a cada experto una puntuación . Un sesgo de equilibrio de carga cambia la puntuación de selección a . Tras seleccionar, los pesos de salida proceden de las puntuaciones originales, normalizadas sobre los expertos seleccionados. El sesgo no interviene en esos pesos.
El ejemplo selecciona dos de cuatro expertos. El experto 1 tiene la mayor puntuación bruta, pero su sesgo negativo lo excluye; en su lugar se ejecutan los expertos 2 y 3. Ambos reciben el mismo vector de token . Cada uno produce un vector nuevo, escrito o , y la capa suma esas salidas con pesos 0.56 y 0.44. El diagrama muestra solo esta contribución de los expertos enrutados.
Una forma compacta de la regla de enrutamiento de DeepSeek-V3, para un token, es:
y reúnen las puntuaciones y sesgos de todos los expertos; es la cantidad que se selecciona. La primera línea devuelve los índices de los expertos seleccionados . La llave de la segunda línea es un if/else: dividir la puntuación original de un experto seleccionado entre la suma de las puntuaciones seleccionadas, o asignar cero si no se seleccionó. La última línea suma los vectores de salida de los expertos con esos pesos. En la figura, , así que y . El sesgo aparece solo en la selección. Las contribuciones residuales y del experto compartido quedan fuera de .
Durante el entrenamiento, baja el sesgo de un experto usado en exceso y sube el de uno poco usado. Esto favorece una carga más uniforme. DeepSeek-V3 también conserva una pequeña pérdida de equilibrio por secuencia, así que «auxiliary-loss-free» no significa que el modelo carezca por completo de una pérdida de equilibrio.
Su configuración activa 8 de 256 expertos enrutados por token, más un experto compartido que siempre se ejecuta. Esas cantidades y el experto compartido pertenecen a este modelo, no a la definición de MoE. Véanse DeepSeek-V3 v2, §2.1.2, ecuaciones (12)–(17) y la lectura del enrutamiento.
mHC: mezcla residual restringida a medias ponderadas
Una conexión residual ordinaria lleva un vector de token más allá de una subcapa y le suma el resultado de esta. mHC mantiene varios de esos vectores, llamados flujos residuales, y cambia cómo se mezclan entre capas. Su matriz de mezcla ideal tiene entradas no negativas con filas y columnas que suman uno. Esa mezcla forma medias ponderadas y conserva el total entre los flujos. La implementación aproxima esta restricción con un número finito de pasos de normalización; no restringe todas las operaciones de la red.
El artículo específico sobre mHC explica el mecanismo, la normalización y los límites con diagramas. Úsalo para ese tema; la lectura de la ecuación aporta la derivación.
LoRA: una actualización de rango bajo junto a un peso congelado
El fine-tuning completo actualiza las matrices de pesos del modelo. LoRA congela una matriz preentrenada y aprende una corrección más pequeña en paralelo:
es el vector de token que entra en la capa lineal elegida, y es el vector de salida que se pasa al resto del modelo. La multiplicación original sigue ejecutándose. En la corrección, transforma la entrada en un vector mucho más pequeño y lo devuelve al tamaño de la salida. Los ejemplos de entrenamiento y la pérdida de la tarea determinan las actualizaciones de y ; permanece fijo. Su pequeña dimensión compartida es el ajuste de rango ; la actualización resultante tiene rango como máximo.
Para una matriz de pesos y , una actualización completa tiene unos 16,8 millones de entradas. Las dos matrices LoRA tienen : 256 veces menos entradas entrenables para esta matriz. Esto reduce el almacenamiento de gradientes y estados del optimizador, pero el peso base completo sigue ocupando memoria y participando en el cálculo.
Sigue los dos cálculos desde la misma entrada: la matriz congelada sigue calculando su salida, mientras que la corrección entrenable pasa por solo ocho números.
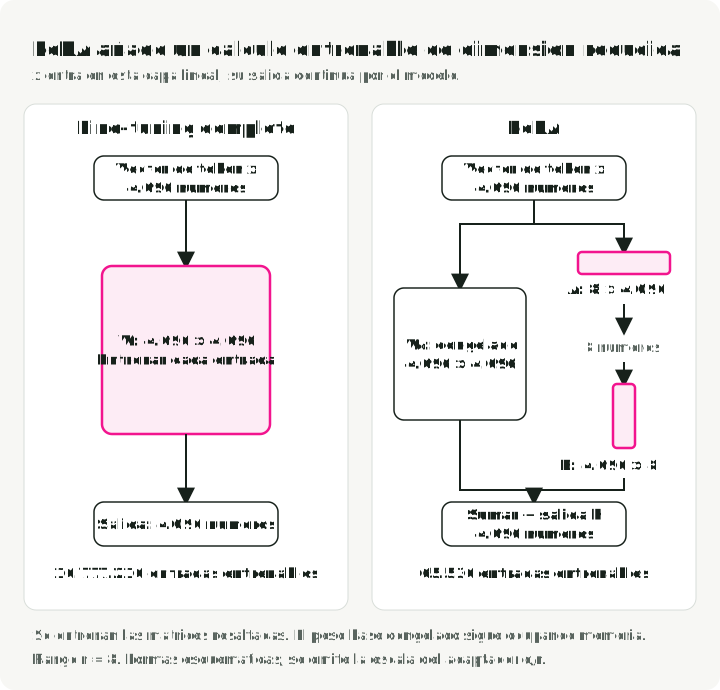
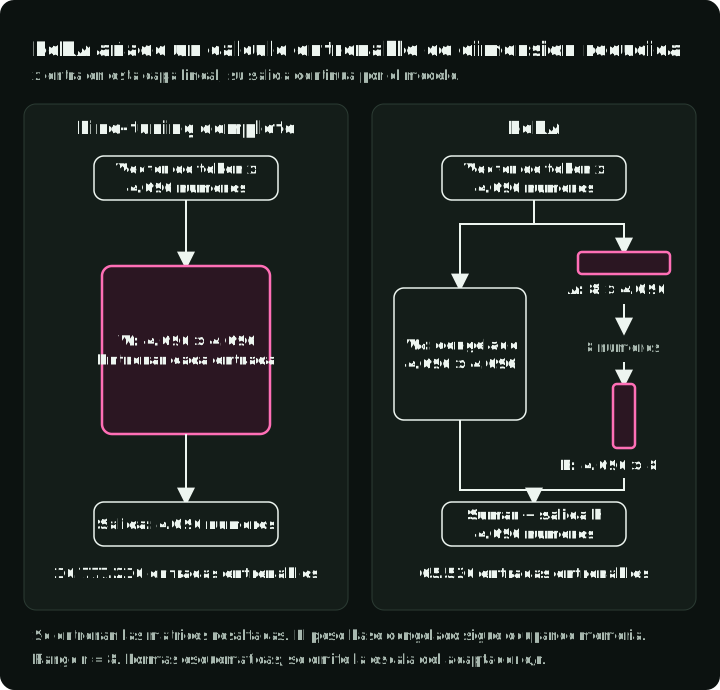
En el método original, empieza en cero para que la corrección no cambie nada al principio. El artículo escala la actualización por , un ajuste omitido en su ecuación (3) mostrada arriba. Tras el entrenamiento, la corrección escalada se puede sumar a ; la capa fusionada solo necesita entonces la multiplicación matricial original. Mantener los adaptadores separados añade cálculo, pero permite intercambiarlos.
Véanse LoRA v2, §4.1, ecuación (3) y la lectura detallada de LoRA. QLoRA también almacena los pesos base congelados en formato de 4 bits y los descuantiza para calcular; no convierte toda la memoria de entrenamiento a 4 bits. La guía de fine-tuning compara las opciones prácticas.
Recorridos opcionales de las ecuaciones
Las lecturas de ecuaciones enlazadas contienen definiciones de símbolos, derivaciones intermedias y comprobaciones con números pequeños. Se produjeron con las instrucciones para agentes de programación de paper-math-skills. Son explicaciones complementarias; los artículos enlazados junto a cada mecanismo son las fuentes primarias.
Fuentes y versiones
Los enlaces anteriores identifican las versiones usadas para los números de sección y ecuación. Para la atención original de referencia, véase Attention Is All You Need v7, §3.2 y §3.5. Para el tema separado de la mezcla residual, véase mHC v2.