Как читать целевые функции: дистилляция, DPO и GRPO

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Дистилляция, Direct Preference Optimization (DPO) и Group Relative Policy Optimization (GRPO) меняют вероятности языковой модели, но используют разные обучающие примеры и обратную связь. Это руководство для инженеров, которые хотят понять эти различия, прежде чем читать полные целевые функции. Схемы показывают, откуда берётся обратная связь и как она меняет сравнения вероятностей; уравнения задают соответствующие операции.
При обычном файн-тюнинге с учителем модель учится предсказывать следующий токен в сохранённых примерах. Методы ниже меняют обратную связь: учитель предоставляет вероятности, пара предпочтений указывает, какой ответ лучше, а награда оценивает ответы, сэмплированные во время обучения. Политика — это просто модель, которая генерирует ответы. Все логарифмы ниже натуральные.
Часть 1 объясняет, как читать уравнения, и содержит справочник обозначений. Здесь каждый раздел объясняет нужные ему термины, и его можно читать отдельно.
Классическая дистилляция: температура в обоих softmax
Обучающая метка указывает правильный результат: при предсказании следующего токена это следующий токен в сохранённом примере. Модель-учитель даёт больше информации: вероятности всех токенов-кандидатов, включая правдоподобные альтернативы. Дистилляция обучает меньшую модель-ученика воспроизводить эти вероятности. Обучение уменьшает численное значение функции потерь, меняя параметры ученика; параметры учителя остаются фиксированными.
В статье о дистилляции Хинтона и соавторов, §2, распределения обеих моделей сглаживают перед сравнением. Разделим каждый логит — исходную оценку до softmax — на температуру :
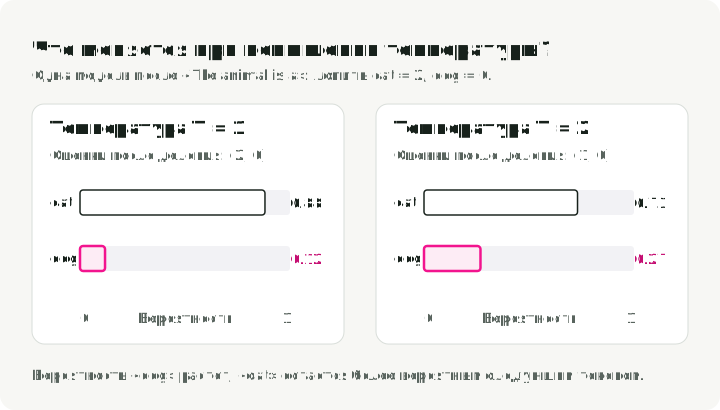
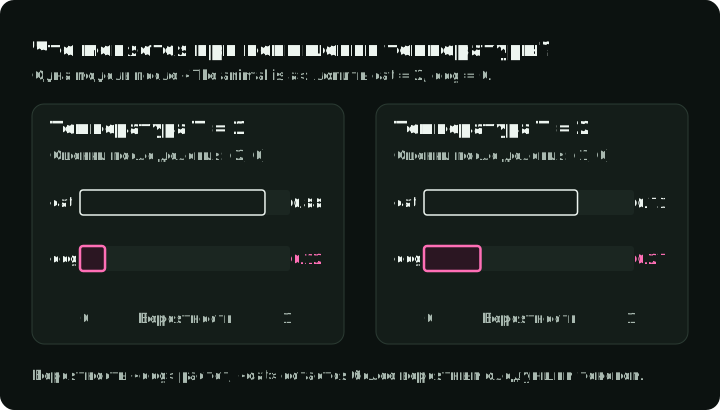
Здесь — оценка кандидата , а — его вероятность. Допустим, у упрощённой модели есть только два возможных следующих токена, «cat» и «dog», и после «The animal is a» она присваивает им оценки . При вероятности равны примерно ; при они становятся . Меньшая оценка теперь сильнее влияет на сравнение. Учитель и ученик используют одинаковую температуру.
Столбцы показывают, как при повышении температуры те же две оценки дают менее концентрированное распределение.
Функция потерь объединяет обычную потерю по метке с потерей за несовпадение со сглаженным распределением учителя. Обозначим вероятности учителя через , а ученика через при температуре . Для одного входа с меткой:
Здесь — потеря, — правильный следующий токен, а задаёт пропорции смеси. Верхние индексы в скобках обозначают температуры, а не степени. Первый член читается как «штрафовать низкую вероятность правильного токена при ». Второй — как «воспроизводить сглаженные вероятности учителя». Обучение усредняет эти потери по сохранённым входам и меняет только ученика.
— KL-дивергенция от учителя к ученику . Она измеряет различие двух распределений вероятностей: при совпадении равна нулю. Первое распределение задаёт веса сравнения, поэтому вероятные по оценке учителя результаты получают больший вес. Хинтон и соавторы описывают член сопоставления через кросс-энтропию; эта форма KL вычитает константу, зависящую только от учителя, и даёт те же градиенты ученика.
Множитель приблизительно компенсирует уменьшение градиентов при повышении температуры. Это настройка обучения; при использовании обученного ученика для этого softmax обычно возвращают .
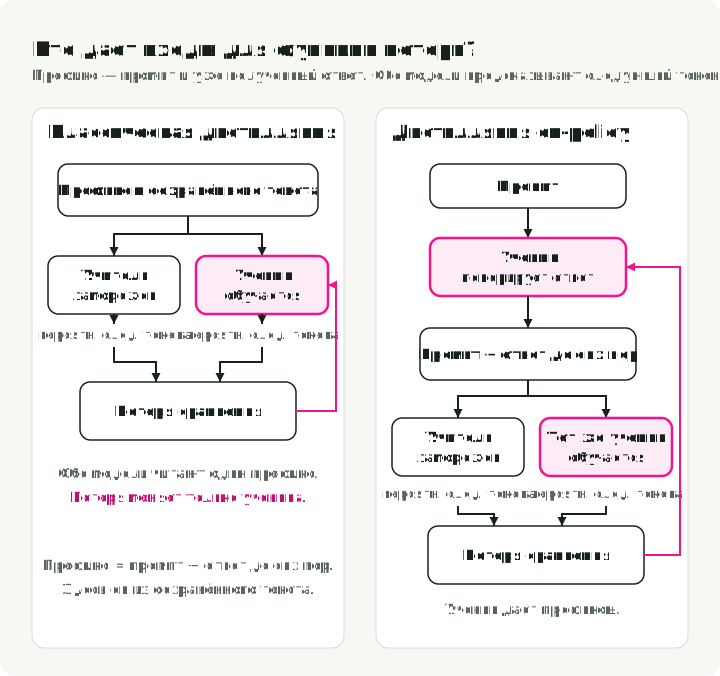
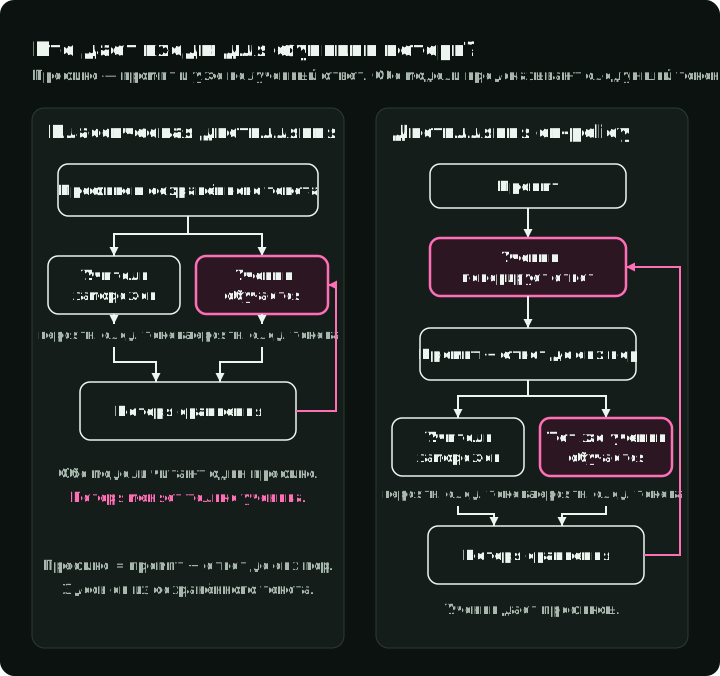
Префикс — текст, доступный перед следующим токеном: промпт и уже полученные токены ответа. Например, «The animal is a» — префикс перед «cat». На рисунке обе модели читают один префикс и выдают вероятности следующего токена. Слева префиксы берутся из сохранённых примеров. Справа — из ответов, которые ученик генерирует при обучении. В обоих случаях потеря сравнения обновляет только ученика.
Бывает и дистилляция без сопоставления вероятностей. Дистиллированные модели DeepSeek-R1, §2.4, прошли файн-тюнинг на 800 000 примеров, заранее отобранных с помощью DeepSeek-R1. Они использовали функцию потерь с учителем на сохранённом тексте; запускать модель-учителя во время такого обучения не требовалось.
Подробный разбор дистилляции объясняет смешанную функцию потерь и масштабирование температурой.
Дистилляция on-policy: ученик стоит первым в KL
Ученик, генерирующий собственный ответ, может получить префиксы — промпт и уже сгенерированную часть ответа, — которых никогда не было в обучающем датасете. Дистилляция on-policy получает обратную связь на текст, который ученик действительно создаёт. Получив промпт, ученик сэмплирует ответ. Замороженный учитель затем оценивает те же префиксы, так что обучение сравнивает модели там, где ученику нужна помощь.
On-policy описывает этот источник обучающего текста. Сам по себе термин не задаёт конкретную функцию потерь. Здесь в примерах используется обратная KL, в которой ученик стоит первым:
Для фиксированного промпта обозначение задаёт ученика с обучаемыми параметрами , — учителя, а — ответ, сэмплированный из ученика. Выражение сравнивает вероятность, которую ученик присвоил своему ответу, с вероятностью учителя. При усреднении по ответам ученика оно штрафует высокую вероятность текста, который учитель считает маловероятным.
Это отличается от требования охватить все результаты, которые мог бы выдать учитель. Если маленький ученик не может воспроизвести полное распределение учителя, обратная KL может способствовать концентрации на части его вероятных ответов. MiniLLM, §2.1, уравнение (1), использует эту целевую функцию. Реальная процедура обучения также добавляет сэмплы учителя в генерацию и корректирует градиент, чтобы снизить дисперсию и смещение по длине; схема показывает базовую конфигурацию on-policy, а не все изменения MiniLLM.
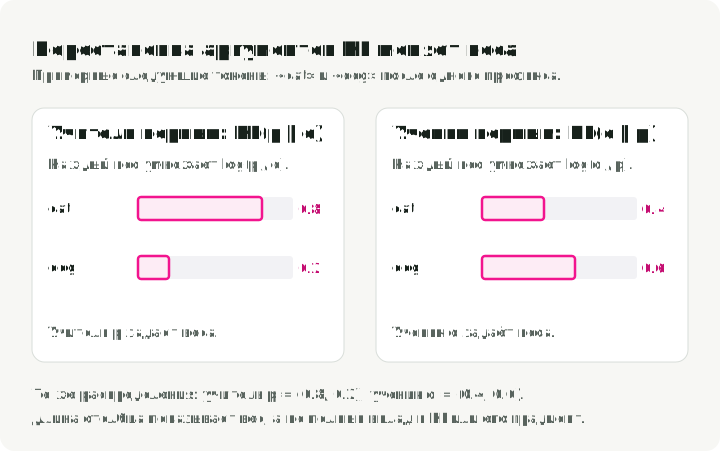
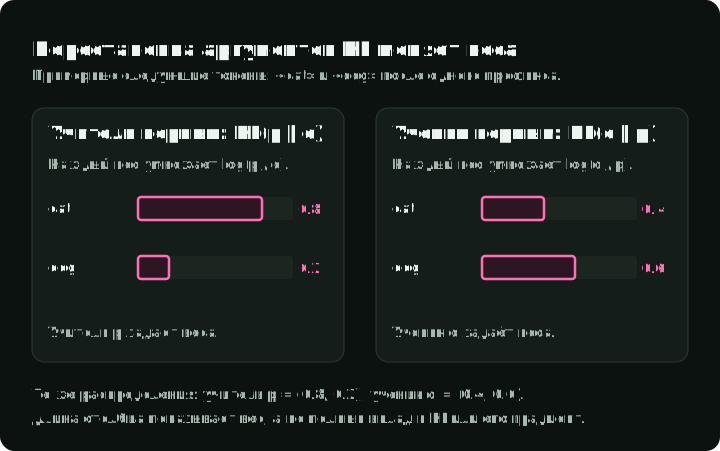
В упрощённом примере ниже учитель и ученик присваивают разные вероятности «cat» и «dog» после одного префикса. KL умножает логарифм отношения для каждого токена на его вес, а затем складывает два члена. При смене первого аргумента больший вес переходит от «cat» к «dog». Столбцы показывают веса, а не полные вклады в потерю.
От KL последовательности к KL токенов
Вероятность ответа вычисляется из вероятностей его следующих токенов. На каждом префиксе ответа ученика обе модели предсказывают следующий токен. Поэтому их различия можно сравнивать по позициям, а затем суммировать по ответу. DeepSeek-V4, §5.1.2, уравнение (29), использует дистилляцию с обратной KL от нескольких специализированных моделей-учителей в одного ученика. Эти учителя — отдельные модели, а не экспертные подсети внутри слоя mixture-of-experts.
В позиции пусть — вероятность токена-кандидата по оценке ученика. Префикс содержит промпт и предыдущие токены ответа ; — вероятность учителя на том же префиксе. Тогда:
— словарь, а — KL следующего токена на одном префиксе. Внутренняя сумма читается как «сравнить каждый токен-кандидат с весом, равным вероятности ученика». Сложите эти сравнения по позициям, затем усредните по ответам, которые генерирует ученик. Внешнее математическое ожидание по-прежнему использует сэмплирование текста, даже когда каждое суммирует весь словарь.
Один сэмплированный токен или весь словарь
Учитель может оценить только выбранный учеником токен или вернуть вероятности для всего словаря. Первый вариант передаёт меньше информации; второй сравнивает все возможные следующие токены на данном префиксе. DeepSeek-V4 сообщает о нестабильном обучении с оценкой по одному токену и использует сравнение по всему словарю. Это делает сравнение токенов точным на данном префиксе; сами префиксы по-прежнему берутся из сэмплированных ответов.
Обе модели читают «The animal is a» и возвращают вероятности, показанные ниже. Выделенные строки входят в функцию потерь для обновления ученика. Вариант с полным словарём включает «dog» и «fox», хотя ученик выбрал «cat»; вариант с одним токеном оценивает это сравнение только по выбранному токену.
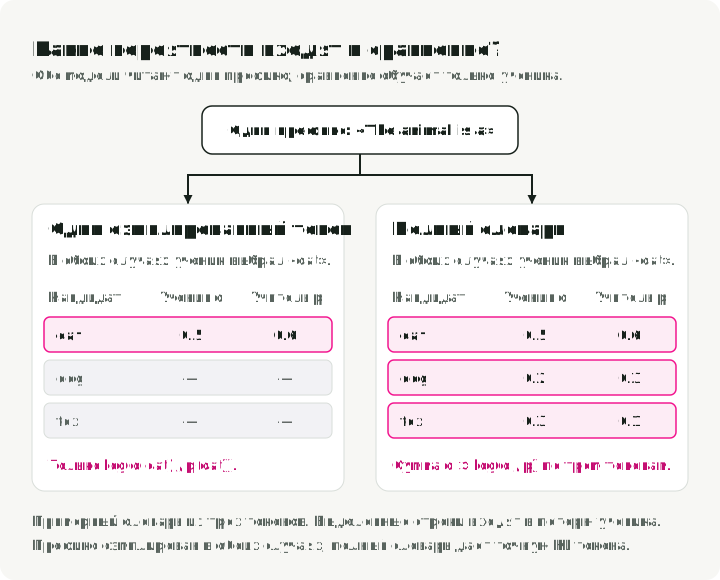
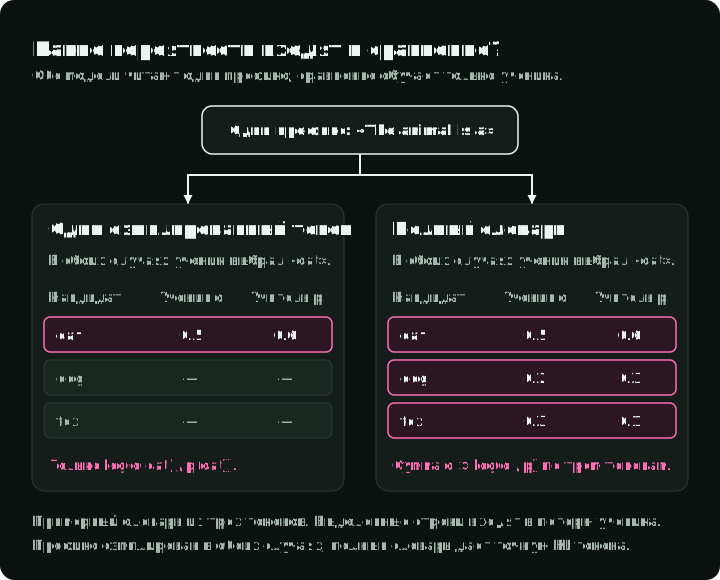
Для трёх строк получаем . Логарифм отношения только для сэмплированного «cat» равен примерно . Одна выборка может дать отрицательное значение, хотя полная KL неотрицательна.
Подробный разбор on-policy рассматривает переход от последовательностей к токенам, поправки сэмплирования и оценки градиента.
DPO: логистическая потеря для двух логарифмов отношений
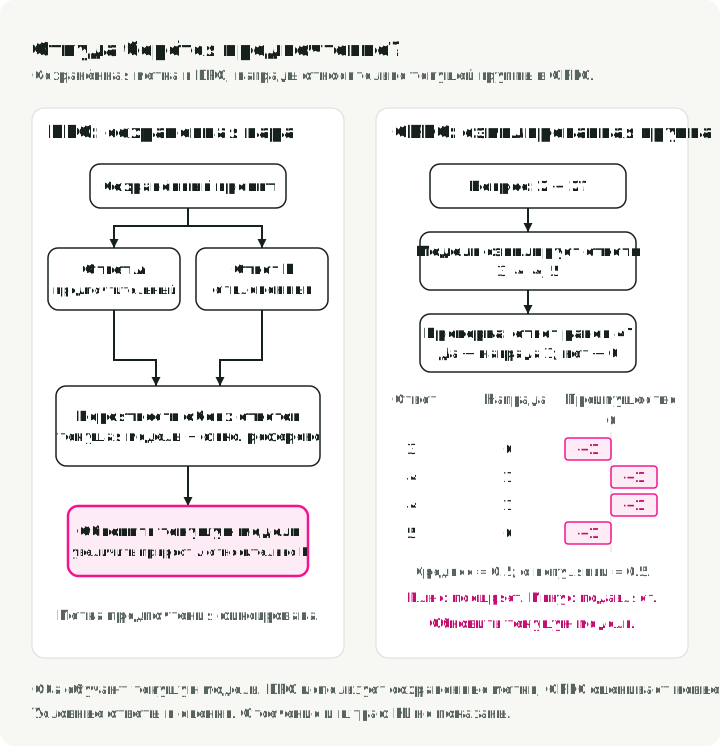
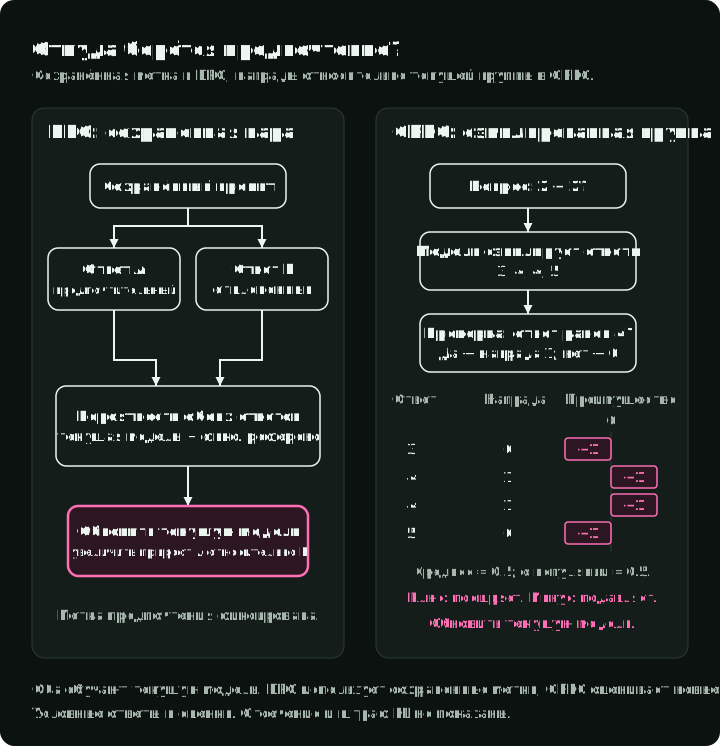
DPO начинает с сохранённой пары предпочтений: одного промпта, предпочтительного и отклонённого ответов. Пара может быть получена из человеческих оценок более ранних ответов моделей. При обучении модель читает каждый сохранённый ответ токен за токеном и записывает его вероятность при заданных промпте и предыдущих токенах. Сумма этих логарифмов вероятностей даёт логарифм вероятности ответа. Это оценивает вероятность текста по модели; сохранённая метка предпочтения указывает, какой ответ лучше.
В обычной процедуре RLHF пары предпочтений сначала обучают отдельную модель награды, а затем обучение с подкреплением обучает языковую модель по этой награде. DPO, §4, уравнение (7), вместо этого обучает языковую модель непосредственно на парах. Замороженная референсная модель оценивает те же ответы для сравнения. Обучение меняет только текущую модель; ни одной из моделей не нужно генерировать новые ответы на этом шаге.
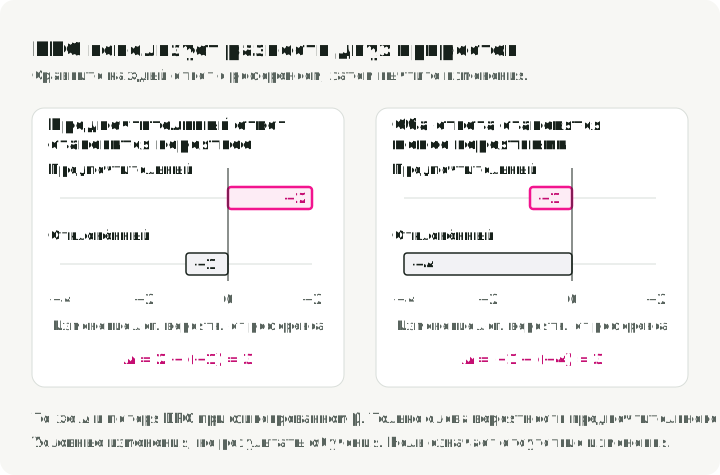
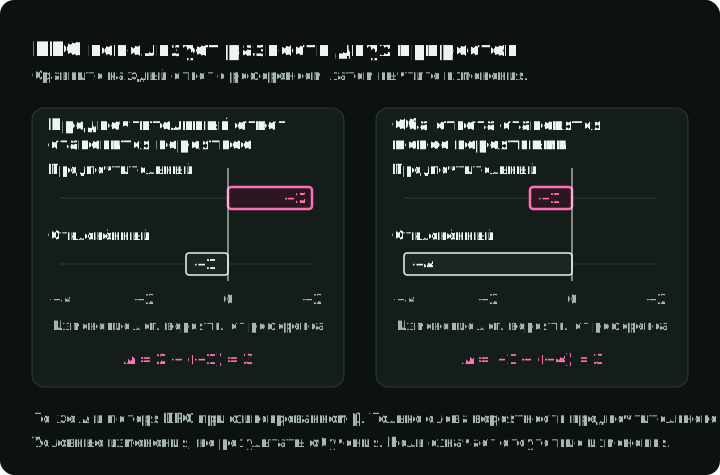
Для каждого ответа вычтите референсный логарифм вероятности из текущего. Назовём это изменение приростом. DPO сравнивает прирост предпочтительного ответа с приростом отклонённого:
Здесь — промпт, и — предпочтительный и отклонённый ответы, а и — текущая и референсная модели. Сигмоида отображает число в , а — положительный масштаб. Последняя строка читается как «усреднить потерю пары в квадратных скобках по сохранённым парам датасета ». Увеличение уменьшает эту потерю; обучение минимизирует , меняя параметры текущей модели.
Например, если логарифм вероятности предпочтительного ответа вырос на 2, а отклонённого упал на 1, то . Предпочтение изменилось в нужном направлении относительно референса. Функция потерь не содержит отдельного члена KL и не задаёт максимальное расстояние до референса.
Одна разность может скрыть проблему: предпочтительный ответ может становиться менее вероятным, пока вероятность отклонённого падает ещё быстрее. Потеря при этом улучшается. Smaug исследует этот сбой, поэтому проверяйте вероятности отдельных ответов наряду с потерей предпочтений.
Оба случая ниже дают одинаковое и, следовательно, одинаковую потерю пары при фиксированном . Только слева предпочтительный ответ становится вероятнее, чем был у референса.
На следующем рисунке обратная связь DPO связана с сохранённой парой. GRPO генерирует четыре ответа на «2 + 2?» во время обучения. Проверка ответа присваивает 1 за «4» и 0 в остальных случаях. Сравнение каждой награды со средним по группе даёт преимущество: положительная обратная связь поощряет токены сэмплированного ответа, а отрицательная — подавляет. Следующий раздел показывает этот расчёт и ограничения его влияния.
Подробный разбор DPO выводит функцию потерь из целевой функции с регуляризацией награды и разбирает её градиент.
GRPO: целевая функция PPO с групповой базой сравнения
Group Relative Policy Optimization сэмплирует несколько ответов на один вопрос, оценивает их и сравнивает каждую оценку со средним по группе. Правильный ответ среди преимущественно неправильных получает положительную обратную связь; неправильный среди правильных — отрицательную. Для математики или кода оценку может давать проверка ответа или тесты. Другие задачи могут использовать модель награды.
DeepSeekMath, §4.1.1, представил GRPO как вариант Proximal Policy Optimization (PPO). DeepSeek-R1, §2.2.1, позже использовал его. Главное изменение — способ вычисления преимущества, относительной награды, которая направляет обновление:
— награда ответа , а — число ответов на один вопрос. Вычитание среднего показывает, какие ответы получили оценки выше или ниже среднего по группе. Деление на стандартное отклонение масштабирует эти разности. В показанной группе среднее равно , а стандартное отклонение генеральной совокупности — , что даёт преимущества .
Что меняется по сравнению с PPO
PPO обычно обучает отдельную модель ценности, чтобы оценивать будущую награду по частичному ответу. GRPO использует вместо неё оценки группы как базу сравнения, поэтому не обучает эту модель ценности. Обратная связь в виде награды всё ещё нужна, а исходная целевая функция по-прежнему использует референсную модель для штрафа KL. Удаление модели ценности не устраняет эти другие роли.
Сравнение ниже показывает, где находилась заменённая модель ценности. Нижний ряд показывает два других входа обучения. Старая модель или модель сэмплирования — версия, которая сгенерировала этот батч ответов; её записанные вероятности токенов остаются фиксированными, пока текущая модель обучается на этом батче. Отдельная референсная модель, также фиксированная во время этих обновлений, даёт вероятности для сравнения KL. Оба сравнения оценивают один токен после одного префикса.
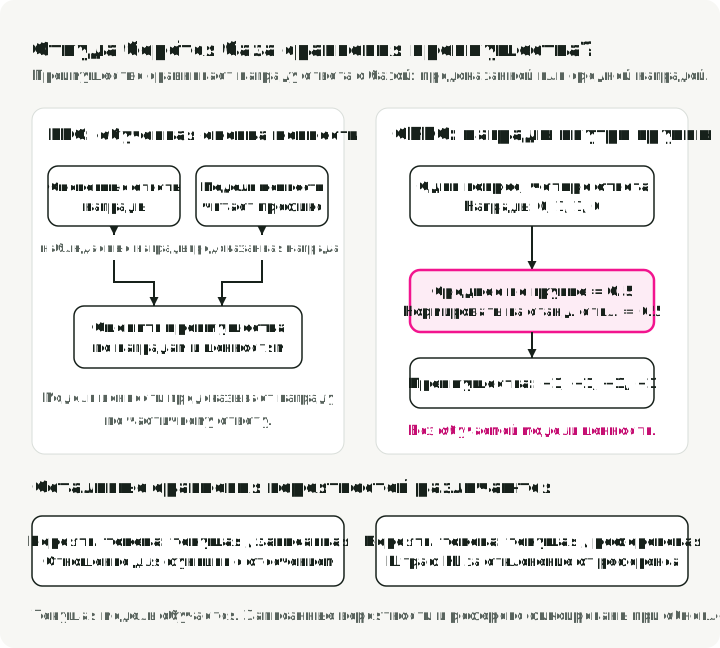
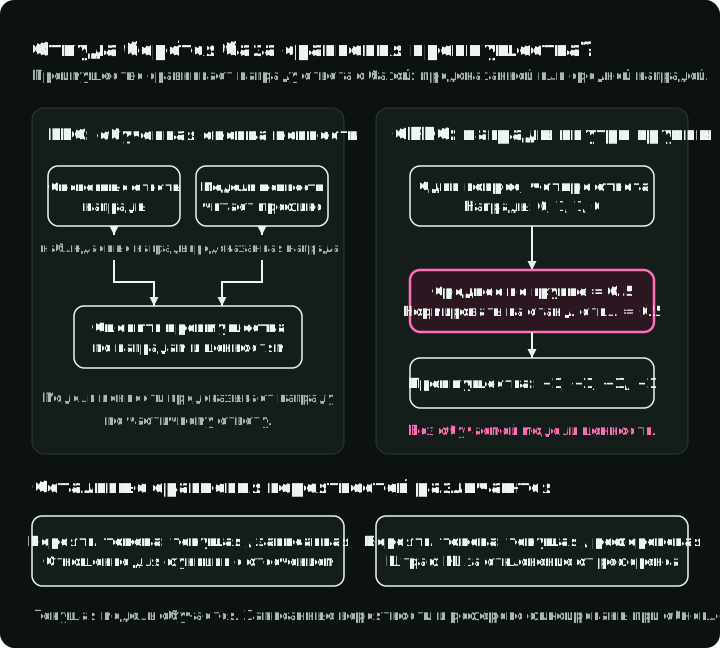
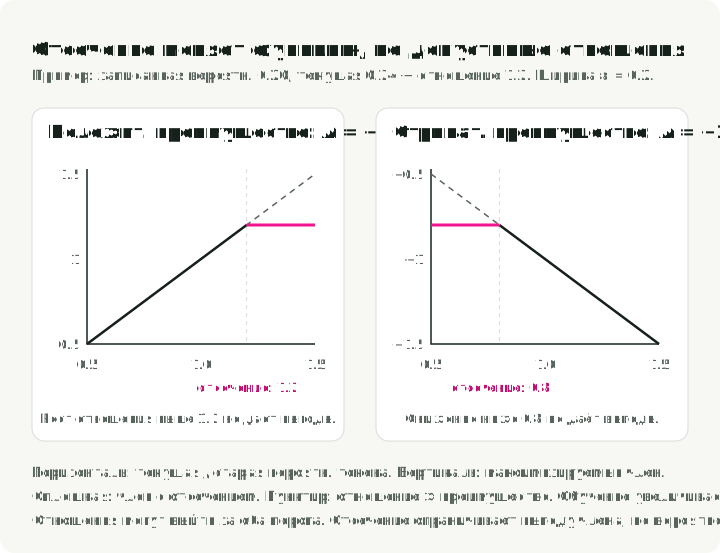
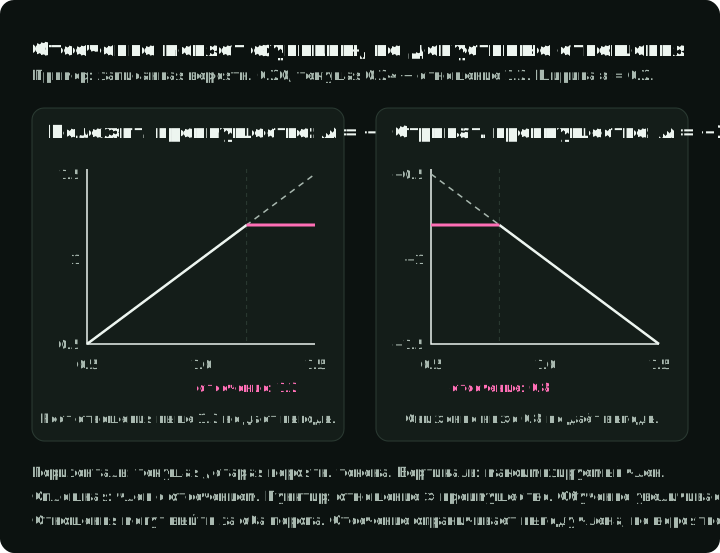
GRPO сохраняет целевую функцию PPO с отсечением отношения вероятностей. Если сэмплированный токен имел вероятность , а текущая модель теперь присваивает ему на том же префиксе, отношение равно . Целевая функция взвешивает это отношение преимуществом ответа. Обучение меняет текущую модель, чтобы увеличить эту функцию, а отдельный штраф KL сдерживает отклонение от референса.
Для одного сэмплированного ответа обозначим через промпт и токены ответа перед позицией , а через — токен на этой позиции. Часть уравнения (3) DeepSeekMath, показанная на графике:
— текущая модель, — копия для сэмплирования, а — преимущество этого ответа относительно группы. Ширина задаёт интервал отсечения. Читайте как «заменить отношение вне интервала ближайшей границей», а затем как «взять меньший из двух членов, взвешенных преимуществом». — вклад, который нужно максимизировать. GRPO вычитает штраф KL и усредняет по токенам внутри ответов, ответам внутри групп и сэмплированным вопросам.
При , и два члена равны и , поэтому . При и они равны и , поэтому . Это два горизонтальных участка графика.
График выделяет вклад одного токена при фиксированном преимуществе. Положительное преимущество поощряет большее отношение; отрицательное — меньшее. Отсечение делает линию горизонтальной там, где благоприятное изменение перестаёт улучшать этот член. Оно не задаёт жёсткого ограничения реальных вероятностей модели.
Копия для сэмплирования и референс могут начинать с одинаковых весов, но служат разным сравнениям. Копия для сэмплирования обновляется при сборе нового батча; её записанные вероятности остаются знаменателем при обновлениях на этом батче.
Если все ответы получают одинаковую награду, относительного предпочтения для обучения нет. Формула преимущества тогда делит ноль на ноль. Реализации нужно правило для этого случая, например нулевые преимущества; DAPO, §3.2, вместо этого исключает такие группы и сэмплирует им замену.
Подробный разбор GRPO рассматривает полную целевую функцию, случаи отсечения, градиенты, сэмплированный оцениватель KL и влияние усреднения по ответам или по токенам.
Дополнительные разборы уравнений
Подробные разборы по ссылкам включают выводы и проверки на небольших числах. Они созданы с помощью навыков для программирующих агентов из paper-math-skills и собраны в paper-math-readings.
Источники и версии
- Хинтон и соавторы. Distilling the Knowledge in a Neural Network, §2, уравнение (1).
- Гу и соавторы. MiniLLM, §2.1–2.2.
- DeepSeek-AI. DeepSeek-V4, §5.1.2, уравнение (29).
- Рафаилов и соавторы. Direct Preference Optimization, §4, уравнение (7).
- Шао и соавторы. DeepSeekMath, §4.1.1, уравнения (1)–(4).
- DeepSeek-AI. DeepSeek-R1, §2.2.1 и §2.4.