Ler funções objetivo: destilação, DPO e GRPO

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
A destilação, a Direct Preference Optimization (DPO) e a Group Relative Policy Optimization (GRPO) alteram as probabilidades de um modelo de linguagem, mas usam exemplos de treino e informação de retorno diferentes. Este guia destina-se a engenheiros que querem compreender essas diferenças antes de ler as funções objetivo completas. Os diagramas mostram de onde vem a informação de retorno e como altera as comparações de probabilidades; as equações apresentam as operações correspondentes.
No fine-tuning supervisionado habitual, o modelo aprende a prever o token seguinte em exemplos guardados. Os métodos abaixo alteram a informação de retorno: um professor fornece probabilidades, um par de preferências indica qual a melhor resposta ou uma recompensa avalia respostas amostradas durante o treino. Uma política é simplesmente o modelo que gera respostas. Todos os logaritmos abaixo são naturais.
A Parte 1 explica como ler uma equação e inclui uma referência de notação. Aqui, cada secção explica os termos de que precisa e pode ser lida de forma independente.
Destilação clássica: uma temperatura nas duas funções softmax
Uma etiqueta de treino identifica o resultado correto: na previsão do token seguinte, é o próximo token num exemplo guardado. Um modelo professor fornece mais informação: as suas probabilidades para cada token candidato, incluindo alternativas plausíveis. A destilação treina um aluno mais pequeno para reproduzir essas probabilidades. O treino reduz uma perda numérica alterando os parâmetros do aluno; os do professor mantêm-se fixos.
O artigo sobre destilação de Hinton e colaboradores, §2, suaviza as probabilidades dos dois modelos antes de as comparar. Divida cada logit — a pontuação bruta antes da função softmax — por uma temperatura :
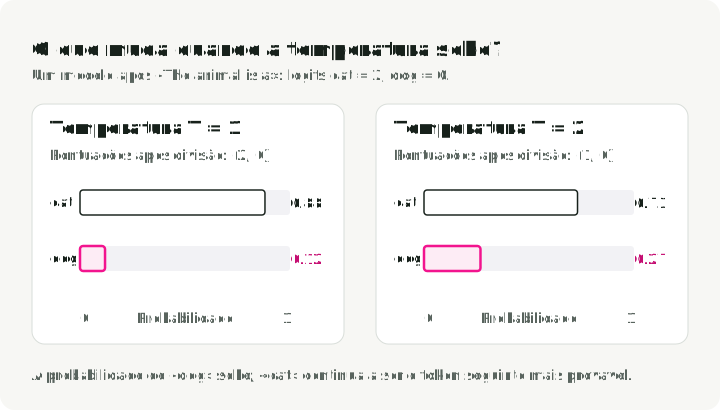
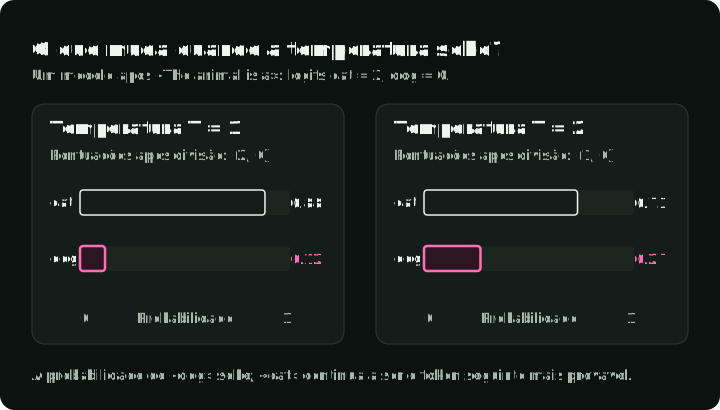
Aqui, é a pontuação do candidato e a sua probabilidade. Suponha que um modelo simplificado tem apenas dois tokens seguintes possíveis, «cat» e «dog», e lhes atribui pontuações depois de ler «The animal is a». Com , as probabilidades são aproximadamente ; com , passam a . A pontuação menor contribui agora mais para a comparação. O professor e o aluno usam a mesma temperatura.
As barras mostram como as mesmas duas pontuações dão uma distribuição menos concentrada à medida que a temperatura sobe.
A perda de treino combina a perda habitual face à etiqueta com uma perda de correspondência à distribuição suavizada do professor. Representamos por as probabilidades do professor e por as do aluno à temperatura . Para uma entrada etiquetada:
Aqui, é a perda, é o token seguinte correto e define a mistura. Os índices superiores entre parênteses indicam temperaturas, não potências. Leia o primeiro termo como «penalizar uma probabilidade baixa para o token correto com ». Leia o segundo como «reproduzir as probabilidades suavizadas do professor». O treino calcula a média destas perdas nas entradas guardadas e altera apenas o aluno.
é a divergência KL do professor para o aluno . Mede a diferença entre duas distribuições de probabilidade: vale zero quando coincidem. A primeira distribuição fornece os pesos da comparação, pelo que os resultados prováveis segundo o professor recebem mais peso. Hinton e colaboradores descrevem um termo de correspondência por entropia cruzada; esta forma KL subtrai uma constante que depende apenas do professor e dá os mesmos gradientes para o aluno.
O fator compensa aproximadamente os gradientes menores a temperaturas mais altas. Esta é uma configuração de treino; o aluno em produção normalmente volta a nesta função softmax.
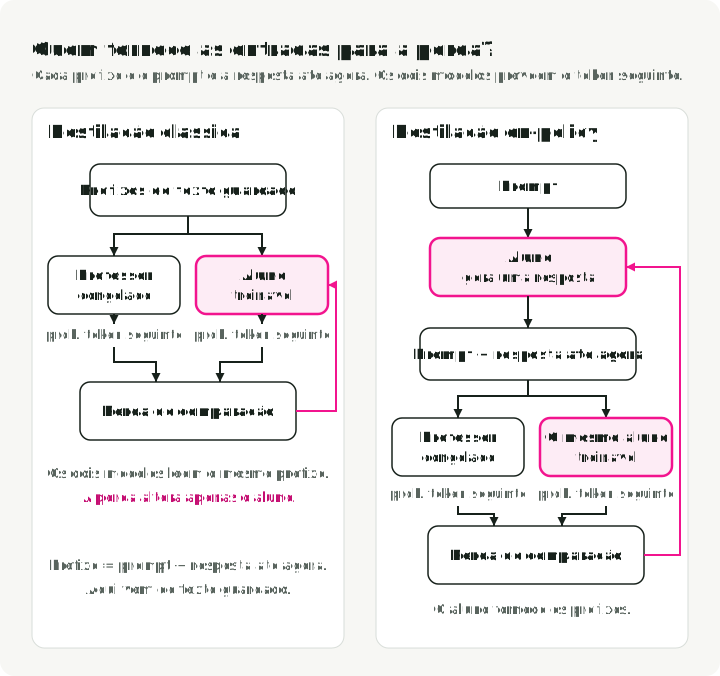
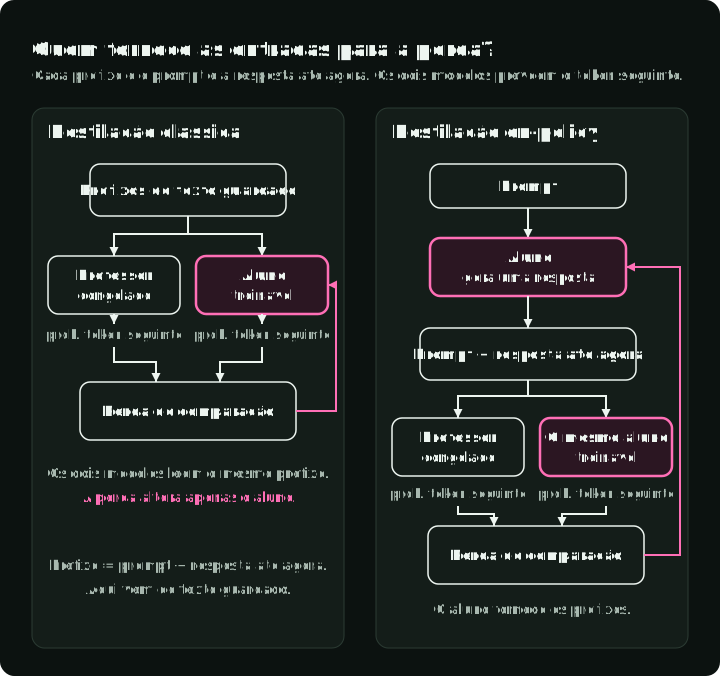
Um prefixo é o texto já disponível antes do token seguinte: o prompt e todos os tokens da resposta gerados até então. Por exemplo, «The animal is a» é o prefixo antes de «cat». Na figura, os dois modelos leem o mesmo prefixo e produzem probabilidades para o token seguinte. À esquerda, os prefixos vêm de exemplos guardados. À direita, vêm de respostas que o aluno gera durante o treino. Ambos os percursos usam a perda de comparação para atualizar apenas o aluno.
Também existe destilação sem correspondência de probabilidades. Os modelos destilados do DeepSeek-R1, §2.4, foram sujeitos a fine-tuning com 800 000 amostras previamente selecionadas com o DeepSeek-R1. Usaram uma perda supervisionada sobre texto guardado; não era necessário executar um professor durante esse treino.
A análise detalhada da destilação explica a perda mista e o escalamento por temperatura.
Destilação on-policy: o aluno vem primeiro na KL
Um aluno que gera a sua própria resposta pode chegar a prefixos — o prompt e a resposta até esse momento — que nunca ocorreram no dataset de treino. A destilação on-policy obtém informação de retorno sobre texto que o aluno realmente produz. Dado um prompt, o aluno amostra uma resposta. Um professor congelado avalia depois os mesmos prefixos, pelo que o treino compara os dois modelos onde o aluno precisa de orientação.
On-policy descreve essa origem do texto de treino. Por si só, não determina uma perda específica. Os exemplos aqui usam a KL inversa, com o aluno primeiro:
Para um prompt fixo , é o aluno com parâmetros treináveis , é o professor e uma resposta amostrada do aluno. A expressão compara a probabilidade que o aluno atribuiu à sua resposta com a probabilidade do professor. Na média das respostas do aluno, penaliza-o por atribuir probabilidade alta a texto que o professor considera improvável.
Isto difere de pedir ao aluno que abranja todos os resultados que o professor poderia produzir. Quando um aluno pequeno não consegue reproduzir a distribuição completa do professor, a KL inversa pode favorecer a concentração em alguns dos seus resultados prováveis. O MiniLLM, §2.1, equação (1), usa este objetivo. O seu procedimento de treino também mistura amostras do professor na geração e ajusta o gradiente para reduzir a variância e o enviesamento de comprimento; o diagrama mostra a configuração on-policy básica, não todas as alterações do MiniLLM.
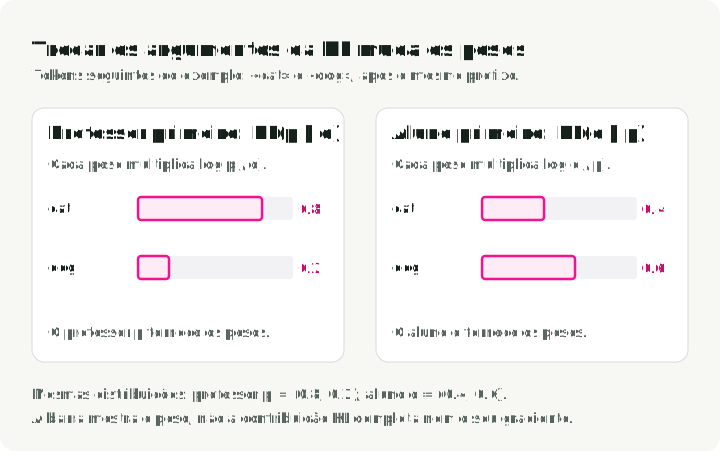
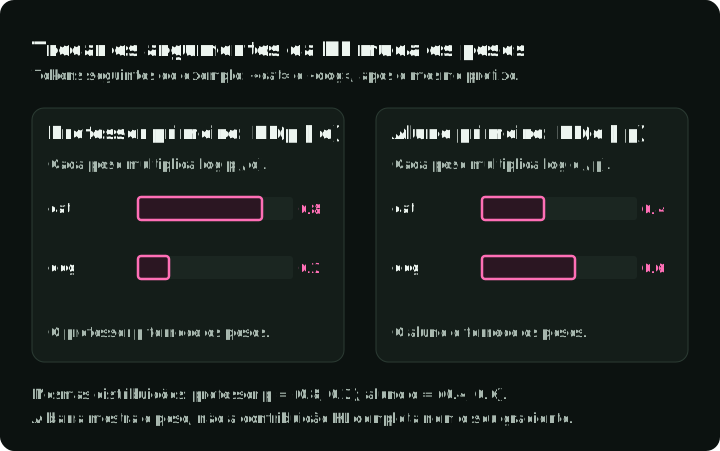
No exemplo simplificado abaixo, professor e aluno atribuem probabilidades diferentes a «cat» e «dog» após o mesmo prefixo. A KL multiplica o logaritmo do rácio de cada token pelo respetivo peso e soma os dois termos. Mudar o primeiro argumento transfere o peso maior de «cat» para «dog». As barras mostram os pesos, não as contribuições completas para a perda.
Da KL de sequências à KL de tokens
A probabilidade de uma resposta é construída a partir das probabilidades dos seus tokens seguintes. Em cada prefixo de uma resposta do aluno, os dois modelos preveem o token seguinte. As diferenças podem, por isso, ser comparadas posição a posição e depois acumuladas ao longo da resposta. O DeepSeek-V4, §5.1.2, equação (29), usa destilação por KL inversa de vários professores especializados para um único aluno. Estes professores são modelos separados, não as sub-redes de especialistas dentro de uma camada mixture-of-experts.
Na posição , seja a probabilidade do aluno para o token candidato . O prefixo contém o prompt e os tokens anteriores da resposta ; é a probabilidade do professor nesse mesmo prefixo. Então:
é o vocabulário e a KL do token seguinte num prefixo. Leia a soma interior como «comparar cada token candidato, ponderado pela probabilidade do aluno». Some estas comparações nas várias posições e calcule depois a média nas respostas que o aluno gera. A esperança exterior continua a amostrar texto, mesmo quando cada soma todo o vocabulário.
Um token amostrado ou o vocabulário completo
O professor pode avaliar apenas o token que o aluno escolheu ou devolver probabilidades para todo o vocabulário. A primeira opção transfere menos informação; a segunda compara todos os tokens seguintes possíveis nesse prefixo. O DeepSeek-V4 relata treino instável com a sua estimativa de um token e usa a comparação do vocabulário completo. Isto torna a comparação de tokens exata num dado prefixo; os prefixos continuam a vir de respostas amostradas.
Os dois modelos leem «The animal is a» e devolvem as probabilidades abaixo. As linhas destacadas entram na perda usada para atualizar o aluno. A versão de vocabulário completo inclui «dog» e «fox», embora o aluno tenha escolhido «cat»; a versão de um token estima essa comparação apenas a partir do token escolhido.
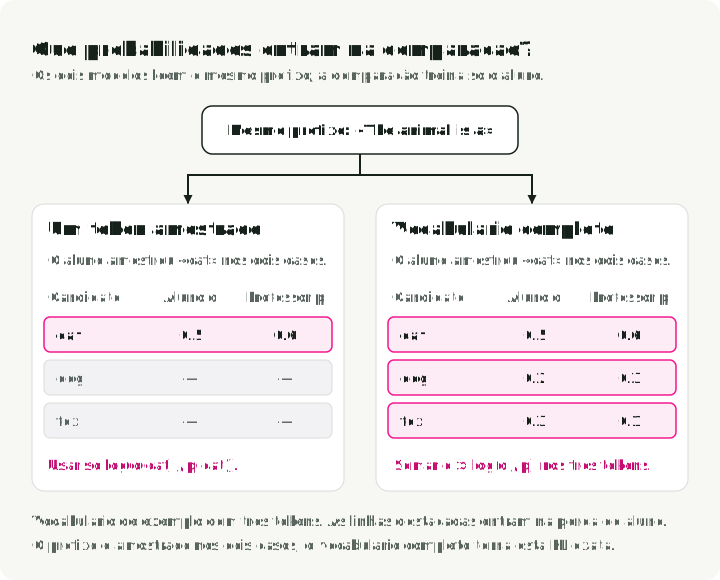
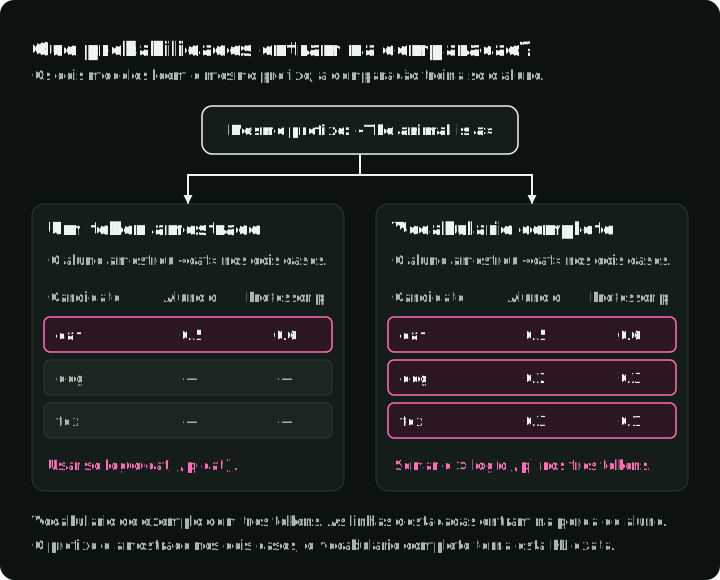
Usando as três linhas, . O logaritmo do rácio apenas para o «cat» amostrado é cerca de . Uma amostra pode ser negativa, embora a KL completa seja não negativa.
A análise detalhada de on-policy apresenta a derivação de sequências para tokens, as correções de amostragem e as estimativas do gradiente.
DPO: uma perda logística sobre dois logaritmos de rácios
O DPO começa com um par de preferências guardado: um prompt, uma resposta preferida e uma resposta rejeitada. O par pode vir de avaliações humanas de respostas anteriores de modelos. Durante o treino, o modelo lê cada resposta guardada token a token e regista a sua probabilidade dado o prompt e os tokens anteriores. A soma desses logaritmos de probabilidades dá o logaritmo da probabilidade da resposta. Isto avalia a probabilidade do texto segundo o modelo; a etiqueta de preferência guardada indica qual a melhor resposta.
Num procedimento RLHF convencional, os pares de preferências treinam primeiro um modelo de recompensa separado, e a aprendizagem por reforço treina depois o modelo de linguagem com essa recompensa. O DPO, §4, equação (7), treina antes o modelo de linguagem diretamente a partir dos pares. Um modelo de referência congelado avalia as mesmas respostas para comparação. O treino altera apenas o modelo atual; nenhum dos modelos precisa de gerar novas respostas neste passo.
Para cada resposta, subtraia o logaritmo da sua probabilidade de referência ao logaritmo da sua probabilidade atual. Chamamos ganho a esta alteração. O DPO compara o ganho da resposta preferida com o da resposta rejeitada:
Aqui, é o prompt, e são as respostas preferida e rejeitada, e e são os modelos atual e de referência. A sigmoide transforma um número num valor em , e é uma escala positiva. Leia a última linha como «calcular a média da perda do par entre parênteses retos nos pares guardados do dataset ». Aumentar reduz essa perda; o treino minimiza alterando os parâmetros do modelo atual.
Por exemplo, se a resposta preferida ganha 2 no logaritmo da probabilidade e a rejeitada perde 1, então . A preferência mudou no sentido pretendido em relação à referência. A perda não tem um termo KL separado e não impõe uma distância máxima à referência.
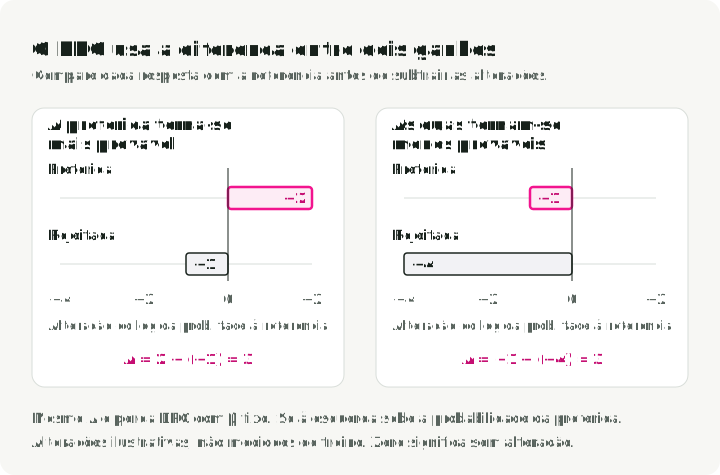
A diferença, por si só, pode ocultar um problema: a resposta preferida pode tornar-se menos provável enquanto a rejeitada se torna menos provável ainda mais depressa. A perda continua a melhorar. O Smaug estuda esta falha, pelo que deve inspecionar as probabilidades de cada resposta, além da perda de preferências.
Os dois casos abaixo dão o mesmo e, portanto, a mesma perda do par para um fixo. Só o caso da esquerda torna a resposta preferida mais provável do que era na referência.
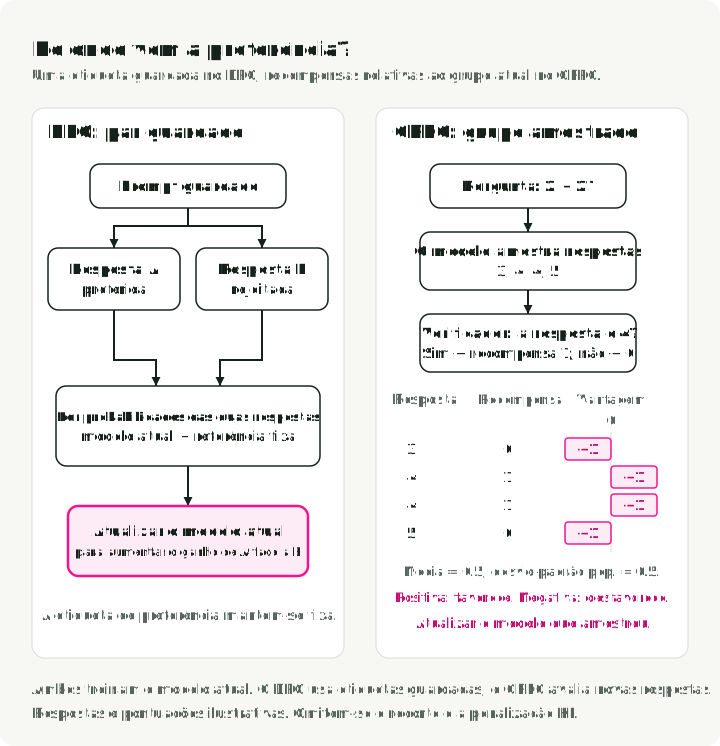
Na figura seguinte, a informação de retorno do DPO está associada a um par guardado. O GRPO gera quatro respostas a «2 + 2?» durante o treino. Um verificador atribui 1 a «4» e 0 às restantes respostas. A comparação de cada recompensa com a média do grupo produz uma vantagem: a informação positiva favorece os tokens da resposta amostrada, e a negativa desfavorece-os. A secção seguinte mostra esse cálculo e os limites do seu efeito.
A análise detalhada do DPO deriva a perda a partir do objetivo com regularização da recompensa e analisa o seu gradiente.
GRPO: o objetivo do PPO com uma referência de grupo
A Group Relative Policy Optimization amostra várias respostas à mesma pergunta, avalia-as e compara cada pontuação com a média do grupo. Uma resposta correta entre respostas maioritariamente incorretas recebe informação positiva; uma resposta incorreta entre corretas recebe informação negativa. Para matemática ou código, a avaliação pode usar um verificador de respostas ou testes. Outras tarefas podem usar um modelo de recompensa.
O DeepSeekMath, §4.1.1, introduziu o GRPO como uma variante da Proximal Policy Optimization (PPO). O DeepSeek-R1, §2.2.1, usou-o posteriormente. A alteração principal está na forma de calcular a vantagem, a recompensa relativa que orienta a atualização:
é a recompensa da resposta e o número de respostas a uma pergunta. Subtrair a média indica quais as respostas com pontuação acima ou abaixo do grupo. Dividir pelo desvio-padrão ajusta a escala dessas diferenças. No grupo ilustrado , a média é e o desvio-padrão populacional é , dando vantagens .
O que muda em relação ao PPO
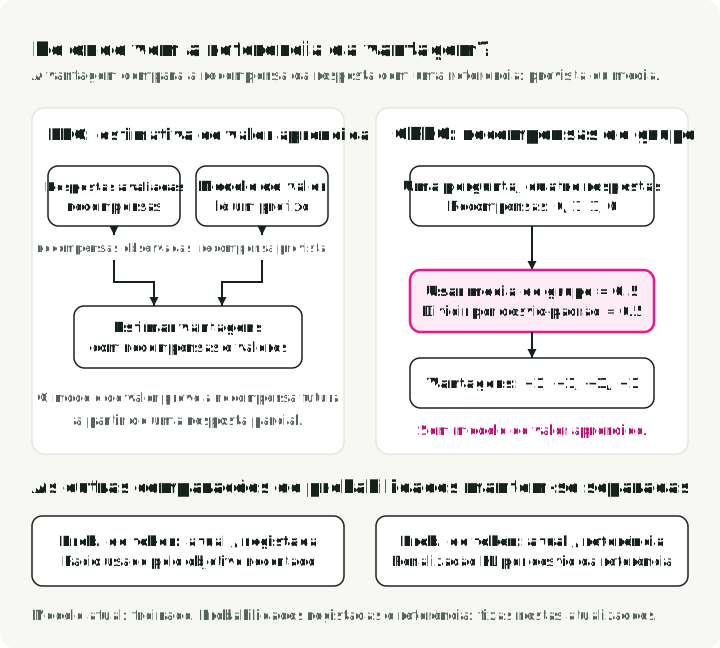
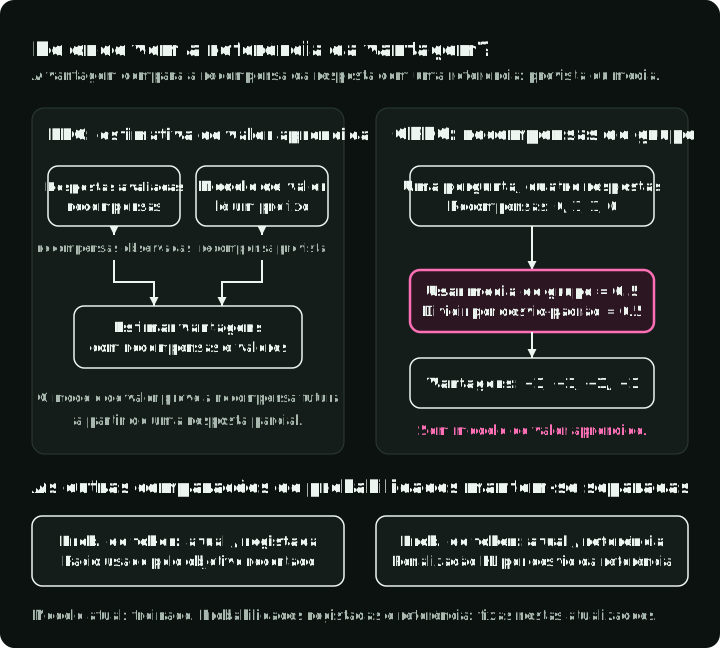
O PPO treina habitualmente um modelo de valor separado para estimar a recompensa futura a partir de uma resposta parcial. O GRPO usa antes as pontuações do grupo como referência, pelo que não treina esse modelo de valor. Continua a precisar de recompensas, e o seu objetivo original continua a usar um modelo de referência para uma penalização KL. Remover o modelo de valor não elimina essas outras funções.
A comparação abaixo identifica o modelo de valor substituído. A linha inferior mostra duas outras entradas do treino. O modelo antigo ou de amostragem é a versão que gerou este lote de respostas; as probabilidades de tokens registadas mantêm-se fixas enquanto o modelo atual treina com esse lote. Um modelo de referência separado, também fixo durante estas atualizações, fornece probabilidades para a comparação KL. As duas comparações avaliam o mesmo token após o mesmo prefixo.
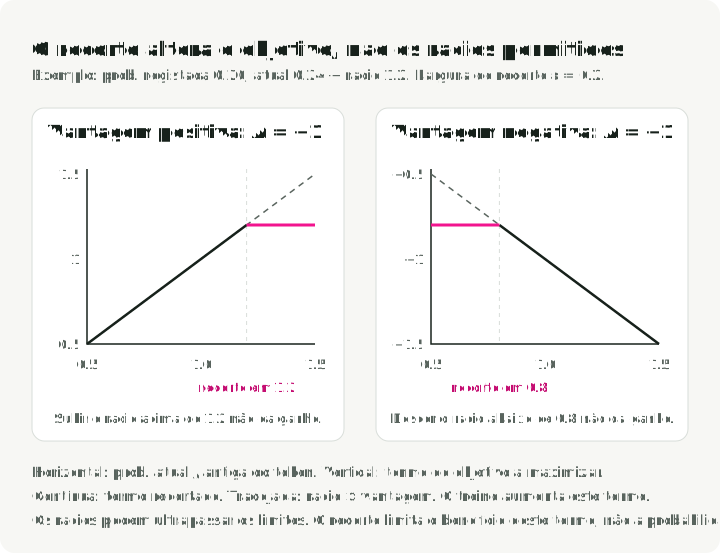
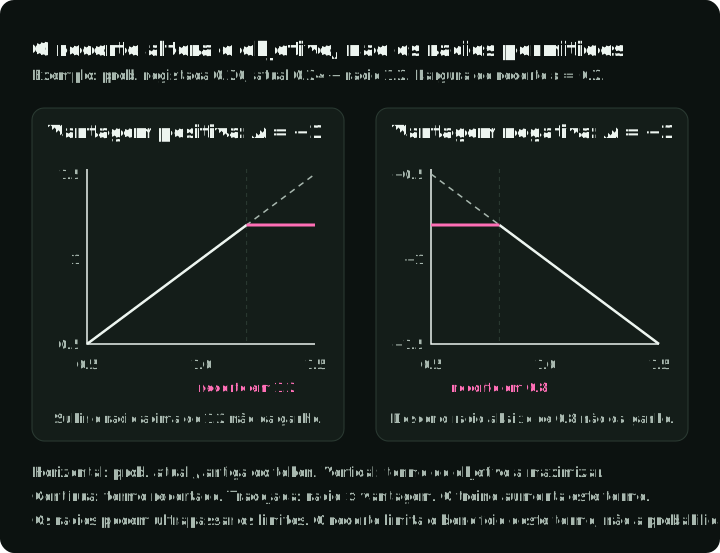
O GRPO mantém o objetivo do PPO com recorte do rácio de probabilidades. Se um token amostrado tinha probabilidade e o modelo atual lhe atribui agora no mesmo prefixo, o rácio é . O objetivo pondera este rácio pela vantagem da resposta. O treino altera o modelo atual para aumentar este objetivo, com uma penalização KL separada que desencoraja o afastamento da referência.
Para uma resposta amostrada, representamos por o prompt e os tokens da resposta anteriores à posição , e por o token nessa posição. A parte da equação (3) do DeepSeekMath mostrada no gráfico é:
é o modelo atual, a cópia de amostragem e a vantagem desta resposta no grupo. A largura define o intervalo de recorte. Leia como «substituir um rácio fora do intervalo pelo extremo mais próximo» e depois como «tomar o menor dos dois termos ponderados pela vantagem». é uma contribuição a maximizar. O GRPO subtrai a sua penalização KL e calcula a média nos tokens de cada resposta, nas respostas de cada grupo e nas perguntas amostradas.
Com , e , os dois termos são e , pelo que . Com e , são e , pelo que . Estas são as duas partes horizontais do gráfico.
O gráfico isola a contribuição de um token, mantendo a sua vantagem fixa. Uma vantagem positiva favorece um rácio maior; uma negativa favorece um rácio menor. O recorte torna a linha horizontal onde uma alteração favorável deixa de melhorar este termo. Não impõe um limite rígido às probabilidades reais do modelo.
A cópia de amostragem e a referência podem começar com os mesmos pesos, mas servem comparações diferentes. A cópia de amostragem é renovada ao recolher um novo lote; as suas probabilidades registadas continuam a ser o denominador das atualizações nesse lote.
Se todas as respostas recebem a mesma recompensa, não existe preferência relativa para aprender. A fórmula da vantagem divide então zero por zero. As implementações precisam de uma regra para este caso, como produzir vantagens nulas; o DAPO, §3.2, exclui antes estes grupos e amostra substitutos.
A análise detalhada do GRPO apresenta o objetivo completo, os casos de recorte, os gradientes, o estimador KL amostrado e o efeito de calcular médias por resposta ou por token.
Análises opcionais das equações
As análises detalhadas indicadas incluem derivações e verificações com números pequenos. Foram produzidas com as competências para agentes de programação em paper-math-skills e estão reunidas em paper-math-readings.
Fontes e versões
- Hinton e colaboradores. Distilling the Knowledge in a Neural Network, §2, equação (1).
- Gu e colaboradores. MiniLLM, §2.1–2.2.
- DeepSeek-AI. DeepSeek-V4, §5.1.2, equação (29).
- Rafailov e colaboradores. Direct Preference Optimization, §4, equação (7).
- Shao e colaboradores. DeepSeekMath, §4.1.1, equações (1)–(4).
- DeepSeek-AI. DeepSeek-R1, §2.2.1 e §2.4.